Concevoir pour l’observabilité et la visibilité
Chapter Info
Calculating... Writing Progress: 60%
L’observabilité est la capacité à comprendre un système à partir des preuves qu’il produit en continu. Les signaux deviennent des preuves lorsqu’ils permettent d’expliquer ce qui s’est passé, où et pourquoi. Les systèmes logiciels modernes sont distribués, asynchrones et en évolution constante, ce qui rend les défaillances plus difficiles à diagnostiquer. La visibilité rend la santé et le comportement du système accessibles ; l’observabilité va plus loin en transformant des signaux bruts en preuves que les équipes peuvent utiliser pour expliquer ce qui se passe et pourquoi. Ce chapitre explique quelles preuves comptent, comment les structurer et comment construire des systèmes diagnostiquables par conception — pour que les équipes détectent les problèmes tôt, enquêtent rapidement et améliorent la fiabilité dans la durée.
Concepts fondamentaux
Ce qu’on ne voit pas, on ne peut pas le contrôler
Ce que vous ne pouvez pas voir, vous ne pouvez ni le comprendre ni le contrôler. C’est vrai de tout système complexe, qu’il soit technique, organisationnel ou physique. Sans preuve claire de son état interne et de son comportement, les décisions reposent sur des suppositions, les problèmes restent cachés et l’amélioration relève du hasard.
L’opacité des systèmes modernes
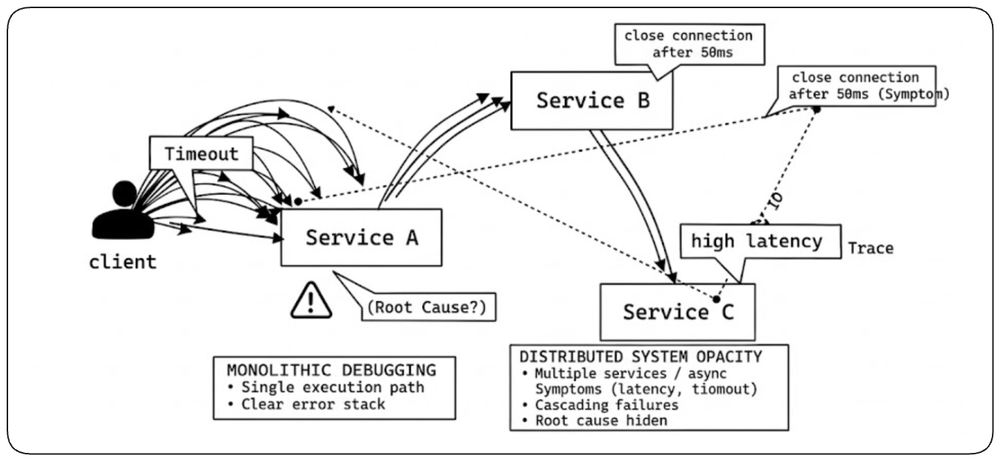
Les systèmes modernes masquent la causalité. Une défaillance visible n’est parfois que le dernier symptôme d’une longue chaîne impliquant plusieurs services, files d’attente et dépendances. L’observabilité reconstitue cette chaîne et transforme des symptômes dispersés en une explication traçable.
Monitoring vs observabilité : une différence fondamentale
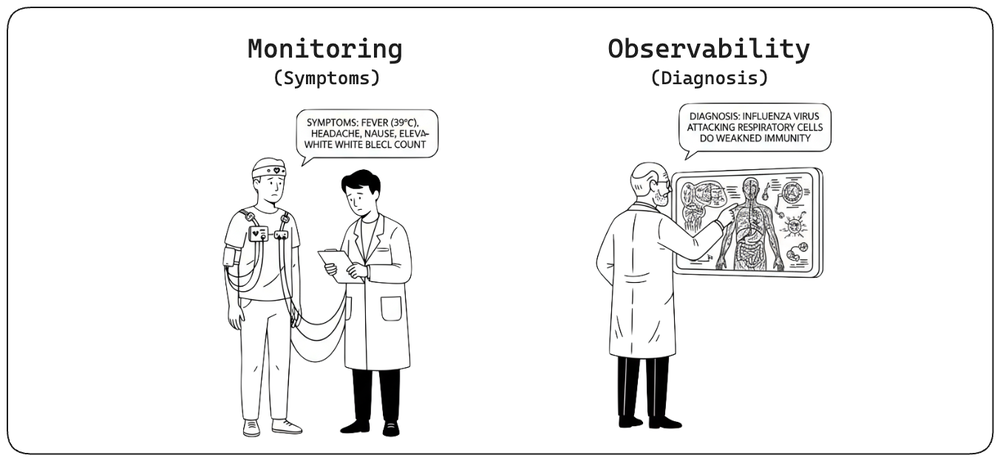
Le monitoring répond à « Y a-t-il un problème ? » en détectant des modes de défaillance connus à l’aide de seuils et d’alarmes prédéfinis. Il se concentre sur l’alerte lorsque des métriques franchissent des limites ou que des schémas attendus sont violés. L’observabilité répond à « Que se passe-t-il et pourquoi ? » en permettant d’investiguer des modes de défaillance connus comme inconnus grâce à suffisamment de signaux et de contexte pour expliquer le comportement du système. En bref : le monitoring fournit des alarmes ; l’observabilité fournit de la compréhension.
Pourquoi l’observabilité existe : la défaillance est normale
L’observabilité existe parce que la défaillance est normale. Dans les systèmes complexes, la question n’est pas de savoir si quelque chose va casser, mais quand, où et comment. Les défaillances se présentent souvent sous forme de symptômes ambigus — une hausse de latence, une panne partielle, une dépendance défaillante ou un parcours utilisateur peu fiable — plutôt que d’une erreur claire. L’observabilité donne aux équipes les preuves pour comprendre ce qui s’est passé, où, pourquoi et ce qui a changé, transformant les incidents de tâtonnements en investigation et en apprentissage.
Principes de conception
L’observabilité commence à la conception, pas pendant l’incident
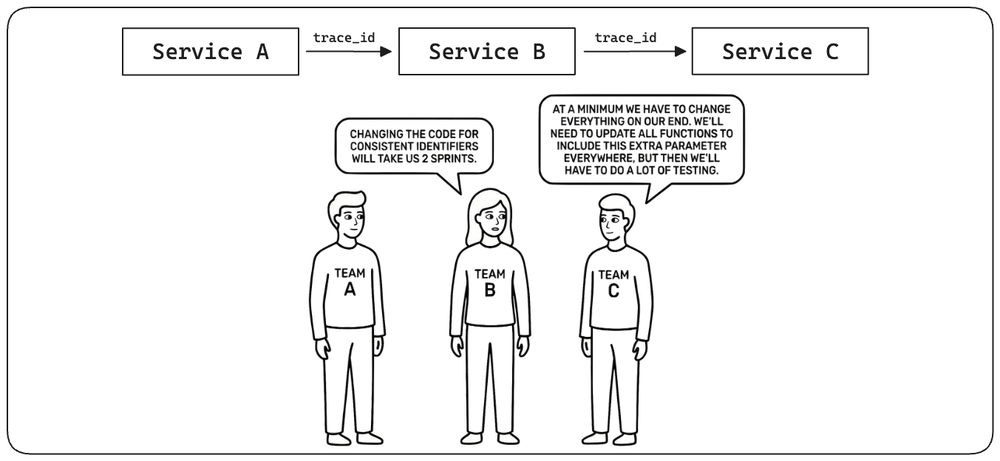
L’observabilité doit être conçue avant que les incidents ne surviennent. Les systèmes doivent exposer dès le départ des frontières claires, des workflows explicites, des identifiants de requête et de trace cohérents, et une sémantique d’événements stable. Sans cette base, les équipes découvrent l’instrumentation manquante au moment où elles en ont le plus besoin, et la réponse aux incidents devient un coûteux jeu de rattrapage.
Le principe « Question d’abord »
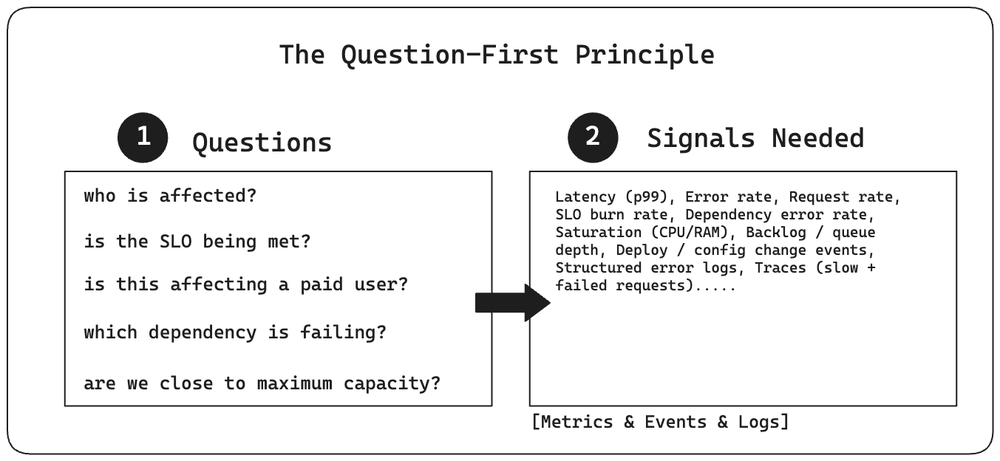
Le principe « Question d’abord » consiste à définir les questions auxquelles vous devez répondre avant de décider quelles données collecter ou afficher. Au lieu de dire « Nous avons ces logs et ces métriques, mettons-les sur un dashboard », demandez-vous : « Quelles décisions devons-nous prendre pendant un incident, et quelles preuves sont nécessaires pour les étayer ? » Cela fait passer l’observabilité de l’accumulation de données à une instrumentation délibérée autour des questions qui comptent le plus.
Sans contexte, les données ne sont que du bruit
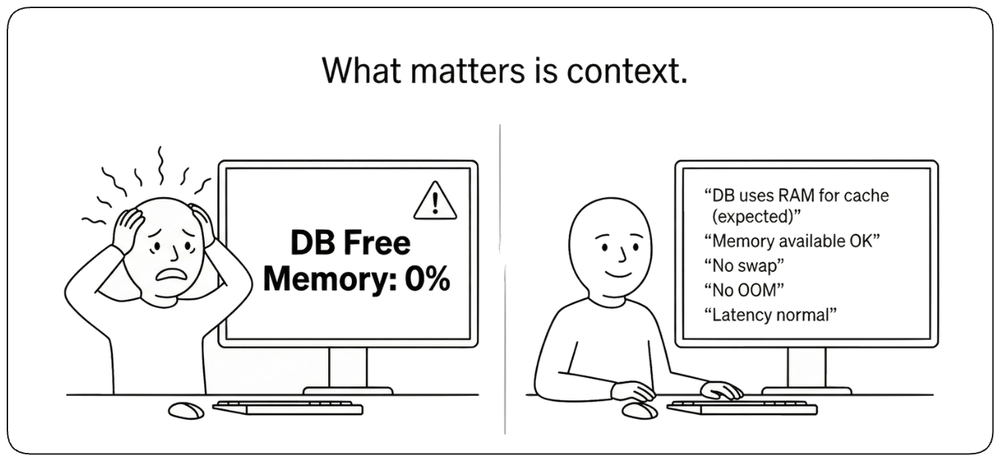
Une donnée brute est du bruit. Le contexte, c’est de la compréhension. Une ligne de log disant « 500 Internal Server Error » ne vous apprend presque rien à elle seule. Y associer des identifiants de corrélation, la version déployée, l’environnement, les dépendances et l’impact utilisateur transforme des signaux isolés en preuves capables d’expliquer ce qui s’est passé.
Savoir qui dépend de vous
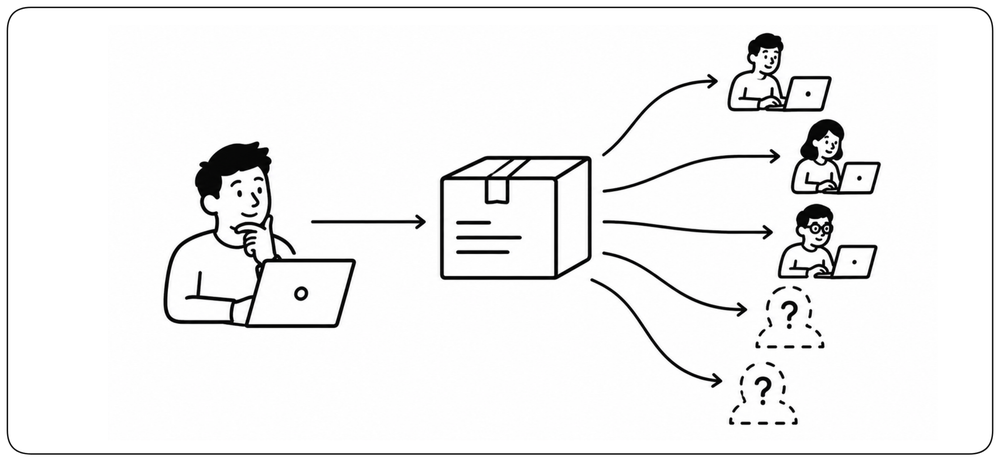
Il arrive qu’un composant ait des utilisateurs inconnus de ses responsables. Qu’il s’agisse d’une API, d’une image Docker, d’une bibliothèque ou d’un service plateforme, ignorer certains consommateurs rend toute évolution risquée. Les cartes de services montrent les flux de requêtes mais ne révèlent pas forcément toutes les équipes qui utilisent un composant. Le suivi des usages, les inventaires de dépendances et l’enregistrement des consommateurs facilitent l’évaluation de l’impact d’un changement. On atteint rarement une visibilité totale, mais il faut assurer la traçabilité des dépendances dans les deux sens : savoir de quoi dépend un composant, et qui dépend de lui. Si l’observabilité permet d’expliquer le comportement d’un système, la visibilité des consommateurs est fondamentale pour anticiper les conséquences d’un changement.
Se concentrer sur le patient, pas sur les moniteurs
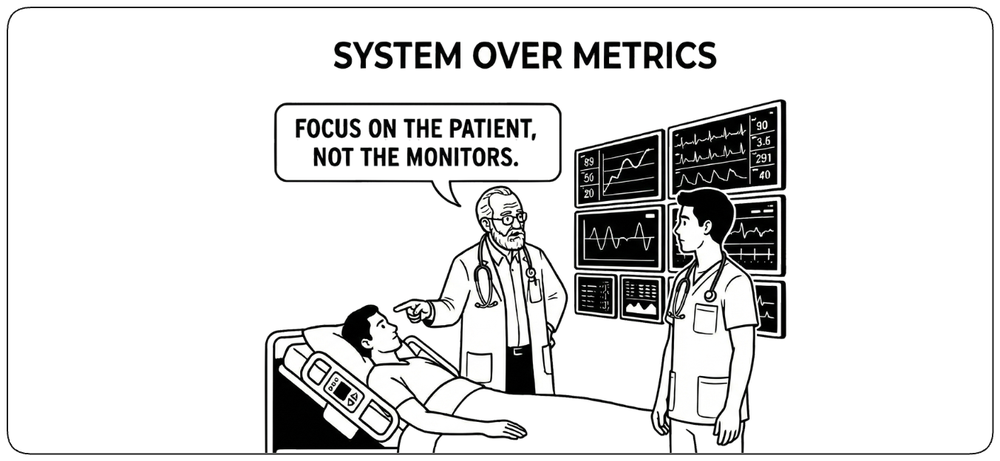
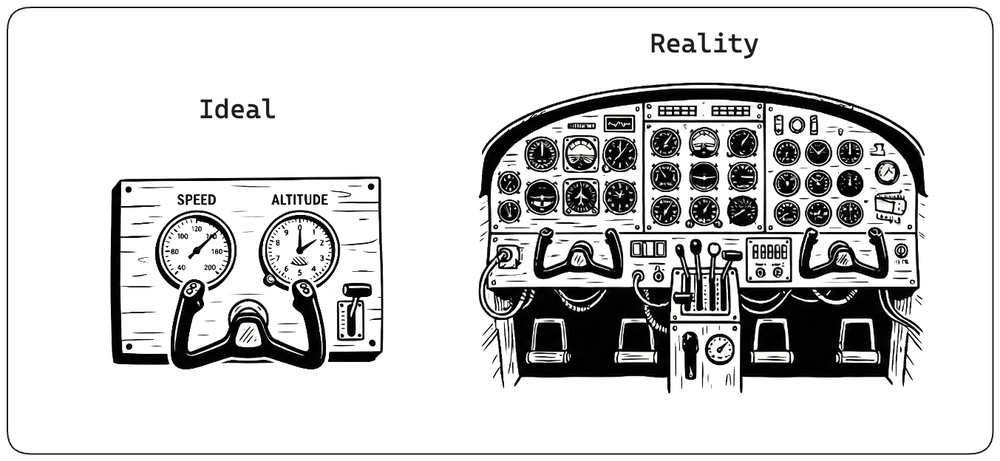
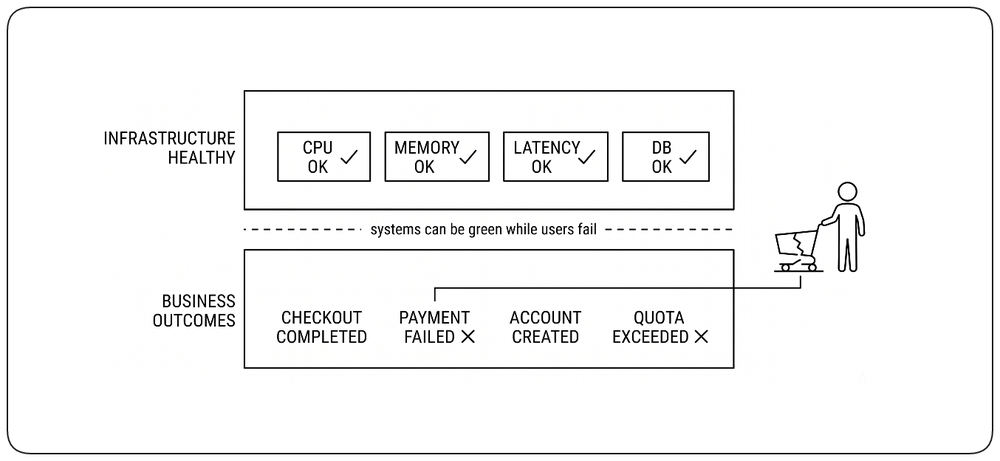
Les métriques peuvent être trompeuses. Un dashboard affichant des chiffres au vert ne garantit pas que les utilisateurs bénéficient réellement d’un système qui fonctionne. La priorité est de comprendre si le système fonctionne correctement pour ses utilisateurs, pas si les métriques ont l’air bonnes. Concentrez-vous sur les résultats côté utilisateur : les requêtes aboutissent-elles ? Les utilisateurs parviennent-ils à atteindre leurs objectifs ? Les workflows critiques sont-ils opérationnels ? Les métriques sont des outils pour répondre à ces questions, pas des objectifs en soi. Quand les métriques et la réalité divergent, faites confiance à la réalité.
On ne peut améliorer que ce qu’on mesure correctement
L’amélioration dépend d’une mesure précise. Les équipes ne peuvent valider un changement, comparer des alternatives ou détecter des régressions que si les mesures reflètent l’expérience réelle des utilisateurs et les contraintes du système. De bonnes métriques font de l’ingénierie une boucle de feedback fondée sur les preuves.
Les quatre signaux d’or : ce que les utilisateurs ressentent vraiment
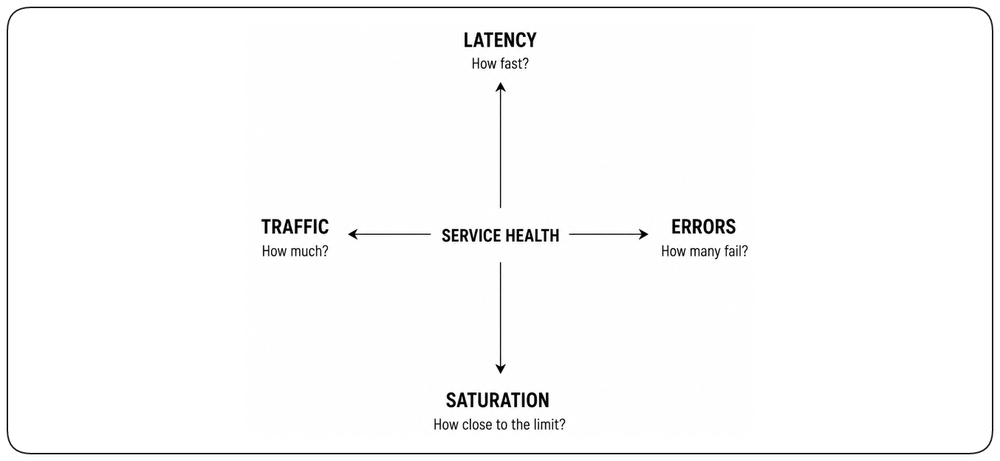
La pratique SRE de Google réduit l’observabilité de tout service orienté utilisateur à quatre signaux : la Latence (le temps que prend une requête), le Trafic (la demande), les Erreurs (combien de requêtes échouent) et la Saturation (à quel point le système est plein). Ces quatre signaux couvrent l’essentiel de l’expérience utilisateur sans noyer les équipes sous les métriques. Ils correspondent naturellement aux Service Level Indicators (SLI) — des grandeurs mesurables sur lesquelles vous vous engagez — et aux Service Level Objectives (SLO) — les valeurs cibles que vous promettez de tenir. Ensemble, ils traduisent la performance technique dans un langage partagé par les ingénieurs, le produit et les utilisateurs.
En savoir plus
Chapitre : Concevoir pour la haute disponibilité — voir « SLI, SLO et SLA ».
Un dashboard doit répondre à une vraie question
Un dashboard existe pour répondre à des questions, pas pour impressionner. Chaque métrique affichée doit correspondre à une décision : l’utilisateur est-il impacté, un composant est-il saturé, quelque chose a-t-il changé. Les dashboards efficaces se concentrent sur des métriques actionnables — taux d’erreur, percentiles de latence, succès des transactions métier, santé des dépendances. Les métriques qui ne conduisent à aucune décision relèvent des logs ou des archives, pas d’un écran partagé.
Chaque dashboard est une occasion d’automatiser
Chaque nouveau dashboard signale un problème qui nécessite l’intervention d’un humain. Chaque fois que c’est possible, investissez dans l’automatisation qui résout le problème avant qu’un humain n’ait à regarder : services auto-réparateurs, auto-scaling, scripts de remédiation automatisés. Les dashboards restent utiles pour comprendre et investiguer, mais l’objectif est de remplacer la surveillance par l’action. Le meilleur dashboard est celui que personne n’a besoin de regarder.
Bénéfices de l’observabilité
Une observabilité efficace améliore la réponse aux incidents, la vitesse de livraison, la scalabilité et la fiabilité en remplaçant les suppositions par des preuves.
Résolution plus rapide des incidents
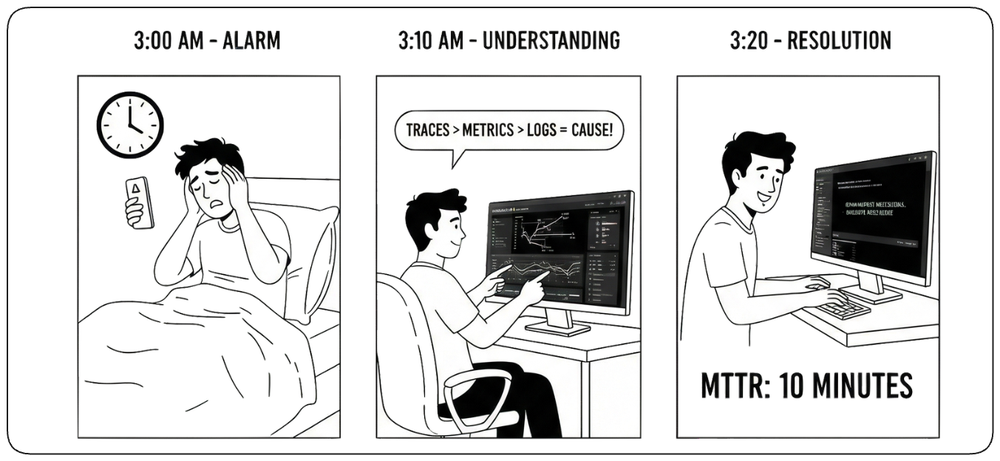
Quand quelque chose casse, l’observabilité remplace les tâtonnements par des preuves. Les traces montrent où les requêtes échouent, les métriques révèlent l’étendue de l’impact, les logs expliquent ce qui s’est passé et le contexte partagé relie les signaux. Au lieu d’essayer des correctifs au hasard ou de redémarrer des services à l’aveugle, les équipes peuvent suivre les preuves jusqu’à la cause la plus probable. Elles peuvent localiser le problème, comprendre qui est affecté et rétablir plus vite — réduisant l’impact utilisateur et le stress opérationnel.
Des changements plus sûrs
L’observabilité rend le changement plus sûr en montrant rapidement ses effets. Si une release augmente les erreurs, la latence ou les parcours utilisateur en échec, les équipes peuvent identifier le changement, mesurer son impact et le rollback ou le corriger en confiance. Cette boucle de feedback permet une livraison plus rapide, des déploiements plus fréquents et de l’expérimentation sans faire de chaque changement un risque aveugle.
Une montée en charge en confiance
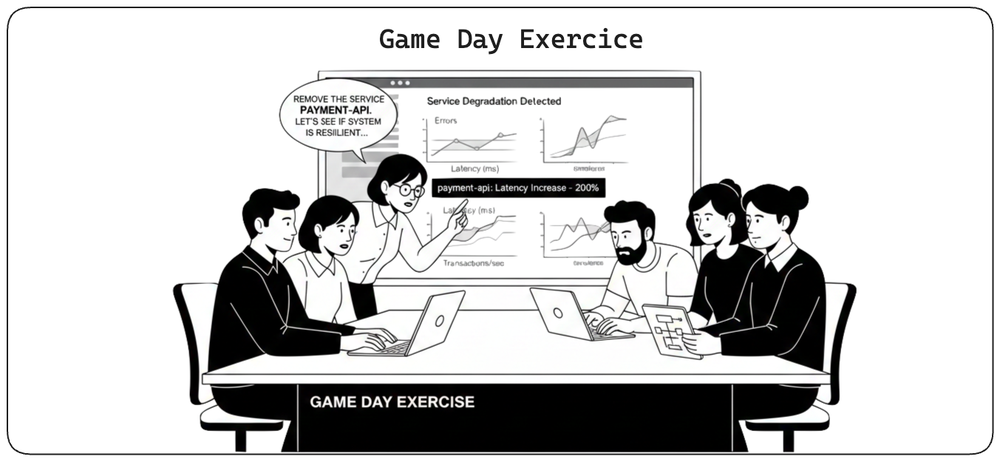
Le scaling est risqué quand le goulot d’étranglement est inconnu. L’observabilité révèle où la latence s’accumule, ce qui sature en premier et quelle dépendance limite le débit, de sorte que les équipes font évoluer la vraie contrainte au lieu d’ajouter de la capacité à l’aveugle. Cela réduit le surdimensionnement, maîtrise les coûts et transforme le scaling en une décision ciblée plutôt qu’en pari.
Plus de fiabilité sans héroïsme
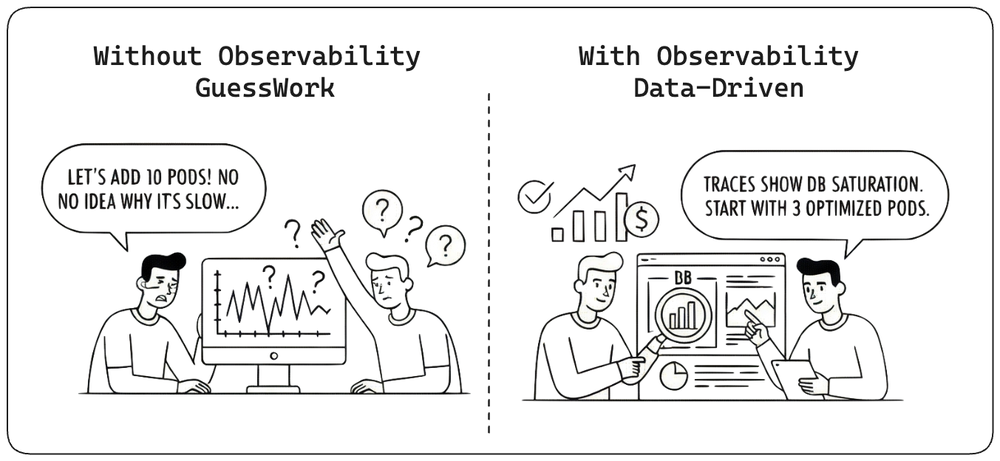
Sans observabilité, la fiabilité dépend de quelques experts qui déboguent sous pression. Avec des signaux clairs, des procédures documentées et une connaissance opérationnelle partagée, le diagnostic devient reproductible et les équipes peuvent réagir efficacement même quand ces experts sont indisponibles. La fiabilité doit progresser grâce au processus et à l’apprentissage, pas à l’héroïsme.
Les quatre piliers de l’observabilité
L’observabilité repose, dans ce chapitre, sur quatre signaux complémentaires : les métriques, les traces, les logs et les événements. Chacun répond à une classe de questions différente — les symptômes, où, pourquoi et ce qui a changé.
Métriques : mesures quantitatives du système
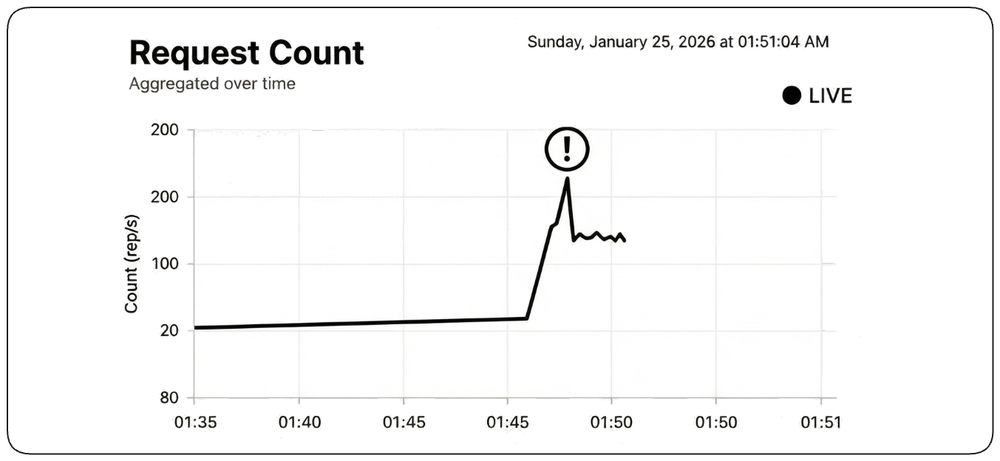
Les métriques sont des nombres agrégés dans le temps (taux, latence, saturation). Elles sont idéales pour repérer des tendances et détecter une dérive par rapport à la normale. Les métriques expliquent rarement le « pourquoi » à elles seules, mais elles montrent de façon fiable par où commencer à chercher.
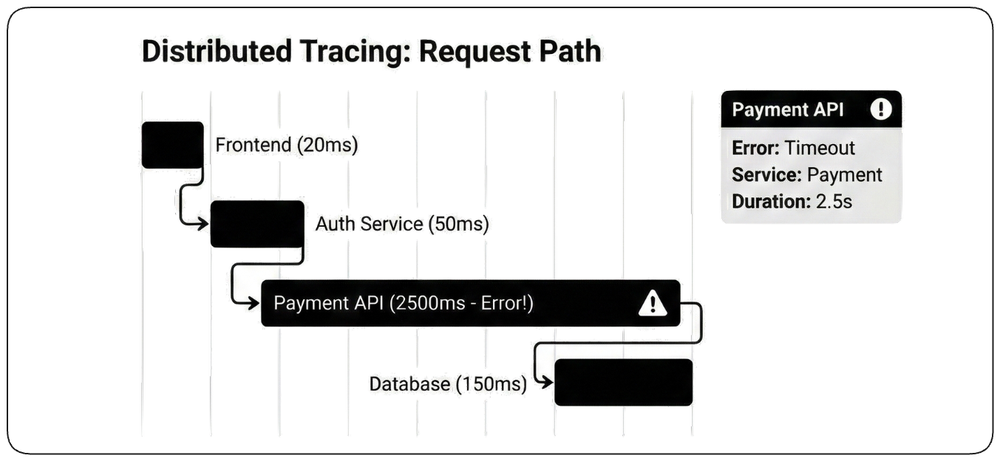
Tracing : suivre les requêtes dans les systèmes distribués
Le tracing répond à « où est passé le temps ? » et « où ça a échoué ? » en montrant le chemin d’une requête à travers les services. Dans les systèmes distribués, c’est souvent le moyen le plus rapide d’identifier le saut précis qui a introduit de la latence ou des erreurs.
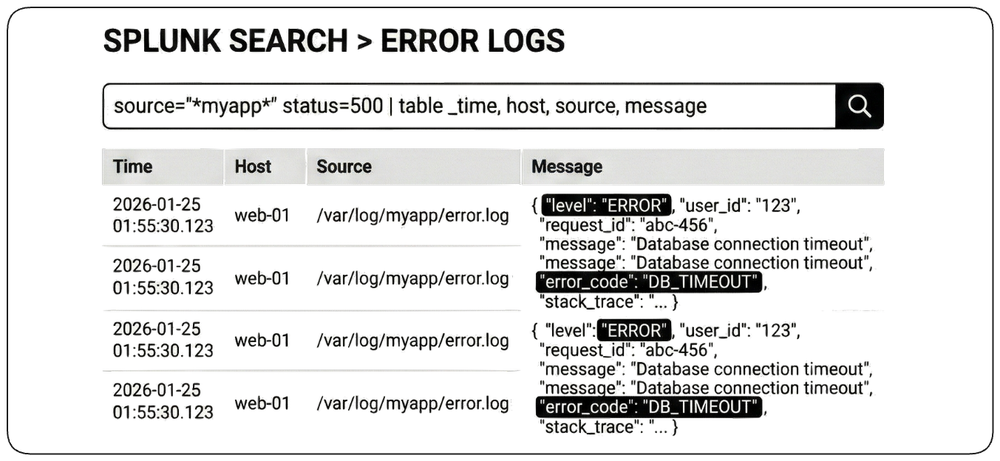
Logging : enregistrements détaillés d’événements
Les logs fournissent le récit : ce qui s’est passé, avec assez de détails pour expliquer les défaillances. L’objectif n’est pas le volume mais la clarté — des enregistrements structurés et interrogeables, corrélables avec les traces et les déploiements.
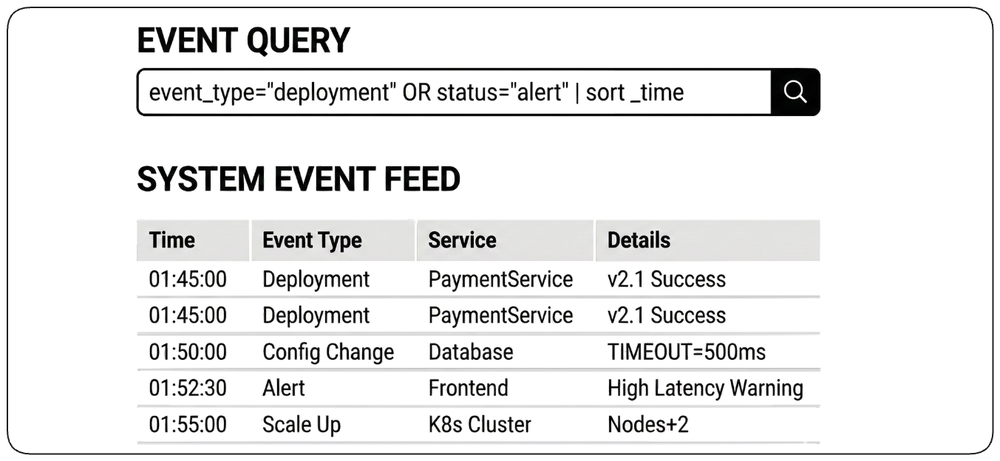
Événements : changements d’état significatifs
Les événements capturent des changements d’état significatifs tels que des déploiements, des mises à jour de configuration, des changements de feature flags ou des jalons de workflow. Contrairement aux logs, ils servent d’ancres temporelles structurées qui aident les équipes à relier le comportement du système à ce qui a changé. Voir « Chaque changement laisse une preuve » plus loin dans ce chapitre pour comprendre pourquoi ce signal mérite sa propre discipline.
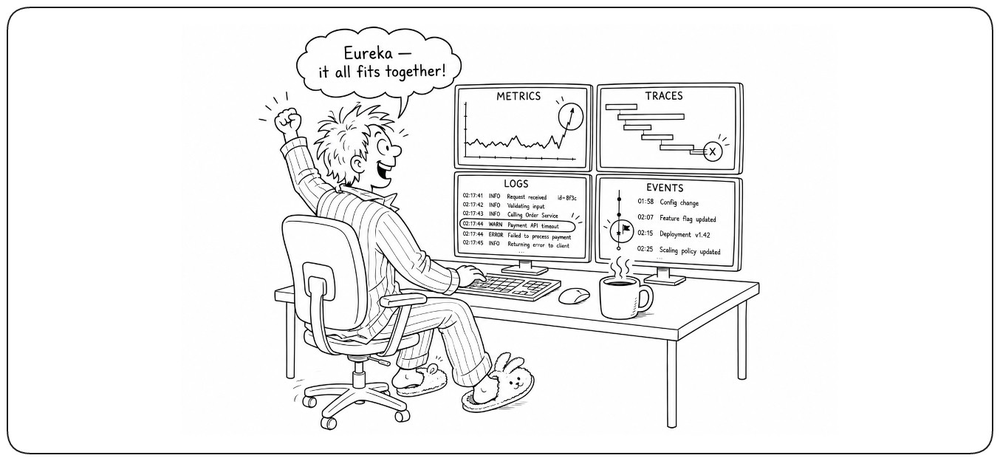
Comment les piliers fonctionnent ensemble
Les investigations commencent souvent par des métriques qui révèlent un symptôme, des traces qui le localisent, des logs qui l’expliquent et des événements qui montrent ce qui a changé. L’ordre peut varier, mais la valeur vient de la corrélation des signaux plutôt que de l’examen de chacun isolément.
Application Performance Management (APM)
L’Application Performance Management relie l’expérience utilisateur au comportement du système. Il montre comment les requêtes circulent dans le système, où le temps est passé et quel composant cause une erreur ou un ralentissement. Il transforme une plainte vague comme « l’application est lente » en une cause technique concrète.
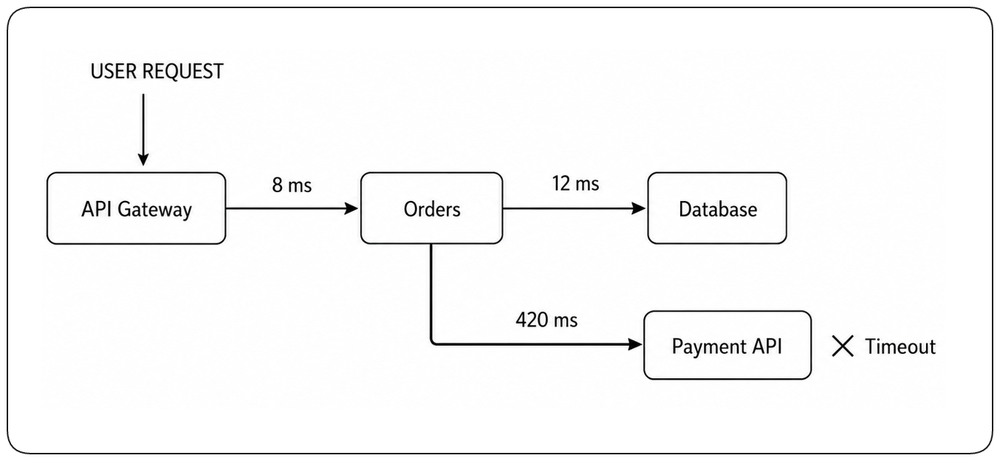
Transaction tracing : suivre les requêtes de bout en bout
Le transaction tracing suit une requête depuis l’action de l’utilisateur jusqu’à la réponse finale, en enregistrant chaque service, dépendance et étape de traitement en chemin. Les données de timing révèlent où la latence s’accumule, que ce soit dans le code applicatif, une requête de base de données, une API externe ou une file d’attente. Au lieu de deviner pourquoi un système est lent, les équipes peuvent identifier le composant exact responsable et agir sur des preuves concrètes.
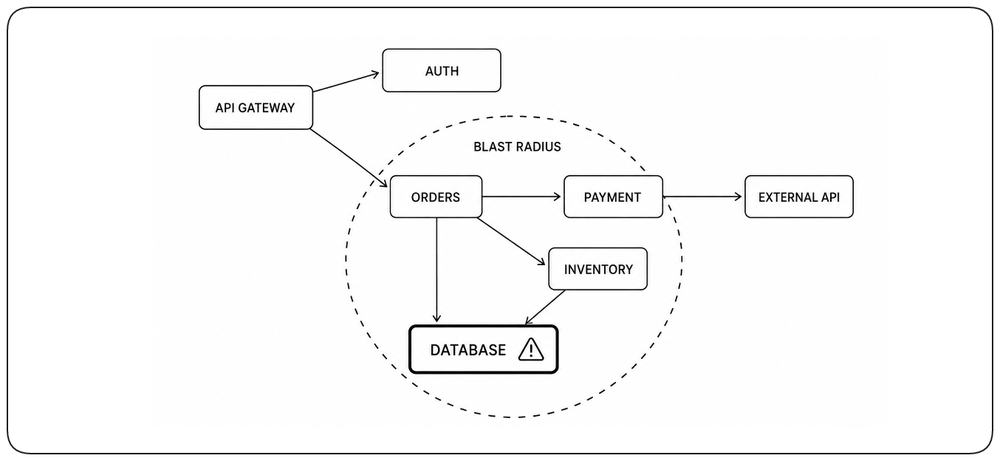
Cartes de services et visualisation des dépendances
Les cartes de services rendent les dépendances du système visibles : quels services s’appellent entre eux, où circule le trafic et comment les défaillances se propagent. Pendant un incident, elles révèlent rapidement le blast radius, en montrant quels composants et parcours utilisateur dépendent du service défaillant. Cela aide les équipes à comprendre l’impact, à identifier les chemins de propagation probables et à prioriser la réponse.
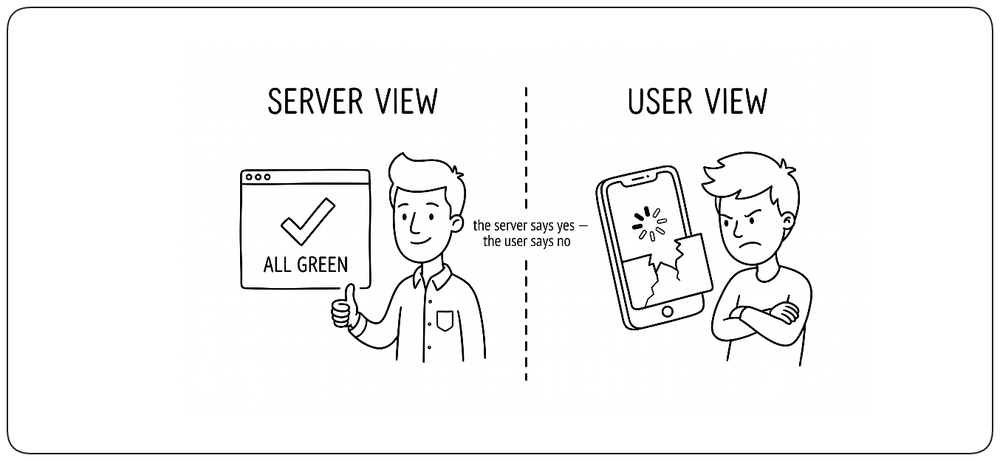
Real User Monitoring (RUM) : mesurer du point de vue de l’utilisateur
Les métriques côté serveur peuvent être au vert alors que les utilisateurs subissent une application cassée. Le Real User Monitoring capture la performance depuis le navigateur ou l’appareil réel de l’utilisateur : temps de chargement des pages, erreurs JavaScript, latence réseau et délais d’interaction. Le RUM révèle des problèmes que les métriques serveur manquent : rendu côté client lent, appels d’API échoués depuis le navigateur, problèmes réseau régionaux ou problèmes spécifiques à un appareil. Il répond à la question qui compte le plus : « Qu’est-ce que l’utilisateur vit réellement en ce moment ? »
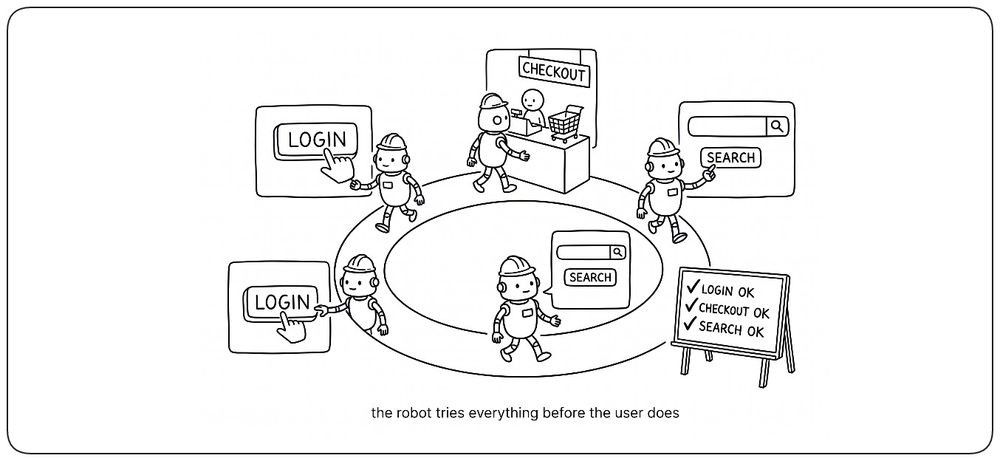
Synthetic monitoring : détection proactive
Le synthetic monitoring exécute en continu des tests automatisés contre le système — simulant des parcours utilisateur, vérifiant des endpoints de santé et validant les chemins critiques avant que les utilisateurs ne rencontrent des problèmes. Contrairement au RUM, qui rapporte ce qui s’est passé, le synthetic monitoring détecte les problèmes de façon proactive. Les vérifications synthétiques courantes incluent les parcours de connexion, les processus de checkout, les endpoints de santé d’API et les transactions métier critiques. Quand une vérification synthétique échoue, les équipes savent immédiatement que quelque chose est cassé — souvent avant qu’un utilisateur ne le signale. La réponse aux incidents passe ainsi du réactif au proactif.
Traduire la performance technique en expérience utilisateur
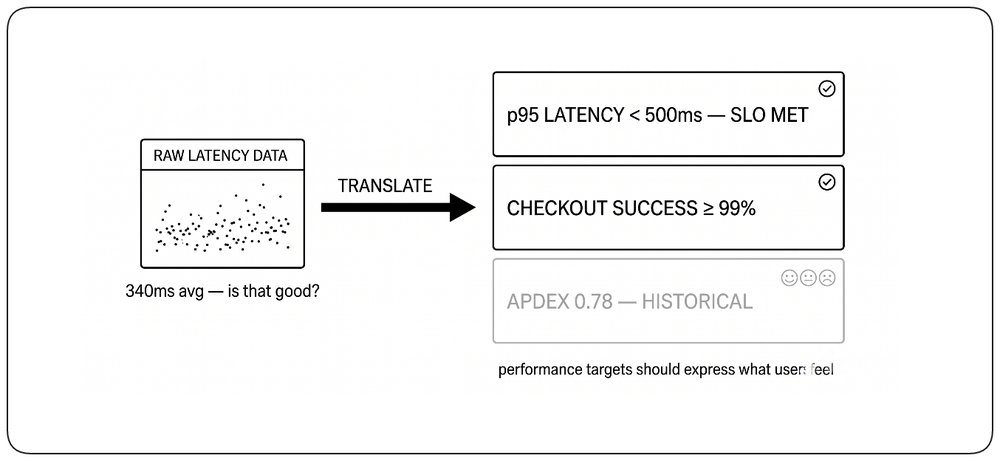
Les chiffres bruts de latence sont difficiles à interpréter — 200 ms, est-ce bon ou mauvais ? Un APM efficace traduit les mesures techniques en indicateurs que toute l’organisation peut comprendre. Les équipes modernes s’appuient sur les percentiles de latence (p95, p99), des SLI et SLO liés aux parcours utilisateur, et des error budgets. L’Apdex a historiquement proposé une première version de cette idée en classant les réponses en Satisfaisantes, Tolérables ou Frustrantes. La formule exacte compte moins que le principe : les objectifs de performance doivent exprimer ce que ressentent les utilisateurs, pas seulement ce que fait le système.
Observer le business, pas seulement les systèmes
La télémétrie technique explique comment le système se comporte ; la télémétrie business explique s’il apporte de la valeur. Checkout terminé, paiement échoué, compte créé, quota dépassé — ces événements sont des signaux d’observabilité à part entière, pas des données d’analytics. Cartographier les parcours utilisateur critiques — connexion, recherche, checkout, paiement — et les suivre comme des entités de premier ordre est ce qui transforme les métriques techniques en contexte business : un ralentissement de 100 ms sur le checkout compte plus que le même ralentissement sur un dashboard d’administration, et « le succès du checkout a chuté de 5 % après le dernier déploiement » est un signal plus net que « le taux d’erreur a augmenté ». Une infrastructure saine ne signifie rien si ces parcours échouent en silence.
Découper avant de deviner
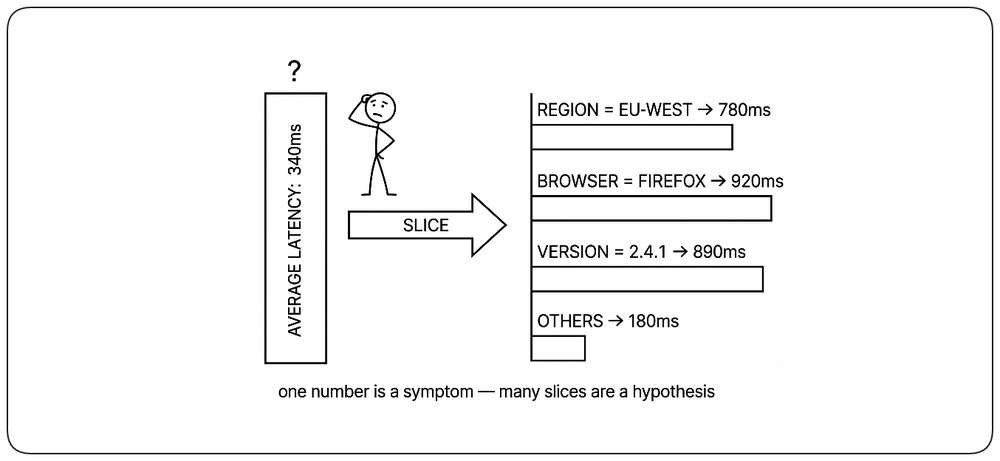
Une moyenne unique cache plus qu’elle ne révèle. Un APM moderne répond à des questions comme « le checkout est lent » en découpant la performance selon des dimensions : version, région, segment de clientèle, navigateur, appareil, endpoint, feature flag, déploiement. Chaque mesure doit être filtrable, afin que les équipes passent en quelques secondes de « quelque chose est lent » à « le checkout est lent pour les utilisateurs de Firefox en EU-West sur la version 2.4.1 depuis le dernier déploiement ». Les dimensions à forte cardinalité transforment un symptôme en hypothèse.
Observabilité de plateforme : en faire le comportement par défaut
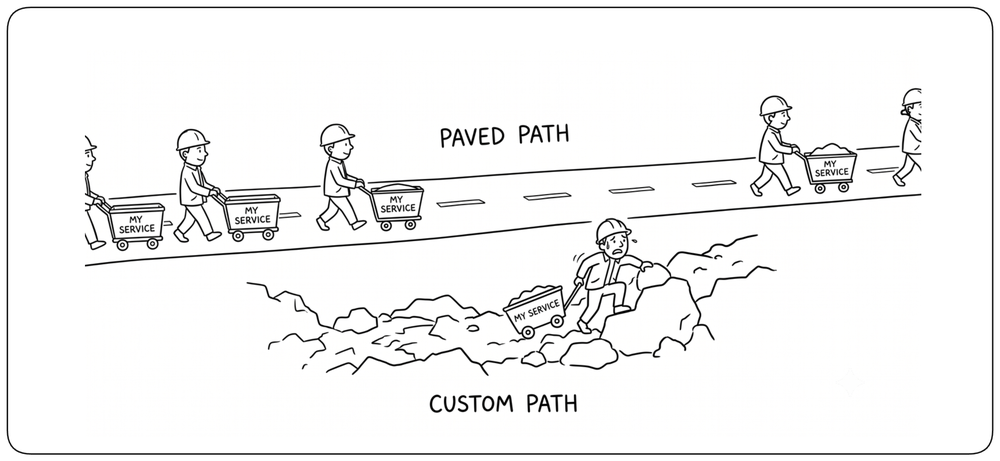
Dans les organisations matures, l’observabilité ne peut pas être un « choix équipe par équipe ». Si chaque service invente ses propres dashboards, conventions de nommage et schémas d’instrumentation, le résultat est de la fragmentation, une réponse lente aux incidents et une fiabilité inégale. L’observabilité de plateforme signifie que la plateforme rend les services observables par défaut. Les développeurs doivent obtenir une visibilité de niveau production dès le premier déploiement, sans avoir besoin d’une expertise poussée des outils de télémétrie. Pensez-y comme à une route pavée : les équipes peuvent toujours construire du sur-mesure, mais le chemin par défaut est sûr, cohérent et rapide.
L’observabilité est un produit, pas un outil
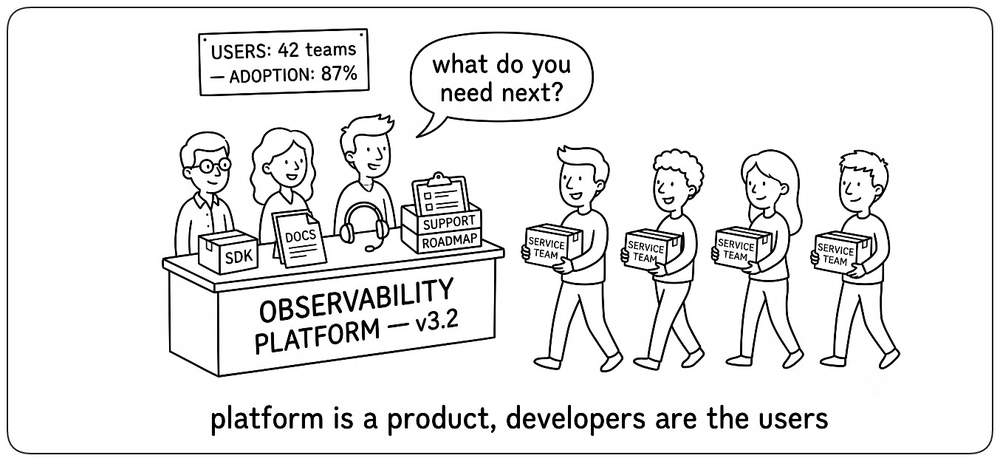
Les organisations matures traitent l’observabilité comme un produit interne, pas comme un ensemble d’outils. L’équipe plateforme a de vrais utilisateurs — développeurs, SRE, ingénieurs d’astreinte — et possède les SDK, la documentation, l’onboarding, le support, les conventions et une roadmap. L’adoption est mesurée. Le feedback alimente la prochaine release. Comme tout produit réussi, l’observabilité doit être facile à adopter, fiable, bien documentée et améliorée en continu selon ce dont ses utilisateurs ont réellement besoin.
Séparer l’instrumentation du backend
Les applications doivent produire une télémétrie standard sans dépendre d’un fournisseur d’observabilité spécifique. L’instrumentation appartient à l’application — quoi émettre, sous quelle forme, avec quels identifiants. Le stockage, la visualisation et l’analyse relèvent de la plateforme et doivent être interchangeables. Cette séparation permet aux organisations de changer de backend, d’en ajouter un second ou de router différents signaux vers différentes destinations sans toucher à une seule ligne de code applicatif.
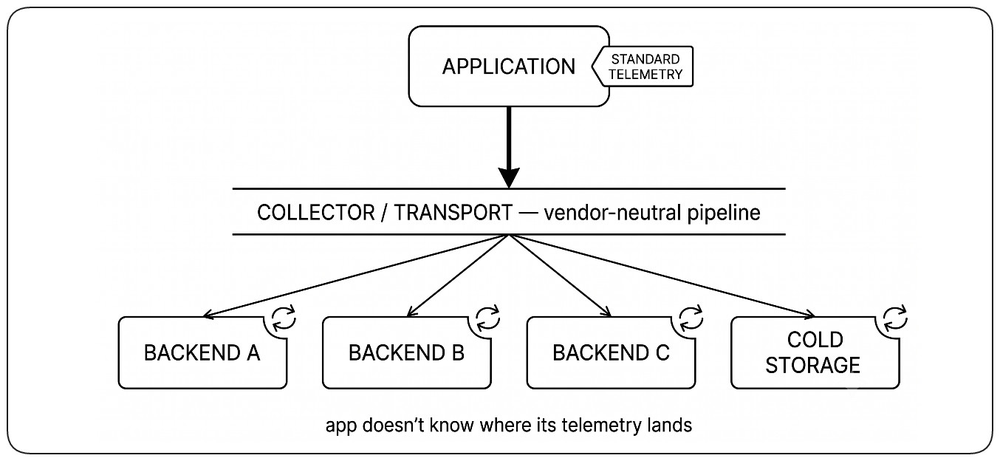
Télémétrie automatique
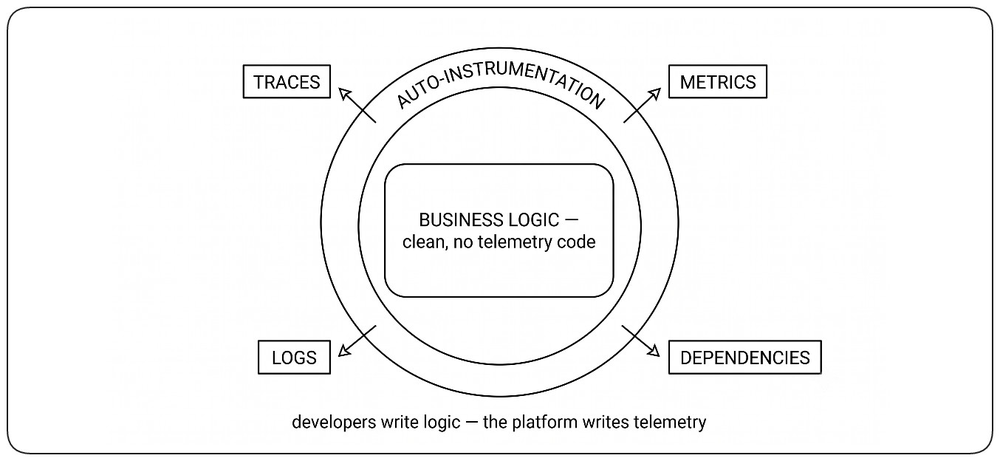
Les développeurs ne devraient pas avoir à penser à rendre leurs services observables. La plateforme doit capturer automatiquement les signaux essentiels de chaque workload — métriques, traces, logs et appels de dépendances — ainsi que le contexte opérationnel standard : nom du service, version, environnement, région, identifiants de requête et de trace. Les équipes se concentrent sur la logique métier pendant que la plateforme capture les preuves nécessaires pour l’exploiter.
La cohérence permet la compréhension
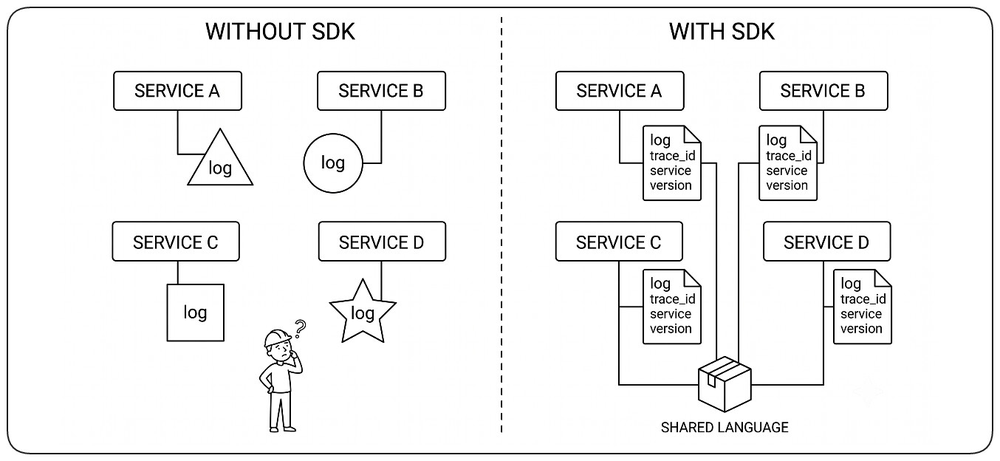
L’observabilité ne fonctionne que si chaque service suit le même vocabulaire. SDK partagés, schémas communs, nommage cohérent, propagation des traces et identifiants standardisés permettent à la télémétrie de services indépendants de s’assembler naturellement. La cohérence est ce qui transforme des signaux isolés en une image cohérente du système, et ce qui rend possible l’investigation inter-services.
Un seul plan d’investigation
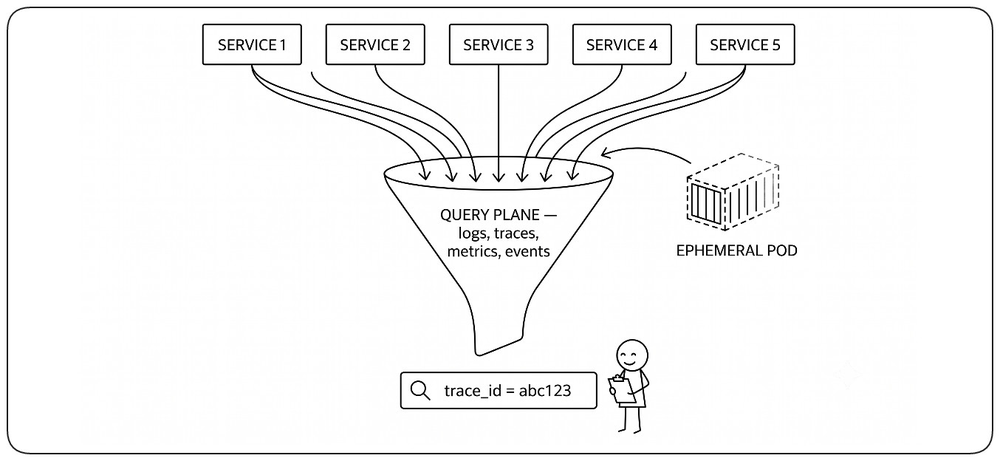
Les ingénieurs doivent investiguer les incidents, pas chasser les données. Logs, métriques, traces et événements doivent arriver dans une plateforme unique et interrogeable où ils peuvent être corrélés immédiatement. La centralisation survit à une infrastructure éphémère, applique les règles de rétention et d’accès, et fait de l’investigation un workflow continu plutôt qu’une chasse aux outils.
Prêt pour la production dès le premier jour
Quand le premier déploiement en production est terminé, les ingénieurs doivent déjà disposer de tout ce qu’il faut pour opérer le service : dashboards, alertes, historique de déploiement, santé des dépendances et points d’entrée d’investigation. Les runbooks relient les symptômes aux actions, pour que les ingénieurs réagissent calmement sous pression. Les équipes ne devraient jamais démarrer en production avec une boîte à outils opérationnelle vide.
Chaque changement laisse une preuve
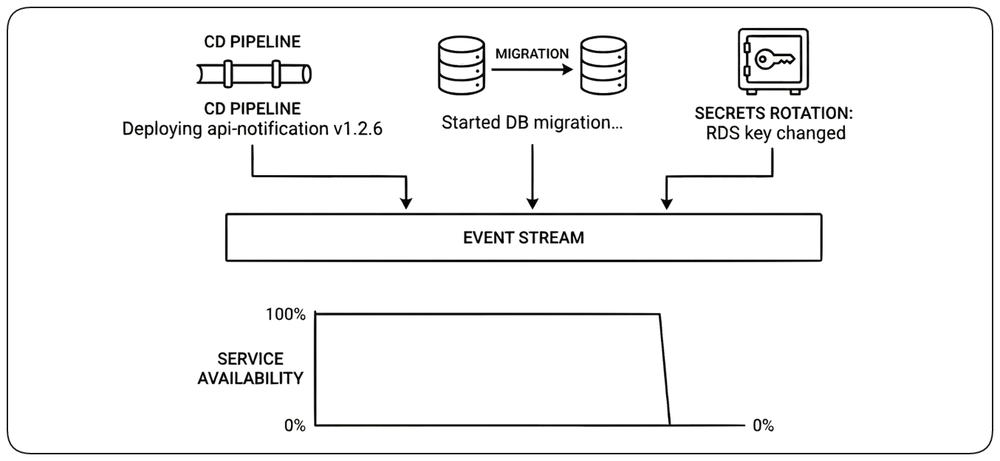
La plupart des incidents de production commencent par un changement — un déploiement, une mise à jour de configuration, un feature flag, une rotation de secret, un événement de scaling ou une mise à niveau de dépendance. Ces changements doivent être capturés automatiquement sous forme d’événements structurés et intégrés à la plateforme d’observabilité. Quand les ingénieurs demandent « qu’est-ce qui a changé ? », la réponse doit venir de preuves, pas de la mémoire.
En savoir plus
Chapitre : Concevoir pour la résilience — voir « Quand les défaillances surviennent-elles ? »
Expérience développeur sur la voie pavée
Les équipes ne devraient pas avoir à décider comment construire l’observabilité. La plateforme fournit les bibliothèques, templates, conventions et outils qui font d’une bonne observabilité le comportement par défaut. Faire la bonne chose ne devrait demander aucune décision, et les équipes restent libres de personnaliser lorsque leurs besoins dépassent le défaut.
L’échantillonnage est une décision de conception
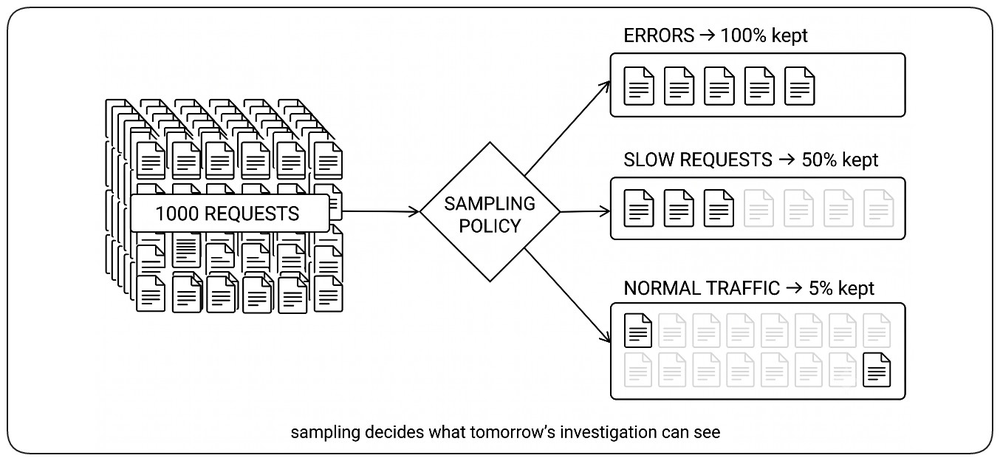
Collecter tous les signaux est rarement réaliste, et l’échantillonnage n’est pas une astuce d’économie appliquée après coup. C’est une décision de conception qui détermine ce qui pourra être investigué plus tard. L’échantillonnage détermine quels incidents pourront être reconstitués, quels schémas seront visibles et quelles anomalies resteront cachées. Un bon échantillonnage préserve les preuves nécessaires pour expliquer les défaillances — traces complètes sur les erreurs, capture plus riche sur les chemins lents — tout en éclaircissant le trafic de routine qui ajoute du volume sans apporter de compréhension.
Toute la télémétrie n’a pas la même valeur
Une télémétrie différente mérite un traitement différent. Les erreurs, les événements de sécurité et les transactions impactant les clients justifient souvent une collecte complète et une longue rétention. Le trafic de routine réussi peut être échantillonné de façon agressive. Le détail de niveau debug peut n’être conservé que quelques jours. Traiter tous les signaux de la même façon gaspille du budget sur des données de faible valeur et prive les catégories où les preuves comptent le plus. La hiérarchisation par valeur rend le compromis explicite : ce qui est précieux, ce qui est sacrifiable, et pour combien de temps.
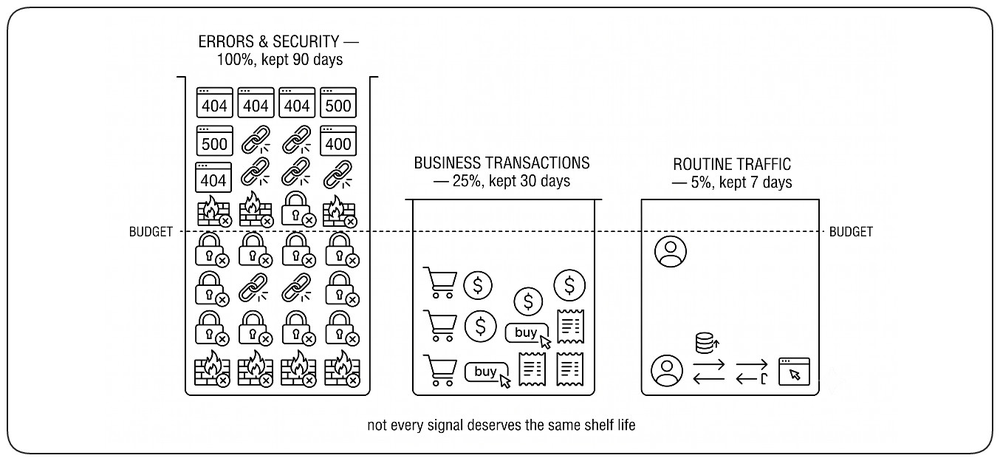
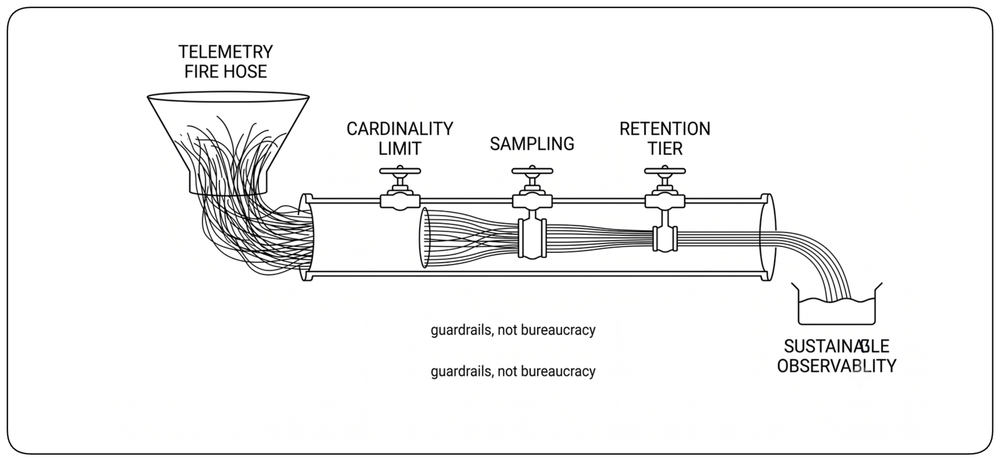
L’observabilité a une économie
L’observabilité n’est pas gratuite. Chaque label de métrique, trace, log et décision de rétention a un coût qui croît avec l’échelle. Les plateformes durables maîtrisent la télémétrie grâce à trois leviers : la cardinalité, l’échantillonnage et la rétention. Une bonne gouvernance fournit les valeurs par défaut qui gardent la visibilité abordable sans sacrifier la valeur d’investigation.
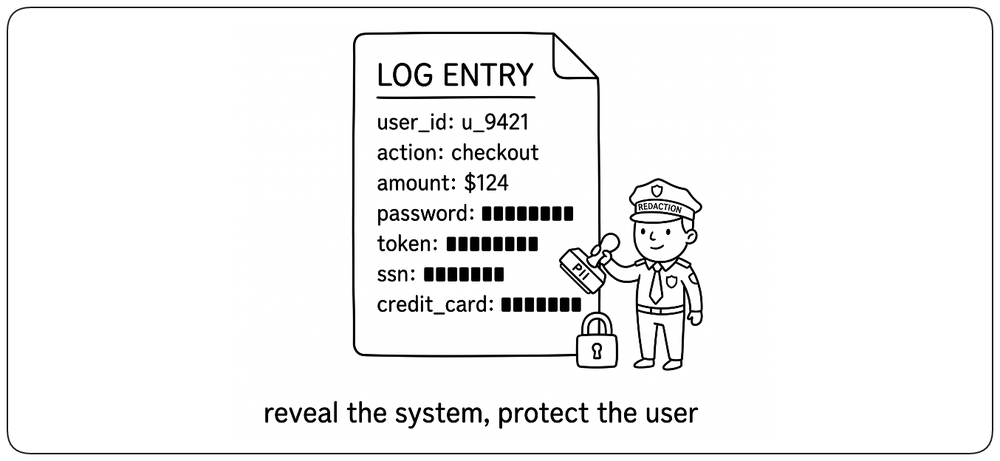
L’observabilité ne doit pas divulguer de données sensibles
L’observabilité augmente la visibilité — ce qui la rend précisément dangereuse quand elle est manipulée avec négligence. Les secrets, identifiants, données personnelles, tokens et informations réglementées ne doivent jamais apparaître dans les logs ou les traces sans protection explicite. Un contexte riche et la minimisation des données ne sont pas opposés : les plateformes efficaces masquent à la source, classifient les champs par sensibilité, appliquent des contrôles d’accès sur la télémétrie stockée et traitent chaque ligne de log comme potentiellement auditable. La plateforme qui en révèle le plus sur le système doit en révéler le moins sur ses utilisateurs.
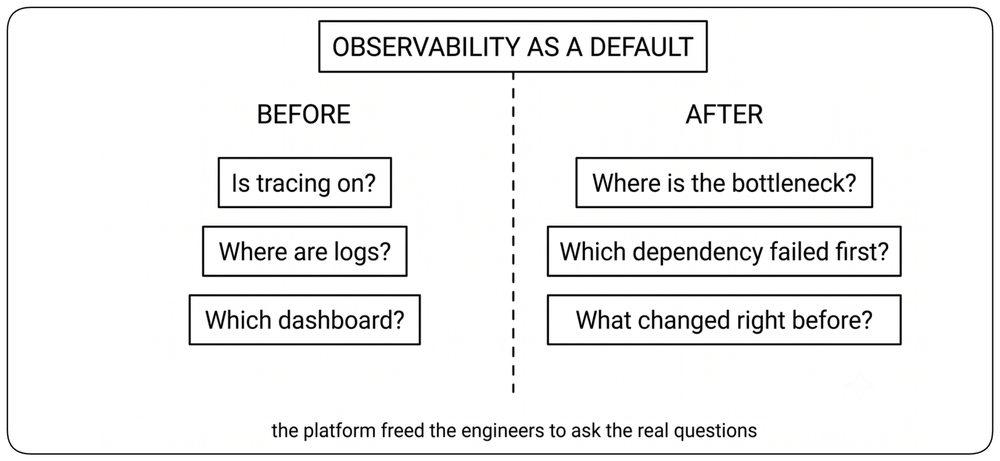
L’observabilité devient une propriété de l’organisation
Quand la plateforme prend en charge l’observabilité, les équipes cessent de se demander si la télémétrie existe ou où la trouver. Elles investiguent immédiatement l’impact utilisateur, identifient les goulots d’étranglement, corrèlent les changements et résolvent les incidents à partir de preuves plutôt que d’intuition. L’observabilité n’est plus quelque chose que chaque équipe construit — elle devient une infrastructure dont toutes les équipes héritent.
Rendre les erreurs visibles
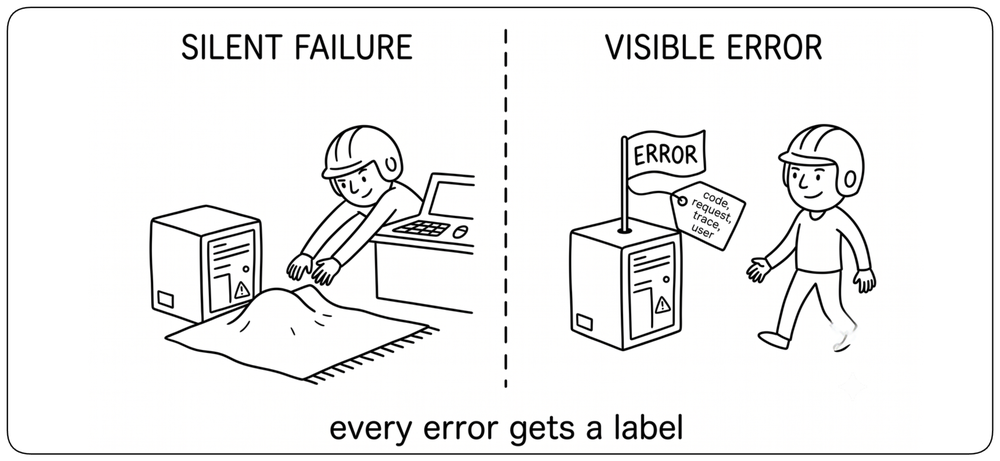
Les erreurs sont inévitables ; les erreurs invisibles sont inacceptables. Une gestion d’erreurs efficace dans les systèmes observables va au-delà de l’interception et du logging — elle garantit que chaque défaillance devient un signal visible, contextualisé et actionnable. Sans une conception adéquate de la gestion d’erreurs, les équipes perdent du temps à courir après les symptômes plutôt que les causes.
Chaque erreur est une preuve
Une erreur n’est pas seulement le signal que quelque chose a échoué — c’est une preuve qui doit expliquer ce qui s’est passé, où et pourquoi. Les erreurs avalées, masquées ou loggées sans contexte deviennent des angles morts. Un système conçu pour l’observabilité fait remonter les erreurs explicitement : elles se propagent avec assez de contexte pour être corrélées avec la requête, l’utilisateur et le déploiement, et pour guider la prochaine action. Chaque chemin d’erreur doit préserver assez de contexte structuré pour devenir une preuve exploitable.
Contexte d’erreur structuré
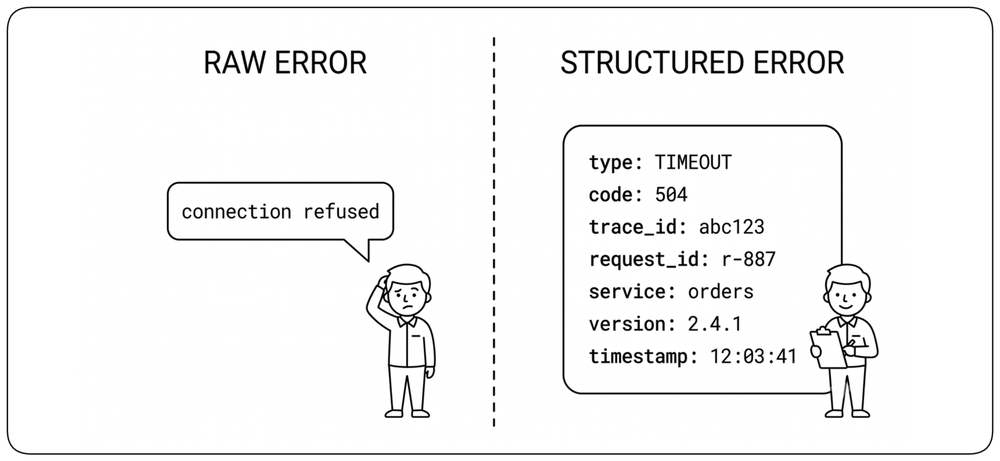
Des messages bruts comme « connection refused » ou « timeout » ne suffisent pas pour le diagnostic. Les erreurs doivent inclure l’opération échouée, la dépendance, l’état des retries, les identifiants de corrélation, l’horodatage et les métadonnées de service pertinentes. Cette structure transforme une défaillance générique en preuve qui peut être recherchée, regroupée et corrélée à travers les logs, les traces et les métriques.
Contrats d’erreur standard
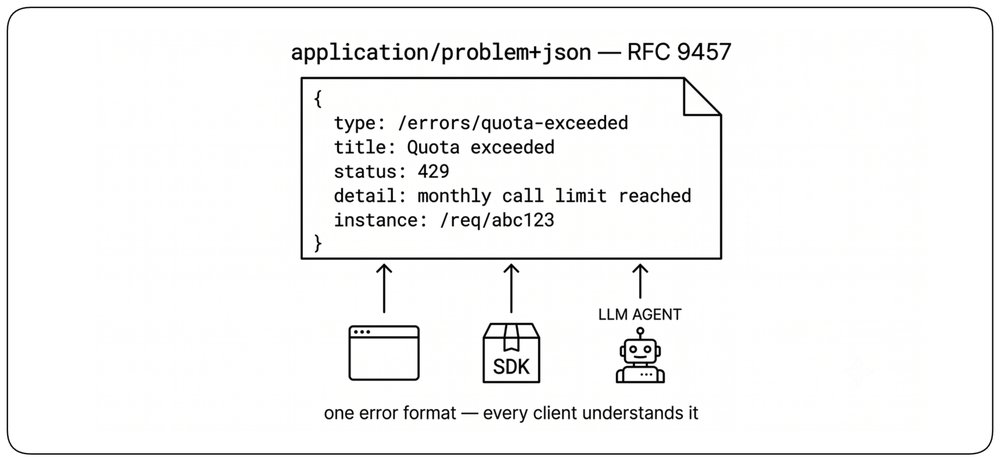
Les erreurs font partie de la surface de l’API, et leur forme fait partie du contrat. Quand chaque service invente son propre format d’erreur, les clients et les outils d’observabilité passent plus de temps à parser qu’à réagir. Un contrat d’erreur standard — champs stables, type lisible par machine, message lisible par un humain, identifiant de trace — fait des erreurs des citoyens de premier ordre que les SDK, dashboards et agents IA peuvent interpréter sans code spécifique.
RFC 9457 — un contrat prêt à l’emploi
La RFC 9457 définit application/problem+json avec un ensemble partagé de champs (type, title, status, detail, instance) et de la place pour des extensions métier. L’adopter — ou adopter un standard interne similaire — supprime toute une classe de bugs de parsing et rend les erreurs interopérables entre équipes, outils et langages.
Retourner un trace ID avec chaque erreur
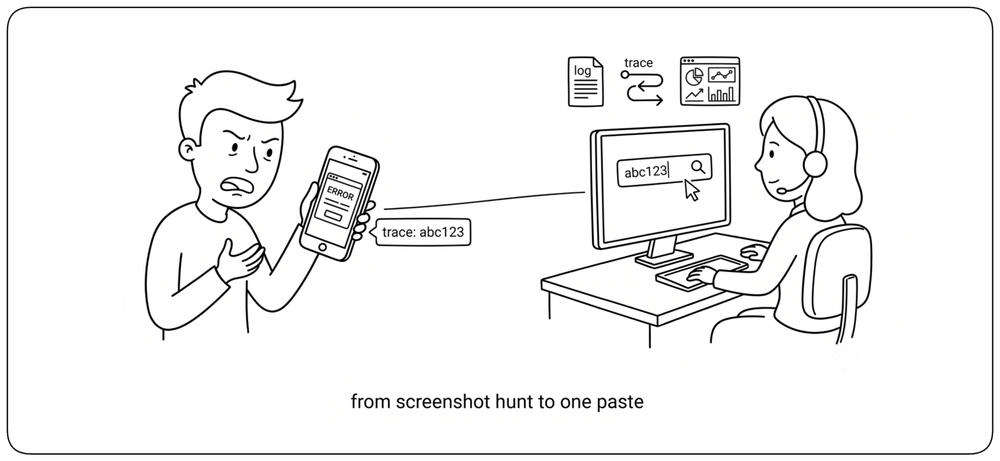
Chaque réponse d’erreur doit retourner un identifiant de trace dans le corps ou les headers. Cet identifiant relie la défaillance visible par l’utilisateur aux logs, traces et métriques internes collectés par la plateforme d’observabilité. Au lieu de demander des captures d’écran, des horodatages et des détails sur l’utilisateur, le support peut rechercher le trace ID et voir immédiatement ce qui a échoué, où et pourquoi. Un trace ID transforme un incident signalé d’une investigation manuelle en une simple recherche directe.
Regrouper les erreurs par cause, pas par message
Le suivi des erreurs doit regrouper les défaillances par leur cause probable, pas seulement par texte de message identique. Un même défaut peut produire des messages différents, tandis que des messages identiques peuvent provenir de causes sans rapport. Un bon regroupement combine type d’erreur, emplacement dans la stack, service, opération et contexte environnant pour transformer des milliers d’occurrences en un petit nombre de problèmes actionnables.
Classification des erreurs pour l’actionnabilité
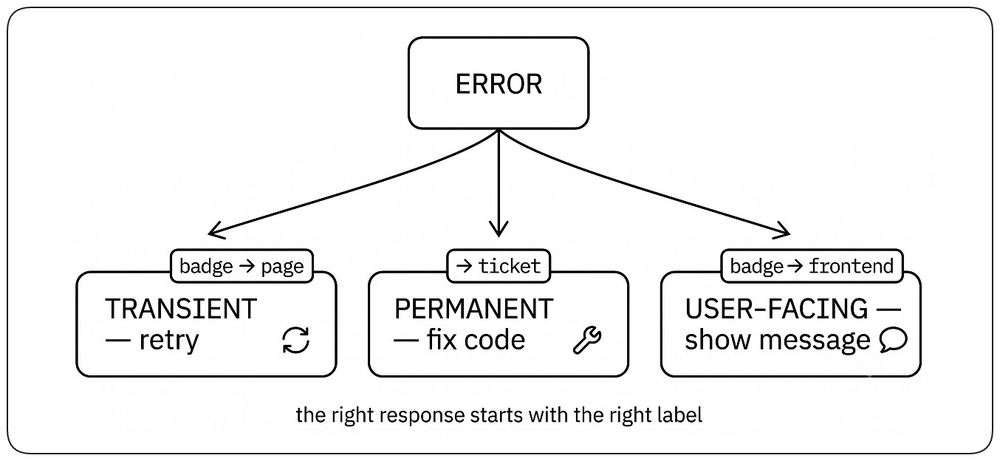
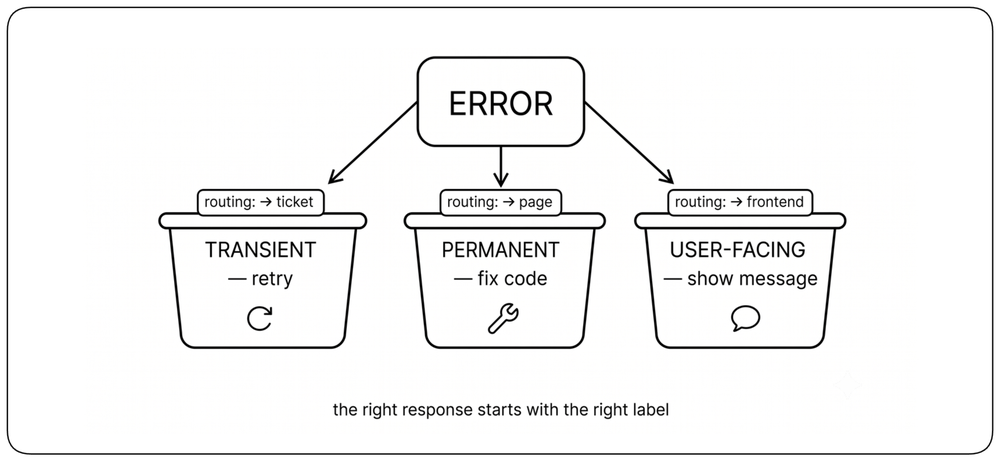
La classification des erreurs détermine la réponse appropriée. Les dimensions utiles incluent le caractère transitoire ou permanent d’une défaillance, son caractère réessayable ou fatal, et son caractère visible par l’utilisateur ou interne. Une classification cohérente aide les systèmes, les opérateurs et les appelants automatisés à décider de ce qui doit se passer ensuite.
4xx vs 5xx : distinguer la responsabilité du client de la défaillance de l’infrastructure
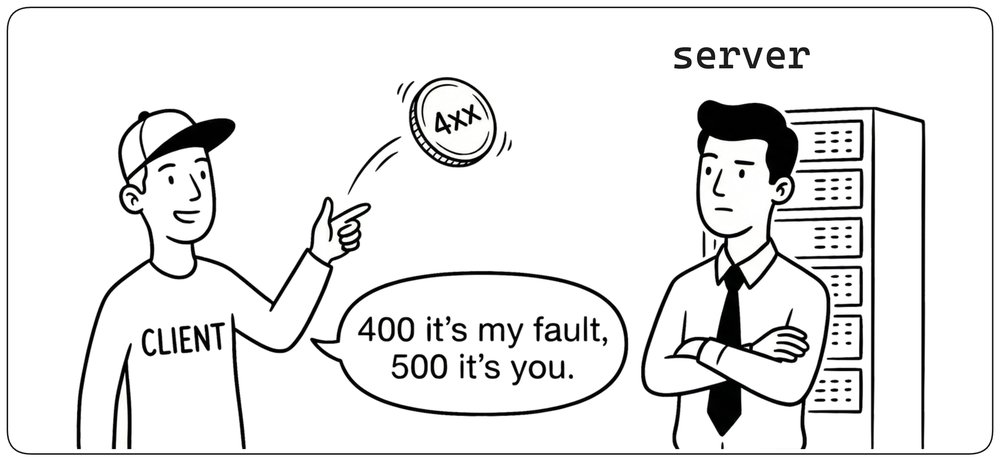
Les classes de statut HTTP doivent refléter qui est responsable de la défaillance. 4xx signifie que la requête est invalide ou ne peut pas être satisfaite telle que soumise : le client doit changer quelque chose. 5xx signifie qu’une requête valide a échoué à cause du serveur ou de ses dépendances : l’équipe du service doit agir. Une mauvaise classification corrompt l’observabilité. Compter les réponses 4xx comme des échecs de disponibilité crée de fausses alertes, tandis que retourner du 4xx pour des défaillances serveur masque de vrais incidents. La règle est simple : 4xx signifie corriger la requête ; 5xx signifie corriger le service.
La classification des erreurs active les mécanismes de résilience
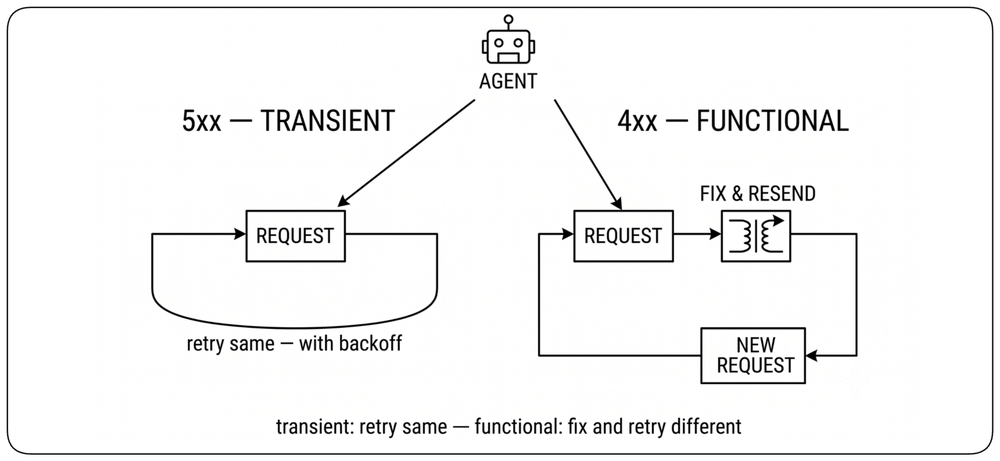
La classification des erreurs détermine la bonne réponse de résilience. Les défaillances transitoires comme les timeouts ou les erreurs 5xx peuvent justifier de réessayer la même requête, souvent avec un backoff. Les défaillances fonctionnelles comme une entrée malformée ou des erreurs de validation exigent de modifier la requête avant de réessayer. Cette distinction est particulièrement importante pour les appelants automatisés et les agents LLM : transitoire signifie réessayer ; fonctionnel signifie corriger et réessayer différemment. La classification est ce qui rend possible le bon mécanisme de résilience.
En savoir plus
Chapitre : Concevoir pour la résilience — voir Retry Pattern et The Limits of Retry.
Propagation des erreurs et continuité des traces
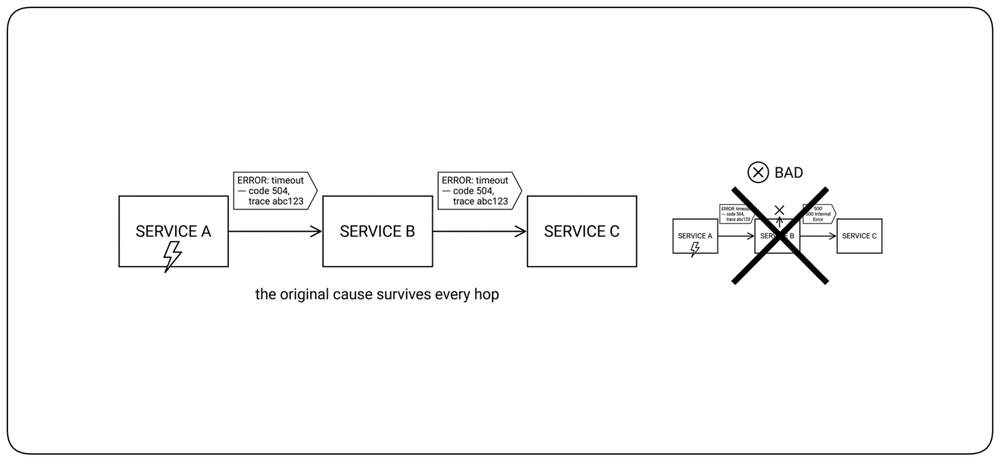
Dans les systèmes distribués, les erreurs naissent souvent dans un service et apparaissent dans un autre. Quand un service en amont échoue, le service en aval doit propager l’erreur — ou une version résumée — tout en préservant la continuité de la trace. Perdre le contexte d’erreur d’origine aux frontières des services rend l’analyse de cause racine impossible. Bonne pratique : propager les codes et identifiants d’erreur, les attacher aux spans et aux logs, et éviter d’écraser ou de jeter le contexte d’erreur amont. L’objectif est une histoire d’erreur cohérente sur l’ensemble du chemin de la requête.
Alerting
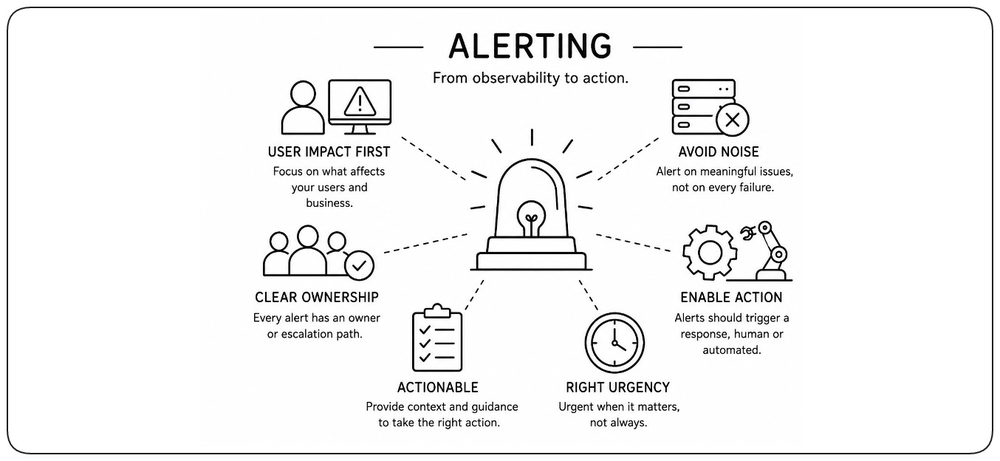
L’alerting transforme l’observabilité en action. Alors que l’observabilité aide les équipes à comprendre ce qui se passe et pourquoi, l’alerting détermine quand une intervention est nécessaire. Son but n’est pas de notifier chaque anomalie, mais de détecter les situations qui exigent une réponse spécifique d’un humain ou d’un système automatisé. Un alerting efficace priorise l’impact utilisateur plutôt que les défaillances individuelles, minimise les interruptions inutiles et garantit que chaque alerte a un propriétaire clair et une action attendue.
Découpler les applications de la logique d’alerting
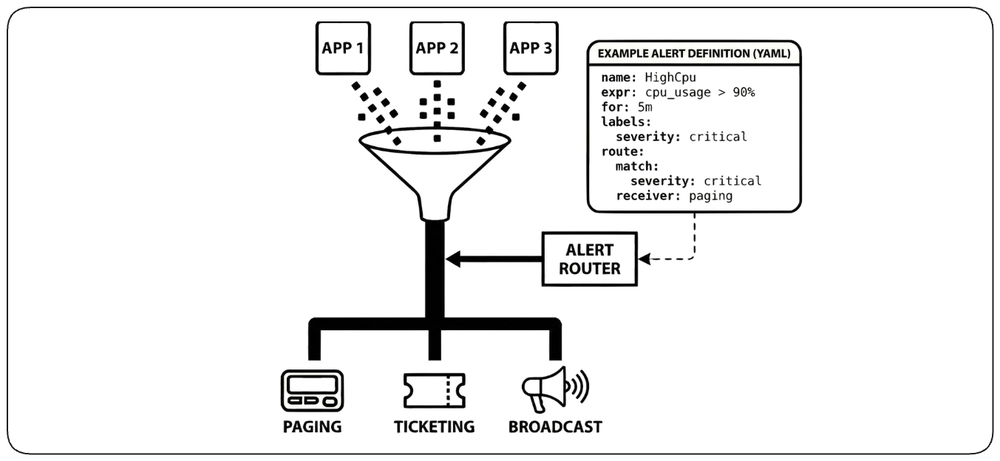
Quand la logique d’alerting est intégrée au code applicatif, elle devient difficile à maintenir et incohérente d’un service à l’autre. Mettre à jour des seuils ou le routage exige souvent des changements de code et des déploiements, ce qui couple les décisions opérationnelles aux cycles de release produit. Un routeur d’alertes centralisé garde cette logique séparée. Les services émettent des signaux, et les règles d’alerte évoluent indépendamment : les pages restent rares, les tickets restent actionnables et le routage peut changer sans toucher au code applicatif.
Alertes as code : versioning et revue
Les définitions d’alertes doivent être gérées comme du code, selon les principes de l’Infrastructure as Code. Les interfaces UI sont utiles pour expérimenter et tester rapidement, mais les alertes de production doivent être définies dans des fichiers de configuration versionnés, passer par une code review et être déployées via des pipelines CI/CD. Cela garantit que les changements sont traçables, relisables et cohérents entre les environnements. Le workflow doit permettre d’expérimenter via l’UI, puis de codifier pour l’usage en production.
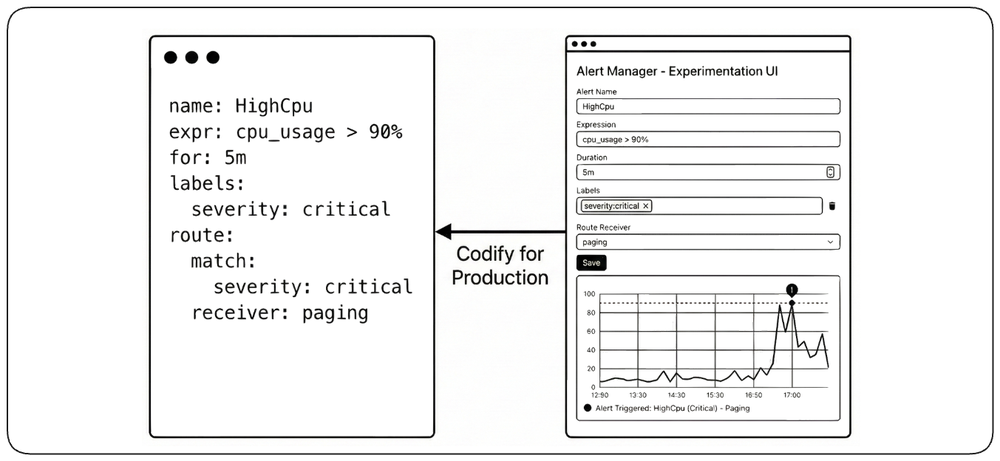
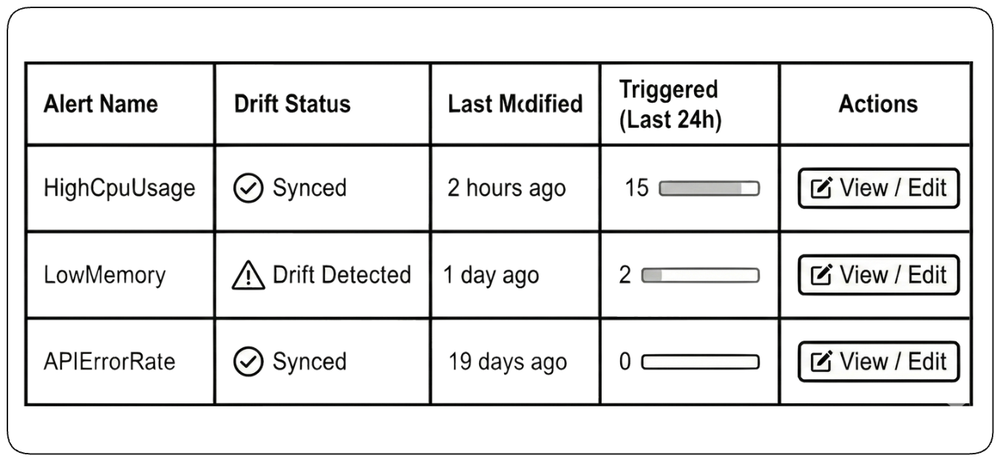
Détecter la dérive de configuration
Dans tout système à double mode qui supporte à la fois la configuration par le code et par l’UI, il est essentiel de détecter et de signaler la dérive de configuration — quand la configuration UI diverge de la définition dans le code — pour éviter les incohérences et s’assurer que les équipes savent quelle source de vérité fait foi.
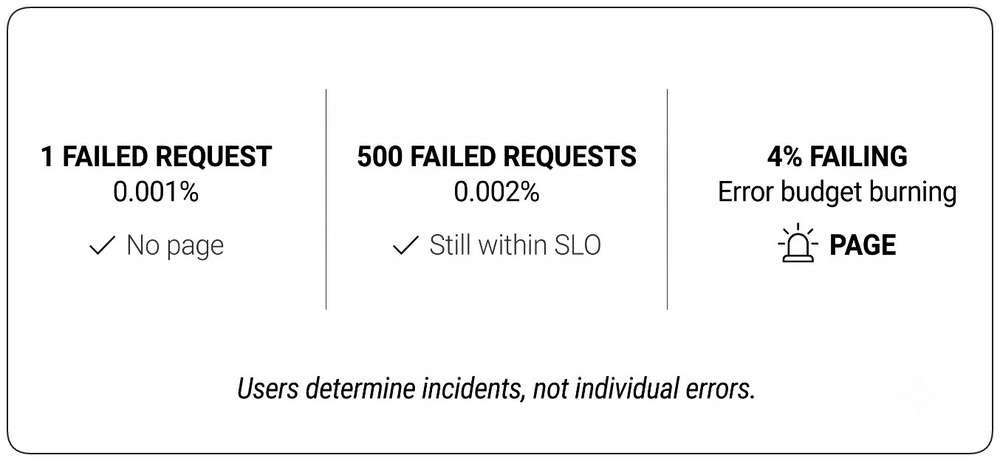
Un incident, c’est de l’impact utilisateur, pas des défaillances individuelles
Les défaillances sont inévitables. Quelques requêtes échouées n’indiquent pas forcément un incident, et réveiller un ingénieur pour chaque erreur isolée créerait vite une fatigue d’alerte. !!Ce qui compte, c’est l’impact utilisateur durable.!! Un incident commence lorsque les défaillances dépassent le niveau que le service a accepté de tolérer, généralement défini via les SLI, les SLO et l’error budget. L’alerting doit protéger cette expérience utilisateur, pas réagir à chaque défaillance individuelle.
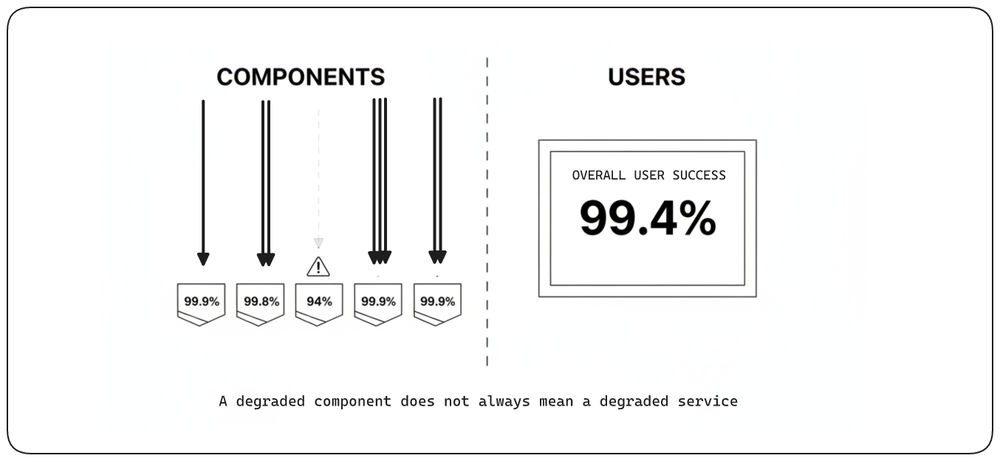
Mesurer ce que vivent les utilisateurs
Un serveur ou un shard peut sembler défaillant alors que les utilisateurs sont à peine touchés. L'inverse peut aussi arriver : tous les composants semblent sains, mais certains utilisateurs échouent quand même. !!Le SLO doit mesurer le résultat que reçoivent les utilisateurs sur l’ensemble du service.!! Les métriques internes aident à trouver le problème, mais elles ne doivent pas définir la promesse.
En savoir plus
Google SRE Workbook, Alerting on SLOs : « Définissez votre SLO en fonction de ce qui compte pour l’expérience utilisateur agrégée, pas selon des métriques par shard ou par composant. »
Compter les requêtes, pas les minutes
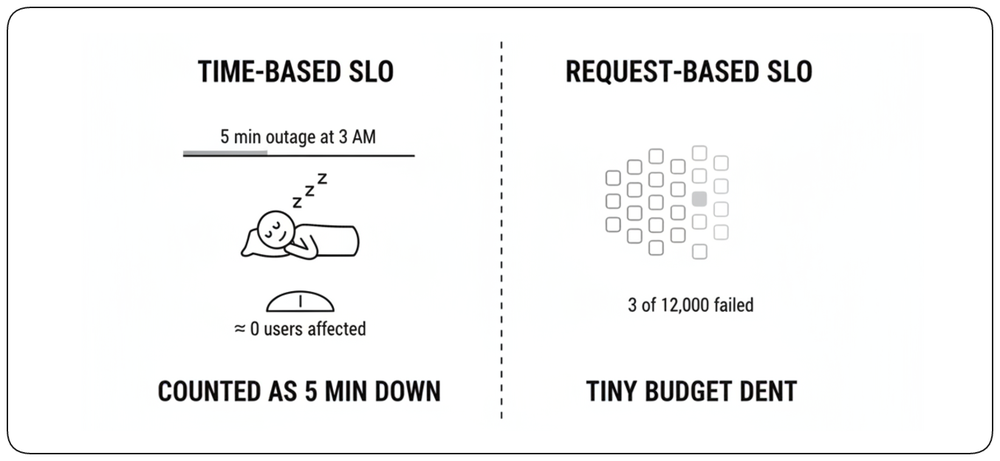
Un SLO basé sur le temps compte combien de temps le service a été indisponible. Mais cinq minutes la nuit n’affectent presque personne, alors que cinq minutes en pleine charge peuvent affecter des milliers d’utilisateurs. !!Un SLO basé sur les requêtes compte ce qui importe vraiment : combien de requêtes utilisateur ont réussi ou échoué.!! Cela donne une image plus fidèle de l’impact utilisateur.
En savoir plus
Google SRE Workbook, Alerting on SLOs : « Nous recommandons généralement d’utiliser des SLO basés sur les requêtes chaque fois que possible, car ils reflètent mieux l’expérience utilisateur réelle. »
Burn rate : deux vitesses, deux réponses
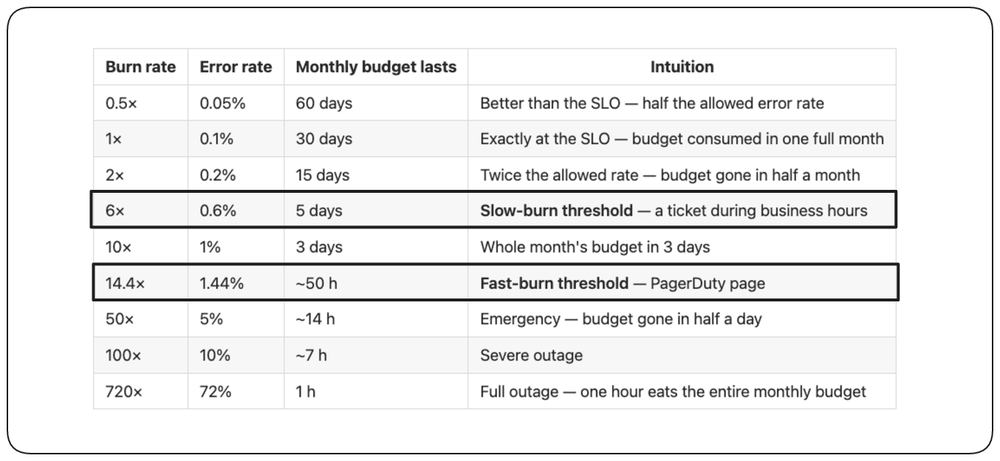
Des alertes basées uniquement sur un seuil d’erreur fixe peuvent être trompeuses. Un petit taux d’erreur peut être inoffensif pendant quelques minutes mais grave s’il dure des heures. !!Le burn rate montre la vitesse à laquelle l’error budget est consommé.!! Google SRE recommande deux alertes : une alerte de fast burn qui page l’ingénieur d’astreinte, et une alerte de slow burn qui crée un ticket pour les heures ouvrées.
En savoir plus
Google SRE Workbook, Alerting on SLOs : « Pour le burn rate le plus rapide — par exemple, un burn rate qui consommerait tout l’error budget en quelques heures — vous devez paginer un humain immédiatement. Pour des burn rates plus lents qui épuiseraient tout de même le budget en quelques jours, un ticket traité pendant les heures ouvrées est plus approprié. »
Ne pas paginer pour un incident déjà terminé
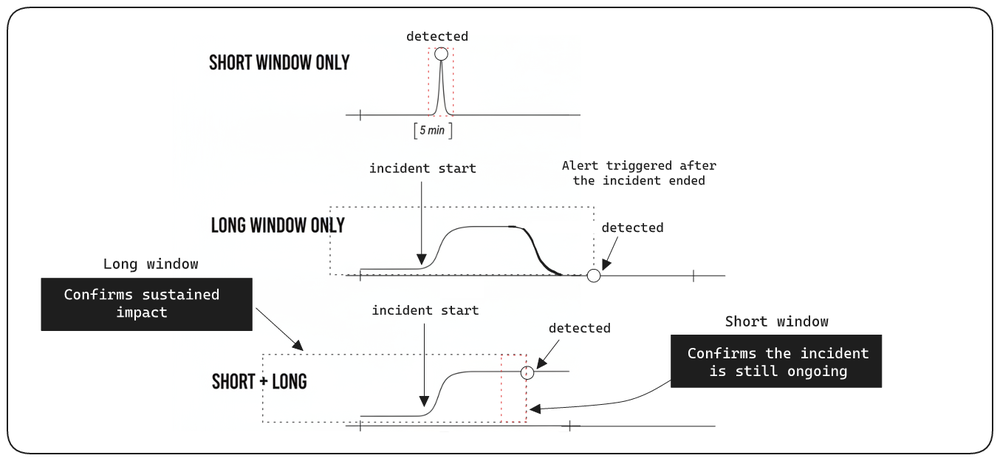
Une longue fenêtre de burn rate confirme qu’un incident était sérieux, mais elle peut ne se déclencher qu’une fois le problème disparu. Une fenêtre courte seule réagit immédiatement, mais peut paginer pour un bref pic. !!Google SRE combine les deux avec un AND logique : la longue fenêtre confirme que l’incident a duré assez longtemps pour compter, tandis que la fenêtre courte confirme qu’il est toujours en cours.!! L’alerte ne se déclenche que lorsque les deux conditions sont vraies.
Les trois types d’alertes
Il n’existe que trois types d’alertes, chacun correspondant à un mécanisme de réponse et à un niveau d’urgence différents. Comprendre ces catégories aide les équipes à concevoir des stratégies d’alerting efficaces qui alignent les actions de réponse sur la sévérité de l’alerte. Chaque alerte doit entrer dans l’une de ces trois catégories — sinon, ce n’est pas une alerte, c’est un signal d’observabilité qui a sa place sur un dashboard ou dans les logs.
Action immédiate requise : Page
Les alertes Page sont réservées aux situations qui exigent une réponse humaine immédiate pour protéger les utilisateurs, le chiffre d’affaires ou les données. Elles doivent être rares, à fort signal et clairement liées à un impact réel (service down, erreurs critiques, risque de sécurité). Si ce n’est pas assez urgent pour réveiller quelqu’un, ce ne doit pas être une page.
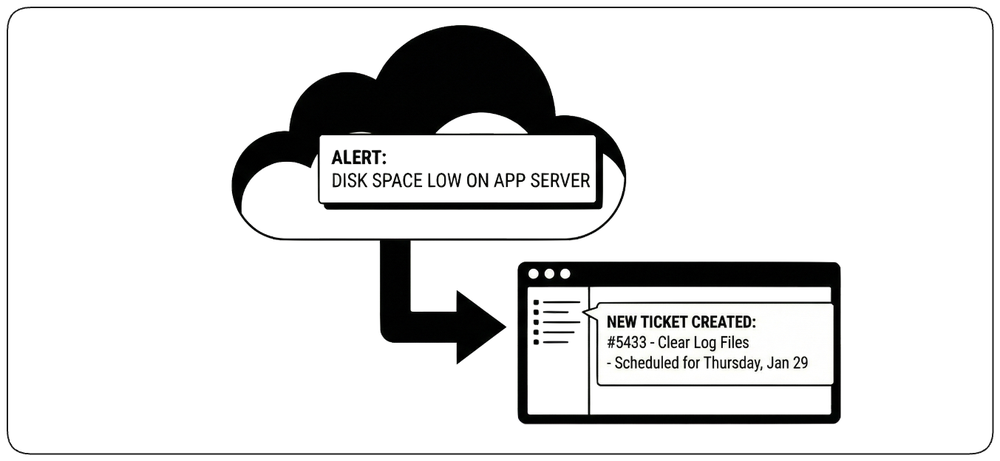
Action requise bientôt : Ticket
Les alertes Ticket sont des problèmes qui doivent être corrigés ou investigués bientôt, mais ne justifient pas d’interrompre immédiatement l’astreinte. Ce sont typiquement des signaux d’alerte précoces (taux d’erreur en hausse, performance dégradée) qui exigent une action pour éviter que des problèmes prévisibles ne deviennent des incidents. L’objectif est un travail contrôlé et planifié — pas une réponse d’urgence. Un ticket doit aussi porter un âge maximal : s’il reste ouvert au-delà de son délai de traitement, il doit escalader automatiquement en page. Sans ce filet de sécurité, les tickets s’accumulent discrètement jusqu’à ce que la fuite qu’ils suivaient devienne l’incident que personne n’a vu venir.
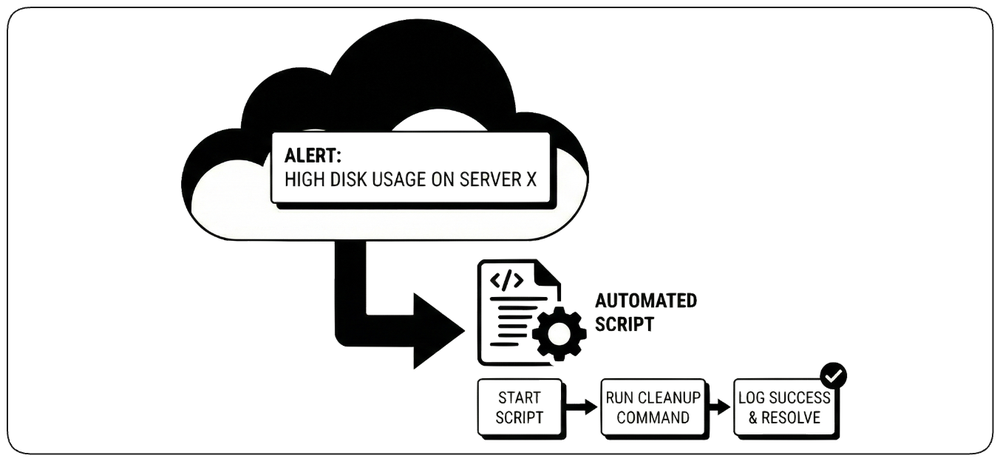
Remédiation automatique : Script
Les alertes de remédiation automatisée déclenchent une action prédéfinie et sûre sans intervention humaine. Elles fonctionnent mieux pour des problèmes répétitifs et bien compris dont la correction est peu risquée (nettoyage, redémarrage, resynchronisation, scaling). Ces alertes doivent rester observables, afin que les équipes puissent vérifier que l’automatisation fonctionne et ne masque pas des défaillances plus profondes.
Chaque alerte doit avoir un propriétaire
Une alerte ne crée de la valeur que si quelqu’un est responsable d’agir dessus. Sans propriétaire clair ni réponse attendue, les alertes deviennent du bruit et les incidents restent non résolus. Chaque alerte doit correspondre à une équipe ou une rotation d’astreinte, une action définie et une responsabilité explicite.
En savoir plus
Chapitre : Concevoir pour être opéré — voir « Paging et astreinte ».
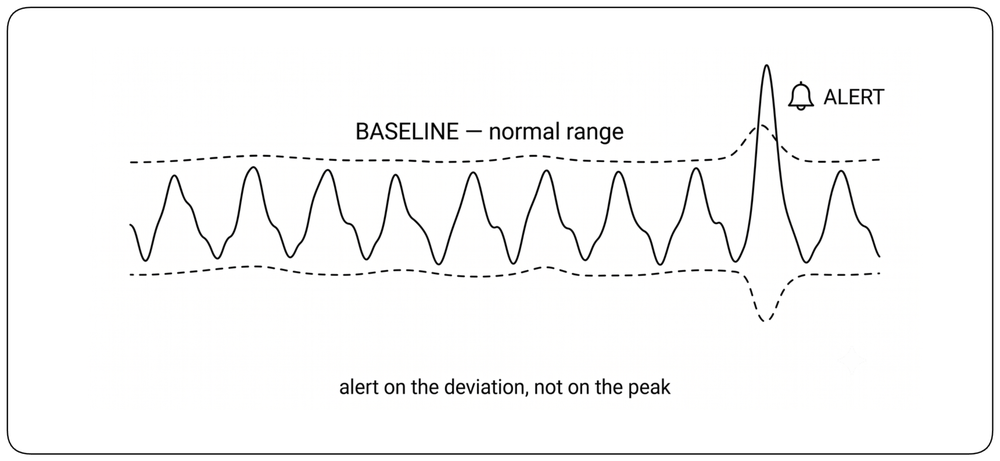
Détecter le signal dans le bruit : systèmes d’alerte basés sur les séries temporelles
Les alertes doivent se baser sur des signaux dans le temps, pas sur des points de données isolés. L’objectif est de détecter des écarts significatifs par rapport au comportement normal tout en évitant le bruit dû à la variabilité attendue (schémas de trafic, pics quotidiens, effets saisonniers). Un bon alerting utilise des baselines et des tendances pour réduire les faux positifs et produire des alertes qui mènent à l’action.
Faux positifs : le défi de la précision des alertes
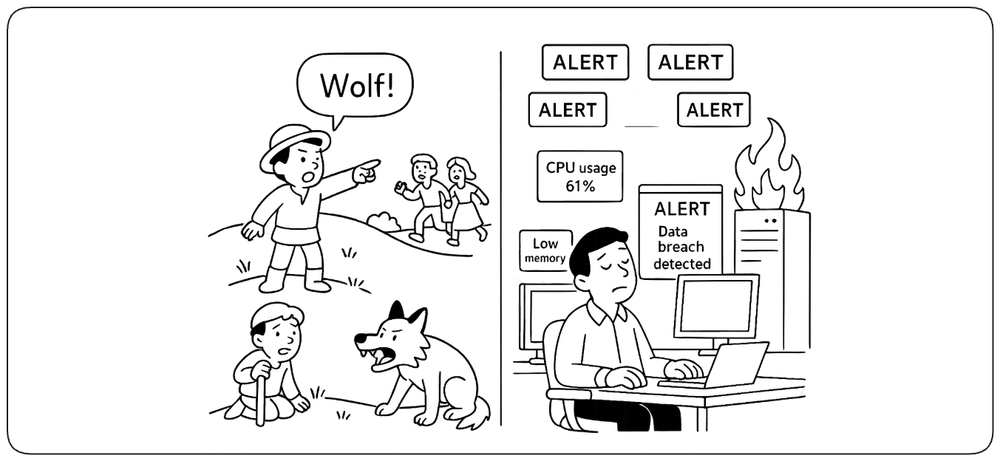
Les faux positifs surviennent quand les systèmes de monitoring déclenchent des alertes pour des anomalies mineures plutôt que pour de vrais incidents. Ce bruit constant crée une fatigue d’alerte, poussant les équipes à se méfier de leurs outils et à se désensibiliser aux notifications. Les ingénieurs risquent alors d’ignorer des avertissements critiques ou de réagir trop lentement quand une vraie crise survient. Pour l’éviter, les alertes doivent être rigoureusement ajustées pour être actionnables et centrées sur l’impact utilisateur réel plutôt que sur des pics de métriques bruts.
Des alertes sur tout, des actions sur rien
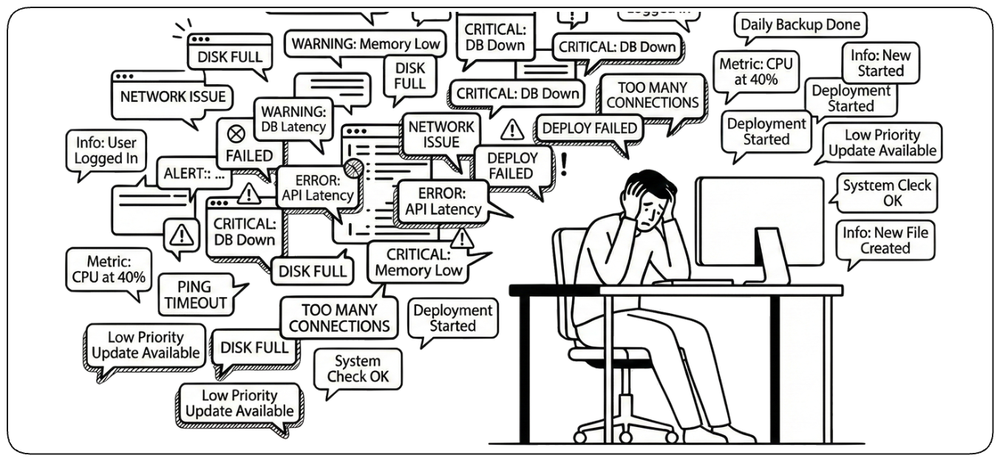
Alerter sur chaque métrique crée de la fatigue et affaiblit la confiance. Quand tout est urgent, rien ne l’est. Les équipes se mettent à ignorer les notifications, à désactiver des règles ou à ajouter des filtres qui masquent de vrais incidents. Un alerting efficace exige de la discipline : ne paginer que lorsqu’une action humaine est nécessaire, prioriser par impact et préférer un petit ensemble d’alertes de confiance à un gros volume de bruit.
Les alertes informatives sont un anti-pattern
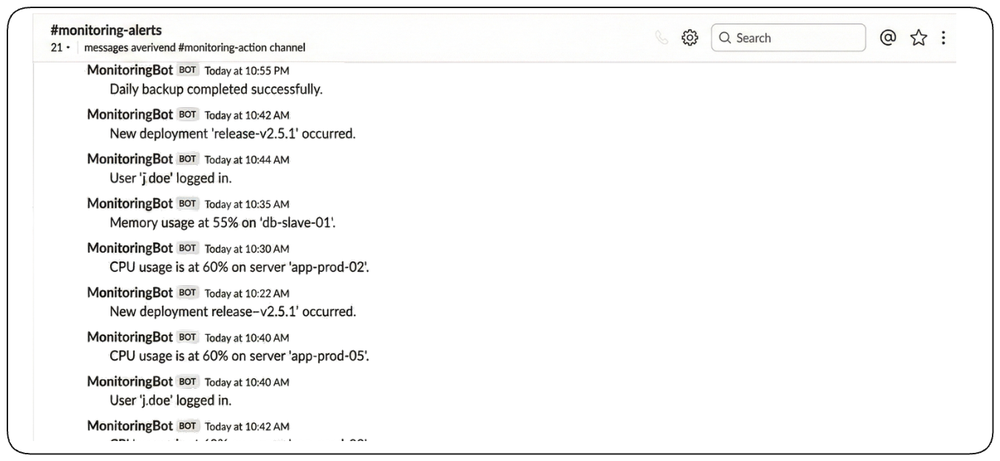
Une alerte est une interruption qui exige une action. Si personne n’a besoin d’agir, ce n’est pas une alerte — c’est une métrique, un log ou un événement. Les alertes informatives ajoutent du bruit, créent de la fatigue et affaiblissent la confiance dans le monitoring. Avant d’en créer une, demandez-vous : que doit faire l’ingénieur d’astreinte quand elle se déclenche ? Si la réponse est « rien » ou « juste être au courant », elle a sa place sur un dashboard ou dans un log, pas dans le canal d’alertes.
Facteurs humains et processus
L’observabilité concerne aussi les humains et les processus
L’observabilité n’est pas seulement technique. Des métriques, logs et traces parfaits n’apportent aucune valeur si les équipes ne peuvent pas les interpréter, leur faire confiance ou agir dessus. Des alertes bruyantes créent de la fatigue, des signaux incohérents ralentissent les investigations et des leçons non capitalisées conduisent à des défaillances répétées. Une observabilité efficace réduit la charge cognitive grâce à des points d’entrée clairs, des signaux fiables, des runbooks, de la formation et des pratiques opérationnelles partagées.
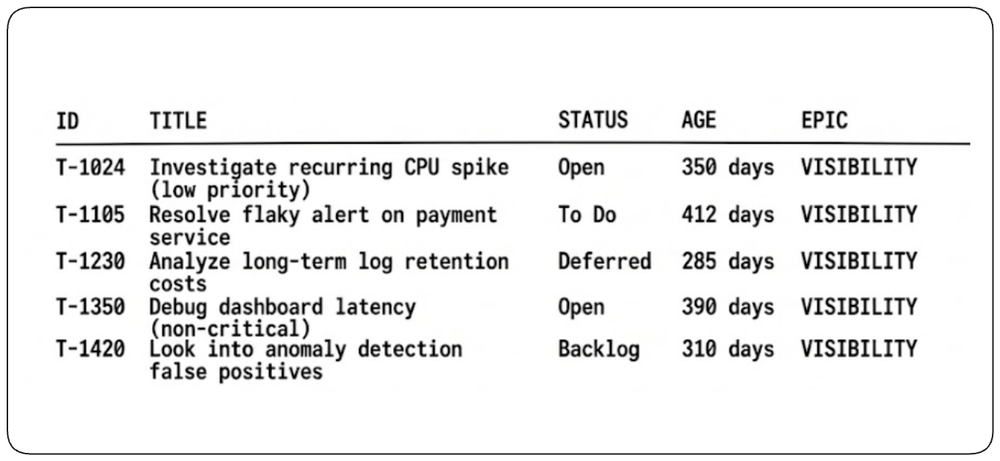
Le travail ingrat que personne ne célèbre
Le travail d’observabilité est essentiel mais rarement visible. De meilleurs dashboards, des alertes plus propres et des logs plus riches empêchent les incidents de s’aggraver, pourtant ils reçoivent moins de reconnaissance que le travail sur les fonctionnalités. Résultat : les lacunes découvertes pendant les incidents sont souvent reportées et se répètent. Les leaders doivent corriger ce déséquilibre d’incitations en priorisant les améliorations d’observabilité, en assignant des responsables et en les traitant comme de la maintenance essentielle plutôt que du polissage optionnel.
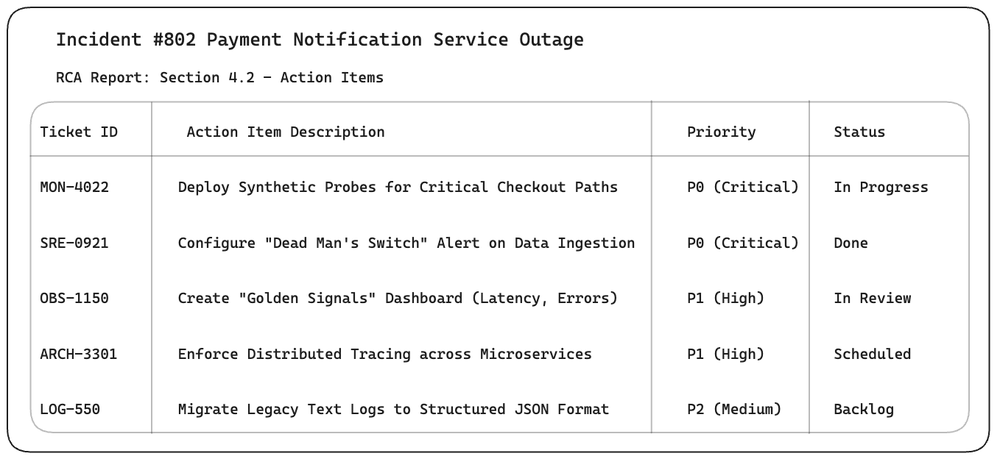
Utiliser les post-mortems pour alimenter l’investissement en observabilité
Les post-mortems doivent améliorer plus que le produit — ils doivent améliorer l’observabilité. En temps normal, les équipes priorisent naturellement les fonctionnalités plutôt que les dashboards, les alertes et l’instrumentation. Les incidents changent ces priorités. Le post-mortem est le moment d’identifier la visibilité manquante qui a ralenti la détection ou le diagnostic et de transformer ces lacunes en travail d’ingénierie suivi, avec des responsables clairs. Chaque incident doit laisser le système non seulement réparé, mais aussi plus observable qu’avant.
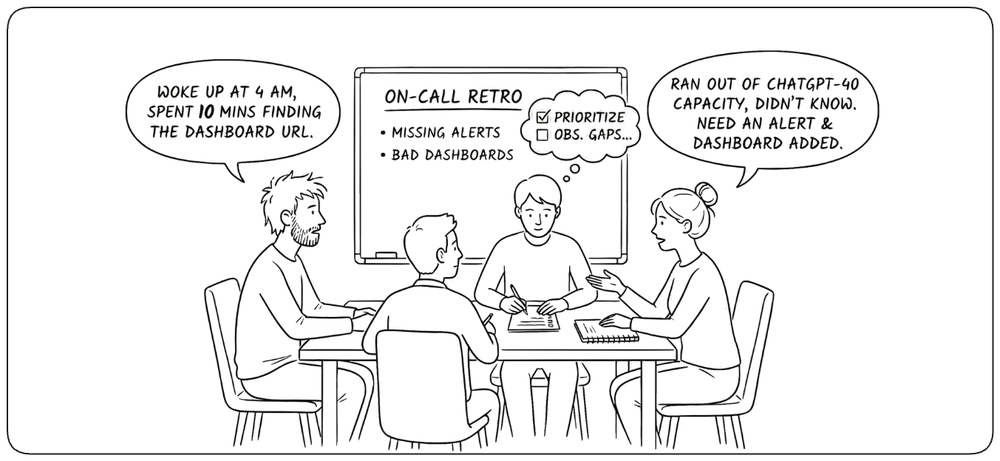
Rétrospectives de rotation d’astreinte : capturer les lacunes d’observabilité
Les rétrospectives d’astreinte capturent les frictions opérationnelles récurrentes que les revues d’incident individuelles peuvent manquer. À la fin de chaque rotation, les équipes doivent identifier les difficultés d’investigation répétées, les alertes bruyantes, les points d’entrée manquants et le travail manuel tant que l’expérience est fraîche. Ces schémas doivent devenir des améliorations priorisées, afin que chaque rotation laisse le système un peu plus facile à opérer.
L’investigation est une compétence
Les outils d’observabilité révèlent des signaux ; l’investigation les transforme en compréhension. Cette compétence n’est pas innée chez l’ingénieur — elle se construit avec le temps, incident après incident, en posant des questions plus pointues, en formulant des hypothèses, en les écartant avec des preuves et en sachant quand prendre du recul. Les équipes qui traitent l’investigation comme un artisanat développent des réflexes partagés : où regarder en premier, quelles dimensions découper, comment lire une timeline, quand une coïncidence n’en est pas une. La meilleure plateforme d’observabilité du monde produit peu de valeur sans ingénieurs formés pour l’interroger — et cette même compétence est ce qui rend vraiment utile la prochaine génération d’investigation assistée par l’IA.
Comment l’IA change l’observabilité
L’IA change l’observabilité en rendant l’investigation plus rapide et plus accessible. Elle peut relier des preuves entre outils, traduire des questions en langage naturel en requêtes, suggérer des causes probables et assembler des timelines d’incident au fil des événements. Ces capacités ne remplacent pas le jugement de l’ingénieur ; elles amplifient la valeur de la télémétrie déjà disponible.
Corrélation entre sources
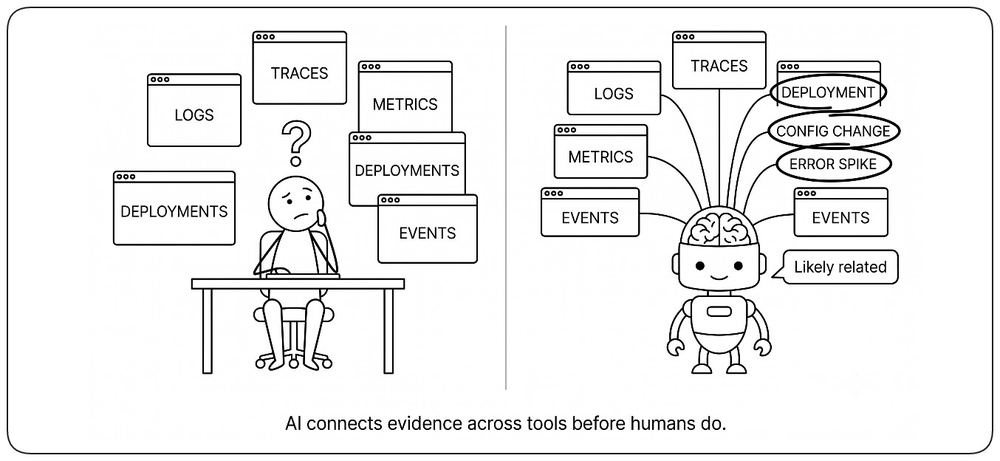
L’IA peut corréler des preuves entre logs, traces, métriques, déploiements, changements de configuration, incidents de dépendances et événements business bien plus vite que les humains. Au lieu de passer manuellement d’un outil à l’autre, les ingénieurs reçoivent immédiatement des relations et des hypothèses probables. L’IA ne remplace pas l’investigation — elle l’accélère en reliant des preuves qui resteraient sinon dispersées.
Investigation en langage naturel
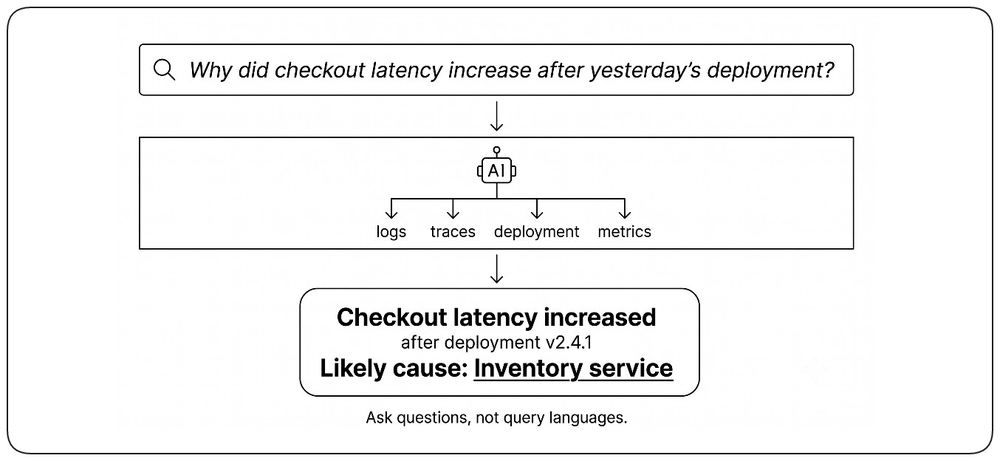
L’observabilité ne devrait pas exiger d’apprendre des langages de requête complexes. L’IA permet aux ingénieurs d’investiguer les systèmes en langage naturel : « Pourquoi la latence du checkout a-t-elle augmenté après le déploiement d’hier ? » ou « Montre-moi toutes les requêtes échouées pour les utilisateurs européens après la version 2.4.1. » L’objectif n’est pas de remplacer les requêtes structurées, mais de rendre les preuves accessibles à un plus large éventail d’ingénieurs.
L’IA comme assistant d’investigation
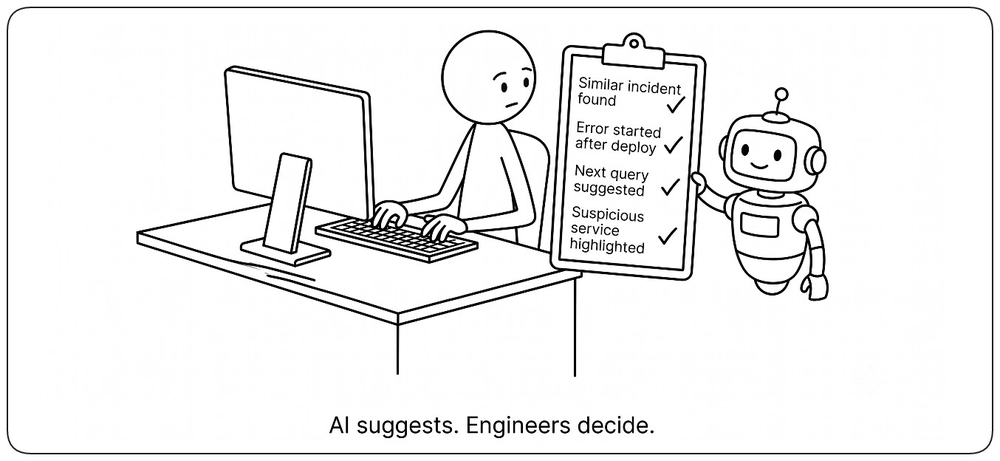
Les plateformes d’observabilité modernes utilisent de plus en plus l’IA comme assistant d’investigation plutôt que comme décideur. Elle résume les logs, met en évidence les traces inhabituelles, identifie les changements suspects, suggère la prochaine requête à lancer et explique pourquoi une hypothèse particulière mérite d’être investiguée. Les ingénieurs restent responsables de la validation des conclusions, mais ils passent moins de temps à chercher et plus de temps à raisonner.
L’IA comme premier intervenant
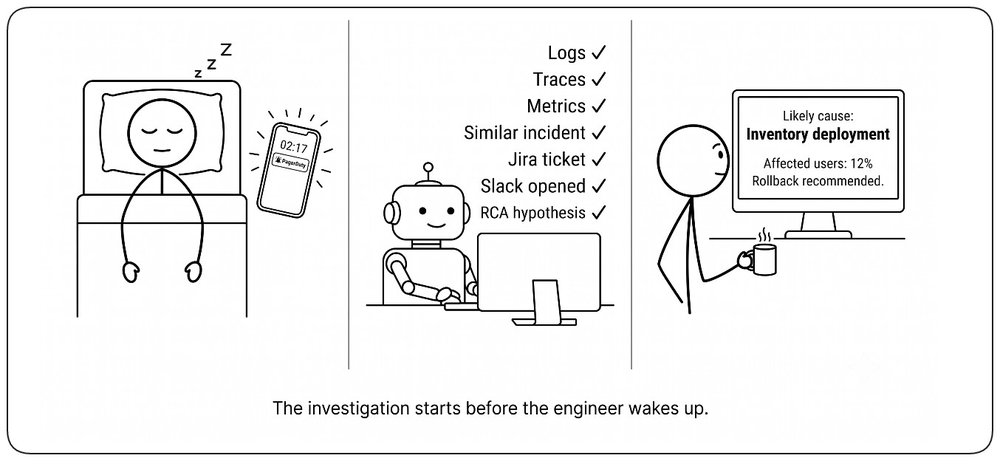
La réponse moderne aux incidents commence de plus en plus par l’IA, avant même qu’un humain ne rejoigne l’investigation. Dès qu’une alerte se déclenche, l’IA peut corréler la télémétrie, identifier les causes racines probables, évaluer l’impact utilisateur, rechercher des incidents similaires, générer un diagnostic initial, ouvrir des tickets d’incident, notifier les équipes concernées et recommander, voire déclencher, des étapes de remédiation prédéfinies. Quand l’ingénieur d’astreinte se réveille, l’investigation est déjà en cours. Les humains restent responsables des décisions, mais ils ne partent plus d’une page blanche — les humains investiguent aujourd’hui, les humains supervisent demain.
Post-mortems générés par l’IA
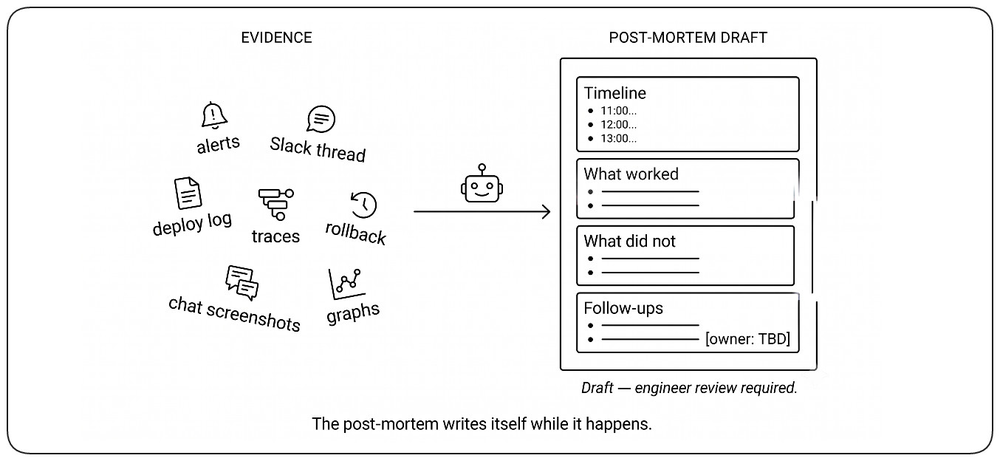
Une fois l’incident résolu, l’IA peut assembler le brouillon du post-mortem à partir des preuves qu’elle a déjà collectées pendant la réponse. Elle reconstitue la timeline, identifie les facteurs contributifs, décrit ce qui a fonctionné et ce qui n’a pas fonctionné, souligne les retards de détection ou de diagnostic et propose des actions de suivi concrètes comme des alertes manquantes, une instrumentation absente ou des runbooks peu clairs. Les ingénieurs affinent et valident le récit, mais ils ne partent plus de pages blanches, de logs de chat éparpillés et d’horodatages à moitié oubliés. Le post-mortem devient un artefact partagé produit avec l’IA, et non après coup.
Chaque investigation améliore la suivante
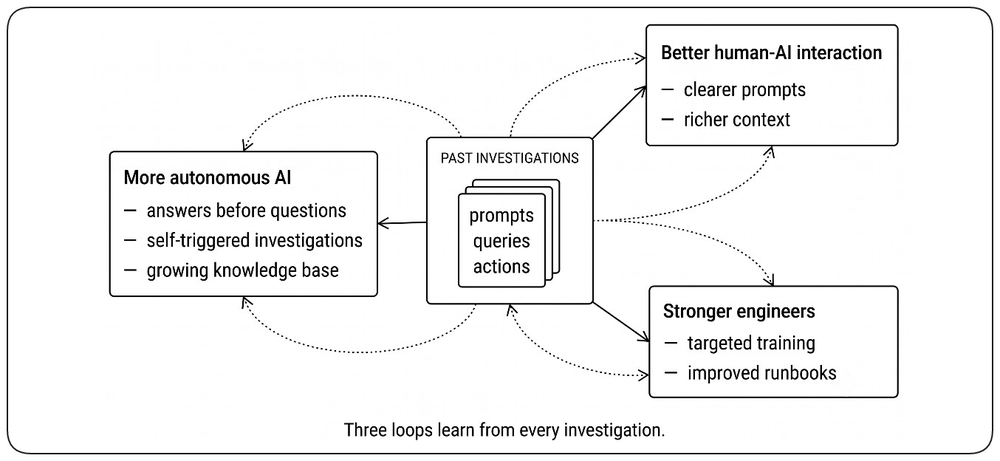
Les prompts, questions et actions que les ingénieurs utilisent pendant un incident sont eux-mêmes de la télémétrie précieuse : l’investigation elle-même devient observable. Capturé dans la durée, cet historique permet trois boucles d’amélioration distinctes. D’abord, les ingénieurs apprennent à collaborer plus efficacement avec l’IA — poser de meilleures questions, formuler de meilleurs prompts et exploiter pleinement ses capacités. Ensuite, les équipes identifient les angles morts dans leur compréhension du système et les transforment en formation ciblée ou en meilleurs runbooks. Enfin, l’IA elle-même devient progressivement plus autonome, en construisant une base de connaissances à partir des interactions passées pour anticiper les questions, proposer des investigations avant qu’elles ne soient demandées et parvenir seule à des conclusions initiales. L’investigation cesse d’être une activité ponctuelle et devient une pratique en amélioration continue.
Observer la maturité de l’équipe dans le temps
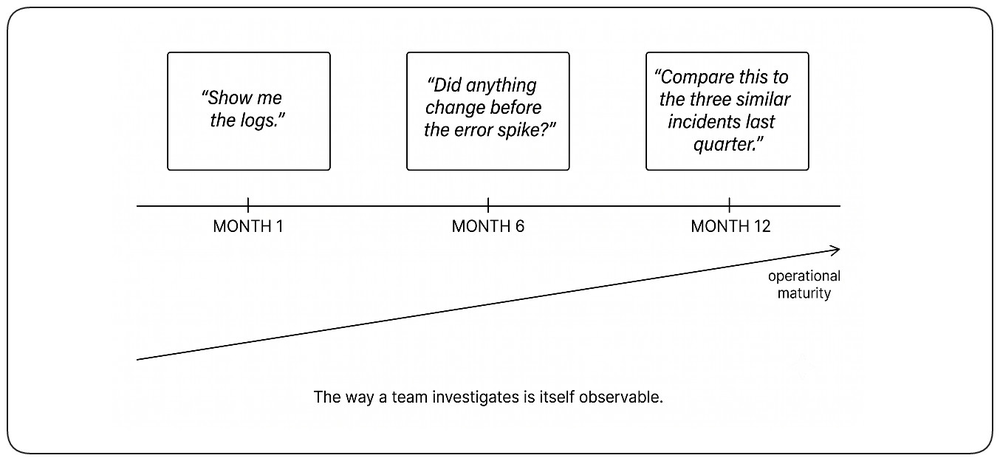
Quand les prompts d’investigation sont capturés sur des mois et des années, ils révèlent quelque chose que le système lui-même ne pourrait jamais montrer : comment l’équipe évolue. Les premiers prompts sont plutôt exploratoires — « montre-moi les logs », « est-ce que quelque chose a changé ? » Avec le temps, ils deviennent plus spécifiques, plus contextuels, plus stratégiques — « compare cet incident aux trois similaires de ce trimestre », « pourquoi notre rollback a-t-il pris plus de temps que les deux derniers ? ». Cette progression est un signal mesurable de maturité opérationnelle. Les équipes et leurs leaders peuvent enfin voir comment leur pratique d’investigation s’améliore, où elle stagne et où un coaching délibéré est nécessaire. L’observabilité commence à inclure les humains qui opèrent le système, et pas seulement le système lui-même.
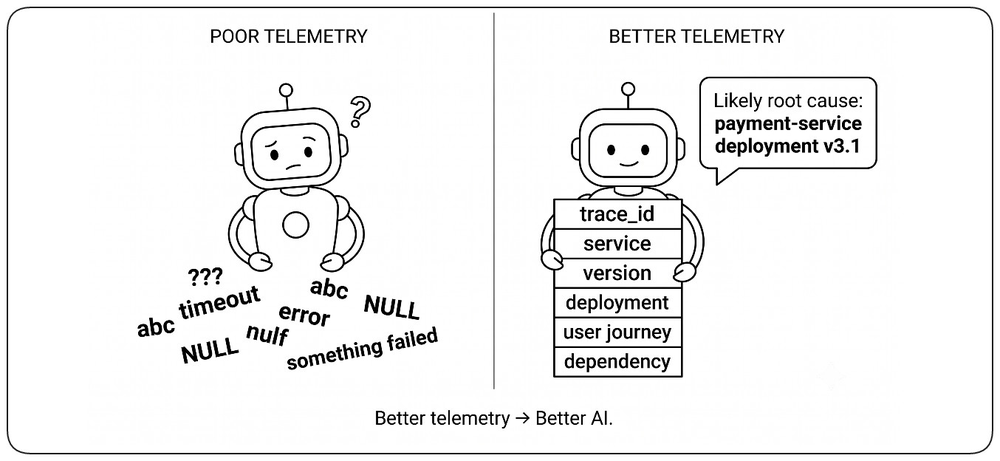
L’IA dépend d’une observabilité de qualité
L’IA ne peut raisonner qu’à partir des preuves qu’elle reçoit. Des traces manquantes, des identifiants incohérents, des logs non structurés ou des événements incomplets mènent à des conclusions incomplètes ou trompeuses. !!La qualité des opérations assistées par l’IA est déterminée par la qualité de la plateforme d’observabilité qui la sous-tend.!! Une meilleure télémétrie produit un meilleur raisonnement. L’IA amplifie l’observabilité — elle ne peut pas la remplacer.