Concevoir pour être construit (anciennement : CI)
Chapter Info
Calculating... Writing Progress: 50%
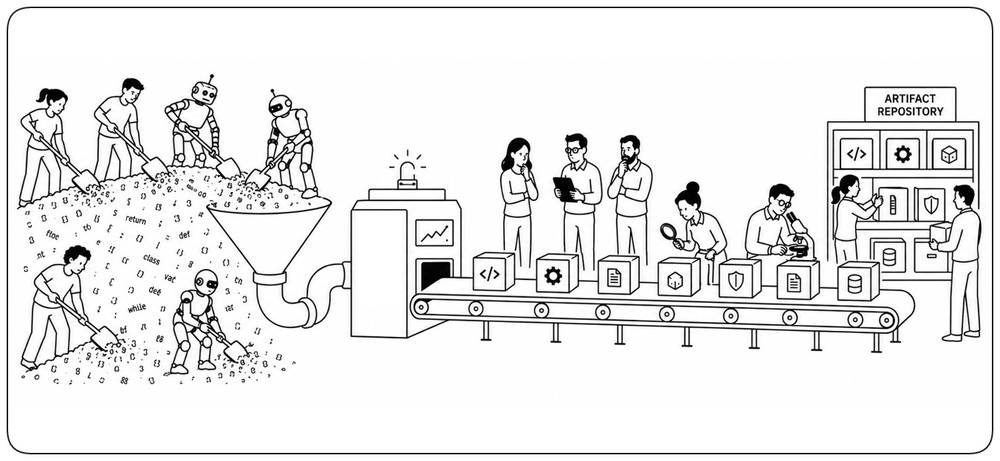
Chaque changement de code doit tôt ou tard répondre à la même question : peut-on faire suffisamment confiance à cette version pour avancer ? Un bon système de build transforme cette question en processus reproductible. Il prend un changement précis, le valide, construit le logiciel, exécute les vérifications nécessaires, empaquette le résultat et produit un artefact qui peut être tracé et promu en toute confiance.
Les fondamentaux du build
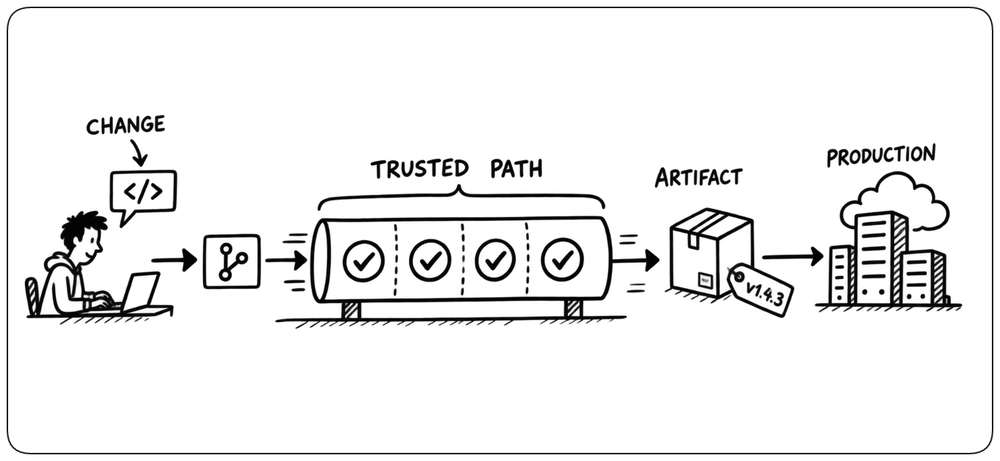
Un build fiable fait avancer chaque changement le long d’un chemin de confiance vers la production : intégrer fréquemment, valider automatiquement, produire des résultats reproductibles et renvoyer rapidement du feedback. Les principes suivants posent ces fondations.
Le chemin vers la production
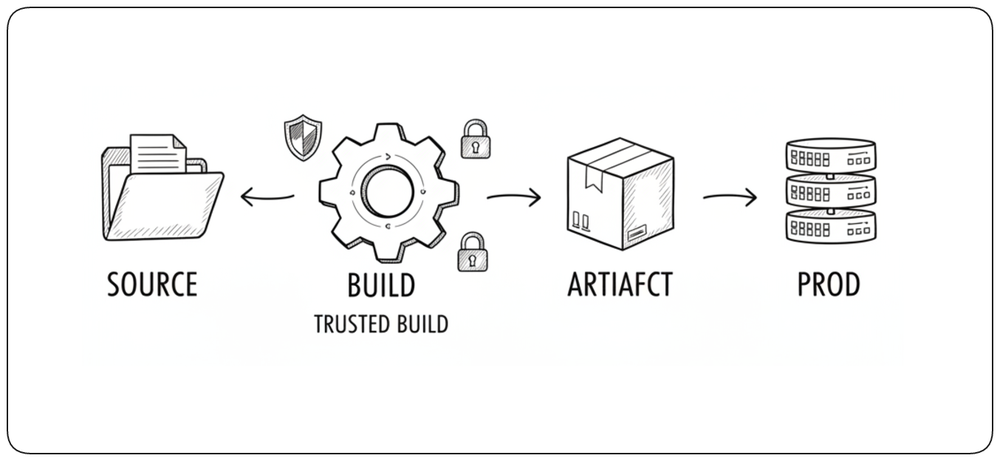
Le chemin vers la production est la route contrôlée qui conduit un changement de code de la source à un artefact déployable, puis finalement à la production. Tout changement destiné à la production doit suivre le même chemin de confiance, chaque étape apportant une preuve supplémentaire que le changement peut progresser sans risque.
Intégrer en continu
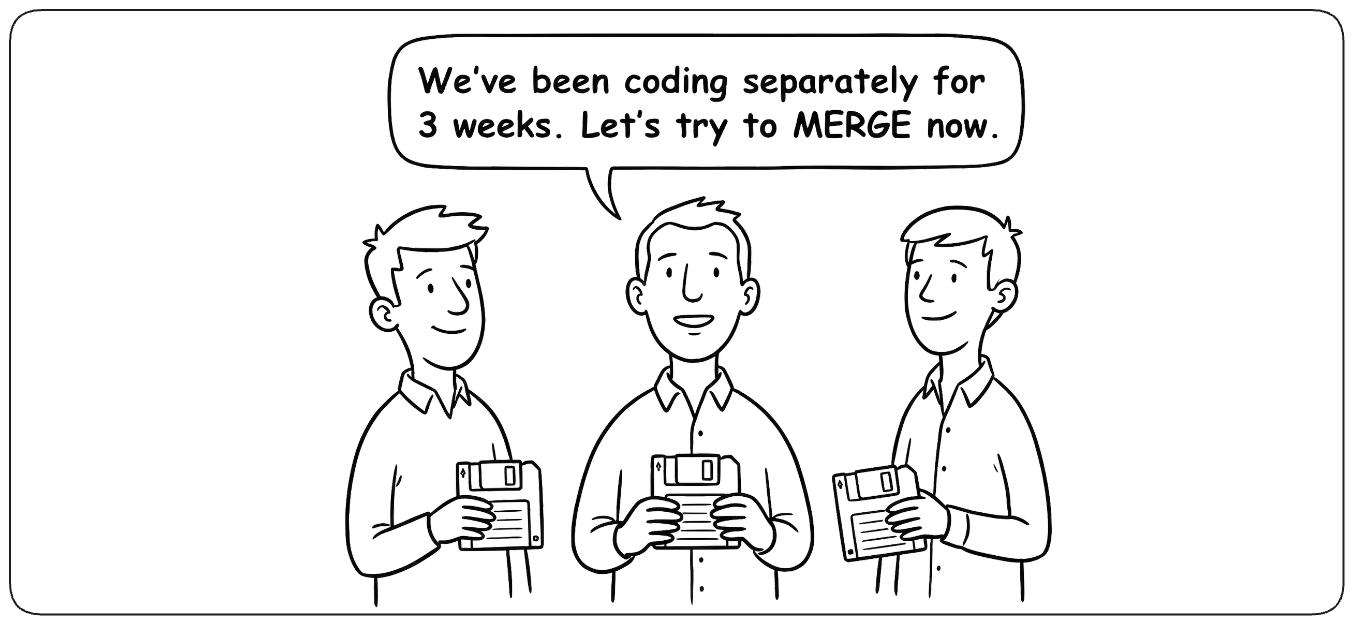
L’intégration continue signifiait à l’origine exactement ce que dit son nom : intégrer les changements en continu. Les développeurs fusionnent fréquemment de petits changements dans le code partagé au lieu de laisser les branches diverger longtemps. Une intégration fréquente révèle conflits et incompatibilités alors que les changements sont encore petits et faciles à comprendre. Pour des raisons historiques, le terme Continuous Integration désigne aujourd’hui plus largement le build, les tests et la validation automatisés qui accompagnent chaque changement.
Automatiser chaque changement
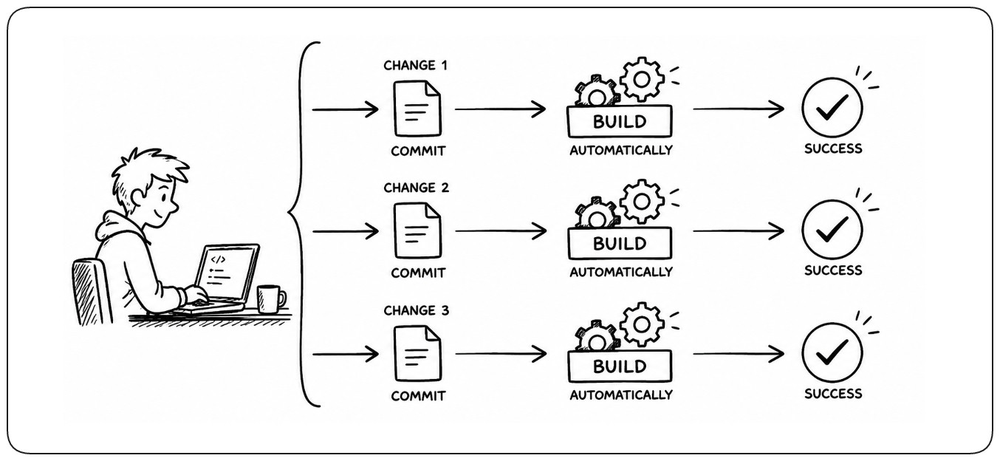
Chaque changement doit entrer automatiquement en validation. Le feedback reste ainsi proche du changement qui l’a causé : les échecs sont détectés quand le périmètre est encore réduit et que la cause probable est plus facile à identifier. Les développeurs ne devraient pas avoir à se souvenir quand ni comment lancer la validation ; le chemin vers la production doit réagir de façon cohérente à chaque changement.
Automatiser les décisions de routine
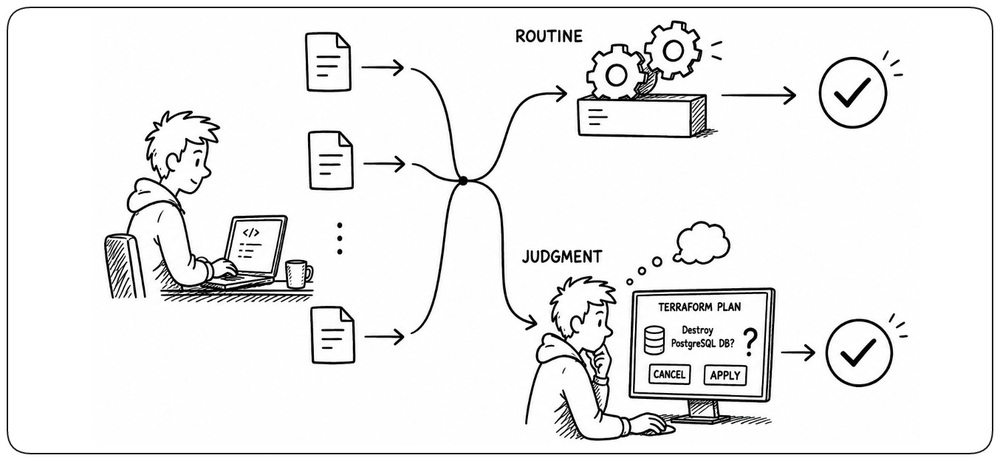
Les décisions de build de routine doivent être prises automatiquement dès que les règles nécessaires peuvent être exprimées clairement. L’approbation humaine doit être réservée aux décisions qui exigent vraiment du jugement, et non insérée dans chaque intégration comme point de contrôle par défaut. L’automatisation maintient la boucle de feedback en mouvement tout en laissant aux personnes la responsabilité des décisions que les machines ne peuvent pas prendre.
Construire de façon reproductible
Un build doit être reproductible : les mêmes entrées déclarées doivent produire le même résultat à chaque fois, quel que soit l’endroit où le build s’exécute. La reproductibilité rend les artefacts dignes de confiance, les échecs plus faciles à diagnostiquer et permet de reconstruire une version connue en toute confiance. Des entrées cachées ou non maîtrisées sapent cette confiance.
Construire une fois, déployer partout
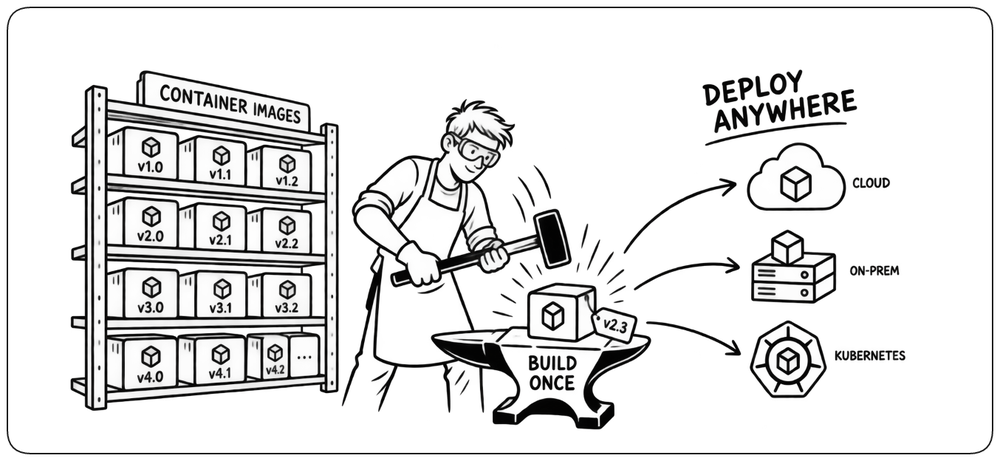
Construisez un artefact une seule fois, puis promouvez cet artefact exact à travers les tests, le staging et la production. Reconstruire pour chaque environnement introduit des différences entre ce qui a été testé et ce qui est finalement déployé. La configuration propre à un environnement doit être fournie au moment du déploiement, et non intégrée dans des builds distincts. Les conteneurs, popularisés par Docker, ont rendu ce modèle praticable en empaquetant l’application avec son runtime et ses dépendances dans un artefact portable qui circule de façon cohérente entre les environnements.
Préserver le lien entre la source et l’artefact
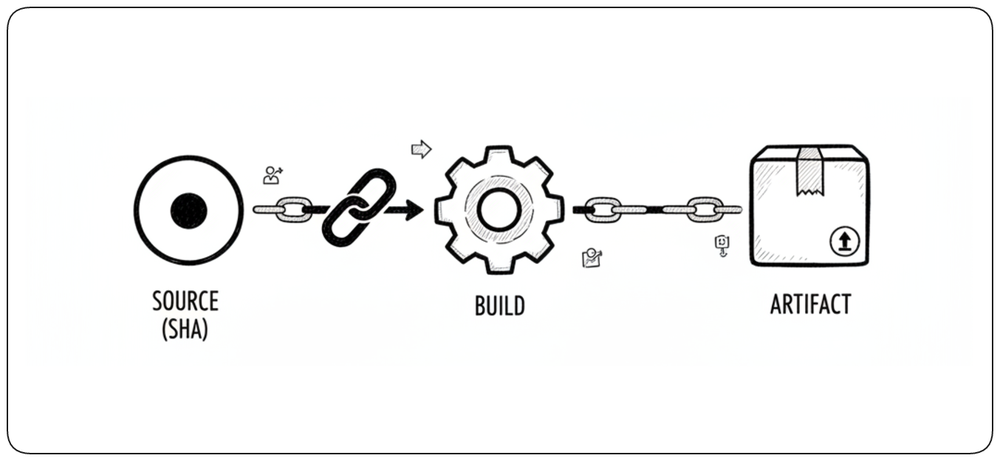
Chaque artefact doit conserver un lien ininterrompu avec la révision exacte du code source et le build qui l’ont produit. Le SHA du commit, l’enregistrement du build et l’identité de l’artefact forment une chaîne qui permet de comprendre précisément ce qui tourne, de reproduire une version, d’investiguer les échecs et de revenir en arrière en toute confiance.
Valider chaque changement
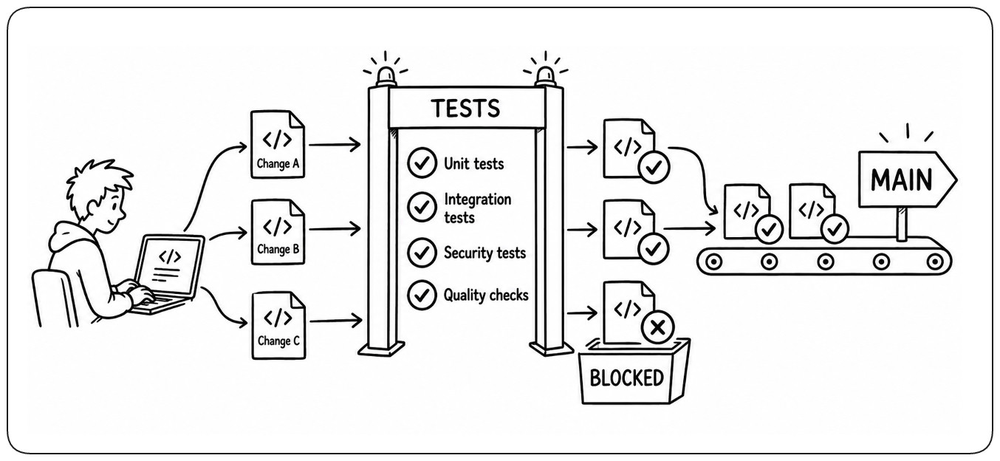
La compilation prouve seulement que le code peut être construit. Chaque changement doit collecter automatiquement assez de preuves pour démontrer qu’il peut être intégré sans risque. Tests, analyse statique, contrôles de sécurité et autres validations répondent à des questions différentes sur le changement et doivent s’exécuter avant qu’il ne progresse.
Détecter tôt, échouer vite
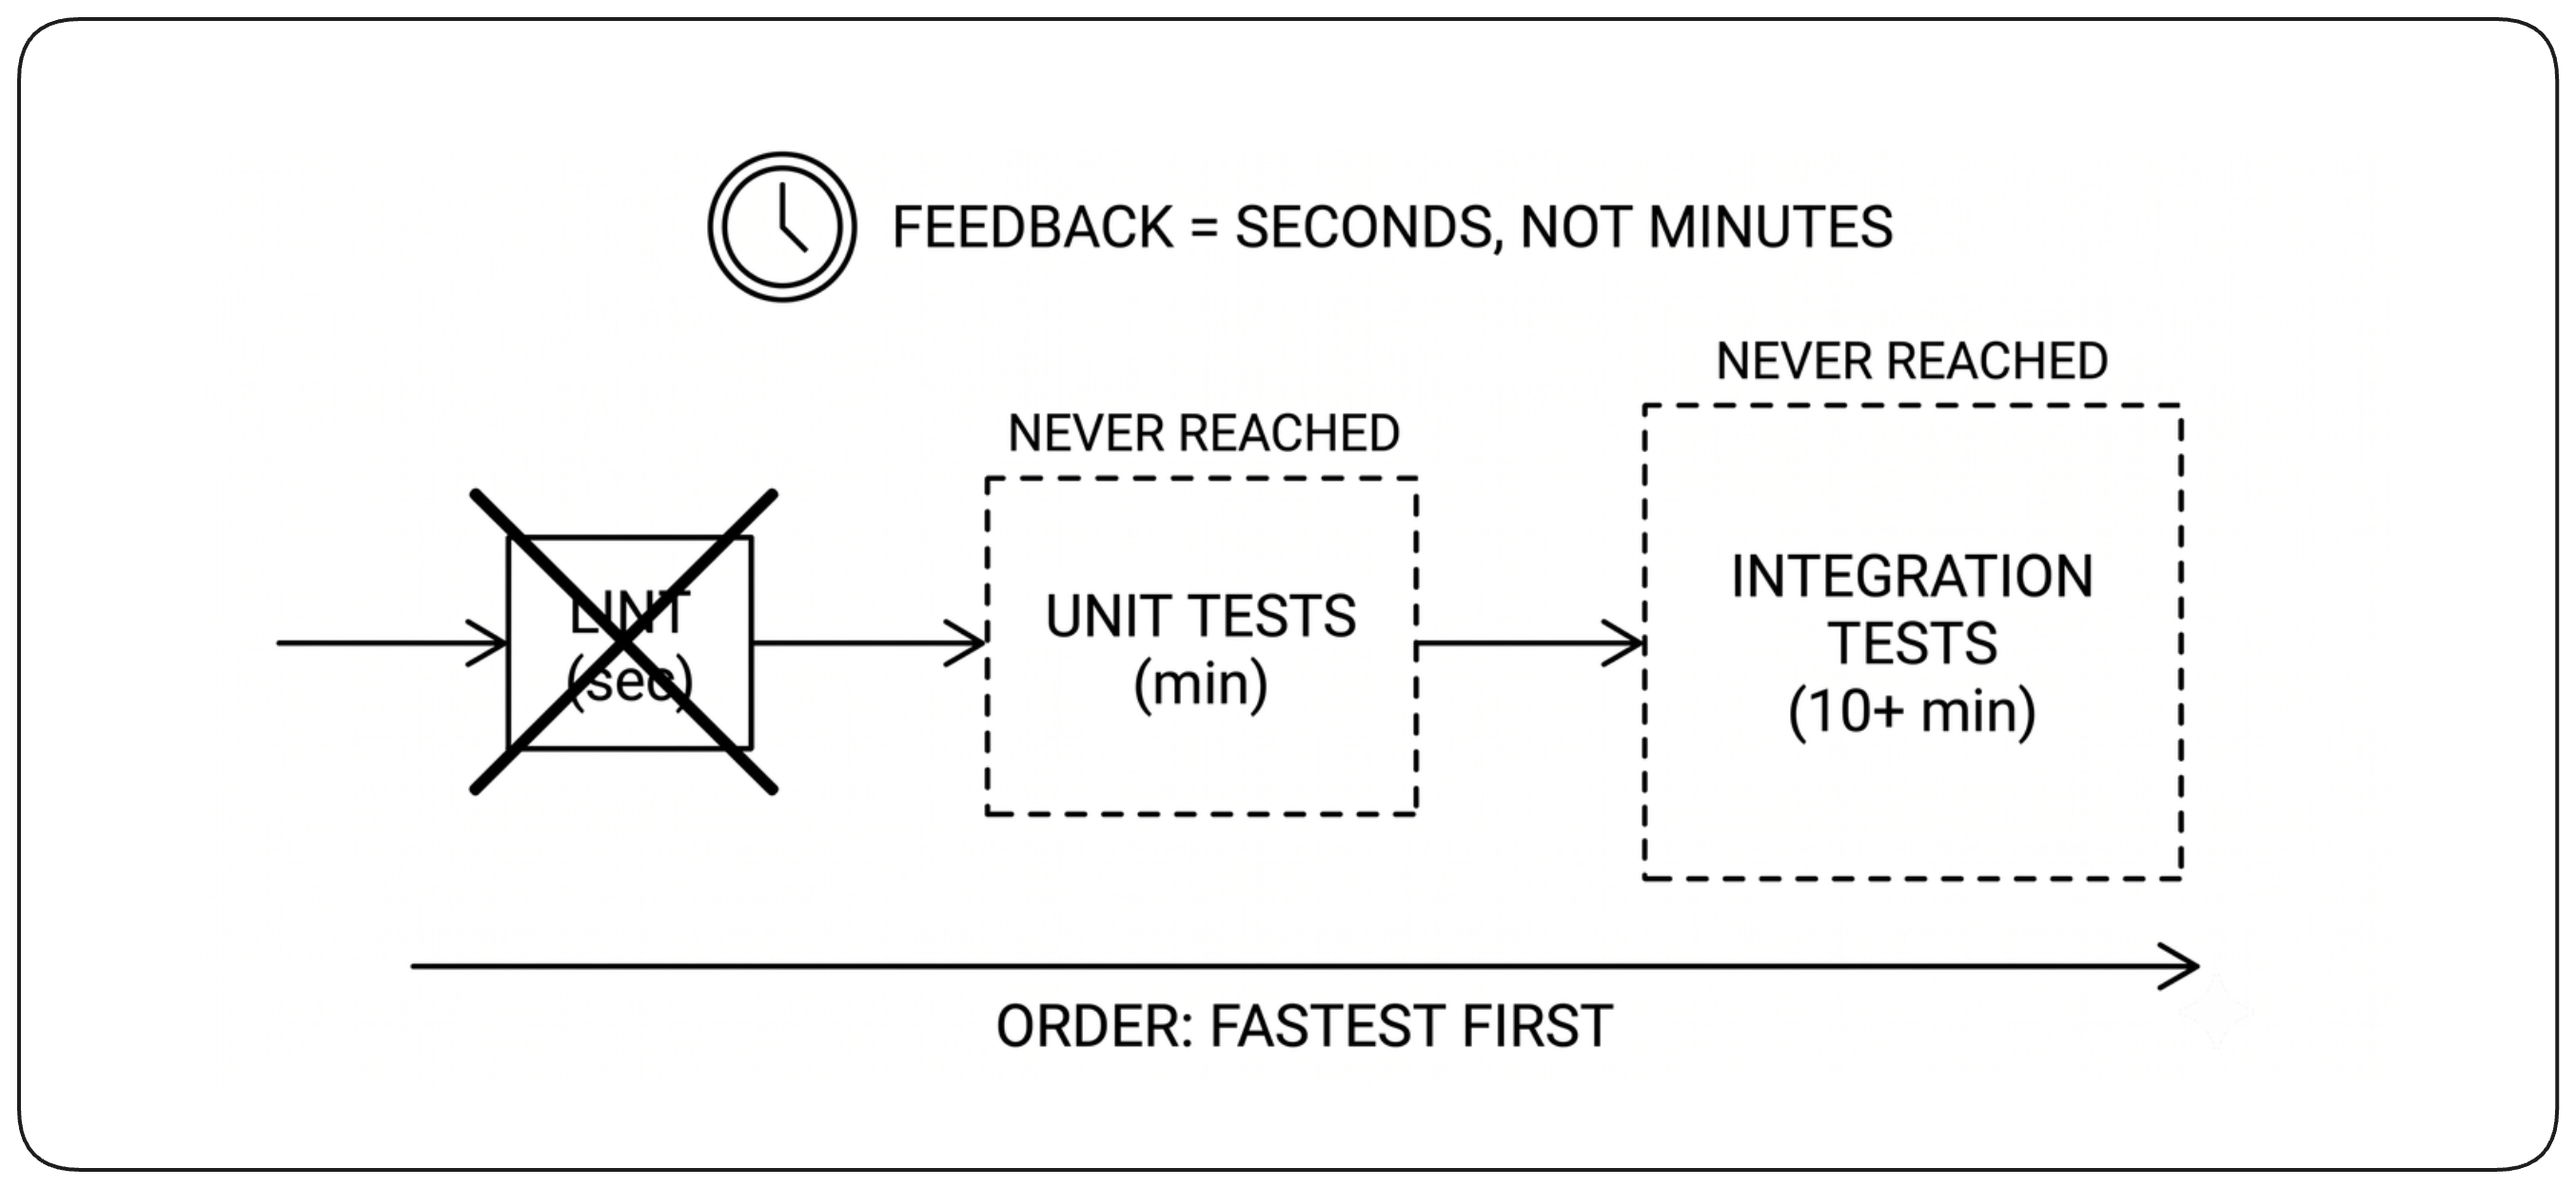
Concevez le build pour détecter les échecs le plus tôt possible. Ordonnez les vérifications de sorte que les validations rapides et à fort signal s’exécutent en premier et que les problèmes soient découverts avant le début du travail coûteux. Dès qu’un échec bloquant est connu, arrêtez immédiatement : continuer ne peut pas changer le résultat et ne fait que gaspiller temps et ressources de calcul. Une détection précoce donne aussi du feedback aux développeurs alors que le contexte de leur changement est encore frais.
Garder un feedback rapide
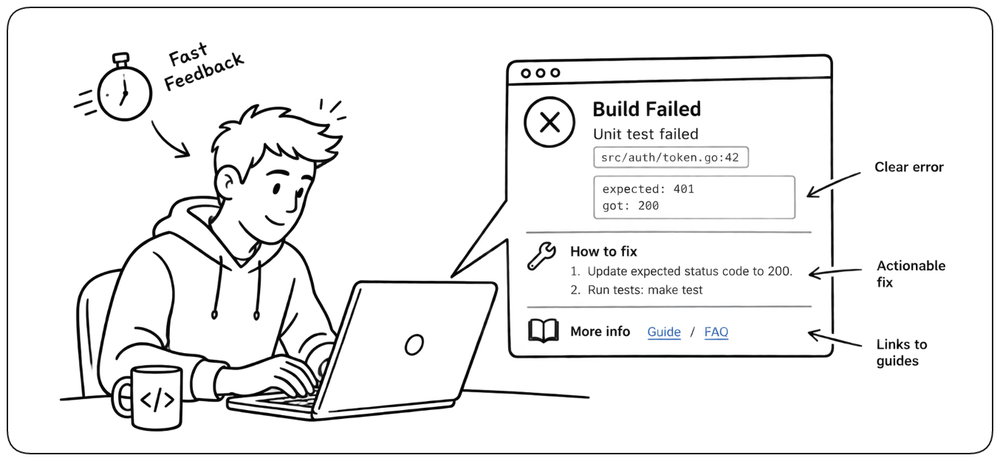
Le build doit renvoyer des résultats utiles assez vite pour que les développeurs restent dans le contexte de leur changement. Le feedback doit être clair et précis, montrant ce qui a échoué et pourquoi, afin de corriger rapidement. Un feedback rapide et exploitable encourage les petites intégrations et la correction immédiate ; un feedback lent, vague ou peu fiable encourage le regroupement des changements et les contournements.
Ne jamais contourner le chemin vers la production
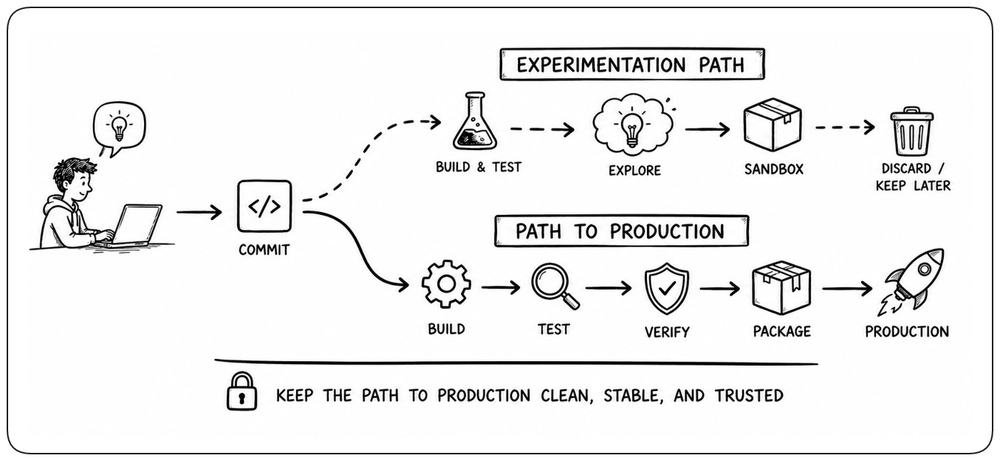
Chaque changement de production doit emprunter le même chemin de confiance vers la production. Ce chemin crée les preuves qui rendent un artefact digne de confiance : builds, tests, contrôles de sécurité et autres validations requises. Les builds manuels ou les itinéraires alternatifs contournent ces garanties. L’expérimentation peut utiliser des workflows plus légers, mais tout ce qui est destiné à la production doit finir par revenir sur le chemin de confiance.
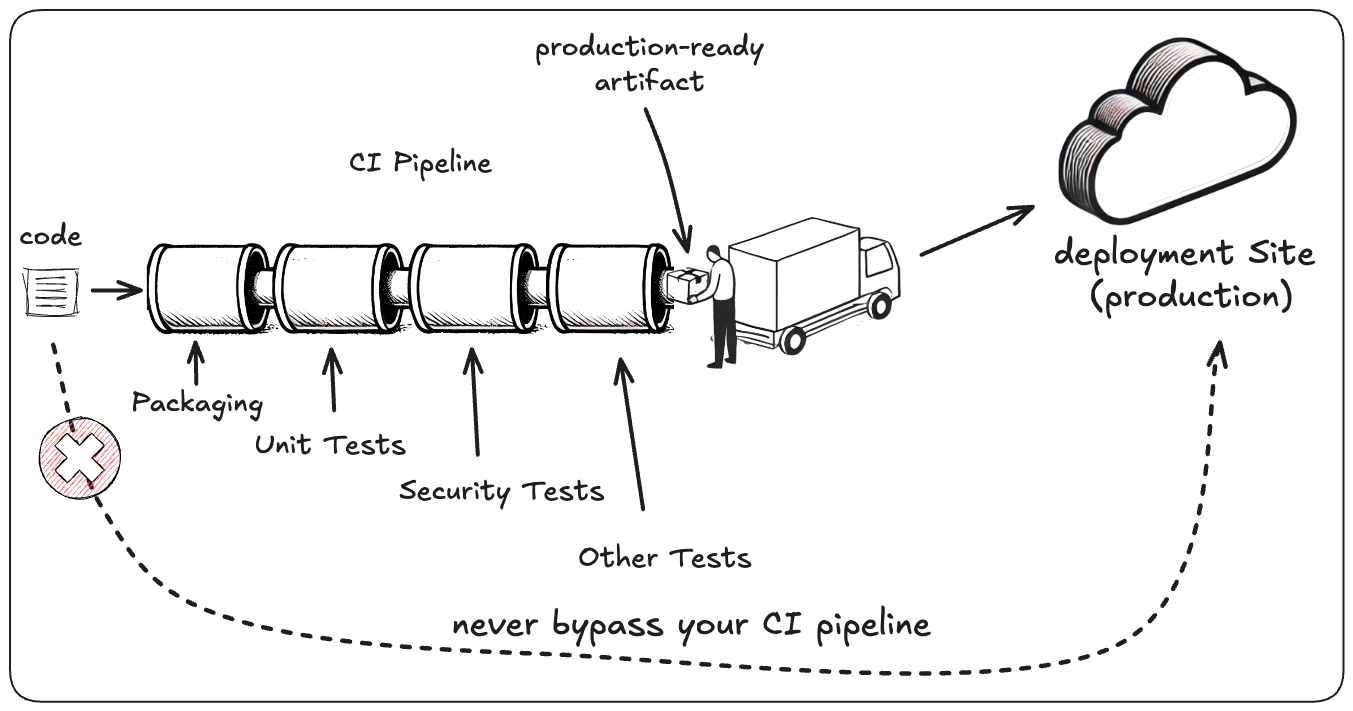
Garder le chemin vers la production au vert
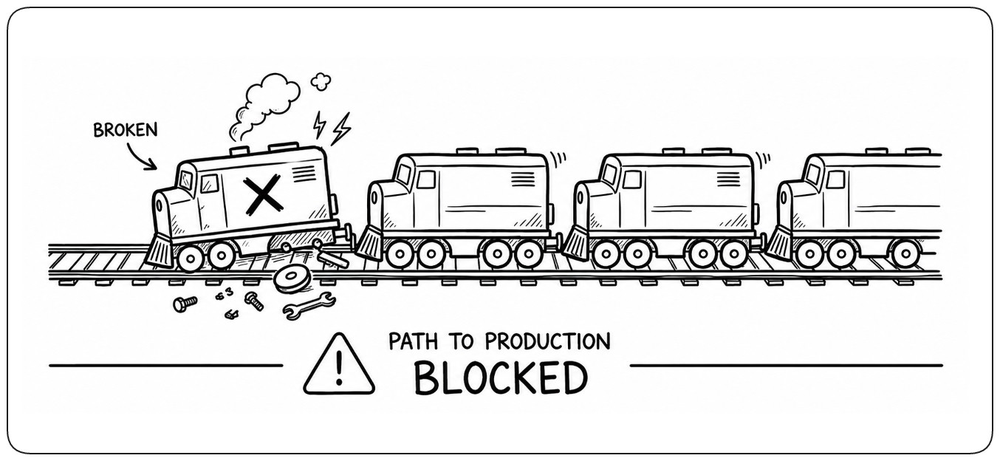
Le chemin vers la production doit rester sain et digne de confiance pour que les changements continuent d’avancer. Un échec à n’importe quel endroit de ce chemin peut bloquer builds, intégrations et livraisons pour toute l’équipe. Il rend aussi chaque résultat moins fiable : les développeurs ne peuvent plus savoir si un échec vient de leur propre changement ou d’un système déjà cassé. Quand le chemin est cassé, le rétablir devient la priorité : corriger rapidement le problème ou annuler (revert) le changement fautif avant de reprendre le travail normal.
Rendre la santé du build visible
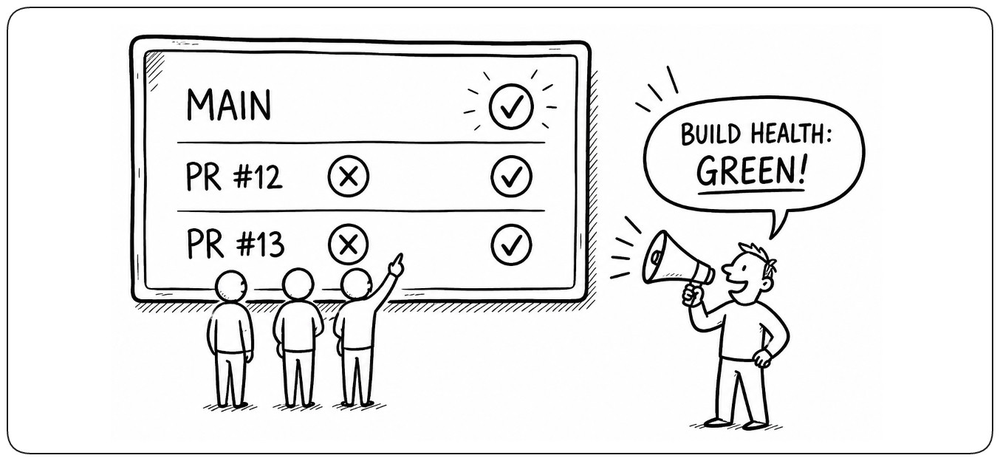
La santé de master et des changements proposés doit être immédiatement visible pour tous. Les échecs de build, les validations bloquées et les autres signaux qui rendent une révision risquée doivent être difficiles à manquer. La visibilité fait de la santé du build une responsabilité partagée et empêche l’échec de devenir un bruit de fond accepté.
Le processus de build
Un build transforme une révision précise du code source en artefact validé. Il part d’un changement exact, l’exécute dans un environnement contrôlé, le valide et le transforme progressivement, puis se termine par la publication d’un artefact identifiable, prêt à être déployé. Cette section suit ce processus pas à pas. Ces fondations posées, nous pouvons maintenant suivre ce qui arrive réellement à un changement lorsqu’il traverse le build.
Déclencheurs de build
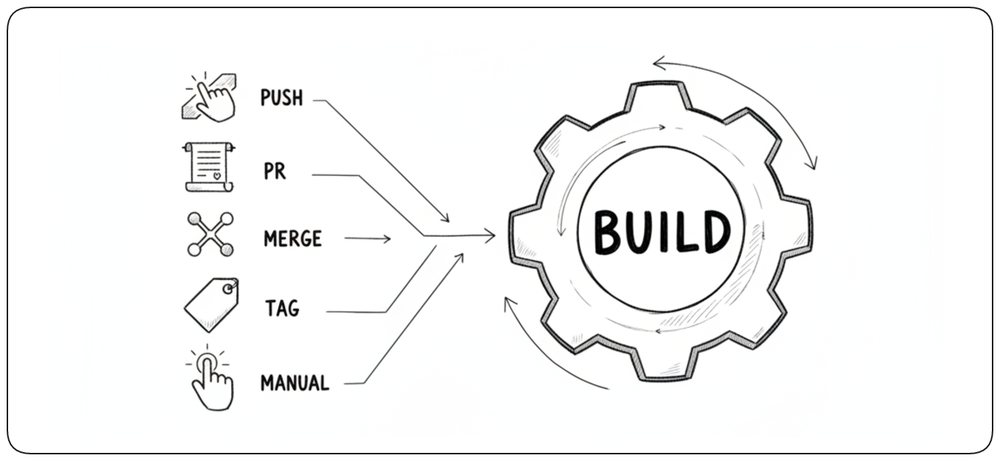
Un déclencheur de build est l’événement qui lance l’exécution d’un build. Un push, une pull request, un merge ou un tag peuvent démarrer le build et faire entrer un changement dans le chemin vers la production. Les déclencheurs relient un événement de développement concret à une exécution précise du build, ce qui montre clairement pourquoi le build a tourné et quel changement il valide.
Partir d’un état propre et exact
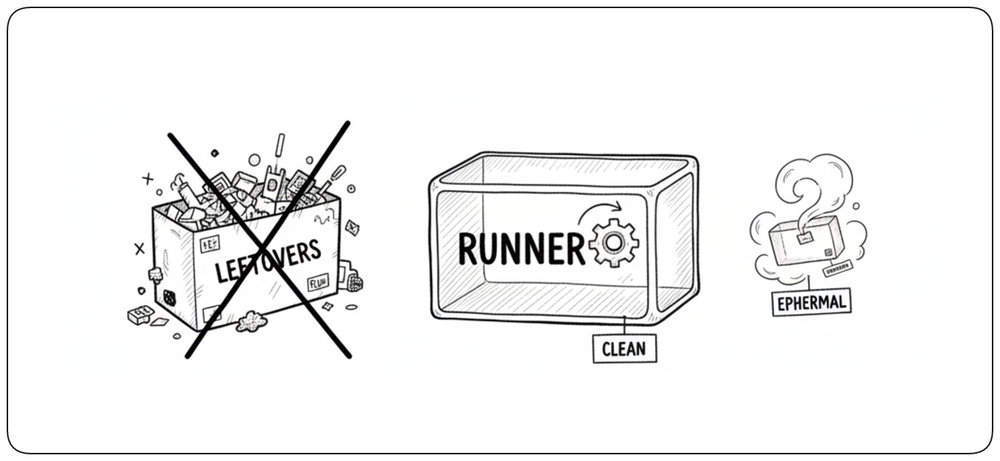
Chaque build doit partir d’un environnement propre et prévisible, et de la révision exacte du code source qu’il doit valider. Un environnement propre ne signifie pas éviter les caches : dépendances, sorties de build ou autres données réutilisables peuvent être mises en cache pour améliorer les performances, tant que le cache est géré explicitement et ne devient pas un état de build caché. Des runners ou conteneurs éphémères empêchent l’état non maîtrisé des builds précédents d’influencer le résultat, tandis que le checkout d’un SHA de commit précis garantit que le code source est connu et traçable.
Exécuter d’abord les vérifications peu coûteuses
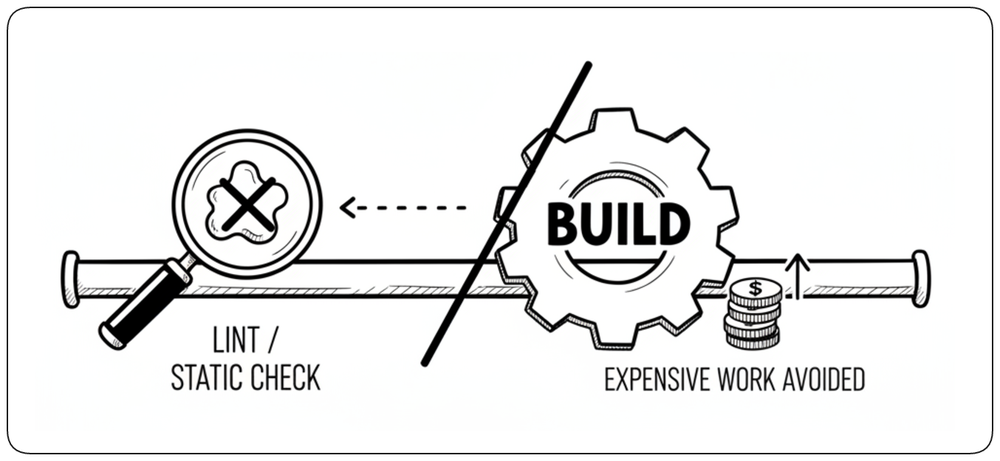
Ordonnez les vérifications du build pour que les validations peu coûteuses et à fort signal s’exécutent avant le travail coûteux. Linters, validation de configuration et analyse statique peuvent rejeter de nombreux problèmes avant le début de la compilation, du packaging ou des tests d’intégration. Cela réduit à la fois le temps de feedback et le gaspillage de calcul.
Construire le logiciel
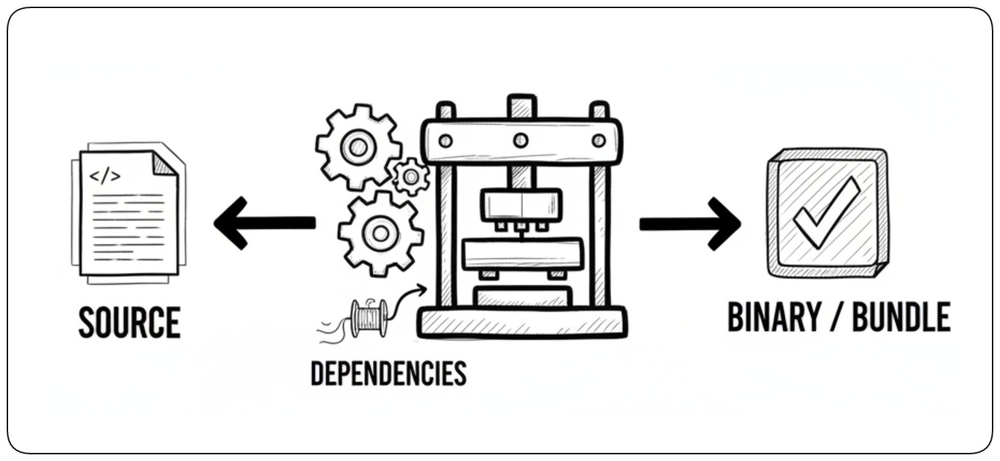
Le build transforme le code source en logiciel utilisable. Selon la technologie, cela peut signifier compiler le code en binaire, le transpiler ou générer du code exécutable. Cette étape vérifie que le code source et ses dépendances déclarées peuvent être construits avec succès.
Exécuter les tests rapides
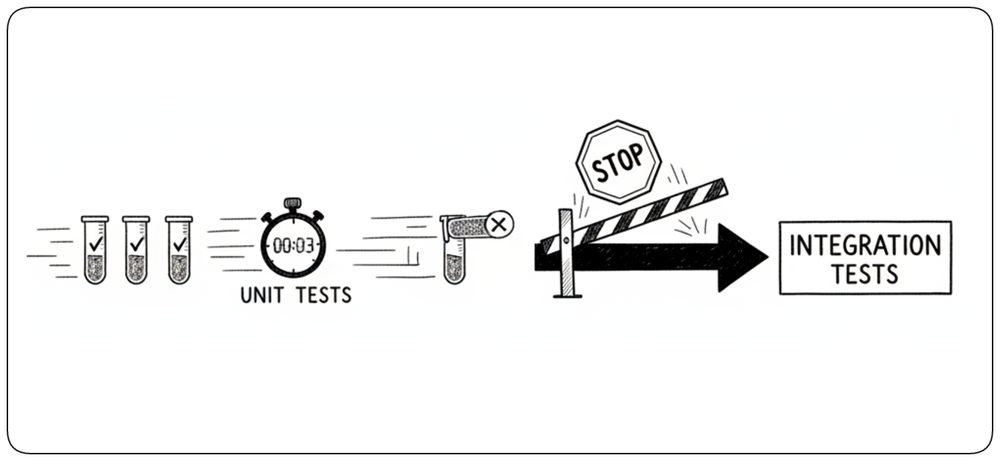
Des tests automatisés rapides vérifient le comportement avant que l’artefact ne progresse plus loin dans le build. Les tests unitaires forment généralement la première couche de tests, car ils sont rapides, isolés et donnent un feedback précis lorsqu’un changement casse un comportement existant. Un échec bloquant doit arrêter immédiatement les étapes suivantes.
Empaqueter l’artefact
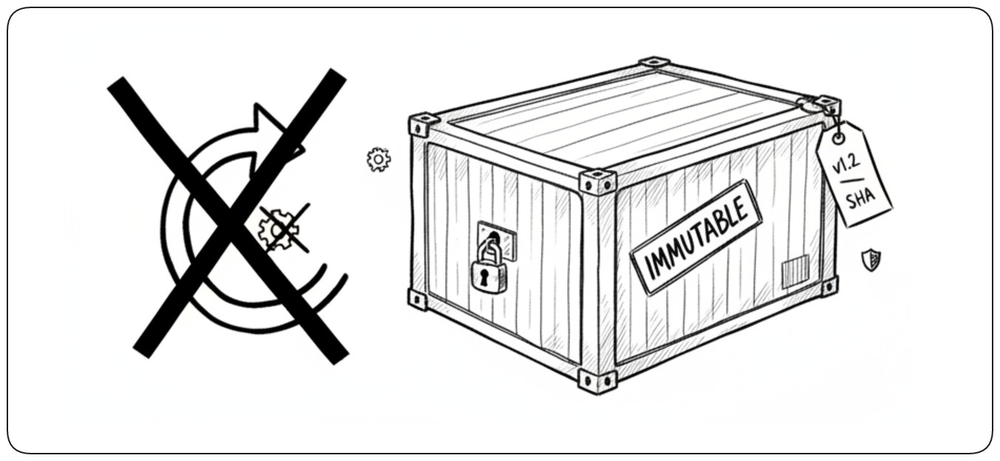
Une fois le logiciel construit et ses vérifications rapides passées, empaquetez-le dans un artefact immuable qui peut circuler le long du chemin vers la production. Cela peut signifier créer une image de conteneur, une archive, un chart Helm ou tout autre paquet déployable. À partir de là, les tests suivants, le staging et le déploiement doivent utiliser cet artefact exact plutôt que le reconstruire.
Exécuter les tests d’intégration
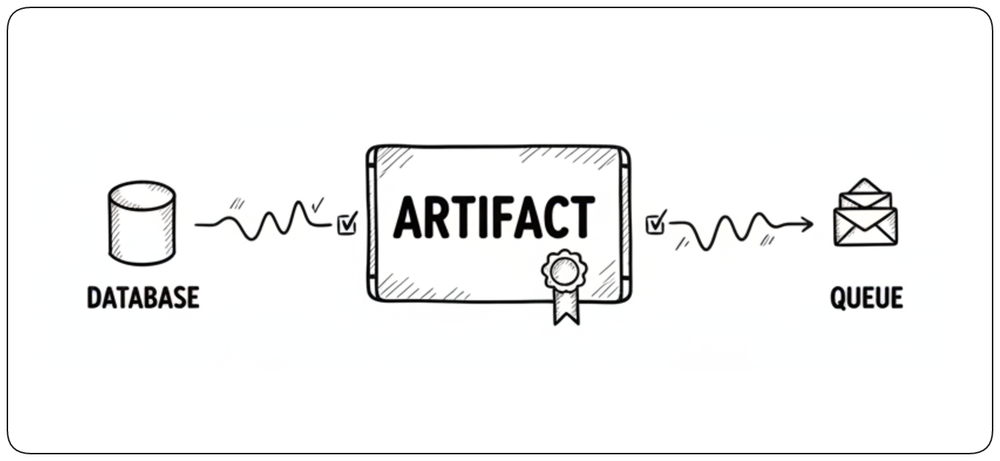
Certains problèmes n’apparaissent que lorsque l’application empaquetée interagit avec de vraies dépendances. Les tests d’intégration peuvent démarrer l’artefact avec des bases de données, des files d’attente ou d’autres services et vérifier que ces interactions fonctionnent correctement. Tester l’artefact empaqueté renforce la confiance que cette même unité pourra ensuite être déployée.
Publier l’artefact validé
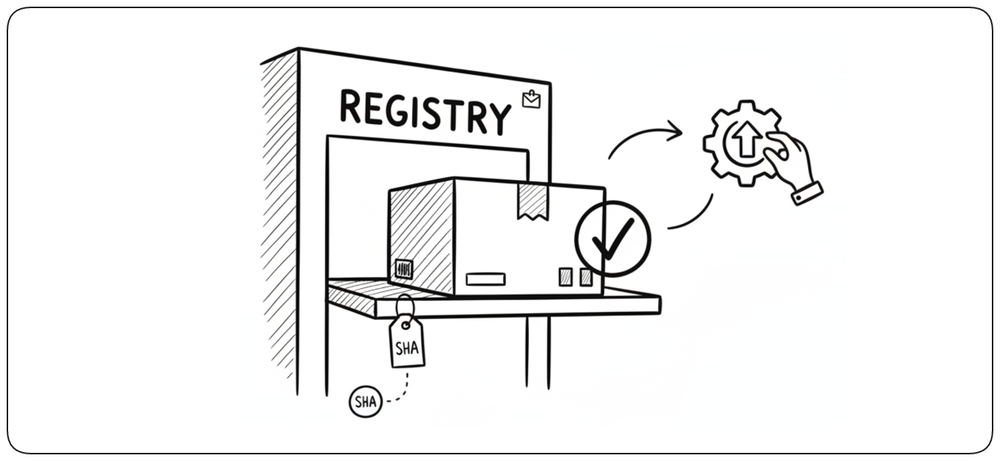
Une fois les vérifications requises passées, l’artefact est publié dans un dépôt ou un registry où les systèmes de déploiement peuvent le récupérer. La publication doit préserver son identité immuable ainsi que son lien avec le commit source et les résultats de validation. Le build est alors terminé : le code source est devenu un artefact validé et traçable, prêt à être déployé.
Comment l’IA transforme le processus de build
L’IA ne remplace pas le processus de build. Elle change la vitesse et l’échelle auxquelles le travail y entre. Code, tests, configuration et changements d’infrastructure peuvent désormais être générés en quelques secondes, mais chaque changement doit toujours gagner la confiance en suivant le même chemin, de la source à l’artefact validé. Une fois ce processus compris, la question suivante est : que se passe-t-il quand l’IA augmente radicalement le rythme auquel les changements y entrent ?
L’IA augmente le flux de changements
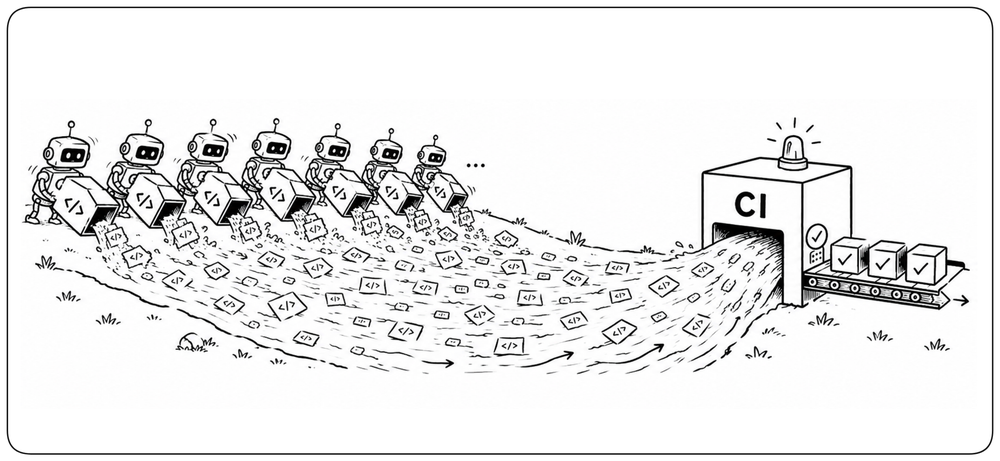
Les agents IA peuvent générer du code, des tests, de la configuration et des changements d’infrastructure bien plus vite que les développeurs ne pourraient les produire manuellement. Le build reçoit donc un flux de changements proposés beaucoup plus important et plus continu. La CI ne peut plus être conçue autour de la vitesse de codage humaine ; elle doit pouvoir absorber, filtrer et valider des changements au volume de la génération automatique.
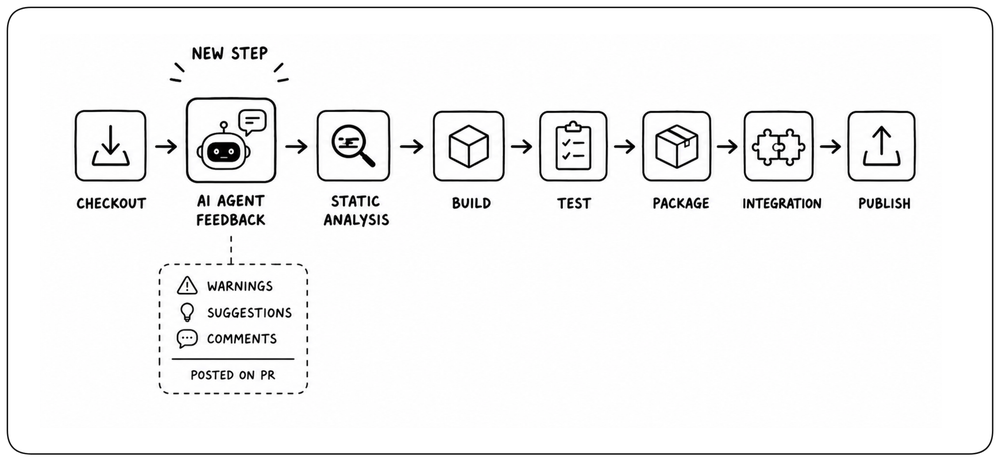
Ajouter une revue précoce par des agents
Ajoutez une revue par des agents tôt dans le processus de build partagé, afin d’identifier les problèmes potentiels pendant que le reste du pipeline continue. Les agents peuvent inspecter le changement à la recherche de défauts, d’incohérences, de travail manquant ou de choix de conception discutables, et publier leurs constats sous forme de commentaires sur la pull request. Ces constats sont consultatifs plutôt que bloquants : les développeurs peuvent y donner suite ou décider de continuer. Cela ajoute un signal de feedback précoce sans allonger le chemin critique du build.
Faire de la revue un système multi-agents
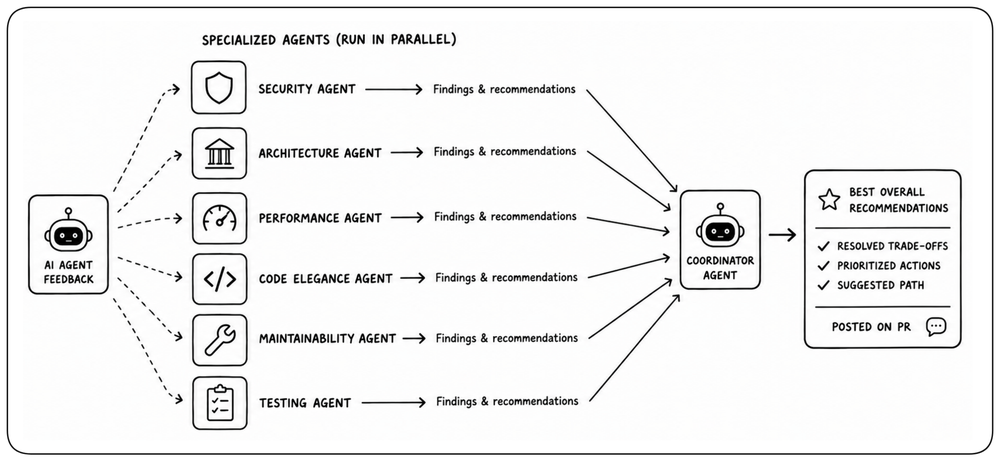
Pour tirer le meilleur de l’IA dans la revue de code, évitez de dépendre d’un seul agent généraliste pour tout. Donnez aux agents des rôles clairs et spécialisés au sein du système : l’un peut se concentrer sur la sécurité, un autre sur l’architecture, la performance, les tests, la qualité du code ou la maintenabilité. La spécialisation permet à chaque agent d’appliquer un raisonnement plus profond à une préoccupation plus étroite, tandis que le système de revue combine ces perspectives en une évaluation plus complète du changement.
L’IA exige une plateforme de validation scalable
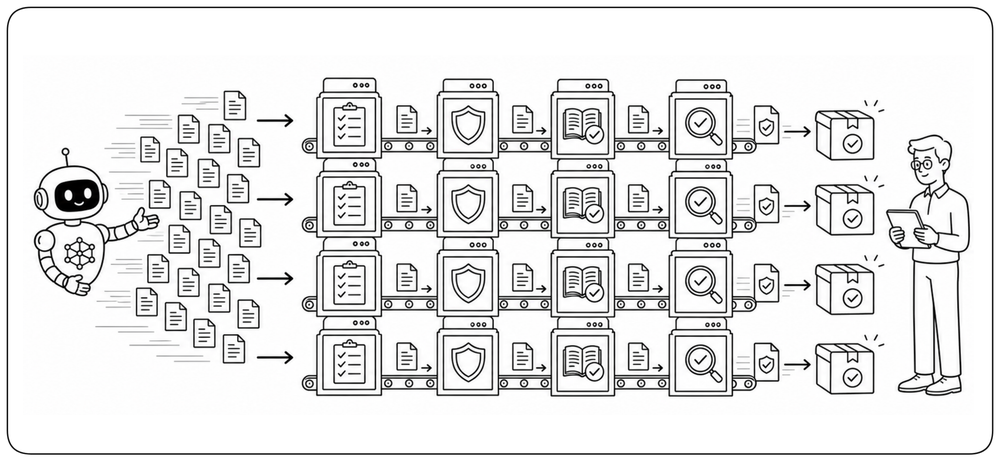
Quand l’IA peut générer et relire des changements à vitesse machine, l’auteur du code et la seule revue humaine ne suffisent plus à garantir que chaque changement est sûr. La confiance doit venir de preuves indépendantes et déterministes produites par le build : reproductibilité, tests, contrôles de sécurité, politiques, validation de contrats et artefacts traçables. À mesure que le volume de changements générés par l’IA augmente, la plateforme qui produit ces preuves doit monter en charge avec lui, en gardant une validation rapide, fiable et fortement automatisée sans devenir le prochain goulot d’étranglement. Qu’un changement ait été écrit par une personne ou par un agent, il doit gagner la confiance par le même chemin.
La revue humaine monte d’un niveau
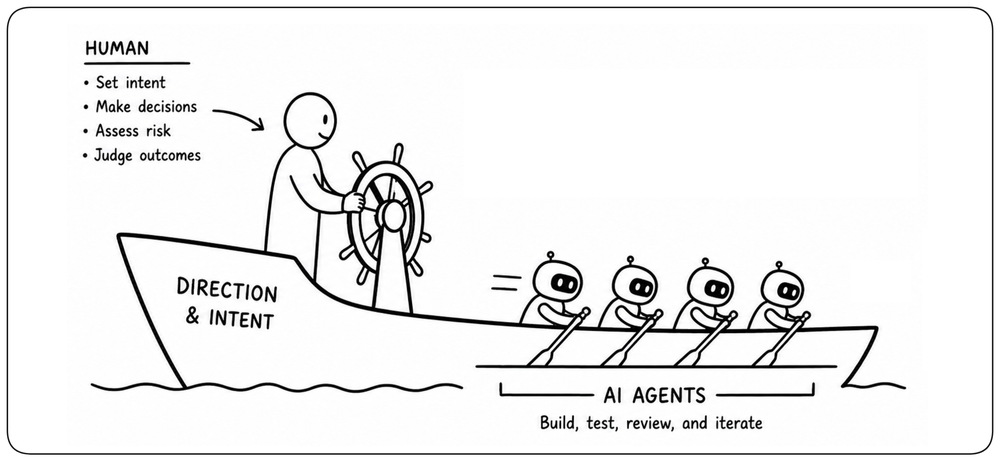
À mesure que les agents IA prennent en charge davantage d’implémentation et de revue technique, les humains doivent éviter de devenir le goulot d’étranglement en micro-managant chaque détail. Leur rôle se déplace vers la définition de l’intention, les décisions d’architecture, l’évaluation des risques et le jugement des résultats. L’IA ne peut passer à l’échelle l’exécution que si les humains apprennent à passer à l’échelle la délégation.
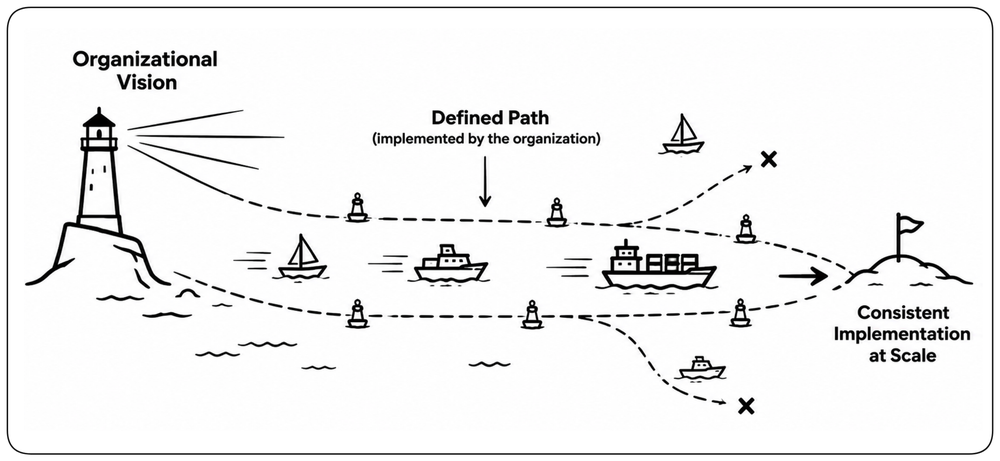
Rendre la vision de l’organisation exécutable
La vision d’une organisation ne doit pas vivre uniquement dans des principes et de la documentation. Les standards d’architecture, de sécurité, de qualité, de conformité et d’ingénierie traduisent cette vision en attentes concrètes sur la façon de construire le logiciel. Partout où ces attentes peuvent être exprimées de façon déterministe, encodez-les sous forme de contrôles automatisés. La vision de l’organisation peut ainsi s’appliquer de manière cohérente à chaque équipe, chaque développeur et chaque agent IA, sans compter sur des humains pour la faire respecter changement par changement.
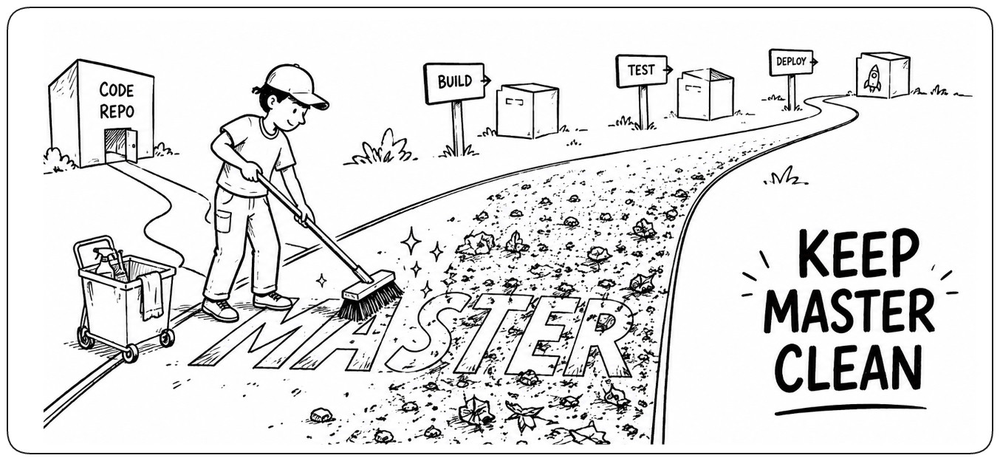
Garder master propre
Master est le point d’intégration partagé du développement en cours. Quand il casse, il peut bloquer tout le chemin vers la production et empêcher tous les autres d’avancer. Comment garder master propre sans en faire un obstacle au développement ? À mesure que davantage de changements traversent le build, garder en bonne santé le point d’intégration partagé devient de plus en plus important.
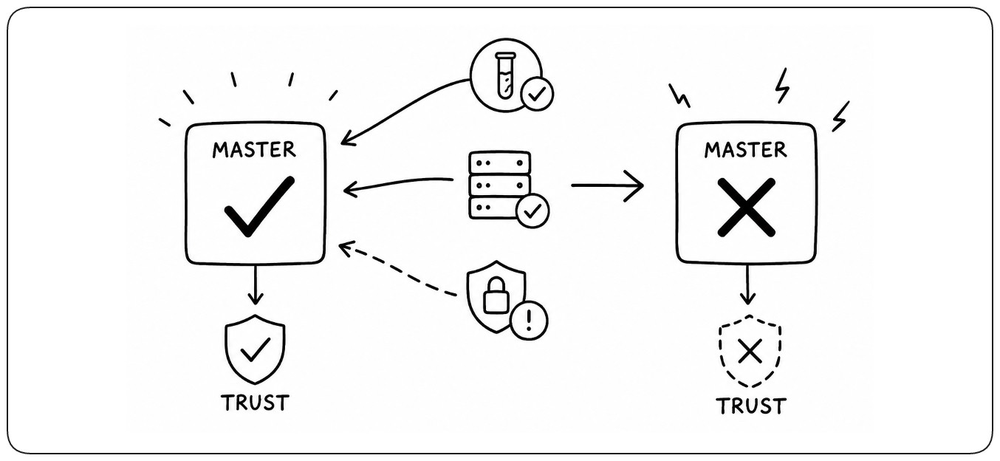
Ce qui rend master sain
Un master sain est un master pour lequel les preuves disponibles continuent de justifier la confiance. Un build réussi établit d’abord cette confiance, mais des preuves ultérieures peuvent l’invalider : un test asynchrone peut échouer, un environnement d’intégration peut révéler un problème, ou une vulnérabilité peut être découverte. La santé de master ne se limite donc pas au moment où le build passe au vert. Quand de nouvelles preuves rendent une révision risquée, master doit être considéré comme cassé jusqu’à ce que la confiance soit rétablie.
Offrir un espace sûr pour expérimenter
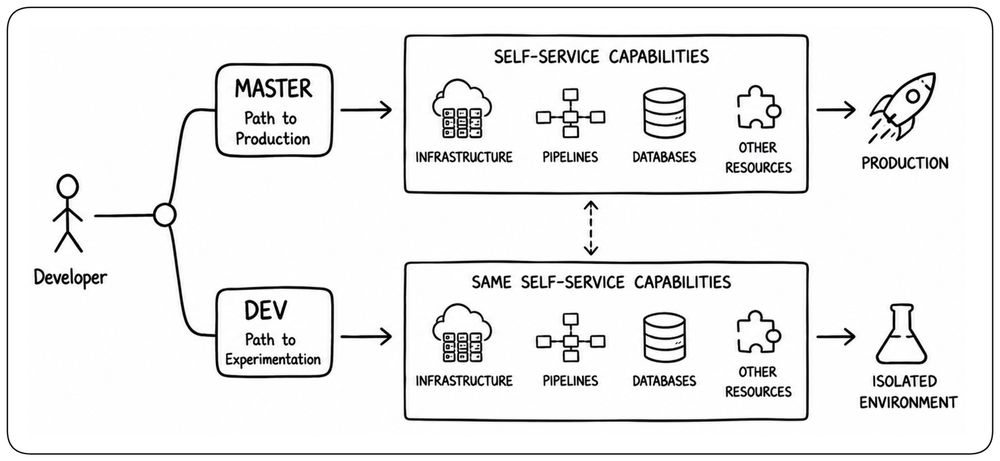
Les développeurs ont besoin d’un moyen sûr de construire, déployer et valider des changements inachevés sans mettre master en danger. Un environnement d’expérimentation séparé leur permet de tester librement sans utiliser le chemin vers la production comme terrain d’essai. Offrir cet espace supprime l’une des causes profondes d’un master cassé.
Étendre le self-service au chemin d’expérimentation
Les capacités en self-service ne doivent pas exister uniquement sur le chemin vers la production. Si les équipes ne peuvent créer infrastructure, pipelines, bases de données ou autres ressources de plateforme qu’après un merge sur master, elles sont forcées d’utiliser master pour expérimenter. Le chemin d’expérimentation doit offrir des capacités self-service équivalentes sous une forme isolée, afin que les équipes puissent valider les changements de plateforme et d’infrastructure avant qu’ils n’atteignent master.
Protéger master des changements non validés
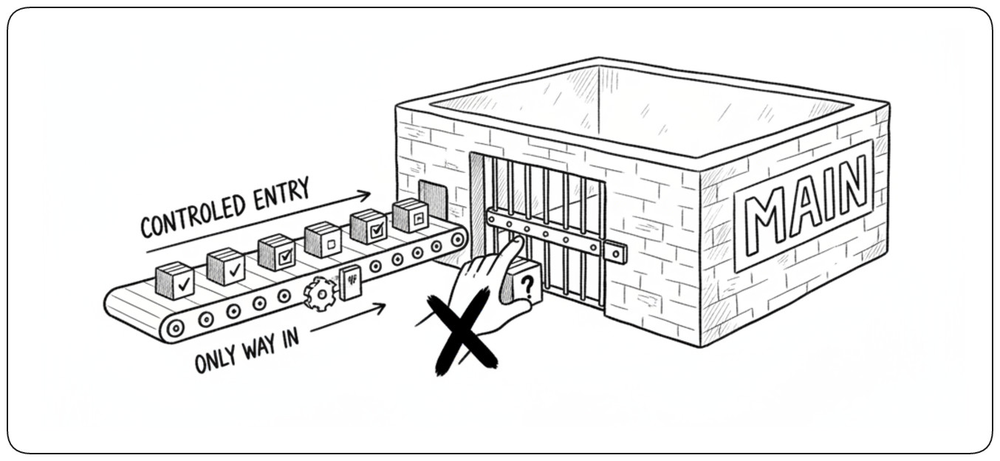
Une fois que les développeurs disposent d’un endroit sûr pour expérimenter, master ne doit accepter que des changements ayant passé la validation requise. La protection de branche peut imposer des builds réussis, des contrôles automatisés et une revue avant le merge. Master ne doit jamais devenir l’endroit où un changement est testé pour la première fois.
Relire avant que les changements n’atteignent master
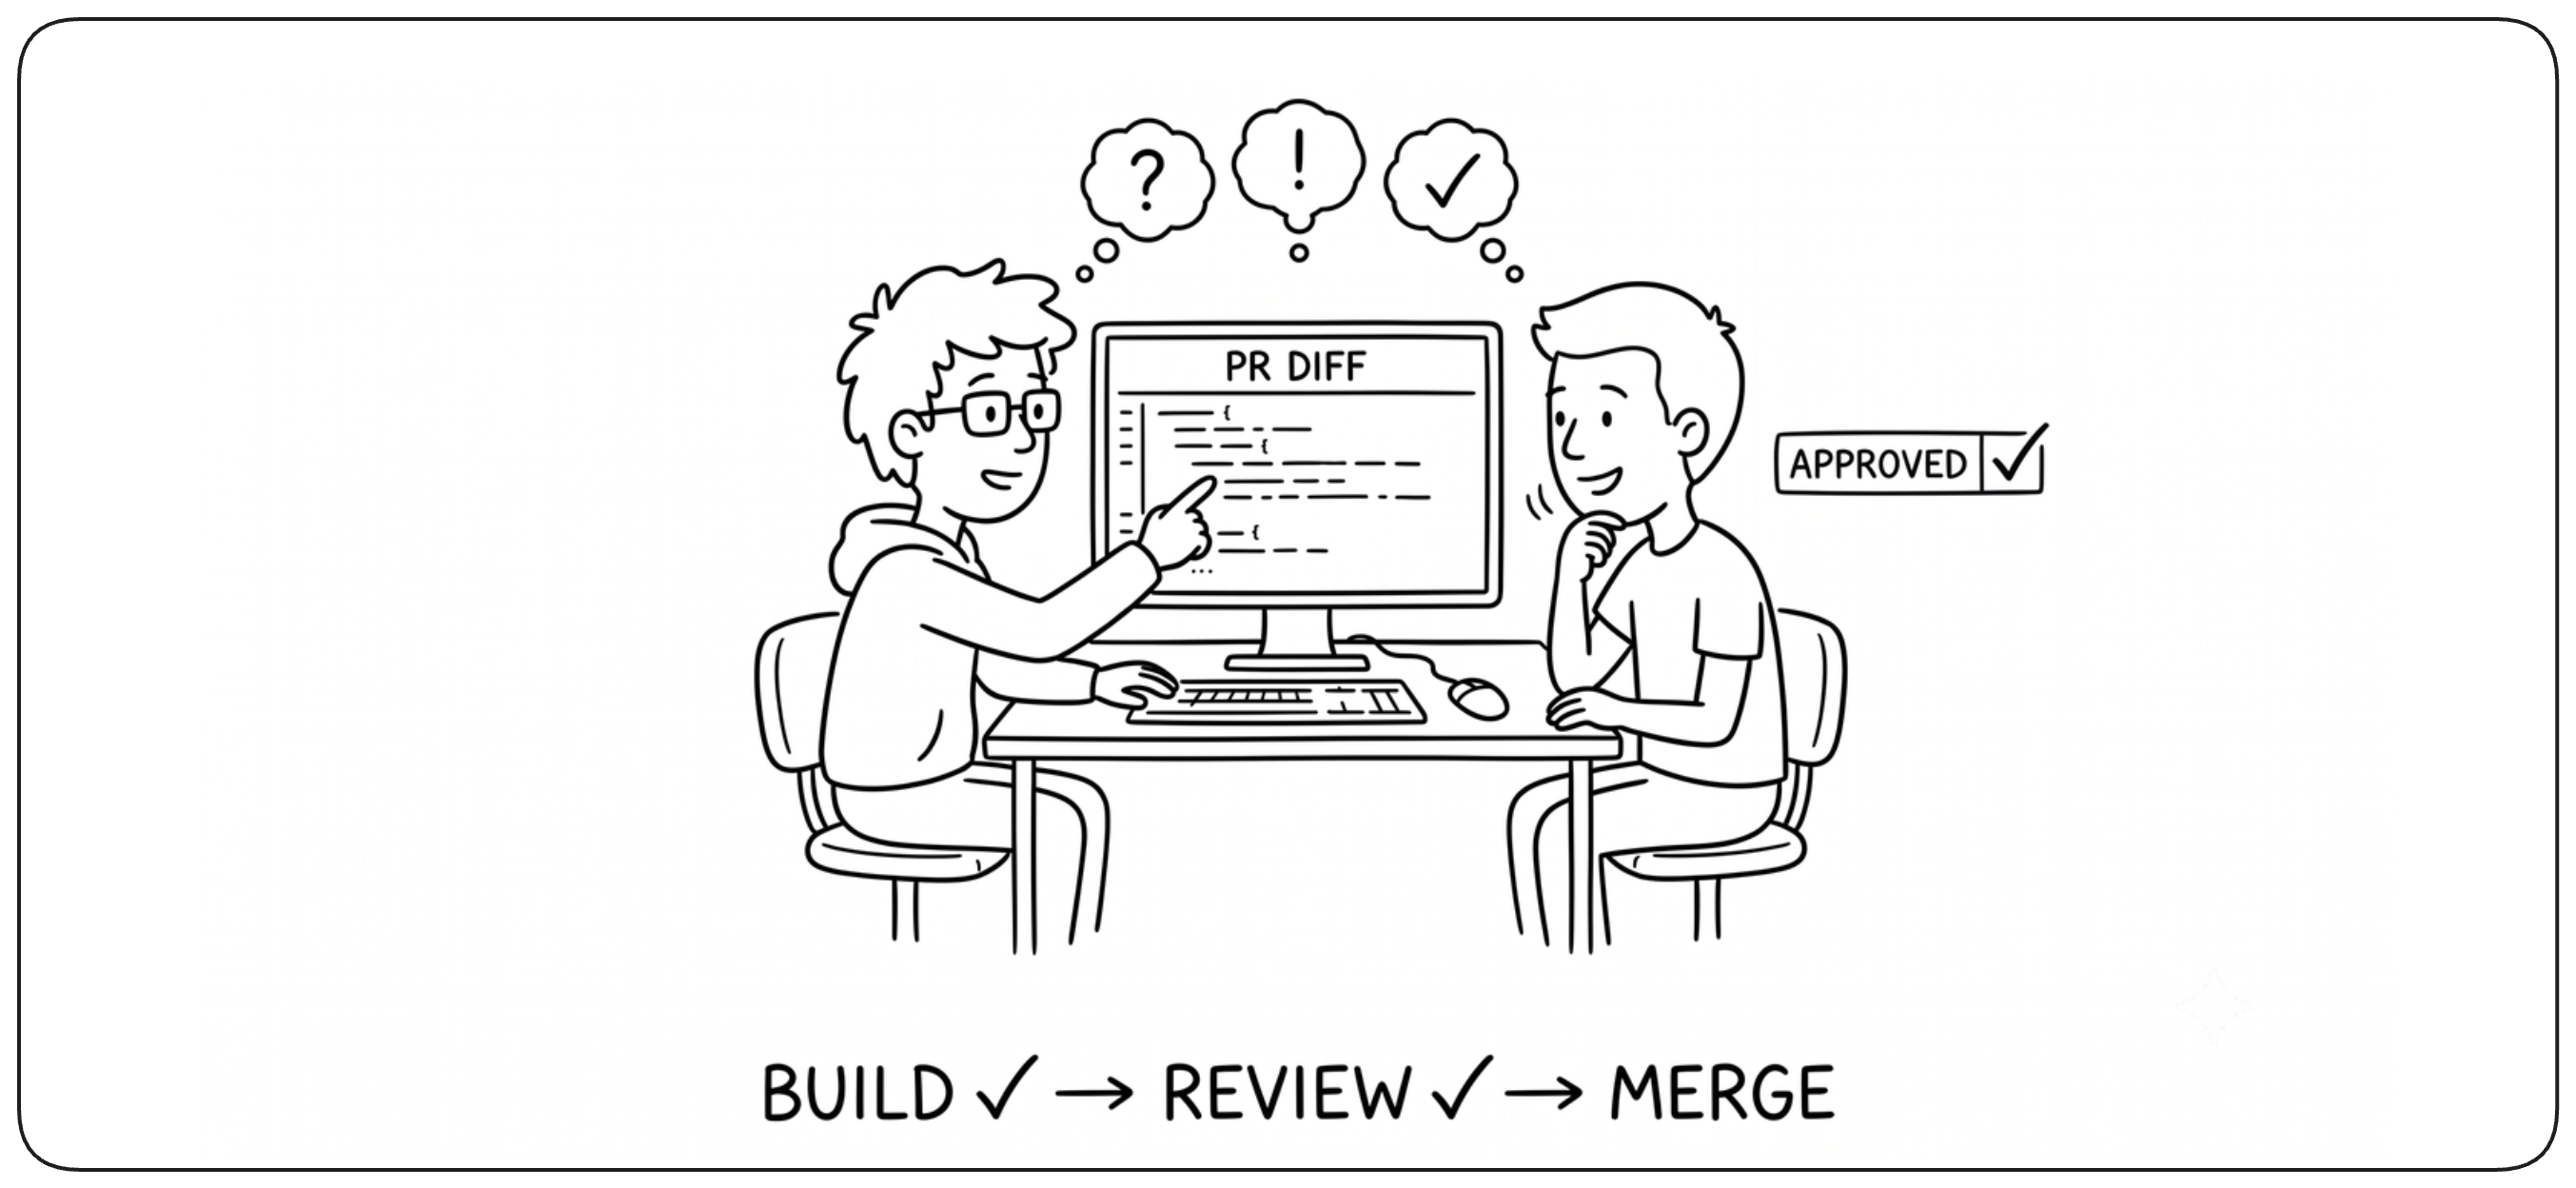
Les contrôles automatisés peuvent vérifier de nombreuses propriétés d’un changement, mais ils ne peuvent pas pleinement juger l’intention, la conception ou la maintenabilité. La revue de code ajoute un jugement humain avant qu’un changement n’atteigne master. Les revues sont les plus efficaces quand les changements sont petits et que l’automatisation a déjà traité ce que les machines peuvent vérifier.
Garder des changements petits
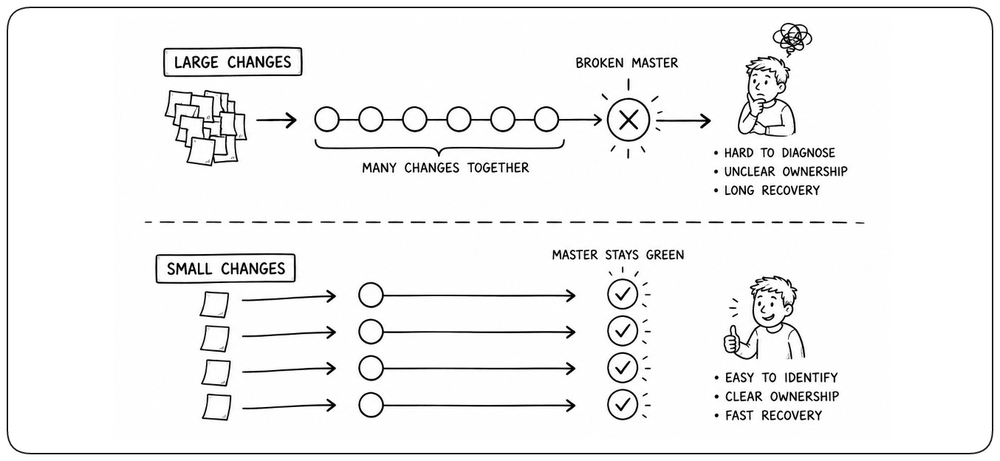
Quand de nombreux changements arrivent ensemble, un master cassé devient difficile à diagnostiquer. L’échec peut venir de plusieurs changements, la responsabilité devient floue et le rétablissement peut tourner à une longue investigation. De petits changements rendent les problèmes plus faciles à identifier, comprendre, corriger ou annuler. Plus le changement est petit, plus vite master peut revenir au vert.
Garder l’isolation courte
Chaque branche crée une isolation temporaire par rapport à master. Plus cette isolation dure, plus les deux côtés peuvent évoluer indépendamment et plus la réintégration devient difficile. Gardez les branches de courte durée pour que la divergence soit découverte et résolue tant qu’elle est encore petite.
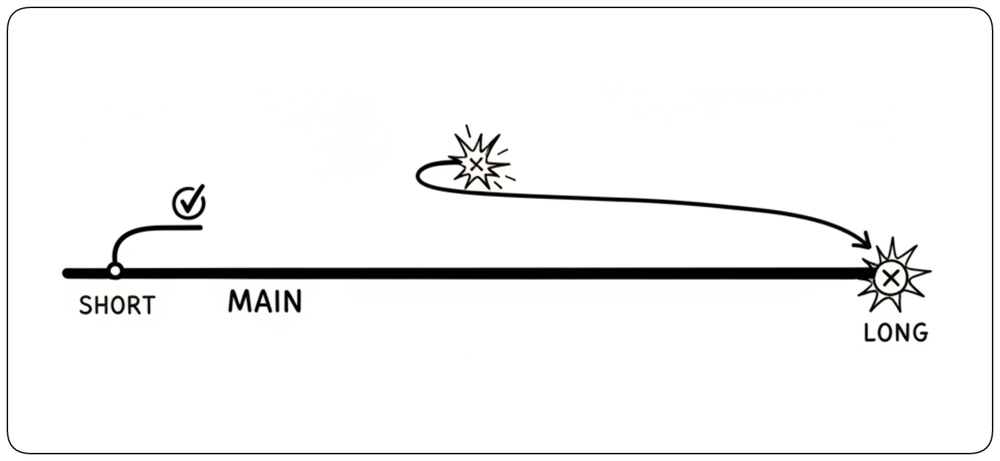
Intégrer fréquemment de petits changements
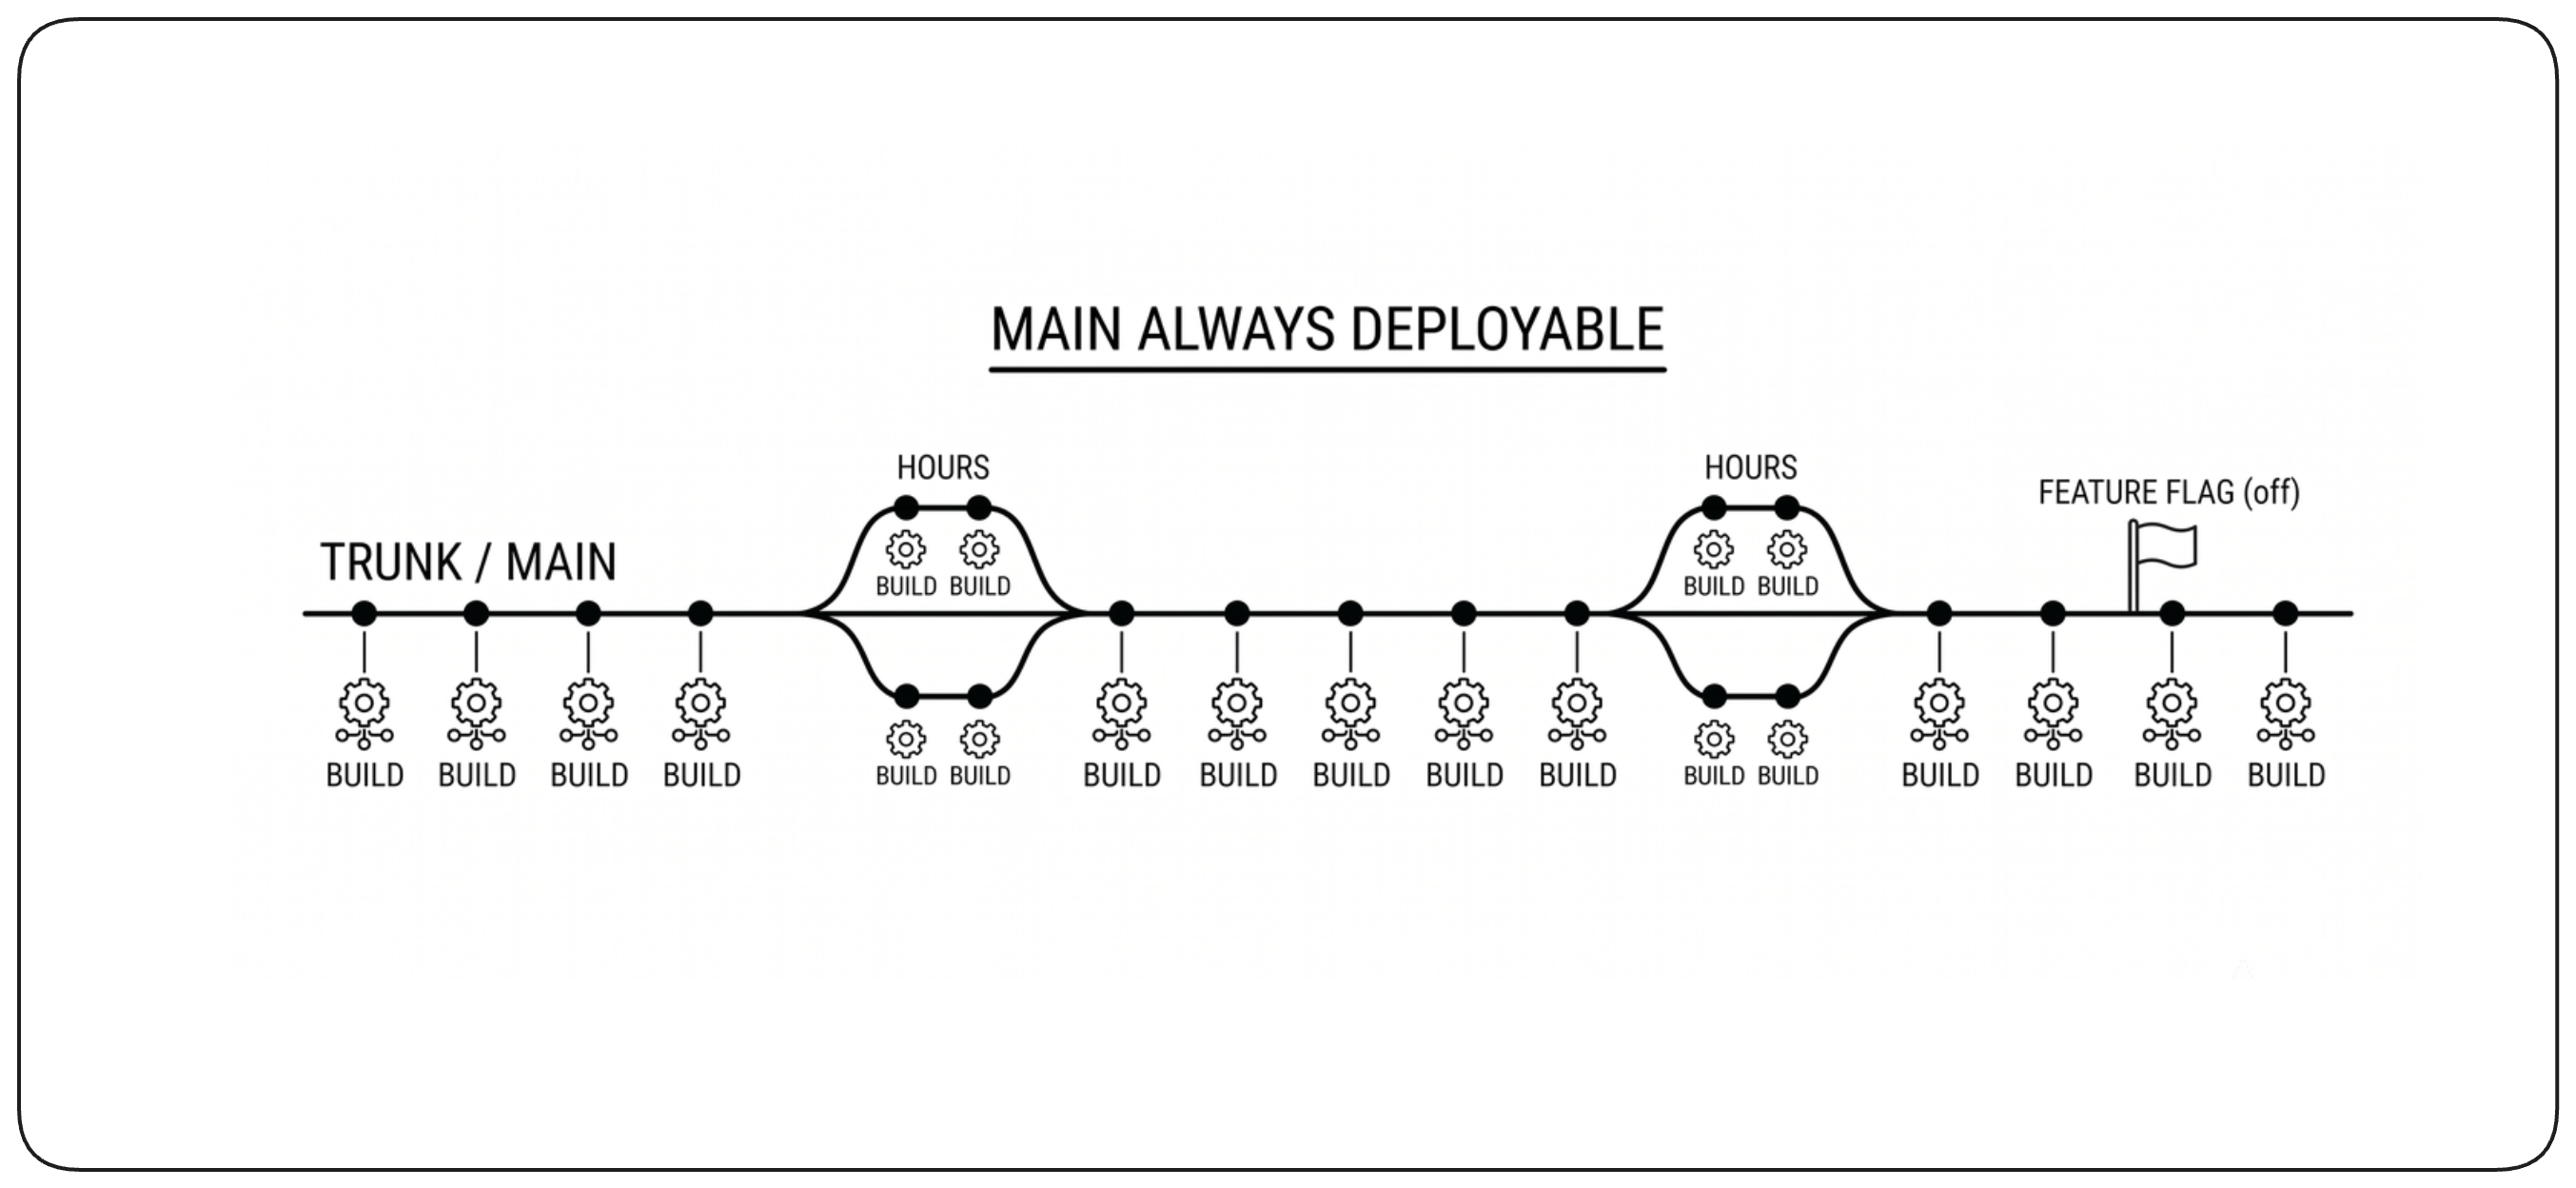
Le trunk-based development combine ces idées : garder des changements petits et une isolation courte. Les développeurs intègrent directement dans master ou via des branches de très courte durée, ce qui expose tôt les incompatibilités. Les feature flags permettent de garder cachées les fonctionnalités inachevées sans isoler le code.
Valider contre master avant le merge
La validation d’une pull request doit anticiper non seulement si le changement est correct en lui-même, mais aussi ce qui se passera quand il atteindra master. C’est particulièrement important dans les plateformes en self-service, où un merge peut créer dynamiquement des pipelines, de l’infrastructure ou d’autres ressources de plateforme qui n’existent pas encore pendant la validation de la pull request. Des contrôles comme les tests, la sécurité et la validation de politiques peuvent s’exécuter normalement, tandis que les actions ayant des effets réels sur la plateforme ou l’infrastructure doivent être simulées ou exécutées en mode dry-run avant le merge.
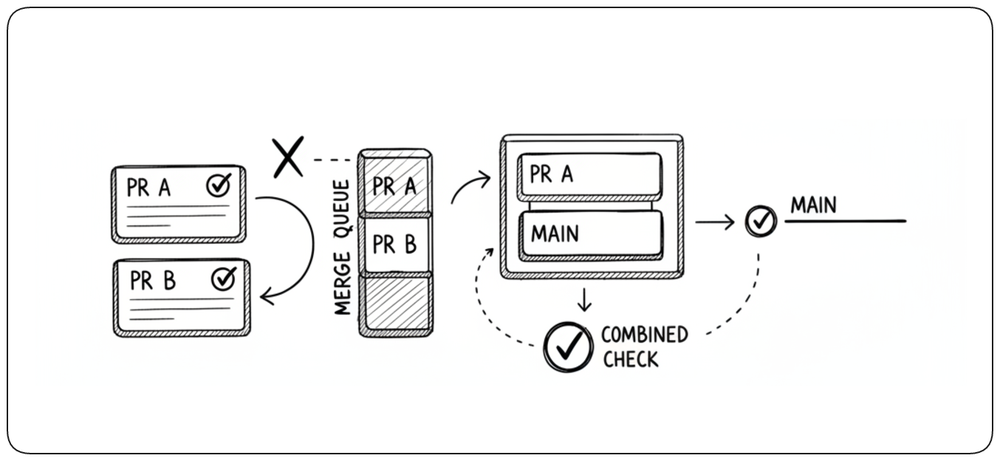
Sérialiser les changements avant qu’ils n’atteignent master
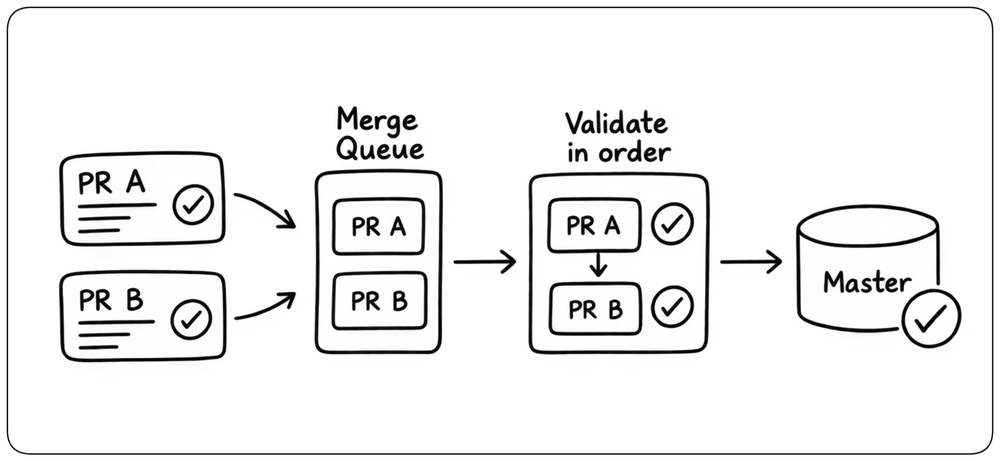
Quand plusieurs pull requests sont prêtes en même temps, les valider chacune indépendamment ne suffit pas. Une merge queue place les changements dans l’ordre et valide chacun contre l’état de master incluant les changements qui le précèdent. Cela évite que des pull requests individuellement valides ne cassent master une fois combinées.
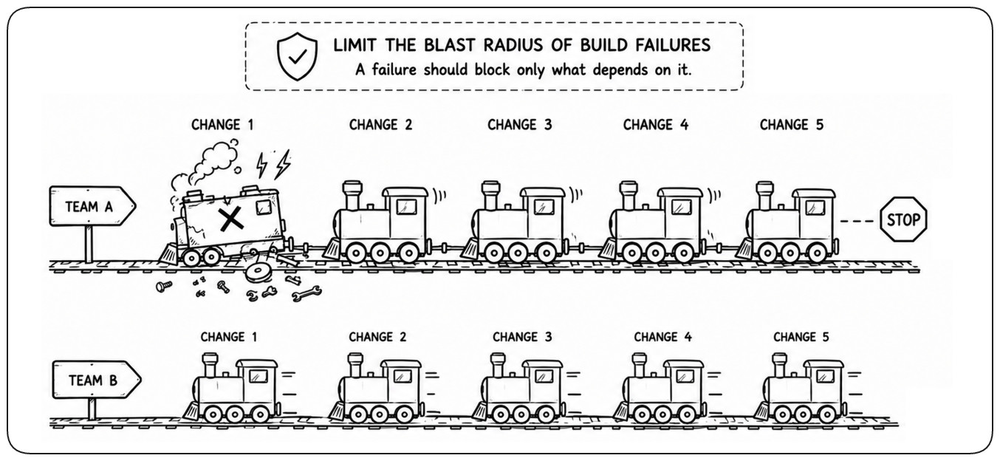
Limiter le rayon d’impact des échecs de build
Un échec ne doit bloquer que les parties du système qui en dépendent. Définissez des frontières de build pour que les composants et équipes sans lien puissent continuer d’avancer quand une partie échoue. Des pipelines séparés, des artefacts indépendants et des builds conscients des dépendances peuvent isoler les échecs, que le code vive dans un seul dépôt ou dans plusieurs.
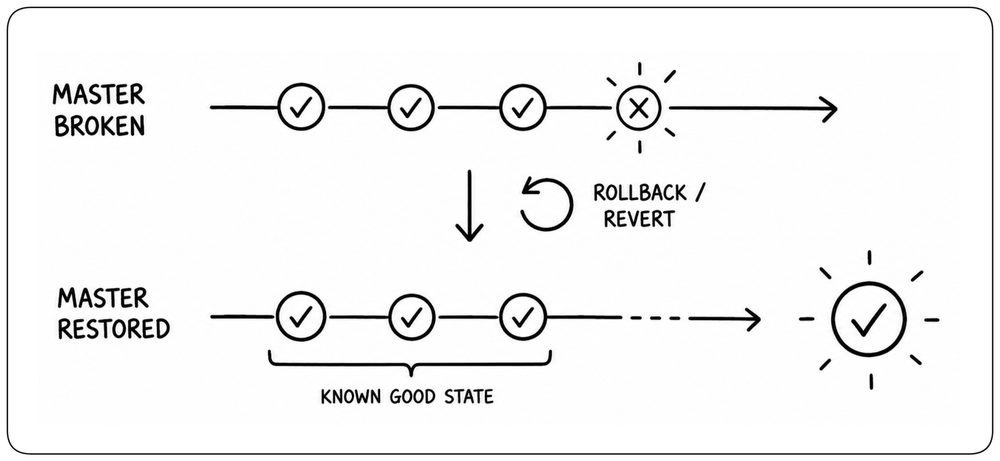
Quand master casse, le rétablir immédiatement
La prévention n’éliminera jamais tous les échecs. Quand master casse, le rétablir devient la priorité : corriger la cause immédiatement ou annuler (revert) le changement fautif avant de reprendre le travail normal. Un master cassé doit rester une exception de courte durée, jamais un état que l’équipe apprend à contourner.
Valider des changements sûrs
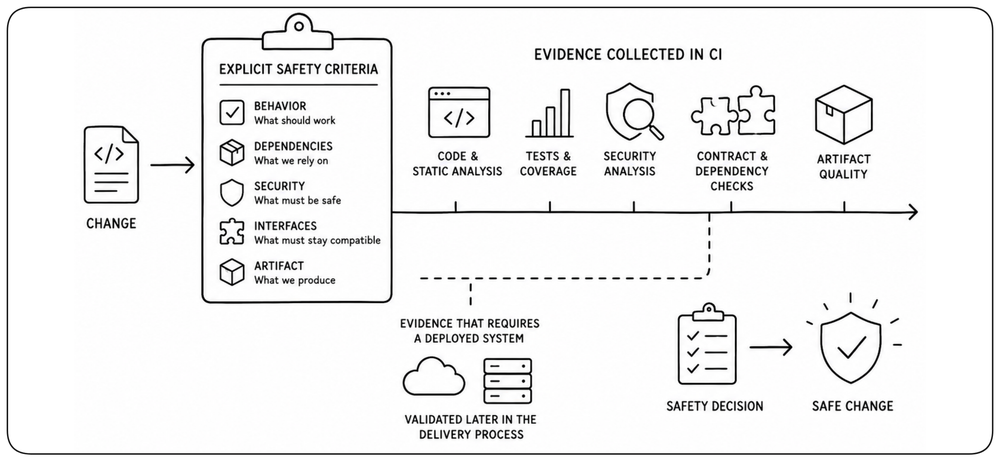
Valider un changement sûr exige des preuves sur le comportement, les dépendances, la sécurité et l’artefact produit par le build. Une grande partie de ces preuves vient des tests, mais les tests seuls ne suffisent pas. Cette section se concentre sur les validations qui relèvent de la CI ; la validation qui nécessite un système déployé est traitée dans Concevoir pour être livré.
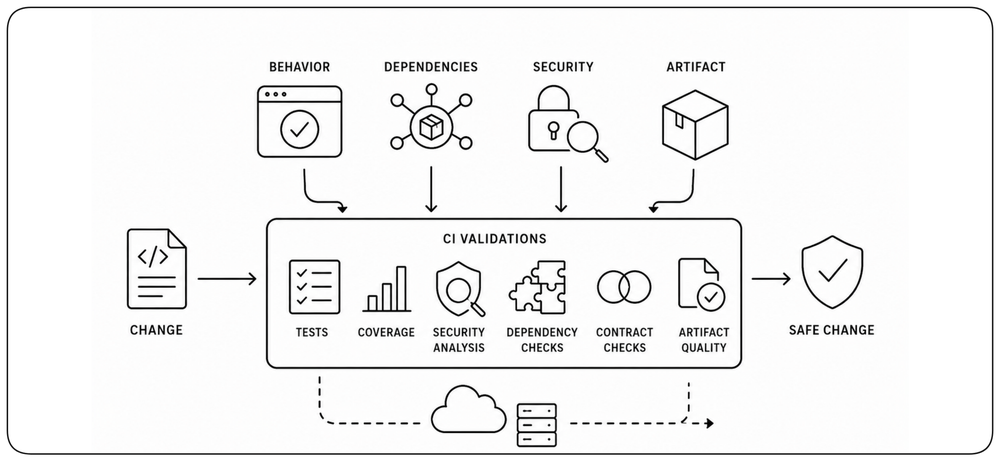
La sûreté vient de signaux multiples
Un changement ne doit pas être considéré comme sûr parce qu’un seul test ou une seule vérification a réussi. Différentes formes de validation exposent différents modes de défaillance et apportent différents types de confiance. La sûreté vient de la combinaison de signaux indépendants dont les forces et les limites se complètent.
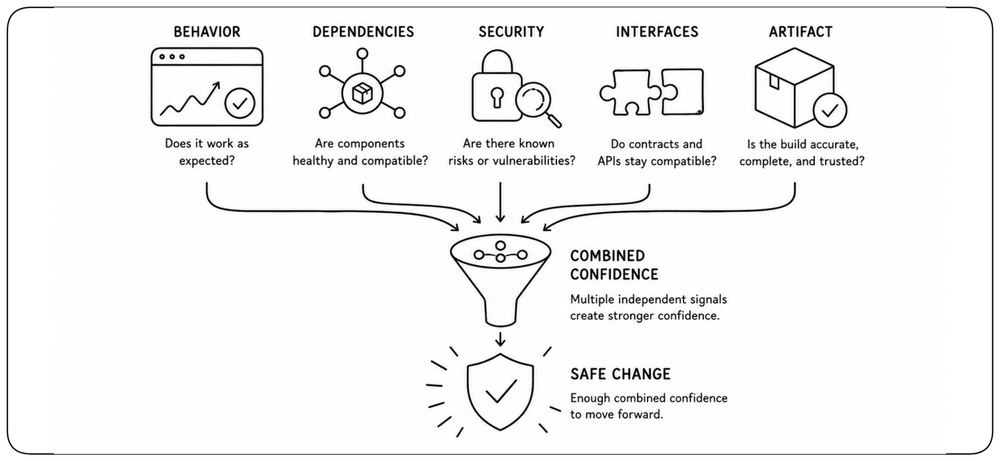
Rendre explicites les preuves de sûreté
Les preuves nécessaires pour faire confiance à un changement doivent être définies explicitement et collectées là où elles peuvent être établies de façon fiable. La CI peut évaluer des signaux issus du code, des dépendances, des interfaces, des tests, de l’analyse de sécurité et de l’artefact lui-même. Des critères clairs rendent les décisions de sûreté cohérentes, observables et automatisables.
Adapter les preuves requises au risque
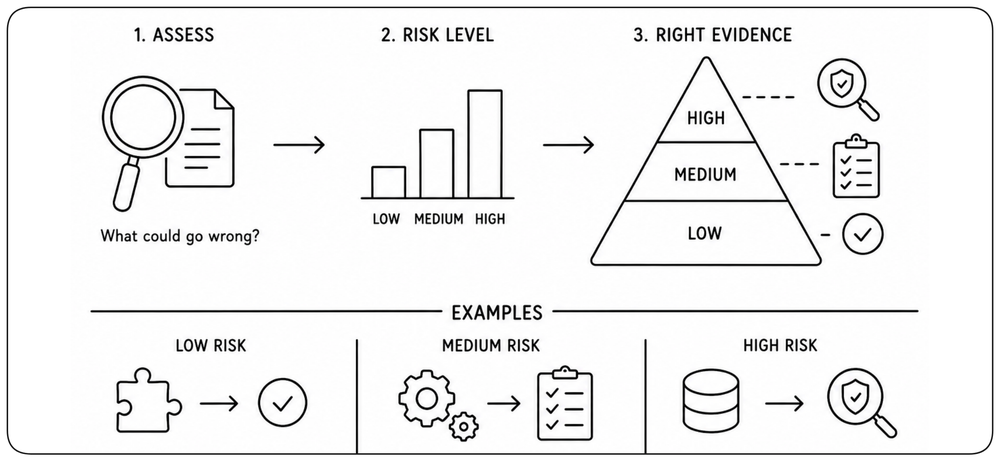
La quantité et la profondeur de la validation doivent refléter l’impact potentiel du changement. Une petite modification isolée peut n’exiger que des vérifications légères, tandis que les changements touchant l’authentification, les modèles de données, l’infrastructure ou les interfaces critiques peuvent exiger une validation plus approfondie et des conditions de blocage plus strictes.
Utiliser l’environnement de test crédible le plus petit
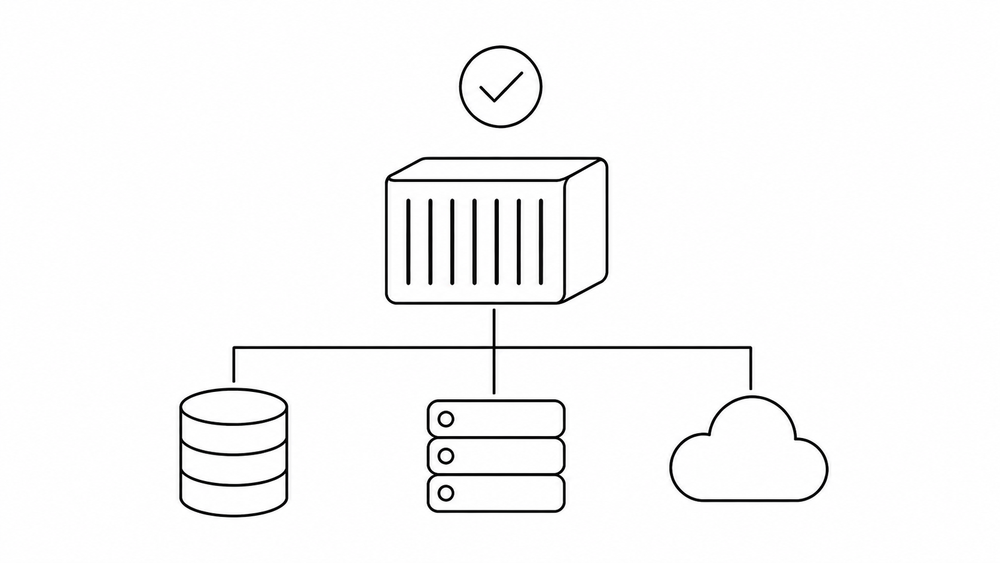
Un environnement de test ne doit être réaliste que dans la mesure où l’affirmation à vérifier l’exige. Les tests unitaires peuvent s’exécuter avec des dépendances isolées, tandis que les tests d’intégration peuvent nécessiter de vraies bases de données, des brokers ou des services créés temporairement pour le build. Ces environnements doivent rester reproductibles, jetables et indépendants des déploiements de longue durée. La validation qui exige un système déjà déployé appartient à une étape plus tardive du processus de livraison.
Validation comportementale : équilibrer vitesse et confiance
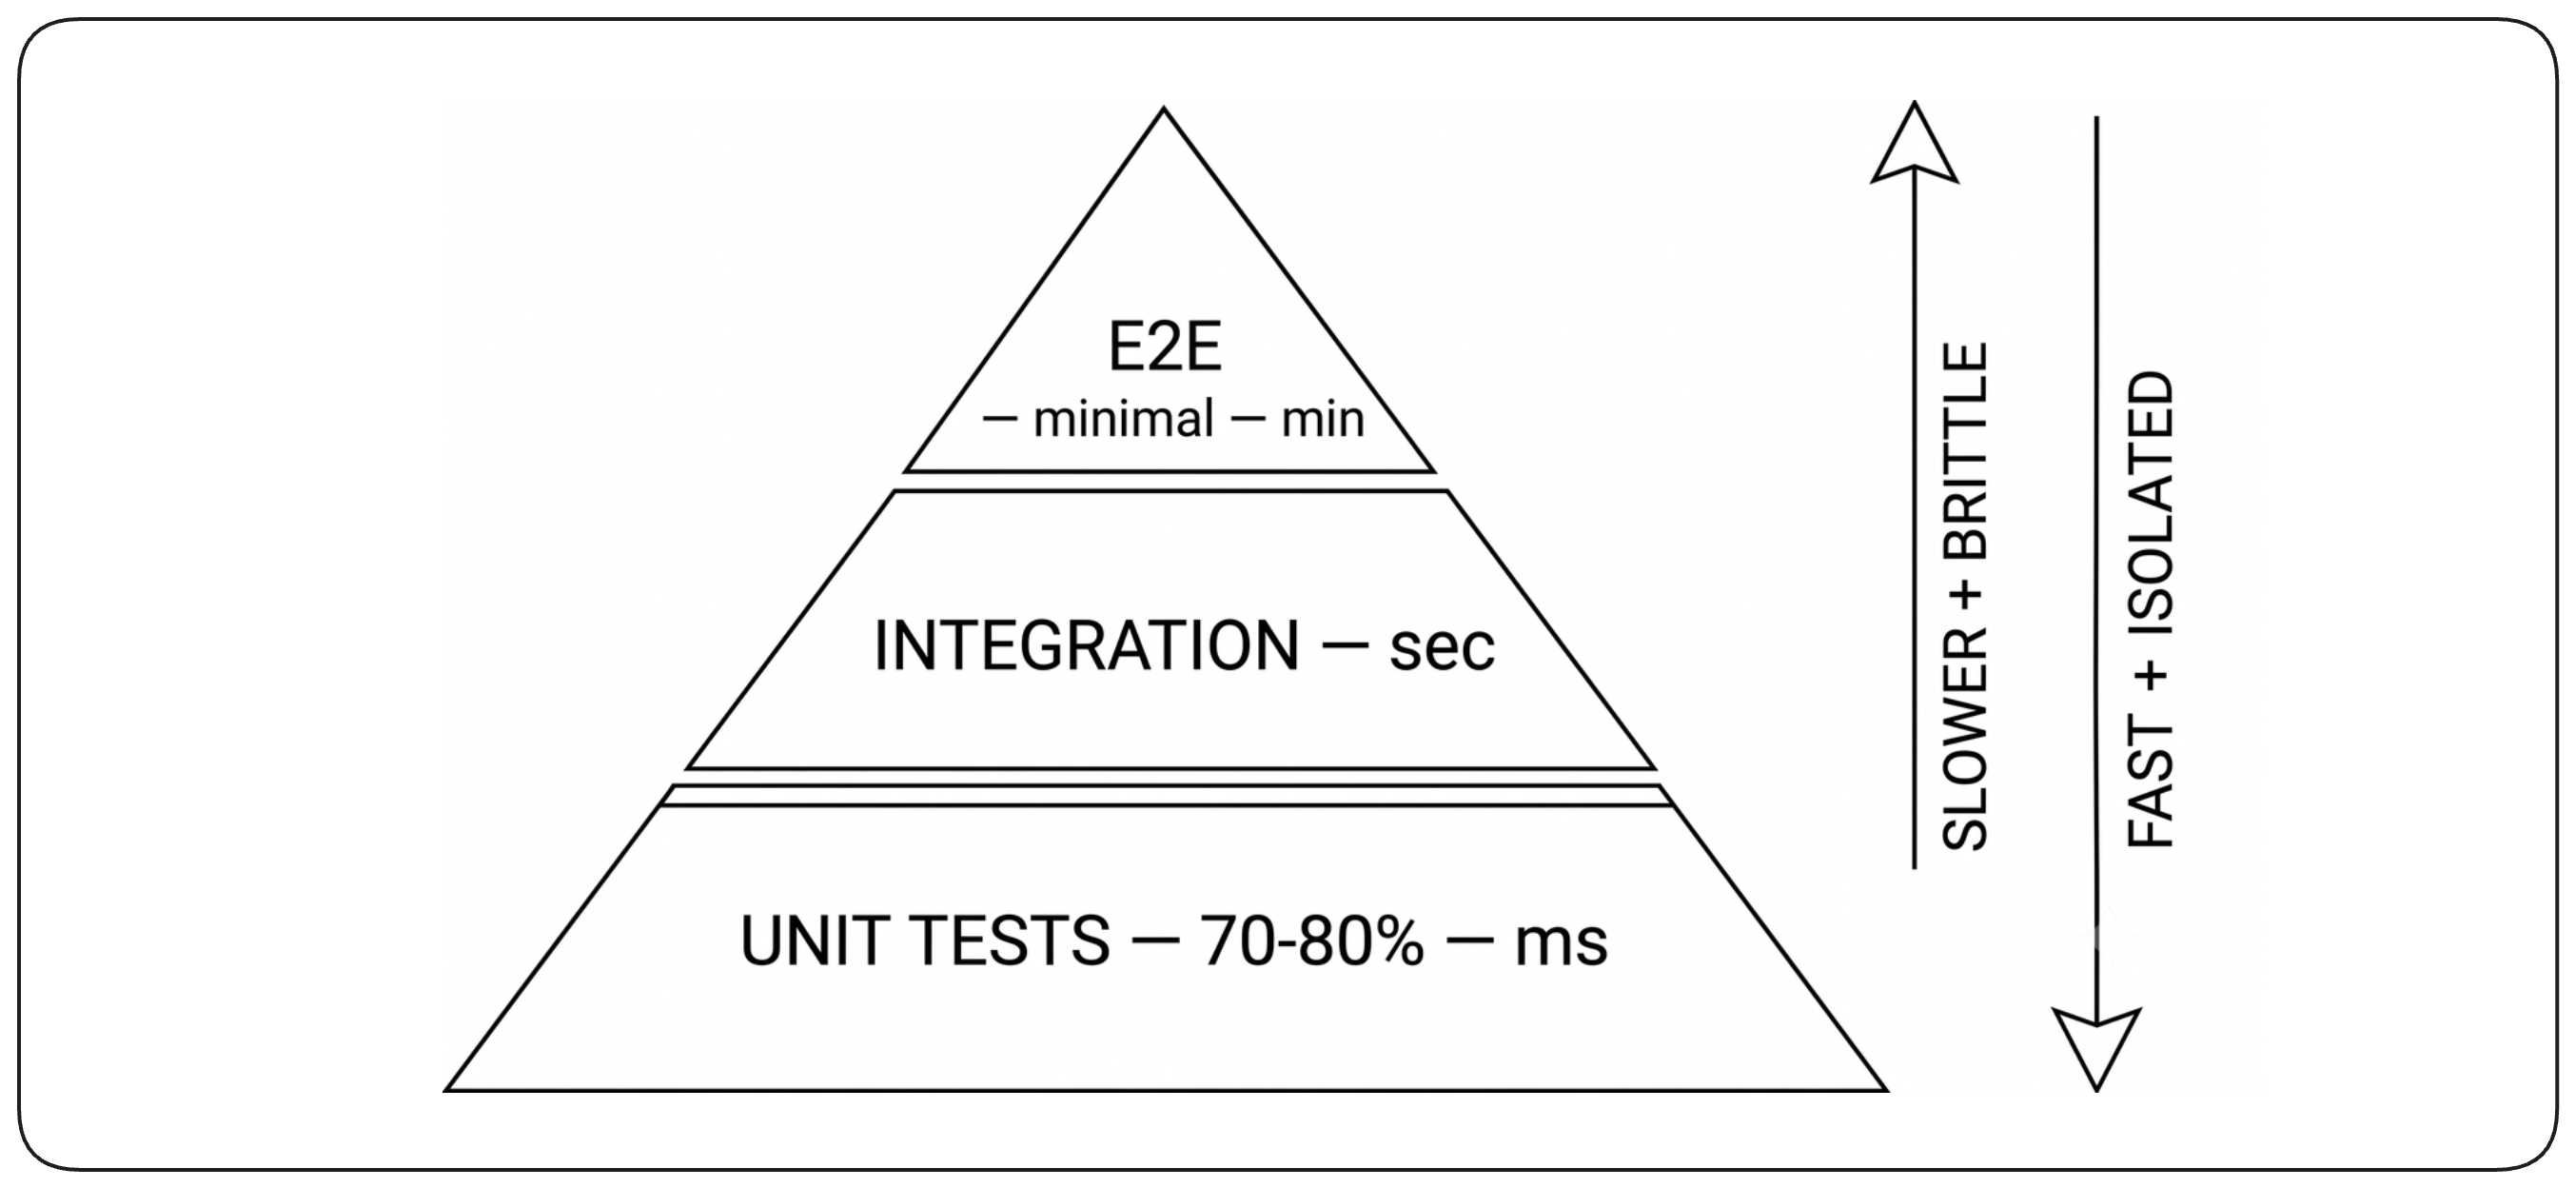
La validation comportementale vérifie si le logiciel se comporte comme prévu. Utilisez de nombreux tests rapides et isolés pour des vérifications précises au plus près du code, et complétez-les par des tests d’intégration ciblés lorsque les interactions entre composants ou dépendances doivent être vérifiées. L’objectif est d’obtenir une confiance comportementale suffisante tout en gardant une validation rapide, fiable et facile à diagnostiquer.
Validation de contrat : protéger la compatibilité entre services
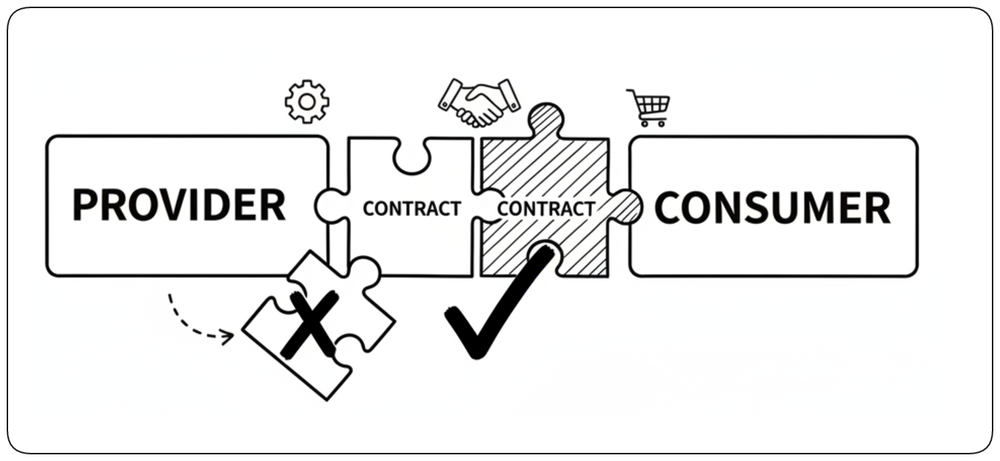
Dans les systèmes distribués, un changement peut casser un autre service même si les deux services fonctionnent correctement isolément. Les tests de contrat vérifient que fournisseurs et consommateurs s’accordent toujours sur la forme et le comportement de leur interface. Ils détectent tôt les changements d’API incompatibles sans exiger un environnement de bout en bout complet.
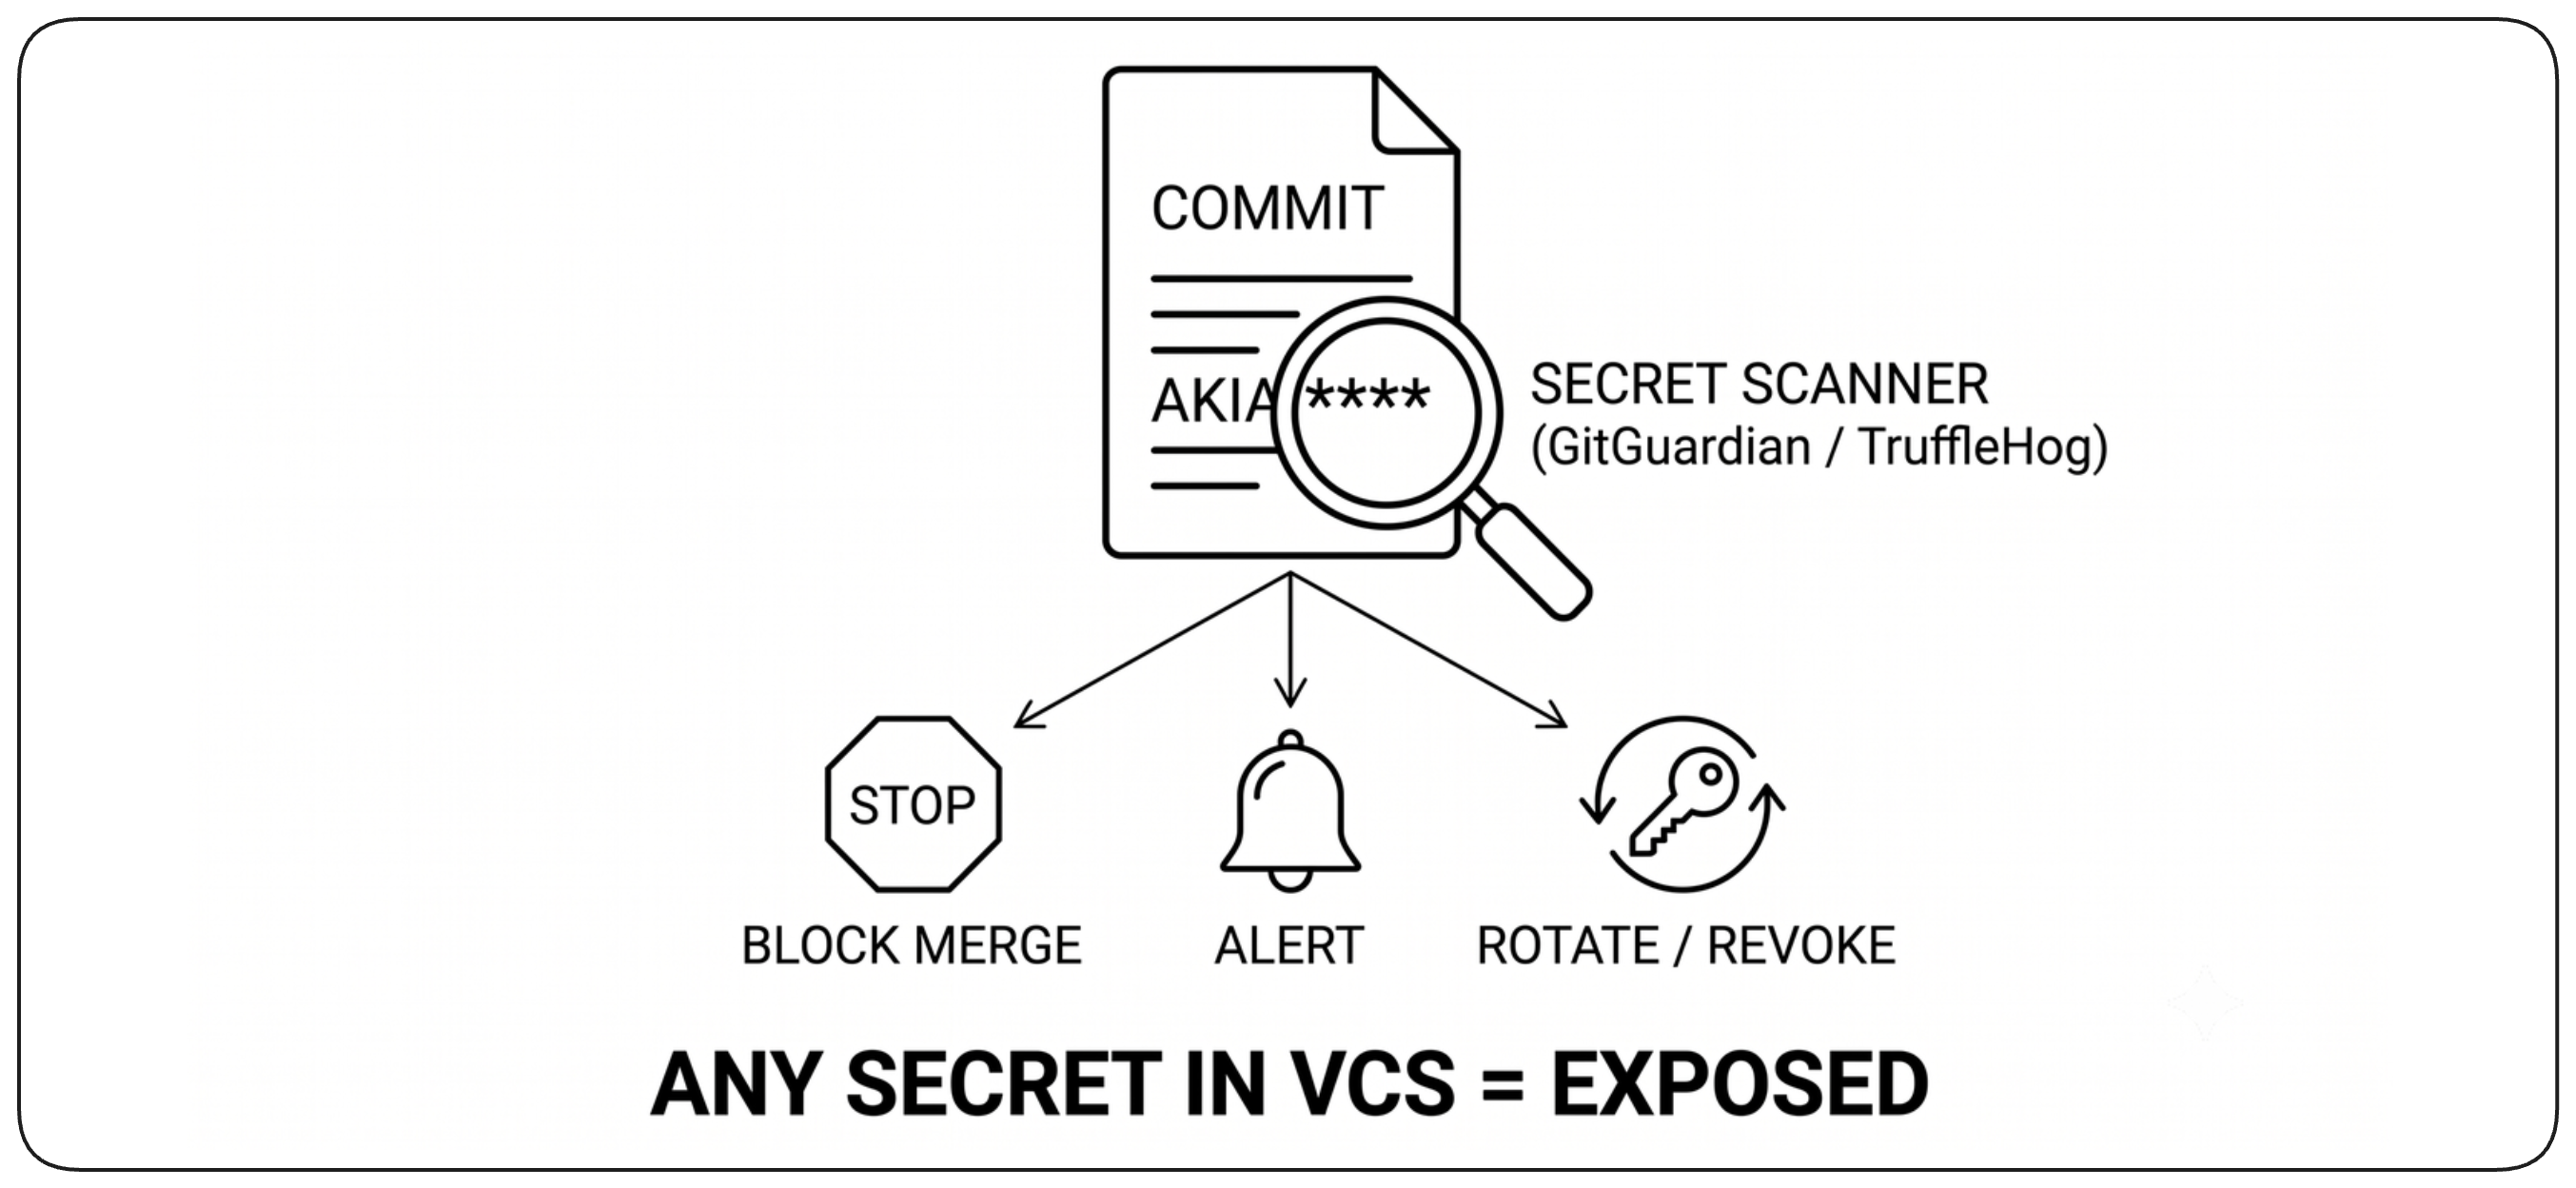
Détecter les secrets avant qu’ils ne se propagent
Identifiants, clés d’API, clés privées et autres secrets ne doivent jamais faire partie de l’historique du code source ni des artefacts de build. Une détection automatisée des secrets doit les repérer le plus tôt possible et bloquer les changements dangereux. Dès qu’un secret est entré dans le contrôle de version, il doit être considéré comme exposé et renouvelé (rotation), plutôt que simplement supprimé du dernier commit.
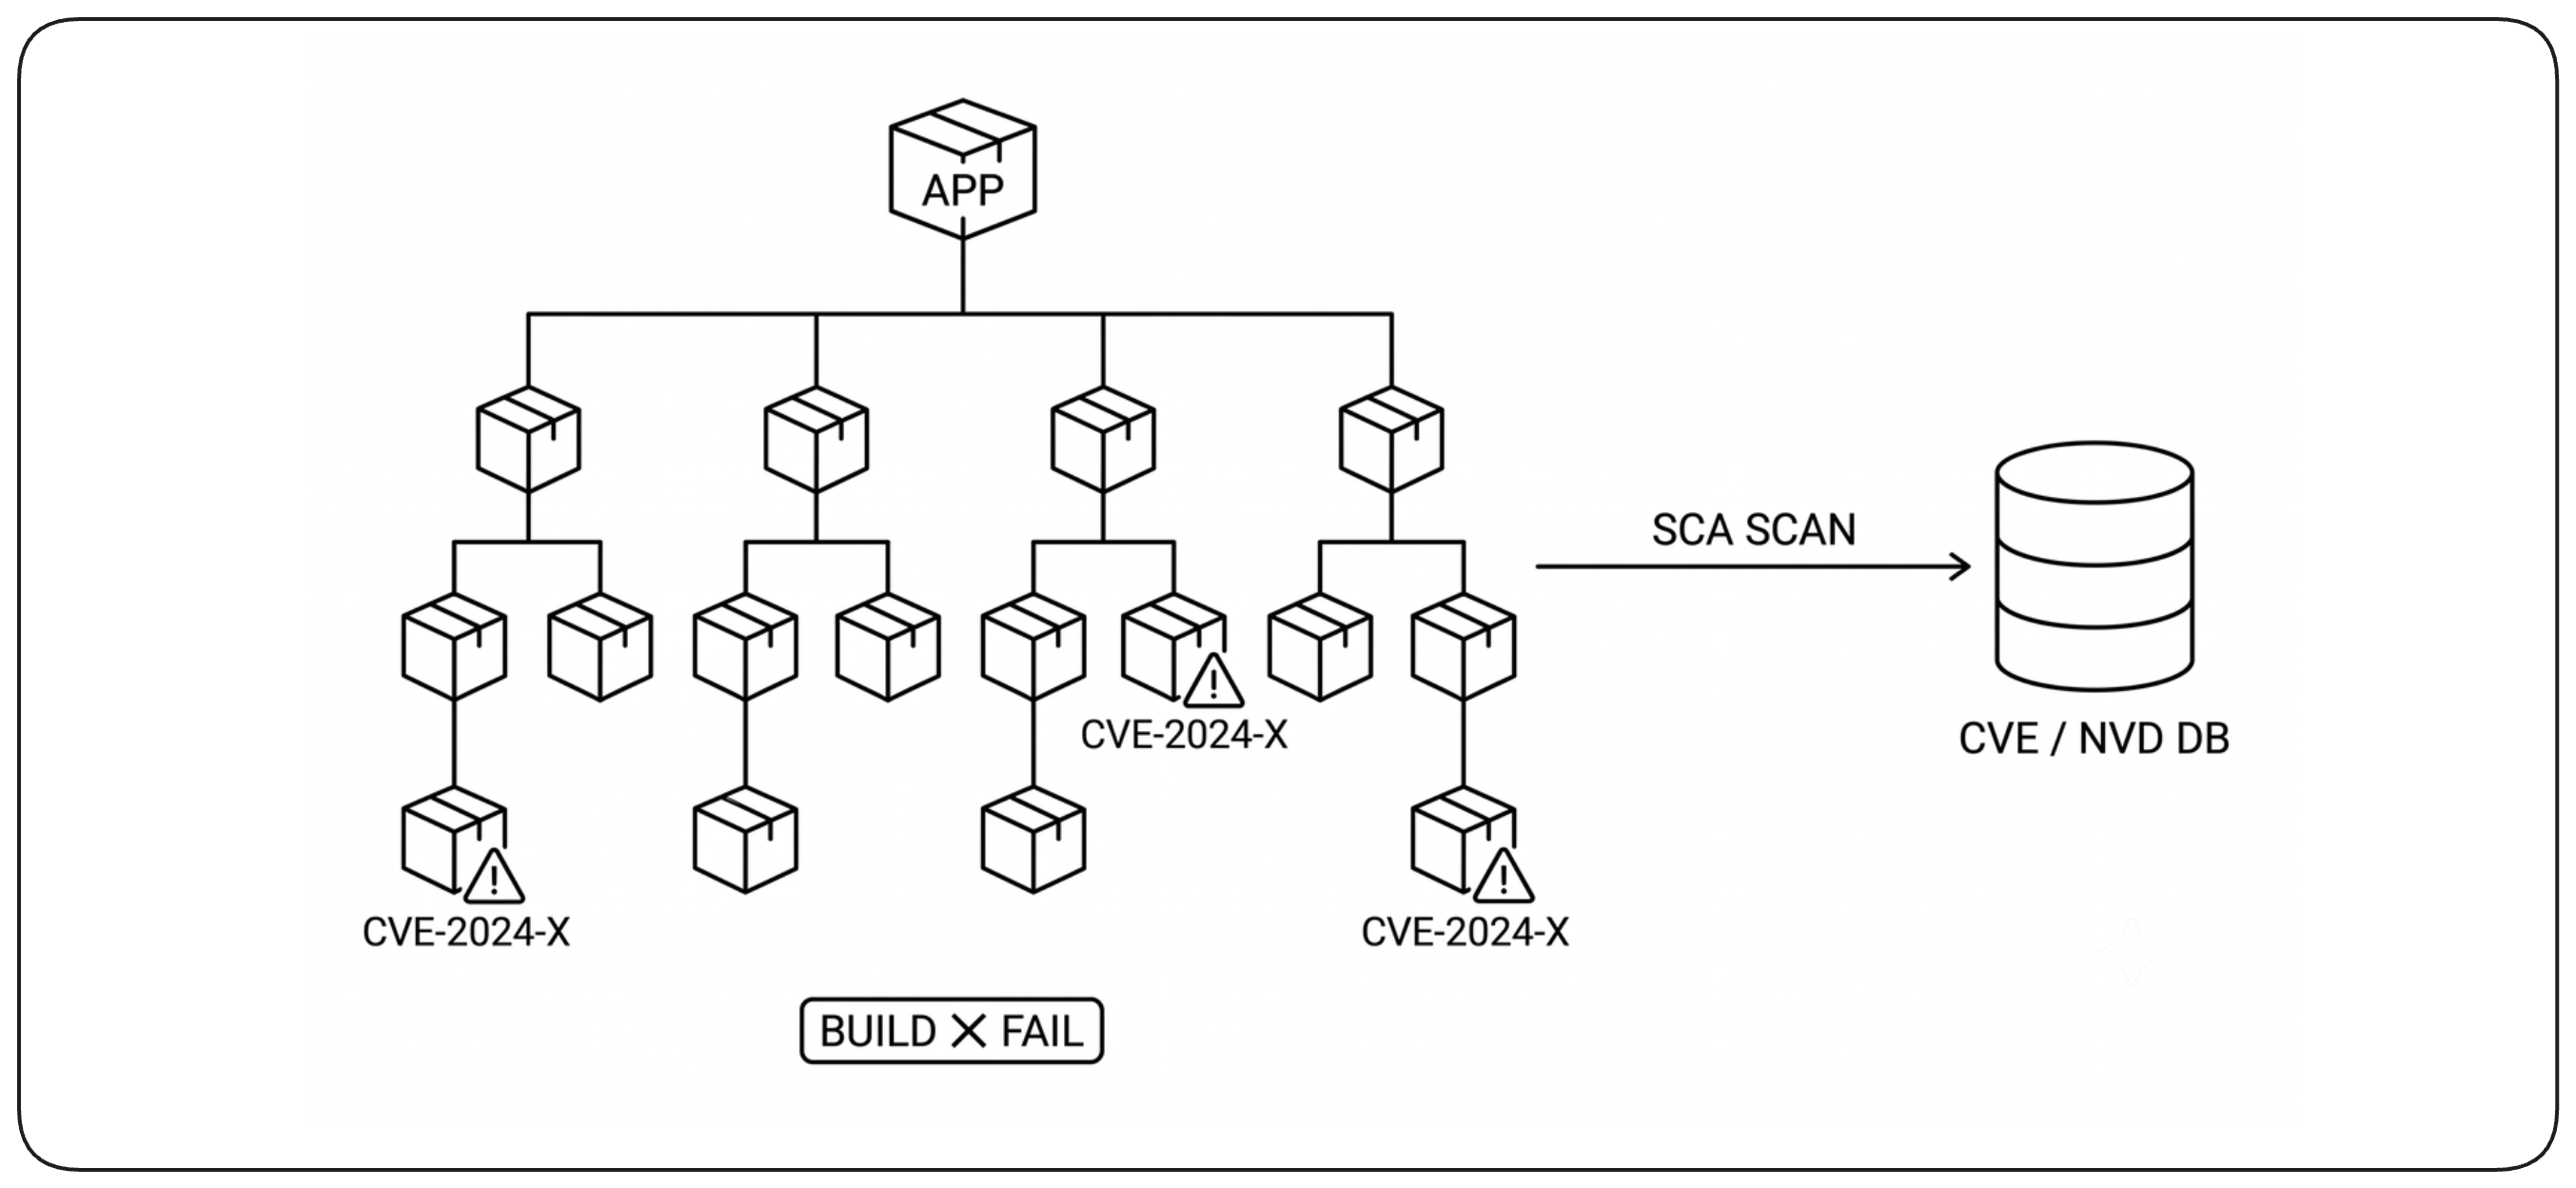
Maîtriser les dépendances tierces
Les bibliothèques et paquets tiers font partie des entrées du build et doivent être maîtrisés comme votre propre code. Analysez les dépendances pour détecter les vulnérabilités connues, épinglez (pin) les versions consommées et récupérez-les via des sources de confiance chaque fois que possible. Un build reproductible et digne de confiance exige de savoir non seulement quelles dépendances il utilise, mais aussi d’où elles viennent exactement et quelles versions sont entrées dans l’artefact.
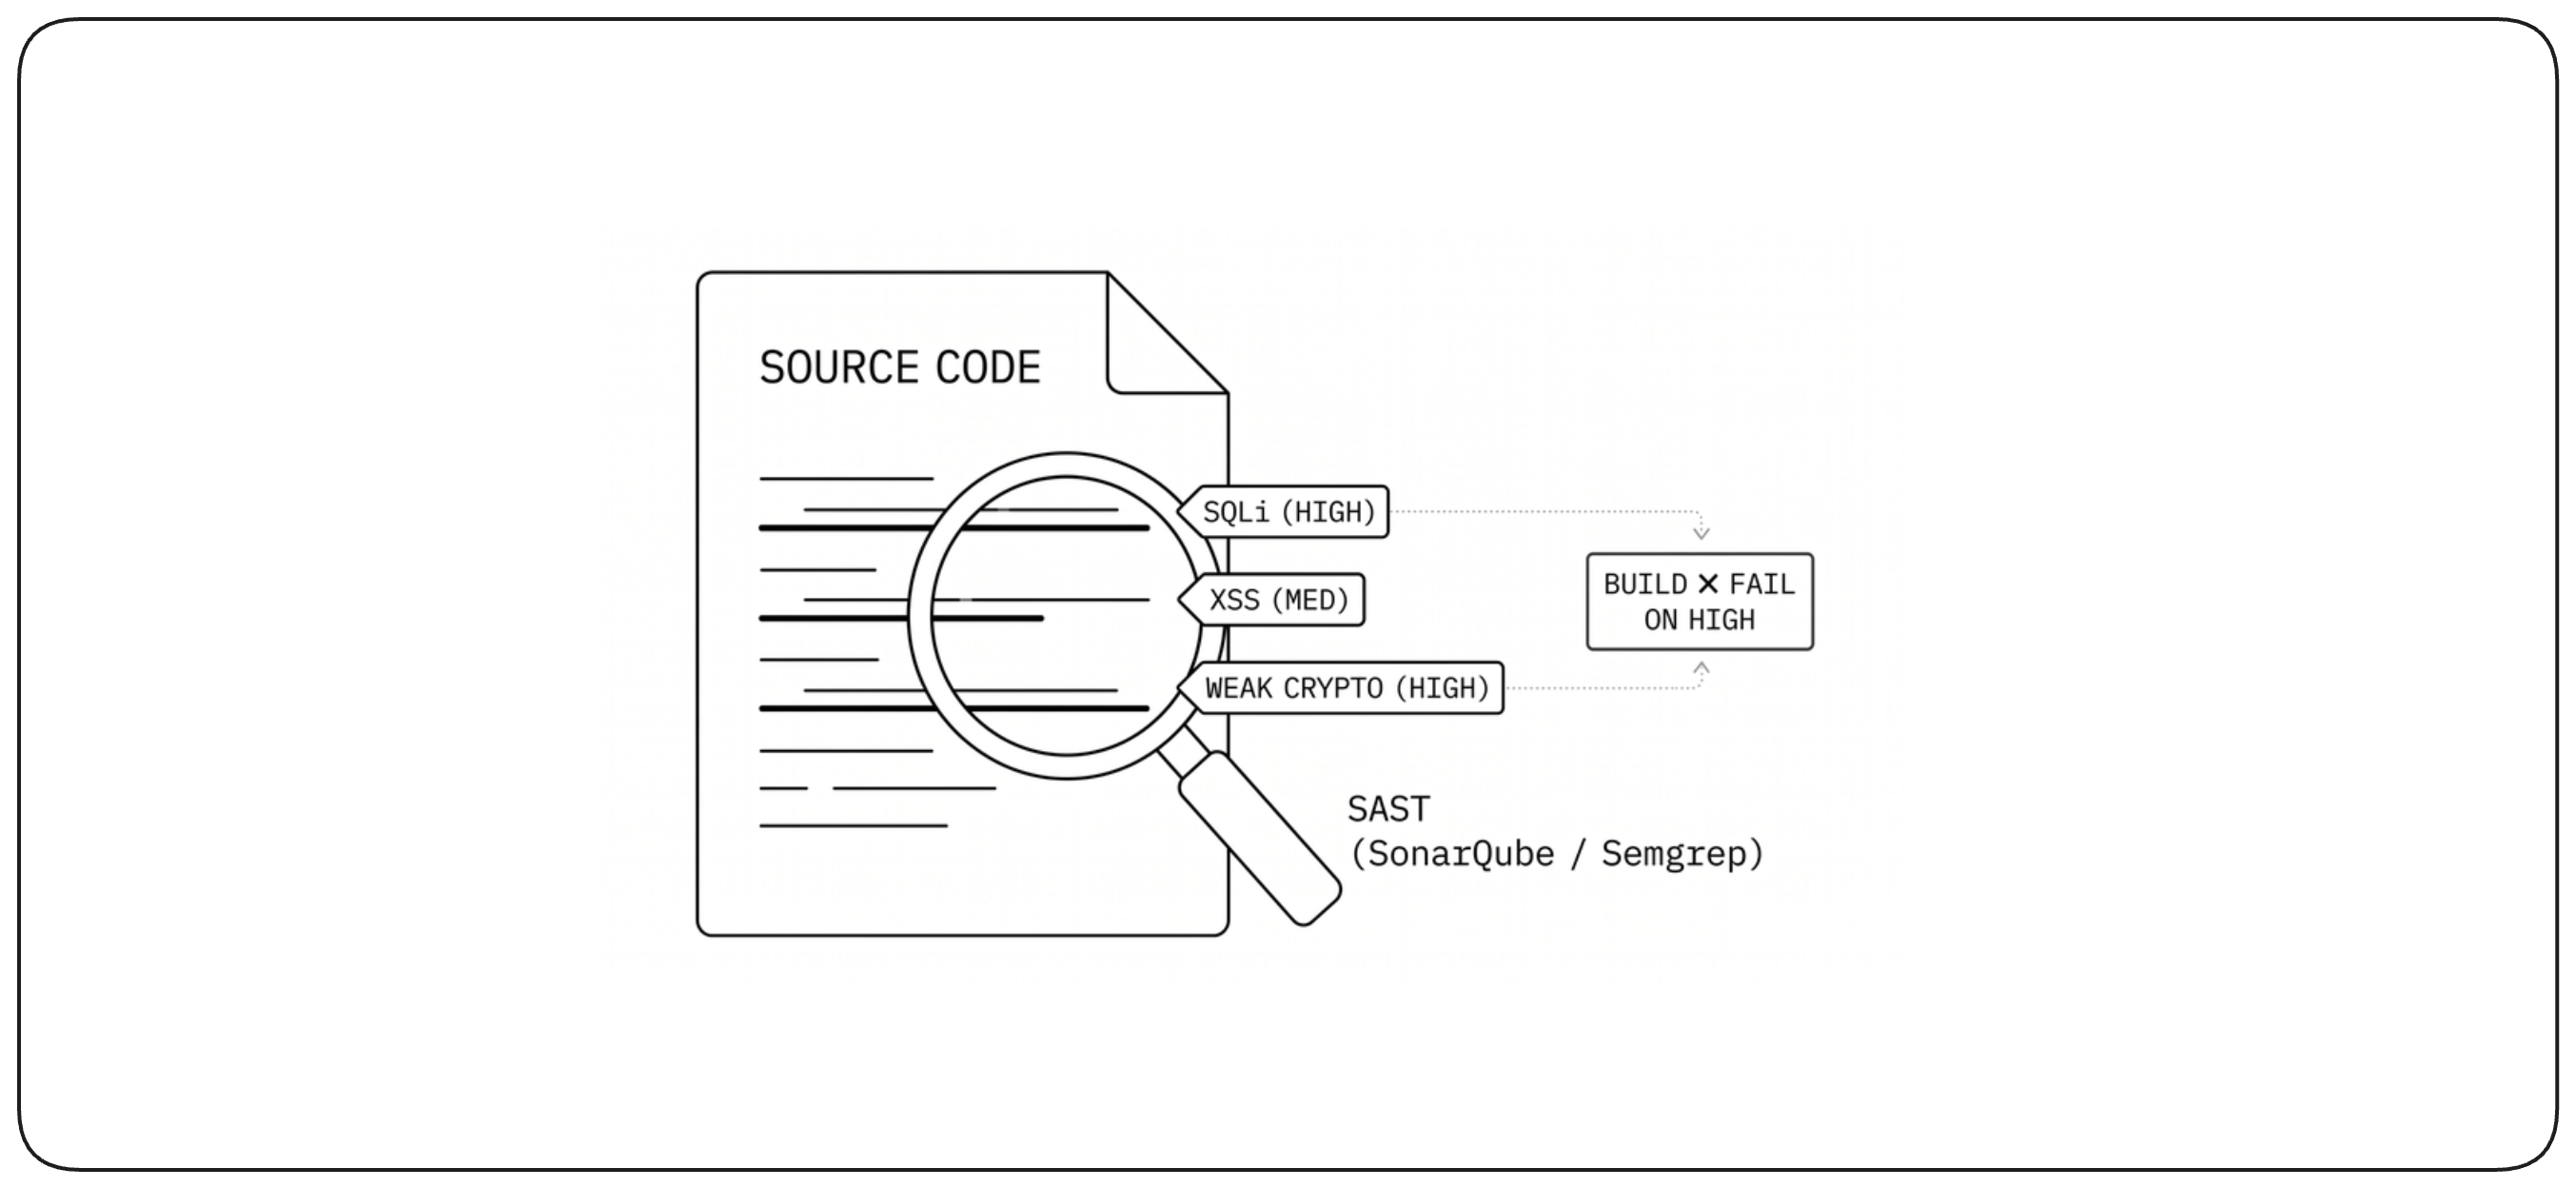
Analyser le code pour détecter les failles de sécurité
L’analyse statique de sécurité examine le code source sans l’exécuter et peut détecter des classes de vulnérabilités comme les failles d’injection, les API dangereuses et la cryptographie non sécurisée. Ces contrôles sont utiles tôt dans le build, mais ils doivent être réglés avec soin : les règles bruyantes et les faux positifs finissent vite par être ignorés. Les politiques bloquantes doivent se concentrer sur les constats qui représentent un risque significatif.
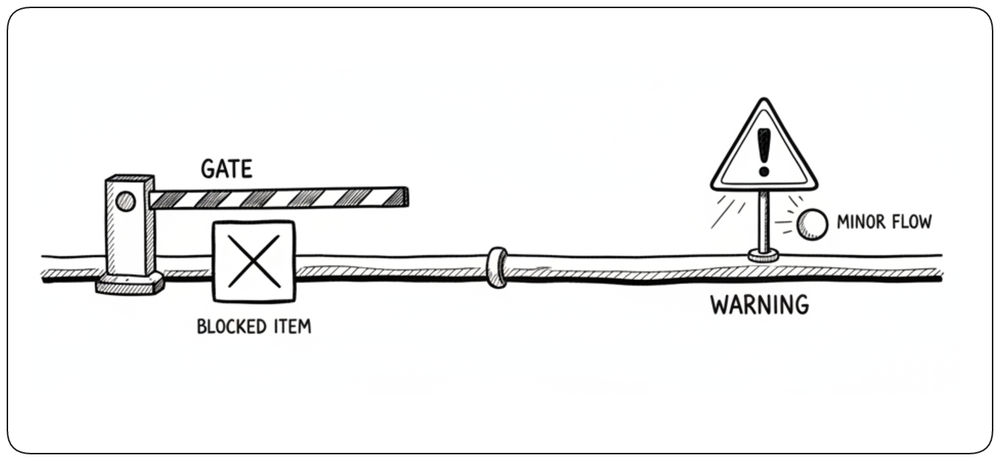
Faire respecter les décisions de sûreté par des gates
Les vérifications individuelles produisent des preuves ; le build évalue ces preuves ensemble selon le risque et les critères requis. Des preuves manquantes ou des résultats inacceptables doivent bloquer la progression, tandis que les constats consultatifs peuvent rester des avertissements. Les gates doivent être peu nombreuses, explicites et réservées aux conditions qui rendent réellement la progression risquée.
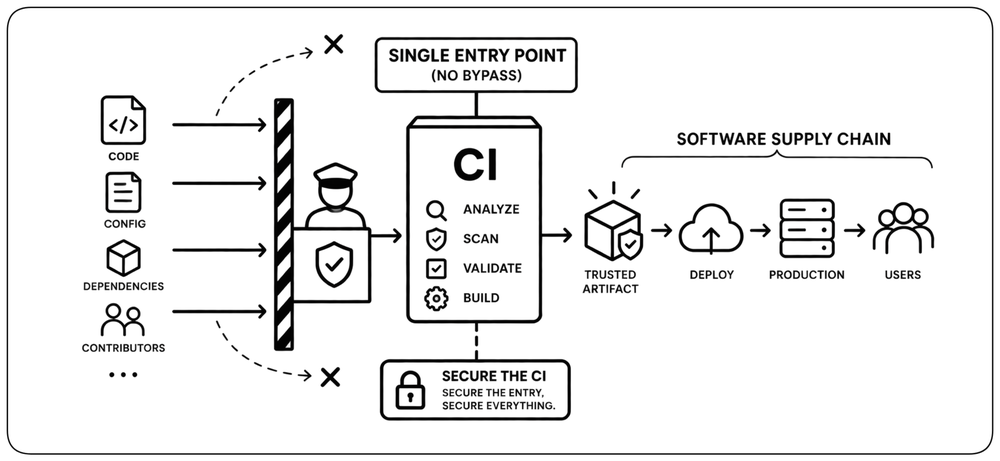
Sécuriser le build
Le build est le point d’entrée contrôlé de la chaîne d’approvisionnement logicielle (supply chain). Chaque changement destiné à la production doit passer par la CI ; il ne doit exister aucun chemin alternatif pour la contourner. Cela fait du build une frontière de sécurité critique : c’est là que les changements sont analysés, validés et transformés en artefacts de confiance avant de pouvoir avancer. Sécuriser le build signifie donc protéger ce point d’entrée lui-même — qui et quoi peut y entrer, quels accès le build reçoit et si ses sorties restent dignes de confiance.
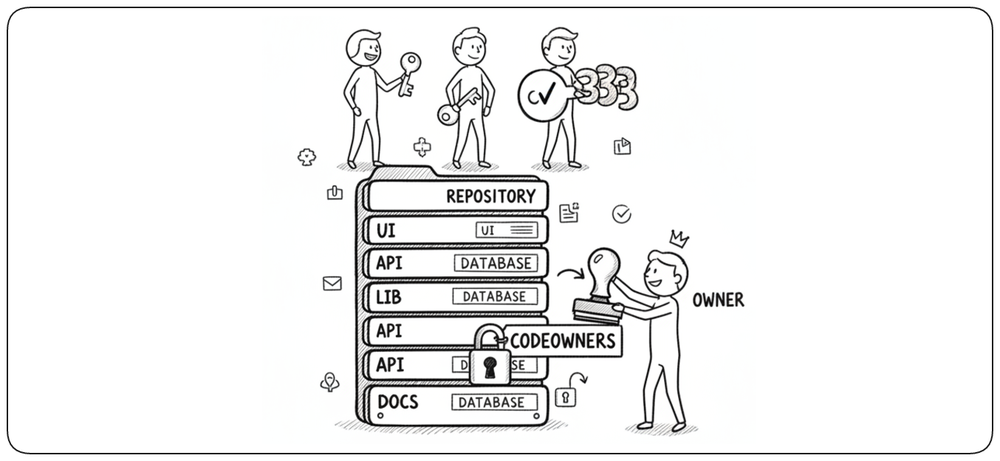
Sécuriser qui peut modifier le code
La sécurité commence avant l’exécution du build : seuls les personnes et systèmes autorisés doivent pouvoir modifier le code qui y entre. L’accès aux dépôts doit suivre le moindre privilège, les zones sensibles peuvent exiger l’approbation de propriétaires désignés, et une authentification forte doit protéger l’accès en écriture. L’objectif est de contrôler qui peut introduire un changement avant que le build ne commence à décider si ce changement est digne de confiance.
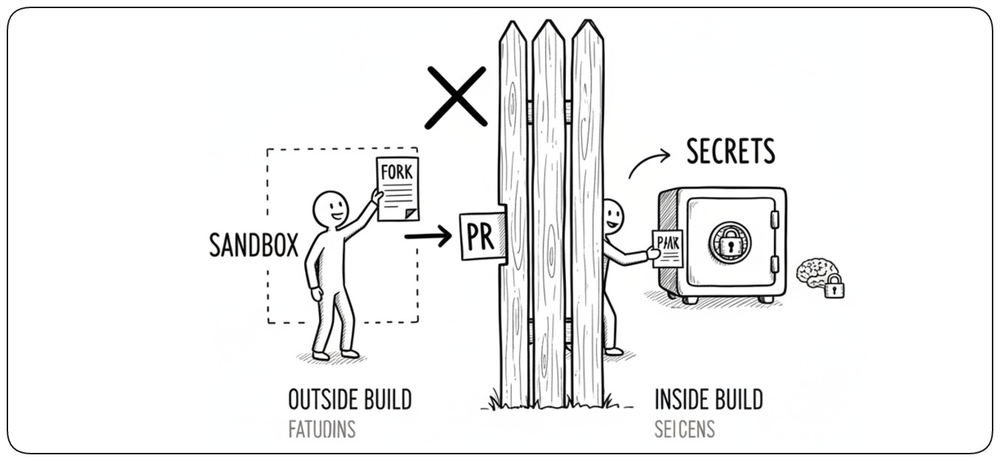
Collaborer en sécurité avec des contributeurs externes
Les contributions externes introduisent du code non fiable dans le processus de build et exigent donc une frontière plus forte. Les workflows basés sur les forks permettent aux contributeurs de proposer des changements sans accès en écriture au dépôt, tandis que leurs builds s’exécutent avec des permissions restreintes et sans accès aux secrets ni aux ressources protégées. La collaboration reste ouverte sans donner au code non fiable les privilèges d’un build interne.
Donner au build uniquement les accès dont il a besoin
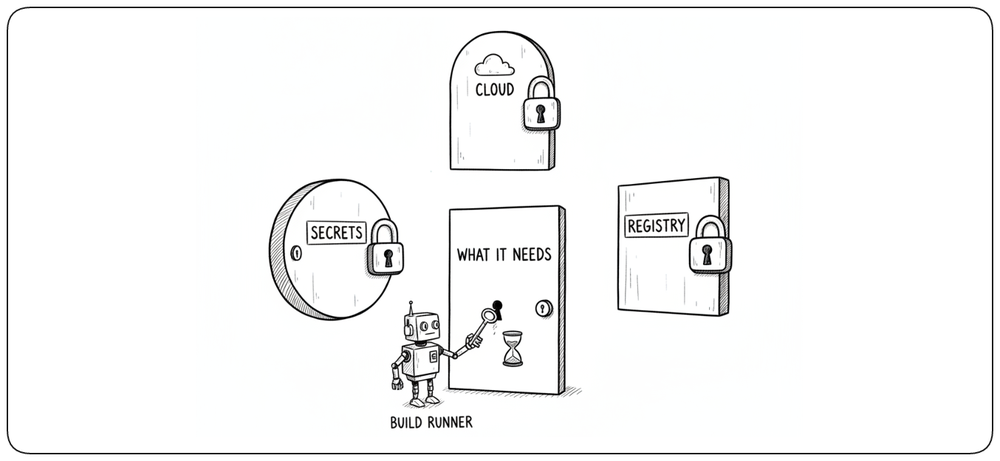
Les runners de build et les comptes de service ont souvent accès au code source, aux secrets, aux registries et aux ressources cloud, ce qui en fait des cibles d’attaque de choix. Appliquez le moindre privilège : chaque job ne doit recevoir que les permissions et identifiants dont il a besoin, et seulement pour la durée nécessaire. Une étape de build compromise ne doit pas donner automatiquement accès au reste de l’infrastructure.
Protéger l’intégrité des artefacts
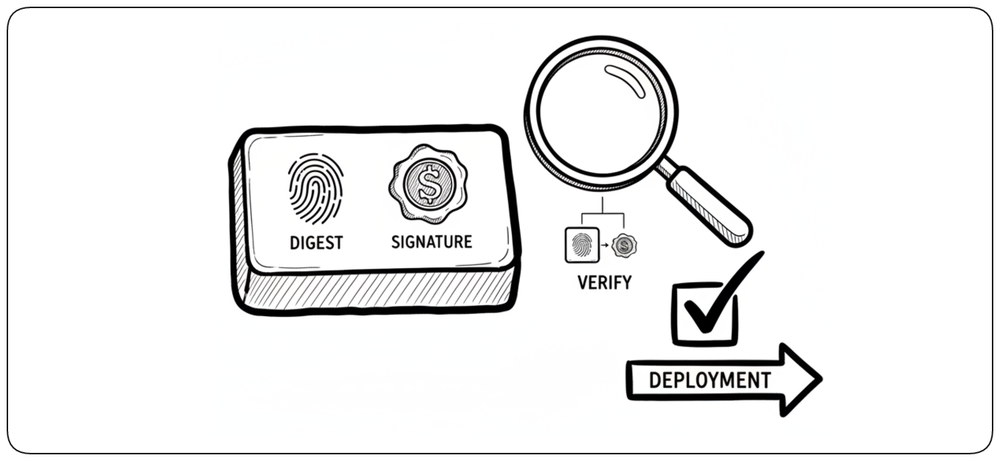
Une fois qu’un artefact a passé le build, les consommateurs doivent pouvoir vérifier qu’il s’agit toujours exactement de l’artefact approuvé et qu’il n’a pas été modifié depuis. Un condensat cryptographique (digest) identifie le contenu de l’artefact, tandis qu’une signature numérique lie ce digest à une identité de signature de confiance. Les systèmes de déploiement doivent vérifier les deux avant d’exécuter l’artefact, afin de préserver l’intégrité et la provenance du build jusqu’à la production.
Protéger la chaîne d’approvisionnement logicielle
Les contrôles de sécurité protègent le build contre les entrées dangereuses, mais le build lui-même doit aussi être protégé. Ses outils, dépendances, runners, identifiants et sorties font partie de la supply chain logicielle et doivent être maîtrisés et auditables. Si l’infrastructure de build est compromise, même un code source correctement écrit peut produire un artefact non fiable.
Gestion des artefacts
La gestion des artefacts garde les sorties de build validées disponibles, identifiables et dignes de confiance une fois le build terminé. Une fois que le build a établi la confiance, la gestion des artefacts doit la préserver pendant que la sortie est stockée, identifiée et finalement consommée.
Les sorties de build prennent différentes formes
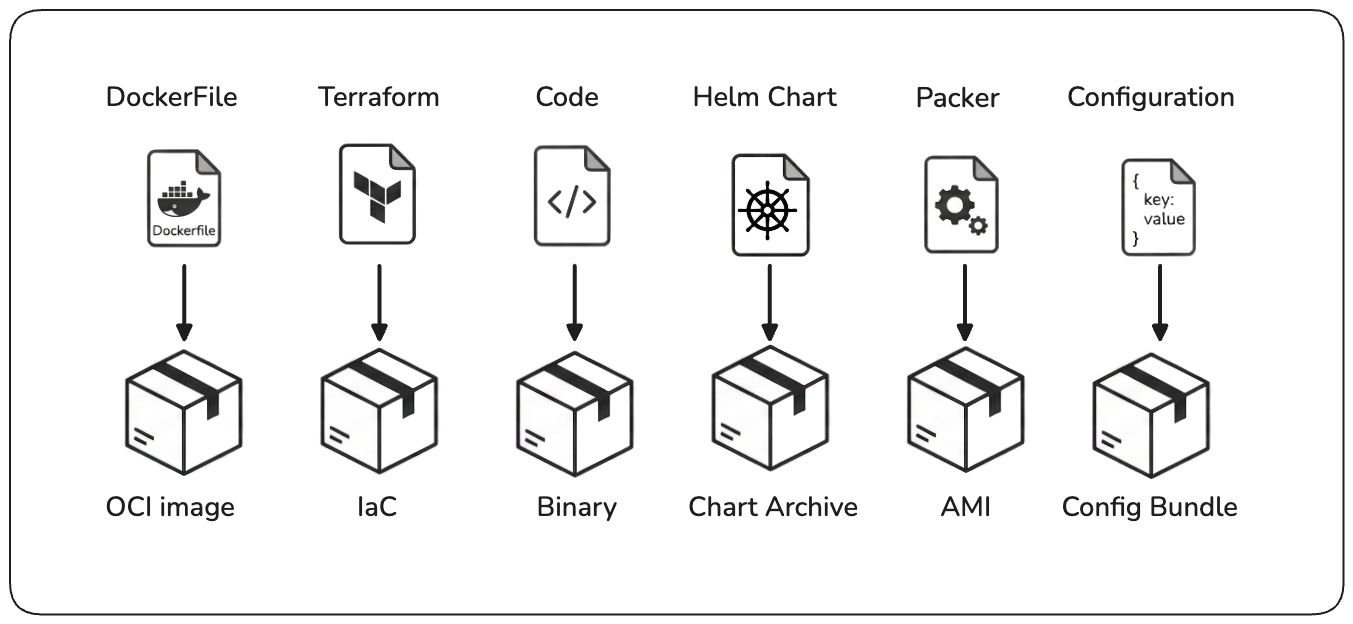
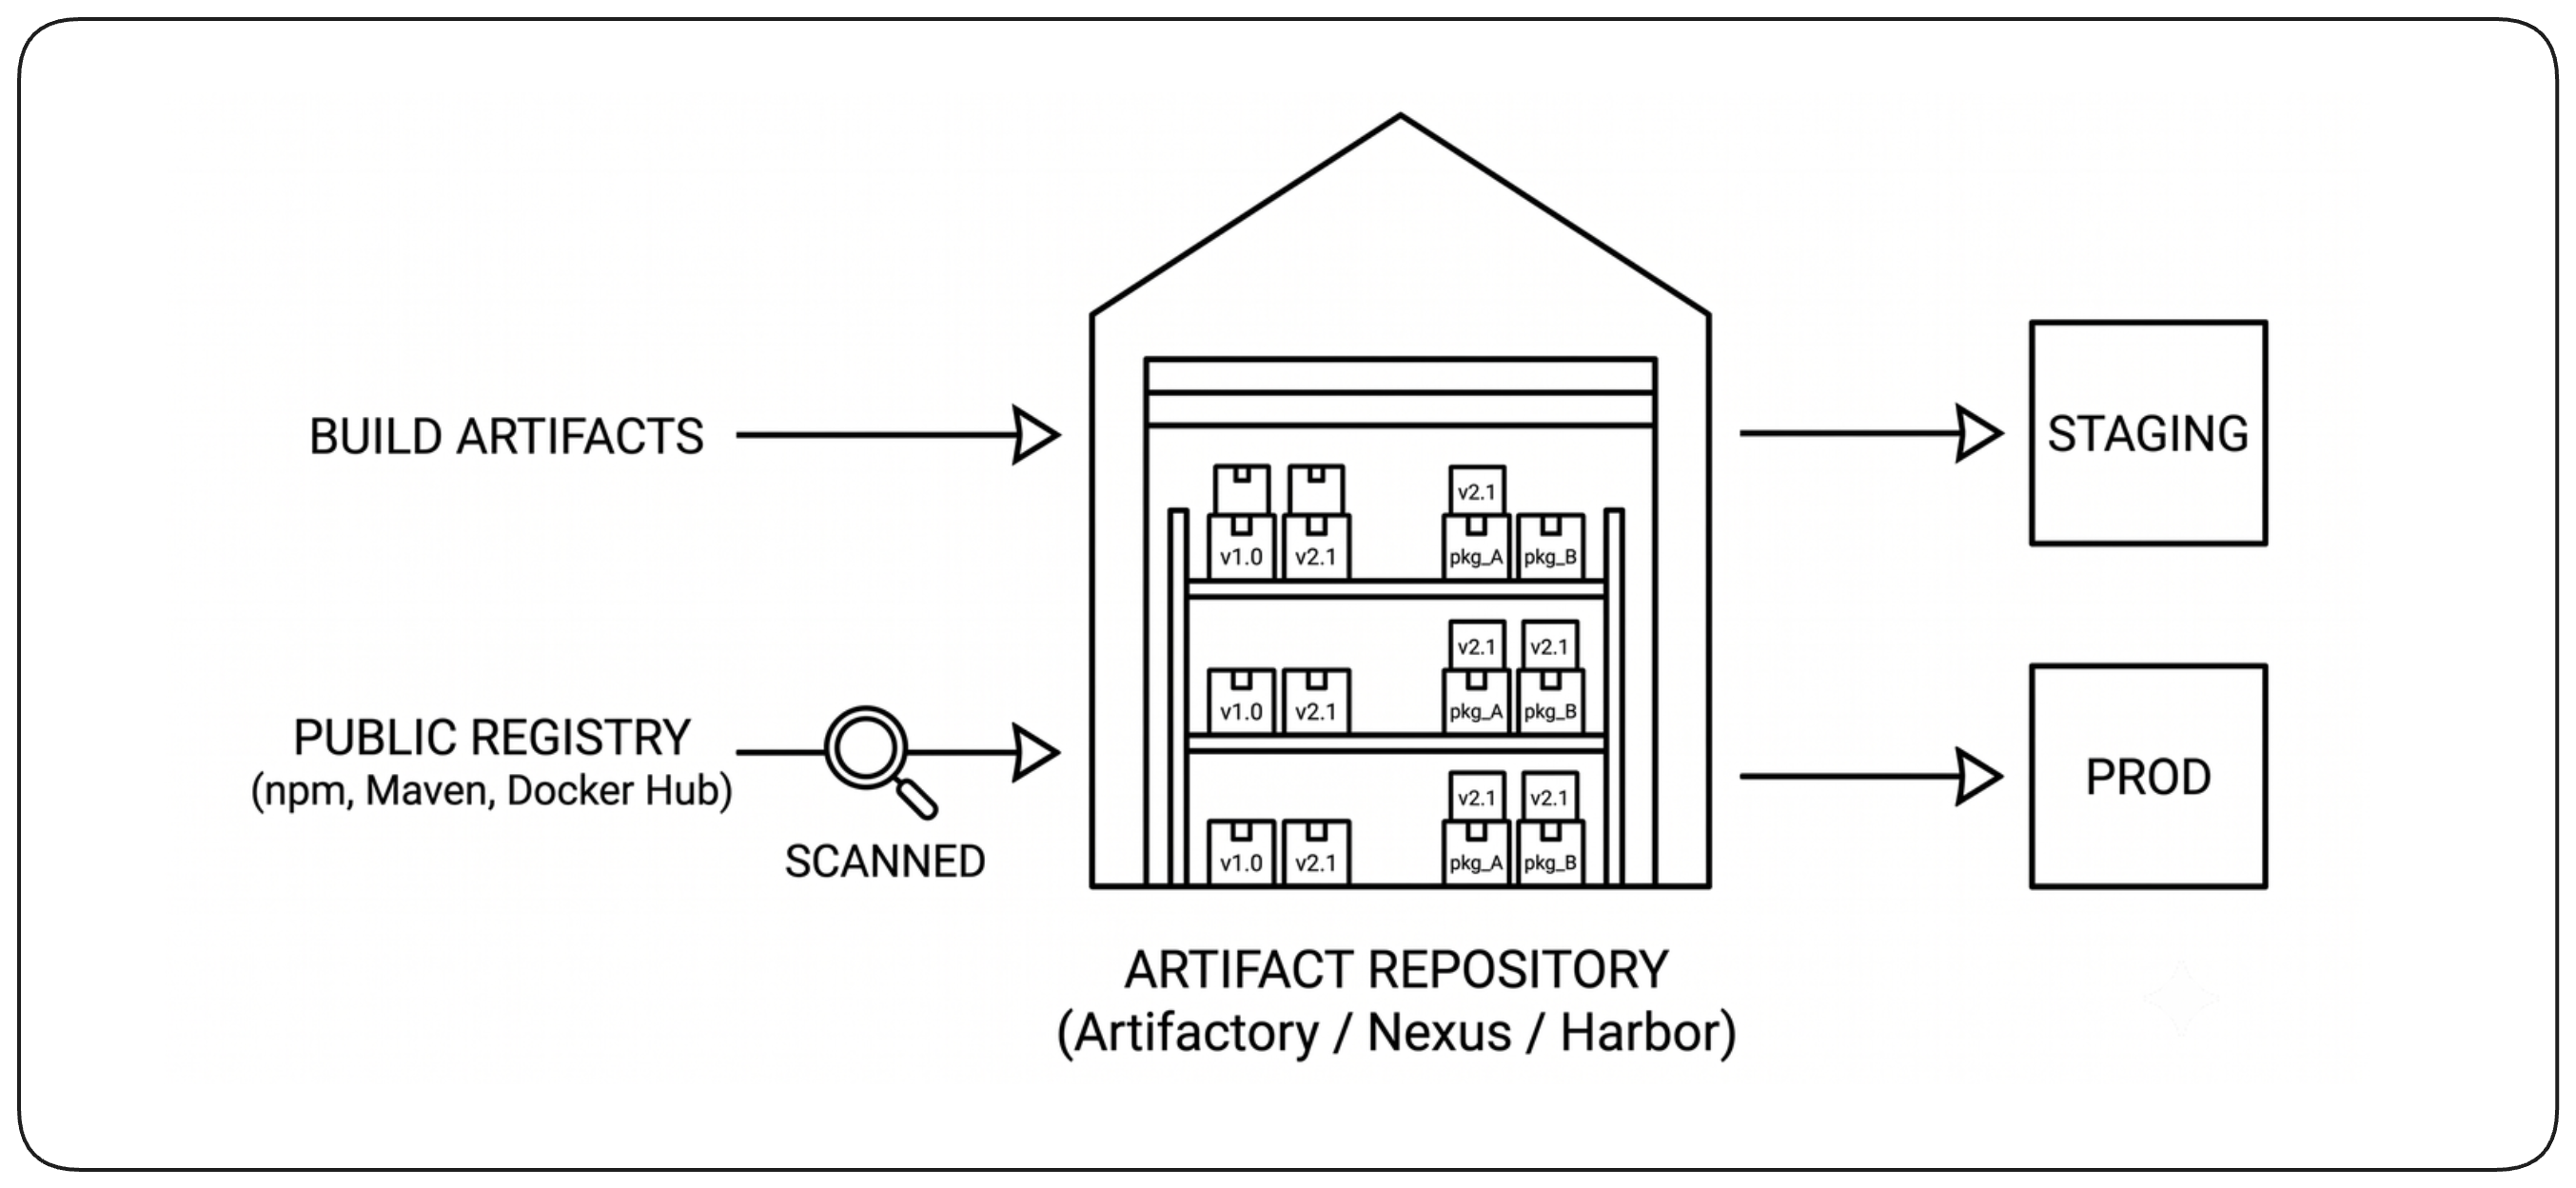
Un artefact de build est une sortie immuable produite et validée pour un usage ultérieur. Ce peut être un binaire, une image de conteneur, un paquet d’infrastructure, une image machine, un chart de déploiement ou un bundle de configuration. Quelle que soit sa forme, il devient une unité identifiable qui peut être stockée, tracée, promue et consommée sans être reconstruite.
Stocker les artefacts dans un dépôt
Les sorties de build validées doivent être stockées dans un dépôt d’artefacts ou un registry dédié, plutôt que laissées sur les machines de build ou mélangées au code source. Un dépôt central donne aux systèmes de déploiement un endroit stable où récupérer les artefacts approuvés et offre un contrôle d’accès, une rétention et une auditabilité cohérents.
Donner à chaque artefact une identité immuable
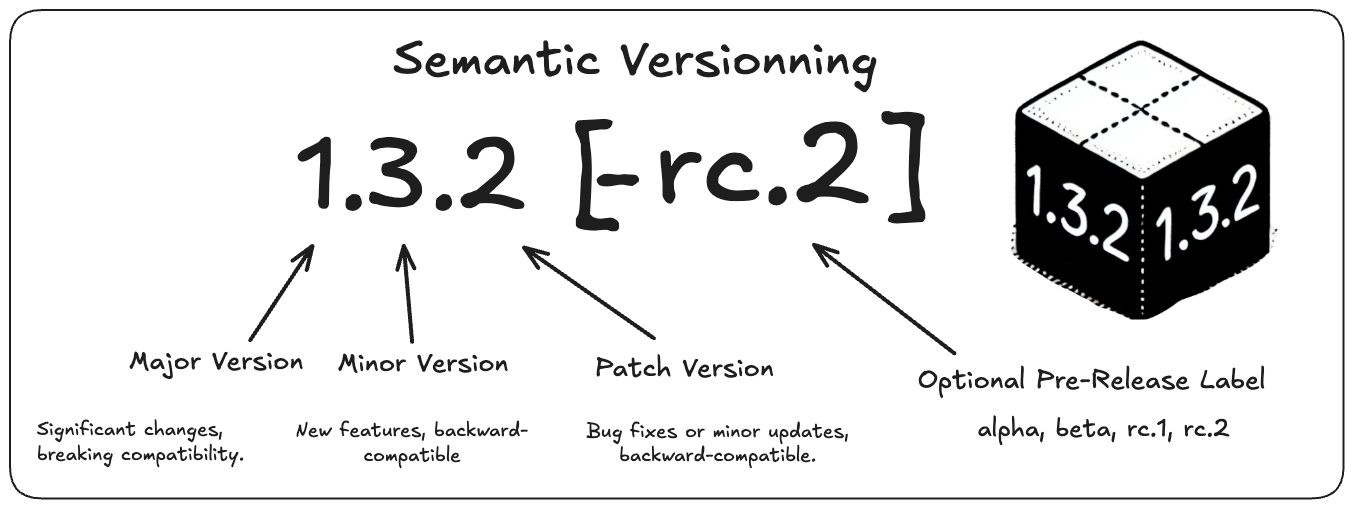
Chaque artefact a besoin d’une identité immuable pour que les équipes sachent exactement ce qui a été testé, déployé ou annulé. Une version de release comme 1.4.2 identifie une release logique ; un identifiant de build distingue un build particulier ; un digest cryptographique identifie le contenu exact de l’artefact. Ces identifiants servent des objectifs différents. Un identifiant censé désigner un contenu immuable ne doit jamais être réaffecté à un autre contenu. Ensemble, ils offrent un versionnement lisible par les humains et une identité précise vérifiable par les machines.
Conserver les métadonnées et la provenance des artefacts
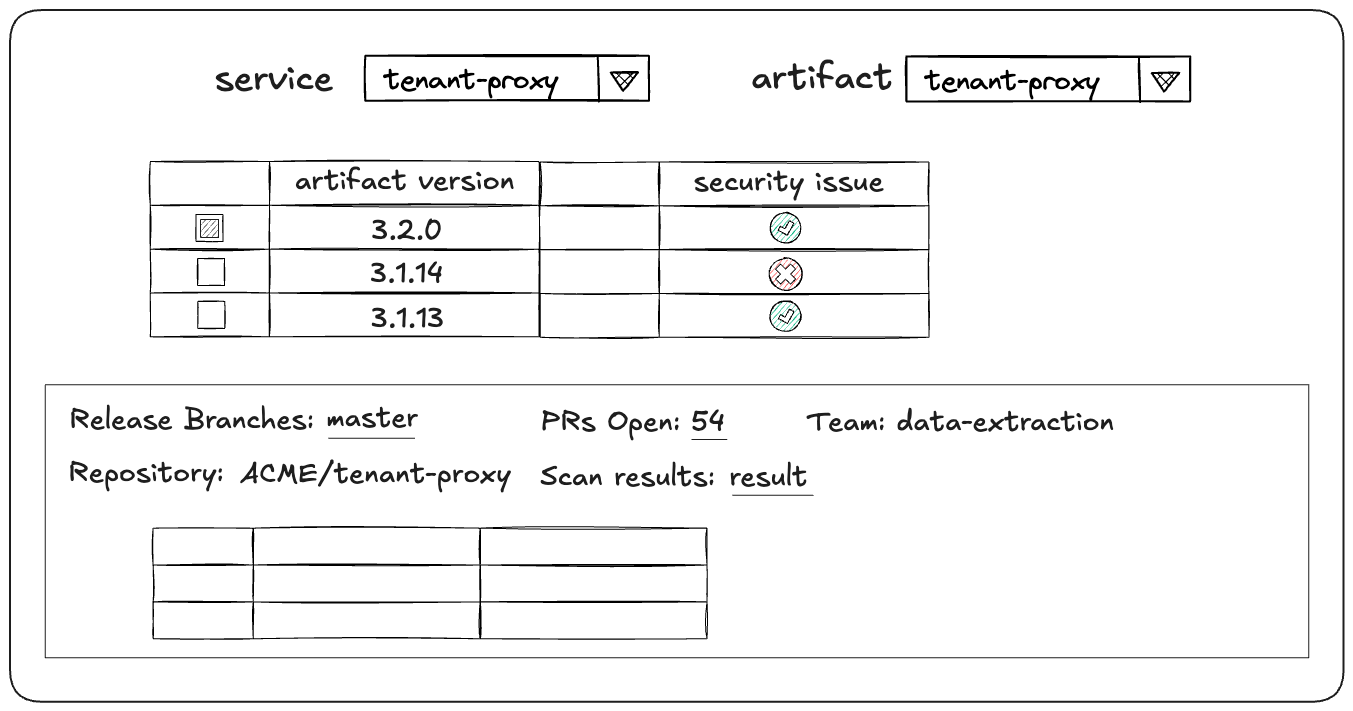
Un artefact doit conserver assez de métadonnées pour expliquer d’où il vient et quelles preuves lui ont permis de progresser. Cela inclut généralement la révision source, l’identifiant du build, la date de création et les résultats pertinents des tests et des contrôles de sécurité. La provenance relie l’artefact final au processus qui a établi sa confiance, ce qui facilite grandement le dépannage, l’audit et les décisions de déploiement.
Définir la rétention des artefacts
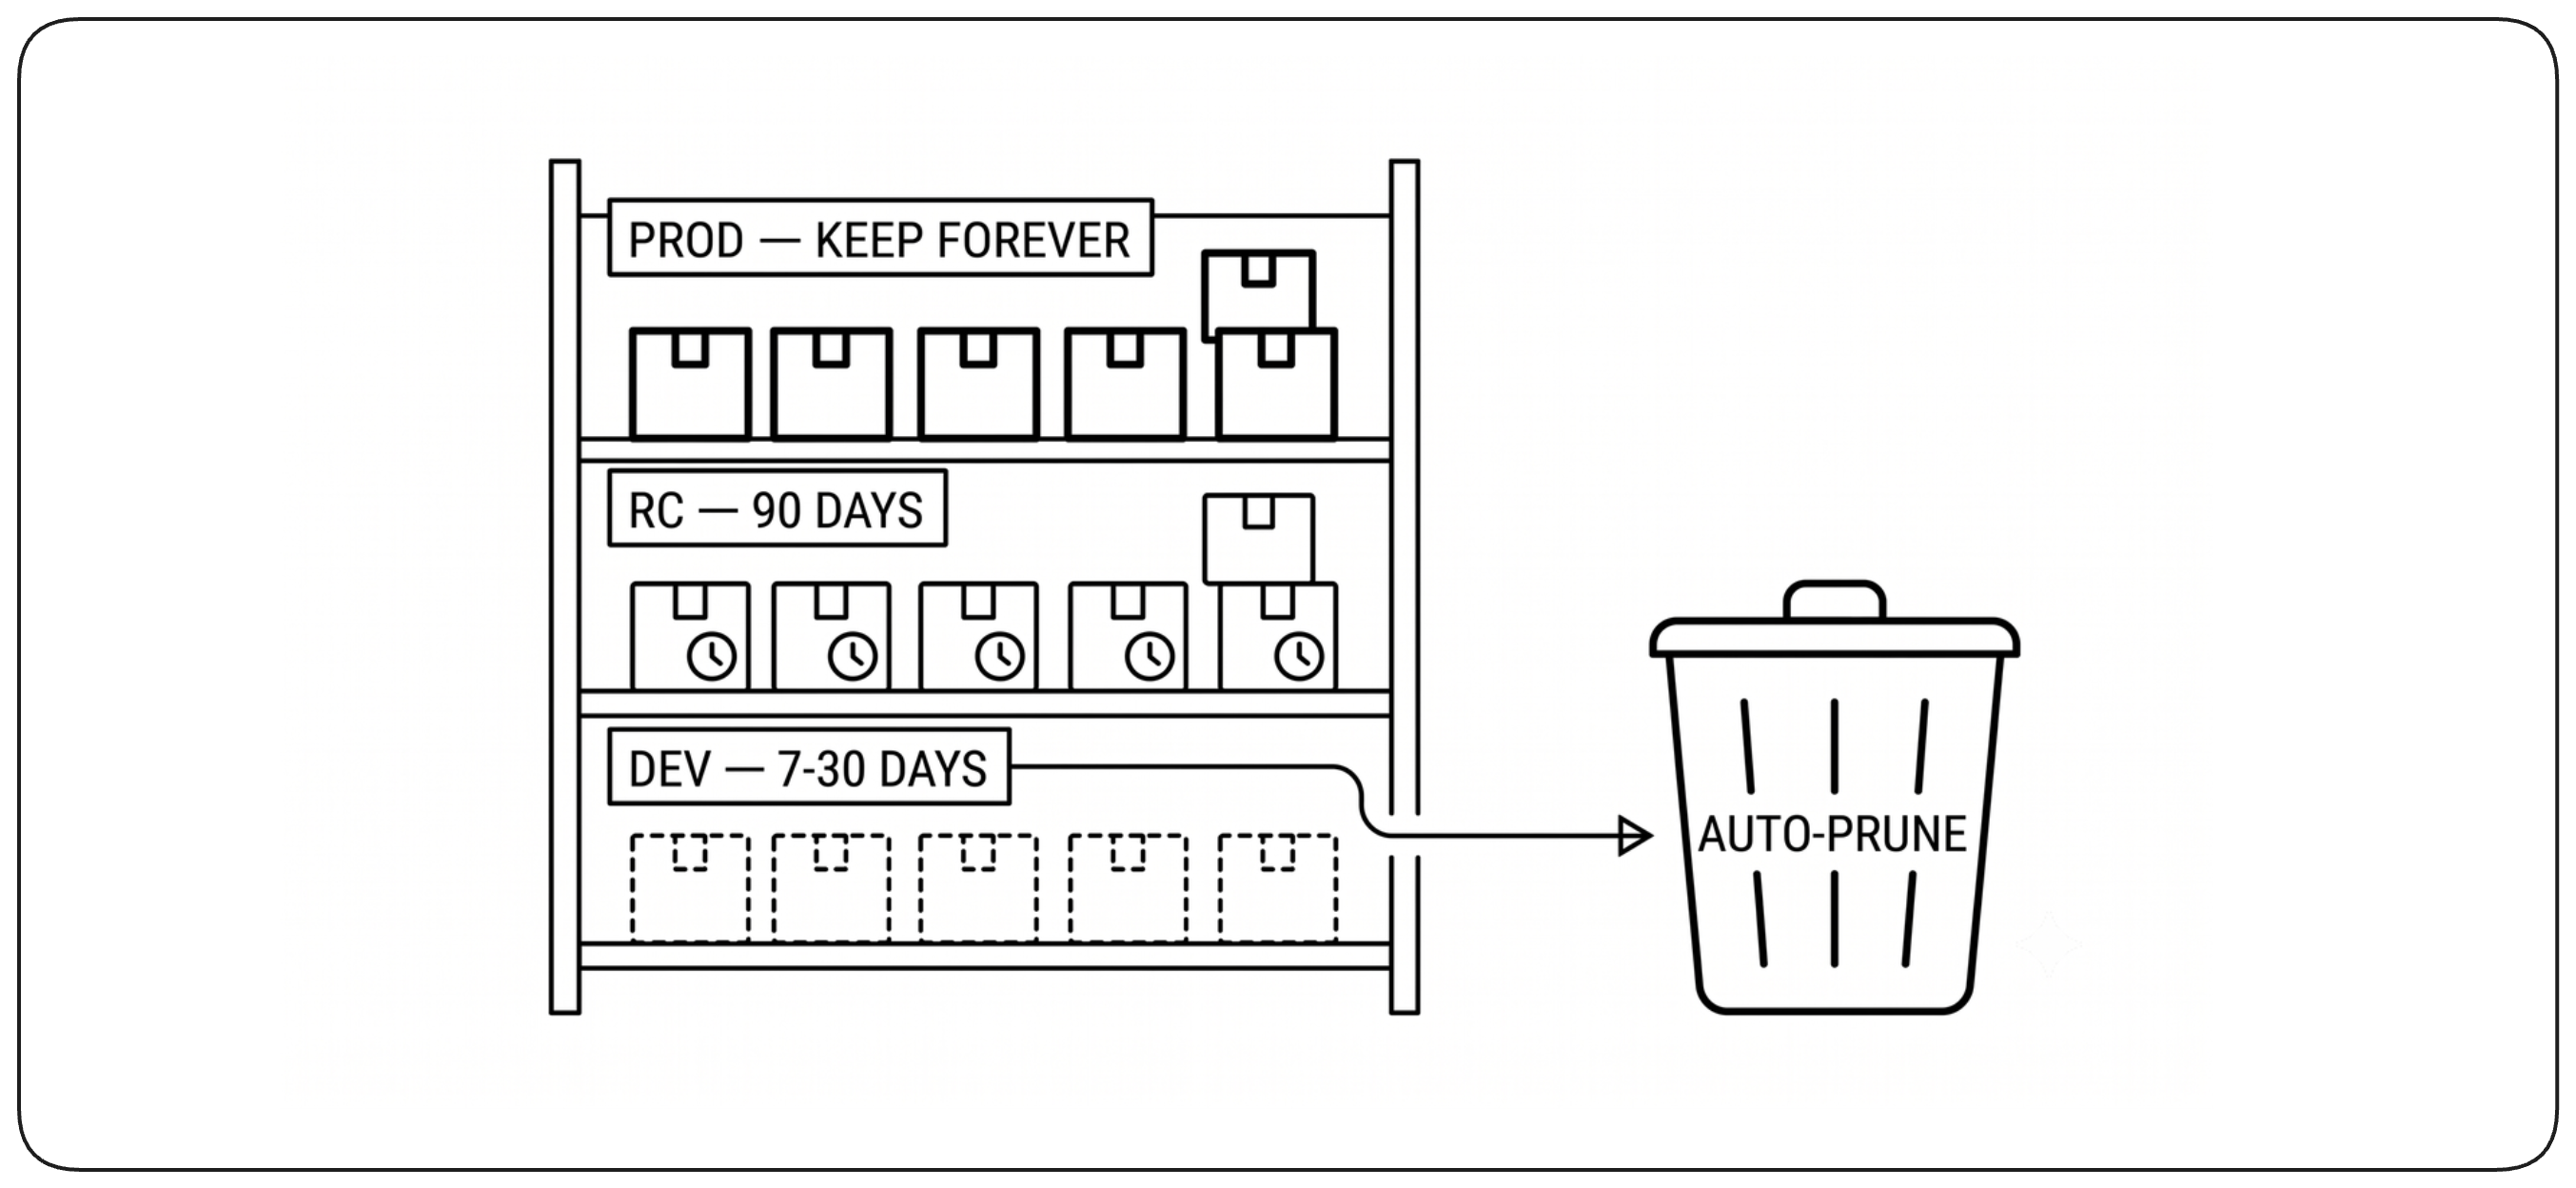
Les dépôts d’artefacts grossissent continuellement : la rétention doit donc être intentionnelle. Conservez les artefacts aussi longtemps qu’ils sont nécessaires pour le rollback en production, l’audit, la conformité ou le développement actif, et supprimez automatiquement les sorties obsolètes. Les politiques de rétention doivent refléter les besoins opérationnels plutôt que des durées fixes appliquées uniformément à tous les artefacts.
Le rôle de la plateforme
Une plateforme de build doit retirer la complexité de l’infrastructure aux équipes applicatives tout en préservant les standards nécessaires à la sécurité, à la fiabilité et à la cohérence. Son rôle est d’offrir un paved path : des valeurs par défaut simples pour les cas courants, assez de flexibilité pour les besoins exceptionnels et des capacités partagées que les équipes ne devraient pas avoir à reconstruire elles-mêmes. Faire fonctionner ces pratiques de façon cohérente dans de nombreuses équipes exige plus que de bonnes définitions de build : il faut une plateforme qui rend le bon chemin facile à suivre.
Choisir la bonne infrastructure de build
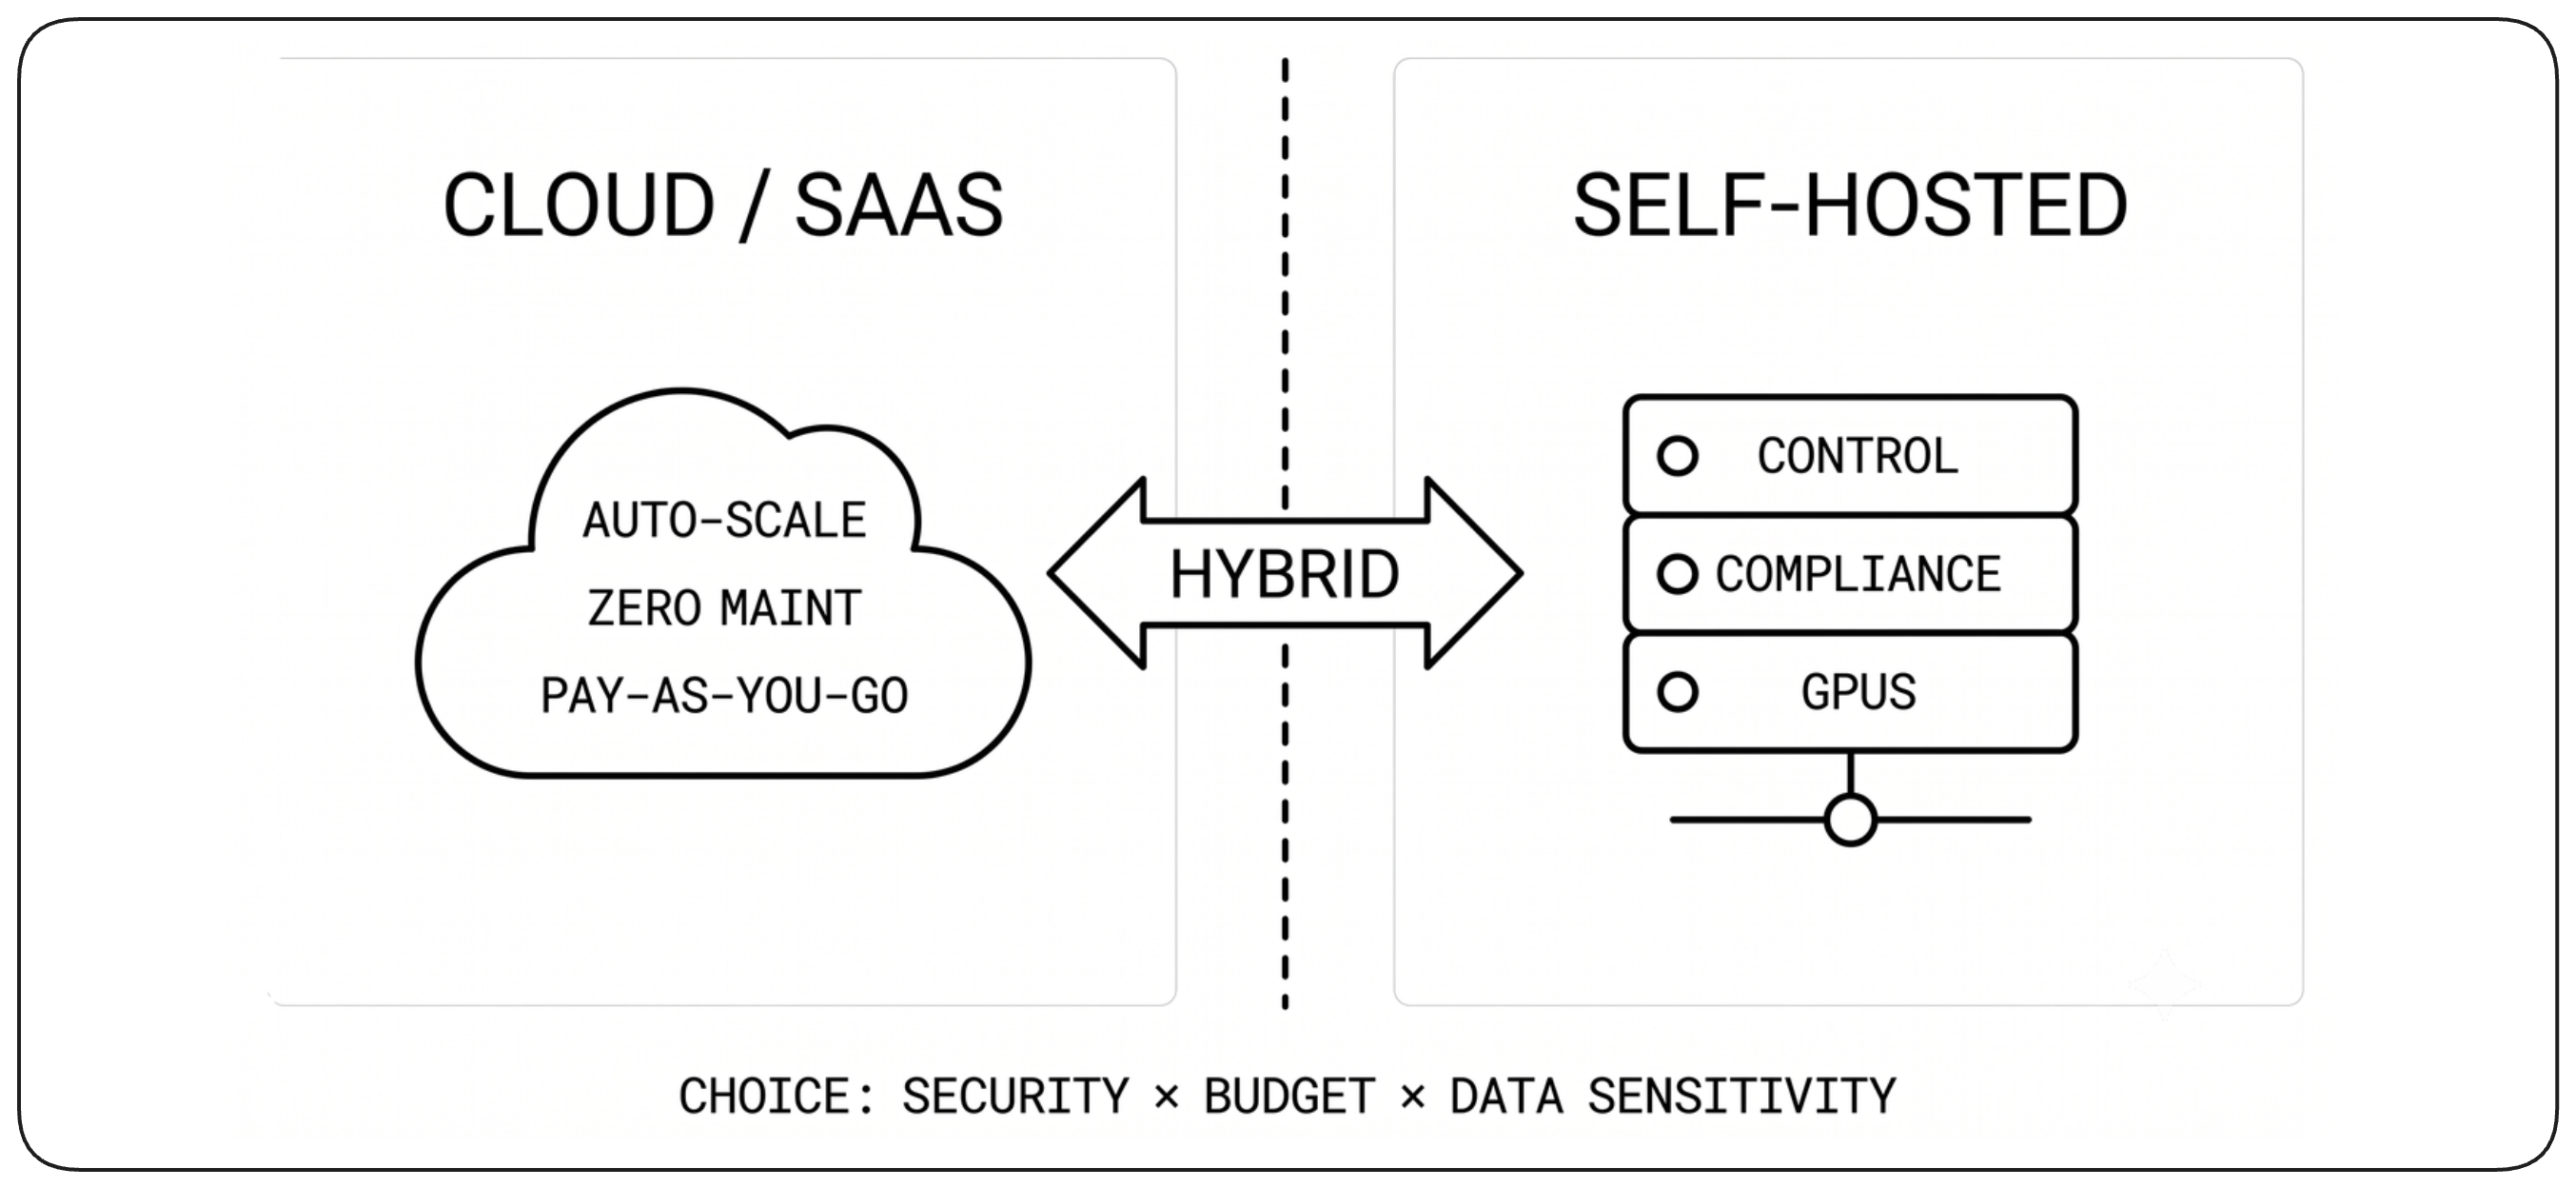
L’infrastructure de build peut être fournie comme service managé, opérée en interne, ou combiner les deux approches. Les plateformes managées réduisent la charge opérationnelle et passent facilement à l’échelle, tandis que les runners auto-hébergés offrent plus de contrôle sur le réseau, le matériel, la sécurité et la conformité. Le bon modèle dépend des besoins de la charge de travail ; la plateforme doit masquer la majeure partie de ce choix aux développeurs chaque fois que possible.
Fournir un paved path
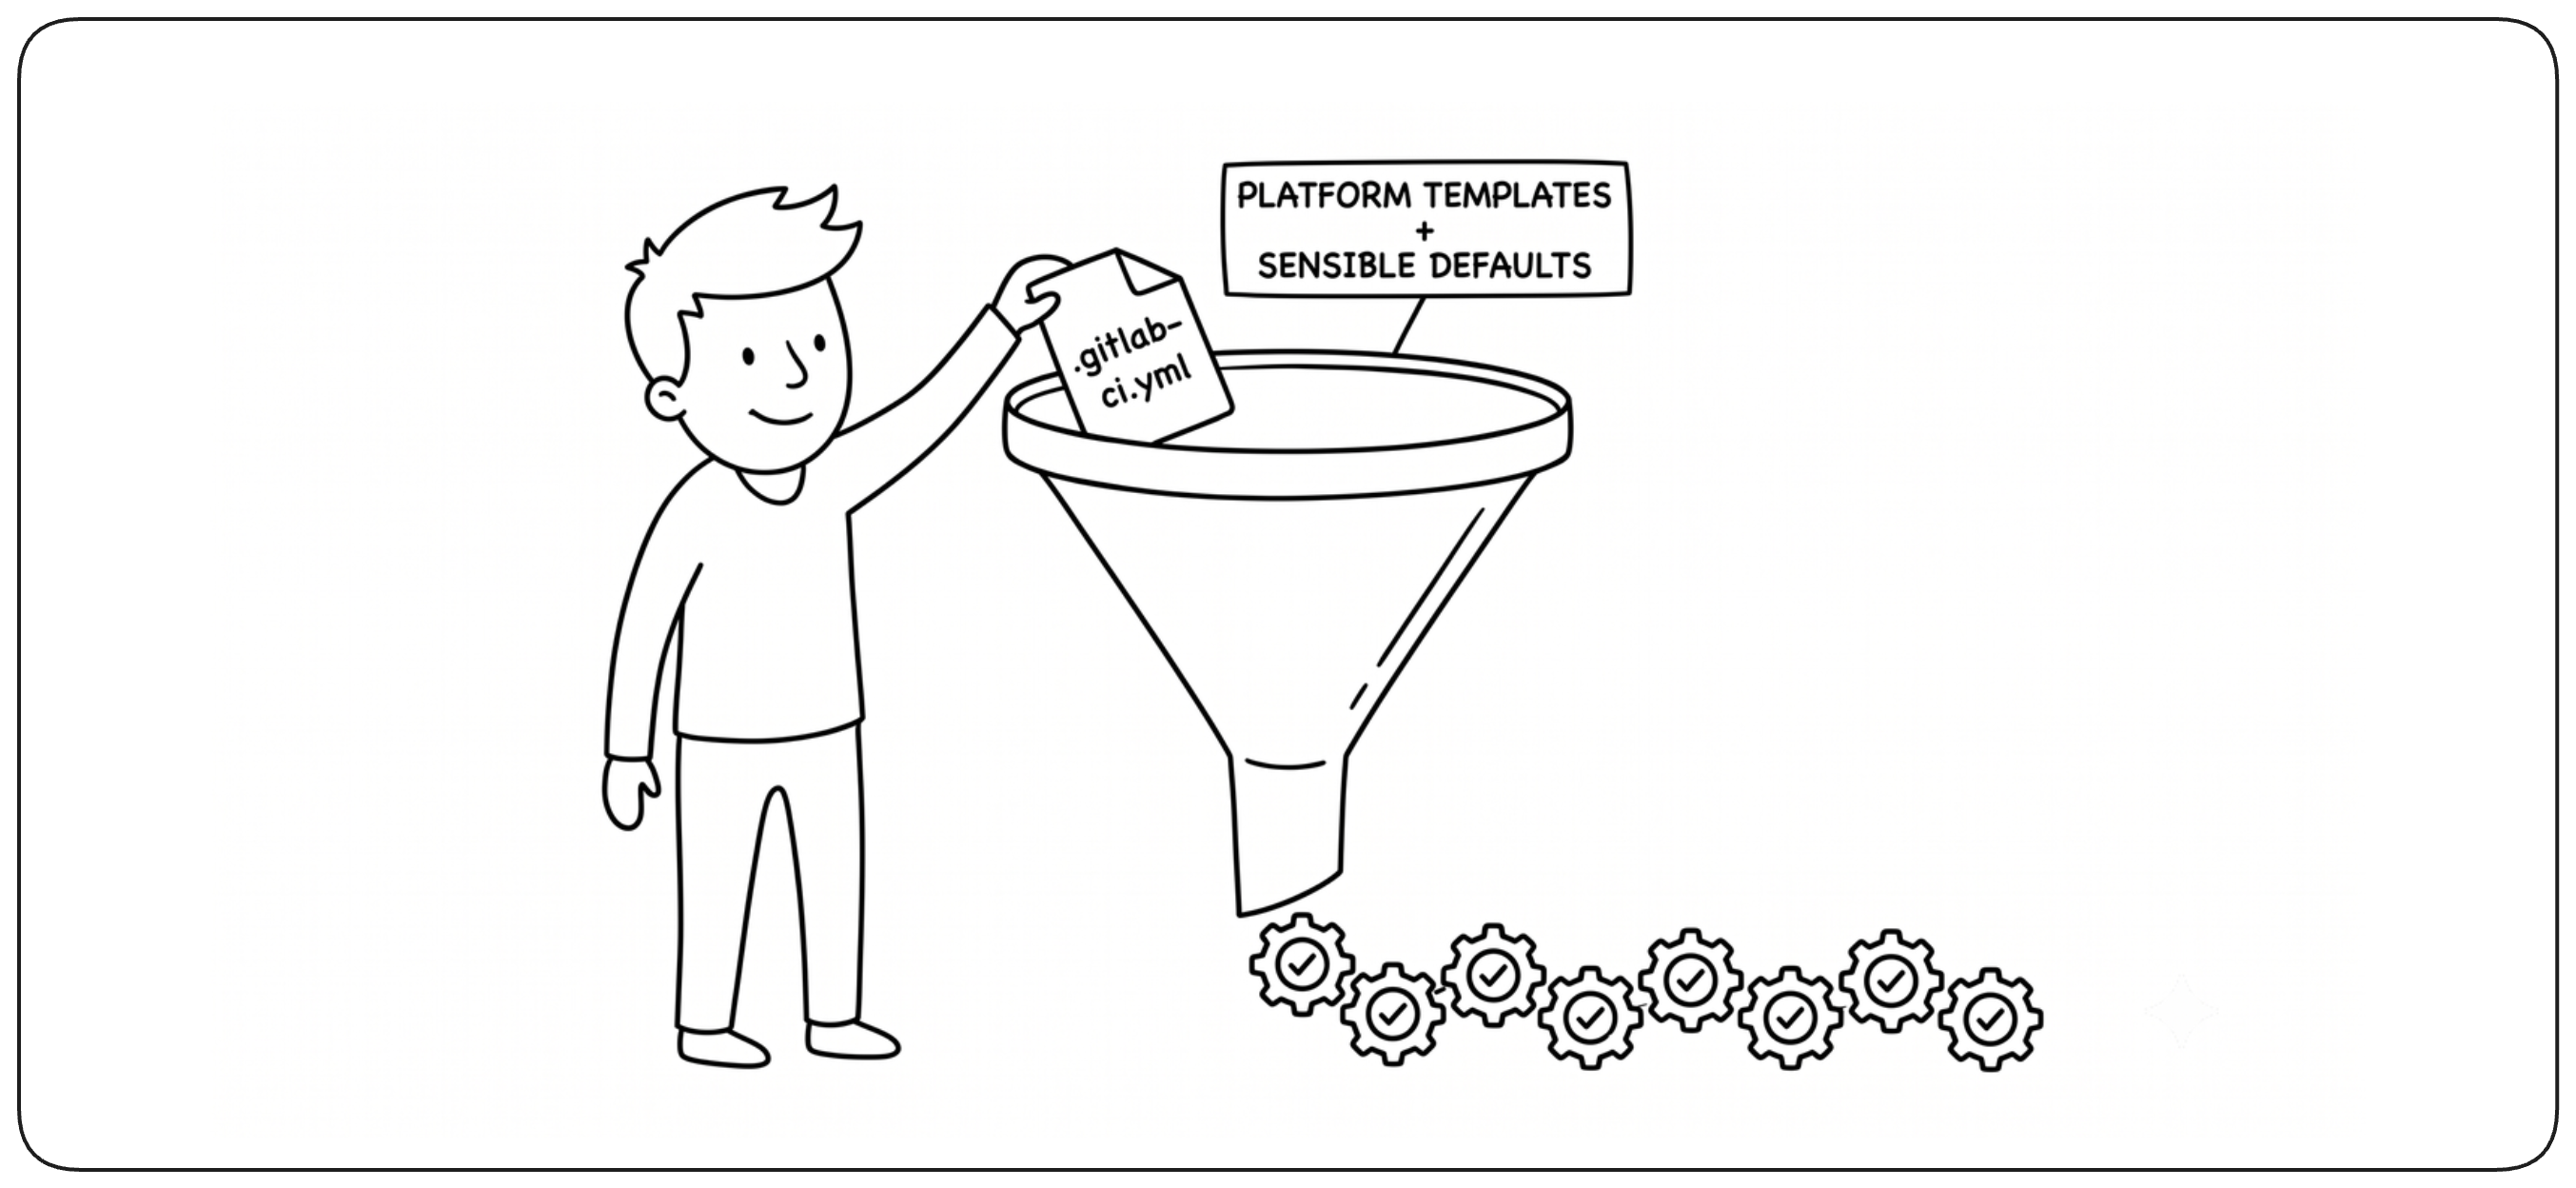
Le chemin courant doit exiger très peu de configuration. Des templates réutilisables, des valeurs par défaut sensées et des contrôles de qualité et de sécurité intégrés permettent aux équipes de démarrer avec un build fiable sans concevoir un pipeline de zéro. Les développeurs ne doivent personnaliser le build que lorsque leur application exige vraiment quelque chose de différent.
Optimiser pour la plateforme, pas pour le build individuel
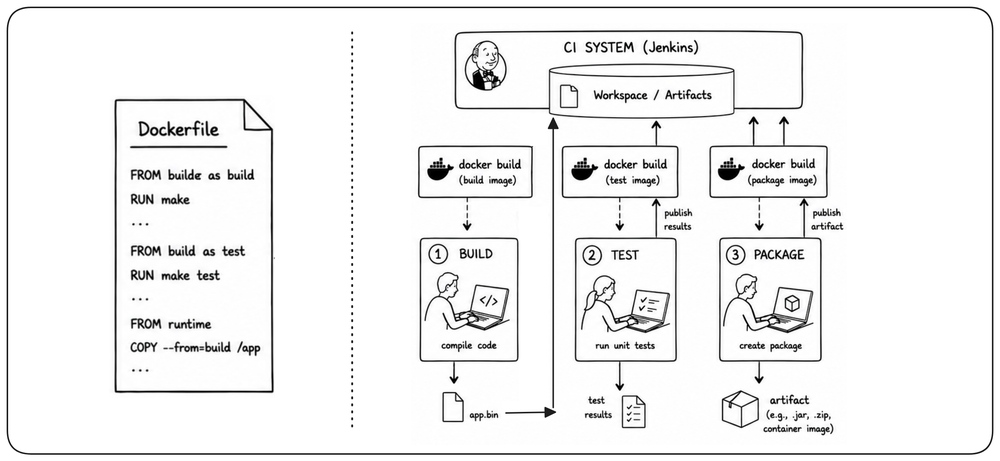
La conception d’une plateforme exige parfois de sacrifier une bonne pratique locale au profit d’une plus grande cohérence et d’un meilleur contrôle à grande échelle. Un build Docker multi-stage peut être élégant pour un service, mais garder compilation, tests et packaging visibles comme étapes de plateforme distinctes peut faciliter la standardisation du reporting, des contrôles de sécurité, du caching et de l’application des politiques entre de nombreuses équipes. L’objectif n’est pas d’optimiser chaque build isolément, mais de choisir des conventions qui rendent l’ensemble de la plateforme plus facile à exploiter et à faire évoluer.
Utiliser des étapes managées pour les capacités partagées
Les capacités de build communes doivent être fournies comme des briques maintenues de façon centralisée plutôt que réimplémentées indépendamment par chaque équipe. Des étapes managées pour des tâches comme l’analyse de sécurité, la publication ou la conformité permettent à la plateforme d’améliorer le comportement une seule fois et de propager cette amélioration partout. Les équipes gardent le contrôle de la logique de build propre à leur application, tandis que les préoccupations partagées restent cohérentes et maintenables.
Garder les politiques en dehors de la définition du build
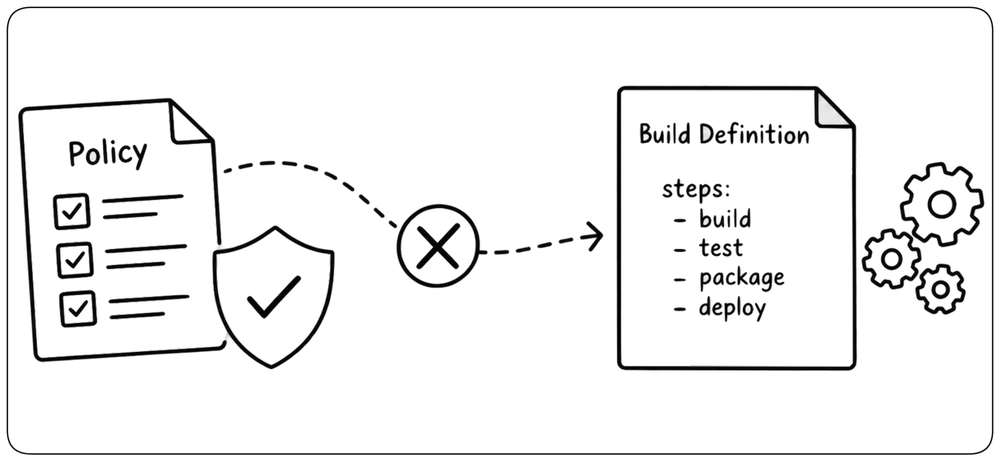
Dans les grandes organisations, la validation partagée ne doit pas dépendre du fait que chaque équipe mette à jour son Dockerfile ou son script de build. La plateforme doit fournir des points de contrôle standardisés autour du build, afin que de nouveaux contrôles de sécurité, de qualité ou de conformité puissent être introduits de façon centrale. Les équipes applicatives gardent le contrôle de la façon dont leur logiciel est construit, tandis que la plateforme contrôle les règles que chaque changement doit passer.
Garder la configuration du build as code
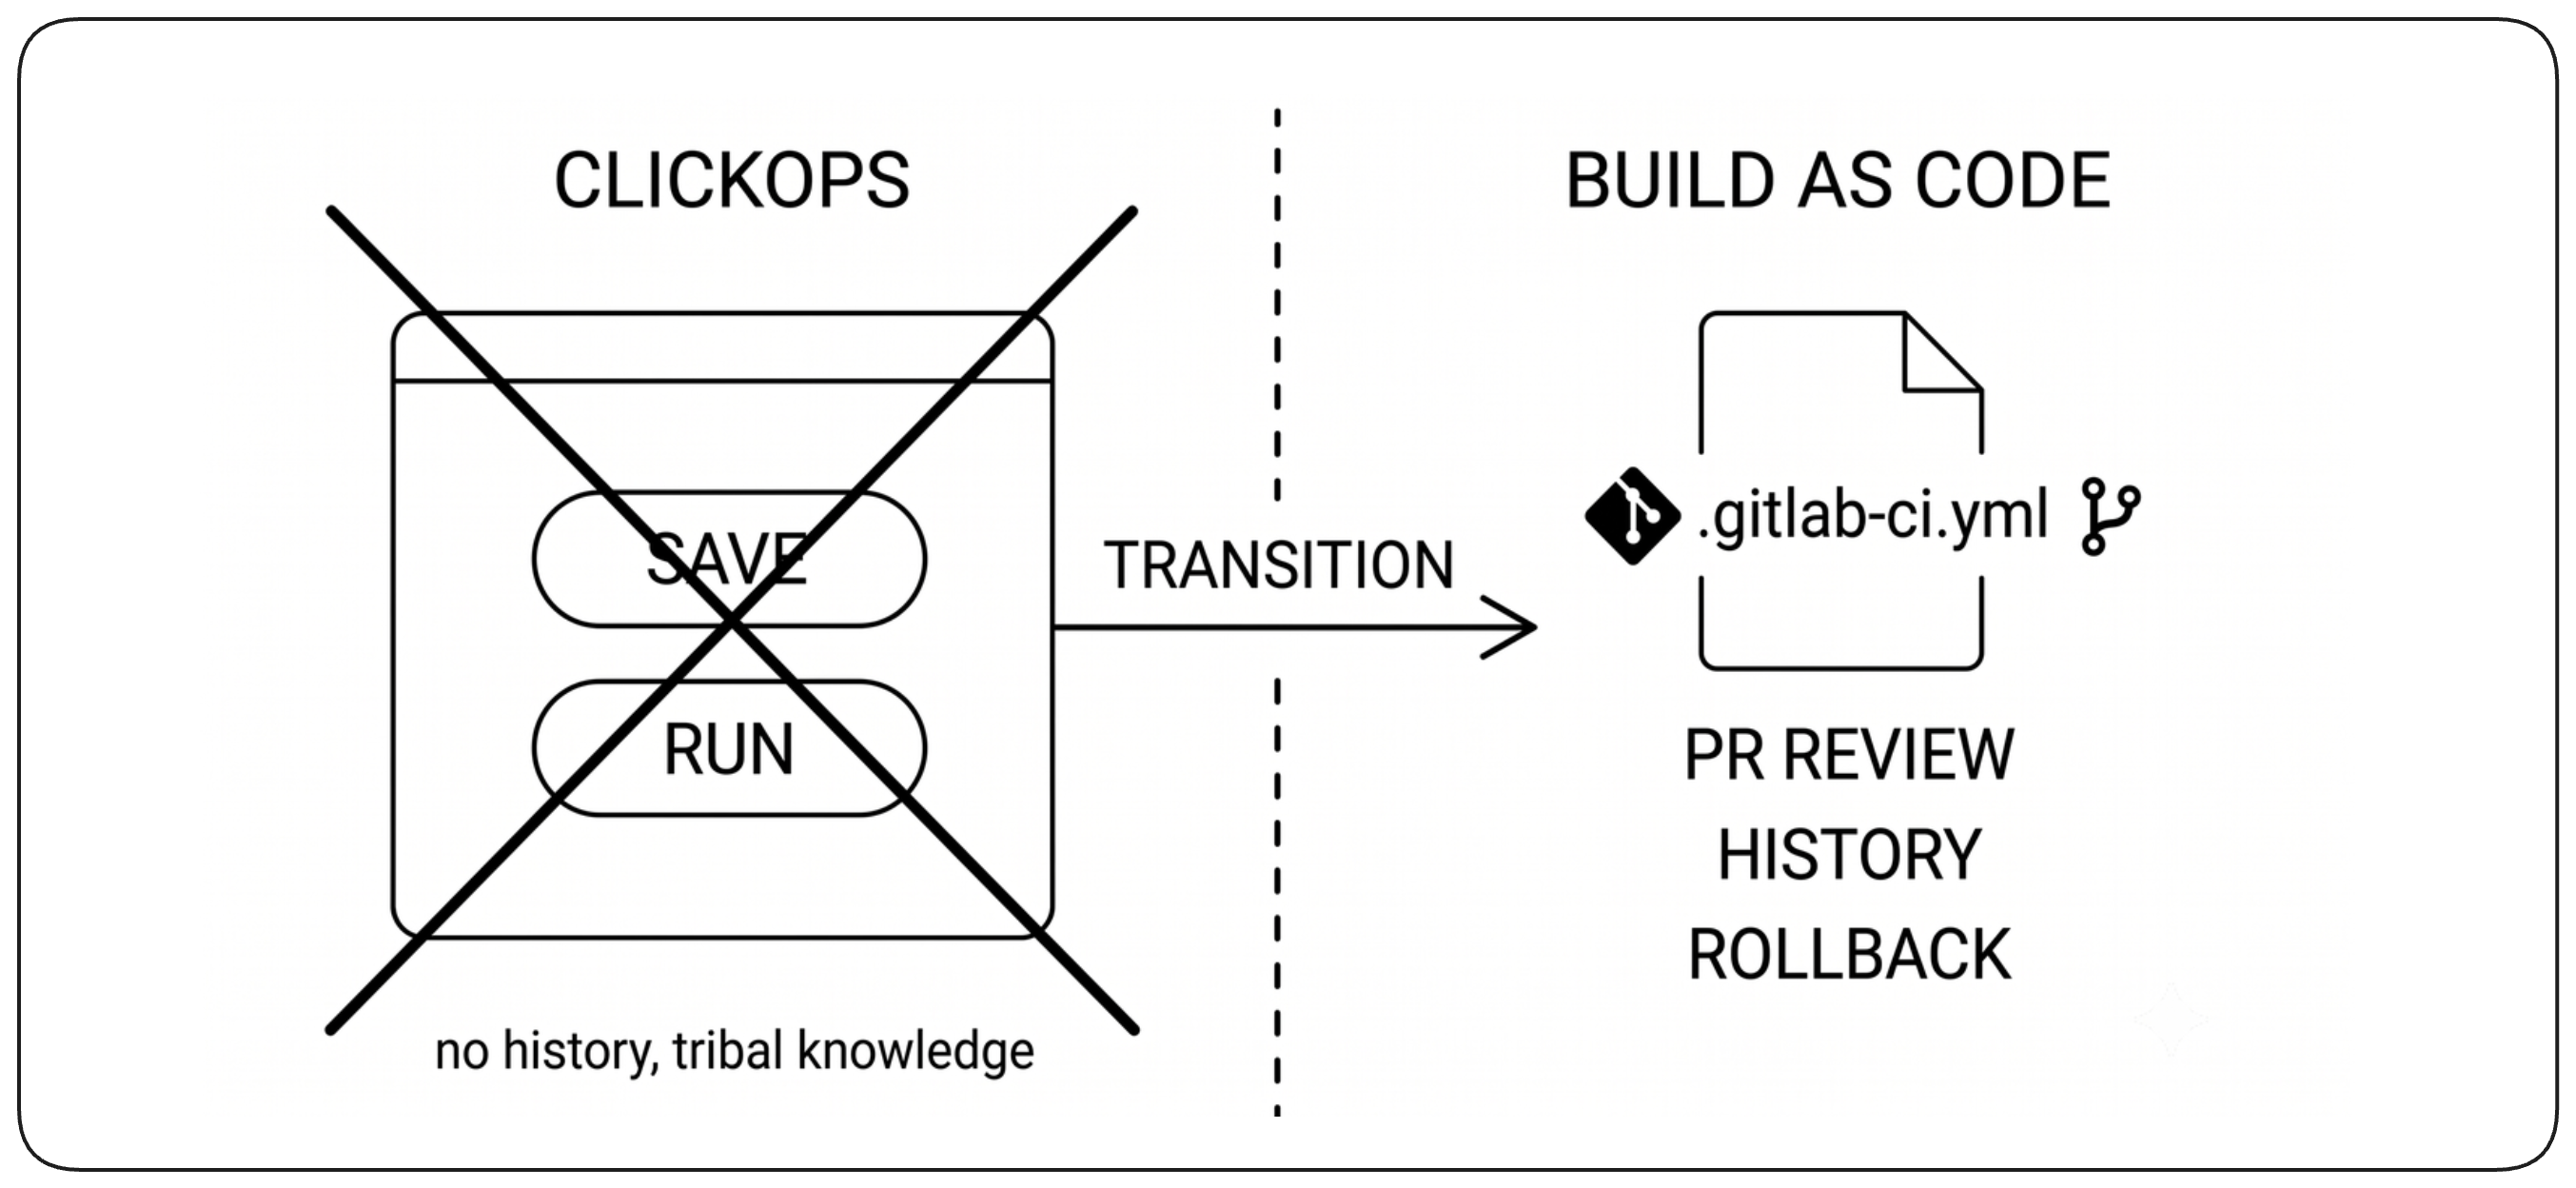
La configuration du build doit vivre dans le contrôle de version, avec le logiciel qu’elle construit. Les changements deviennent alors relisibles, traçables et réversibles comme n’importe quel autre changement de code. Évitez que des comportements critiques du build n’existent que sous forme de configuration modifiable dans une interface web, où leur historique et leur intention sont difficiles à comprendre.
Permettre le self-service avec des garde-fous
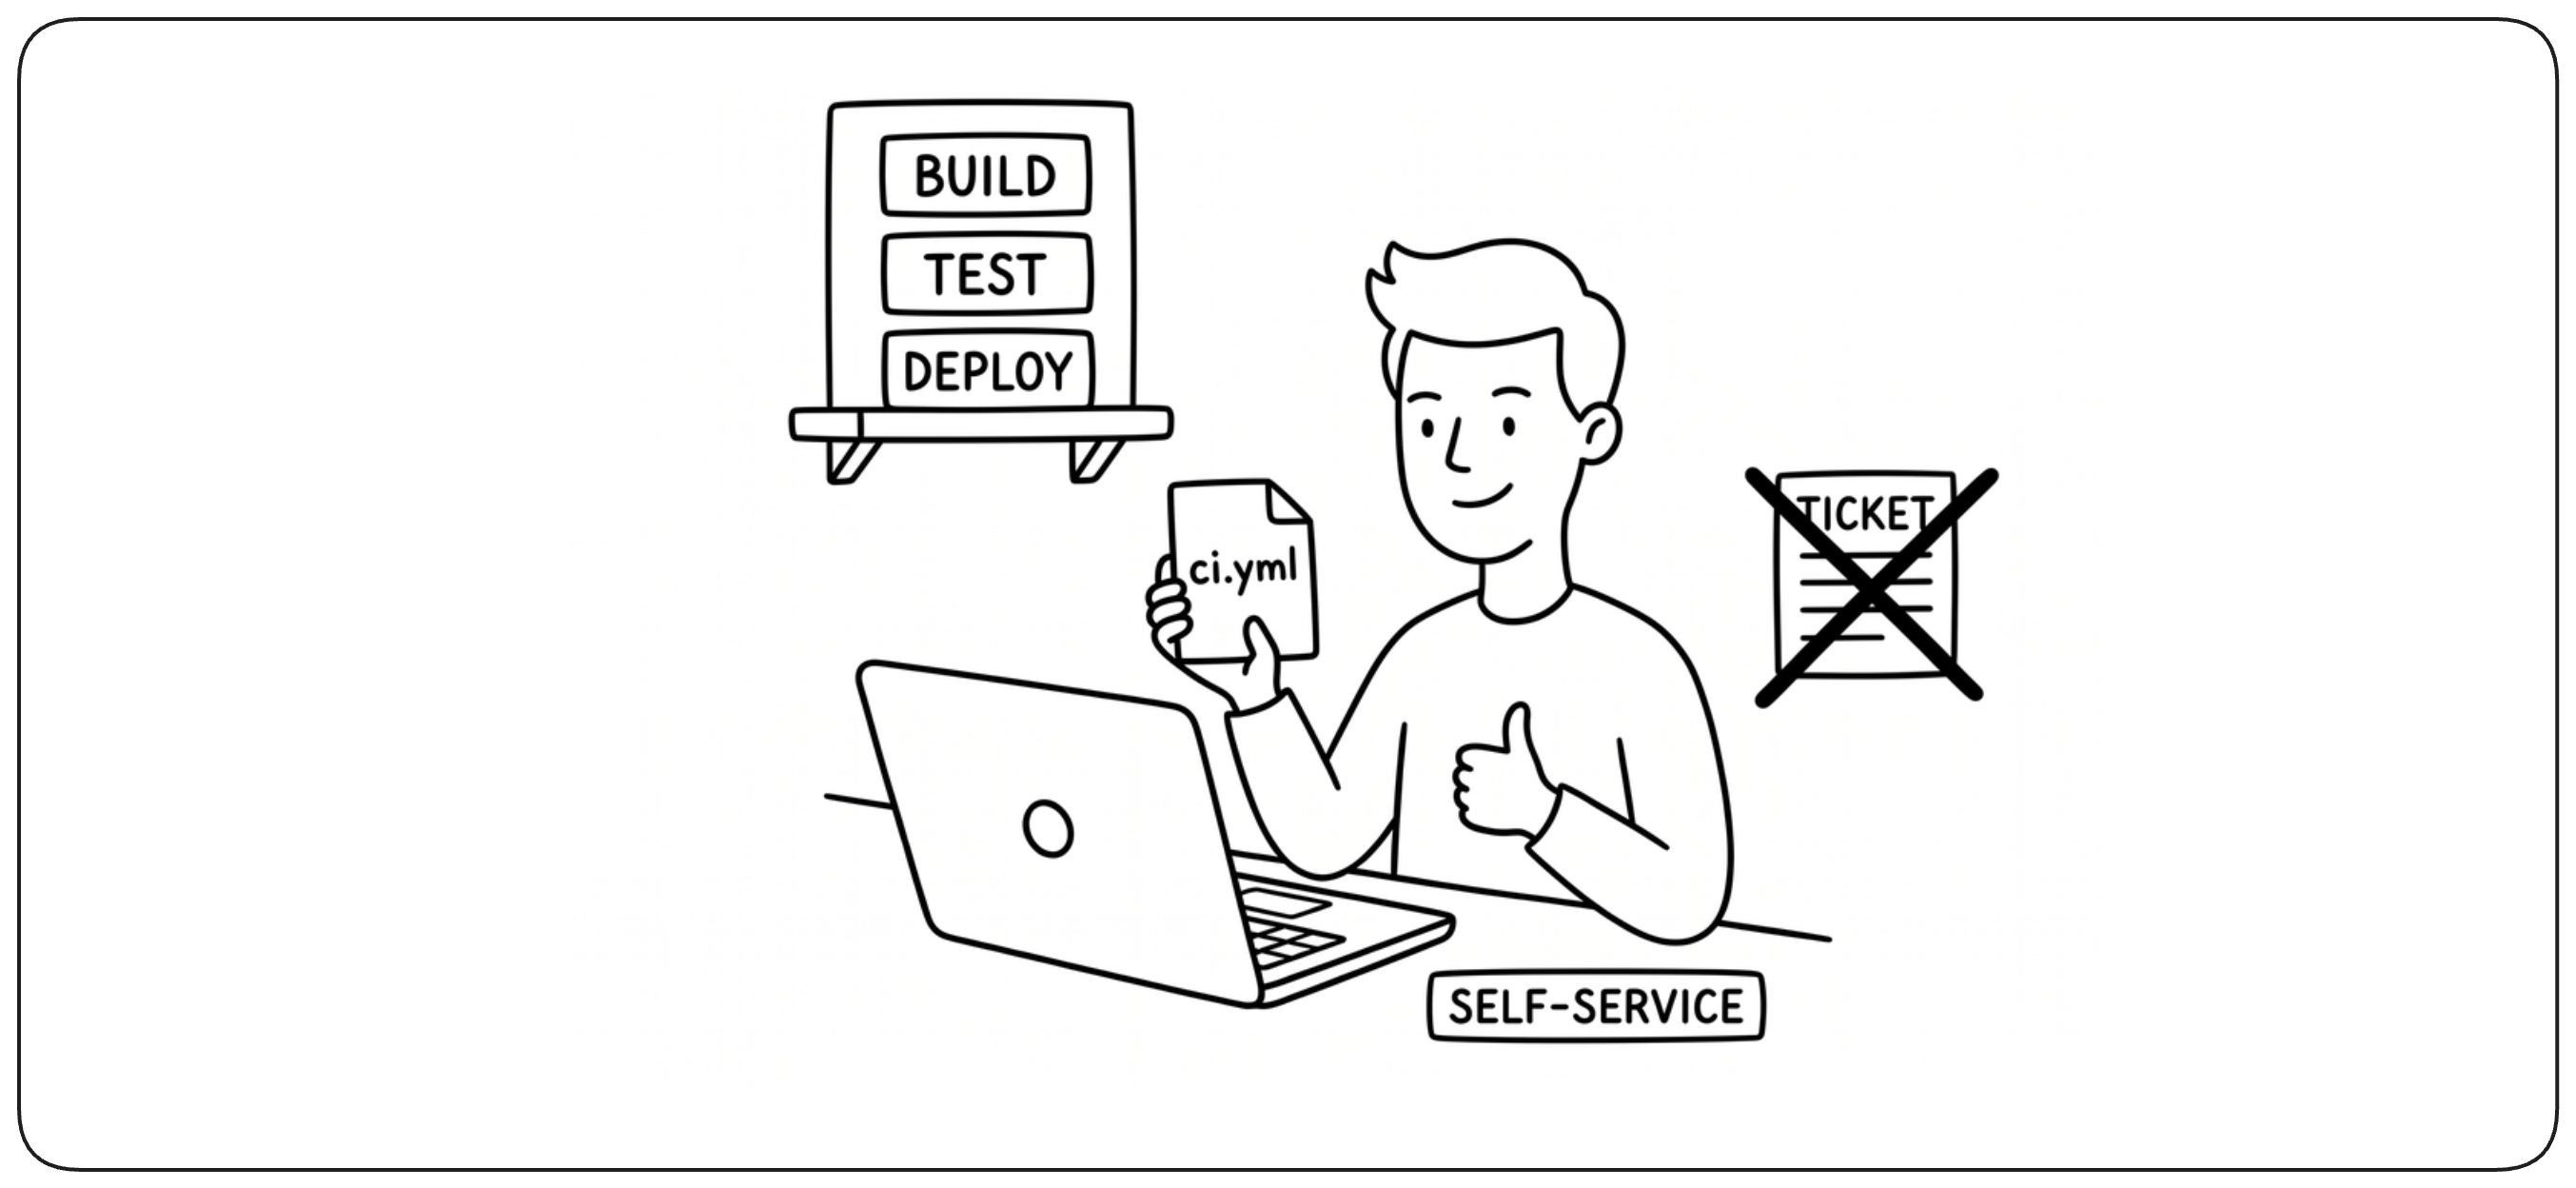
Les développeurs doivent pouvoir modifier et étendre leur propre configuration de build sans dépendre d’une équipe plateforme pour chaque changement. La plateforme doit fournir des templates réutilisables, des politiques et des valeurs par défaut sûres, tandis que les équipes applicatives restent libres d’adapter le build à leurs besoins. Le self-service fait passer l’ownership à l’échelle sans renoncer à la cohérence ni à la sécurité. Les mêmes garde-fous doivent s’appliquer aux chemins d’expérimentation, pour permettre aux équipes d’avancer vite sans que l’expérimentation devienne un moyen de contourner les contrôles requis en production.
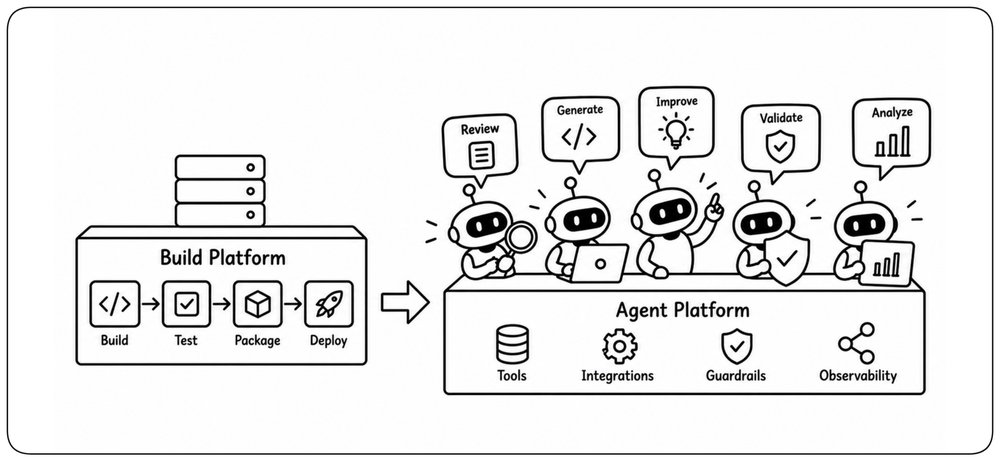
Les plateformes de build deviennent des plateformes d’agents
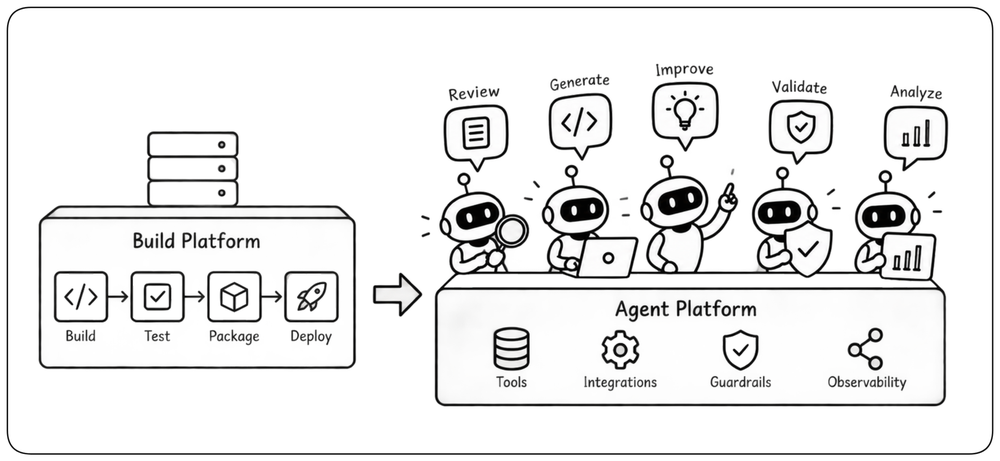
Les plateformes de build ont été conçues avant tout pour les développeurs et les scripts d’automatisation. Les agents IA deviennent maintenant une nouvelle catégorie d’utilisateurs, qui exige des interfaces programmables, un feedback structuré, des permissions bornées et de solides garde-fous. Les agents doivent pouvoir inspecter les échecs, déclencher du travail et itérer de façon autonome sans obtenir un moyen de contourner le chemin de confiance vers la production.
Performance du build
Des builds rapides préservent la boucle de feedback dont dépend l’intégration continue. La performance doit se mesurer à la rapidité avec laquelle les développeurs reçoivent un feedback utile, et non simplement à la rapidité avec laquelle chaque tâche de build se termine. À mesure que le build grossit, optimisez le travail qui se trouve sur ce chemin critique du feedback.
Optimiser le chemin critique
La performance du build est déterminée par le travail qui bloque le feedback utile. Mesurez le chemin critique, identifiez les étapes les plus lentes et optimisez en premier les parties que les développeurs doivent attendre. Accélérer le travail non bloquant est utile, mais réduire le chemin bloquant a le plus grand impact sur le flow des développeurs.
Mesurer la capacité de la boucle de feedback
À mesure que le rythme des changements proposés augmente, la latence du build peut croître même si chaque build n’est pas devenu plus lent. Suivez le temps d’attente en file, le temps de feedback, le débit et le taux de réussite des builds pour détecter quand le système de validation se sature. Un build rapide ne suffit pas si les changements passent l’essentiel de leur temps à attendre d’être exécutés.
Exécuter en parallèle le travail indépendant
Les étapes de build qui ne dépendent pas les unes des autres doivent s’exécuter simultanément plutôt que séquentiellement. Tests, analyse statique, étapes de packaging et vérifications de configuration peuvent souvent s’exécuter en parallèle, ce qui réduit le temps écoulé sans supprimer de validation. Le parallélisme doit être appliqué là où il raccourcit le chemin critique sans créer de coût ou de complexité excessifs.
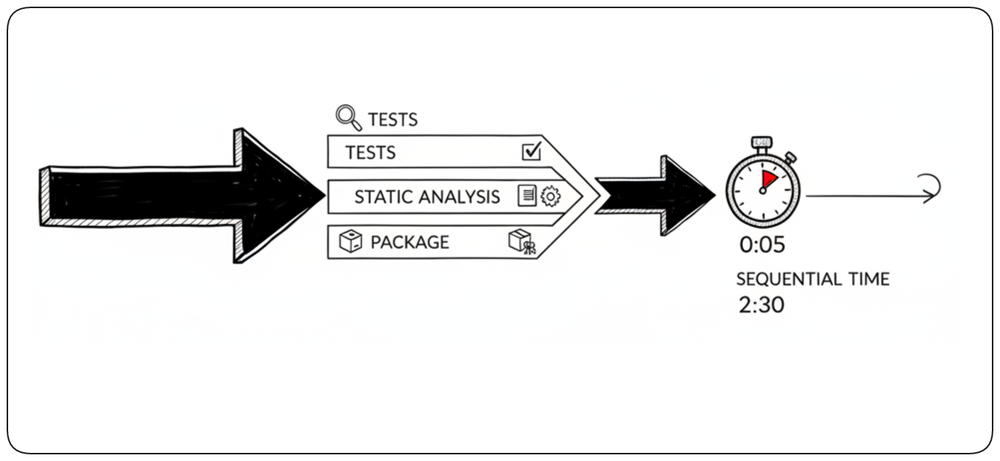
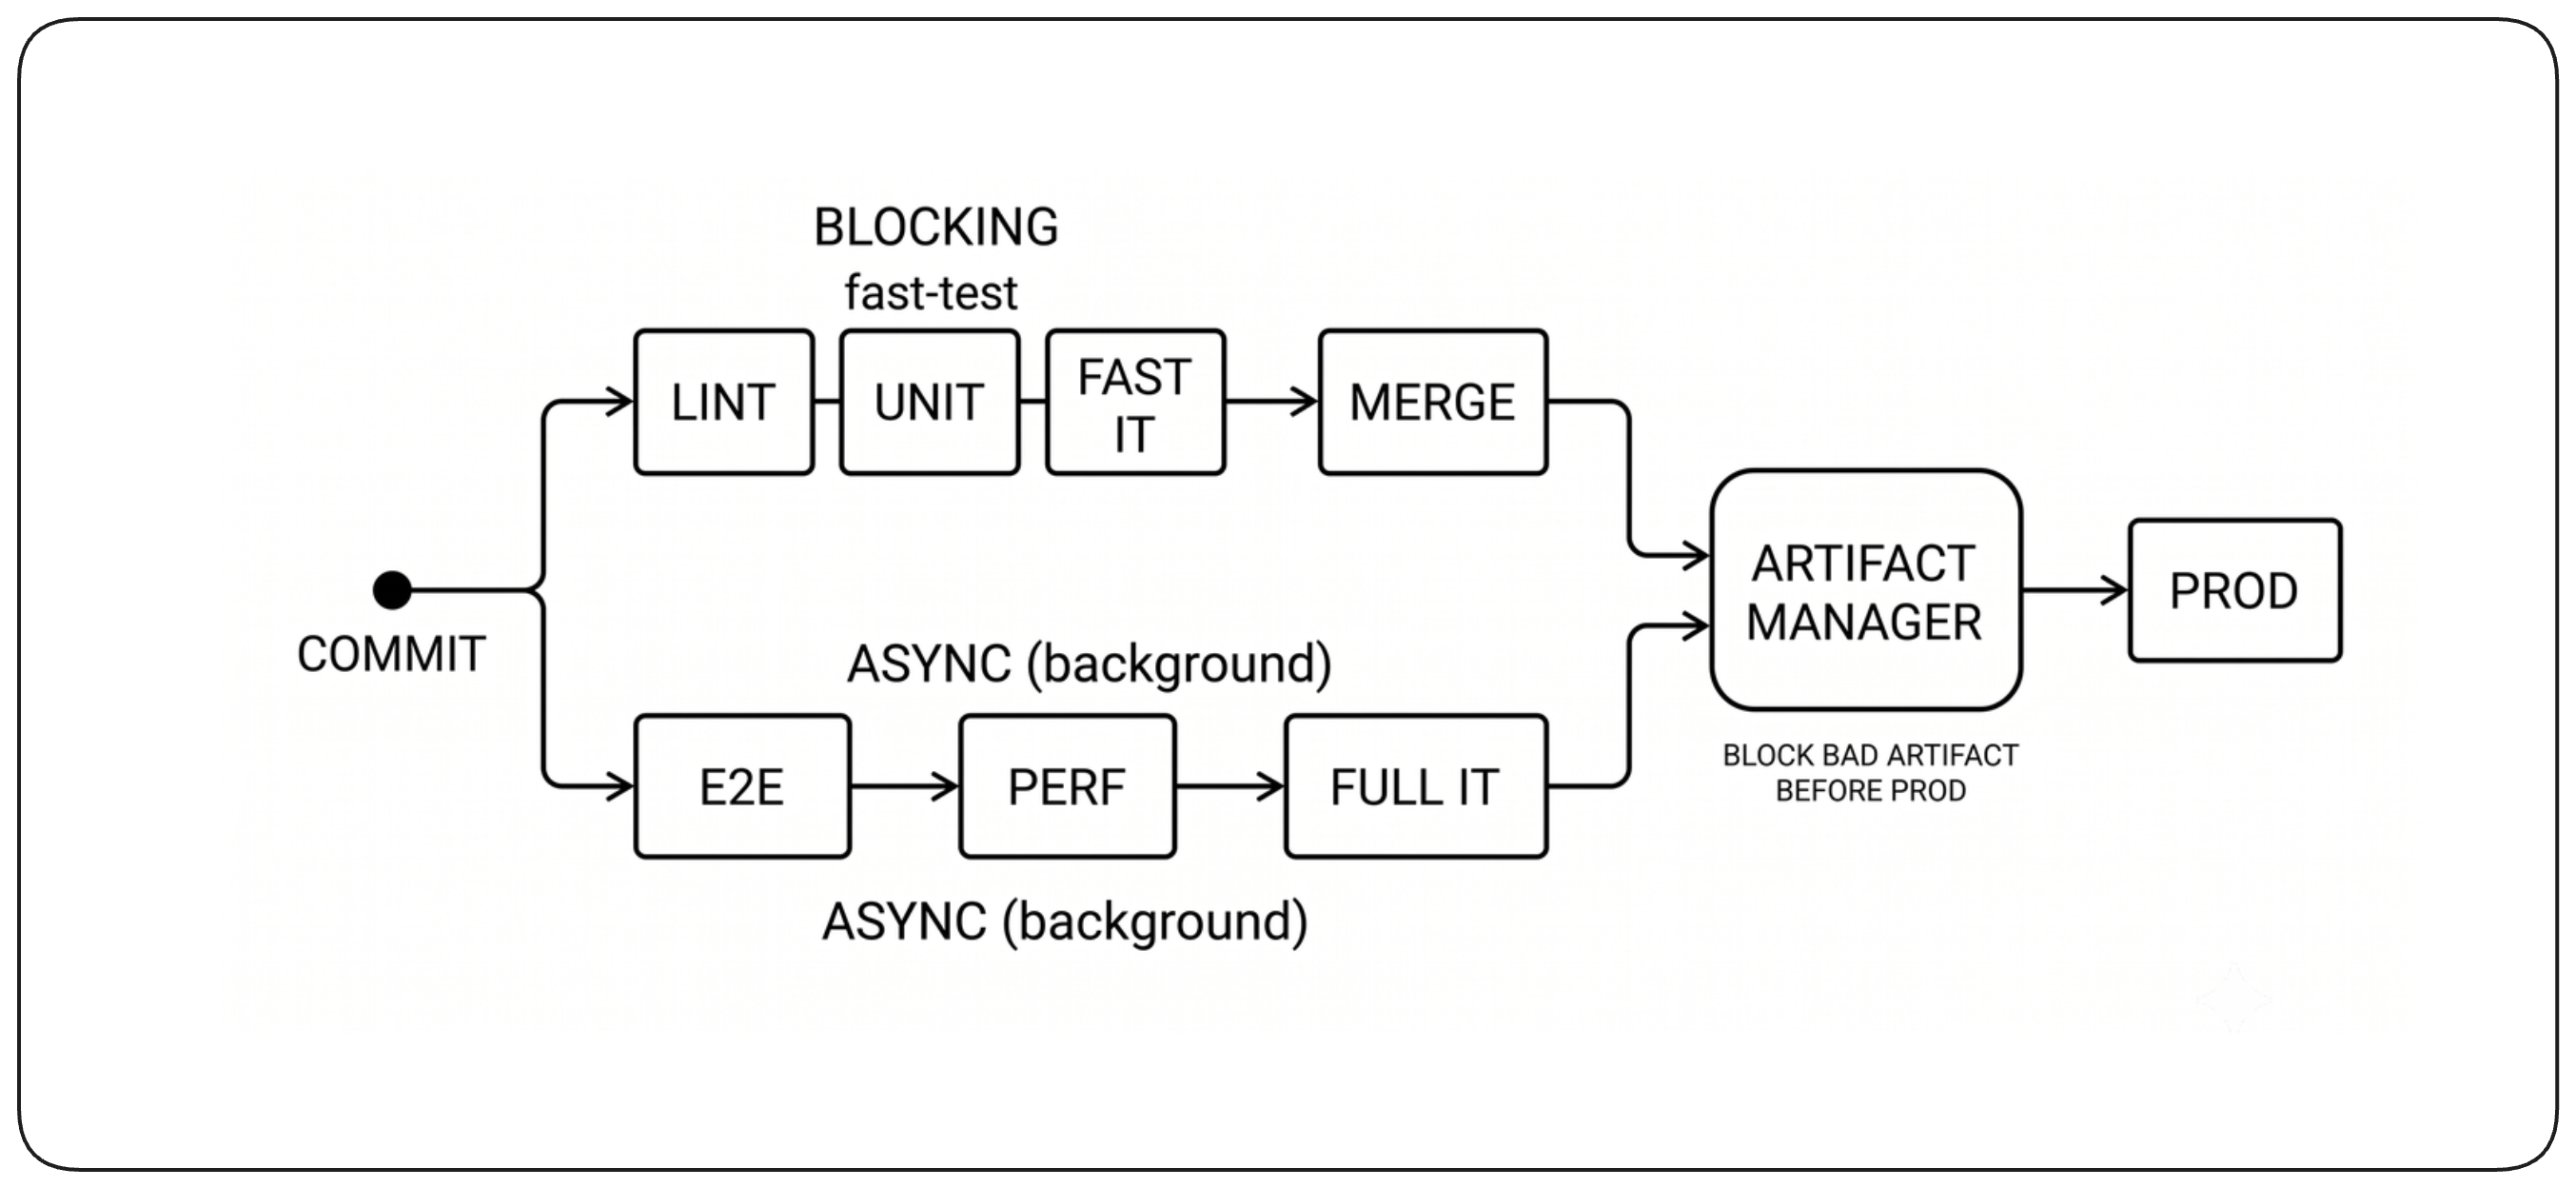
Différer les vérifications coûteuses sans perdre le contrôle
Certaines vérifications précieuses sont trop lentes pour bloquer chaque changement. Les tests de bout en bout, de performance ou impliquant des systèmes externes, de longue durée, peuvent s’exécuter de façon asynchrone sur l’artefact exact produit par le build. Ils ne doivent pas retarder le feedback rapide aux développeurs, mais ils doivent quand même pouvoir empêcher cet artefact d’atteindre la production si un problème sérieux est trouvé.
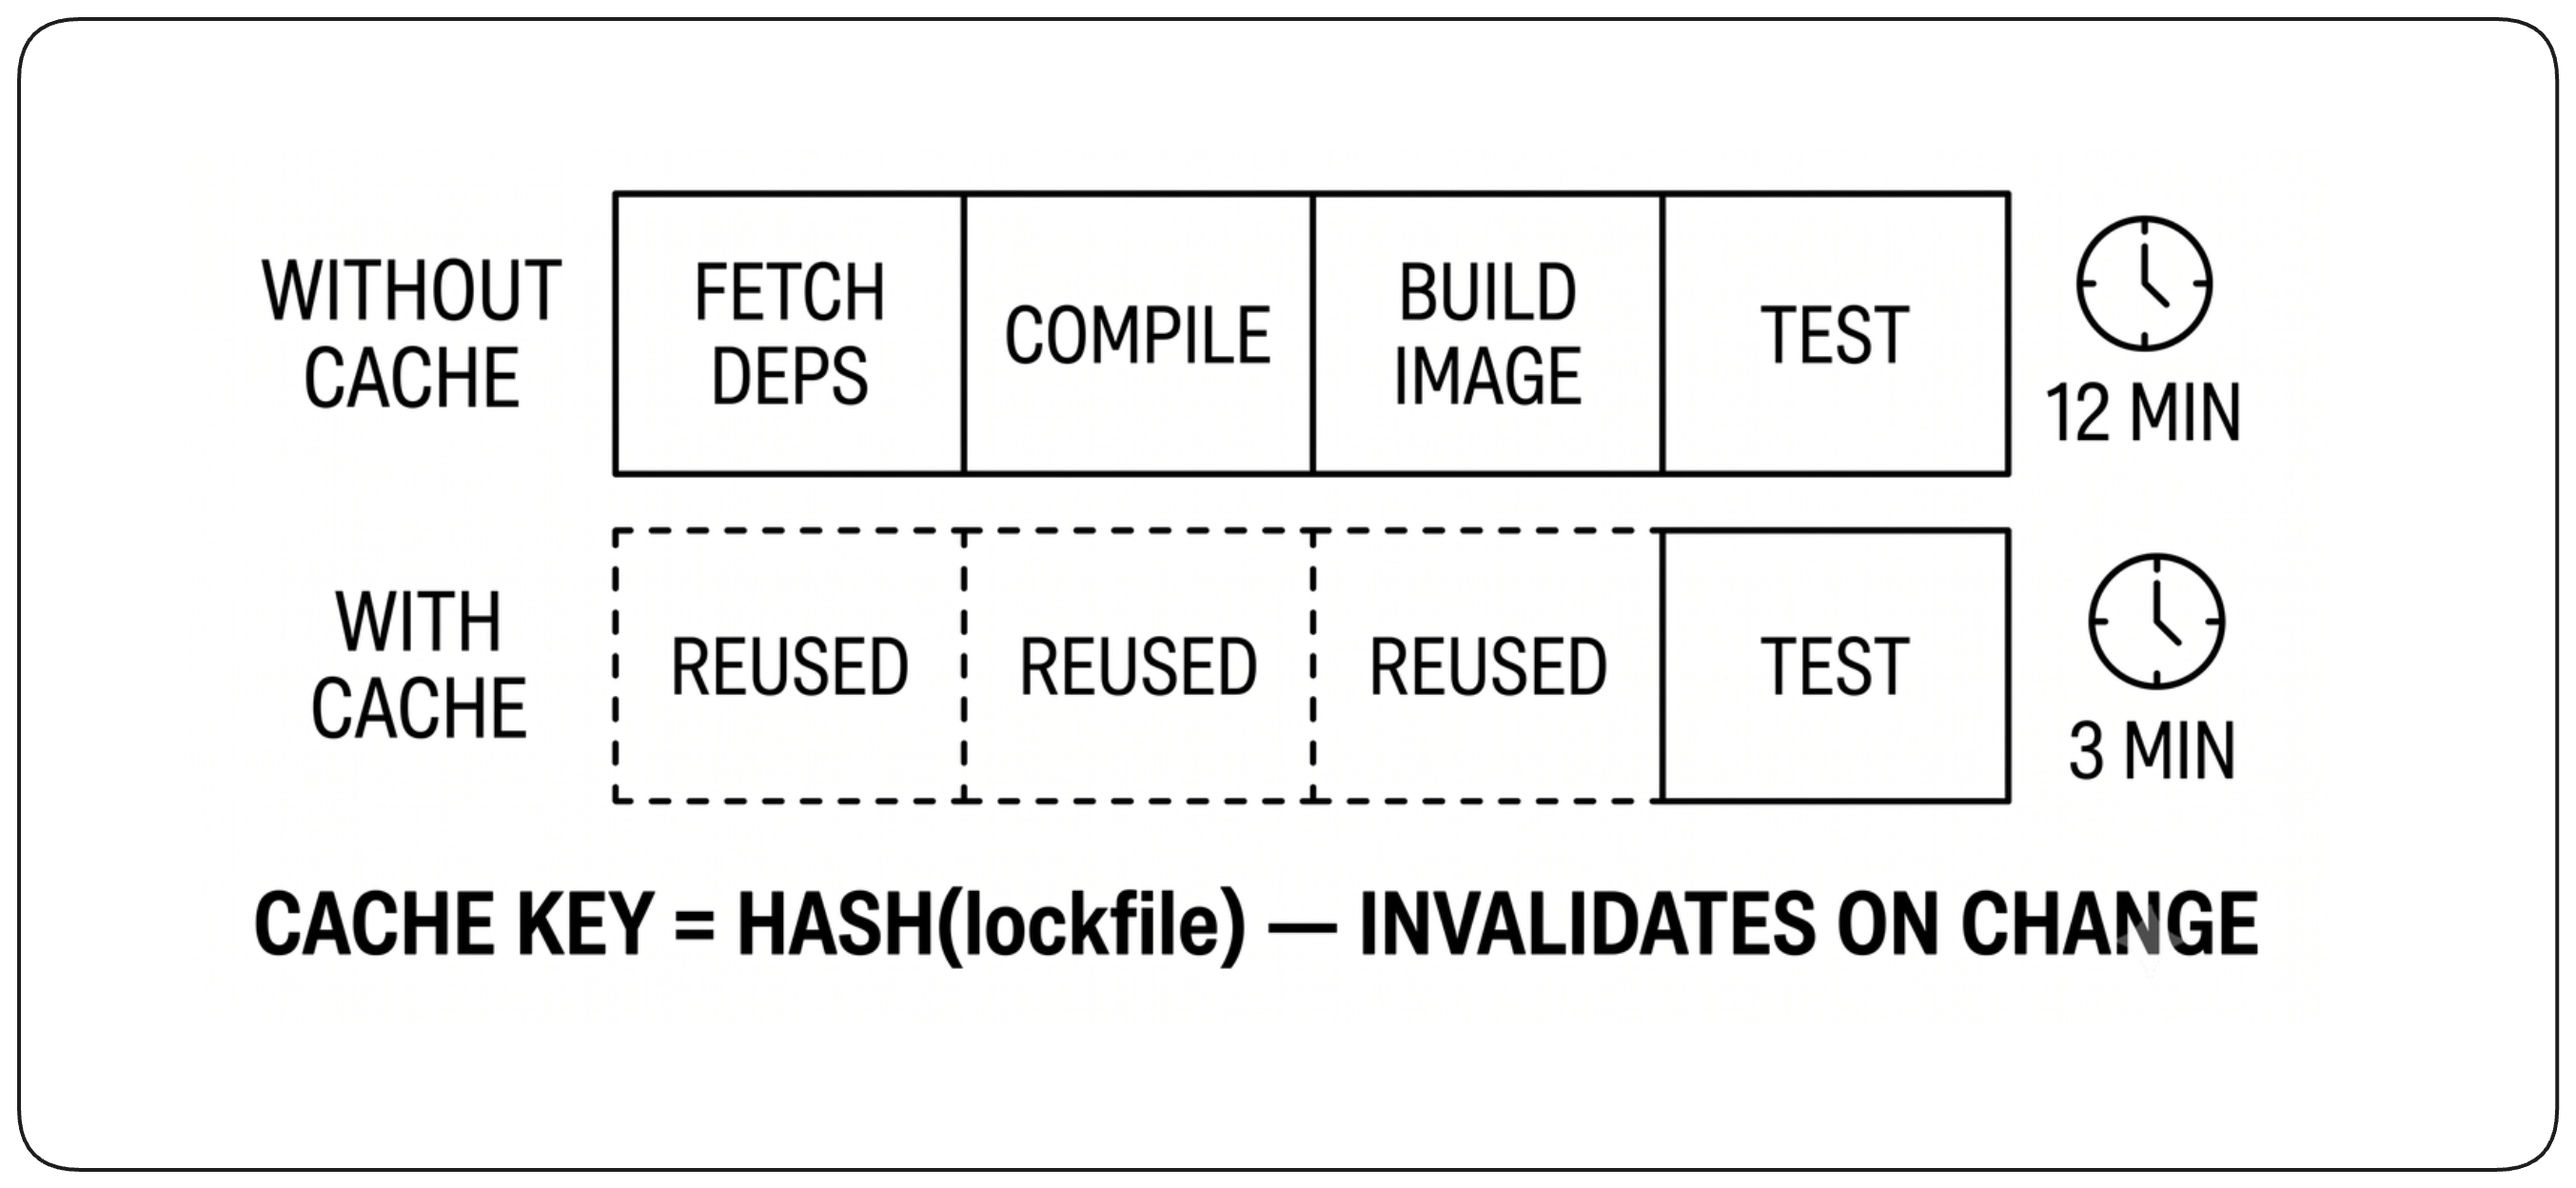
Réutiliser le travail en sécurité grâce au cache
Le cache évite de répéter un travail dont les entrées n’ont pas changé, comme télécharger des dépendances, reconstruire des composants inchangés ou relancer des tests dont les entrées pertinentes sont identiques. Les clés de cache doivent être dérivées de toutes les entrées susceptibles d’affecter le résultat mis en cache, afin que les résultats périmés soient invalidés automatiquement. Un cache est une optimisation, jamais une dépendance cachée : le vider doit rendre le build plus lent, pas changer son succès ou son échec.
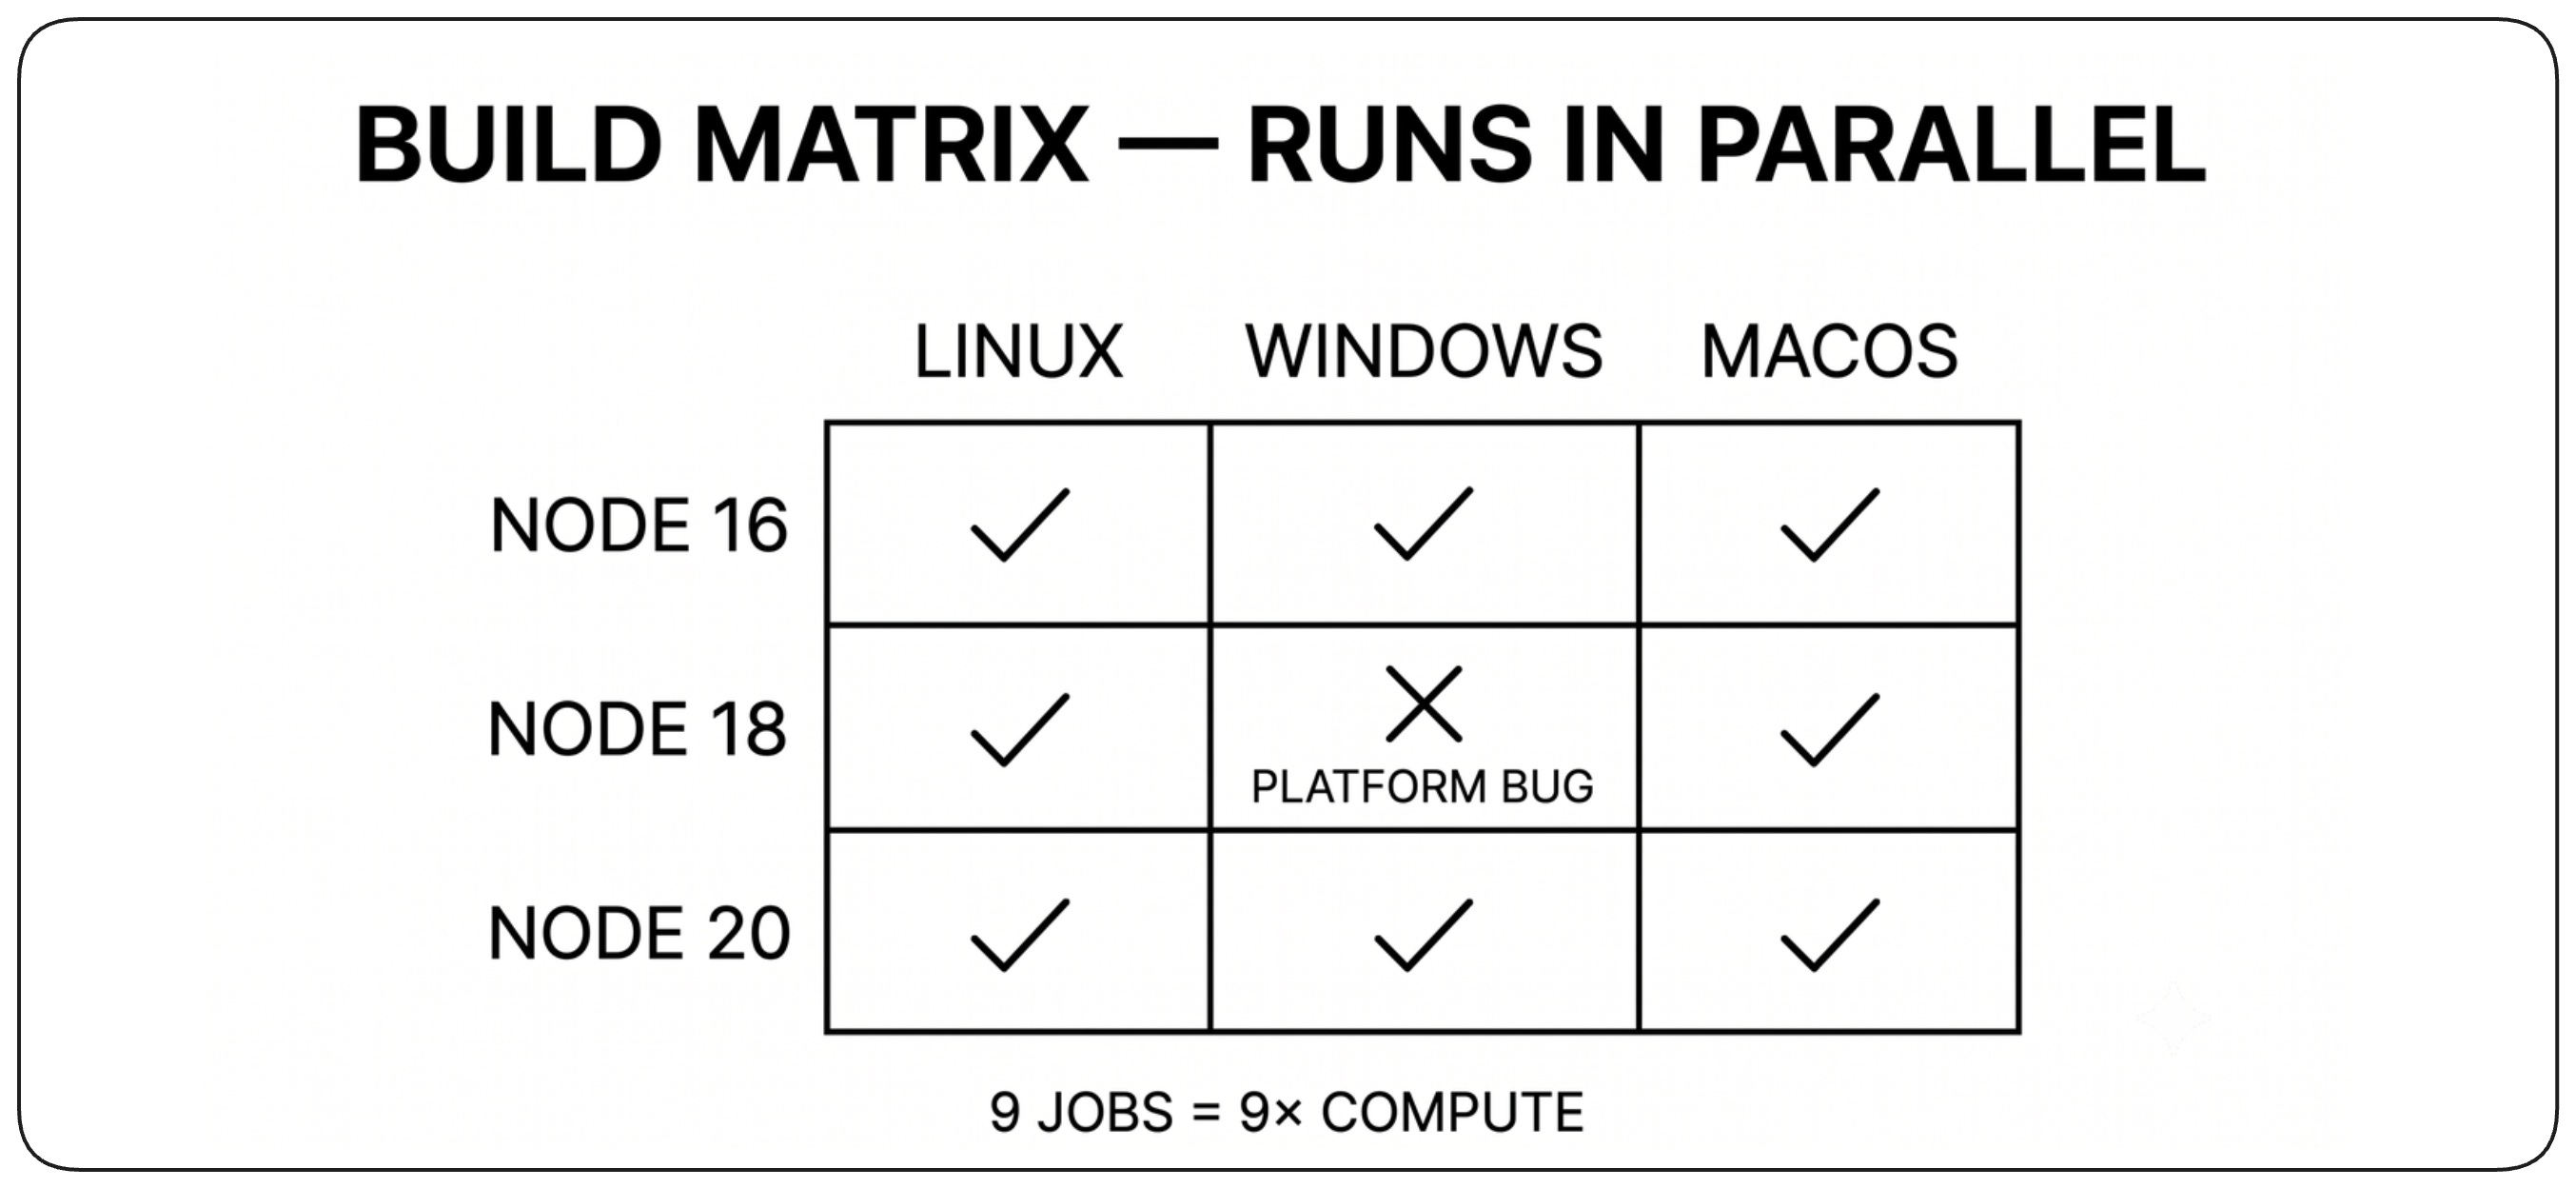
Ne tester que les configurations qui comptent
Certains logiciels doivent être validés sur plusieurs systèmes d’exploitation, versions de langage, architectures ou combinaisons de dépendances. Une matrice de build rend ces variations explicites et permet de les exécuter en parallèle, mais chaque combinaison supplémentaire augmente le coût et le temps de feedback. Testez les configurations qui représentent de vraies exigences de compatibilité plutôt que toutes les combinaisons théoriques.
Expérience développeur
L’expérience développeur détermine si les développeurs font confiance au build et l’adoptent, ou s’ils essaient de le contourner. Un bon build reste discret quand tout fonctionne, donne des indications claires quand ce n’est pas le cas, et rend les workflows de développement courants simples et prévisibles.
Faire disparaître le build dans le workflow
Un bon build doit demander le moins d’attention possible quand tout fonctionne. Les développeurs doivent pouvoir commiter, recevoir du feedback et continuer à travailler sans penser à l’infrastructure de build. Le build ne devient visible que lorsqu’il a une information utile à fournir.
Rendre les échecs exploitables
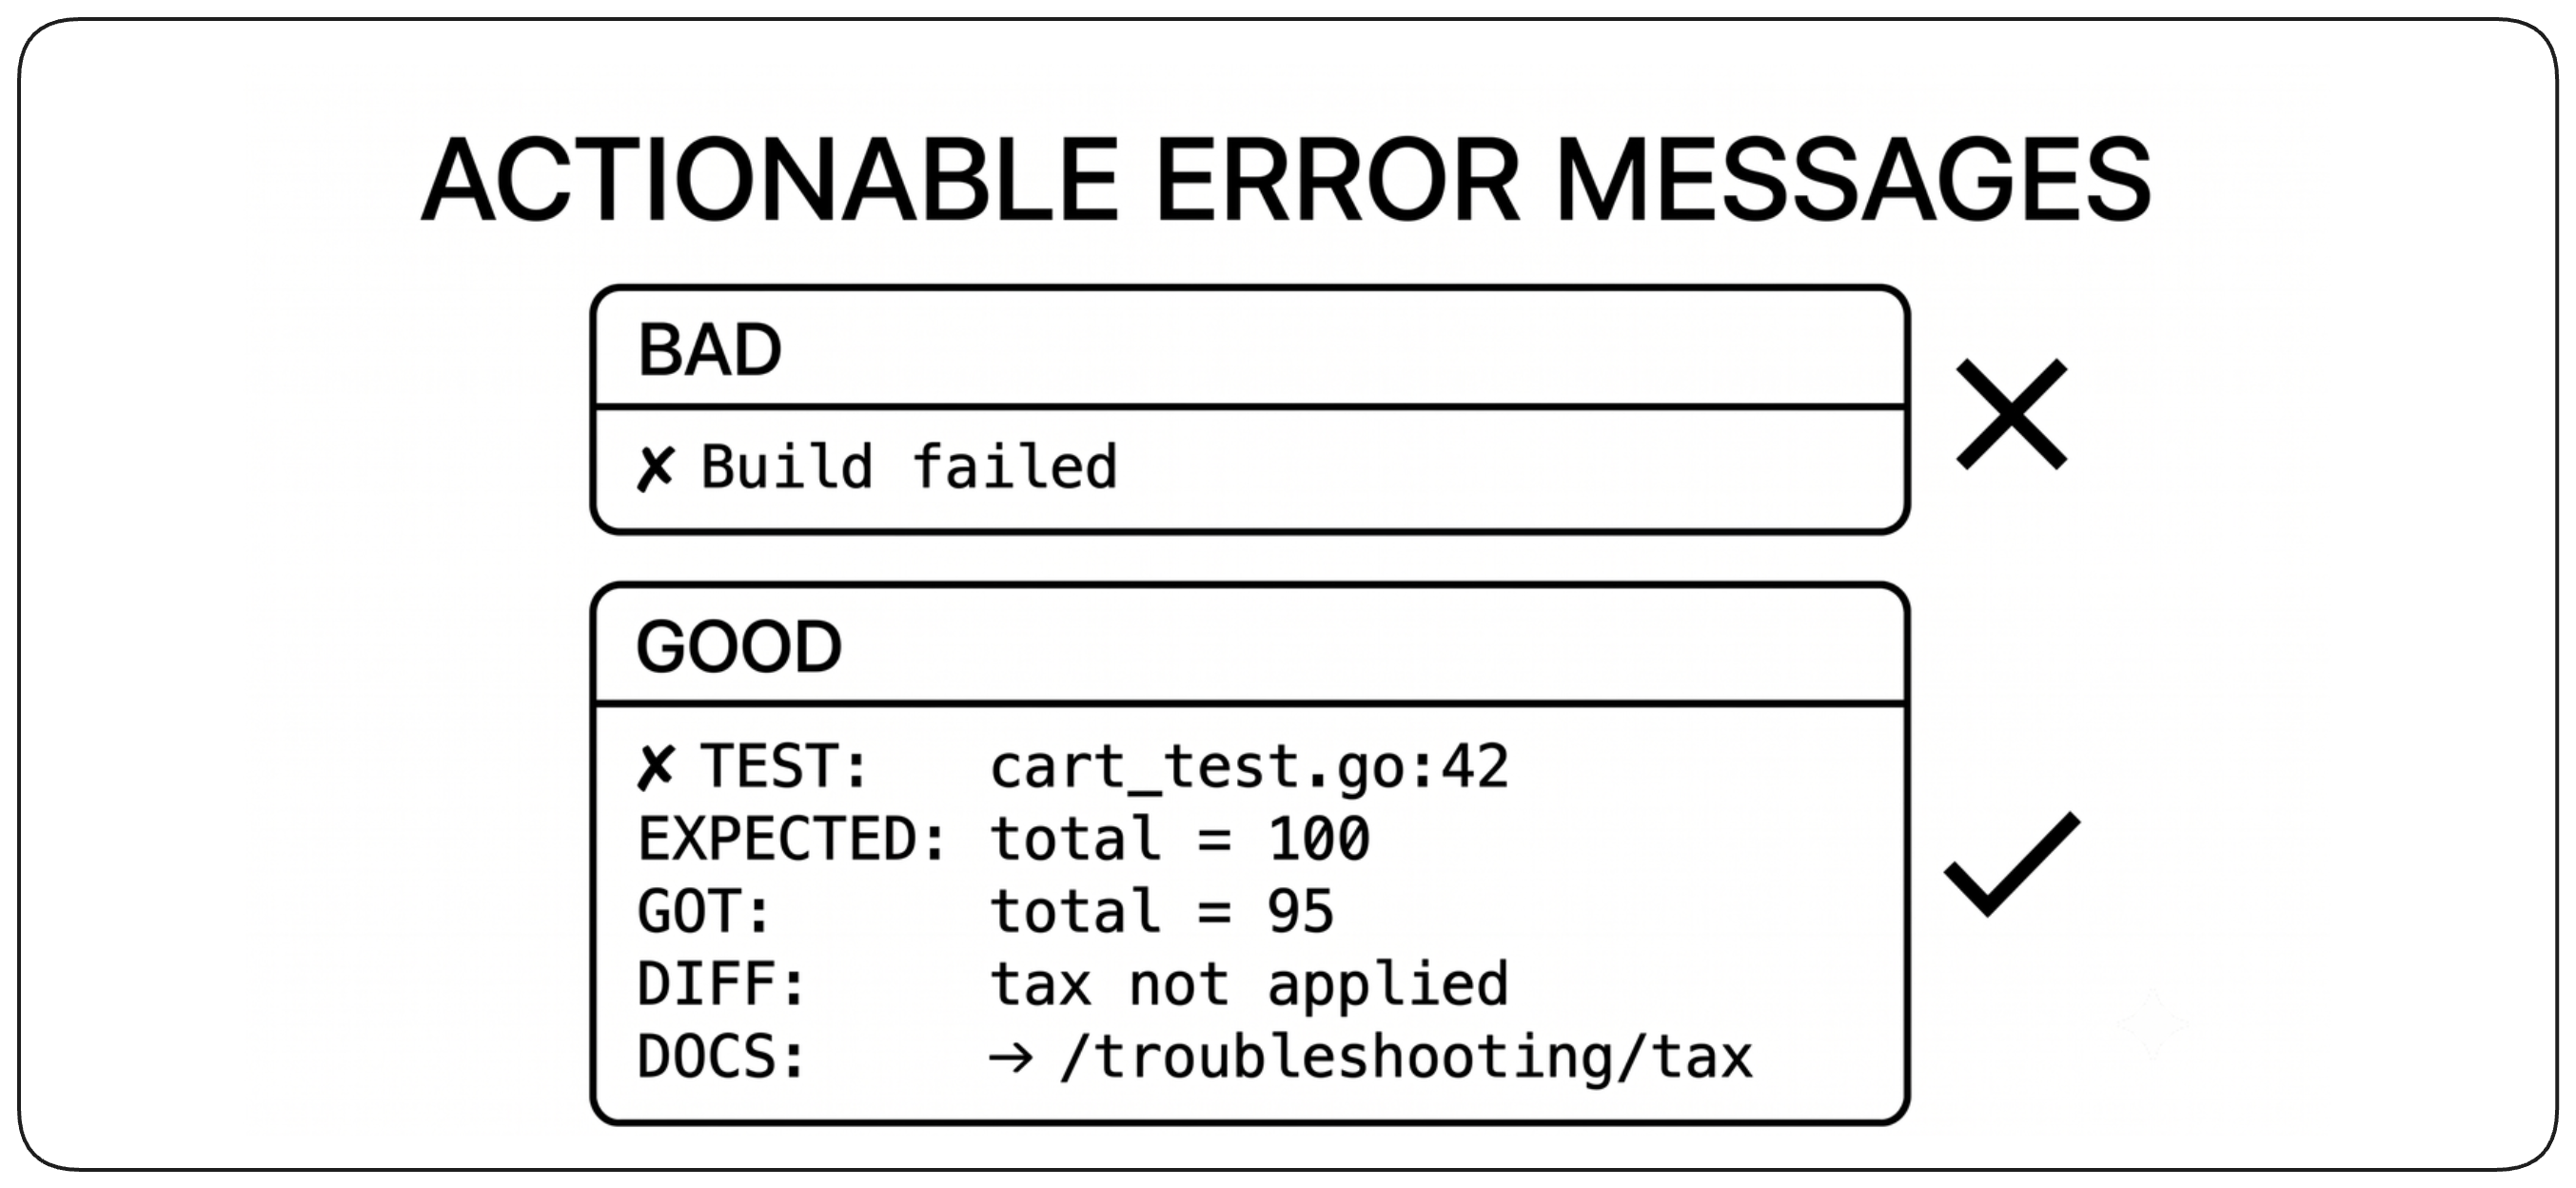
Quand un build échoue, le développeur doit comprendre rapidement ce qui a échoué, pourquoi, et où regarder ensuite. Les messages d’erreur doivent identifier la vérification en échec, fournir le contexte pertinent et pointer vers les informations nécessaires à l’investigation. Un échec qui oblige à fouiller des milliers de lignes de logs est un problème d’utilisabilité du système de build.
Permettre aux développeurs de reproduire les vérifications en local
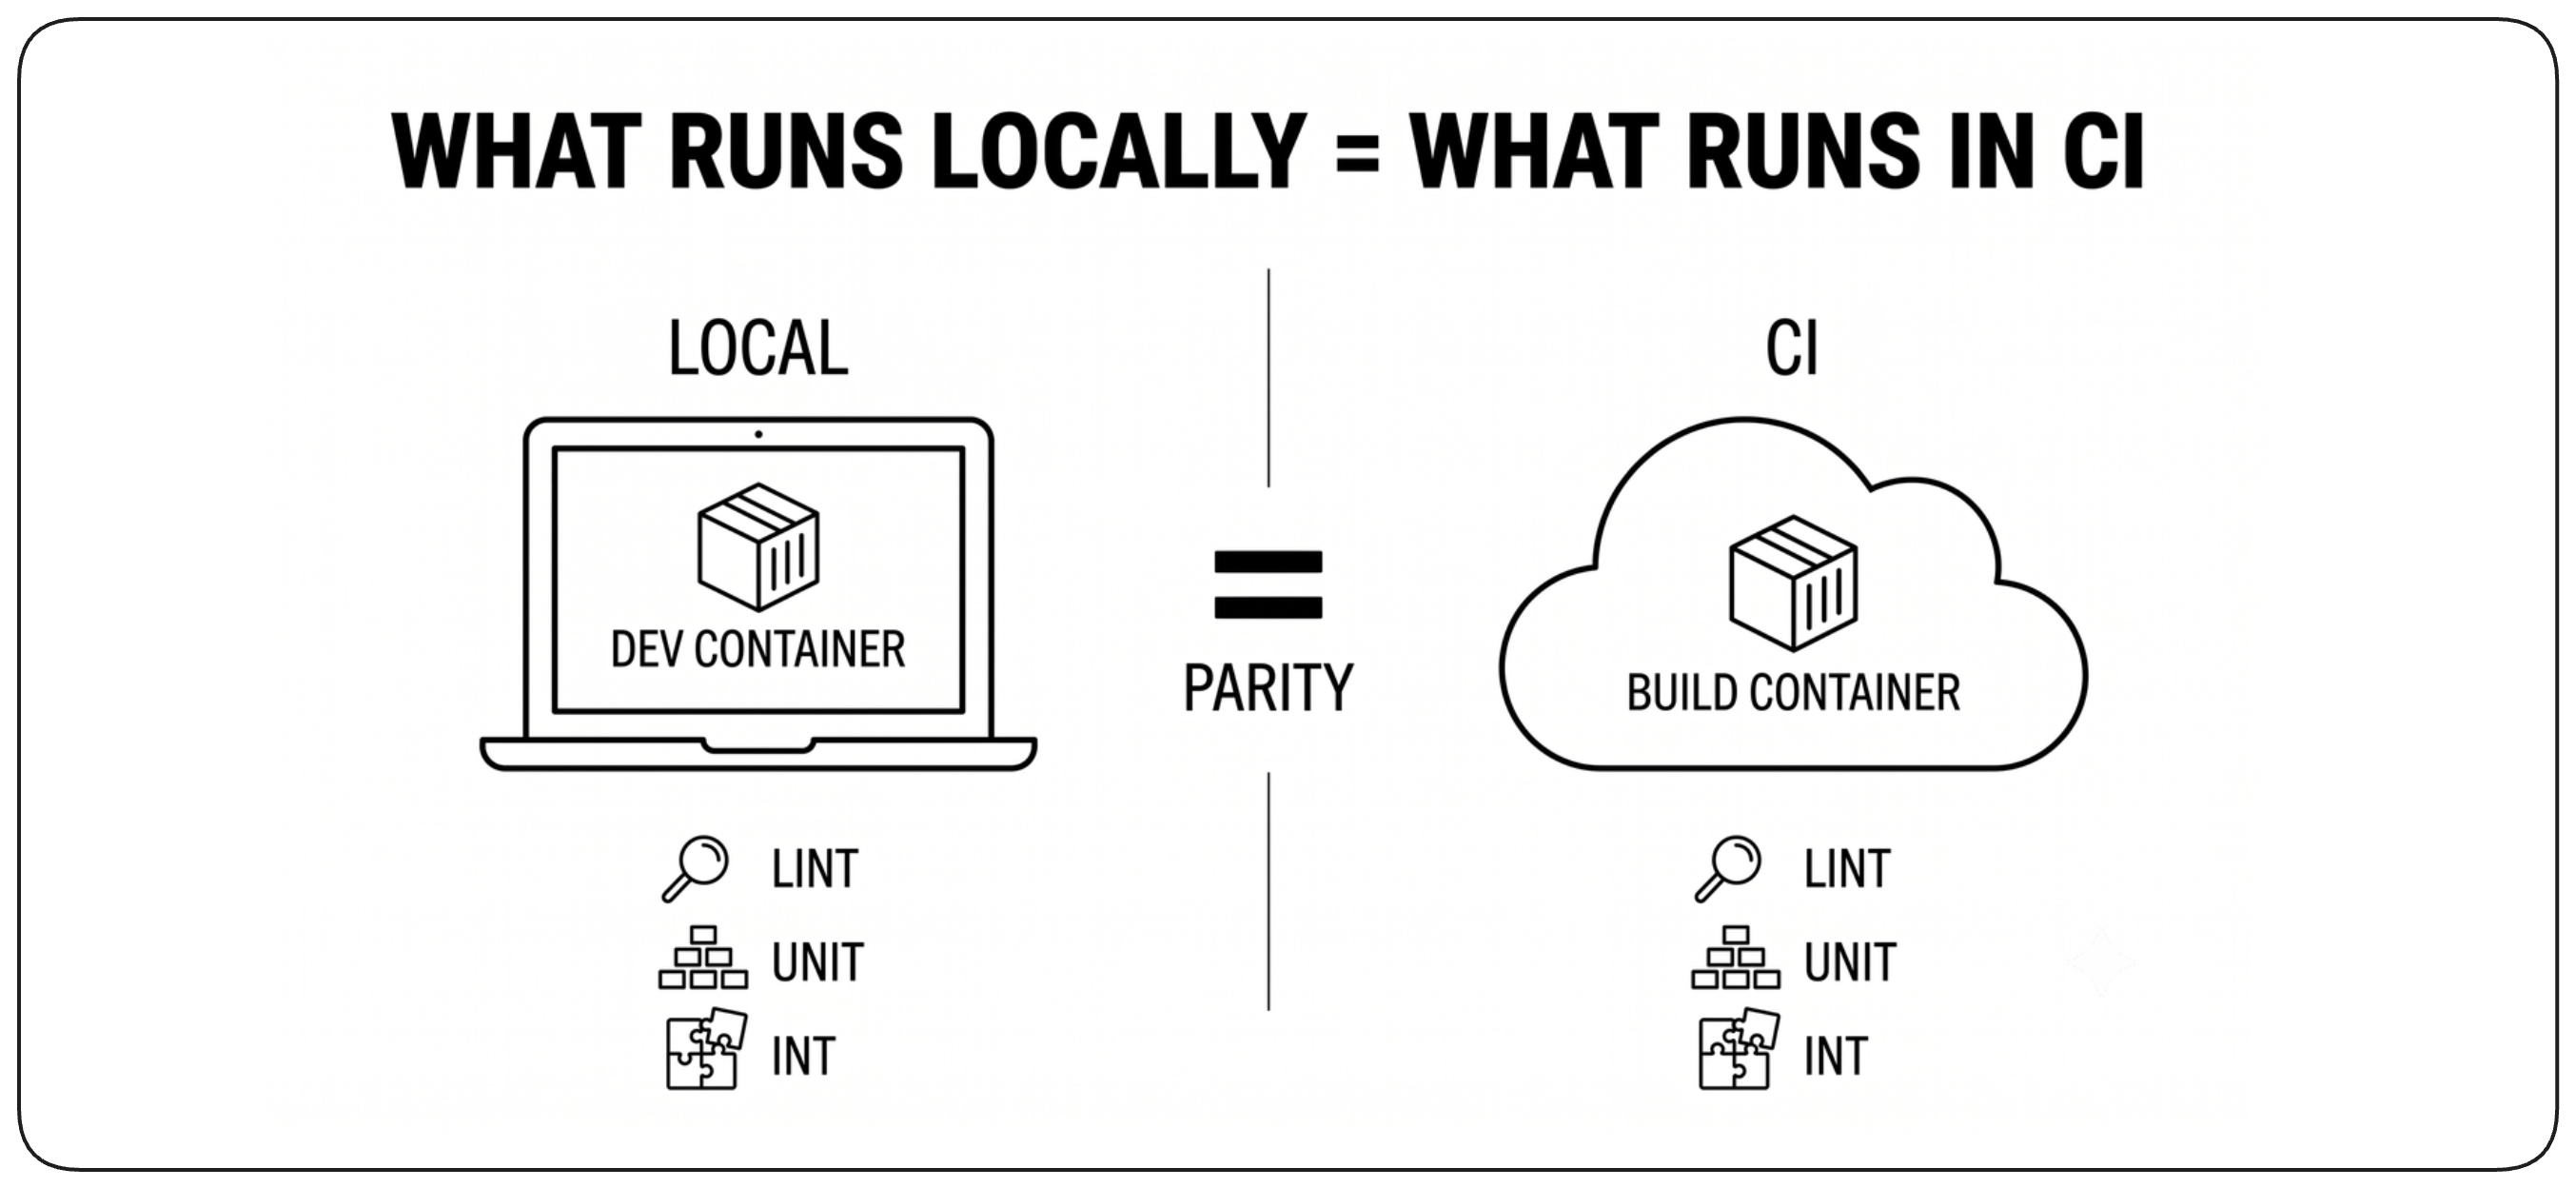
Les développeurs doivent pouvoir exécuter les vérifications de build importantes avant de pousser un changement. L’exécution locale n’a pas besoin de reproduire toute l’infrastructure de build, mais les mêmes commandes, dépendances et règles de validation doivent se comporter de façon cohérente. Cela raccourcit les boucles de feedback et facilite la reproduction des échecs de build.
Garder le build facile à comprendre
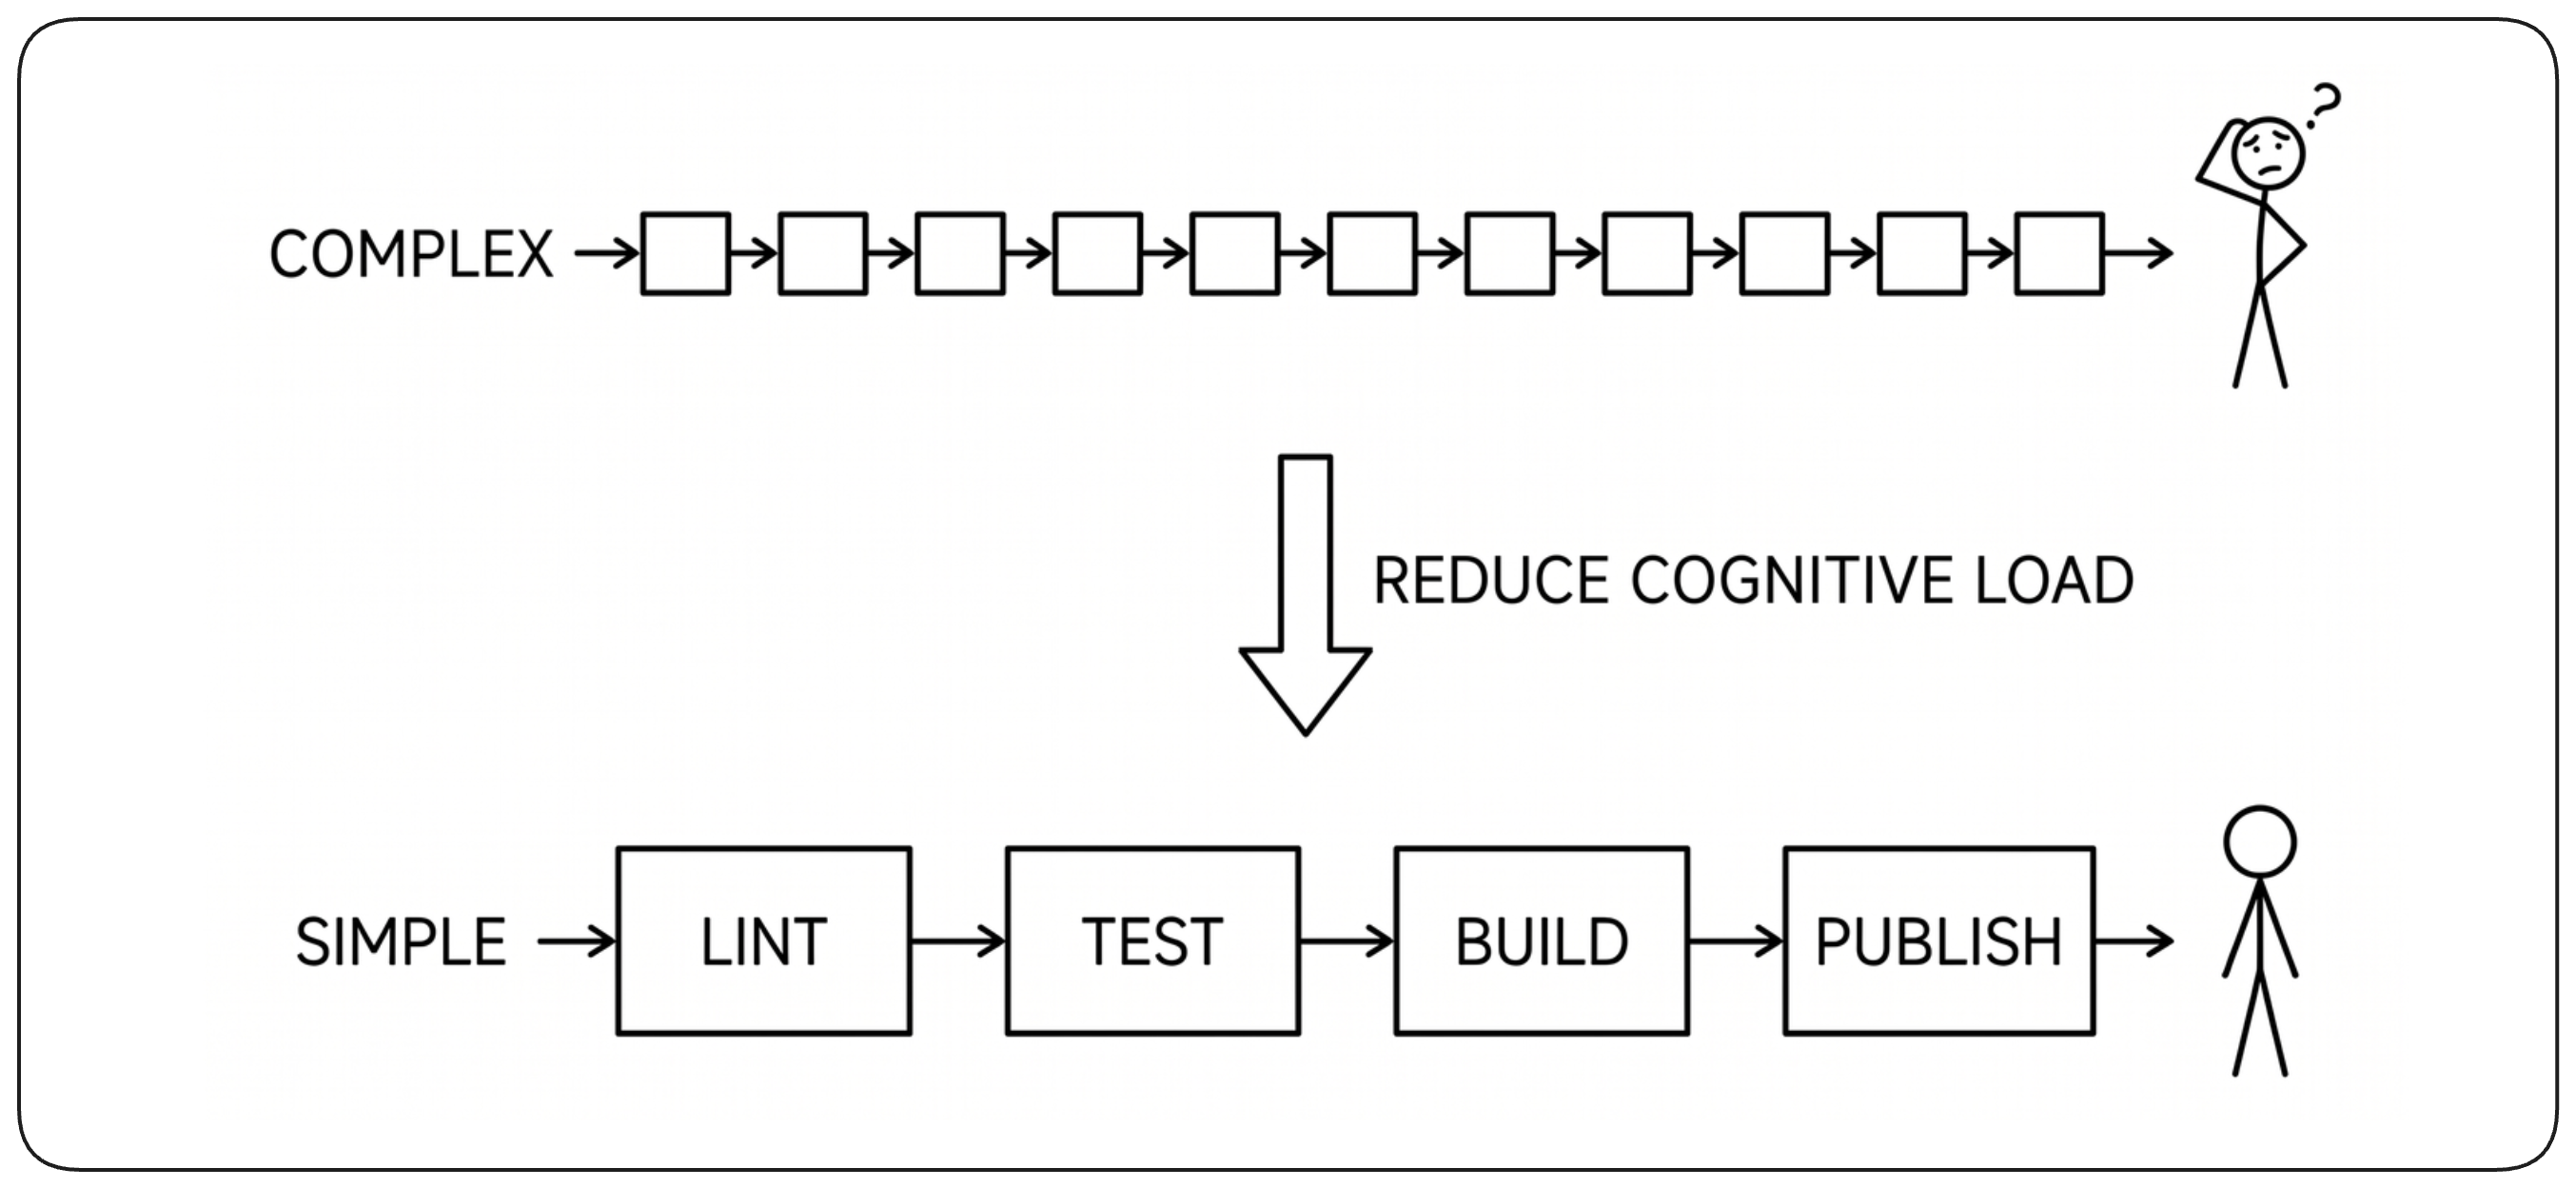
Les développeurs doivent pouvoir comprendre ce que fait le build sans devenir experts de la plateforme de build. Préférez un petit nombre d’étapes claires, des valeurs par défaut sensées et des conventions à de grandes quantités de configuration personnalisée. La complexité inévitable doit être masquée derrière des capacités de plateforme réutilisables plutôt que répétée dans chaque projet.
Envoyer le feedback aux bonnes personnes
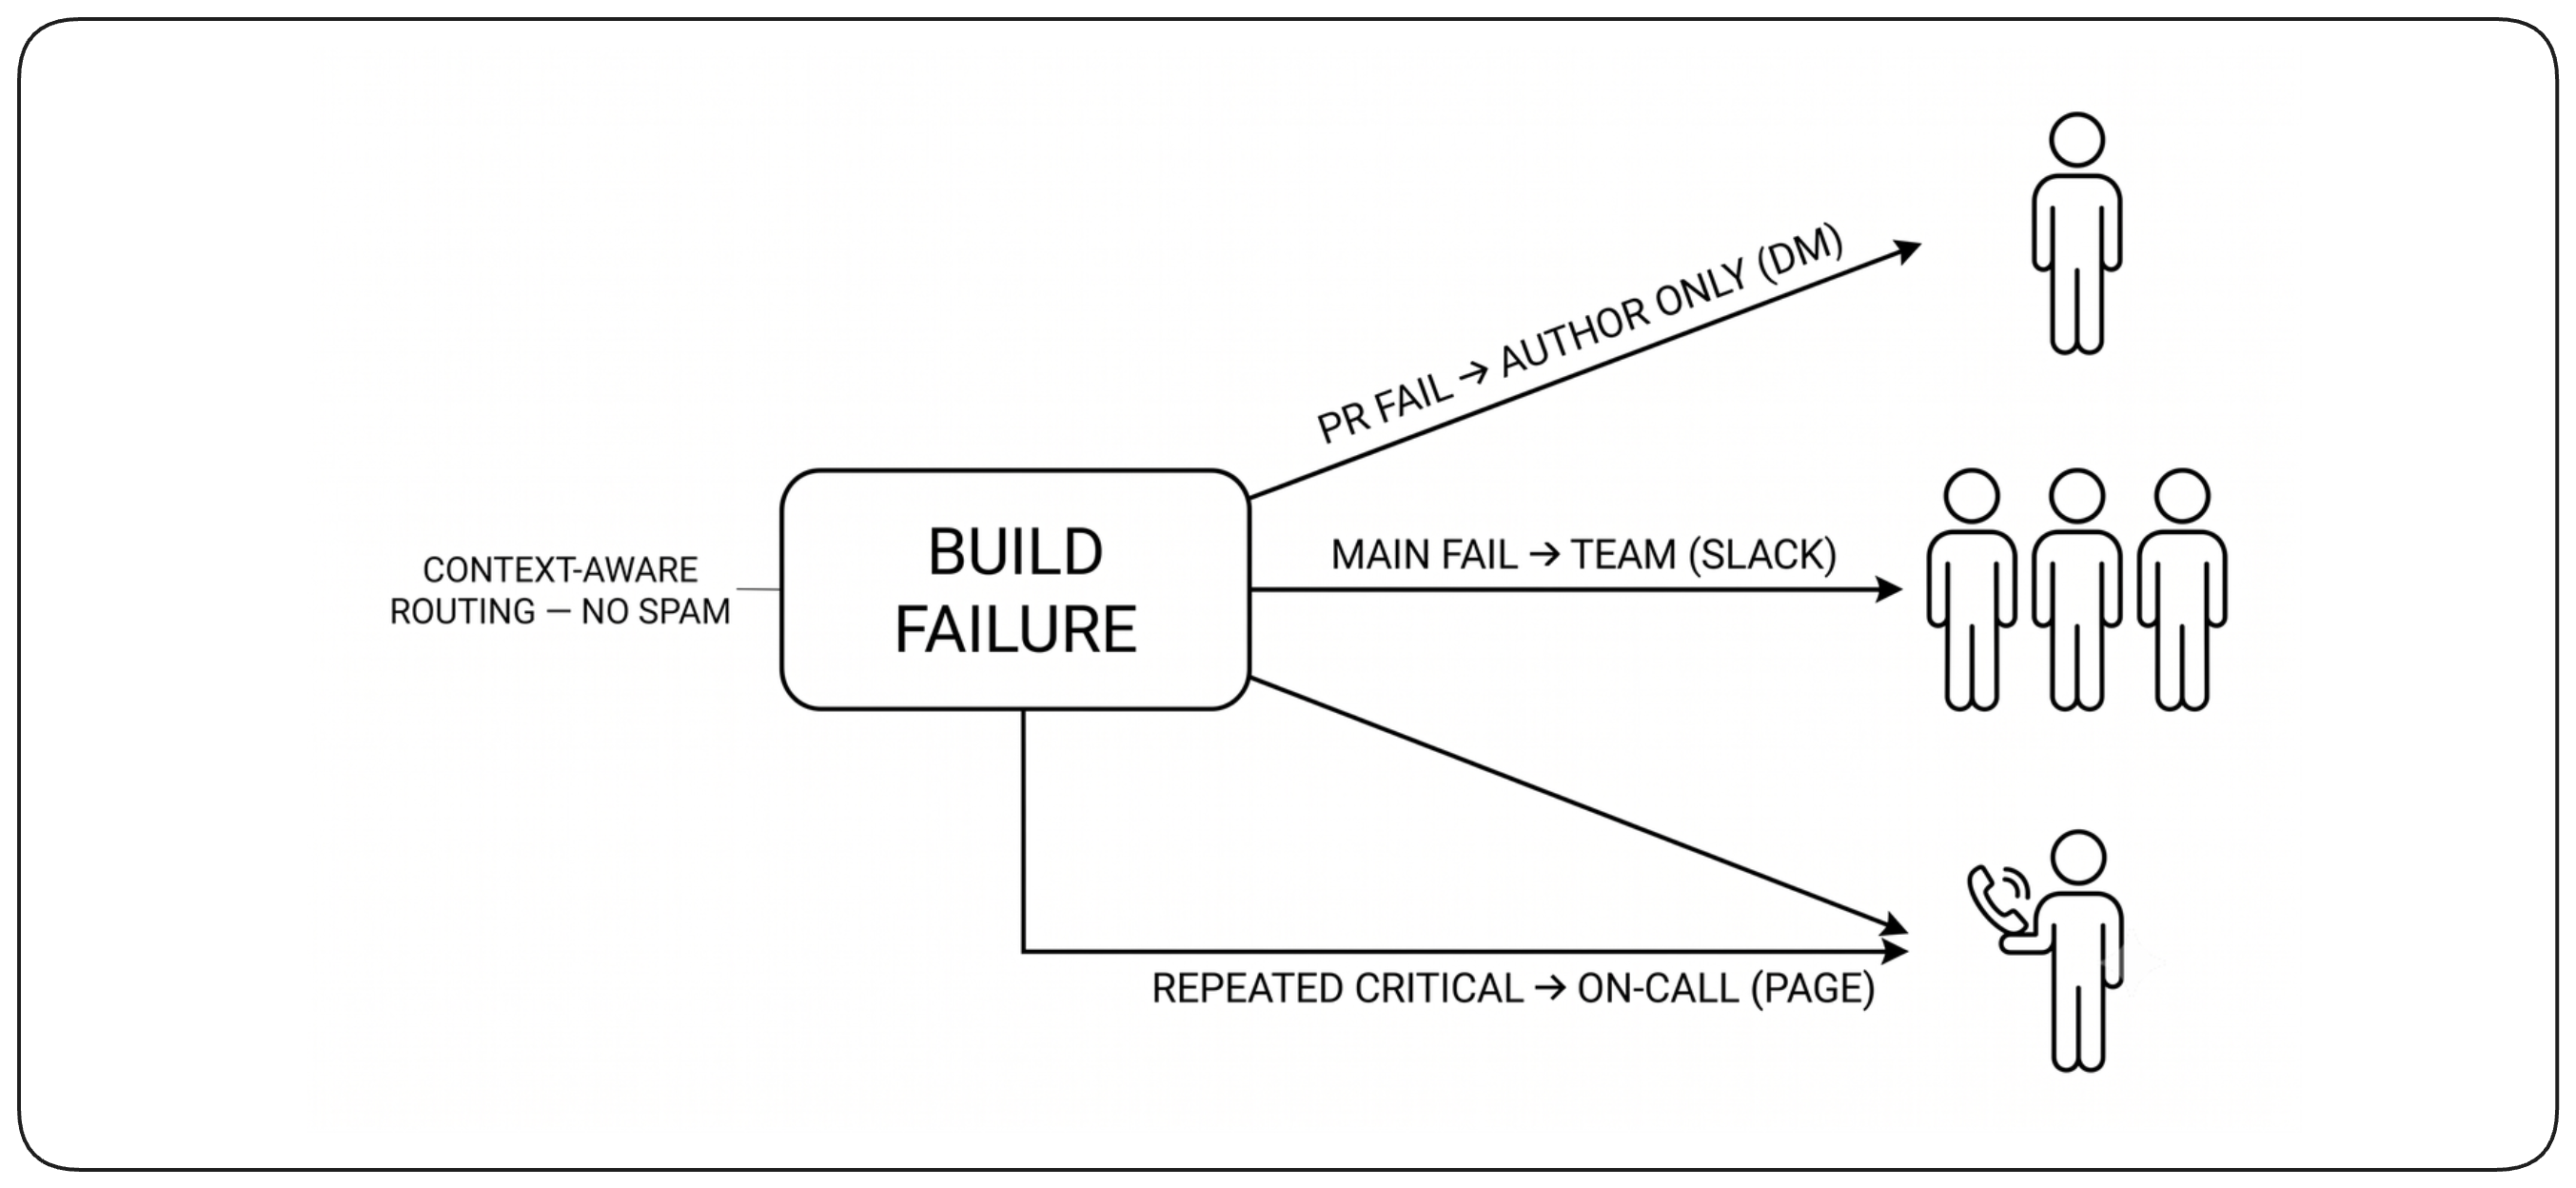
Les notifications de build doivent atteindre les personnes qui peuvent agir, sans créer de bruit de fond. L’échec d’une pull request concerne généralement son auteur, tandis qu’une branche principale cassée concerne l’équipe. Les notifications doivent contenir assez de contexte pour agir immédiatement et éviter de diffuser les échecs de routine à des personnes qui ne peuvent pas aider.
Métriques et observabilité
L’observabilité du build rend le build lui-même mesurable. Elle doit révéler où les développeurs attendent, pourquoi les builds échouent et si le système de build devient plus lent ou moins fiable avec le temps.
Mesurer le temps de feedback
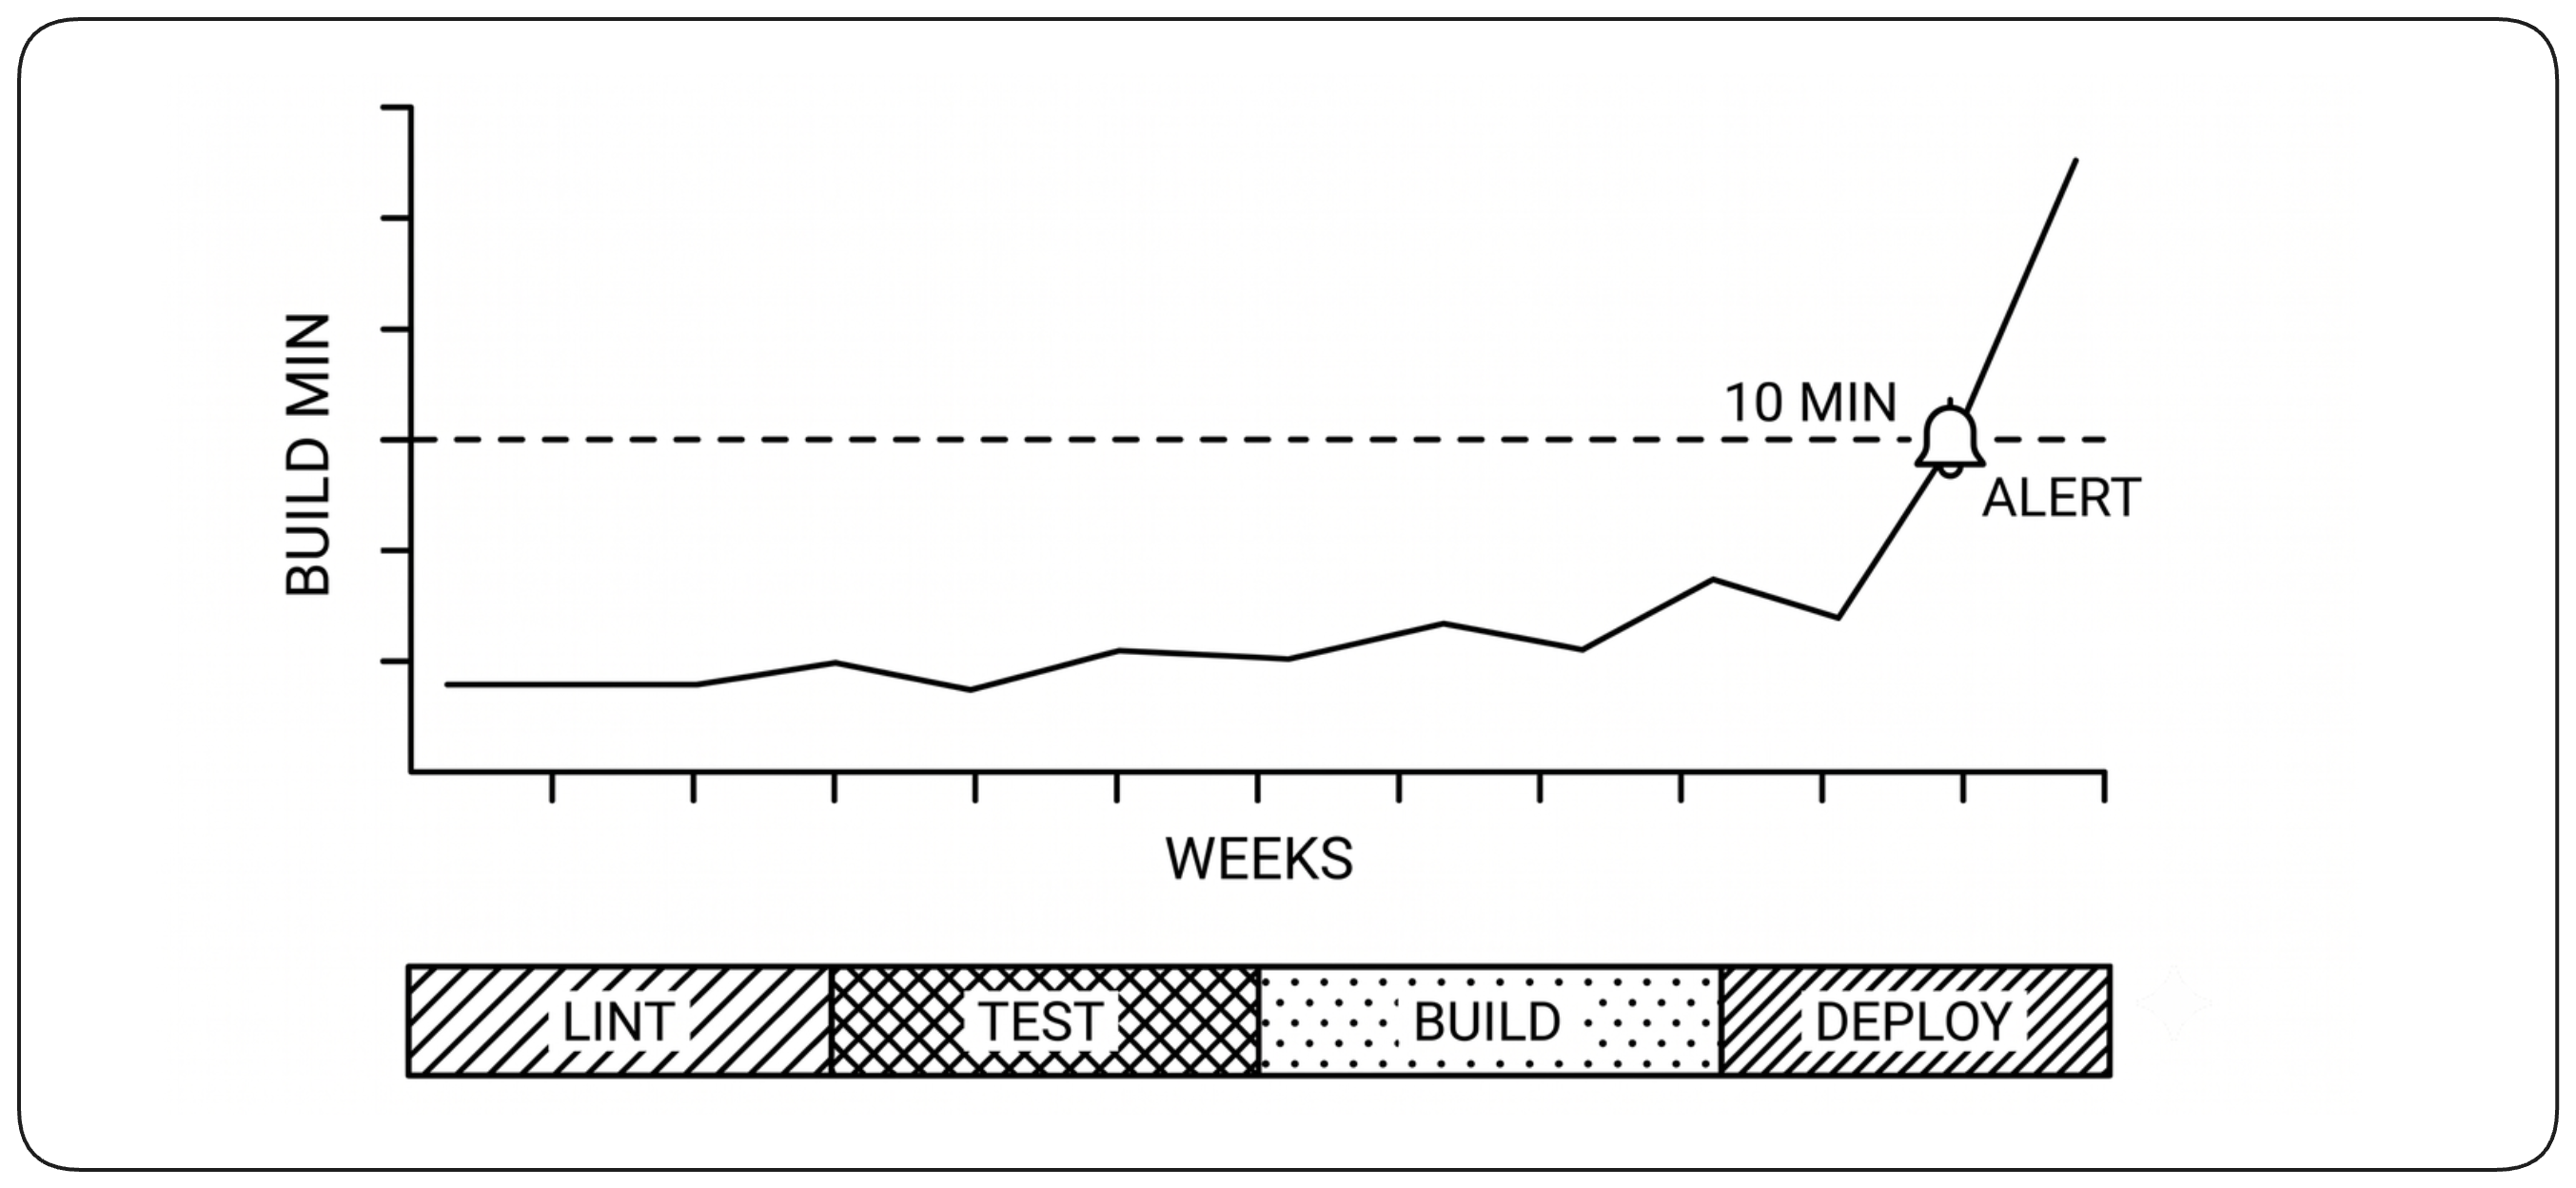
Mesurez combien de temps les développeurs attendent un feedback utile, et pas seulement la durée totale du pipeline. Séparez le temps d’attente en file du temps d’exécution et ventilez l’exécution par étape pour révéler l’origine des retards. Les percentiles et les tendances sont souvent plus utiles que les moyennes, car ils révèlent les expériences lentes que les développeurs ressentent réellement.
Distinguer les échecs de build des échecs d’infrastructure
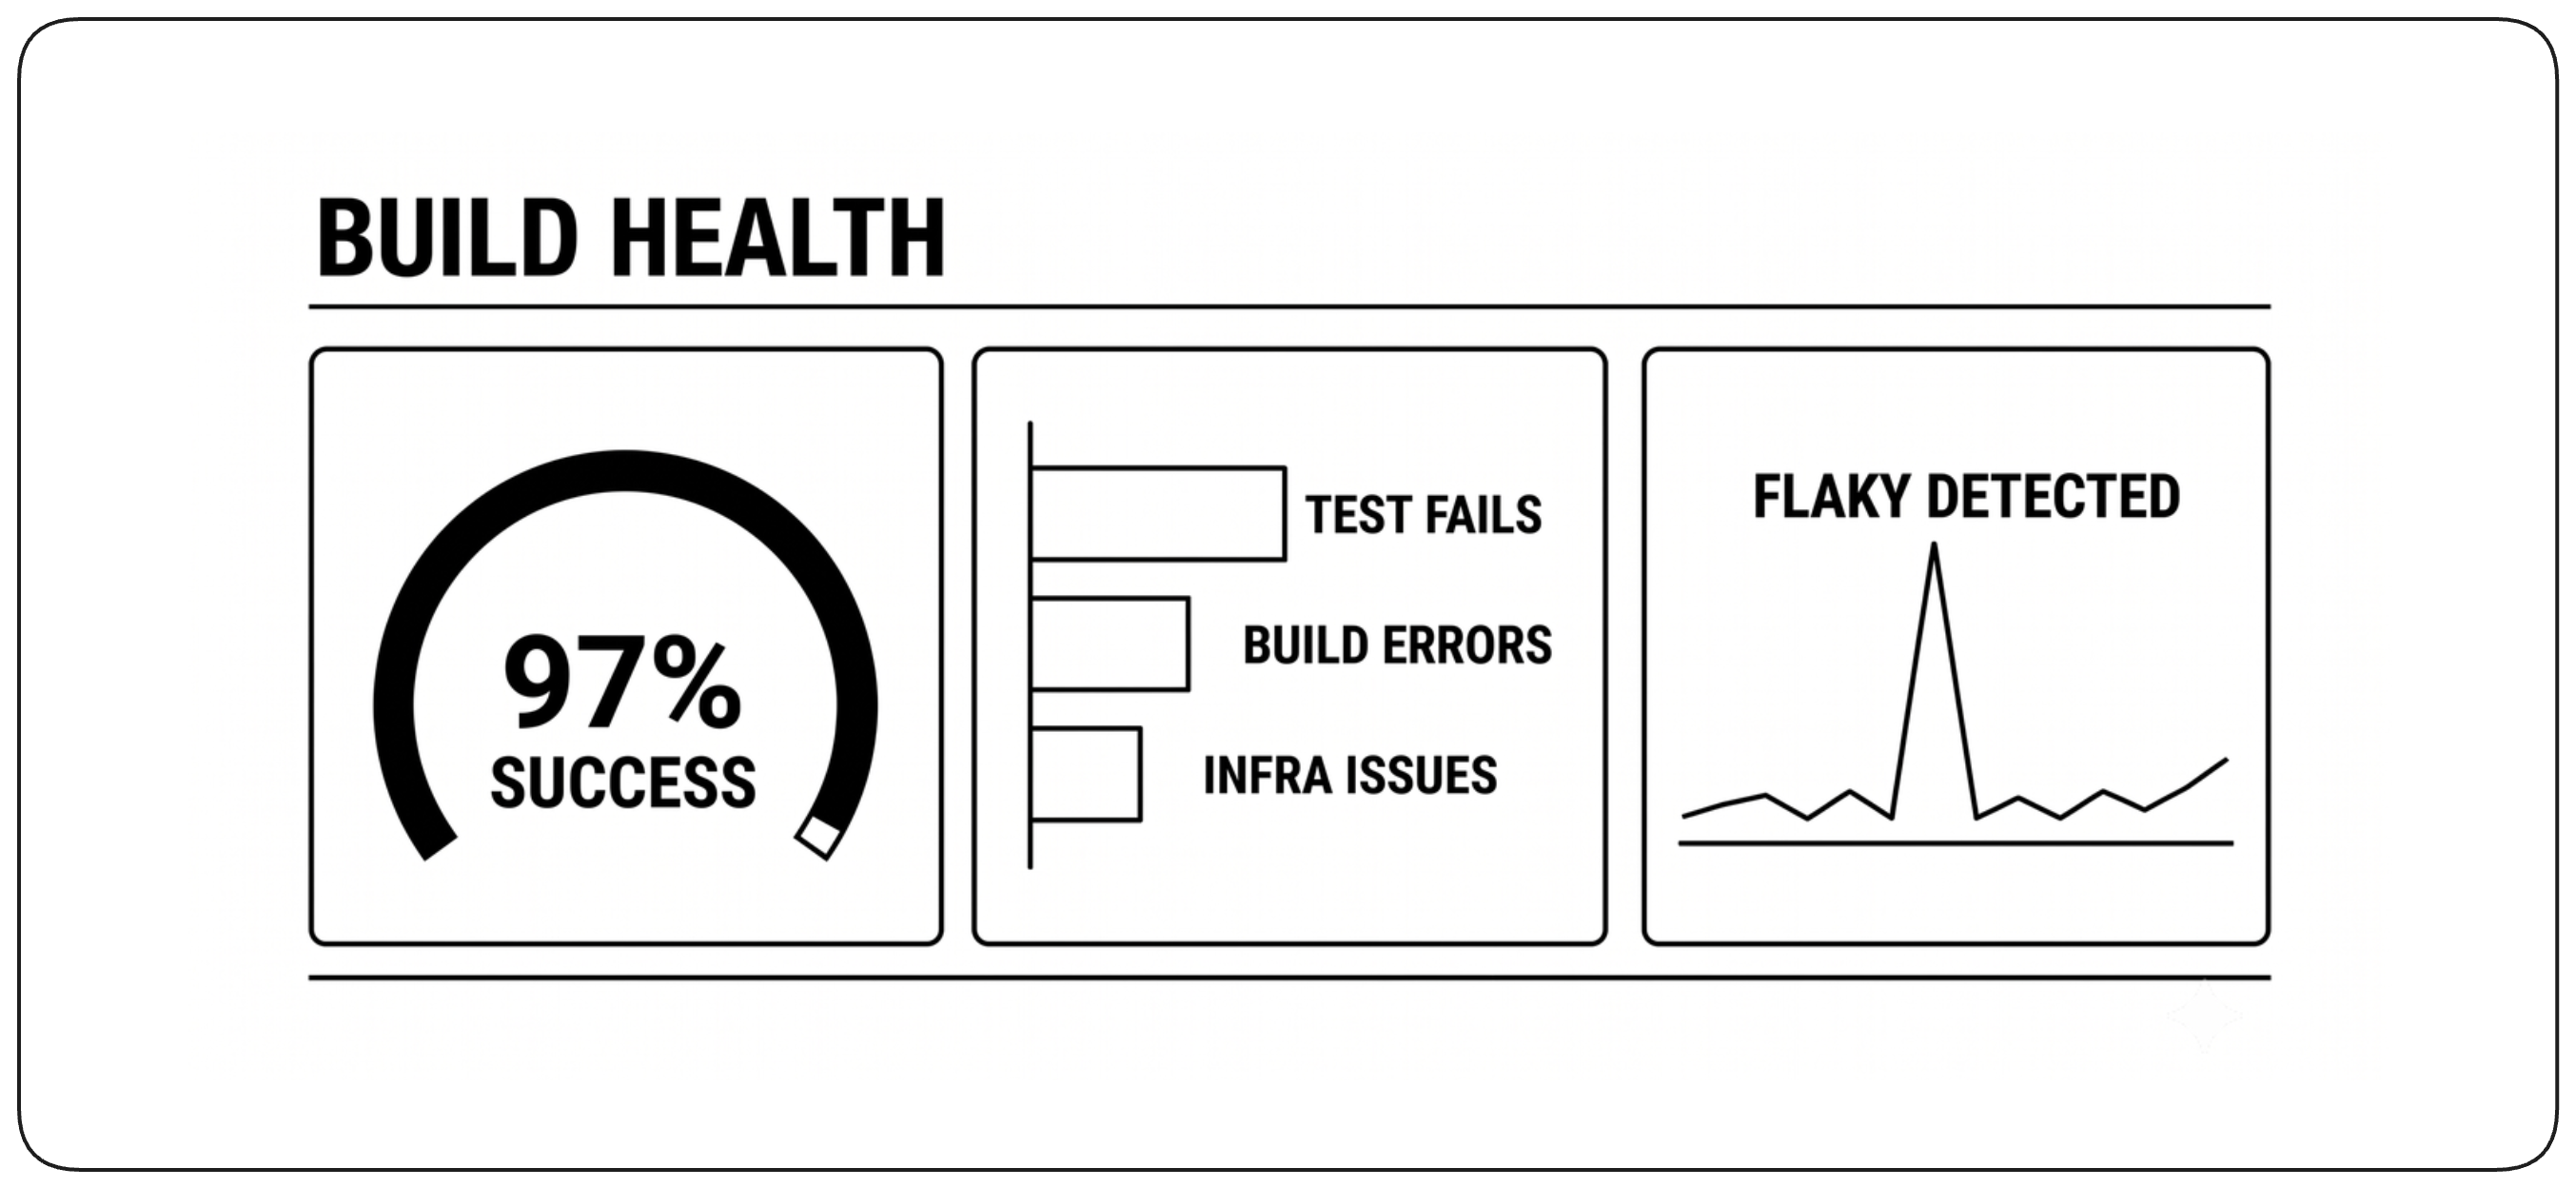
Un build en échec ne signifie pas forcément que le système de build est défaillant : rejeter un changement cassé est exactement ce qu’il doit faire. Distinguez les échecs causés par le changement des tests instables (flaky), des pannes de runners, des problèmes réseau et des autres problèmes d’infrastructure. Cette séparation montre si les développeurs peuvent faire confiance au build lui-même.
Mesurer la fiabilité du système de build
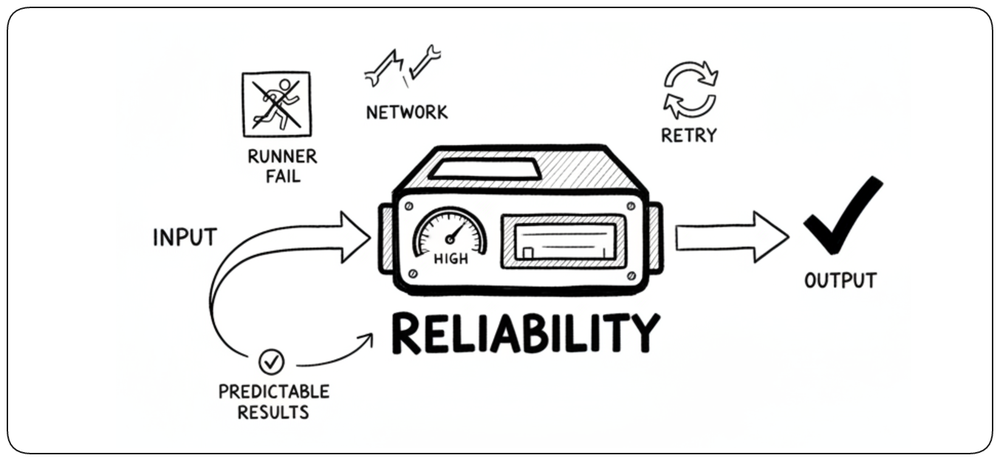
Les développeurs ont besoin d’un feedback prévisible de la part de l’infrastructure de build elle-même. Suivez les pannes de runners, les retries inattendus, les erreurs réseau, les indisponibilités de services et les autres cas où le pipeline échoue indépendamment du changement de code. Une plateforme de build fiable doit produire le même résultat pour les mêmes entrées sans obliger les développeurs à relancer les jobs en échec.
Utiliser les tendances pour trouver les régressions
Les mesures individuelles montrent ce qui se passe maintenant ; les tendances révèlent si le build s’améliore ou se dégrade. Suivez dans le temps le temps de feedback, le temps d’attente en file, les échecs d’infrastructure et la fiabilité, afin que les régressions graduelles deviennent visibles tôt. Quand une métrique change, l’observabilité doit aider à identifier l’origine de la régression.
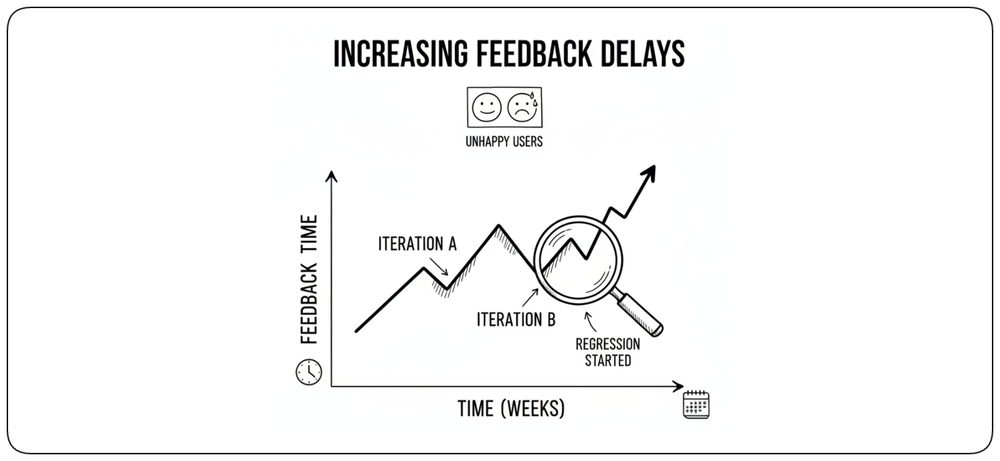
Le jugement humain à l’ère de l’IA
L’IA ne supprime pas les principes décrits dans ce chapitre. Elle augmente leur importance. Les changements arrivent plus vite, la validation devient le goulot d’étranglement, le jugement humain se déplace vers l’intention et le risque, et la plateforme de build sert de plus en plus à la fois les développeurs et les agents autonomes.
Les humains définissent l’intention
L’IA peut générer des implémentations, des tests, des correctifs et de la configuration, mais elle ne peut pas décider de ce que le système doit finalement accomplir. Les humains restent responsables de la définition de l’intention, des contraintes, du risque acceptable et des preuves requises avant qu’un changement puisse progresser.
L’IA explore le comment
Une fois l’intention et les contraintes claires, l’IA peut explorer rapidement de nombreuses implémentations possibles : générer du code, des tests, des refactorings et des correctifs, puis utiliser le feedback du build pour les améliorer. La valeur passe de la production d’une seule réponse à l’exploration d’un espace de solutions bien plus vaste.
Générer plus, faire confiance grâce aux preuves
À mesure que générer des changements devient moins coûteux, la génération elle-même devient moins significative comme preuve de qualité. La confiance doit venir du build : exécution reproductible, revue, tests, contrôles de sécurité et artefacts traçables. L’IA peut augmenter le volume de changements, mais chaque changement doit toujours mériter le droit de progresser.
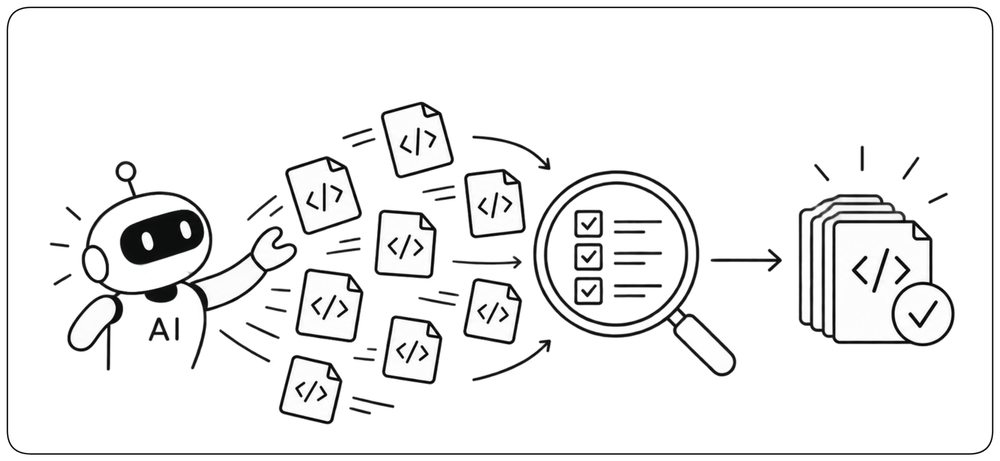
Du changement à l’artefact de confiance
Un build fiable transforme un changement non fiable en artefact de confiance. Il y parvient en maîtrisant les entrées, en validant le comportement et la sécurité, en préservant la traçabilité et en produisant une sortie immuable unique qui peut avancer en sécurité vers la production. Les outils évolueront, mais cette responsabilité reste la même : chaque changement doit gagner les preuves nécessaires pour avancer.