Concevoir les processus du cycle de développement
Chapter Info
Calculating... Writing Progress: 10%
Les processus sont le système d’exploitation d’une organisation d’ingénierie. Ils transforment les objectifs, politiques et responsabilités de l’entreprise en méthodes de travail cohérentes, fiables et de plus en plus automatisées à toutes les étapes du cycle de vie logiciel. Du développement au déploiement, en passant par la sécurité, les opérations et la maintenance, les processus déterminent l’avancement des tâches, la prise de décision et l’application des dispositifs de contrôle. En limitant la coordination manuelle et la dépendance à l’expertise individuelle, ils permettent à l’organisation d’ingénierie de croître sans que la charge opérationnelle n’augmente de façon proportionnelle.
Fondements des processus
Le cycle de développement logiciel
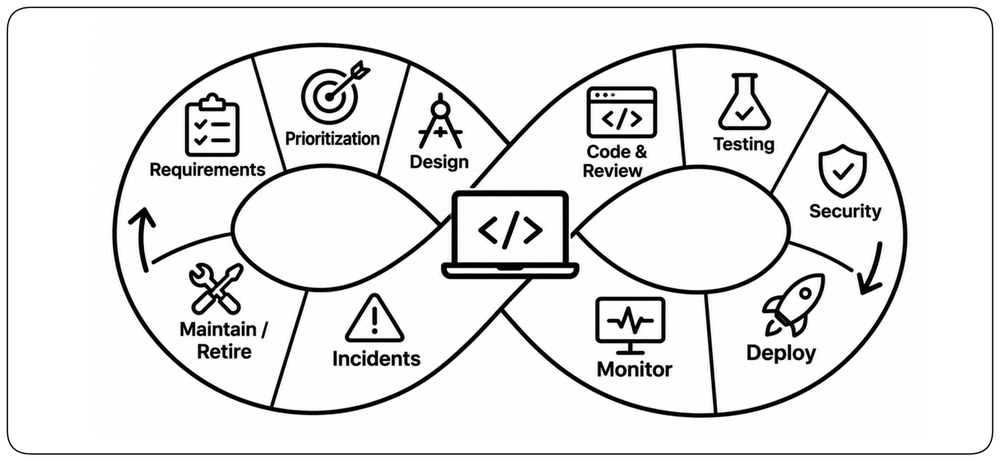
Le cycle de développement logiciel recouvre l’ensemble des activités liées à la création, la livraison, l’exploitation et l’évolution d’un logiciel. Il englobe la compréhension des besoins, la définition des priorités, la conception, l’écriture et la revue de code, les tests, la gestion de la sécurité, les déploiements, la supervision en production, la gestion des incidents et le maintien ou le retrait des systèmes. Ces activités ne sont pas strictement séquentielles : elles se chevauchent, se répètent et s’influencent mutuellement tout au long de la vie d’un système.
Les processus donnent vie au cycle de vie
Le cycle de vie du développement logiciel décrit les activités nécessaires à la création et à l’exploitation d’un logiciel, mais il ne les réalise pas en lui-même. Les processus transforment ces activités en un système opérationnel : ils définissent comment le travail commence, avance, circule entre les équipes et se termine. Ils relient les activités en précisant les responsabilités, les conditions et les transitions. Sans processus, le cycle de vie reste une simple description de ce qui devrait se passer, sans offrir un moyen fiable d’y parvenir.
L’anatomie d’un processus
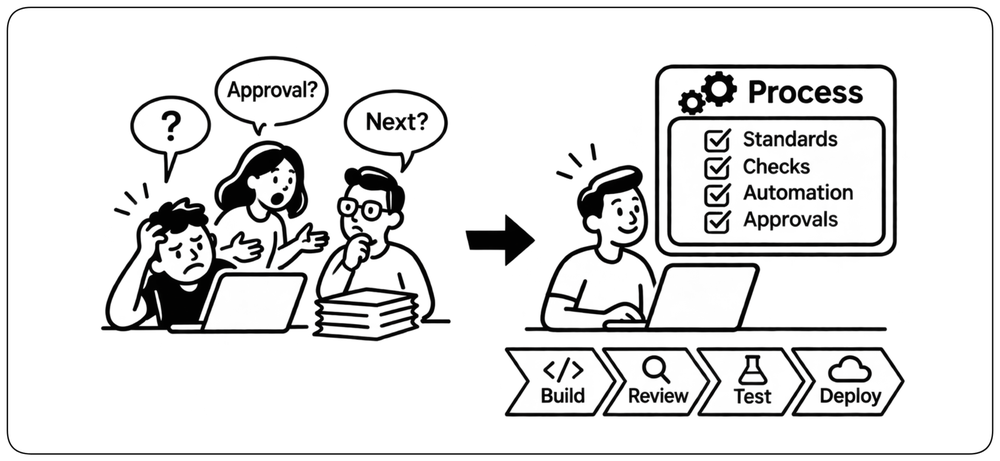
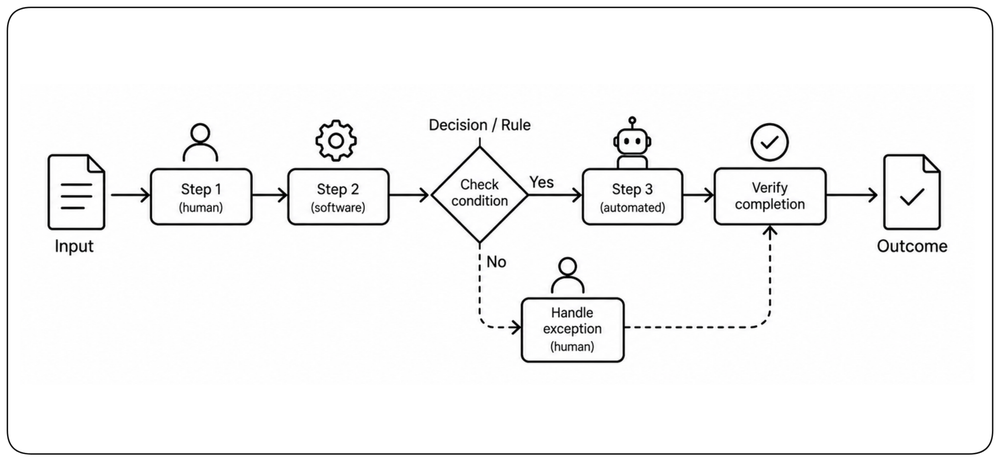
Tout processus comporte une entrée, un résultat attendu et une séquence d’étapes pour passer de l’un à l’autre. Chaque étape a des responsabilités, des règles et des conditions pour avancer. Un processus doit aussi gérer les exceptions quand les choses ne se passent pas comme prévu. En rendant ces éléments explicites, le processus devient compréhensible, reproductible, mesurable, puis automatisable. Cette même structure s’applique aux revues de code, déploiements, demandes d’accès et à la gestion des incidents.
Rendre le processus explicite
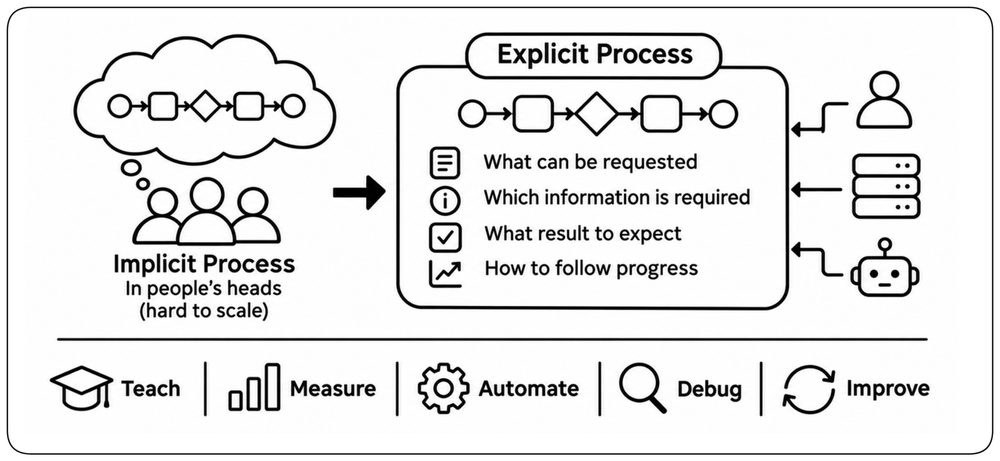
Les organisations ont des processus, qu’ils soient formellement définis ou non. Lorsqu’un flux de travail repose uniquement sur les habitudes, la connaissance personnelle, la coordination informelle et des décisions non documentées, il reste implicite, dépend de la mémoire et de l’héroïsme individuel. Le rendre explicite clarifie ce qui peut être demandé, quelles informations sont requises, le résultat attendu et la manière dont le travail progresse. Un processus explicite peut être enseigné, mesuré, automatisé, débogué et amélioré.
Processus et plateforme
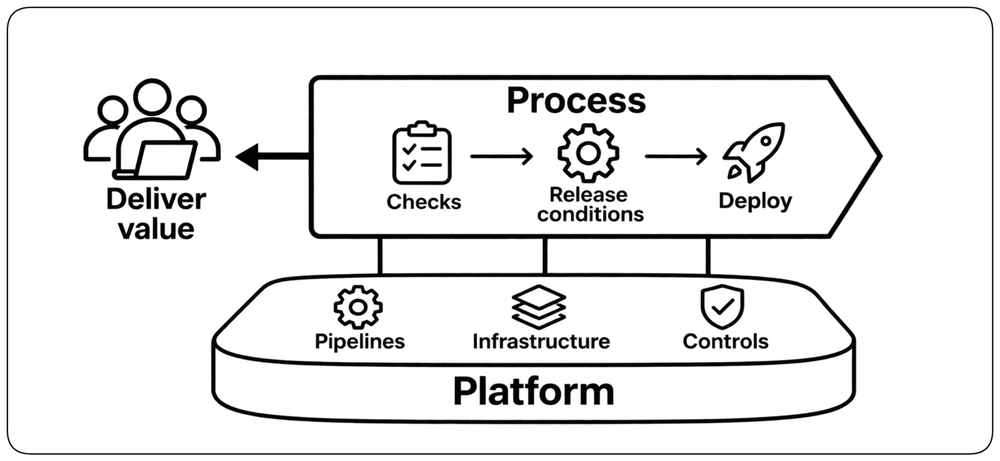
Les processus et les plateformes sont complémentaires mais ne se remplacent pas. Un processus définit ce qui doit se passer, dans quelles conditions et avec quelles responsabilités. Une plateforme fournit des capacités techniques réutilisables qui exécutent et automatisent progressivement ce travail. Par exemple, un processus de déploiement définit les vérifications nécessaires et les conditions de mise en production, tandis qu’une delivery platform offre les pipelines, l’infrastructure et les contrôles pour les appliquer. Une plateforme sans processus clairs n’est qu’un ensemble d’outils ; des processus sans plateformes de soutien reposent trop sur la coordination manuelle.
Les organisations passent à l’échelle par le processus
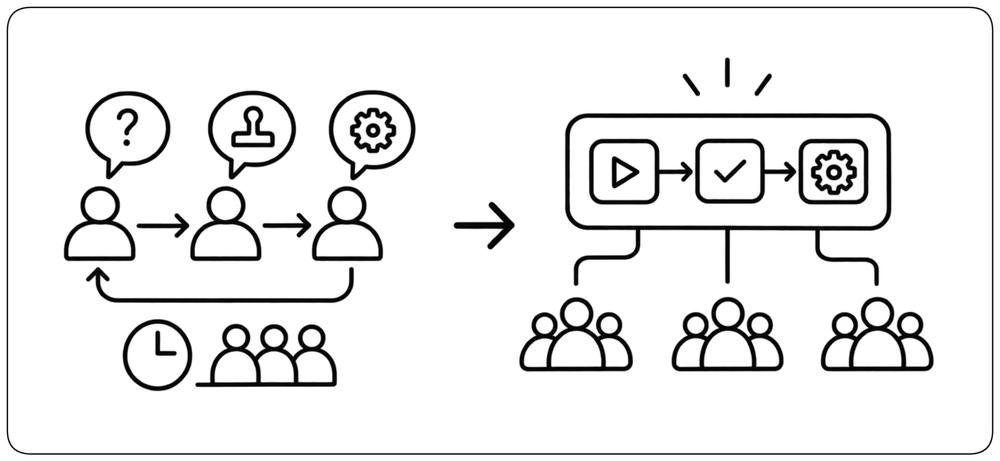
Une organisation ne peut pas évoluer si chaque action nécessite qu’une personne se souvienne de la marche à suivre, organise un transfert, demande une validation ou exécute manuellement l’étape suivante. À mesure que l’organisation grossit, ces dépendances se transforment en files d’attente et en goulets d’étranglement. Les organisations qui passent à l’échelle transforment le travail répétitif en processus explicites, en libre-service et de plus en plus automatisés. L’objectif n’est pas de supprimer la responsabilité humaine, mais d’éviter que l’exécution courante et les décisions bornées n’exigent une coordination humaine synchrone. Les équipes peuvent alors agir de façon indépendante sans ralentir l’organisation dans la même proportion.
Des runbooks aux processus exécutables
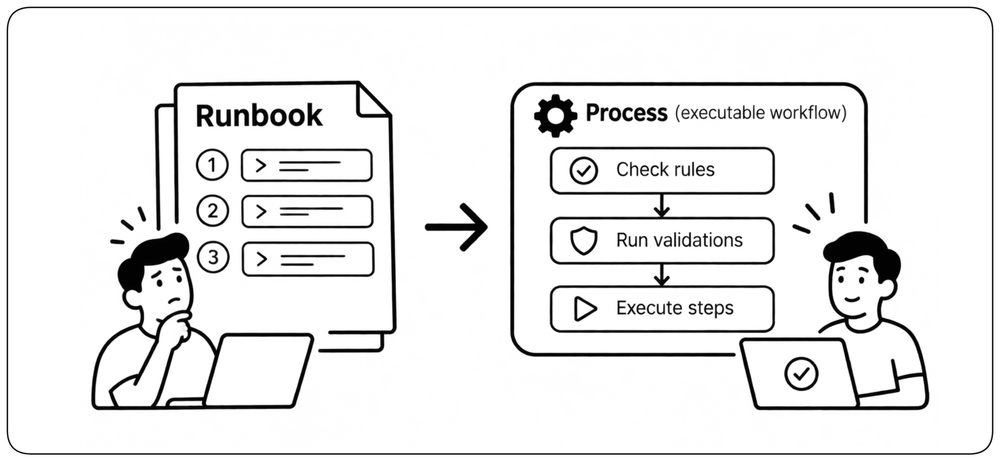
Les runbooks traditionnels indiquent aux ingénieurs quelles commandes exécuter et quelles étapes suivre, mais l’opération reste manuelle. Cela ralentit le flux, expose à l’erreur et devient souvent impossible pour les nouveaux-venus qui n’ont pas le contexte, la connaissance ou les droits nécessaires. Les processus modernes transforment ces instructions récurrentes en workflows exécutables qui appliquent automatiquement les règles, effectuent les vérifications et font avancer le travail. Les runbooks restent utiles dans les cas exceptionnels, mais les opérations courantes ne devraient pas dépendre d’un expert suivant un document.
Traiter le processus comme un artefact d’ingénierie à part entière
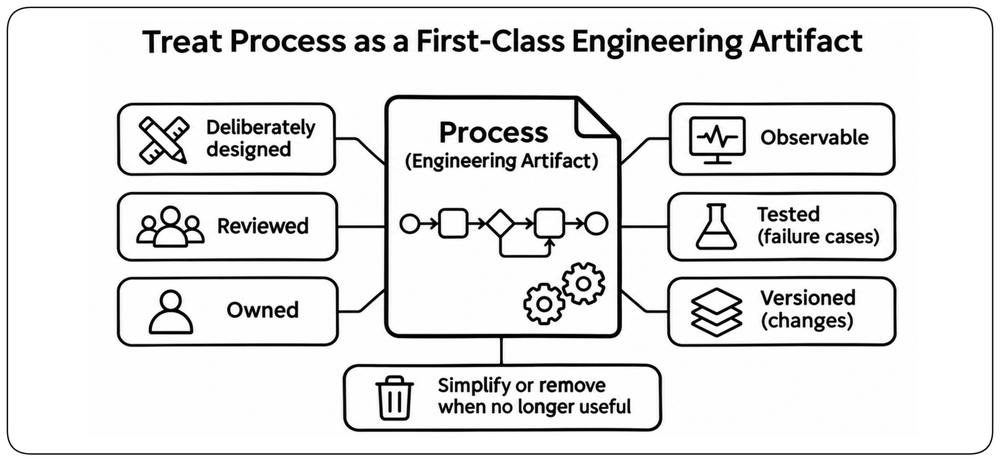
Un processus fait partie du système d’ingénierie, ce n’est pas une couche informelle rajoutée autour. Les processus importants méritent la même rigueur que le logiciel : leur conception, leur évolution et leur maintenance doivent être intentionnelles et assumées. Un workflow de déploiement défectueux, un circuit d’approbation cassé ou un processus d’incident mal conçu peuvent nuire à l’ingénierie aussi sérieusement qu’un code brisé. Considérer le processus comme un véritable artefact technique, c’est le reconnaître comme un composant à part entière qui doit être conçu, pas simplement documenté.
Processus d’ingénierie essentiels
Processus d’intégration continue
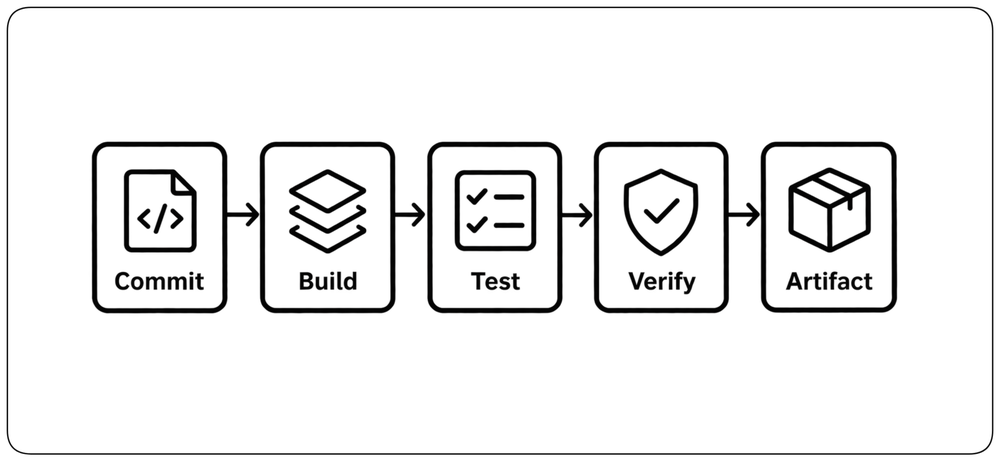
L’intégration continue (CI) intègre en continu les modifications dans une base de code partagée, les valide et génère des artéfacts logiciels versionnés prêts pour la livraison en aval. Chaque changement déclenche des vérifications automatisées telles que la compilation, les tests unitaires, l’analyse statique et la détection de failles de sécurité. Si la validation réussit, le pipeline construit et publie des artéfacts traçables, comme des paquets ou des images de conteneur.
Processus de chemin vers la production
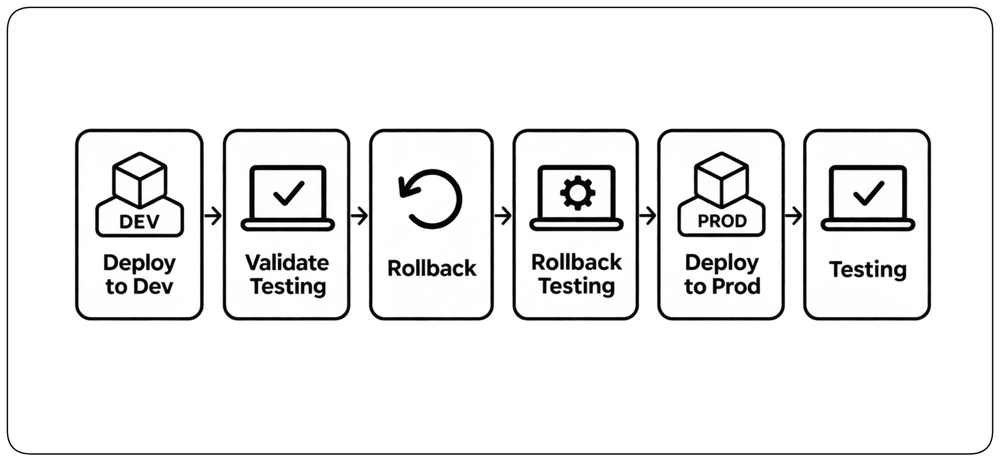
Le chemin vers la production est le processus contrôlé par lequel un changement logiciel est construit, validé, puis déployé en toute sécurité. Contrairement au chemin de développement, il vise à réduire le risque de déploiement via des vérifications automatisées, l’intégrité des artefacts, les autorisations, la surveillance de la santé du déploiement et des mécanismes de rollback ou de récupération. Il garantit que la nouvelle version tourne en toute sécurité ; décider quand et à qui une fonctionnalité devient visible relève du processus de feature rollout. L’objectif est de rendre le déploiement en production sûr, répétable, observable et routinier.
Processus de chemin vers le développement
Le chemin de développement permet aux ingénieurs de déployer et de tester rapidement des modifications dans un environnement de développement, sans les contrôles de niveau production. Les ingénieurs doivent pouvoir déployer directement depuis une branche ou une pull request via le CI, ou bien passer outre le CI et envoyer leurs modifications depuis leur machine locale vers l’environnement de développement. Les deux méthodes doivent être en libre-service, rapides, et nécessiter très peu de coordination. L’objectif est de raccourcir la boucle de retour, afin que les ingénieurs puissent expérimenter, déboguer, valider les intégrations et observer les changements dans un environnement en fonctionnement avec un minimum de friction.
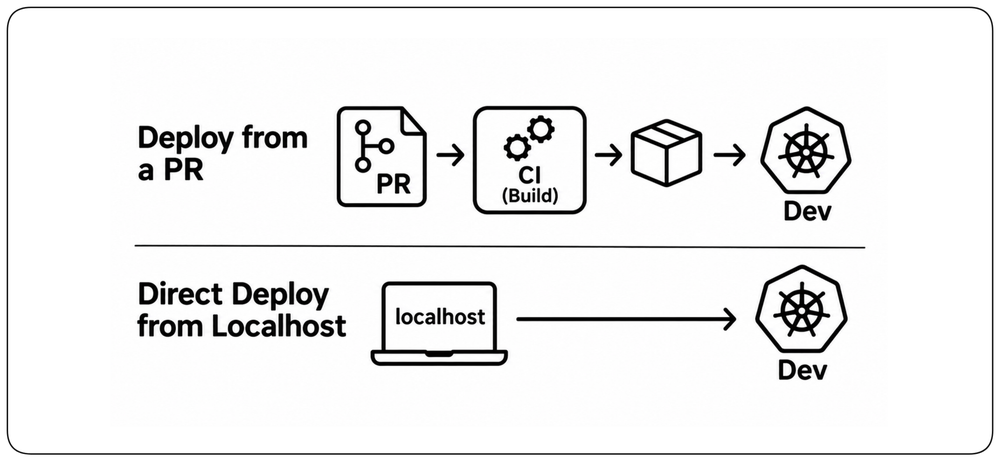
Processus de gestion des versions
La gestion des releases contrôle la manière dont les artefacts logiciels validés progressent à travers les différents environnements. Elle suit quel artefact est déployé où, applique les politiques de sécurité et de promotion, gère les fenêtres de déploiement et les périodes de moratoire, et impose un délai de stabilisation suffisant avant de passer à l’environnement suivant. Les développeurs doivent avoir une visibilité claire sur le statut des releases, les résultats de validation, l’historique des déploiements et les différences de versions entre les environnements. L’objectif est de rendre les releases prévisibles, traçables et de plus en plus automatisées, tout en empêchant les promotions non sûres ou non autorisées.
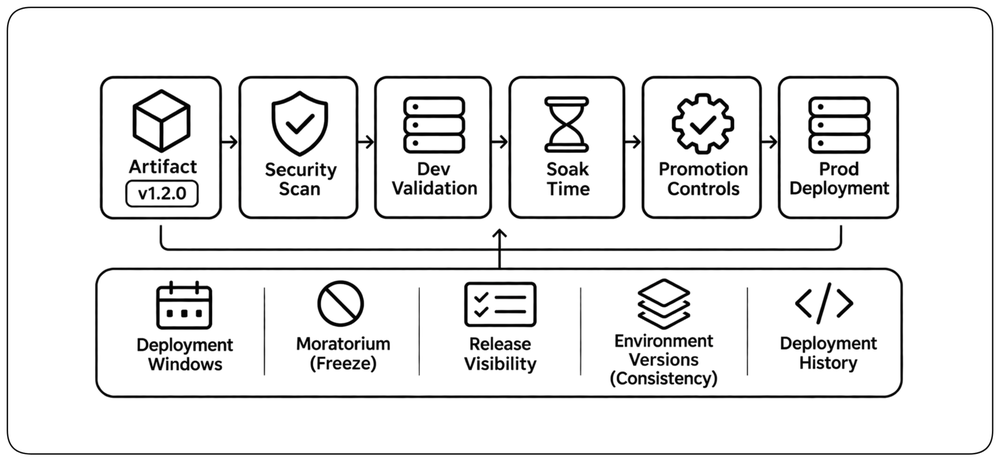
Processus de déploiement progressif de fonctionnalité
Déployer du code et exposer une fonctionnalité aux utilisateurs sont deux décisions différentes. Le processus de déploiement progressif contrôle le moment, l’endroit et les utilisateurs qui bénéficient du nouveau comportement. L’utilisation de feature flags, d’une exposition progressive, d’indicateurs de santé et du rollback automatique permet de tester sans grand impact avant une ouverture plus large. Ce processus doit définir les critères de succès, le responsable, et ce qui se passe en cas de problème. L’objectif est de diffuser la valeur progressivement tout en limitant les risques de comportements inattendus.
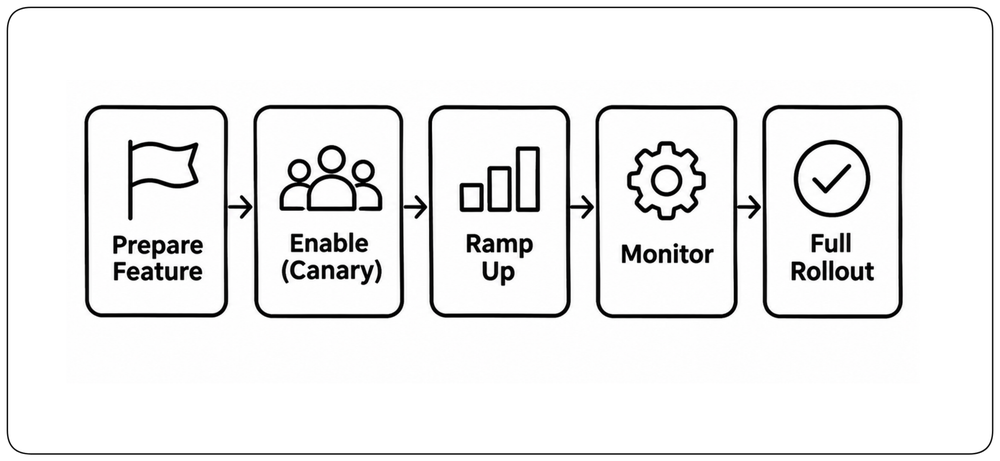
Processus de revue de code
La relecture de code associe vérifications automatisées, analyse assistée par IA et jugement humain pour améliorer la qualité logicielle. Les outils automatisés appliquent des règles prévisibles, tandis que l’IA aide à détecter les bugs potentiels, incohérences logiques, problèmes de sécurité et cas limites négligés. Les relecteurs humains apportent le contexte architectural, la compréhension métier et leur jugement sur la conception ainsi que la maintenabilité. Ces atouts se complètent, offrant ainsi différents points de vue sur une même modification. Les relectures peuvent nécessiter plusieurs cycles de retours, de corrections et de validations avant qu’un changement ne soit approuvé puis fusionné.
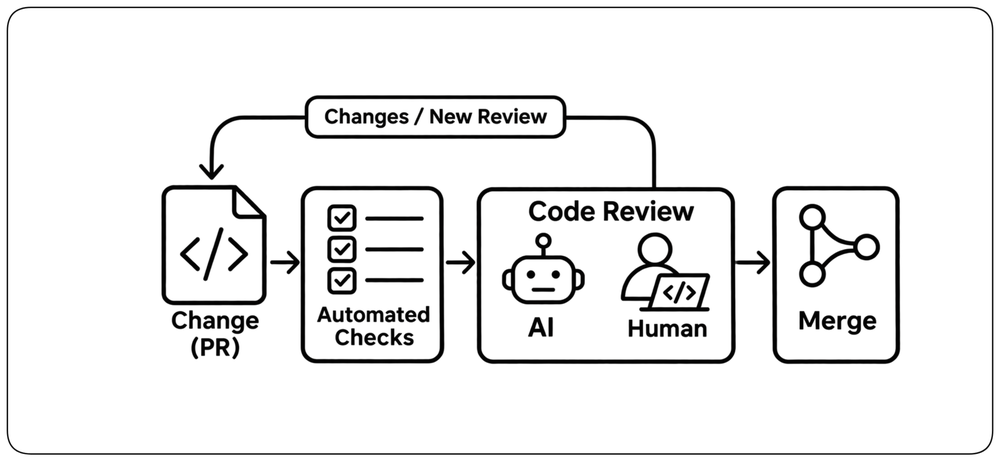
Processus de revue d’architecture
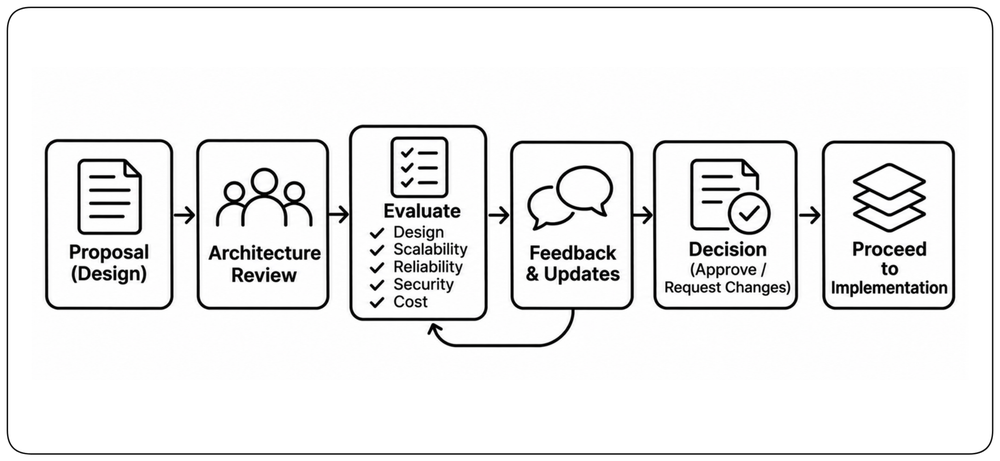
Les changements architecturaux majeurs impactent souvent plusieurs services, équipes et orientations techniques à long terme. Un processus de revue d’architecture garantit que les choix importants sont évalués avant l’implémentation, en considérant les alternatives, les compromis, la sécurité, l’évolutivité et les impacts opérationnels. Les revues doivent être proportionnées au risque et à l’ampleur du changement, avec des critères clairs pour déterminer quand elles sont nécessaires. L’objectif est de s’appuyer sur l’expertise collective et d’assurer la cohérence globale, sans transformer chaque choix en parcours d’approbation interminable.
Processus de création d’environnement
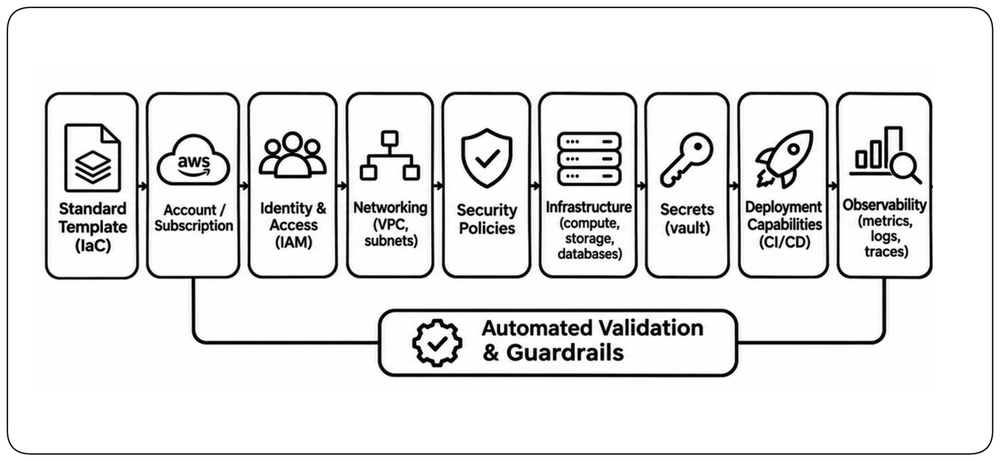
Créer un nouvel environnement de développement, de préproduction ou de production doit être un processus reproductible, et non un projet d’infrastructure unique. Il orchestre le réseau, l’infrastructure, l’identité, les politiques de sécurité, les secrets, les capacités de déploiement, l’observabilité et la préparation opérationnelle. Les modèles standards et la validation automatique assurent la cohérence des environnements et réduisent la dépendance à des équipes spécialisées. Les environnements de production exigent des garde-fous et des vérifications supplémentaires. L’objectif est d’offrir des environnements complets de manière fiable, sécurisée et avec un minimum de coordination manuelle.
Processus d’approvisionnement en infrastructure en libre-service
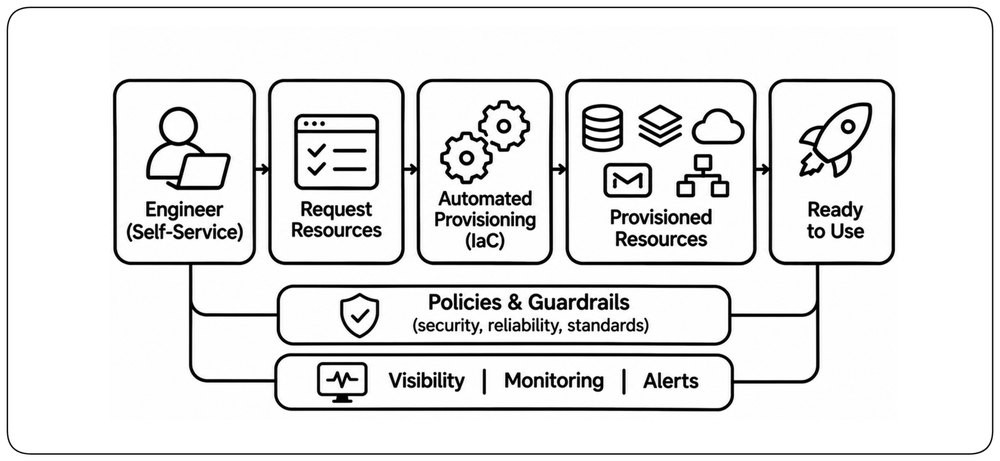
L’approvisionnement en infrastructure fournit les ressources nécessaires au fonctionnement des services individuels, telles que les bases de données, les caches, le stockage d’objets, les files d’attente et la connectivité réseau spécifique à chaque service. Les ingénieurs doivent pouvoir déployer ces ressources via des parcours standardisés en libre-service, sans avoir à ouvrir de tickets, dépendre d’équipes spécialisées, ni développer leurs propres modules Terraform. L’Infrastructure as Code permet de rendre les configurations reproductibles, tandis que les politiques automatisées appliquent les standards de sécurité, de fiabilité et d’organisation. Les demandes inhabituelles ou sensibles passent par un processus de validation explicite. L’objectif est de rendre l’infrastructure disponible rapidement, en toute sécurité et avec un minimum de coordination manuelle.
Processus d’intégration d’un service
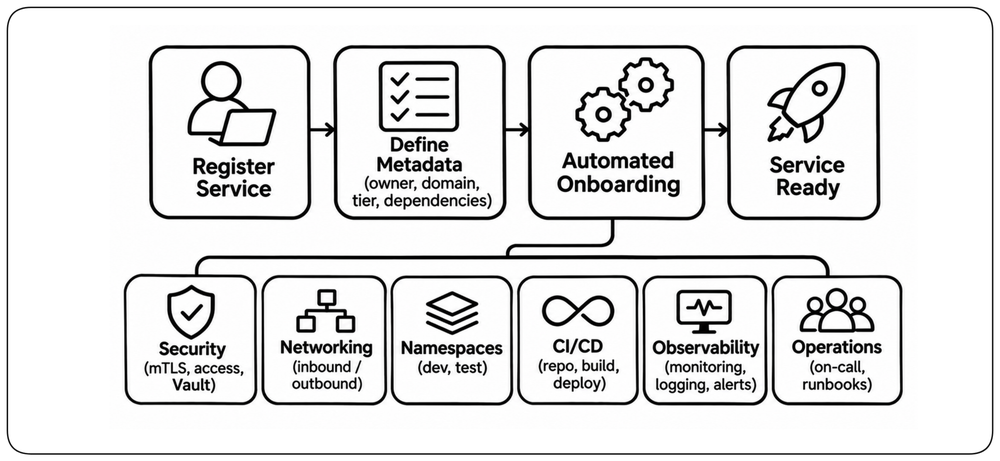
L’onboarding d’un service commence par l’enregistrement du nouveau service avec son propriétaire, son domaine métier, son niveau de criticité, ses dépendances, sa documentation et ses exigences en matière de sécurité. Ces informations alimentent l’automatisation de la configuration des politiques réseau, de l'identité du service, des certificats mTLS, des droits d’accès, des environnements de développement et de test, des pipelines CI/CD, ainsi que du monitoring, de la journalisation et des alertes. Les configurations standard définissent les paramètres de sécurité et d’exploitation par défaut, tandis que les spécificités du service déterminent les communications autorisées, les droits de déploiement et les besoins de fiabilité. L’objectif est de rendre les services prêts pour le développement et le déploiement via un processus homogène, en libre-service et avec une coordination manuelle minimale.
Processus de gestion de l’astreinte
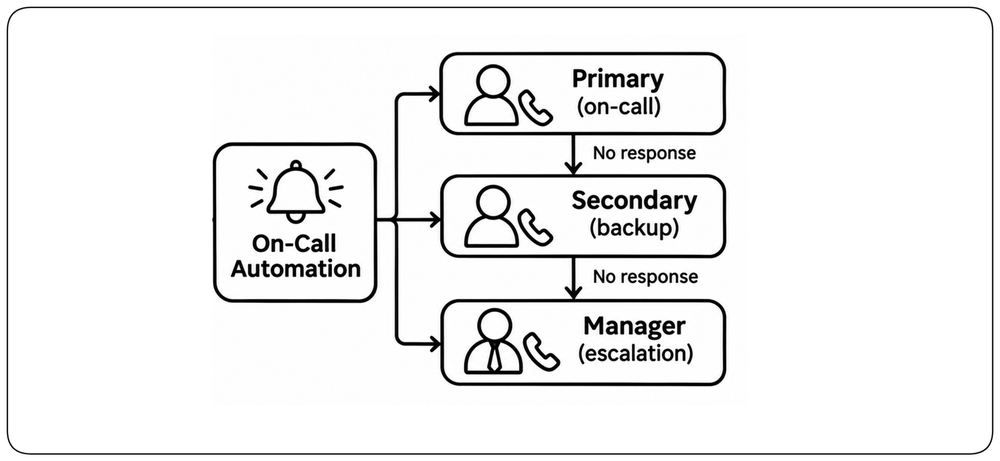
Une exploitation fiable exige qu’une personne soit responsable lorsque les systèmes nécessitent une intervention. Un processus de gestion de l’astreinte définit les rotations, la couverture, les escalades et les passations, afin que les incidents parviennent aux bonnes personnes sans dépendre de contacts personnels ou d’arrangements informels. Les alertes doivent être actionnables, routées automatiquement et appuyées sur des attentes claires et des procédures de récupération. Le processus doit aussi prévenir la surcharge et rendre visibles les interruptions récurrentes. L’objectif est d’assurer une réponse fiable sans reposer sur la disponibilité permanente de quelques ingénieurs.
Processus de gestion des incidents
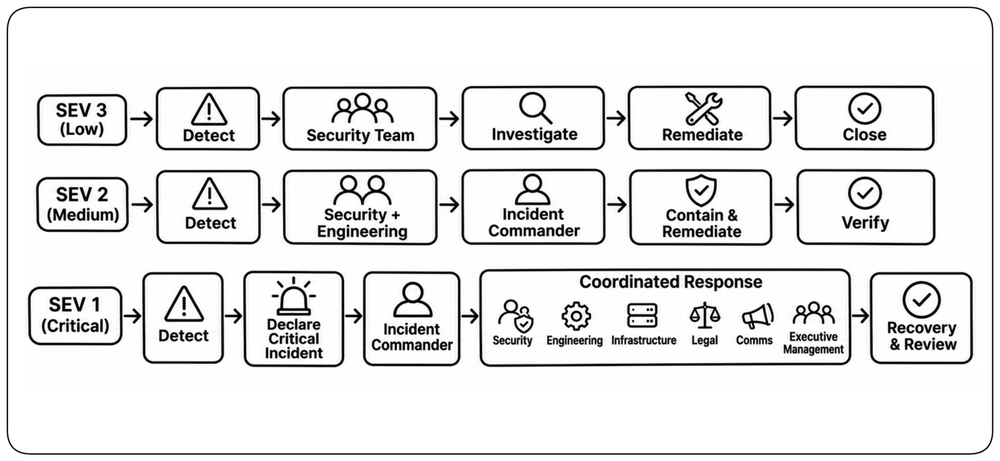
Les incidents nécessitent une réponse structurée, adaptée à leur gravité et leur nature. Un processus standardisé définit comment les incidents sont détectés, classés, escaladés, coordonnés et résolus. Les incidents les plus graves mobilisent des équipes supplémentaires, des rôles spécialisés et la direction. Les incidents de sécurité peuvent aussi exiger la neutralisation de la menace, des investigations forensiques, la préservation des preuves et l’intervention d’experts juridiques. Des responsabilités claires, des notifications automatisées et des procédures de reprise éprouvées réduisent la dépendance à une coordination improvisée. L’objectif est de rétablir les opérations normales rapidement et en toute sécurité tout en tirant des enseignements de chaque incident.
Processus de restauration de base de données
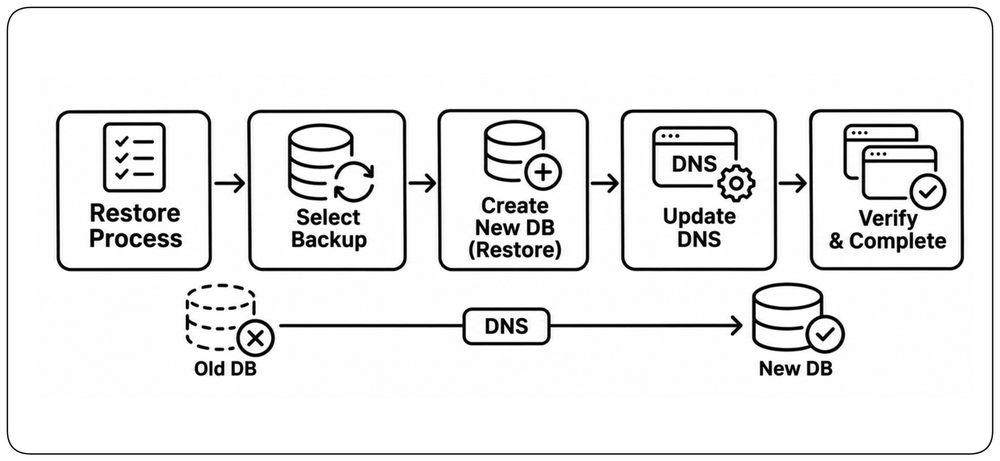
Les sauvegardes sont généralement intégrées à l’infrastructure et configurées via l’Infrastructure as Code, avec des planifications et des politiques de rétention automatisées. Cependant, la restauration des données est souvent beaucoup plus complexe. Elle peut impliquer la sélection de la bonne sauvegarde, la mise à disposition des ressources, la restauration des données, la reconnexion des services et la vérification de la cohérence. Un processus de restauration standardisé et automatisé doit orchestrer ces étapes, gérer les échecs et réduire le temps de reprise. L’objectif est de rendre la restauration rapide, fiable et reproductible, sans exiger que les ingénieurs exécutent manuellement des procédures complexes.
Processus de reprise après sinistre
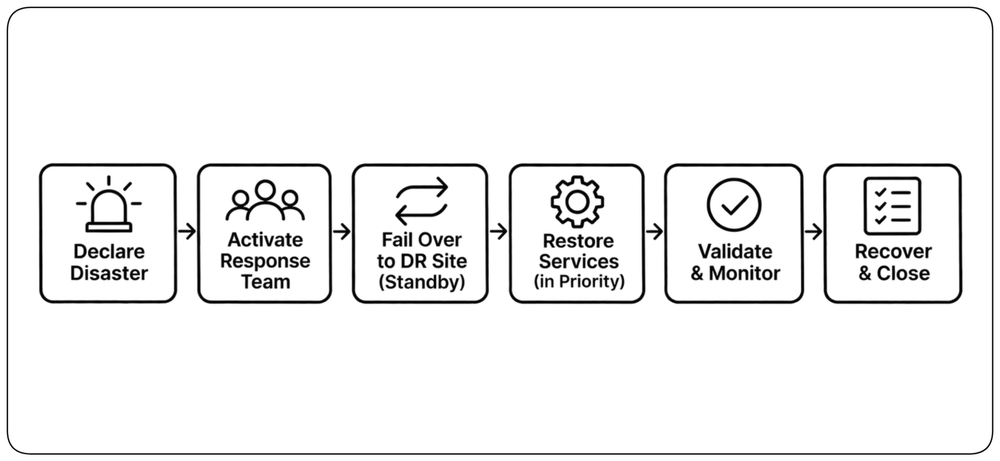
La reprise après sinistre permet à l’organisation de restaurer ses services critiques lorsqu’une défaillance majeure dépasse le cadre d’un incident habituel. Elle définit les objectifs de reprise, les procédures de bascule, les responsabilités, les circuits de communication, et les preuves justifiant la remise en service. Les sauvegardes seules ne suffisent pas : la reprise doit être testée dans des conditions réalistes et continuellement améliorée. L’objectif est de pouvoir surmonter des défaillances sévères grâce à une procédure maîtrisée, et non par des actions héroïques improvisées.
Processus de gestion des vulnérabilités
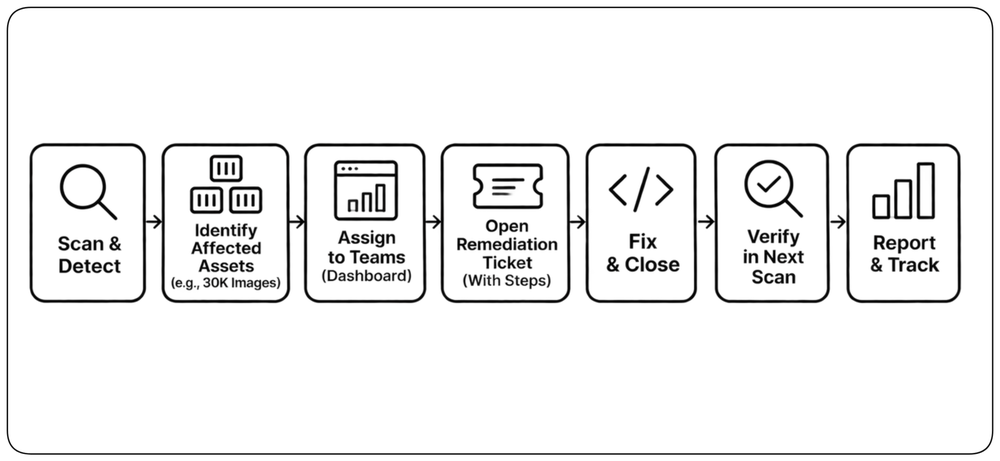
Des failles de sécurité sont découvertes en permanence dans les applications, bibliothèques, conteneurs et infrastructures. Un processus de gestion des vulnérabilités identifie automatiquement les expositions, évalue leur gravité réelle, attribue les responsabilités et suit la correction. Toutes les vulnérabilités ne nécessitent pas la même urgence. La priorisation doit prendre en compte l’exploitabilité, l’exposition et l’impact métier. L’objectif est de transformer la découverte de failles en démarche continue et mesurable, plutôt qu’en urgence exceptionnelle.
Processus pour les logiciels tiers
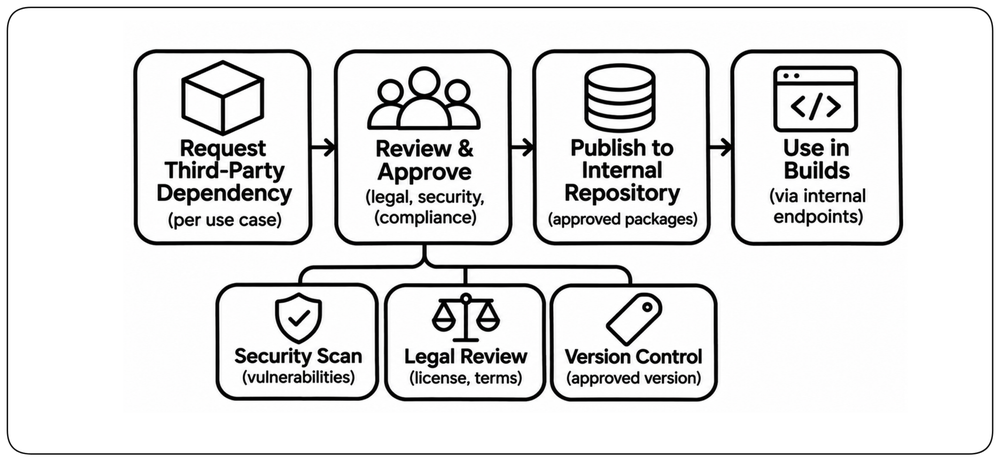
L’introduction de bibliothèques, paquets, logiciels, services ou outils tiers dans une organisation doit être encadrée de façon adéquate. Un processus dédié coordonne l’évaluation de la sécurité, les revues juridiques, les vérifications de conformité et l’évaluation du fournisseur. Les exigences et validations doivent être proportionnelles au niveau de risque, et les demandes courantes traitées de façon automatisée et en libre-service autant que possible. Les dépendances approuvées doivent être diffusées via des dépôts de confiance. L’objectif est de donner accès à des solutions externes sans introduire de risques non maîtrisés ni de délais inutiles.
Processus de gestion des accès aux environnements
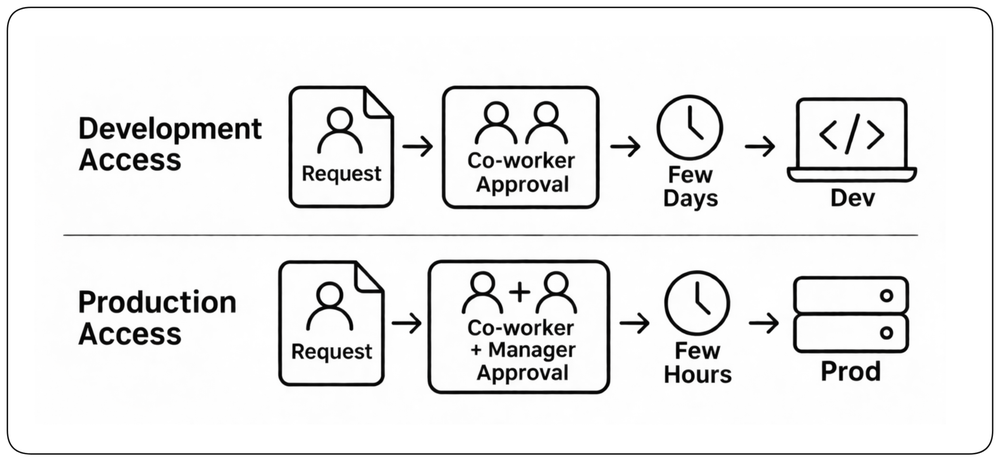
L’accès aux environnements de développement et de production doit suivre le principe du moindre privilège. Les ingénieurs peuvent disposer d’un accès en lecture permanent aux environnements dont ils ont la responsabilité, mais l’accès en écriture ne doit être accordé qu’en cas de besoin. Un processus en libre-service permet de demander des permissions temporaires, avec une durée, des conditions de validation et des contrôles de sécurité définis selon l’environnement et le niveau de risque. L’accès à la production peut nécessiter une autorisation supplémentaire, tandis que les demandes à faible risque peuvent être validées automatiquement. Les permissions doivent expirer et être révoquées de façon automatique. L’objectif est de supprimer les privilèges permanents inutiles sans freiner le travail des ingénieurs.
Processus de rotation des identifiants
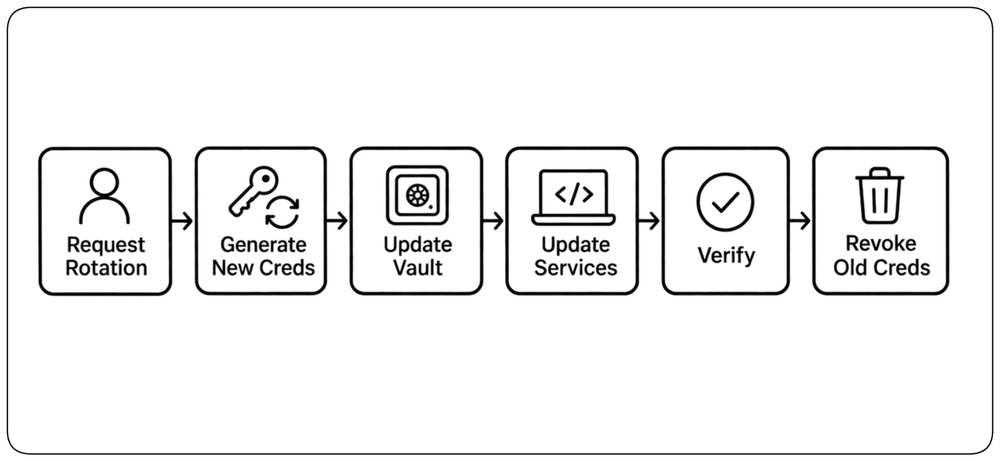
Les applications reposent sur des identifiants tels que des mots de passe de base de données, des clés API ou des secrets de comptes de service. Les développeurs ont besoin d’un processus standardisé et en libre-service pour faire pivoter ces identifiants sans coordination manuelle avec les équipes infrastructure ou sécurité. Ce processus doit générer de nouveaux identifiants, les placer sécuritairement dans des coffres, mettre à jour les services dépendants, vérifier que les nouveaux identifiants fonctionnent, puis révoquer les anciens. La rotation doit être automatisée, planifiée si besoin, et prévoir une reprise en cas d’échec. L’objectif est de rendre la rotation des identifiants sûre, courante et indépendante d’une expertise spécifique.
Processus d’intégration et de sortie des employés
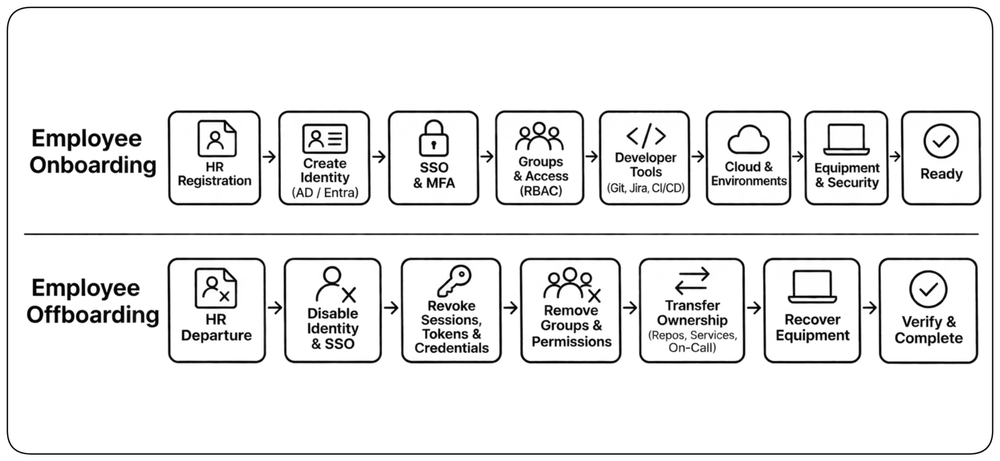
L’intégration et le départ des employés doivent être standardisés, automatisés et coordonnés entre les équipes RH, IT, sécurité et direction. L’onboarding assure que les nouveaux employés reçoivent le matériel, les comptes, les droits et les outils nécessaires pour être productifs. L’offboarding garantit que les accès sont révoqués, les ressources de l’entreprise sont récupérées et les responsabilités transférées lors du départ. Ces deux processus nécessitent une responsabilité claire, une exécution rapide et une vérification. L’objectif est de rendre les transitions des employés efficaces, sûres et indépendantes de la coordination manuelle.
Processus de décommissionnement de service
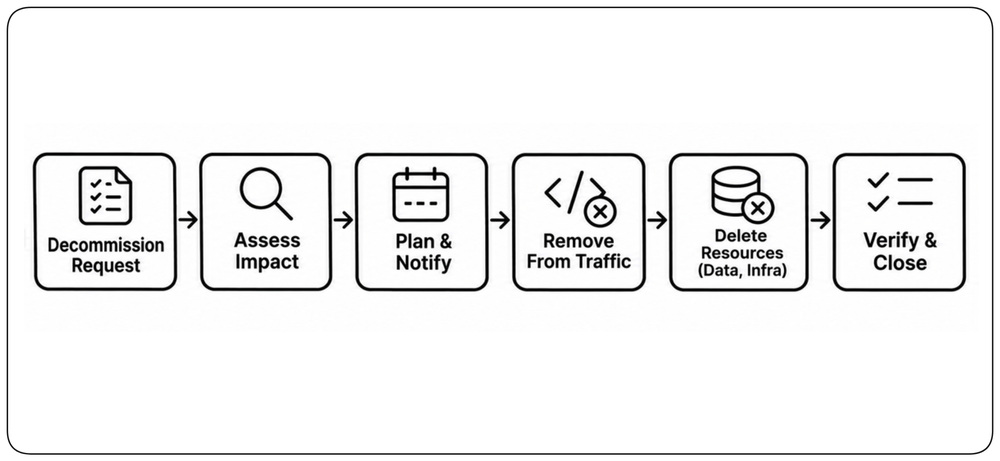
Supprimer un service peut être aussi complexe que d’en introduire un. Un processus de décommissionnement identifie les consommateurs et les dépendances, vérifie que le service n’est plus utile, et retire de façon sécurisée le trafic, l’infrastructure, les identifiants, la supervision et les ressources associées. Les exigences de conservation des données et de conformité doivent être respectées. Ce processus doit éviter que des services abandonnés deviennent des risques de sécurité, des coûts inutiles ou des dépendances cachées. Le décommissionnement doit faire partie intégrante du cycle de vie des services, et non être une opération de nettoyage improvisée.
Principes de conception des processus
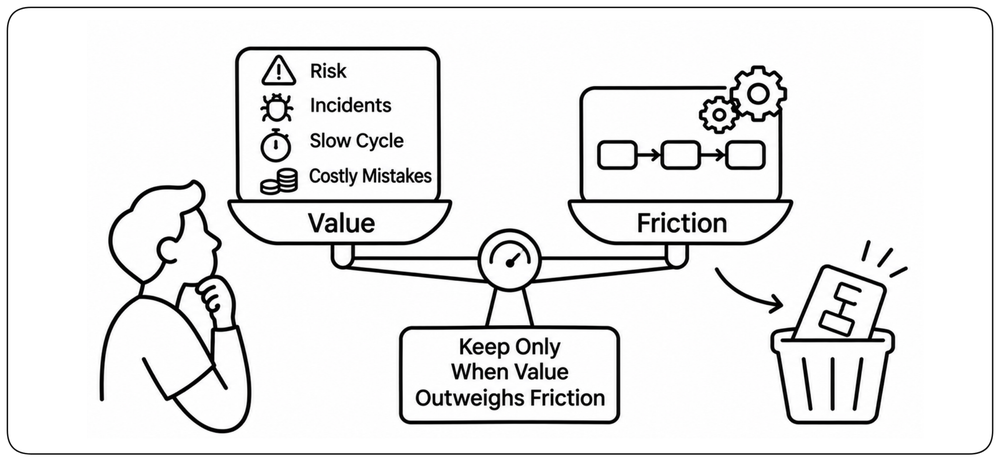
Un processus doit mériter son coût
Chaque processus doit répondre à un problème réel et observé — un incident récurrent, une erreur coûteuse, un cycle de revue lent. Un processus ajouté sans risque concret, mode de défaillance ou objectif mesurable risque de devenir de la bureaucratie. La même discipline s’applique en sens inverse : un processus dont la justification d’origine ne tient plus doit être supprimé, pas conservé par habitude. Un processus ne doit continuer d’exister que tant que la valeur qu’il crée justifie la friction qu’il introduit.
Concevoir le flux de bout en bout
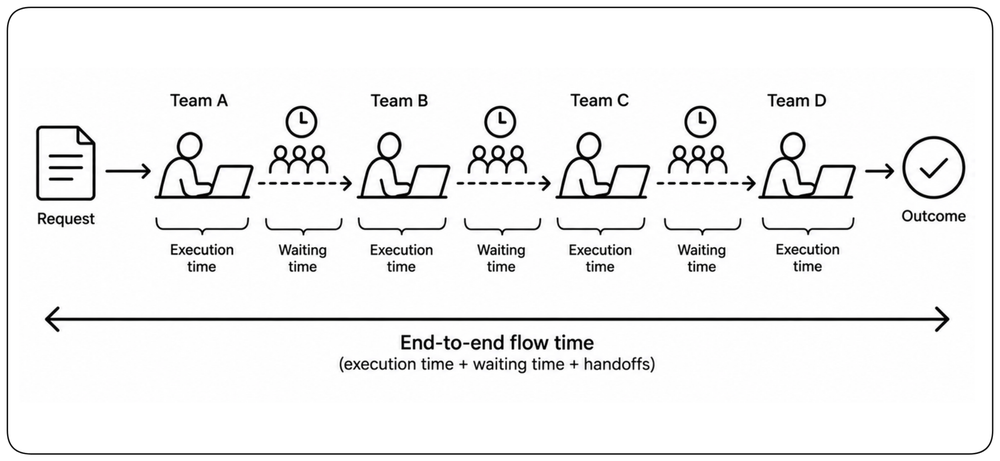
Un processus doit être conçu en fonction du résultat final, et non selon l’efficacité de chaque équipe ou activité individuelle. Le travail peut avancer vite dans une équipe puis attendre des jours ailleurs. Un manque de clarté sur la propriété, des informations manquantes ou des transferts mal définis entraînent des retards. Un bon processus rend ces transitions explicites et optimise l’ensemble du parcours, de la demande jusqu’au résultat, en prenant en compte les attentes, reprises et coordinations inter-équipes.
Les processus doivent faire avancer le travail, pas déplacer les personnes
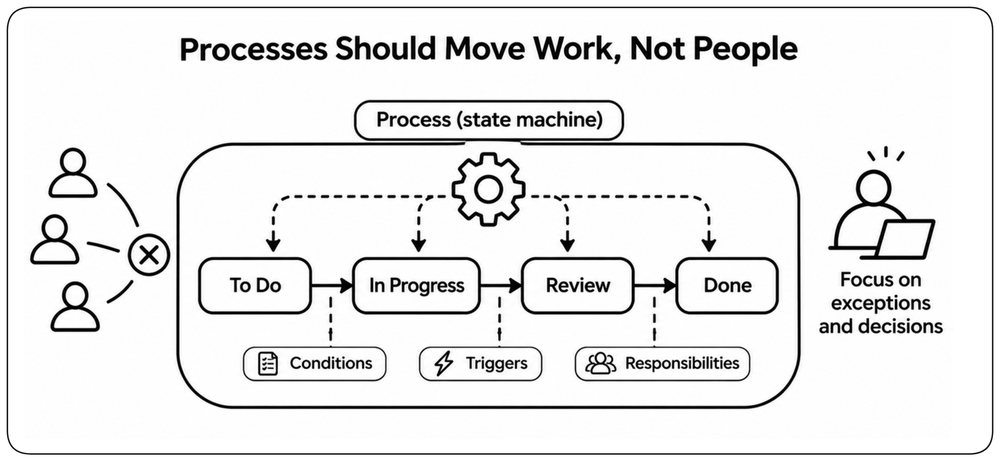
Un processus peut être conçu comme une machine à états, où le travail progresse à travers des états et des transitions définis. Chaque transition possède des conditions, des déclencheurs et des responsabilités claires. Les transitions courantes doivent avancer automatiquement quand leurs conditions sont remplies ; les décisions nécessitant un jugement ou une validation explicite doivent impliquer la personne compétente. Les humains ne devraient pas avoir à traquer des validations, envoyer des rappels ou coordonner manuellement des étapes prévisibles. L’objectif n’est pas seulement d’automatiser des tâches individuelles, mais le cheminement global du travail tout en conservant des décisions humaines là où elles ont de la valeur.
Séparer la politique de l’exécution
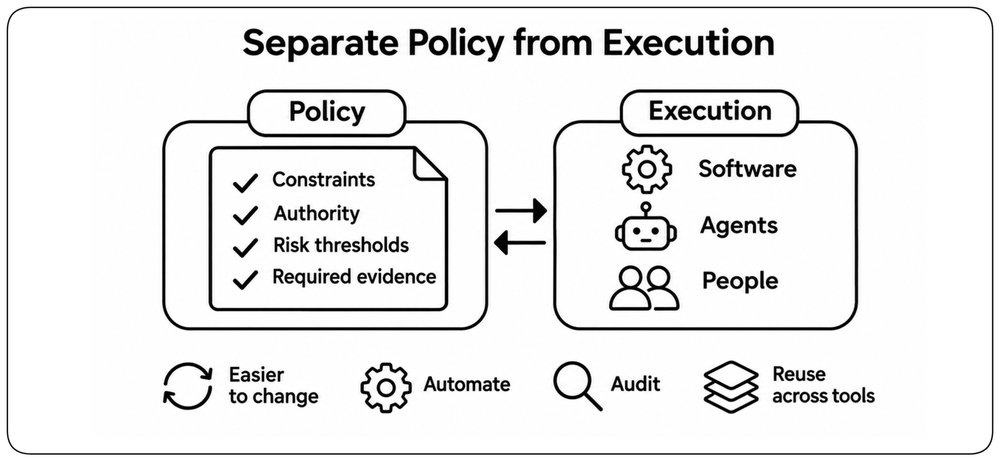
La politique définit ce qui doit être vrai : contraintes, autorités, seuils de risque, preuves requises. L’exécution applique ces règles, que ce soit par logiciel, agents ou personnes. Les dissocier rend un processus plus facile à faire évoluer, automatiser, auditer et réutiliser, sans enfouir les règles dans l’implémentation. Les politiques peuvent alors devenir des valeurs par défaut, des vérifications automatiques, des règles d’approbation ou des exceptions claires, au lieu de compter sur chaque ingénieur pour les interpréter individuellement.
Minimiser l’intervention humaine, préserver la responsabilité
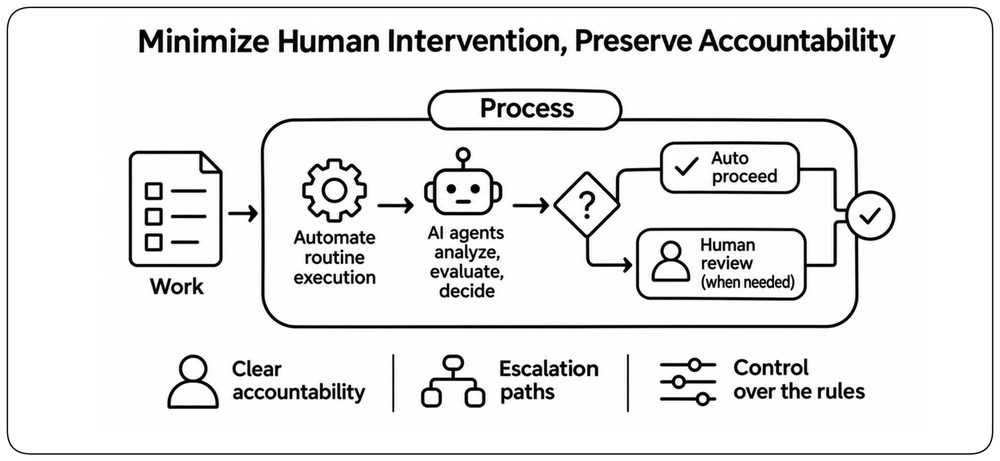
L’intervention humaine doit être réservée aux endroits où elle apporte de la valeur. L’exécution routinière doit être automatisée, mais de plus en plus, les agents IA peuvent aussi analyser le contexte, évaluer des alternatives et prendre des décisions complexes dans des limites définies. Un processus bien conçu délègue au logiciel et aux agents autant d’exécution et de prise de décision que possible en toute sécurité, tout en préservant une responsabilité humaine claire, des chemins d’escalade et le contrôle des règles. L’objectif n’est pas de garder des humains dans chaque boucle — c’est de n’utiliser l’attention humaine que là où le jugement humain reste nécessaire.
Faire du chemin sûr le chemin facile
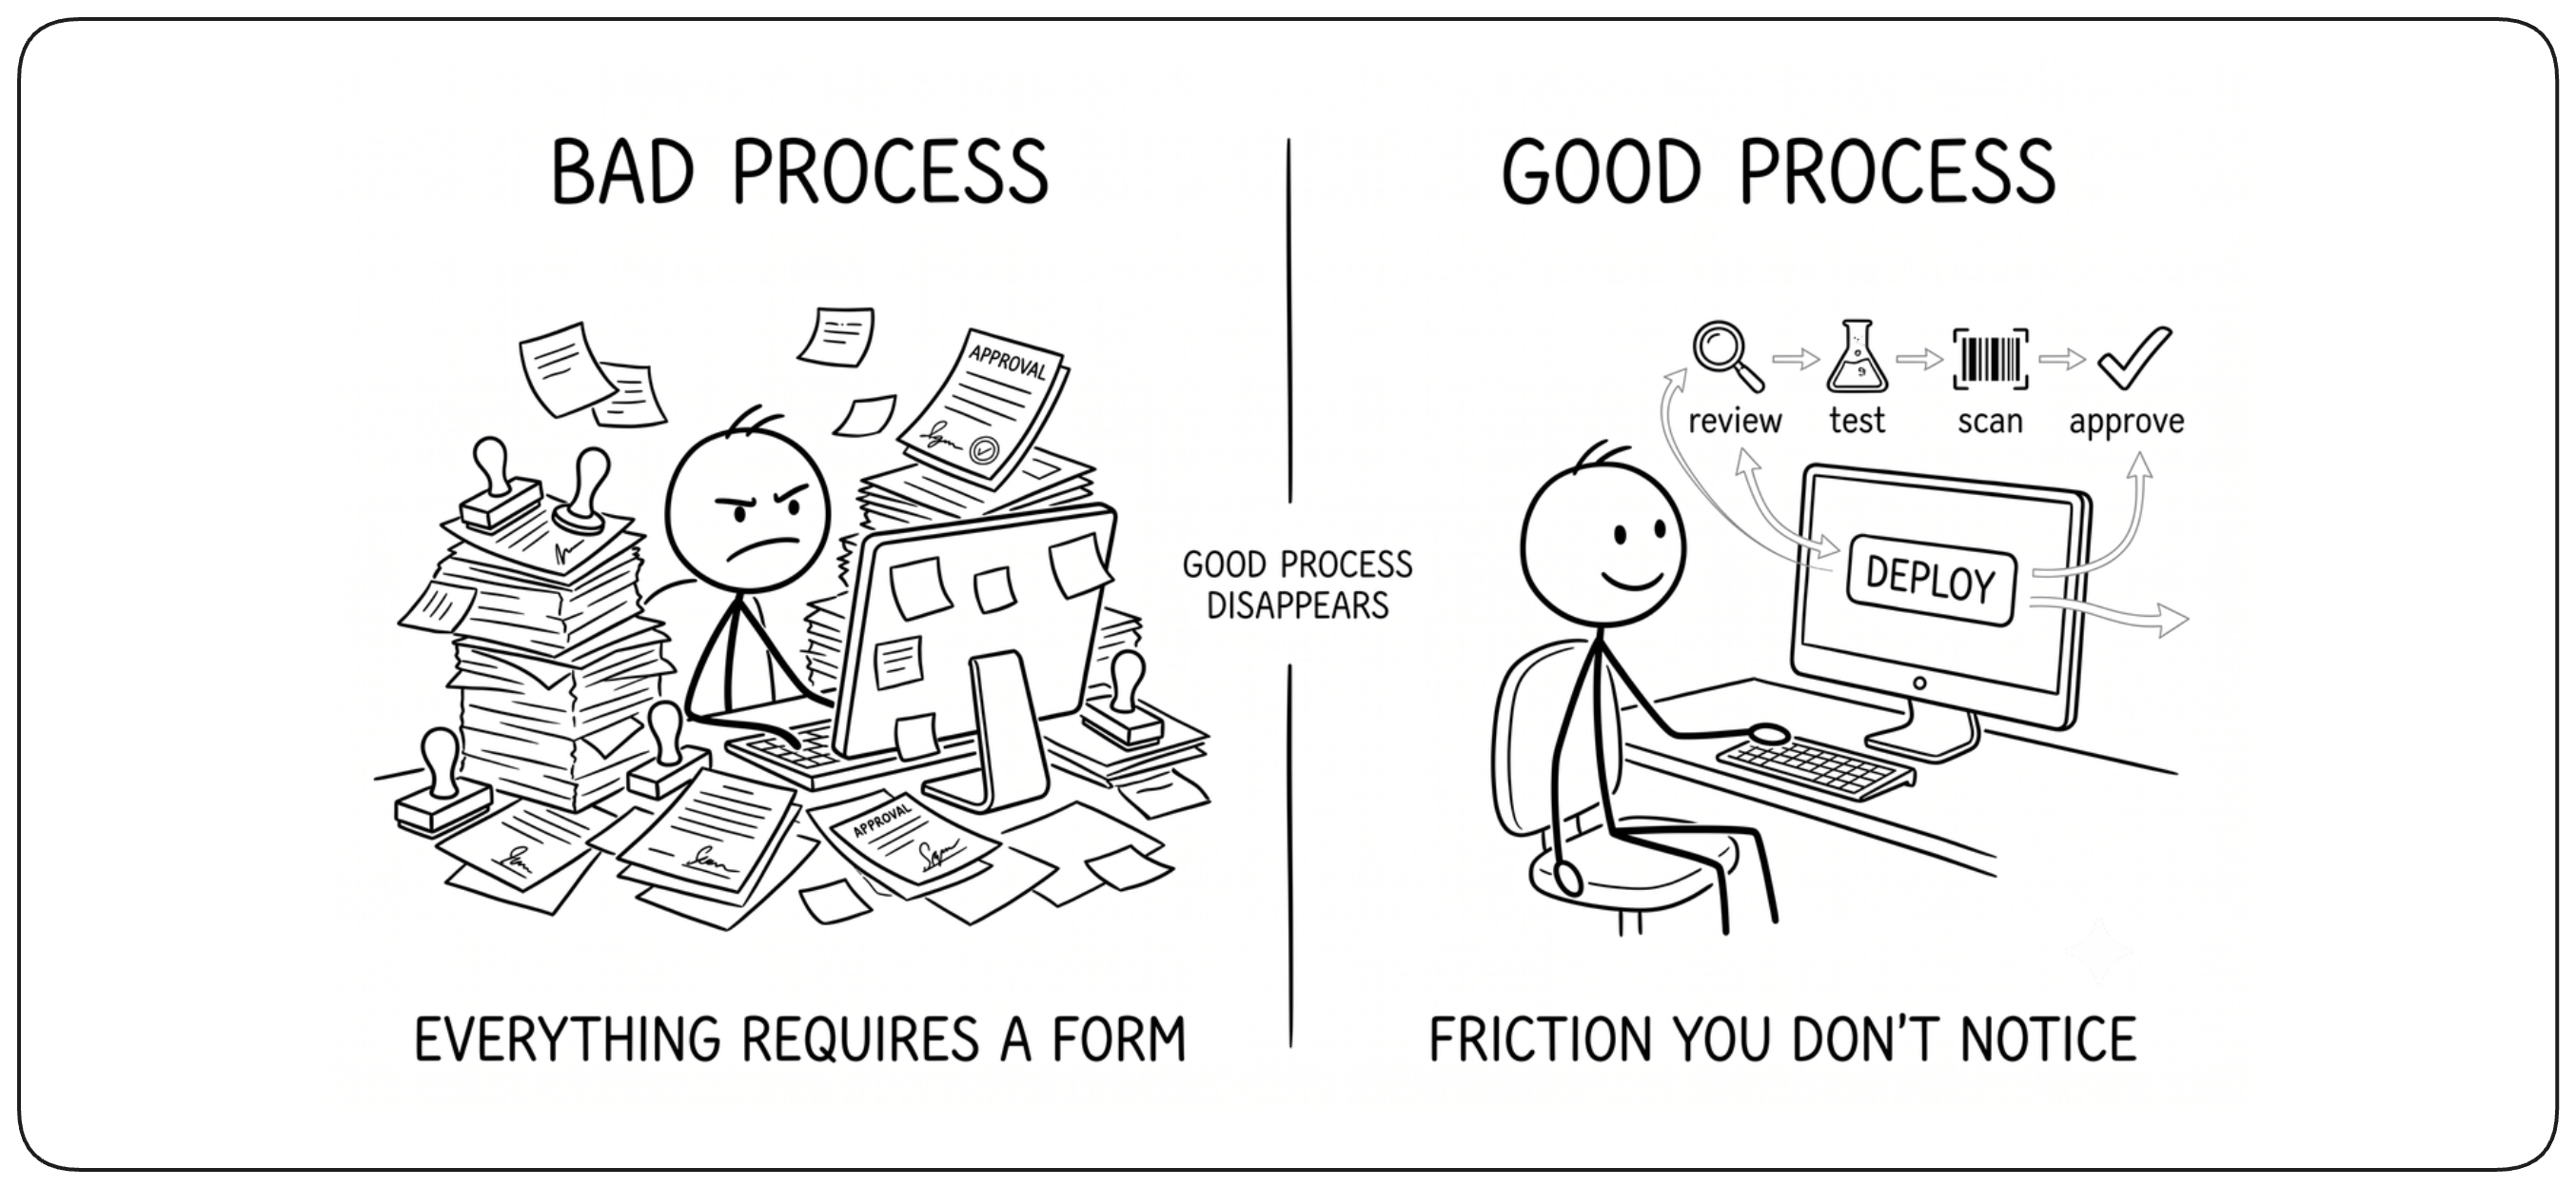
Le chemin sûr est le workflow normal qui satisfait les contrôles, permissions et garde-fous requis. Un bon processus doit faire du chemin sûr le plus facile à suivre. Le workflow courant doit être évident, rapide et, de préférence, intégré à l’outillage et aux valeurs par défaut. Les ingénieurs ne devraient pas avoir à mémoriser le processus ni à décider sans cesse comment le suivre. Quand le bon comportement devient la ligne de moindre résistance, le processus disparaît dans la manière dont le travail est fait.
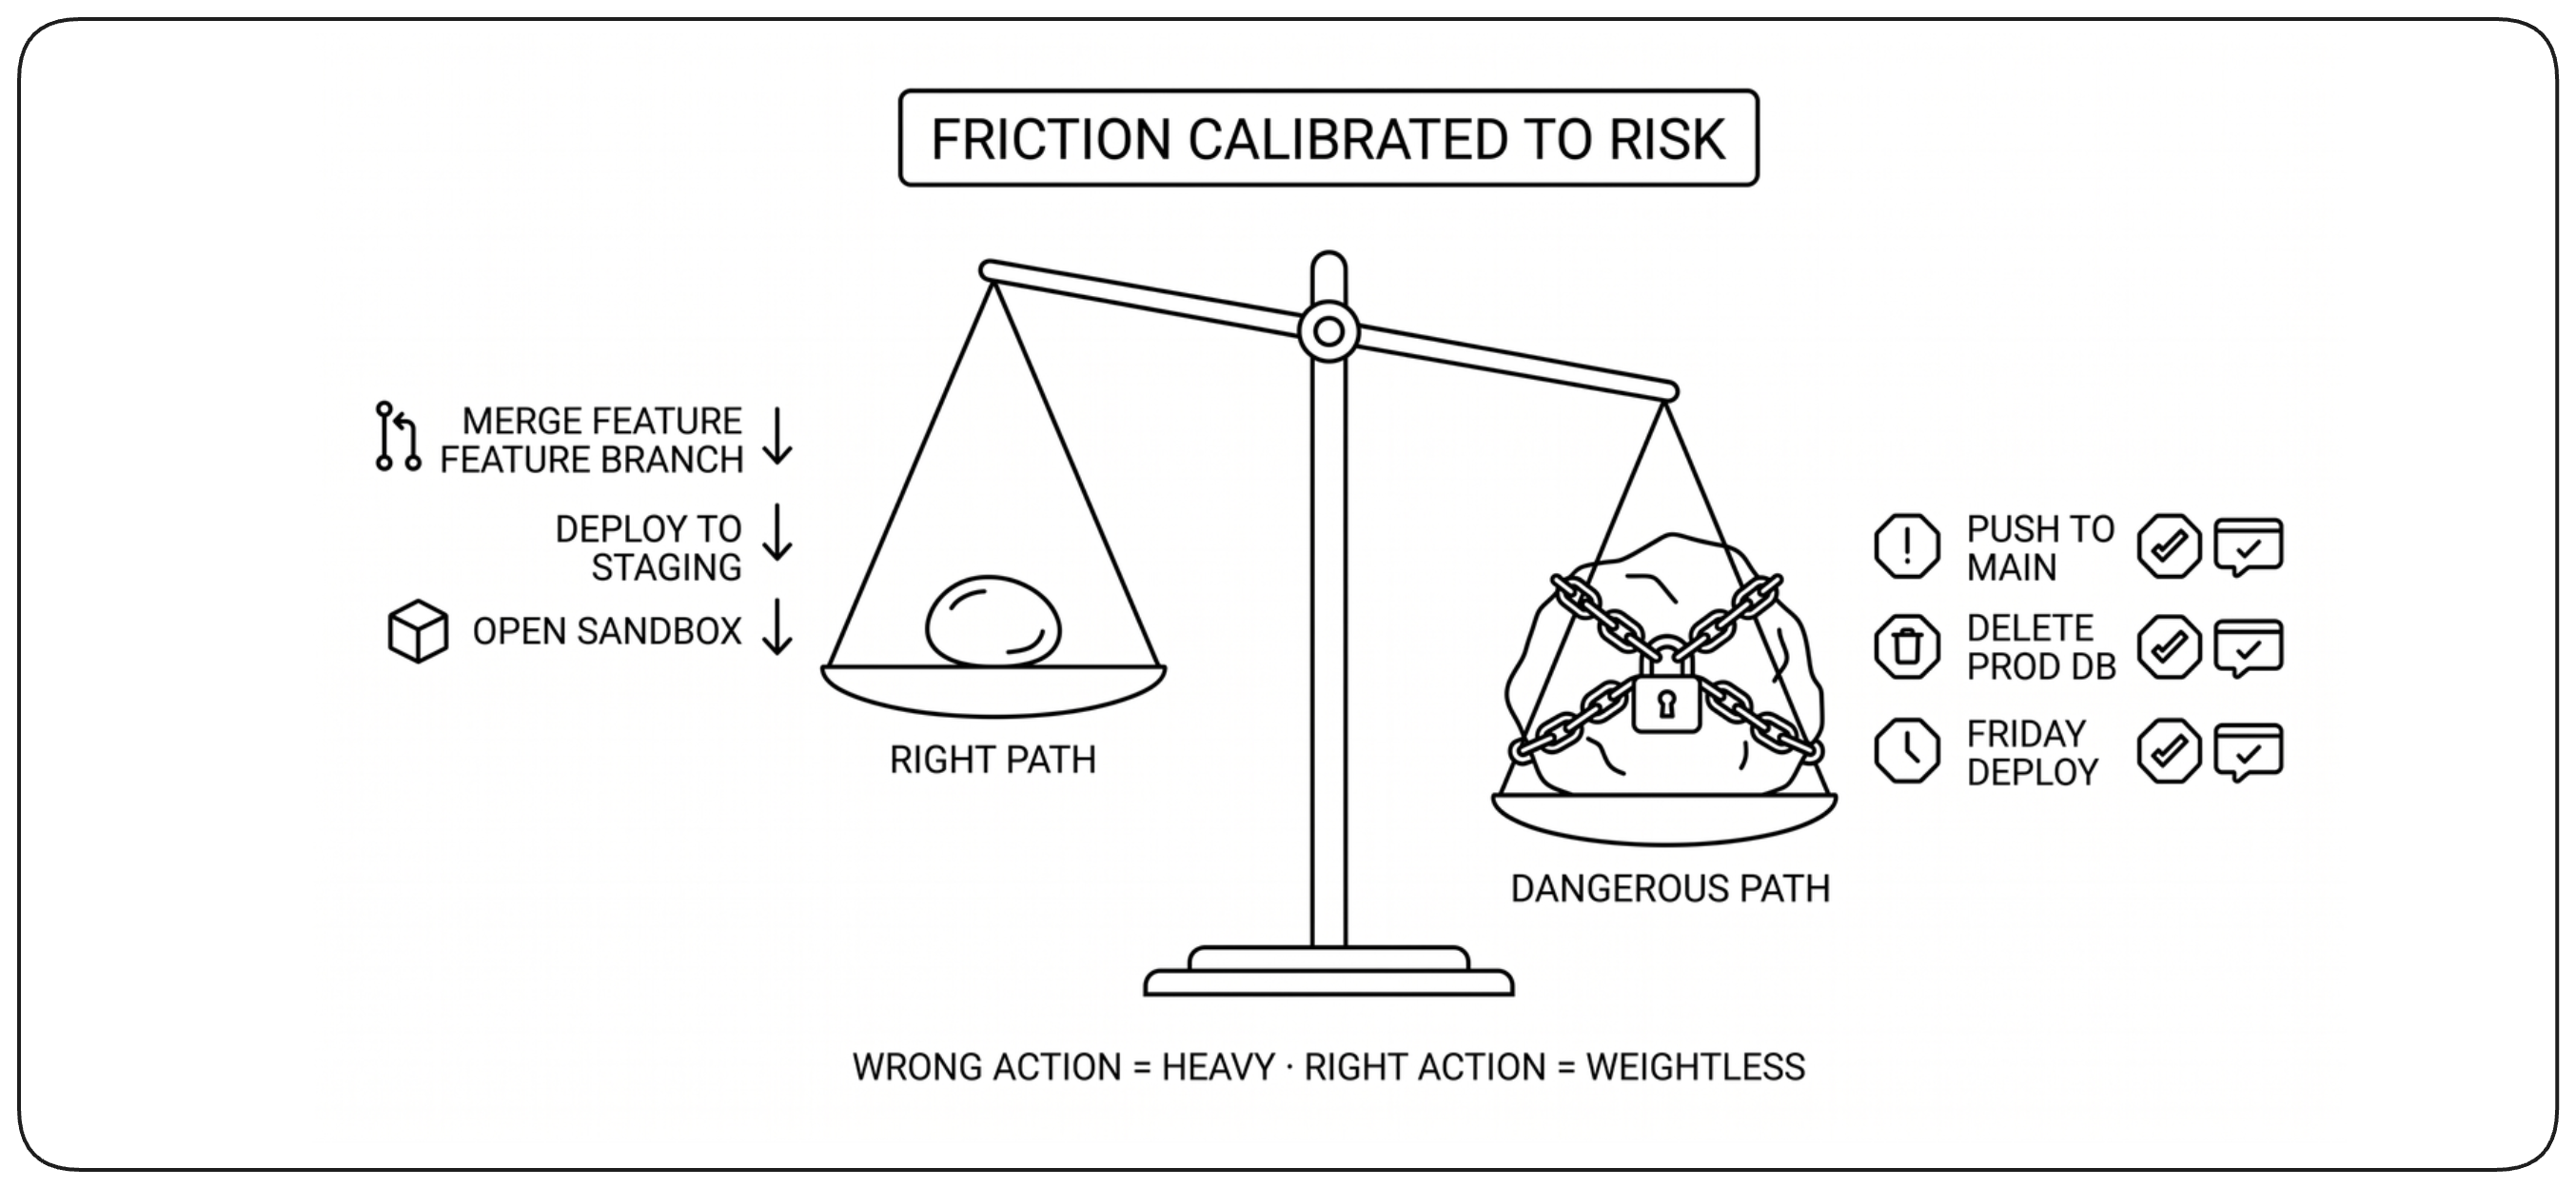
Placez la friction là où il y a du risque
Un bon processus ne supprime pas toute friction : il la place là où elle nous protège, pas là où elle nous ralentit. Les tâches routinières et peu risquées devraient s’effectuer sans lourdeur inutile. Les actes plus risqués ou difficiles à annuler exigent des garde-fous réfléchis : confirmation explicite, relecture supplémentaire, autorisation renforcée ou raison écrite. L’objectif est le minimum de processus qui sécurise le résultat tout en préservant la simplicité du chemin sûr.
Meilleures pratiques de processus
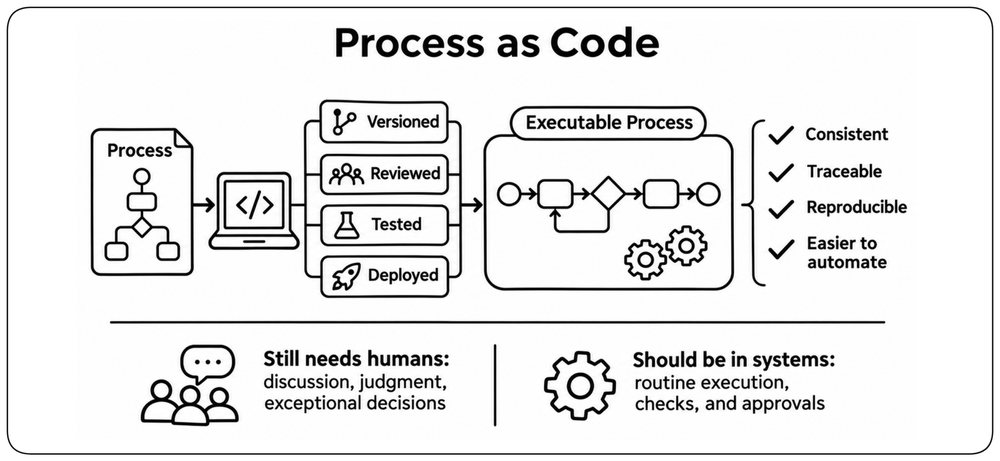
Processus en tant que code
Les processus techniques importants devraient être définis et exécutés par du code, dès que cela est possible. Les workflows, politiques, règles d’approbation, vérifications et transitions doivent être versionnés, relus, testés et déployés comme un logiciel. Ceci garantit des comportements cohérents, traçables, reproductibles et plus simples à automatiser à travers les équipes. Toutes les interactions humaines ne peuvent ni ne doivent être codées : la discussion, le jugement et les décisions exceptionnelles restent essentiels. Mais pour les tâches de routine, l’exécution doit vivre dans les systèmes, pas dans les documents ou dans la mémoire des équipes.
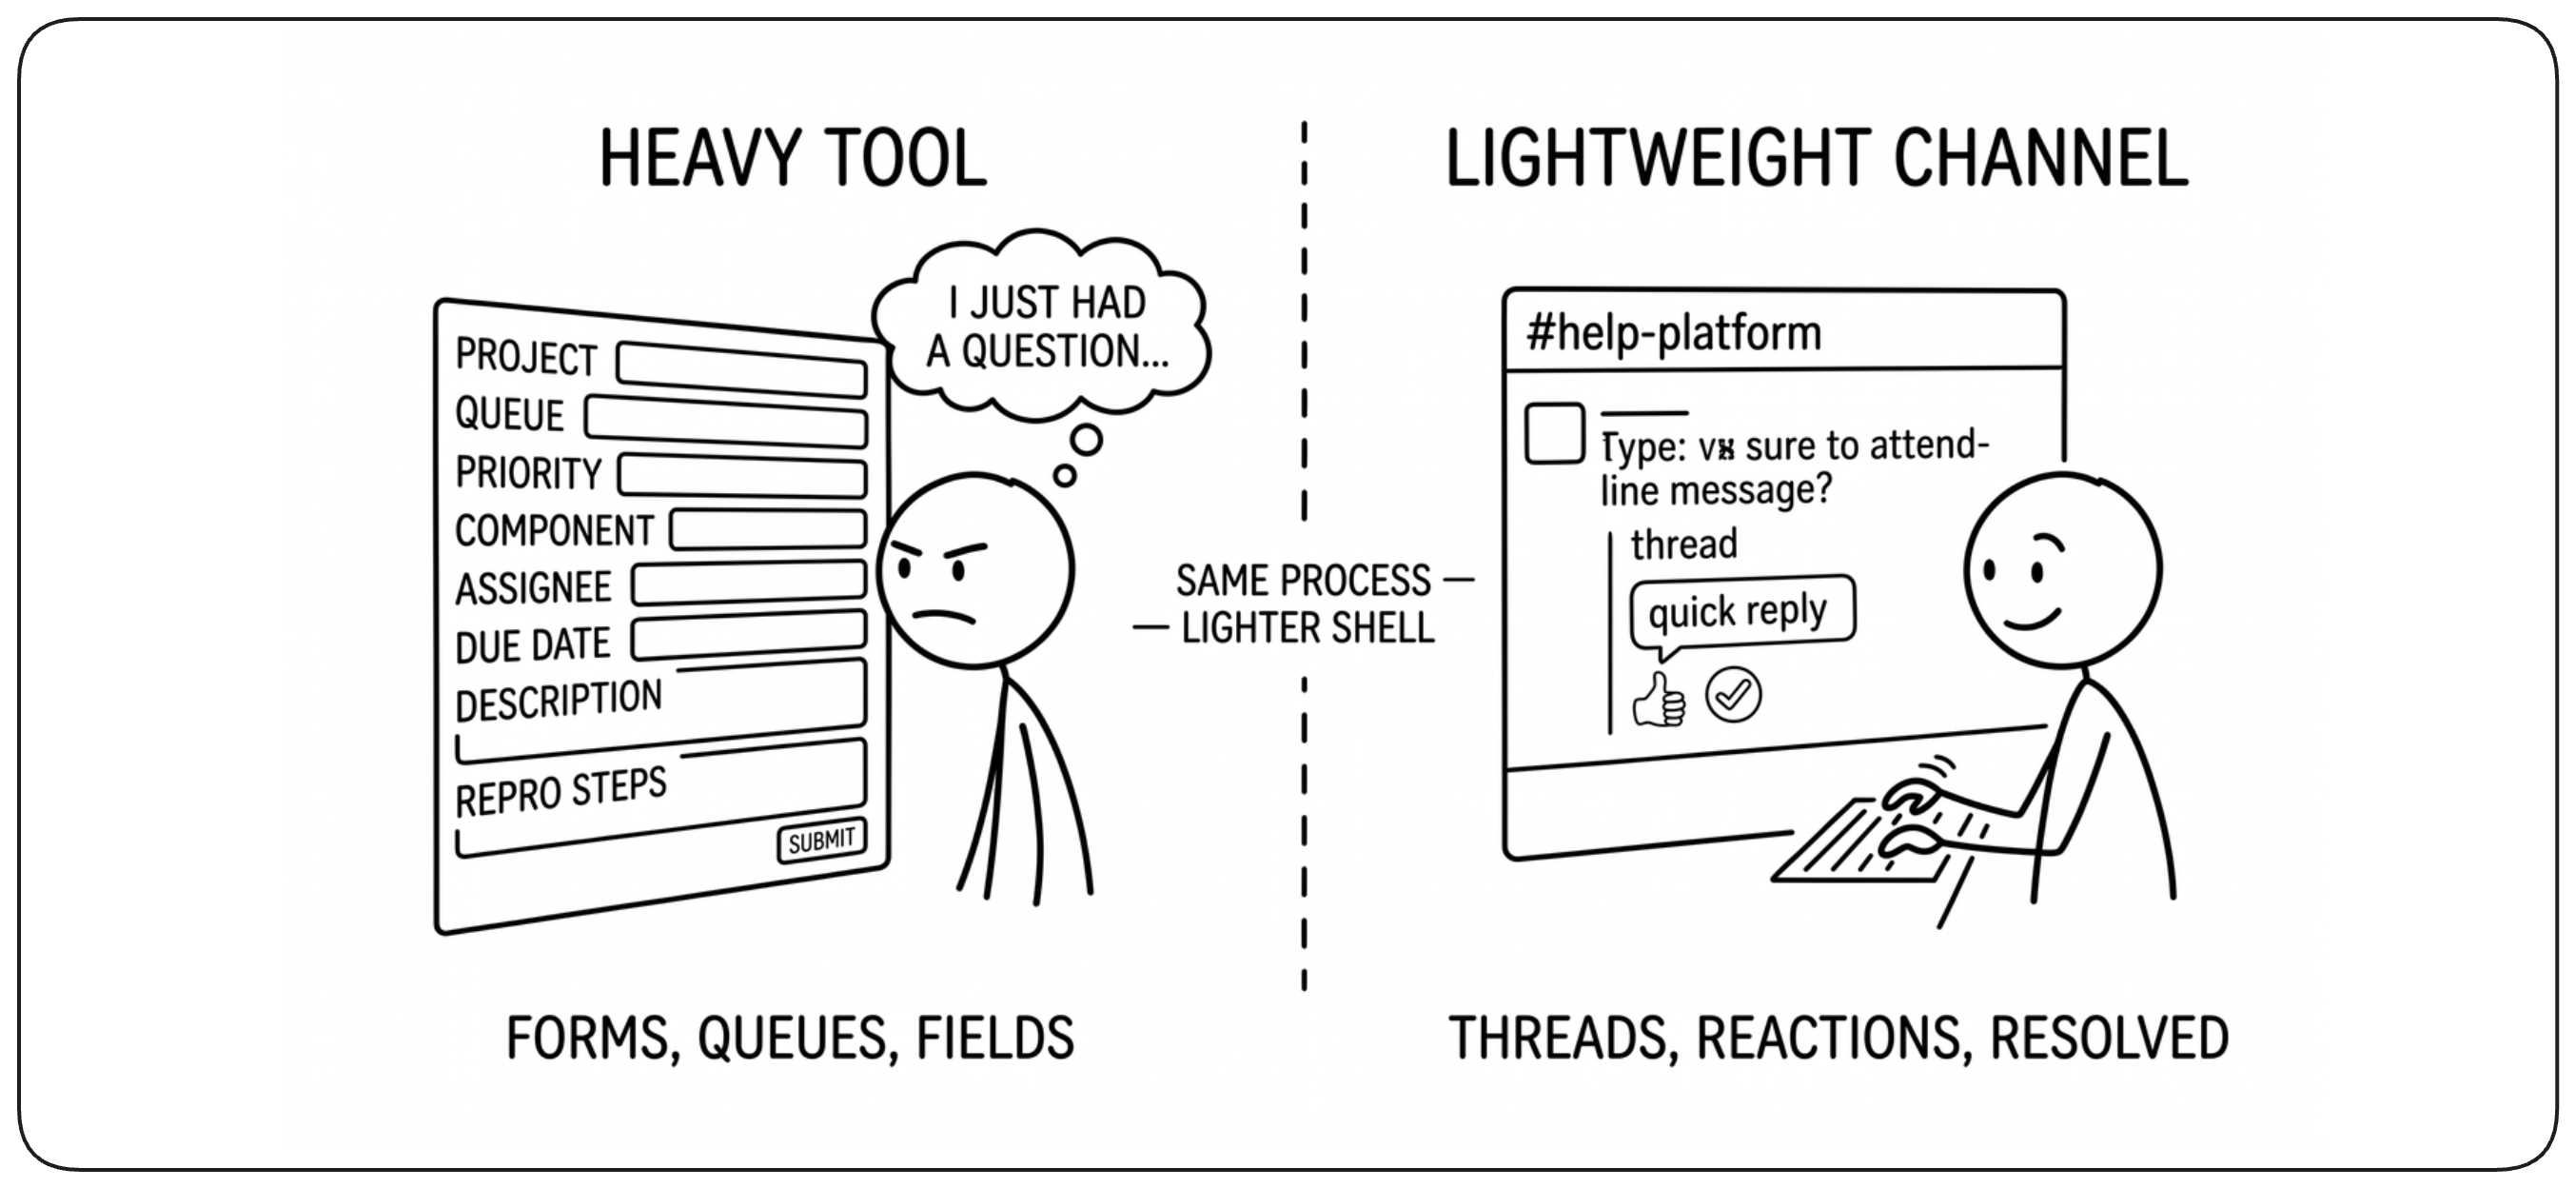
Préférer l’outil le plus léger qui préserve le processus
Un processus doit utiliser l’interface la plus légère qui préserve l’information, la visibilité, la durabilité et le contrôle dont il a besoin. Un thread Slack peut fournir un point d’entrée rapide pour une question ou une demande à la plateforme, tandis qu’une machinerie durable derrière lui enregistre la responsabilité, la politique, le statut et l’historique d’audit quand ces garanties comptent. L’objectif n’est pas la conversation à la place des systèmes ; c’est une interface légère adossée à la machinerie durable dont le processus a besoin.
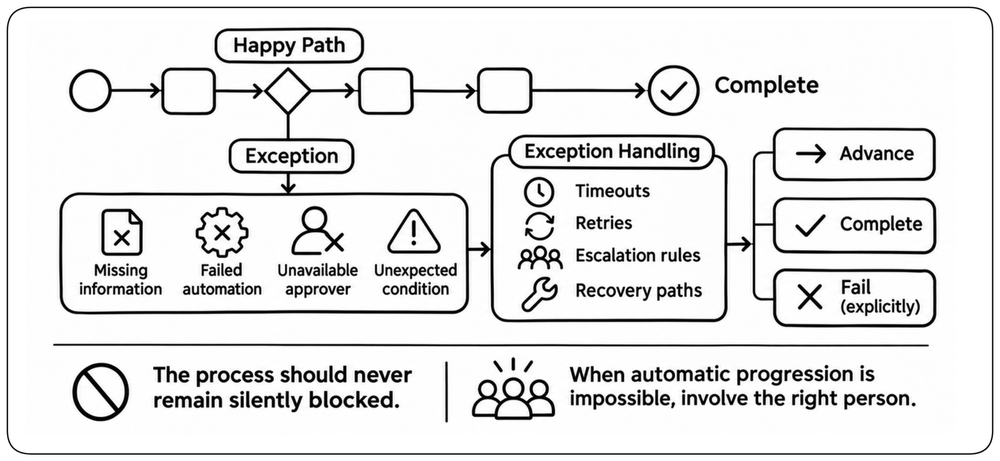
Concevoir le chemin d’exception
Les processus automatisés doivent traiter plus que le cas nominal. Informations manquantes, automatisations échouées, validateurs indisponibles ou situations inattendues ne doivent pas laisser le travail en attente indéfinie. Un processus bien conçu prévoit des délais, des reprises, des règles d’escalade et des modes de récupération. Si la progression automatique est impossible, le processus doit rendre le problème visible et impliquer la bonne personne. Tout workflow doit soit avancer, soit se terminer, soit échouer de façon explicite plutôt que de rester bloqué en silence.
Testez le processus, pas seulement le produit
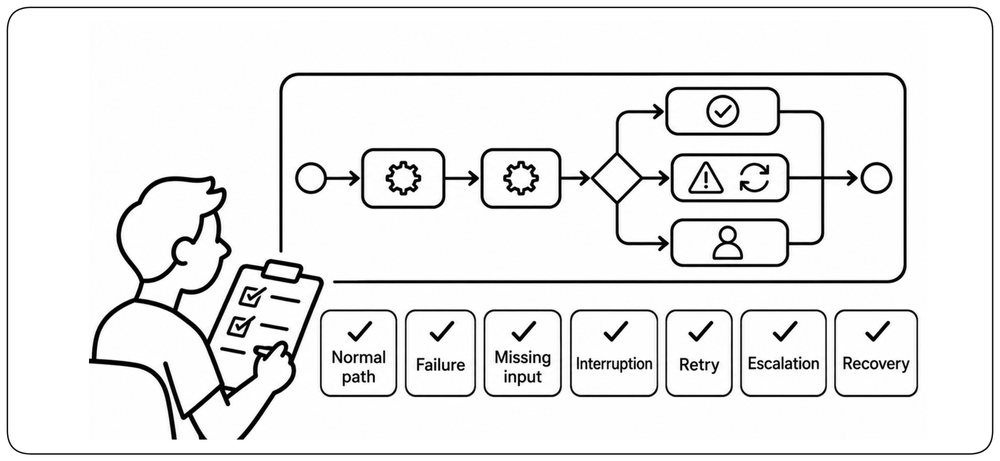
Les processus automatisés peuvent échouer, comme tout logiciel. Il faut tester non seulement la voie normale, mais aussi les étapes en échec, les entrées manquantes, les interruptions, les reprises, les escalades et la récupération. Un processus n’est fiable que s’il gère les situations qu’il rencontrera en pratique. Tester ces cas avant qu’ils ne comptent réellement évite qu’un workflow ne devienne une source cachée de risque opérationnel.
L’exécution du processus doit être observable
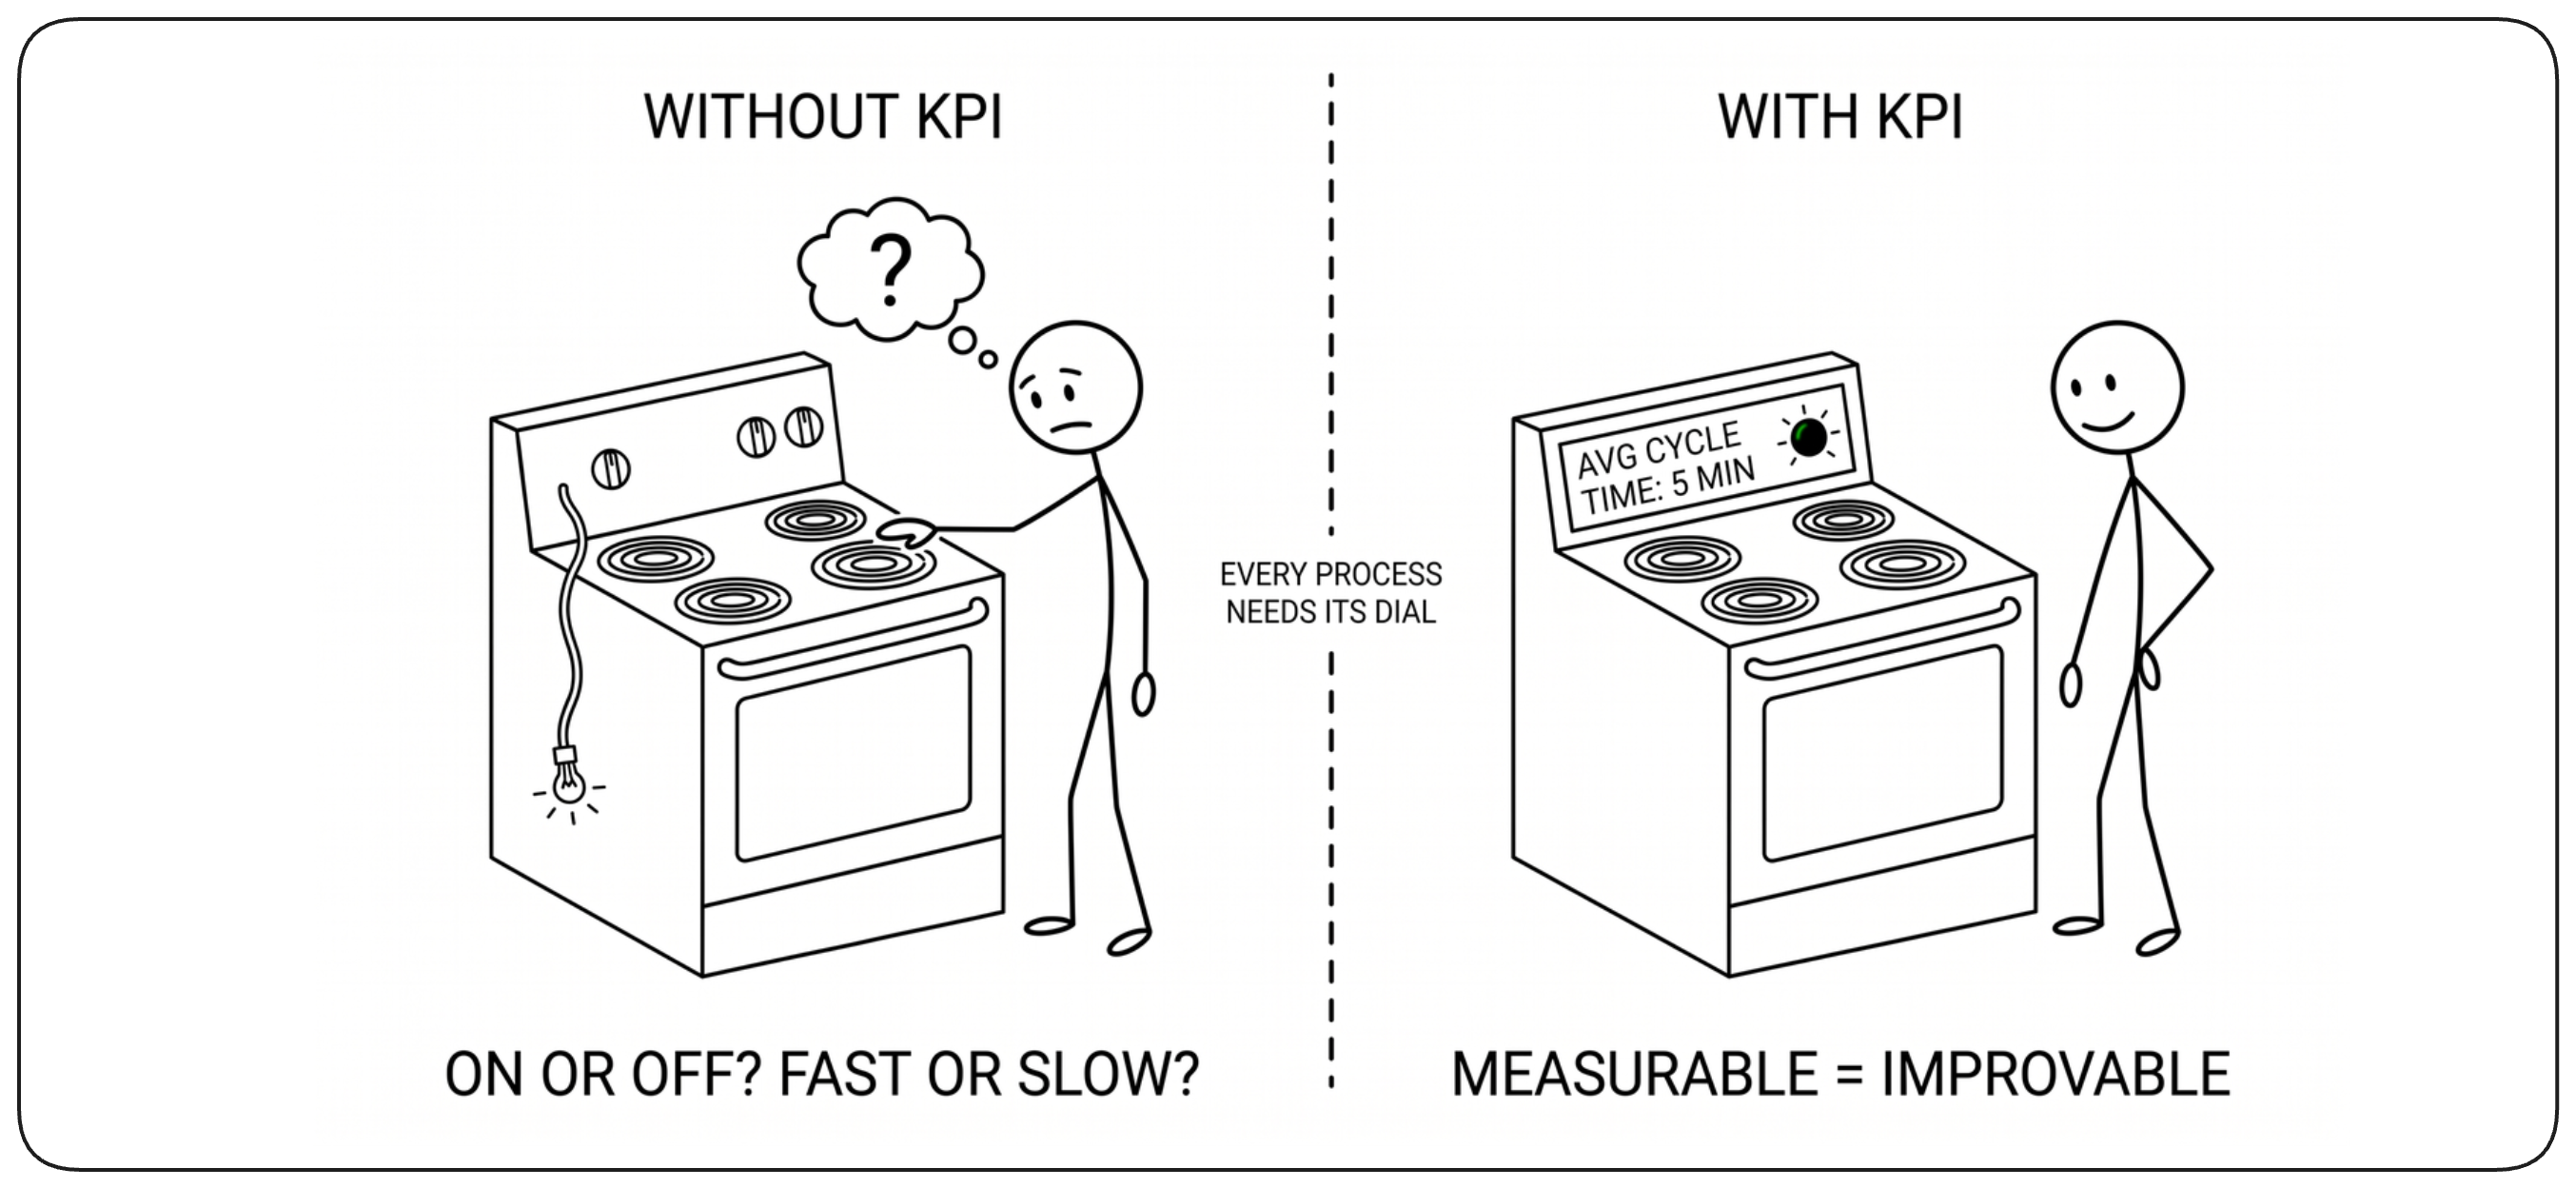
Un processus automatisé doit rendre son avancement visible. À tout moment, il doit être possible de savoir où en est une demande, pourquoi elle est dans cet état, et ce qui est nécessaire pour la faire avancer. Des indicateurs comme le temps d’exécution, les délais d’attente, le taux d’échec ou la fréquence des escalades permettent d’identifier les blocages et faiblesses. Si l’on doit interroger quelqu’un pour connaître l’état d’un processus, il manque un élément clé de visibilité. L’observabilité donne aux organisations les moyens d’améliorer leurs workflows sans dépendre du savoir individuel.
L’exécution du processus doit être traçable
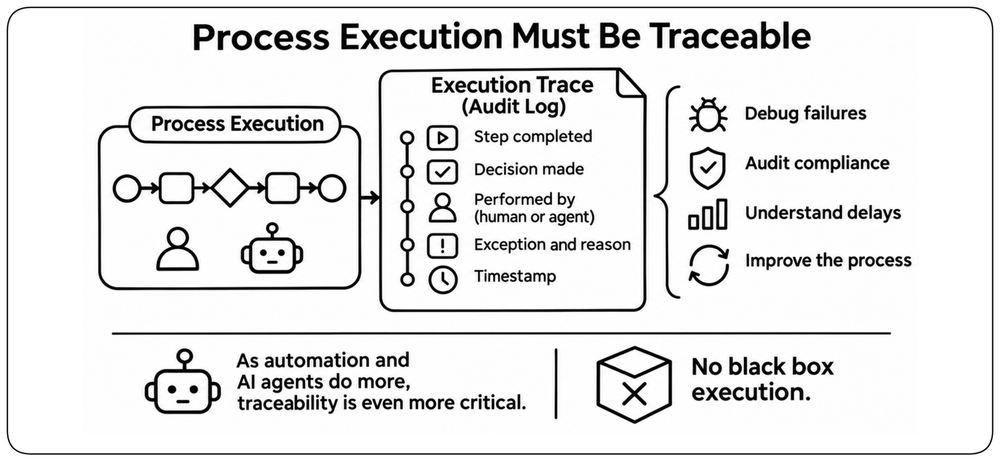
Un bon processus laisse une trace de son exécution. Il doit être possible de reconstituer la progression du travail, les étapes réalisées, les décisions prises, qui (ou quoi) a réalisé chaque action et la cause des éventuelles exceptions. Cet historique est essentiel pour déboguer les échecs, auditer la conformité, comprendre les retards et améliorer le processus. À mesure que l’automatisation et les agents IA assument plus de responsabilités, la traçabilité devient encore plus cruciale : l’exécution ne doit jamais devenir une boîte noire.
Surveiller la file d’attente, pas seulement le travail
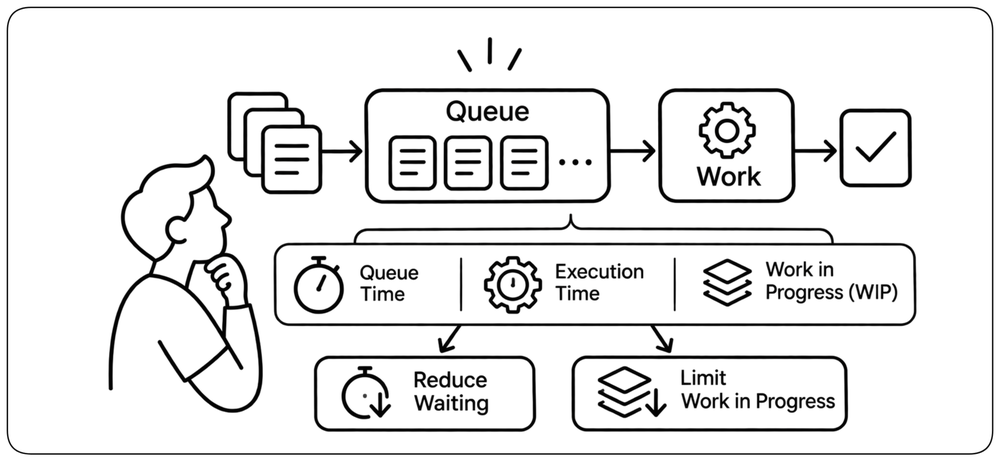
Le travail qui prend le plus de temps est souvent un travail qui attend. Une activité rapide peut quand même produire un résultat lent quand les demandes s’accumulent dans des files, attendent une passation ou rivalisent avec trop de travail déjà en cours. Mesurez le temps d’attente et le travail en cours (WIP) en plus du temps d’exécution, puis réduisez l’attente inutile et limitez la quantité de travail inachevé qui entre dans le système en même temps.
Les processus importants ont besoin d’un responsable
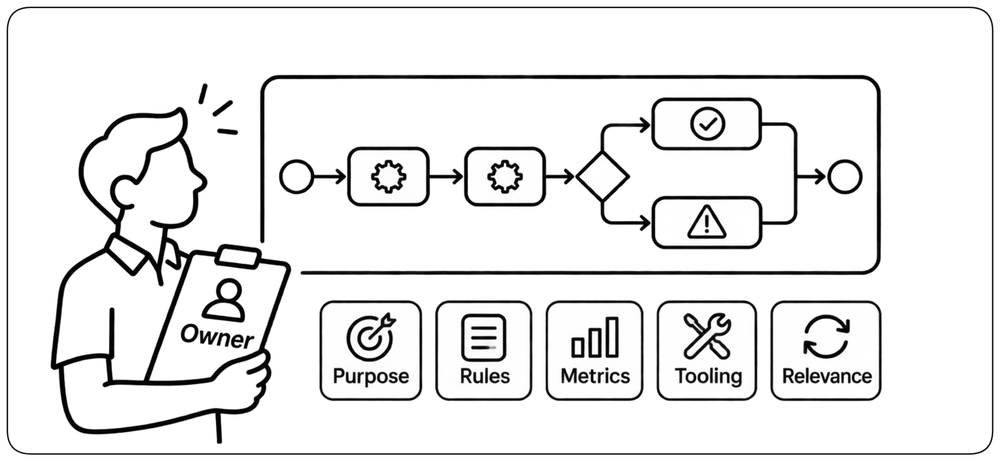
Un processus qui appartient à tout le monde n’appartient souvent à personne. Chaque processus important doit avoir un responsable clair, garant de son but, de ses règles, de ses métriques, de son outillage et de sa pertinence continue. Être responsable ne signifie pas exécuter manuellement chaque étape ; cela signifie vérifier que le processus résout toujours le problème pour lequel il a été créé, l’améliorer quand ce n’est pas le cas, et le supprimer quand sa justification disparaît. Les processus devraient avoir des mainteneurs, comme les systèmes de production.
Les processus critiques ont besoin d’un support opérationnel
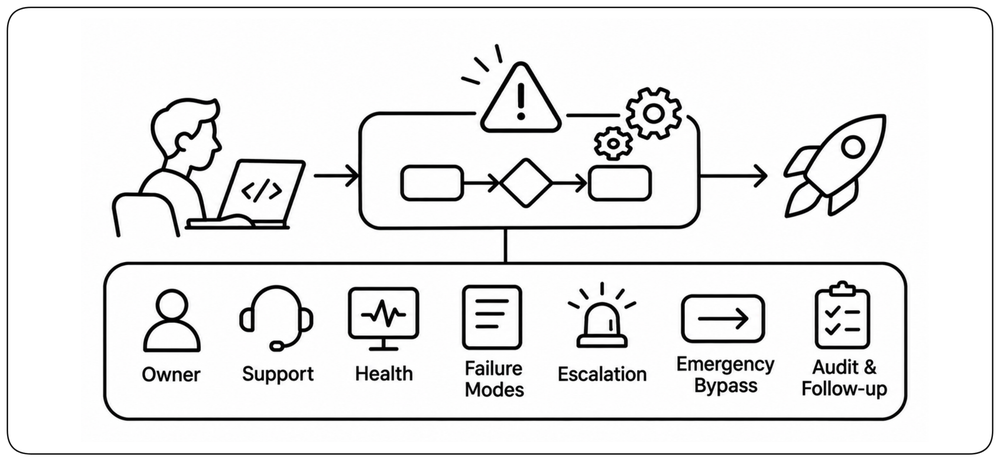
Certains processus sont eux-mêmes des dépendances critiques pour la production. Si les ingénieurs ne peuvent plus fusionner, déployer, obtenir un accès, valider une modification ou intervenir sur un incident à cause d’un workflow défaillant, ce processus devient une panne opérationnelle. Les processus critiques nécessitent une responsabilité claire, une filière de support, une surveillance de l’état, des modes d’échec documentés, une procédure d’escalade et une solution de contournement d’urgence, avec une autorité explicite, une traçabilité et un suivi après-coup. Cette solution de contournement doit rester exceptionnelle, mais elle doit exister avant la survenue d’un problème.
Les processus doivent évoluer
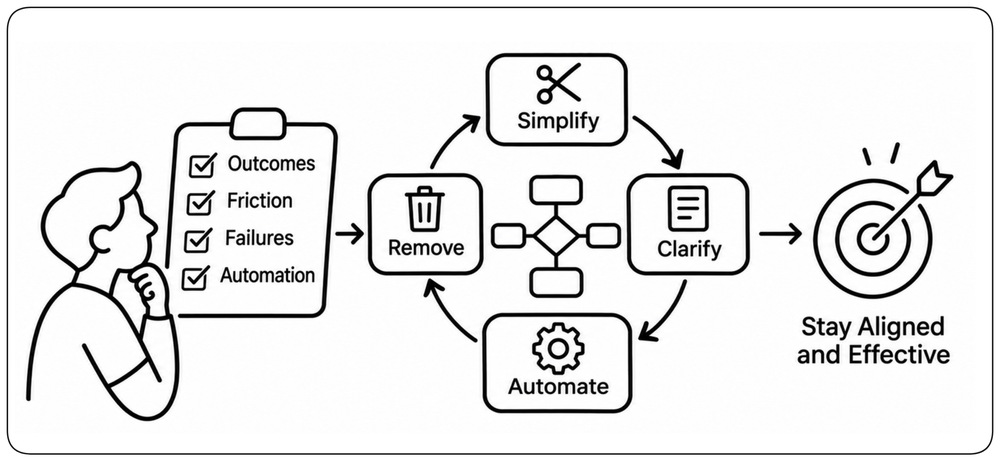
Un processus doit évoluer en même temps que l’organisation qu’il sert. Analysez régulièrement ses résultats, les points de friction, les cas d’échec et les opportunités offertes par la nouvelle automatisation. Utilisez ces signaux pour simplifier les étapes, clarifier la politique, améliorer les workflows et automatiser ce qui requiert encore des interventions récurrentes. L’amélioration continue permet d’aligner le processus sur les systèmes, équipes et besoins qui évoluent.
Processus à l’ère de l’IA
L’automatisation classique applique des règles prédéfinies. L’IA peut également interpréter le contexte et prendre des décisions encadrées. Dans les deux cas, le processus doit rester explicite, observable et contrôlable.
N’automatisez pas l’ancien processus
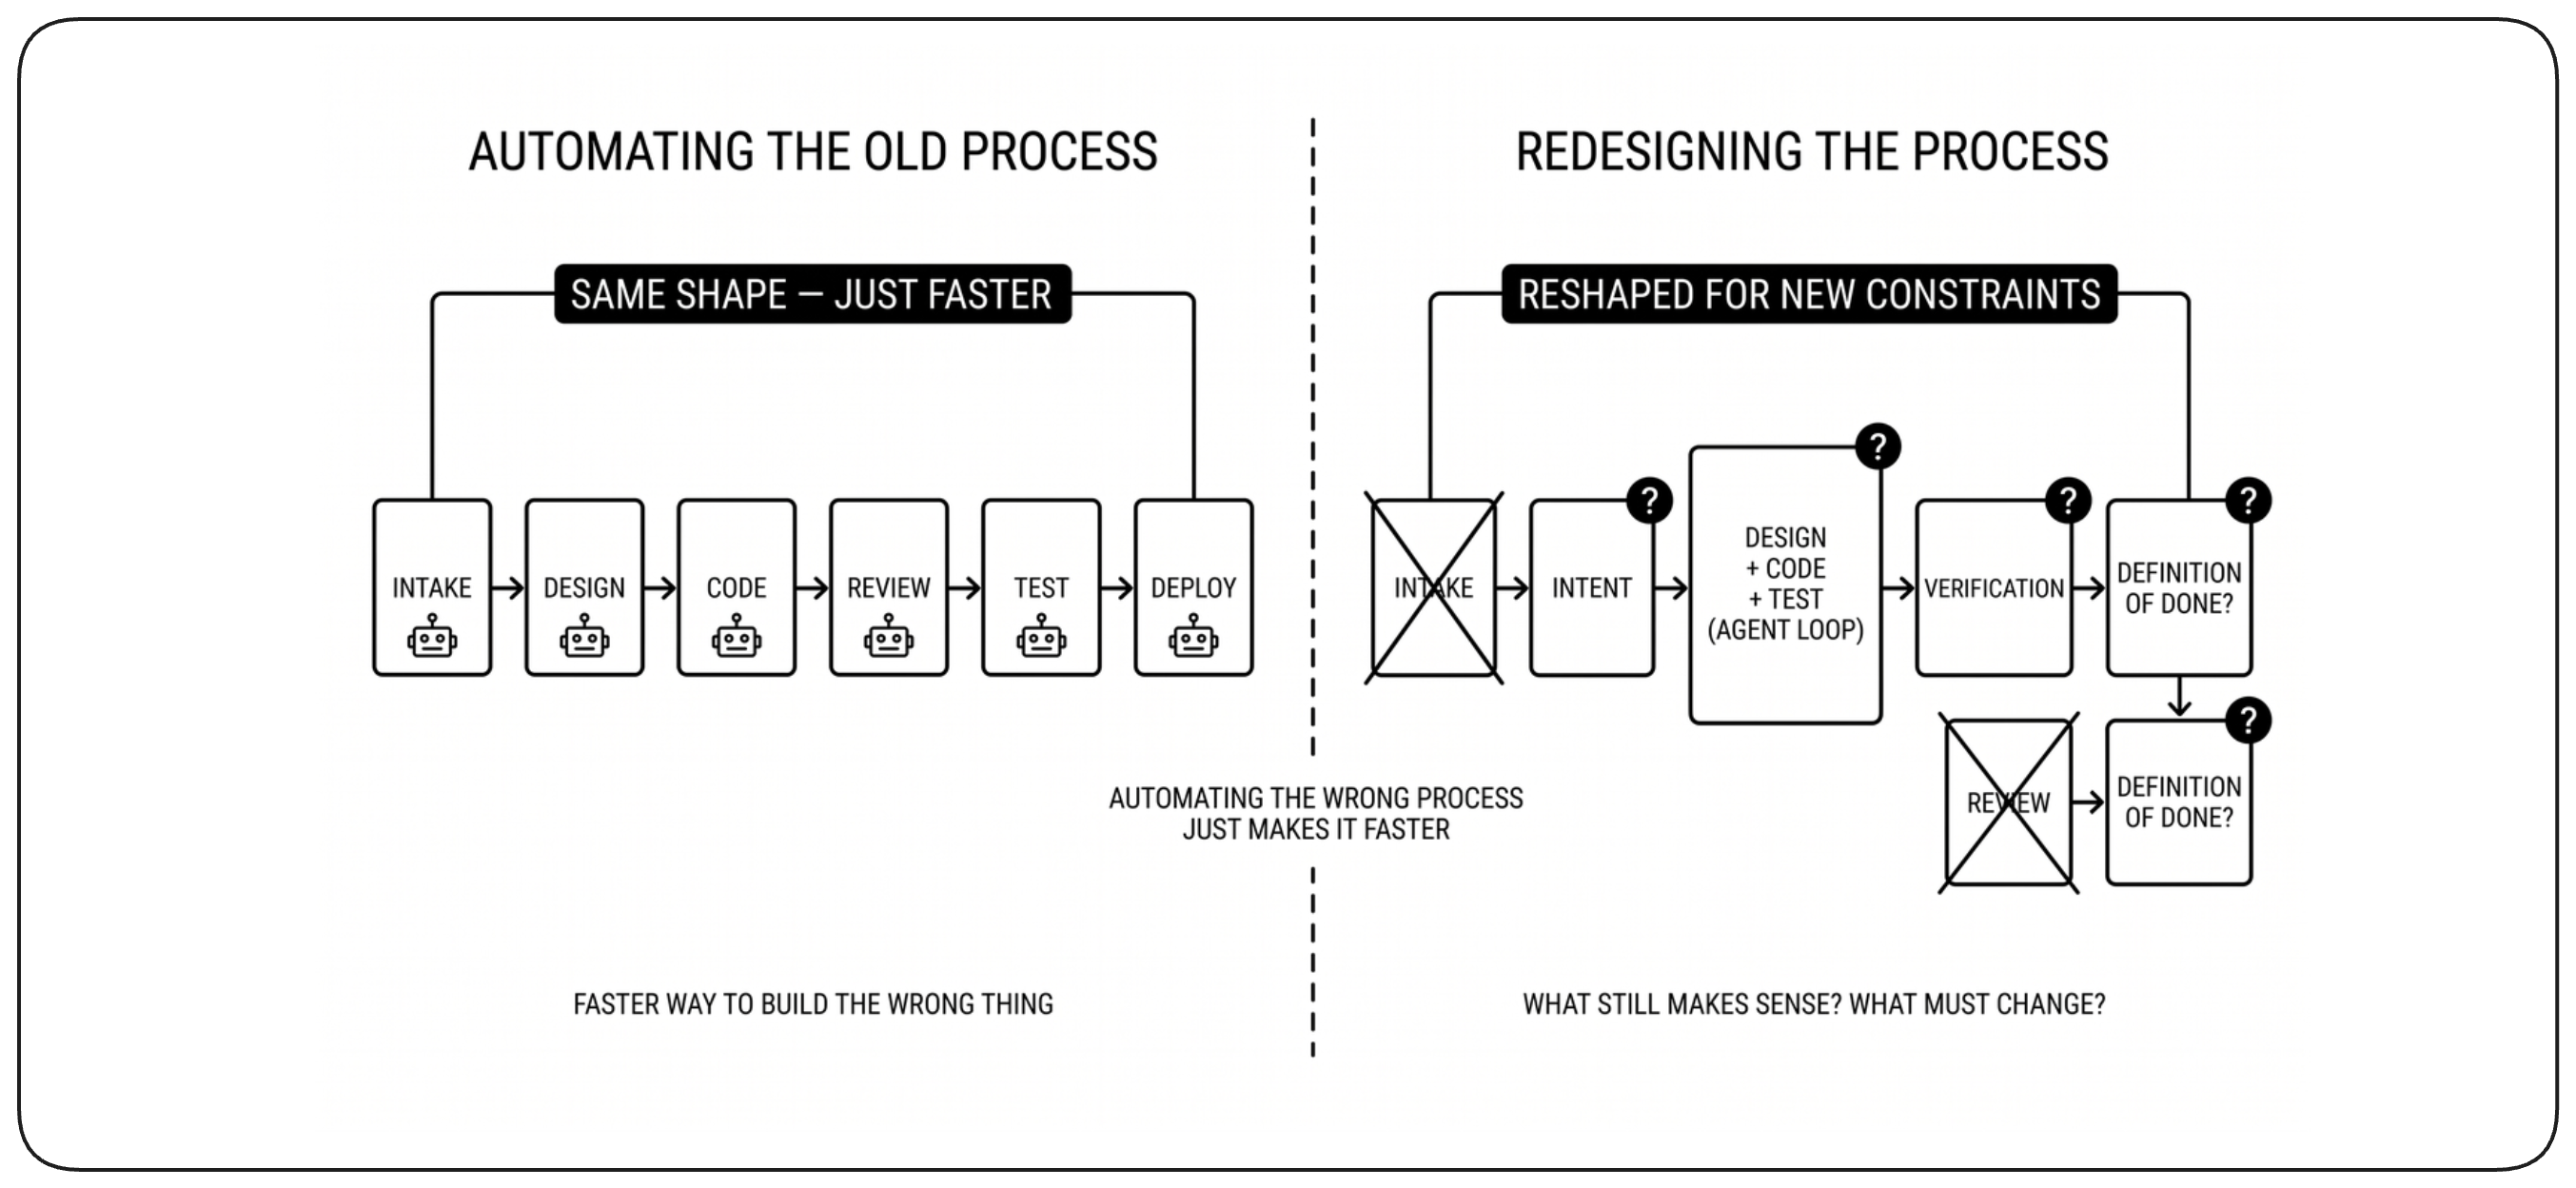
La maturité en IA demande plus que de confier chaque étape du workflow existant à un agent. L’ancien processus a été façonné par des contraintes comme la vitesse d’exécution humaine, le coût de communication et un contexte de travail limité. Quand ces contraintes changent, le workflow doit être reconsidéré. Les équipes doivent décider quelles parties protègent encore un résultat réel et lesquelles doivent être repensées — y compris l’intake, les tests, la revue, la responsabilité, l’infrastructure et la définition de « terminé ». Automatiser le mauvais processus ne fait que le faire échouer plus vite.
L’IA déplace le goulot d’étranglement de l’exécution vers la validation
À mesure que l’exécution devient moins coûteuse, la validation devient le goulot d’étranglement principal. Le résultat est-il correct, sûr, conforme à l’intention et cohérent avec le reste du système ? Les processus conçus à une époque où la capacité d’exécution était rare doivent être pensés pour un nouvel équilibre où ce sont l’attention et la confiance qui sont précieuses. La question n’est plus combien nous pouvons produire vite, mais à quelle vitesse nous pouvons établir la confiance dans ce qui a été livré. Dans des workflows riches en IA, la capacité de vérification devient une contrainte de conception majeure.
Concevoir les processus pour les humains et les agents
L’IA introduit un nouvel acteur dans les workflows d’ingénierie. Il faut définir ce que les agents peuvent initier, ce qu’ils peuvent décider, les preuves qu’ils doivent fournir, les cas nécessitant une validation humaine, ainsi que le maintien de l’attribution des responsabilités. À mesure que les agents assument davantage d’exécution et de prise de décision, les humains se concentrent sur l’intention, la politique, les contraintes, les critères d’acceptation, la supervision et la gestion des exceptions. Les agents doivent s’intégrer au processus via les mêmes contrats clairs que les personnes — entrées, permissions, sorties, limites et circuits d’escalade — plutôt que d’agir comme une couche invisible autour du workflow.
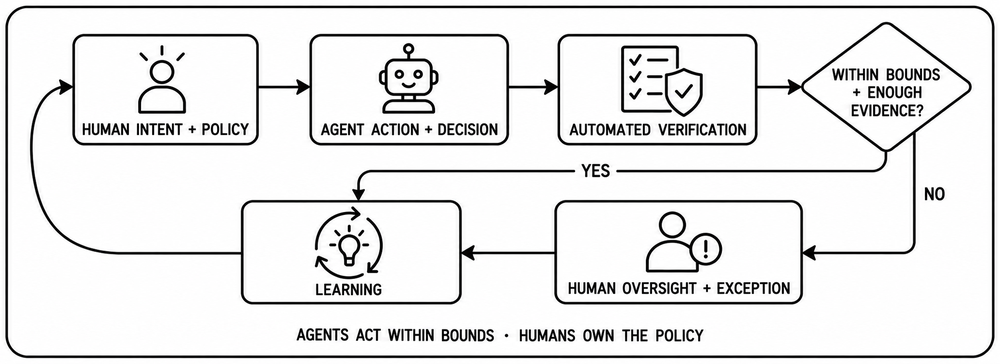
Faire confiance aux preuves, pas à l’agent
Le travail généré par l’IA ne doit pas être cru parce que l’agent semble sûr de lui ou parce qu’il réussit généralement. La confiance doit venir de preuves produites par le processus : tests, contrôles de politique, analyse statique, diffs, simulations, approbations, signaux runtime ou autres sorties vérifiables adaptées au changement. Les permissions des agents doivent être bornées, les actions importantes doivent rester traçables, et les opérations à plus haut risque doivent exiger des preuves plus solides. À mesure que l’exécution devient moins chère et plus rapide, la preuve devient le fondement de la confiance.
Une exécution plus rapide exige de meilleurs processus
L’IA bouleverse l’économie de l’ingénierie : les organisations peuvent produire des changements et déclencher des actions plus vite que jamais, mais leur capacité à absorber les erreurs n’a pas progressé au même rythme. Une coordination faible, une ownership floue ou des workflows mal pensés peuvent générer des échecs à une échelle et à une vitesse sans précédent. L’avantage compétitif ne se trouve plus uniquement dans la rapidité d’exécution, mais dans la capacité à transformer cette vitesse en résultats fiables. À mesure que la technologie accélère, la qualité des processus devient la limite déterminante pour une montée en charge sûre.