Concevoir pour le cloud : l’infrastructure moderne
Chapter Info
Calculating... Writing Progress: 80%
!!Le cloud computing a transformé la façon dont nous construisons, déployons et exploitons l’infrastructure. Ce qui exigeait autrefois des mois de planification, des investissements en capital et l’achat de matériel physique se fait désormais en quelques minutes grâce aux API et à l’automatisation.!! Ce passage des serveurs physiques à une infrastructure virtuelle, pilotée par logiciel, a remodelé non seulement la technologie elle-même, mais aussi la façon dont les organisations abordent la scalabilité, la fiabilité et l’innovation. !!Ce chapitre explore les principes de l’infrastructure cloud moderne — des modèles de service et des patterns cloud-native jusqu’à l’Infrastructure as Code, fondation de l’ensemble.!!
La (r)évolution du cloud
Qu’est-ce que le cloud computing
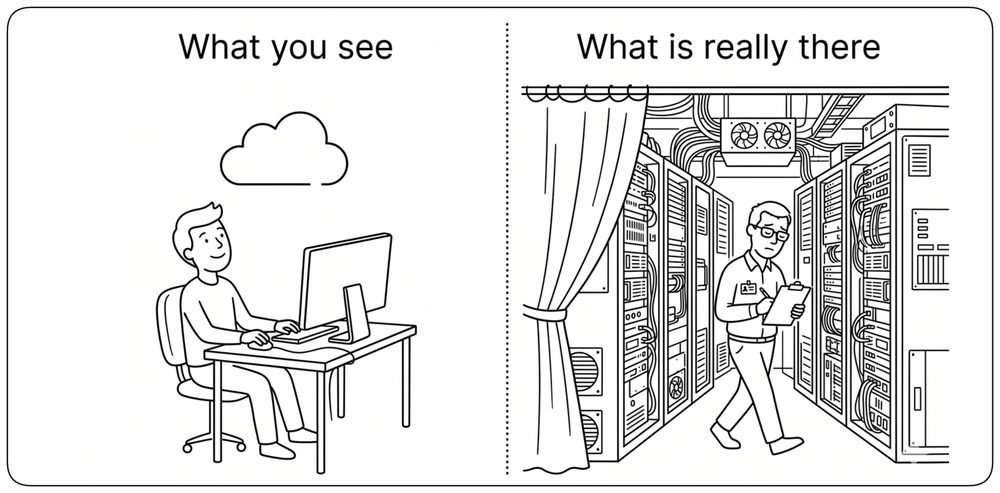
!!Le cloud est, au fond, étonnamment simple : c’est le data center de quelqu’un d’autre, exposé via une API.!! Des serveurs, du stockage, des bases de données et du réseau à la demande, fournis par internet et exploités par des fournisseurs tiers qui gèrent des installations à l’échelle planétaire. Plutôt que de posséder du matériel, les organisations louent ces ressources à l’usage, en y accédant via des API, des consoles web ou des interfaces en ligne de commande. La magie n’est pas dans le cloud lui-même — elle est dans l’illusion qu’il n’y a aucun data center.
D’une nécessité interne à une opportunité business
Jusqu’au milieu des années 2000, l’infrastructure était une nécessité, pas un produit. Les organisations exploitaient leurs propres serveurs physiques dans des data centers on-premise — coûteux, rigides, lents à faire évoluer — et personne n’imaginait pouvoir la vendre à d’autres. !!Le tournant est venu quand Amazon a compris que l’infrastructure construite pour ses propres opérations pouvait devenir un business : en louant sa capacité excédentaire, il a transformé un centre de coûts en moteur de profit.!! Cette seule décision a discrètement remodelé la façon dont la technologie serait construite, livrée et imaginée pendant les deux décennies suivantes.
Cloud vs on-premise : un changement d’état d’esprit
!!Le changement le plus profond apporté par le cloud n’est pas technique — c’est un changement d’état d’esprit : on passe de posséder et chouchouter des serveurs à traiter l’infrastructure comme des ressources éphémères et jetables.!! La pensée cloud privilégie l’élasticité plutôt que la planification de capacité pour le pire scénario, l’automatisation plutôt que le travail manuel, et l’Infrastructure as Code plutôt que le click-ops. Sur le plan culturel, cela signifie adopter l’expérimentation et privilégier la vitesse — pour ne pas simplement réimplémenter dans le cloud les patterns de l’on-prem.
L’économie du cloud : échelle et multi-tenancy
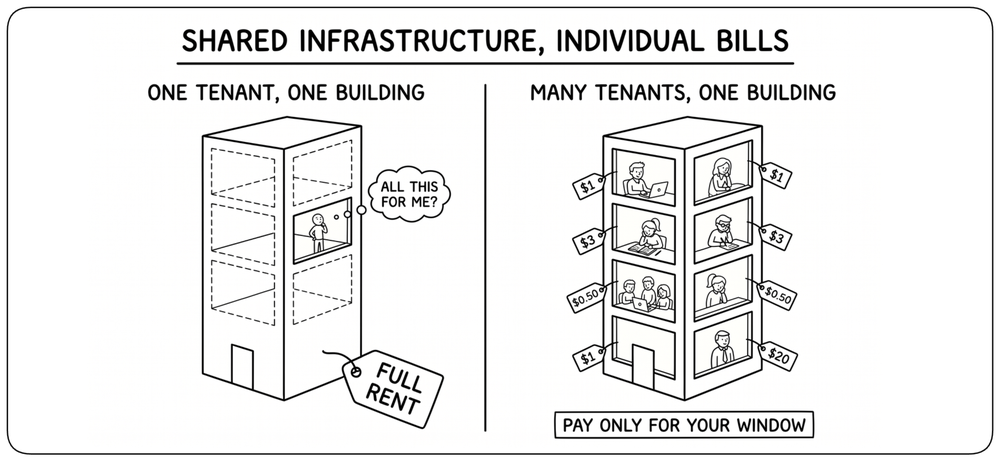
!!Les fournisseurs opèrent à l’échelle industrielle et atteignent une économie qu’aucune organisation seule ne pourrait égaler — en grande partie grâce à la multi-tenancy, où l’infrastructure physique est partagée entre de nombreux clients pour mutualiser les ressources, maximiser l’utilisation et amortir les coûts fixes.!! Le résultat : un provisionnement instantané, une véritable élasticité qui suit la demande, et une démocratisation — une startup peut accéder à la même infrastructure que Netflix, en ne payant que ce qu’elle utilise.
Libérer la créativité des limites physiques
Le cloud n’a pas été qu’une évolution technologique ; ce fut un tournant culturel. L’infrastructure a cessé d’être une contrainte pour devenir un catalyseur. !!Au lieu d’attendre des semaines pour un serveur, les développeurs pouvaient en lancer un en quelques secondes.!! Ce qui exigeait autrefois une présence physique et une configuration manuelle est devenu programmable et élastique. La révolution ne portait pas sur la virtualisation — elle portait sur la libération de la créativité des limites physiques.
La démocratisation du développement logiciel
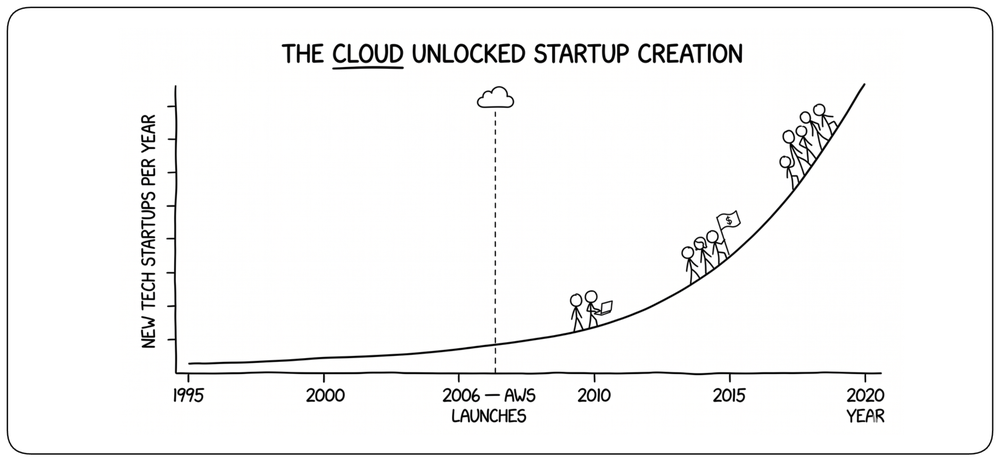
Une fois l’infrastructure libérée des limites physiques, elle l’a aussi été des gardiens du temple. !!Le même basculement qui a libéré la créativité a dissous les barrières traditionnelles à l’innovation : une infrastructure de niveau entreprise est devenue accessible à quiconque possède une carte bancaire.!! Trois développeurs peuvent désormais lancer un produit qui sert mille clients payants dès le premier jour — sur la même infrastructure que les géants mondiaux. Les organisations rivalisent sur les idées et l’exécution, pas sur le capital et l’achat de matériel — et les équipes peuvent enfin se concentrer sur la valeur business plutôt que sur l’infrastructure.
L’ère des startups : le petit dépasse le grand
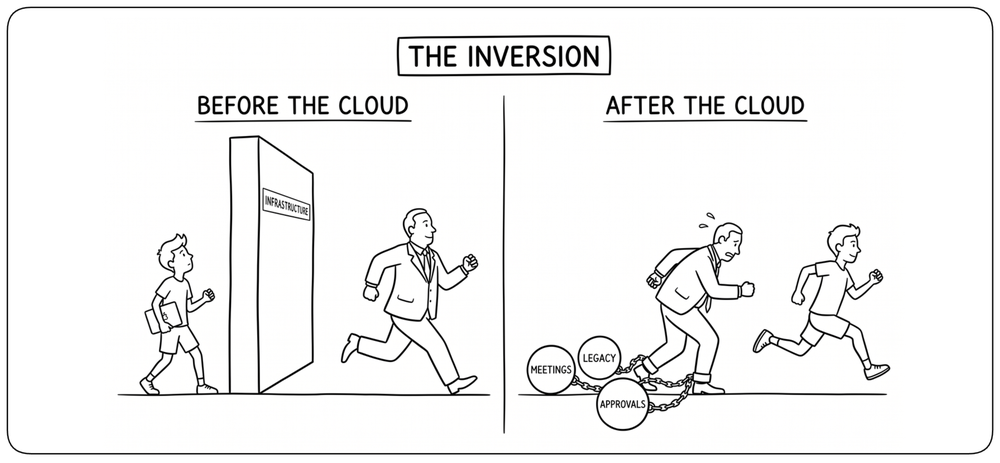
L’explosion des startups qui a suivi n’était pas qu’une question d’accès — elle reposait sur un avantage structurel et opérationnel que le petit détenait désormais sur le grand. Une fois la barrière de l’infrastructure tombée, il restait ce que chacun apportait dans la course : l’acteur établi portait des systèmes hérités, des validations en comité et du matériel amorti à protéger ; la startup n’avait rien de tout cela. !!Quand une nouvelle idée apparaît, la startup la livre le lundi pendant que l’acteur établi planifie encore la réunion pour en discuter.!! L’agilité, autrefois lot de consolation de la petite taille, est devenue l’avantage décisif de la nouvelle ère.
L’état d’esprit cloud-native
Le cloud-native est moins une stack qu’un ensemble de réglages par défaut inversés. Chaque principe ci-dessous retourne une posture longtemps incontestée à l’ère pré-cloud — patcher devient remplacer, les serveurs individuels deviennent des troupeaux, les opérations manuelles deviennent interdites, le pipeline devient la production. !!Le cloud récompense les systèmes bâtis sur des inversions ; il punit ceux qui ont apporté leurs vieilles habitudes.!! Voici neuf de ces inversions — concevoir, construire, exploiter, survivre.
Tout en code
Tout ce qui n’est pas exprimé en code dérive : les configurations divergent d’un environnement à l’autre, le savoir reste enfermé dans la tête de chacun, les changements ne laissent aucune piste d’audit. Le cloud-native traite chaque artefact — infrastructure, configuration, politique, documentation — comme du code source, versionné dans Git, relu en pull request, déployé par des pipelines. !!Si ce n’est pas dans le code, ça n’existe pas.!! Les équipes applicatives l’ont compris il y a des décennies pour le code produit ; la même rigueur s’applique désormais à tout ce qui fait tourner le produit.
Concevoir une infrastructure centrée sur le service
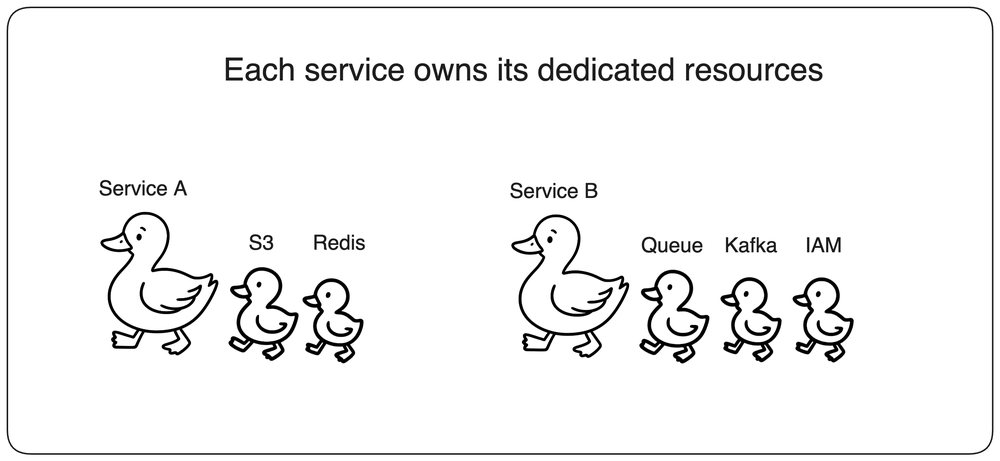
L’infrastructure pré-cloud était horizontale : une équipe base de données possédait toutes les bases, une équipe réseau tous les réseaux, une équipe stockage tout le stockage. Le cloud-native la retourne à la verticale : chaque service possède sa propre stack de bout en bout — sa base de données, ses files, son stockage, ses politiques IAM, son monitoring. !!Chaque service possède son infrastructure ; rien n’est partagé, rien n’est demandé à une autre équipe.!! Ce modèle de responsabilité est la fondation qui rend possibles Cattle Not Pets, l’automatisation et une responsabilité claire — sans lui, tous les autres principes cloud-native s’enlisent dans la coordination.
Infrastructure immuable
Une infrastructure mutable consiste à patcher les serveurs sur place — appliquer des mises à jour, ajuster des configurations, corriger la dérive. Chaque patch est un petit risque ; avec le temps, plus aucun serveur n’est tout à fait identique à un autre. L’infrastructure immuable remplace cela par une règle simple : !!si remplacer est plus rapide que réparer, remplacez.!! Chaque changement reconstruit à partir d’une image versionnée, validée de bout en bout, et remplace complètement l’ancienne instance. La dérive disparaît parce que rien n’est jamais modifié après le déploiement. Le rollback est trivial — redéployer la version précédente. L’immuabilité réelle est surtout atteignable au niveau applicatif ; les ressources persistantes comme les bases de données doivent encore être réparées, d’où l’importance de l’idempotence.
Éphémère par conception
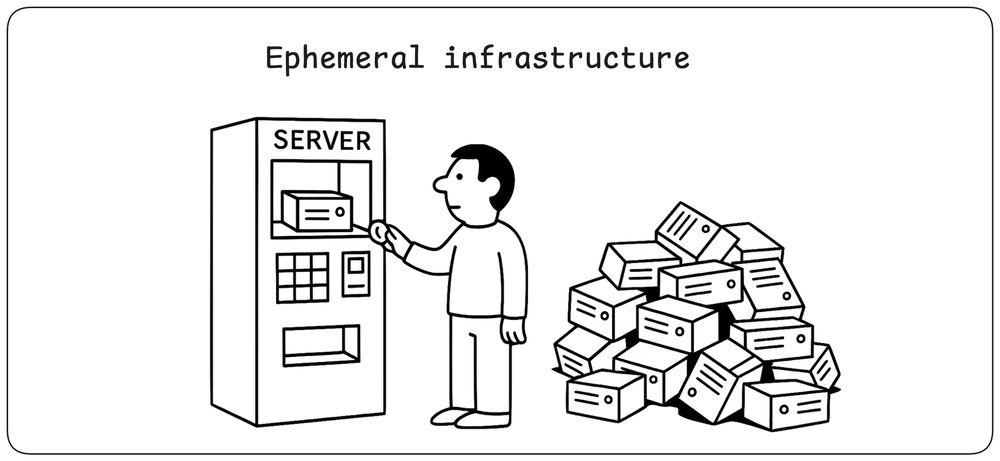
Si l’infrastructure n’est jamais modifiée mais remplacée en bloc, les instances individuelles deviennent éphémères par définition — créées à la demande, détruites quand elles ne servent plus. Les serveurs longue durée accumulent dérive, fuites mémoire et vulnérabilités silencieuses ; les instances éphémères n’en ont jamais l’occasion. !!Traitez chaque instance comme jetable, chaque environnement comme temporaire.!! Les conteneurs Kubernetes démarrent et s’arrêtent à la seconde ; les pipelines CI provisionnent un environnement de test neuf pour chaque pull request et le détruisent au merge. L’éphémérité est la conséquence opérationnelle d’une immuabilité prise au sérieux.
Du bétail, pas des animaux de compagnie
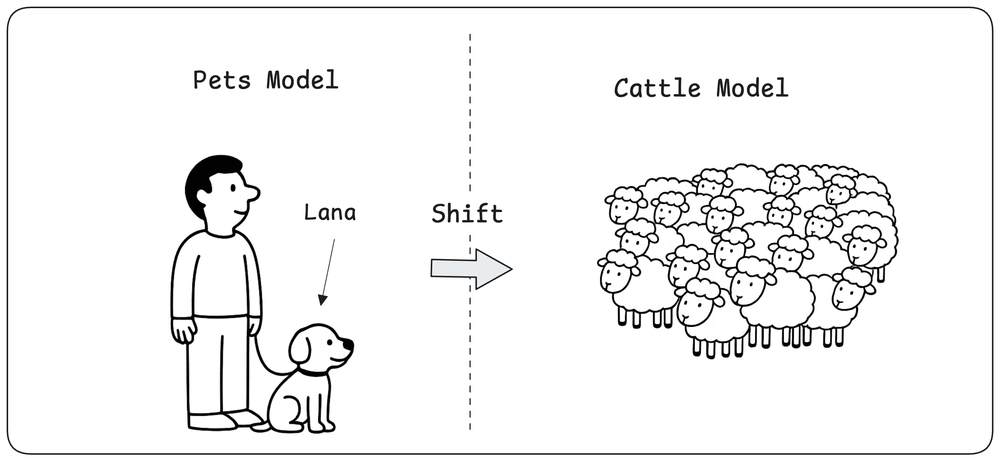
Avant le cloud, chaque serveur avait un nom, une personnalité et quelqu’un qui y tenait — quand il tombait malade, on le soignait. Le cloud-native traite les serveurs comme du bétail : numérotés, interchangeables, remplacés sans cérémonie quand ils tombent. !!Les serveurs doivent mourir sans que personne ne s’en aperçoive.!! Ce n’est pas de la cruauté envers les machines ; c’est le seul modèle qui passe à l’échelle. Un serveur « pet » est un point de défaillance unique avec une histoire. Un serveur « bétail » est un parmi beaucoup, automatiquement remplacé par un autre identique quand il disparaît.
Tout automatiser
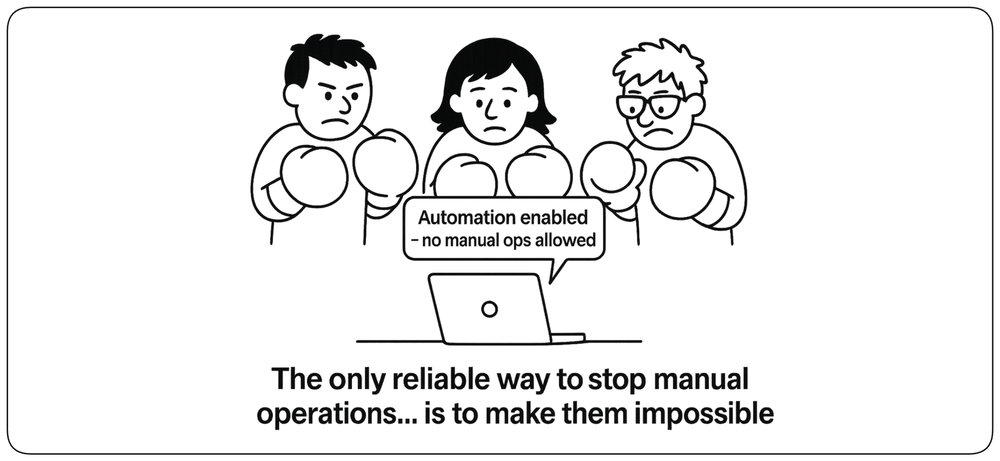
Une opération manuelle est un futur incident. Elle sera faite différemment la deuxième fois, oubliée la troisième, et exécutée à 3 h du matin par la mauvaise personne la quatrième. Le cloud-native ne se contente pas de décourager les opérations manuelles, il les rend impossibles : pas d’accès SSH à la production, pas de boutons de console qui contournent le pipeline, pas de scripts lancés depuis un laptop. !!La seule façon fiable d’arrêter les opérations manuelles est de les rendre impossibles.!! Chaque changement — provisionnement, rotation de clés, renouvellement de certificats, déploiement, rollback — passe par une automatisation versionnée.
L’observabilité plutôt que le monitoring
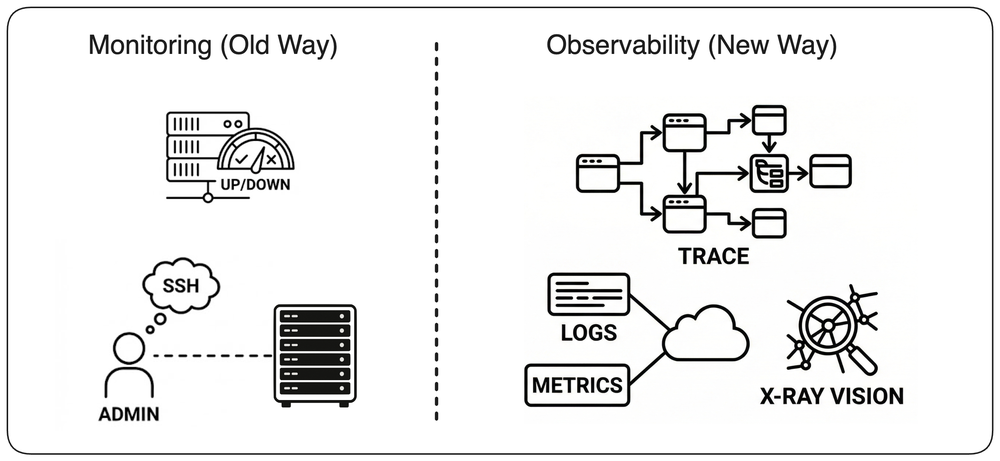
Quand l’infrastructure est éphémère, le serveur sur lequel vous vouliez vous connecter en SSH a déjà été remplacé. L’ancien modèle de debug — se connecter à la machine, suivre le fichier de log, redémarrer le daemon — a disparu. Le monitoring demande « est-ce UP ou DOWN ? » ; l’observabilité demande « pourquoi se comporte-t-il ainsi ? » !!Dans les systèmes éphémères, on ne peut pas déboguer ce qui n’existe plus — seulement ce qui a été instrumenté avant sa disparition.!! Des logs structurés, des traces distribuées et des métriques qui survivent aux instances individuelles deviennent le seul moyen de comprendre un système dont les composants sont en flux constant.
Deep Dive: Observability Principles
For comprehensive coverage of observability concepts, distributed tracing, logging patterns, alerting strategies, and incident response—see the Design for Visibility chapter.
Modèles de service et niveaux d’abstraction
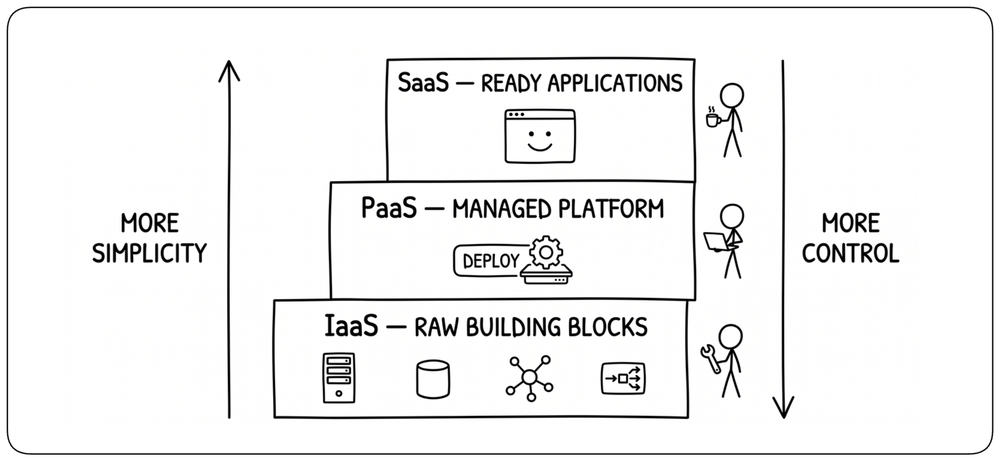
!!Les services cloud sont organisés en couches d’abstraction qui déterminent ce qui est fourni, combien de contrôle vous gardez et quelles responsabilités opérationnelles vous assumez.!! Nous montons la pile de bas en haut : l’IaaS fournit les briques d’infrastructure brutes, le PaaS offre une plateforme applicative managée, et le SaaS livre des applications complètes prêtes à l’emploi. !!Chaque couche échange du contrôle contre de la simplicité — plus on monte, plus le fournisseur opère, et moins on construit de zéro.!!
Chaque couche sert aussi un public différent : l’IaaS est conçu pour les platform engineers, les équipes ops et DevOps qui architecturent l’infrastructure sous-jacente ; le PaaS s’adresse aux développeurs et aux équipes applicatives qui se concentrent sur le code plutôt que sur les serveurs ; le SaaS vise les utilisateurs finaux qui consomment des applications toutes faites sans aucune responsabilité opérationnelle.
Infrastructure as a Service (IaaS)
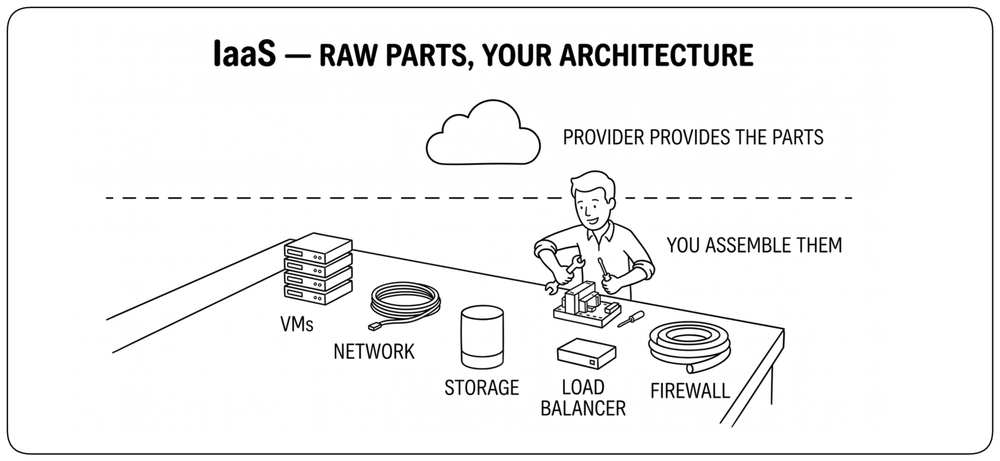
Tout en bas de la pile, l’Infrastructure as a Service (IaaS) fournit les briques fondamentales du cloud computing : machines virtuelles, stockage, réseau, load balancers et autres ressources bas niveau. !!Ces composants remplacent le matériel physique et permettent aux platform engineers de créer l’infrastructure de façon programmatique via des API.!! Le fournisseur cloud exploite les data centers physiques, les serveurs et le matériel réseau, tandis que le client contrôle les systèmes d’exploitation, les configurations, les déploiements et le runtime. L’IaaS offre flexibilité et contrôle total, ce qui en fait la fondation de la plupart des architectures cloud modernes.
Platform as a Service (PaaS)
Un cran plus haut dans l’échelle d’abstraction, le Platform as a Service (PaaS) fournit une plateforme applicative entièrement managée où les développeurs déploient du code sans gérer l’infrastructure sous-jacente. !!Le fournisseur gère les serveurs, les systèmes d’exploitation, les patchs, le scaling, le réseau et les environnements d’exécution — les développeurs se concentrent uniquement sur la logique applicative.!! Le PaaS élimine la charge opérationnelle avec des pipelines de déploiement intégrés, l’autoscaling, le logging, le monitoring et un durcissement de sécurité par défaut. Cette abstraction accélère la livraison tout en imposant la cohérence entre les environnements.
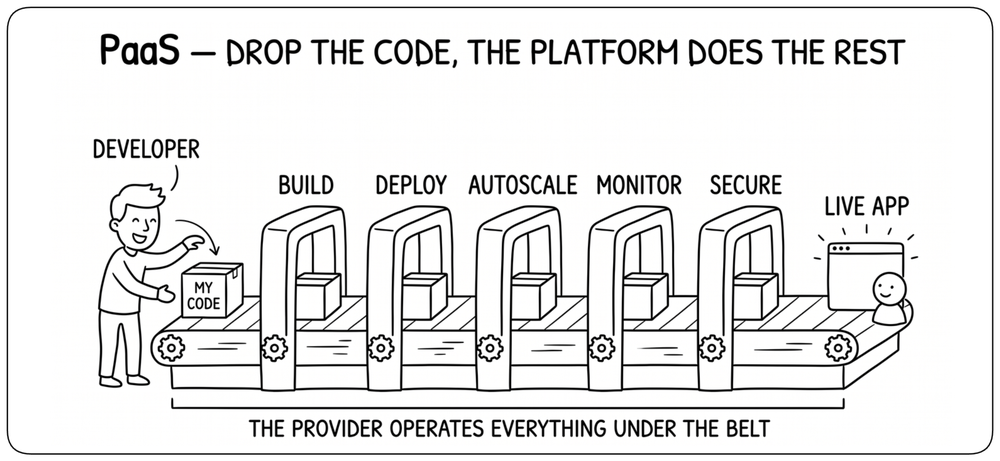
!!Le PaaS est idéal quand les équipes valorisent la vitesse, la standardisation et une complexité opérationnelle réduite.!! Il déplace la responsabilité de la gestion de l’infrastructure vers la livraison de valeur business.
Limites du Platform as a Service (PaaS)
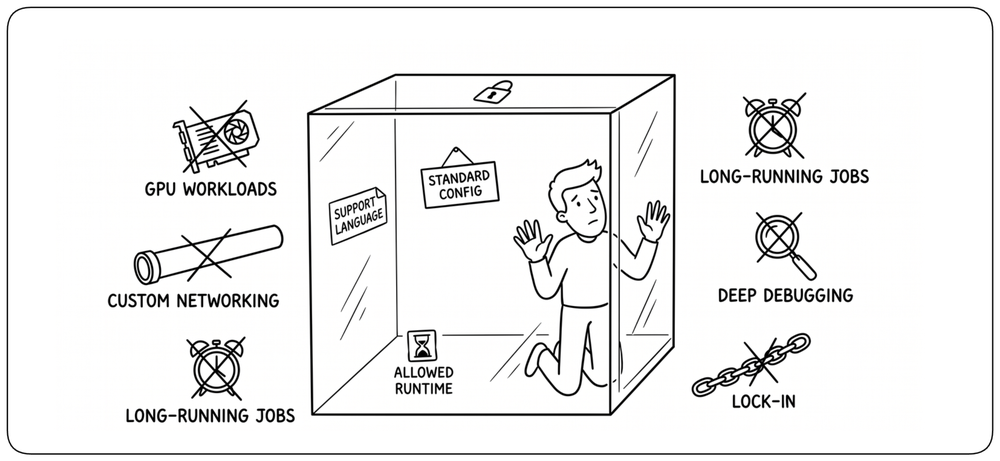
!!Si le PaaS accélère le développement et supprime la charge opérationnelle, il introduit plusieurs compromis importants.!! La personnalisation est restreinte — le fournisseur contrôle le runtime, le modèle de déploiement et la configuration réseau, ce qui peut ne pas convenir à des workloads spécialisés. Le lock-in de plateforme est significatif : les applications couplées au système de build ou aux intégrations de service de la plateforme sont plus difficiles à migrer ensuite. Le debug et le tuning de performance poussé sont limités, car les équipes n’ont pas accès à l’infrastructure sous-jacente. Le PaaS impose aussi des contraintes sur le traitement en arrière-plan, les tâches longues et le réseau personnalisé. Enfin, le coût peut mal évoluer pour les workloads à fort volume, comparé à l’IaaS ou aux approches basées sur les conteneurs.
Quand le PaaS ne convient pas : construire sa propre plateforme interne
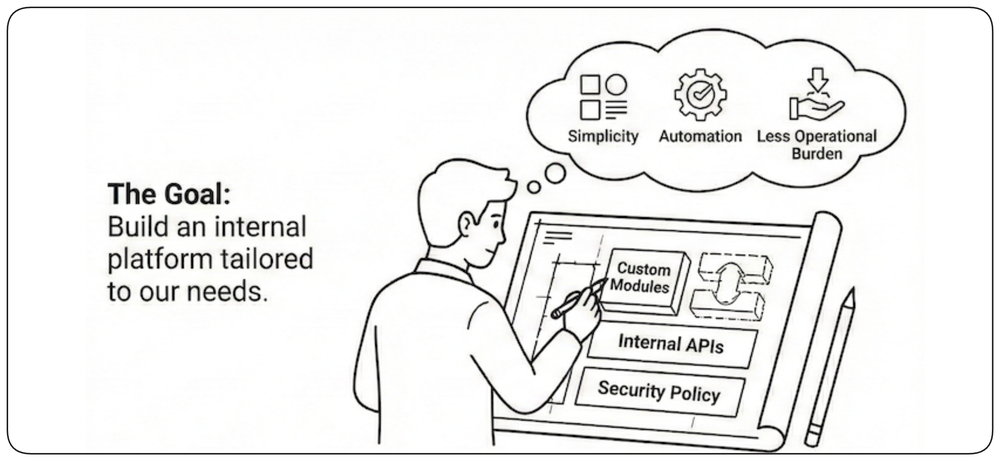
Un PaaS du commerce est souvent insuffisant pour les équipes qui ont besoin de plus de personnalisation, d’une intégration plus étroite ou d’une sécurité plus stricte. !!Pour conserver les bénéfices du PaaS — simplicité, automatisation, moindre charge opérationnelle — de nombreuses entreprises construisent une plateforme interne : un PaaS sur mesure adapté à leurs besoins.!! L’objectif est de donner aux développeurs un moyen simple et cohérent de déployer et d’exploiter des services, en automatisant le provisionnement et la sécurité, sans recréer un PaaS public. Cette idée est approfondie dans le chapitre Concevoir pour les développeurs.
Software as a Service (SaaS)
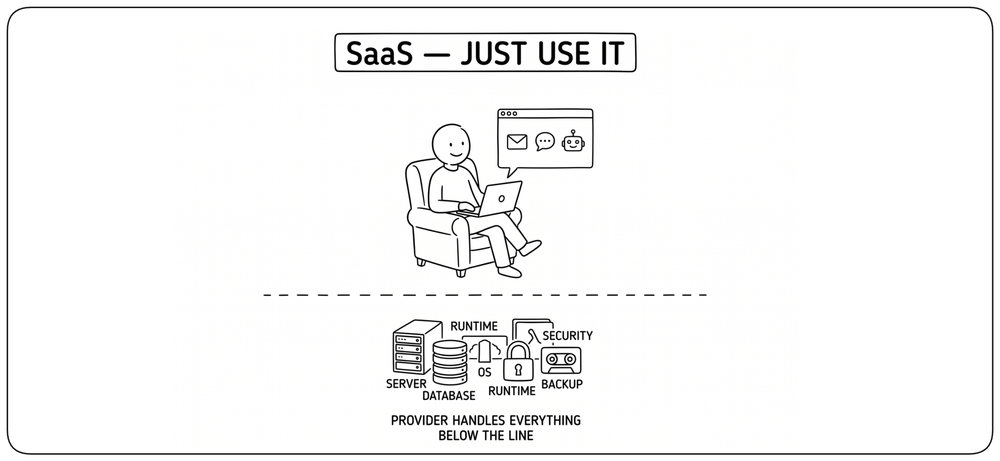
Tout en haut de la pile, le Software as a Service (SaaS) livre des applications complètes directement aux utilisateurs finaux, sans aucune gestion d’infrastructure ni de plateforme. !!Le fournisseur opère tout — l’application, le runtime, le stockage des données, le scaling, les mises à jour et la sécurité — et les clients consomment le service via une API ou une interface web sans aucune responsabilité opérationnelle.!! Parmi les exemples courants : Gmail, ChatGPT et Salesforce — des services entièrement consommés sans gérer la moindre infrastructure sous-jacente.
Services managés vs non managés
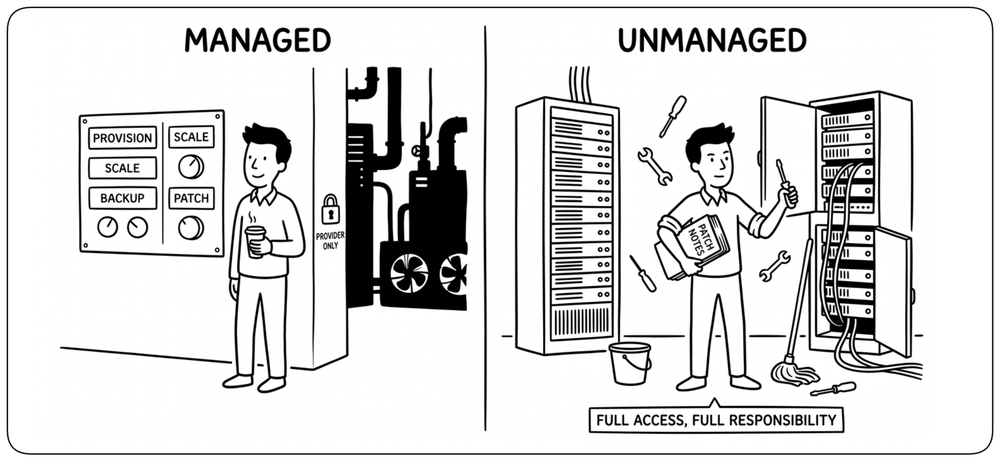
Au-delà de la hiérarchie IaaS/PaaS/SaaS, les services cloud diffèrent aussi par leur modèle opérationnel : managé ou non managé. !!Les services managés prennent en charge toutes les opérations — provisionnement, patching, scaling, monitoring, sauvegardes — et vous les configurez via des API sans toucher aux systèmes sous-jacents (RDS, Cloud SQL, Kubernetes managé).!! Les services non managés donnent un contrôle total mais exigent que vous opériez tout vous-même — VM, installation logicielle, patchs, scaling, troubleshooting. Cette distinction est orthogonale aux modèles de service : la plupart des architectures mélangent les deux — managé là où la complexité opérationnelle n’apporte pas de valeur, non managé là où le contrôle compte.
Modèles de calcul : comment votre code s’exécute
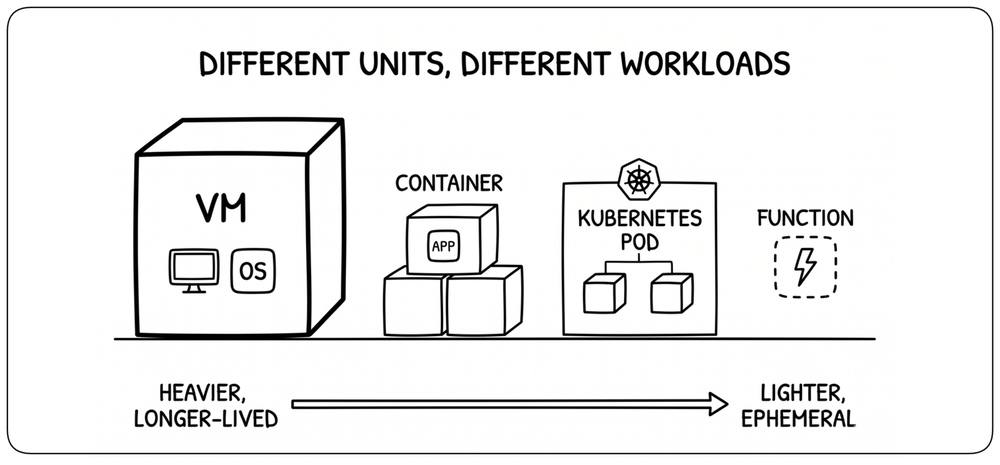
Les modèles de service décident qui opère quoi ; les modèles de calcul décident ce qui exécute réellement votre code. La même application peut tourner sur une machine virtuelle, dans un conteneur, orchestrée par Kubernetes, ou comme une fonction stateless — et chaque unité apporte ses propres compromis en temps de démarrage, densité, isolation et coût opérationnel. !!Choisir un modèle de calcul n’est pas une religion — c’est adapter la forme du workload à la forme du runtime.!!
Machines virtuelles : l’unité par défaut
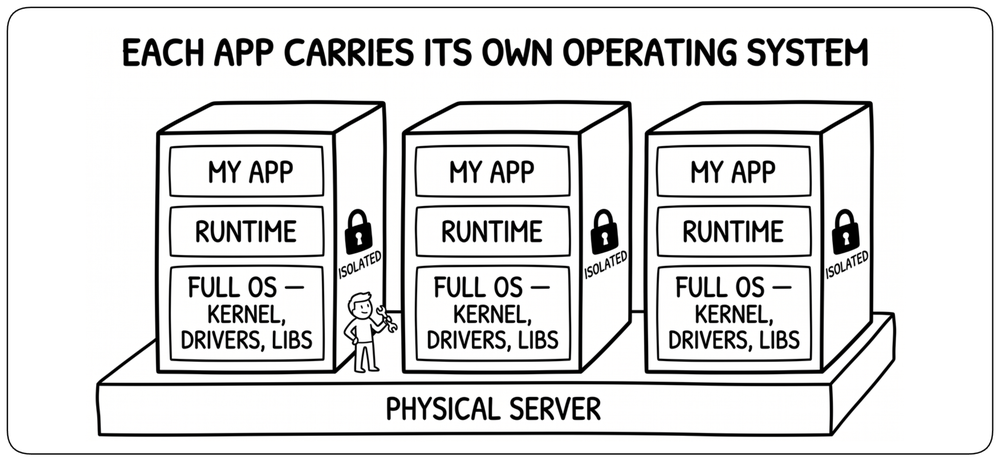
La machine virtuelle est le modèle de calcul cloud d’origine : un système d’exploitation complet tournant sur du matériel partagé, isolé de ses voisins. !!Les VM offrent une compatibilité maximale — tout ce qui tourne sur un serveur physique tourne sur une VM — et un contrôle total sur l’OS, le noyau, les drivers et le runtime.!! Le compromis est le poids : chaque VM embarque son propre système d’exploitation, met des minutes à démarrer et consomme des ressources qu’elle travaille ou non. Les VM conviennent aux workloads qui exigent un contrôle au niveau de l’OS, aux applications legacy, aux drivers spécialisés ou au calcul soutenu de longue durée.
Conteneurs : plus légers, plus denses, plus rapides
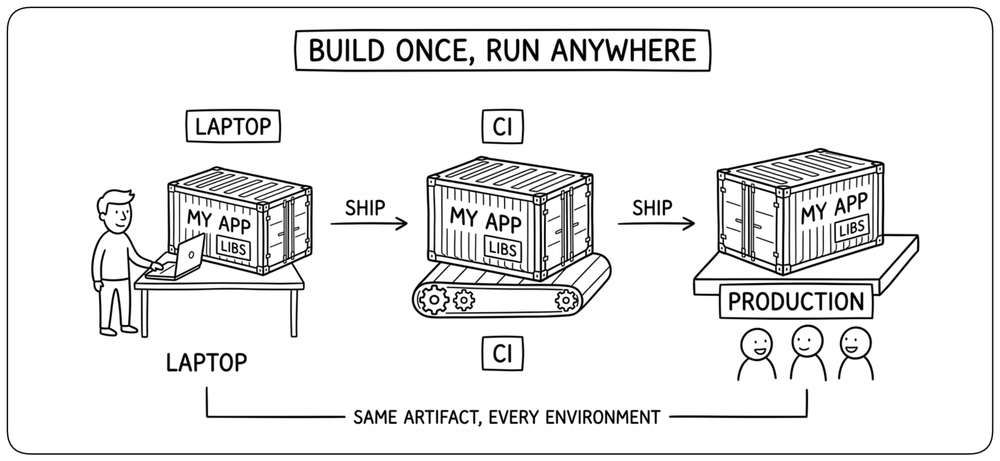
Les conteneurs empaquettent une application avec uniquement les bibliothèques dont elle a besoin — pas un système d’exploitation complet — et partagent le noyau de l’hôte. Le résultat est spectaculaire : les conteneurs démarrent en secondes plutôt qu’en minutes, on en entasse des dizaines sur une machine qui n’accueillerait qu’une poignée de VM, et ils produisent des artefacts identiques qui s’exécutent de la même façon sur un laptop, en CI et en production. !!Les conteneurs ont fait du déploiement un artefact de build plutôt qu’un environnement à configurer.!! Ils sont devenus l’unité de calcul par défaut des nouvelles applications — assez petits pour scaler par requête, assez portables pour passer d’un hôte ou d’un cloud à l’autre.
Kubernetes : orchestrer les conteneurs à grande échelle
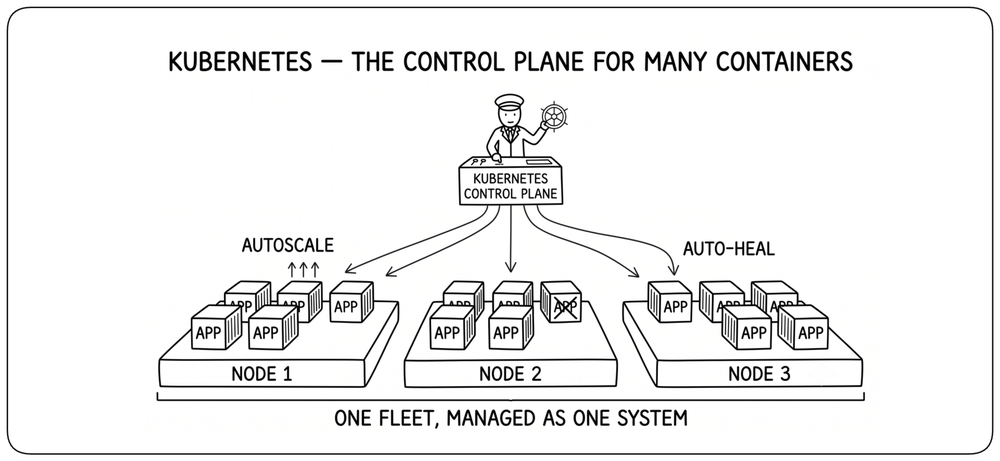
Un seul conteneur est facile ; mille conteneurs répartis sur des dizaines de machines, c’est un autre problème. Kubernetes est la réponse standard : un control plane qui décide où chaque conteneur s’exécute, le redémarre quand il meurt, le scale sous charge, répartit le trafic entre les réplicas et déploie de nouvelles versions sans interruption. Il s’est imposé comme le standard de facto du déploiement cloud-native — portable sur tous les grands clouds et assez extensible pour gérer presque n’importe quel composant de plateforme avec les mêmes patterns déclaratifs. Le coût est réel : Kubernetes est réputé complexe, avec ses propres concepts (pods, services, ingresses) et sa charge opérationnelle. !!Kubernetes ne remplace pas les conteneurs ; il fait en sorte qu’une flotte de conteneurs se comporte comme un seul système.!!
Fonctions : pas de serveur, juste du code
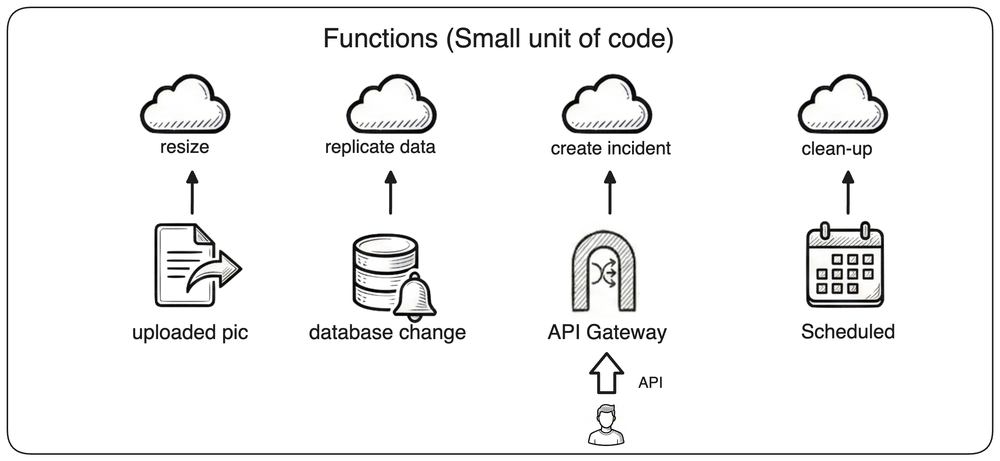
À l’extrémité la plus légère du spectre, les fonctions font disparaître le serveur lui-même. Au lieu de déployer une application, le développeur téléverse un morceau de code déclenché par un événement : un appel HTTP, un upload de fichier, un cron planifié, un changement en base. Le fournisseur n’exécute la fonction que lorsque c’est nécessaire, la fait passer de zéro à des milliers d’invocations concurrentes instantanément, et ne facture que les millisecondes d’exécution. !!Les fonctions sont l’expression la plus pure du pay-per-use : pas de serveurs à provisionner, pas de capacité inactive à payer, pas de runtime à maintenir en vie.!! Elles conviennent parfaitement aux jobs événementiels — redimensionnement d’images, webhooks, tâches planifiées — mais très mal aux workloads longs ou stateful.
Modèles de bases de données : ce que le cloud a changé
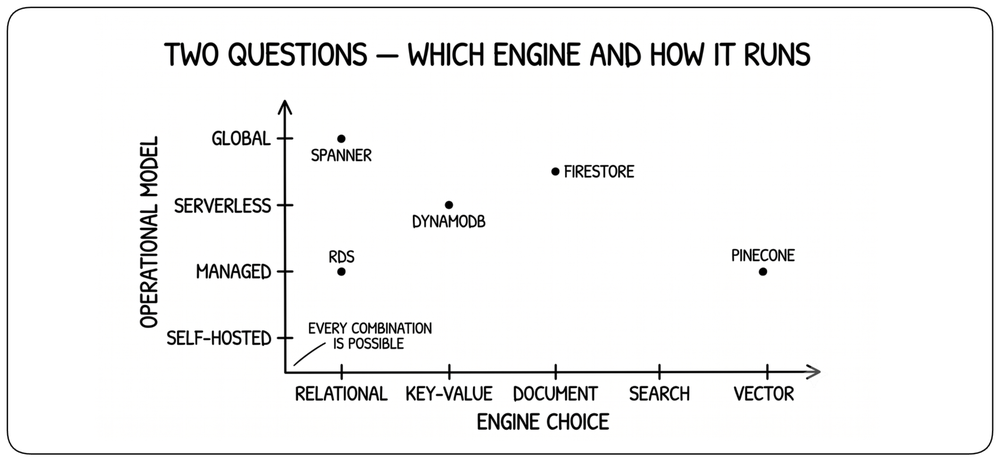
!!Le cloud n’a pas inventé les bases de données — il a inversé la façon de les choisir et de les exploiter.!! Avant, la question était surtout de savoir quel moteur convient aux données ; maintenant, c’est aussi de savoir quel modèle opérationnel convient au workload. Les mêmes données peuvent vivre sur une VM Postgres auto-opérée, une instance RDS managée, une table serverless qui descend à zéro entre les requêtes, ou un store répliqué globalement sur plusieurs continents. !!Le choix intéressant aujourd’hui n’est pas seulement le moteur — c’est la façon dont la base scale, coûte et survit.!!
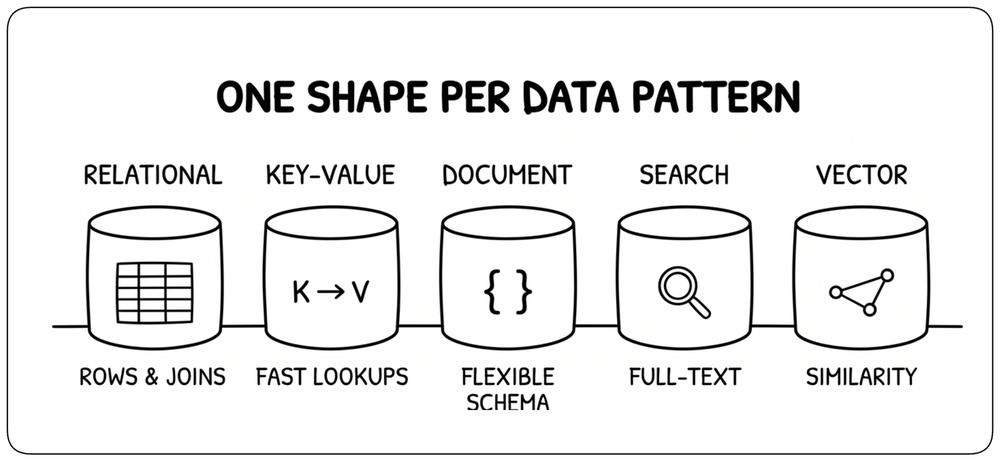
Le zoo des moteurs : une forme par pattern de données
Le cloud n’a pas désigné de vainqueur — il a rendu toutes les formes de bases de données facilement disponibles. Les moteurs relationnels (Postgres, MySQL) ancrent toujours les données transactionnelles avec schémas et jointures. Les stores clé-valeur (DynamoDB, Redis) offrent des lectures en quelques millisecondes à n’importe quelle échelle. Les bases documentaires (MongoDB, Firestore) conviennent aux payloads semi-structurés dont le schéma évolue avec le produit. Les moteurs de recherche (Elasticsearch, OpenSearch) gèrent le full-text et les requêtes classées. Les bases vectorielles (Pinecone, pgvector, Weaviate) sont apparues avec les LLM pour stocker des embeddings et faire de la recherche par similarité. !!Le but n’est plus de forcer chaque pattern de données dans un seul moteur — c’est de choisir la bonne forme pour chaque donnée.!!
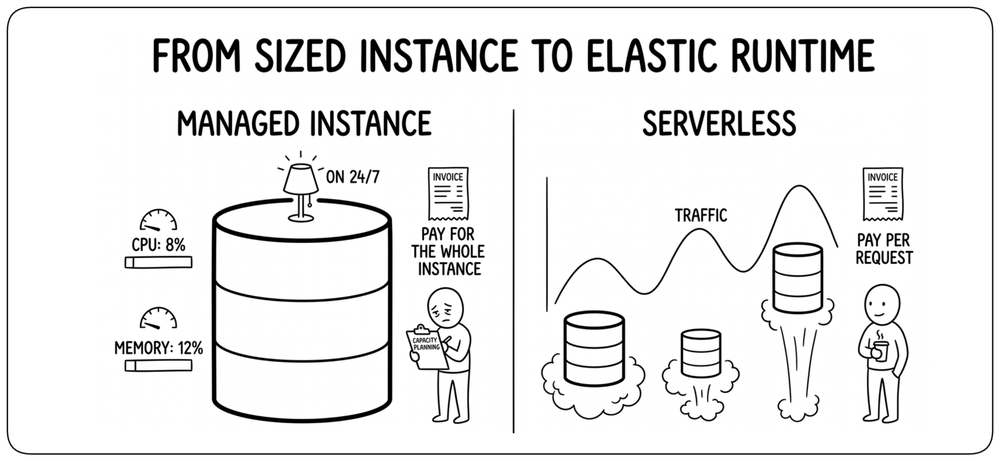
Bases serverless : scale-to-zero, paiement à la requête
Les bases managées ont supprimé le fardeau du patching et des sauvegardes, mais ont conservé une hypothèse du monde on-prem : une base est une instance, dimensionnée à l’avance, payée qu’on l’utilise ou non. Les bases serverless ont brisé cette hypothèse. Aurora Serverless, DynamoDB on-demand, Firestore, Neon, PlanetScale et d’autres ajustent automatiquement leur capacité à la hausse et à la baisse, souvent jusqu’à zéro entre les requêtes, et facturent à l’opération réelle. Pas d’instance à dimensionner, pas de capacité inactive à payer, pas de réunion de planification de capacité. !!Une base serverless est à une base managée ce qu’une fonction est à une VM — le runtime n’apparaît que lorsqu’il y a du travail à faire.!! Le compromis : la latence de cold start et une tarification à la requête qui peut faire mal sous très forte charge soutenue.
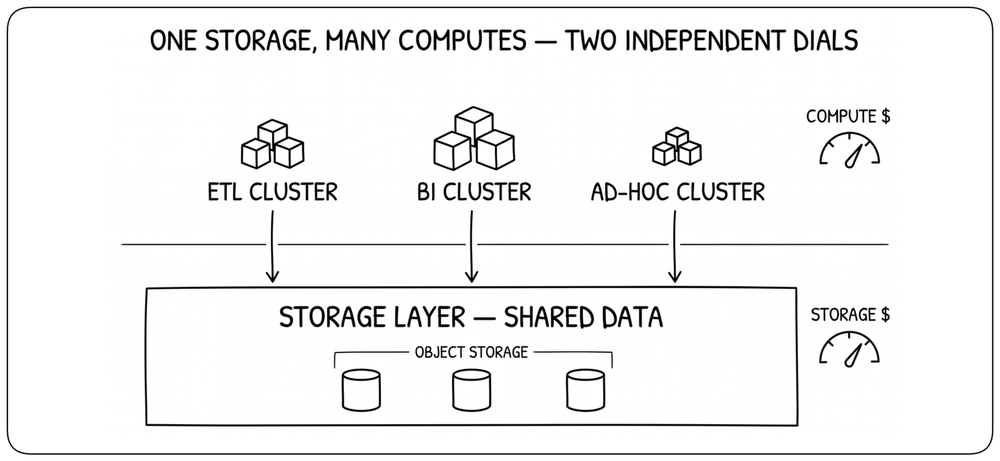
Découpler le stockage du calcul
Les bases traditionnelles liaient stockage et calcul à la même machine — le disque et le CPU vivaient et mouraient ensemble. Les moteurs cloud-native comme Snowflake, BigQuery, Aurora, Redshift et Neon ont rompu ce lien : les données résident dans une couche de stockage distribuée, souvent bâtie sur du stockage objet, tandis que le calcul est un cluster élastique qui peut croître, rétrécir ou disparaître sans toucher aux données. Le même stockage peut être interrogé simultanément par plusieurs clusters de calcul indépendants — un pour l’ETL, un pour la BI, un pour l’analyse ad hoc — chacun dimensionné pour son workload. !!Stockage et calcul sont devenus deux curseurs indépendants, facturés séparément, scalés séparément, opérés séparément.!! Cloner une base de plusieurs téraoctets devient instantané, car seuls les pointeurs de stockage sont copiés, pas les données.
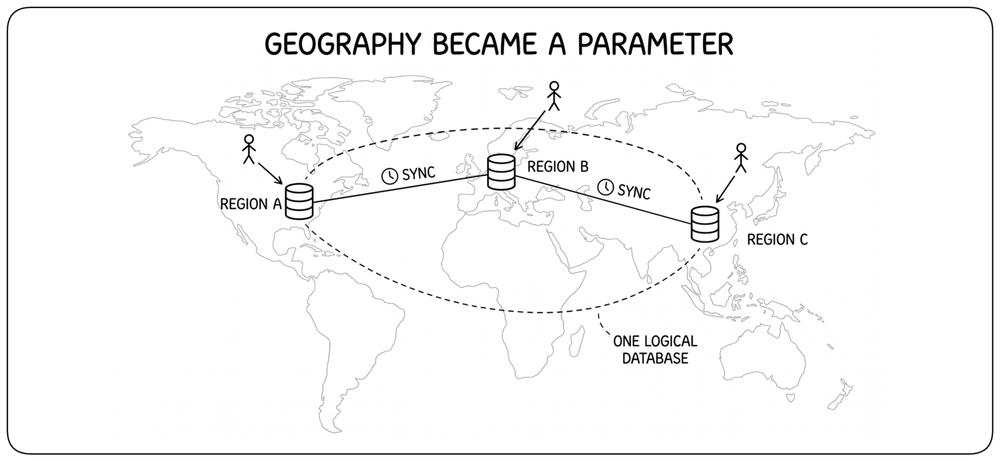
Bases globales : un store logique, plusieurs régions
Répliquer une base de données entre continents était autrefois un projet qui se comptait en trimestres. !!Google Spanner, DynamoDB Global Tables, Cosmos DB et CockroachDB en ont fait une configuration : une base logique unique répliquée physiquement entre régions, avec des niveaux de cohérence (forte, bornée, éventuelle) choisis par workload.!! Les lectures se font près de l’utilisateur, les écritures convergent globalement, et le failover régional se fait sans changement de code — ce qui fait des bases globales la fondation du disaster recovery moderne, exploré dans le chapitre Résilience. !!La géographie est devenue un paramètre, pas une architecture.!! Le compromis est réel — les écritures inter-régions coûtent de la latence, et la cohérence globale forte est la garantie la plus coûteuse qu’une base puisse offrir.
Modèles de multitenancy
!!La multitenancy est le changement d’état d’esprit qui a rendu possible la révolution du cloud.!! Au fond, c’est simple : une seule instance de logiciel ou d’infrastructure sert plusieurs clients (tenants), chacun avec ses propres données et configurations isolées. Mais ce concept simple a tout transformé. Sans multitenancy, les fournisseurs cloud auraient besoin d’une infrastructure dédiée par client — le cloud computing ne serait que de l’hébergement cher. Avec la multitenancy, AWS sert des millions de clients dans les mêmes data centers et atteint des économies d’échelle jusque-là impossibles. !!L’application de votre startup tourne à côté de l’infrastructure de Netflix, les deux partageant les mêmes ressources sous-jacentes tout en conservant des frontières de sécurité.!! Ce partage massif de ressources fait baisser les coûts de plusieurs ordres de grandeur. L’économie pay-per-use du cloud, son accessibilité à toute organisation, son utilisation efficace des ressources — tout découle de la multitenancy. C’est le moteur économique du cloud computing moderne.
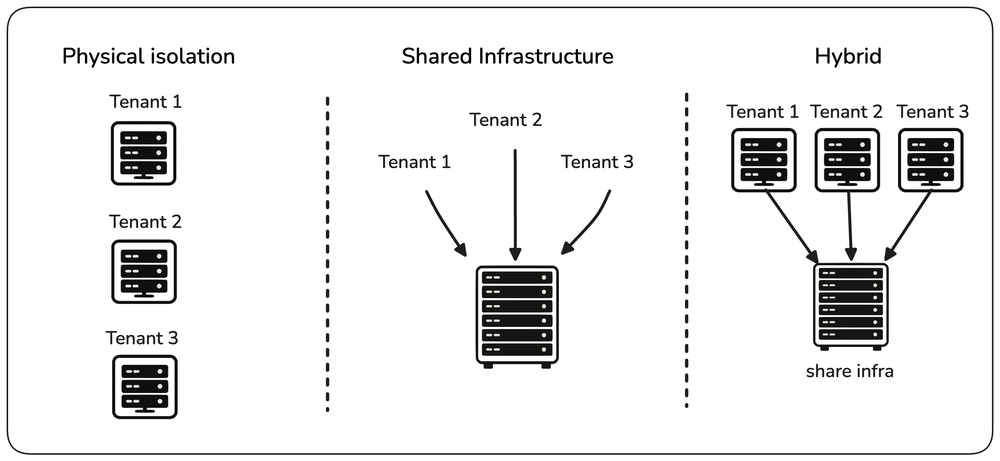
Comprendre les modèles d’isolation des tenants
!!Il existe trois stratégies fondamentales pour isoler les tenants dans un système multi-tenant.!! L’isolation physique donne à chaque tenant une infrastructure dédiée — sécurité et conformité maximales, mais coût et complexité opérationnelle maximaux. L’infrastructure partagée sert tous les tenants depuis des ressources communes avec une séparation logique — efficacité maximale et coût minimal, mais exige une conception soignée de l’isolation. L’hybride combine les deux approches — infrastructure partagée pour les tenants standard, ressources dédiées pour les clients enterprise aux exigences spécifiques. Le choix dépend des besoins de sécurité, des obligations de conformité, des contraintes de coût et de la capacité opérationnelle.
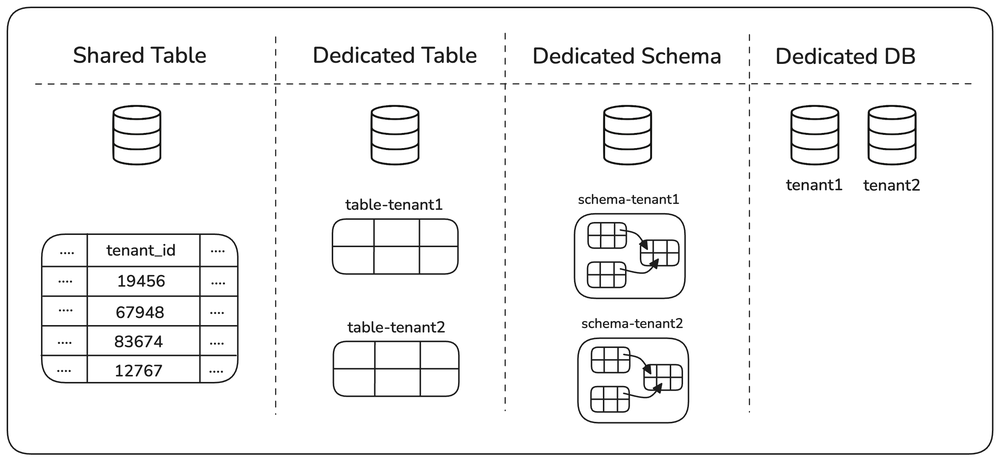
Stratégies de multi-tenancy en base de données
L’architecture de la base de données joue un rôle critique dans les systèmes multi-tenant. !!L’approche base partagée avec schéma partagé stocke les données de tous les tenants dans les mêmes tables, avec une colonne tenant_id pour l’isolation - elle maximise la densité mais exige une conception soignée des requêtes pour éviter les fuites de données.!! La base partagée avec schémas séparés donne à chaque tenant son propre schéma dans une instance de base partagée, ce qui offre une meilleure isolation tout en gardant la simplicité opérationnelle. L’approche base dédiée par tenant offre l’isolation la plus forte et la gestion des données la plus simple, mais augmente la complexité et les coûts d’infrastructure.
Isolation logique par défaut, physique à la demande
!!Dans la plupart des cas, la multi-tenancy poolée avec isolation logique offre le meilleur équilibre — elle minimise la charge opérationnelle, maximise l’utilisation des ressources et laisse de la flexibilité pour grandir.!! C’est un point de départ pragmatique. Si vous avez adopté l’Infrastructure as Code et les déploiements automatisés, l’isolation physique complète devient techniquement faisable. Avec ces fondations, lancer un environnement entièrement dédié pour un client n’est plus un projet de plusieurs mois — c’est un déploiement automatisé.
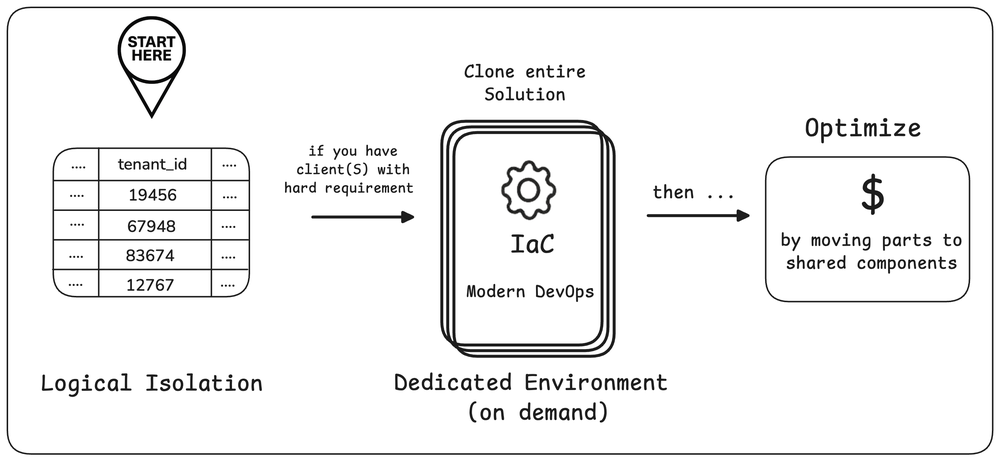
!!Architecturez vos systèmes pour supporter les deux stratégies dès le premier jour.!! En grandissant, vous pourrez optimiser davantage — par exemple en partageant certains composants d’infrastructure comme les systèmes de logging ou les services de notification entre des environnements par ailleurs isolés.
Identification du tenant et contexte
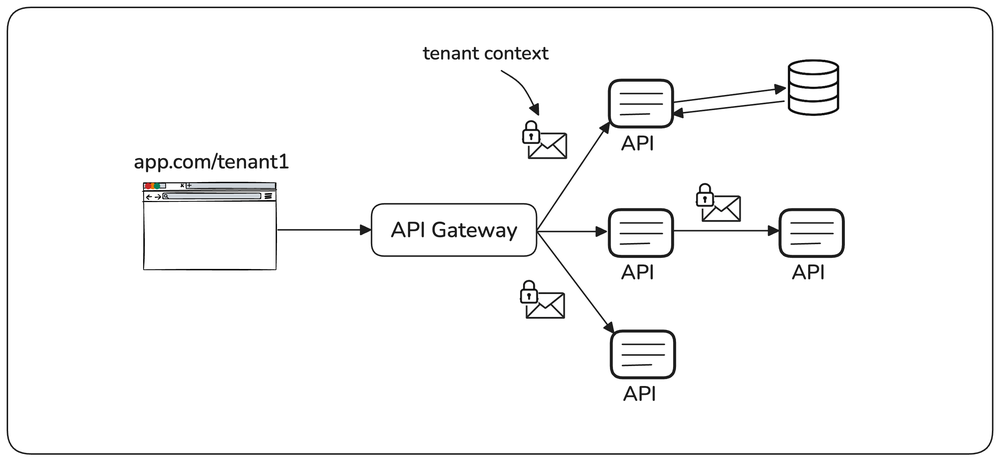
Identifier correctement le tenant et maintenir son contexte à travers toute la stack applicative est essentiel pour la sécurité multi-tenant. !!L’identification du tenant se fait généralement à l’API gateway ou au point d’entrée de l’application, via du routage par sous-domaine (tenant1.app.com), du routage par chemin (/tenant1/api) ou des tokens d’authentification contenant l’information du tenant.!! Une fois identifié, le contexte du tenant doit être propagé à travers toutes les couches - de l’API aux services, aux bases de données et aux jobs en arrière-plan. Ce contexte doit être immuable et validé à chaque frontière pour prévenir les attaques d’usurpation de tenant. Les frameworks modernes fournissent souvent des middlewares ou des mécanismes de propagation de contexte pour que l’information du tenant circule sans heurt à travers la stack applicative.
Limites de ressources et usage équitable
Dans les environnements multi-tenant, empêcher un seul tenant de monopoliser les ressources est critique pour maintenir la qualité de service. !!Mettez en place des quotas par tenant pour les appels API, le stockage, les ressources de calcul et les opérations concurrentes.!! Le rate limiting doit opérer au niveau du tenant, pour que l’usage excessif d’un tenant n’impacte pas les autres. Les systèmes d’ordonnancement et de files de ressources devraient intégrer des algorithmes d’équité entre tenants pour éviter la famine. Surveiller la consommation de ressources par tenant permet une planification de capacité proactive et aide à identifier les tenants à migrer vers une infrastructure dédiée. Ces contrôles garantissent que le modèle multi-tenant reste soutenable tout en offrant des performances constantes à tous les tenants.
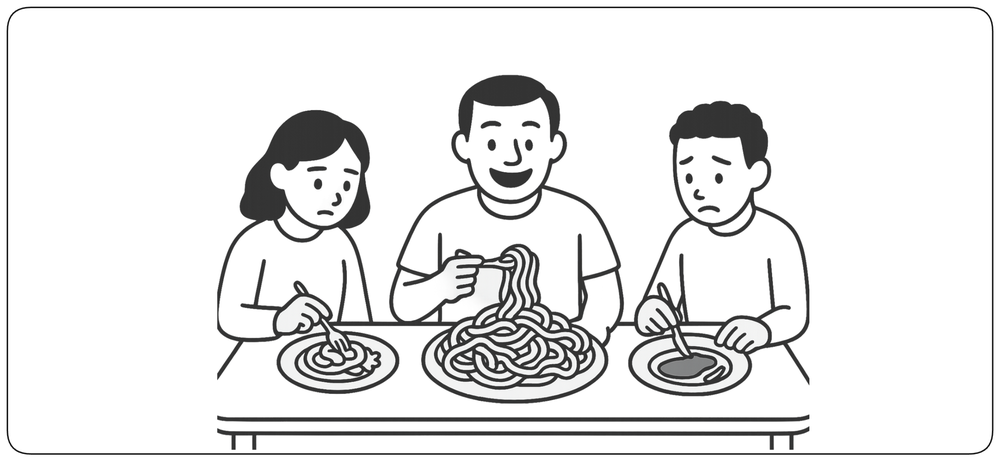
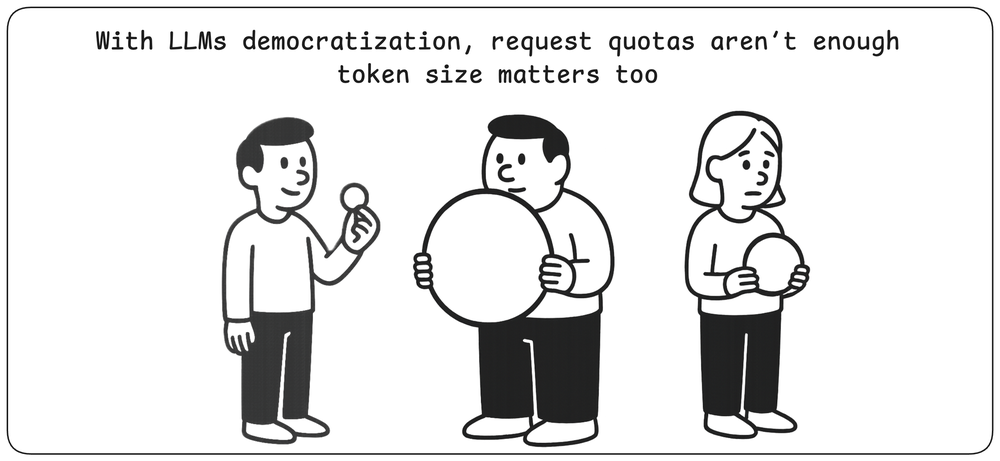
!!Les quotas de requêtes traditionnels ne suffisent plus ; l’usage équitable moderne doit tenir compte du volume de tokens et de la taille du contexte pour refléter le coût de calcul réel des opérations LLM.!!
Considérations de sécurité multi-tenant
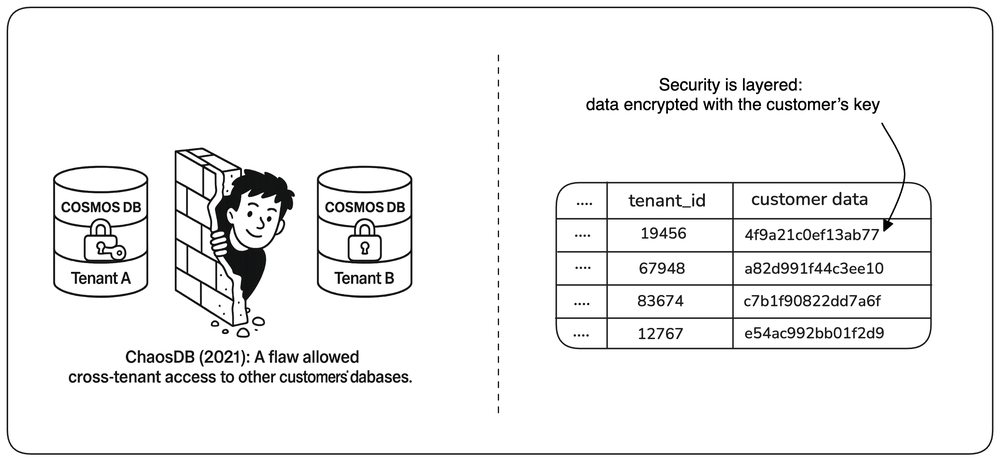
La sécurité des systèmes multi-tenant exige plusieurs couches de protection pour empêcher les tenants d’accéder aux données des autres. !!Chaque requête et chaque requête de base de données doit vérifier l’identité du tenant, en filtrant les données par ID de tenant pour que les utilisateurs ne voient que leurs propres informations.!! Mettez en place des politiques de row-level security comme filet de sécurité au niveau de la base — même si le code applicatif échoue, la base empêche l’accès inter-tenants. Utilisez des clés de chiffrement distinctes par tenant pour les données sensibles, afin que le contournement de l’isolation de la base ne permette toujours pas de déchiffrer les informations d’un autre tenant. Journalisez toutes les opérations avec le contexte du tenant pour détecter les tentatives suspectes d’accès inter-tenants. Testez régulièrement l’isolation des tenants par des tests d’intrusion qui tentent spécifiquement l’usurpation de tenant et l’accès aux données. Pour les clients enterprise qui exigent des contrôles renforcés, fournissez des politiques de sécurité spécifiques au tenant au-delà des protections standard.
Faire évoluer les architectures multi-tenant
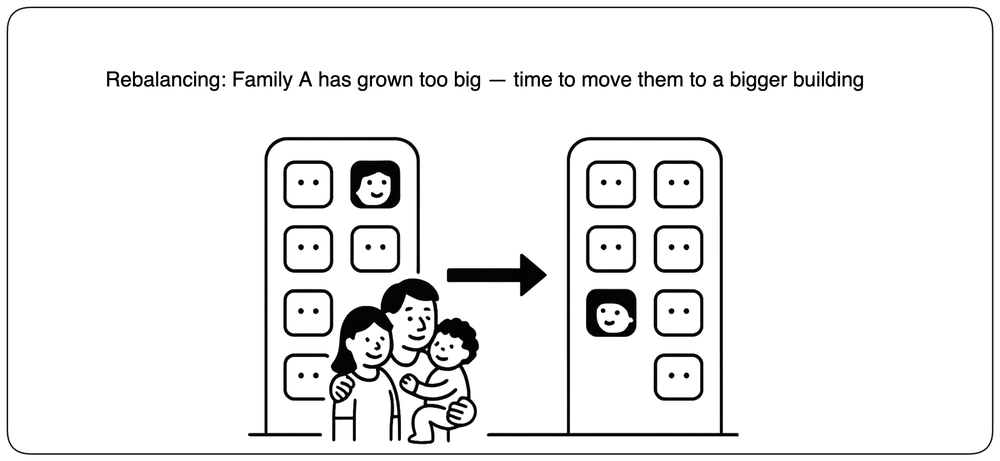
Faire évoluer les systèmes multi-tenant est difficile parce que la croissance des tenants est imprévisible. !!Un tenant qui démarre petit peut soudain devenir gros, créant une distribution inégale où quelques gros tenants surchargent un environnement de production donné.!! Comme le placement initial ne peut pas se fonder de façon fiable sur des prédictions, les plateformes doivent prévoir une redistribution continue : déplacer des tenants, répartir autrement (sharding), ou rééquilibrer les clusters pour éviter les hotspots. À mesure que le système grandit, ajouter de nouveaux environnements et lisser en continu le placement des tenants maintient une répartition homogène des workloads et garantit que la plateforme reste stable et réactive.
Modèles de déploiement
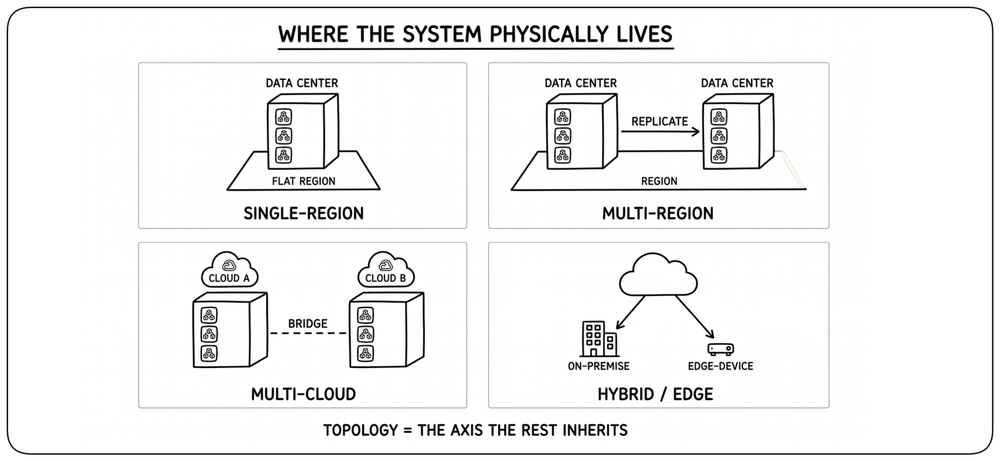
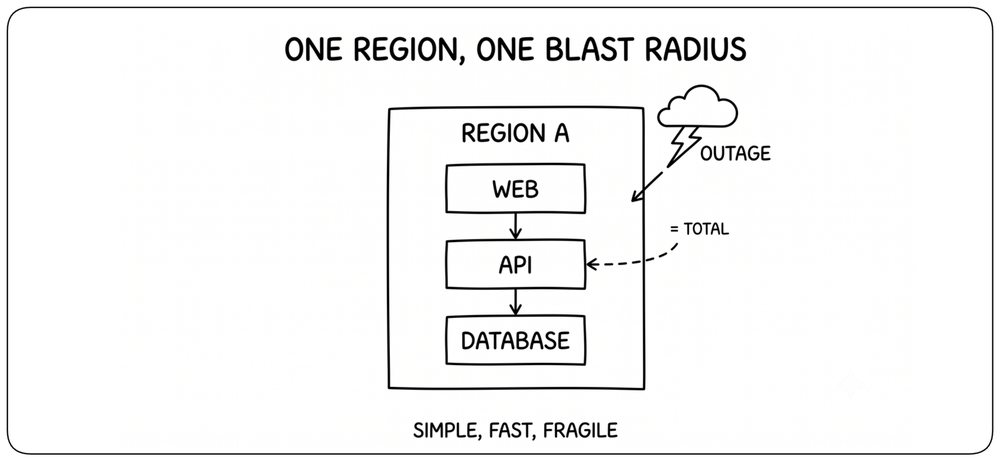
Les décisions de service, de calcul, de base de données et de tenancy laissent une question ouverte : où le système s’exécute physiquement. La topologie de déploiement est l’axe qui détermine combien de régions, de clouds ou de sites le système couvre — et comment ils basculent les uns sur les autres. Un déploiement mono-région est simple et rapide mais lie la disponibilité à un seul endroit. Le multi-région achète du disaster recovery au prix de la réplication inter-régions. Le multi-cloud et l’hybride poussent l’optionalité plus loin, avec davantage de dette opérationnelle. !!La topologie est un choix dont hérite le reste de l’architecture.!! La choisir tard coûte cher — elle façonne le placement des données, les budgets de latence et les frontières d’identité.
Mono-région : le défaut de la simplicité
La plupart des systèmes devraient démarrer dans une seule région. Une région garde la latence basse, la réplication triviale et les opérations ennuyeuses — la topologie la plus simple qui livre. Le coût est la concentration : chaque service et dépendance vit dans le même rayon d’impact, donc une panne régionale arrête tout le système d’un coup. Pour les outils internes, les produits en phase initiale et tout ce qui tolère quelques heures d’indisponibilité, c’est le bon défaut. !!Une région est rapide, peu chère et fragile — choisissez-la volontairement, pas par accident.!! Ne passez au multi-région que lorsqu’un SLO, un contrat client ou un régulateur l’exige.
Multi-région : résilience géographique
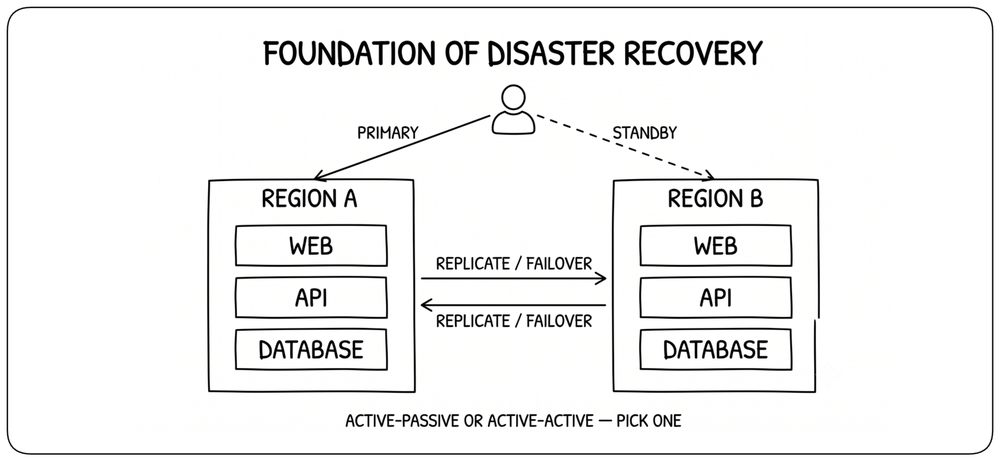
Le déploiement multi-région est la fondation du disaster recovery cloud, exploré en profondeur dans le chapitre Résilience. Deux variantes dominent : actif-passif (une région sert le trafic, une autre attend en warm) échange du coût contre de la simplicité ; actif-actif (toutes les régions servent le trafic en même temps) maximise la disponibilité et la capacité mais impose des décisions sur la cohérence des données, la résolution de conflits et le routage global. Les bases globales, les load balancers anycast et les stores d’état répliqués rendent l’une ou l’autre variante possible. !!Le multi-région n’est pas une fonctionnalité — c’est une architecture.!! Il touche toutes les couches au-dessus : identité, observabilité, pipelines de déploiement et le modèle de données lui-même.
Multi-cloud : l’optionalité a un coût
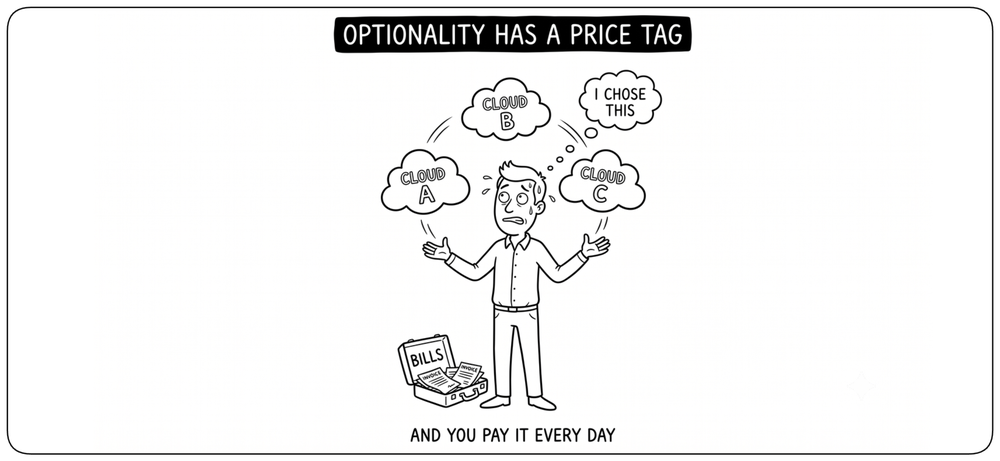
Opérer sur plusieurs fournisseurs cloud ressemble à une protection contre le lock-in ou à une exigence réglementaire, mais en pratique c’est la topologie la plus coûteuse à exploiter. !!Chaque fournisseur a son propre modèle d’identité, son réseau, son observabilité et ses services managés — et toute abstraction qui masque ces différences masque aussi les fonctionnalités qui rendaient le cloud intéressant au départ.!! !!Le multi-cloud est un coût réel payé chaque jour pour une optionalité que vous n’exercerez peut-être jamais.!! Adoptez-le quand la conformité, des règles de cloud souverain ou une capacité critique unique vous y forcent — pas comme une assurance contre un avenir que vous ne savez pas chiffrer.
Hybride et edge : le calcul là où il est nécessaire
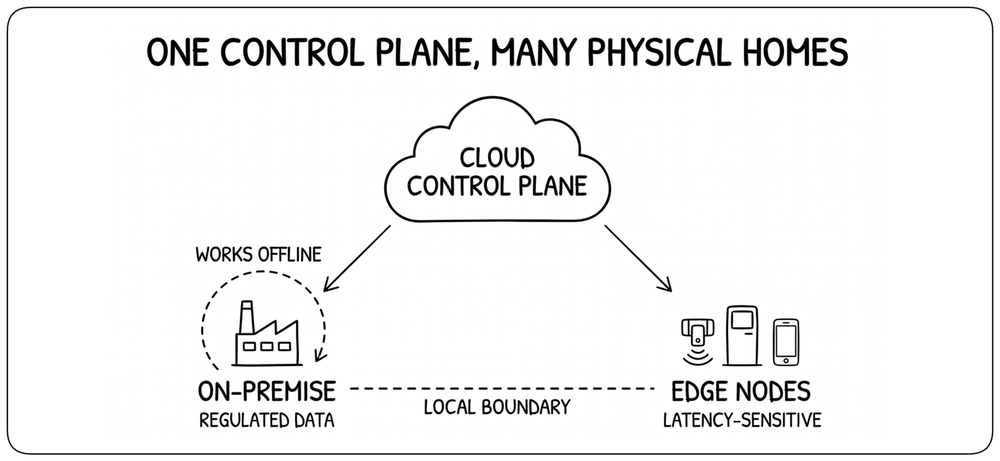
Certains workloads ne peuvent pas vivre entièrement dans une région centrale. Les données réglementées doivent rester on-premise, les usines ont besoin d’une latence de l’ordre de la milliseconde, les magasins doivent continuer à fonctionner quand la liaison avec le cloud tombe. !!Les topologies hybrides étendent le control plane du cloud jusque dans les data centers privés ; les topologies edge poussent le calcul encore plus loin, dans le réseau ou l’appareil de l’utilisateur.!! Les deux font passer la question de conception de « quelle région » à « quelle frontière » — ce qui tourne en local, ce qui se synchronise, ce qui tolère d’être hors ligne. !!L’edge, c’est le cloud qui rencontre la physique.!! Latence, souveraineté et connectivité intermittente cessent d’être des abstractions pour devenir des contraintes quotidiennes.
Choisir les modèles
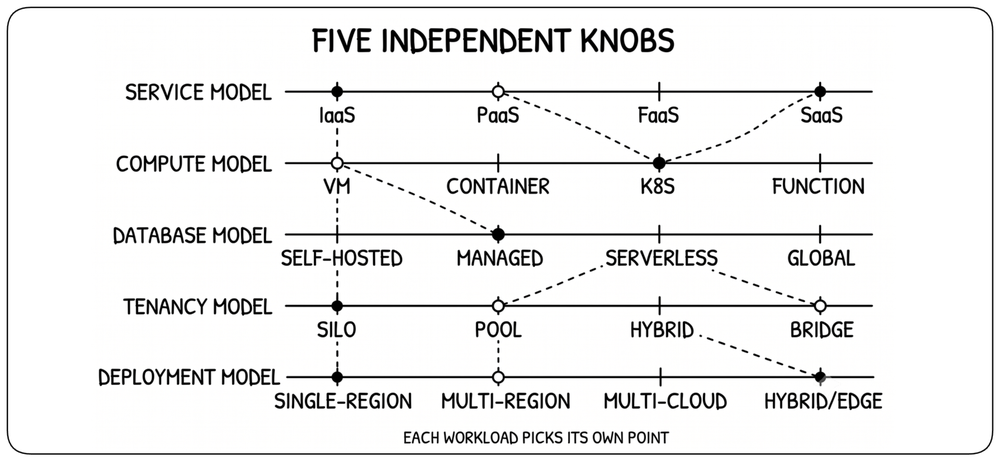
Modèles de service, de calcul, de base de données, de multitenancy et de déploiement sont cinq axes indépendants — et un système réel fait un choix différent sur chacun pour chacune de ses parties. L’art n’est pas de choisir un modèle et d’y forcer le reste du système ; c’est de savoir quels réglages tourner, quand et pourquoi. !!Une bonne architecture cloud n’est pas une réponse unique — c’est un ensemble de compromis cohérents faits délibérément.!! Voici cinq principes qui valent sur les cinq axes.
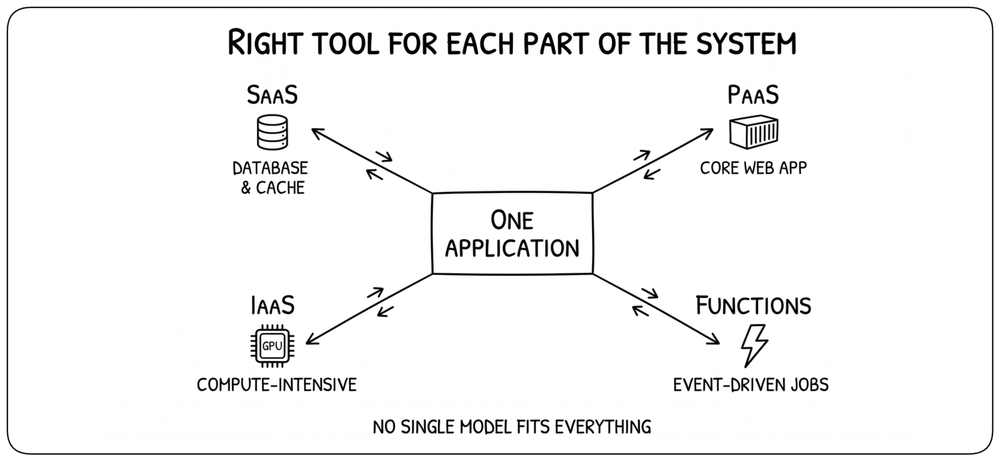
Le bon outil pour chaque partie du système
Les architectures cloud réussies ne se standardisent pas sur un seul modèle — elles associent chaque partie du système au service, à l’unité de calcul, au moteur de données, à la stratégie d’isolation des tenants et à l’empreinte de déploiement les plus appropriés. Une application typique utilise une base relationnelle managée pour les transactions, un store clé-valeur pour le cache, des conteneurs sur Kubernetes pour l’application web principale, de l’IaaS pour les workloads GPU spécialisés, des fonctions pour la colle événementielle, une tenancy poolée pour les clients standard avec une isolation en silo pour les clients régulés, et une seule région pour la plupart des services avec du multi-région uniquement pour le data plane qui ne peut pas tomber. !!La standardisation, c’est du confort ; la spécialisation, c’est de la performance.!! Le but n’est pas de choisir un modèle et d’y forcer tout le reste, mais de sélectionner avec soin la bonne forme pour chaque tâche — et de tracer des frontières claires entre elles.
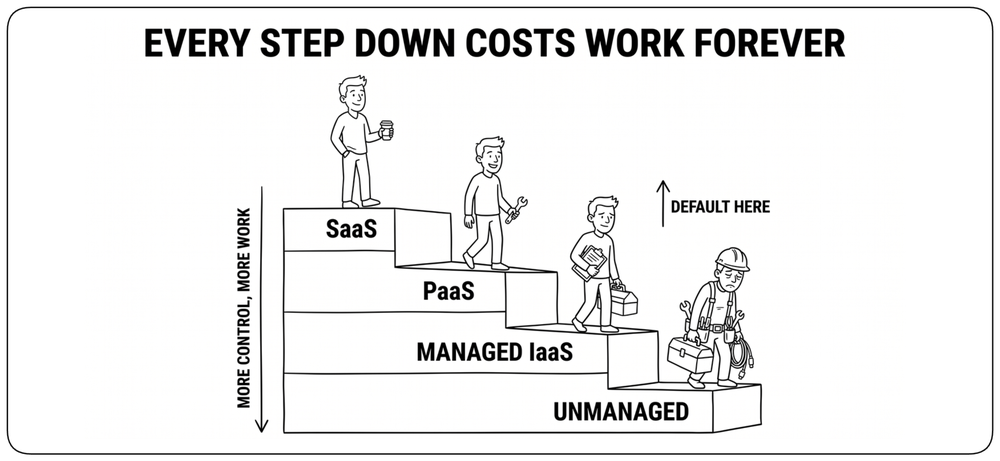
Managé par défaut, descendre seulement pour une raison
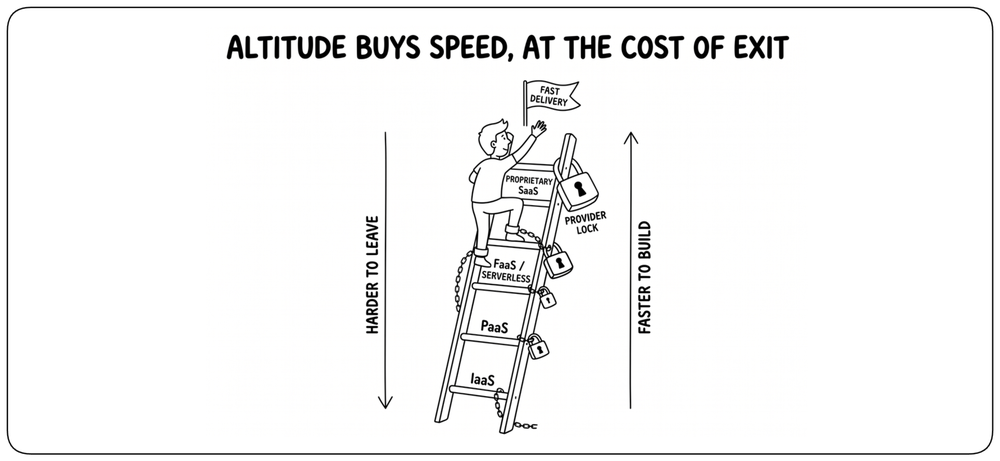
Chaque marche descendue dans l’échelle d’abstraction — du SaaS au PaaS, du PaaS à l’IaaS, du managé au non managé — coûte du travail opérationnel que quelqu’un de votre équipe portera pour toujours. Le bon défaut est le niveau le plus élevé qui convient : laissez le fournisseur opérer tout ce qu’il peut, et ne descendez que lorsqu’une vraie contrainte l’impose (conformité, noyau personnalisé, coût soutenu à grande échelle, matériel spécialisé). !!Chaque responsabilité opérationnelle que vous prenez est une fonctionnalité que vous n’avez pas livrée.!! Le contrôle de bas niveau est parfois essentiel — mais il n’est jamais gratuit, et son coût se cumule sur toute la vie du système.
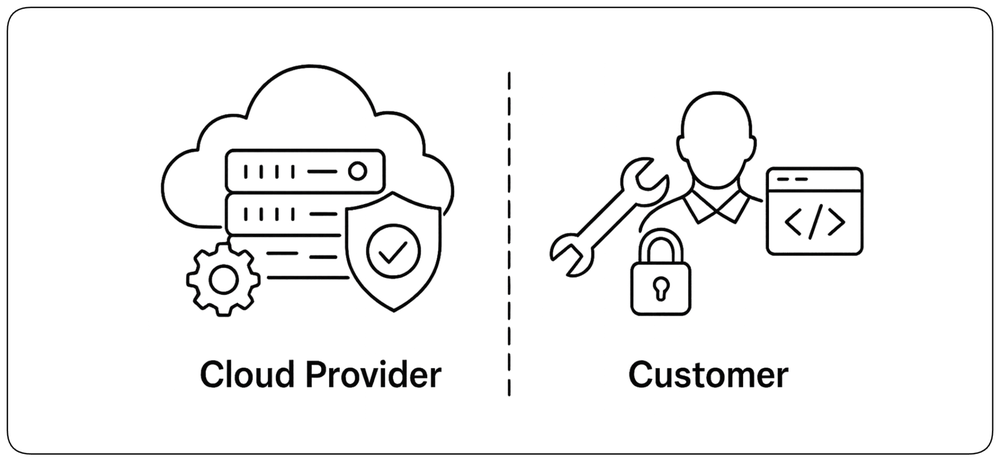
Savoir ce que l’on s’engage à opérer
Chaque modèle de l’échelle d’abstraction vient avec une facture différente de travail opérationnel. Le modèle de responsabilité partagée rend cette facture explicite : le fournisseur gère les couches sous la ligne, vous gérez celles au-dessus — et la ligne bouge avec chaque modèle de service. Avec l’IaaS, vous possédez l’OS, les patchs, le scaling, les sauvegardes et l’essentiel de la posture de sécurité. Avec le PaaS, le fournisseur prend le runtime et la plateforme ; vous gardez le code, les données et la configuration. Avec le SaaS, presque tout est du côté du fournisseur, sauf l’identité, le contrôle d’accès et les données que vous y mettez. !!Choisir un modèle de service, ce n’est pas seulement choisir un niveau d’abstraction — c’est choisir quels problèmes vous acceptez de porter pour toujours.!! Lisez la ligne avant de signer, ou vous la découvrirez pendant un incident.
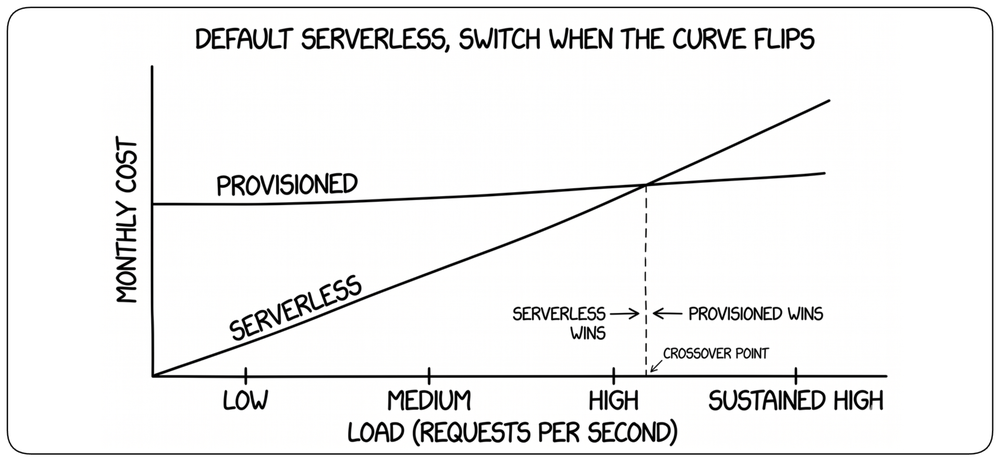
Serverless d’abord, provisionné quand la charge est soutenue
Le paiement à la requête bat la capacité provisionnée jusqu’à ce que le workload devienne prévisible et constant. Pour une demande inconnue, un trafic en pics et les services en phase initiale, le serverless gagne sur toutes les dimensions : pas de capacity planning, pas de coût à vide, pas d’empreinte minimale. Mais le calcul s’inverse quand la charge devient soutenue — à haut débit stable, la tarification à la requête est dépassée et les instances provisionnées deviennent moins chères. !!Commencez en serverless ; ne passez au provisionné que quand la courbe le rend moins cher, pas parce que cela semble plus « sérieux ».!! La même logique s’applique au calcul (fonctions → conteneurs → VM) et aux données (DynamoDB on-demand → provisionné → réservé).
Le lock-in est le prix de l’altitude
Plus on monte dans l’échelle d’abstraction, plus on échange de la portabilité contre de la productivité. Les composants SaaS, les runtimes serverless propriétaires et les bases spécifiques à un fournisseur se livrent plus vite et coûtent moins cher à opérer — mais ils embarquent aussi des hypothèses qui ne voyagent pas vers un autre cloud. !!Chaque fonctionnalité cloud-native que vous adoptez est un petit engagement signé avec ce fournisseur.!! C’est parfois un bon compromis — la vitesse aujourd’hui vaut beaucoup — mais cela doit être un choix conscient, pas un défaut. Gardez la logique métier centrale portable, poussez le code spécifique au fournisseur dans de fines couches d’adaptation, et sachez quelles portes vous fermez en montant.
Infrastructure as Code
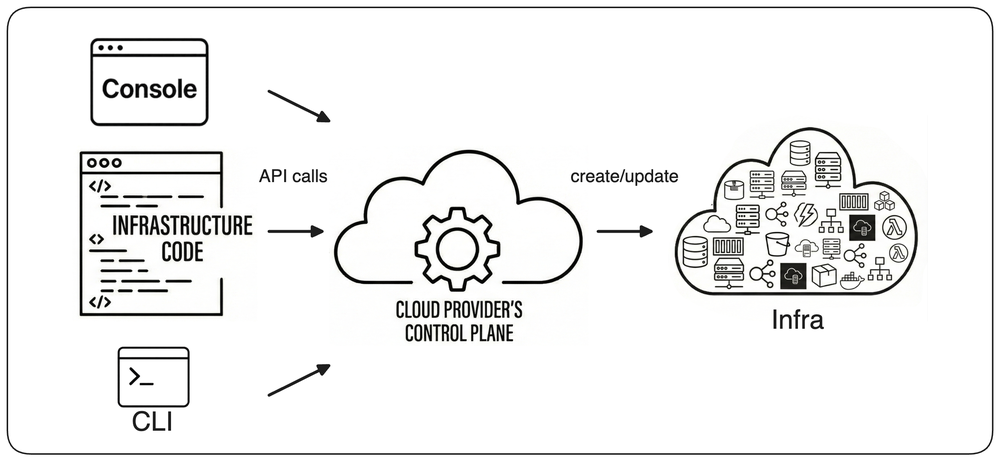
Chaque opération dans le cloud — qu’elle soit tapée dans une console ou pilotée par Terraform — finit par devenir un appel d’API. !!Le data center est devenu une API, et l’infrastructure est devenue quelque chose que l’on décrit en code plutôt que quelque chose que l’on câble à la main.!! Voici l’arc qui nous a menés là : des consoles manuelles aux scripts impératifs, puis à l’IaC déclarative et aux capacités « système intelligent » — composabilité, graphes de dépendances, réconciliation, idempotence — qui rendent possible l’infrastructure moderne.
Les limites du provisionnement manuel par console
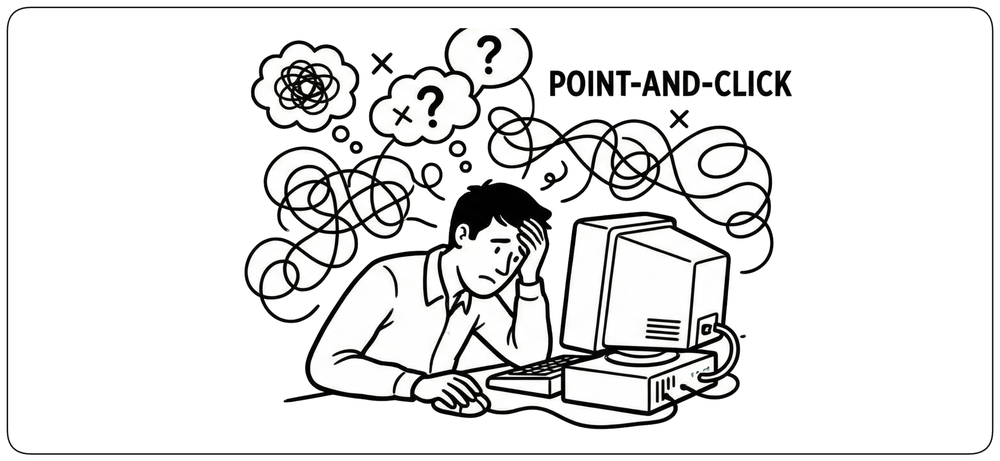
Le provisionnement d’infrastructure a longtemps été dominé par le point-and-click dans des consoles web. !!Chaque ressource devait être créée à la main, écran après écran — les configurations divergeaient d’un environnement à l’autre, les changements ne laissaient aucune piste d’audit, et le provisionnement dépendait de celui qui se souvenait de la bonne séquence.!! !!Le travail manuel en console ne passe pas à l’échelle, ne se reproduit pas et ne survit pas au turnover.!! À mesure que les systèmes grandissaient, la console est devenue le goulot d’étranglement qu’aucune organisation ne pouvait se permettre.
Automatisation d’infrastructure par scripts
L’étape suivante naturelle a été d’envelopper ces opérations manuelles dans des scripts — bash, Python, appels AWS CLI enchaînés. !!L’automatisation impérative a remplacé la souris par du code : plus rapide, plus reproductible et, au moins en théorie, relisible.!! Pour la première fois, l’infrastructure pouvait être déployée deux fois de la même façon. C’était un vrai progrès par rapport à la console, mais cela a apporté ses propres problèmes.
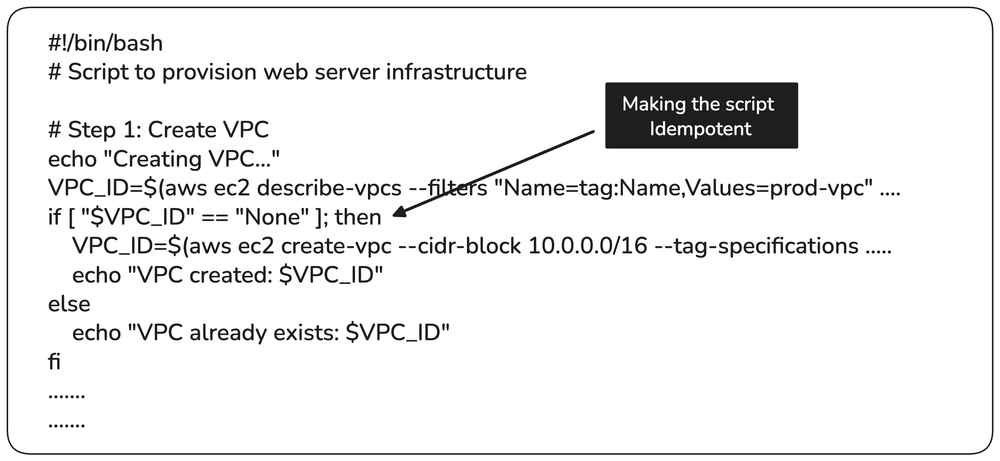
Scripts : automatisation sans réutilisabilité
Les scripts se comportent comme des recettes procédurales — étape 1 créer le VPC, étape 2 créer le subnet, étape 3 attacher la gateway — efficaces pour un chemin, fragiles en dehors. !!Chaque script encode une séquence précise, étroitement liée à son scénario ; le paramétrer pour un autre environnement revient généralement à le réécrire.!! !!Les scripts impératifs automatisent le travail, mais ils ne se composent pas.!! Les équipes qui ont suivi cette voie ont accumulé des scripts quasi dupliqués sans abstraction partagée, échangeant le goulot de la console contre un goulot de maintenance.
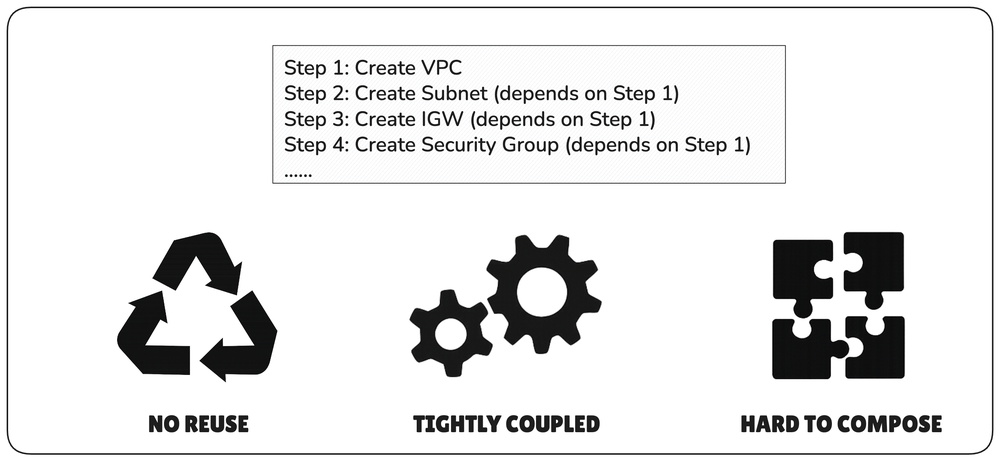
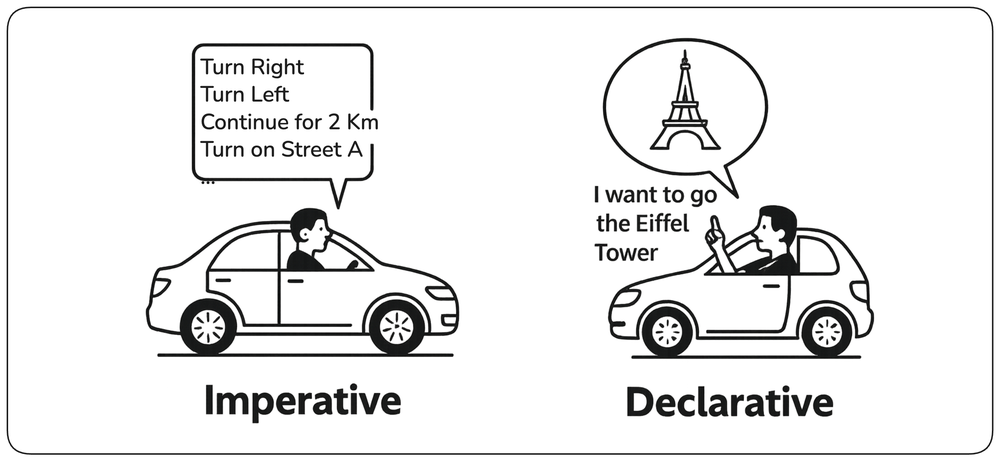
Le virage déclaratif : quoi, pas comment
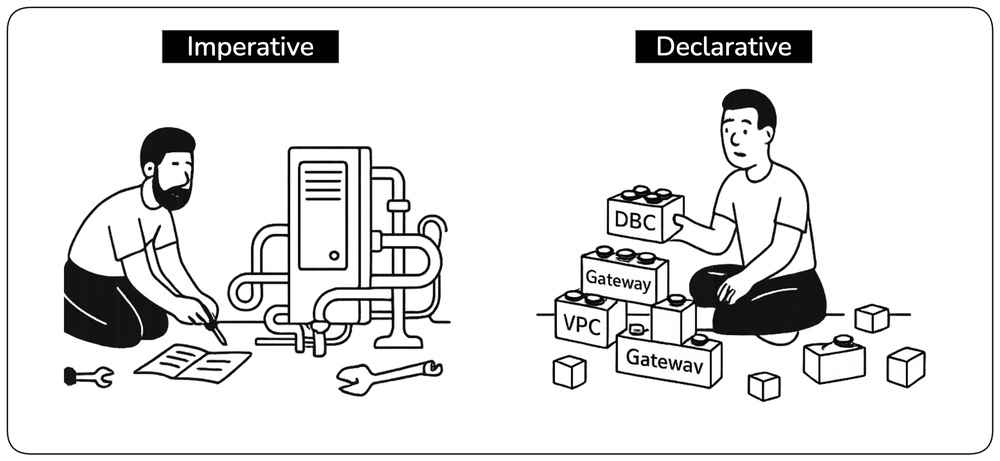
La percée a été un changement dans ce que l’on écrit. Au lieu de décrire les étapes (comment construire l’infrastructure), les ingénieurs décrivent l’état final désiré (quelle infrastructure doit exister) et laissent le système trouver les étapes. Le rôle lui-même change : les ingénieurs cessent d’être des opérateurs qui exécutent des séquences pour devenir des concepteurs d’intention — ils énoncent « trois pods qui tournent, ce service joignable, cette politique appliquée », et la plateforme s’occupe du reste. !!Arrêtez de décrire les étapes ; décrivez la destination.!! Le même trajet, deux langages — l’un pour le conducteur, l’autre pour le passager.
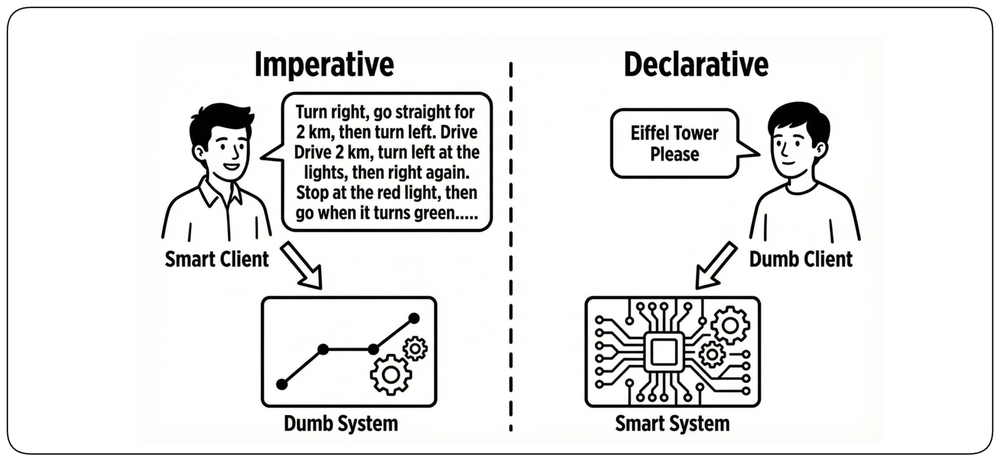
Client bête, système intelligent
L’impératif comme le déclaratif exigent de savoir comment atteindre l’objectif — la question est de savoir qui détient ce savoir. !!L’impératif le pousse sur le client : l’utilisateur doit comprendre chaque étape et instruire le système avec précision.!! Le déclaratif le déplace vers le bas : le système connaît lui-même le chemin, l’utilisateur n’a qu’à exprimer son intention. !!Rendez le client aussi simple que possible, le système aussi intelligent que nécessaire.!! Tout ce qui suit — composabilité, graphes de dépendances, réconciliation — découle de cette seule inversion.
Composabilité
Parce que les ressources déclaratives sont des abstractions, elles se composent comme des briques LEGO : dire ce que fait chaque pièce, déclarer comment elles se connectent, ignorer l’intérieur. Un VPC, un subnet, un security group, une base de données — chacun est un module autonome qui peut être paramétré, imbriqué et réutilisé dans différents contextes sans que personne ne touche à son implémentation. !!Construire une fois, composer partout.!! C’est pourquoi l’infrastructure déclarative est intrinsèquement plus réutilisable que les scripts impératifs : elle a été conçue dès l’origine pour être assemblée plutôt que construite.
Couplage faible par la découverte
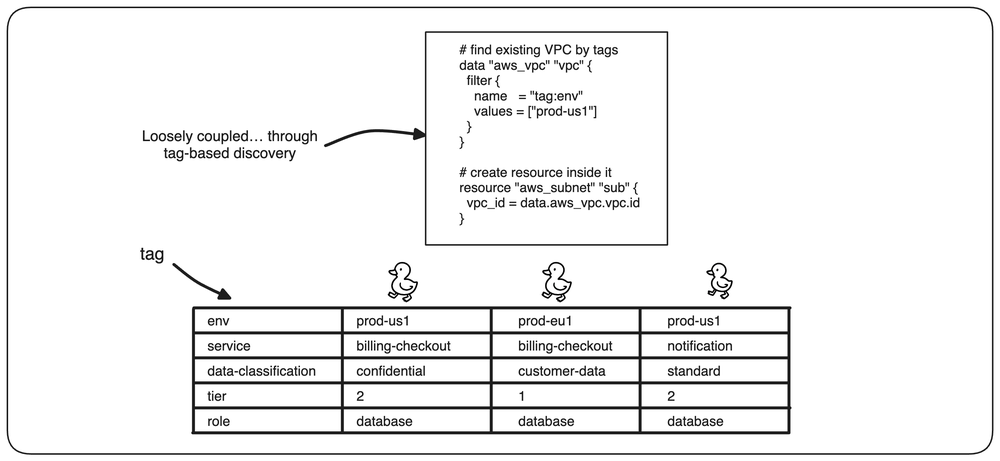
Composer des modules ne fonctionne que s’ils ne se codent pas en dur les uns les autres. !!Un module applicatif qui a besoin d’un VPC ne devrait pas y intégrer vpc-0abc123 — cela casse la portabilité dès que vous passez à un nouvel environnement.!! !!Les modules doivent découvrir, et non coder en dur, les ressources dont ils dépendent.!! Deux mécanismes le permettent : le tag matching, où un module localise son VPC en cherchant env=prod, purpose=apps ; et l’output state, où chaque module publie ses IDs et endpoints dans un état partagé que les autres peuvent interroger. Combiné au stockage d’état distant, c’est ce qui permet aux équipes de composer l’infrastructure à partir de modules indépendants sans coordonner leurs identifiants.
Gestion des dépendances
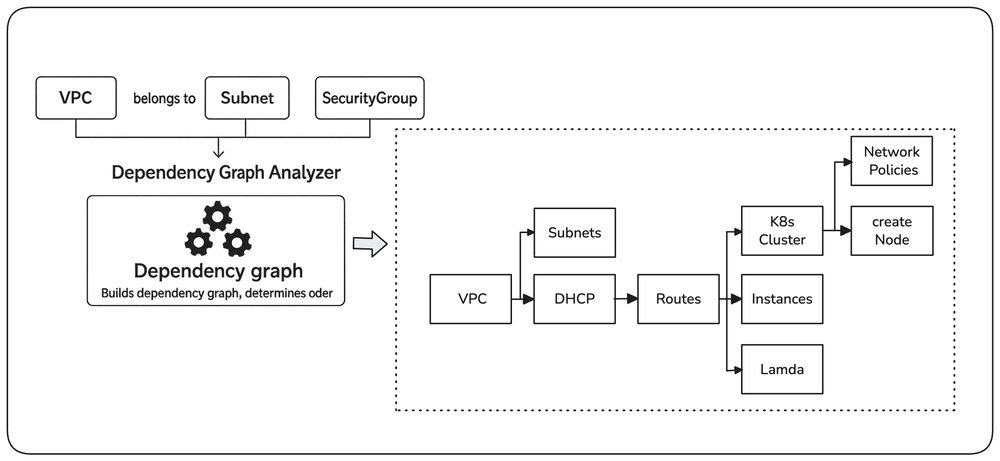
Dans les scripts impératifs, l’ordre est le fardeau du développeur — se tromper de séquence et le déploiement échoue à mi-chemin. !!Les systèmes déclaratifs éliminent cela en traitant les relations comme des données : quand vous dites « ce subnet appartient à ce VPC », vous n’écrivez pas une étape, vous énoncez un fait.!! !!Déclarez des relations, pas des séquences — laissez le système calculer l’ordre.!! Le moteur construit un graphe de dépendances, détermine automatiquement le bon ordre, parallélise les opérations indépendantes et détecte les cycles avant l’exécution. Le développeur se concentre sur le quoi ; la chorégraphie est le problème du système.
Cohérence par la réconciliation
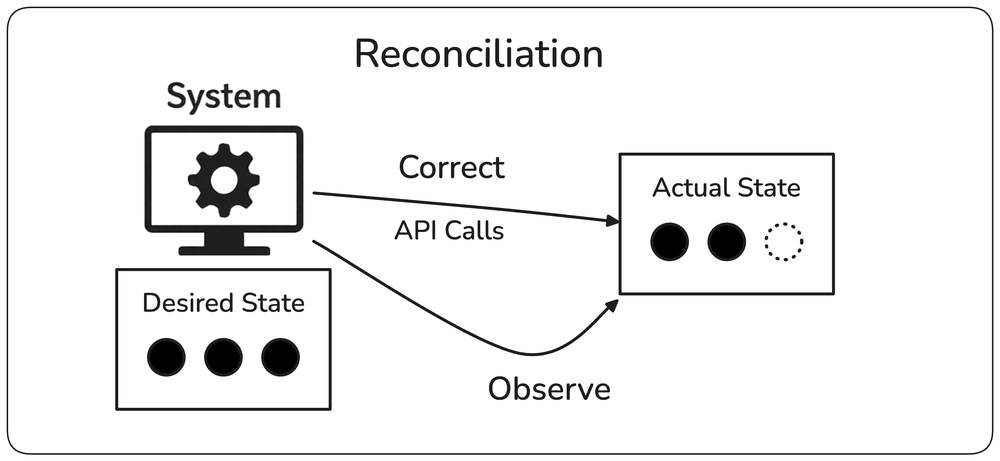
La réconciliation est le cœur battant des systèmes déclaratifs. Le moteur observe en continu l’état réel du monde, le compare à l’état désiré et corrige l’écart par des appels d’API — recréant ce qui manque, ajustant ce qui est faux, supprimant ce qui n’a pas sa place. !!L’intelligence ne vient pas de l’exécution d’instructions, mais de la garantie que la réalité reste alignée sur l’intention.!! La configuration statique devient un comportement auto-correctif ; la dérive devient quelque chose que le système corrige plutôt que quelque chose que l’opérateur remarque.
Réconciliation continue vs à la demande
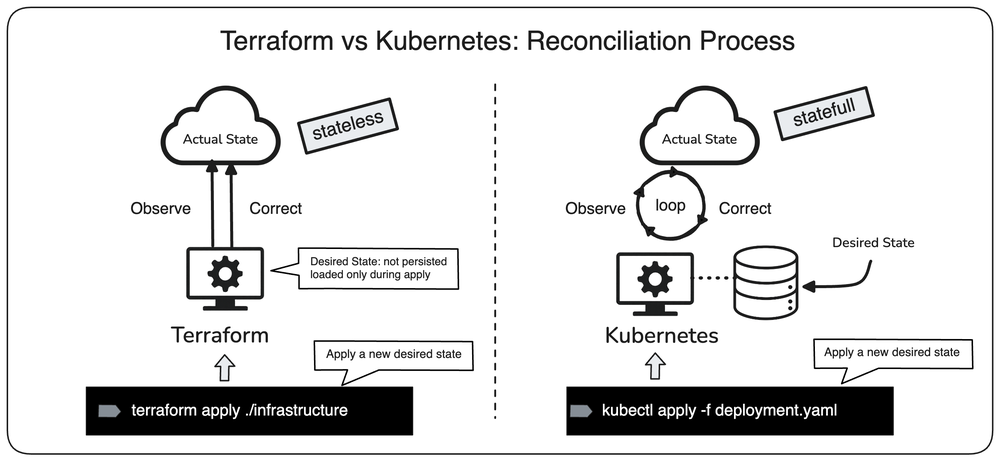
Kubernetes et Terraform réconcilient tous deux, mais pas selon le même calendrier. !!Kubernetes exécute une boucle continue — il mémorise l’état désiré, surveille l’état réel et corrige la dérive en temps réel sans que personne ne le déclenche.!! Terraform réconcilie à la demande : il charge l’état désiré, compare une fois, applique le diff, puis s’arrête jusqu’à ce que vous relanciez terraform apply. !!Même principe, deux rythmes — auto-réparation continue vs convergence par points de contrôle.!! Les deux gardent la réalité alignée sur l’intention ; ils divergent seulement sur la question de savoir si l’alignement est un état ou un événement.
GitOps : la réconciliation pilotée par Git
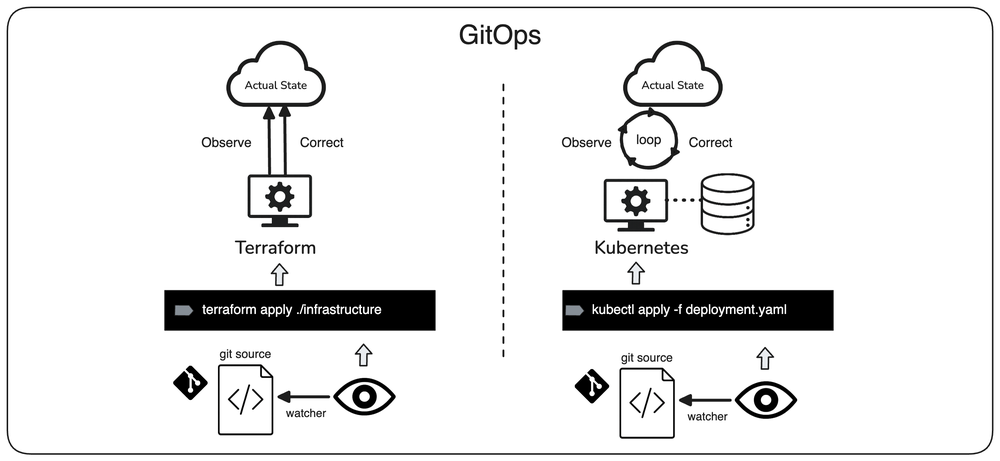
Le GitOps pousse l’idée d’état désiré un cran plus loin : Git devient l’unique source de vérité, et la réconciliation se déclenche automatiquement à chaque commit. Un watcher surveille le repo, détecte les changements mergés et réconcilie l’infrastructure ou les applications sans que personne n’ait à lancer apply à la main. Chaque changement est un commit (auditabilité complète), chaque rollback est git revert, chaque déploiement passe par la revue de pull request et les contrôles de politique CI. !!Git devient le seul control plane autorisé — si ce n’est pas dans le repo, ça n’existe pas.!! Le compromis est réel : exiger des PR introduit une friction humaine qu’une automatisation de bout en bout pure éviterait.
Idempotence
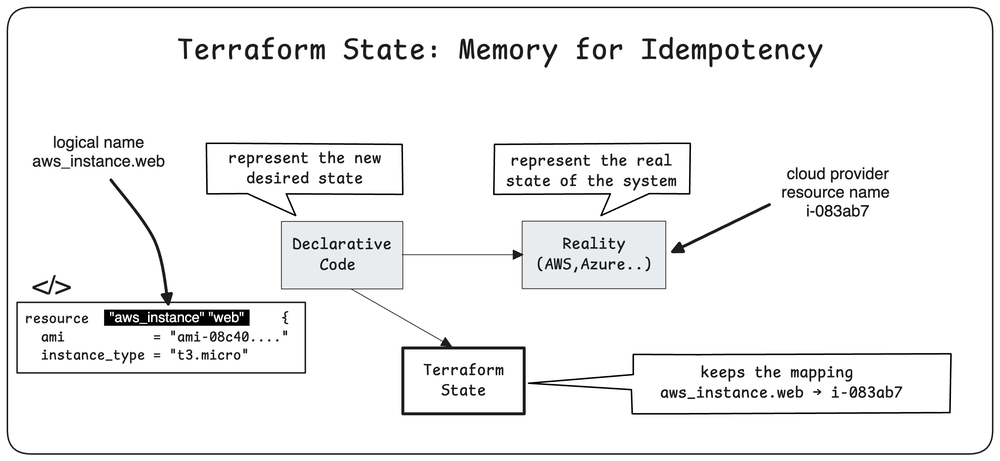
L’idempotence signifie qu’exécuter la même opération plusieurs fois produit le même résultat que l’exécuter une fois — pas de ressources dupliquées, pas d’effets de bord cumulatifs, pas de surprise au deuxième apply. !!Vous pouvez la relancer encore et encore — rien ne casse.!! Les outils déclaratifs modernes y parviennent en associant chaque nom logique de la configuration (aws_instance.web) à l’ID réel de la ressource chez le fournisseur (i-083ab7) ; à chaque exécution, le moteur vérifie si la ressource existe déjà et correspond à la spécification, puis crée, met à jour ou ne fait rien — de façon déterministe. !!Sans idempotence, chaque retry est un pari ; avec elle, l’automatisation devient sûre.!!
Exploiter l’infrastructure cloud
!!L’état d’esprit fixe la posture, l’IaC donne le langage — reste la discipline quotidienne d’exploitation de l’infrastructure cloud : quand automatiser, où tracer les lignes de responsabilité, comment organiser le changement, et quels garde-fous évitent que les équipes se marchent dessus ou marchent sur la production.!! Ces pratiques sont le mode d’emploi opérationnel une fois les principes en place.
Automatiser le provisionnement et le déprovisionnement
Automatiser la création est la moitié évidente ; automatiser la destruction est la moitié que les équipes oublient. !!Une suppression incontrôlée laisse des volumes orphelins, du DNS pendant et des factures surprises qui arrivent deux mois plus tard — et le démantèlement manuel dans la précipitation, c’est ainsi que la production se fait amputer par erreur.!! !!Le déprovisionnement compte autant que le provisionnement — mesurez la maturité à la sûreté avec laquelle vous savez démonter les choses, pas seulement à la vitesse à laquelle vous les montez.!! Traitez les deux avec la même rigueur : automatisés, auditables, conscients des dépendances et protégés par des garde-fous contre la destruction accidentelle.
Décaler la maturité de l’infrastructure en avance sur les applications
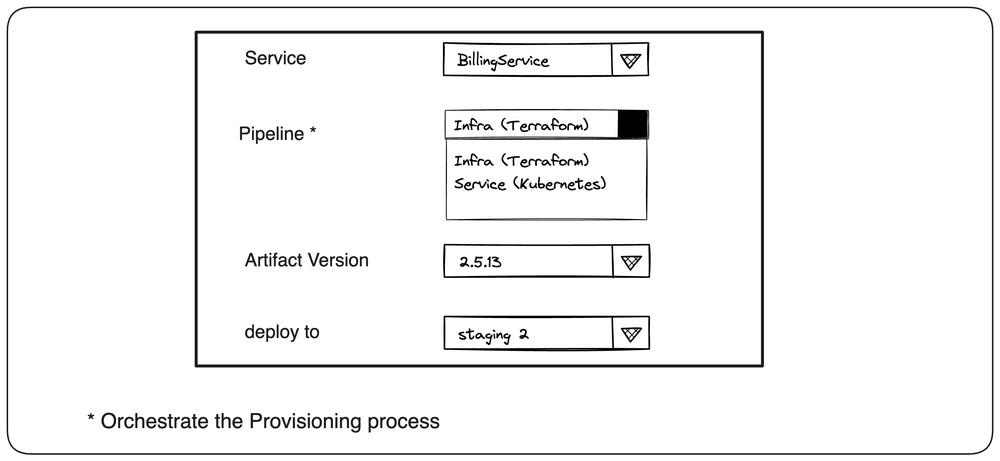
Quand les équipes construisent l’infrastructure fondamentale en interne — plateformes internes, service meshes sur mesure, serving ML — les équipes applicatives ne peuvent pas consommer en sécurité les environnements dev ou staging de l’équipe infra. !!Les changements cassants y arrivent par conception, et les applications ont besoin de stabilité pour se développer.!! !!Les applications ne consomment que la production de l’infrastructure — jamais son dev ou son staging.!! Le pipeline doit décaler : les changements d’infra sont développés, stabilisés et promus en infra-prod avant qu’aucune application n’en dépende.
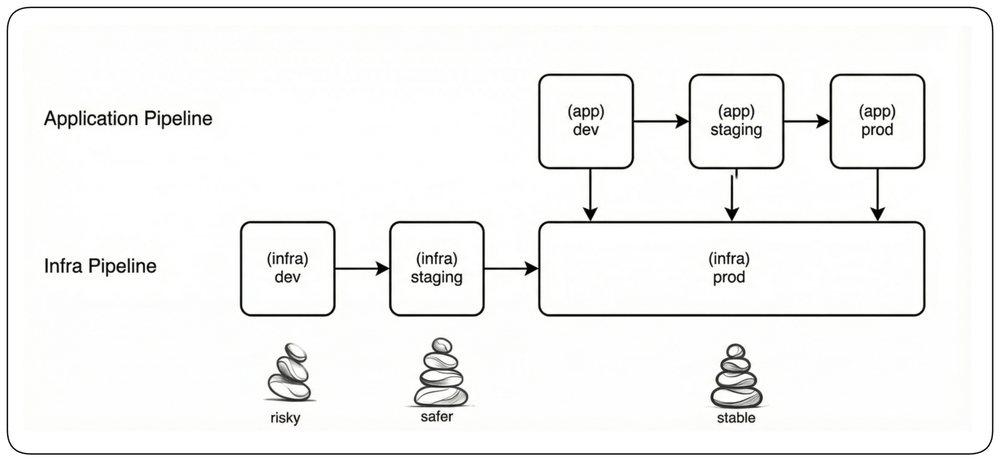
Tenir les développeurs à l’écart de l’infrastructure de production
L’accès direct des développeurs à l’infrastructure de production, c’est ainsi que naissent les pannes — un terminate accidentel, un security group élargi « juste pour déboguer », une modification de config jamais reportée dans le repo. !!La solution n’est pas de laisser les développeurs ignorants de l’infrastructure ; c’est de faire en sorte que leur seul chemin passe par le code, la revue et les pipelines.!! !!Les développeurs décrivent l’infrastructure en code ; les pipelines la changent en production.!! Les équipes plateforme peuvent ajouter du self-service par-dessus, mais le socle reste le même : aucune main humaine sur les ressources de prod.
Traiter les pipelines comme la production
Si votre pipeline IaC est en panne, vous ne pouvez ni déployer, ni patcher, ni récupérer. !!Si votre fichier d’état est corrompu, vous avez peut-être perdu la vérité sur chaque environnement que vous exploitez.!! !!Le pipeline est la production — le système qui fait tourner la production est lui-même de la production.!! Le cloud-native traite le deploy plane comme le data plane : état chiffré, backends verrouillés, logs d’audit, credentials à moindre privilège, monitoring, on-call. La tentation de considérer le CI/CD comme de « l’outillage interne » disparaît la première fois qu’un état corrompu se propage à tous les environnements à la fois.
Rendre les ressources privées par défaut
Les ressources cloud devraient être inaccessibles depuis l’internet public sauf raison business explicite — un frontend web, une API publique. !!Bases de données, services internes, files de messages, object stores : tout en privé.!! !!Si une ressource n’a pas besoin d’être publique, elle ne l’est pas — sans exception, sans « ouvert temporairement ».!! Utilisez des subnets privés, des security groups restreints, des VPC endpoints, des politiques de bucket strictes et des rôles IAM à la place de clés longue durée. La défense en profondeur suppose que chaque couche finira par tomber ; fermer d’abord la couche réseau est l’assurance la moins chère que l’on puisse acheter.
Établir des frontières de responsabilité claires
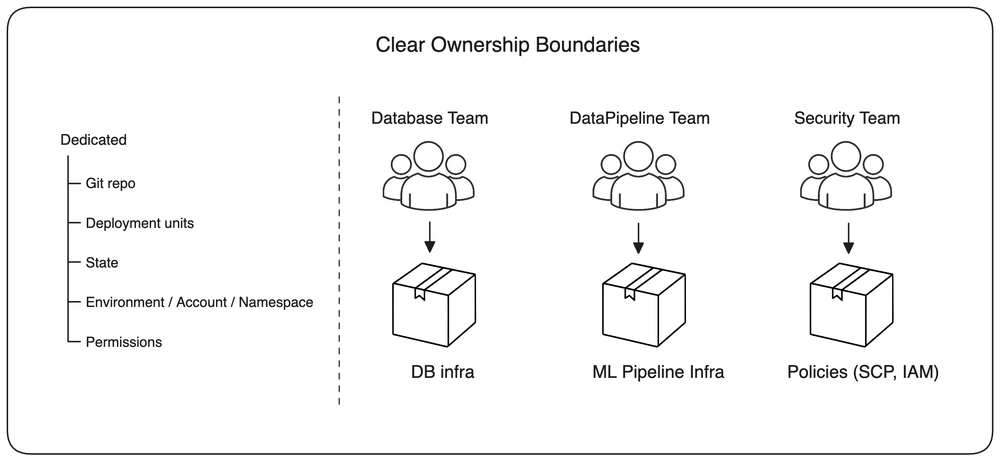
Chaque ressource d’infrastructure a exactement une équipe propriétaire — son propre repo, son propre fichier d’état, son propre compte ou namespace, son propre IAM. !!Un état partagé entre équipes, c’est un rayon d’impact partagé.!! L’équipe Database possède l’infra des bases, l’équipe Data Pipeline ses pipelines ML, l’équipe Security les SCP et l’IAM — personne ne va chez les autres, personne ne modifie l’état d’une autre équipe. !!C’est ce qui permet à l’infrastructure de passer à l’échelle d’une organisation sans que chaque changement devienne une réunion de coordination inter-équipes.!!
Regrouper l’infrastructure par schéma de changement
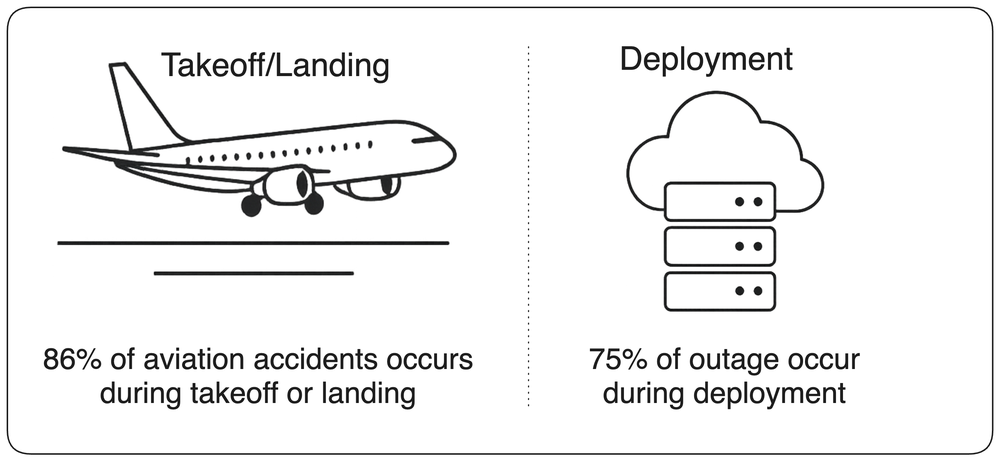
Organisez le code d’infrastructure selon la fréquence à laquelle les éléments changent ensemble, pas selon ce qu’ils sont conceptuellement. !!Le réseau de base qui change une fois par trimestre ne devrait pas partager une unité de déploiement avec des security groups applicatifs qui changent chaque semaine — un petit changement applicatif ne devrait pas mettre le VPC en danger.!! !!Regroupez ce qui change ensemble, séparez ce qui ne change pas ensemble.!! Ce n’est pas du rangement ; c’est de la gestion du rayon d’impact. Borner ce que chaque déploiement peut toucher est ce qui rend l’évolution de l’infrastructure sûre à grande échelle.
Redémarrer régulièrement les systèmes
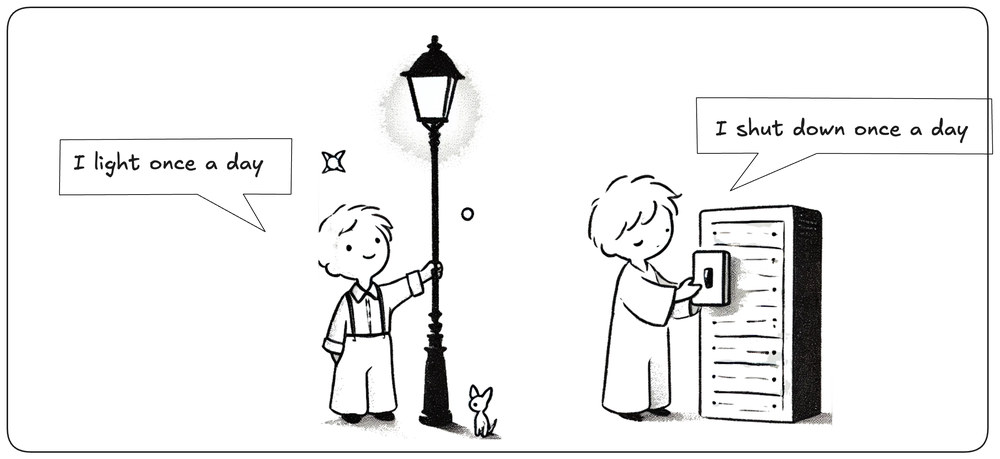
Les systèmes longue durée accumulent un état caché — fuites mémoire, caches périmés, processus qui ont oublié pourquoi ils ont été lancés, dérive de configuration que personne n’a remarquée. !!Redémarrer selon un calendrier — quotidien, hebdomadaire — efface tout cela et force le système à prouver qu’il sait revenir.!! !!Si votre système ne survit pas à un redémarrage planifié, il ne survivra pas à un redémarrage imprévu.!! Les arrêts planifiés sont une répétition contrôlée des pannes qui finiront de toute façon par arriver, et ils révèlent les points fragiles pendant que vous regardez.
Tester régulièrement la sauvegarde et la restauration
Des sauvegardes dont on découvre qu’elles sont cassées pendant un vrai sinistre ne sont pas des sauvegardes — c’est de l’espoir. !!Les organisations découvrent régulièrement que leurs scripts de snapshot échouent en silence depuis des mois, que le chemin de restauration n’a jamais été câblé, ou que le temps de récupération est 10 fois celui que promettait le RTO.!! !!Des sauvegardes non testées, c’est de l’espoir ; des sauvegardes testées, c’est une assurance.!! Menez de vrais exercices de récupération dans des environnements isolés, vérifiez l’intégrité, mesurez le temps de restauration réel par rapport au SLO, et faites tourner l’équipe qui mène l’exercice — le but est que le prochain sinistre soit ennuyeux, pas surprenant.