Concevoir pour la haute disponibilité
Chapter Info
Calculating... Writing Progress: 30%
La disponibilité est la monnaie silencieuse du logiciel moderne. Les utilisateurs ne la remarquent pas quand elle fonctionne ; ils s’en souviennent quand elle fait défaut. La question d’architecture est précise : comment concevoir un système pour que les défaillances attendues et les transitions planifiées ne rendent pas le service indisponible ?
Ce chapitre part de l’exigence de disponibilité pour aller vers les domaines de défaillance que le système doit survivre, puis l’indépendance de la redondance, le basculement des données et de la capacité de service, la distribution géographique, les changements planifiés, les dépendances IA et la validation. L’operability couvre les pratiques opérationnelles, la résilience couvre la gestion des défaillances au niveau applicatif, et le release management couvre les techniques de déploiement ; la disponibilité utilise leurs résultats comme données d’entrée architecturales.
Concepts fondamentaux
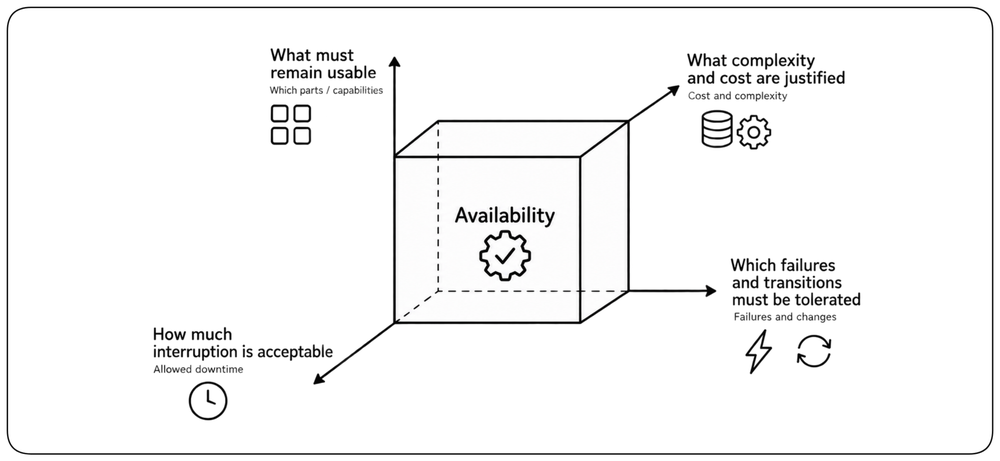
La disponibilité est la capacité d’un système à rester utilisable lorsque des défaillances surviennent ou pendant que des changements planifiés ont lieu. En tant que propriété de conception, elle comporte plusieurs dimensions : ce qui doit rester utilisable, quelles défaillances et transitions doivent être tolérées, quelle interruption est acceptable, et quelle complexité et quel coût sont justifiés pour y parvenir.
Ce que promet la haute disponibilité
Les défaillances attendues et les changements planifiés ne doivent pas rendre le service indisponible au-delà de l’exigence de disponibilité définie. La haute disponibilité (HA) préserve un service utile malgré les défaillances et les transitions que l’architecture est conçue pour tolérer. Une interruption peut encore se produire, mais elle reste dans la limite acceptable.
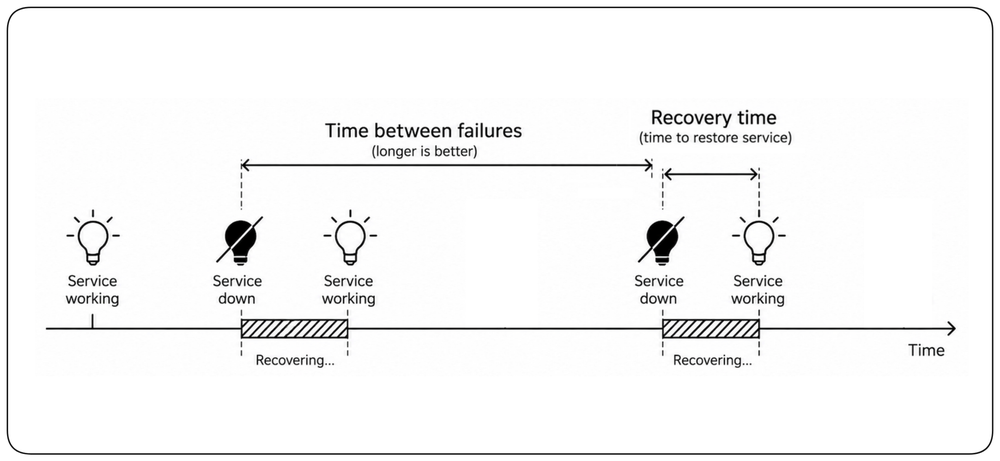
Fréquence des défaillances et récupération
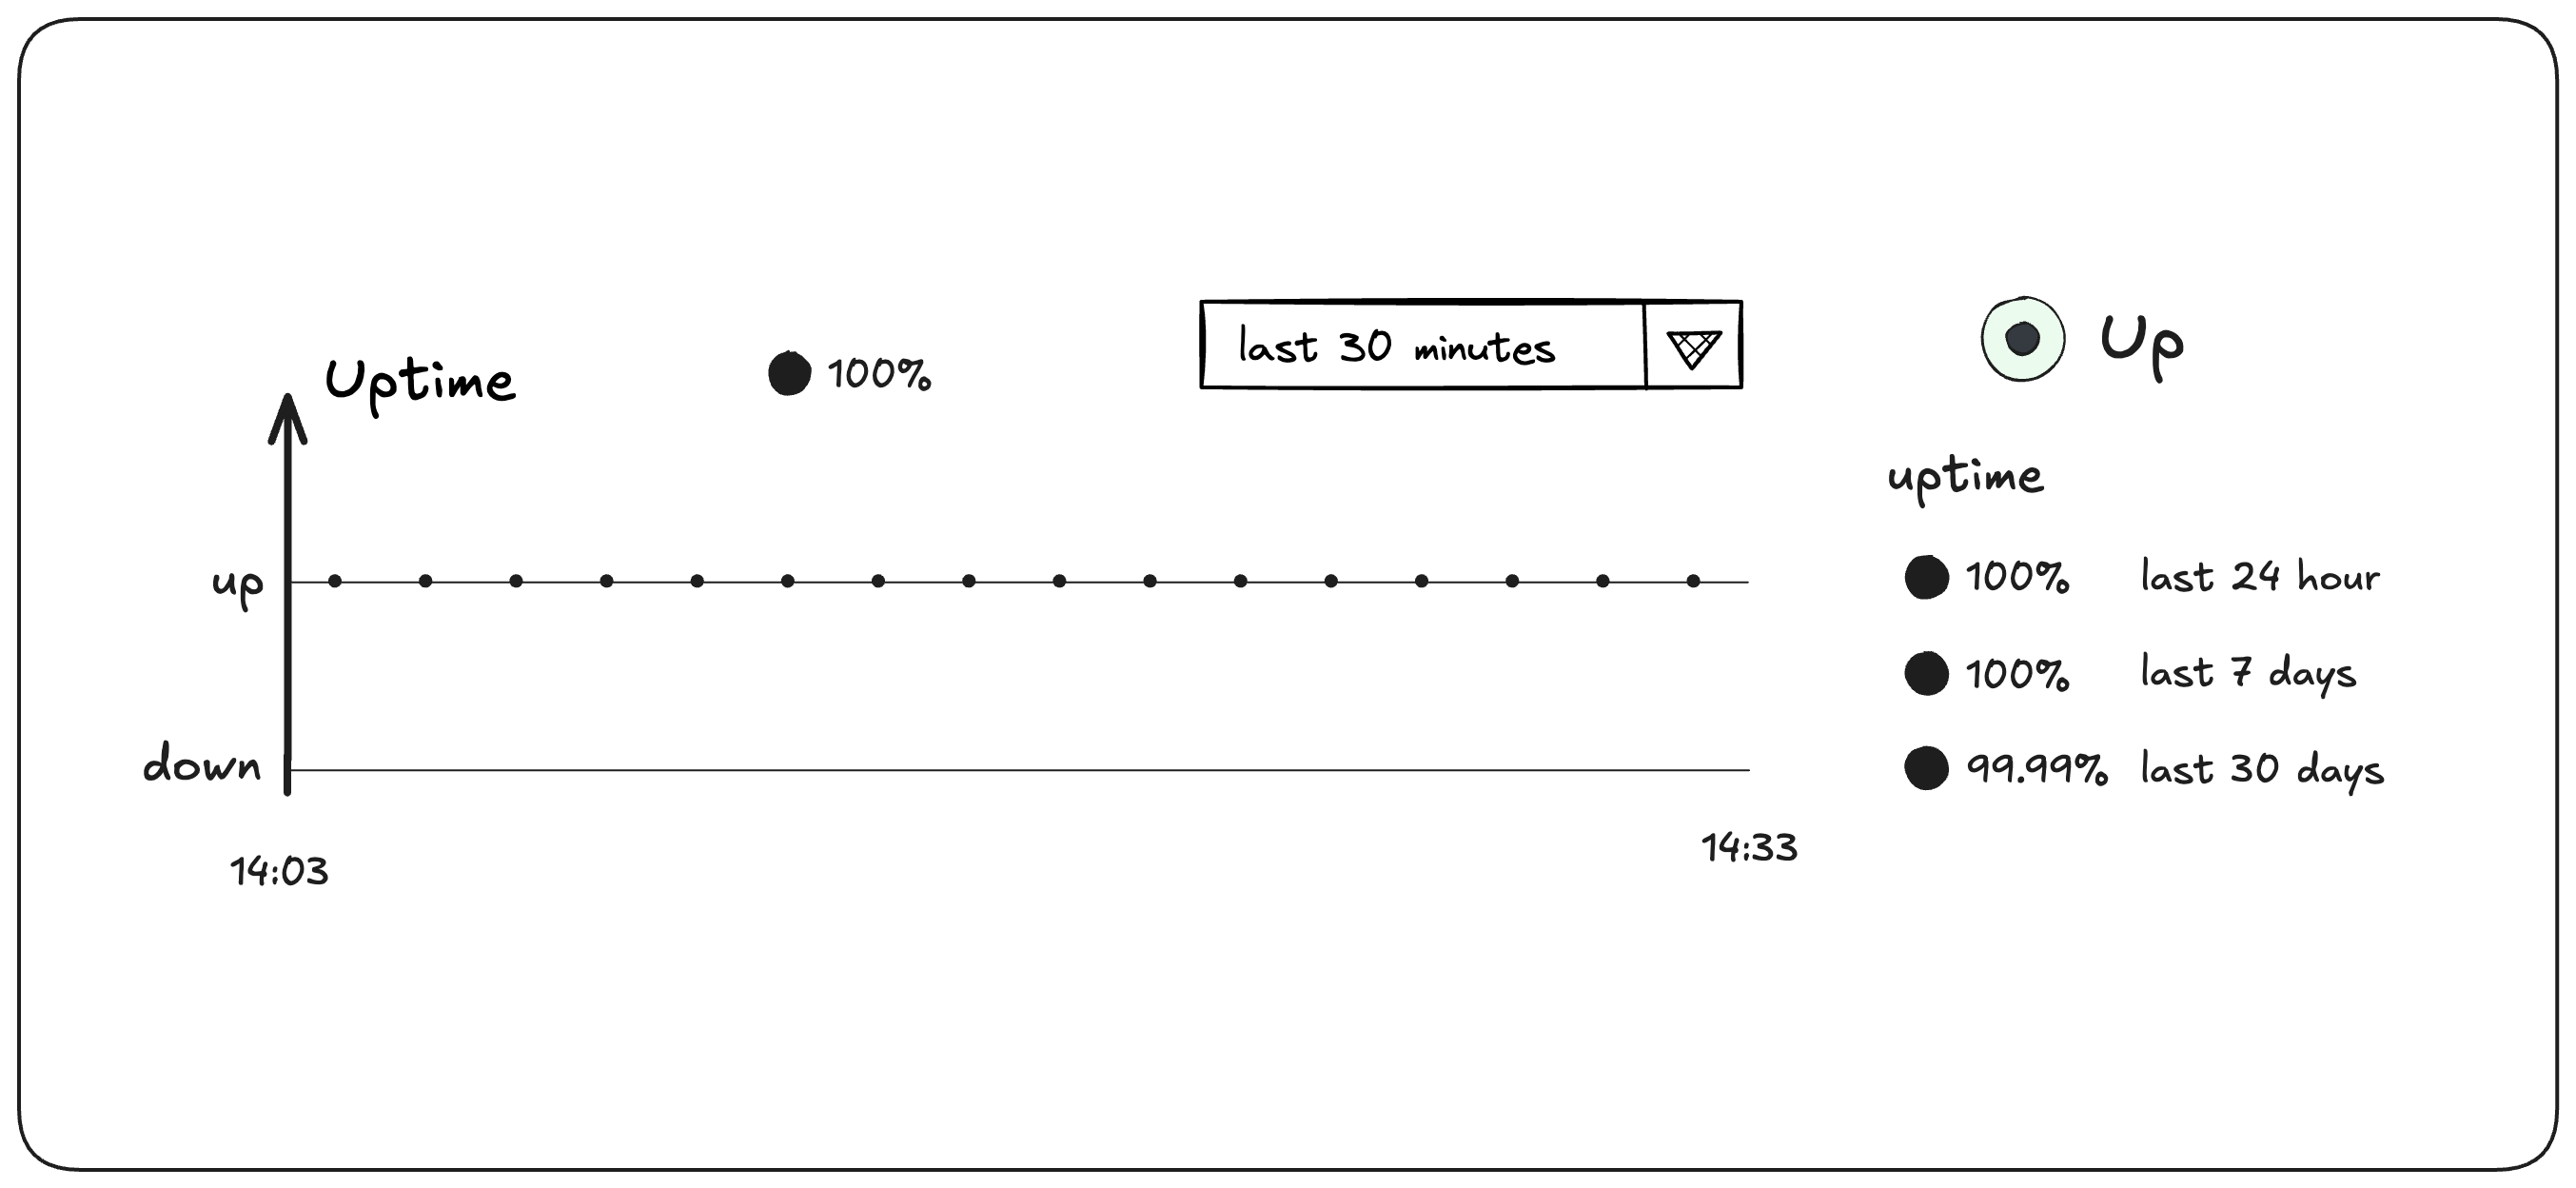
Deux propriétés ont un impact majeur sur la disponibilité : !!la fréquence à laquelle les défaillances affectent le service et la rapidité avec laquelle le système récupère lorsqu’elles surviennent.!! Comme les défaillances ne peuvent pas être totalement éliminées, l’architecture doit traiter les deux : réduire leur fréquence et récupérer rapidement quand elles se produisent.
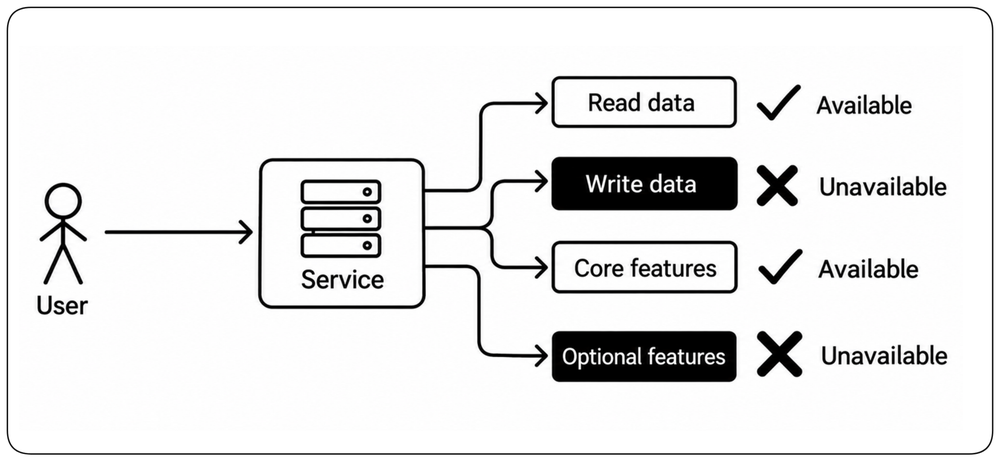
La disponibilité n’est pas binaire
Un système n’est pas obligé d’être entièrement en service ou entièrement hors service. !!L’architecture doit définir quelles capacités doivent rester disponibles lorsque certaines défaillances surviennent.!! Les lectures peuvent continuer pendant que les écritures s’arrêtent, ou les fonctions essentielles rester disponibles pendant que les fonctions optionnelles disparaissent. La disponibilité doit donc être conçue et évaluée par capacité utilisateur, et pas seulement pour le système dans son ensemble.
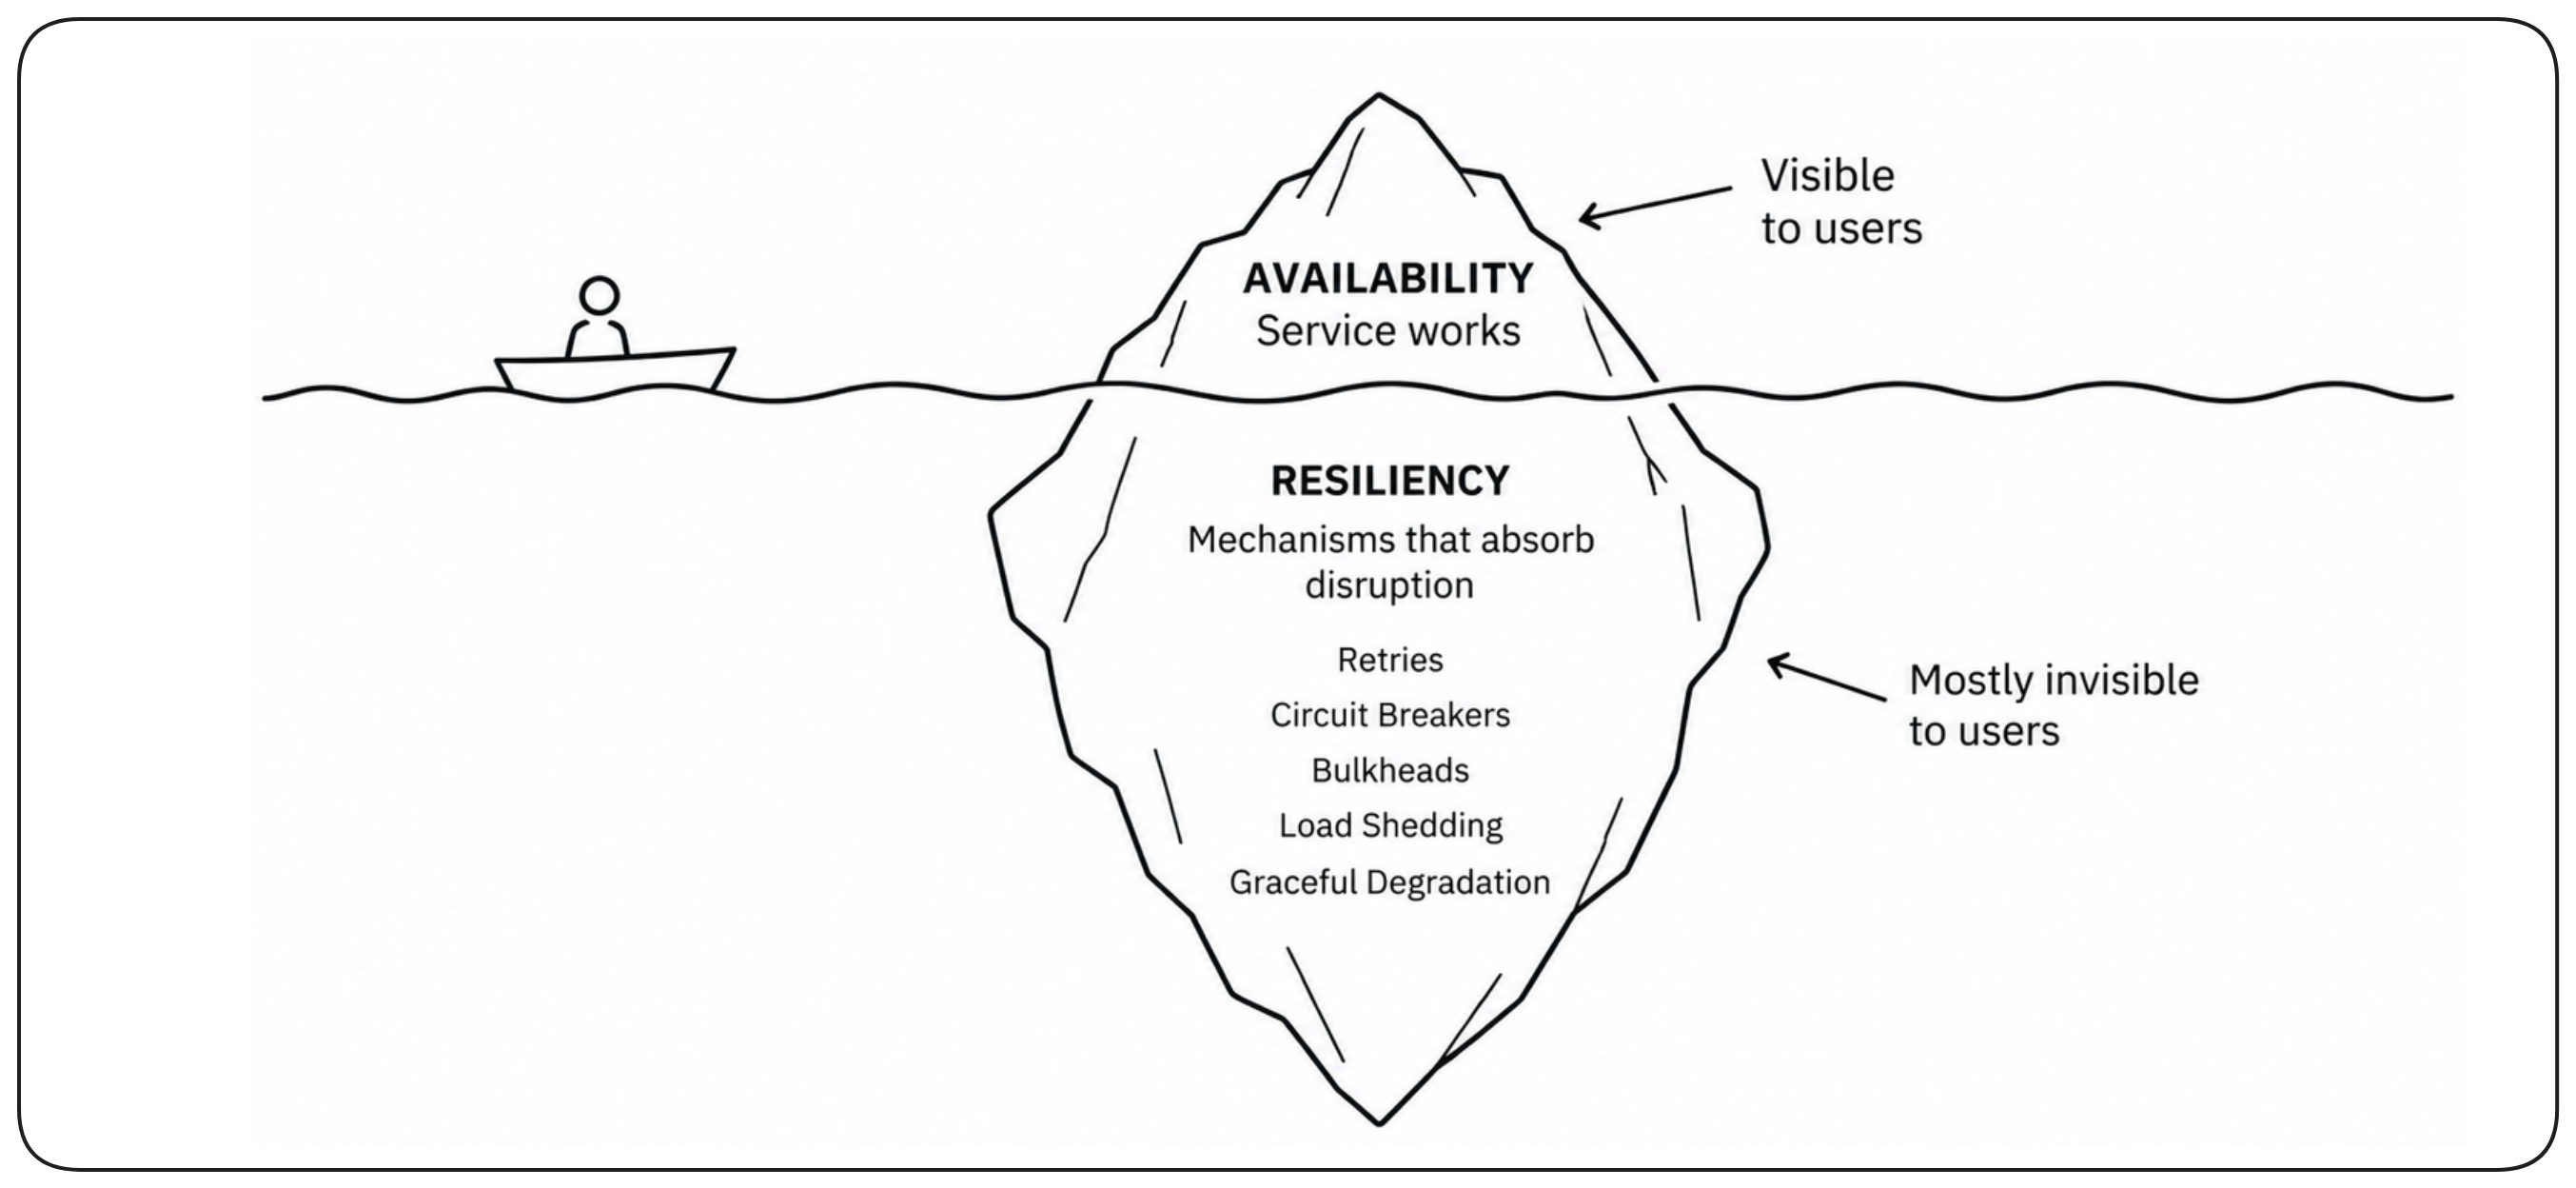
Disponibilité vs résilience
La disponibilité et la résilience abordent la défaillance sous des angles différents. La disponibilité définit si le service, le calcul et les données requis restent utilisables malgré la perturbation. La résilience décrit comment l’application absorbe la perturbation grâce à des patterns tels que les retries, les circuit breakers et la dégradation progressive. !!La résilience aide à préserver la disponibilité, mais la disponibilité est le résultat visible par l’utilisateur.!! Ce chapitre se concentre sur l’architecture de disponibilité ; la gestion des défaillances au niveau applicatif relève de la résilience.
Pour aller plus loin
Chapitre : Concevoir pour la résilience.
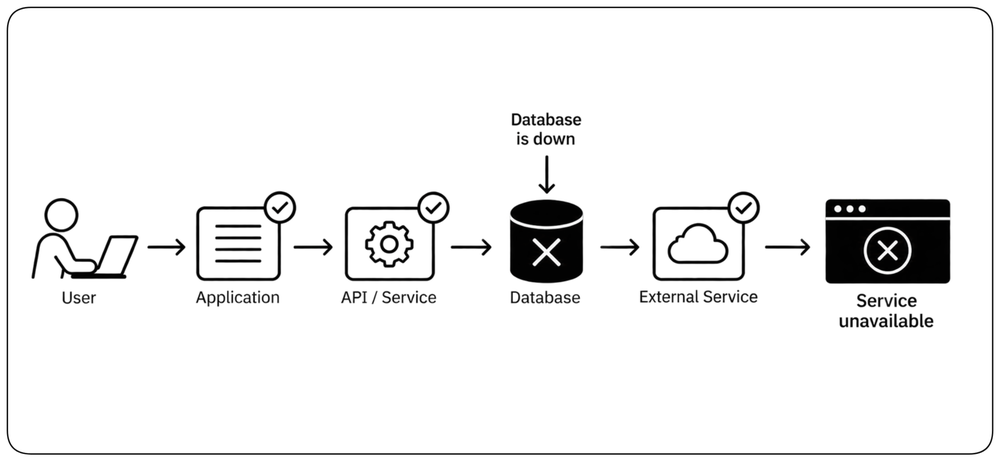
La disponibilité est une propriété de bout en bout
Un service n’est disponible que si le chemin complet nécessaire pour fournir une capacité utilisateur est disponible. Des composants hautement disponibles ne garantissent pas un système hautement disponible si la requête dépend encore d’une base de données, d’un chemin réseau, d’un service d’identité ou d’un fournisseur externe plus faible. !!La disponibilité doit donc être raisonnée depuis la capacité visible par l’utilisateur jusqu’à chaque dépendance nécessaire pour la fournir.!!
Définir l’exigence de disponibilité — les neuf
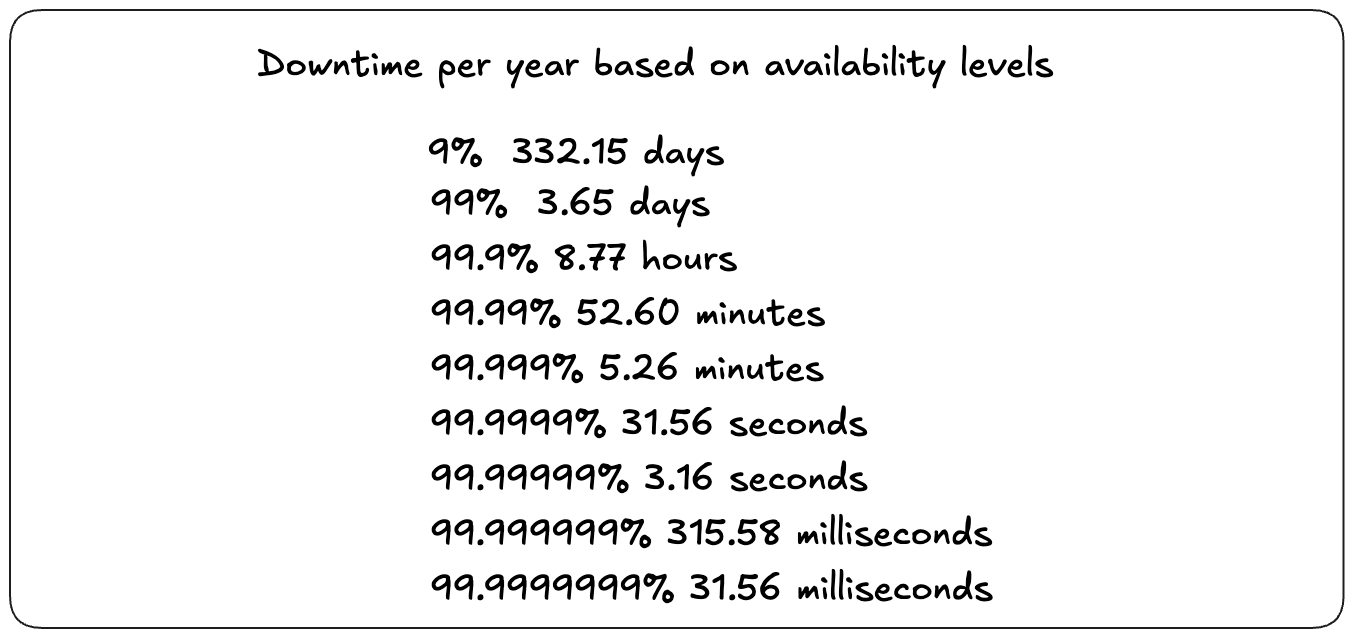
Une exigence de disponibilité définit !!quelle interruption un service est autorisé à exposer sur une période donnée!!. Elle s’exprime couramment en pourcentage du temps pendant lequel le service doit rester disponible — les « neuf ». 99 % autorise environ 7,3 heures d’indisponibilité par mois, 99,9 % environ 44 minutes, 99,99 % environ 4,4 minutes et 99,999 % environ 26 secondes. L’exigence appropriée dépend de la valeur et de la criticité du service.
Laisser l’exigence guider l’architecture
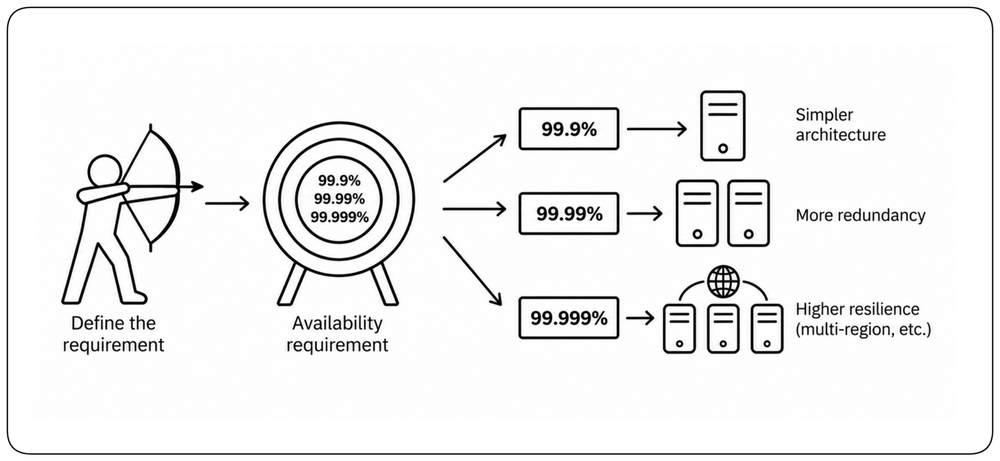
Des exigences de disponibilité différentes mènent à des architectures différentes. !!L’exigence détermine quelles défaillances doivent être tolérées, quelle redondance et quelle capacité de réserve sont nécessaires, et à quelle vitesse le basculement doit s’achever.!! Un système conçu pour 99,9 % peut faire des compromis très différents de ceux d’un système conçu pour 99,99 % ou 99,999 %. Par exemple, Google Cloud DNS est le seul service Google Cloud qui garantit une disponibilité de 100 %.
Pour aller plus loin
Chapitre : Concevoir pour l’operability.
Plus de disponibilité ajoute de la complexité
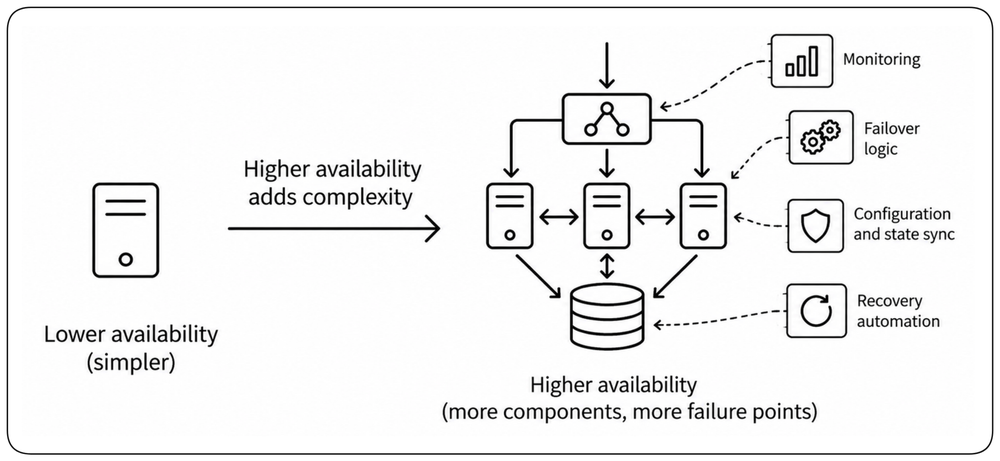
Une disponibilité plus élevée exige généralement plus de composants, plus de coordination, plus de transitions d’état et plus de gestion des défaillances. !!Les mécanismes introduits pour prévenir les pannes peuvent eux-mêmes créer de nouveaux modes de défaillance.!! La disponibilité ne s’améliore que si la protection apportée par l’architecture dépasse la complexité et les dépendances qu’elle introduit.
Choisir la disponibilité qui vaut son prix
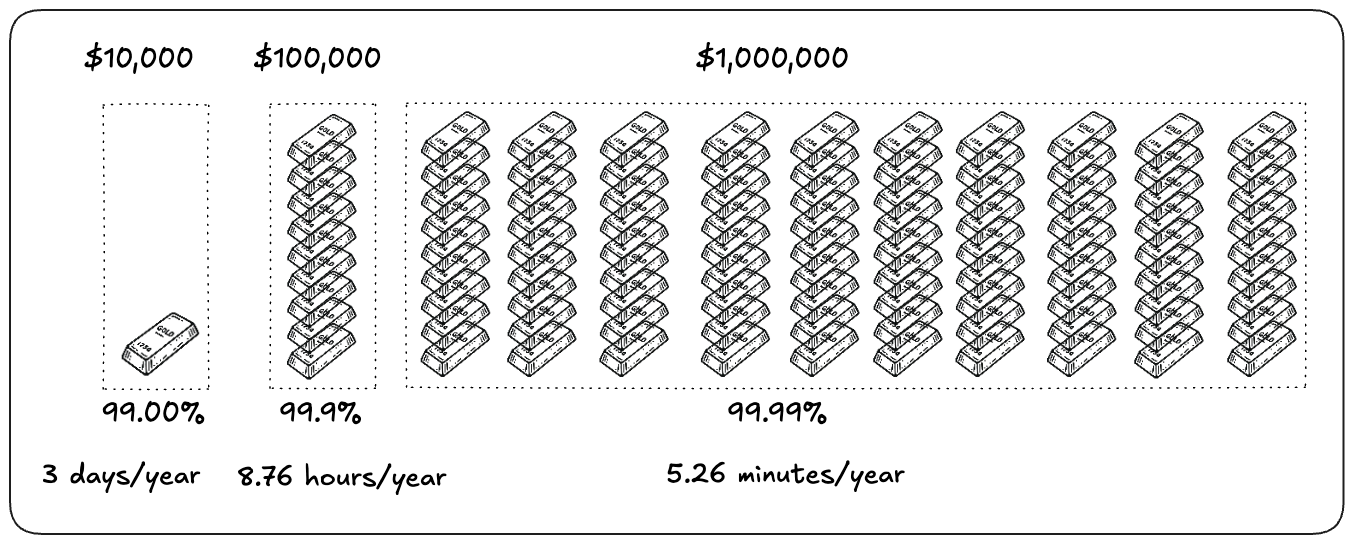
Chaque niveau de disponibilité supplémentaire protège contre davantage de scénarios de défaillance, si bien que son coût grimpe rapidement — plus de redondance, de capacité de réserve, d’automatisation et d’isolation des défaillances, dont une partie sous forme de capacité volontairement inutilisée. Comme l’indisponibilité a aussi un coût business réel, l’exigence de disponibilité rationnelle se situe au point où éviter davantage d’indisponibilité vaut plus que l’architecture qu’elle impose.
Services managés : transférer la complexité, garder la simplicité
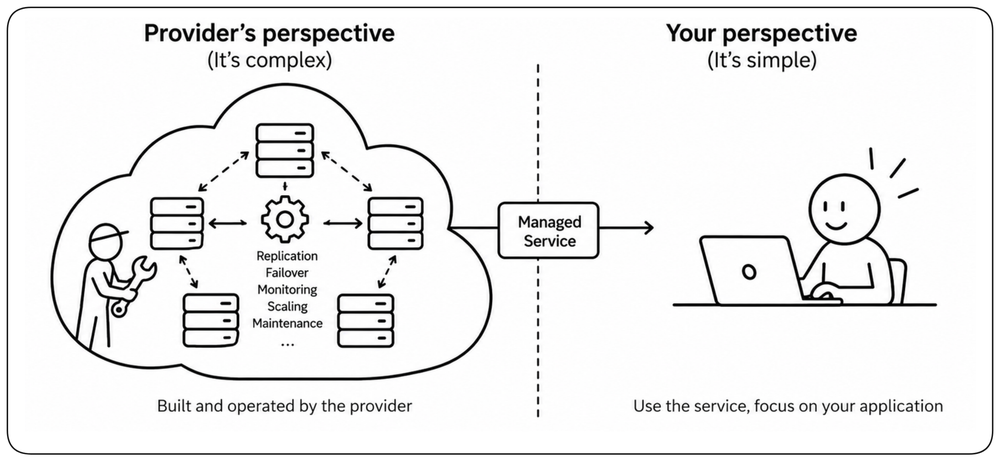
La haute disponibilité n’exige pas toujours de construire et d’exploiter soi-même chaque mécanisme de redondance. Les services managés peuvent masquer la réplication, le basculement, le remplacement d’infrastructure et la coordination derrière une frontière de service plus simple. !!Ils permettent à votre architecture de rester plus simple en transférant une partie de la complexité de disponibilité au fournisseur.!! La complexité existe toujours : comprenez les garanties et les domaines de défaillance du fournisseur avant de dépendre de lui.
Identifier ce que le système doit survivre
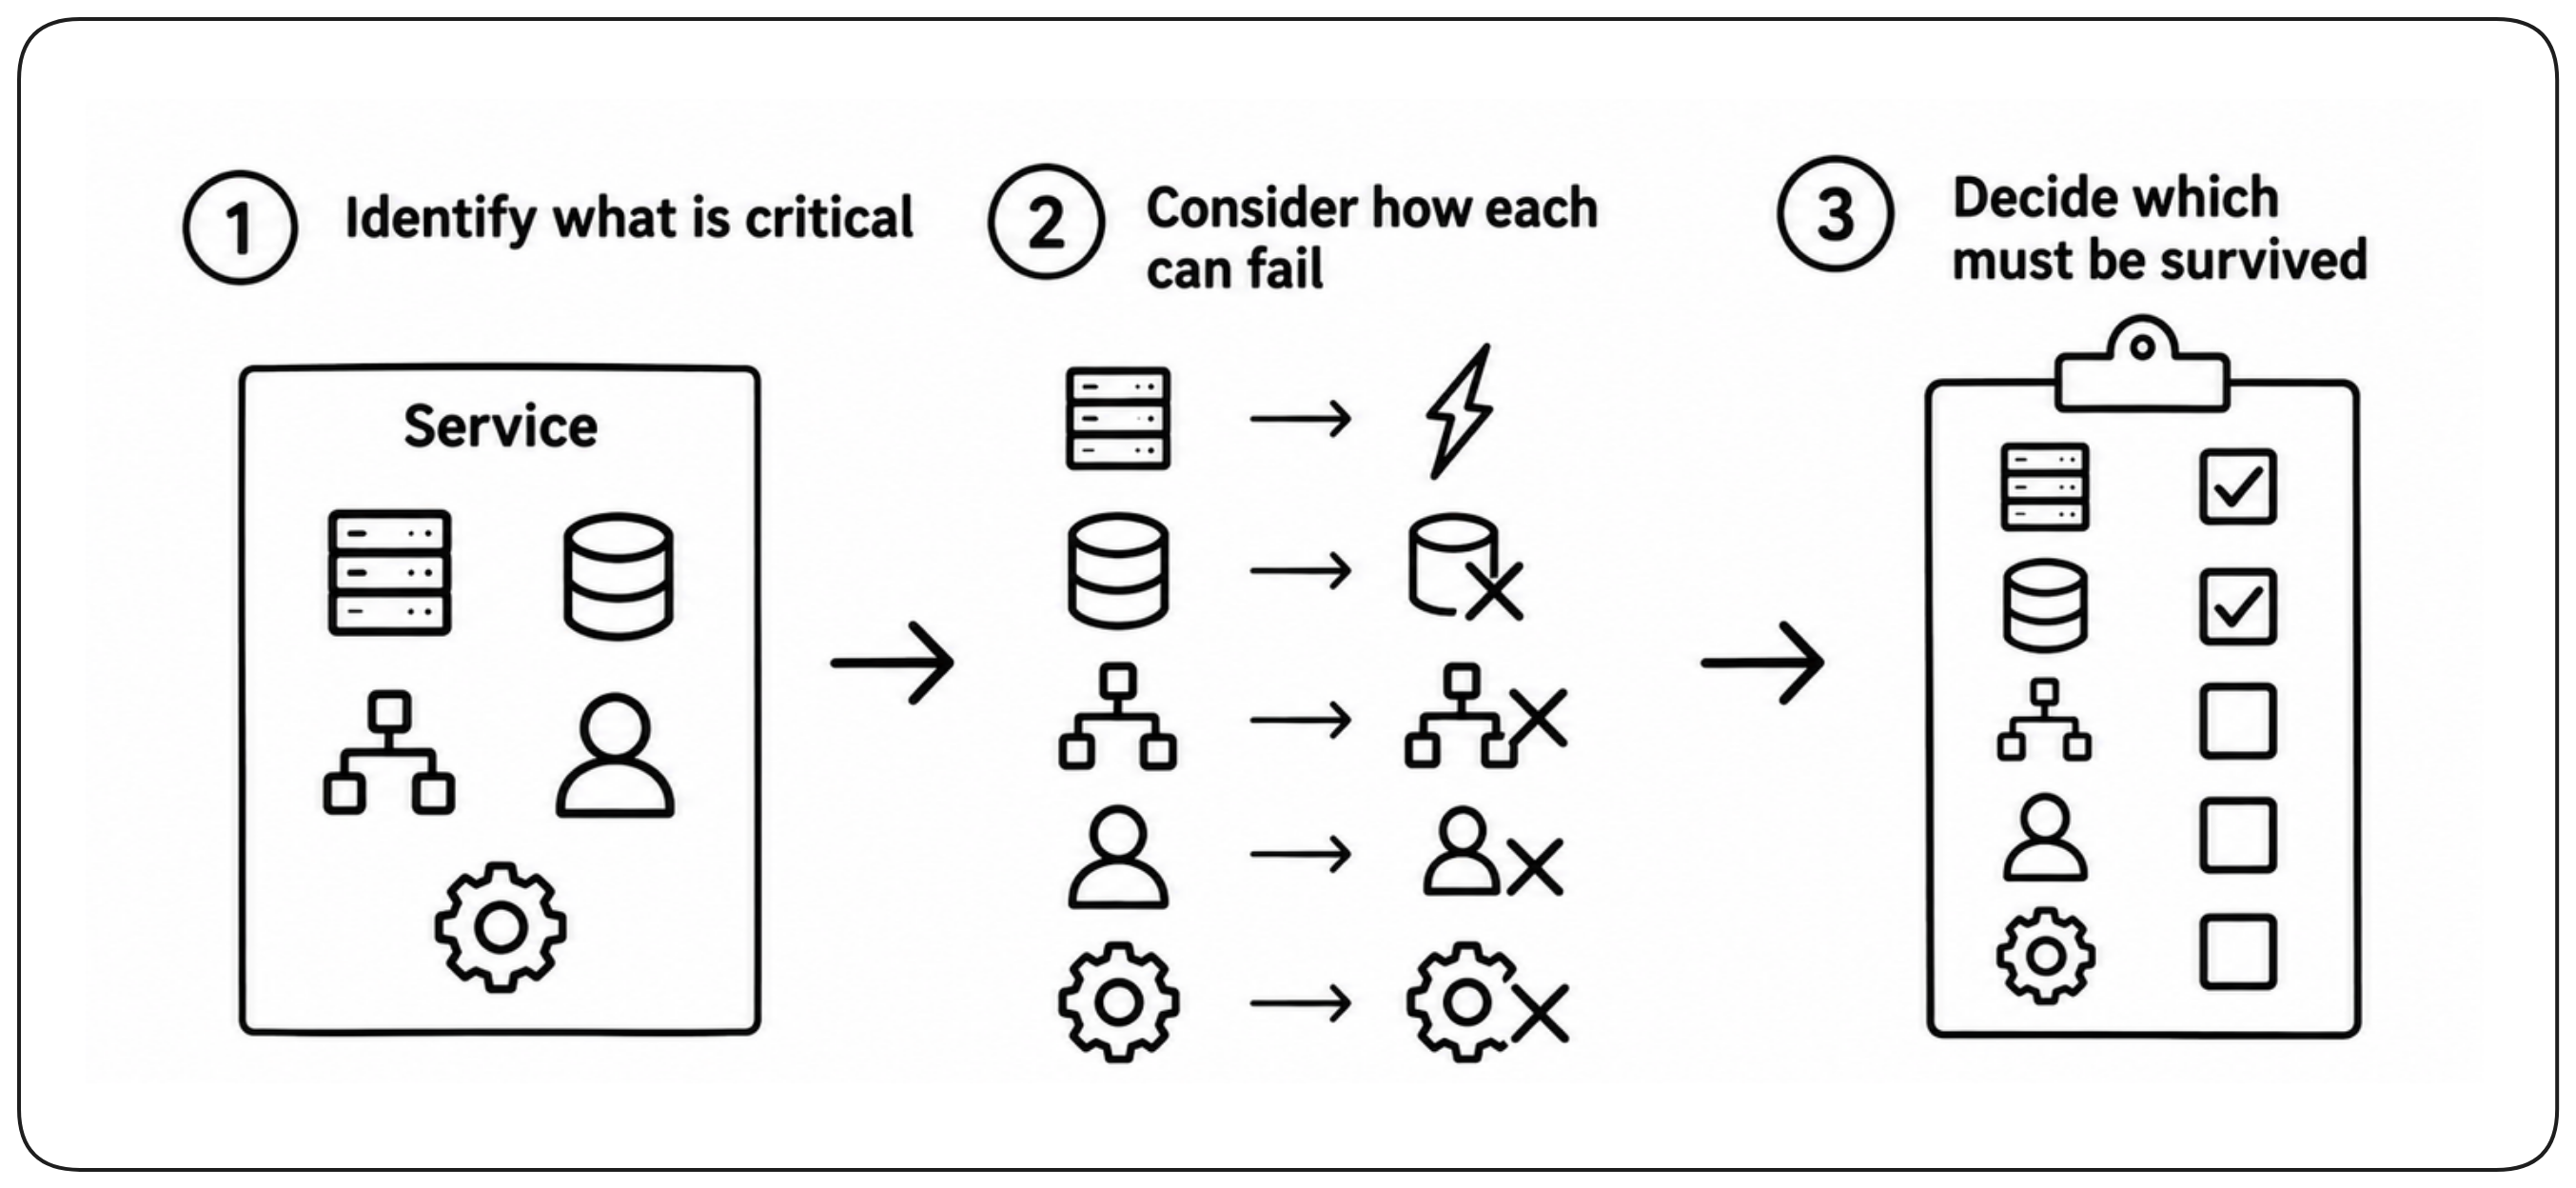
La conception de la disponibilité commence par identifier les composants et dépendances critiques dont le service a besoin pour rester fonctionnel. Le calcul, les data stores, les chemins réseau, les systèmes d’identité et les services externes peuvent chacun devenir indisponibles de manière différente. L’architecture doit comprendre ces dépendances et les défaillances qui peuvent les supprimer, puis déterminer quelles défaillances le service doit survivre.
Concevoir autour des domaines de défaillance
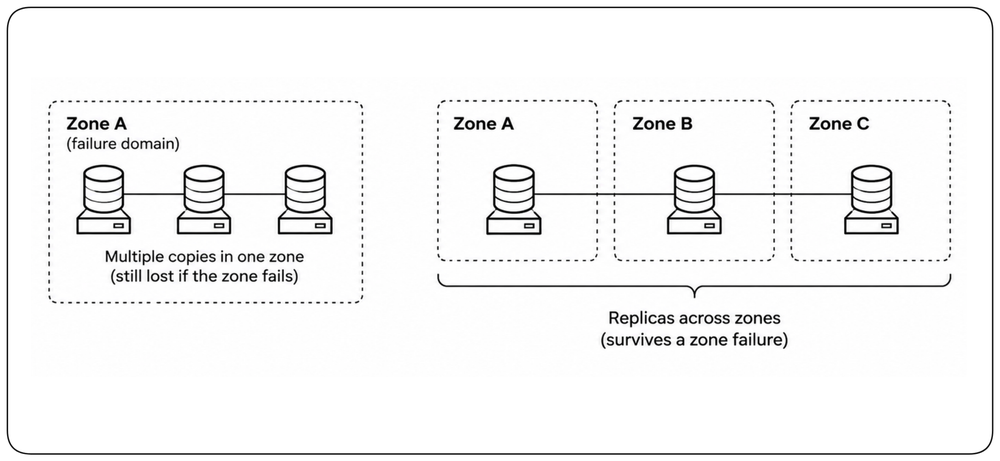
Un domaine de défaillance est une frontière à l’intérieur de laquelle des composants peuvent tomber ensemble. Deux instances sur le même hôte protègent contre une défaillance de processus mais pas contre une défaillance d’hôte ; deux hôtes dans une même zone protègent contre une défaillance d’hôte mais pas contre une défaillance de zone. !!L’architecture de disponibilité doit placer la capacité survivante requise en dehors du domaine de défaillance qu’elle promet de tolérer.!!
Trouver les points uniques de défaillance (SPOF)
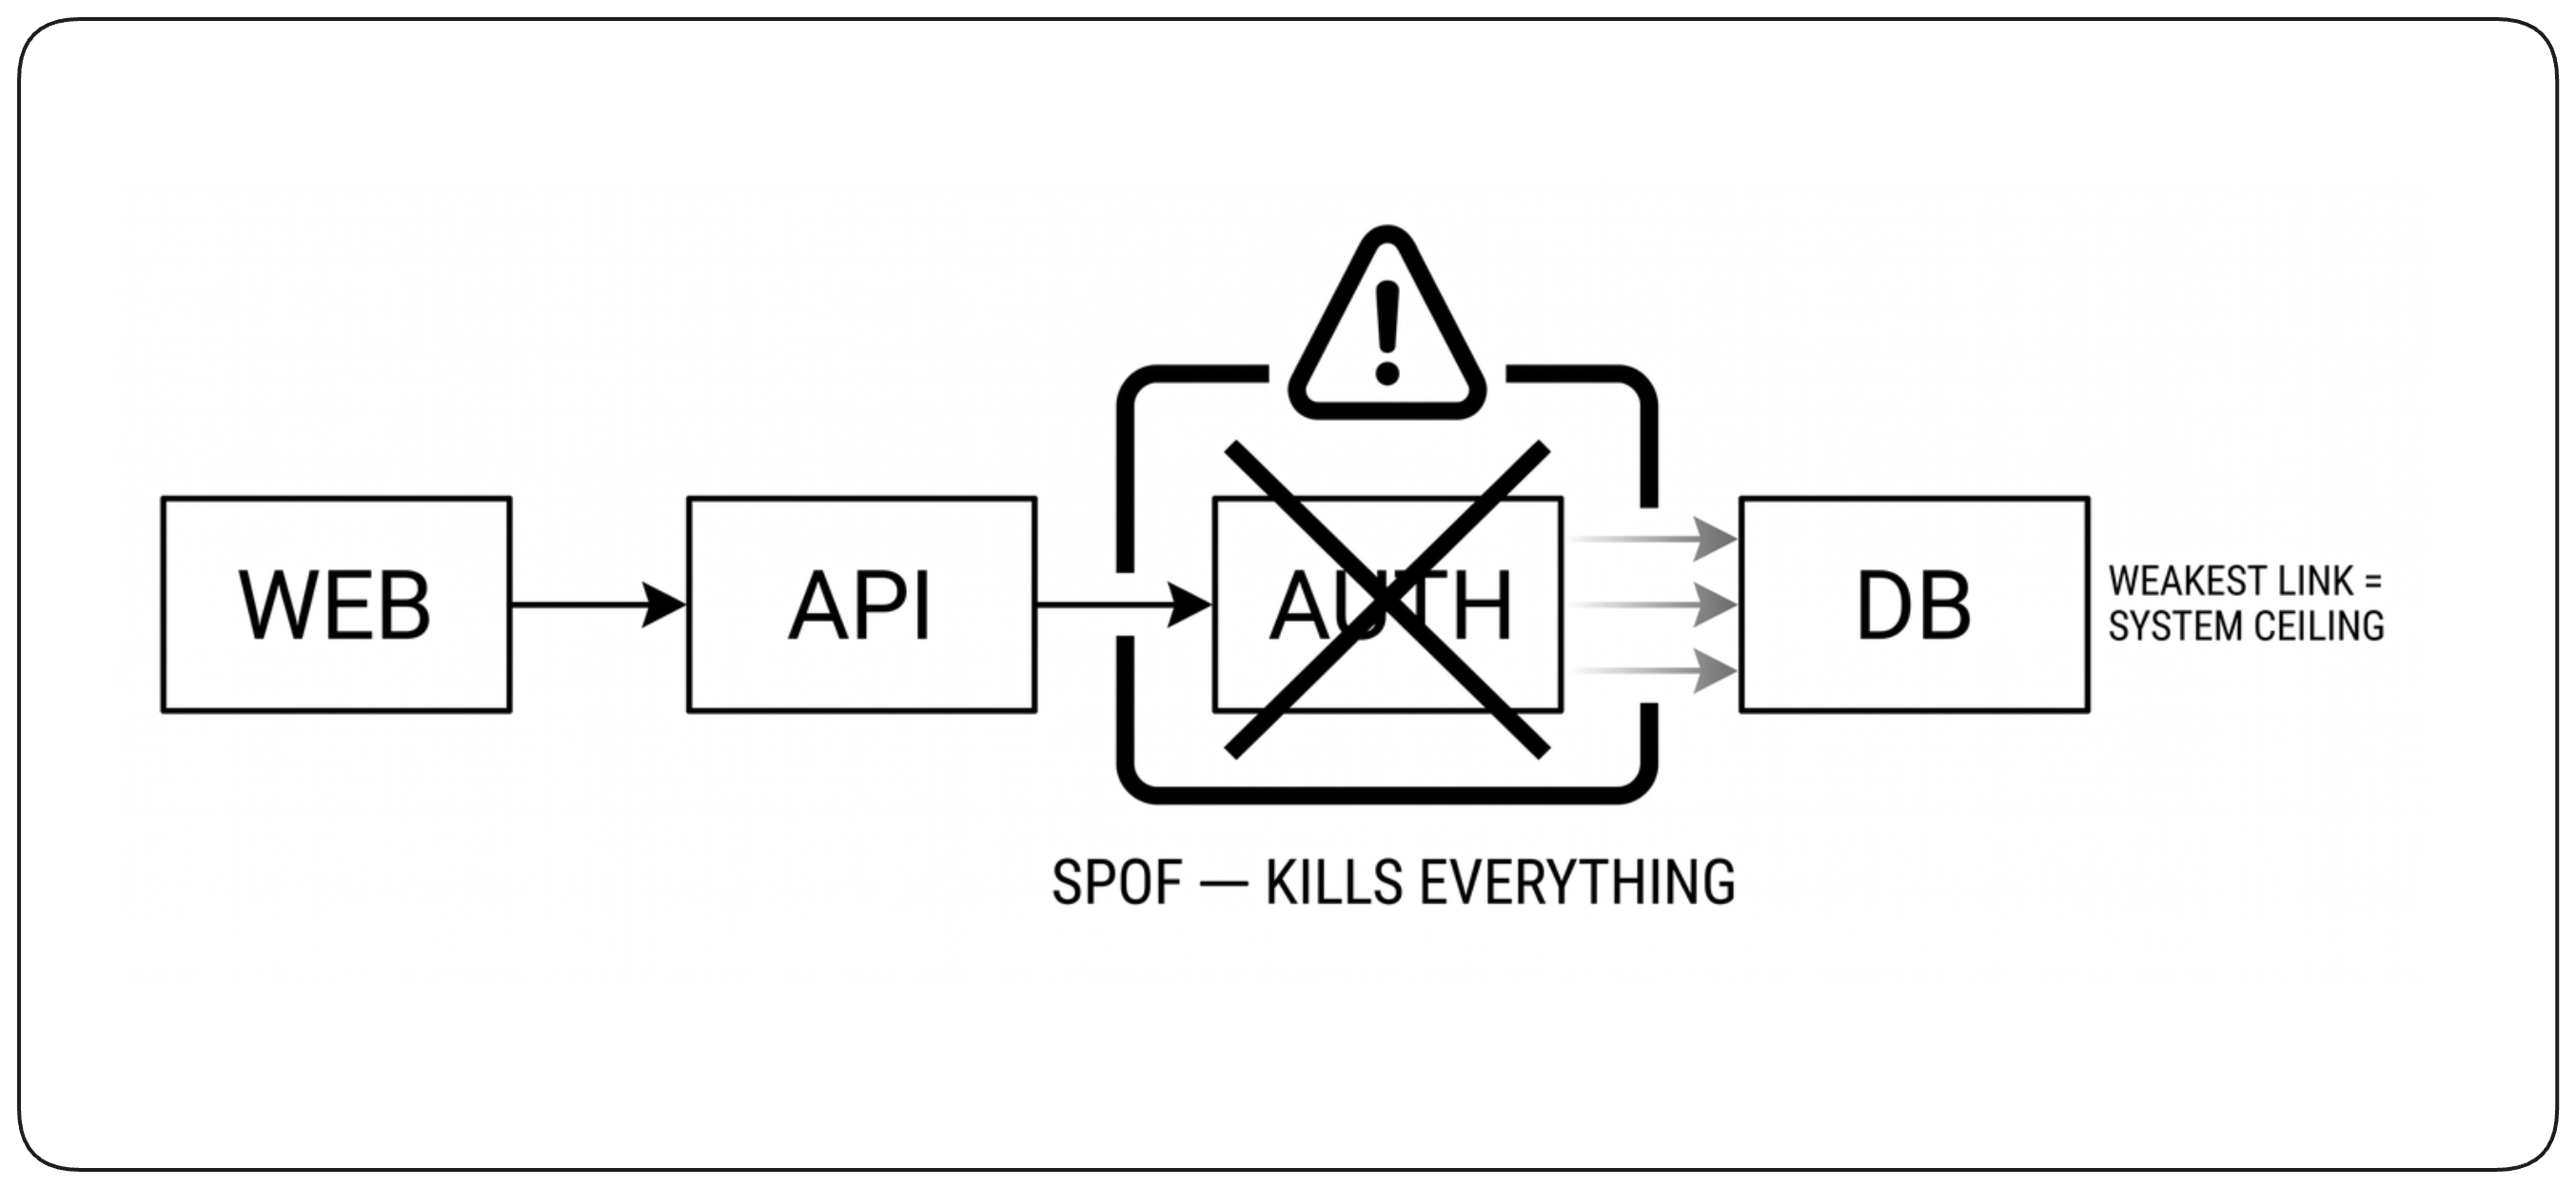
Un point unique de défaillance est tout composant dont la perte peut supprimer la capacité entière qu’il fournit. !!Parcourez chaque chemin de requête critique et demandez-vous, à chaque composant, dépendance et control plane : que se passe-t-il si cet élément disparaît maintenant ?!! Les SPOF évidents incluent une base de données ou un load balancer unique ; les SPOF cachés incluent le DNS partagé, l’identité, les chemins réseau et les services externes. Une capacité de data plane répliquée peut encore dépendre d’un seul control plane pour la découverte, les certificats, le routage ou la configuration.
Le problème de la chaîne de dépendances
Chaque dépendance requise ajoute une exposition à la défaillance pour la capacité visible par l’utilisateur. Comme une requête a besoin que toutes les dépendances requises soient disponibles en même temps, leurs disponibilités se composent. !!La disponibilité de bout en bout baisse donc à mesure que l’on ajoute des dépendances requises, même si chacune est hautement disponible.!! Même si chaque dépendance est individuellement redondante, le service échoue dès qu’une dépendance requise est indisponible. Traitez les dépendances externes critiques comme des domaines de défaillance et réduisez les liens synchrones inutiles ; le comportement de repli au niveau applicatif relève de la résilience.
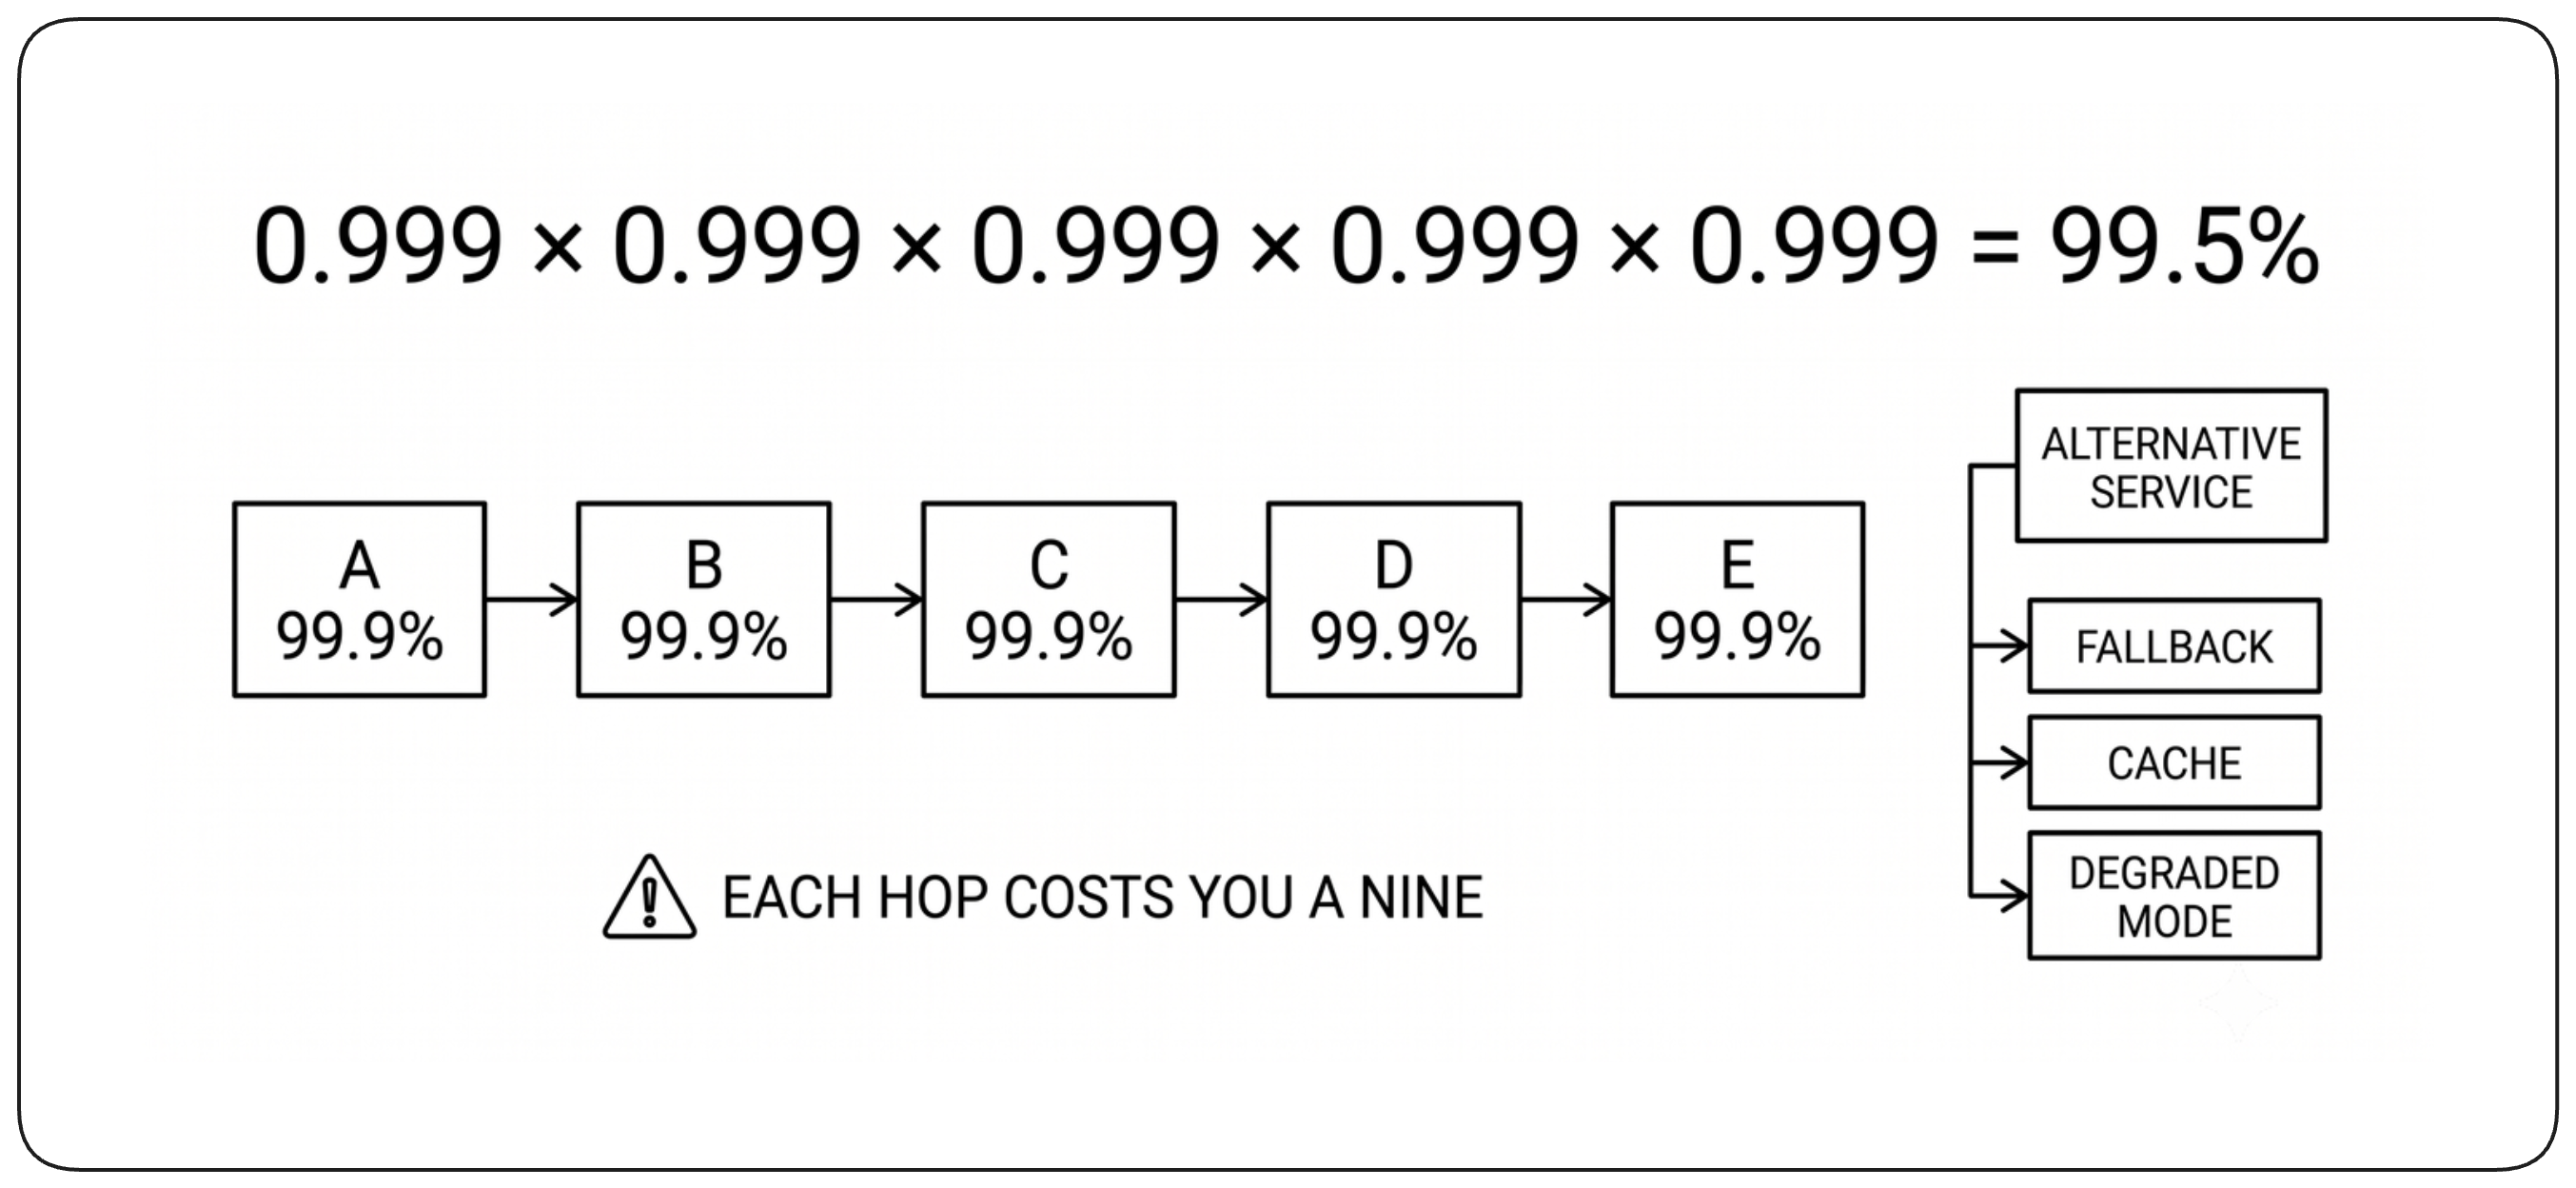
Les dépendances externes fixent votre plafond de disponibilité
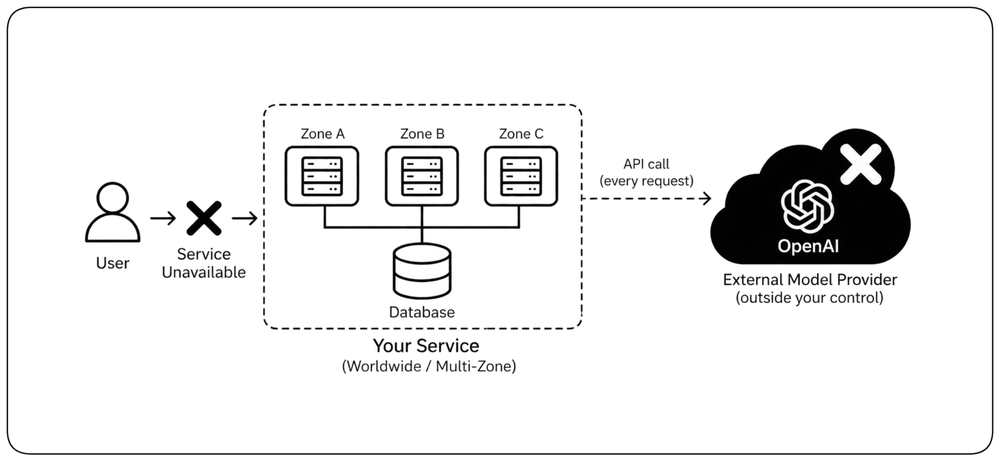
Une dépendance critique hors de votre contrôle peut limiter la disponibilité de l’ensemble de votre service. Si chaque requête dépend d’une API externe, d’un fournisseur de modèles, d’un service de paiement ou d’un fournisseur d’identité, sa panne devient la vôtre. !!Soit vous acceptez cette dépendance comme faisant partie de votre plafond de disponibilité, soit vous fournissez un chemin indépendant qui maintient la capacité critique en état de marche sans elle.!!
Construire une redondance indépendante
Une fois les domaines de défaillance requis connus, l’architecture doit déterminer comment le service continue lorsque l’un d’eux est perdu. La redondance est le fondement de cette conception.
La redondance préserve la capacité
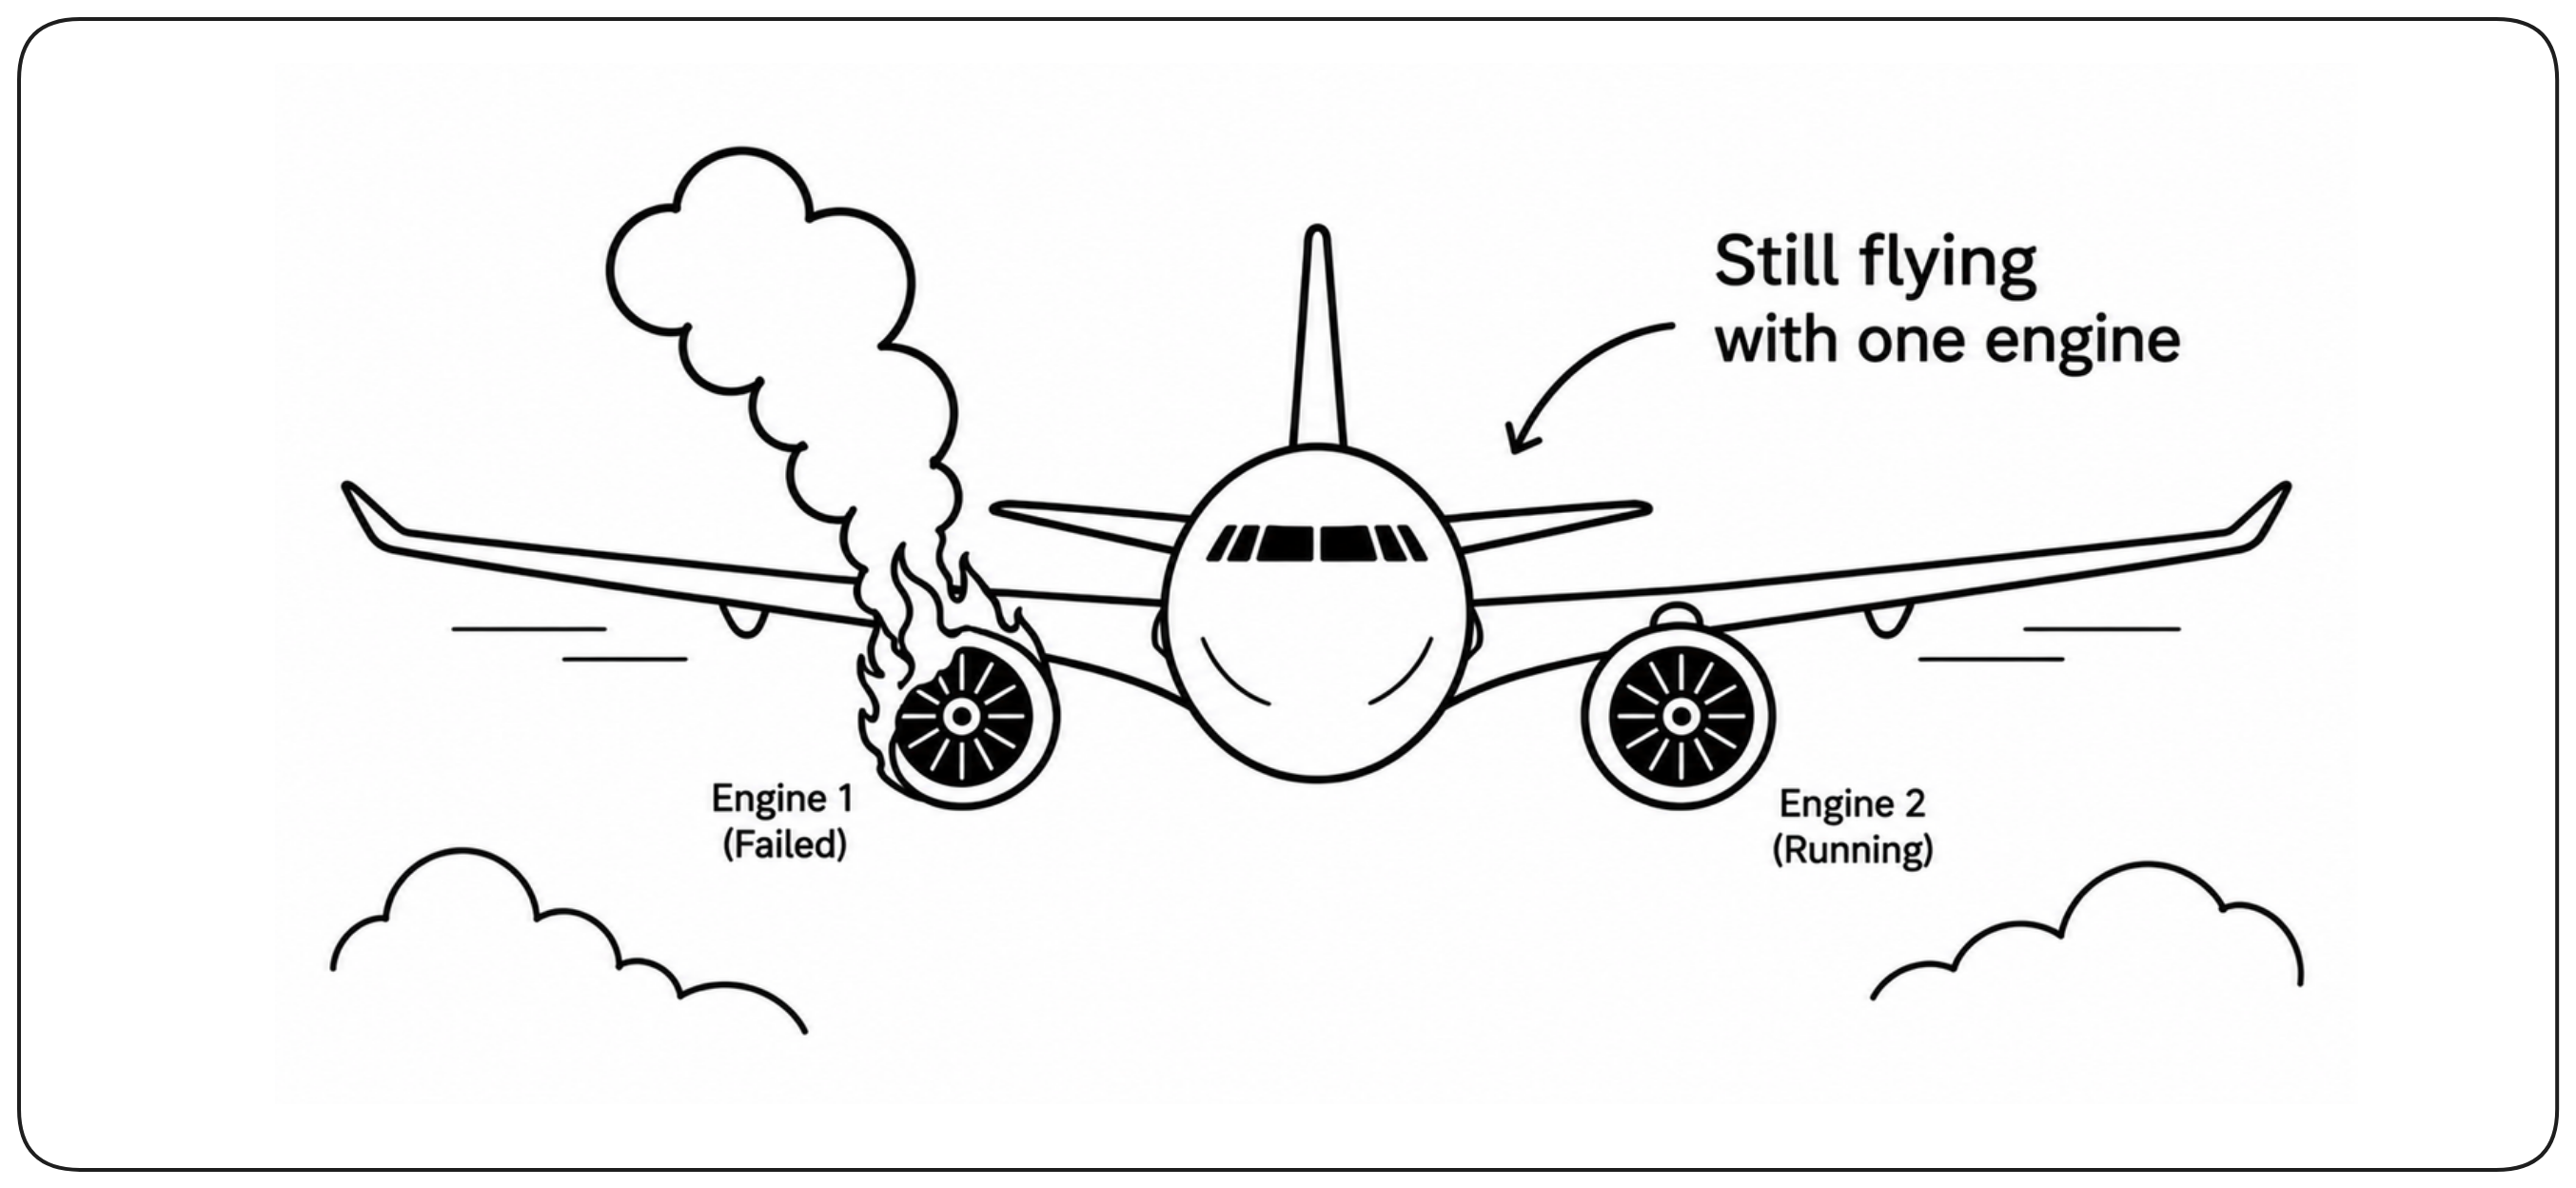
La haute disponibilité repose sur la redondance : lorsqu’une partie du système tombe, un autre chemin doit encore fournir la capacité critique. !!La capacité survivante doit être suffisante pour supporter la charge requise.!! La redondance n’est donc pas de la duplication pour elle-même ; c’est ce qui permet au service de continuer lorsqu’une partie du système est perdue.
Éliminer les points uniques de défaillance
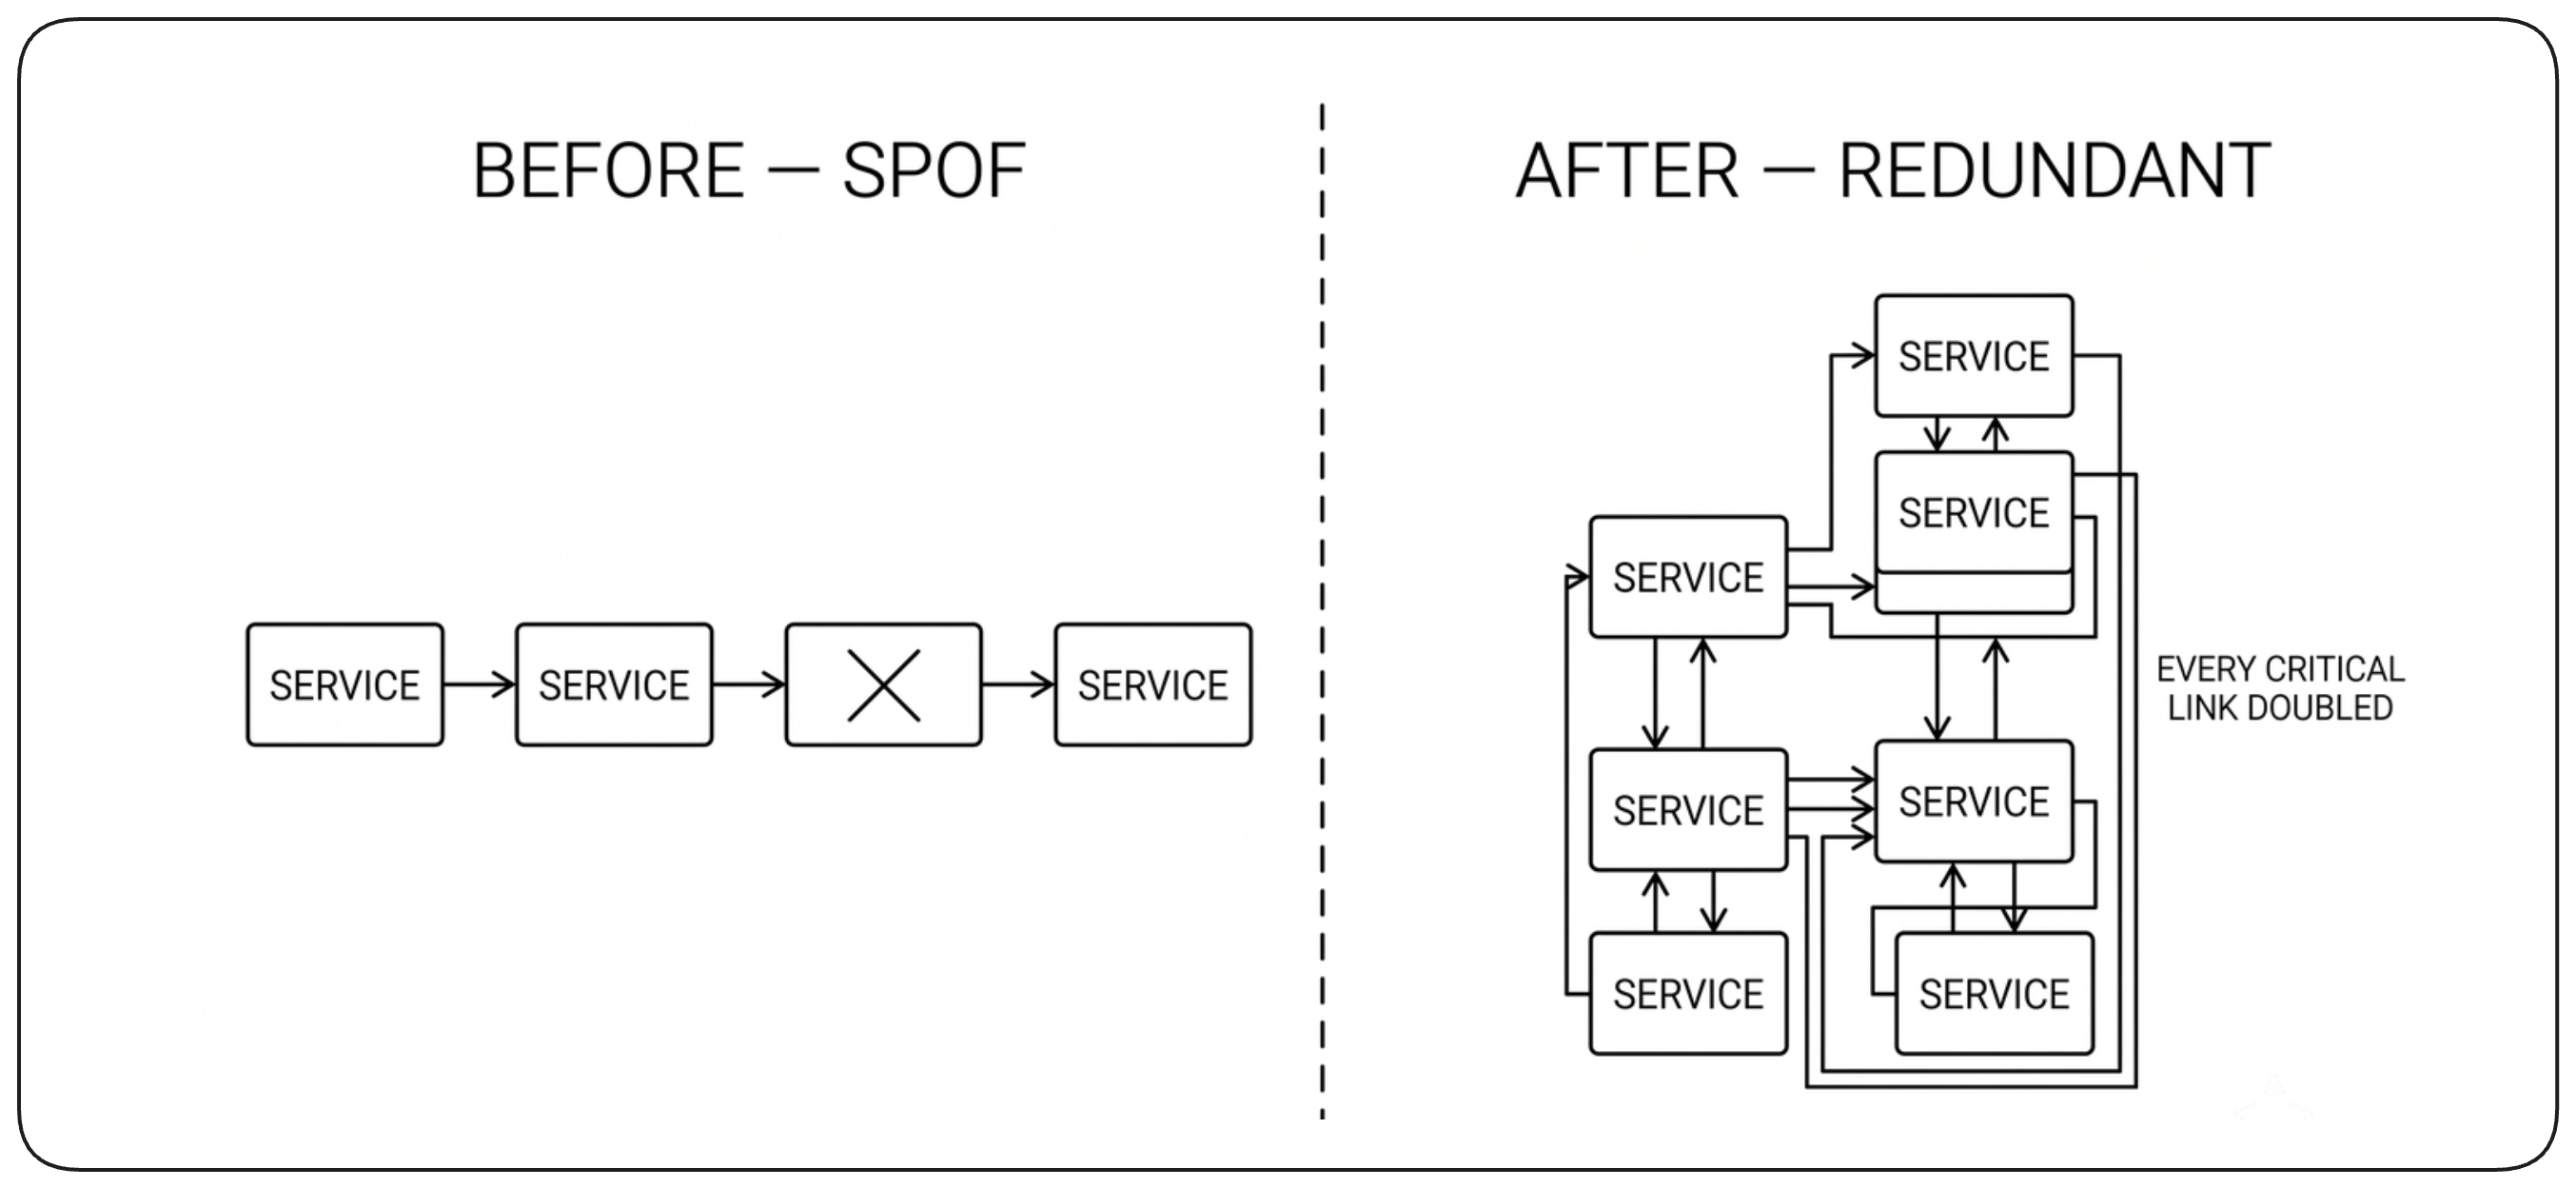
La redondance doit couvrir chaque composant nécessaire pour fournir la capacité critique. !!Aucun composant dont la perte peut supprimer la capacité ne doit rester son unique fournisseur.!! Cela s’applique non seulement aux composants de service, mais aussi aux données, aux chemins réseau et aux dépendances de contrôle.
Rendre la redondance indépendante
La redondance n’est efficace que si les composants redondants ne partagent pas les dépendances dont ils sont censés survivre à la défaillance. !!L’indépendance doit tenir sur le chemin complet — calcul, données, réseau, alimentation et dépendances de contrôle.!! Sinon, plusieurs copies peuvent encore disparaître en une seule défaillance. Vérifiez que la redondance est indépendante en pratique, et pas seulement dupliquée dans la topologie.
La redondance exige de la capacité de réserve
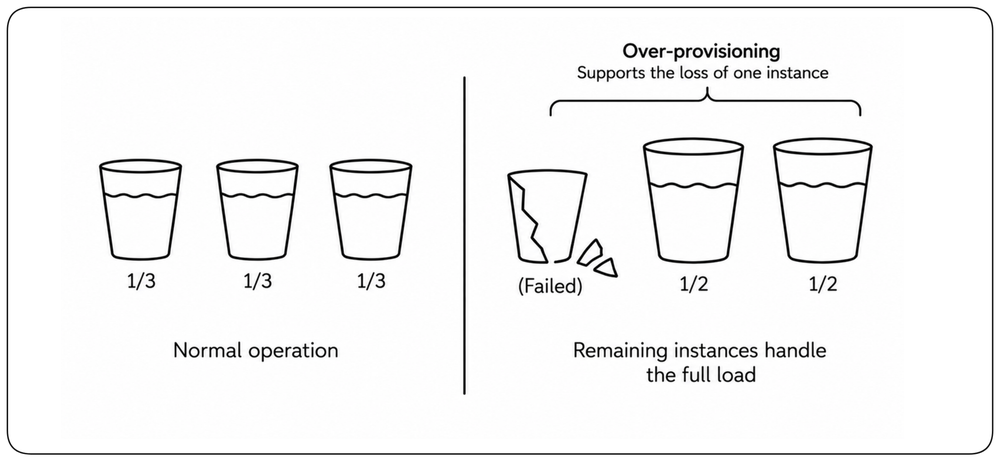
La redondance consiste à s’assurer qu’il reste assez de capacité disponible lorsqu’une partie du système disparaît. !!Cette capacité peut être réservée à l’avance ou acquise dynamiquement, mais elle doit devenir disponible assez vite pour satisfaire l’exigence de disponibilité.!! Lorsque la capacité ne peut pas être créée rapidement ni garantie à la demande, il faut la provisionner à l’avance, ce qui peut avoir un impact significatif sur le coût puisqu’une partie de la capacité peut rester inutilisée en fonctionnement normal. Son coût doit être pesé face à l’impact business de l’indisponibilité qu’elle est censée éviter.
La redondance doit échouer en sécurité
La redondance dépend de mécanismes tels que les health checks, la synchronisation, le routage et la logique de transition. Ces mécanismes peuvent eux aussi tomber, et une protection mal conçue peut causer la panne qu’elle devait empêcher — par exemple via de faux signaux de santé, des basculements inutiles ou des transitions instables. !!La protection apportée par la redondance doit dépasser les nouveaux modes de défaillance introduits par sa gestion.!!
Actif-passif : un sert, un attend
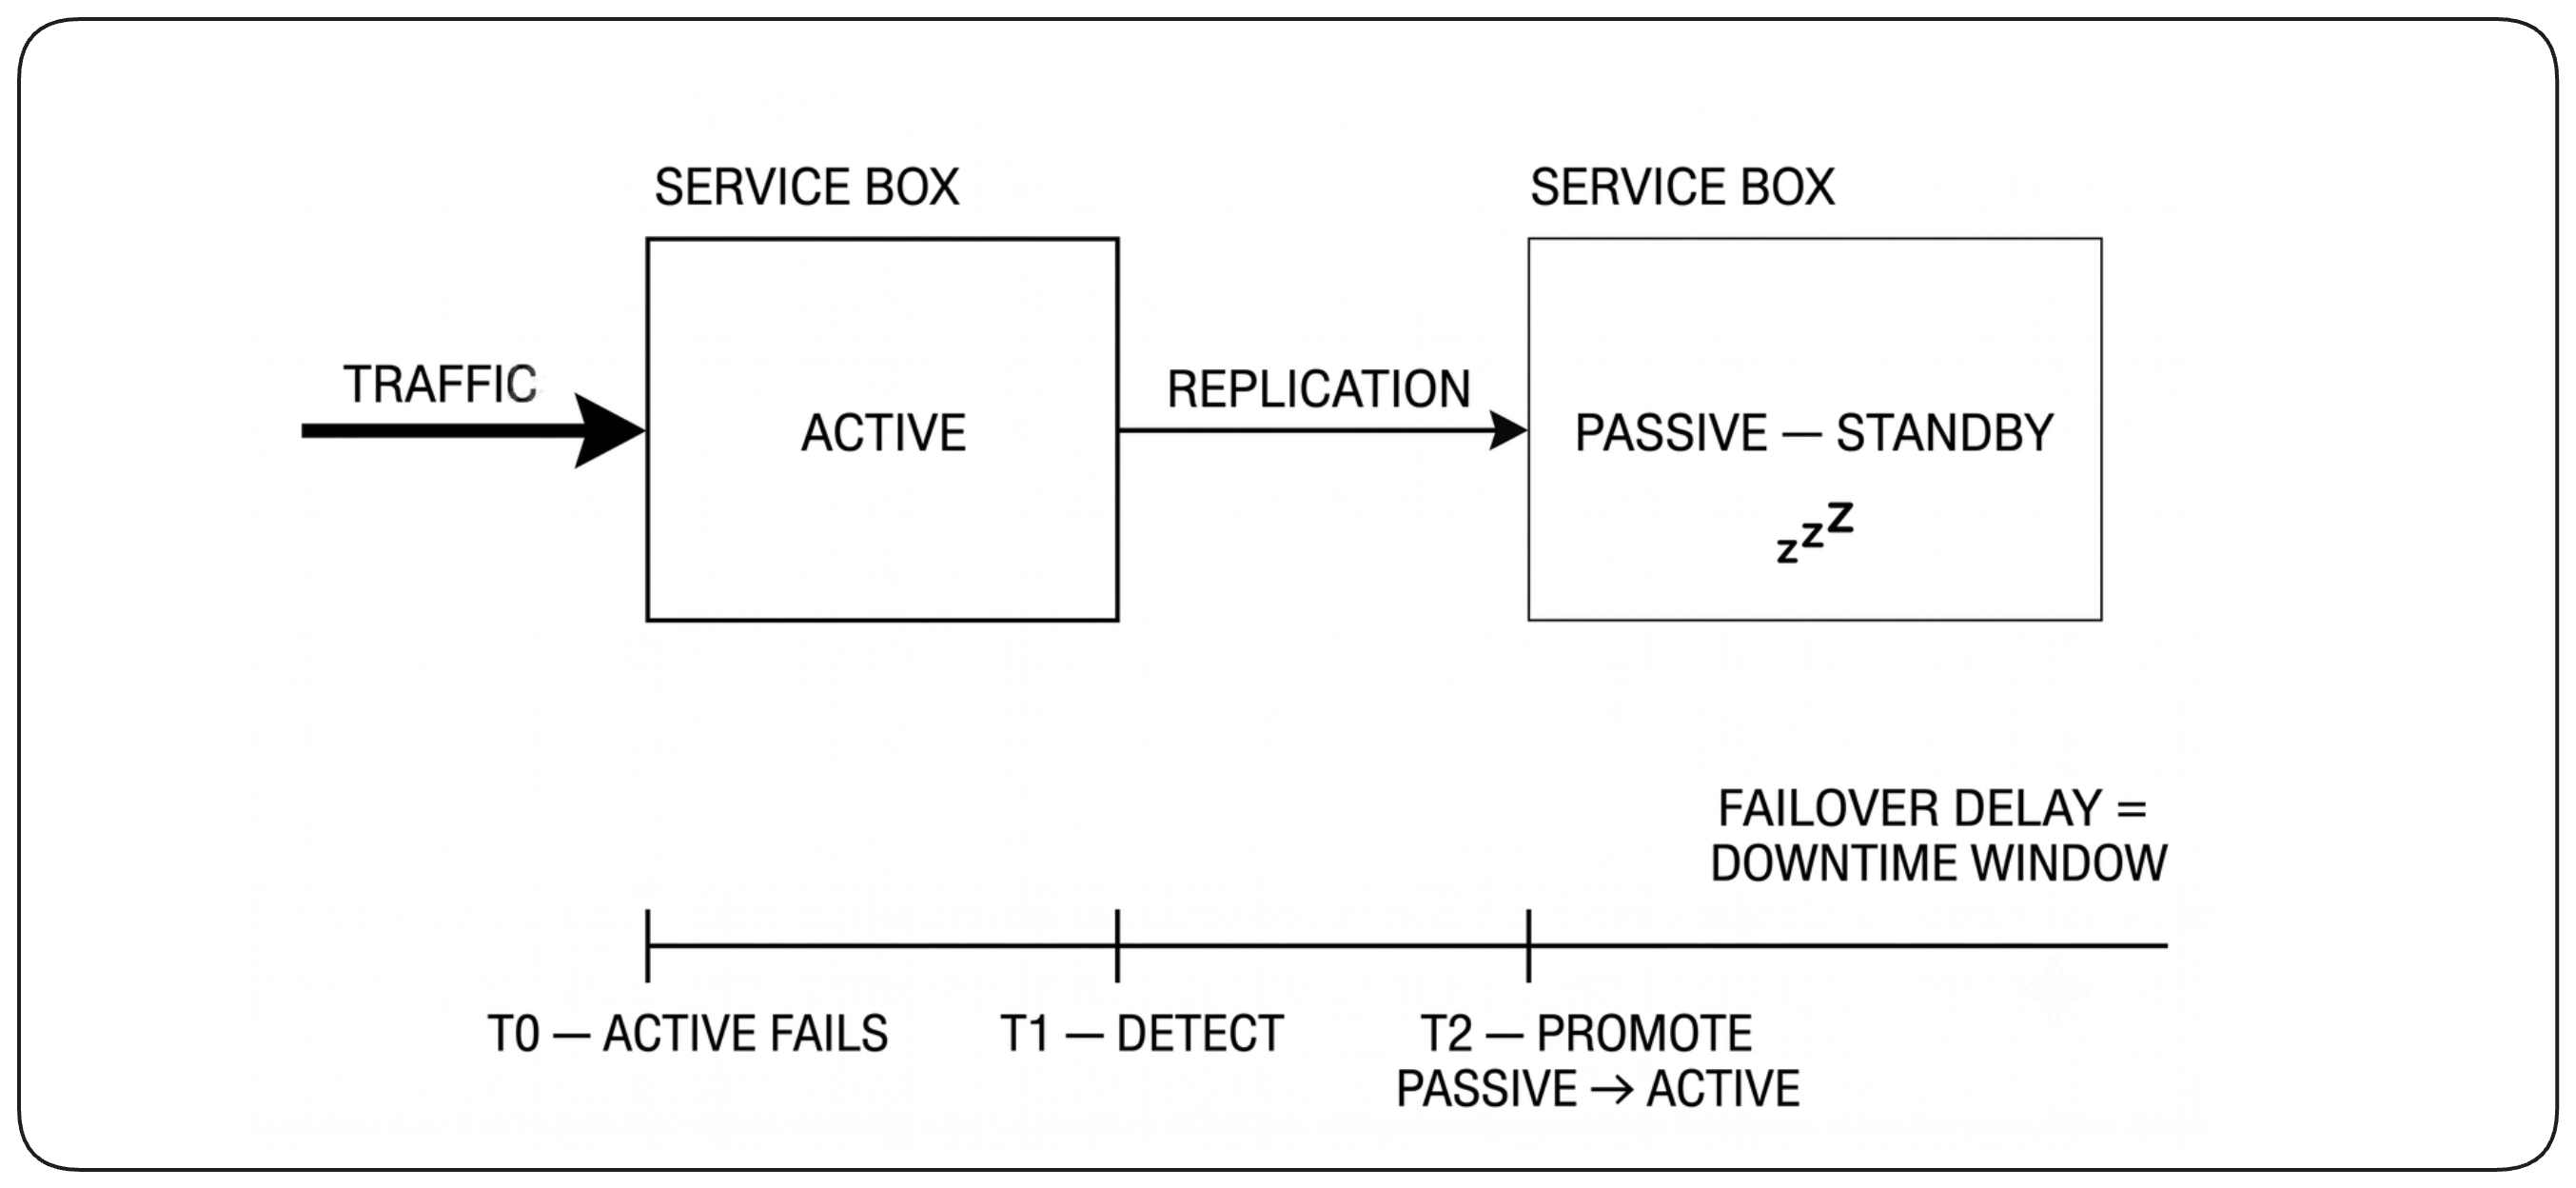
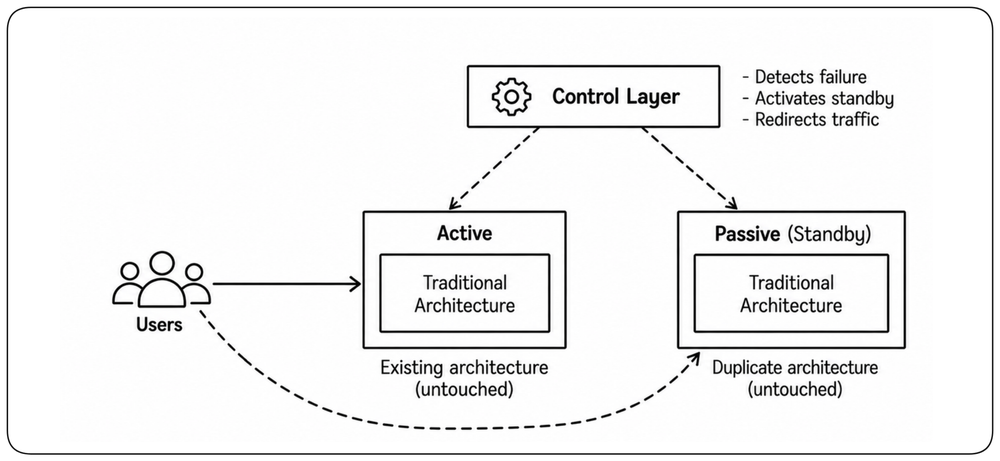
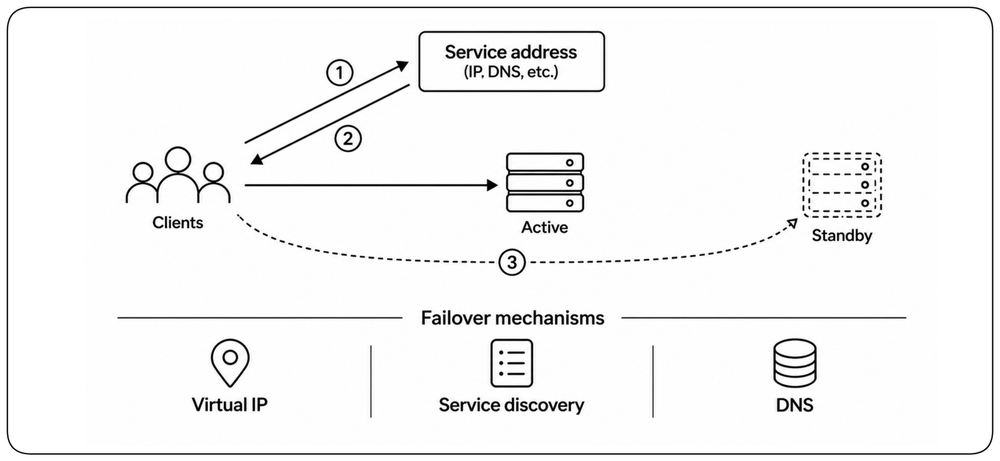
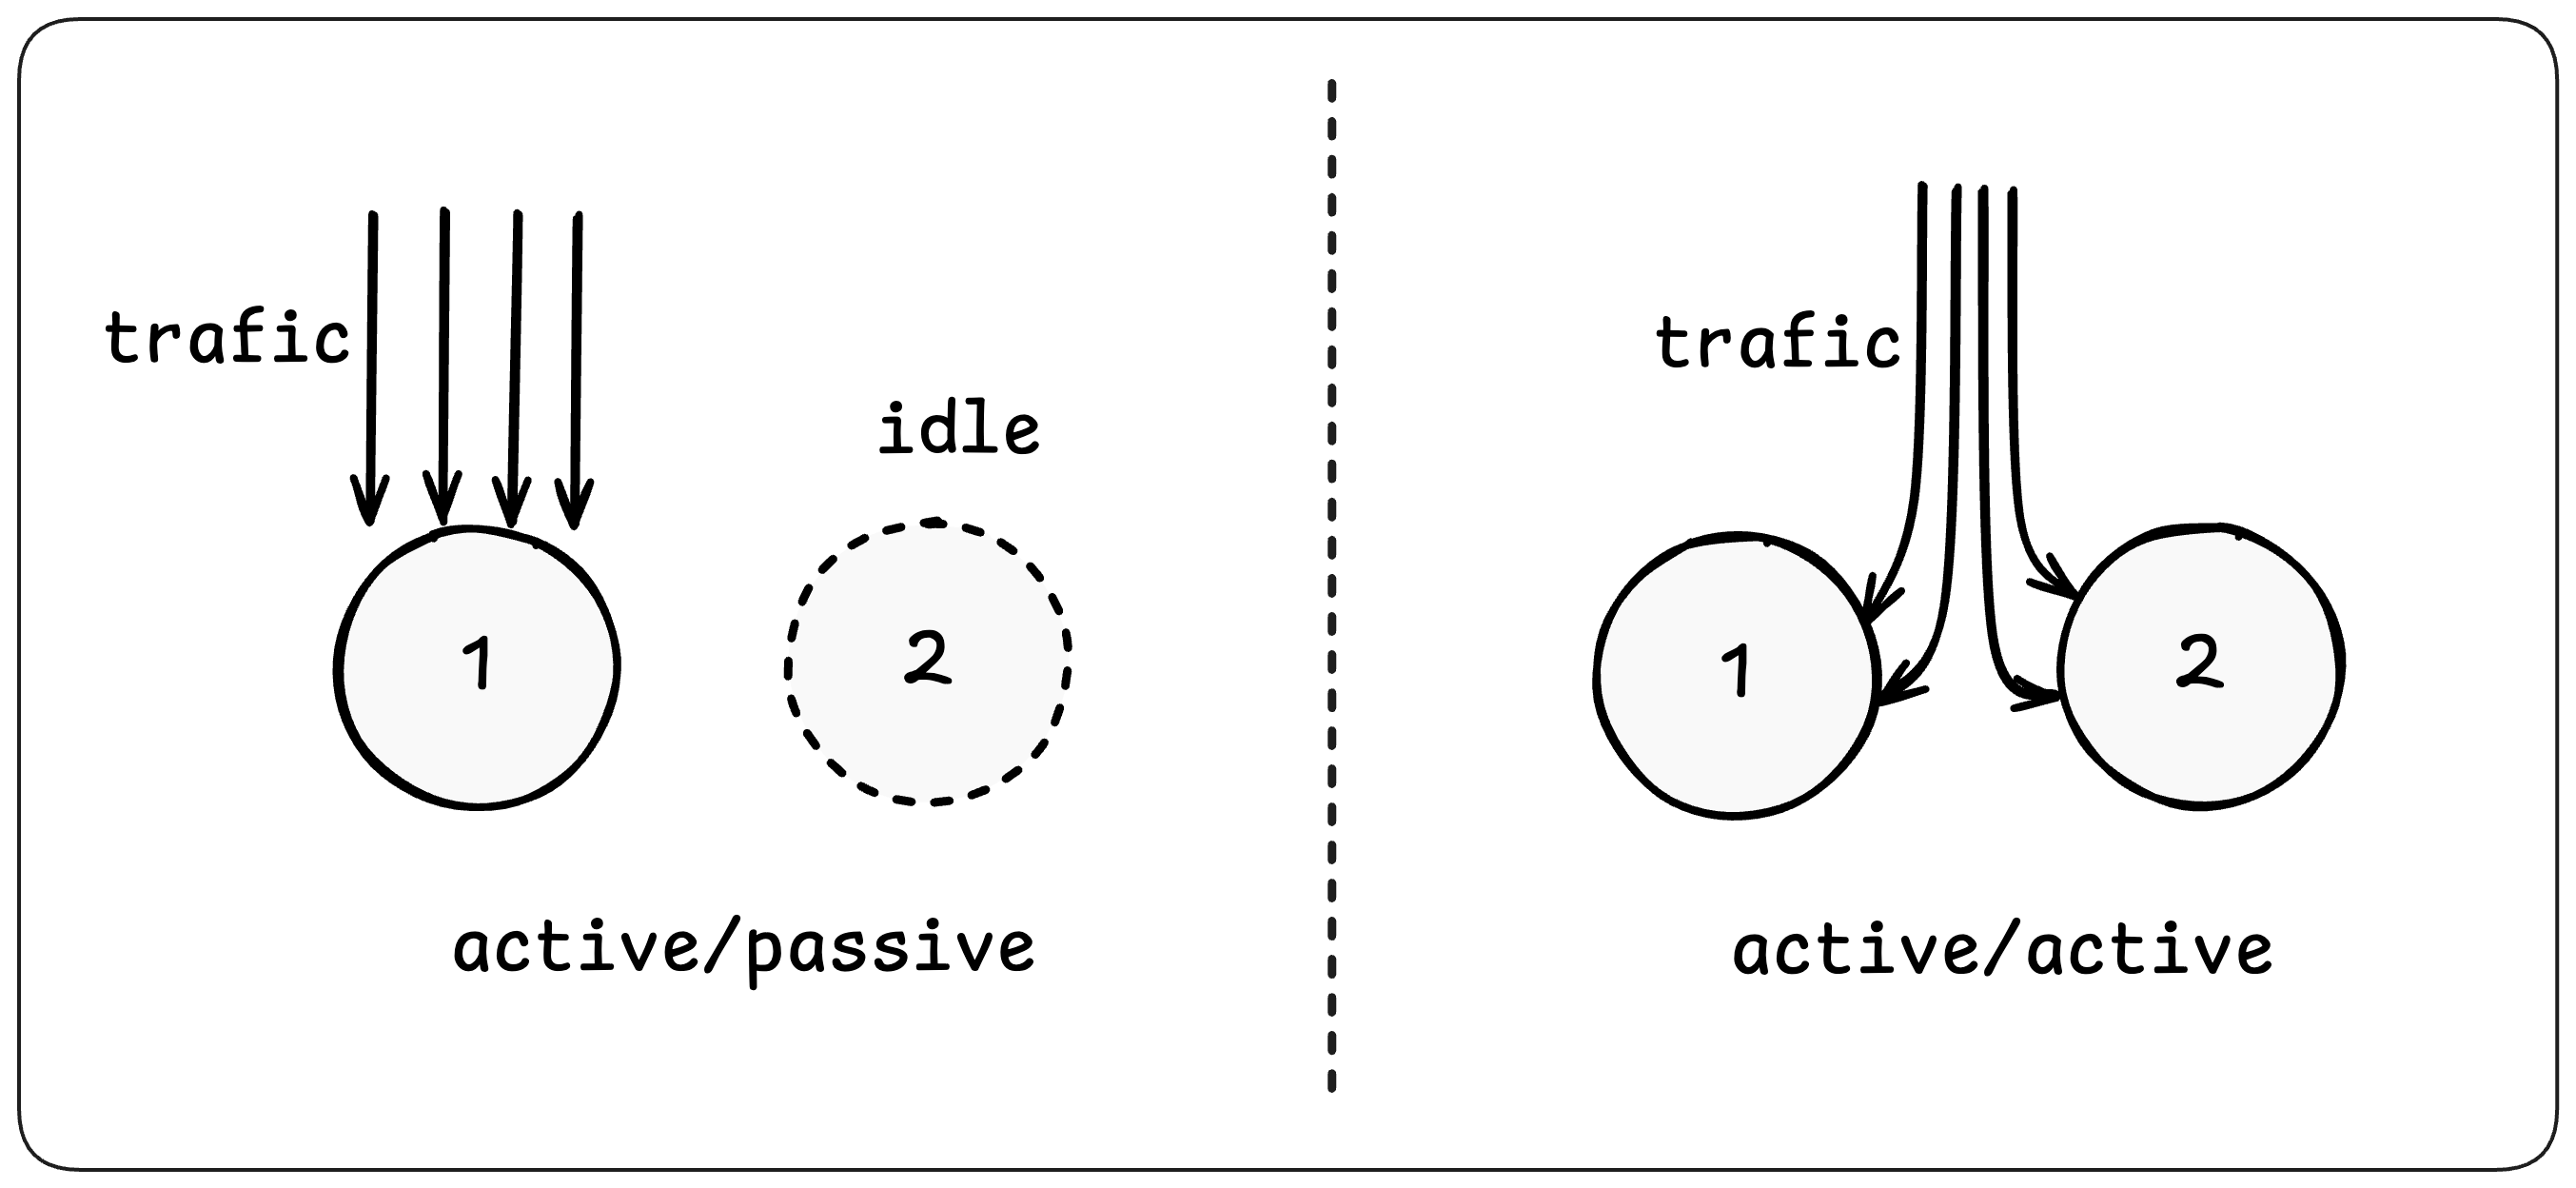
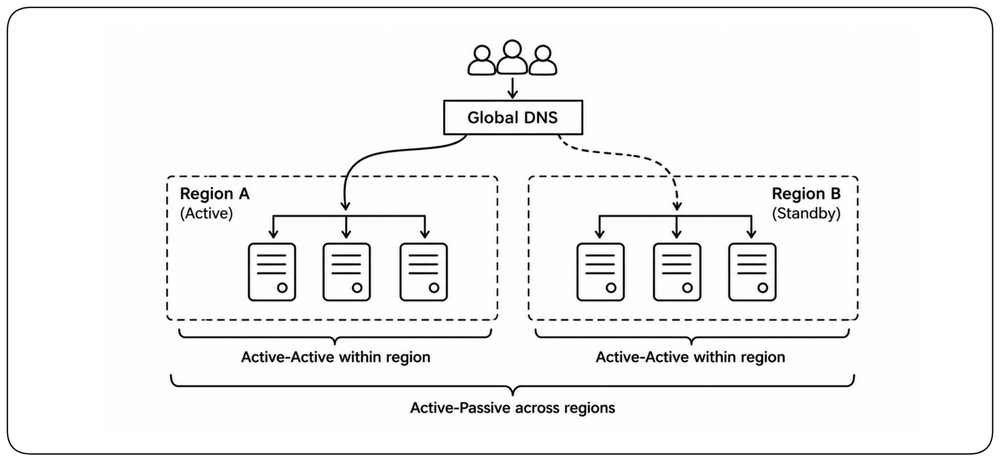
Une façon d’assurer la redondance est de garder une instance en service pendant qu’une autre attend en secours. Ce modèle s’appelle actif-passif. Si l’instance active tombe, l’instance de secours prend le relais. !!Ce modèle fonctionne bien lorsqu’une seule instance doit servir à la fois. Toutefois, une courte interruption peut avoir lieu avant que l’instance de secours ne prenne le relais.!!
L’actif-passif a apporté la HA aux architectures traditionnelles
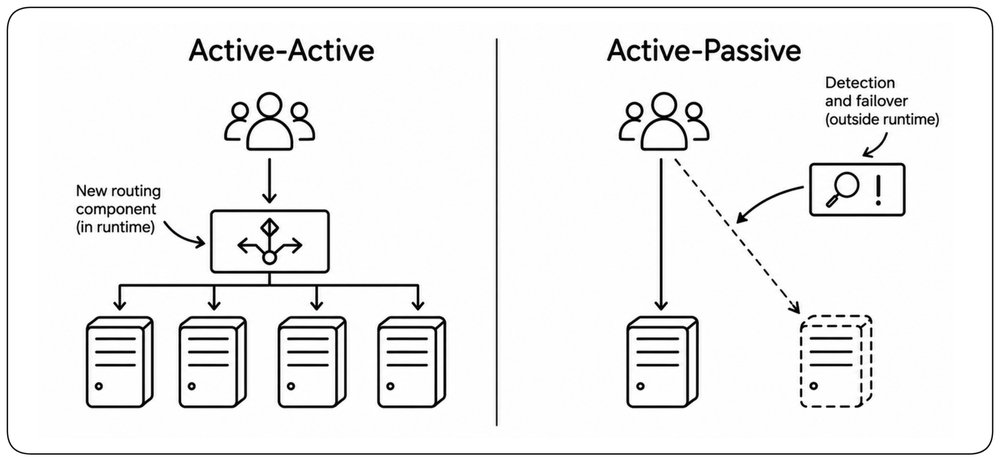
Dans les années 1990, l’actif-passif est devenu une façon courante d’apporter la haute disponibilité aux architectures traditionnelles. Plutôt que de repenser le système, il conservait l’architecture existante en grande partie intacte et ajoutait une couche de contrôle autour d’elle. Cette couche détectait la défaillance, activait une copie de secours et redirigeait le trafic pour rétablir le service.
Faire fonctionner le basculement actif-passif
La redondance actif-passif repose sur une transition : le système doit détecter que la capacité active ne peut plus servir, déterminer que l’instance de secours est prête, et lui transférer le service. !!La disponibilité de la conception dépend donc non seulement de l’instance de secours, mais aussi de la fiabilité et de la rapidité du mécanisme de basculement lui-même.!!
Détecter la défaillance de façon fiable
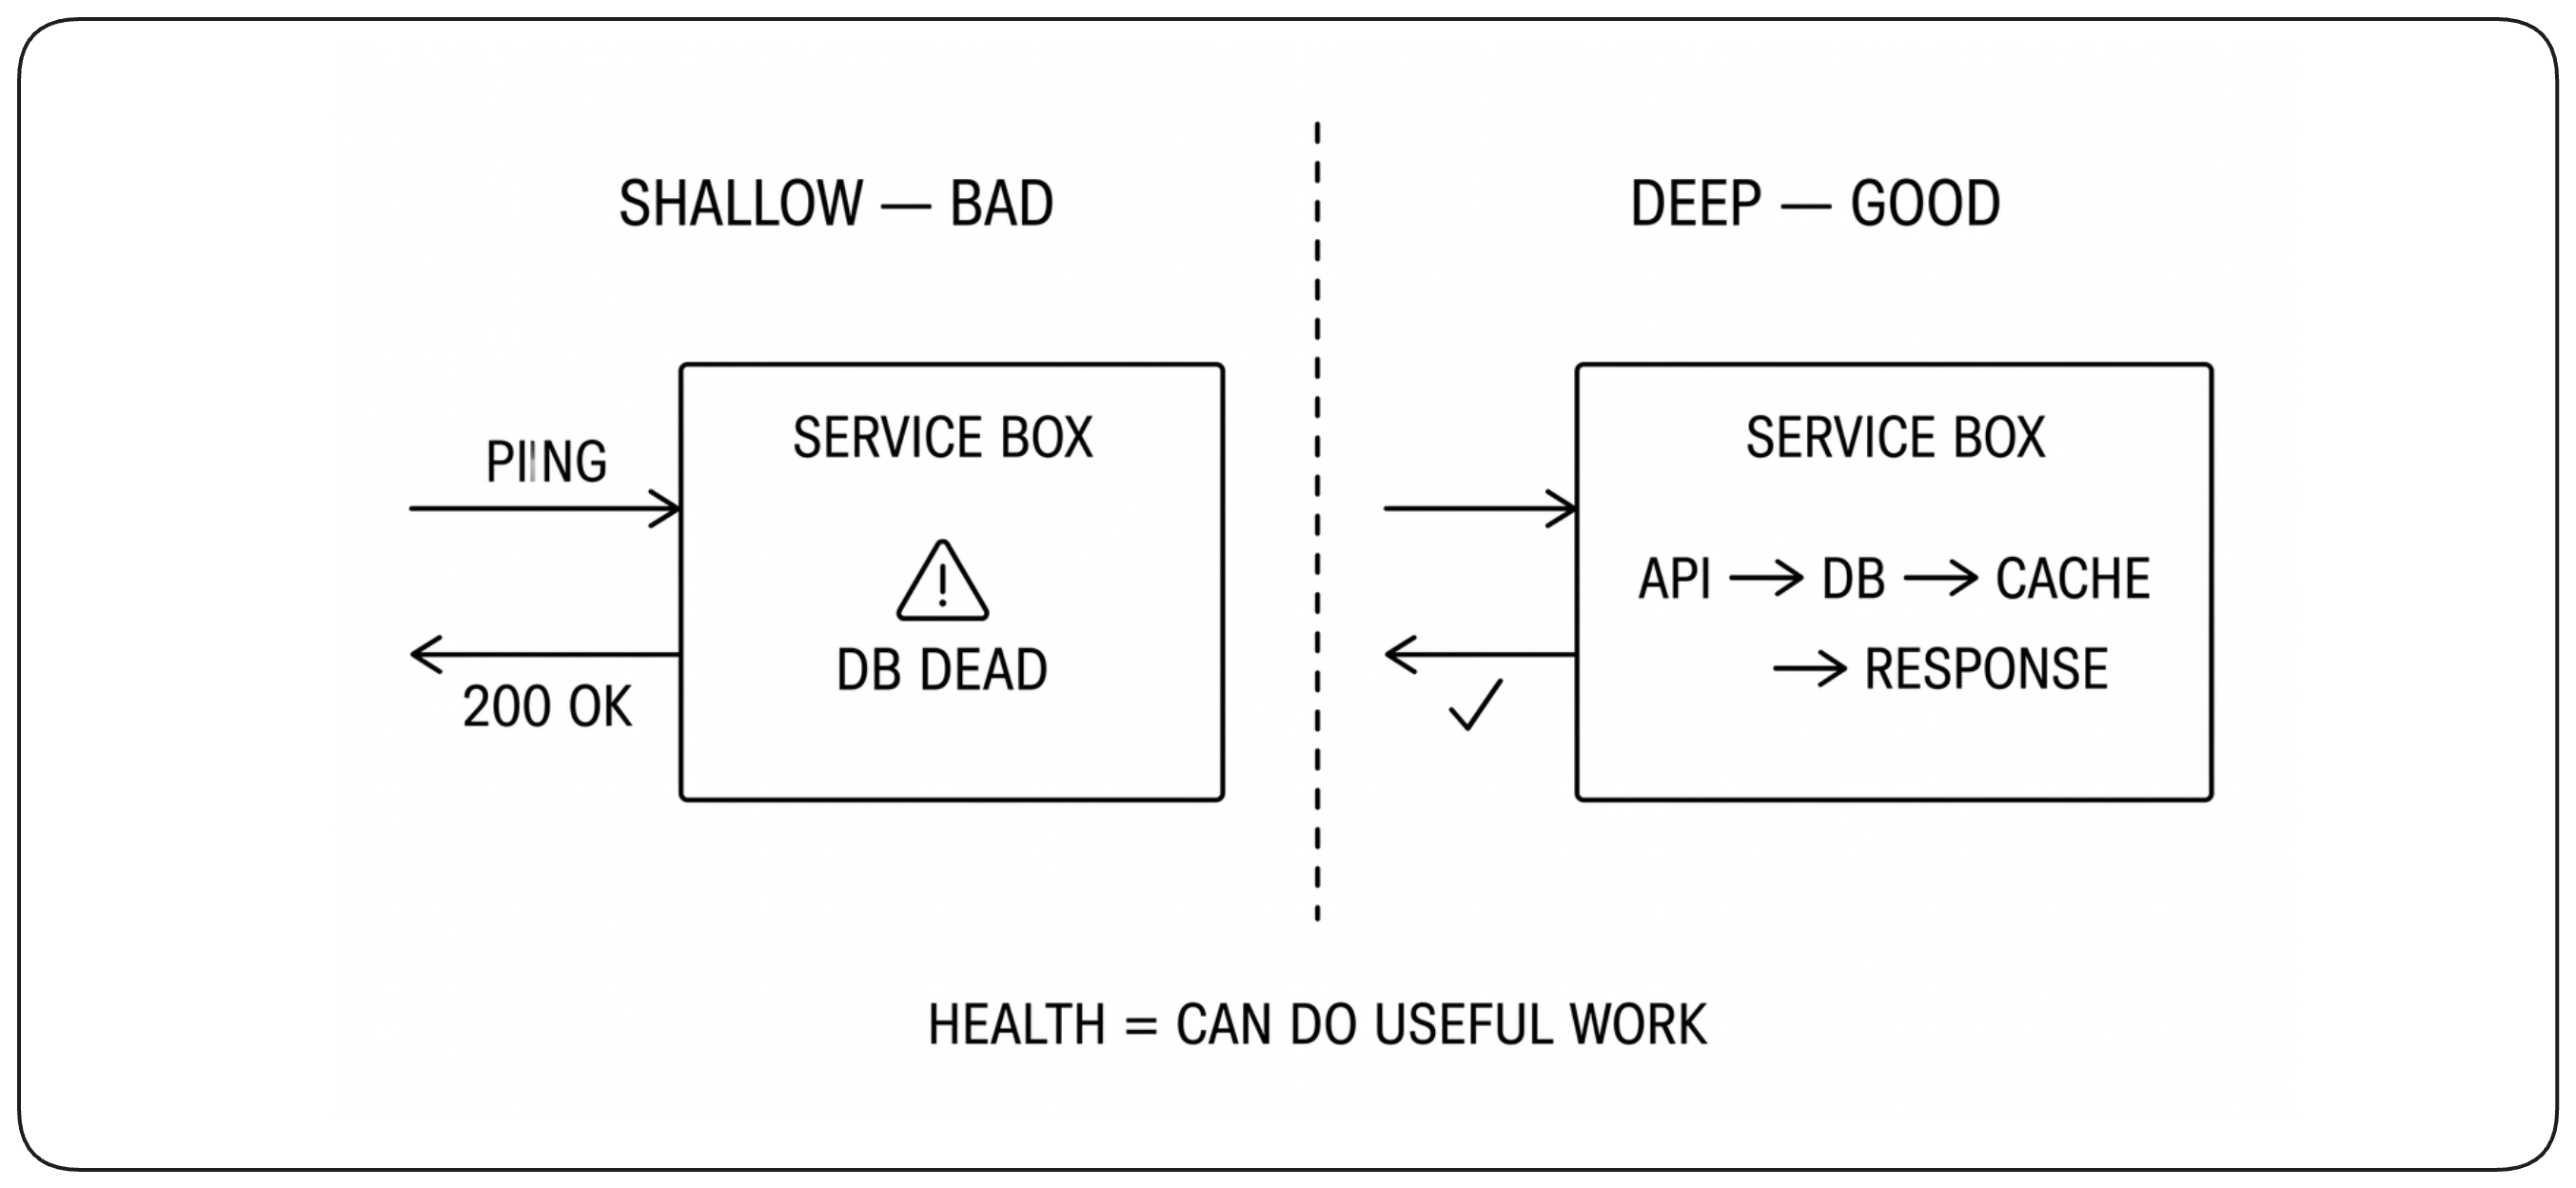
Le basculement commence par déterminer si l’instance active peut encore remplir son rôle. Un processus peut tourner tout en étant incapable de servir correctement, donc une simple vérification de processus ne suffit pas. !!Le système a besoin d’un signal de santé fiable qui détecte une réelle perte de service sans réagir de façon trop agressive aux problèmes temporaires.!! Un signal faible retarde la récupération ; un signal trop sensible peut déclencher des basculements inutiles.
Décider quand basculer
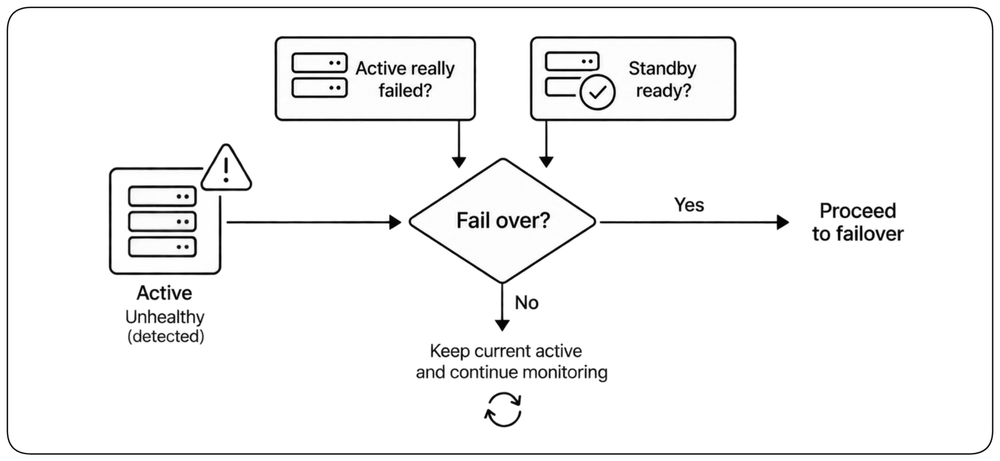
Détecter un problème ne signifie pas automatiquement que le système doit passer sur l’instance de secours. Une défaillance transitoire peut disparaître, l’instance de secours peut ne pas être prête, ou le basculement peut créer plus d’instabilité que de rester en place. !!Ne basculez que lorsque l’instance active ne peut plus servir de façon fiable et que l’instance de secours est prête à prendre le relais ; sinon, un état dégradé contrôlé peut être plus sûr qu’une transition incertaine.!! Cela évite les basculements instables ou inutiles.
Automatiser le basculement
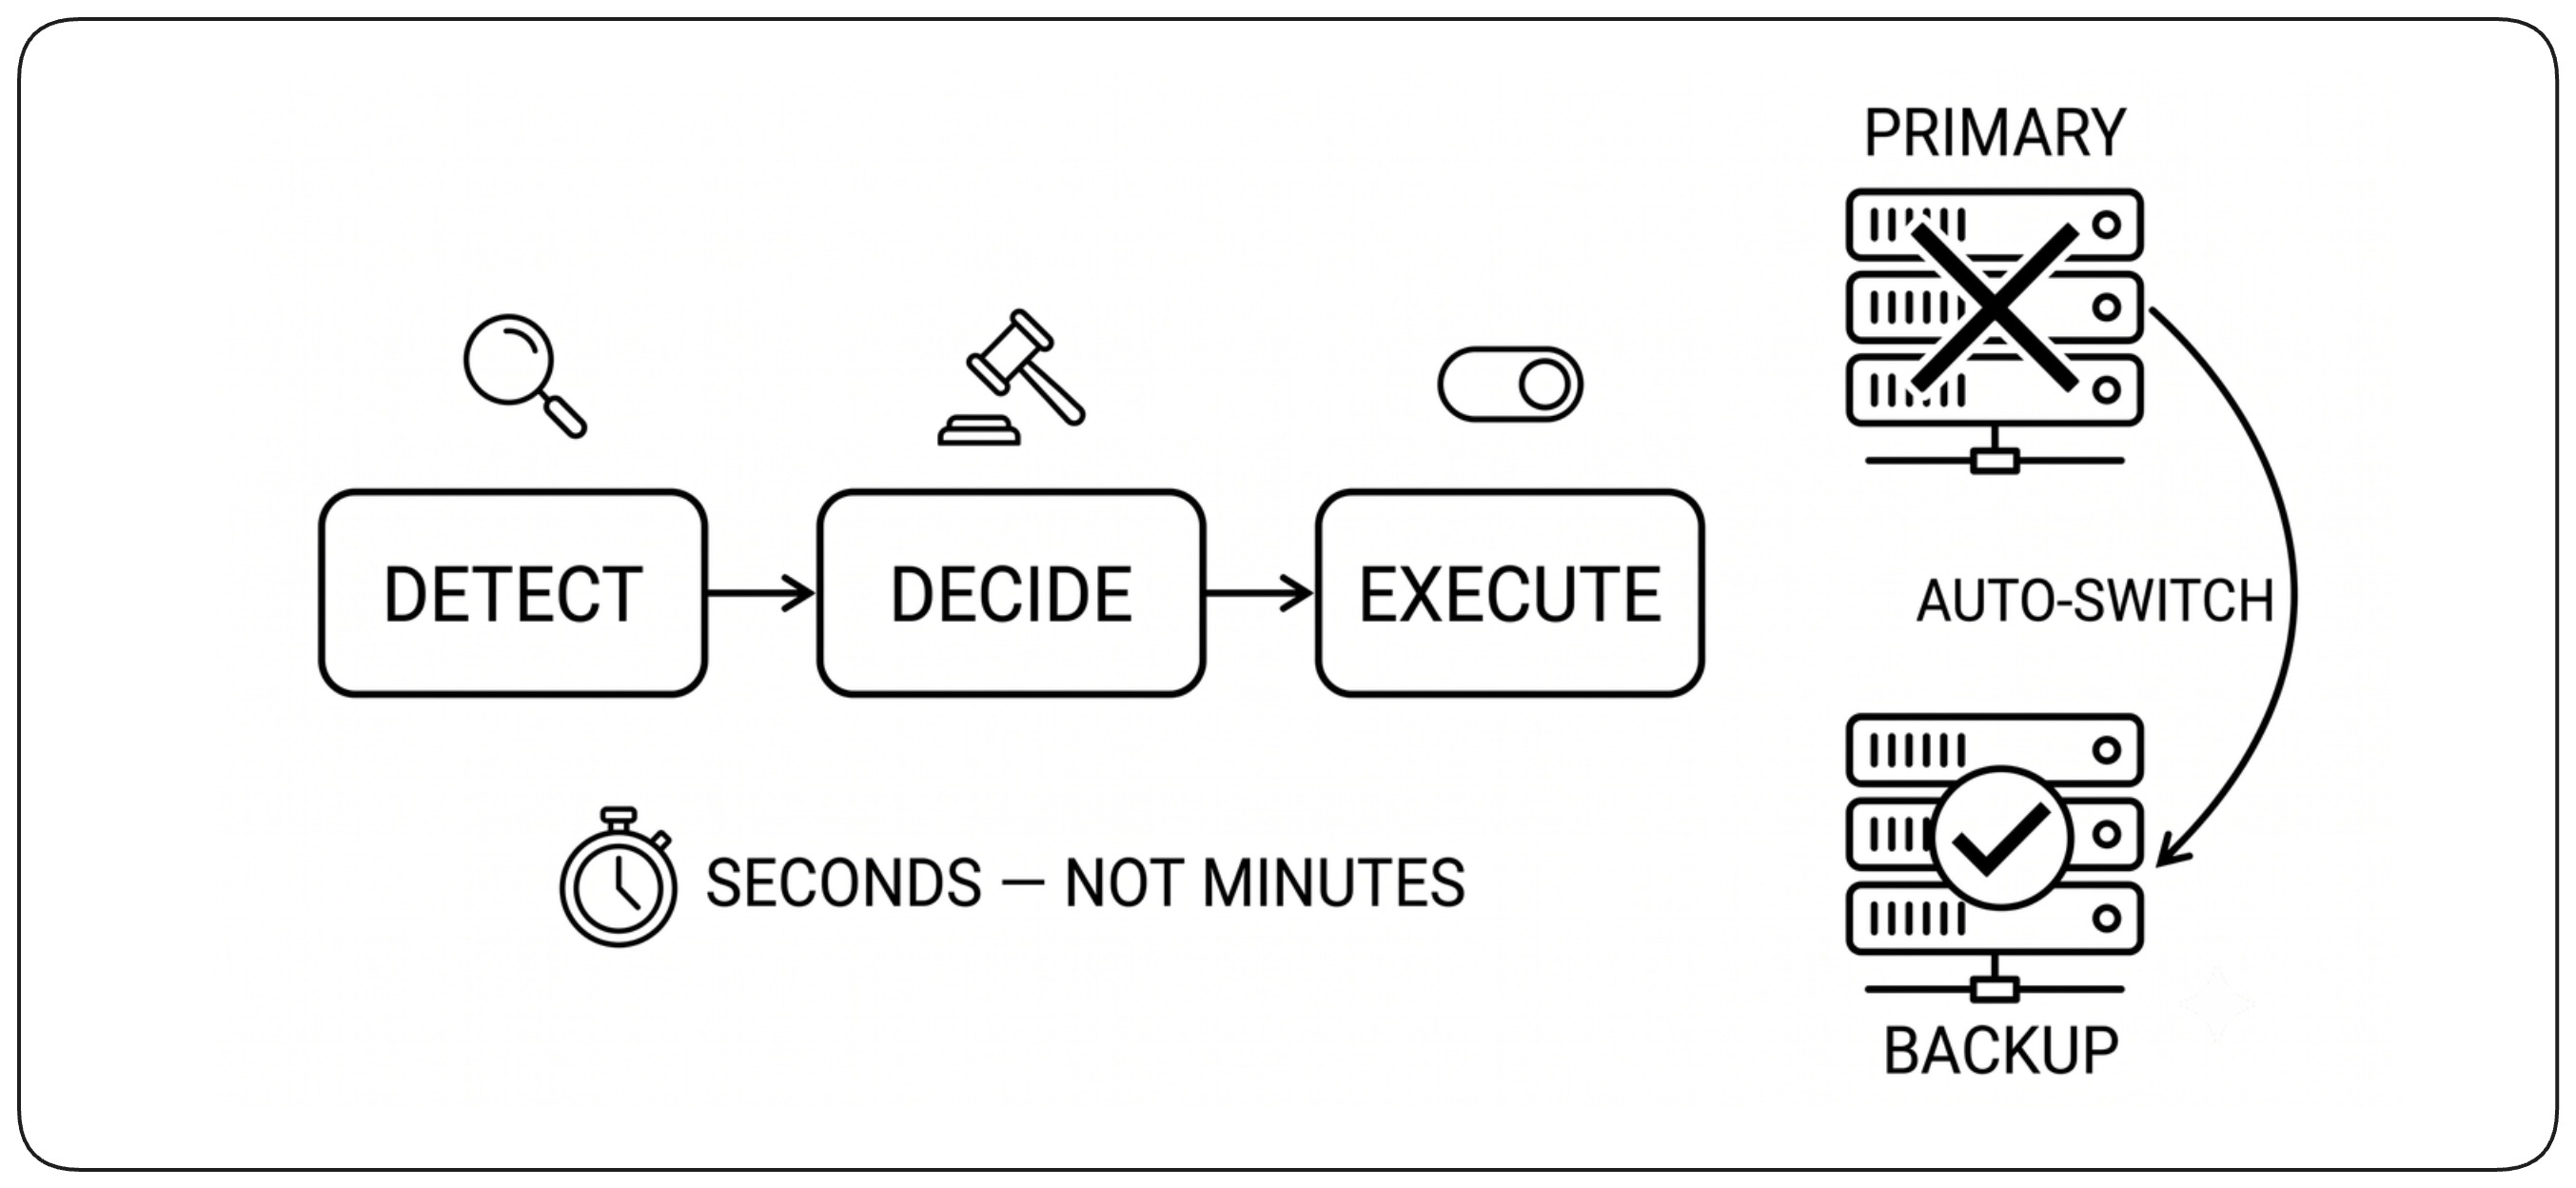
Une fois le basculement justifié, l’automatisation effectue la transition : activer l’instance de secours si nécessaire et lui rediriger le trafic. !!L’automatisation réduit l’intervalle entre la défaillance confirmée et le rétablissement du service.!! La transition doit s’achever assez vite pour satisfaire l’exigence de disponibilité, mais la justesse compte plus que de basculer aveuglément vite.
Mécanismes de basculement
Le basculement exige un moyen de rediriger le service de l’instance active défaillante vers l’instance de secours. Le mécanisme change l’endroit où pointe le service logique sans exiger que les clients changent leur façon de l’adresser. Selon l’architecture, cela peut consister à déplacer une IP virtuelle, mettre à jour la service discovery ou modifier le DNS.
Actif-actif : toutes les instances servent le trafic
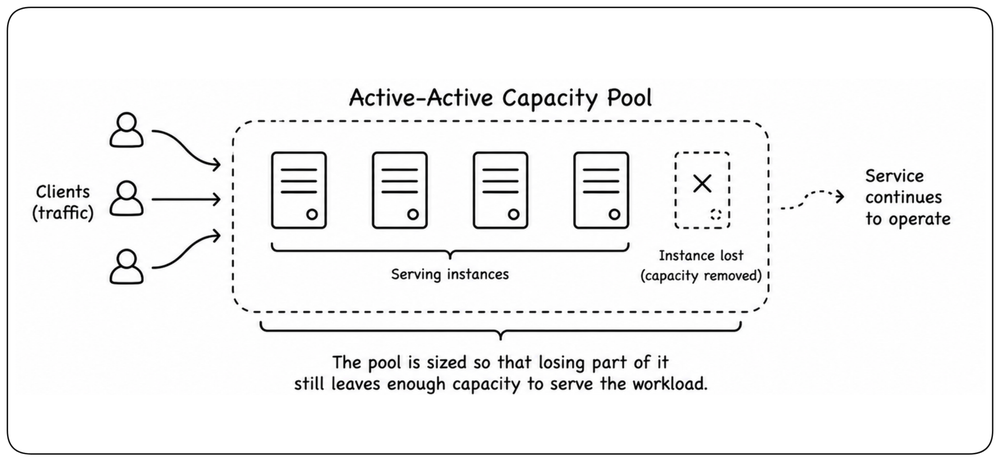
Dans un modèle actif-actif, plusieurs instances servent le trafic simultanément. !!Contrairement à l’actif-passif, aucune instance de secours n’attend d’être promue : chaque instance est déjà en service.!! Lorsqu’une instance tombe, le trafic peut passer directement aux instances actives restantes.
Faire fonctionner la capacité actif-actif
La redondance actif-actif maintient plusieurs instances en service en même temps. Lorsque de la capacité disparaît, les instances saines continuent de servir, le trafic est redistribué et la capacité perdue peut être remplacée dynamiquement. La disponibilité dépend du maintien d’une capacité suffisante tout au long de cette transition.
Actif-actif vs actif-passif : où loge la complexité
L’actif-actif et l’actif-passif placent la complexité à des endroits différents de l’architecture. L’actif-actif gère en continu un pool de capacité de service, qui peut aussi absorber les pics et les défaillances. L’actif-passif simplifie le fonctionnement normal mais peut laisser de la capacité inactive jusqu’à ce qu’elle soit nécessaire, et dépend d’une transition fiable lorsque l’instance active tombe. !!Le choix ne consiste pas à éviter la complexité, mais à décider où la porter et comment utiliser cette capacité.!!
Le cloud a rendu l’actif-actif naturel
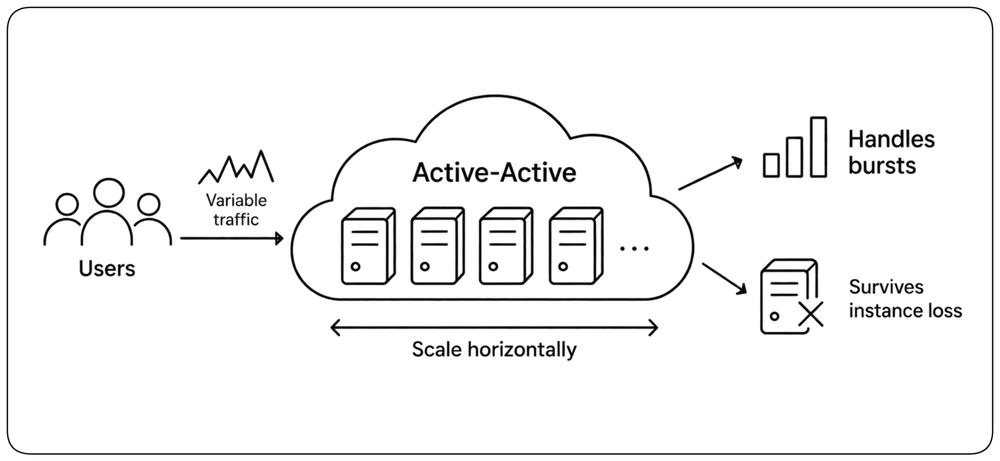
Les plateformes cloud modernes ont fait de l’actif-actif un modèle naturel pour la capacité de service stateless. Le même ensemble d’instances peut distribuer le trafic normal, absorber les pics, passer à l’échelle horizontalement et survivre à la perte d’une instance. !!La haute disponibilité et la scalabilité peuvent donc reposer sur la même architecture.!! L’actif-passif reste utile lorsque plusieurs instances actives sont difficiles, coûteuses ou risquées.
Traiter l’actif-actif comme un pool de capacité
L’actif-actif se comprend mieux comme un pool de capacité de service. Le pool est dimensionné de sorte que la perte d’une partie laisse assez de capacité pour supporter la charge requise. !!Une défaillance doit retirer de la capacité du pool, pas supprimer le service.!! Si le pool survivant ne peut pas servir en sécurité toutes les requêtes, le système peut devoir protéger les capacités critiques en limitant ou en rejetant le travail de moindre priorité jusqu’au rétablissement de la capacité.
Remplacer dynamiquement la capacité perdue
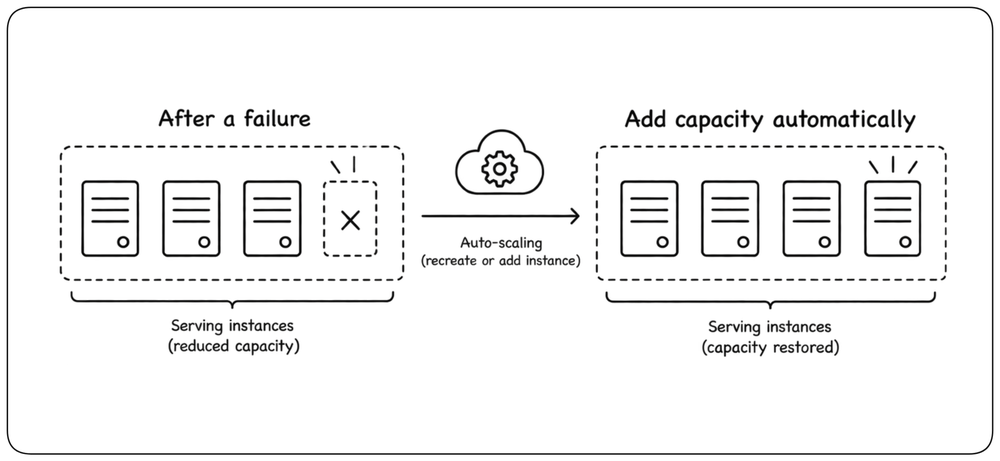
Après qu’une défaillance a réduit le pool, certaines plateformes peuvent recréer ou ajouter automatiquement de la capacité de service pour rétablir sa marge. Kubernetes, les systèmes d’autoscaling et les pools de calcul élastiques en sont des exemples courants. !!Le remplacement dynamique peut réduire la capacité de réserve réservée en permanence, mais seulement si la nouvelle capacité peut être obtenue assez vite et de façon assez fiable.!! Le matériel rare, les quotas ou la capacité à réserver à l’avance peuvent encore imposer un sur-provisionnement statique.
Concevoir les données pour la disponibilité
La disponibilité des composants qui conservent un état ne peut pas être résolue par la seule redondance. Ajouter une instance remplace la capacité perdue, mais pas les données que détenait le composant défaillant. L’état doit lui aussi survivre — conservé dans des copies indépendantes pour qu’une copie utilisable subsiste après la défaillance.
Garder plus d’une copie de l’état
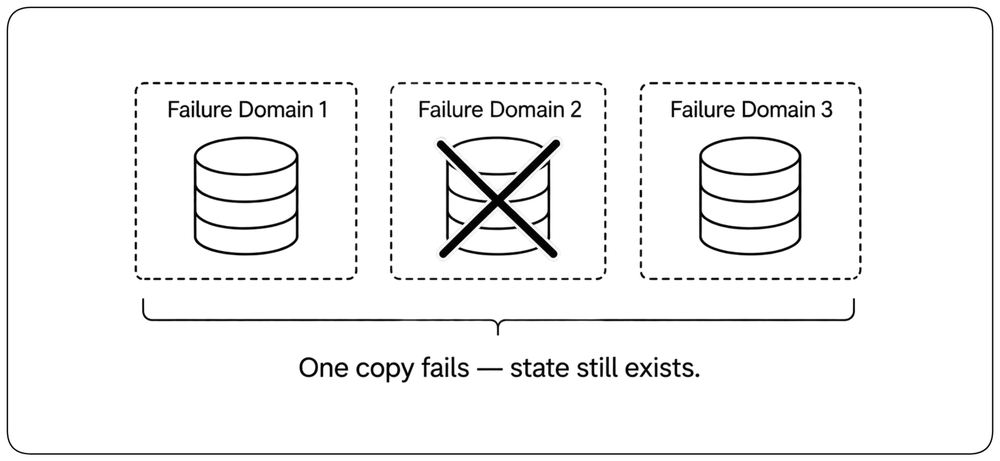
L’état ne peut pas rester disponible si sa seule copie est perdue. !!Conservez plusieurs copies de l’état dans des domaines de défaillance indépendants afin que la perte d’une copie ne supprime pas les données.!! La réplication crée ces réplicas — des copies supplémentaires du même état — et donne au système un point de départ lorsqu’une défaillance survient.
Décider à quel point la copie survivante doit être à jour
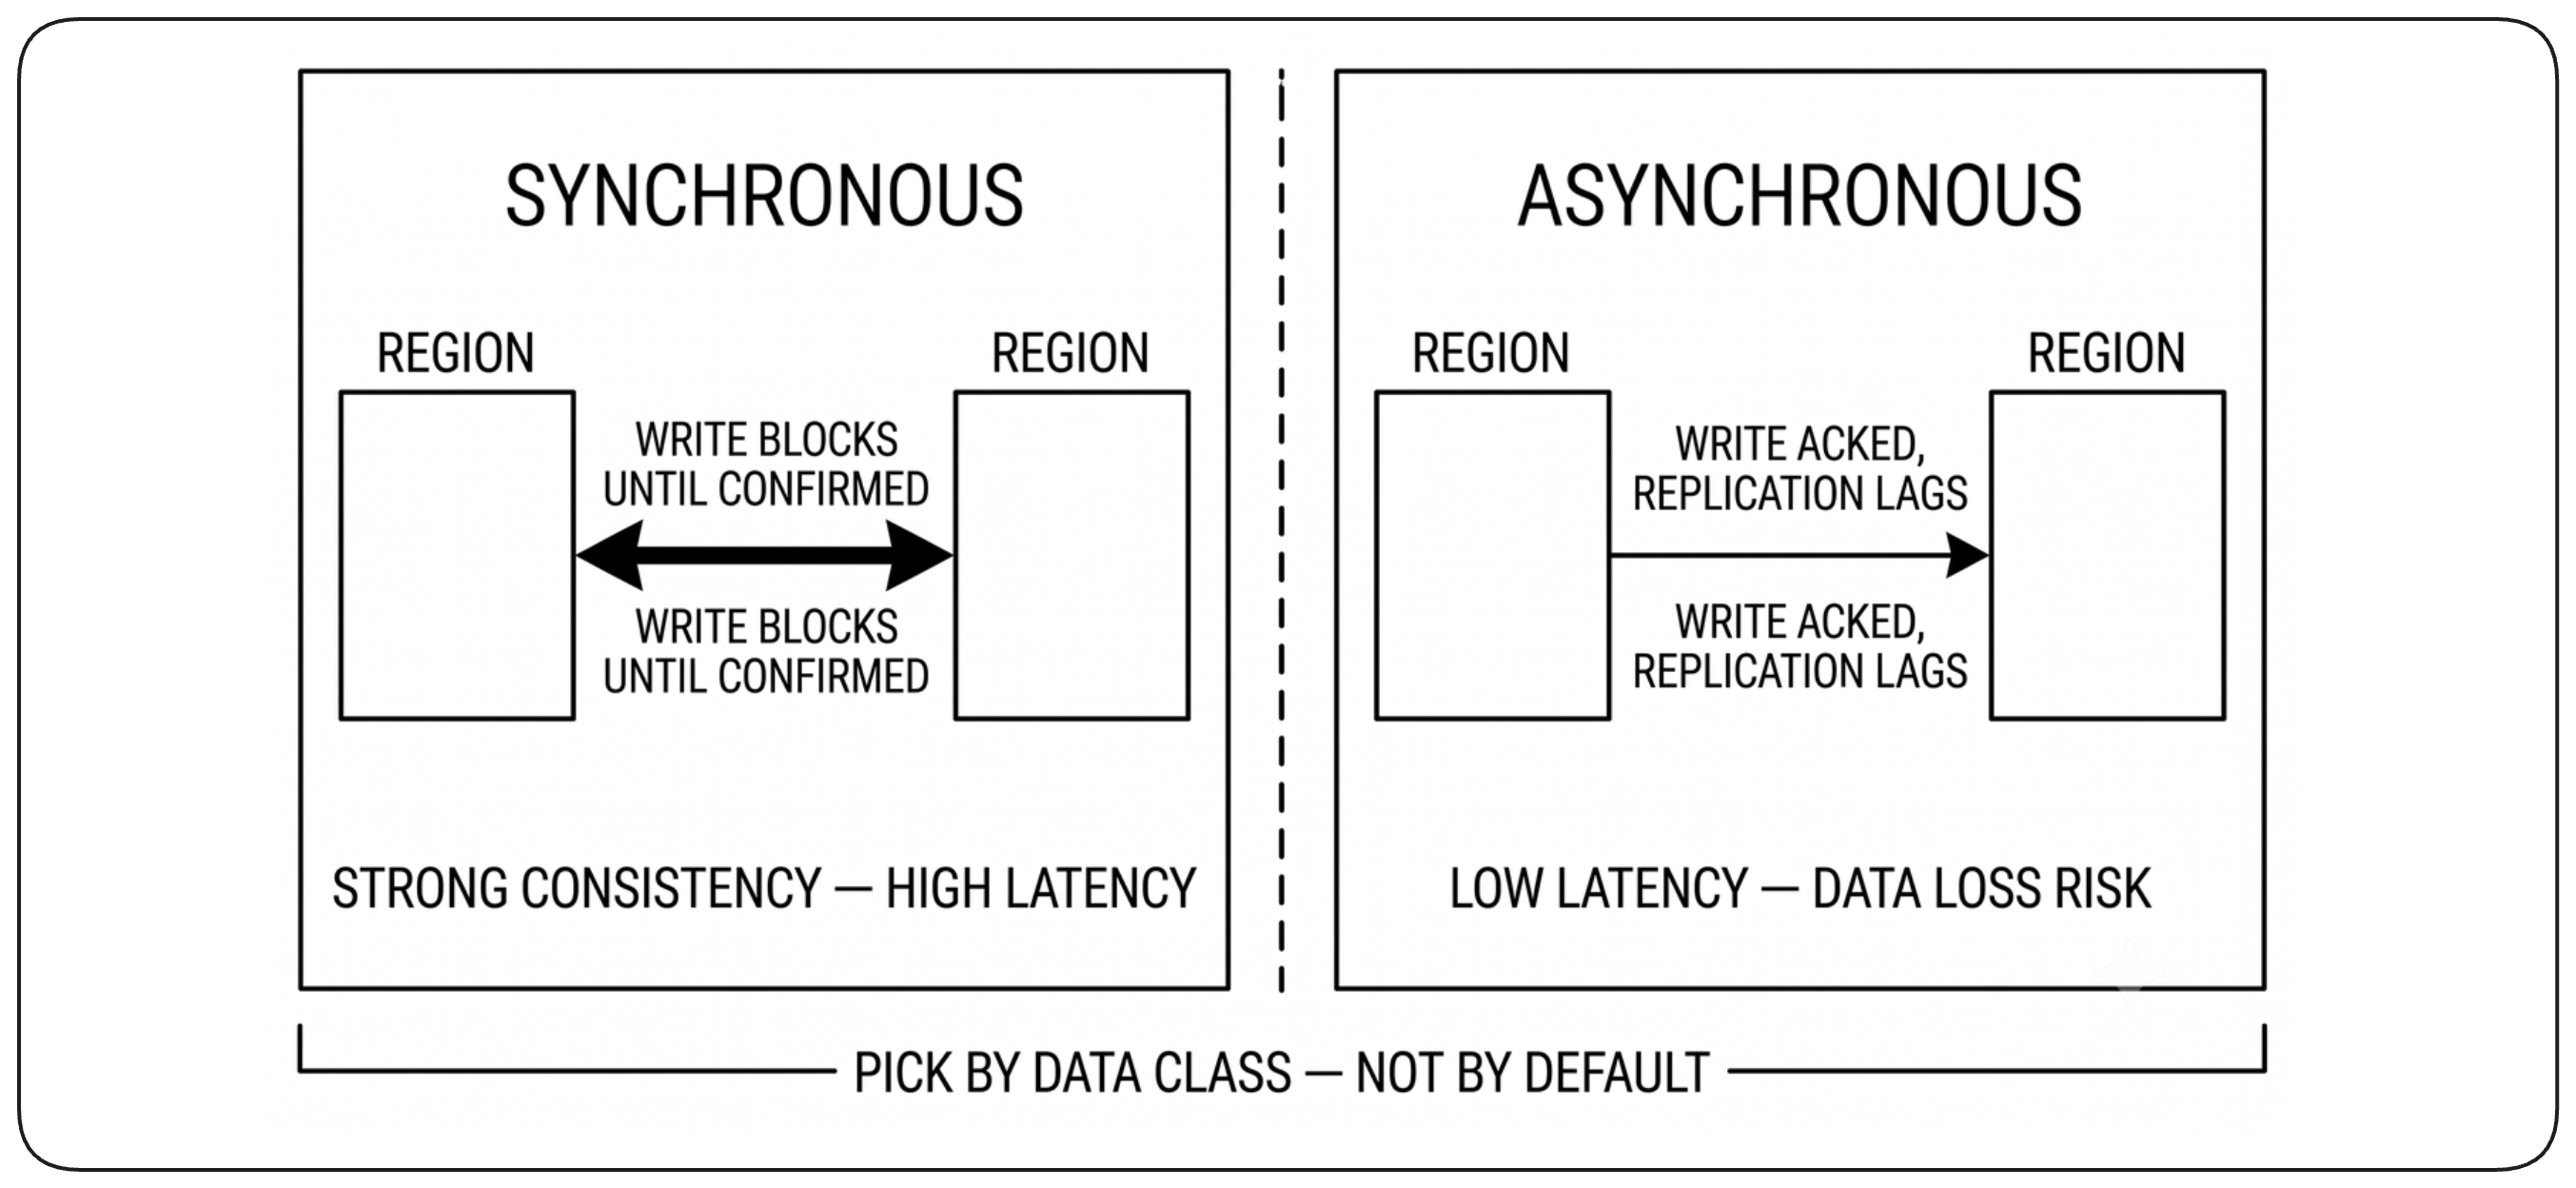
Idéalement, la copie survivante contiendrait exactement le même état que la copie perdue. En pratique, garder des réplicas parfaitement synchronisés a un coût. La réplication synchrone réduit le risque de perdre des données récentes, mais ajoute de la latence et fait dépendre les écritures de l’accessibilité d’une autre copie. La réplication asynchrone permet aux écritures de se terminer sans attendre un autre réplica, mais laisse la copie survivante prendre du retard. !!La question de conception est donc : quelle différence est tolérable entre la copie survivante et celle qui a été perdue ?!!
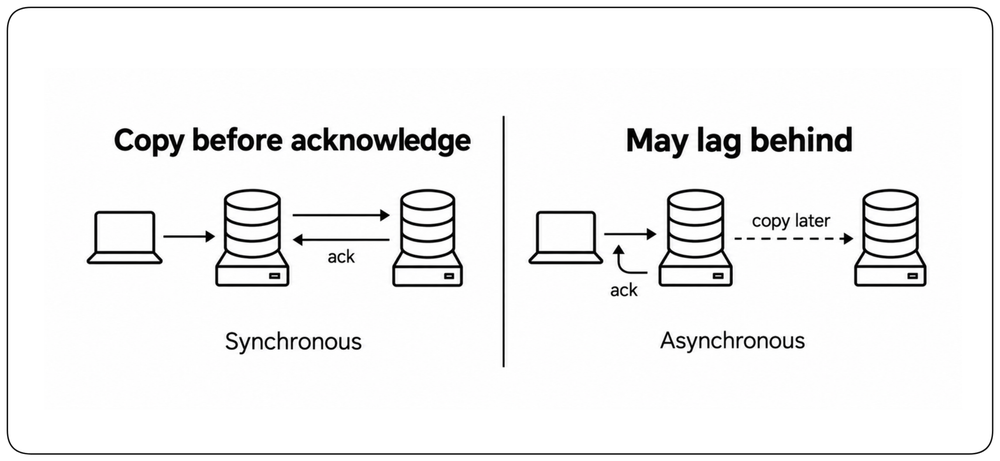
Basculer vers une copie utilisable
Lorsque la copie en service tombe, le système doit choisir un autre réplica et lui rediriger le service. La copie choisie doit contenir un état que le système est prêt à servir. Avec la réplication asynchrone, cette copie peut ne pas contenir les écritures les plus récentes, donc le basculement peut les perdre. !!La réplication garde une autre copie disponible ; le basculement fait de cette copie celle qu’utilise le service, selon le même principe actif-passif introduit plus tôt.!!
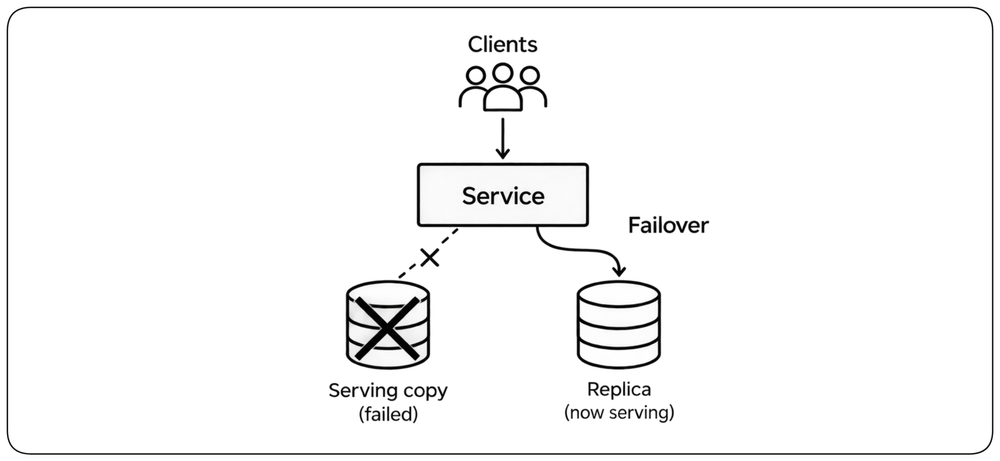
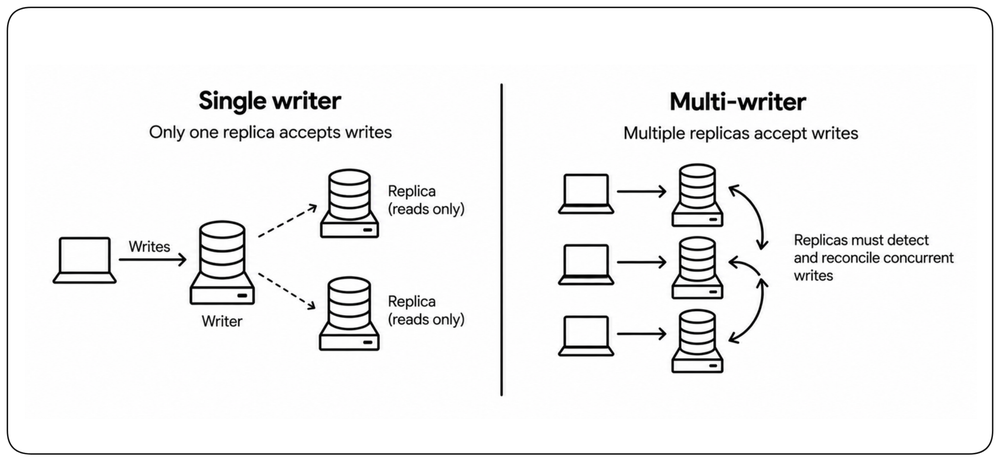
Modèles d’écriture : un seul écrivain vs plusieurs écrivains
Les systèmes répliqués n’acceptent pas tous les écritures de la même manière. Certains utilisent un seul écrivain à la fois : un seul réplica ou groupe est autorisé à accepter les écritures. D’autres permettent à plusieurs réplicas d’accepter des écritures simultanément. Les systèmes multi-écrivains doivent être conçus pour détecter et réconcilier les écritures faites en même temps sur des réplicas différents.
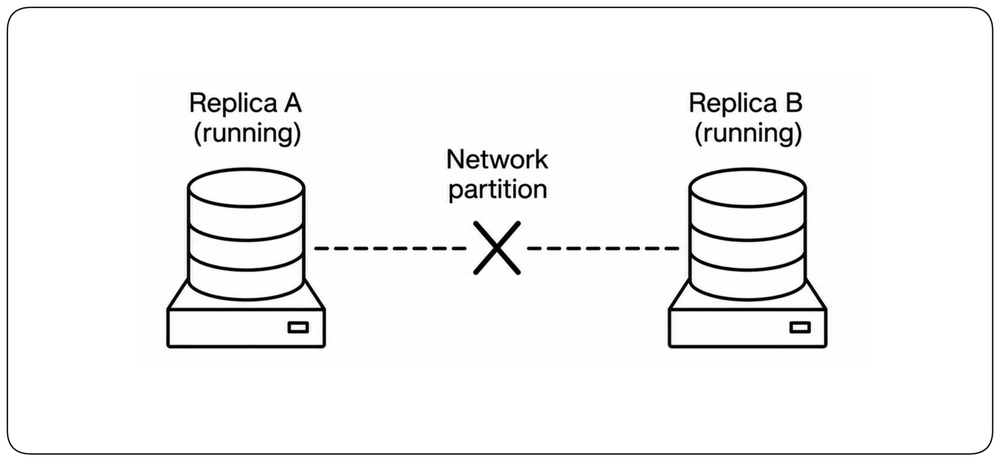
Quand les réplicas ne peuvent plus communiquer
Les réplicas échangent normalement des informations pour que les copies de l’état restent synchronisées. Une défaillance réseau peut rompre cette communication sans arrêter les réplicas eux-mêmes. C’est une partition réseau : chaque côté continue de tourner, mais aucun ne peut savoir ce qui se passe de l’autre. !!Le système doit maintenant décider ce qu’il peut continuer à faire en sécurité jusqu’au rétablissement de la communication.!!
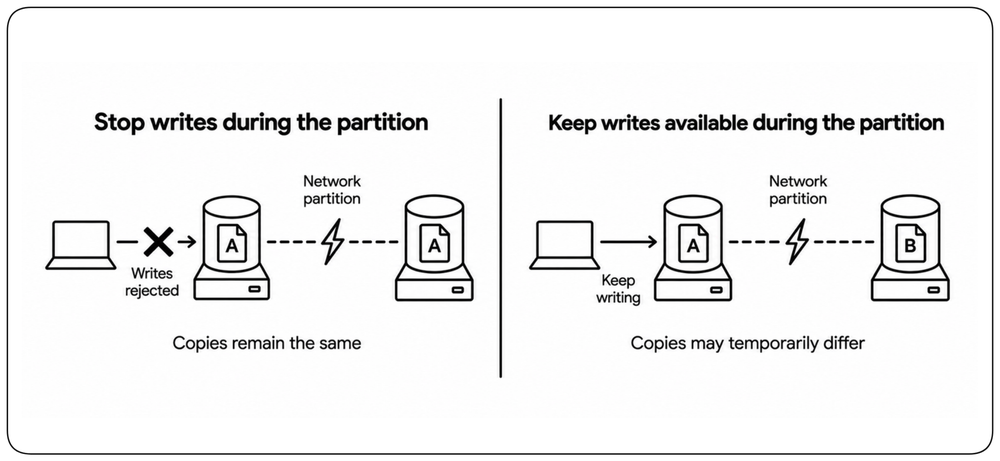
Décider ce qui reste disponible pendant une partition
Lorsque les réplicas ne peuvent pas communiquer, le système doit choisir ce qu’il sacrifie. Il peut arrêter certaines opérations pour éviter que les copies divergent, ou continuer à servir en acceptant que les copies diffèrent temporairement. !!Définissez explicitement quelles capacités utilisateur restent disponibles pendant une partition et quelle différence temporaire entre les copies est acceptable.!!
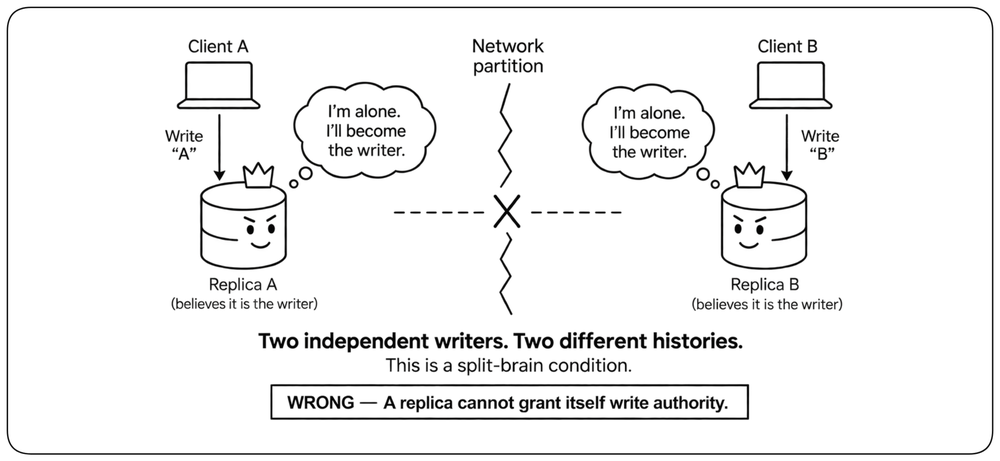
Un seul écrivain : empêcher les écritures en split-brain
Dans une conception à écrivain unique, une partition réseau crée une ambiguïté dangereuse : chaque groupe séparé peut croire qu’il a l’autorité pour accepter les écritures. Si les deux continuent indépendamment, chaque côté peut accepter des écritures différentes, créant deux versions conflictuelles des données. C’est le split-brain. !!Un réplica ne doit pas pouvoir décider seul qu’il est l’écrivain ; l’autorité d’écriture doit être décidée par le système.!!
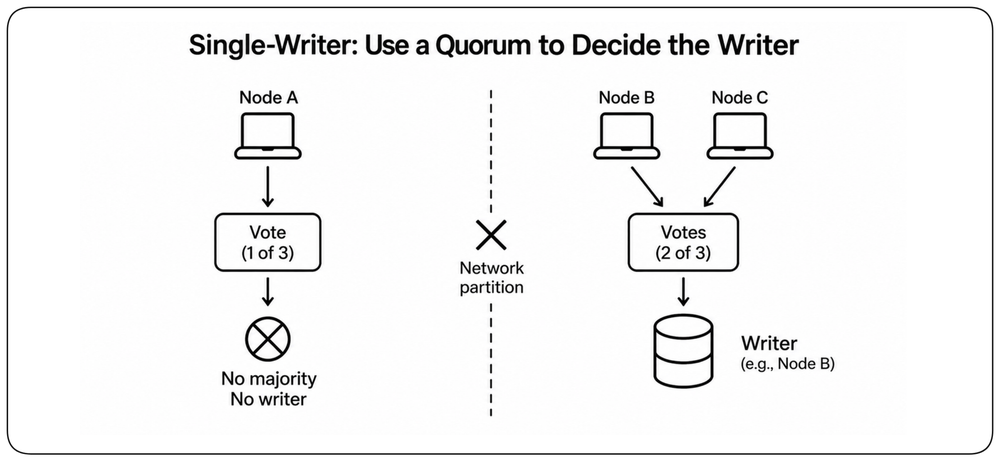
Un seul écrivain : utiliser un quorum pour désigner l’écrivain
Dans une conception à écrivain unique, un seul écrivain peut détenir l’autorité à la fois. Après une défaillance ou une partition réseau, un quorum peut déterminer quel côté est autorisé à établir ou conserver un écrivain. !!Avec trois nœuds votants, deux voix forment une majorité : le côté qui compte deux nœuds peut autoriser un écrivain, tandis que le nœud isolé ne le peut pas.!! Cela empêche une partition de créer deux écrivains indépendants.
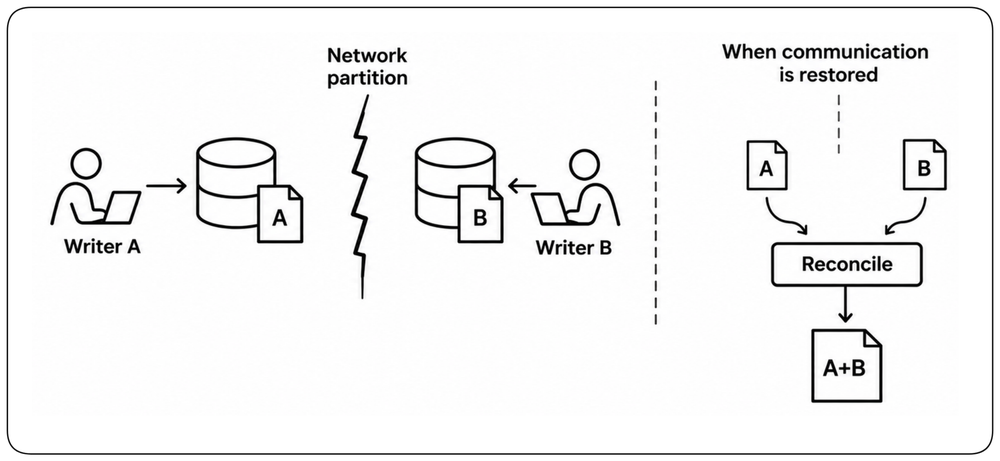
Plusieurs écrivains : réconcilier les écritures concurrentes
Dans une conception multi-écrivains, plusieurs réplicas sont intentionnellement autorisés à accepter des écritures indépendamment. Une partition réseau ne crée donc pas, à elle seule, une autorité d’écriture invalide. Cependant, les écrivains séparés peuvent mettre à jour les mêmes données de façon différente. !!La conception doit inclure un mécanisme défini pour détecter et réconcilier les écritures concurrentes lorsque la communication est rétablie.!!
Définir le degré d’obsolescence toléré en lecture
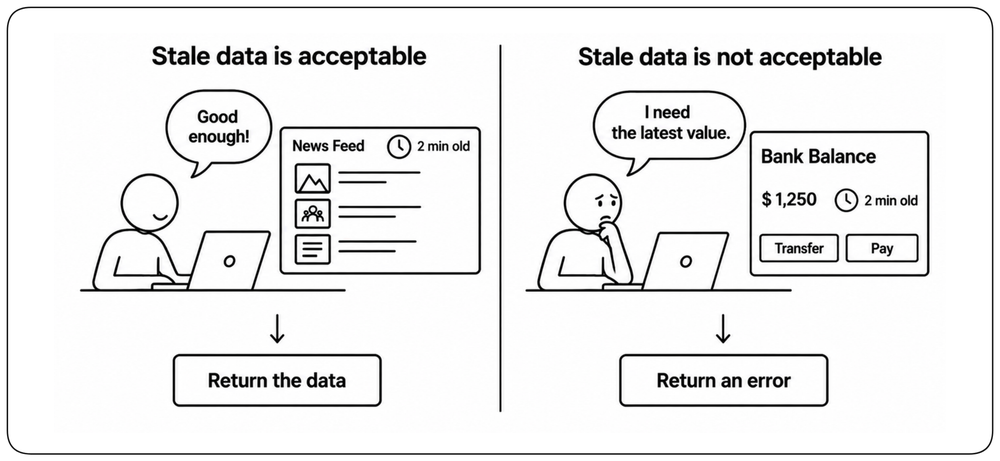
Les réplicas peuvent maintenir les lectures disponibles lorsque la copie la plus fraîche est inaccessible. Cependant, un autre réplica peut ne pas encore contenir les dernières écritures, donc les données retournées peuvent être obsolètes. !!Définissez jusqu’où une lecture peut devenir obsolète avant qu’il soit préférable de retourner une erreur plutôt que des données périmées.!! Différentes capacités peuvent faire des choix différents.
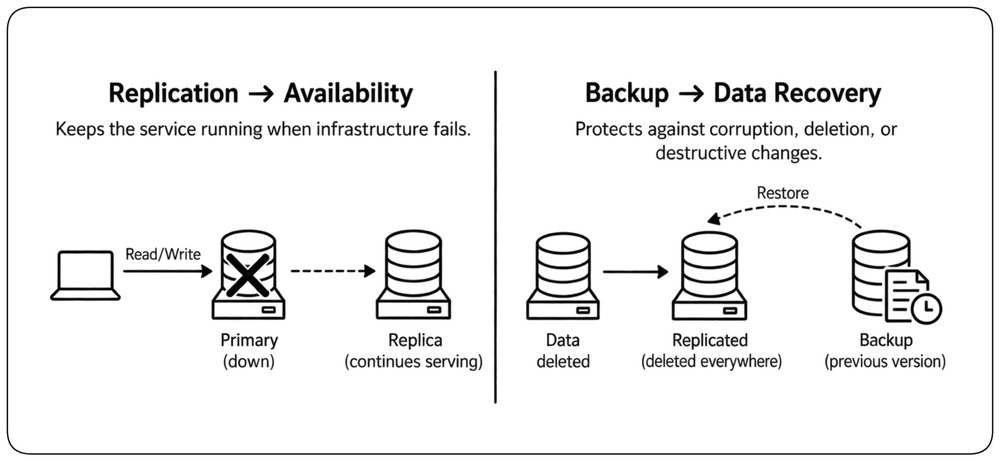
Séparer la continuité de service de la récupération des données
La réplication et la récupération résolvent des problèmes différents. Les réplicas aident le service à continuer lorsque l’infrastructure active tombe ; les sauvegardes et autres mécanismes de récupération indépendants protègent contre la corruption, la suppression ou les changements destructeurs qui peuvent atteindre tous les réplicas actifs. Concevez séparément la poursuite du service et la récupération des données perdues ou corrompues.
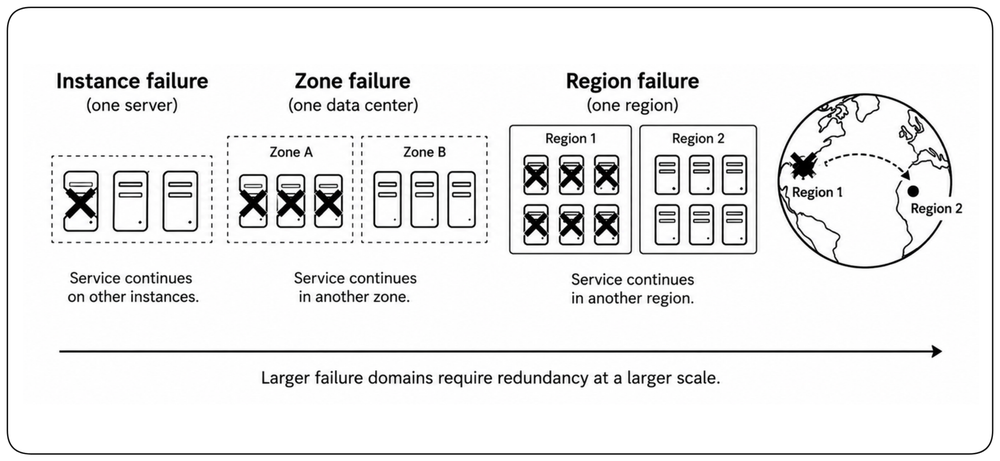
Survivre à des domaines de défaillance plus larges
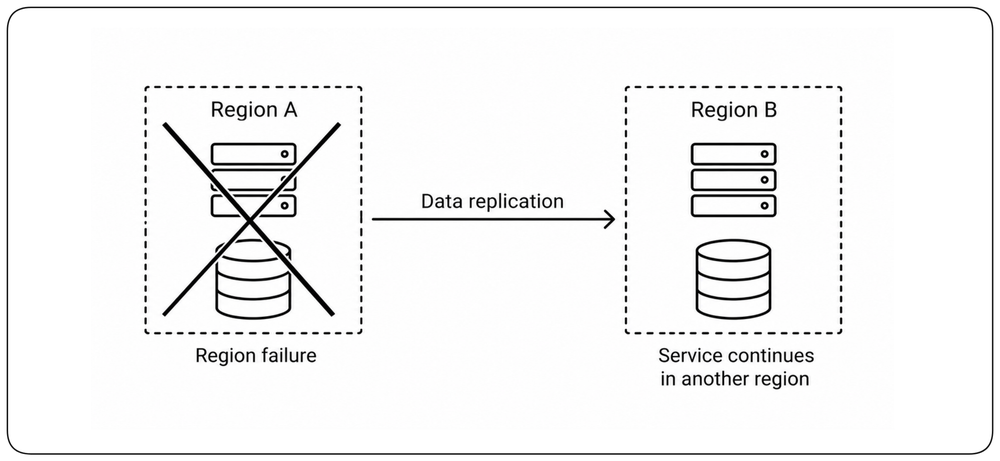
Une défaillance peut affecter plus qu’une seule instance : une zone ou une région entière peut devenir indisponible. Plus la défaillance que vous voulez survivre est large, plus votre redondance doit s’étendre. La redondance entre instances peut survivre à une défaillance d’instance ; entre zones, à une défaillance de zone ; entre régions, à une défaillance régionale. !!Pour chaque domaine de défaillance que le service doit survivre, assez de calcul, d’état, de chemins de trafic, de dépendances critiques et de capacité doivent rester disponibles en dehors de lui.!! Perdre ce domaine de défaillance doit retirer de la capacité, pas le service.
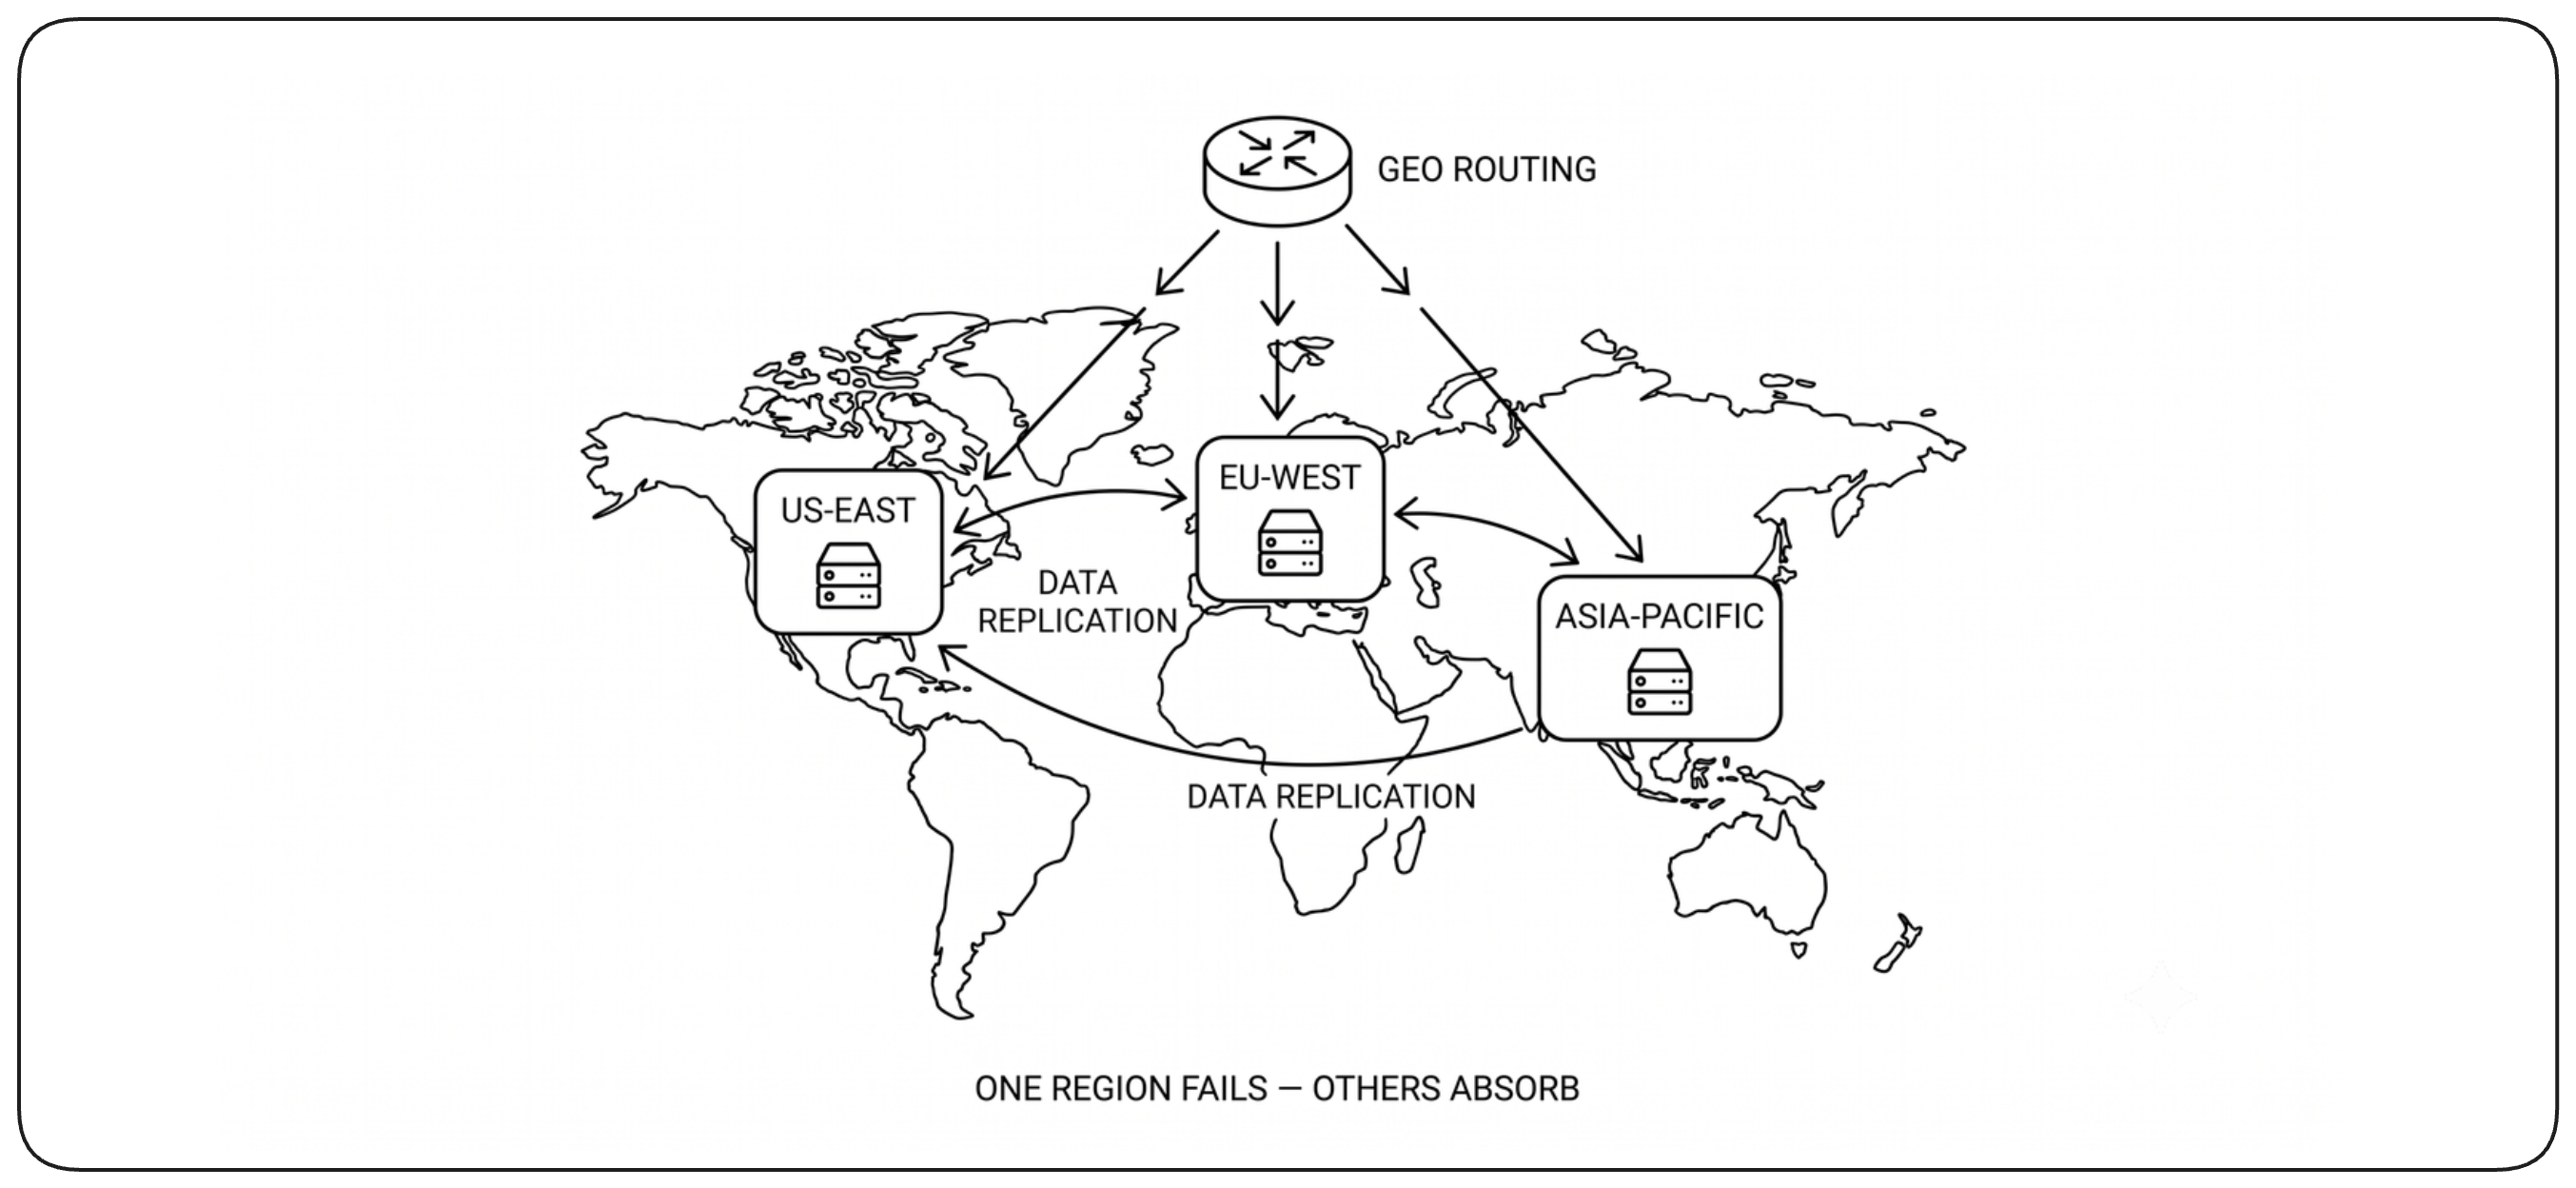
Se protéger contre une défaillance régionale
Un service qui doit survivre à une défaillance régionale a besoin d’un chemin de service complet en dehors de la région défaillante. !!Le calcul, l’état, le routage du trafic, les dépendances critiques et une capacité suffisante doivent rester disponibles sans cette région.!! La région survivante doit pouvoir fournir la capacité requise de façon autonome, et pas seulement contenir un autre déploiement du service.
Les données, la partie difficile de la disponibilité multi-région
La capacité de calcul peut généralement être recréée dans une autre région, mais les données ne peuvent pas simplement être recréées après une défaillance régionale sans perdre la continuité. !!Pour survivre à une défaillance régionale, une copie utilisable des données requises doit déjà exister en dehors de la région défaillante.!! De nombreuses bases de données managées offrent la réplication et le basculement multi-région, mais leurs garanties diffèrent. Comprenez ces garanties avant de vous y fier pour la disponibilité régionale.
Choisir une stratégie de réplication inter-régions
La distance entre régions change le compromis de réplication. La réplication synchrone entre régions ajoute de la latence longue distance au chemin d’écriture, tandis que la réplication asynchrone évite cette latence mais augmente la quantité de données récentes déjà acquittées qui peuvent être perdues lors d’un basculement régional. !!Choisissez la stratégie de réplication inter-régions selon la latence que le chemin d’écriture peut tolérer et la quantité de données récentes que le service peut se permettre de perdre quand une région tombe.!!
Choisir la redondance par domaine de défaillance
Différents domaines de défaillance peuvent utiliser des modèles de redondance différents. !!Choisissez le pattern qui maintient la capacité requise disponible pour chaque domaine de défaillance plutôt que d’imposer un seul modèle à tout le système.!! Par exemple, un service peut utiliser une capacité actif-actif entre zones pour survivre aux défaillances locales, tout en utilisant un basculement actif-passif entre régions pour survivre à la perte d’une région entière.
Préserver la disponibilité pendant le changement
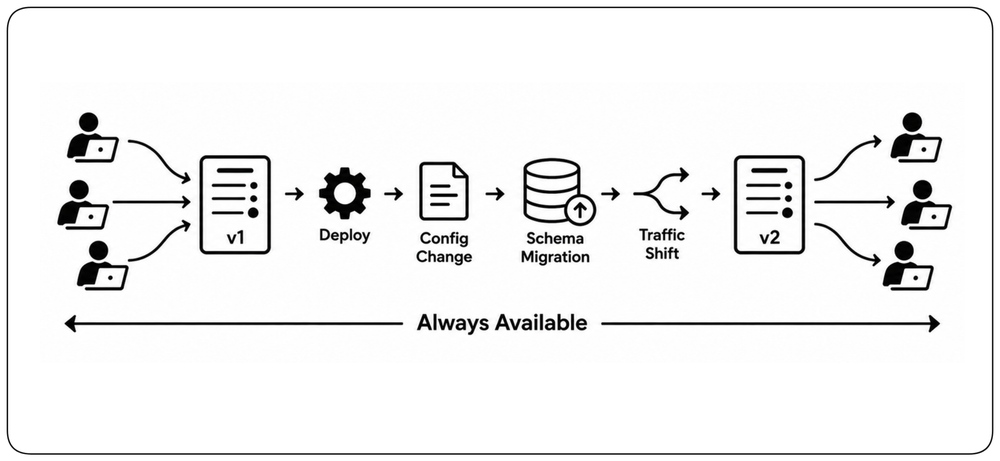
Un système peut devenir indisponible même si aucune de ses infrastructures n’est tombée. Les déploiements, les changements de configuration, les migrations de schéma et les bascules de trafic modifient tous un système en fonctionnement alors que les utilisateurs en dépendent encore. !!La disponibilité doit donc être préservée non seulement dans l’état final, mais tout au long de la transition entre les états.!!
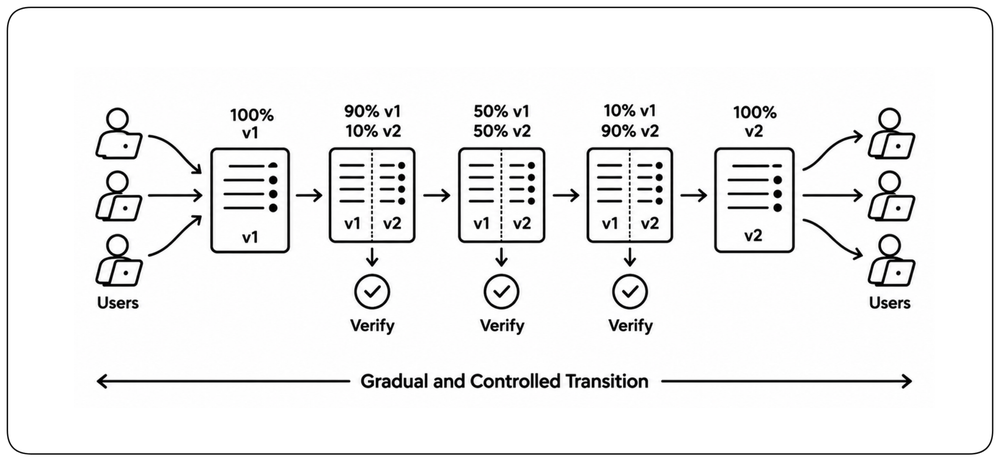
Contrôler la transition
Un changement en production doit passer par des états intermédiaires contrôlés plutôt que de remplacer d’un coup tout le système en fonctionnement. !!Exposez le changement progressivement, vérifiez les capacités utilisateur requises à chaque étape et arrêtez la progression avant que l’exigence de disponibilité ne soit violée.!! L’architecture doit fournir les frontières, les signaux de santé et la compatibilité nécessaires pour rendre ce contrôle possible ; les techniques détaillées de rollout relèvent du release management.
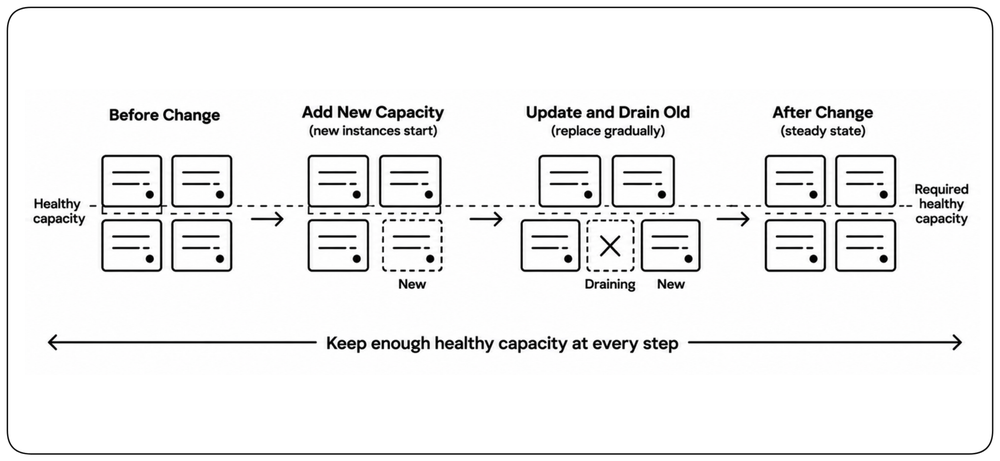
Garder assez de capacité pendant que le système change
Les changements peuvent réduire temporairement la capacité saine disponible pour servir le trafic et absorber les défaillances. !!Planifiez les changements en fonction de la topologie dégradée : assez de capacité saine doit rester disponible à mesure que la nouvelle capacité est introduite et l’ancienne retirée.!! Les rolling updates, les déploiements blue-green et les canary releases sont différents mécanismes pour préserver cette marge.
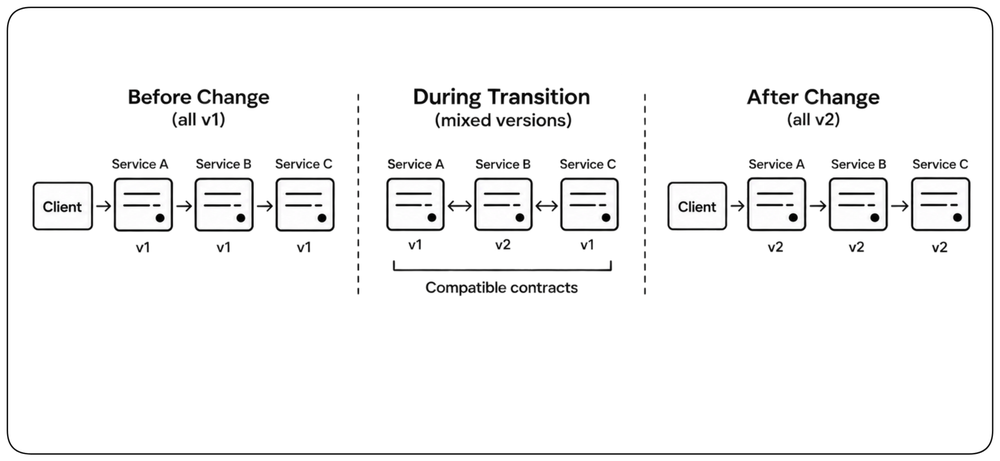
Garder les anciennes et nouvelles versions compatibles
Les changements atteignent rarement tous les composants au même instant. Pendant une transition, d’anciennes et de nouvelles versions peuvent tourner côte à côte et communiquer entre elles. !!Concevez les interfaces, les protocoles et les contrats de données pour que des versions mixtes puissent coexister en sécurité pendant toute la durée du changement.!! Un déploiement devient un risque de disponibilité lorsqu’une version suppose que tous les autres composants ont déjà changé.
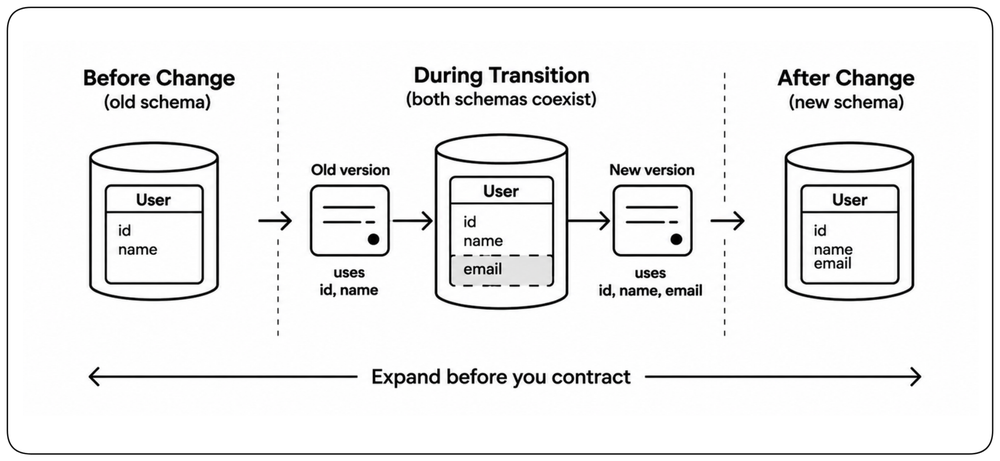
Étendre les données avant de les contracter
Les changements de données sont particulièrement difficiles car les versions applicatives et l’état stocké évoluent à des vitesses différentes. !!Ajoutez la nouvelle représentation avant de supprimer l’ancienne, et gardez les deux utilisables jusqu’à ce que toutes les versions dépendantes aient terminé la transition et que les données existantes aient été migrées.!! Les migrations expand-contract créent cette fenêtre de compatibilité et évitent que l’évolution du schéma n’impose une indisponibilité.
Concevoir un chemin de récupération sûr
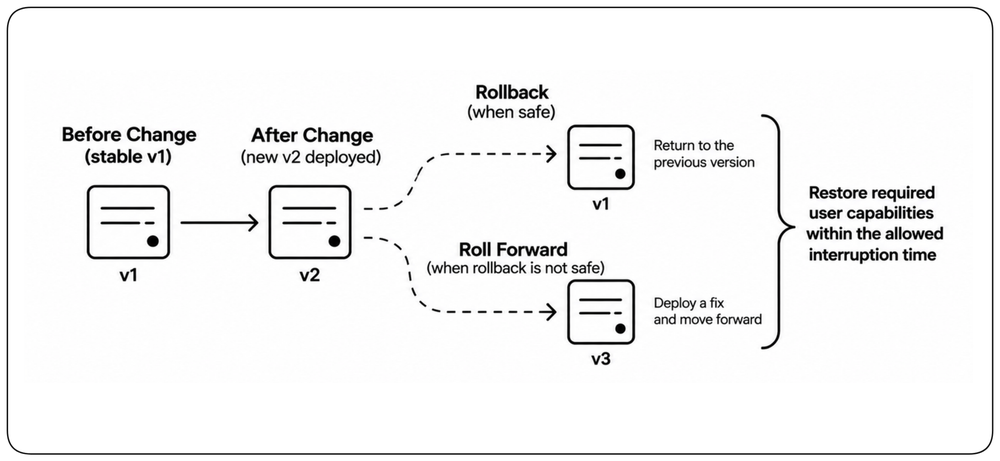
Un changement n’est pas sûr simplement parce qu’on peut l’introduire progressivement ; le système doit aussi disposer d’un chemin de récupération défini lorsque le nouvel état s’avère défaillant. !!Définissez le chemin de récupération avant le changement, en utilisant le rollback lorsque l’annulation est sûre et un chemin de roll-forward explicite lorsque les données, la configuration ou des effets de bord externes rendent le rollback dangereux.!! La récupération doit rétablir les capacités utilisateur requises dans la limite d’interruption autorisée par l’exigence de disponibilité.
Pour aller plus loin
Chapitre : Concevoir pour être livré, en particulier la section sur le changement sûr, qui couvre les techniques de déploiement et de release utilisées pour introduire les changements en production en toute sécurité.
Concevoir les fonctionnalités IA pour la disponibilité
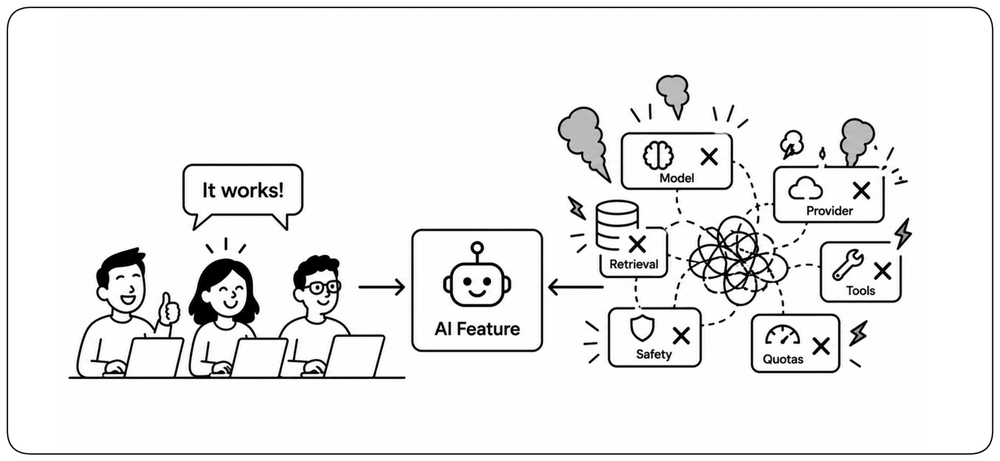
La disponibilité de l’IA doit être définie à la frontière de la capacité utilisateur, pas à celle de l’endpoint du modèle. Un modèle sain est inutile si la récupération (retrieval), les outils, les services de sécurité, les quotas ou la capacité du fournisseur empêchent la capacité d’aboutir. À l’inverse, le produit peut rester disponible même lorsque le modèle préféré ne l’est pas. !!Concevez la fonctionnalité IA pour que la perte d’un modèle, d’un fournisseur ou d’une dépendance ne devienne pas automatiquement la perte de la capacité utilisateur.!!
Modéliser le chemin d’inférence IA complet
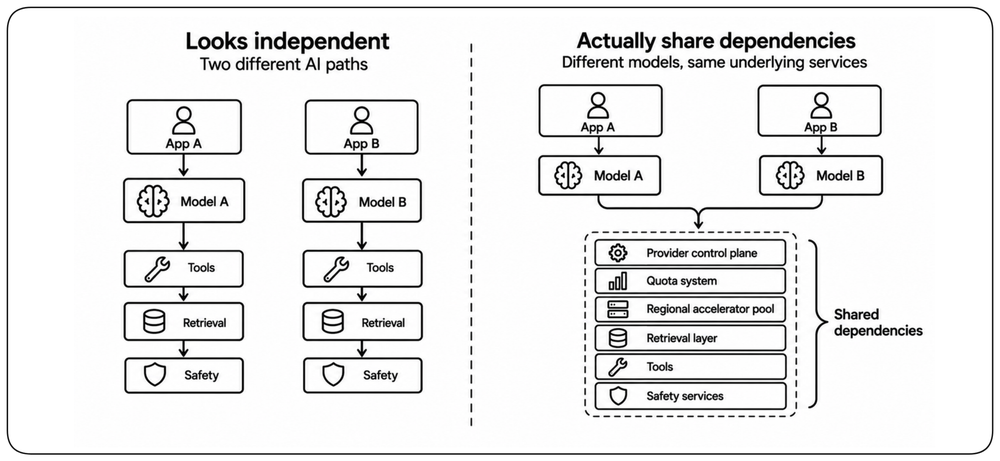
Les chemins IA peuvent sembler redondants parce qu’ils utilisent des endpoints ou des déploiements de modèles différents tout en dépendant des mêmes services sous-jacents. Une requête d’inférence peut exiger des endpoints de modèle, des stores de retrieval, des services de sécurité, des outils, des pools d’accélérateurs régionaux, des systèmes de quotas et des control planes de fournisseur. !!Deux chemins IA apparemment indépendants ne le sont pas s’ils partagent le même control plane de fournisseur, le même pool de quotas, la même région, la même couche de retrieval ou le même outil critique.!! Cartographiez le chemin complet avant de considérer une alternative comme une protection contre la défaillance.
Séparer la disponibilité du produit de celle du modèle
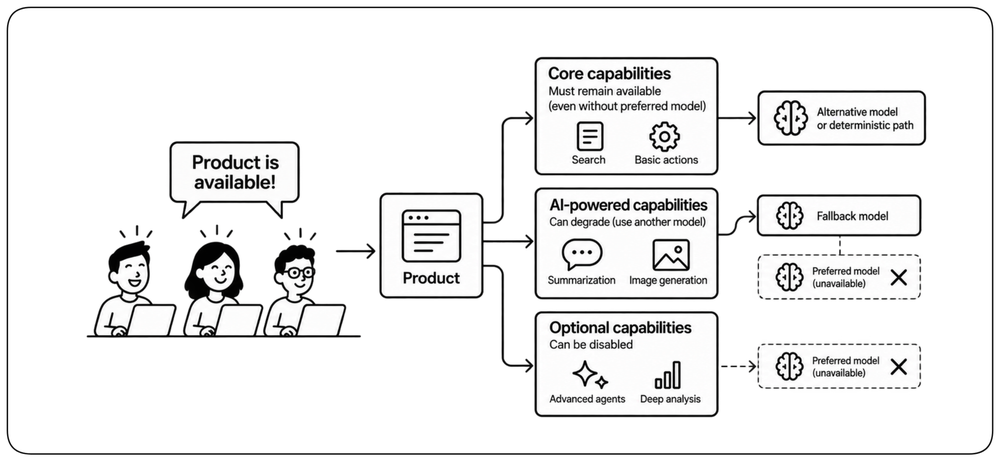
Le modèle préféré est une dépendance d’implémentation, pas nécessairement la frontière de disponibilité du produit. Certaines capacités peuvent se replier sur un autre modèle ou sur un chemin déterministe plus simple lorsque le modèle préféré est indisponible. Ce chemin alternatif est le fallback. Les capacités optionnelles peuvent se dégrader pendant que le produit principal continue de servir. !!Définissez quelles capacités utilisateur exigent l’IA, lesquelles peuvent se dégrader et lesquelles doivent rester disponibles sans le modèle préféré.!! Cela évite qu’un seul déploiement de modèle ne devienne le plafond de disponibilité implicite de tout le service.
Planifier la capacité IA pour la topologie dégradée
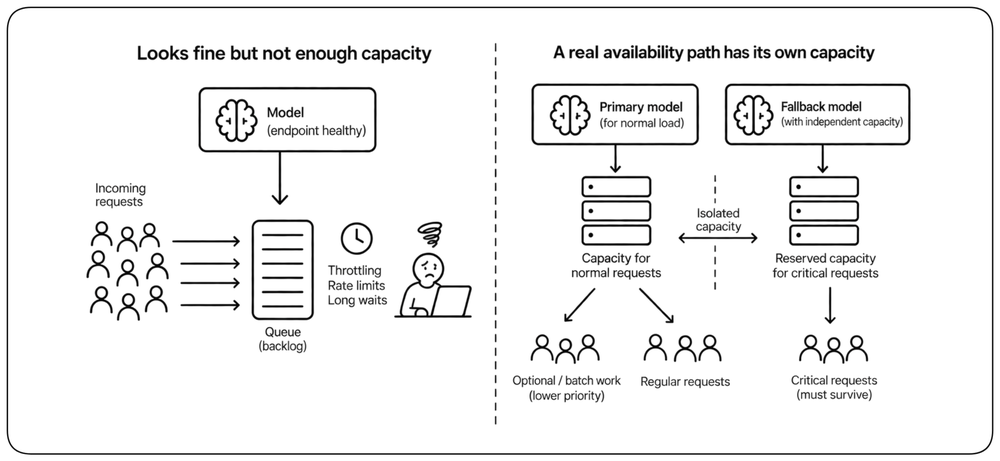
Un endpoint d’inférence peut être sain et pourtant incapable de servir la charge requise. La rareté des accélérateurs, les quotas de tokens, le throttling, les requêtes longues et l’allocation dynamique par le fournisseur peuvent tous transformer la capacité en contrainte de disponibilité. !!Un chemin de fallback n’est pas un chemin de disponibilité s’il n’a pas assez de capacité indépendante pour supporter la charge qui doit survivre.!! L’isolation de capacité et les priorités de charge empêchent le travail optionnel ou batch d’épuiser les chemins nécessaires aux requêtes critiques.
Un fallback doit rester utilisable
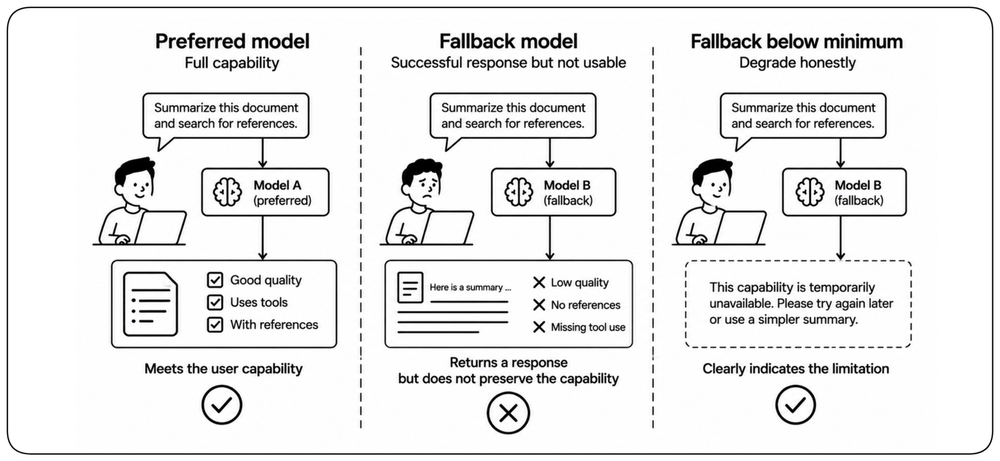
Un fallback peut retourner une réponse réussie sans préserver une capacité utilisateur disponible. Les modèles et les fournisseurs peuvent différer par la qualité de sortie, la latence, les limites de contexte, l’usage des outils, le comportement de sécurité et la sémantique des protocoles. !!Un fallback IA ne compte comme disponible que s’il préserve le comportement minimal acceptable de la capacité utilisateur.!! Définissez ce minimum explicitement et validez chaque fallback par rapport à lui ; sinon, dégradez honnêtement la capacité plutôt que de retourner un résultat inutilisable ou dangereux.
Prouver l’architecture de disponibilité
Les affirmations de disponibilité restent des hypothèses architecturales tant que le système ne les démontre pas face aux défaillances et aux transitions qu’il promet de survivre.
Tester chaque promesse de disponibilité
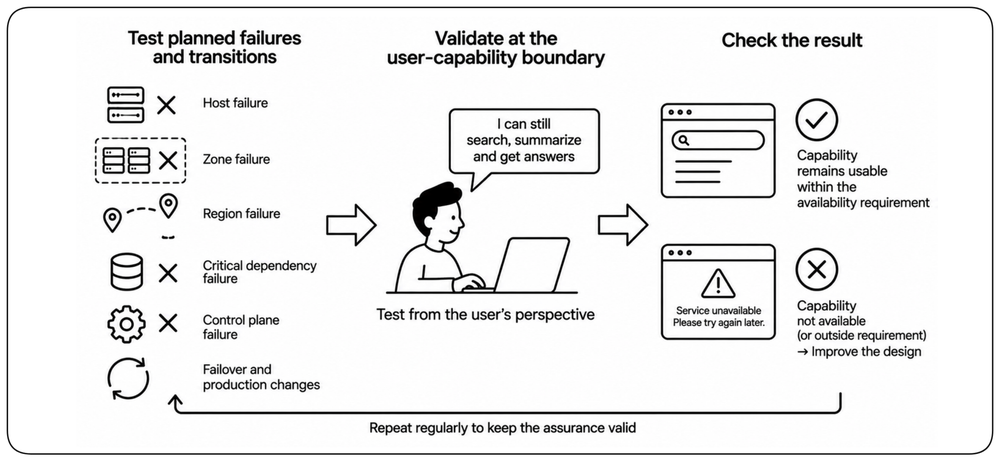
Une conception de disponibilité reste une hypothèse architecturale tant que les défaillances et transitions promises ne sont pas exercées. Testez la perte d’hôtes, de zones, de régions, de dépendances critiques et de control planes, ainsi que les basculements et les changements en production que le système prétend tolérer. !!Validez le résultat à la frontière de la capacité utilisateur, pas seulement via la santé des composants.!! Un test réussit lorsque la capacité requise reste utilisable dans les limites de l’exigence de disponibilité.
Tester la topologie dégradée sous charge
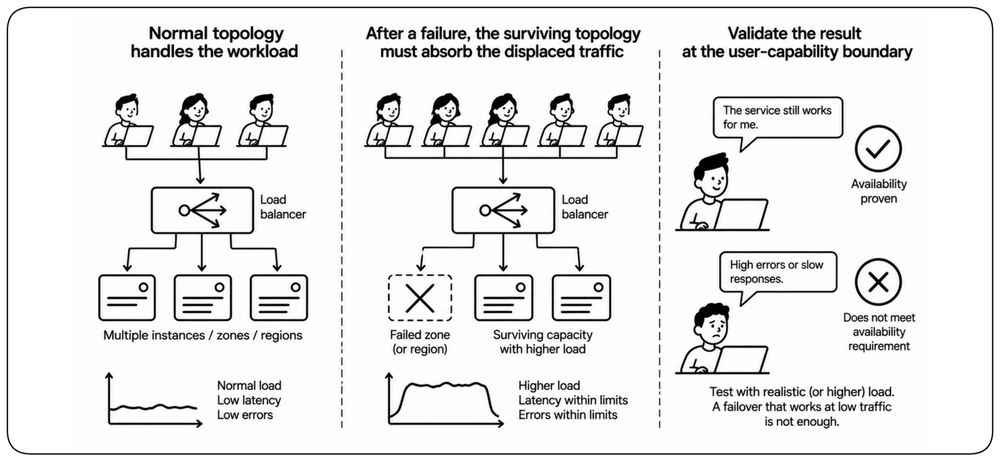
Un système peut basculer avec succès à faible trafic et s’effondrer sous sa charge réelle. La topologie survivante doit absorber le trafic déplacé tout en fonctionnant avec moins de ressources, des quotas plus serrés et moins de marge. !!La disponibilité n’est prouvée que lorsque la topologie dégradée supporte la charge requise dans ses limites de latence et d’erreurs.!!
Tester le chemin de récupération complet
Survivre à la défaillance initiale n’est que la première partie de la récupération. Le système doit restaurer la capacité, réconcilier l’état, rééquilibrer le trafic et revenir à une topologie stable sans provoquer une autre panne. !!Le test ne se termine que lorsque le système est de nouveau stable, dans la limite de perte de données permise et sans propriété conflictuelle.!! La supervision détaillée, l’alerting, la réponse aux incidents et les runbooks relèvent de l’operability.
Pour aller plus loin
Chapitre : Concevoir pour l’operability.