Concevoir pour être exploité (SRE)
Chapter Info
Calculating... Writing Progress: 20%
Un système n’est pas bien conçu s’il fonctionne mais ne peut pas être exploité de façon fiable. La production impose d’autres contraintes : les pannes doivent être comprises sous pression, la reprise doit être sûre, la fiabilité doit être mesurable, et le système doit rester soutenable pour les personnes qui l’exploitent.
L’opérabilité est donc une propriété de conception, pas quelque chose qu’une équipe d’exploitation vient greffer après la livraison. Le Site Reliability Engineering (SRE) fournit une grande partie des pratiques d’ingénierie pour y parvenir — en faisant de la fiabilité quelque chose qui se mesure, s’exploite et s’améliore en continu.
Ce chapitre explore la façon de définir la fiabilité, d’exploiter et de rétablir les systèmes, la manière dont les équipes apprennent des pannes, et comment les agents IA transforment le travail d’exploitation.
L’état d’esprit de l’opérabilité
L’opérabilité est la discipline qui rend un système praticable à exploiter, à faire évoluer et à rétablir à toute heure. Elle est conçue dans le système plutôt qu’ajoutée après la livraison.
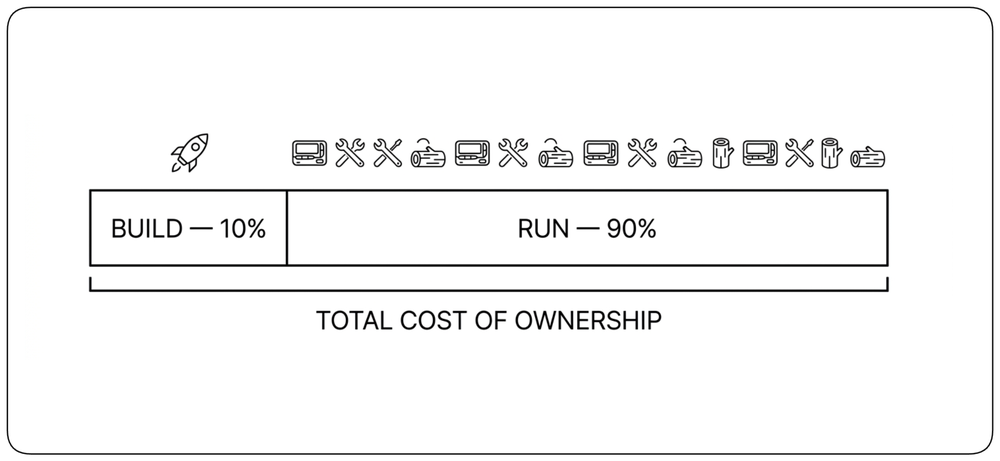
Construire n’est que le début, pas la fin
Le coût affiché d’un logiciel, c’est ce qu’il faut pour livrer la version 1. Le coût réel, c’est tout ce qui suit : le maintenir en service, le patcher, le migrer, le déboguer sous charge et le supporter à travers des générations d’ingénieurs. Les décisions de conception traitent souvent la livraison comme une ligne d’arrivée. L’opérabilité part de l’hypothèse inverse : la livraison est le moment où le système commence sa longue vie.
Opérabilité, observabilité et disponibilité
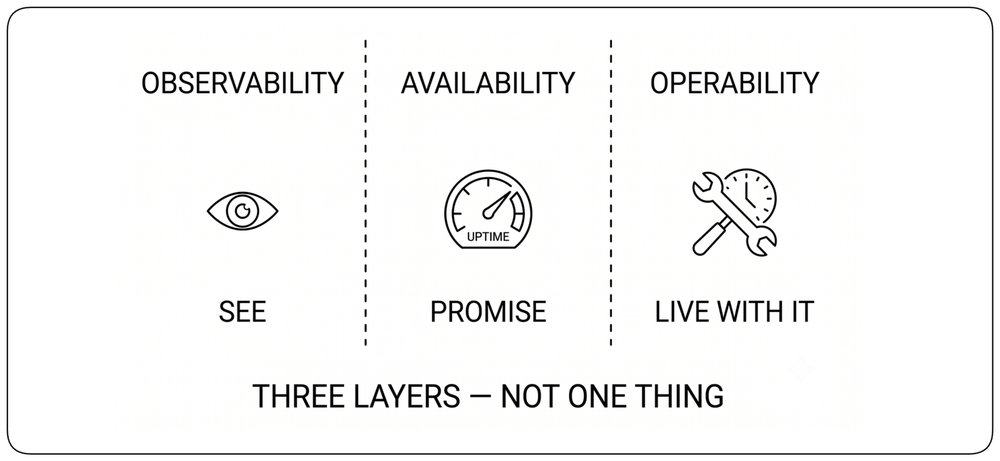
Trois mots, trois rôles différents. !!L’observabilité est la capacité de voir ce que fait le système. La disponibilité indique si les utilisateurs peuvent l’utiliser avec succès. L’opérabilité est la discipline qui consiste à l’exploiter, le faire évoluer, le déboguer et le rétablir de façon durable!!. Un système peut être observable mais difficile à exploiter, ou disponible mais dépendant d’un effort humain insoutenable.
You Build It, You Run It
Quand l’équipe qui écrit le code est aussi exposée à ses conséquences opérationnelles, les décisions de conception changent. Le retour est immédiat : la latence compte davantage, les erreurs doivent être lisibles, les retries ont besoin de limites et les déploiements de valeurs par défaut plus sûres. Séparer complètement ceux qui construisent des conséquences opérationnelles affaiblit cette boucle de rétroaction. Donner aux équipes d’ingénierie la responsabilité directe du comportement de leurs systèmes en production fait de la qualité opérationnelle une partie de la conception.
Site Reliability Engineering
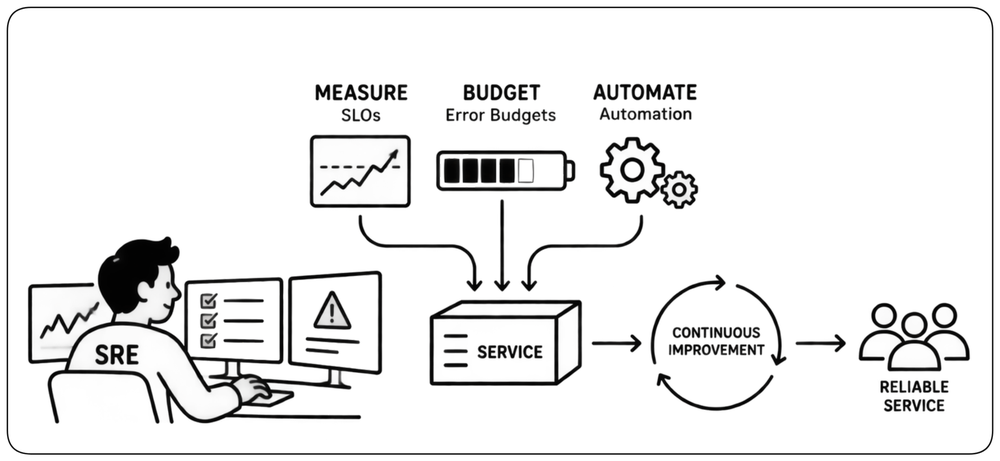
L’opérabilité est l’objectif ; le Site Reliability Engineering est une discipline d’ingénierie pour l’atteindre. Le SRE traite la fiabilité comme quelque chose qui se mesure, se budgète, s’automatise et s’améliore en continu. Les service-level objectives définissent ce que fiable veut dire, les error budgets donnent une base quantitative pour décider du risque opérationnel que l’équipe peut prendre, et le travail d’exploitation devient une matière première pour améliorer le système plutôt qu’un fardeau humain permanent.
Une grande partie de la pratique SRE moderne a été codifiée et popularisée chez Google, notamment à travers Site Reliability Engineering (2016) et The Site Reliability Workbook (2018). Ces ouvrages ont contribué à établir plusieurs pratiques utilisées dans tout ce chapitre, dont les SLO, les error budgets, la gestion du toil, l’astreinte durable et l’apprentissage par les incidents.
Définir la fiabilité
La fiabilité commence par l’utilisateur
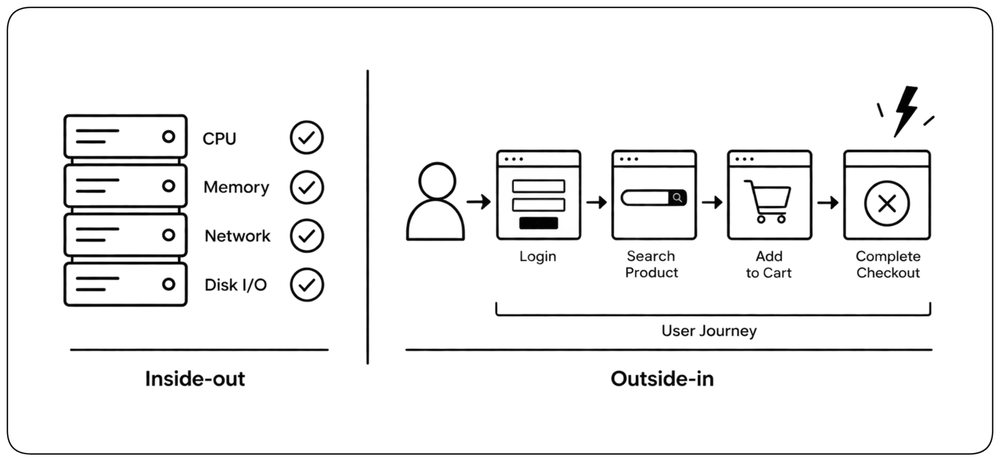
Un système peut avoir un CPU, une mémoire, un réseau et des processus en bonne santé alors que les utilisateurs échouent encore à accomplir ce qui compte. !!La fiabilité doit donc se définir de l’extérieur vers l’intérieur!! : partir des parcours utilisateur que le service existe pour soutenir, puis utiliser les signaux d’infrastructure pour expliquer pourquoi ces parcours réussissent ou échouent.
Mesurer ce que vivent les utilisateurs
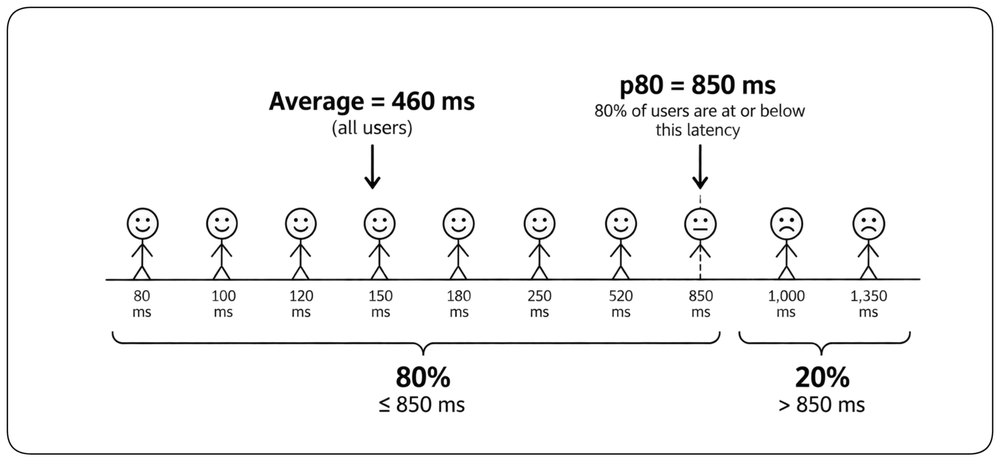
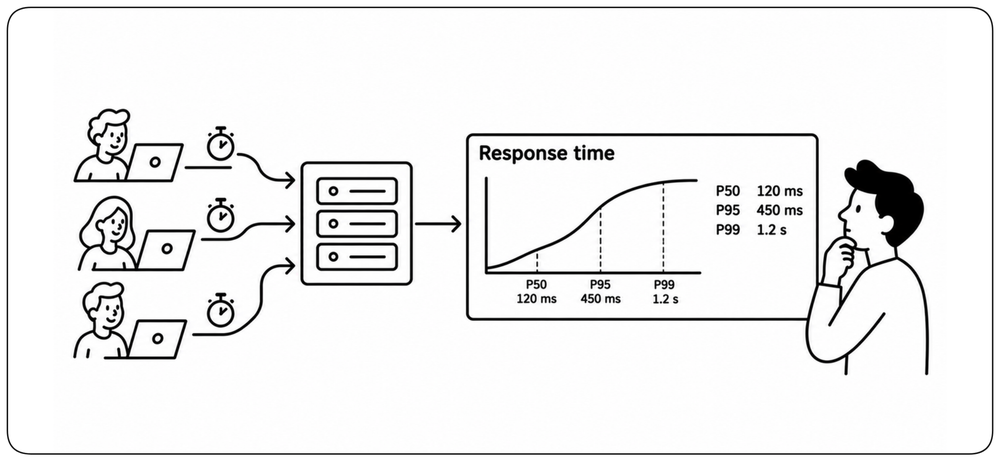
Les métriques de fiabilité doivent décrire ce que les utilisateurs vivent réellement, et pas seulement résumer le comportement du système. Par exemple, la latence se comprend mieux comme une distribution de temps de réponse que comme une moyenne unique. Les moyennes peuvent masquer des expériences lentes pour une part significative des utilisateurs, alors que les percentiles les rendent visibles.
Niveaux de service — SLI, SLO, SLA
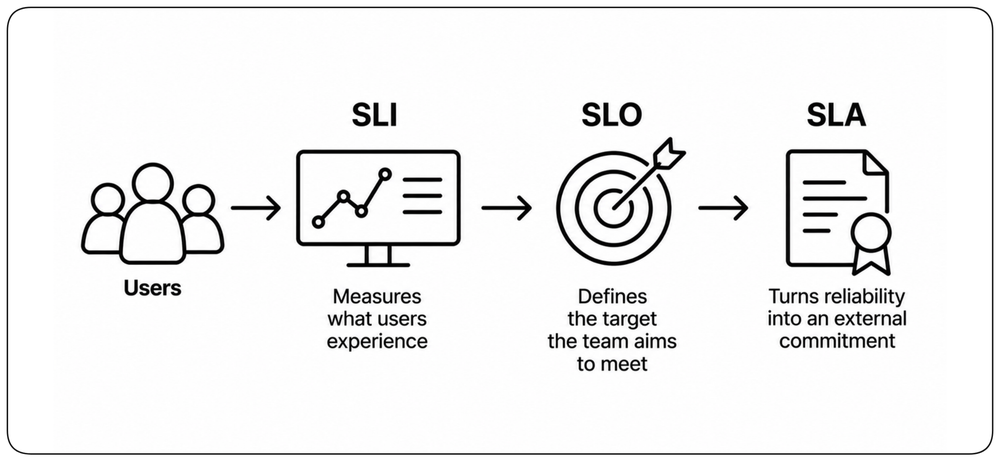
La fiabilité devient gérable dès qu’on peut la définir. Un SLI mesure ce que vivent les utilisateurs, un SLO définit la cible que l’équipe vise, et un SLA transforme la fiabilité en engagement externe. Ensemble, ils remplacent des attentes floues par des résultats mesurables.
SLI — ce que l’on mesure
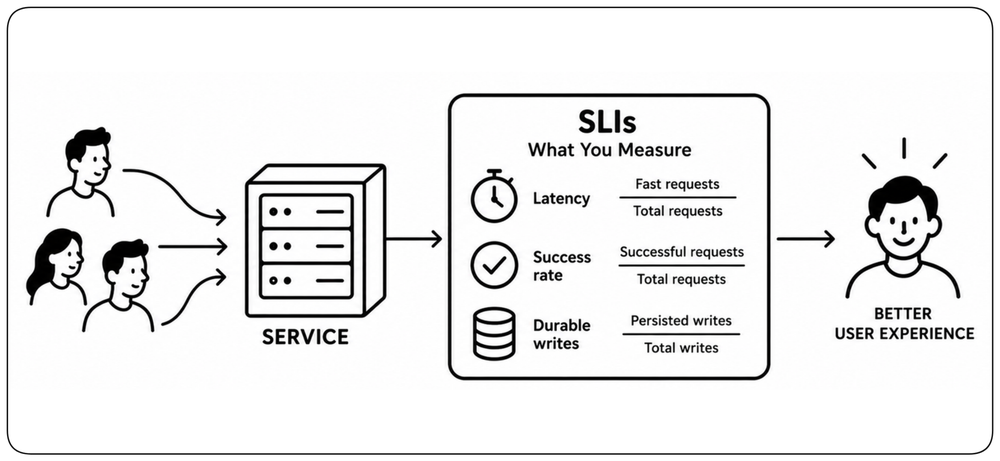
Un Service Level Indicator mesure un aspect précis de l’expérience du service : la proportion de requêtes traitées sous un seuil de latence, la fraction qui répondent avec succès, ou la part des écritures qui sont persistées durablement. Un bon SLI change quand l’expérience utilisateur change. Les métriques d’infrastructure comme l’utilisation du CPU sont généralement des signaux de diagnostic, pas des SLI orientés utilisateur. Choisissez quelques mesures orientées utilisateur et exprimez-les comme un ratio d’événements réussis sur le total des événements.
SLO — la cible que l’on vise
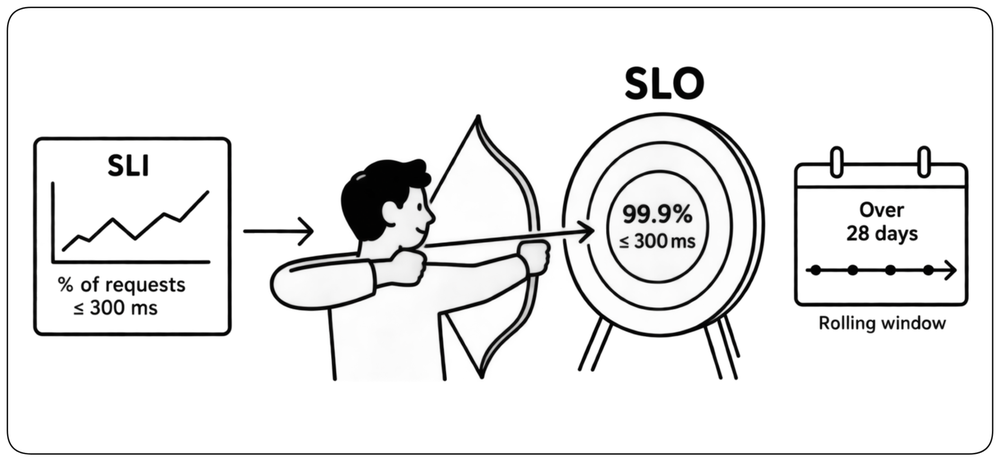
Un Service Level Objective est la cible interne que l’on fixe pour un SLI sur une fenêtre : « 99,9 % des requêtes sont traitées en moins de 300 ms, mesuré sur 28 jours. » La fenêtre de mesure et la définition d’un événement réussi font toute la différence. La fenêtre doit correspondre à la manière dont le service est exploité ; les fenêtres glissantes sont souvent utiles car elles évitent les effets de bord du calendrier. Les objectifs de latence doivent capturer la proportion de requêtes qui respectent un seuil pertinent plutôt que de s’appuyer sur une moyenne qui peut masquer de mauvaises expériences utilisateur.
SLA — la promesse avec des conséquences
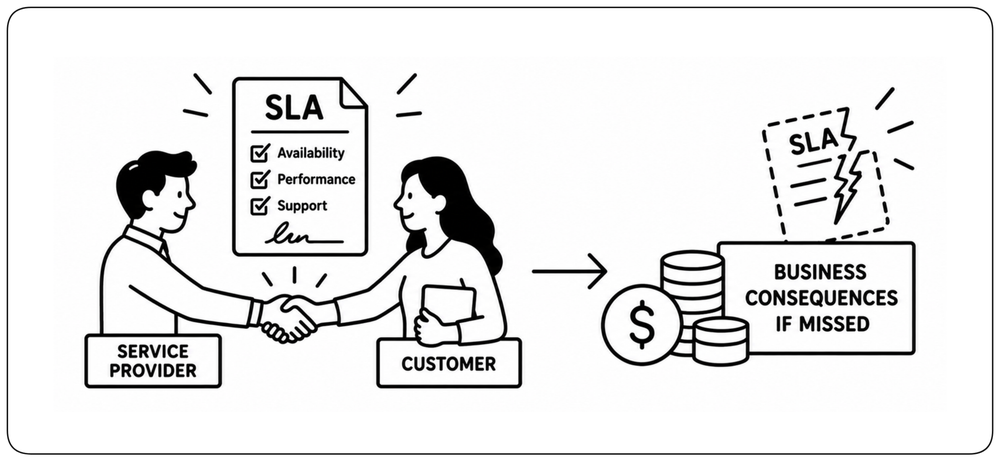
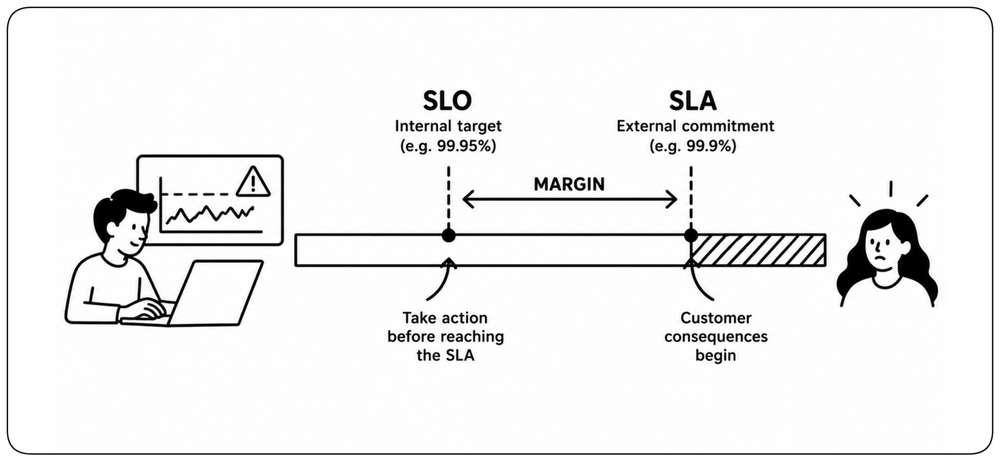
Un Service Level Agreement est un engagement externe assorti de conséquences business s’il n’est pas tenu. Un SLA est une promesse commerciale ; un SLO est une cible d’ingénierie.
Garder une marge entre cibles internes et engagements externes
Quand un SLA externe existe, un SLO interne peut fournir un seuil d’action plus précoce. Fixer la cible interne au-dessus de l’engagement contractuel donne à l’équipe de la marge pour réagir avant que les conséquences pour le client ne commencent. La taille de cette marge doit refléter le service, le contrat et la vitesse à laquelle la fiabilité peut être rétablie.
Les dépendances plafonnent la fiabilité
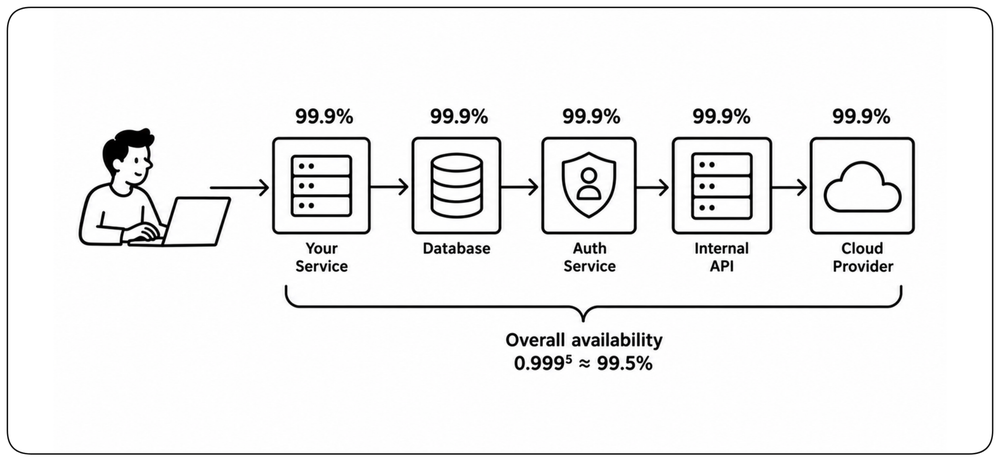
Aucun service n’est une île : le vôtre appelle une base de données, un service d’authentification, des API internes et un fournisseur cloud. Pour des dépendances obligatoires appelées en série sans repli, les disponibilités se multiplient : cinq dépendances à 99,9 % chacune plafonnent le chemin à 0,999⁵ ≈ 99,5 % avant même que votre propre code n’exécute une seule ligne. La redondance, le cache, la dégradation gracieuse et le travail asynchrone peuvent changer cette équation. La leçon : fixer un SLO qui reflète le chemin réellement emprunté par les utilisateurs, avec ses dépendances et les mécanismes qui en réduisent l’impact.
Error budgets
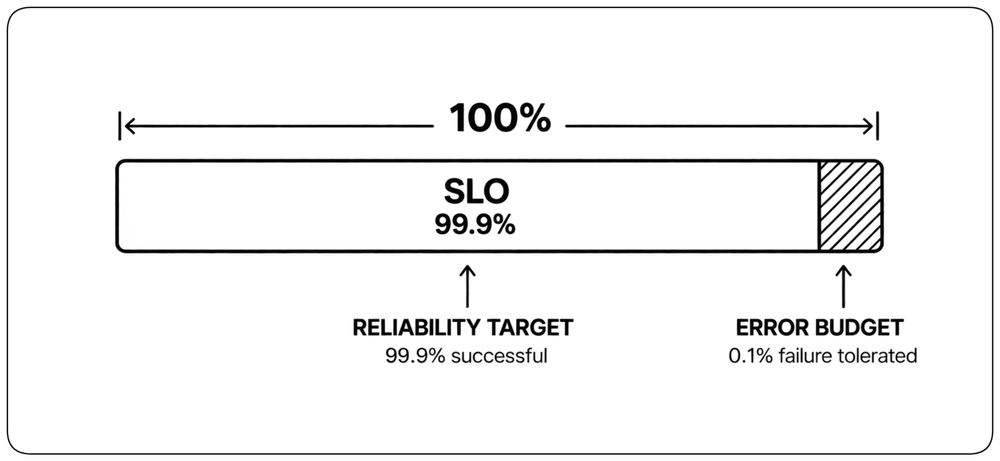
Tout SLO implique une certaine tolérance à l’échec. Les error budgets rendent cette tolérance explicite pour que la fiabilité et le risque de livraison se discutent avec des chiffres plutôt que des opinions.
100 % est la mauvaise cible
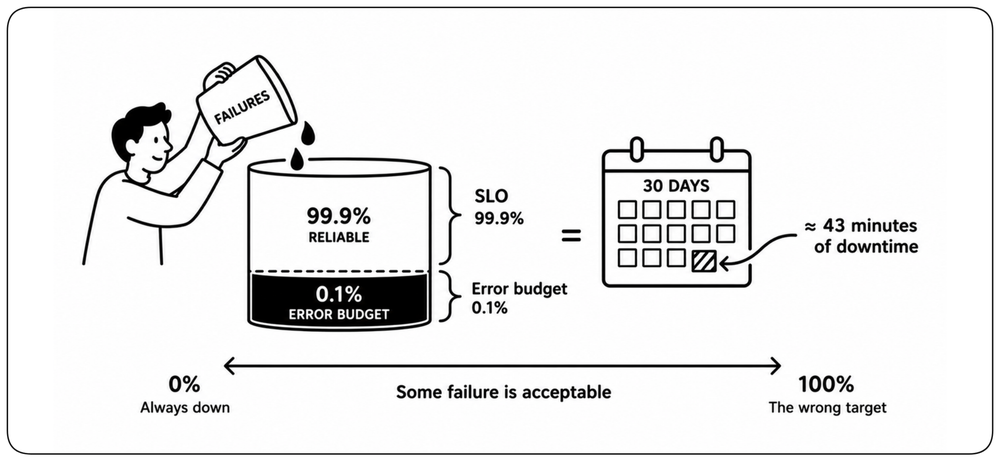
La fiabilité parfaite est rarement la bonne cible. L’écart entre 100 % et le SLO est l’error budget : la quantité de non-fiabilité que le service peut absorber tout en respectant son objectif. Pour un SLO de disponibilité de 99,9 %, cela correspond à environ 43 minutes d’indisponibilité sur un mois de 30 jours. Cette marge reconnaît qu’une non-fiabilité limitée peut survenir alors que le service respecte toujours son objectif.
Utiliser l’error budget pour gouverner le risque
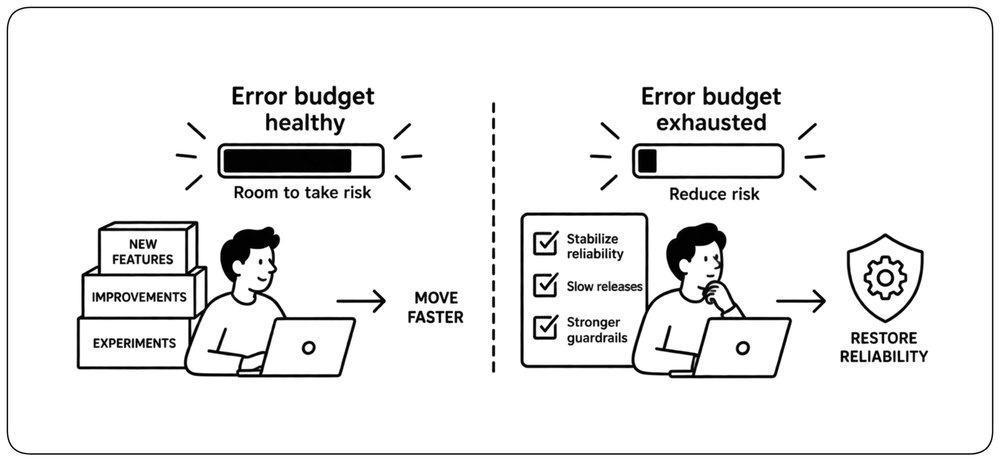
Un error budget transforme un débat subjectif sur le risque de livraison en politique explicite. !!Quand le budget est sain, l’équipe peut prendre plus de risques ; quand il est épuisé, elle doit réduire le risque et prioriser le rétablissement de la fiabilité!!. La réponse exacte est une décision produit — ralentir les releases, exiger des garde-fous plus forts ou concentrer la capacité sur la stabilisation — mais elle est convenue avant l’incident ou l’échéance. Le chiffre ne remplace pas le jugement ; il lui donne un cadre partagé.
Les périodes critiques changent la politique de risque
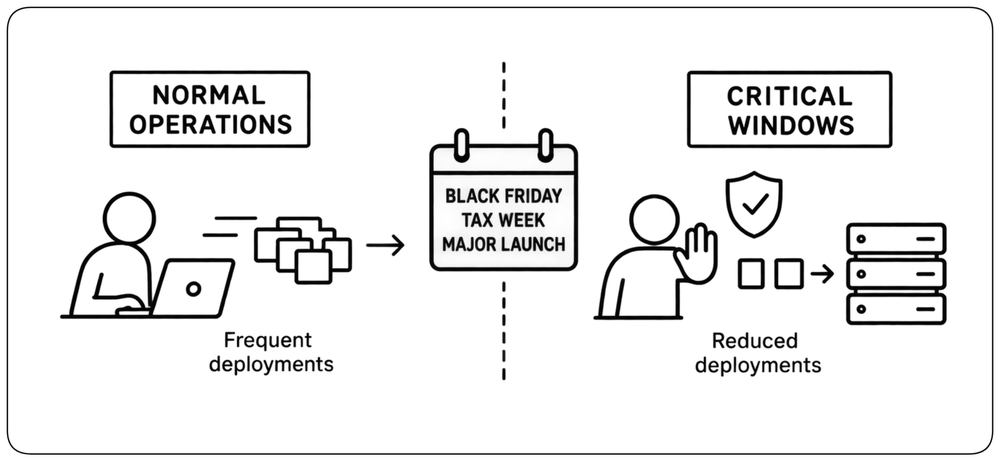
Les périodes critiques pour le business peuvent justifier une posture d’exploitation plus prudente même quand le SLO sous-jacent ne change pas. Lors d’événements comme le Black Friday, les échéances fiscales ou les grands lancements, le coût d’un échec est plus élevé : les équipes peuvent donc réduire la cadence de déploiement, augmenter la marge de capacité, durcir le contrôle des changements et escalader plus tôt. !!La cible de fiabilité définit ce dont les utilisateurs ont besoin ; la politique d’exploitation définit quel risque l’organisation accepte de prendre à ce moment-là!!.
Fixer les cibles de fiabilité à partir de preuves
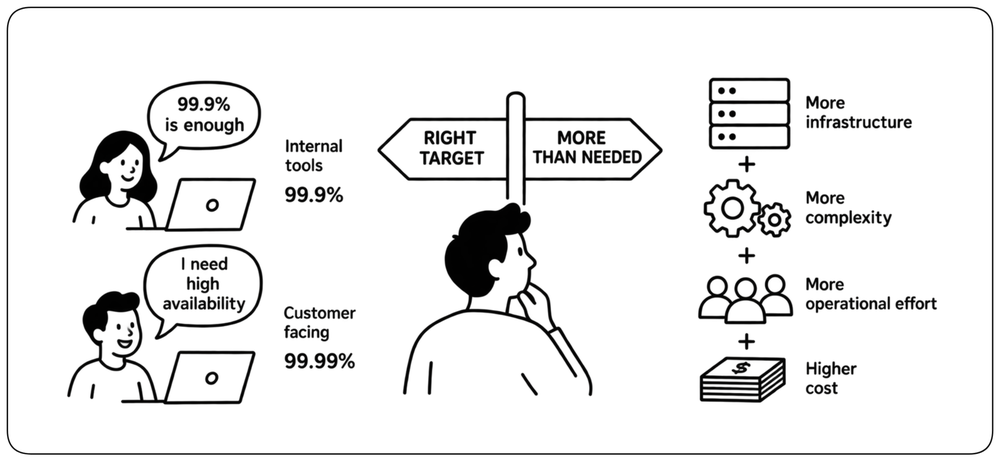
Le bon SLO est la cible de fiabilité la plus basse qui offre encore une expérience jugée acceptable par les utilisateurs. Partez de la performance historique et des retours utilisateurs, identifiez le point où la fiabilité commence à créer une vraie gêne, et fixez l’objectif délibérément autour de cette frontière. Un service qui exige réellement 99,99 % de disponibilité doit être conçu pour cela ; celui dont les utilisateurs se satisfont de 99,9 % ne devrait pas absorber le surcoût et la complexité sans raison. Une fiabilité au-delà du besoin des utilisateurs n’est pas gratuite : elle consomme de la complexité d’ingénierie, de l’infrastructure et de l’effort d’exploitation qui pourraient être investis ailleurs.
READS : les signaux qui expliquent la santé du service
Les SLO disent si le service atteint sa cible de fiabilité ; les signaux opérationnels aident à expliquer pourquoi. READS est une synthèse pratique inspirée de modèles établis comme RED et les Golden Signals de Google : Request Rate, Errors, Availability, Duration et Saturation. Ensemble, ils relient la santé visible par l’utilisateur aux conditions internes du système.
Request Rate — quel trafic ?
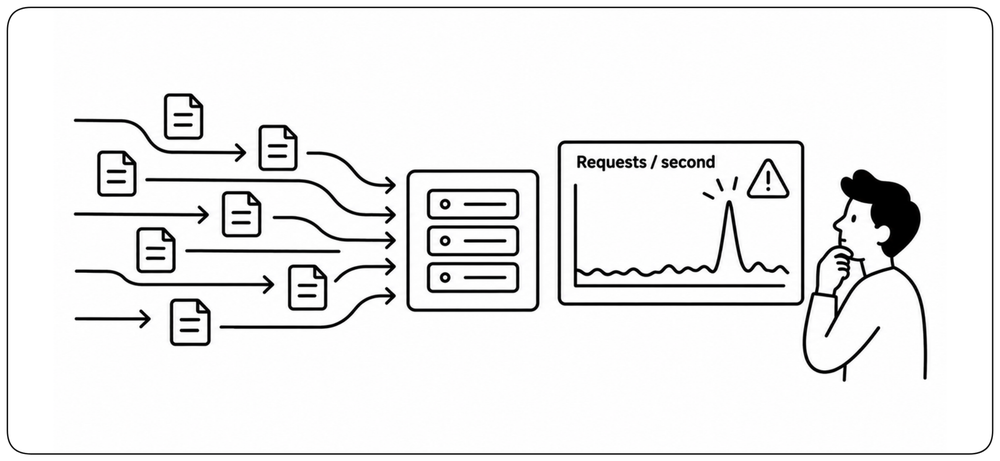
Mesurez le rythme du travail entrant : requêtes, jobs ou messages. Le trafic donne leur contexte aux erreurs, à la latence et à la saturation, et des changements soudains peuvent révéler des problèmes avant qu’ils n’apparaissent ailleurs.
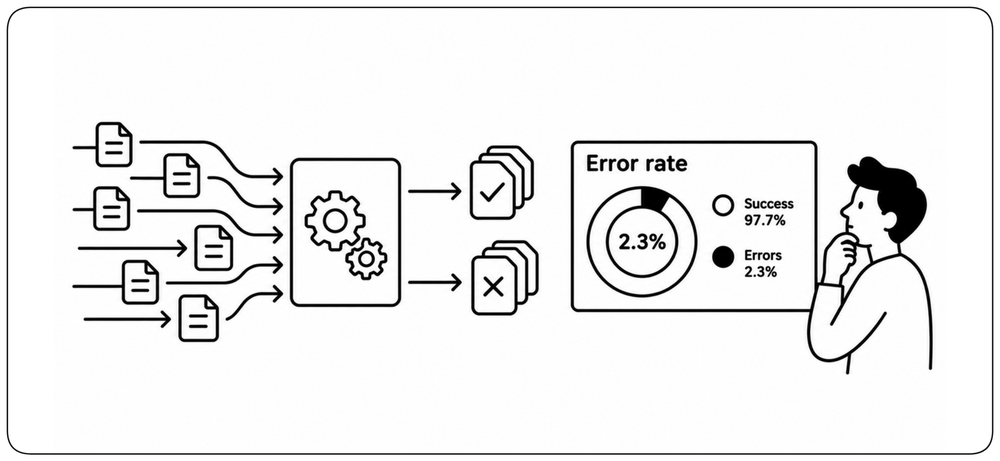
Errors — quelle part échoue ?
Mesurez la proportion de travail qui échoue, y compris les erreurs, les timeouts et les réponses incorrectes. Préférez les ratios aux comptes bruts pour que les échecs restent significatifs quand le trafic varie.
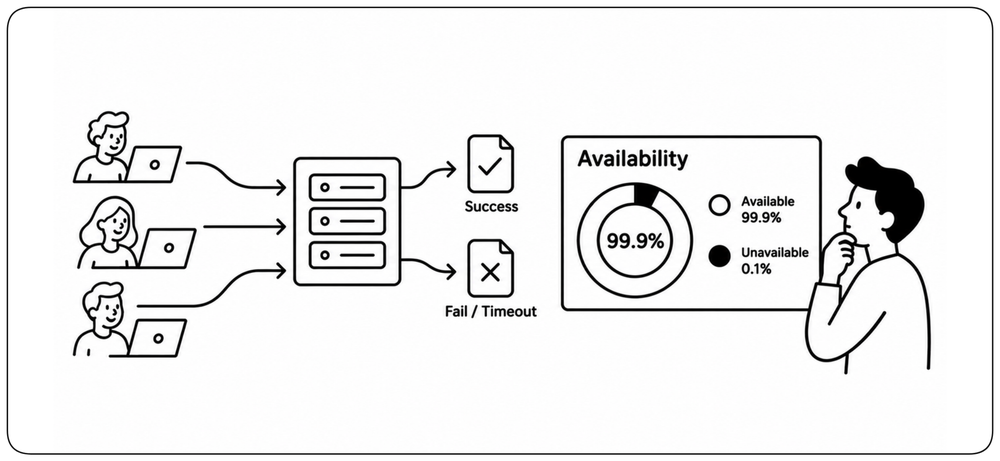
Availability — est-il là, tout simplement ?
Les erreurs décrivent le travail en échec ; la disponibilité résume si le service peut encore remplir sa fonction principale. Mesurez la disponibilité du point de vue de l’appelant : une requête qui échoue ou expire est indisponible pour l’utilisateur même si le processus sous-jacent tourne. Préférez la disponibilité basée sur les requêtes au simple uptime quand des pannes partielles sont possibles : un service peut tourner alors qu’une part significative des utilisateurs ne peut toujours pas terminer ses requêtes.
Duration — combien de temps ça prend ?
Mesurez le temps que prend le travail pour se terminer et regardez la distribution plutôt que la seule moyenne. Les percentiles révèlent les expériences utilisateur lentes que les moyennes peuvent masquer.
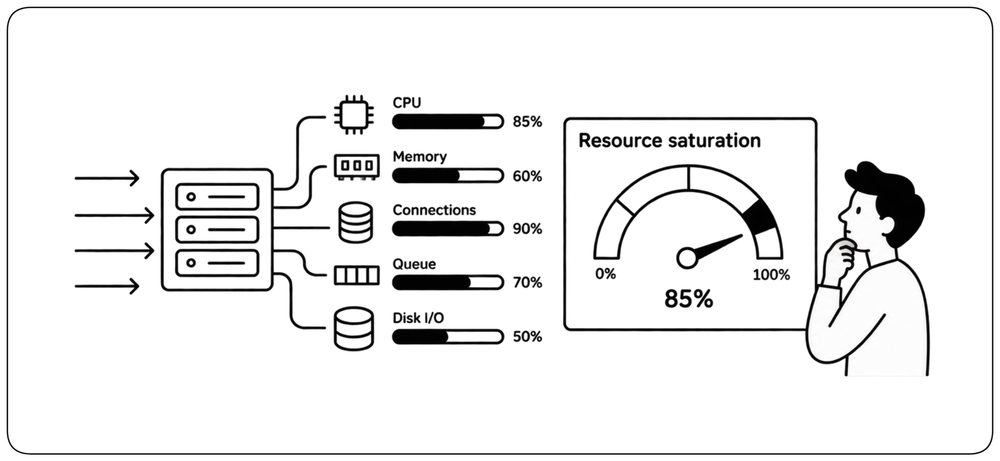
Saturation — à quelle distance d’une limite ?
Mesurez à quel point le service est proche d’épuiser une ressource contrainte comme le CPU, la mémoire, les connexions, les files d’attente ou les I/O disque. La saturation donne souvent un avertissement avant que les utilisateurs ne subissent des pannes.
Exploiter le système
Les signaux opérationnels n’ont de valeur que s’ils éclairent une décision ou une action claire. Les runbooks, les pratiques d’astreinte, l’accès sûr à la production et la réduction du toil transforment l’observation en travail quotidien fiable.
Runbooks
Un runbook est la procédure documentée pour traiter une situation opérationnelle connue — un déploiement, une reprise, une tâche de maintenance courante, une alerte fréquente. Les runbooks transforment le savoir tribal en procédure documentée et reproductible. Sans eux, chaque incident est résolu à partir de zéro par celui qui se trouve être d’astreinte.
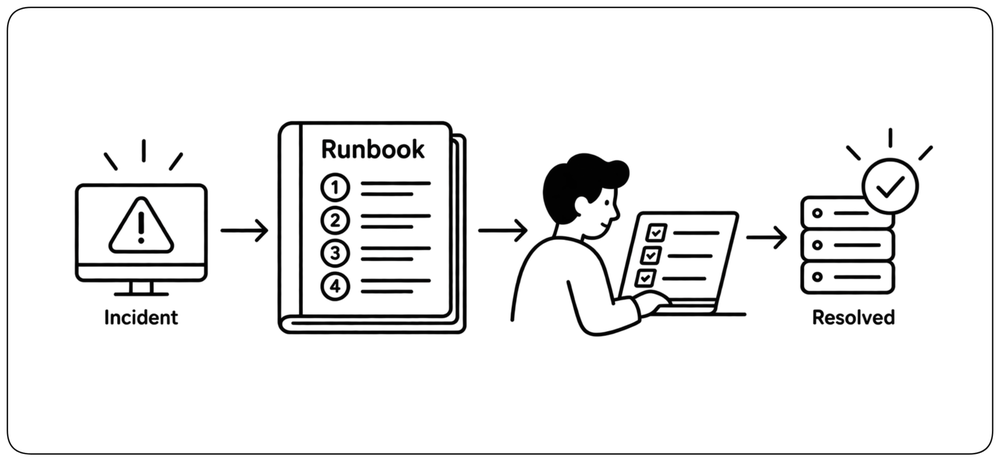
Un runbook est une promesse faite à soi-même à 3 h du matin
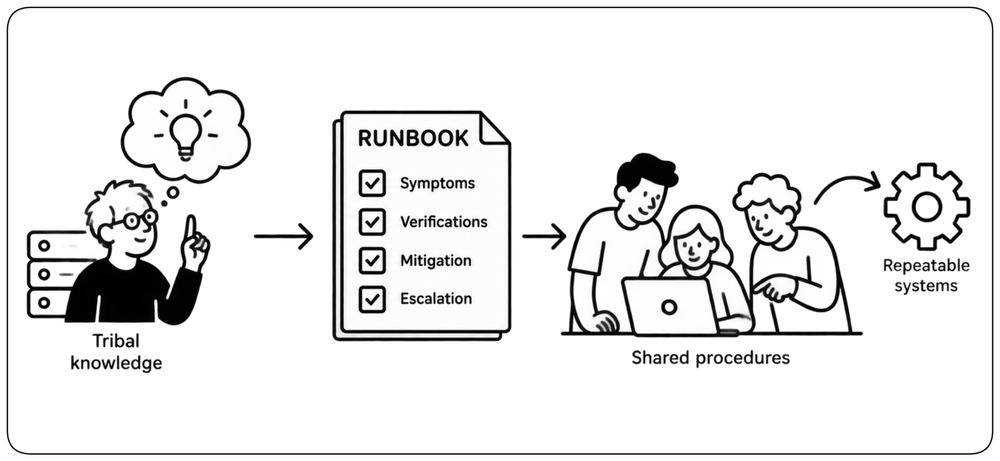
Un runbook est une lettre que l’on écrit à une version future de soi-même, épuisée et à moitié endormie — ou à un collègue qui n’a jamais vu ce système. La promesse est simple : !!vous ne devriez pas avoir à reconstituer la procédure de mémoire — vous devriez pouvoir suivre un chemin connu!!. Un bon runbook liste les symptômes, les vérifications, la mitigation sûre et le chemin d’escalade. Un runbook révèle aussi la charge cognitive : des étapes récurrentes sont des signaux qu’une partie du travail opérationnel pourrait être automatisée ou supprimée par la conception.
Du savoir tribal à la procédure écrite
Chaque équipe a un ingénieur senior qui « sait simplement » comment régler les pires problèmes de production. Ce savoir est un passif déguisé en actif. Le jour où il part — ou le jour où il est en vacances quand le système casse — l’équipe redécouvre tout dans la douleur et en public. Les runbooks transforment le savoir opérationnel individuel en procédures partagées, et les procédures partagées en systèmes reproductibles. Le savoir opérationnel critique ne devrait pas dépendre d’un seul ingénieur expérimenté ; il devrait être encodé dans la documentation, l’outillage et l’automatisation.
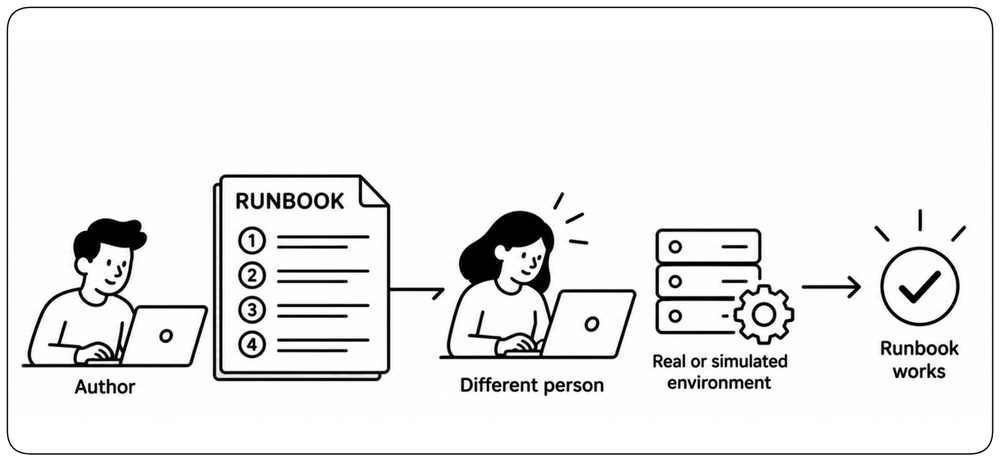
Le test d’un bon runbook
Un runbook doit être utilisable sous pression, pas seulement lisible. Faites-le suivre par quelqu’un d’autre que son auteur, sur une situation réelle ou simulée. Des étapes ambiguës, des prérequis manquants, des actions dangereuses ou des connaissances non documentées sont des défauts du runbook. Les procédures opérationnelles doivent être exercées avant d’être nécessaires sous pression.
Alertes et astreinte
L’astreinte révèle le coût opérationnel des raccourcis et du travail reporté, souvent à la pire heure possible. La concevoir de façon durable est une préoccupation d’ingénierie : elle détermine si une équipe peut exploiter un système sur le long terme.
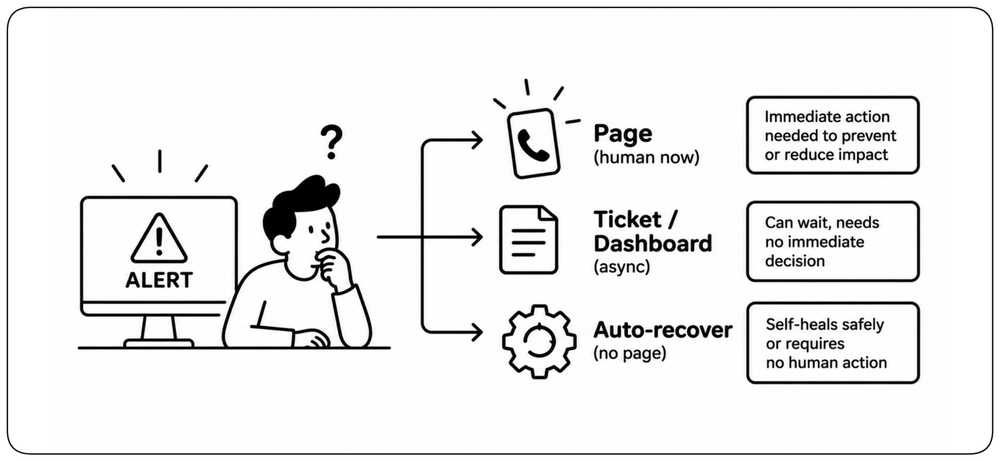
Qu’est-ce qui mérite une alerte ?
Une alerte est un contrat : elle dit « lâchez tout, il faut un humain tout de suite. » Alertez quand une action humaine immédiate est nécessaire pour prévenir ou réduire un impact significatif sur le service. Les situations qui peuvent attendre, se résorber sans risque ou ne demandent aucune décision immédiate relèvent d’un ticket, d’un dashboard ou d’une revue asynchrone.
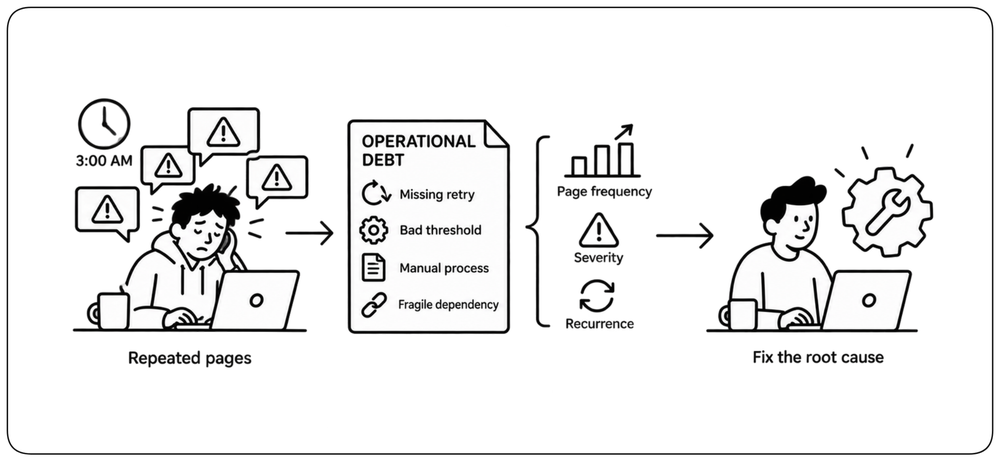
L’astreinte expose la dette opérationnelle
Des alertes répétées sont un retour sur la conception du système et sa maturité opérationnelle : un retry manquant, un seuil mal configuré, un runbook automatisable ou une dépendance insuffisamment résiliente. La fréquence, la sévérité et la récurrence des alertes révèlent la charge opérationnelle que le système impose à son équipe. Quand les alertes récurrentes consomment aussi l’error budget du service, les signaux se renforcent : la fiabilité pour l’utilisateur se dégrade alors que la dette opérationnelle absorbe l’attention humaine. C’est une bonne raison de prioriser la correction de la cause sous-jacente. La réduire passe généralement par la correction de la conception, pas par l’ajout de répondants.
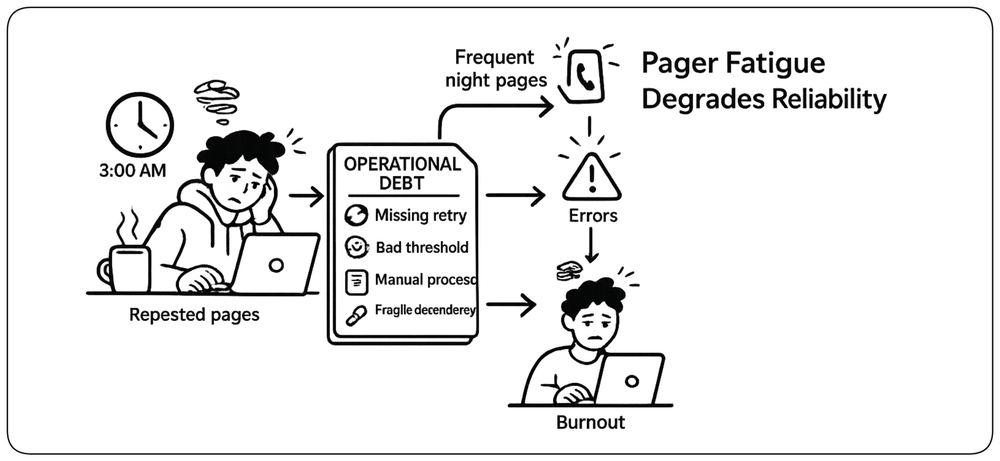
La fatigue des alertes dégrade la fiabilité
Des alertes fréquentes la nuit ne rendent pas une équipe meilleure pour répondre ; elles érodent le jugement et l’attention. Une astreinte durable est une condition préalable à un logiciel fiable.
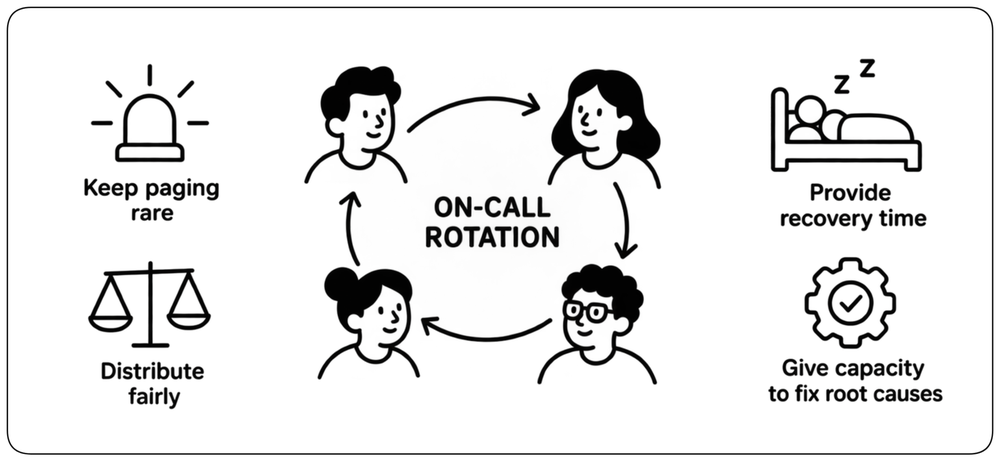
Concevoir une rotation durable
Une rotation saine garde les alertes rares, répartit la charge équitablement, ménage une récupération après les périodes éprouvantes et laisse à l’équipe assez de capacité pour éliminer les causes récurrentes. Respecter le coût humain fait partie de la maturité opérationnelle.
Déboguer la production en sécurité
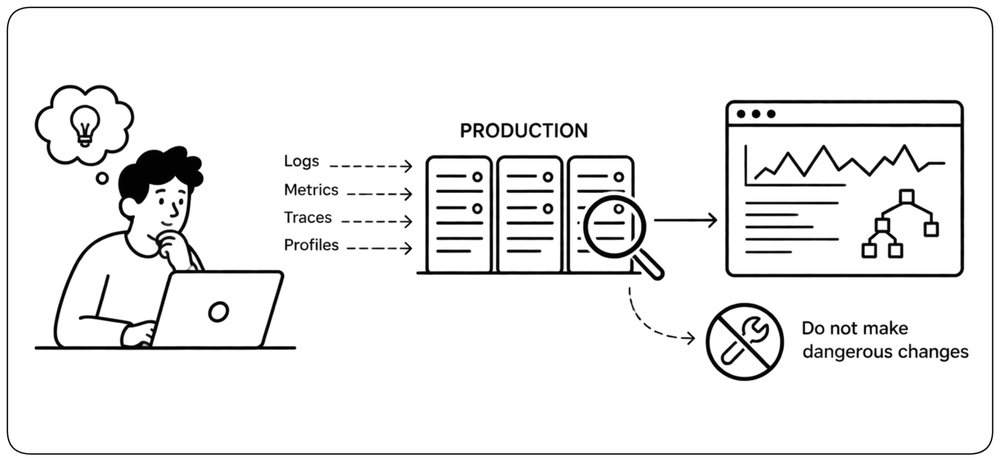
La production contient des conditions que les environnements de pré-production ne peuvent pas reproduire entièrement. L’opérabilité consiste à rendre cet environnement inspectable sans que l’investigation elle-même devienne dangereuse.
Rendre la production sûre à explorer
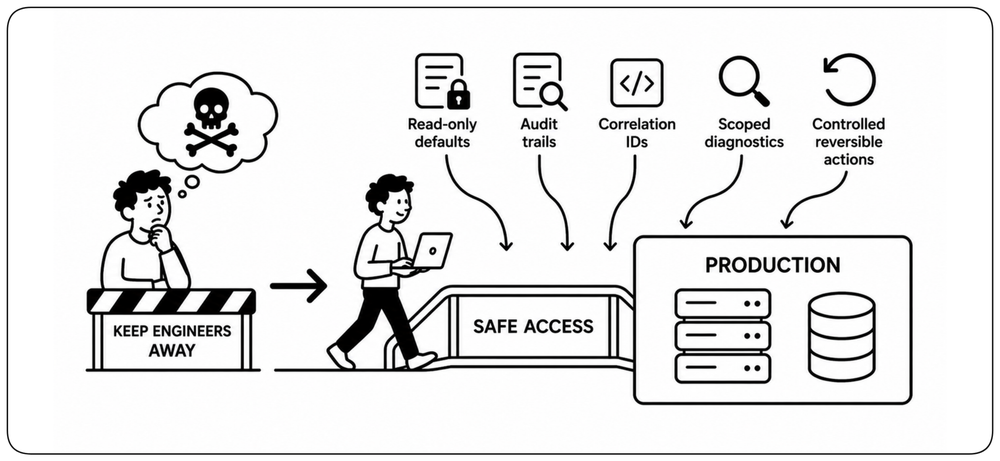
L’instinct qui consiste à tenir les ingénieurs éloignés de la production part d’une bonne intention — la peur de causer des dégâts — mais il peut laisser une équipe incapable de déboguer l’environnement qui compte. Rendez l’accès à la production sûr par défaut : accès en lecture seule, pistes d’audit, correlation IDs, diagnostics limités en portée, et actions contrôlées et réversibles.
Déboguer à partir de preuves, pas de suppositions
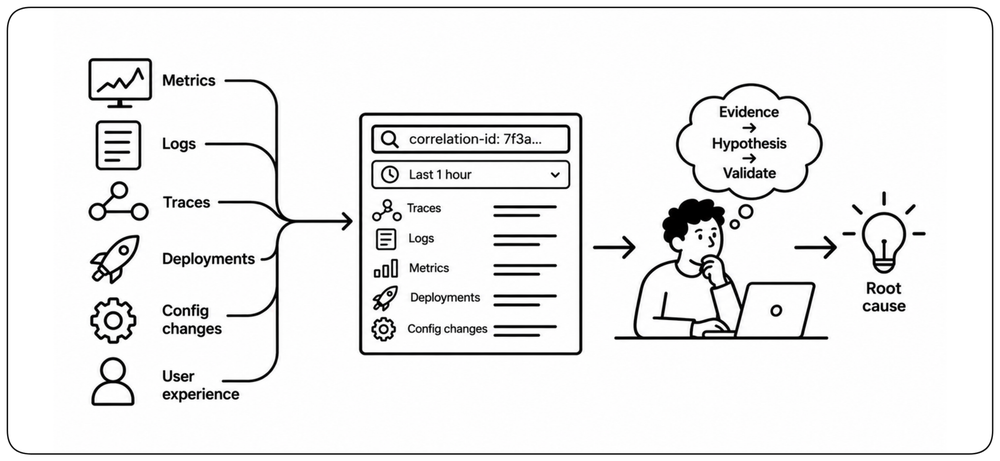
Partez de preuves capables de relier un résultat à un changement : traces, logs, métriques, historique de déploiement, changements de configuration et expérience de l’appelant. Les correlation IDs et les requêtes bornées dans le temps rendent ces preuves exploitables sous pression. Un bon débogage en production réduit l’espace de recherche sans transformer l’investigation en expérience non tracée.
Réduction du toil
Le travail opérationnel répétitif ne doit pas devenir une dépendance permanente à l’attention humaine. La réduction du toil transforme ces tâches récurrentes en backlog d’ingénierie.
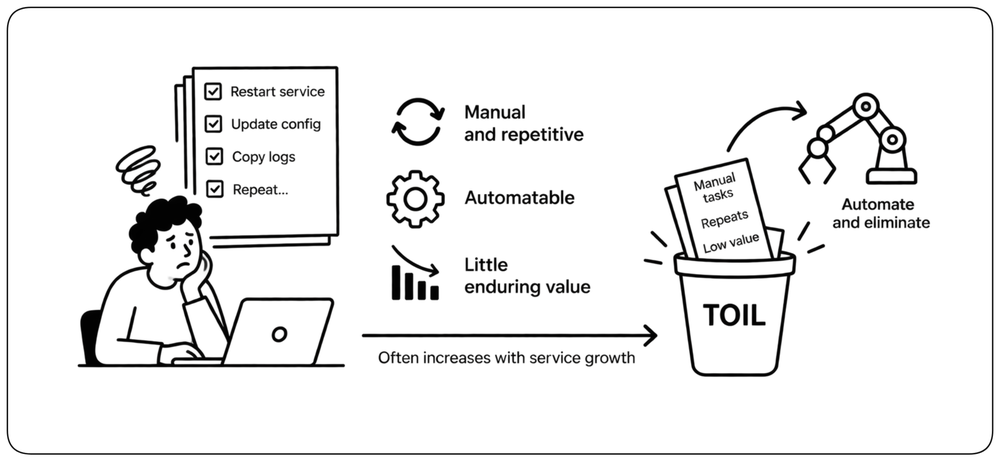
Qu’est-ce que le toil ?
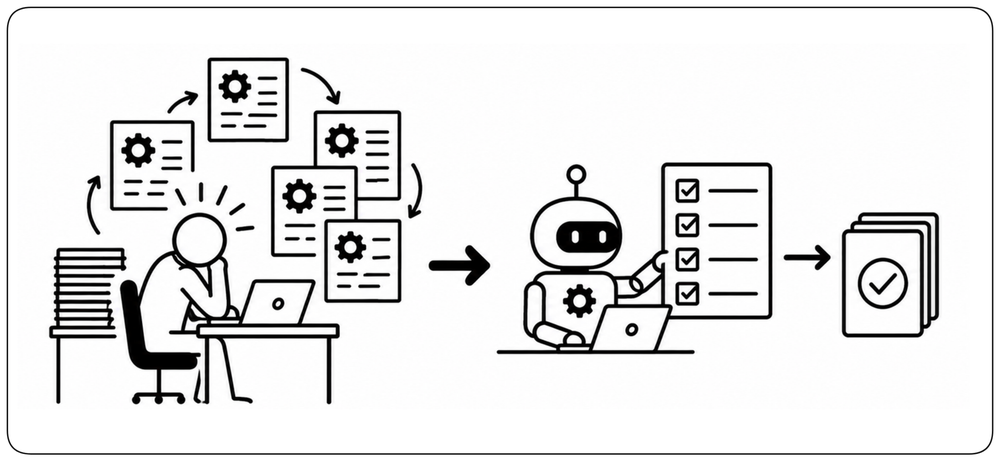
Le toil est un travail opérationnel manuel, répétitif, automatisable et qui apporte peu de valeur durable. Il croît souvent avec la taille du service : redémarrer un service instable, répéter des changements de configuration ou copier à la main des informations de diagnostic d’un système à l’autre.
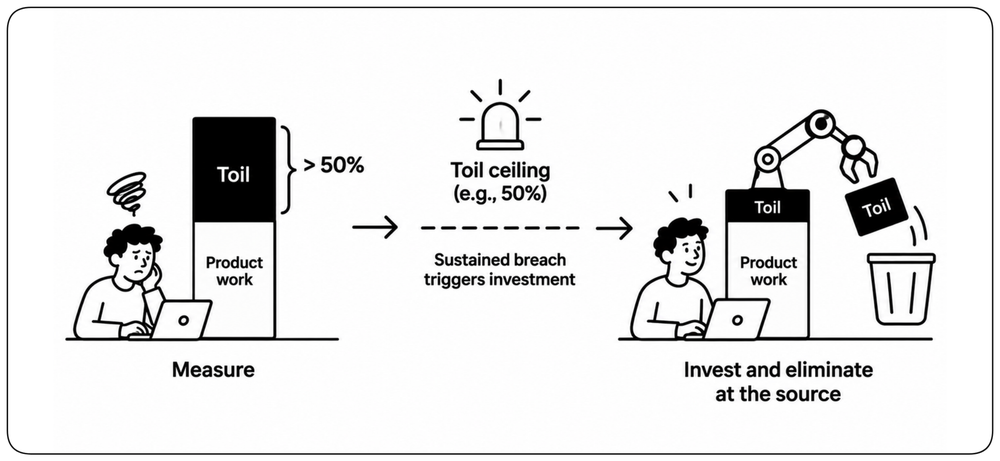
Plafonner le toil
Fixez une limite explicite à la part du temps d’ingénierie consacrée au toil, puis traitez les dépassements durables comme un signal pour investir dans son élimination à la source. Google SRE utilise célèbrement 50 % comme borne supérieure du toil pour certains rôles SRE, et non comme une loi universelle.
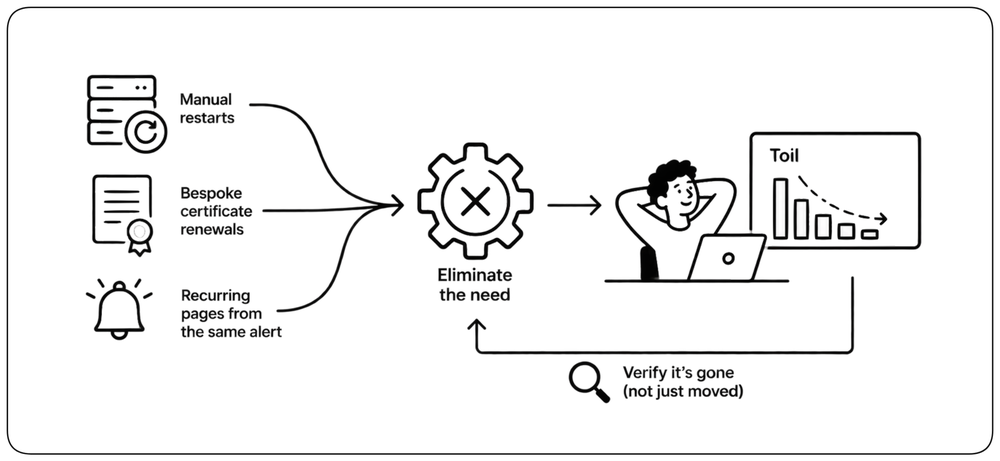
Éliminer le toil à la source
Ciblez le travail répétitif qui apprend peu : redémarrages manuels, renouvellements de certificats artisanaux, alertes récurrentes issues de la même alerte. Préférez supprimer le besoin de ce travail plutôt que simplement automatiser son exécution. Vérifiez ensuite que le travail a bien disparu et qu’il n’a pas simplement migré vers une autre file.
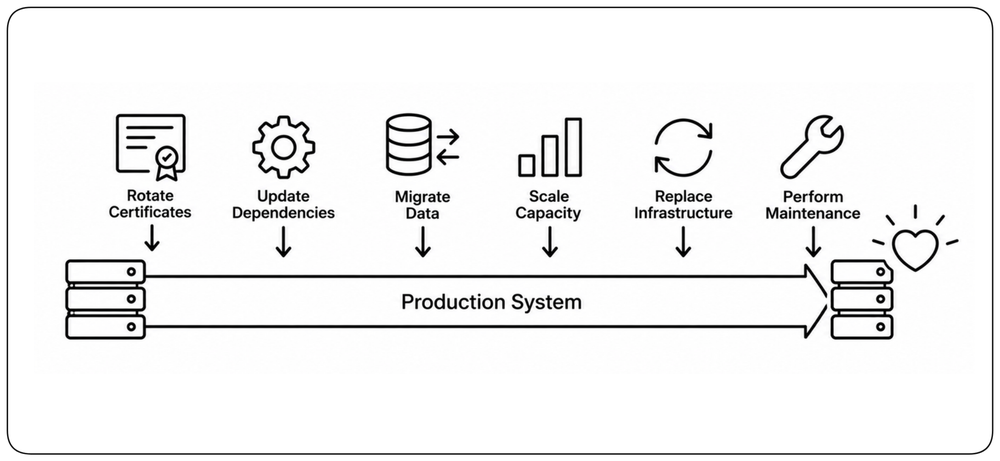
Opérations de Day 2
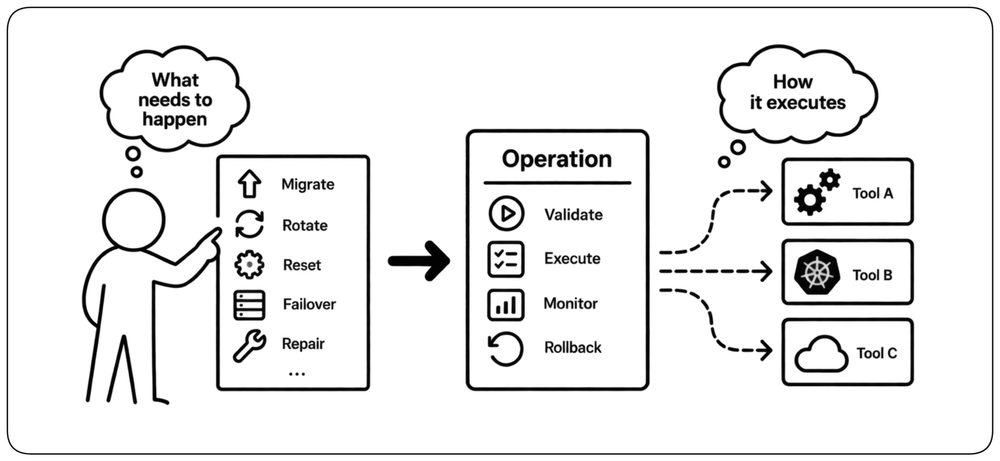
Un système de production doit évoluer pendant qu’il tourne. Les certificats expirent, les dépendances changent, les données bougent, la capacité croît, l’infrastructure est remplacée et une maintenance exceptionnelle finit par devenir nécessaire. Les opérations de Day 2 sont les changements et actions contrôlés qui maintiennent un système en production en bonne santé tout au long de cette évolution. Elles doivent être conçues comme des capacités opérationnelles de premier plan, et non improvisées quand le besoin apparaît.
Faire des opérations de Day 2 des capacités de premier plan
Les opérations de production comme les migrations, rotations, resets, failovers, réparations, diagnostics et changements d’infrastructure doivent avoir des workflows explicites et supportés. !!Encoder l’intention opérationnelle sous forme d’opération définie sépare ce qui doit se passer de la manière dont un outil particulier l’exécute!!, ce qui permet à l’implémentation d’évoluer sans forcer chaque propriétaire de service à repenser l’opération.
Exploiter la production sans accès direct
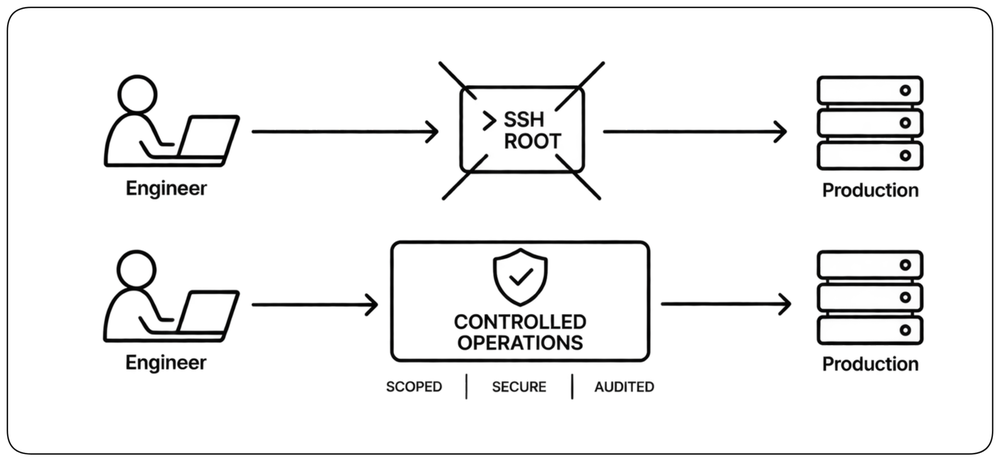
Les opérations de production courantes ne devraient pas exiger que les ingénieurs se connectent à des hôtes, des clusters, des bases de données ou des comptes cloud pour les manipuler directement. !!Exposez les opérations supportées via des interfaces contrôlées, avec des permissions limitées et un comportement connu!!. L’accès direct à la production doit être l’exception, pas le modèle d’exploitation.
Adapter l’autorité au risque opérationnel
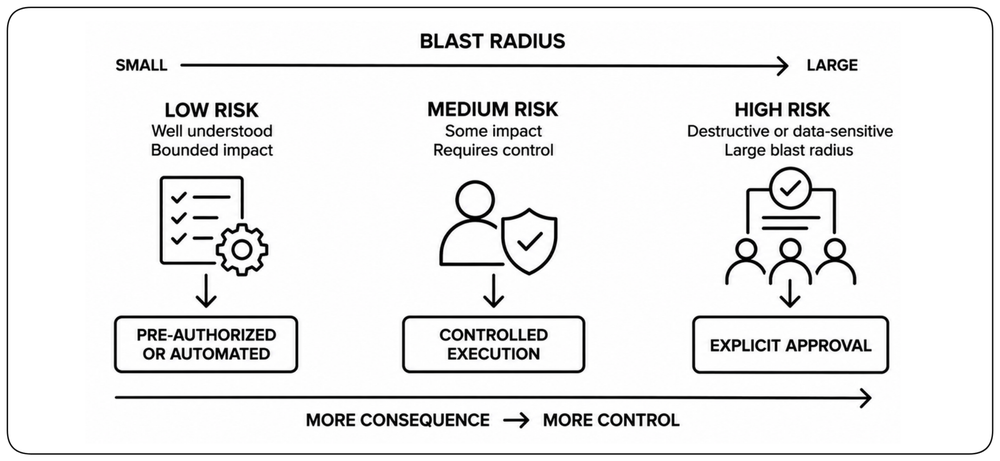
Toutes les opérations de production ne méritent pas le même niveau d’autorité. Les opérations à faible risque, bien comprises et d’impact borné peuvent être pré-autorisées ou automatisées, tandis que les opérations destructrices, irréversibles ou touchant des données sensibles doivent exiger des contrôles plus forts et une approbation explicite. !!Le chemin d’exécution doit refléter le blast radius potentiel de l’opération!!.
Rendre les workflows opérationnels sûrs par construction
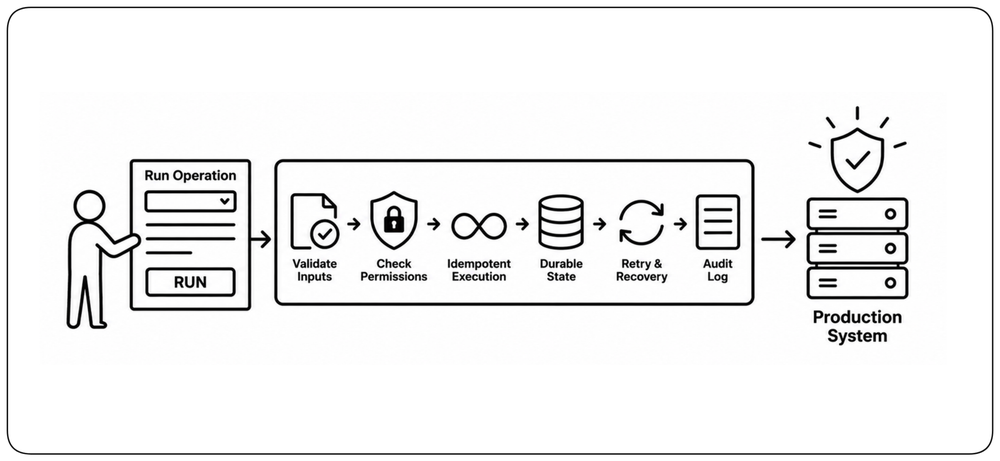
Les opérations de Day 2 modifient des systèmes en production et peuvent avoir des conséquences importantes. !!Intégrez la sécurité dans le workflow!! : validez les entrées, limitez les permissions, rendez l’exécution idempotente quand c’est possible, conservez un état durable pour les opérations longues, définissez le comportement de retry et de reprise, et enregistrez qui a demandé l’opération, ce qui a été autorisé, ce qui a réellement été exécuté et quel en a été le résultat. La sécurité et la traçabilité doivent venir de la plateforme opérationnelle, pas d’un opérateur qui se souvient de chaque précaution.
Exercer les opérations avant d’en avoir besoin
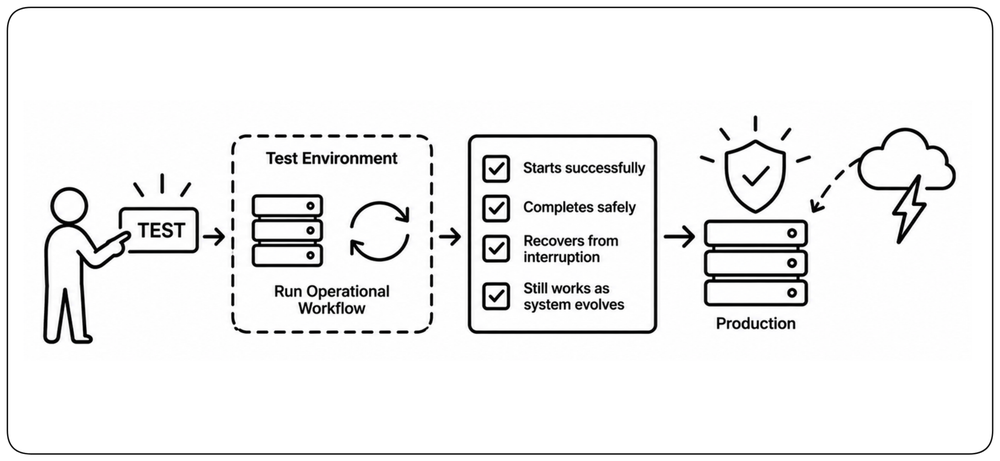
Un workflow opérationnel qui existe mais n’a jamais été exercé n’est qu’une hypothèse. Testez régulièrement les migrations, rotations, failovers, procédures de reprise et autres opérations de Day 2 critiques avant qu’elles ne deviennent urgentes. !!Vérifiez non seulement qu’elles démarrent, mais qu’elles se terminent en sécurité, se rétablissent après une interruption et fonctionnent toujours à mesure que le système environnant évolue!!.
Réagir à la panne
Quand un système tombe en production, les minutes suivantes déterminent le coût. La réponse aux incidents est la chorégraphie de détection, déclaration, mitigation et communication qui transforme le chaos en opération maîtrisée.
Déclarer avant d’être certain
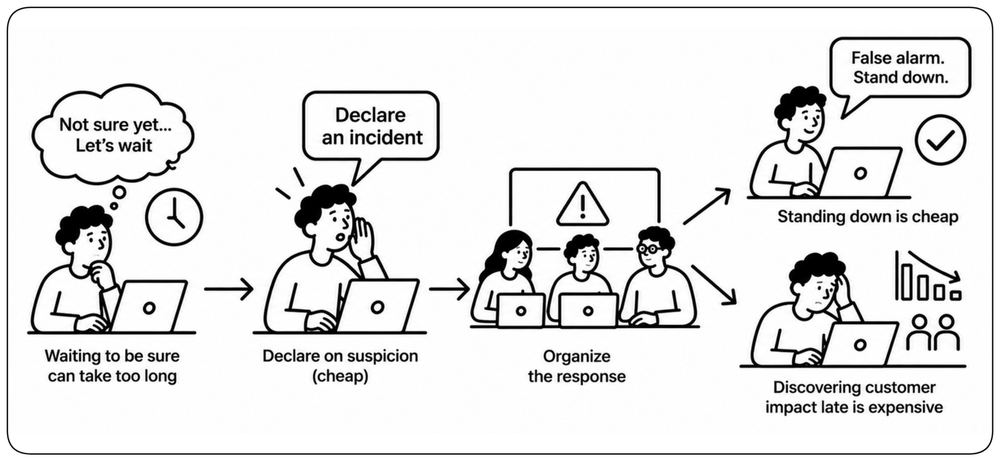
Un échec courant de la réponse aux incidents est d’attendre trop longtemps pour déclarer. Les ingénieurs veulent être sûrs avant de donner l’alerte, et « sûr » peut prendre une heure que le système n’a pas. !!Déclarer un incident coûte peu ; sous-déclarer coûte cher!!. Le bon réflexe est de déclarer sur un soupçon, d’organiser la réponse et de lever l’alerte vite s’il s’avère que ce n’était rien. Lever une fausse alerte coûte peu ; découvrir tard un impact client, non.
Stabiliser d’abord, diagnostiquer ensuite
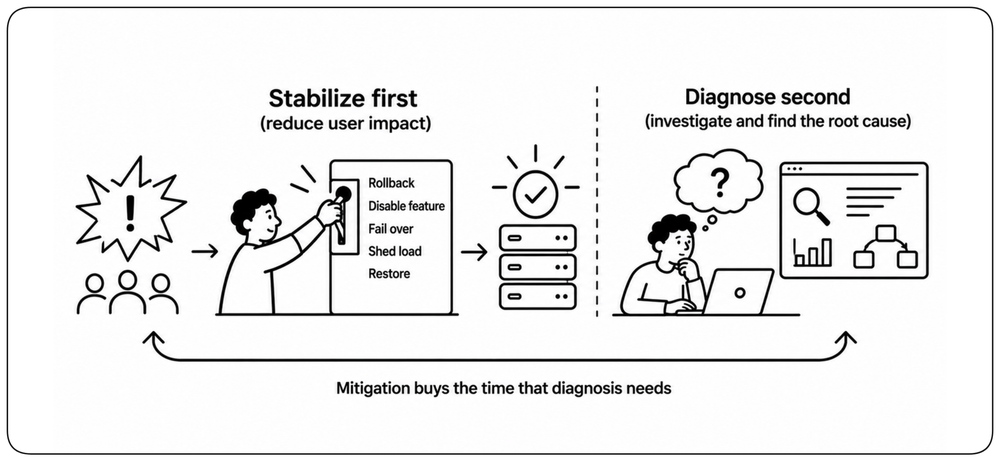
Pendant un incident, réduire l’impact utilisateur passe avant la compréhension parfaite. Préférez l’action connue la plus sûre qui peut réduire rapidement l’impact : rollback, désactivation d’une fonctionnalité, failover, délestage de charge ou restauration d’un état sain connu. Un diagnostic plus profond compte, mais il vient une fois le système assez stable pour une investigation rigoureuse. !!La mitigation achète le temps dont le diagnostic a besoin!!.
Établir un commandement d’incident clair
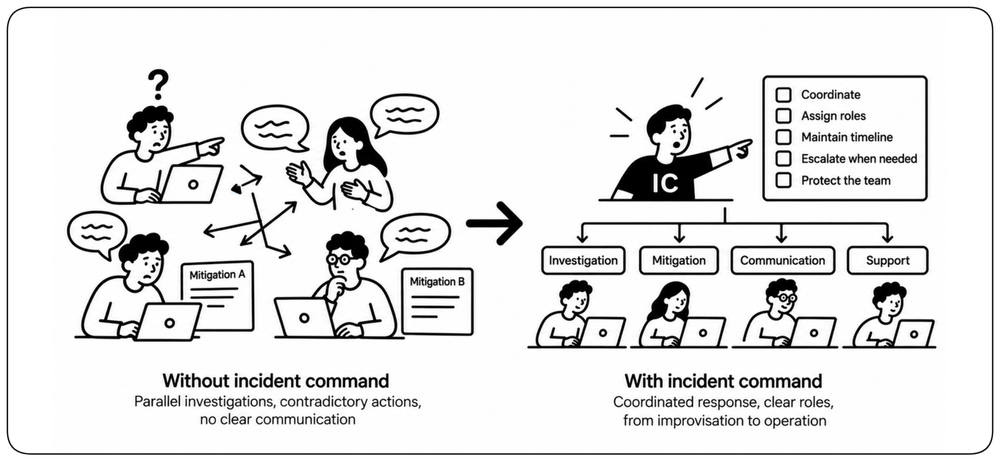
Sous stress, un groupe d’ingénieurs compétents peut produire une confusion remarquable : investigations parallèles, mitigations contradictoires, personne ne parle au client. Le rôle d’Incident Commander crée la structure de coordination nécessaire pour l’éviter. La responsabilité première du commandant est la coordination : attribuer les rôles, tenir la chronologie, escalader si nécessaire et protéger les intervenants des distractions. Ce rôle fait passer la réponse aux incidents de l’improvisation à l’exploitation.
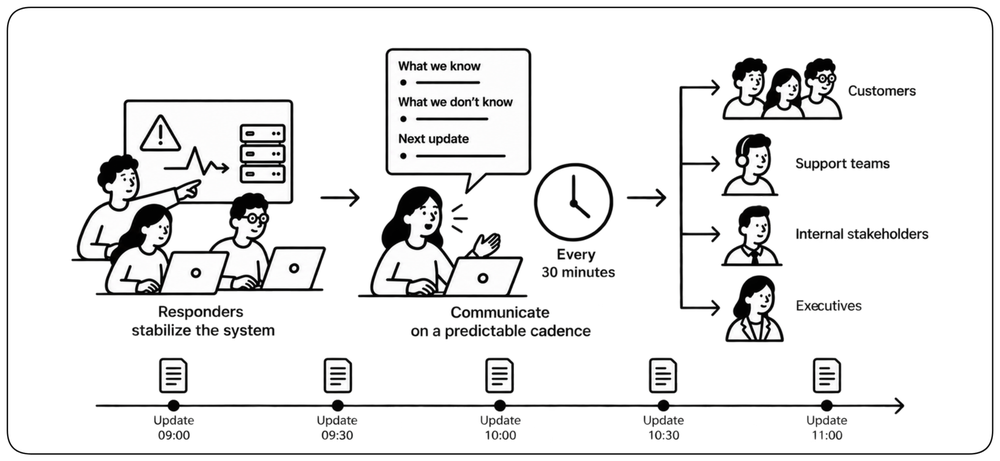
Communiquer à un rythme prévisible
Pendant que les intervenants stabilisent le système, quelqu’un doit tenir les parties prenantes concernées informées. Clients, parties prenantes internes, équipes de support et dirigeants ont besoin d’une mise à jour unique et sereine, à une cadence convenue et adaptée à l’incident. Le silence laisse l’imagination combler le vide avec les pires scénarios. Dites ce qui est connu, ce qui ne l’est pas et quand viendra la prochaine mise à jour, même quand il n’y a pas de nouvelle.
Apprendre et s’améliorer
Postmortems et apprentissage
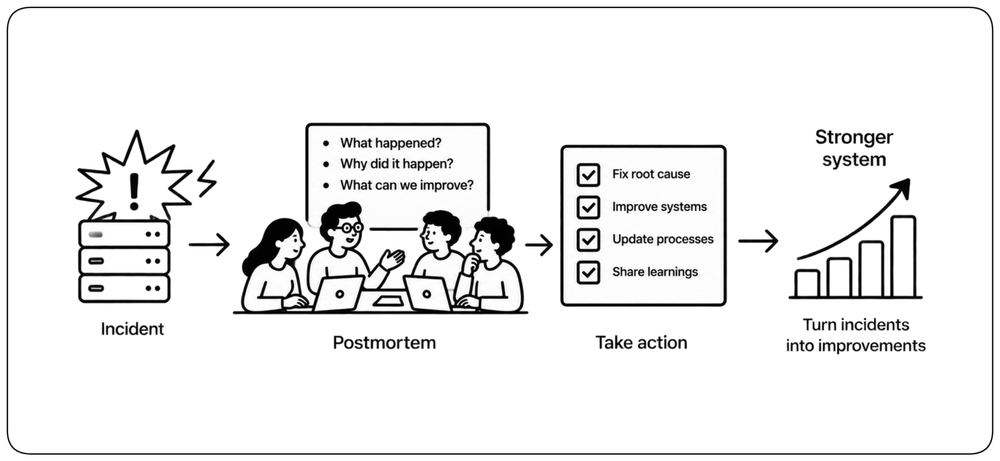
L’incident est le prix que vous avez payé. Le postmortem est ce que vous obtenez en retour. Une équipe qui n’apprend pas systématiquement de ses incidents paie deux fois — une fois pour la panne d’origine, et à nouveau quand la même faiblesse systémique contribue à une autre panne. La discipline de l’apprentissage structuré à partir des échecs transforme les incidents en améliorations plutôt qu’en événements isolés.
Postmortems sans blâme
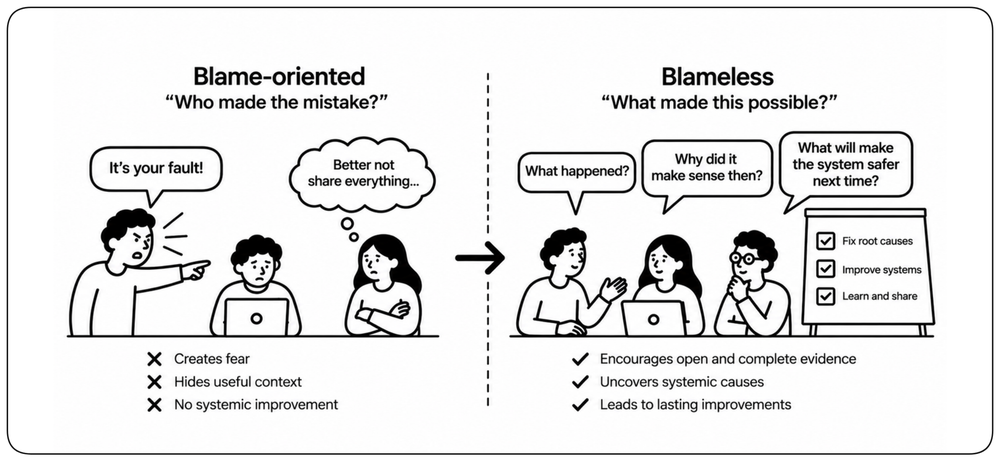
Un postmortem sans blâme commence par comprendre pourquoi les actions menées avaient du sens dans leur contexte, plutôt que par la recherche d’un coupable. La question passe de « qui a fait l’erreur ? » à « quelles conditions ont permis cette panne, et qu’est-ce qui rendrait le système plus sûr la prochaine fois ? » Un processus axé sur le blâme encourage des rapports défensifs et cache du contexte utile ; l’absence de blâme rend plus probables des preuves complètes et des améliorations systémiques.
Regarder au-delà de la cause immédiate
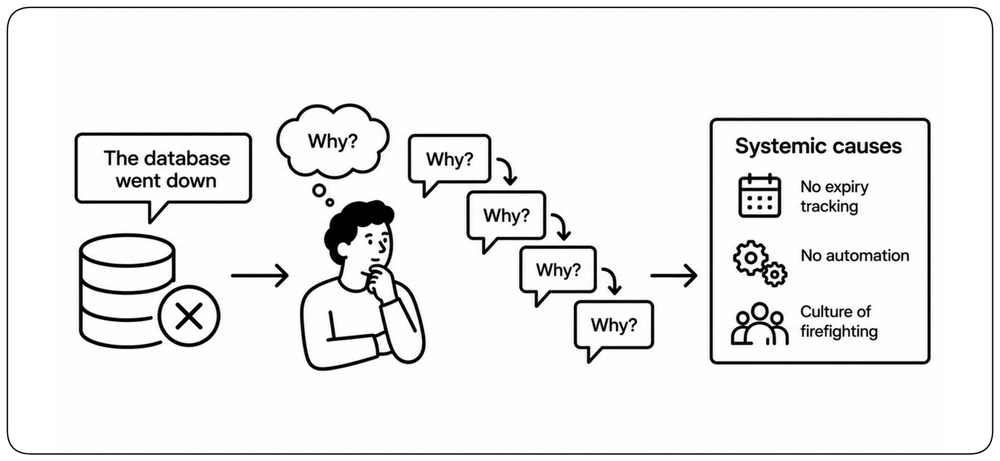
« La base de données est tombée » décrit ce qui s’est passé, pas pourquoi le système l’a permis. Un certificat expiré peut expliquer la panne, mais l’absence de suivi des expirations, d’automatisation ou un état de pompier permanent peuvent expliquer pourquoi le certificat a pu expirer sans être remarqué. Des techniques comme les Cinq pourquoi (Five Whys) aident à pousser l’investigation au-delà du déclencheur immédiat vers les faiblesses du système, du processus et de l’outillage.
Des actions de suivi qui sont vraiment menées
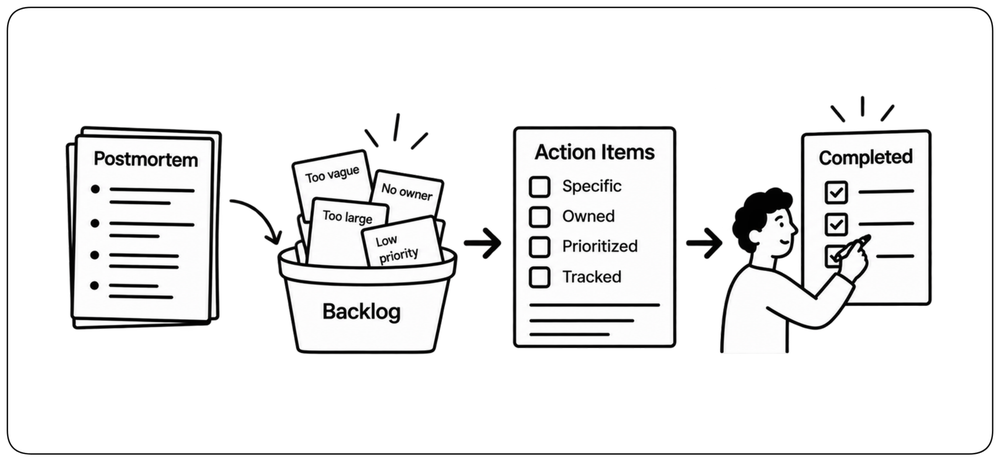
L’objet d’un postmortem n’est pas le document — c’est le changement. Les actions de suivi d’un postmortem peuvent facilement mourir dans le backlog : trop vagues, sans propriétaire, trop grosses ou trop éloignées des priorités du moment. De bonnes actions de suivi sont précises, assignées, priorisées et suivies jusqu’à leur terme. Un postmortem qui identifie les changements nécessaires sans jamais les exécuter produit de l’apprentissage sans amélioration.
L’opérabilité à l’ère de l’IA
L’opérabilité est l’une des disciplines les plus susceptibles d’être transformées par les agents IA. Les runbooks, la réponse d’astreinte, le triage d’incident, la rédaction de postmortems et l’automatisation du toil sont autant de domaines où l’IA peut supprimer une grande part de travail mécanique. Ce sont aussi des domaines où une autorité mal bornée peut créer un risque opérationnel important.
Le goulot d’étranglement de l’investigation
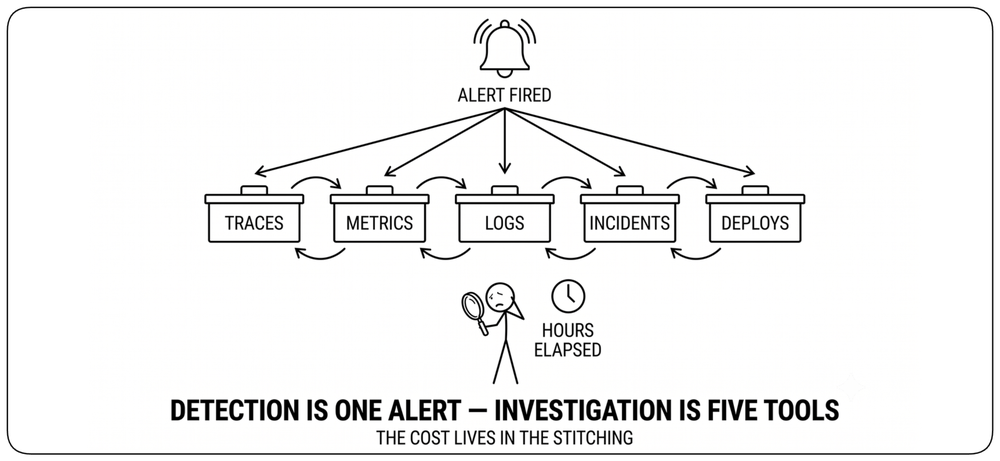
La détection est de plus en plus automatisée ; l’investigation exige encore que des humains rassemblent le contexte. Une fois l’alerte déclenchée, un ingénieur saute entre traces, métriques, logs, déploiements, changements de configuration et incidents passés pour comprendre ce qui s’est passé. Le goulot n’est souvent pas de détecter la panne, mais de relier les preuves qui l’expliquent. L’IA peut réduire une grande partie de ce travail de collecte de contexte en corrélant les preuves entre les systèmes opérationnels.
Des runbooks aux agents opérationnels
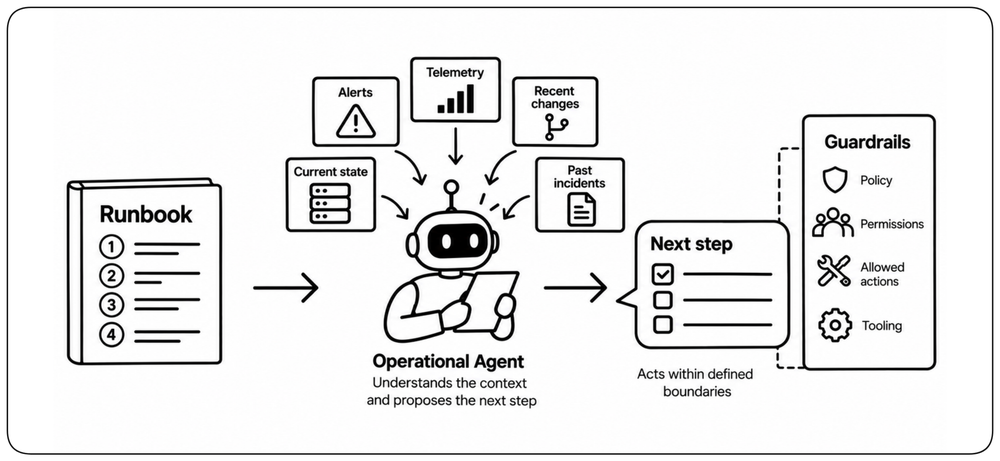
Un runbook traditionnel dit à un ingénieur quoi faire. Un agent opérationnel peut combiner cette procédure avec l’état courant du système — alertes, télémétrie, changements récents et incidents passés — et proposer une prochaine étape plausible en utilisant le runbook comme guide opérationnel et l’état du système comme contexte. Le runbook ne disparaît pas ; il fournit le guide opérationnel, tandis que la politique et l’outillage définissent ce que l’agent a réellement le droit de faire.
Mitigation assistée par agent
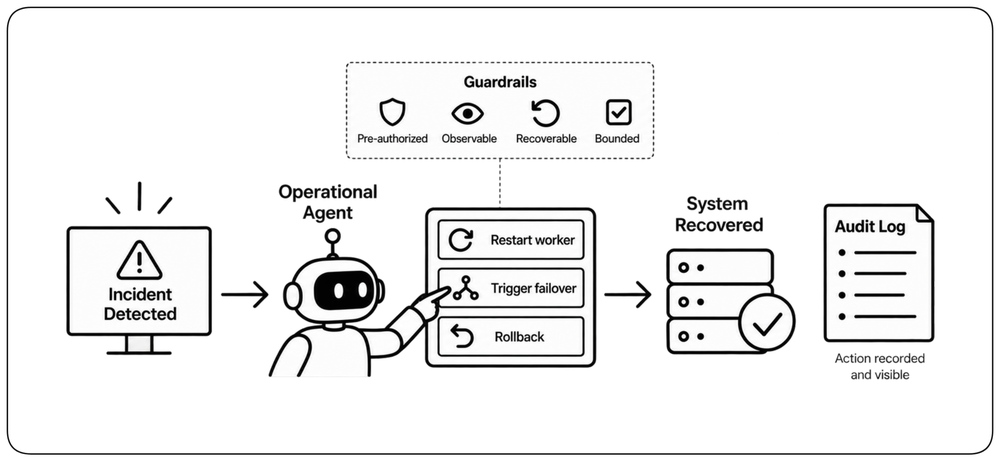
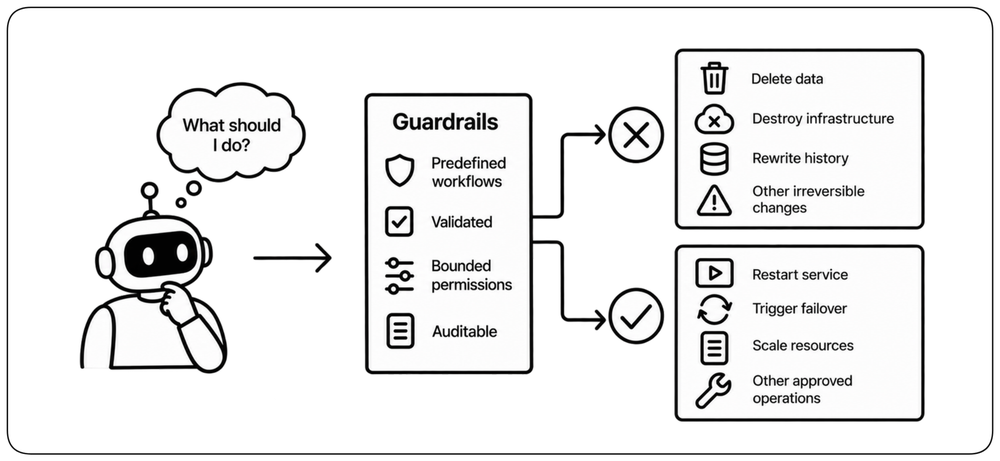
Les agents opérationnels peuvent exécuter des mitigations quand l’action est bornée, pré-autorisée, observable et réversible. Ils peuvent redémarrer un worker défaillant connu, invoquer un failover approuvé ou faire un rollback via un workflow établi. Chaque action doit être déclarée et laisser des traces. L’automatisation doit réduire l’impact des incidents sans rendre les pannes récurrentes invisibles.
Les actions lourdes de conséquences exigent des garde-fous explicites
L’IA peut raisonner de façon probabiliste, mais les actions lourdes de conséquences exigent des limites explicites. Supprimer des données, détruire de l’infrastructure, réécrire l’historique ou effectuer d’autres changements difficiles à annuler doit passer par des workflows prédéfinis, validés, bornés et auditables. L’agent peut choisir ou invoquer une opération approuvée, mais son autorité doit être contrainte indépendamment de ce que décide le modèle.
L’astreinte du futur
Le rôle humain dans l’astreinte s’éloignera de la collecte de preuves et de la saisie de commandes routinières pour aller vers le jugement de l’intention, du risque et des exceptions. Les agents peuvent rassembler le contexte, exécuter des diagnostics bornés et lancer des mitigations approuvées. Les humains restent responsables des décisions qui sortent de l’autorité explicite de l’agent ou exigent un jugement plus large.
L’avenir de l’astreinte n’est pas l’absence d’humains. C’est une surface opérationnelle plus réduite qui requiert leur attention directe.
Postmortems rédigés par l’IA
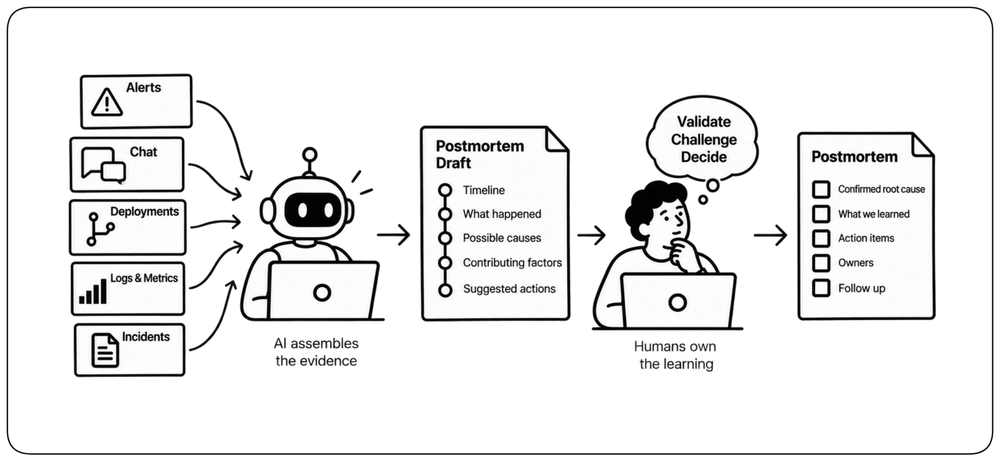
L’IA peut reconstituer la chronologie d’un incident à partir des alertes, du chat, de l’historique de déploiement et des preuves opérationnelles, puis produire un premier brouillon de postmortem. Les ingénieurs valident le récit, remettent en question les causes proposées et décident des changements à mener. L’IA assemble les preuves ; les humains portent l’apprentissage.
L’objectif de l’opérabilité n’est pas de retirer les humains de l’exploitation. C’est de déplacer leur attention vers le jugement, l’apprentissage et les améliorations d’ingénierie qui rendent le prochain incident moins probable.