Concevoir pour la scalabilité
Chapter Info
Calculating... Writing Progress: 60%
Tout système qui réussit finit par affronter le même défi : la croissance.
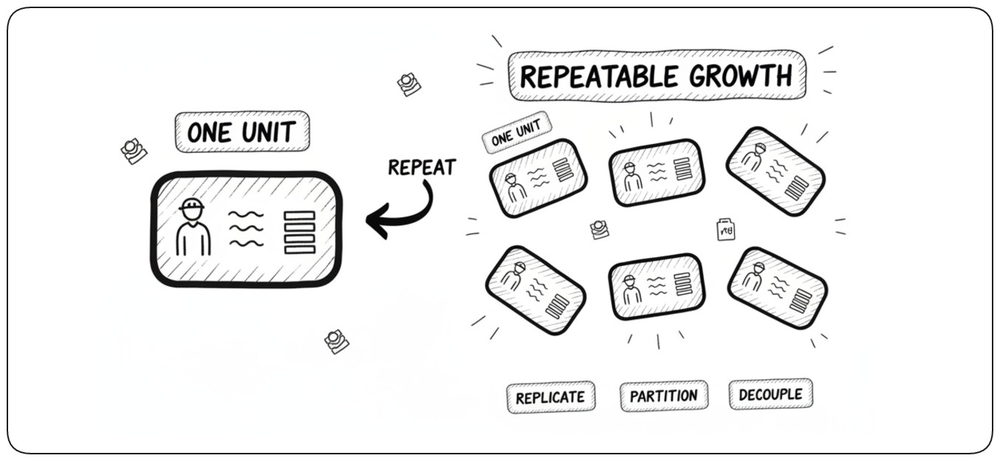
Le vrai défi est de rendre cette croissance reproductible plutôt que fragile. Si les fondations sont bonnes, ajouter de la capacité revient à répéter ce qui fonctionne déjà. Si elles sont mauvaises, chaque raccourci finit par céder sous la charge, et la réécriture arrive alors que le système est déjà sous pression.
Dans ce chapitre, la scalabilité est traitée comme une propriété architecturale : des frontières claires, de l’automatisation et des unités de travail reproductibles. Nous distinguerons la scalabilité de la performance, passerons en revue les principales stratégies de mise à l’échelle, et verrons comment le travail, les données et les équipes doivent être façonnés pour que le système puisse croître durablement.
Introduction
Ce qu’est la scalabilité
La scalabilité est la capacité d’un système à absorber une demande croissante sans s’effondrer sous le poids de la performance, du coût ou de la complexité opérationnelle. Ce n’est pas une fonctionnalité que l’on « active » plus tard, mais !!le résultat de choix architecturaux qui rendent la croissance possible!!. Un système scalable gère plus d’utilisateurs, de données et de transactions en ajoutant des ressources de façon prévisible. Quand le système est construit, bien des contraintes de mise à l’échelle sont déjà gravées dans l’architecture — composants avec état impossibles à répliquer ou dépendances fortement couplées impossibles à distribuer. !!La scalabilité doit être conçue dès le départ, pas ajoutée après coup.!!
Un défi d’ingénierie intemporel
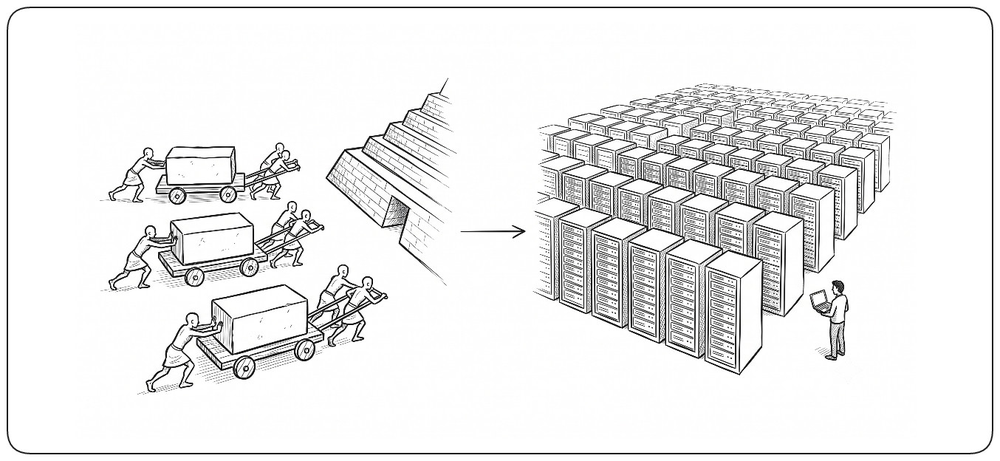
La scalabilité n’est pas une enfant de l’ère numérique ; c’est un problème d’ingénierie ancestral, des grandes pyramides à la révolution industrielle. À toutes les époques, le défi reste le même : !!augmenter le débit sans s’effondrer sous le surcoût de coordination!!. Les solutions sont tout aussi intemporelles. Qu’il s’agisse de déplacer des blocs de pierre à Gizeh ou de traiter des millions de requêtes cloud, le passage à l’échelle repose sur les mêmes principes : !!la standardisation pour réduire la complexité et l’automatisation pour dépasser les limites de l’intervention humaine!!.
Scalabilité vs performance
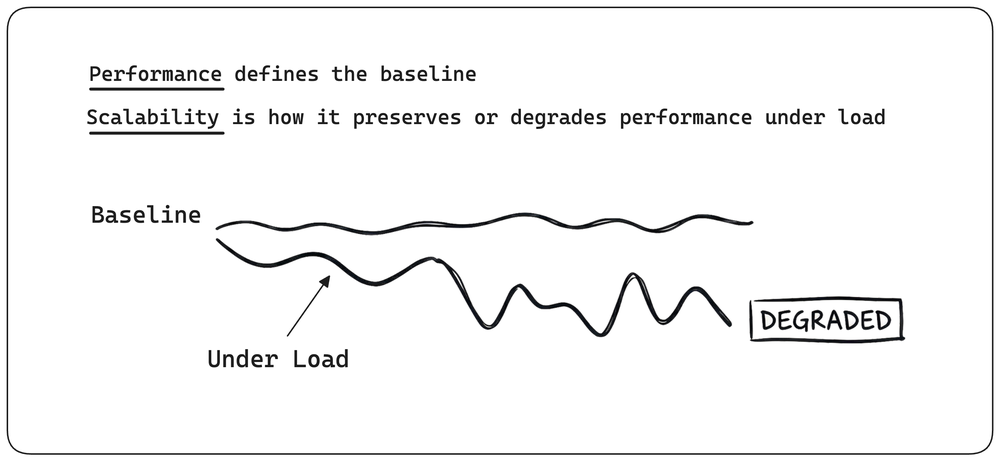
Performance et scalabilité répondent à deux dimensions différentes de l’architecture : la performance définit la vitesse et l’efficacité des opérations individuelles, comme la latence et le temps de réponse, tandis que la scalabilité définit la capacité du système à maintenir ces standards quand la charge augmente. Un système scalable n’est pas forcément rapide — mettre à l’échelle un processus inefficace ne produit qu’un plus grand volume de requêtes lentes.
Going further: performance
Latency, throughput, caching, and optimization techniques are covered in depth in the Design for Performance chapter.
Scalabilité vs élasticité
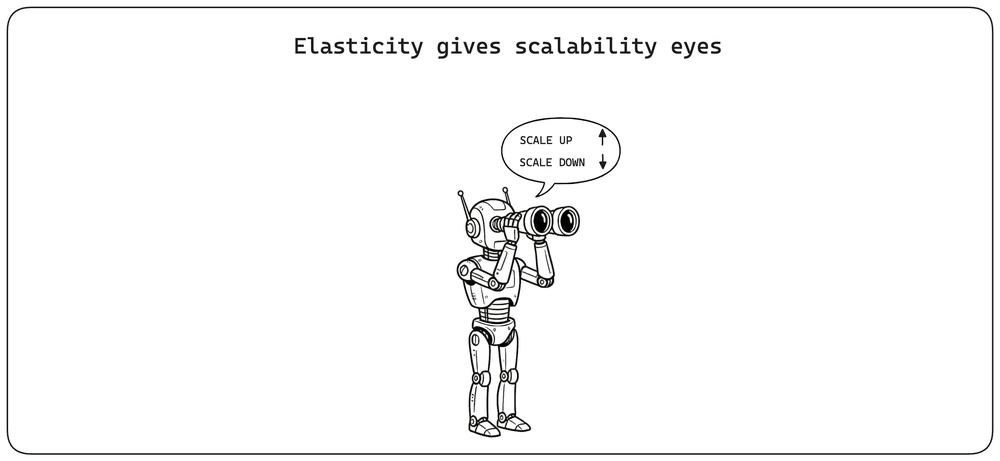
La scalabilité est la capacité d’un système à absorber la croissance en ajoutant des ressources, de quelques centaines d’utilisateurs à des millions au fil du temps. L’élasticité est la capacité d’ajuster automatiquement ces ressources à mesure que la demande monte et descend. Un système peut être scalable sans être élastique, mais l’élasticité repose sur des fondations scalables. Nous reviendrons sur l’élasticité plus loin dans ce chapitre, comme stratégie de mise à l’échelle.
Compromis : il n’y a pas de repas gratuit
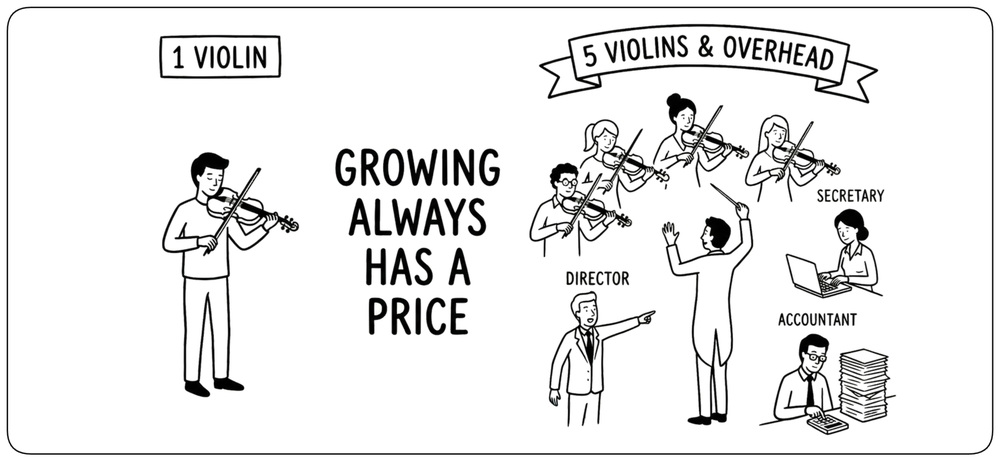
La scalabilité augmente toujours la complexité et le coût. Passer d’un serveur à des centaines introduit des load balancers, des files, du monitoring, de la coordination et davantage d’outillage opérationnel. Chacun ajoute des pièces mobiles, des modes de défaillance et du surcoût. Il n’existe !!pas de meilleure architecture — seulement celle qui correspond à vos contraintes et à votre trajectoire de croissance!!. Comprenez les compromis, faites des choix explicites et remettez-les en question à mesure que vos besoins évoluent.
Le goulot d’étranglement mobile
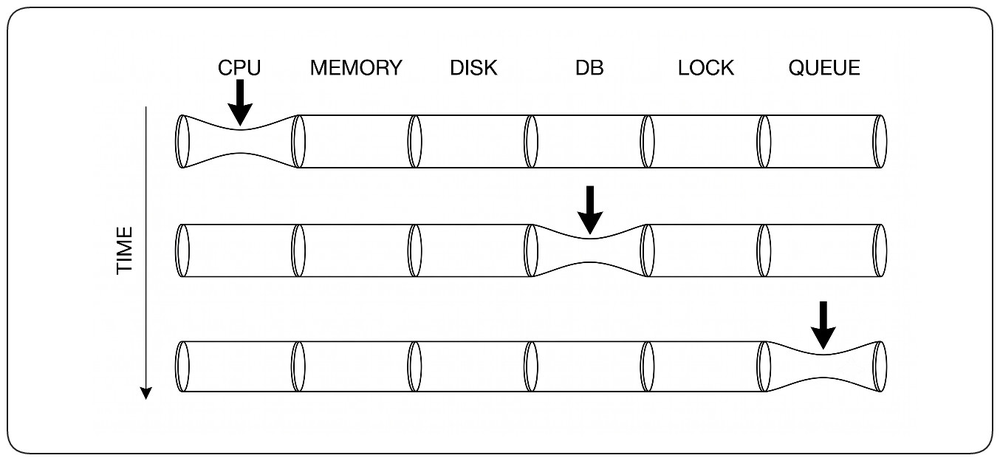
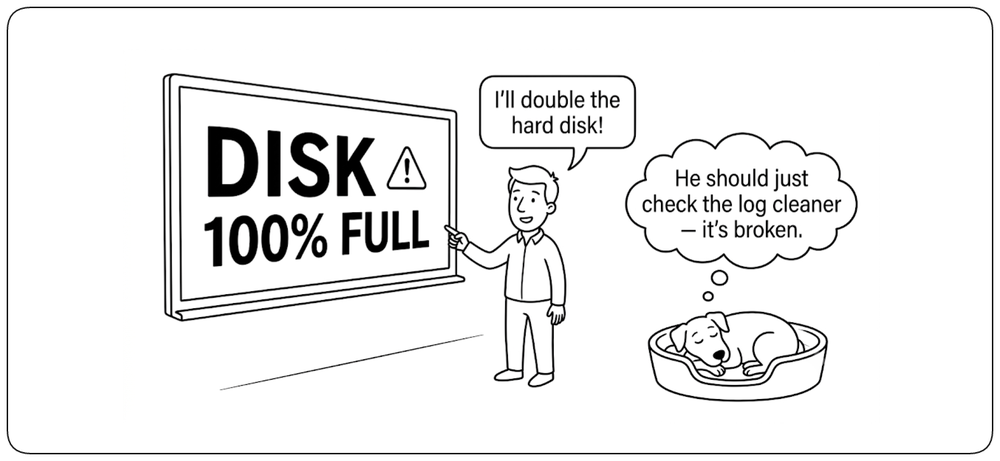
À tout moment, la capacité d’un système est limitée par son goulot d’étranglement dominant — CPU, mémoire, réseau, disque, base de données, contention de verrous, profondeur de file, ou même prise de décision humaine — et !!mettre à l’échelle, c’est la discipline qui consiste à identifier cette contrainte, à la lever, puis à trouver la suivante!!. Traiter la mauvaise contrainte fait perdre argent et temps : ajouter des serveurs quand la base de données est la limite ne fait que l’affamer plus vite ; ajouter du disque quand le réseau est saturé ne change rien. Le goulot d’étranglement se déplace toujours une fois levé, donc la mise à l’échelle n’est jamais « terminée » — c’est une négociation continue avec la ressource qui est, à cet instant, le maillon le plus lent!!.
Principes fondamentaux de scalabilité
Si la scalabilité ne consiste pas à acheter des machines plus grosses, qu’est-ce qui rend un système scalable ? La réponse tient en une poignée de principes de conception qui restent les mêmes quelle que soit la technologie.
L’unité de travail : multiplier les workers
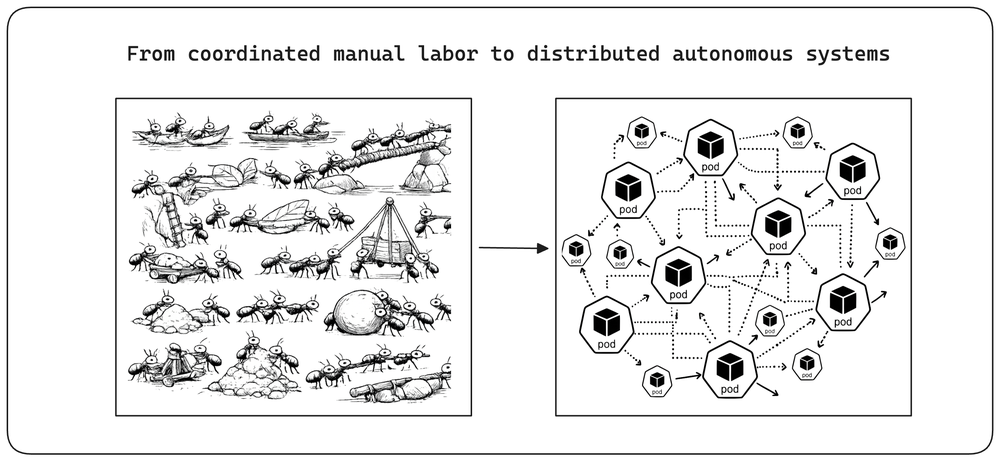
La scalabilité consiste fondamentalement à !!multiplier une main-d’œuvre capable de traiter le travail en parallèle!!. Avec le temps, le « worker » a évolué des personnes et des machines vers le calcul numérique : instances virtuelles, conteneurs, pods Kubernetes et fonctions serverless. Les workers modernes prennent généralement l’une de ces formes — instances (calcul stable et durable avec ressources dédiées), conteneurs ou pods (unités légères et portables qui démarrent vite et passent à l’échelle par paliers fins), ou fonctions serverless (calcul piloté par les événements qui s’adapte automatiquement à chaque requête).
Des workers interchangeables : un calcul sans état
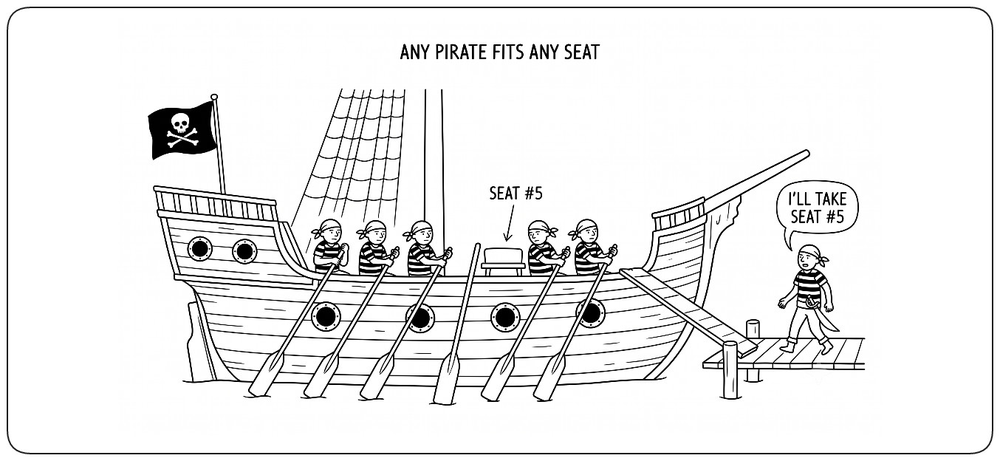
La règle de conception la plus importante est de garder les workers interchangeables : !!un worker ne doit pas conserver l’état des requêtes précédentes!!. Si un état est nécessaire, externalisez-le — bases de données, stockage objet, Redis, files durables — afin que des workers sans état puissent être multipliés horizontalement, remplacés en cas de panne et autoscalés en toute sécurité. Quand n’importe quel worker peut servir n’importe quelle requête, passer à l’échelle revient à ajouter des copies ; quand les workers détiennent un état local, chaque panne ou réduction de capacité perd de l’information et chaque montée en charge exige un temps de préchauffage.
Optimiser avant de mettre à l’échelle
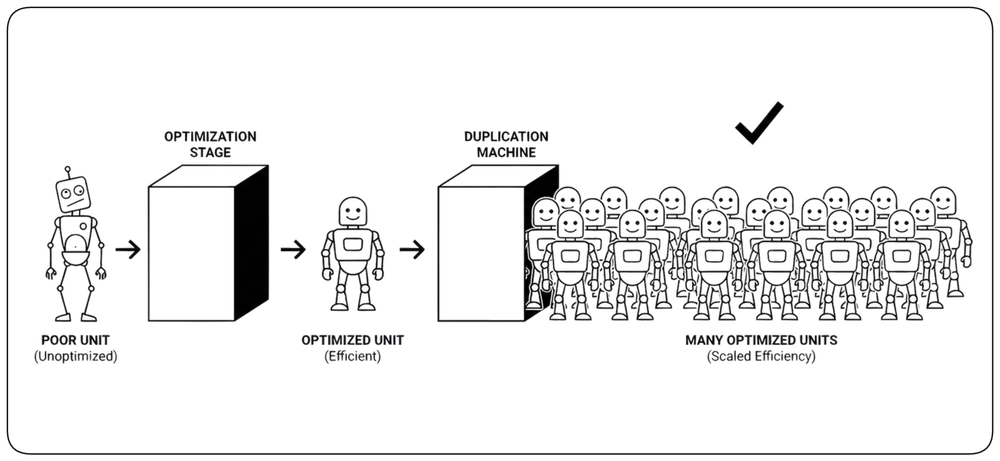
Concentrez-vous sur l’efficacité avant de passer à l’échelle : affinez d’abord l’unité de travail — par des améliorations algorithmiques, l’optimisation des requêtes et la réduction des payloads — afin de minimiser l’empreinte en ressources de chaque opération. !!La mise à l’échelle doit être un outil pour absorber la croissance, pas un masque pour une mauvaise performance!!; perfectionner l’unité de travail au préalable garantit que, lorsque vous vous étendez, vous le faites avec un maximum de rentabilité et un minimum de dette technique.
Automatisation : le travail manuel ne passe pas à l’échelle
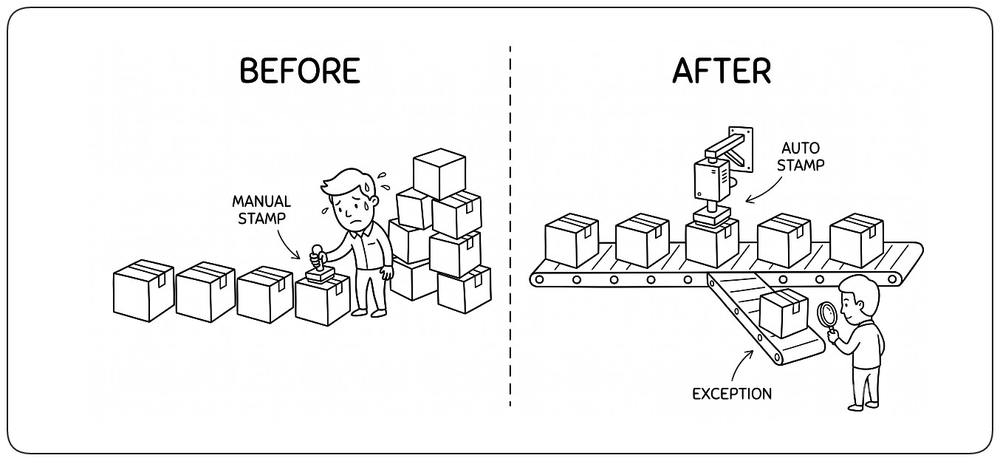
!!Le travail manuel ne passe pas à l’échelle.!! Si le provisioning, le déploiement, la configuration, la reprise, l’approbation ou la coordination du travail courant exigent des personnes à chaque fois, la charge opérationnelle croît avec le système. L’automatisation, les conventions et une responsabilité claire transforment les actions répétées en processus prévisibles. !!Toute tâche répétitive qui dépend d’une intervention humaine devient un goulot d’étranglement de scalabilité!!. L’objectif n’est pas de supprimer les personnes, mais de réserver le jugement humain aux situations qui l’exigent vraiment.
Modularité : ne mettre à l’échelle que ce qui doit l’être
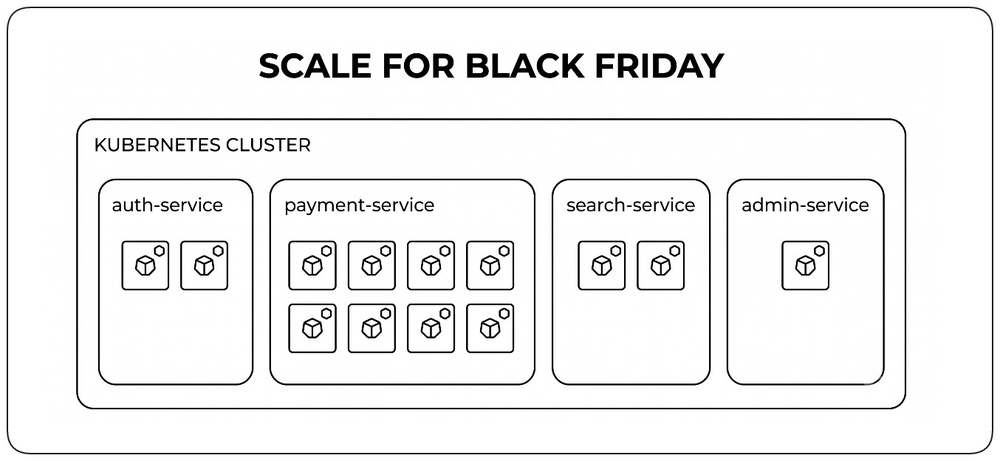
Les systèmes modulaires passent à l’échelle autrement que les monolithes. Au lieu de tout mettre à l’échelle ensemble, !!on ne met à l’échelle que ce qui en a besoin!!. Le service de paiement qui encaisse le trafic du Black Friday peut grandir indépendamment, tandis que le tableau de bord d’administration, rarement utilisé, reste petit. Ce contrôle granulaire des ressources n’est possible que si le système est correctement décomposé en modules indépendants et faiblement couplés — microservices, conteneurs ou fonctions serverless. La modularité est le principe ; les microservices en sont une expression architecturale, tandis que les architectures événementielles et serverless s’appuient sur la même idée de différentes manières.
La défaillance fait partie de l’échelle
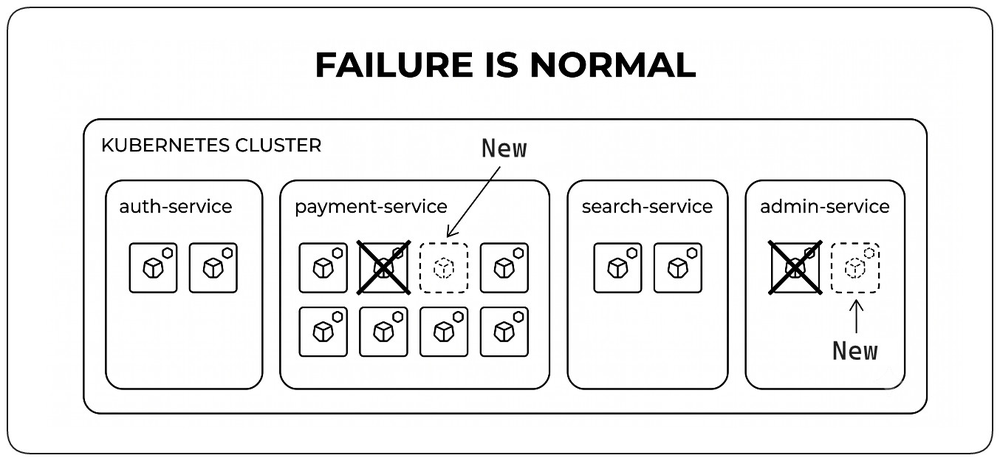
!!À mesure que les systèmes grandissent, les défaillances deviennent une condition normale de fonctionnement!!. Plus de serveurs, plus de services, plus de réseaux et plus de dépendances signifient inévitablement plus de composants qui tombent en panne chaque jour. !!La scalabilité ne consiste donc pas seulement à traiter plus de travail, mais aussi à continuer de fonctionner pendant que des parties du système tombent constamment en panne!!. Les mécanismes qui le permettent — redondance, health checks, failover et dégradation progressive — sont traités dans le chapitre Concevoir pour la résilience.
Une capacité pour la défaillance
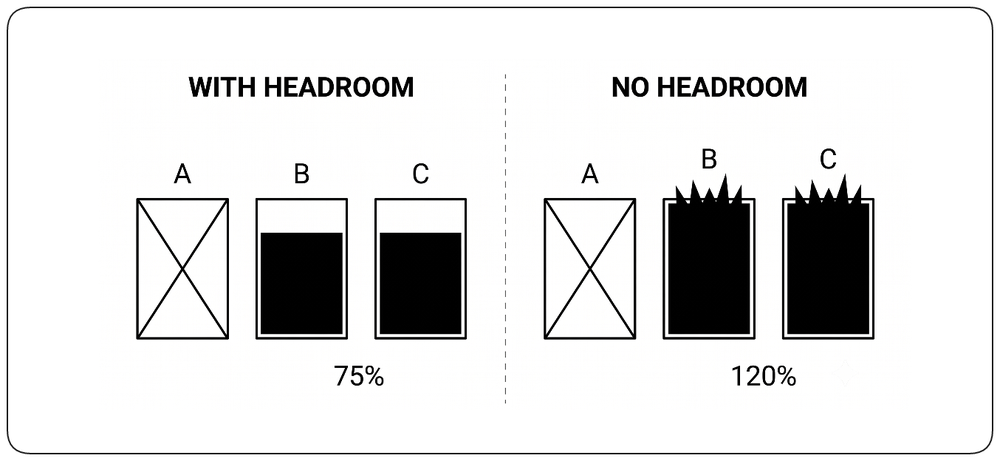
La redondance ne fonctionne que si les parties survivantes du système peuvent absorber la charge laissée par une défaillance. !!Même quand les instances défaillantes sont remplacées automatiquement, la reprise prend du temps, et la capacité restante doit porter la charge supplémentaire entre-temps!!. Une deuxième zone, un deuxième cluster ou un deuxième chemin réseau ne servent à rien s’ils sont déjà proches de leur capacité. !!Le capacity planning doit tenir compte du fonctionnement dégradé, pas seulement du fonctionnement normal!!.
Standardisation : la langue de l’échelle
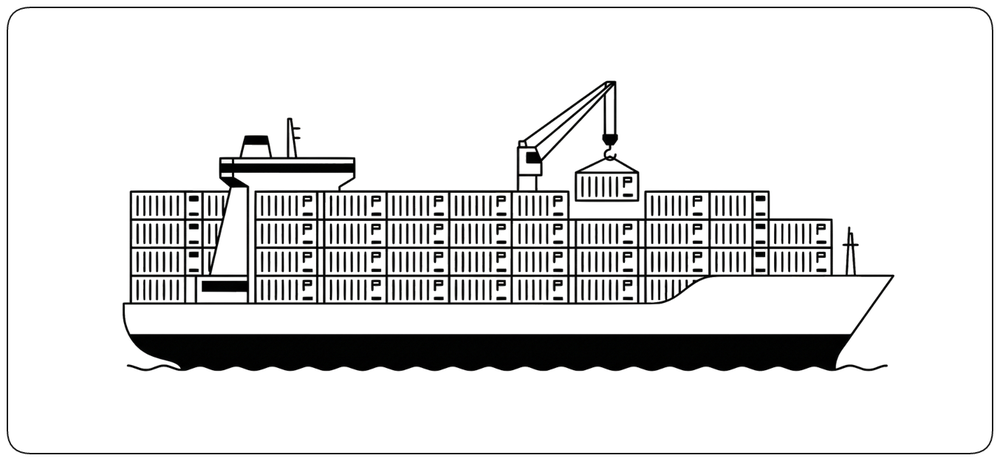
La standardisation permet la composition. !!Quand chaque service parle la même langue, que chaque conteneur suit les mêmes conventions et que chaque API respecte les mêmes patterns, on peut assembler des systèmes à partir de pièces interchangeables!!. Des filetages de vis standardisés qui ont permis la production de masse au XIXe siècle aux API REST et aux conteneurs Docker d’aujourd’hui, la standardisation est le secret pour construire des systèmes qui passent à l’échelle non seulement en taille, mais aussi en complexité.
Stratégies de mise à l’échelle
Ces principes expliquent ce qui rend un système scalable. La question suivante est de savoir comment la capacité est réellement augmentée.
Comprendre ce qui grandit
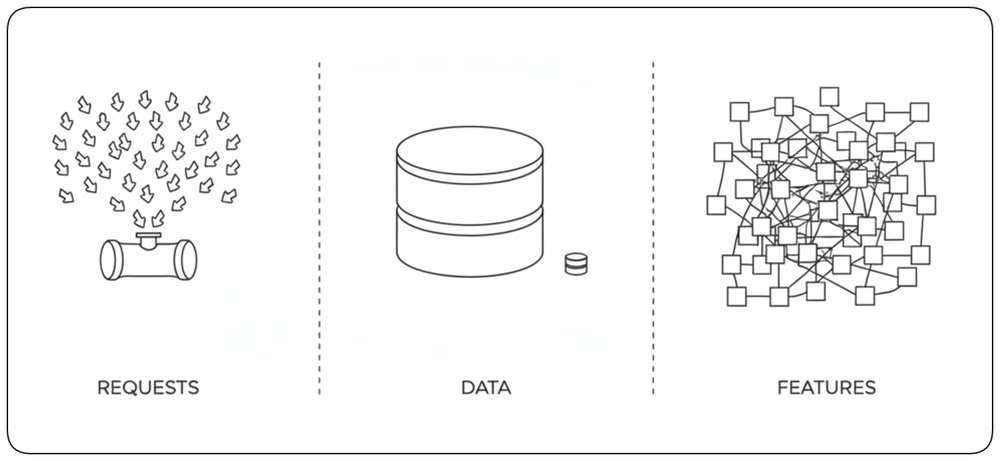
Les systèmes peuvent grandir de différentes façons. Par exemple, !!plus de requêtes créent un problème de débit, plus de données créent un problème de stockage et d’accès, et plus de fonctionnalités créent un problème de complexité!!. Une technique de mise à l’échelle n’est utile que si elle traite la dimension qui grandit réellement. Répliquer des workers peut absorber du trafic supplémentaire, mais cela n’aide guère quand la vraie contrainte est un jeu de données surdimensionné ou une application devenue trop complexe pour évoluer efficacement. !!Avant de mettre à l’échelle, identifiez la contrainte que vous cherchez à lever!!.
Scalabilité verticale : grandir vers le haut
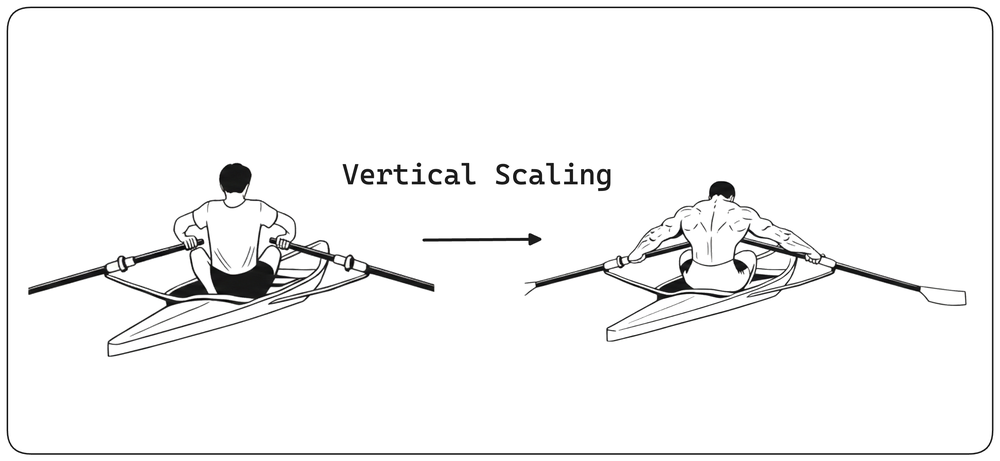
La scalabilité verticale augmente la puissance d’un seul serveur en ajoutant du CPU, de la RAM ou du stockage. C’est le modèle de mise à l’échelle le plus simple : quand il faut plus de capacité, on prend une machine plus grosse. Cela fonctionne bien pour les applications difficiles à distribuer, mais les limites sont claires : le matériel finit par atteindre un plafond, le serveur reste un point de défaillance unique, et les machines plus grosses deviennent de plus en plus chères.
Scalabilité horizontale : grandir vers l’extérieur
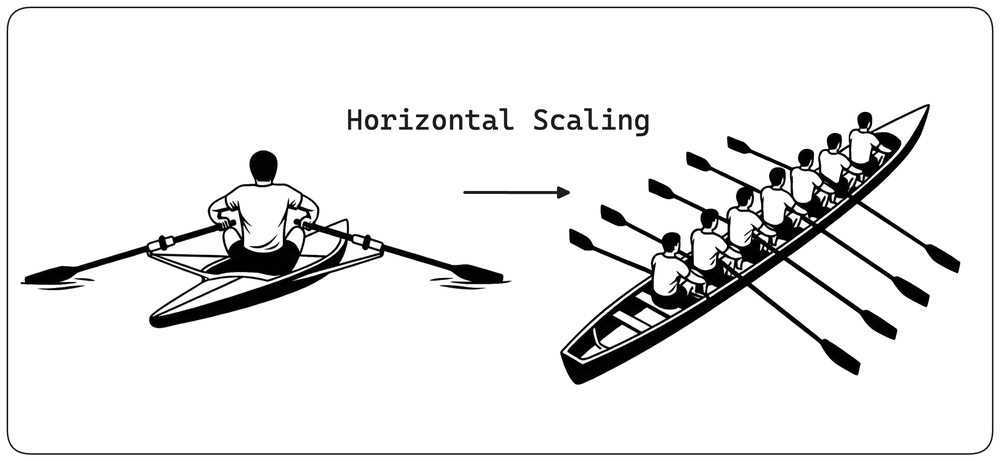
La scalabilité horizontale, ou !!scale out, consiste à ajouter des machines ou des instances pour absorber une charge croissante!!. Le travail est réparti sur plusieurs nœuds, ce qui améliore la capacité et la tolérance aux pannes. Cette approche passe bien à l’échelle pour les grands systèmes et peut être plus rentable que de s’appuyer sur un matériel toujours plus puissant. Le compromis est !!une complexité accrue : coordination distribuée, partitionnement des données, surcoût réseau et davantage de modes de défaillance!!.
Ne mettre à l’échelle que lorsque c’est nécessaire
!!Mettre à l’échelle n’est pas toujours la bonne réponse!!. Avant d’ajouter des machines, éliminez d’abord les inefficacités : un meilleur algorithme, une meilleure requête ou un cache apporte souvent de plus grandes améliorations à moindre coût. Quand de la capacité supplémentaire est nécessaire, la scalabilité verticale est généralement l’option la plus simple jusqu’à ce qu’une machine atteigne ses limites pratiques. La scalabilité horizontale introduit plus de complexité et doit être utilisée quand la charge de travail l’exige. La distinction importante est celle entre !!concevoir pour la scalabilité horizontale et passer réellement au scale out!!: un système peut être conçu avec des workers sans état et réplicables bien avant que plusieurs instances ne soient nécessaires.
Mettre à l’échelle ne supprime pas les points de défaillance uniques
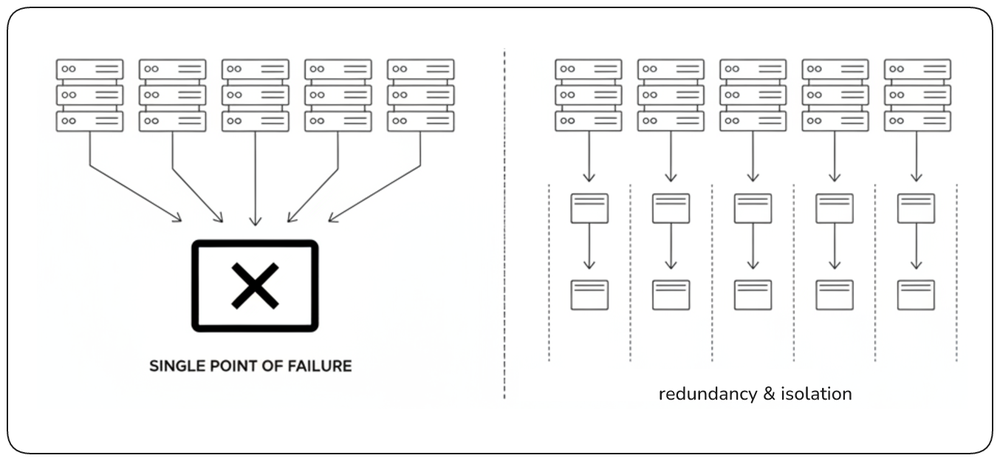
Ajouter des nœuds augmente la capacité, mais ne supprime pas les points de défaillance partagés. Cent serveurs peuvent encore tomber comme un seul système s’ils dépendent tous de la même base de données, du même control plane, du même chemin réseau ou du même état partagé. !!La scalabilité horizontale n’améliore la robustesse du système que si ces dépendances partagées sont elles aussi distribuées ou isolées!!. Sinon, vous avez multiplié la capacité sans supprimer le domaine de défaillance qui peut tout arrêter d’un coup.
Le Scale Cube : trois dimensions
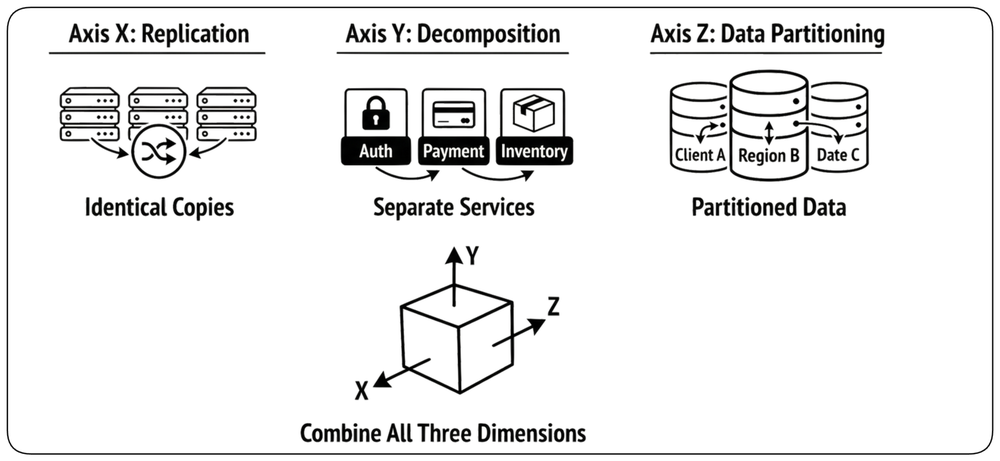
Quand un système doit passer à l’échelle, trois dimensions fondamentales s’appliquent, connues sous le nom de Scale Cube. !!Axe X : dupliquer!! — cloner toute l’application sur des instances identiques derrière un load balancer. Chaque instance exécute le même code et traite n’importe quelle requête. Simple, mais chaque instance porte le poids de toute l’application même si seules certaines parties sont fortement sollicitées. !!Axe Y : découper!! — décomposer l’application par fonction ou capacité afin que chaque partie passe à l’échelle indépendamment selon sa propre charge. !!Axe Z : partitionner!! — répartir les données en shards selon un attribut (identifiant client, région, date) afin que chaque partition gère un sous-ensemble des utilisateurs ou des données. La plupart des systèmes scalables combinent les trois : dupliquer les parties, découper le tout et partitionner les données.
Élasticité et auto-scaling
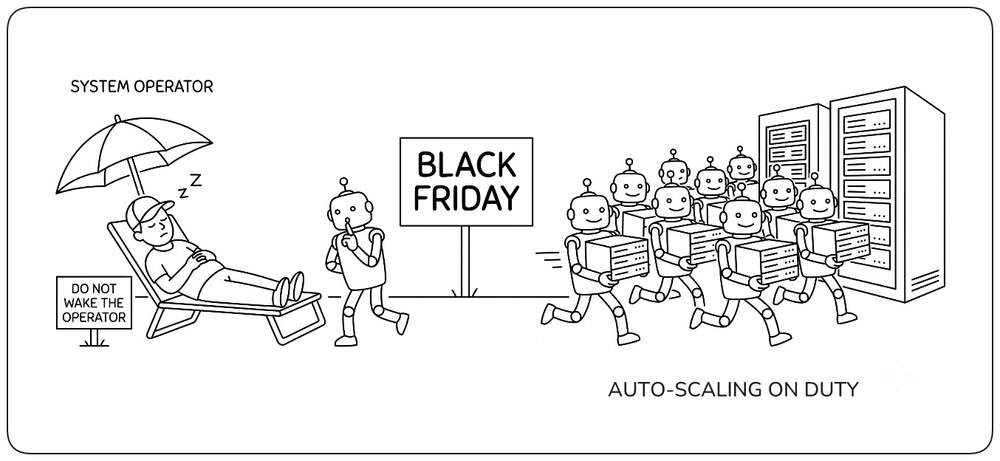
L’élasticité est la capacité d’un système à !!ajuster automatiquement sa capacité à mesure que la demande monte et descend!!. L’auto-scaling est le mécanisme qui rend l’élasticité possible : il surveille des signaux comme le CPU, la profondeur de file ou des métriques applicatives, et ajoute ou retire des instances en conséquence. Des politiques efficaces dépendent du bon déclencheur et du bon timing : !!monter vite lors des pics, mais redescendre progressivement pour éviter le flapping!!. L’élasticité est particulièrement précieuse pour les charges irrégulières, où ne payer que la capacité active évite le coût des ressources inactives.
Évoluer par conception, pas dans la panique
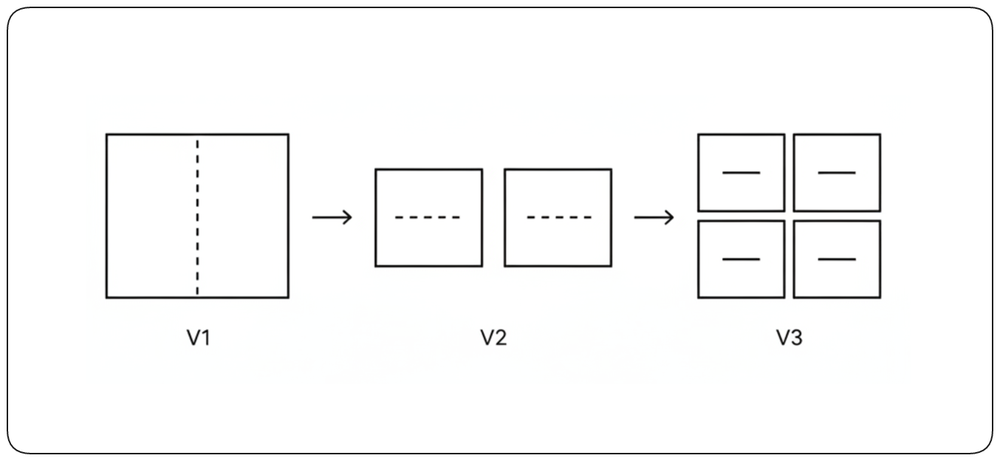
Une architecture scalable n’a pas besoin de tous les mécanismes de mise à l’échelle dès le départ. Il lui faut !!un chemin clair pour le moment où la conception actuelle atteindra ses limites!!. L’objectif n’est pas de prédire parfaitement la croissance future, mais de préserver assez de liberté architecturale pour faire le prochain changement sans tout reconstruire. !!De bonnes frontières, des composants remplaçables et des chemins de migration clairs transforment la croissance future en une tâche d’ingénierie planifiée plutôt qu’en urgence!!.
Distribuer le travail
Ajouter des workers crée de la capacité, mais cette capacité n’est utile que si le travail est distribué efficacement. Certains travaux doivent être traités immédiatement, d’autres peuvent attendre sans risque. Ces deux situations conduisent à deux stratégies de distribution complémentaires : la distribution immédiate et la distribution différée. Toutes deux visent à garder les workers occupés sans en surcharger un seul.
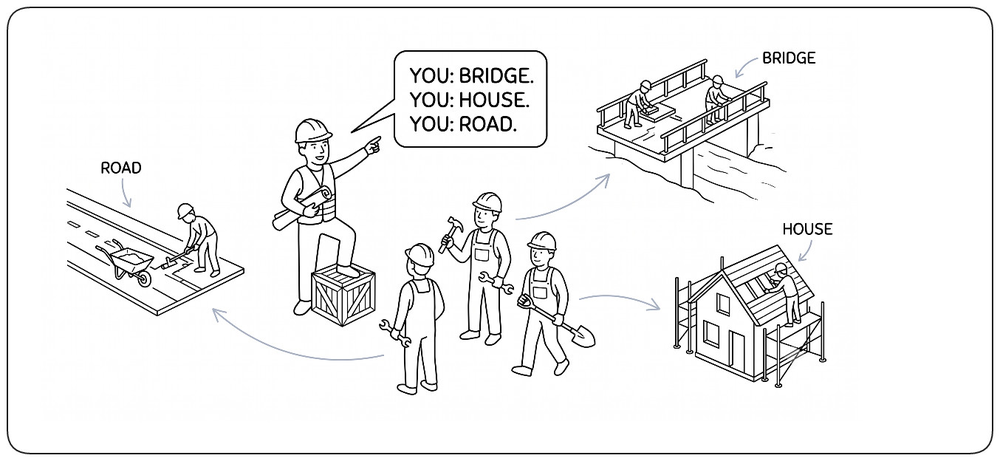
Distribution synchrone des requêtes
Les requêtes de courte durée qui exigent une réponse immédiate sont généralement envoyées directement à un worker disponible. L’objectif est de répartir la charge uniformément pour qu’aucun worker ne devienne le goulot d’étranglement pendant que d’autres restent inactifs. Un load balancer est le mécanisme le plus courant pour réaliser cette distribution, en acheminant chaque requête entrante vers un worker approprié. Les politiques courantes incluent le round-robin (rotation sur les workers dans l’ordre), le least-connections (favorise le worker le moins occupé) et le latency-based (favorise le plus rapide à répondre). Quelle que soit la politique, le principe reste le même : !!garder les workers utilisés de façon homogène pour qu’aucun ne devienne le goulot d’étranglement!!.
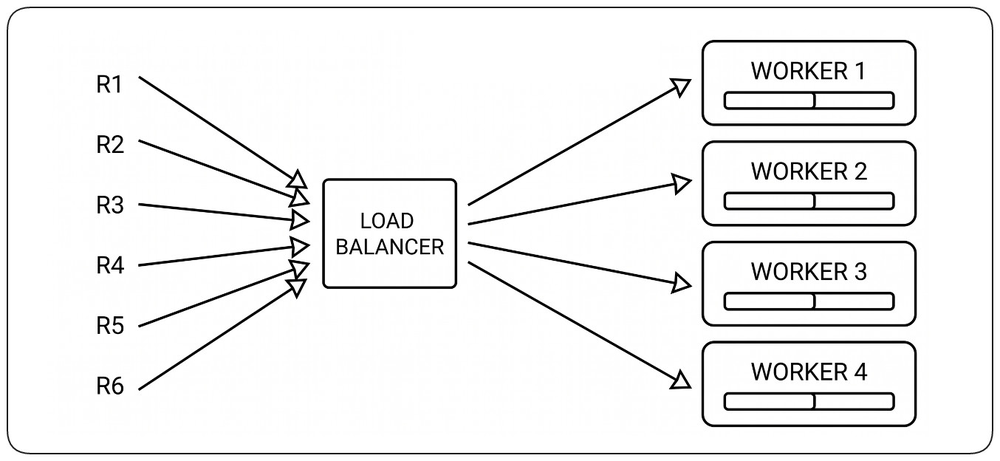
Distribution par file
Quand le travail prend plus de temps à traiter, arrive par rafales ou n’exige pas de réponse immédiate, il vaut souvent mieux découpler la soumission de l’exécution. Au lieu d’assigner chaque tâche directement à un worker précis, les producteurs placent le travail dans une file partagée, et les workers disponibles récupèrent les tâches quand ils sont prêts à les traiter. Cela permet aux workers de traiter le travail à un rythme maîtrisé, en absorbant les rafales sans submerger aucun worker. !!La file devient le point de coordination entre le travail entrant et la capacité de traitement disponible!!.
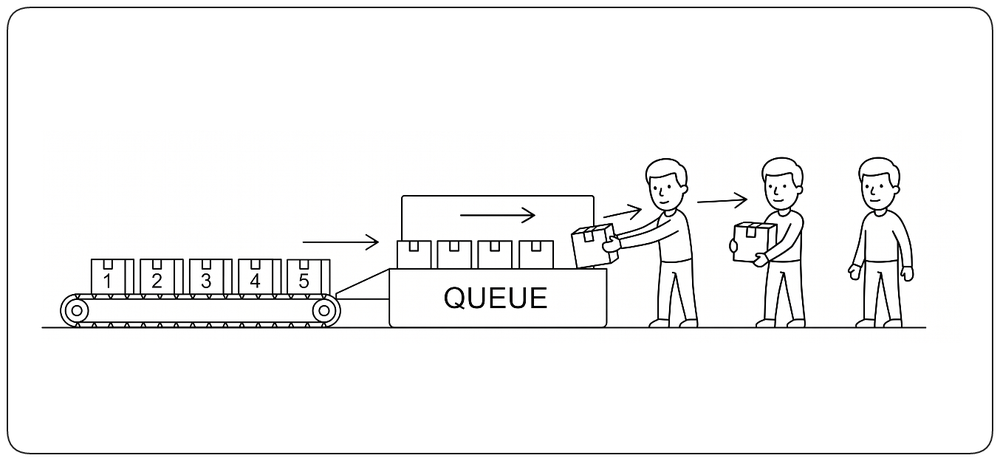
Files qui grossissent : quand le différé devient surcharge
Une file n’est utile que tant qu’elle reste sous contrôle. Quand les tâches arrivent plus vite que les workers ne peuvent les traiter, le travail non terminé s’accumule en continu. Une file qui grossit est donc une indication directe que la capacité de traitement est inférieure à la demande entrante. Plus le travail reste longtemps dans le système, plus il s’en accumule derrière lui. La leçon pratique est simple : !!une file peut absorber des rafales temporaires, mais elle ne peut pas compenser un manque de capacité permanent!!. Tôt ou tard, il faut traiter le travail plus vite, ajouter des workers, réduire le travail entrant ou rejeter l’excédent de charge.
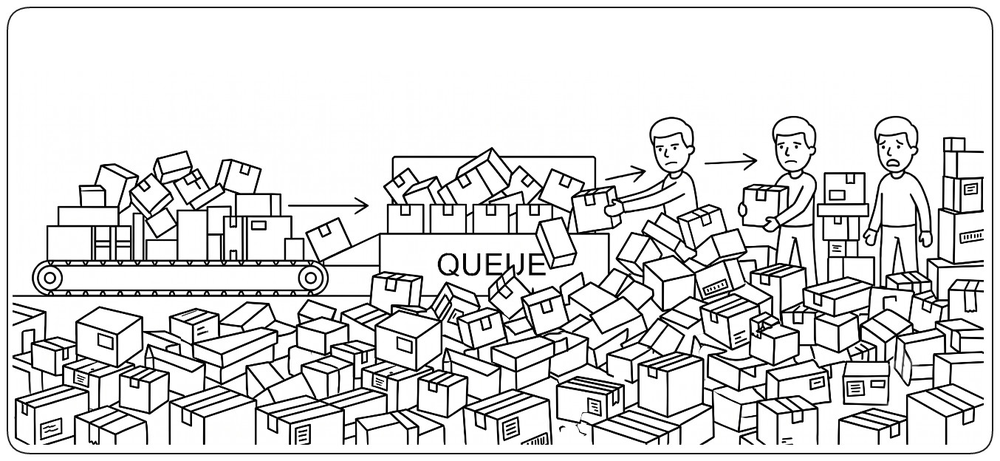
Protéger le système en cas de surcharge
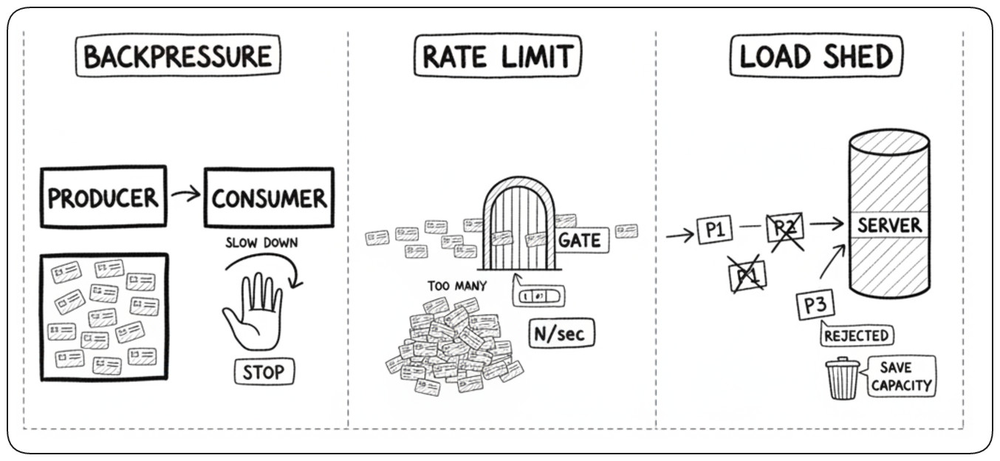
Un système scalable doit aussi savoir quoi faire quand la demande croît plus vite que la capacité ne peut être ajoutée. Le !!backpressure!! ralentit les producteurs quand les consommateurs ne suivent pas, le !!rate limiting!! contrôle la quantité de travail qui entre dans le système, et le !!load shedding!! rejette le travail de moindre priorité quand la capacité est épuisée. Sans ces mécanismes, la surcharge se propage d’un composant à l’autre jusqu’à ce que tout le système devienne instable. Parfois, !!la réponse la plus scalable est de refuser du travail plutôt que d’en accepter plus que le système ne peut traiter en sécurité!!.
Rendre les files fiables
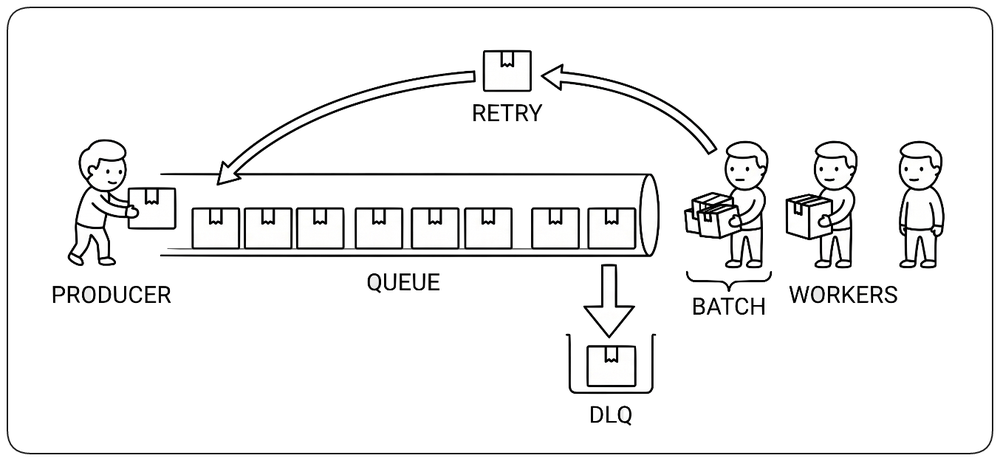
La distribution différée apporte le choix architectural ; plusieurs mécanismes la rendent robuste en pratique. Les !!retries avec exponential backoff!! gèrent les défaillances transitoires sans perdre de travail. Les !!dead-letter queues!! isolent les tâches qui échouent définitivement pour qu’elles ne bloquent pas le traitement sain. Le !!batching!! amortit le surcoût par tâche quand la latence le permet. Et comme la file apporte du découplage — pas une capacité infinie — !!la profondeur de file et la latence de traitement doivent toujours être surveillées!!.
Traitement par lots distribué
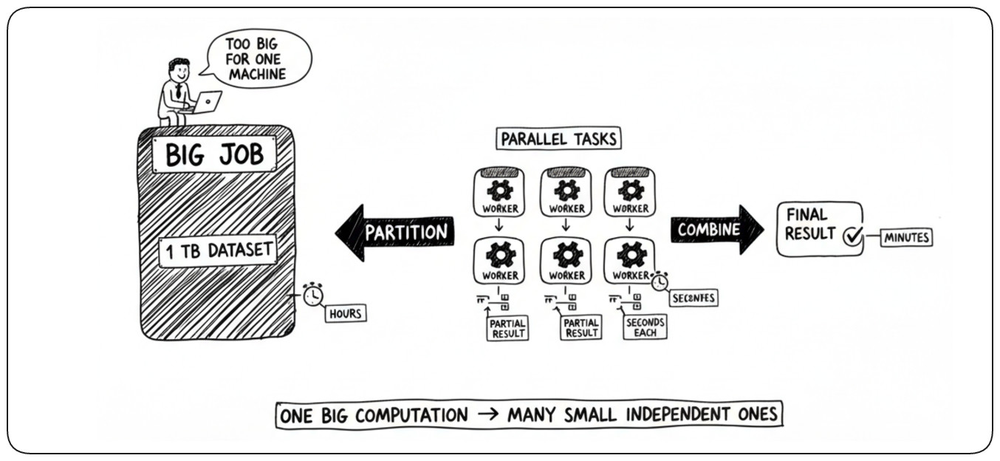
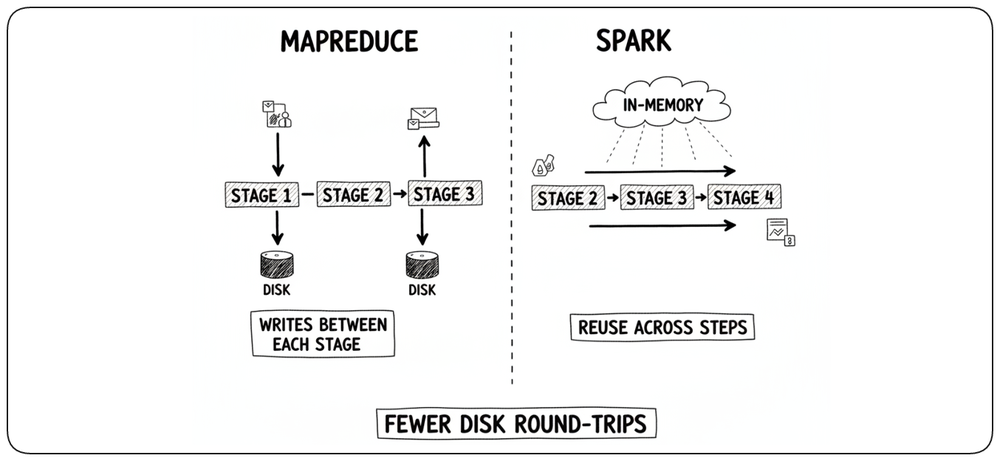
Certains travaux sont trop volumineux pour un seul worker et trop structurés pour être traités comme des messages de file indépendants. Le traitement par lots distribué découpe un jeu de données en partitions, exécute des tâches parallèles sur de nombreux workers, puis combine les résultats partiels. !!Il passe à l’échelle en transformant un gros calcul en de nombreux petits calculs indépendants qui peuvent s’exécuter en parallèle!!. Deux générations de moteurs ont façonné cette approche : MapReduce, qui a établi le modèle, et Spark, qui a rendu le traitement multi-étapes beaucoup plus rapide.
MapReduce : diviser et combiner
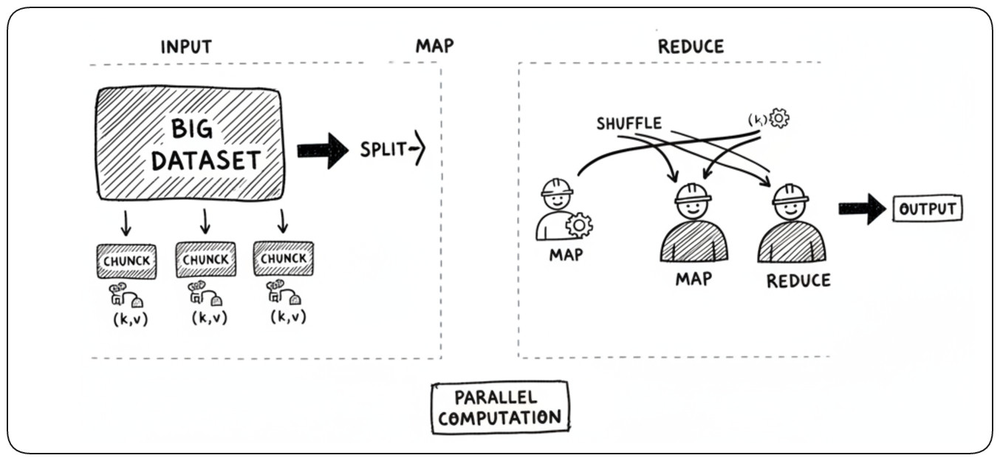
MapReduce a été popularisé par Google au début des années 2000 comme moyen de traiter des jeux de données extrêmement volumineux sur des milliers de machines. L’idée était volontairement simple : !!découper les données, traiter chaque partie en parallèle, puis combiner les résultats partiels!!. La phase map transforme indépendamment des morceaux de données, et la phase reduce agrège les résultats intermédiaires en une réponse finale. Ce modèle a rendu le traitement par lots à grande échelle praticable sur des clusters de machines ordinaires et a fortement influencé des systèmes comme Hadoop.
Spark : garder les données près du calcul
Apache Spark est apparu plus tard pour dépasser certaines limites du modèle MapReduce. Dans MapReduce, les résultats intermédiaires sont souvent écrits sur disque entre les étapes, ce qui rend les charges multi-étapes coûteuses. Spark a introduit un modèle d’exécution plus flexible qui !!garde les données intermédiaires en mémoire et les réutilise sur plusieurs opérations!!. Il est ainsi bien mieux adapté aux algorithmes itératifs, à l’analytique interactive, au machine learning et aux pipelines de traitement complexes. Spark conserve le même modèle de calcul distribué, mais réduit le coût des déplacements et rechargements répétés de données intermédiaires.
Orchestrer le travail
À mesure que le travail est réparti sur davantage de workers et de services, la coordination elle-même devient un problème de scalabilité. Il faut assigner les tâches individuelles, remplacer les workers défaillants et faire avancer les processus multi-étapes sans intervention manuelle. !!La distribution détermine où le travail s’exécute ; l’orchestration garantit que le travail distribué continue de progresser correctement!!.
Garder les workers en bonne santé
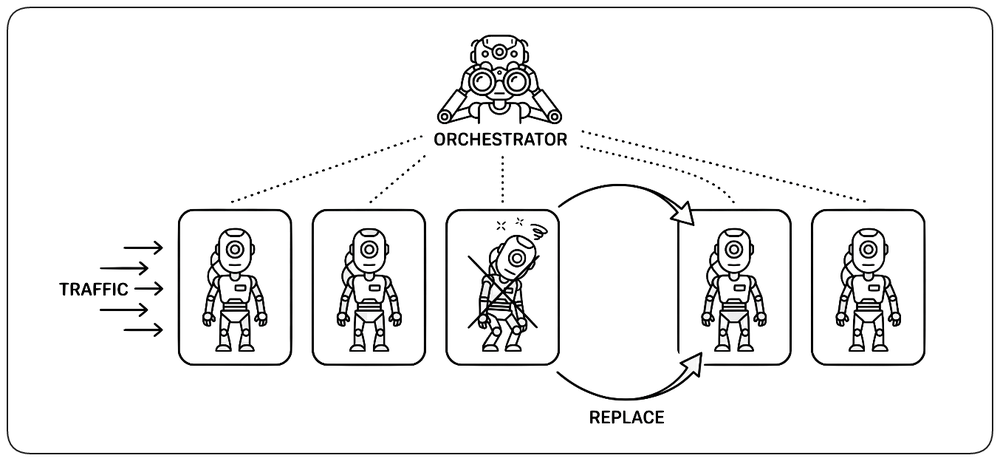
Certains workers tournent en continu pendant des jours, des semaines ou des mois tout en servant du trafic. Avec le temps, ils peuvent planter, devenir défaillants ou cesser de répondre correctement. À grande échelle, les surveiller et les remplacer manuellement est impossible. Un orchestrateur runtime surveille la santé des workers, retire les instances défaillantes du trafic, redémarre ou remplace celles qui sont tombées, et maintient la capacité souhaitée. Kubernetes en est un exemple courant. !!Les workers de longue durée ont besoin d’une orchestration continue pour rester sains, disponibles et aptes à recevoir du trafic!!.
Coordonner des workflows multi-étapes
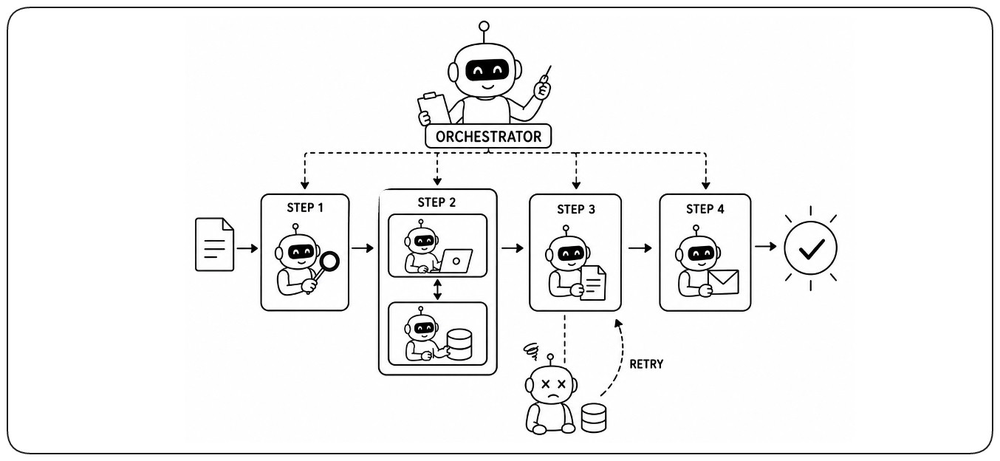
Certaines opérations ne sont pas une tâche unique mais une séquence d’étapes dépendantes. Une étape peut avoir besoin du résultat d’une autre, certaines peuvent attendre des événements externes, et les défaillances peuvent exiger des retries ou des actions compensatoires. Dans ces cas, le système doit suivre l’avancement du workflow et décider de la suite. Un orchestrateur assure cette coordination en maintenant l’état du workflow et en menant le processus d’une étape à la suivante. !!La distribution assigne les tâches individuelles ; l’orchestration coordonne le workflow auquel elles appartiennent!!.
Orchestration vs chorégraphie
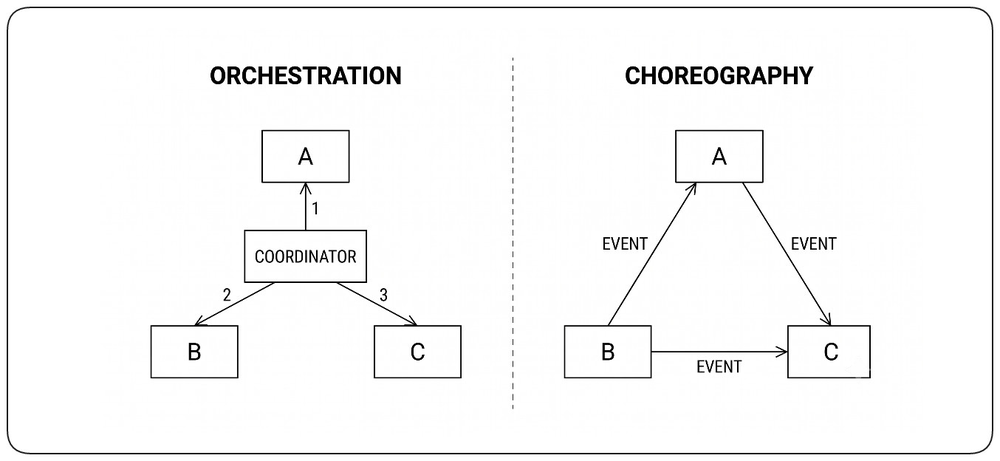
Les workflows distribués peuvent être coordonnés de deux manières principales. Dans l’!!orchestration!!, un coordinateur central décide de l’étape à exécuter ensuite et conserve l’état global du workflow en un seul endroit. Le processus est ainsi plus facile à comprendre, à surveiller et à auditer, mais cela introduit un composant de coordination central qui doit rester fiable et léger. Dans la !!chorégraphie!!, les services réagissent aux événements émis par d’autres services sans coordinateur central. Cela réduit le couplage direct et laisse les services évoluer de façon plus indépendante, mais le workflow global devient implicite et plus difficile à tracer à travers de nombreux composants. !!Utilisez l’orchestration quand le workflow exige un état et un contrôle explicites ; utilisez la chorégraphie quand l’indépendance et le couplage faible comptent plus que la visibilité centralisée!!.
Le coût de l’orchestration de workflows
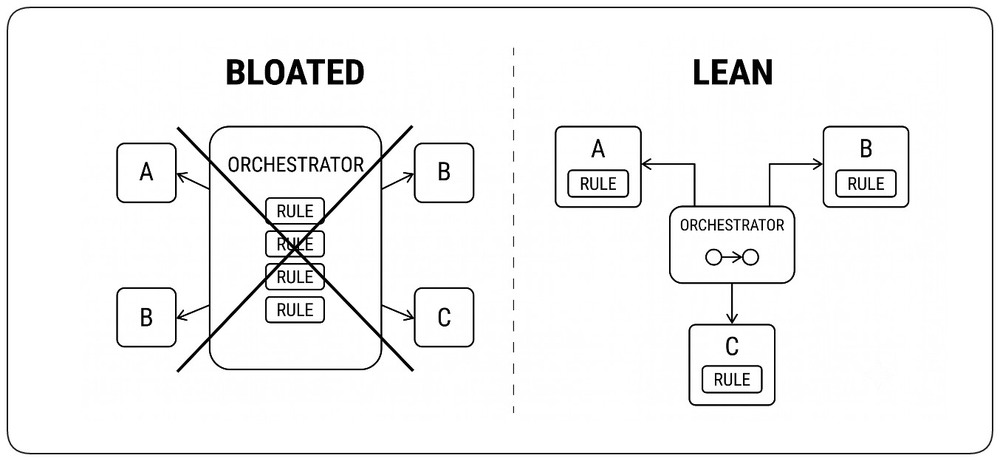
L’orchestration simplifie les workflows complexes, mais elle introduit un composant de coordination supplémentaire. Si trop de logique métier s’accumule dans l’orchestrateur, il devient un goulot d’étranglement, un point de défaillance unique et un cerveau central qui couple fortement des services par ailleurs indépendants. Un bon orchestrateur coordonne l’état et les transitions du workflow tout en laissant les décisions métier aux services qui en sont responsables. !!Utilisez l’orchestration quand la coordination est réellement nécessaire, pas comme substitut à des services bien définis!!.
Mise à l’échelle des données
Mettre à l’échelle le calcul consiste surtout à ajouter des workers pour traiter plus de travail. Les données, c’est différent : elles persistent, doivent survivre aux pannes et rester disponibles à mesure que le volume et le trafic augmentent. Dans toutes les architectures de cette section, trois mécanismes dominent : !!la réplication distribue les lectures et améliore la disponibilité, le partitionnement divise le jeu de données pour que le stockage et les écritures puissent croître horizontalement, et la séparation du calcul et du stockage permet à chaque ressource de passer à l’échelle indépendamment!!. Les différentes familles de bases de données combinent ces mécanismes différemment : le SQL opérationnel met l’accent sur les transactions et la cohérence, le NoSQL sur la distribution et les patterns d’accès, et les plateformes analytiques sur les gros scans, le stockage en colonnes et le calcul élastique.
Concevoir les données pour l’échelle dès le premier jour
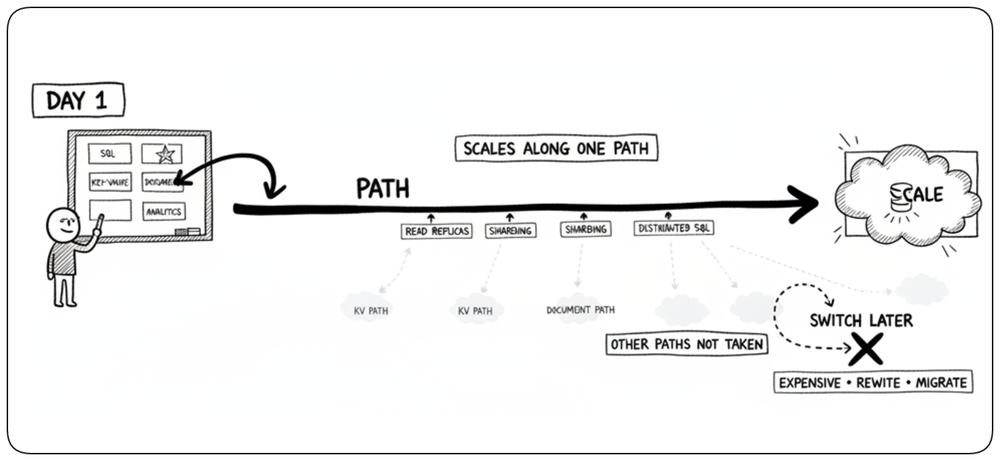
Les choix de données faits tôt influencent fortement la façon dont un système pourra passer à l’échelle plus tard. Une base SQL transactionnelle, un key-value store, une base documentaire ou une plateforme analytique ont chacun des forces différentes et des chemins de mise à l’échelle différents. La scalabilité doit donc faire partie de la décision sur les données dès le premier jour. !!Changer le modèle de données plus tard est possible, mais souvent coûteux et perturbateur!!.
Mettre à l’échelle les bases SQL traditionnelles
Les bases SQL organisent les données en tables structurées avec des relations explicites et de fortes garanties transactionnelles. !!À mesure que la demande croît, différentes stratégies de mise à l’échelle peuvent être introduites selon que la pression vient des lectures, des écritures ou du stockage!!. Les sections suivantes explorent comment les bases SQL peuvent évoluer d’un primaire unique vers des architectures de plus en plus distribuées.
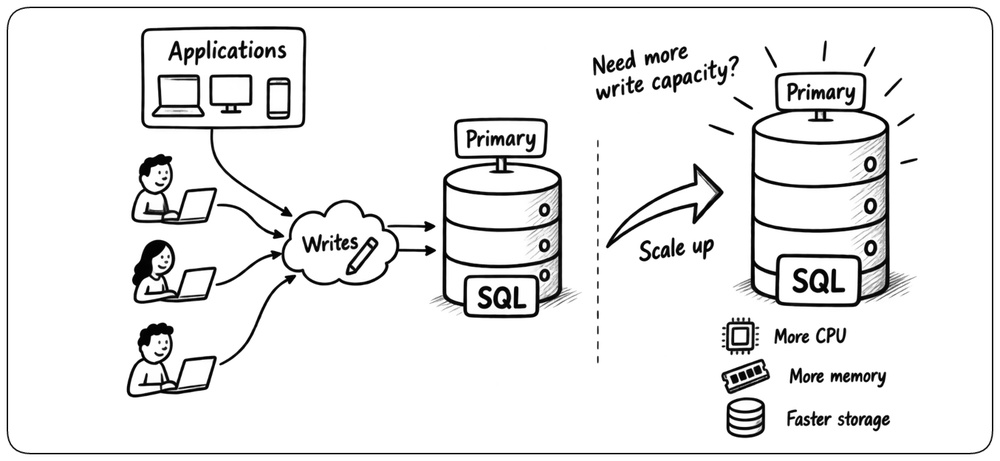
SQL traditionnel : mettre à l’échelle le primaire
Les bases SQL traditionnelles reposent généralement sur un seul nœud primaire pour les écritures. Cela garde les transactions et la cohérence simples, mais !!la capacité d’écriture est limitée par celle de ce primaire!!. À mesure que la demande croît, on peut donner au primaire plus de CPU, de mémoire ou un stockage plus rapide. Les services SQL managés modernes peuvent automatiser une partie de cette croissance, notamment l’extension du stockage, mais la limite architecturale reste la même : les écritures dépendent toujours d’un seul primaire. Autrement dit, !!la façon naturelle d’augmenter la capacité d’écriture est la scalabilité verticale!!.
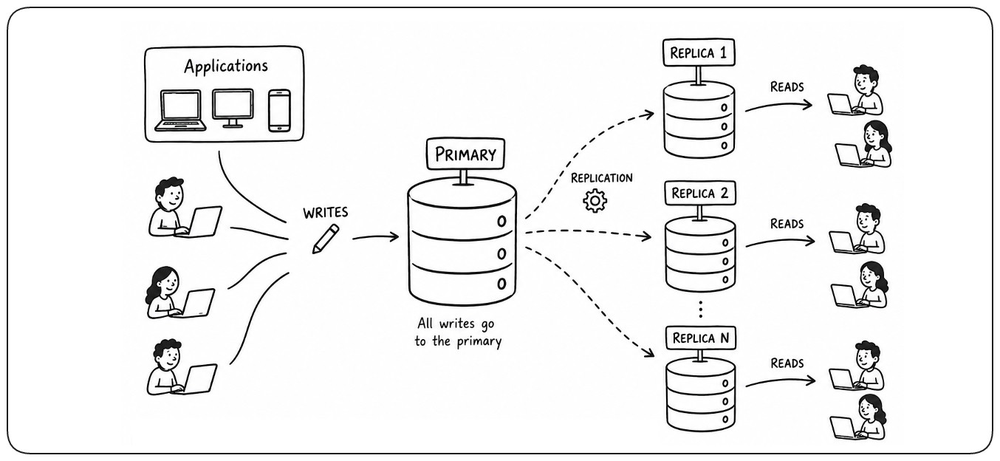
Read replicas : mettre à l’échelle les lectures
De nombreuses applications lisent bien plus qu’elles n’écrivent. Les read replicas exploitent cette asymétrie en envoyant les écritures vers une base primaire et en répartissant les lectures sur des copies répliquées. La réplication vers ces replicas est généralement asynchrone, ce qui augmente le débit de lecture sans changer le chemin d’écriture. Le compromis est le replication lag : les replicas peuvent brièvement renvoyer des données obsolètes, donc les lectures sensibles à la cohérence peuvent devoir aller sur le primaire. !!Les read replicas font passer à l’échelle la capacité de lecture, pas celle d’écriture!!.
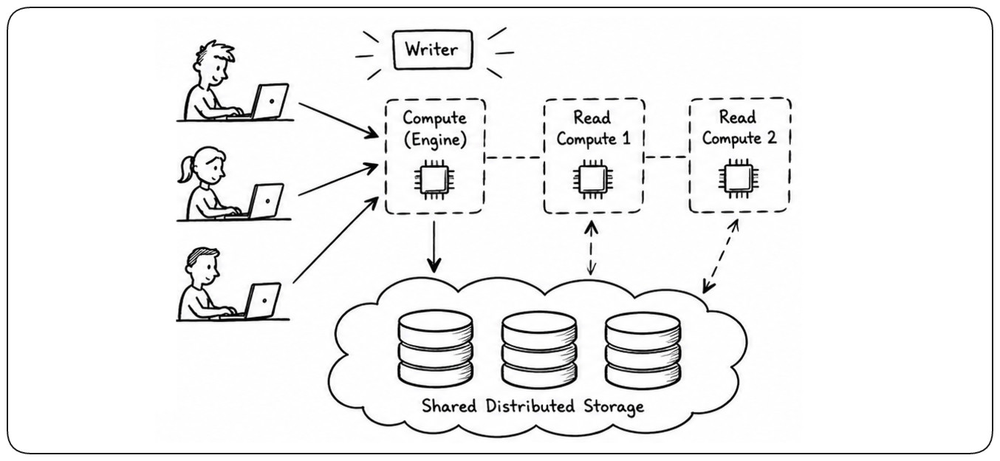
Mettre à l’échelle calcul et stockage indépendamment
Certaines bases SQL modernes, comme Amazon Aurora, séparent le calcul du stockage. Le moteur de base de données s’exécute dans la couche de calcul, tandis que les données persistantes vivent dans une couche de stockage distribuée partagée. !!Le calcul peut être redimensionné ou remplacé sans déplacer tout le jeu de données!!, et plusieurs instances de lecture peuvent utiliser le même stockage sous-jacent — même si elles peuvent encore constater un léger replication lag en appliquant les changements du writer. Aurora utilise toujours un modèle à writer unique : une instance gère les écritures, tandis que des instances supplémentaires font passer les lectures à l’échelle et peuvent prendre le relais lors d’un failover.
Sharding manuel : le SQL à la dure
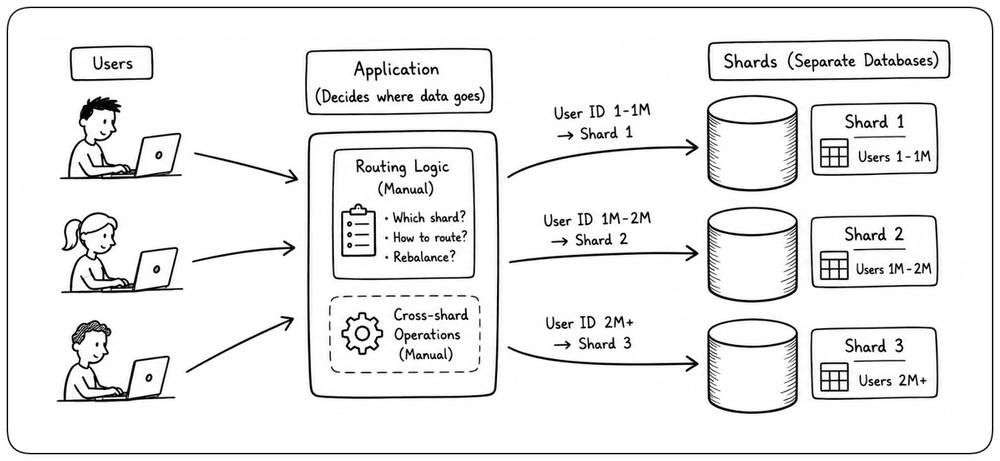
Les bases SQL traditionnelles peuvent passer à l’échelle horizontalement par sharding manuel : l’application décide quelle base possède chaque donnée et route les requêtes en conséquence. Cela supprime la limite de la base unique, mais reporte dans l’application le partitionnement, le routage, le rééquilibrage et les opérations inter-shards. !!Le sharding manuel met la base à l’échelle en déplaçant la complexité des systèmes distribués dans l’application.!!
SQL distribué : le sharding sans renoncer au SQL
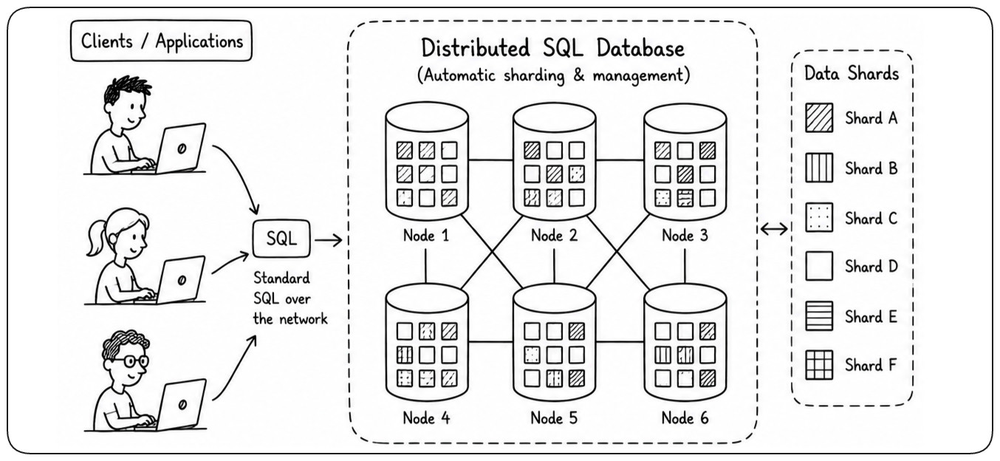
Ces dernières années, les progrès du stockage distribué et de l’infrastructure cloud ont rendu praticable une nouvelle génération de bases SQL. La base répartit les données en shards sur plusieurs nœuds et réplique chaque shard pour la disponibilité. !!Le routage, la réplication et le rééquilibrage sont gérés automatiquement, ce qui permet aux lectures, aux écritures et au stockage de passer à l’échelle horizontalement tout en préservant le SQL et les garanties transactionnelles!!. Cette commodité ne supprime pas le coût de la coordination distribuée ; elle déplace une grande partie de cette complexité à l’intérieur de la base.
Bases NoSQL
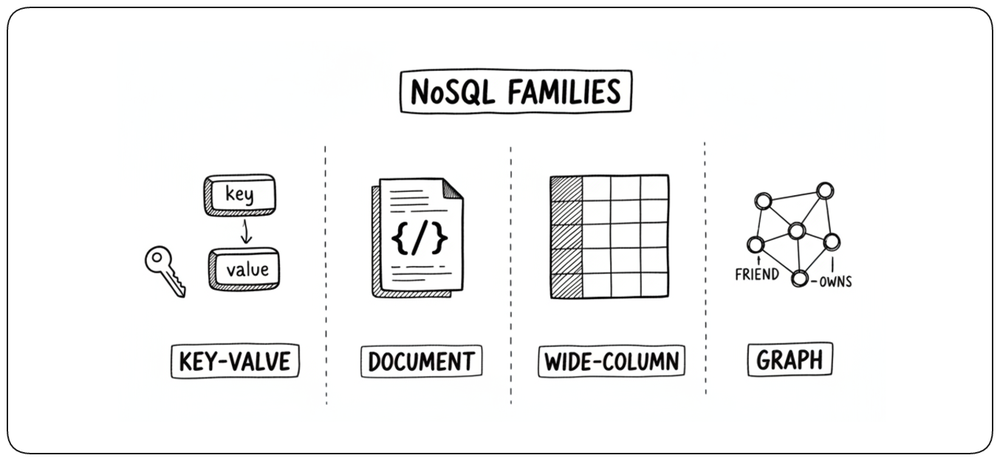
Les bases NoSQL regroupent plusieurs modèles de données, comme key-value, document, wide-column et graphe, conçus autour de différents patterns d’accès. Beaucoup ont été construites avec la distribution comme préoccupation de premier ordre, permettant de répartir données et trafic sur plusieurs nœuds. !!NoSQL n’est pas une architecture unique, mais une famille de modèles de données avec des compromis de scalabilité et de cohérence différents!!.
Choisir le modèle NoSQL
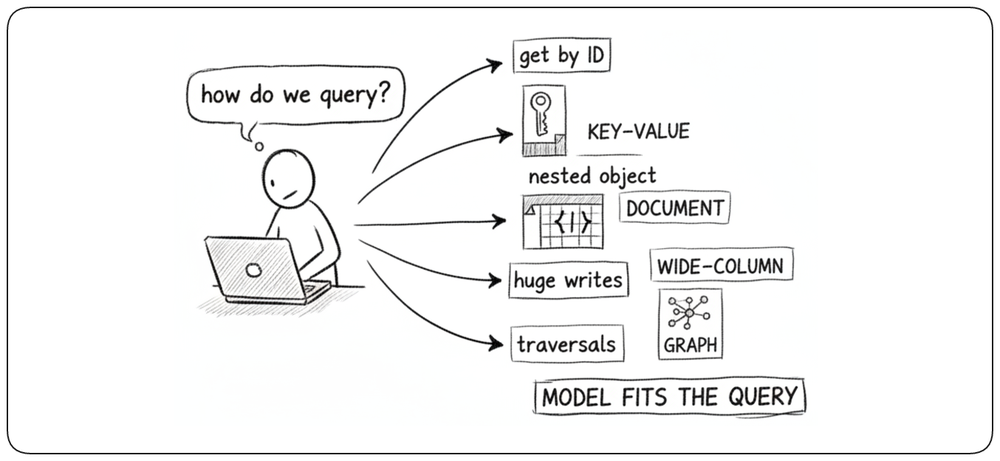
Chaque modèle optimise des patterns d’accès différents. Les key-value stores favorisent la recherche directe par identifiant, les bases documentaires conservent ensemble des objets structurés flexibles, les wide-column stores visent les jeux de données distribués très volumineux et un fort débit d’écriture, tandis que les bases de graphes optimisent les relations et le parcours d’entités connectées. Le bon choix découle généralement de la forme des requêtes que l’application doit servir, et non l’inverse. !!Choisissez le modèle en fonction de la façon dont les données seront accédées!!.
Distribution native
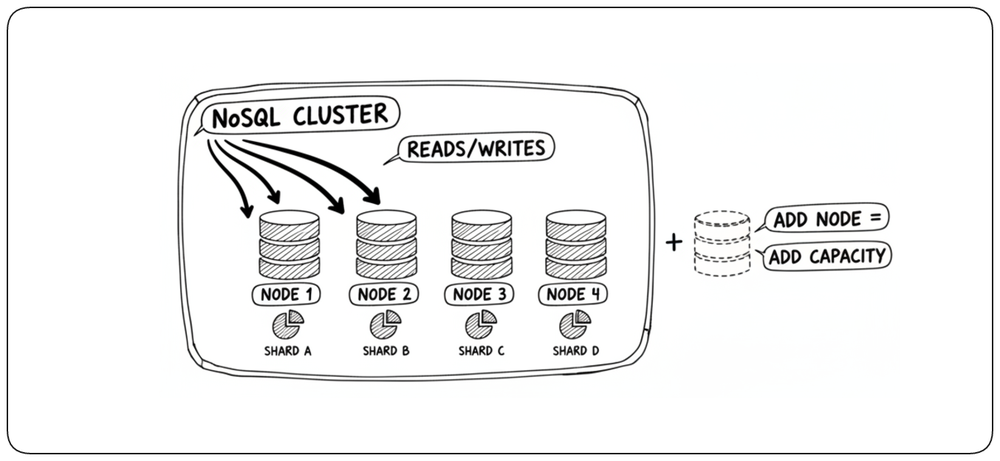
De nombreux systèmes NoSQL sont conçus pour répartir les données sur plusieurs nœuds dès le départ, plutôt que de partir d’un primaire unique. !!Les données sont partitionnées sur le cluster, généralement avec des replicas répartis sur plusieurs nœuds!!, de sorte qu’ajouter des nœuds ajoute en général à la fois du stockage et de la capacité de traitement, tout en donnant à la base davantage d’endroits où répartir la charge. Ce modèle favorise la croissance horizontale, mais cela signifie aussi que la base porte elle-même plus de logique de coordination et de topologie qu’un système mono-nœud traditionnel. !!La distribution horizontale est souvent intégrée à l’architecture même de la base!!.
Réplication et disponibilité
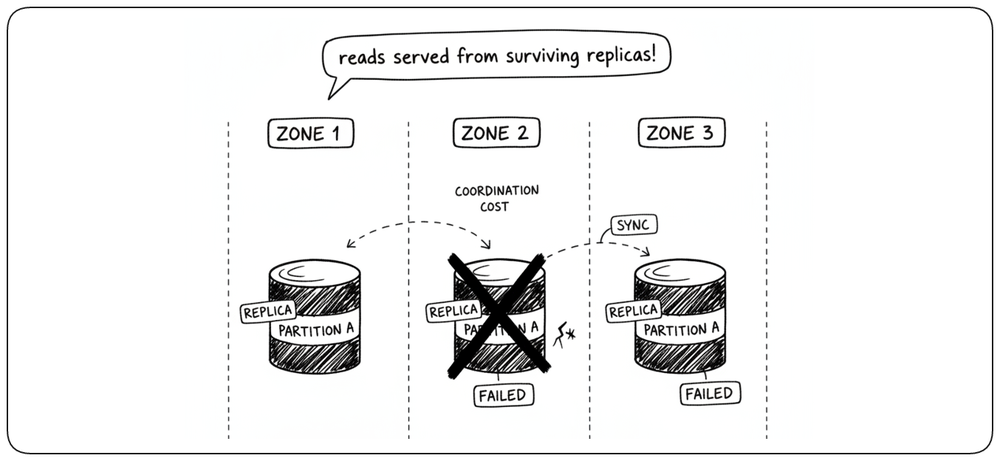
Les bases NoSQL distribuées conservent généralement plusieurs copies de chaque partition sur des nœuds ou des zones afin que le système survive aux défaillances individuelles. Si un nœud ou une zone tombe, un autre replica peut continuer à servir les requêtes sur les mêmes données. Le compromis est que maintenir plusieurs copies alignées demande de la coordination, et que des garanties plus fortes entre replicas coûtent généralement de la latence ou de la disponibilité. !!La réplication garde les données disponibles quand des nœuds tombent, au prix de la coordination!!.
Clés de partition et hotspots
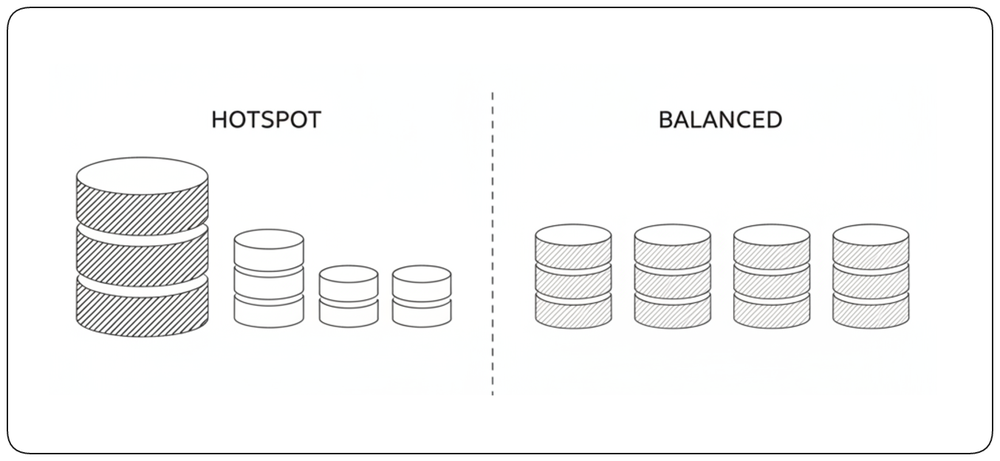
Dans les bases NoSQL distribuées, la clé de partition détermine où vit chaque donnée et quel nœud la sert. Une clé mal choisie concentre le trafic sur quelques nœuds, créant des hotspots où certains replicas sont surchargés pendant que d’autres restent inactifs. Une bonne clé répartit uniformément le stockage et la charge, tout en gardant les données liées assez proches pour des requêtes efficaces. !!La clé de partition est l’une des décisions de scalabilité les plus importantes d’une base de données distribuée!!.
Plateformes de données analytiques
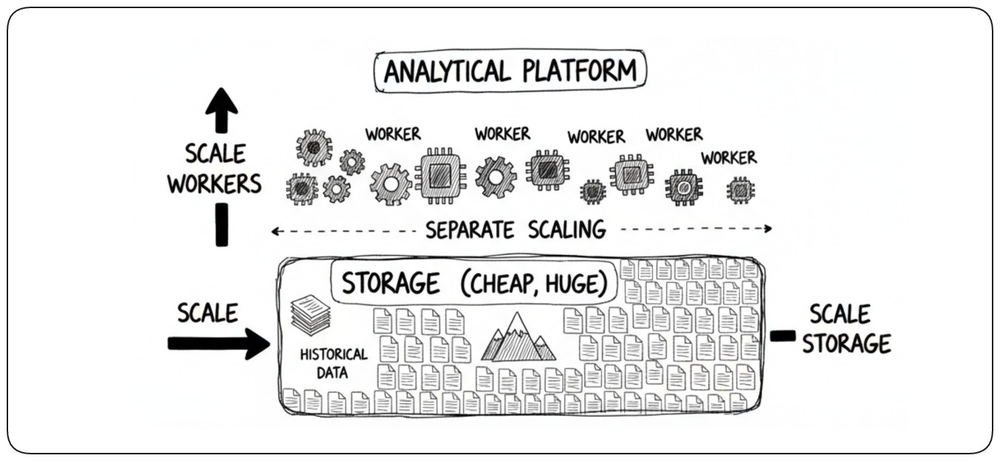
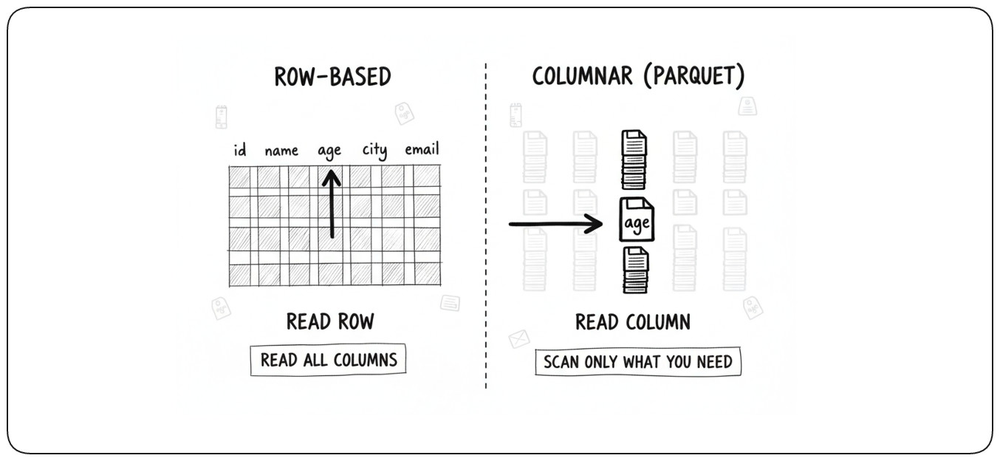
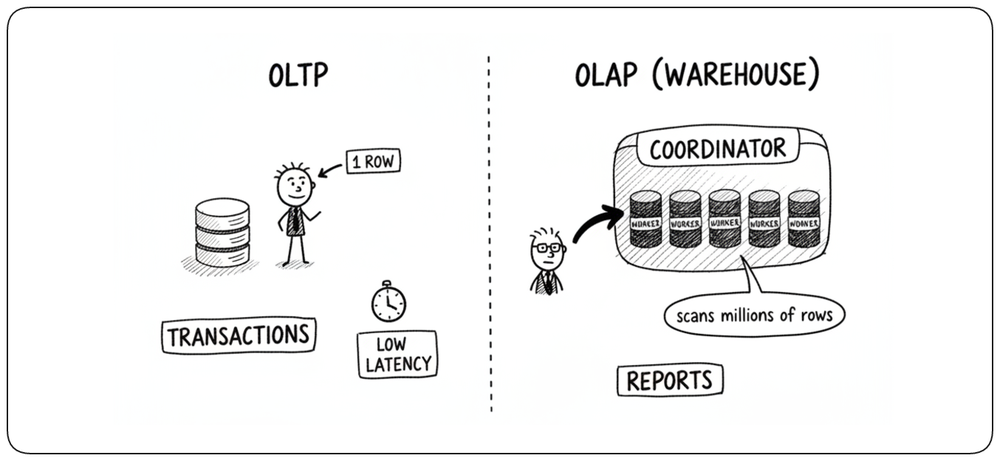
Les plateformes de données analytiques sont conçues pour les gros scans, les agrégations, le reporting et le traitement hors ligne plutôt que pour des lectures et écritures transactionnelles à faible latence. Leurs problèmes de scalabilité sont différents : elles doivent stocker à bas coût de grands jeux de données historiques, ne lire que les colonnes nécessaires à une requête, et ajouter de la capacité de calcul pour les traitements analytiques lourds. !!La scalabilité analytique tient davantage au volume, à l’efficacité des scans et au traitement élastique qu’au débit d’écriture transactionnel!!.
Stockage objet et fichiers en colonnes
Les grands jeux de données analytiques sont souvent stockés dans un stockage objet, dans des formats de fichiers en colonnes comme Parquet. Le stockage objet offre une capacité durable à faible coût, tandis que les fichiers en colonnes permettent aux moteurs de requête de ne lire que les colonnes et partitions nécessaires à une charge. Le stockage passe ainsi à l’échelle indépendamment des systèmes qui traitent les données. !!Un data lake sépare le stockage durable des moteurs qui l’analysent!!.
Partitionnement et pruning
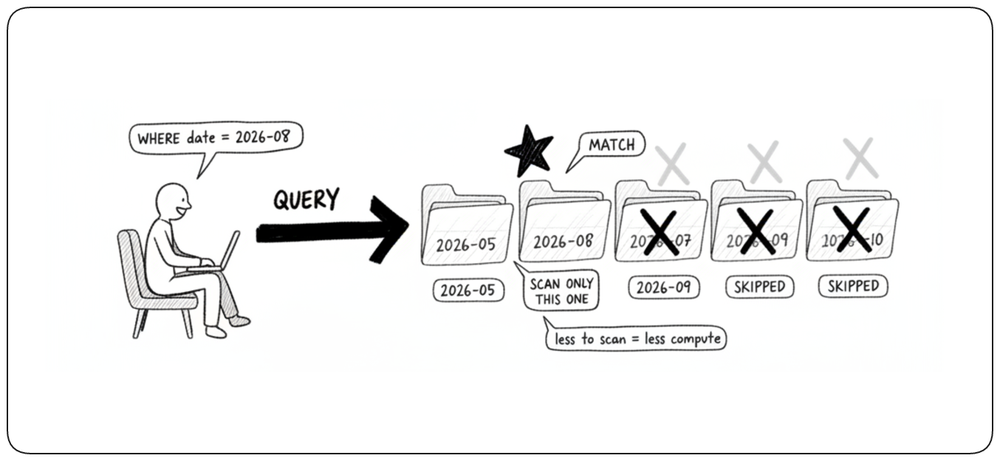
Les systèmes analytiques organisent souvent les grands jeux de données par date, tenant, région ou une autre clé de partition adaptée aux requêtes. Quand une requête filtre sur cette clé, le moteur peut ignorer des fichiers ou partitions entiers au lieu de tout scanner. Cela ne rend pas seulement les requêtes plus rapides ; cela réduit la quantité de calcul nécessaire à mesure que le volume de données croît. !!L’analytique passe mieux à l’échelle quand les requêtes peuvent élaguer les données avant de les scanner!!.
Bases de données analytiques
Les bases de données analytiques organisent les données pour les scans, les jointures, les agrégations et le reporting sur de grands jeux de données. Elles utilisent souvent un stockage en colonnes, la compression, l’exécution distribuée et des query planners optimisés pour le débit plutôt que pour la latence d’une seule ligne. Ces systèmes peuvent encore exposer du SQL, mais leur objectif de scalabilité est le traitement analytique, pas le service des écritures transactionnelles d’une application. !!Les bases analytiques font passer à l’échelle les requêtes complexes sur de grands jeux de données!!.
Exécution de requêtes élastique
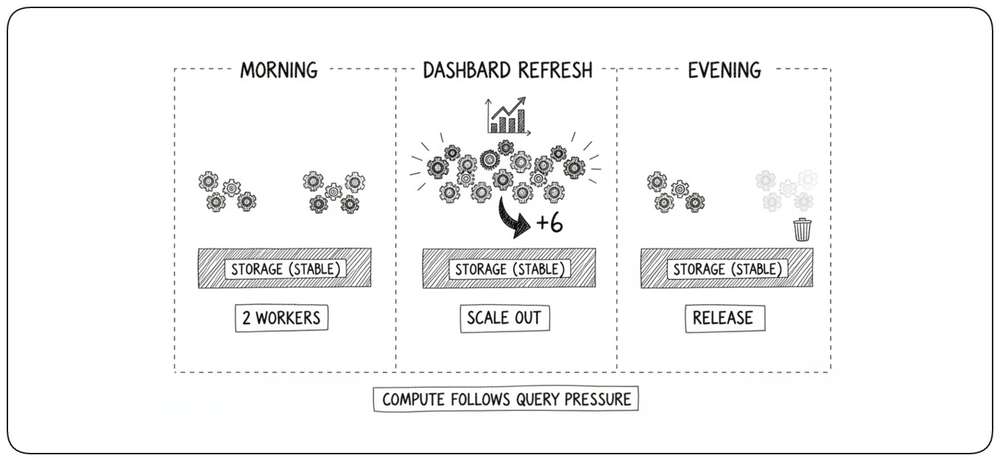
Les charges analytiques sont souvent par rafales : un gros rapport, un rafraîchissement de dashboard ou un job batch peut nécessiter bien plus de calcul pendant une courte période. L’exécution de requêtes élastique permet à la plateforme d’ajouter des workers pour les scans et agrégations lourds, puis de les libérer quand la charge retombe. Le stockage reste durable tandis que la capacité de calcul suit la demande. !!Le calcul analytique doit s’adapter à la pression des requêtes, pas à la taille des données stockées!!.
Cohérence distribuée
Distribuer les données résout un problème de scalabilité mais en crée un autre : la coordination. Une fois l’état partitionné ou répliqué sur plusieurs machines, les nœuds doivent s’accorder — ou parfois être temporairement en désaccord — sur l’état courant. Plus l’état est largement distribué, plus le système doit arbitrer entre cohérence, disponibilité et coût de coordination.
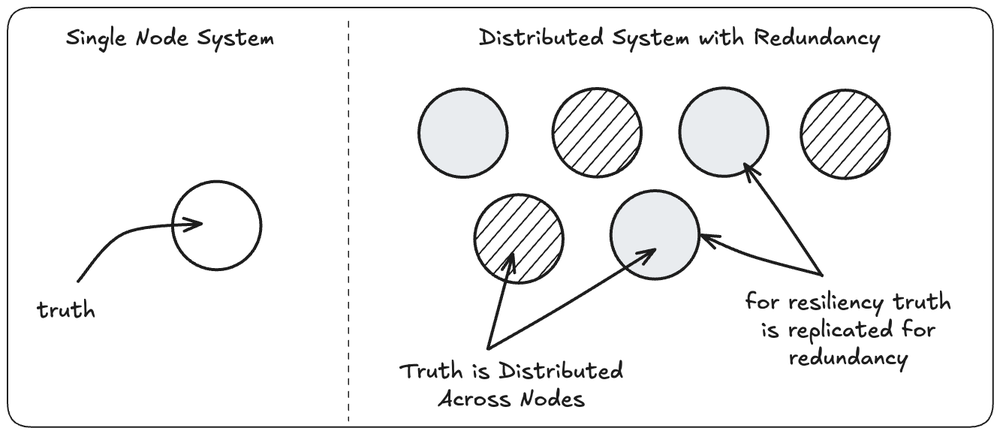
Le problème de la distribution de la vérité
Dans un système simple, toute la « vérité » réside dans un seul nœud. Ce montage fonctionne bien à petite échelle, en centralisant la gestion des données et en minimisant les délais de synchronisation. Mais passer à l’échelle, c’est passer d’un système mono-nœud à un système multi-nœuds où la vérité est distribuée entre les nœuds. Pour assurer la résilience en cas de panne, on ajoute de la redondance : si un nœud tombe, les autres nœuds peuvent toujours garder l’accès à la vérité. La duplication de l’état permet la tolérance aux pannes, mais elle introduit aussi de la complexité. Le besoin de distribuer la vérité est à la fois une force et une faiblesse : la force réside dans la réplication et la protection des données, la faiblesse vient des difficultés de synchronisation.
Le théorème CAP
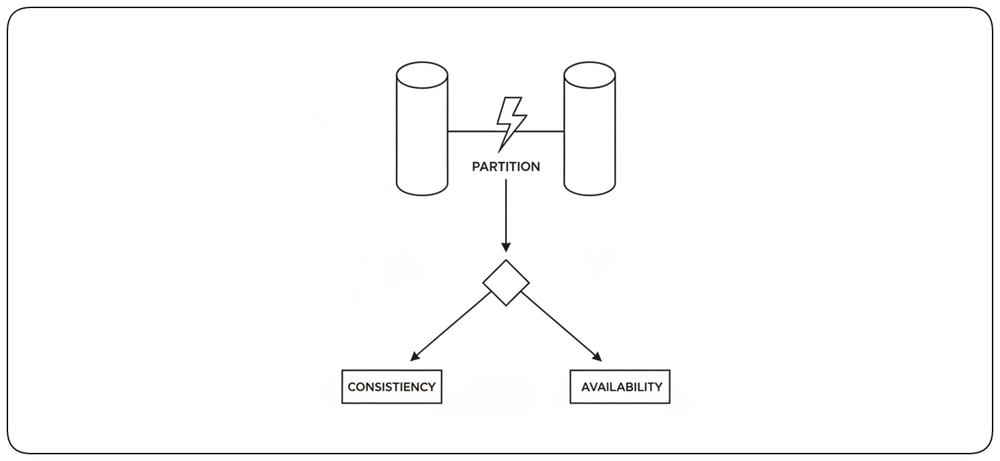
Le théorème CAP explique ce qui se passe quand un système distribué est coupé en deux par une défaillance réseau. Pendant cette partition, le système doit choisir entre !!la cohérence — tous les nœuds s’accordent sur les dernières données — et la disponibilité — chaque requête reçoit toujours une réponse!!. Comme les partitions réseau ne peuvent pas être totalement évitées dans un système distribué, ce compromis est inévitable en pratique : certains systèmes privilégient la cohérence et refusent de servir les requêtes auxquelles ils ne peuvent pas répondre correctement, d’autres privilégient la disponibilité et acceptent une divergence temporaire. CAP est donc !!un compromis entre cohérence et disponibilité pendant une partition!! — les soldes de comptes bancaires exigent généralement de la cohérence, tandis que les fils d’actualité des réseaux sociaux tolèrent une obsolescence temporaire.
Systèmes à cohérence éventuelle
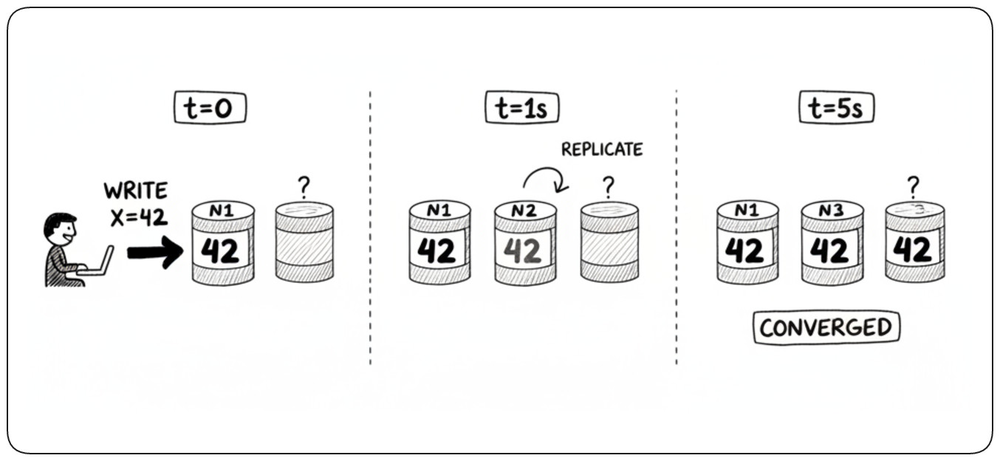
Chaque mise à jour d’état exige une coordination entre les nœuds, ce qui prend du temps — surtout en cas d’écritures lentes, de pannes de nœuds ou de problèmes réseau. C’est là qu’émerge la cohérence éventuelle. Les données ne sont pas synchronisées instantanément entre les nœuds mais finiront par devenir cohérentes, assurant une cohérence globale dans le temps malgré d’éventuels retards et défaillances. Les systèmes à cohérence éventuelle échangent la cohérence immédiate contre la disponibilité et la tolérance au partitionnement. Quand un utilisateur écrit des données, elles peuvent ne pas être immédiatement visibles de tous les lecteurs. Mais avec assez de temps sans nouvelle mise à jour, tous les replicas convergeront vers le même état. Ce modèle convient bien à de nombreuses applications pour lesquelles une cohérence parfaite compte moins que la disponibilité et la réactivité.
Lire ses propres écritures
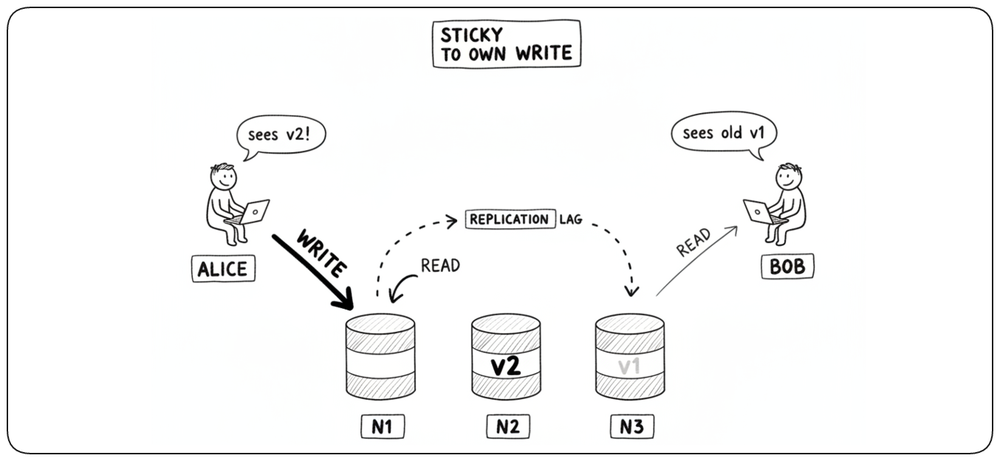
Dans un système à cohérence éventuelle, un utilisateur peut lire des données obsolètes juste après avoir fait un changement, parce que la mise à jour n’a pas encore atteint tous les replicas. RYOW (Read Your Own Writes) l’empêche : !!après une écriture réussie, le même utilisateur doit voir cette écriture — ou une valeur plus récente — à la lecture suivante!!. Le système peut l’implémenter de différentes façons — en routant la lecture vers un replica à jour, en suivant les versions que l’utilisateur a déjà vues, ou en utilisant des timestamps pour choisir un replica. D’autres utilisateurs peuvent encore voir des données plus anciennes sur d’autres replicas, mais chaque utilisateur a une expérience cohérente avec ses propres changements.
La cohérence, un coût de la croissance
Distribuer les données augmente la capacité et la résilience, mais introduit aussi un coût de coordination, des fenêtres d’obsolescence et de la complexité opérationnelle. L’objectif architectural n’est pas de « maximiser la cohérence », mais de !!choisir des garanties adaptées au risque métier!! — les mouvements d’argent et l’exactitude des stocks exigent souvent des garanties plus fortes, tandis que les fils d’actualité, l’analytique et les recommandations tolèrent souvent l’obsolescence. Gardez le principe à haut niveau : !!chaque fois que vous distribuez la vérité, vous achetez un problème de coordination permanent!!. Ne dépensez cette complexité que lorsque l’échelle l’exige.
Styles d’architecture pour la scalabilité
La cohérence des données détermine comment se comportent les données distribuées. Mais la scalabilité dépend aussi de la façon dont l’application elle-même est structurée. Plusieurs styles d’architecture facilitent la distribution du travail, l’isolation de la croissance et la mise à l’échelle indépendante des différentes parties du système.
La scalabilité ne dépend pas d’une architecture précise, mais certains styles architecturaux s’y prêtent particulièrement bien. Ils créent des frontières qui facilitent la distribution du travail, la réplication des composants, l’isolation des goulots d’étranglement et la mise à l’échelle indépendante des différentes parties d’un système. Les microservices, les architectures événementielles et le serverless en sont des exemples courants. Ils ne rendent pas un système scalable à eux seuls, mais ils fournissent des fondations architecturales qui rendent la mise à l’échelle plus facile à implémenter et à faire évoluer.
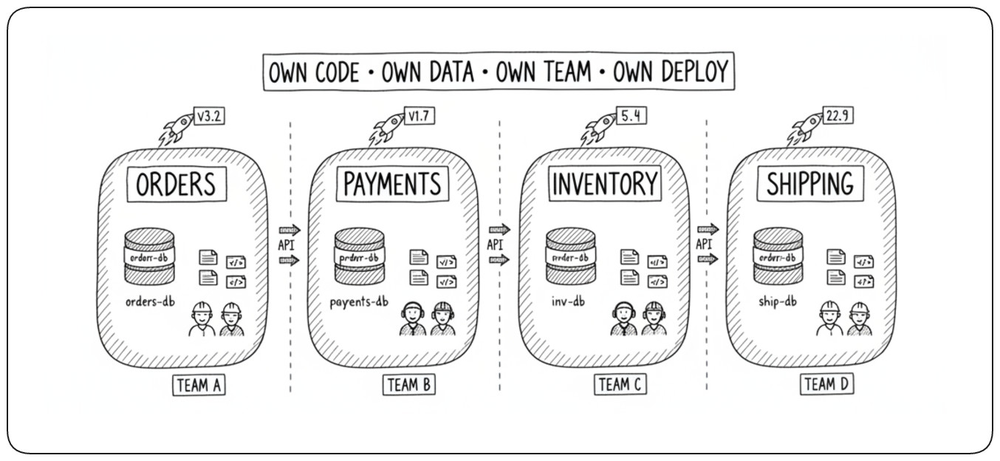
Microservices : bounded context et ownership
Les microservices décomposent l’application en !!services déployables indépendamment, chacun aligné sur un bounded context!! — une capacité métier distincte avec ses propres données, son propre langage et ses propres règles. Le bénéfice en scalabilité est réel mais secondaire ; le bénéfice principal est !!l’ownership et le cycle de vie indépendant!!. Chaque service a une équipe responsable unique qui peut déployer à son propre rythme, faire évoluer sa conception interne sans se coordonner avec le reste de l’organisation et assumer sa fiabilité. Les services communiquent via des API bien définies, ce qui garde les changements locaux. Cette indépendance — du code, des données, du déploiement et de l’équipe — est ce qui rend l’architecture durable à grande échelle ; la scalabilité horizontale de chaque service en est la conséquence naturelle, pas la motivation.
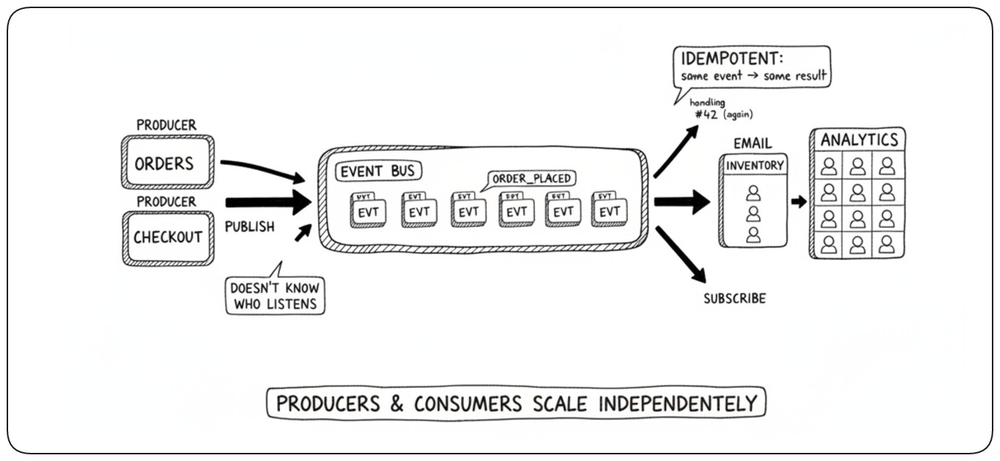
Événementiel : connecter les systèmes de façon lâche
L’architecture événementielle sépare les producteurs des consommateurs dans l’espace comme dans le temps. Un publisher émet un événement quand quelque chose d’intéressant se produit ; un ou plusieurs subscribers réagissent, sans que le publisher sache qu’ils existent. Cela signifie que !!les producteurs peuvent générer du travail sans savoir quel consommateur le traitera, tandis que les consommateurs peuvent passer à l’échelle selon leur propre charge!! — les différentes parties du système peuvent fonctionner et évoluer à des rythmes différents, les files ou flux d’événements absorbant les écarts temporaires de capacité. Les systèmes événementiels doivent aussi gérer les livraisons en double de façon sûre. !!La déduplication détecte si un événement donné a déjà été traité, tandis que l’idempotence garantit que traiter plusieurs fois la même opération a le même effet que la traiter une seule fois!!. Ces techniques sont complémentaires : la déduplication évite le traitement répété, tandis que l’idempotence rend le traitement répété sans danger.
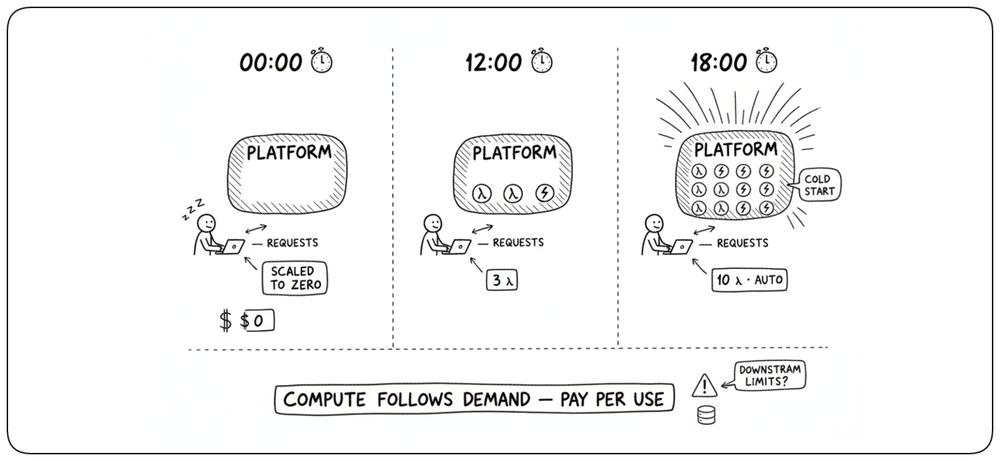
Architecture serverless
Le serverless !!pousse l’élasticité dans la plateforme d’exécution elle-même!!. Au lieu de gérer un pool fixe de workers, des fonctions ou services sont instanciés à la demande selon la charge, et certains services peuvent descendre à zéro quand ils sont inactifs, souvent avec une tarification à la consommation. Cela rend le serverless particulièrement adapté aux charges variables et événementielles (backends d’API, traitement de fichiers, webhooks). Mais !!le scaling automatique du calcul ne rend pas automatiquement tout le système scalable!!: les limites en aval, les cold starts, les limites de concurrence et le coût comptent toujours.
Mise à l’échelle clients
Quand les plateformes grandissent au-delà d’un seul client, une autre dimension de scalabilité apparaît : servir efficacement de nombreux tenants tout en les gardant isolés.
Going further: multi-tenancy
Isolation models, tenant identification, database strategies, and multi-tenant security are covered in depth in the Multitenancy Models section of the Design for Cloud chapter.
Stratégies d’isolation des tenants
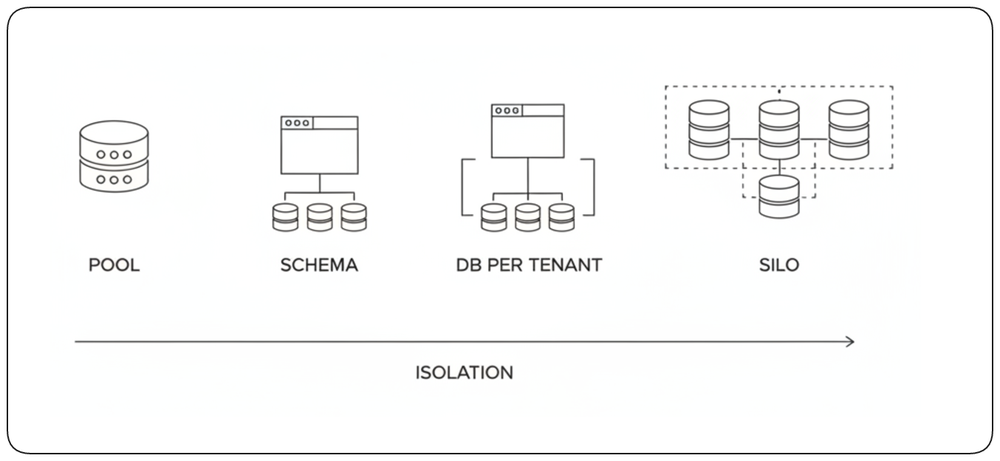
Les systèmes multi-tenant se situent sur un !!spectre d’isolation!!. À une extrémité, tous les tenants partagent tout — même base de données, même schéma, mêmes instances applicatives — ce qui maximise l’efficacité mais exige une sécurité rigoureuse pour éviter les fuites. À l’autre extrémité, chaque tenant dispose de ressources dédiées, ce qui maximise l’isolation mais sacrifie l’efficacité de l’infrastructure partagée. Entre les deux : des instances partagées avec des schémas séparés, ou des schémas partagés avec sécurité au niveau des lignes. Le bon point sur le spectre dépend de la sécurité, de la conformité et de l’économie unitaire.
Le problème du voisin bruyant
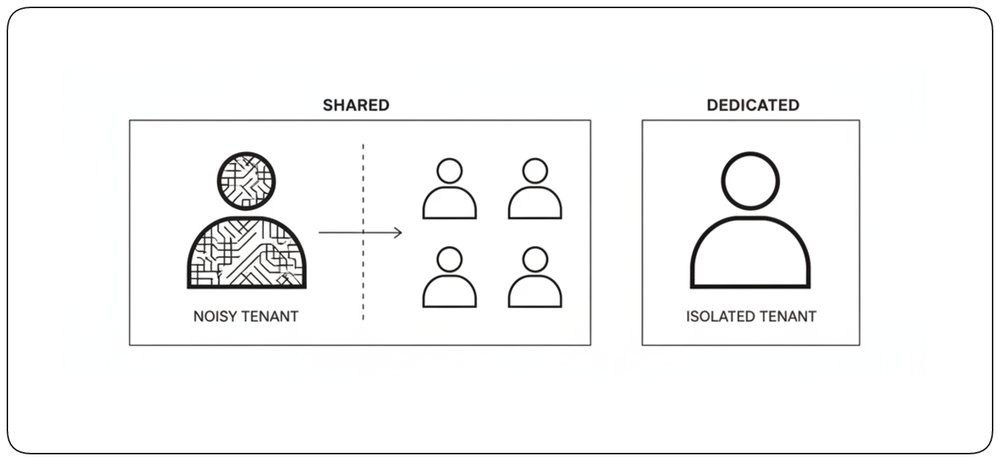
La consommation de ressources varie énormément d’un tenant à l’autre — !!un tenant peut générer 50 % de la charge en ne représentant que 5 % du chiffre d’affaires!!. Une mise à l’échelle multi-tenant efficace exige des contrôles par tenant : rate limiting par tenant, détection des voisins bruyants et isolation graduée qui fait passer les gros tenants sur une infrastructure dédiée. L’objectif est de !!empêcher l’usage d’un tenant de dégrader l’expérience de tous les autres!! tout en profitant de l’efficacité de l’infrastructure partagée.
Mise à l’échelle de l’organisation
La mise à l’échelle s’applique aussi aux organisations. À mesure qu’une entreprise grandit, ajouter des ingénieurs n’augmente pas automatiquement la capacité de livraison : la communication, les dépendances et la coordination croissent aussi. La mise à l’échelle de l’organisation consiste à augmenter la capacité d’une organisation sans que la coordination croisse au même rythme.
Vision partagée : le prérequis à l’échelle
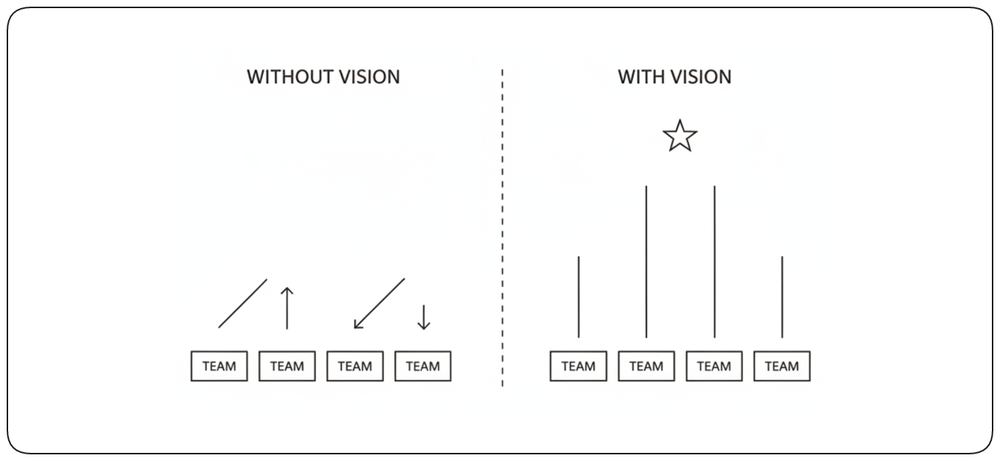
Une organisation en croissance a besoin avant tout d’une chose : une vision partagée. Sans elle, chaque équipe optimise son propre objectif local, les décisions sont rediscutées à chaque niveau et le coût de coordination explose. !!Une vision partagée est ce qui permet à des équipes indépendantes de prendre des décisions alignées sans approbation centrale — c’est le mécanisme invisible qui fait passer tout le reste à l’échelle!!.
Plateformes : faire passer les équipes à l’échelle par le self-service
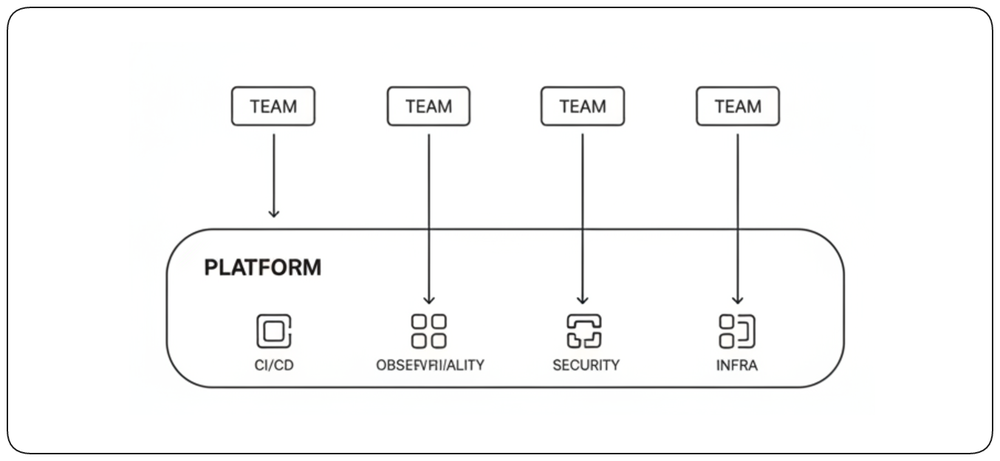
À mesure qu’une organisation grandit, les équipes ne devraient pas résoudre sans cesse les mêmes problèmes d’infrastructure, de déploiement, de sécurité et d’exploitation. Une plateforme partagée transforme ces besoins communs en capacités self-service réutilisables, permettant aux équipes d’aller plus vite sans dépendre d’un groupe central pour chaque changement. !!Les plateformes font passer la capacité d’ingénierie à l’échelle en réduisant le travail répété et la coordination entre équipes!!.
Going further: platforms
Platform design, self-service capabilities, and the developer-experience mindset are covered in depth in the Designing Developer-Centric Platforms chapter.
Frontières d’équipe : passer à l’échelle par l’ownership
Ajouter des ingénieurs n’augmente pas automatiquement la capacité de livraison. À mesure que les équipes grandissent, des responsabilités floues et une coordination inter-équipes constante peuvent devenir le nouveau goulot d’étranglement. Une ownership claire, des frontières bien définies et des interfaces stables permettent aux équipes de travailler indépendamment. !!Mettre les équipes à l’échelle, c’est augmenter la capacité de l’organisation sans augmenter la coordination au même rythme!!.
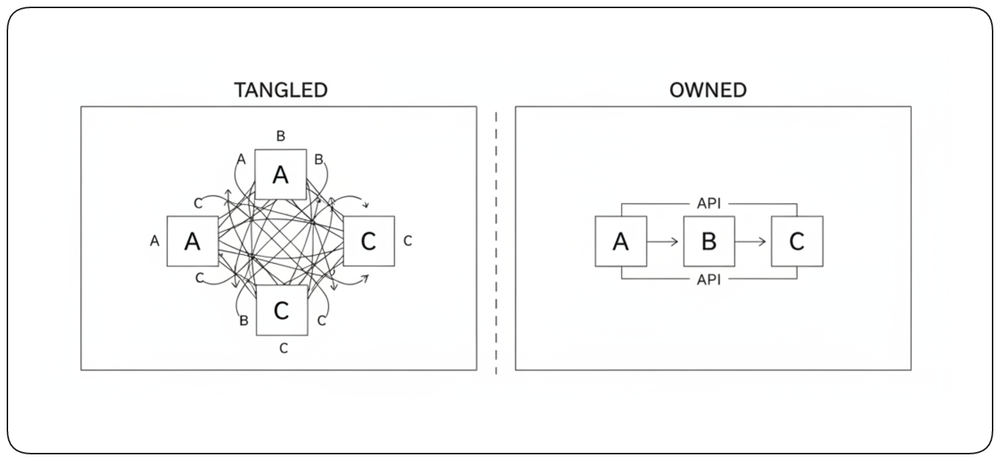
Anti-patterns
Toute conception qui paraît scalable ne l’est pas forcément. Certains choix détruisent la scalabilité aussi sûrement que les bons patterns la permettent. Chaque anti-pattern ci-dessous a un trait commun : !!il crée un point de coordination ou de couplage qui doit être franchi à chaque opération!!, et aucune scalabilité horizontale ne le soulage.
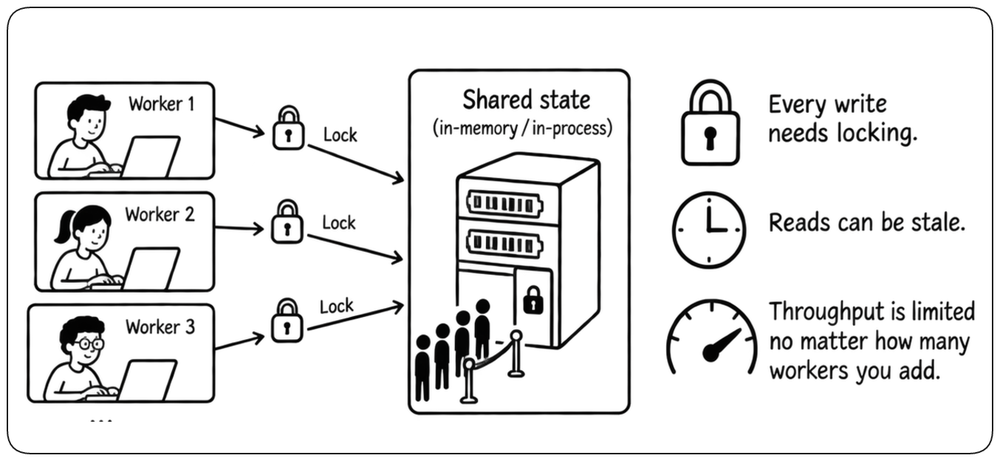
État mutable partagé
Quand plusieurs workers partagent le même état, ils doivent coordonner chaque changement. À mesure que l’on ajoute des workers, cet état partagé devient un goulot d’étranglement et limite la scalabilité. !!Gardez les workers sans état et stockez l’état partagé dans une base de données, un cache ou une file conçus pour l’accès concurrent!!.
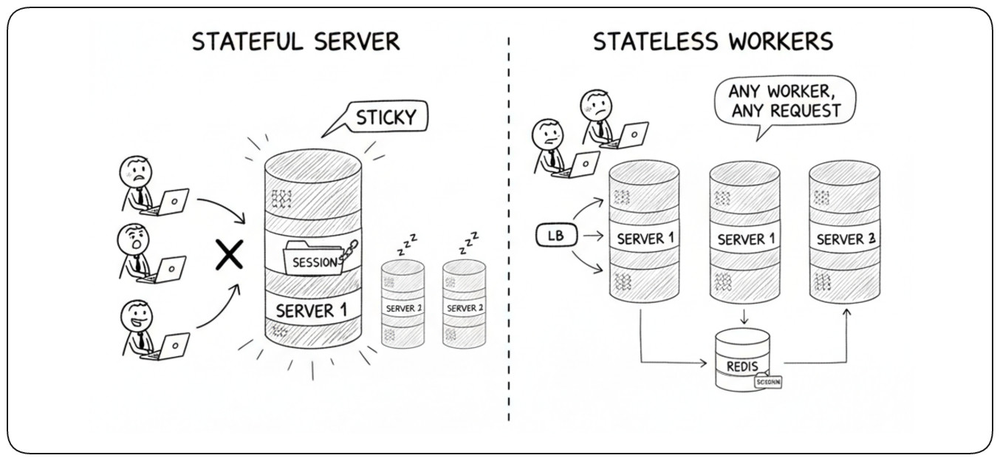
Serveurs avec état
Garder l’état applicatif à l’intérieur d’un serveur rend ce serveur spécial : les requêtes futures peuvent devoir revenir sur la même instance, les instances défaillantes peuvent perdre leur état, et la mise à l’échelle devient plus difficile car les workers ne sont plus interchangeables. !!Les sticky sessions sont un symptôme courant de cette conception!! — elles ramènent l’utilisateur vers le serveur qui détient déjà son état, mais ne suppriment pas le couplage sous-jacent. Les systèmes scalables gardent des workers sans état et déplacent l’état durable vers des systèmes partagés afin que n’importe quelle instance puisse traiter n’importe quelle requête.
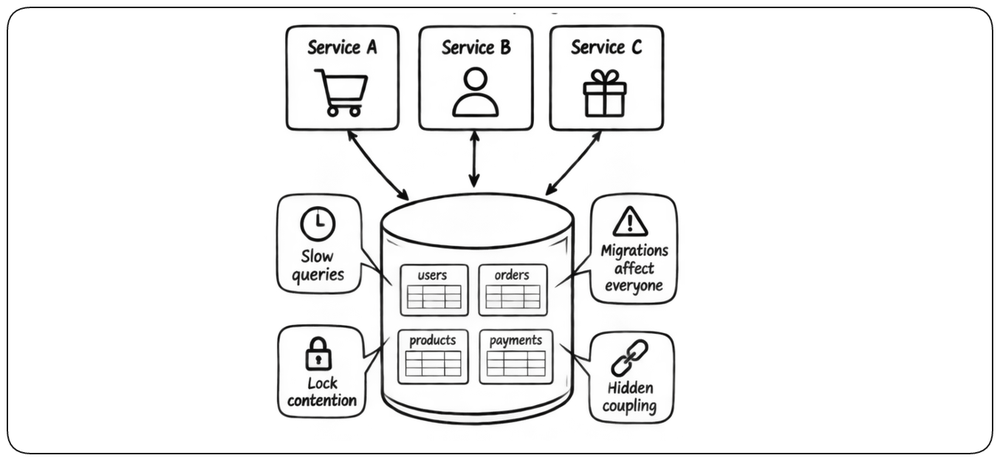
La base de données partagée
Quand plusieurs services lisent et écrivent tous dans le même schéma de base de données, la base devient un point de couplage caché : !!chaque service est affecté par les requêtes, les migrations et la contention de verrous de tous les autres!!. Ce qui ressemble à des microservices est en réalité un monolithe distribué. Chaque service doit posséder ses données ; les lectures inter-services passent par des API ou des événements, pas par du SQL partagé.
Pour aller plus loin
Martin Fowler décrit ce pattern dans Integration Database.
Services bavards et chaînes synchrones
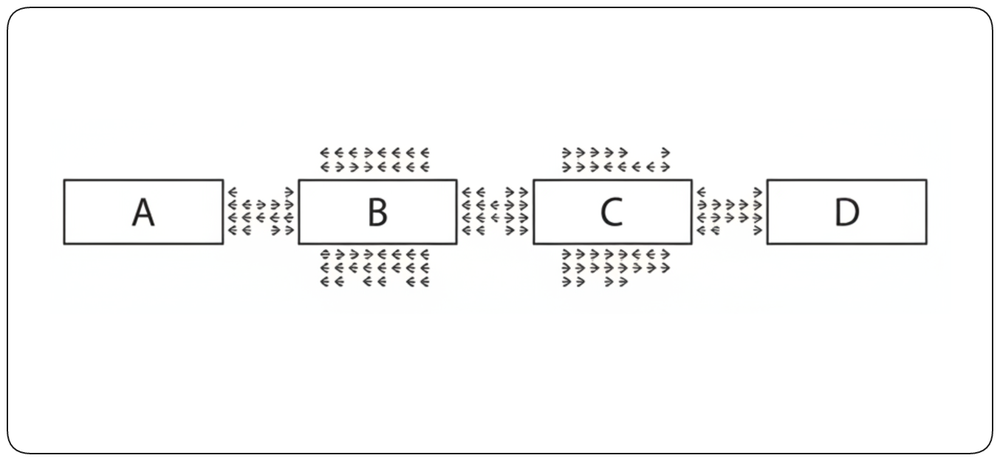
Quand le service A appelle B de façon synchrone, qui appelle C, qui appelle D, !!la latence se cumule et les défaillances se propagent en cascade!!. Une seule requête utilisateur devient dix allers-retours réseau ; un service lent dégrade tous ses appelants en amont. Les remèdes : regrouper les opérations pour réduire les allers-retours, mettre en cache de façon agressive, briser les chaînes avec de la messagerie asynchrone, et utiliser des circuit breakers pour échouer vite plutôt que de rester bloqué sur une dépendance malade.
Retry storms
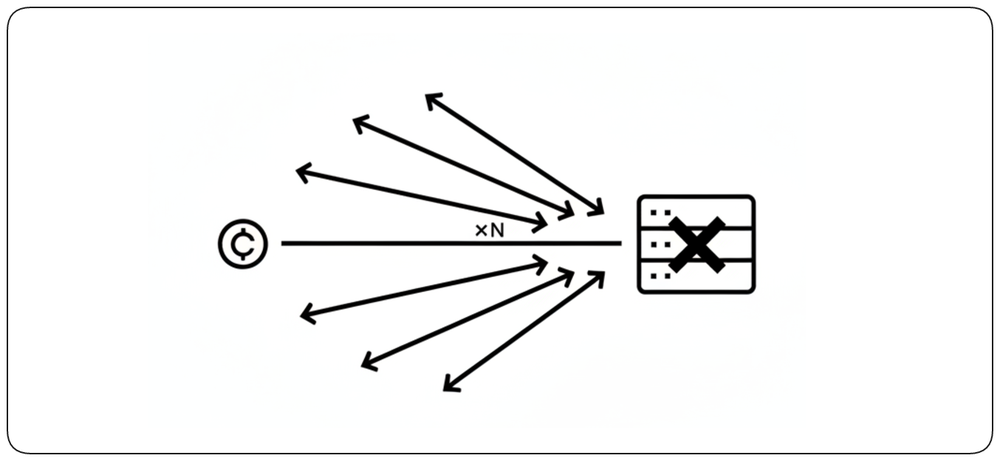
Quand un service en aval se met à échouer, les clients naïfs réessayent immédiatement — et !!les retries amplifient la charge précisément quand l’aval est le moins capable de la supporter!!, transformant un bref incident en panne complète. Chaque politique de retry a besoin d’un !!exponential backoff avec jitter!!, d’un budget de retries strict et d’un circuit breaker qui coupe les appels une fois le taux d’échec au-dessus d’un seuil. Des retries sans backpressure sont une attaque par déni de service que vous lancez contre vous-même.
Transactions distribuées
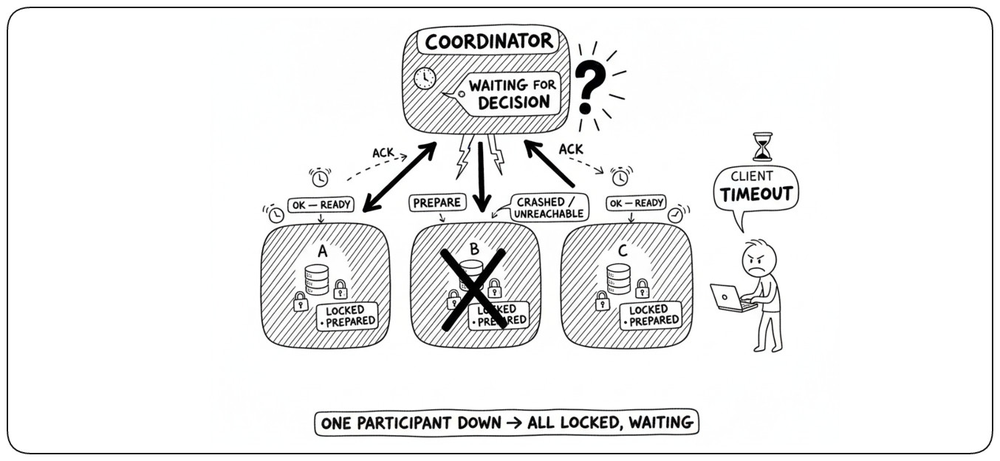
Les transactions distribuées exigent que plusieurs services ou bases de données s’accordent avant qu’un changement puisse aboutir. !!Cette coordination ajoute de la latence et crée des cas de défaillance où un participant peut rester à attendre les autres!! — un mode de défaillance bloquant bien connu du two-phase commit. Préférez, quand c’est possible, les transactions locales, les sagas (actions compensatoires) et les opérations idempotentes. Si un flux métier exige de façon répétée des mises à jour atomiques sur plusieurs services, remettez d’abord en question la frontière du service — elle est peut-être tracée au mauvais endroit.
Verrous distribués
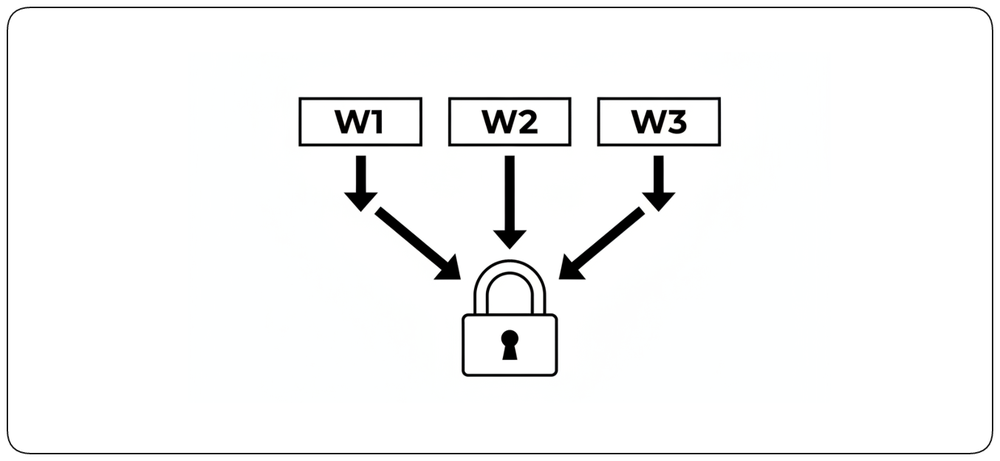
Les verrous distribués ont l’air d’une solution propre aux mises à jour concurrentes, mais ils sont !!un point de contention unique déguisé en système distribué!!. Les services de verrous deviennent le goulot d’étranglement ; les leases expirent lors de pauses du GC et produisent du split-brain ; les modes de défaillance sont subtils. Préférez la concurrence optimiste (vérification de version à l’écriture), l’event sourcing (log en append-only) ou les partitions à writer unique où un worker possède une tranche de l’espace de clés et où aucun verrou n’est nécessaire.
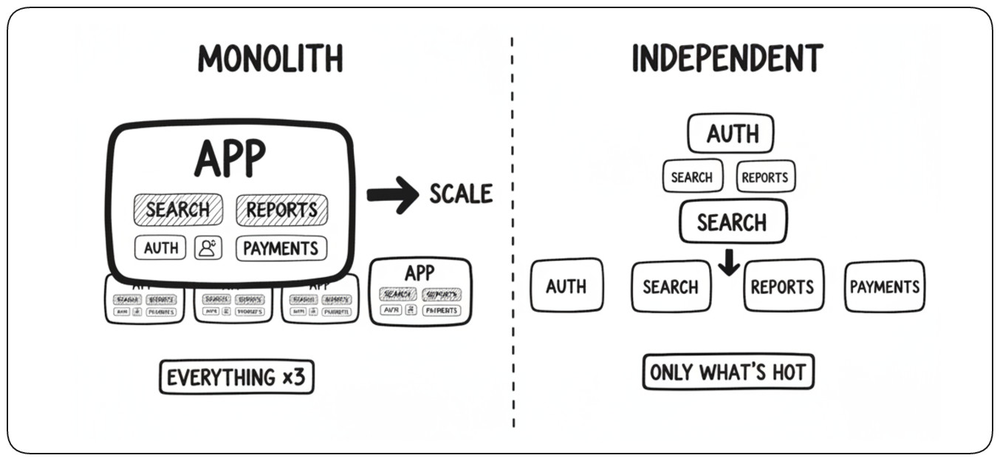
Tout mettre à l’échelle ensemble
Quand un système ne peut être mis à l’échelle que comme une seule unité, chaque composant chaud entraîne les froids avec lui. Doubler la flotte pour soulager un endpoint lourd double la mémoire, le disque et le coût de tout le reste. !!Les systèmes scalables sont faits de pièces qui peuvent être mises à l’échelle indépendamment!! — par service, par charge de travail, par partition de données — afin que la capacité puisse être ajoutée exactement là où se trouve la pression.
L’autoscaling comme remède universel
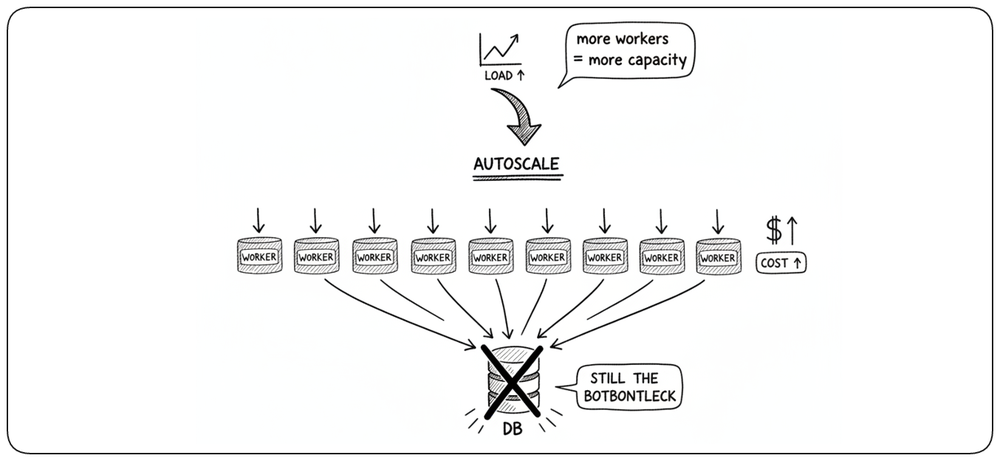
L’autoscaling semble être la réponse à tous les problèmes de capacité : ajouter des nœuds quand la charge monte, les retirer quand elle baisse. En pratique, il ne soulage que les ressources qu’il peut faire croître — essentiellement des workers sans état. Il ne peut pas sauver une base de données saturée, une ressource partagée verrouillée, une partition chaude ou un service en aval qui ne peut lui-même pas passer à l’échelle. Pire, il peut !!masquer le vrai goulot d’étranglement en absorbant les symptômes avec toujours plus d’instances jusqu’à ce que le coût explose!!. L’autoscaling est un outil pour le calcul élastique, pas un substitut à l’identification et à la levée de la vraie contrainte.
À retenir
La scalabilité, c’est la reproductibilité
Un système scalable est construit à partir d’unités qui peuvent être répliquées, distribuées ou partitionnées sans redessiner tout le système. !!Les workers sans état rendent le calcul reproductible, les frontières modulaires rendent les composants scalables indépendamment, les files découplent les rythmes de travail, le partitionnement distribue les données, l’automatisation supprime les goulots d’étranglement humains, et la protection contre la surcharge garde le système stable quand la capacité est dépassée!!. Au fond, la mise à l’échelle ne consiste pas à agrandir les machines — il s’agit de !!rendre la croissance reproductible!!.