Concevoir pour la confiance
Chapter Info
Calculating... Writing Progress: 80%
La confiance, c’est la certitude qu’une requête est légitime. Un système ne fait confiance à une requête que s’il peut vérifier qui l’émet, ce que cette identité est autorisée à faire, et si ces affirmations sont toujours valides. !!Les systèmes modernes ne tirent plus cette certitude de la localisation réseau ni des secrets partagés.!! La confiance doit au contraire être établie explicitement, vérifiée cryptographiquement dans la mesure du possible, limitée en portée et dans le temps, et réévaluée en continu.
Ce chapitre explique comment les systèmes modernes construisent cette confiance : par l’authentification, l’autorisation, l’identité cryptographique, l’IAM cloud, les protocoles d’identité ouverts, la gestion des secrets et, au final, le Zero Trust.
Introduction
L’ancien modèle : faire confiance au périmètre
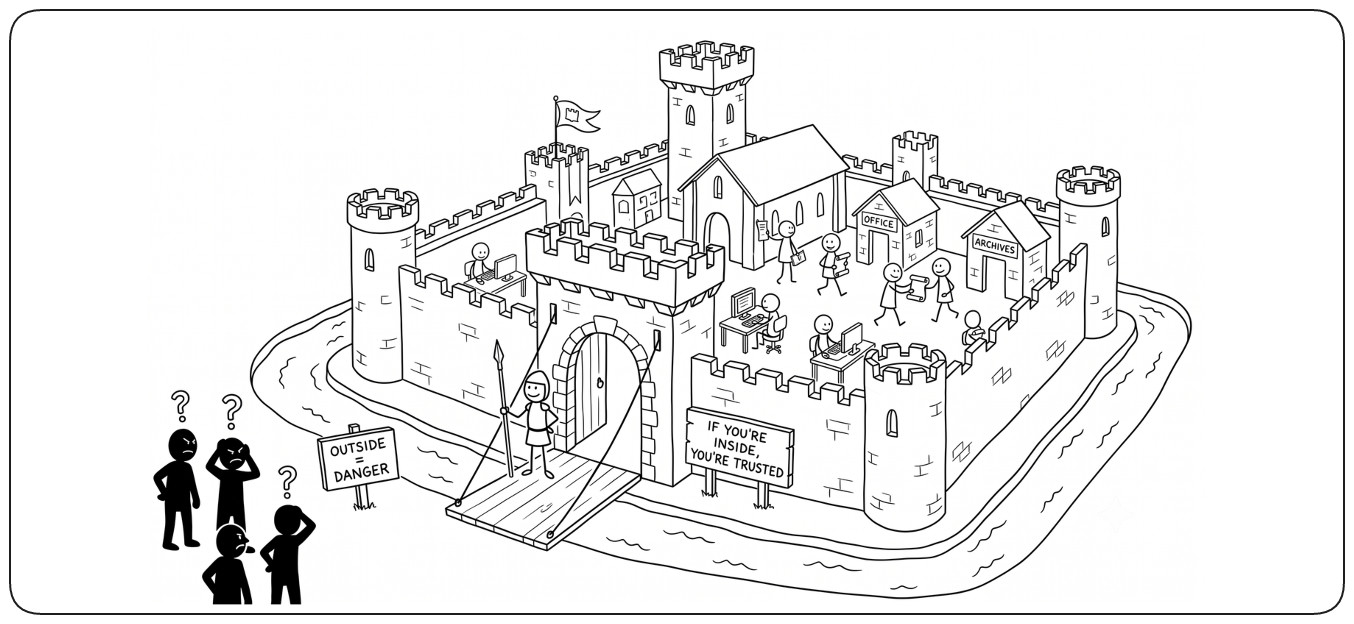
Pendant des décennies, les systèmes ont reposé sur un modèle mental simple : un périmètre fortifié séparait un « intérieur » de confiance d’un « extérieur » dangereux. Pare-feu, VPN et réseaux privés définissaient la frontière ; tout ce qui atteignait le réseau interne était supposé légitime. Les mots de passe, les adresses réseau et le fait d’être « derrière le pare-feu » tenaient lieu de preuve de confiance suffisante — un modèle qui confondait discrètement localisation et identité.
Le périmètre s’est dissous
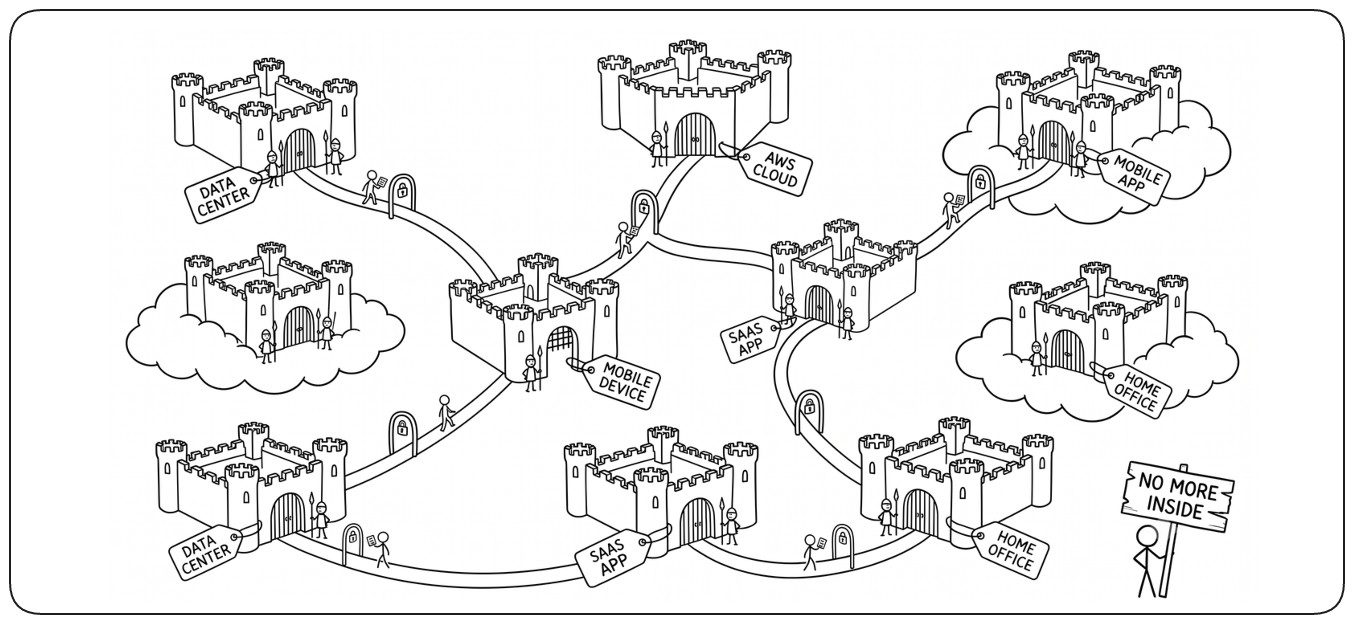
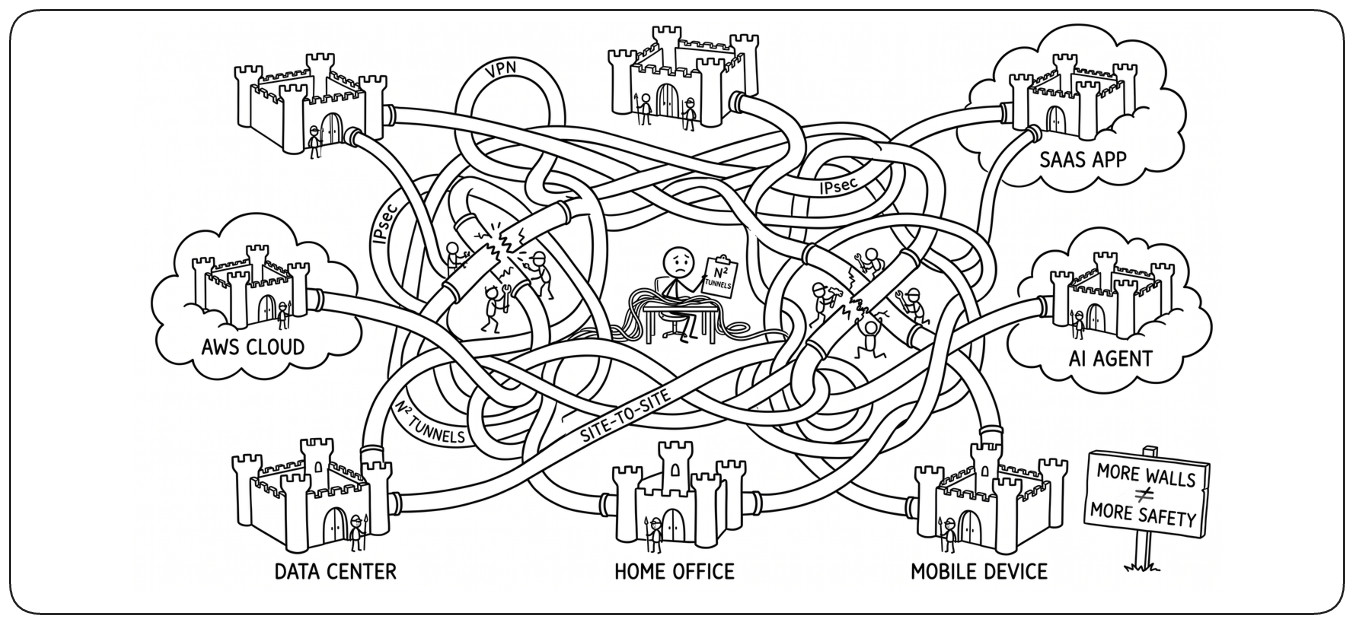
Les systèmes modernes ne vivent plus dans un périmètre unique. Les applications s’exécutent sur plusieurs clouds, les employés se connectent de partout, des SaaS tiers détiennent des données critiques, les appareils mobiles sont hors de tout réseau géré, et des agents IA agissent désormais pour le compte d’humains à travers des systèmes qui ne se voient jamais. !!Il n’y a plus d’« intérieur » à défendre — chaque requête franchit une frontière, et chaque frontière exige sa propre décision de confiance.!! L’ancien modèle ne s’est pas simplement érodé ; il est devenu impossible à appliquer sur le plan architectural.
La solution VPN : recréer le mur partout
Pendant une décennie, la réponse de l’industrie a été de recréer le périmètre en logiciel. VPN, tunnels IPsec et liaisons site à site ont relié bureaux, laptops, clouds et data centers en un seul réseau privé virtuel. La confidentialité en transit s’en est trouvée améliorée, mais ce n’était pas le bon problème. !!La localisation réseau était toujours traitée comme une preuve de confiance : dès qu’un appareil franchissait la frontière du VPN, il était « à l’intérieur », et un seul identifiant volé pouvait se déplacer latéralement dans tout le maillage.!! L’échec était conceptuel — le VPN tentait de reconstruire un lieu de confiance, alors que les systèmes modernes avaient besoin de vérifier l’identité, les permissions et le contexte de chaque requête.
La confiance se prouve, elle ne se présume pas
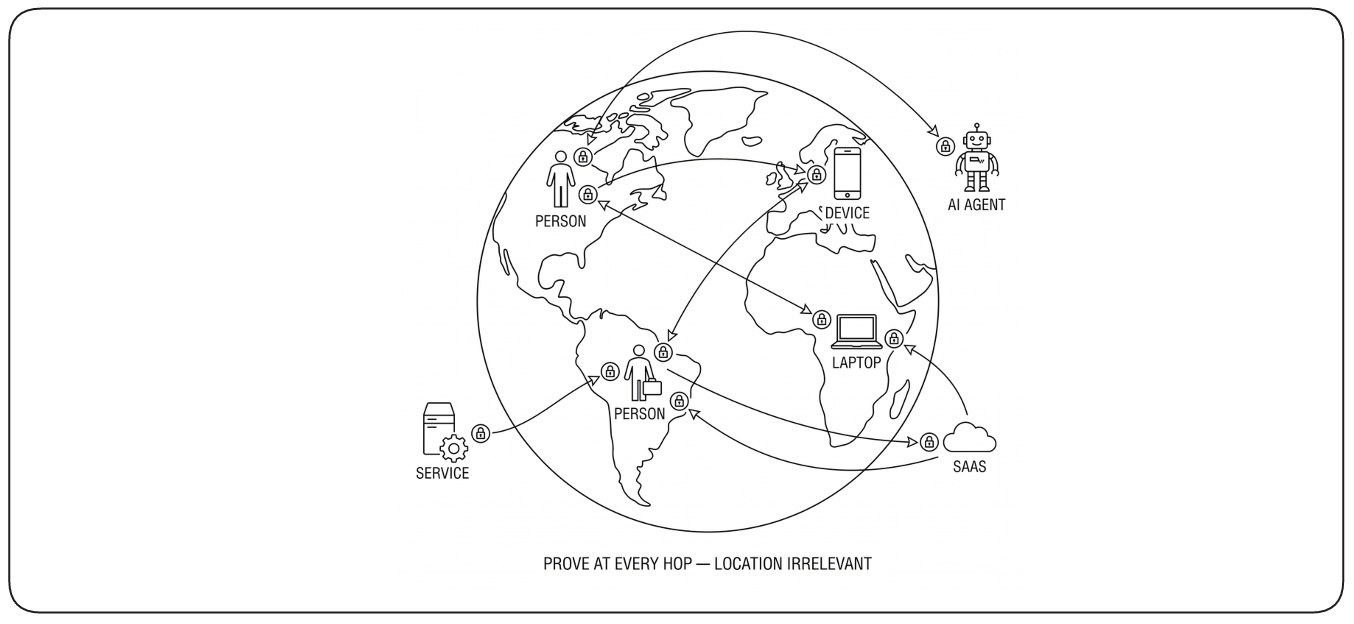
La réponse à un périmètre dissous n’est pas de bâtir un mur plus grand — c’est d’abandonner l’hypothèse selon laquelle la confiance découle de la localisation, du réseau ou de la possession d’un secret partagé. Dans les systèmes modernes, !!la confiance devient explicite : chaque requête doit prouver qui est l’acteur, ce qu’il est autorisé à faire, et que ces deux faits sont toujours valides à l’instant même.!! Rien n’est approuvé par défaut — ni l’appelant, ni le réseau, ni la requête précédente. Chaque interaction repose sur ses propres preuves, évaluées sur le moment.
Introduction au Zero Trust
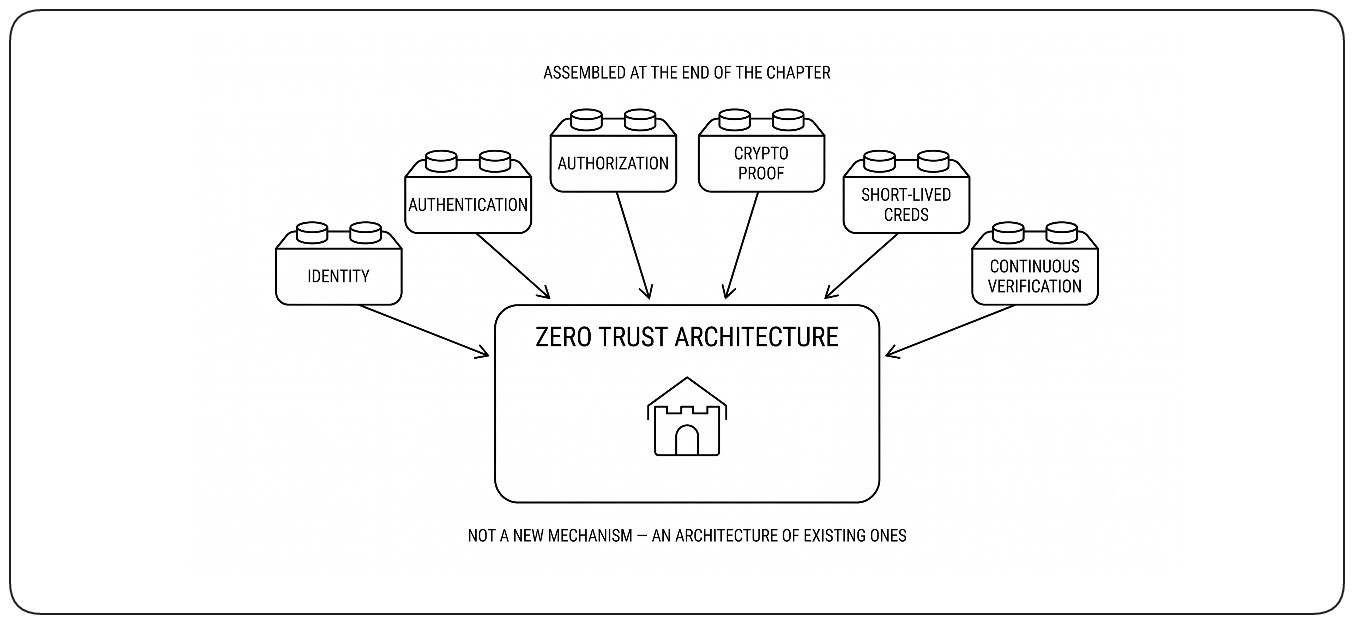
Le Zero Trust est la réponse architecturale à cette nouvelle réalité. !!Ce n’est ni un nouveau mécanisme d’authentification ni un protocole, mais une architecture construite à partir des mécanismes présentés tout au long de ce chapitre : identité, authentification, autorisation, preuve cryptographique, identifiants de courte durée et vérification continue.!! Les sections suivantes expliquent d’abord ces mécanismes ; la section finale sur le Zero Trust montre comment ils s’assemblent.
Gestion des identités et des accès (IAM)
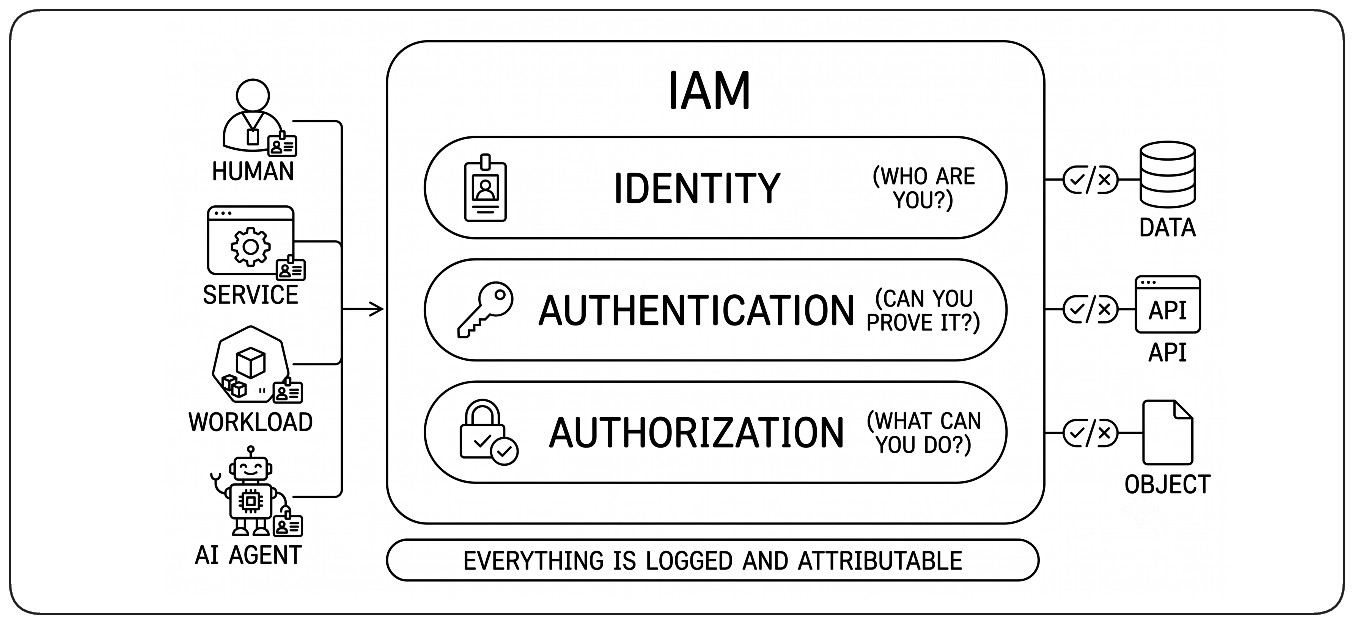
Beaucoup des mécanismes de ce chapitre relèvent d’une même grande discipline : la gestion des identités et des accès (IAM). !!L’IAM gère les identités et contrôle leur accès aux systèmes.!! Elle authentifie les principals, autorise leurs actions et gère les identifiants, rôles et politiques qui soutiennent ces décisions. Que le principal soit un humain, un service, un workload ou un agent IA, l’IAM fournit le socle pour décider qui peut faire quoi.
Principes de conception de la confiance
La confiance ne doit jamais être accordée de façon large, implicite ou indéfinie. Des principes de sécurité établis de longue date fondent chaque mécanisme de ce chapitre : !!n’accorder que l’accès nécessaire, refuser tout ce qui n’a pas été explicitement autorisé, limiter l’accès dans le temps et rendre chaque action attribuable.!! Ces principes sont antérieurs au Zero Trust et guident chaque mécanisme de confiance présenté ici. Avant les mécanismes eux-mêmes, nous énonçons les règles qu’ils doivent respecter.
Moindre privilège
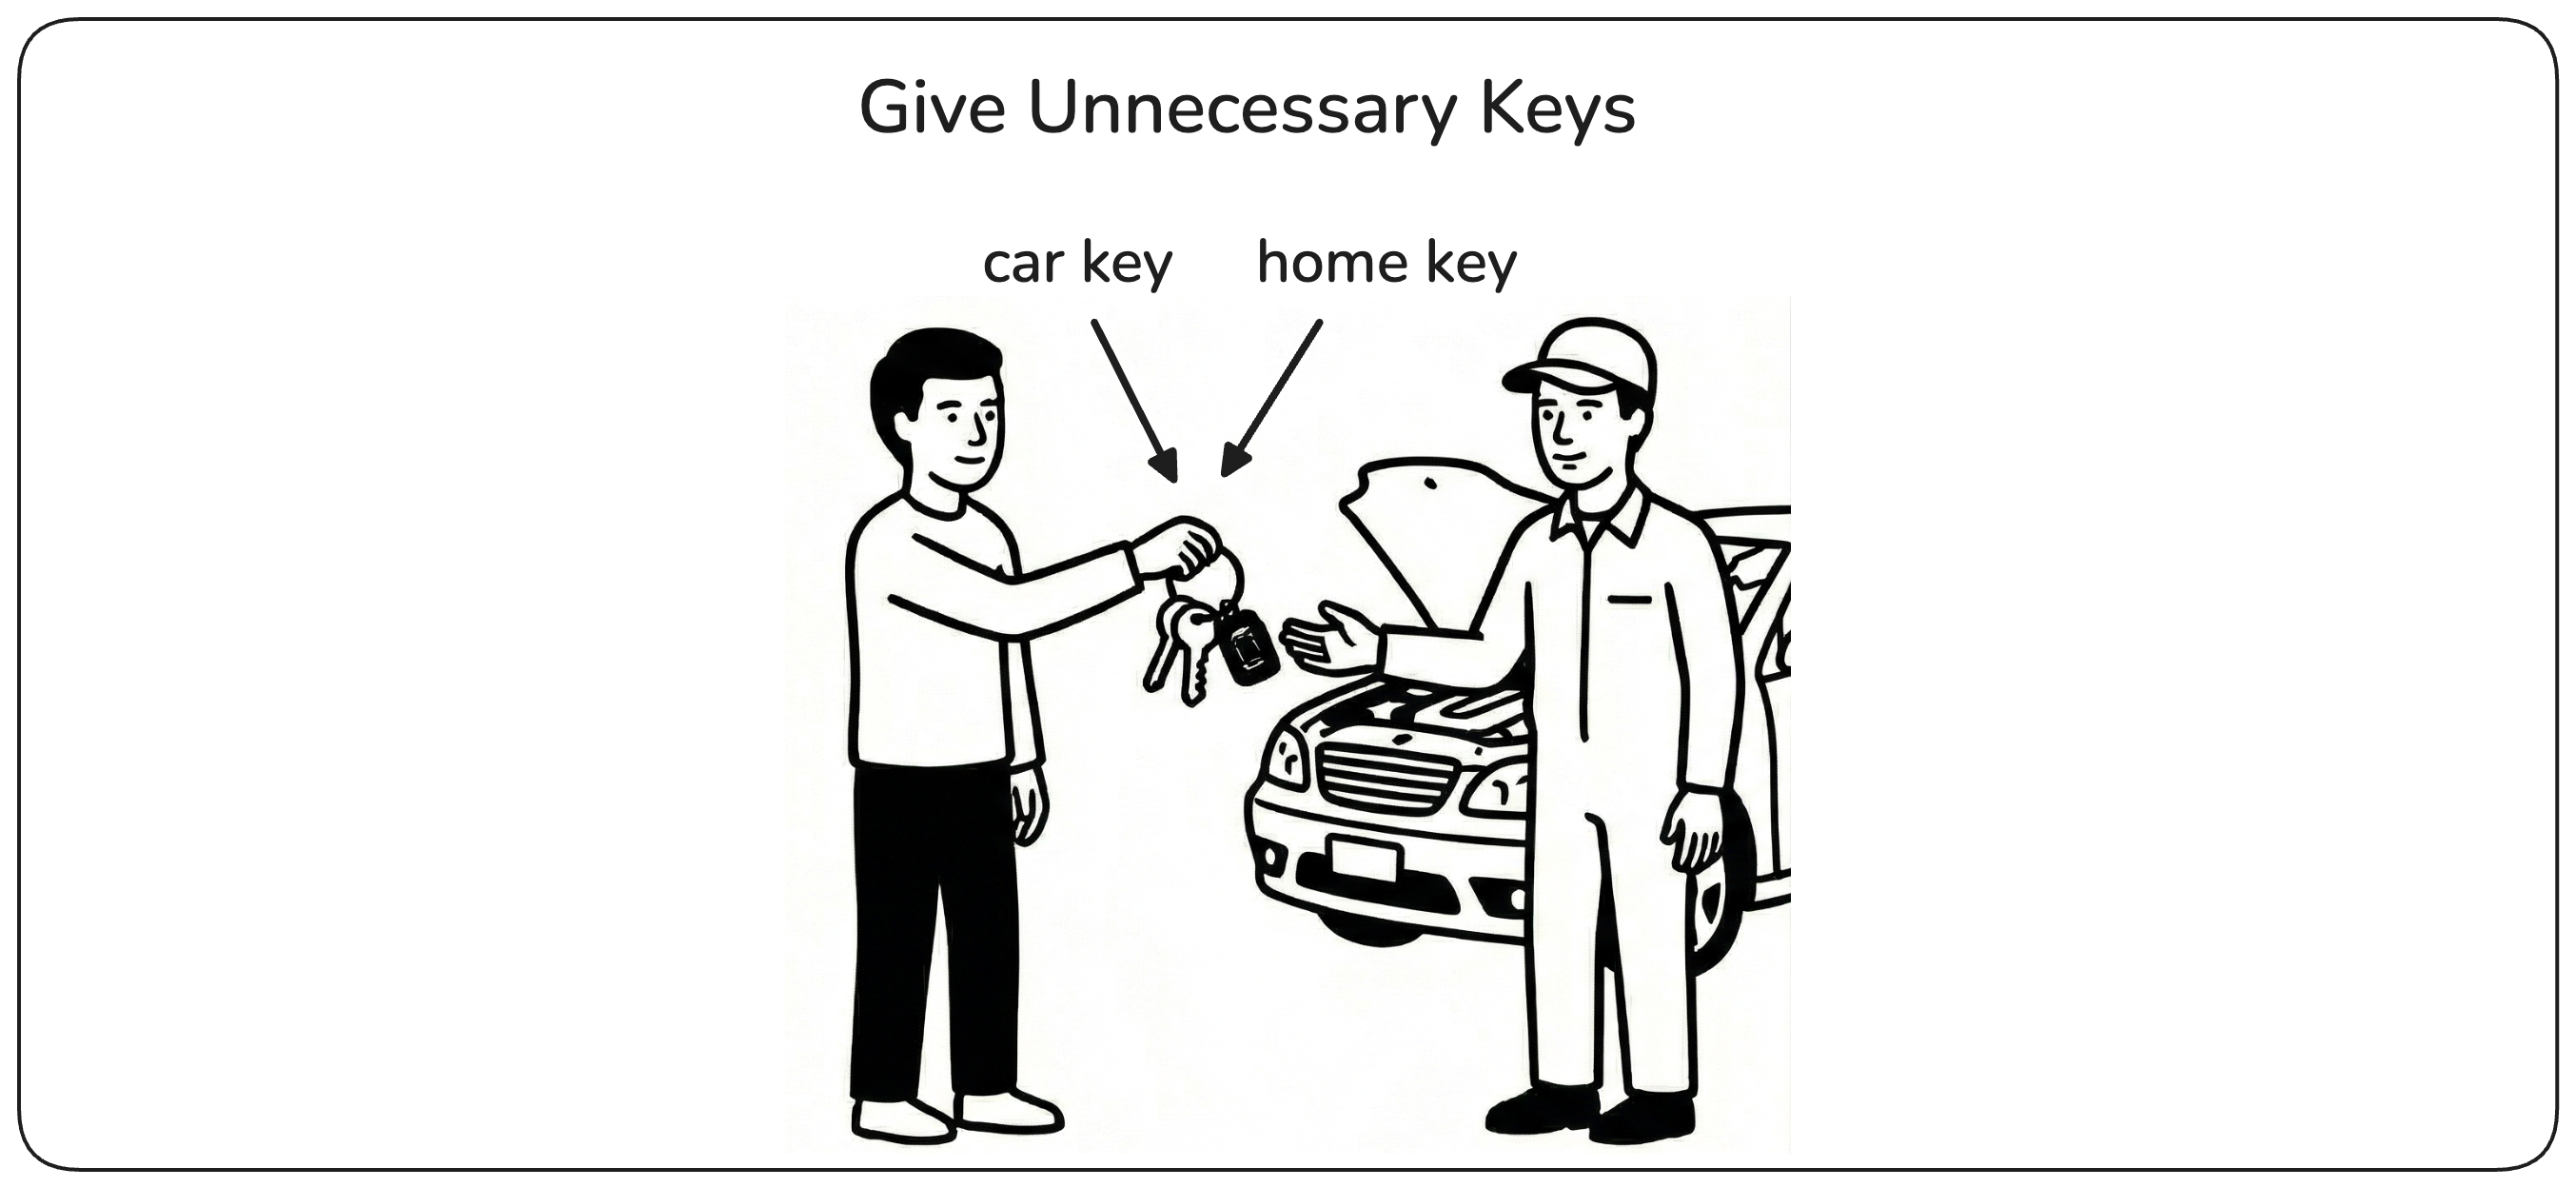
Le principe du moindre privilège n’accorde à chaque utilisateur, workload et token que les permissions nécessaires à sa tâche — et seulement le temps nécessaire. !!En pratique, cela signifie des rôles spécifiques, des permissions de service étroitement délimitées et des tokens limités à l’action et à la ressource visées.!! L’objectif n’est pas seulement d’empêcher les abus, mais de borner les dégâts quand une identité ou un identifiant est compromis.
Tout est interdit par défaut
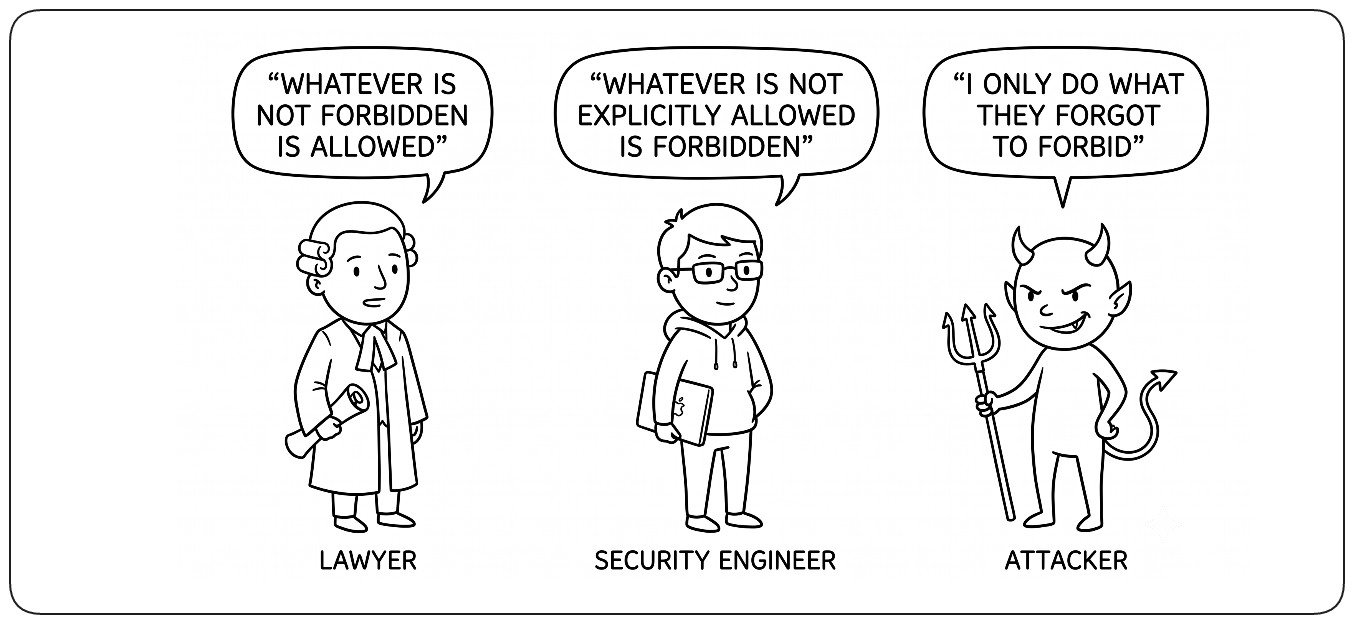
Le moyen le plus simple d’appliquer le moindre privilège est de tout interdire par défaut. Chaque capacité offerte par le système doit être explicitement accordée ; ce qui ne l’est pas est refusé. Cela force chaque permission à être intentionnelle et nommée — aucune permission n’existe par accident, aucune ne survit à la suppression de la règle qui l’a accordée. !!Le refus est la base ; chaque autorisation est une exception délibérée.!!
Quand l’identité ne peut être vérifiée, refuser
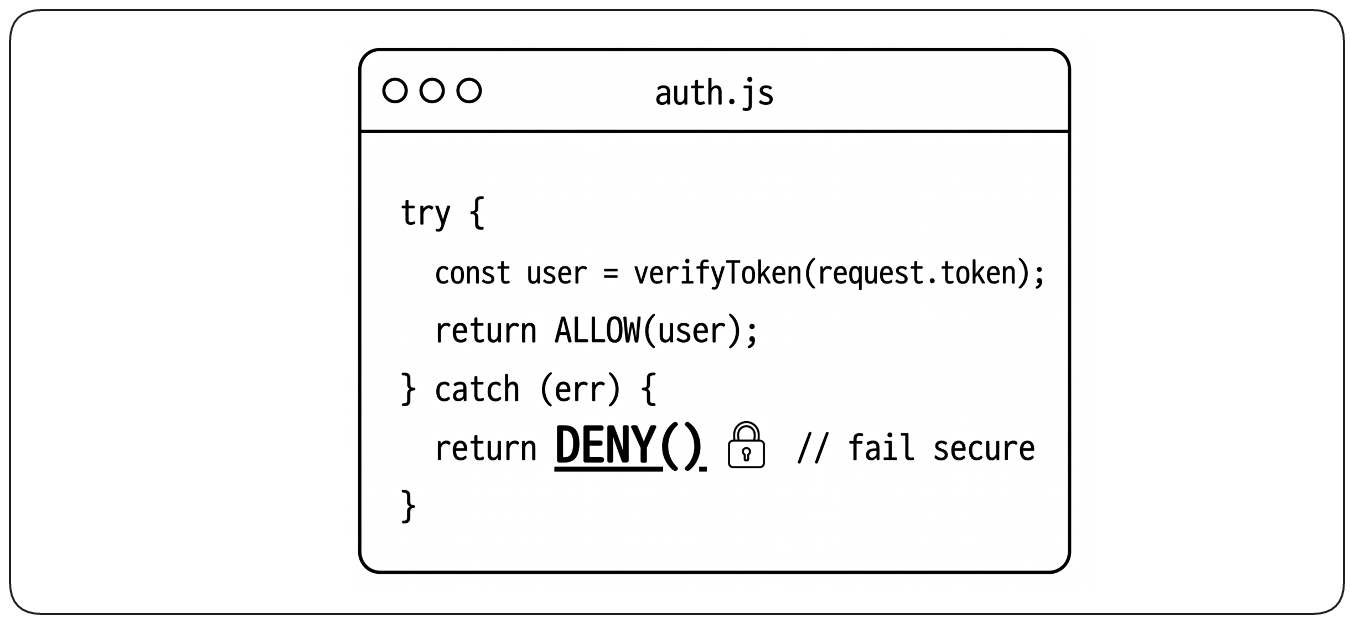
Le refus par défaut ne concerne pas seulement l’absence de règle ; il concerne aussi l’échec d’une vérification. Quand l’identité ou l’autorisation ne peut être établie — IdP injoignable, timeout du service de politiques, clé expirée, token malformé, signature qui ne se vérifie pas — le système doit rejeter la requête. !!Un échec de vérification ne doit jamais devenir silencieusement une permission — dans le doute, on refuse.!!
Identifiants à durée limitée
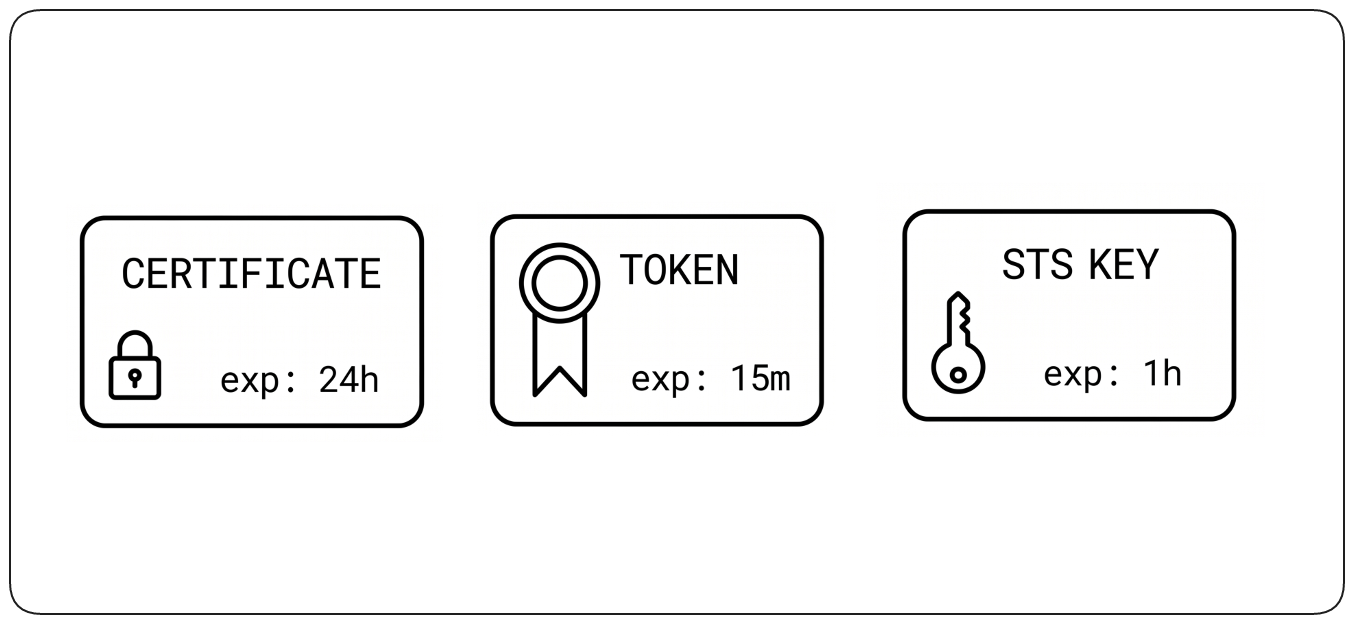
!!La plupart des identifiants opérationnels devraient avoir une date d’expiration — sessions, access tokens, certificats de workload, identifiants cloud temporaires.!! Leur durée de vie doit être bornée par la tâche qu’ils soutiennent — des minutes pour une requête, des heures pour une session, des jours pour tout ce qui est réutilisé. Les identifiants machine émis par le STS du cloud, l’identité de workload ou une autorité de certification sont courts par conception et renouvelés automatiquement tant que le workload en a besoin. Quand la durée de vie s’achève, l’identifiant cesse d’être valide sans que personne n’ait à penser à le révoquer — la compromission d’un identifiant divulgué est donc bornée par ses secondes restantes, et non par la durée d’existence du compte. Les ancres de confiance de longue durée, comme les CA racines, sont l’exception plutôt que la règle.
External Material
Séparation des tâches
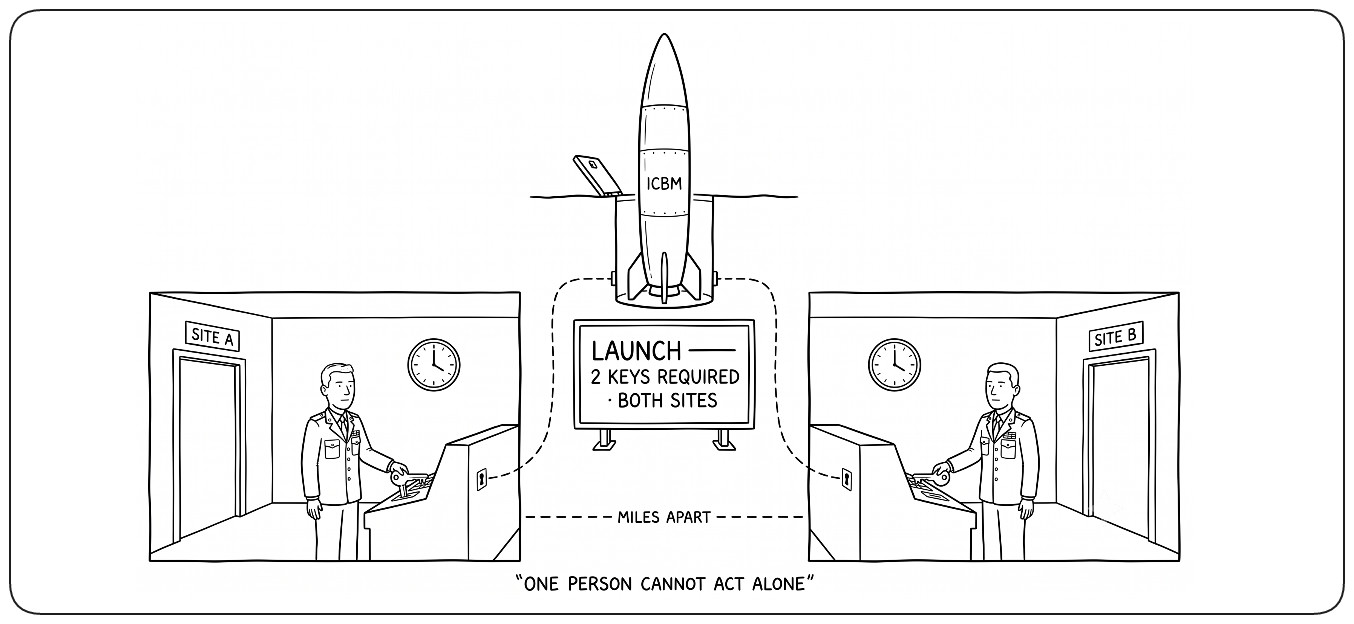
Certaines actions sont trop sensibles pour être contrôlées par une seule identité. !!La séparation des tâches répartit un workflow critique entre des rôles indépendants — une personne demande l’accès, une autre l’approuve ; un système prépare une release, un autre autorise son déploiement en production.!! Le principe s’applique partout où un acteur unique pourrait causer des dégâts disproportionnés : paiements, rotation de clés, changements d’administration, déploiements. Compromettre une seule identité ne doit pas suffire à mener l’opération entière à son terme.
Traçabilité
Le moindre privilège, le refus par défaut et l’accès limité dans le temps bornent ce qui peut être fait et pendant combien de temps. La traçabilité boucle la boucle en rendant chaque action attribuable. !!Chaque requête doit être reliée au principal authentifié qui l’a effectuée — humain, service, workload ou agent IA — jamais à une adresse IP ni à un compte partagé.!! C’est ce qui rend les autres principes applicables : sans attribution fiable, ils restreignent les comportements mais ne peuvent pas expliquer ce qui s’est passé.
Authentification
L’authentification établit qui fait une requête en vérifiant la preuve d’une identité revendiquée. C’est l’une des responsabilités centrales des systèmes de gestion des identités et des accès, mais le concept dépasse toute plateforme IAM ou tout protocole particulier. Cette section traite l’authentification comme un cycle de vie : les acteurs et leurs identités, les preuves utilisées pour les démontrer, le niveau d’assurance que ces preuves apportent, les sessions qui prolongent l’authentification dans le temps, les défis de step-up qui la réévaluent, et la décision architecturale de déléguer l’authentification à un tiers de confiance. La section suivante montre ensuite comment le résultat de cette authentification devient une identité vérifiable, capable de circuler entre les systèmes.
Chaque acteur a une identité — humain, machine, agent IA
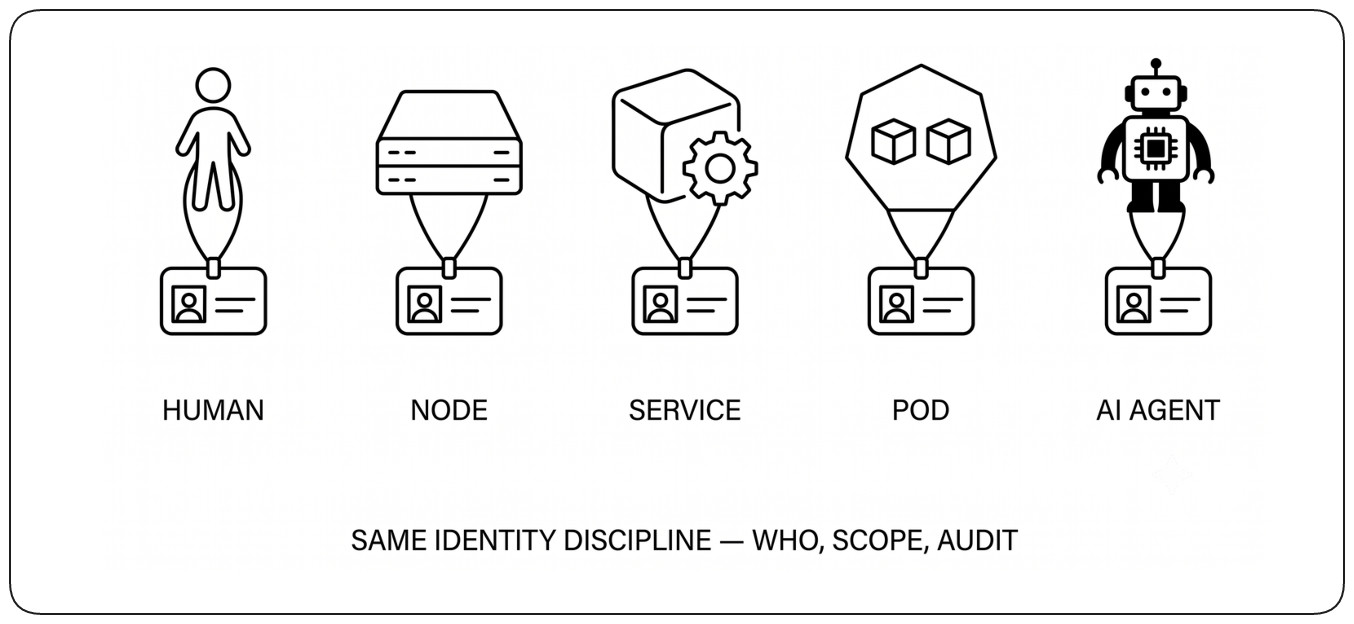
Avant que l’authentification puisse prouver quoi que ce soit, chaque acteur doit avoir une identité à prouver. !!Chaque acteur indépendamment responsable — humain, service, pod, nœud, agent IA — doit avoir une identité distincte, et les identifiants ne doivent jamais être partagés entre des acteurs sans lien.!! La plupart des requêtes d’un système moderne ne sont pas faites par des humains — une Lambda appelle une API, un conteneur interroge une base de données, un pipeline CI/CD pousse une image, un agent IA agit pour le compte d’un utilisateur — et pourtant chacun doit être identifiable exactement de la même façon. Les comptes et identifiants partagés fondent le moindre privilège, la révocation et la traçabilité en une seule ligne anonyme. Les identités sont provisionnées en amont ; l’authentification vérifie le contrôle de cette identité, et les slides suivantes décrivent comment.
Preuves d’authentification
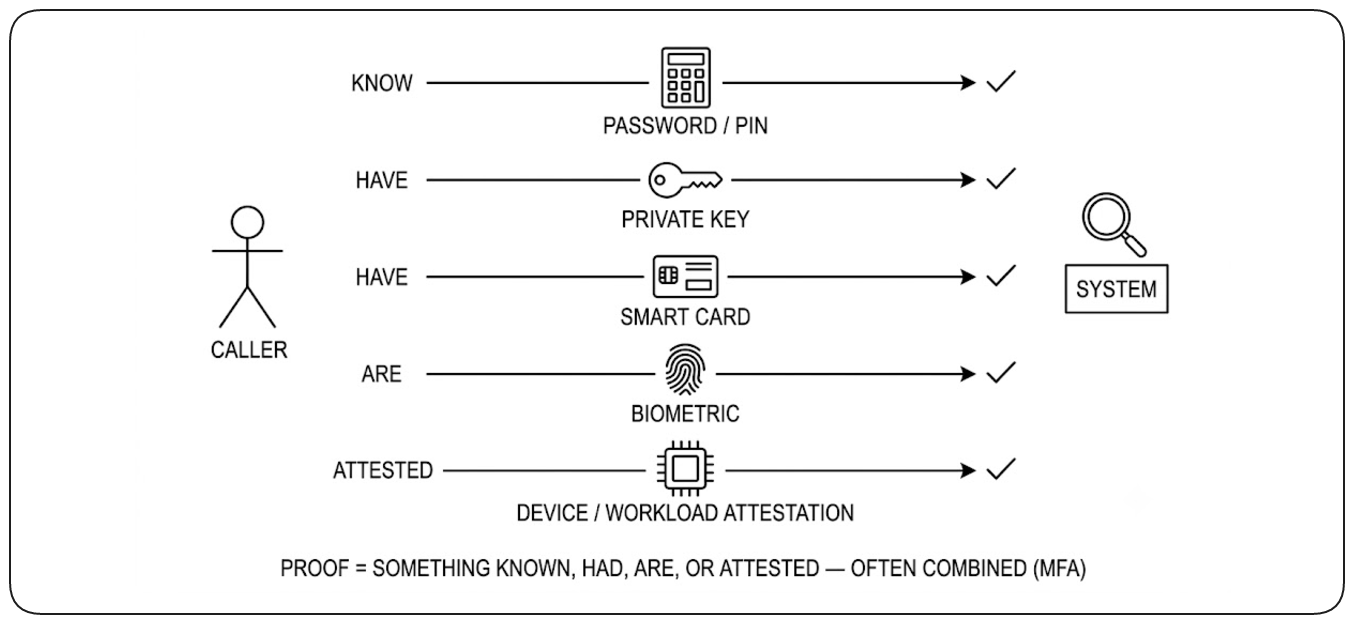
Une fois qu’un acteur a une identité, l’authentification est l’acte de prouver que l’appelant est bien celui qu’il prétend être. Cette preuve repose toujours sur des éléments que l’appelant peut présenter et que le système peut vérifier. !!Les preuves prennent de nombreuses formes : quelque chose que l’appelant connaît (un mot de passe), quelque chose qu’il possède (une clé privée, une carte à puce, un token matériel), quelque chose qu’il est (un facteur biométrique), ou quelque chose que la plateforme peut attester au sujet de l’acteur.!! L’authentification multifacteur combine plusieurs catégories à la fois, de sorte que la compromission d’un seul identifiant ne suffit pas pour usurper l’identité. Ce qui compte conceptuellement n’est pas le mécanisme précis mais le schéma : un acteur présente une preuve, le système la vérifie, et ce n’est qu’alors que l’identité est considérée comme authentifiée.
La force de l’authentification doit correspondre au risque
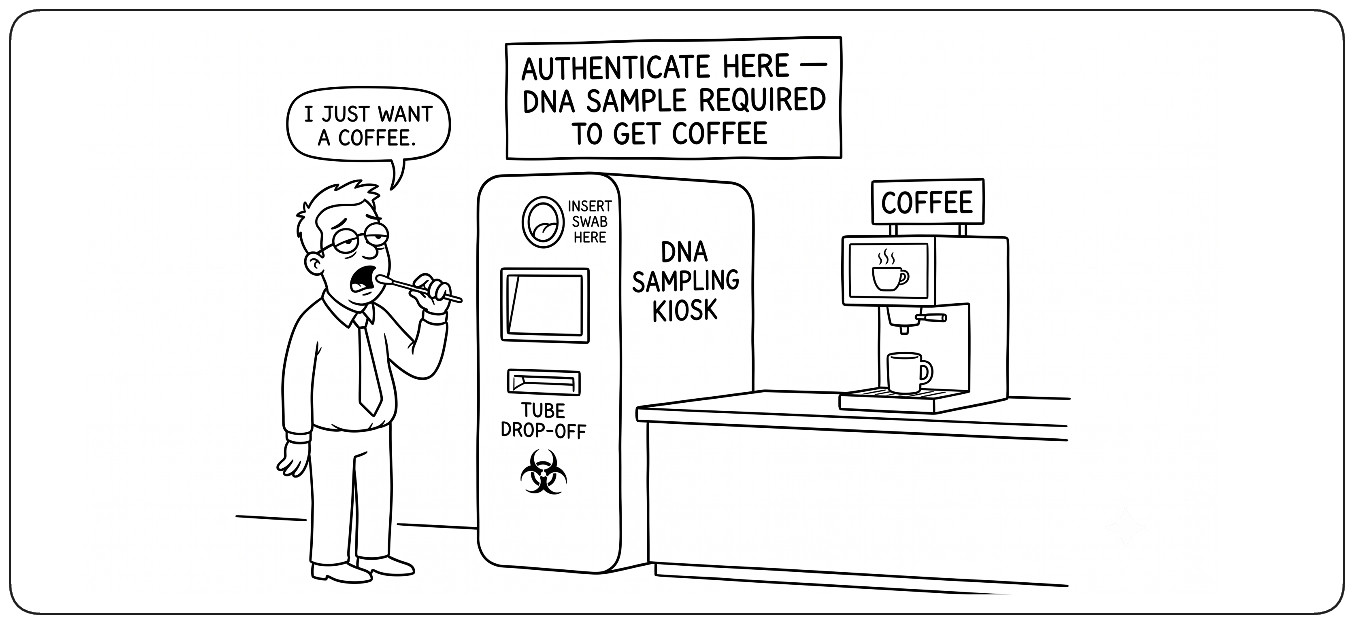
L’authentification n’est pas binaire — elle produit un niveau d’assurance. Un mot de passe offre une assurance modeste ; ajouter un code à usage unique en apporte davantage ; une passkey liée à une clé protégée par du matériel en apporte plus encore. !!La force de l’authentification doit correspondre au risque de l’action demandée, et non au maximum disponible pour chaque requête.!! Exiger la preuve la plus forte partout ne rend pas le système plus sûr — une friction excessive encourage les contournements risqués et brouille la frontière entre l’accès courant et les opérations réellement sensibles.
On ne peut pas réauthentifier chaque requête
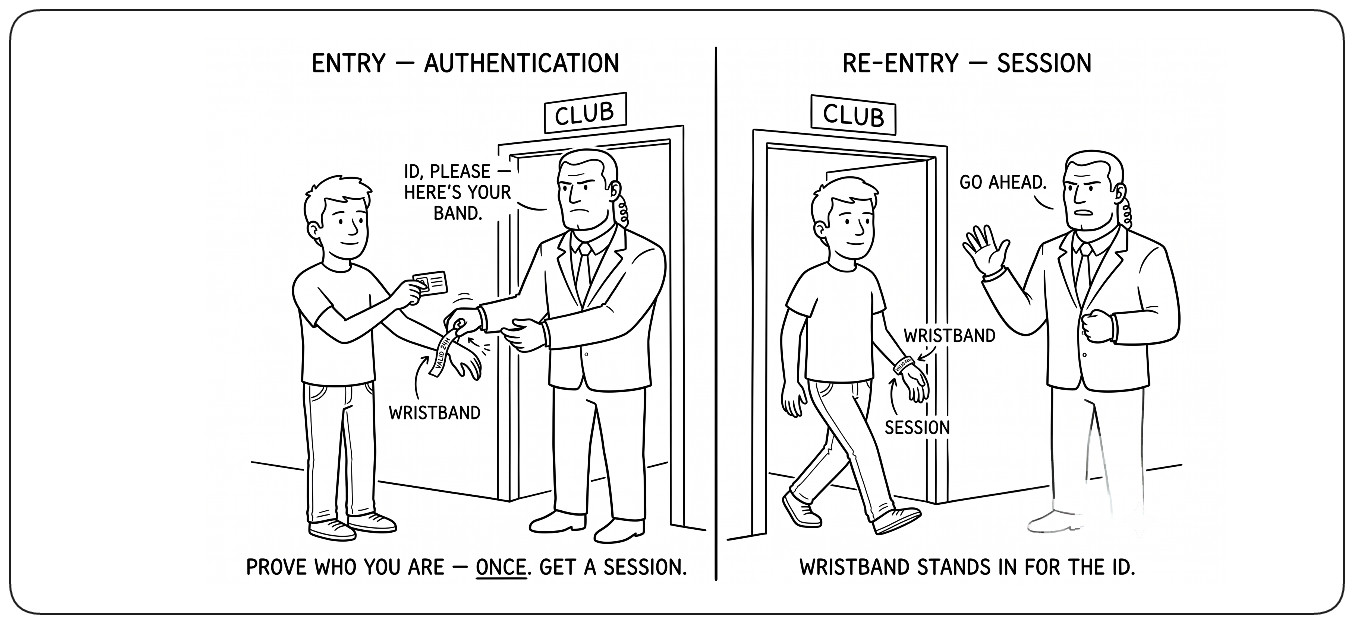
Répéter l’authentification à chaque requête serait impraticable — les utilisateurs ne peuvent pas saisir sans cesse leur mot de passe ou confirmer une passkey pour chaque requête. !!Après une authentification réussie, le système émet une session — un cookie, un token, parfois un certificat — qui tient lieu d’authentification pour les requêtes suivantes.!! La session devient l’identifiant présenté à partir de ce moment, ce qui signifie qu’une connexion forte suivie d’une session illimitée ou volable reste une authentification faible. Les sessions doivent donc être de courte durée, révocables et protégées contre le vol — quand une session survit aux conditions qui la justifiaient, sa validité continue ne représente plus la confiance actuelle.
Certaines actions exigent une preuve plus forte
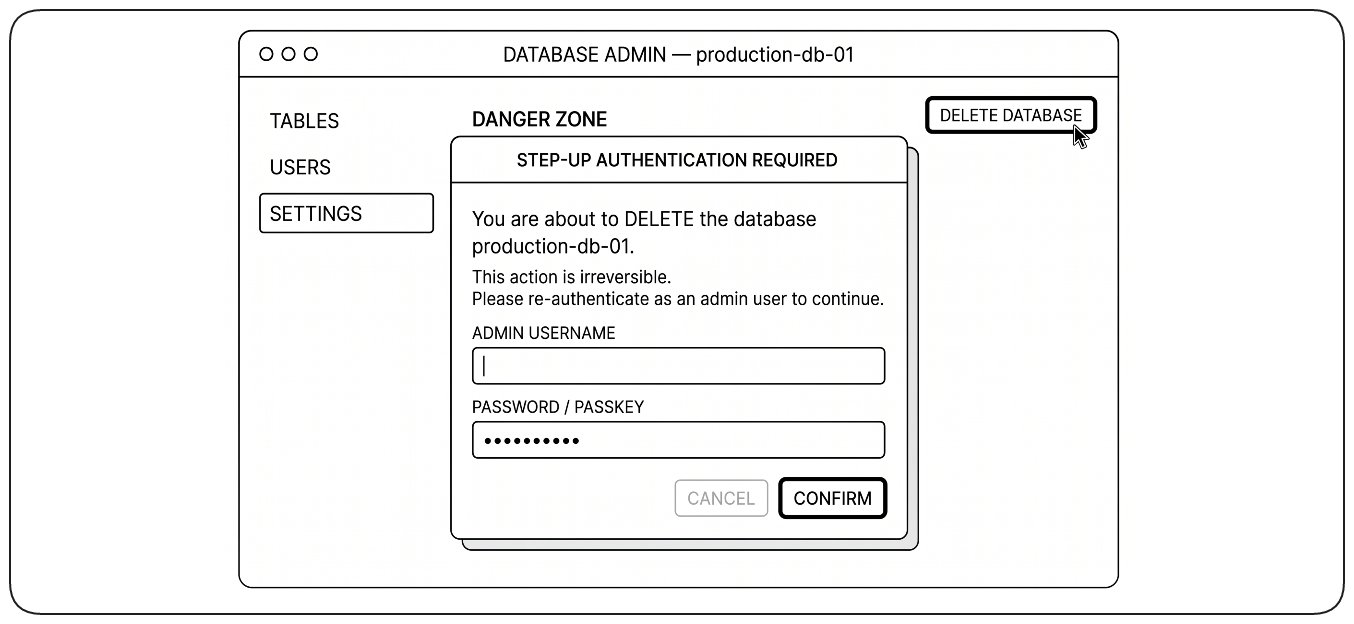
Une session suffit pour les actions courantes, mais pas pour les actions sensibles. Une session détournée ne devrait pas suffire à elle seule pour effectuer les opérations les plus dommageables. Changer le mot de passe d’un compte, enregistrer une nouvelle passkey, approuver un paiement ou accéder à la production peut exiger une preuve récente et plus forte. !!L’authentification step-up demande une preuve plus forte uniquement quand le risque augmente.!!
Les applications peuvent authentifier directement leurs utilisateurs
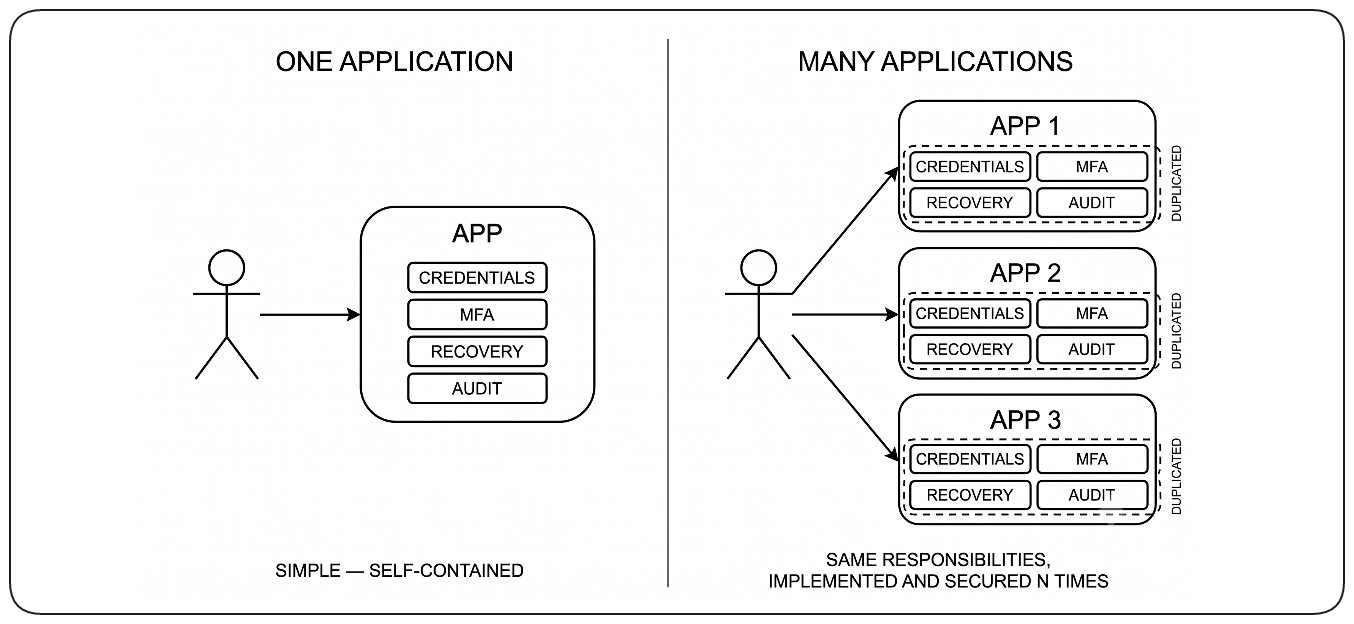
Le modèle d’authentification le plus simple consiste pour une application à authentifier ses propres utilisateurs. !!L’application stocke ou vérifie les identifiants, applique la MFA si nécessaire, crée la session et décide si l’authentification réussit.!! Ce modèle est raisonnable pour une application isolée avec sa propre base d’utilisateurs. Il devient difficile à tenir dès que plusieurs applications doivent authentifier les mêmes utilisateurs : stockage des identifiants, MFA, récupération de mot de passe, révocation, politique de sécurité et audit sont alors implémentés — et sécurisés — séparément dans chaque application, et les utilisateurs se retrouvent avec un compte par système.
Déléguer l’authentification à un tiers de confiance (fédération)
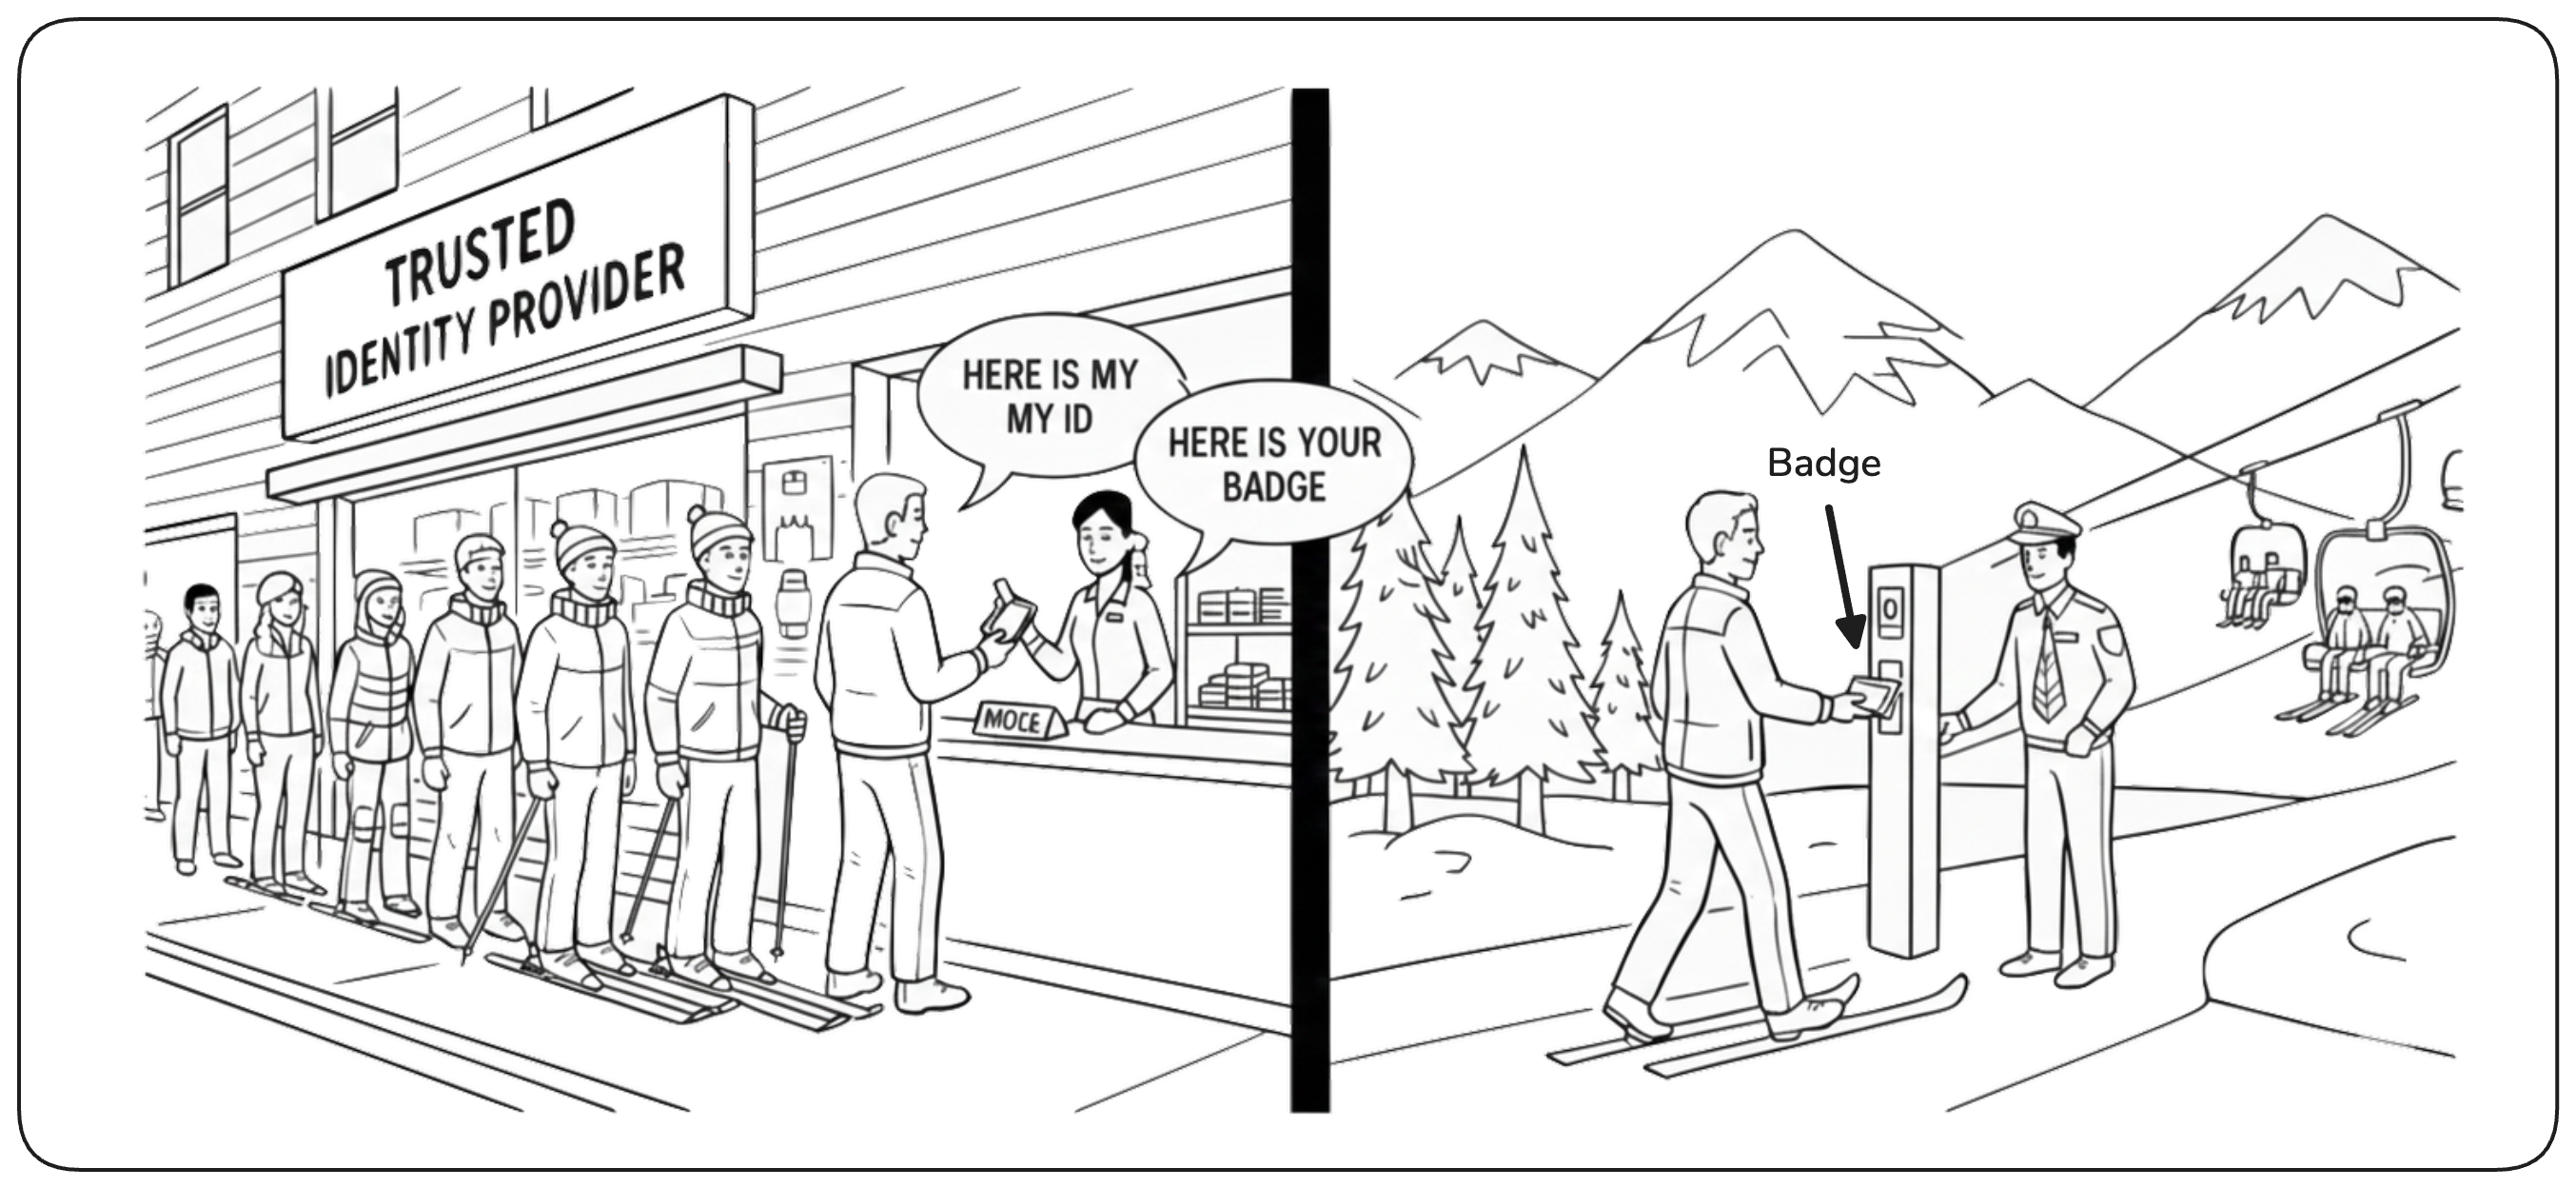
!!La fédération centralise l’authentification dans un fournisseur d’identité (IdP) de confiance qui authentifie l’appelant une fois et se porte garant de cette identité auprès de tout système en aval qui fait confiance au même fournisseur.!! Les applications en aval ne répètent pas l’authentification — elles font confiance à l’IdP pour établir l’identité, et vérifient indépendamment les preuves qu’il émet. Un seul IdP peut servir de nombreuses applications, de sorte que la politique de sécurité, la révocation et l’audit sont définis et sécurisés en un seul endroit.
La fédération centrée sur l’utilisateur passe par des redirections du navigateur
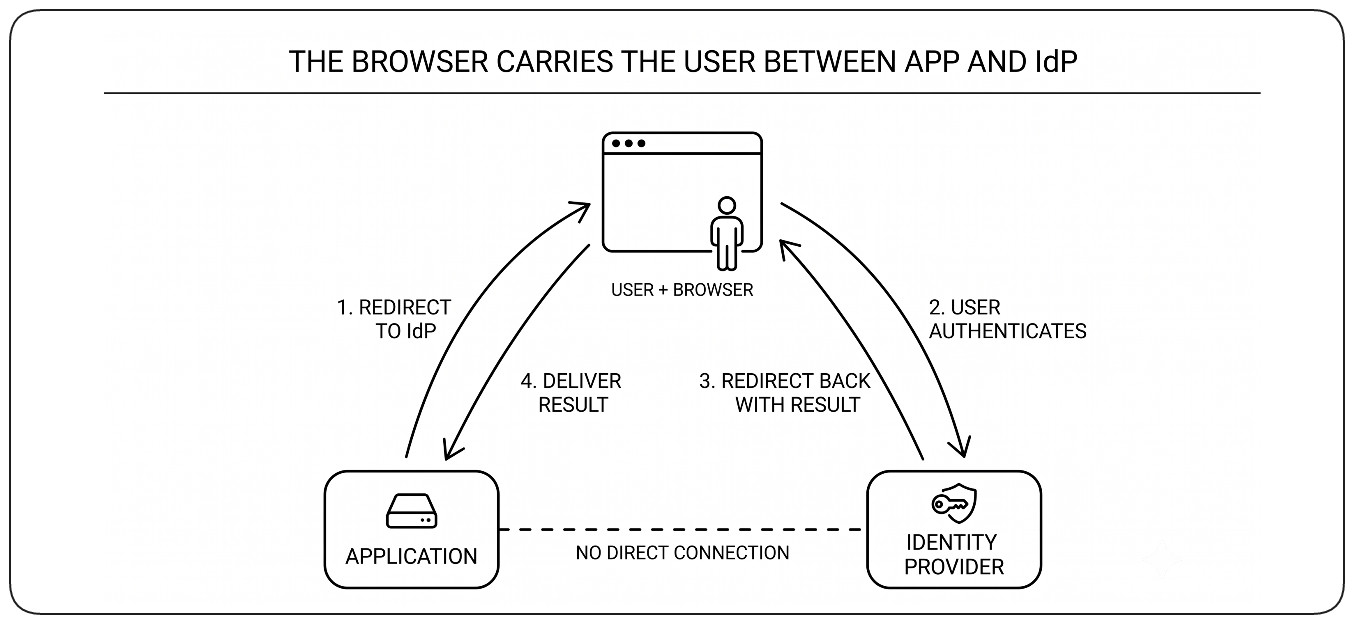
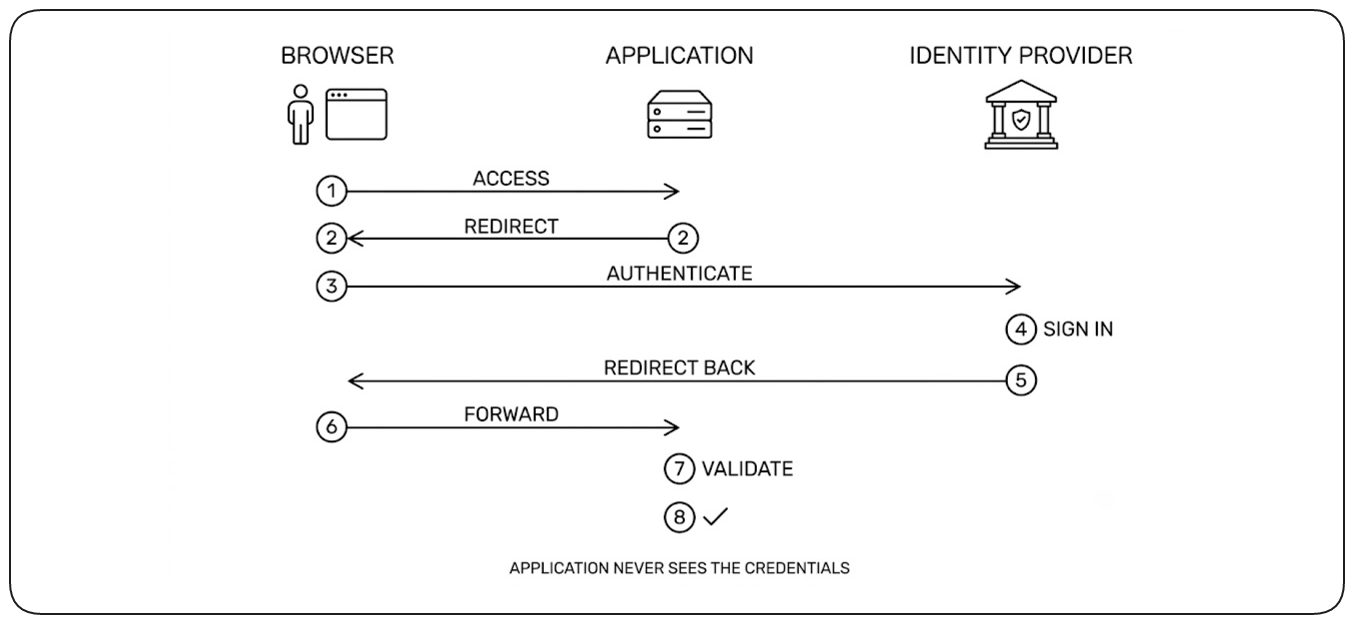
Quand la fédération sert à authentifier un utilisateur humain, le navigateur participe au flux d’authentification. L’application utilise des redirections HTTP standard pour envoyer le navigateur vers un fournisseur d’identité de confiance. Après avoir authentifié l’utilisateur, le fournisseur d’identité redirige le navigateur vers l’application avec une réponse d’authentification. !!Les redirections permettent à l’application de déléguer l’authentification de l’utilisateur sans jamais recevoir ni manipuler ses identifiants.!!
Identité vérifiable
L’authentification prouve une identité une fois. Le défi suivant est de permettre à cette identité vérifiée de circuler entre les systèmes sans répéter la cérémonie d’authentification. Une identité authentifiée n’est utile que si elle peut passer d’un système à l’autre sans être réauthentifiée à chaque saut. Cette section explique comment les systèmes modernes rendent l’identité portable et vérifiable de façon indépendante — prouvée cryptographiquement, liée à une autorité, ancrée dans une racine de confiance, exprimée sous forme de claims signés et vérifiée indépendamment par chaque destinataire. Le reste du chapitre — IAM cloud, protocoles d’identité ouverts, authentification des machines, secrets et Zero Trust — repose sur cette couche.
La cryptographie asymétrique permet une preuve vérifiable
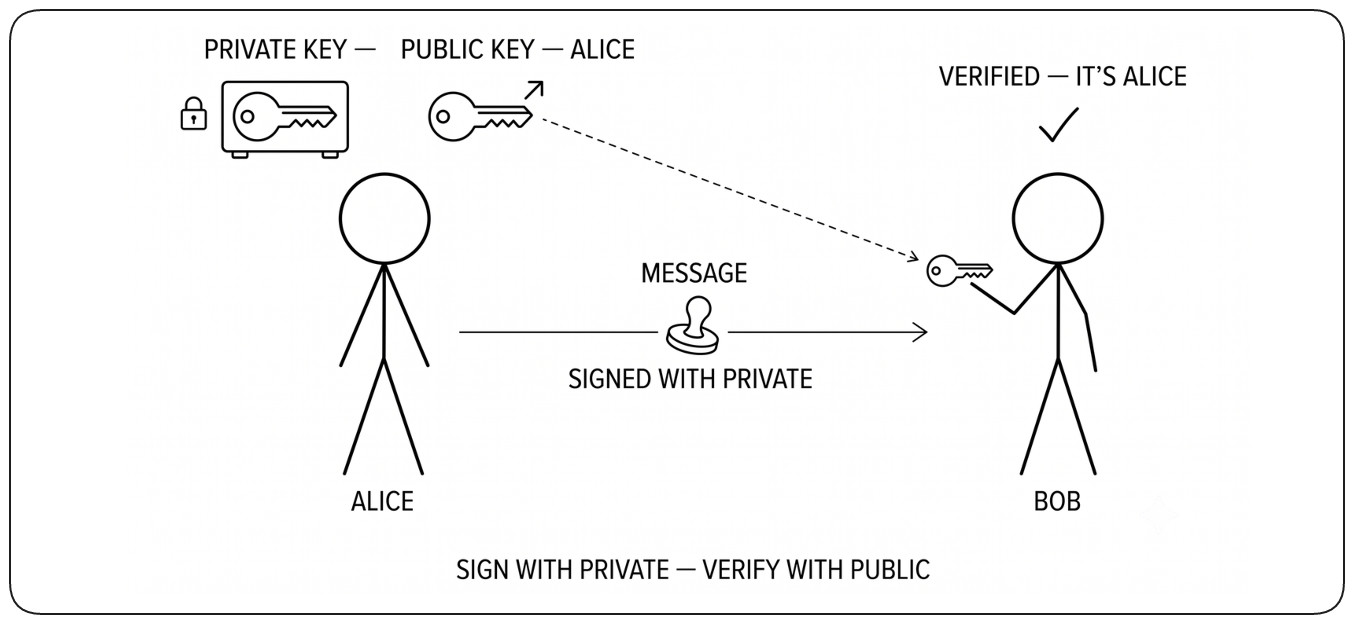
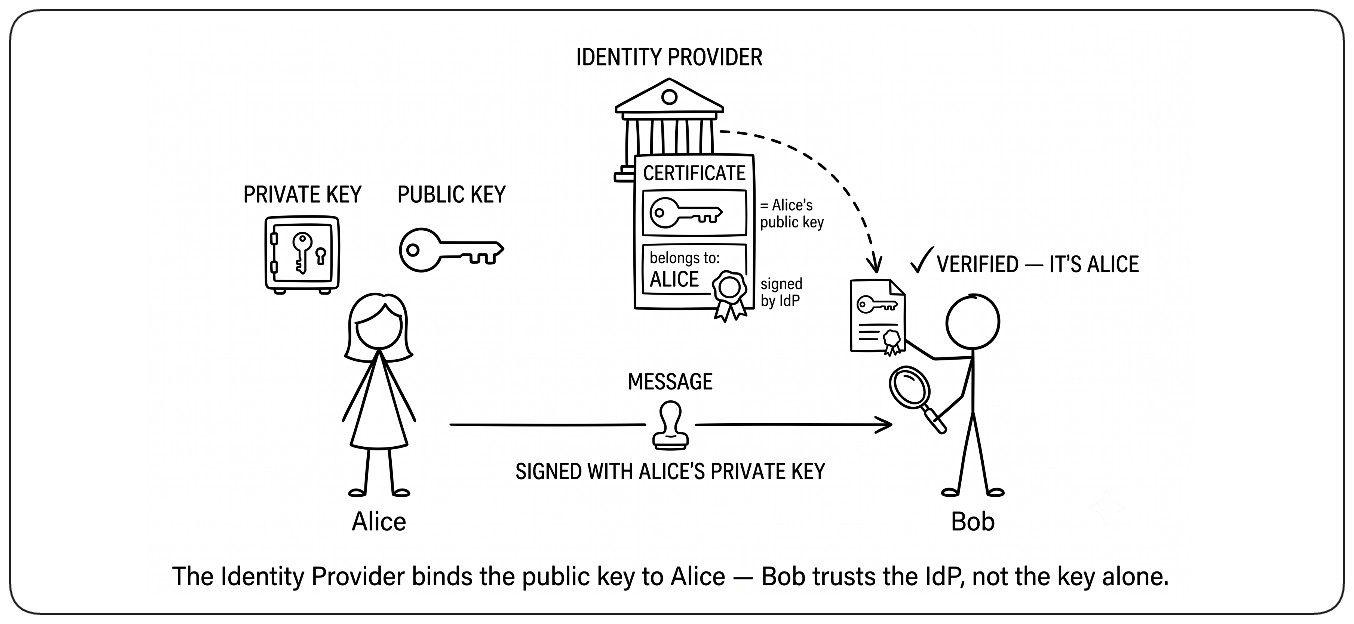
Prouver son identité à travers le réseau a exigé une technologie qui n’a pas existé pendant la majeure partie de l’histoire de l’informatique. !!La cryptographie asymétrique — une paire de clés dont l’une crée une preuve tandis que l’autre la vérifie — a permis de s’authentifier sans partager de secret.!! Un acteur peut signer une requête, et tout vérificateur détenant la clé publique correspondante peut contrôler cette signature — mais la signature seule prouve uniquement le contrôle de la clé privée, pas l’identité de son propriétaire. Ce lien vient ensuite. La plupart des mécanismes d’identité modernes du reste de ce chapitre — tokens signés, mTLS, SPIFFE, passkeys, identité de workload — reposent sur cette seule invention.
Lier la preuve cryptographique à l’identité
Vérifier une signature prouve seulement le contrôle d’une clé privée — cela ne dit pas à qui appartient cette clé. Une autorité de confiance lie la clé publique à une identité : par un certificat signé, une clé publique enregistrée sur un compte, un authentificateur enrôlé auprès d’un IdP, ou une identité de workload émise par la plateforme. Les tiers peuvent alors vérifier à la fois la signature et l’identité qu’elle représente. !!La cryptographie prouve le contrôle d’une clé ; une autorité de confiance lie cette clé à une identité.!!
Toute chaîne aboutit à une racine de confiance
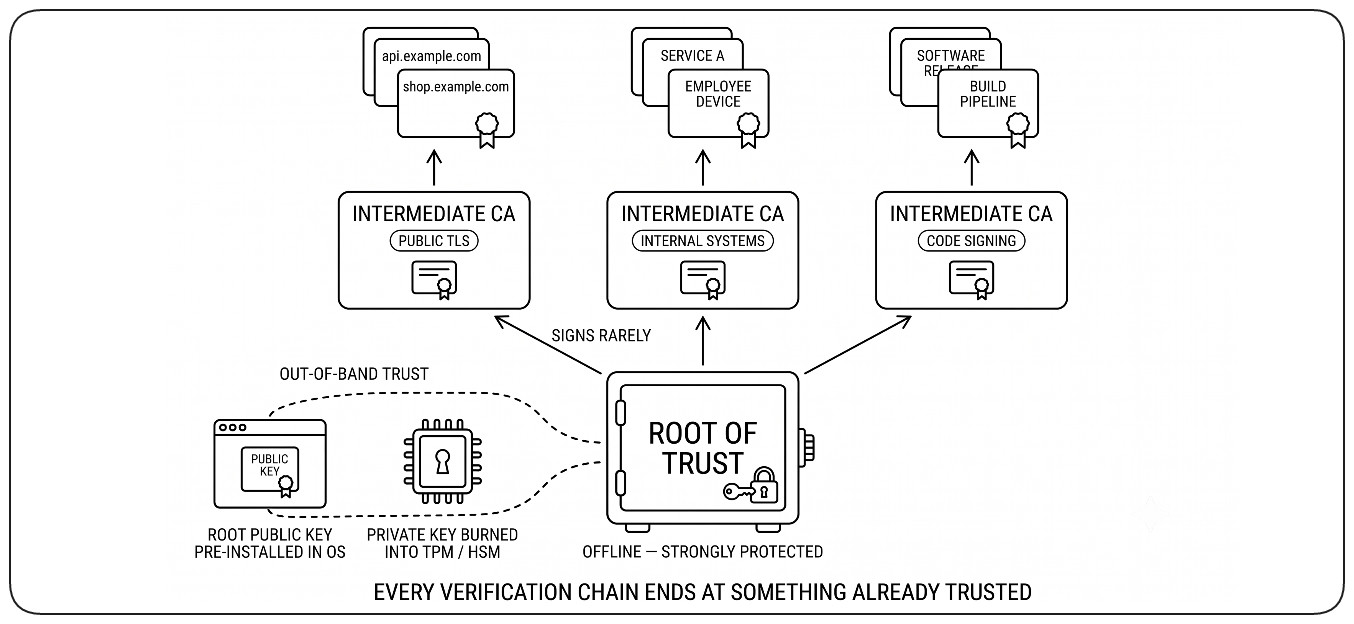
Une autorité de confiance lie une clé publique à une identité — mais pourquoi cette autorité elle-même serait-elle digne de confiance ? Toute chaîne de vérification finit par atteindre une racine de confiance : quelque chose dont la légitimité n’est pas établie par une autre signature, mais par un processus de confiance distinct. Un certificat racine peut être préinstallé dans un système d’exploitation, une identité matérielle peut être provisionnée dans un TPM, ou une clé racine peut être générée et protégée de façon sécurisée dans un HSM.
!!La cryptographie ne crée pas la confiance ; elle étend la confiance issue d’une racine établie — chaque vérification en aval n’est aussi solide que la racine dont elle dépend en fin de compte.!!
Claims signés
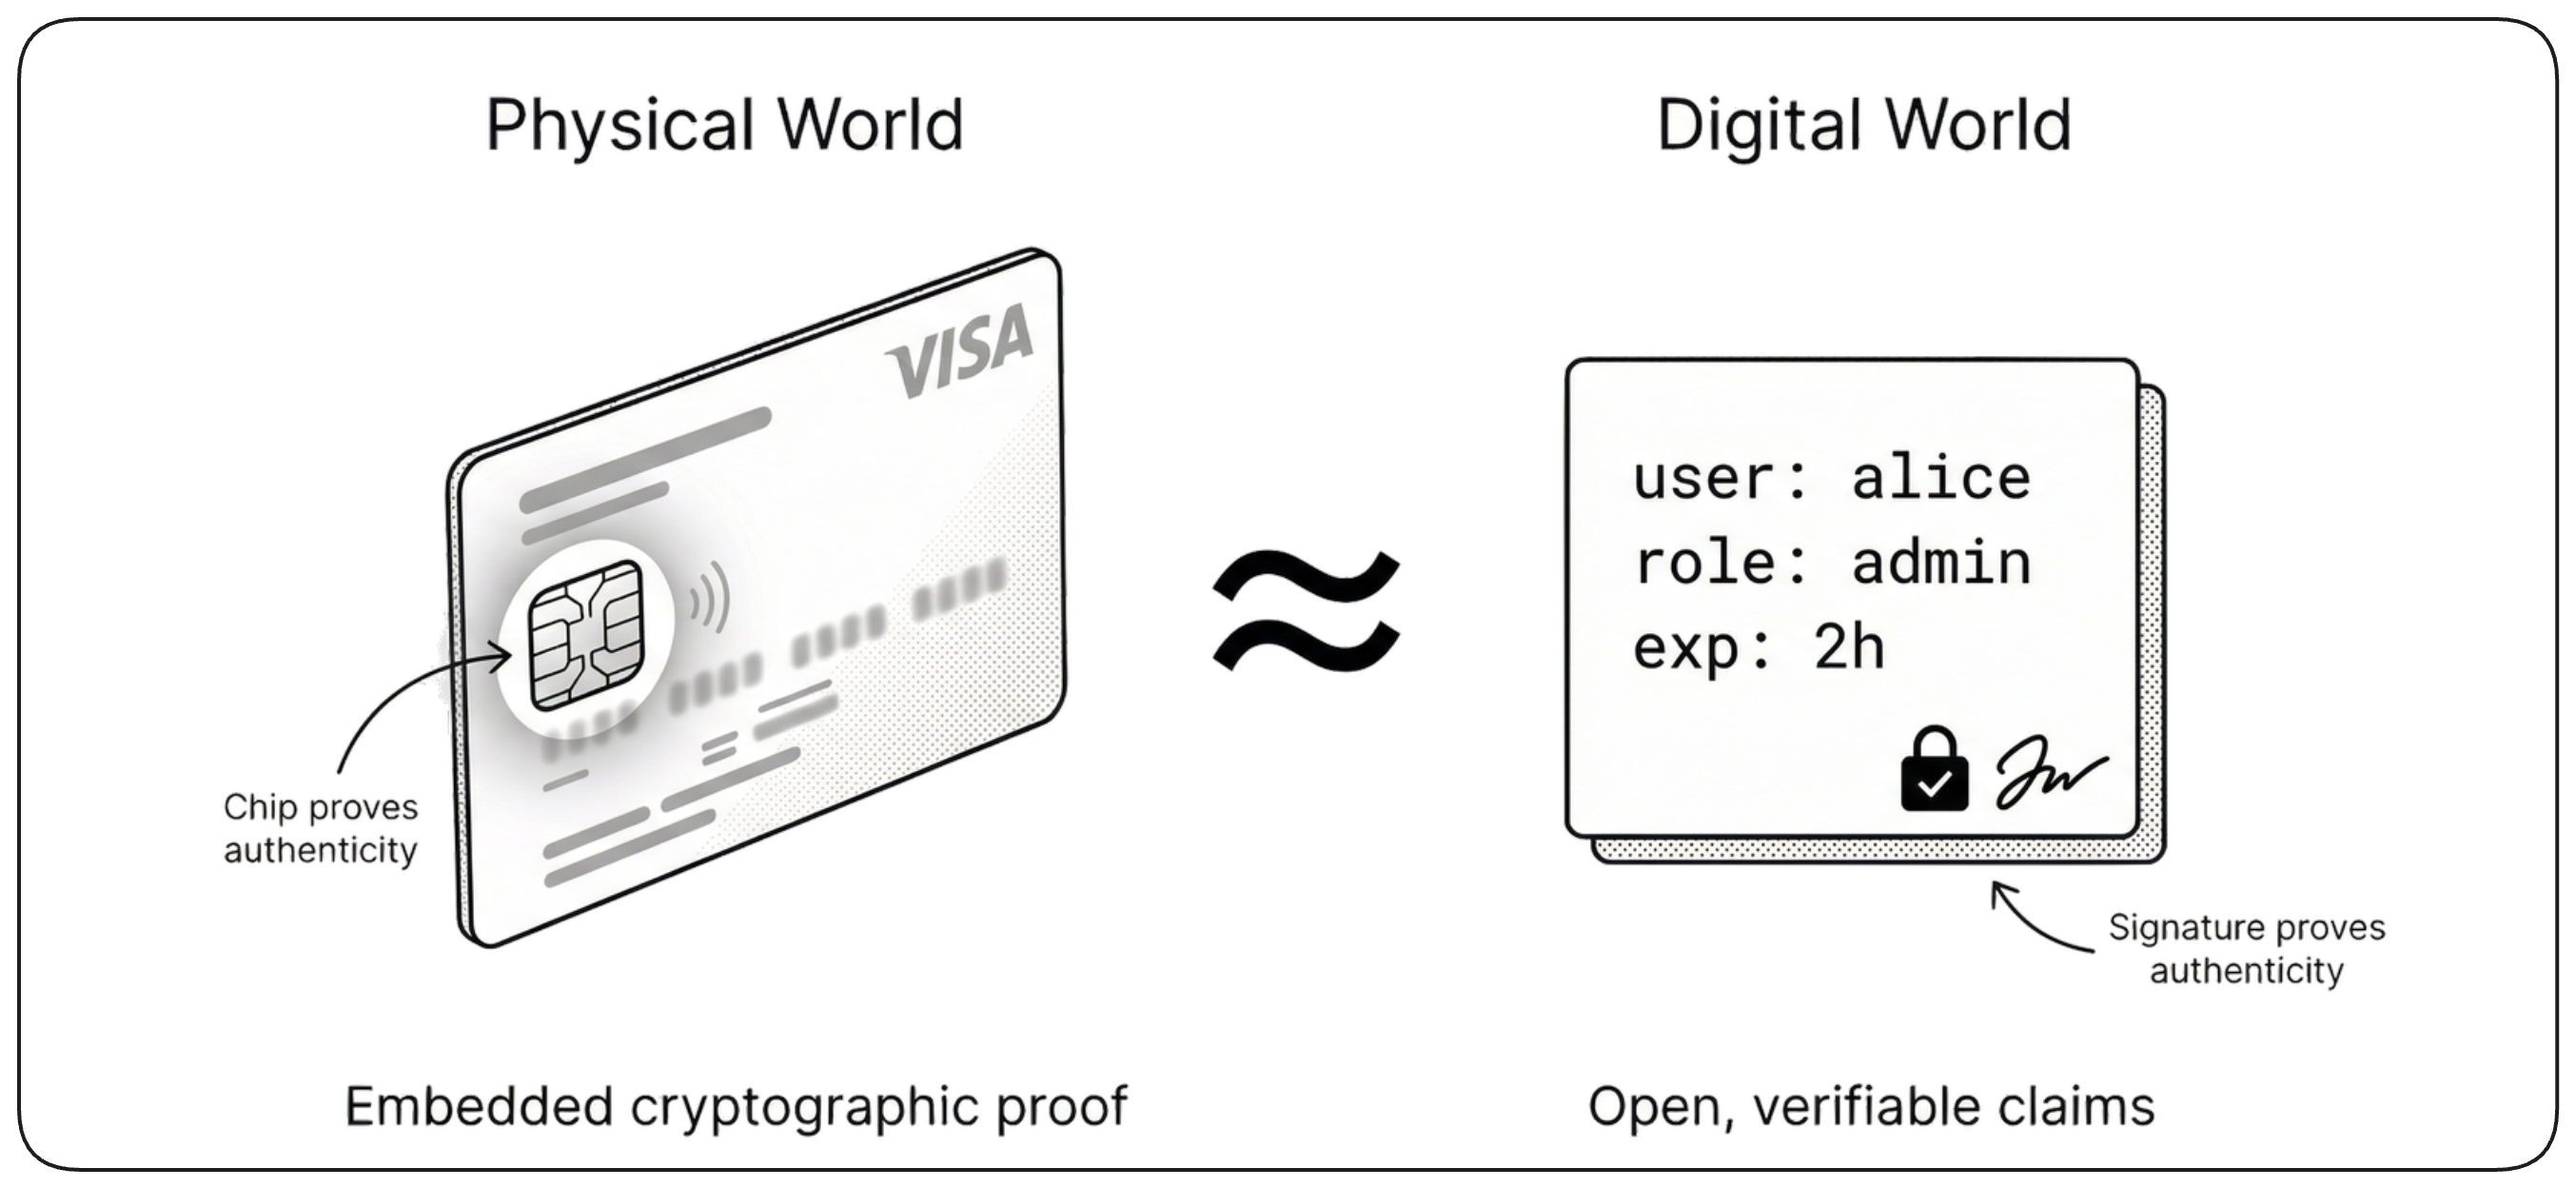
Une fois l’identité authentifiée, un émetteur de confiance exprime le résultat sous forme de claims — de courtes déclarations que l’émetteur affirme au sujet de l’identité authentifiée et de son contexte : « Alice, ingénierie, authentifiée à 10h42, expire dans une heure », ou, pour un workload, « checkout-service, us-east-1, émis par la plateforme de workloads ». L’émetteur signe ces claims avec sa clé privée, de sorte que tout destinataire peut vérifier qui les a émis et détecter toute altération. Les claims eux-mêmes restent lisibles — leur confiance vient de la signature, pas du secret. !!Les claims signés sont une représentation portable et vérifiable de ce qu’un émetteur de confiance affirme au sujet d’une identité.!!
Les claims signés voyagent et se vérifient indépendamment
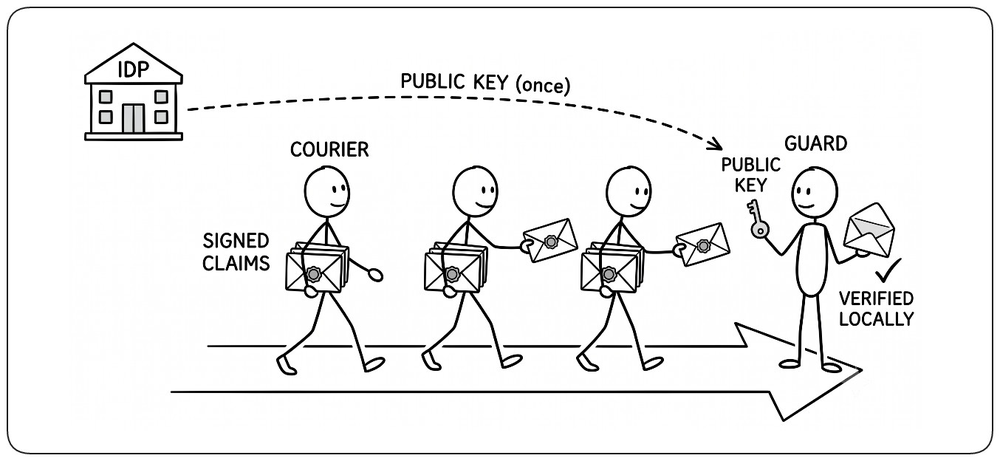
Une fois l’identité authentifiée, un émetteur de confiance signe des claims sur cette identité et les place dans un token. Le token voyage avec chaque requête, portant l’identité et le contexte dont le destinataire a besoin. !!Chaque destinataire peut vérifier la signature localement avec la clé publique de l’émetteur, sans appeler le fournisseur d’identité à chaque requête.!!
Autorisation
L’autorisation détermine ce qu’une identité authentifiée a le droit de faire. Elle évalue le principal, l’action demandée, la ressource cible et les conditions actuelles au regard d’une politique. Comme l’authentification, c’est une responsabilité de sécurité générale que les systèmes IAM aident à mettre en œuvre de façon cohérente pour les utilisateurs, les workloads et les ressources.
Politiques
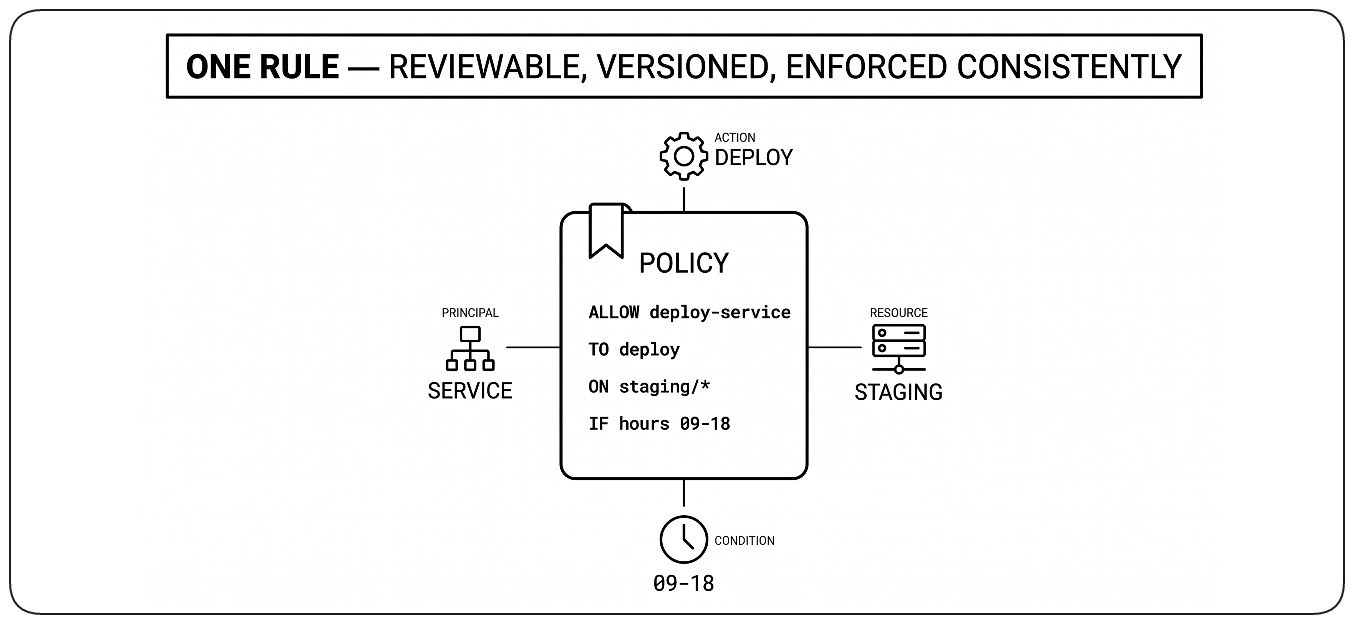
Une politique est une règle explicite qui définit qui peut effectuer quelles actions sur quelles ressources, sous quelles conditions. Plutôt que de disperser les décisions d’autorisation dans le code applicatif, les systèmes modernes les expriment sous forme de politiques déclaratives qui peuvent être relues, versionnées, auditées et appliquées de façon cohérente. Une politique peut accorder à un service la permission de publier des messages dans une file, autoriser un développeur à déployer uniquement vers un environnement de staging, ou permettre à un administrateur d’accéder à la production uniquement pendant une fenêtre de maintenance approuvée. !!L’autorisation relève de la politique, pas du code applicatif.!!
Principals, actions et ressources
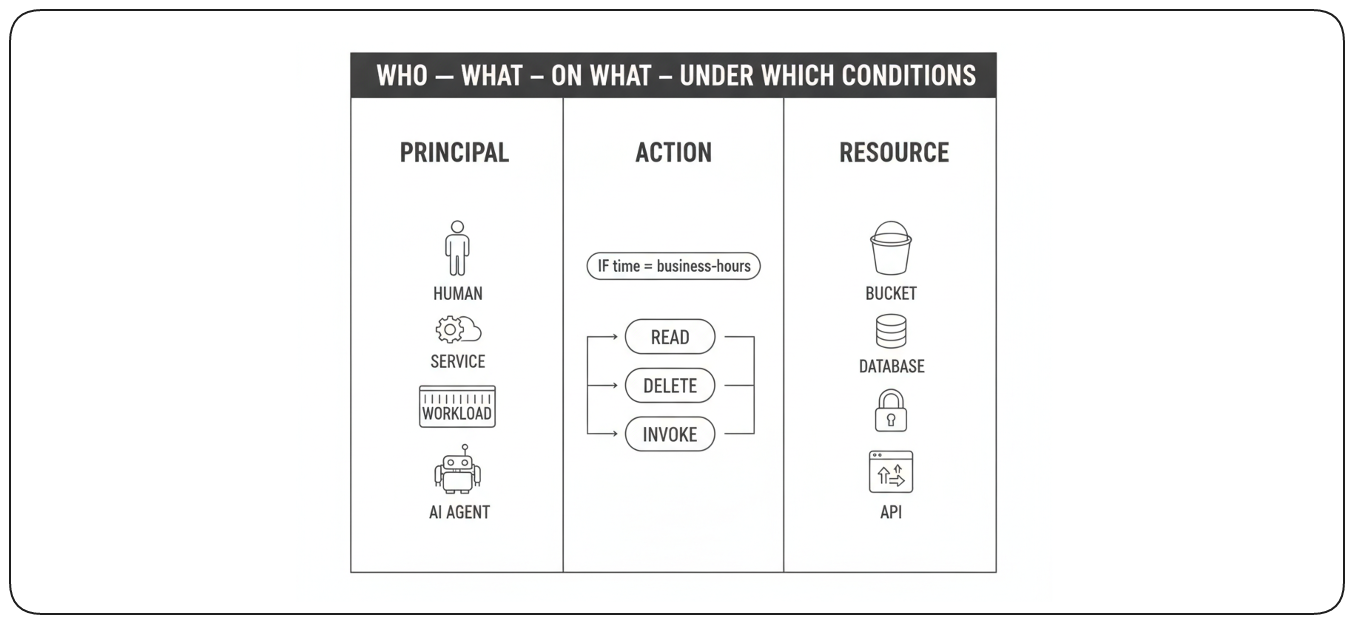
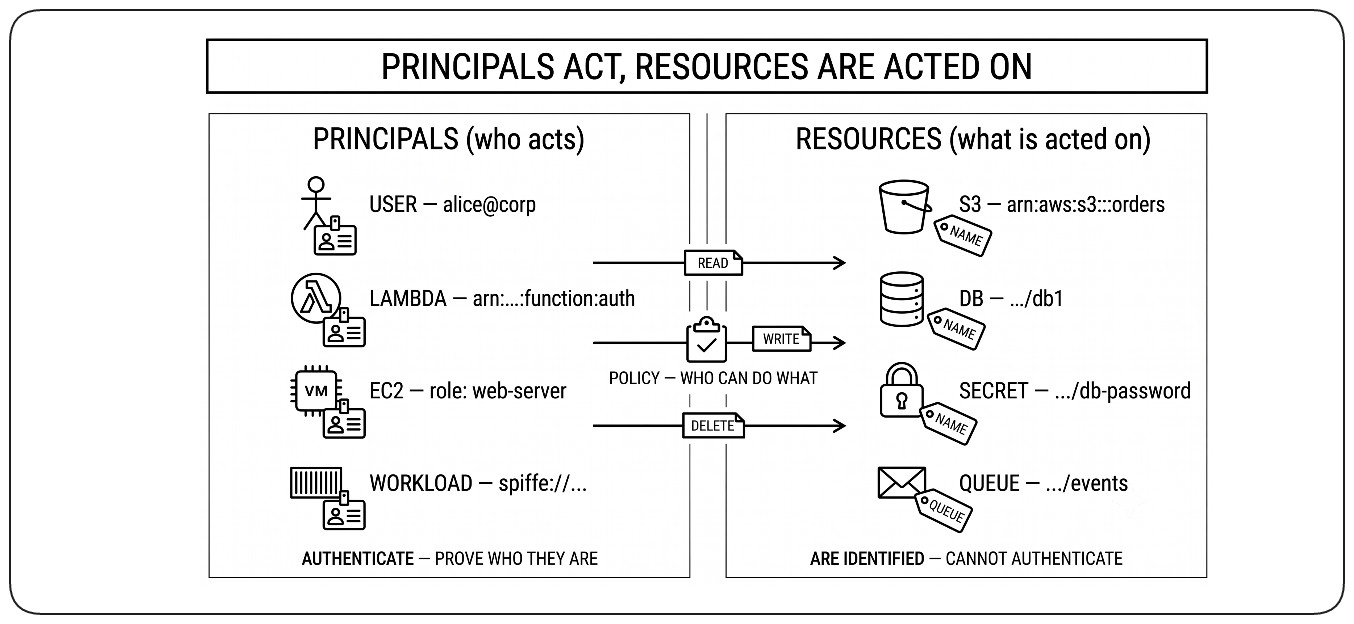
Chaque décision d’autorisation évalue les mêmes éléments fondamentaux : qui fait la requête, ce qu’il veut faire, et sur quoi. Le principal est l’acteur qui demande l’accès — un humain, un service, un workload, un appareil ou un agent IA. L’action est l’opération demandée, comme read, write, delete, invoke ou assumeRole. La ressource est l’objet auquel on accède : un fichier, un bucket, une base de données, une API, un secret ou un service cloud. Des conditions comme l’heure, le réseau, la posture de l’appareil ou la localisation peuvent aussi influencer la décision. !!L’autorisation évalue toujours un principal qui effectue une action sur une ressource.!!
RBAC — contrôle d’accès basé sur les rôles
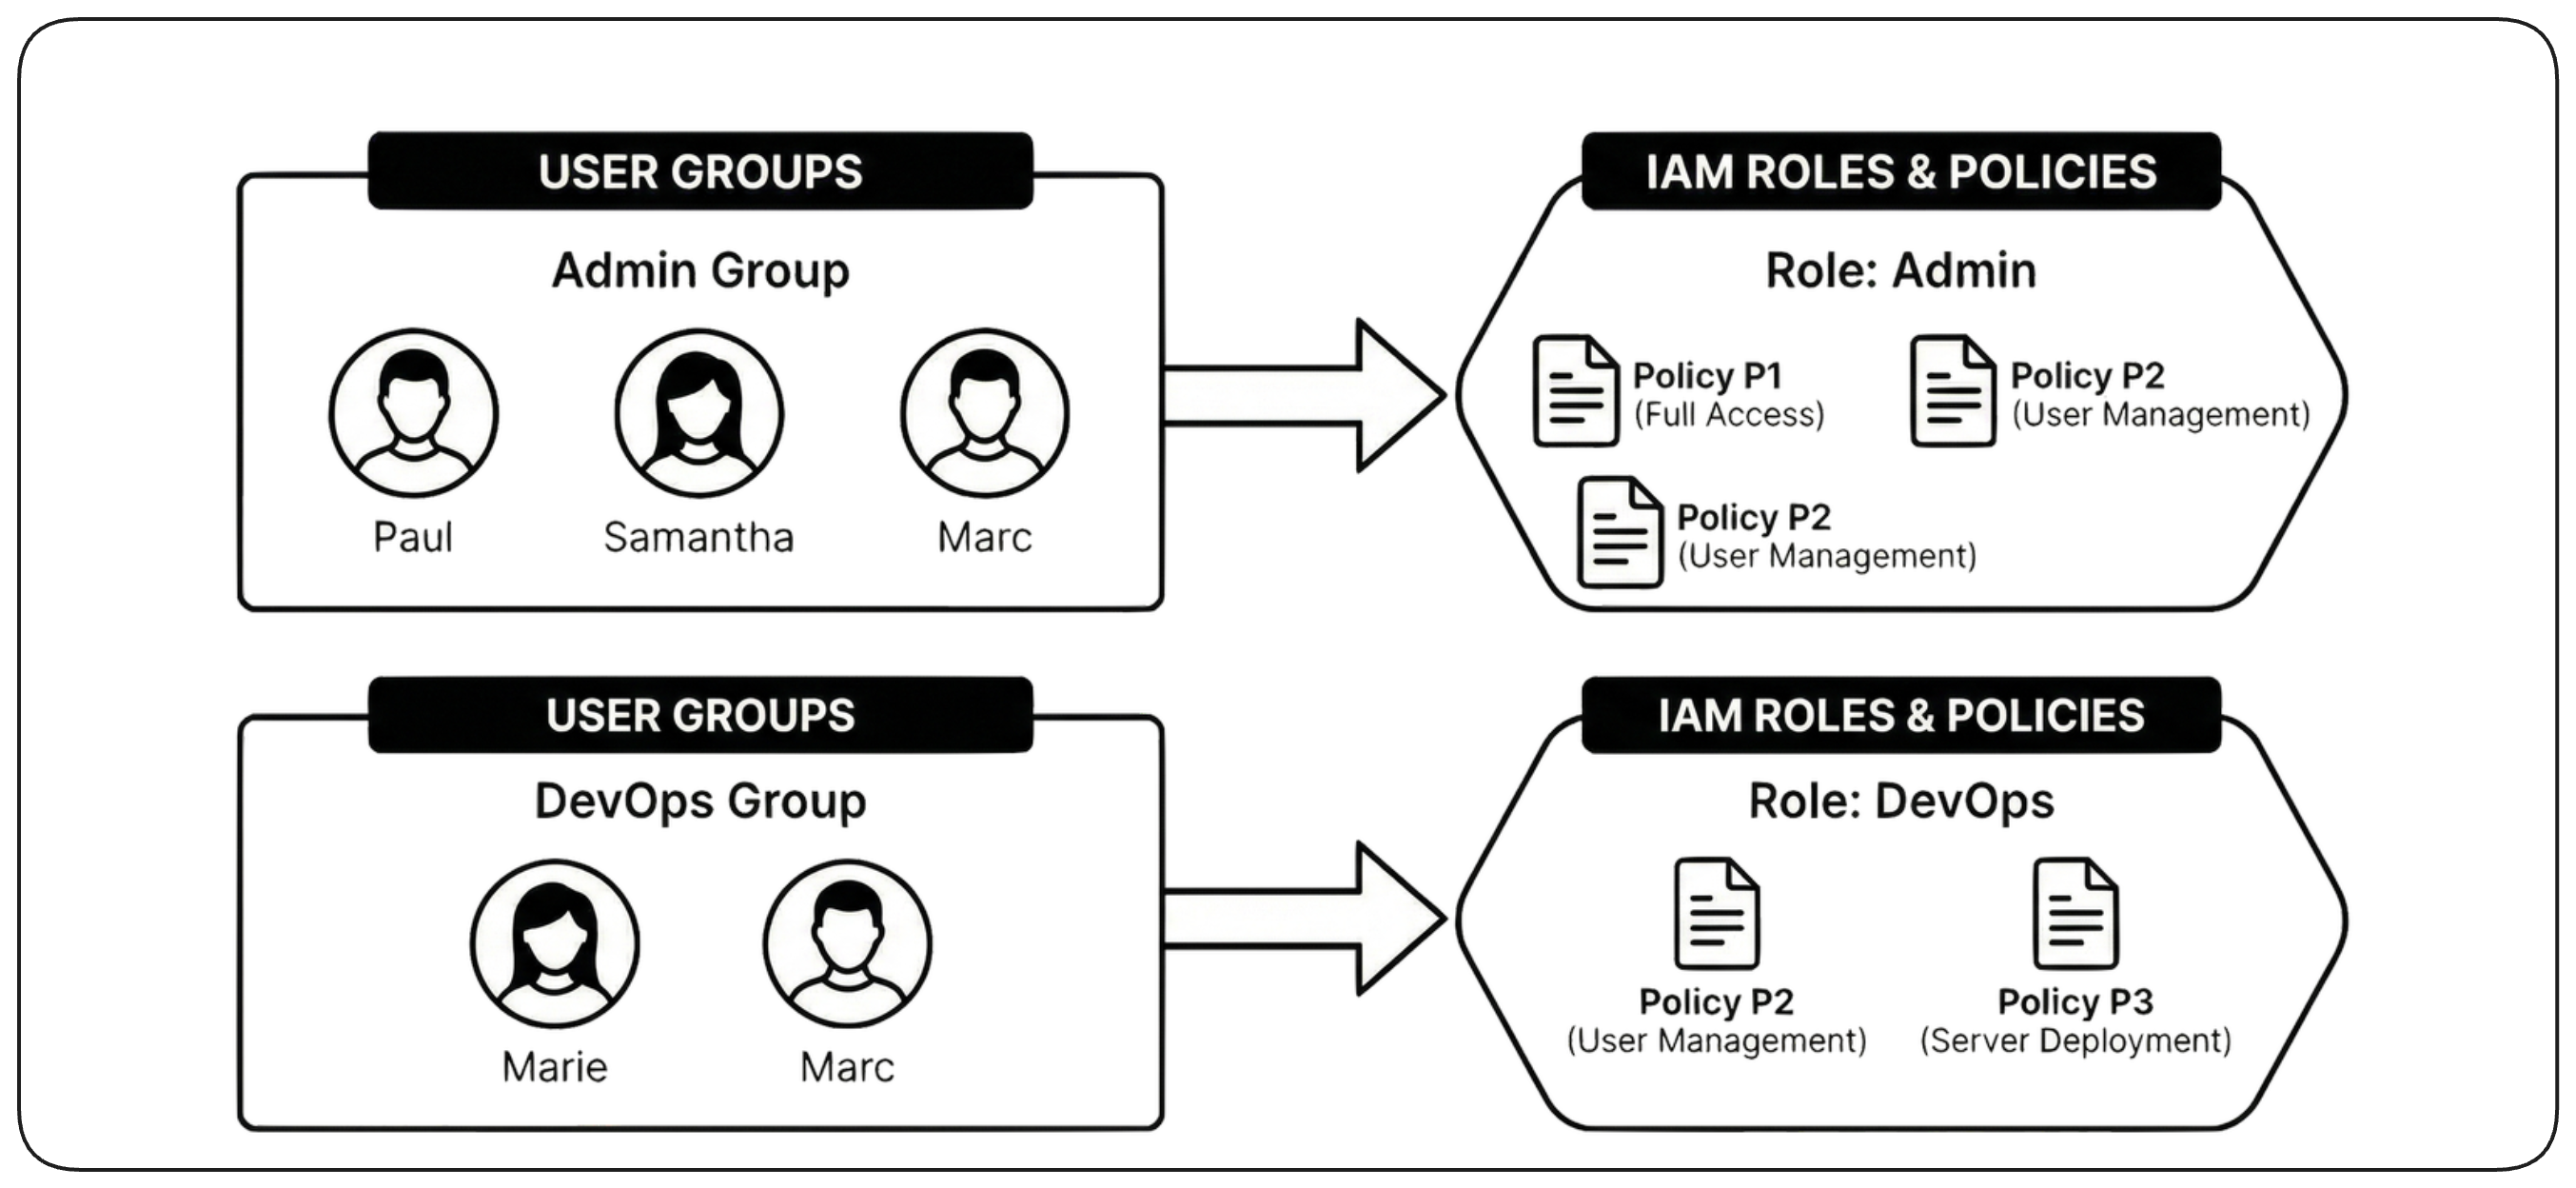
Le contrôle d’accès basé sur les rôles (RBAC) accorde les permissions par des rôles prédéfinis plutôt que directement aux utilisateurs ou aux services. Un principal reçoit d’abord un ou plusieurs rôles, et ces rôles déterminent les opérations qu’il peut effectuer. Le RBAC est simple, prévisible et facile à auditer, ce qui explique pourquoi c’est le modèle d’autorisation dominant dans les systèmes d’entreprise. Sa principale limite est la flexibilité : à mesure que les organisations grandissent, les rôles se multiplient ou deviennent trop larges pour absorber les exceptions. !!Le RBAC attribue les permissions selon les responsabilités, pas selon les individus.!!
ABAC — contrôle d’accès basé sur les attributs
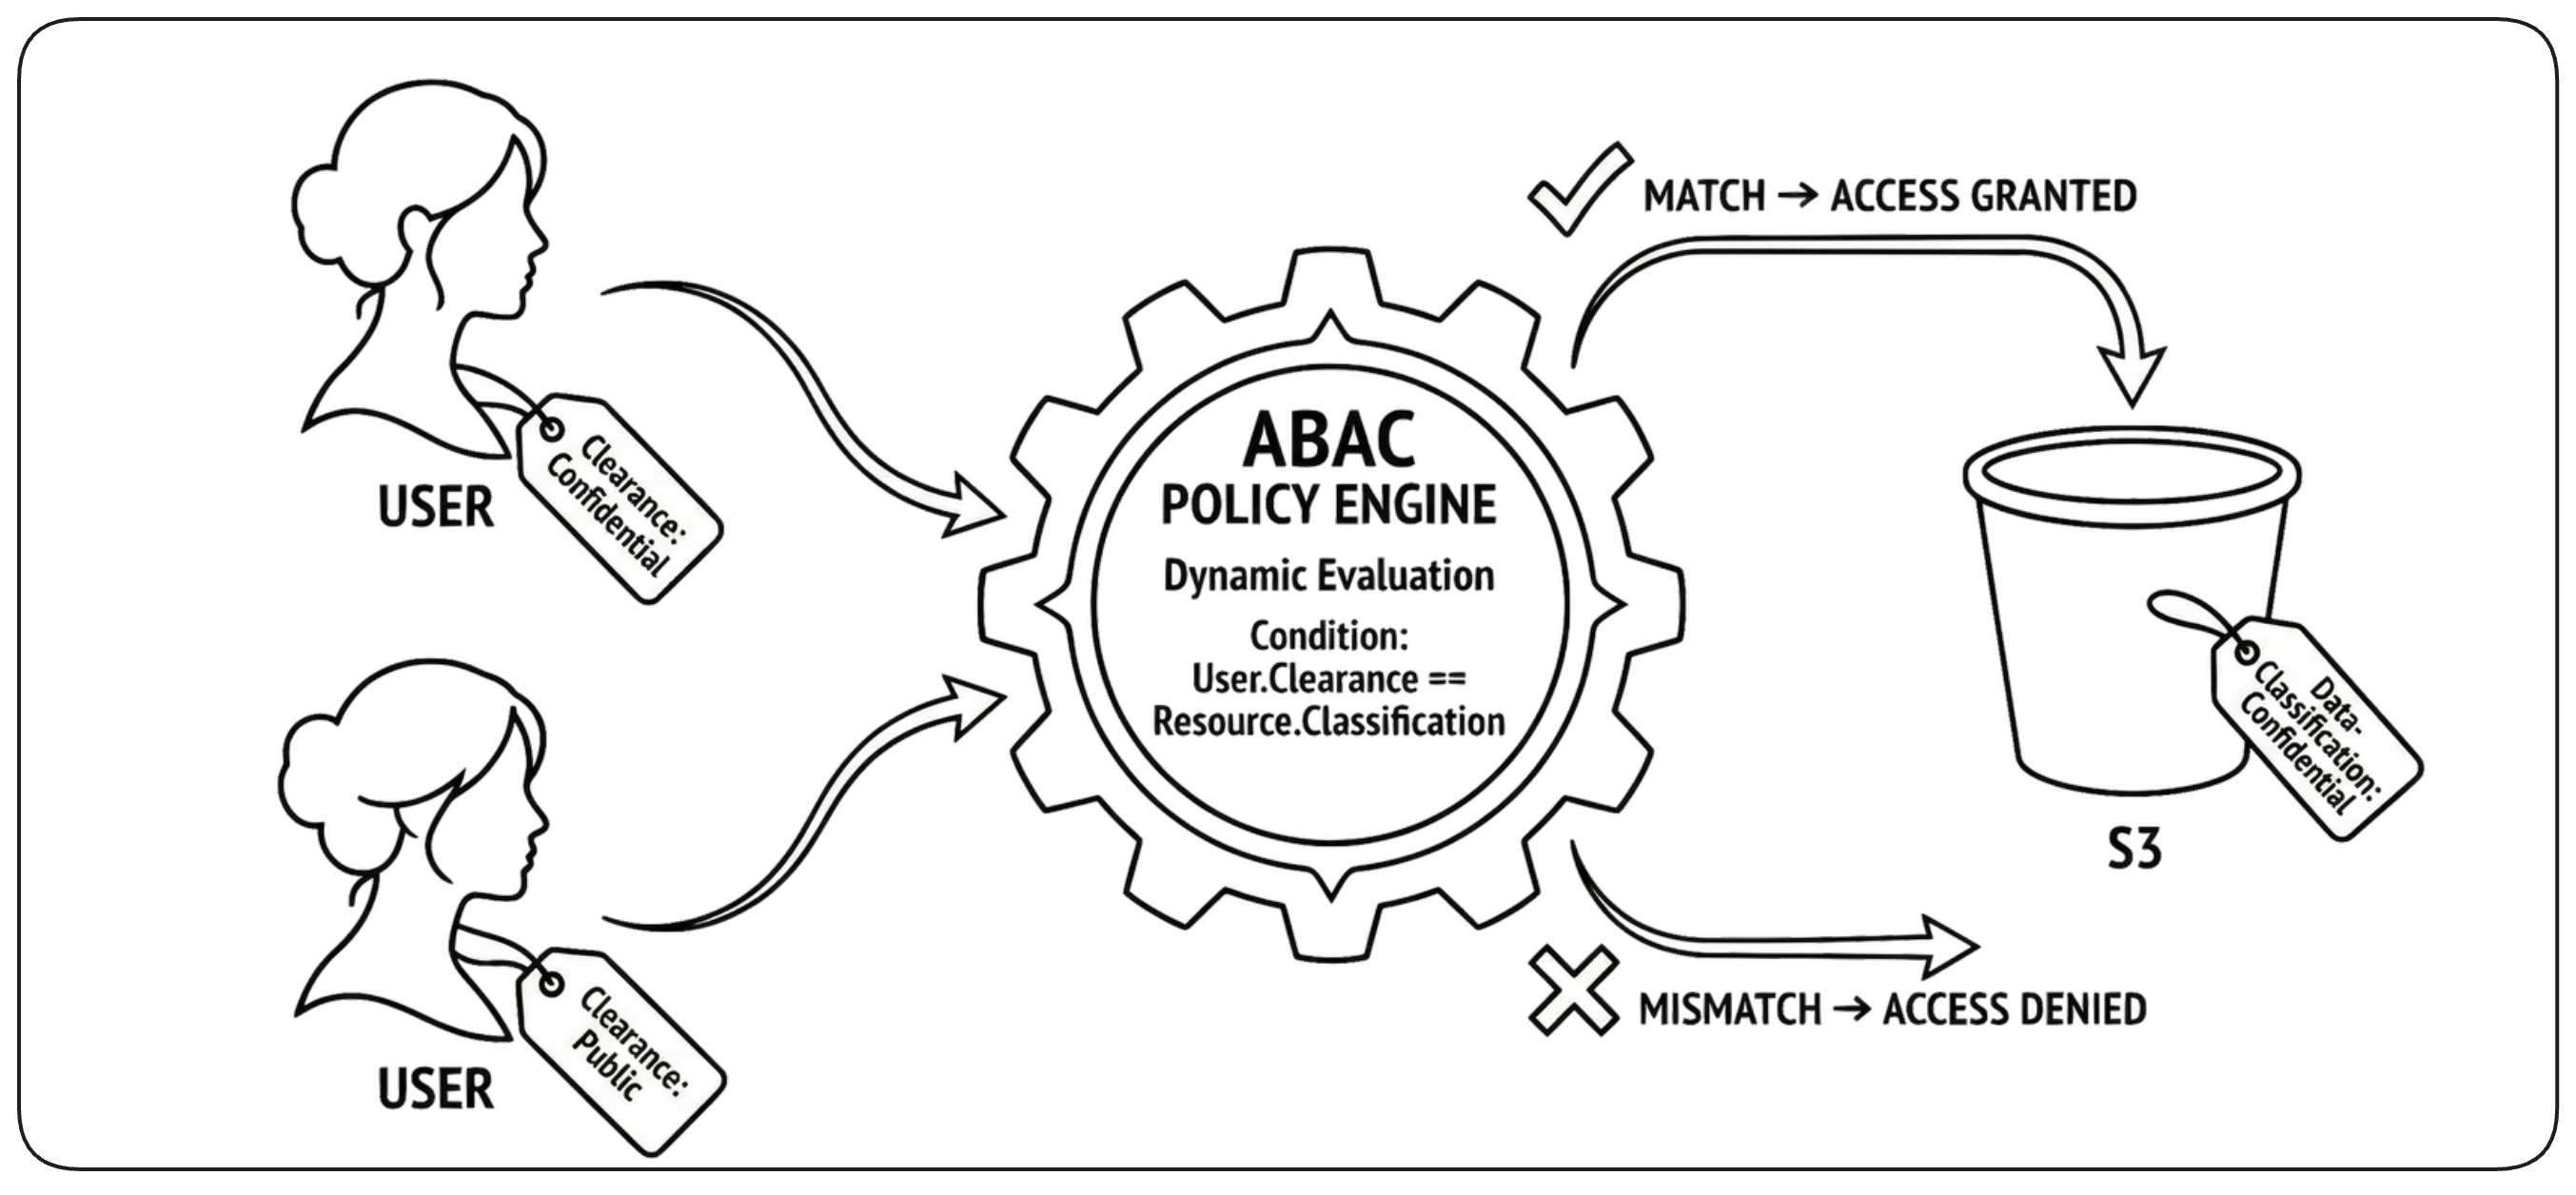
Le contrôle d’accès basé sur les attributs (ABAC) évalue les politiques à partir des attributs disponibles au moment de la requête, plutôt que de s’appuyer uniquement sur une appartenance fixe à un rôle. Les politiques peuvent prendre en compte les attributs du principal (département, habilitation), de la ressource (classification, propriétaire), de l’environnement (heure, réseau, appareil) et même de l’action demandée. Cela rend l’ABAC nettement plus flexible que le RBAC et particulièrement adapté aux environnements vastes et dynamiques. Au lieu de demander « Alice a-t-elle le rôle Administrateur ? », l’ABAC demande « La requête actuelle satisfait-elle la politique ? » !!Le RBAC accorde les permissions via des rôles prédéfinis ; l’ABAC les calcule à partir du contexte courant.!!
L’autorisation peut être demandée
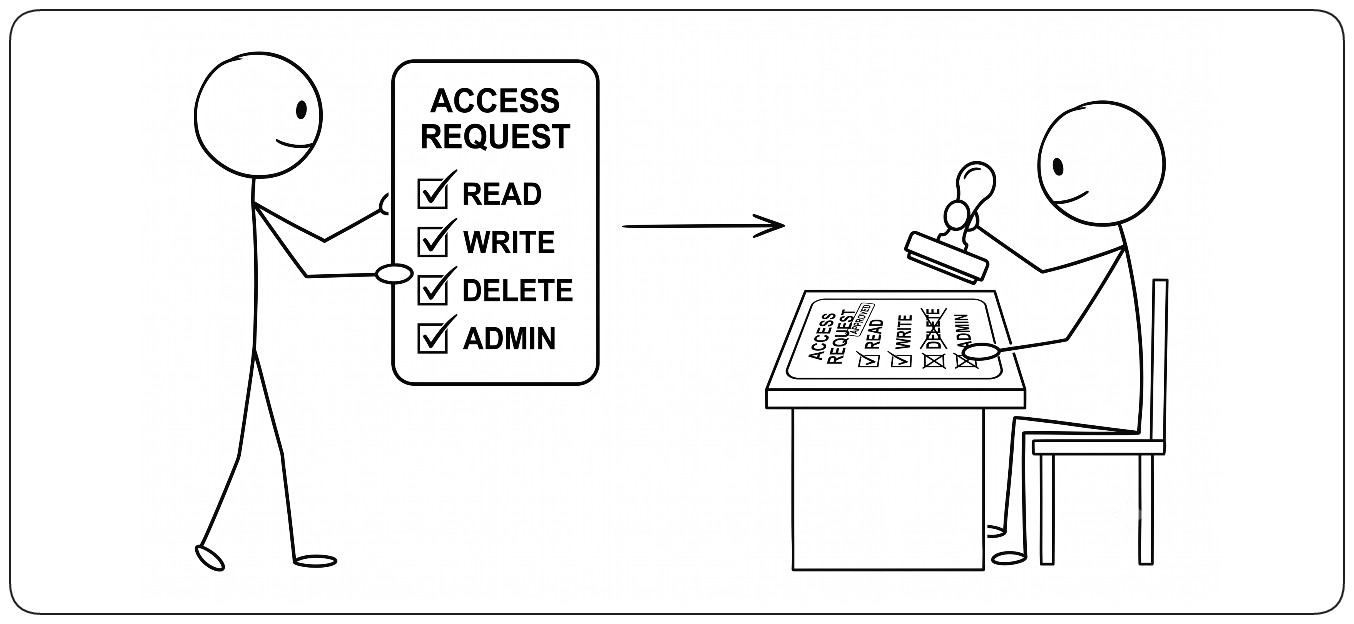
L’autorisation n’est pas toujours attribuée à l’avance. Une application peut demander la permission d’effectuer une opération précise au moment où elle en a besoin. L’autorité d’autorisation évalue cette demande et n’accorde que l’accès permis par la politique, l’approbation d’un administrateur, le consentement de l’utilisateur ou d’autres règles d’autorisation. !!Le demandeur décrit l’accès dont il a besoin ; l’autorité d’autorisation décide de ce qui est accordé.!!
Séparer la politique de son application
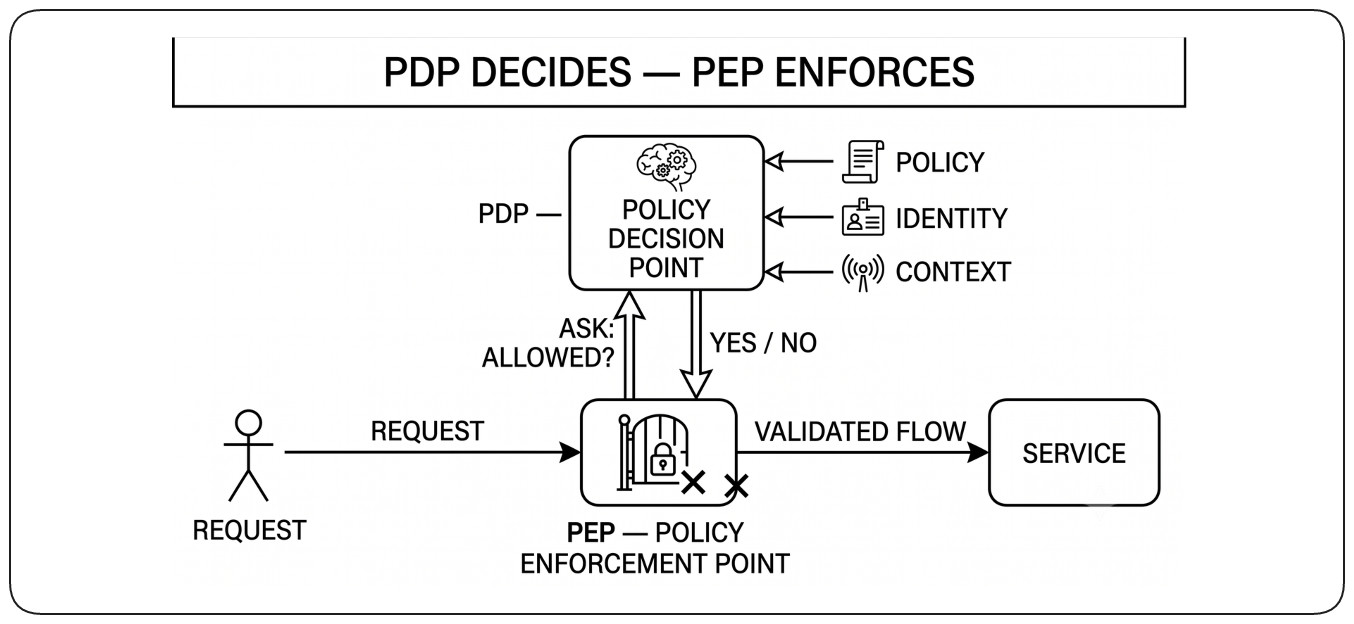
L’autorisation a deux responsabilités distinctes : décider si une action doit être permise, et appliquer cette décision. !!Les séparer ne signifie pas appeler un service central à chaque requête!! — les politiques peuvent être rédigées de façon centralisée, distribuées à de nombreux points d’application, mises en cache localement, ou embarquées dans des service meshes et des API gateways. Ce qui compte n’est pas l’endroit où la décision s’exécute, mais que la politique reste indépendante du composant qui l’applique — pour que les règles puissent changer sans repenser chaque application.
Assembler identité et autorisation
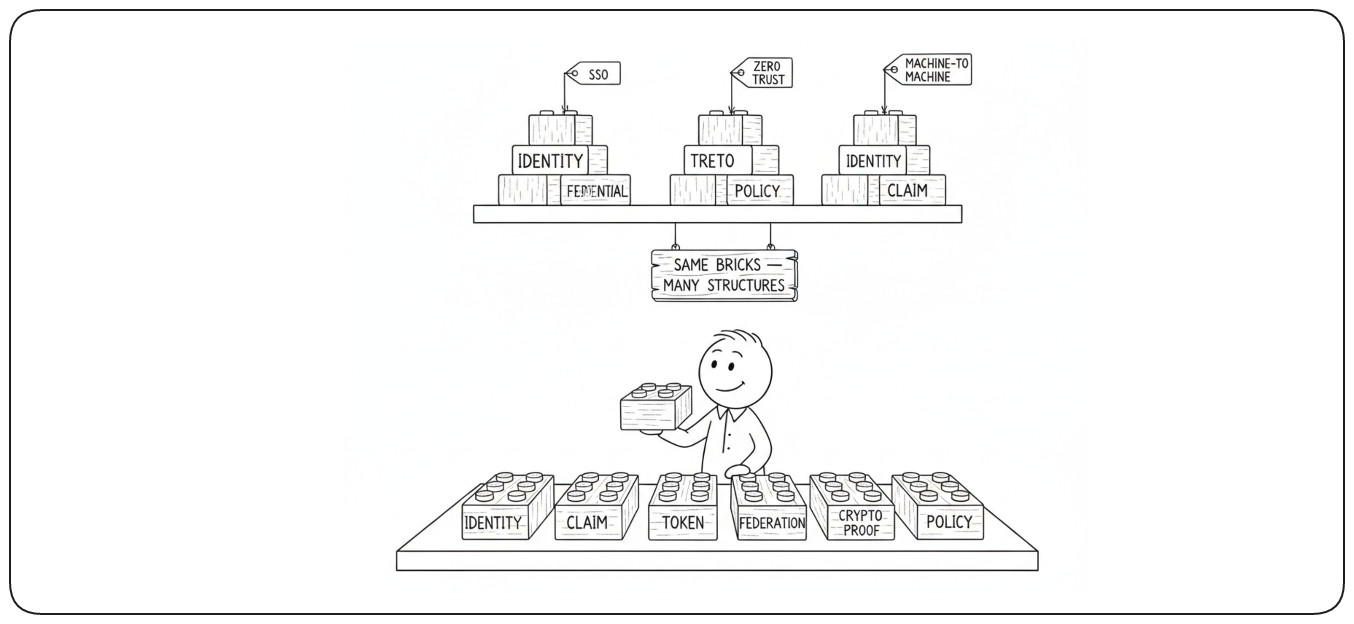
!!L’authentification établit l’identité ; l’autorisation évalue ce que cette identité peut faire.!! Ensemble, elles forment les deux responsabilités de l’IAM. Les systèmes modernes les mettent en œuvre à travers un petit ensemble de mécanismes présentés dans les sections précédentes : identité vérifiable, preuve que le destinataire peut contrôler, fédération et politique d’autorisation. !!La section suivante montre comment les plateformes cloud transforment ces concepts en un plan de contrôle IAM unifié.!!
L’identité comme infrastructure de plateforme
Les sections précédentes décrivaient l’IAM indépendamment de tout fournisseur. Les fournisseurs cloud modernes conditionnent ces mêmes concepts dans des plateformes IAM intégrées — l’environnement concret où la plupart des systèmes modernes tournent réellement. Chaque grand cloud implémente le même modèle de gestion des identités et des accès, avec des API différentes mais les mêmes primitives. Chaque utilisateur et chaque workload devient un principal, et chaque ressource reçoit un identifiant canonique que les politiques peuvent référencer — si bien qu’un seul ensemble de règles gouverne l’accès au calcul, au stockage, au réseau et à tous les autres services cloud.
Les opérations sensibles appartiennent aux environnements de confiance
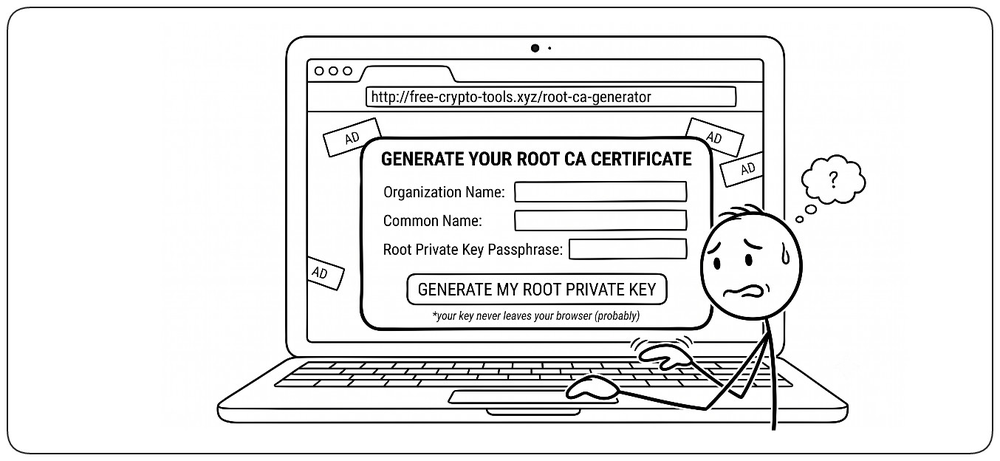
Toute opération ne doit pas être effectuée là où elle prend naissance. Quand une opération implique des données sensibles, des identifiants privilégiés, des décisions de sécurité ou des identités de confiance, !!privilégiez son exécution dans un backend de confiance plutôt que dans du code côté client!! — une page web quelconque qui demande à l’utilisateur de générer lui-même dans le navigateur son certificat de CA racine et sa clé privée est le cas extrême de ce qu’il ne faut pas faire. Un backend de confiance peut s’authentifier, appliquer les politiques, protéger les éléments sensibles et garder la logique critique pour la sécurité sous votre contrôle. Laissez le client dialoguer avec l’utilisateur ; laissez les systèmes de confiance faire le travail sensible.
Services IAM
Chaque grand fournisseur cloud conditionne la gestion des identités et des accès dans un modèle centralisé. AWS IAM combine principals, rôles et politiques dans un seul service. Azure scinde le sujet : Microsoft Entra ID gère les identités et l’authentification, tandis qu’Azure RBAC gère l’autorisation sur les ressources. Google Cloud IAM associe des principals à des rôles sur des ressources. À l’intérieur du cloud, les identités sont déjà établies et gérées par la plateforme — la tâche principale de l’IAM est donc l’autorisation : définir quels principals peuvent effectuer quelles actions sur quelles ressources. !!L’IAM agit comme le plan de contrôle qui définit principals, rôles et politiques pour les utilisateurs, les workloads et l’infrastructure!! — de sorte que chaque demande d’accès, qu’un utilisateur ouvre la console, qu’un service appelle une API ou qu’une application lise dans un stockage, est évaluée selon le même modèle d’autorisation.
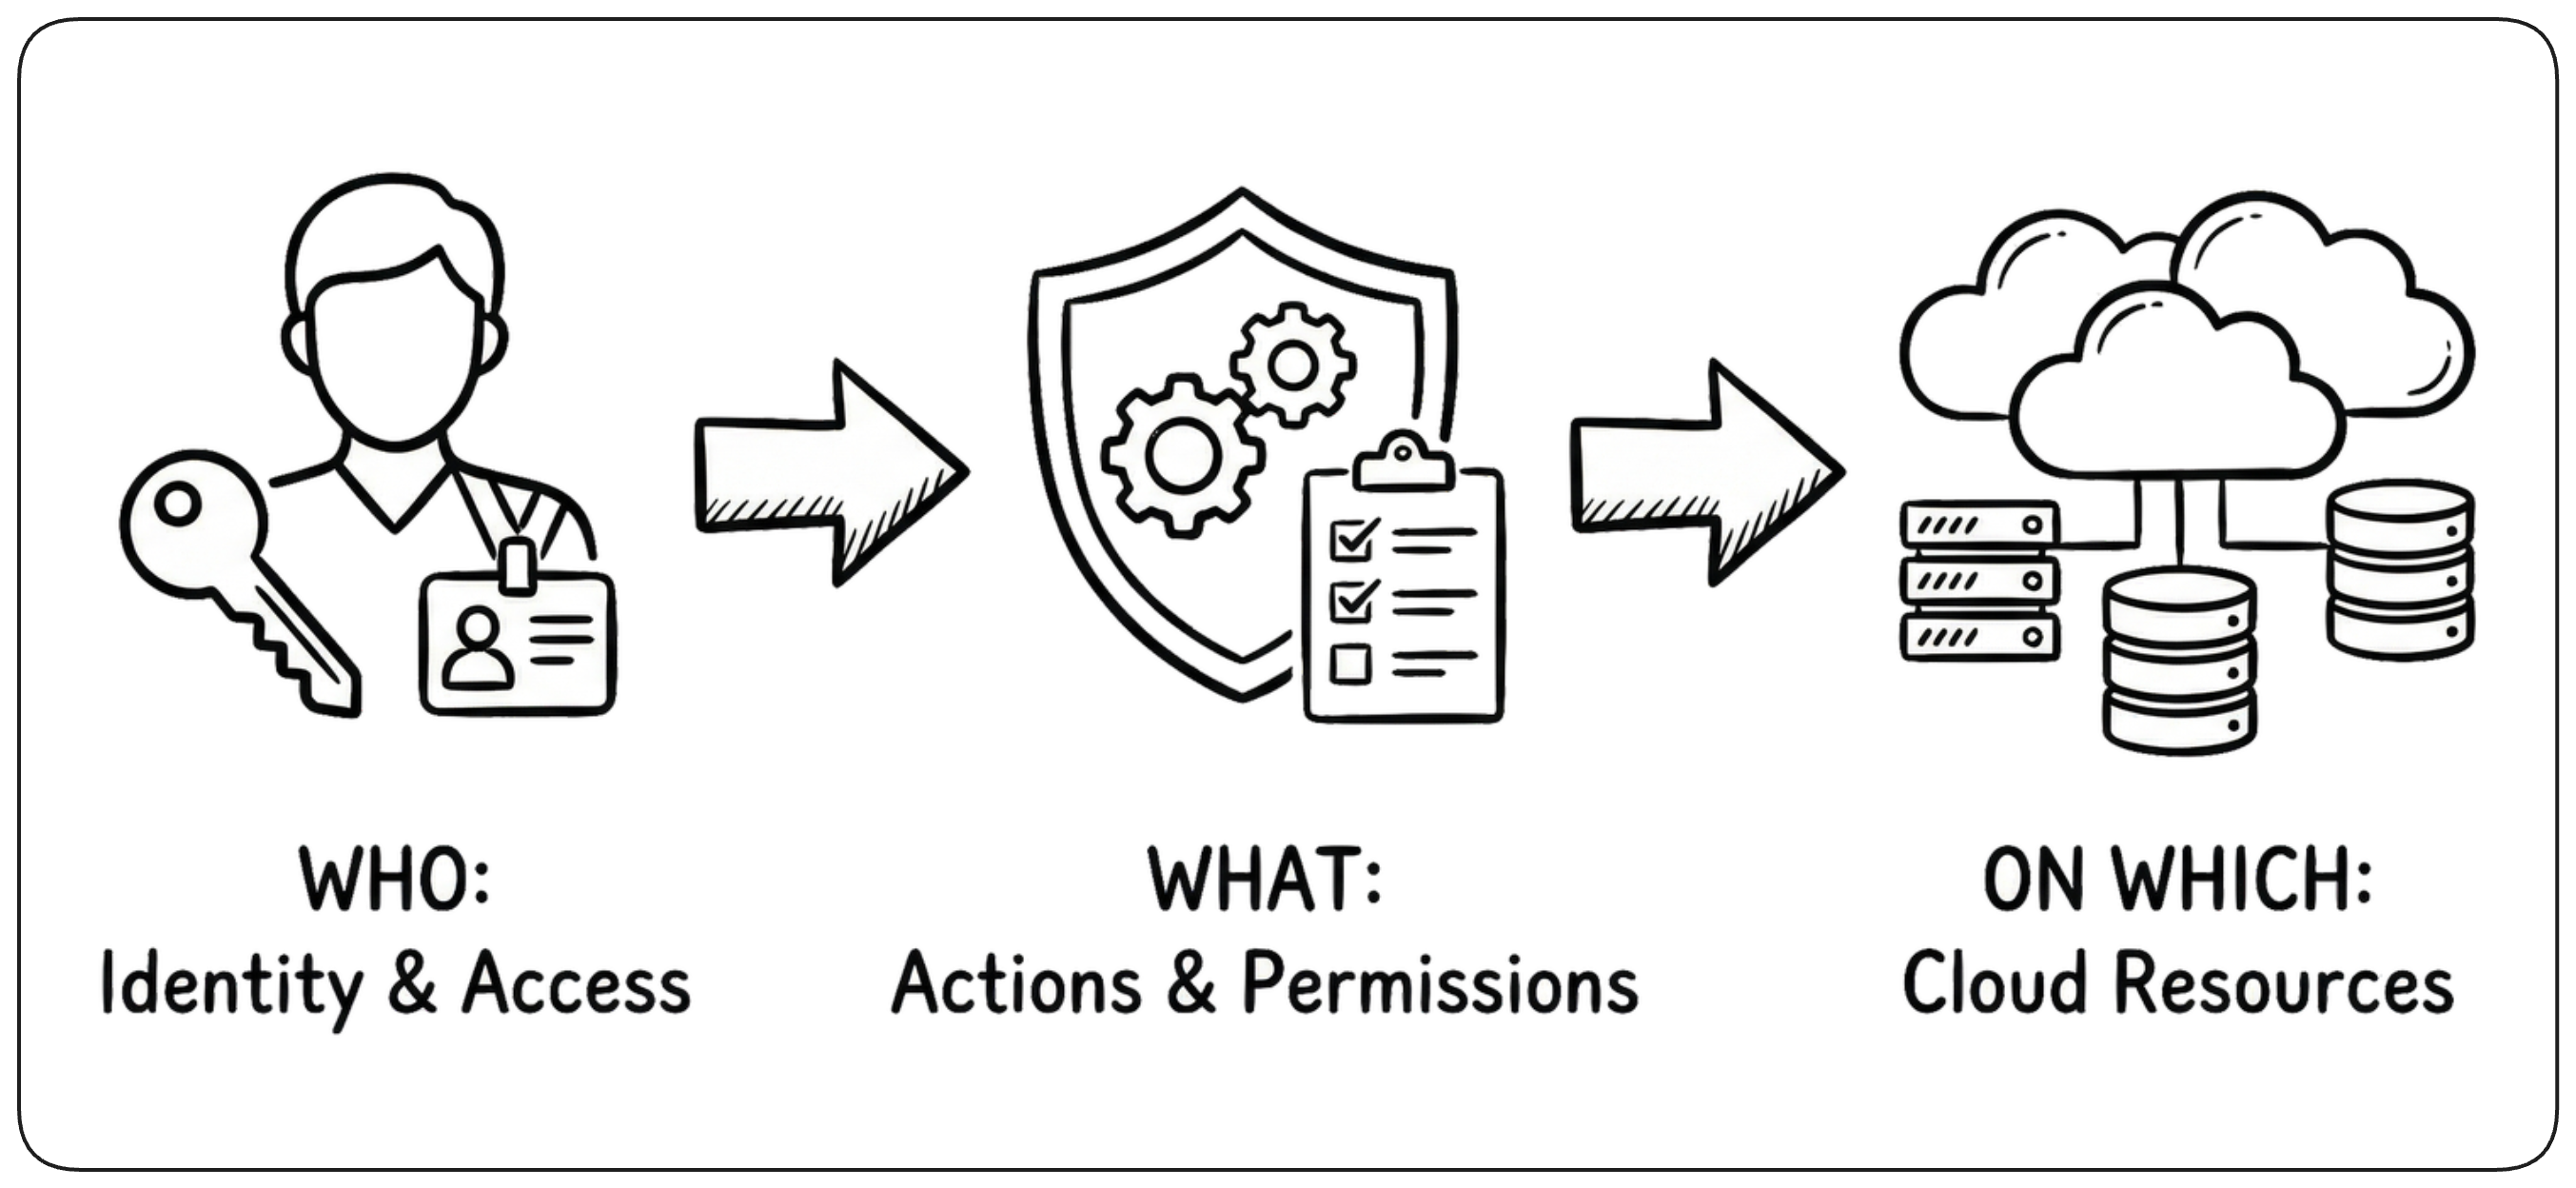
L’identité devient infrastructure
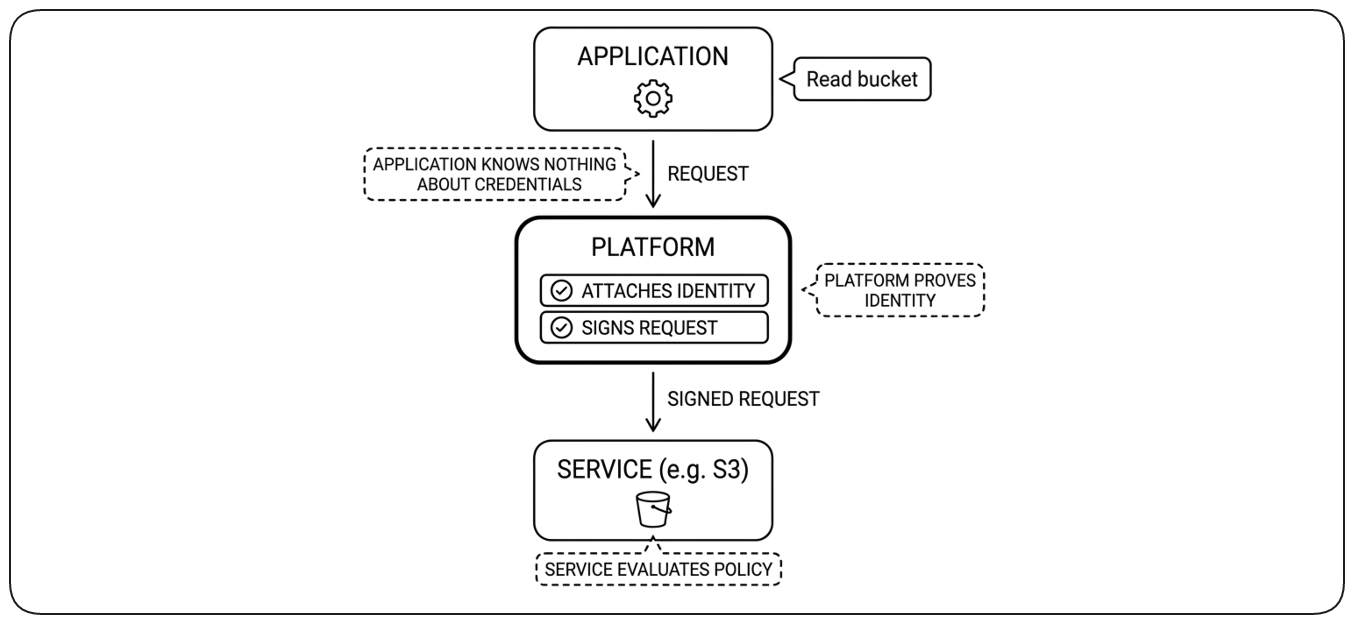
!!Les plateformes cloud font de l’authentification une préoccupation d’infrastructure.!! Chaque workload peut recevoir une identité managée, et la plateforme peut prouver cette identité quand le workload appelle un service pris en charge. Quand une Lambda appelle S3, ou qu’une VM appelle un autre service, la plateforme attache l’identité et signe la requête avec des identifiants qu’elle gère — l’application ne stocke jamais d’identifiants, ne signe jamais rien, n’implémente jamais elle-même l’authentification. Chaque requête porte donc une identité vérifiable sur laquelle l’autorisation et l’audit peuvent s’appuyer — et la même idée revient plus loin dans le chapitre avec l’identité de workload Kubernetes, SPIFFE et mTLS : l’authentification sort du code applicatif pour entrer dans la plateforme elle-même.
Les plateformes cloud donnent à chaque principal et à chaque ressource un nom canonique
Les plateformes cloud rendent le modèle d’autorisation abstrait concret en attribuant des identifiants canoniques à chaque principal et à chaque ressource. !!Chaque Lambda, instance EC2, service account, bucket, base de données, secret et file reçoit un identifiant stable dans l’espace de noms de compte, de tenant ou de projet du fournisseur, que les politiques peuvent référencer directement!! — si bien que les règles d’autorisation décrites en théorie peuvent être écrites, déployées et auditées à grande échelle sans couche de nommage personnalisée entre les deux.
Protocoles ouverts pour la confiance humaine
Les protocoles ouverts permettent aux applications d’établir l’identité d’un humain sans manipuler elles-mêmes ses principaux identifiants réutilisables. Certains délèguent l’authentification à un fournisseur d’identité de confiance ; d’autres remplacent les mots de passe par une preuve cryptographique. !!Les protocoles ouverts séparent l’identité, la preuve cryptographique et la session tout en gardant les identifiants réutilisables hors des applications.!!
OIDC et SAML : protocoles de connexion fédérée
OIDC et SAML sont deux protocoles standards qui permettent à une application d’authentifier des utilisateurs via un fournisseur d’identité de confiance. Au lieu de collecter elle-même les identifiants, l’application redirige l’utilisateur vers l’IdP, qui l’authentifie et le redirige en retour avec une réponse signée confirmant son identité — la fameuse expérience « Se connecter avec Google », que le fournisseur soit Google, Microsoft, Apple ou un IdP d’entreprise. Après avoir validé la réponse, l’application crée généralement sa propre session locale pour l’utilisateur, distincte de la session maintenue par le fournisseur d’identité. !!OIDC est le choix moderne, basé sur JSON, pour les applications web, mobiles et cloud-native ; SAML est le standard basé sur XML qui domine encore le SSO d’entreprise et le B2B.!!
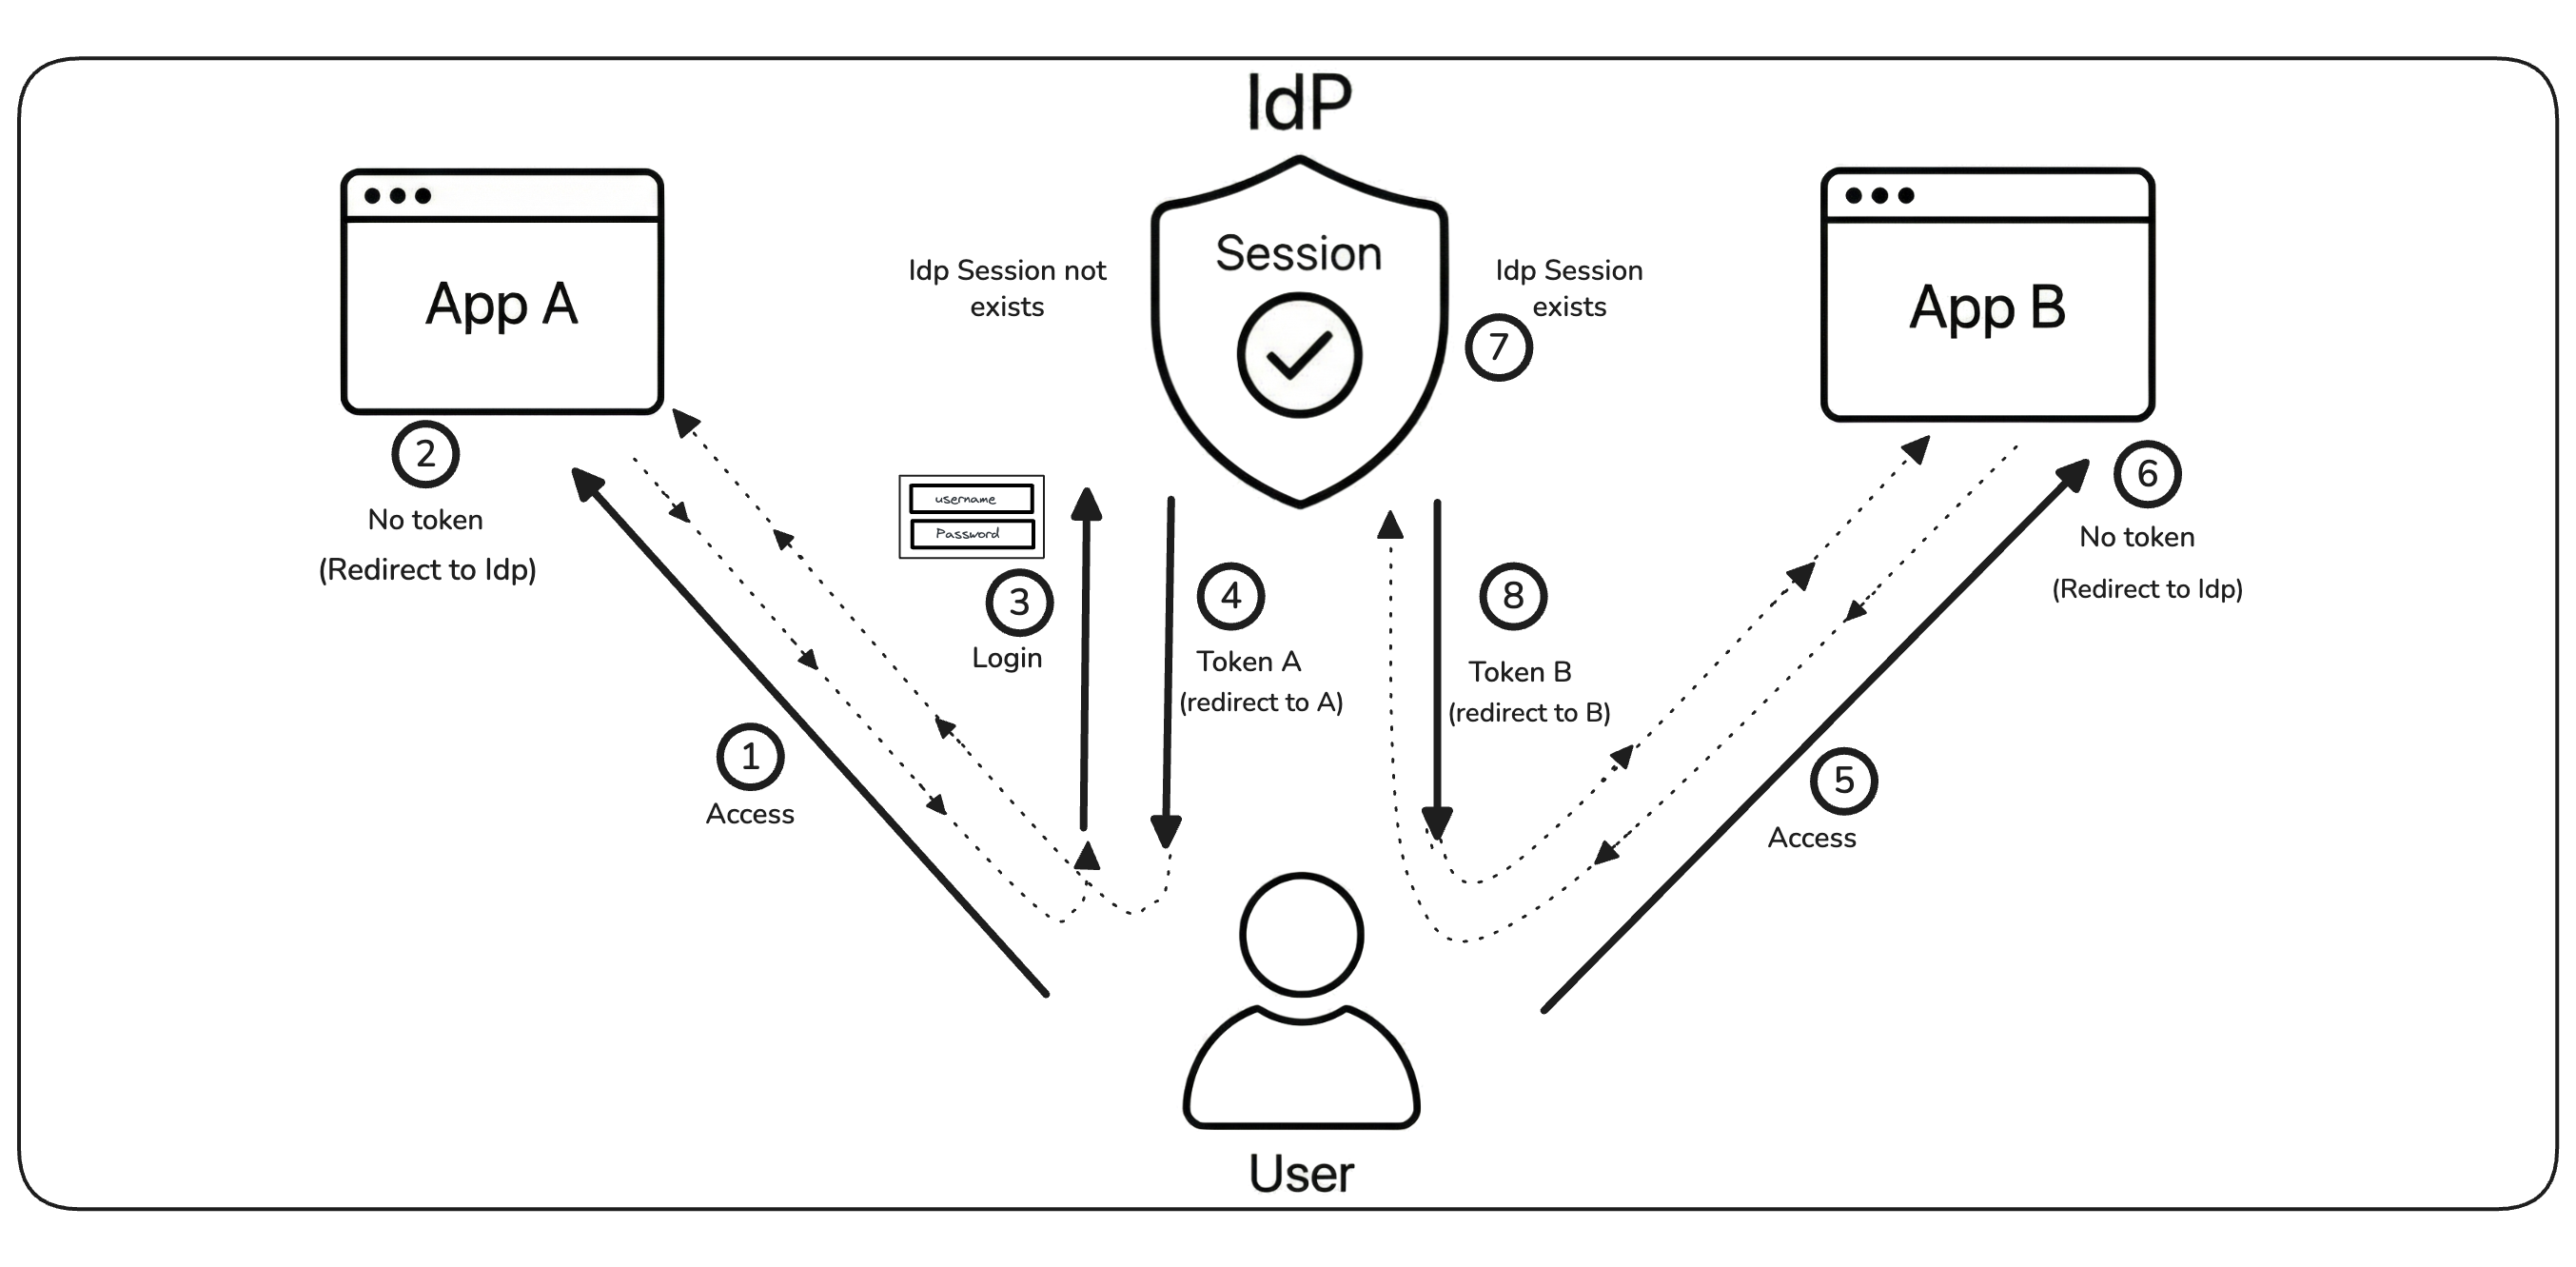
SSO : authentification unique entre plusieurs applications
Le Single Sign-On utilise le même flux de connexion fédérée décrit dans la slide précédente. La différence est que plusieurs applications peuvent réutiliser la même session établie avec le fournisseur d’identité. Tant que cette session IdP reste valide, l’utilisateur peut accéder à toutes ces applications sans s’authentifier à nouveau. L’IdP envoie une réponse d’authentification distincte à chaque application, et chaque application crée sa propre session locale. !!Une seule session IdP permet plusieurs sessions applicatives indépendantes.!!
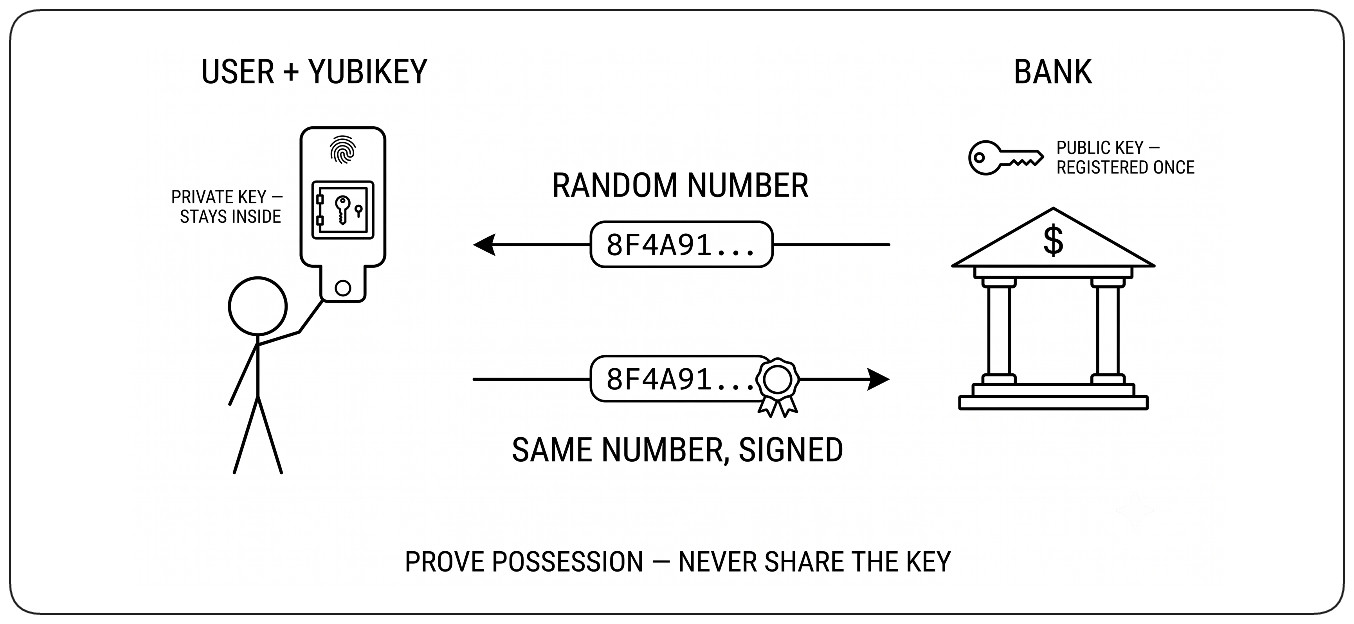
WebAuthn/Passkeys : authentification des utilisateurs sans mot de passe
La plupart des fournisseurs d’identité authentifient encore les utilisateurs par mot de passe, souvent combiné à la MFA. WebAuthn — et les passkeys qui s’appuient dessus — remplacent le mot de passe partagé par une preuve de possession. Un appareil tel qu’un téléphone, un laptop ou une clé de sécurité détient une clé privée et signe un nombre aléatoire frais envoyé par le site, que le site vérifie avec la clé publique. La preuve est liée à l’origine légitime du site, ce qui rend les passkeys résistantes au phishing. !!La clé privée ne quitte jamais l’appareil.!!
Protocoles ouverts pour l’autorisation déléguée
L’authentification répond à qui est l’utilisateur ? L’autorisation déléguée répond à une autre question : que peut faire une autre application au nom de cet utilisateur ? Plutôt que de partager vos mots de passe avec chaque application qui a besoin d’accéder à vos données, vous accordez à chacune une autorisation limitée et révocable d’agir pour vous. !!L’autorisation déléguée garde les identifiants auprès du service qui authentifie l’utilisateur et ne donne aux applications que l’accès restreint et limité dans le temps dont elles ont réellement besoin.!!
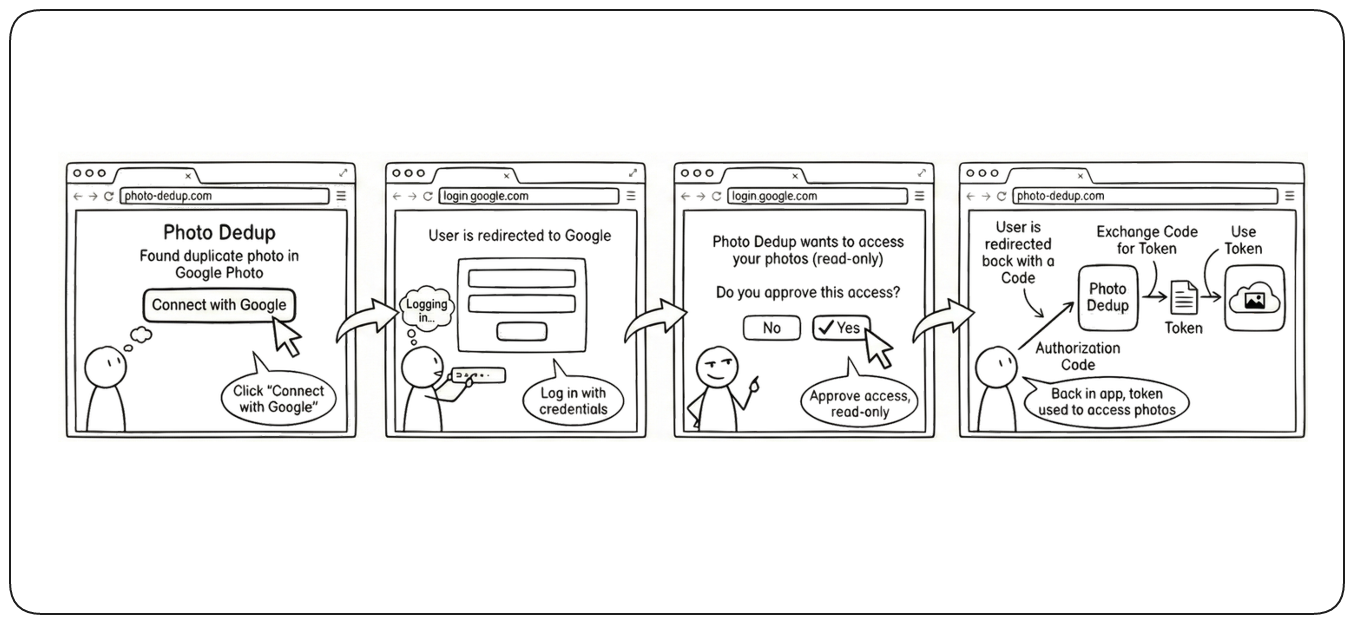
OAuth : accès délégué à vos données
OAuth permet à une application d’accéder à des ressources gérées par un autre service sans recevoir le mot de passe de l’utilisateur — par exemple, un service d’impression de photos qui accède à des photos stockées dans le cloud. La métaphore est celle de la clé de voiturier : une clé limitée qui permet au voiturier de conduire votre voiture mais pas d’ouvrir le coffre. Vous vous authentifiez directement auprès du service qui détient vos données et approuvez des permissions précises ; l’application demandeuse reçoit un access token limité dans le temps et révocable — jamais votre mot de passe. !!OAuth délègue l’accès ; OIDC ajoute une couche d’identité par-dessus le framework OAuth 2.0.!!
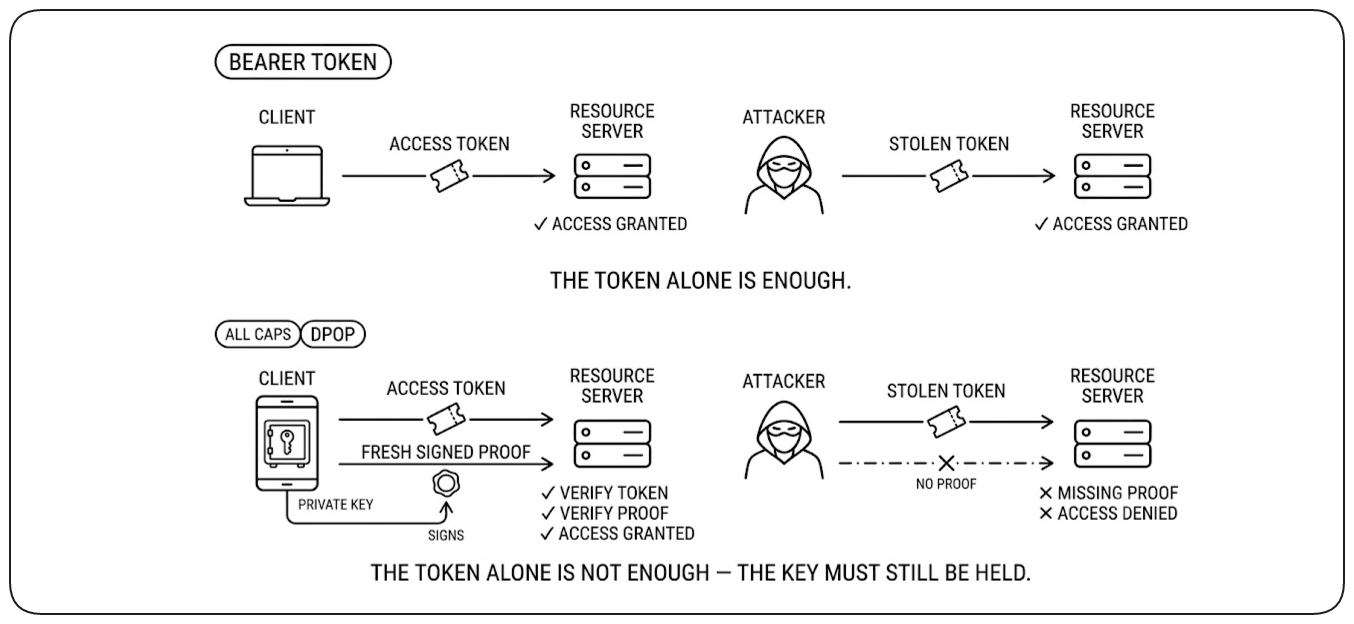
Preuve de possession pour les tokens OAuth
Les access tokens OAuth sont couramment des tokens bearer : quiconque obtient le token peut l’utiliser jusqu’à son expiration — un access token volé peut être rejoué directement contre le serveur de ressources. Des durées de vie courtes limitent les dégâts, sans les éliminer. Les mécanismes de preuve de possession tels que DPoP lient le token à une clé cryptographique générée et détenue par l’instance cliente qui l’a obtenu. Pour chaque requête, cette instance cliente doit produire une nouvelle preuve signée démontrant le contrôle de la clé privée correspondante. Un token volé ne suffit donc plus. !!Le même principe de preuve de possession que WebAuthn utilise pour authentifier un utilisateur est appliqué ici pour protéger l’usage d’un access token OAuth.!!
Protocoles ouverts pour la confiance des workloads
Tout système distribué est rempli de workloads qui communiquent avec d’autres workloads. Contrairement aux humains, les workloads ne peuvent pas ouvrir un navigateur ni effectuer une connexion interactive : !!ils doivent établir la confiance automatiquement à chaque appel.!! Certains présentent des identifiants partagés comme des clés d’API, des mots de passe ou des bearer tokens ; d’autres prouvent leur identité à l’aide de certificats, de requêtes signées ou de tokens fédérés. Dans de nombreux cas, cette preuve sert aussi à autoriser le workload à obtenir une identité ou un rôle temporaire avant d’accéder aux ressources cloud. Les protocoles de workload définissent comment un logiciel établit la confiance, s’authentifie et, si nécessaire, obtient les identifiants dont il a besoin pour agir.
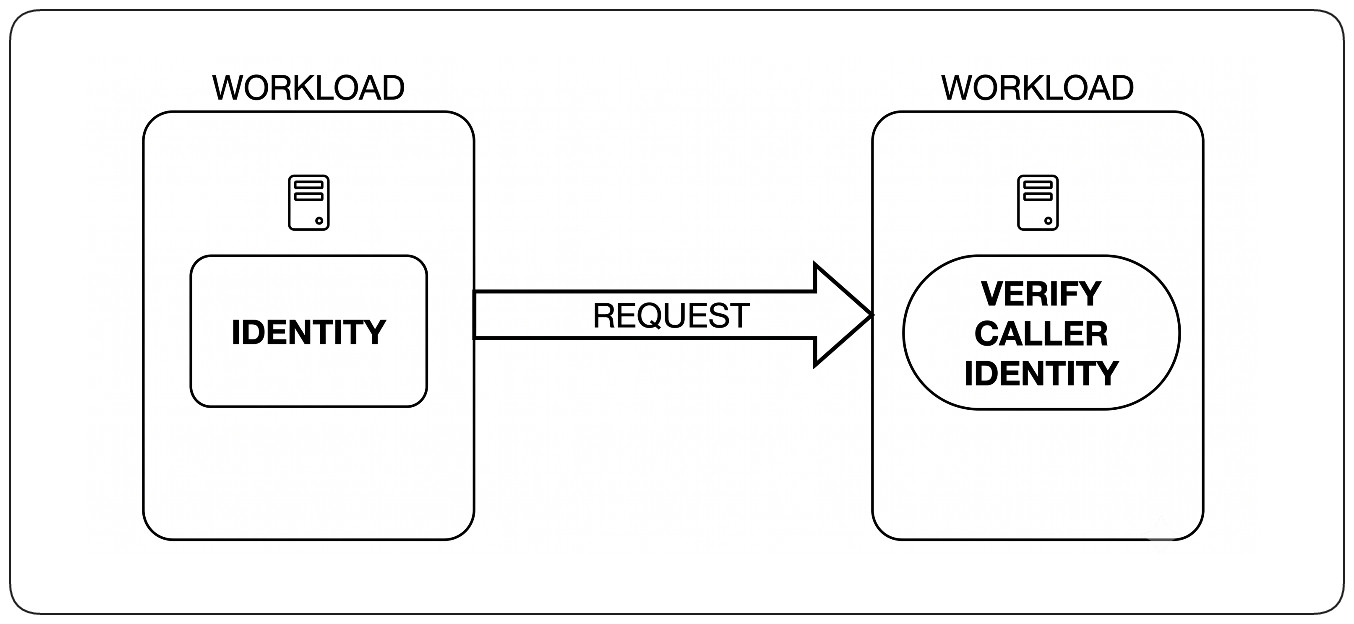
Authentification par secret partagé
De nombreuses interactions entre workloads s’authentifient en présentant un identifiant réutilisable, comme une clé d’API, un mot de passe de service ou un bearer token. Le système récepteur vérifie que l’appelant possède un identifiant valide. !!Simple et toujours très répandu, ce modèle exige que les identifiants soient émis, distribués, stockés, renouvelés et révoqués de façon sécurisée — chaque copie ou lieu de stockage supplémentaire crée un endroit de plus où un identifiant peut fuiter.!!
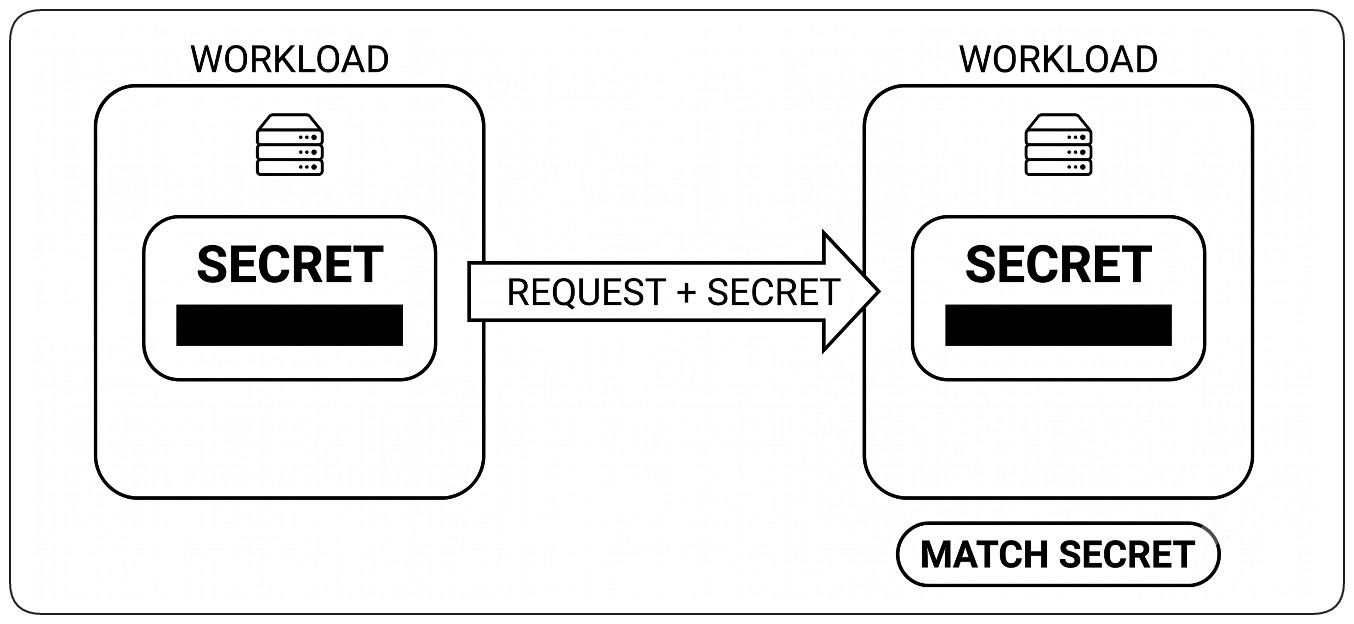
mTLS : authentification mutuelle sans partager de secrets
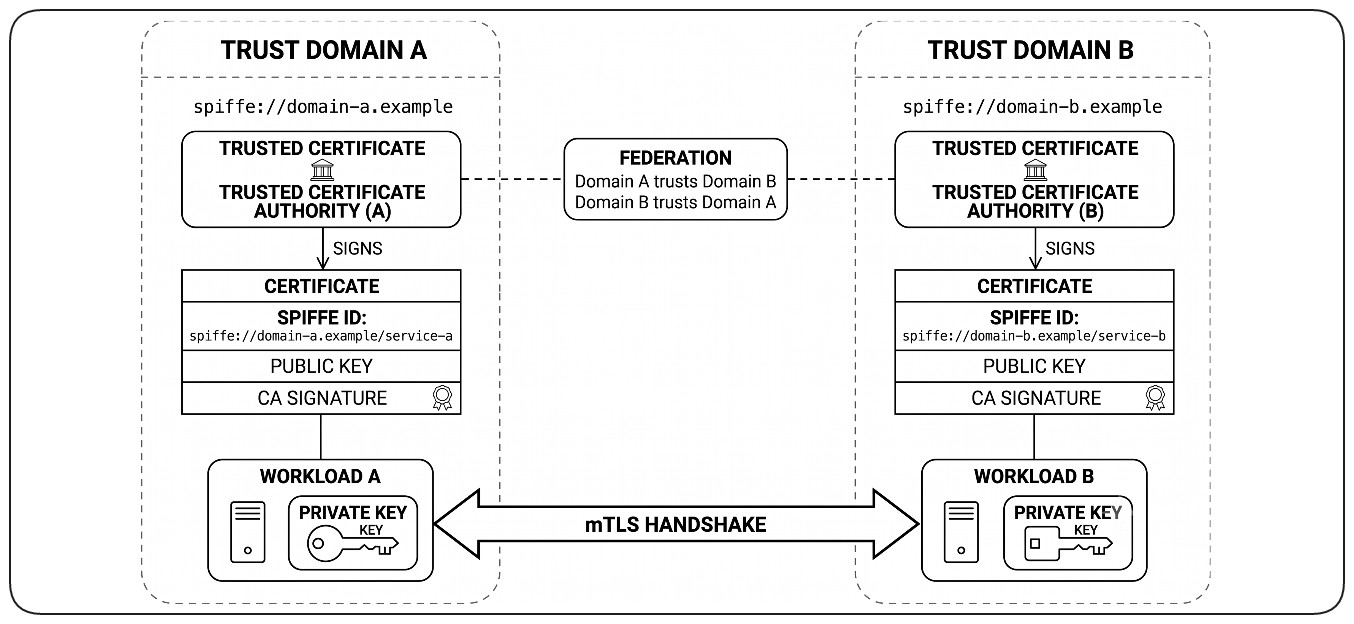
Le TLS standard n’authentifie que le serveur : le client vérifie à qui il parle, mais le serveur n’a aucune preuve cryptographique de l’appelant au niveau transport. Le TLS mutuel étend le handshake pour que les deux pairs présentent des certificats et prouvent le contrôle de leurs clés privées respectives avant tout échange de données applicatives. Une autorité de certification de confiance signe chaque certificat, liant une identité de workload à sa clé publique. Comme les deux pairs font confiance à cette autorité, ils peuvent s’authentifier mutuellement pendant le handshake et établir une clé de session symétrique partagée. Tout le trafic applicatif ultérieur est alors protégé par cette connexion TLS authentifiée, sans clés d’API ni bearer tokens dans les en-têtes de requête
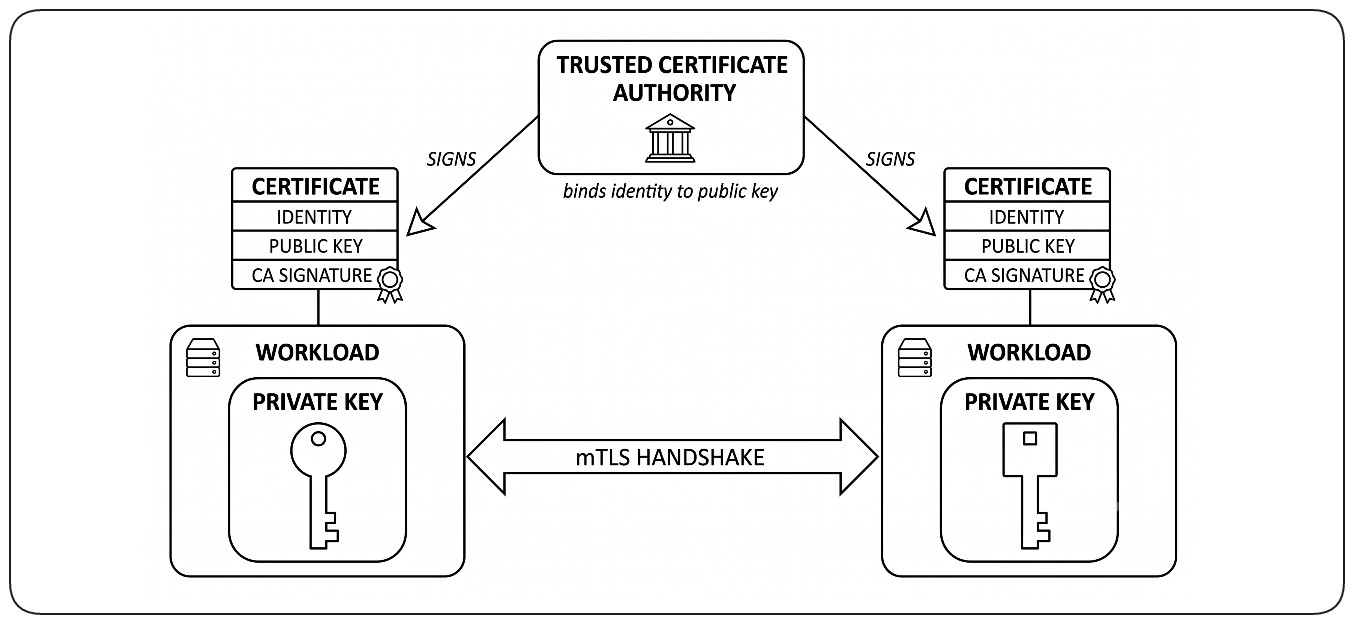
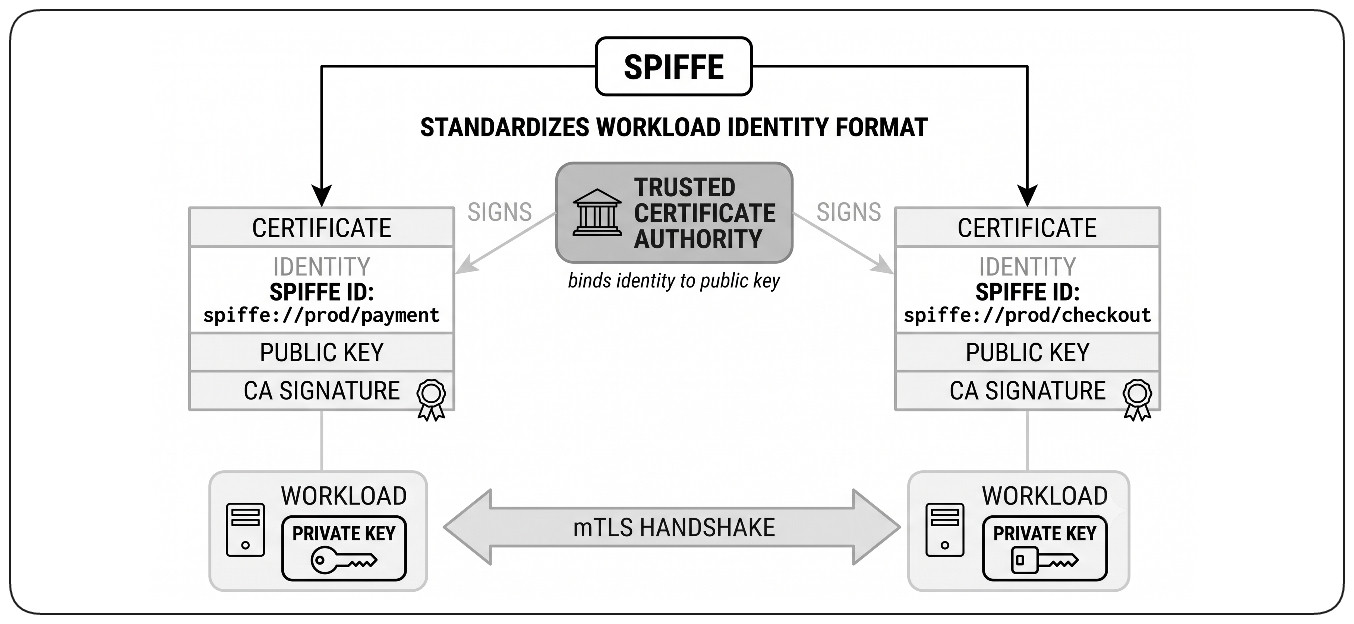
SPIFFE : identité de workload multiplateforme
mTLS définit comment les workloads s’authentifient avec des certificats. SPIFFE définit un format d’identité standard — le SVID — pour ces certificats. SPIRE est l’implémentation de référence qui atteste les workloads et émet et renouvelle automatiquement leurs SVID. Chaque workload reçoit une identité cryptographique portable, vérifiable de façon cohérente sur Kubernetes, les machines virtuelles, les systèmes on-premises et plusieurs clouds. Les politiques d’authentification et d’autorisation peuvent donc suivre le workload plutôt que sa localisation réseau. SPIFFE standardise l’identité de workload ; mTLS transforme cette identité en authentification mutuelle.
Fédération SPIFFE
La fédération SPIFFE étend l’identité de workload au-delà d’un seul domaine de confiance. Chaque domaine conserve sa propre autorité de certification et émet ses propres identités SPIFFE, mais les domaines échangent des trust bundles afin que les certificats émis par l’un puissent être validés par l’autre. Les workloads peuvent ainsi s’authentifier entre domaines de confiance avec le même mécanisme mTLS, sans partager d’identifiants de longue durée.
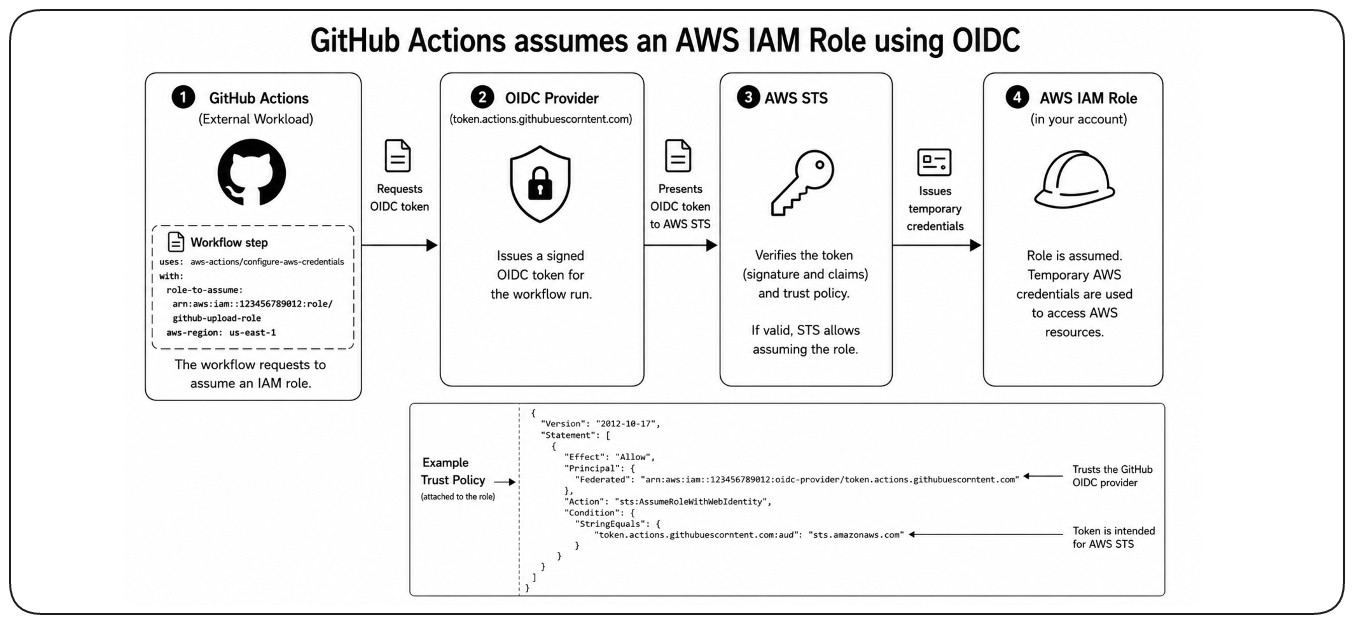
Assumer un rôle cloud via la fédération OIDC
Un workload qui s’exécute en dehors d’un cloud peut assumer un rôle à l’intérieur de ce cloud pour accéder à ses ressources. !!Le cloud est configuré pour faire confiance à un émetteur OIDC externe!!, et le workload présente un token signé émis par celui-ci. Le cloud vérifie le token par rapport à la politique de confiance du rôle et, si les conditions sont remplies, émet des identifiants de courte durée pour ce rôle. Aucun identifiant cloud de longue durée n’a besoin d’être stocké ni distribué. La politique de confiance autorise le workload à assumer le rôle ; les permissions attachées à ce rôle déterminent ce que le workload peut faire ensuite.
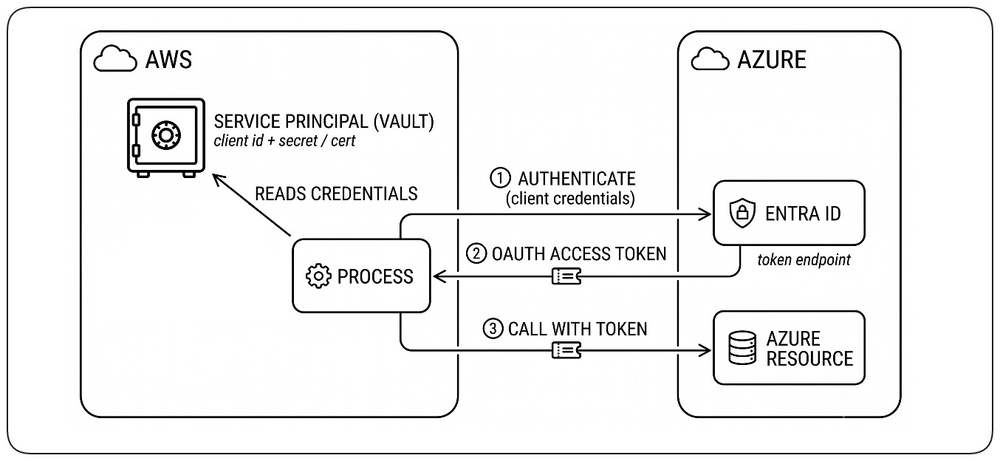
Plusieurs flux peuvent obtenir des identifiants cloud temporaires
L’exemple précédent utilisait la fédération OIDC pour obtenir des identifiants de courte durée auprès d’un fournisseur cloud. C’est l’un des nombreux flux d’authentification capables de produire des identifiants cloud temporaires. Un workload peut aussi s’authentifier via OAuth 2.0 Client Credentials avec un client secret ou un certificat client. !!La destination est la même : des identifiants de courte durée pour effectuer des opérations cloud. Ce qui diffère, c’est la façon dont le workload prouve son identité.!! La fédération OIDC est généralement préférée car elle évite de devoir provisionner, stocker, protéger et renouveler des identifiants de longue durée.
Découpler confidentialité et authenticité
Les systèmes modernes peuvent établir la confiance de deux façons fondamentalement différentes : en s’appuyant sur un secret partagé, ou en vérifiant une preuve cryptographique. Cette section explique pourquoi les architectures modernes privilégient de plus en plus la preuve plutôt que les secrets réutilisables, et comment minimiser et gérer avec soin les secrets partagés quand ils restent nécessaires.
Confidentialité vs authenticité
Confidentialité et authenticité sont souvent confondues — mais elles répondent à des problèmes fondamentalement différents et exigent des solutions différentes. La confidentialité consiste à protéger l’information. Certaines données doivent rester cachées — dossiers personnels, transactions financières, secrets industriels. L’objectif est de garantir que seules les parties autorisées peuvent y accéder. Si elles sont exposées, le mal est fait. L’authenticité consiste à prouver l’identité et l’autorité. Avant d’accepter une requête ou d’accorder un accès, un système doit répondre : qui demande, et en a-t-il le droit ?
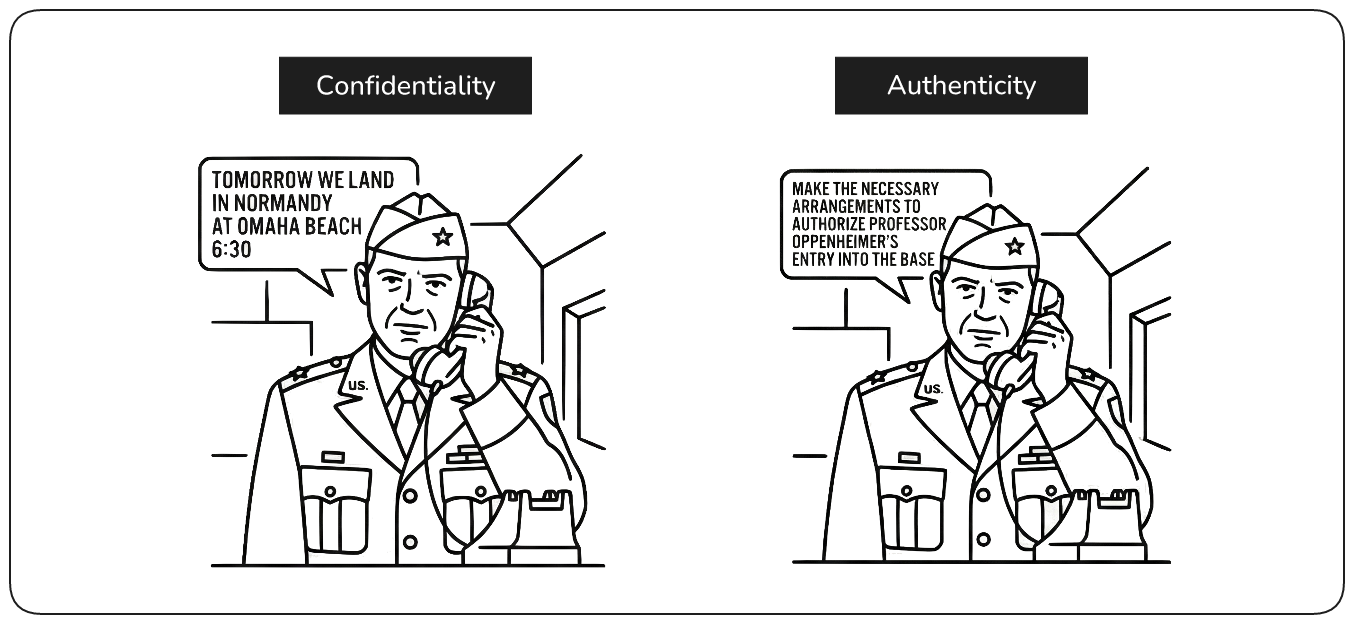
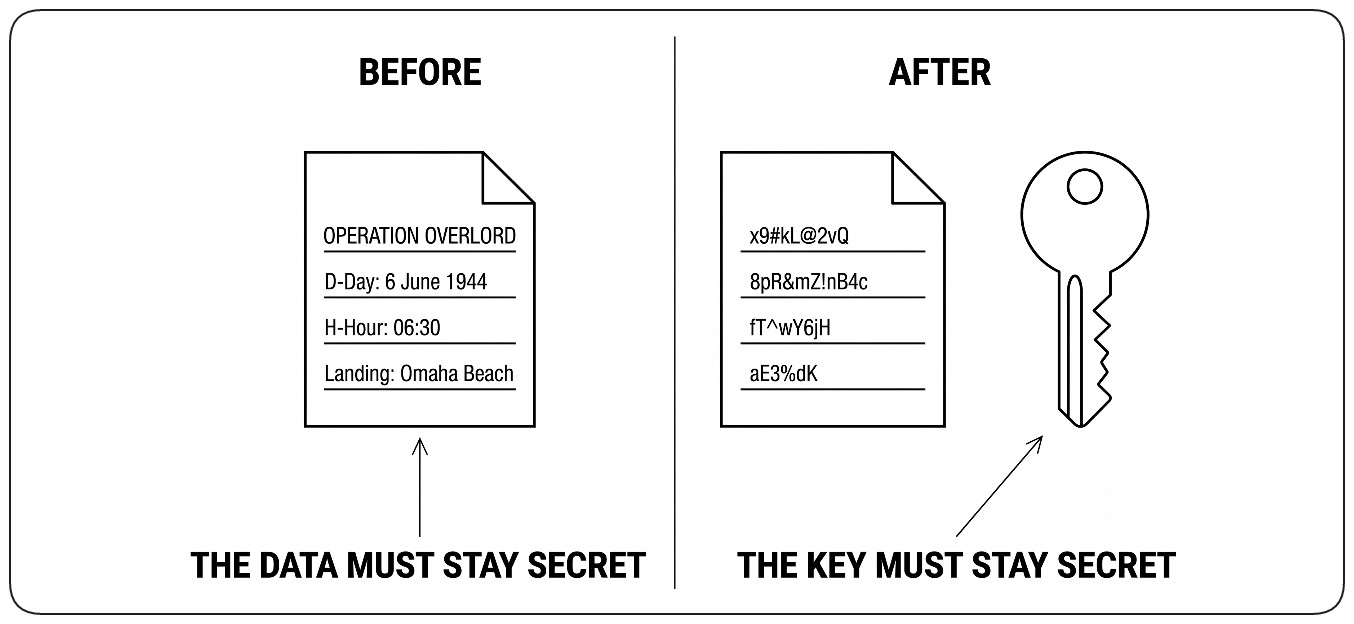
La confidentialité exige des clés
La confidentialité exige de contrôler qui peut accéder à l’information. Dans les systèmes numériques, on y parvient généralement par le chiffrement et la protection des clés cryptographiques — les données elles-mêmes peuvent transiter par n’importe quel canal, pourvu que seules les parties visées détiennent les clés. Une fois l’information exposée, cependant, la confidentialité est perdue à jamais : on ne peut pas annuler une divulgation. !!Ce ne sont plus les données qui doivent rester secrètes. C’est la clé.!!
Authenticité et intégrité
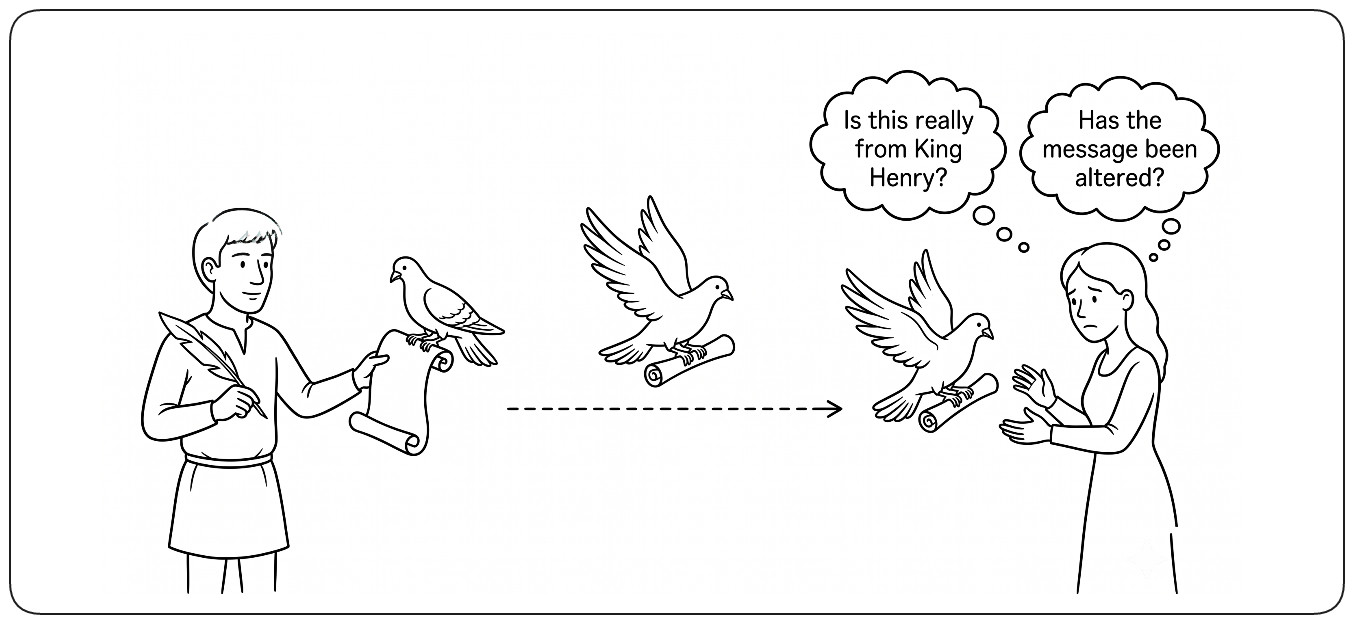
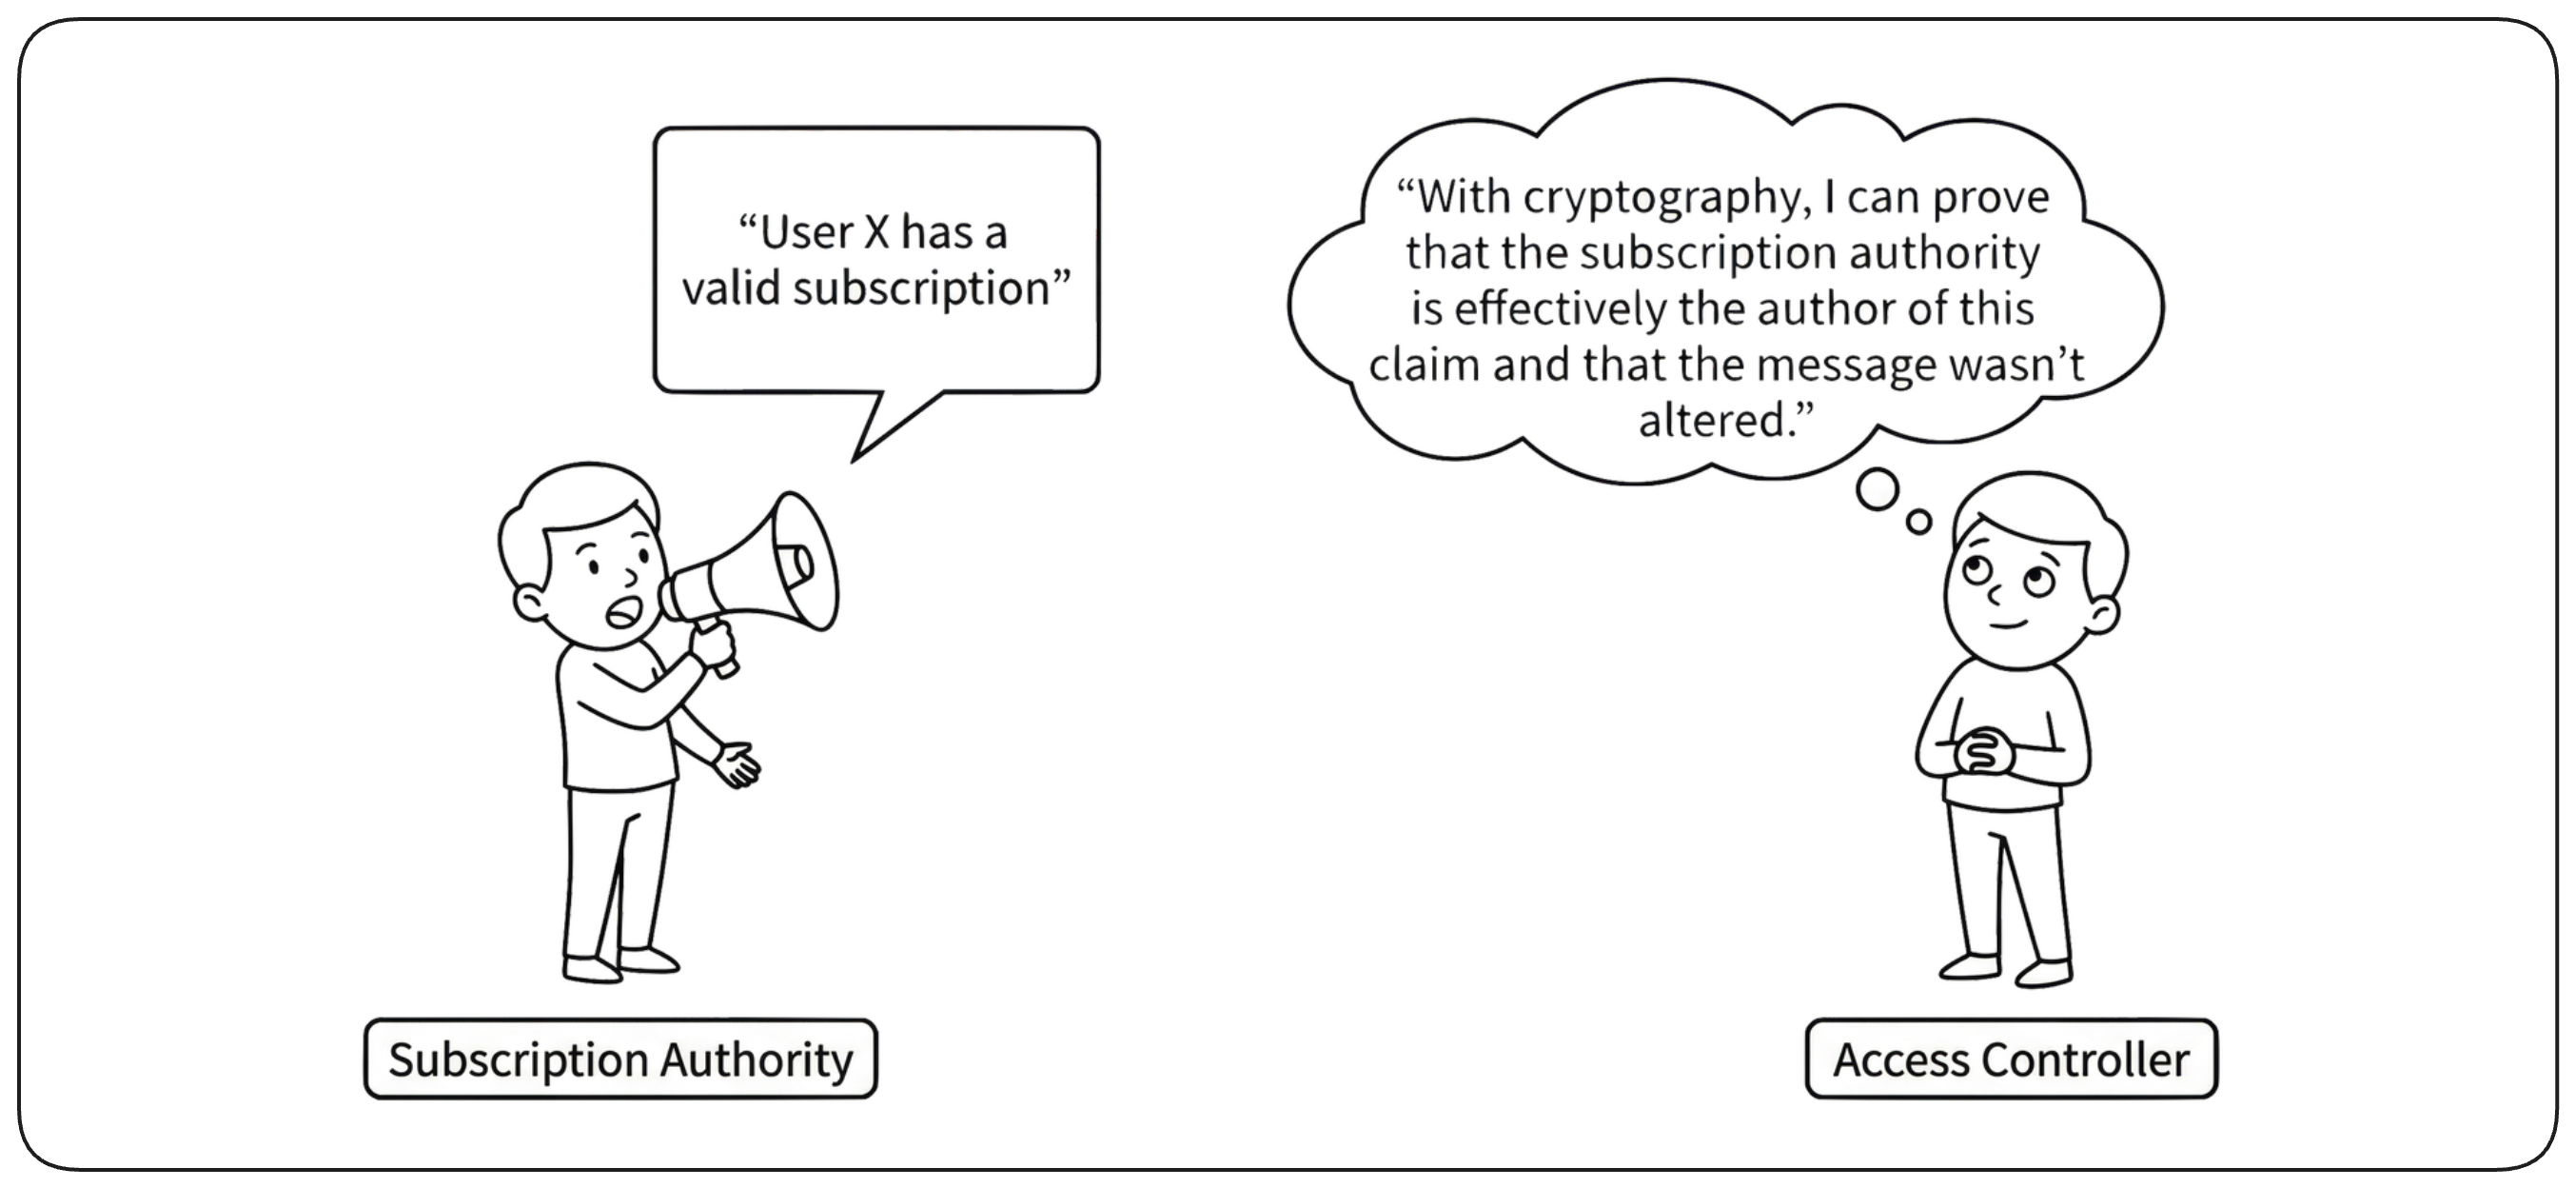
Contrairement à la confidentialité, l’authenticité ne consiste pas à cacher le message — elle consiste à prouver qui l’a écrit. Quand une personne ou un système reçoit une requête, deux questions doivent trouver réponse avant d’agir : l’expéditeur est-il bien celui qu’il prétend être, et le message a-t-il été altéré ? La première relève de l’authenticité ; la seconde de l’intégrité. Ce n’est que lorsque les deux sont vérifiées que le système peut faire confiance à la requête.
Le sceau de cire : une réponse analogique
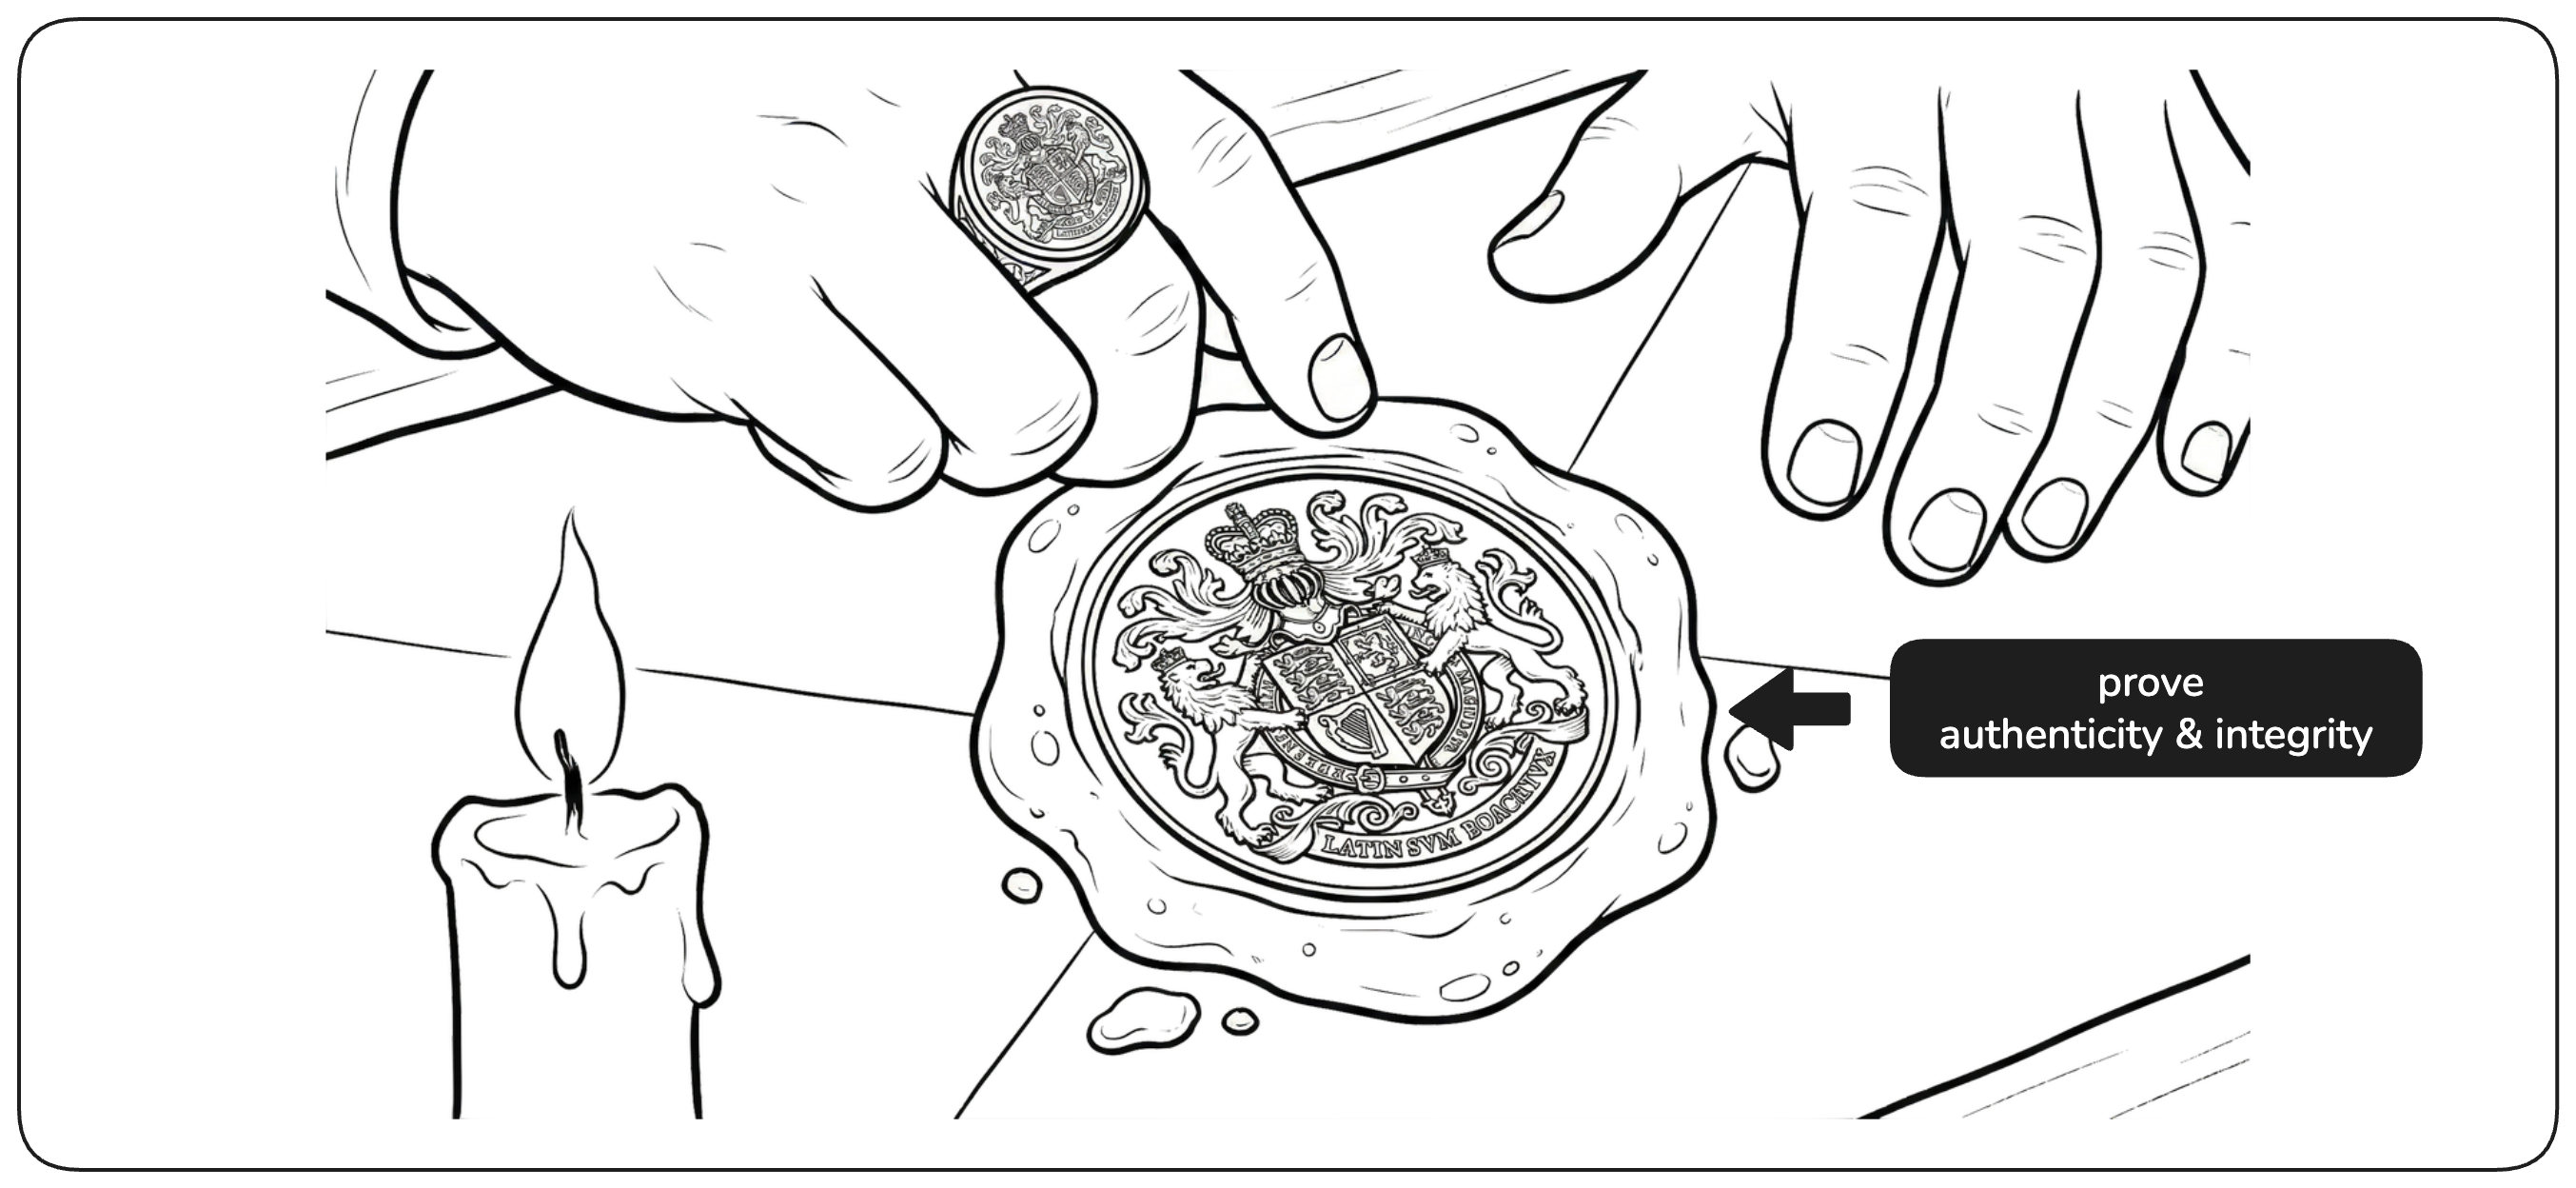
Pendant des siècles, le sceau de cire a été la réponse aux deux problèmes. Les lettres étaient scellées avec de la cire fondue frappée d’une chevalière : le motif unique prouvait l’authenticité — seul l’expéditeur possédait cette bague — et comme une cire brisée ne peut être restaurée, toute altération était immédiatement visible, ce qui prouvait l’intégrité. Pourtant, cette méthode restait fragile — les sceaux pouvaient être falsifiés, la cire soigneusement décollée puis remise — et elle n’a pas survécu à l’ère moderne.
L’authenticité traitée comme de la confidentialité
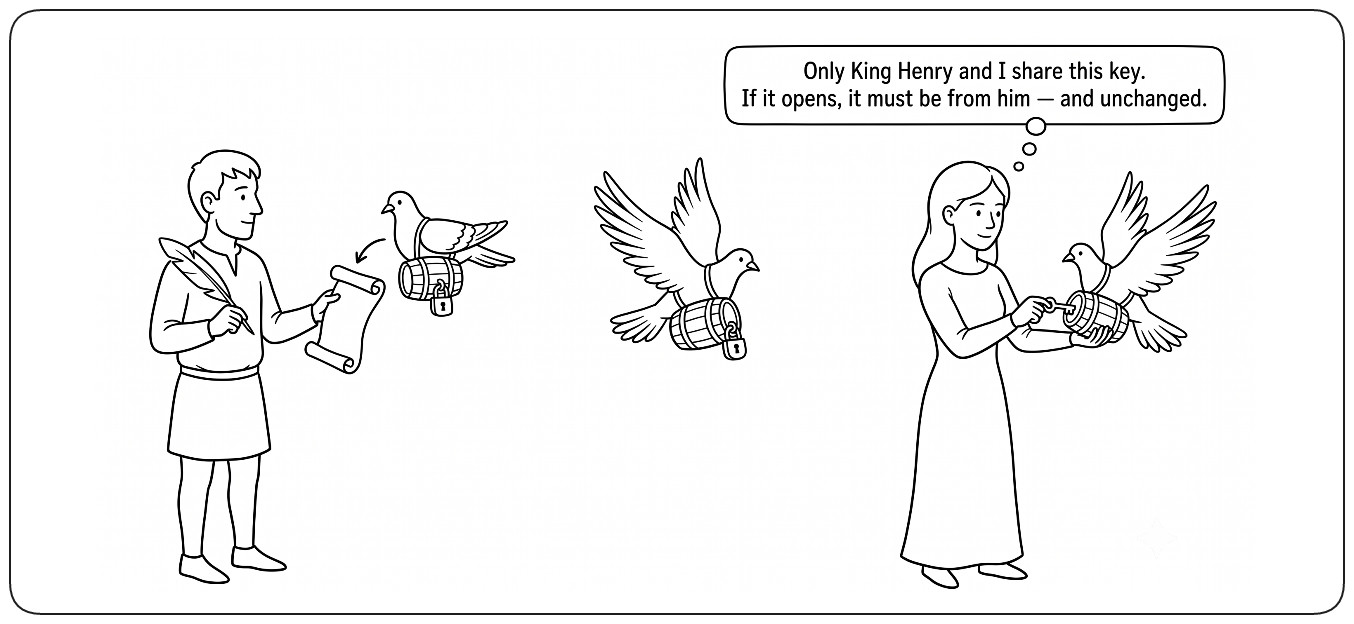
Avant que les signatures numériques ne rendent l’authenticité et l’intégrité vérifiables indépendamment, les systèmes traitaient souvent les deux comme des problèmes de confidentialité. !!Les messages étaient placés dans des conteneurs chiffrés — des coffres portables protégés par des clés partagées. Si un destinataire pouvait déchiffrer le message, l’expéditeur était supposé légitime ; si le message se déchiffrait correctement, il était supposé inchangé.!! Le secret est devenu un substitut à la fois de l’identité et de la détection d’altération — non parce que c’était le bon modèle, mais parce qu’une meilleure preuve n’était pas encore praticable.
Authenticité : le problème d’amorçage
Au-delà du coût opérationnel, les secrets partagés se heurtent à un problème théorique plus profond : les deux parties doivent posséder la même clé avant de pouvoir communiquer de façon sécurisée. !!Mais comment partager un secret en toute sécurité si l’on n’a pas encore de canal sécurisé ?!! Ce problème de l’œuf et de la poule a tourmenté la communication sécurisée pendant des siècles.
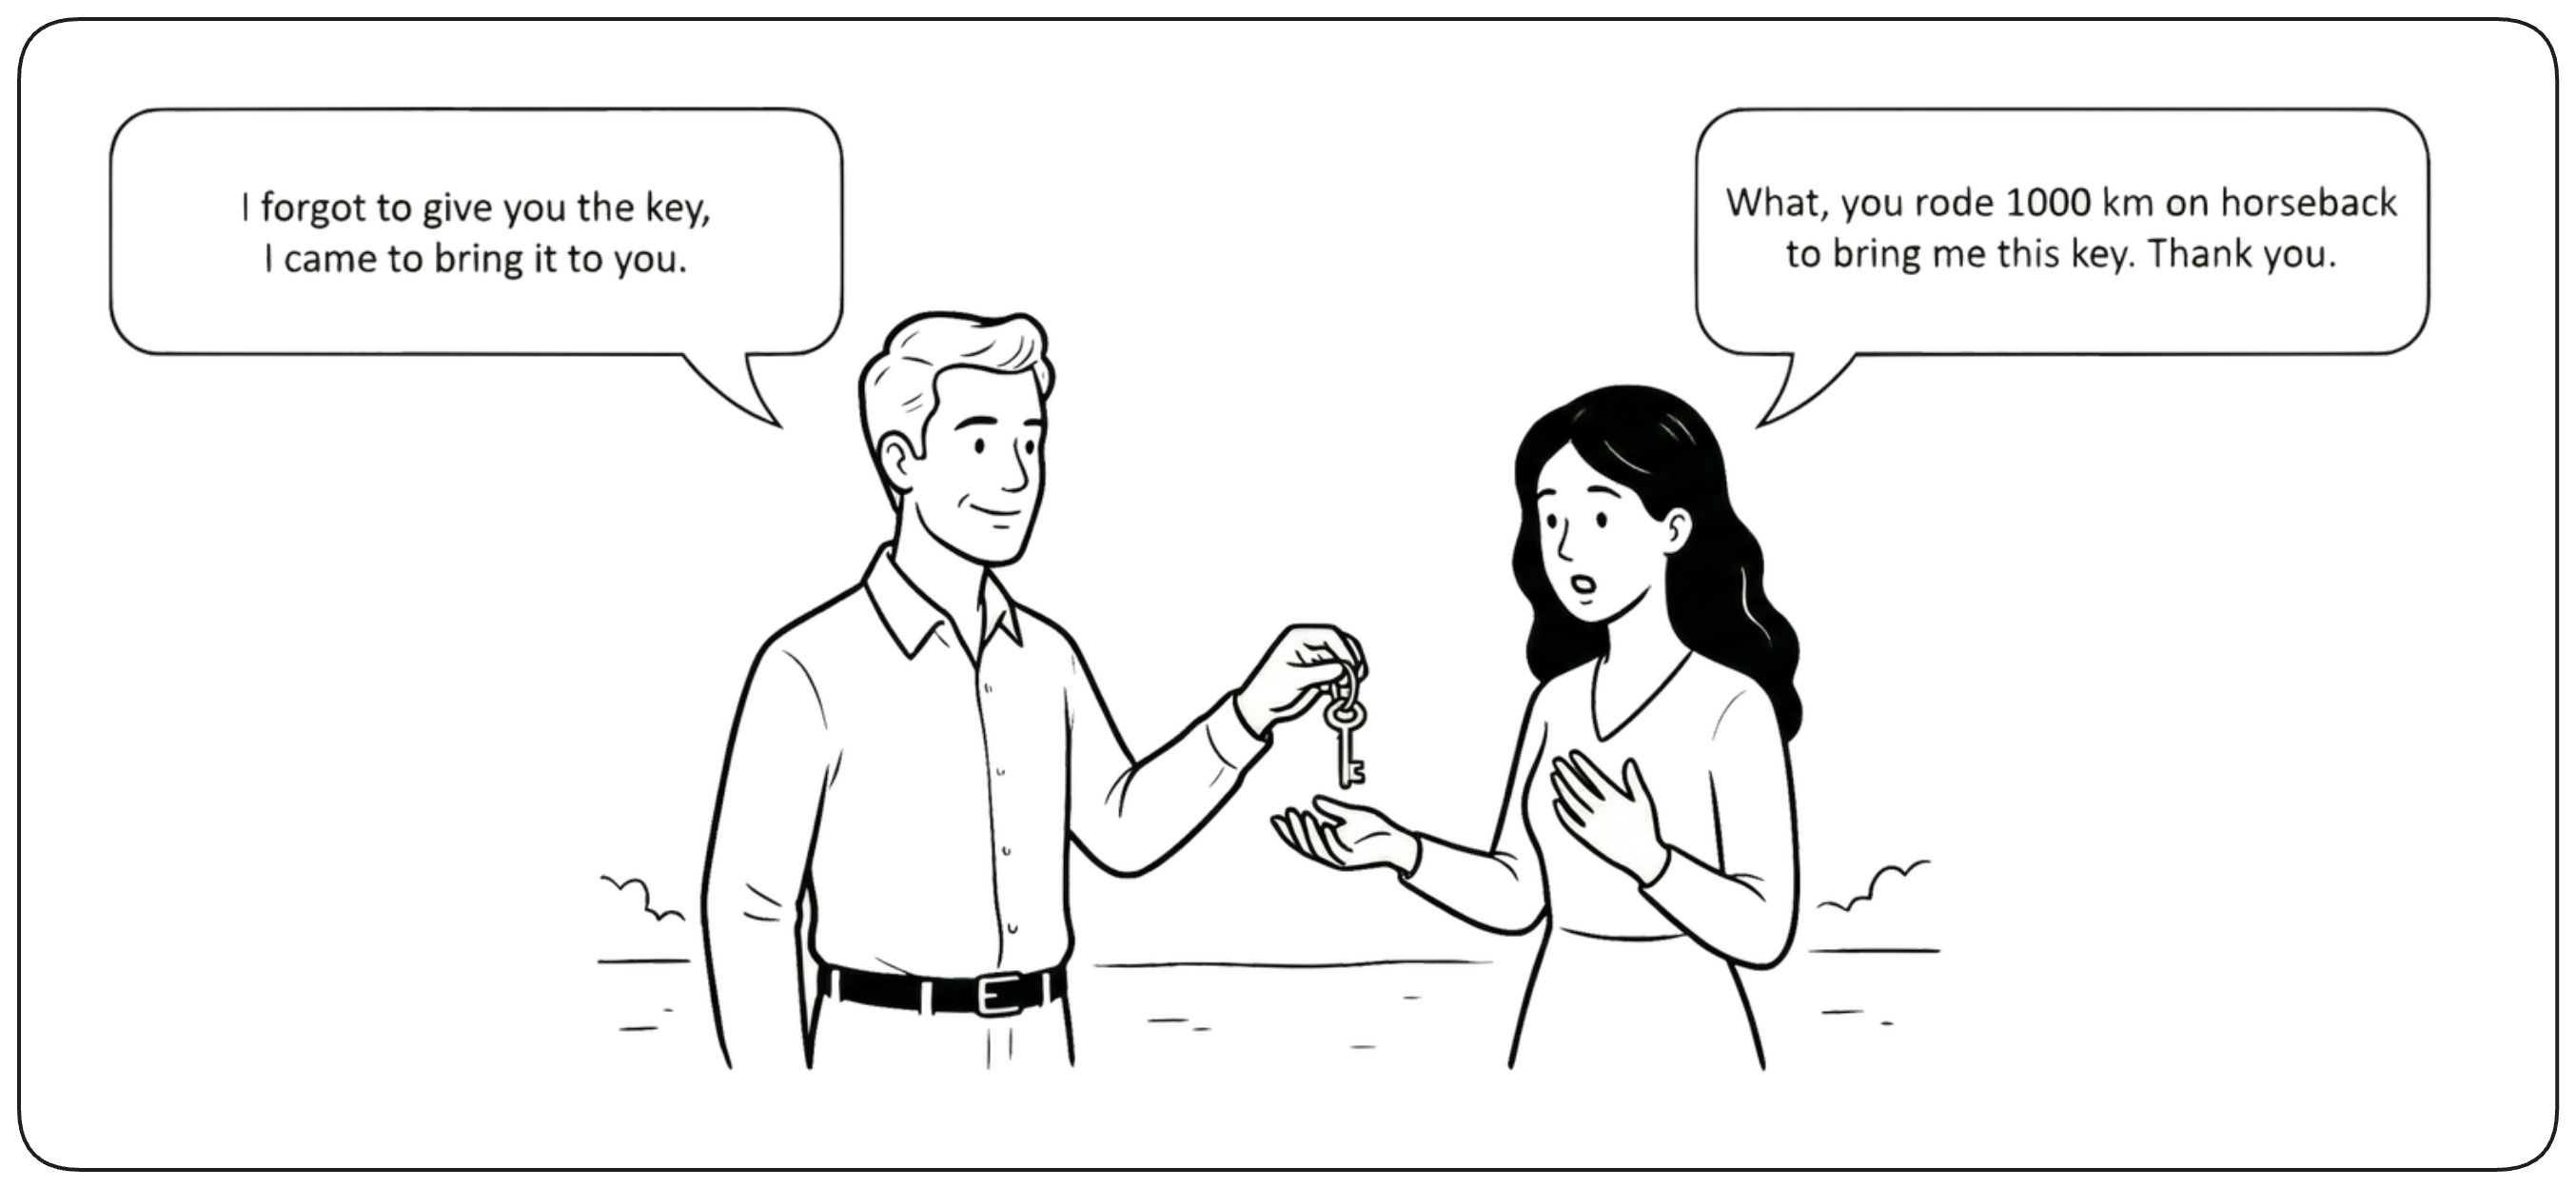
Authenticité : un nouveau paradigme — des secrets aux preuves
Un changement fondamental a éloigné la confiance des secrets partagés pour la porter vers la preuve cryptographique. La cryptographie a permis de prouver qui parle et qu’un message n’a pas été altéré, sans jamais partager de secret réutilisable. Sécuriser un message ne dépend plus de sa dissimulation, mais de la vérification d’une preuve cryptographique. !!Cela découple fondamentalement l’authenticité et l’intégrité de la confidentialité : un message peut voyager sur un canal non fiable, voire public, tandis que son origine et son intégrité restent vérifiables indépendamment grâce à une preuve cryptographique.!! L’identité devient l’ancre de la confiance — elle n’est plus liée au canal, mais portée par le message lui-même, vérifiable partout.
Zero Trust
Tout ce qui a été présenté jusqu’ici — identité, preuve cryptographique, autorisation, IAM cloud, protocoles ouverts, identité de workload et secrets maîtrisés — s’assemble désormais en une seule architecture. !!Le Zero Trust n’ajoute pas de nouveau mécanisme ; il définit comment ces mécanismes sont combinés et appliqués de façon cohérente.!! C’est une philosophie à part entière autour d’une question précise : que change-t-il quand un système cesse de faire confiance au réseau, à la localisation ou à la requête précédente ? Les quatre principes ci-dessous répondent au pourquoi ; les slides d’architecture qui suivent montrent comment ces principes se composent en une architecture concrète, jusqu’à une checklist à laquelle le lecteur peut confronter son propre système.
Supposer la compromission
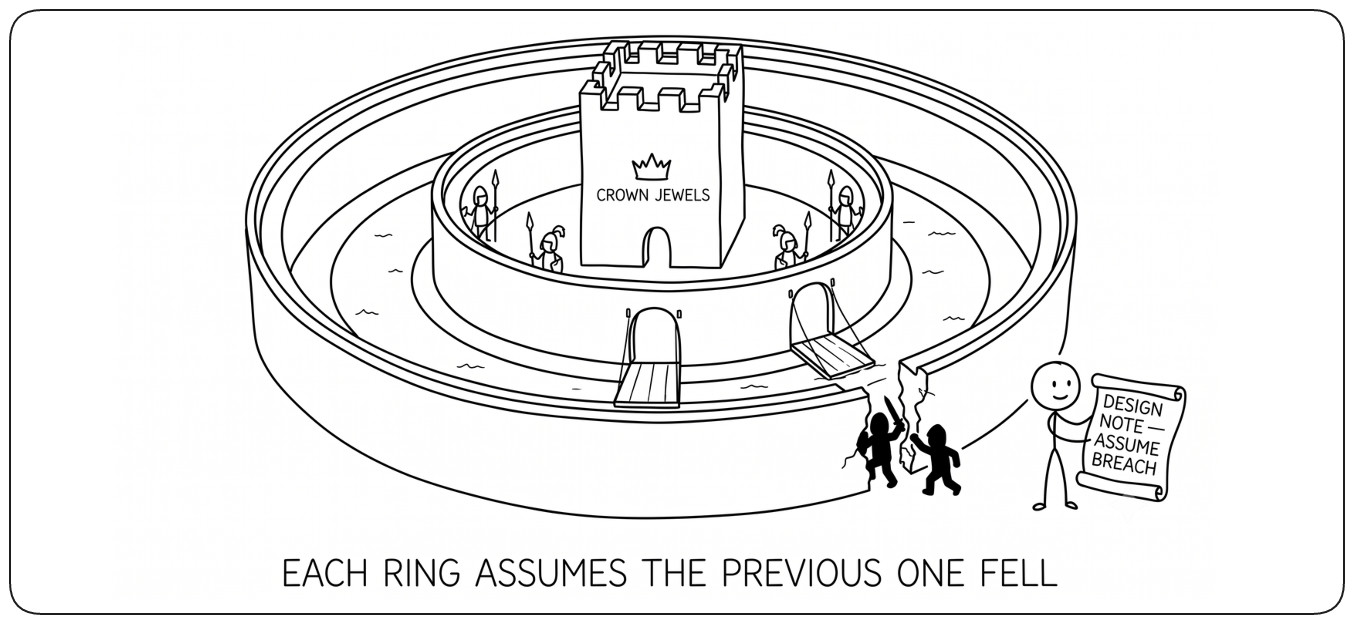
Le Zero Trust conçoit le système comme si l’attaquant était déjà à l’intérieur — parce qu’un jour, il le sera. !!Chaque contrôle suppose que le précédent a échoué!!, de sorte que la défaillance d’une couche isolée est bornée et non catastrophique. C’est pourquoi les mécanismes présentés plus tôt sont superposés : identité authentifiée en périphérie, autorisation à chaque service, preuve cryptographique entre workloads, identifiants de courte durée et pistes d’audit. Si une couche est contournée, les autres tiennent toujours. La question n’est plus « comment les empêcher d’entrer ? » mais « comment limiter ce qu’ils peuvent atteindre une fois à l’intérieur ? ».
La localisation réseau n’accorde rien
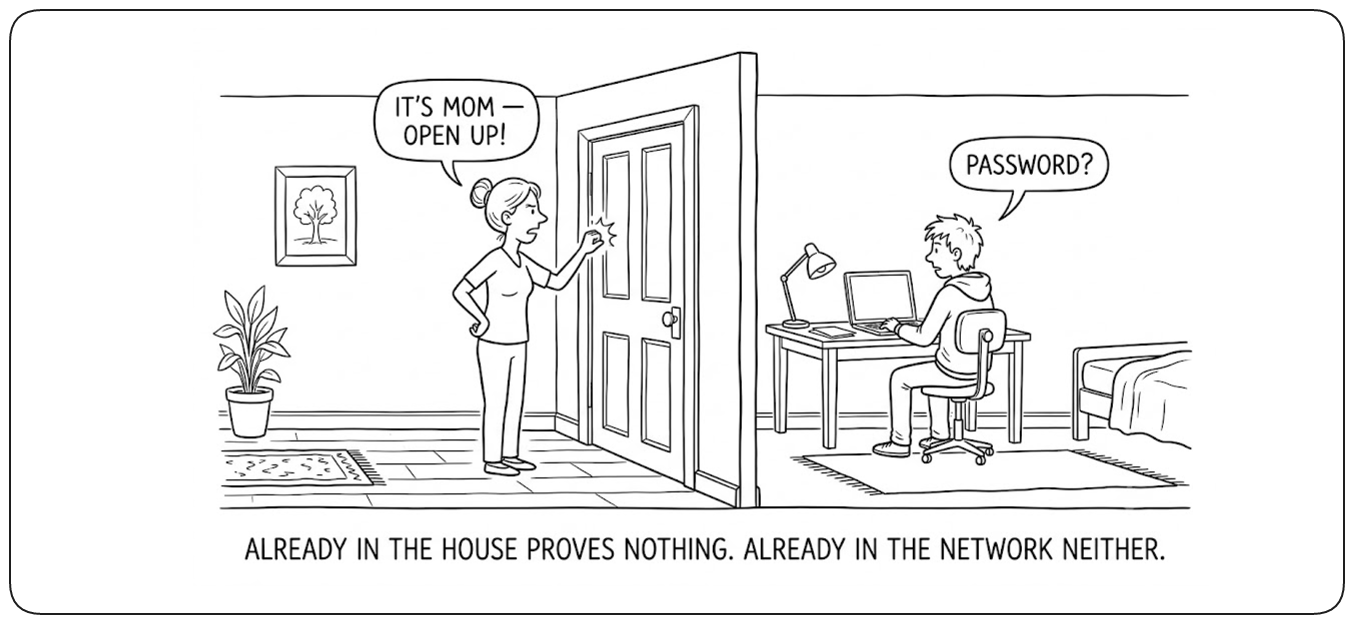
Se trouver dans un VPC, un cluster ou un réseau d’entreprise n’est la preuve de rien. !!Un paquet venant de l’« intérieur » n’a pas plus de légitimité qu’un paquet venant de l’internet public — les deux doivent être authentifiés de la même façon.!! Dans une architecture Zero Trust, l’authentification est ancrée dans l’identité cryptographique plutôt que dans la localisation réseau. Les contrôles réseau (pare-feu, security groups, VPC) restreignent toujours ce qui peut atteindre quoi, mais ils ne répondent plus à qui demande. Cette question relève de l’identité.
Chaque requête est vérifiée indépendamment
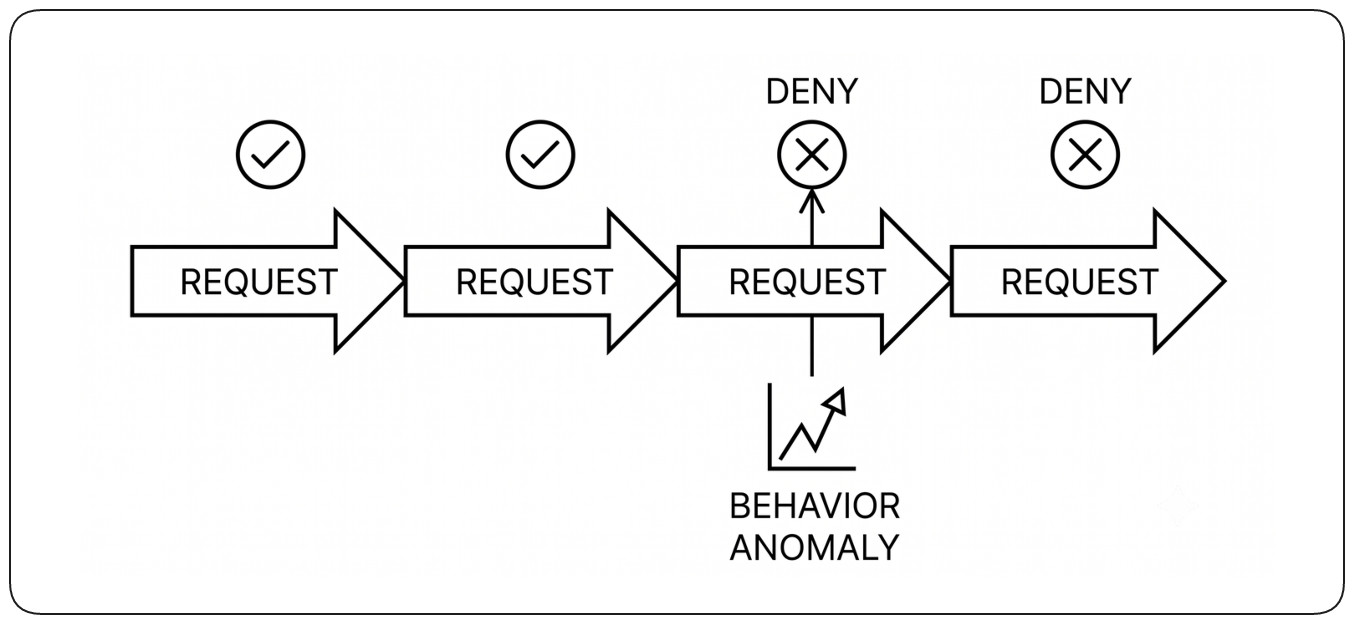
L’ancien modèle vérifiait à la porte d’entrée, puis laissait le visiteur seul pendant des heures. Le Zero Trust ne fait pas cette concession : !!chaque requête est évaluée pour elle-même — la confiance n’est jamais reportée des interactions précédentes.!! Une requête authentifiée antérieure n’est pas une preuve pour la suivante ; une session n’est pas un raccourci. Chaque requête présente sa propre preuve d’identité, et la politique la réévalue à chaque fois — la vérification est une propriété de chaque requête, pas d’un handshake initial.
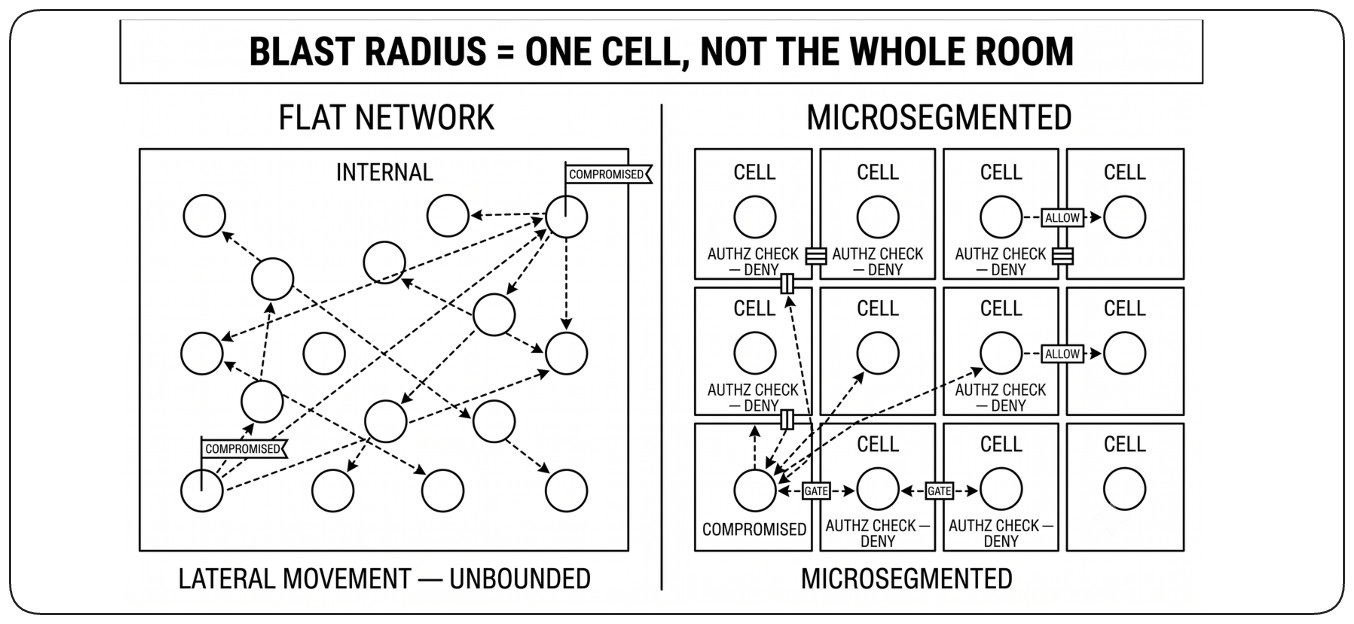
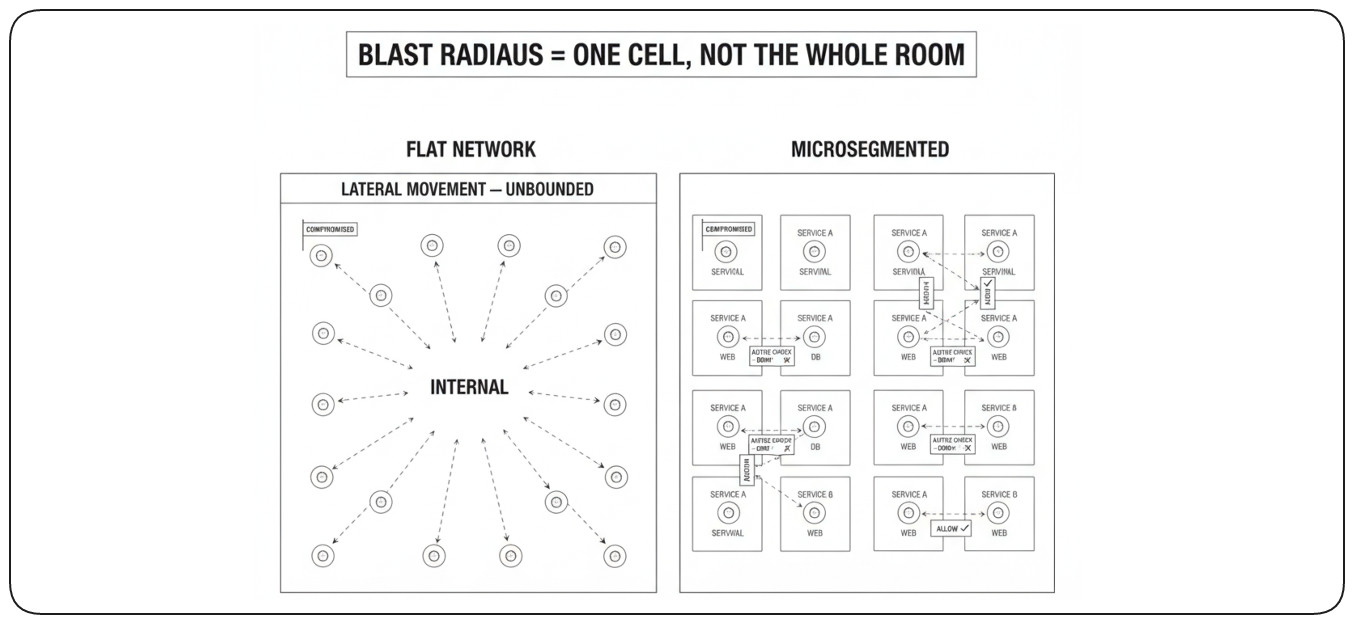
Microsegmentation : contenir le rayon d’impact
Dans une conception Zero Trust, l’intérieur du système n’est pas une grande pièce de confiance — c’est une grille de petites cellules, chacune authentifiant et autorisant la suivante. !!Chaque service authentifie son appelant et évalue l’autorisation de façon indépendante. Compromettre un workload ne donne plus accès au reste du système.!! Le déplacement latéral devient coûteux, visible et borné. La segmentation était autrefois un problème d’adresses IP ; aujourd’hui, c’est un problème d’identité.
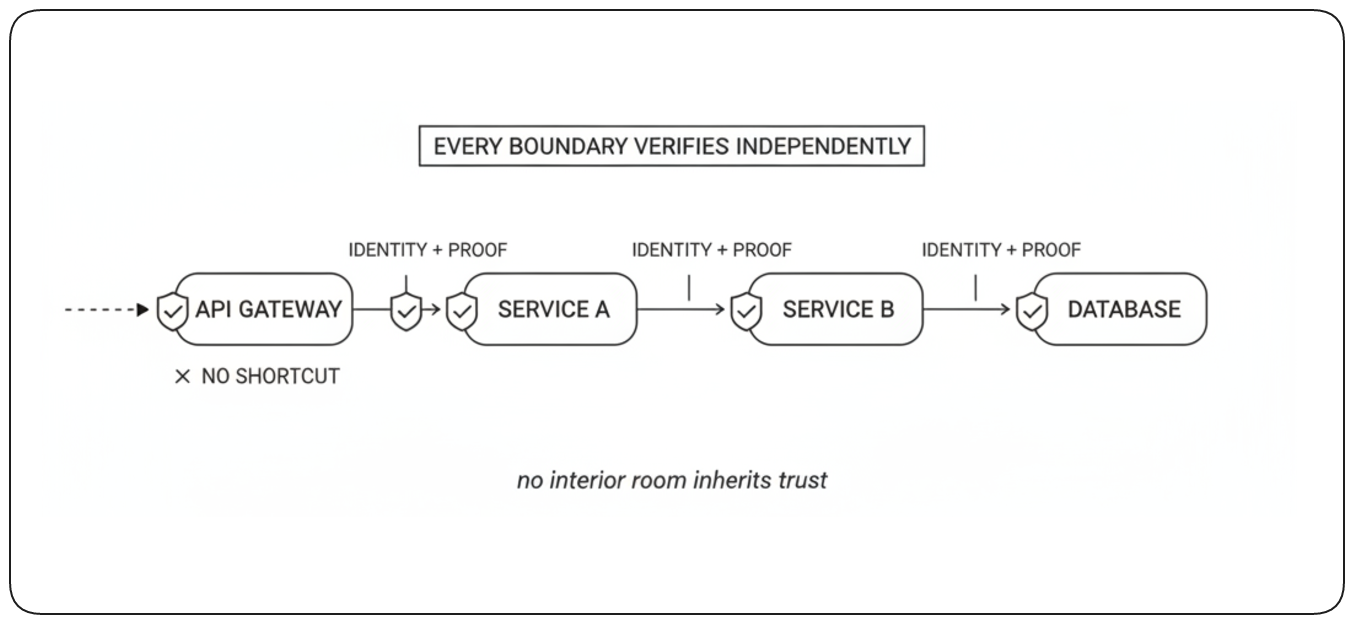
Construire une requête Zero Trust
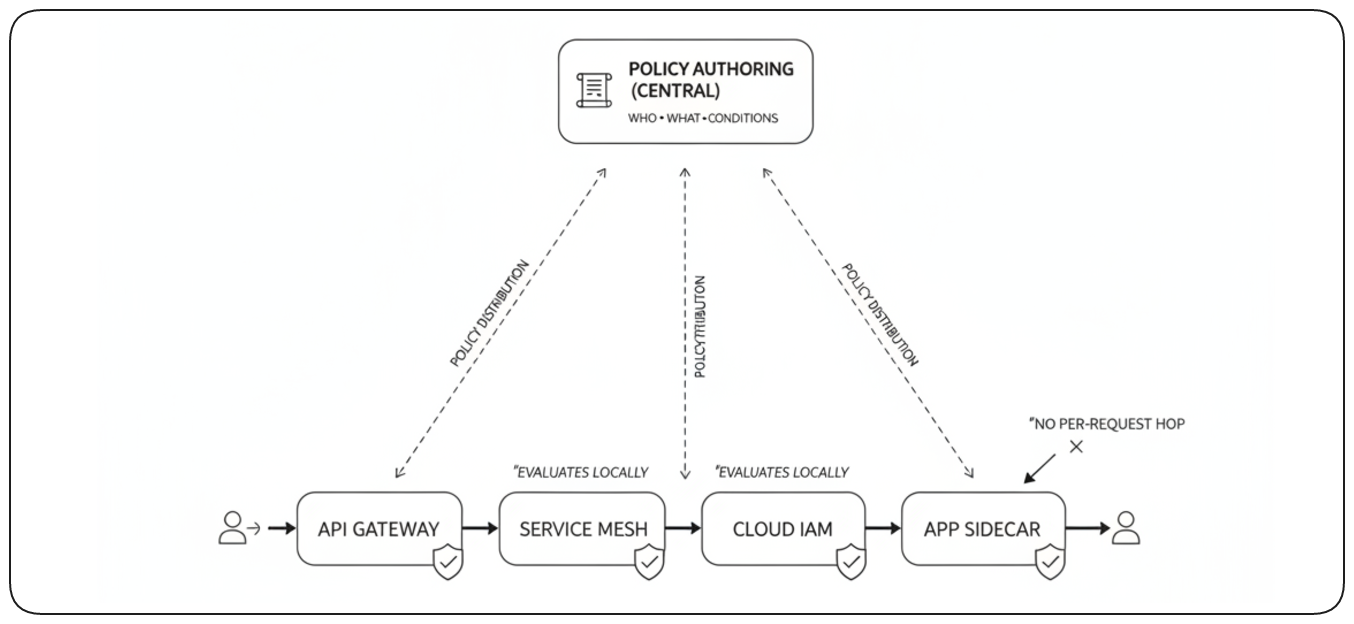
!!Le Zero Trust n’est pas une nouvelle technologie — c’est l’application cohérente à chaque requête des mécanismes présentés tout au long de ce chapitre.!! Chaque requête suit le même cycle de vie : établir l’identité, porter la preuve cryptographique, vérifier localement, évaluer la politique, exécuter et auditer. Pas de raccourcis. Pas de confiance héritée.
Définir la politique de façon centralisée, l’appliquer partout
Les règles d’autorisation doivent être définies en un seul endroit, puis distribuées aux systèmes qui traitent les requêtes. !!API gateways, services, bases de données, sidecars et IAM cloud évaluent l’autorisation localement à partir de politiques gérées de façon centralisée.!! Cela garde l’autorisation cohérente sans exiger d’appel d’autorisation central pour chaque requête.
La confiance est petite dans l’espace et brève dans le temps
Chaque identifiant a deux propriétés : ce qu’il permet de faire, et combien de temps il reste valide. Le Zero Trust minimise les deux. Les identifiants n’autorisent que le strict minimum, et ne restent valides que le moins longtemps possible. Un identifiant volé a donc très peu de valeur : il donne peu, et brièvement. Le moindre privilège réduit la portée d’un identifiant. Les identifiants de courte durée réduisent sa durée de vie. Ensemble, ils minimisent les dégâts qu’un identifiant volé peut causer.
Construire une architecture Zero Trust
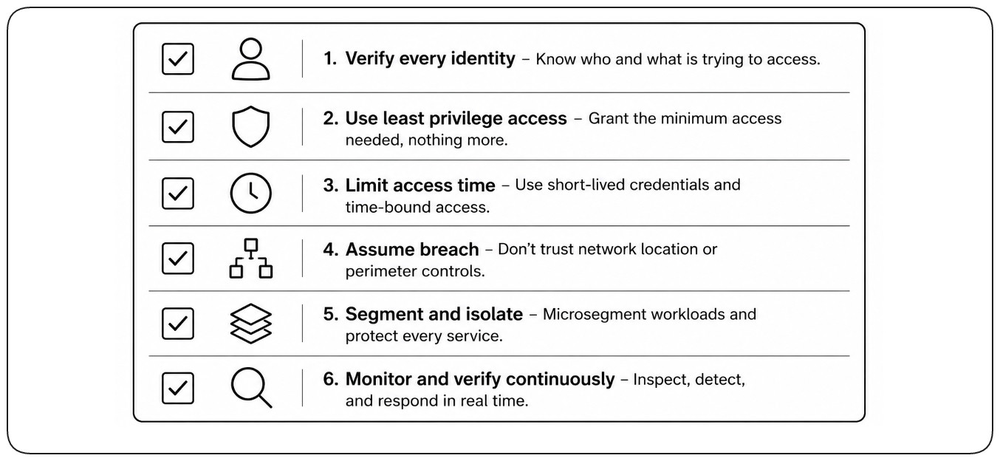
Le Zero Trust n’est ni un produit ni un protocole. C’est un style architectural bâti sur l’identité, la preuve cryptographique, l’autorisation locale, la politique distribuée, la confiance de courte durée et l’auditabilité. Avant de qualifier une architecture de Zero Trust, demandez-vous : chaque acteur est-il identifié, chaque requête prouvée et vérifiée, chaque décision autorisée localement, et chaque accord étroit, de courte durée et auditable ? Chaque « non » révèle une brique manquante.
Gérer les secrets qui restent
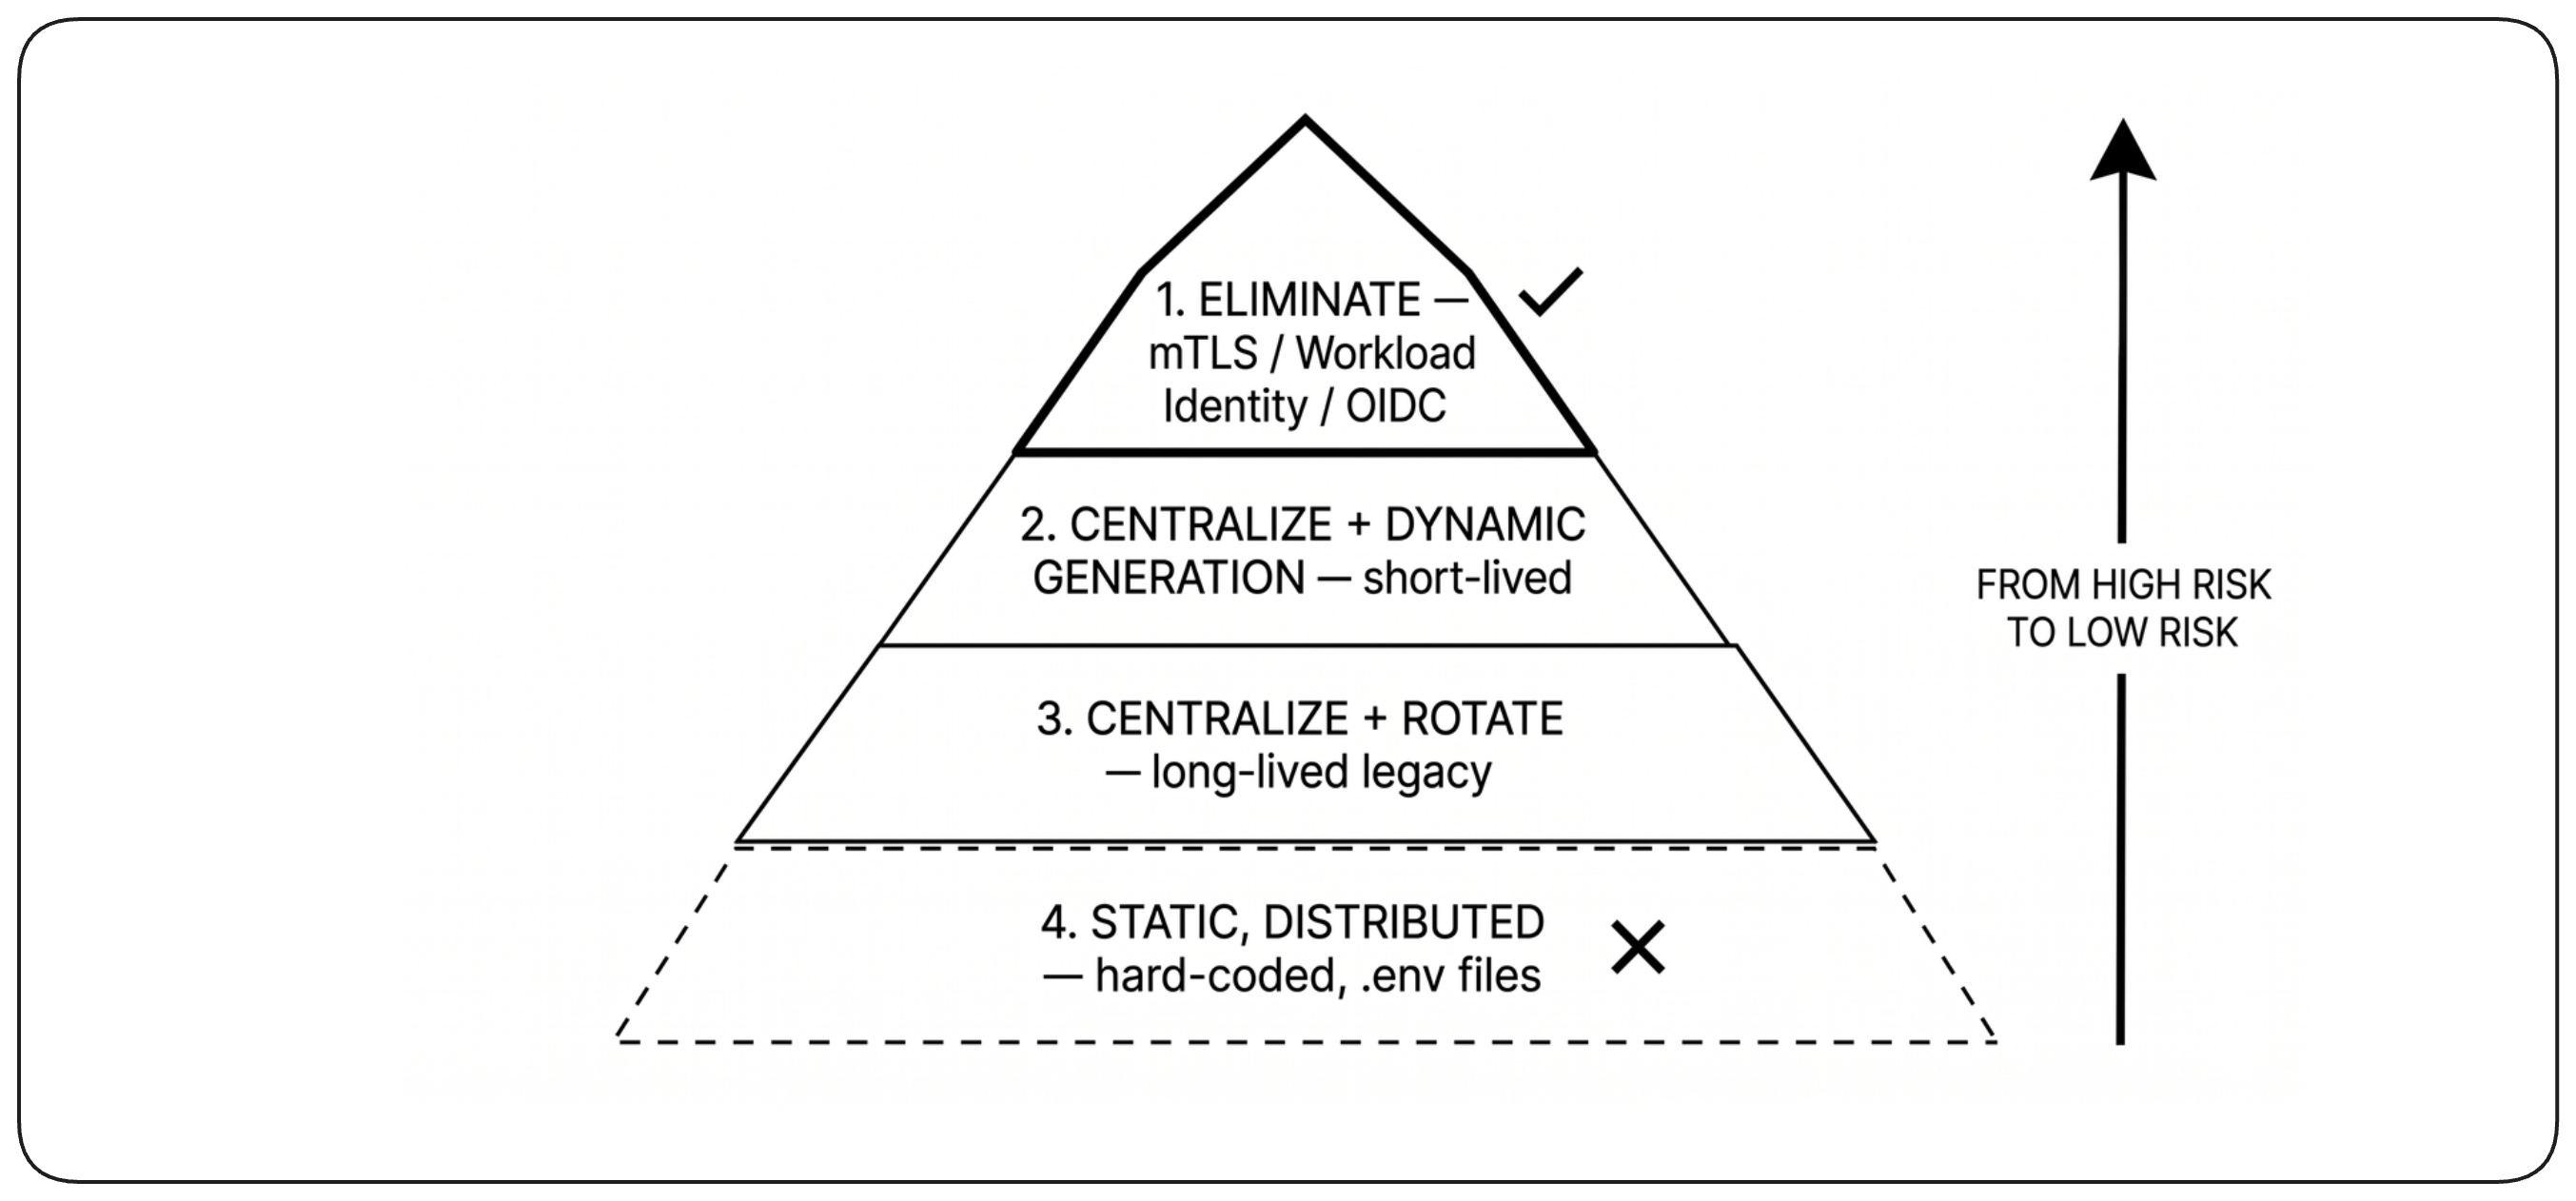
Les secrets partagés ne sont plus le fondement de la confiance — mais ils n’ont pas disparu. Systèmes legacy, services tiers, bases de données et pipelines CI/CD en dépendent encore. !!Pour ceux qui subsistent, l’objectif passe de l’évitement des secrets à la maîtrise de leur risque!! : minimiser leur nombre et leur dispersion, centraliser le contrôle, automatiser leur cycle de vie, découpler les applications de la récupération et propager les valeurs rafraîchies à l’exécution. Cette section est le guide de cette maîtrise.
Éliminer les secrets partagés partout où c’est possible
Chaque secret partagé est un passif : il doit être stocké, copié, renouvelé, et finit par être exposé. !!L’objectif n’est pas seulement de mieux gérer les secrets partagés, mais de les éliminer partout où une authentification fondée sur l’identité peut les remplacer.!! Avec mTLS, l’identité de workload ou la fédération OIDC, chaque partie prouve qu’elle possède son propre identifiant au lieu d’échanger un secret réutilisable. Du matériel cryptographique existe toujours, mais il n’est ni partagé ni géré par le code applicatif. « Secretless » signifie aucun secret partagé géré par l’application — et non l’absence de clés cryptographiques.
Les secrets partagés créent de la dispersion
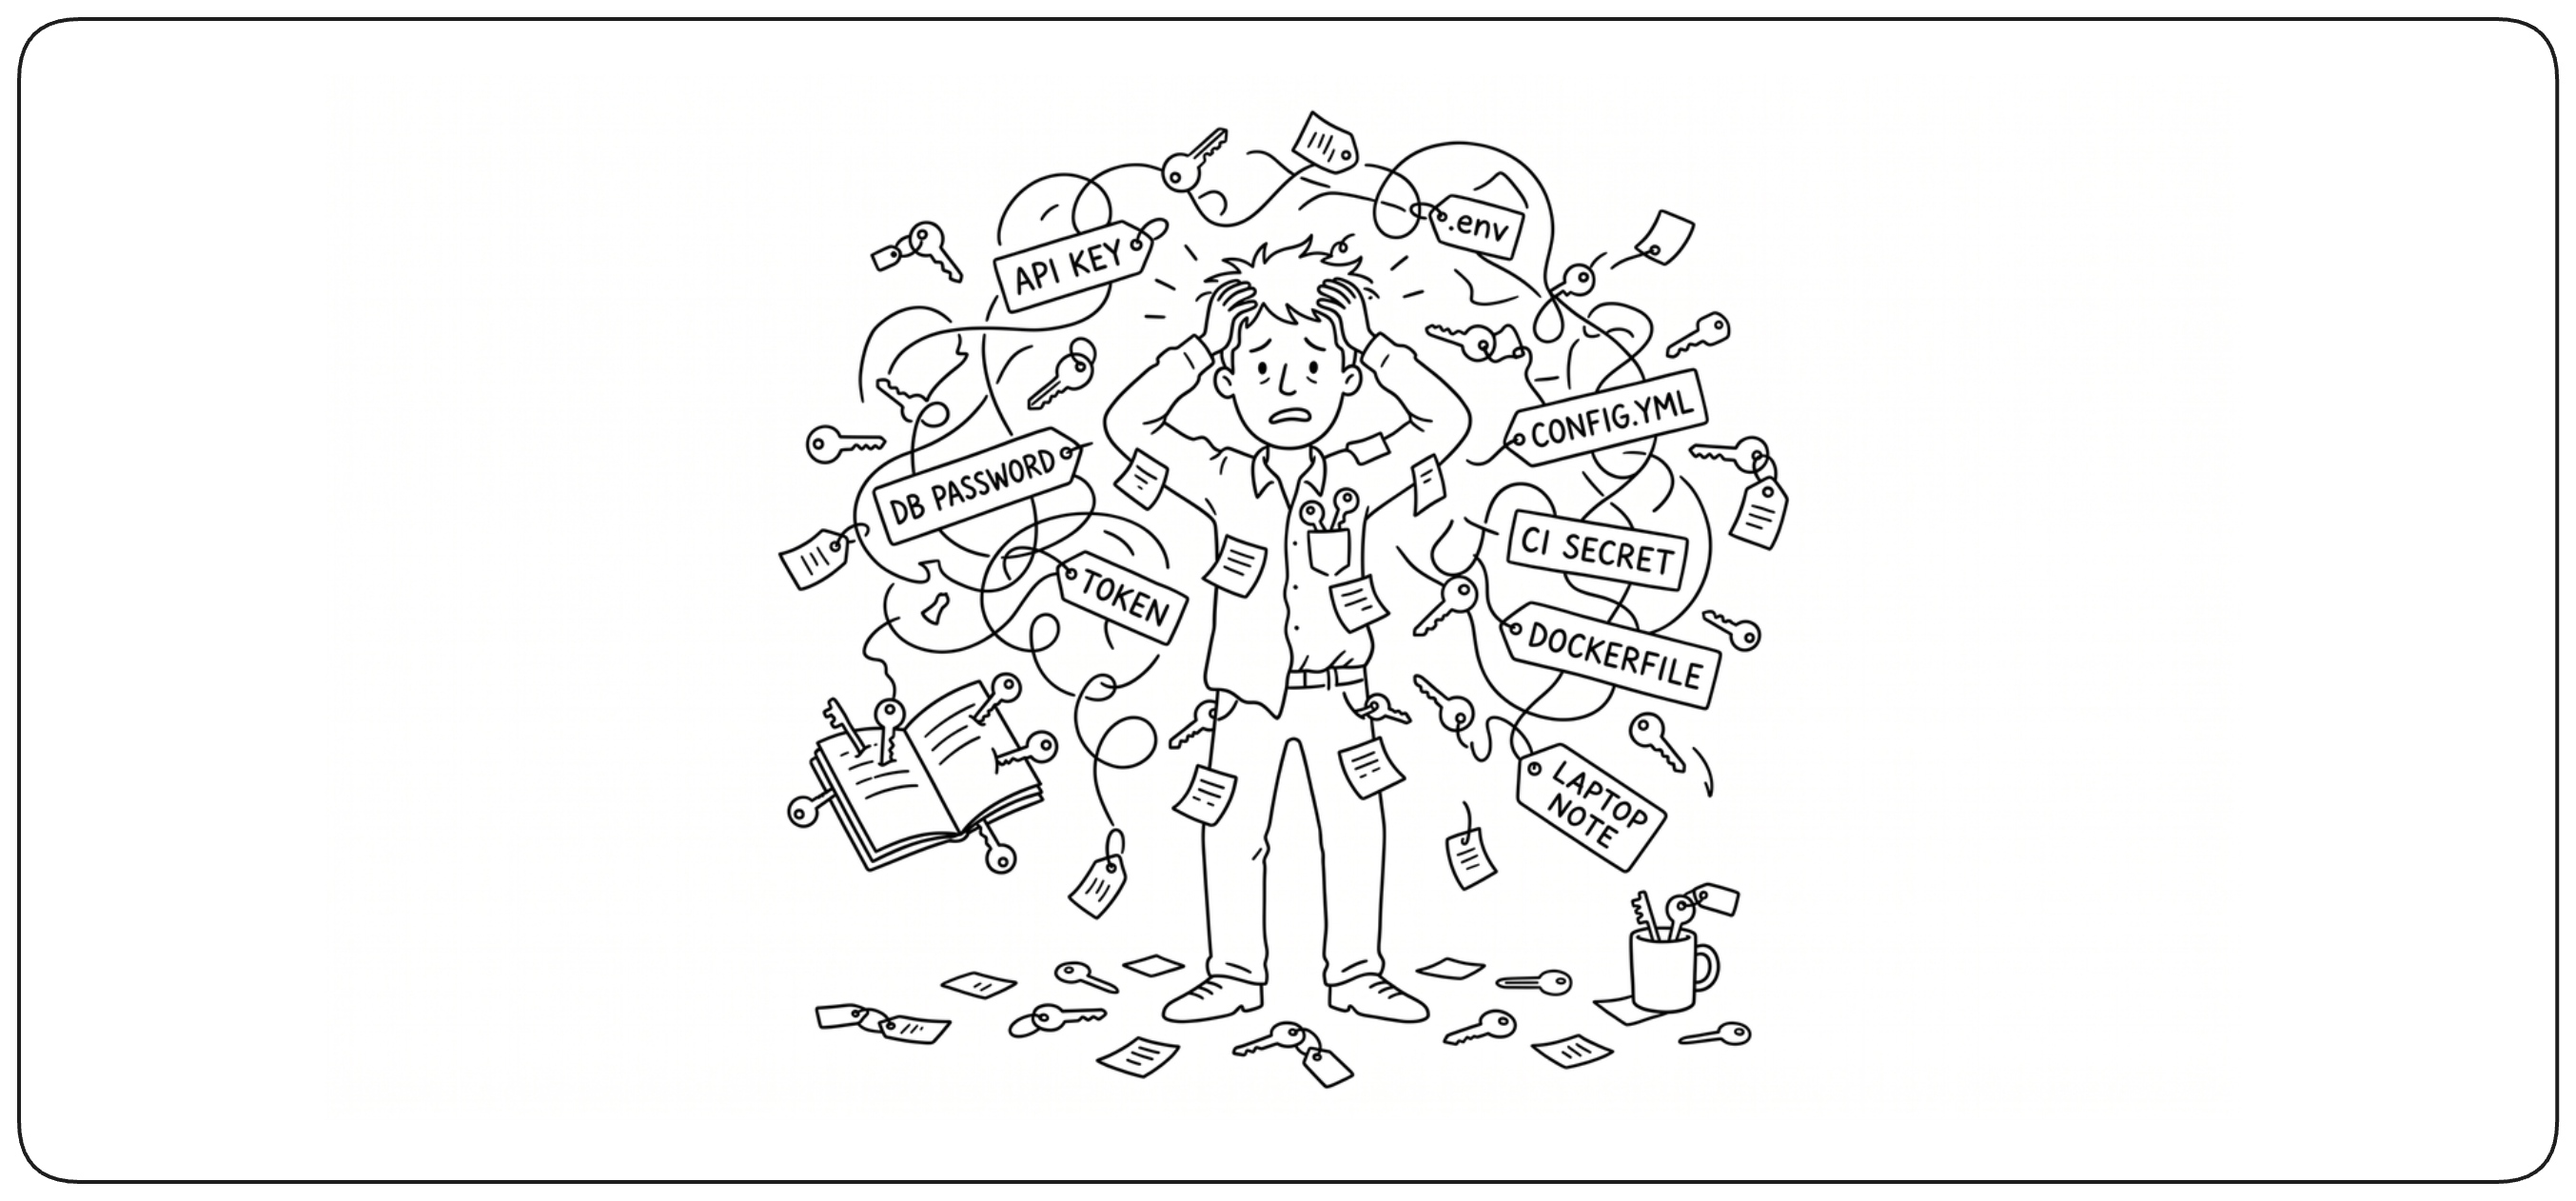
Chaque secret partagé doit être émis, stocké, protégé, renouvelé et révoqué dans chaque système qui l’utilise. !!Le moindre privilège exige souvent des identifiants distincts pour chaque service ou workload, ce qui disperse les secrets dans les fichiers de configuration, les variables d’environnement, les systèmes CI/CD, les plateformes de conteneurs et les machines des développeurs.!! Chaque copie augmente le coût opérationnel et crée un point d’exposition supplémentaire. Dès qu’une organisation ne sait plus où se trouve chaque copie, la rotation devient peu fiable et des identifiants divulgués peuvent rester valides.
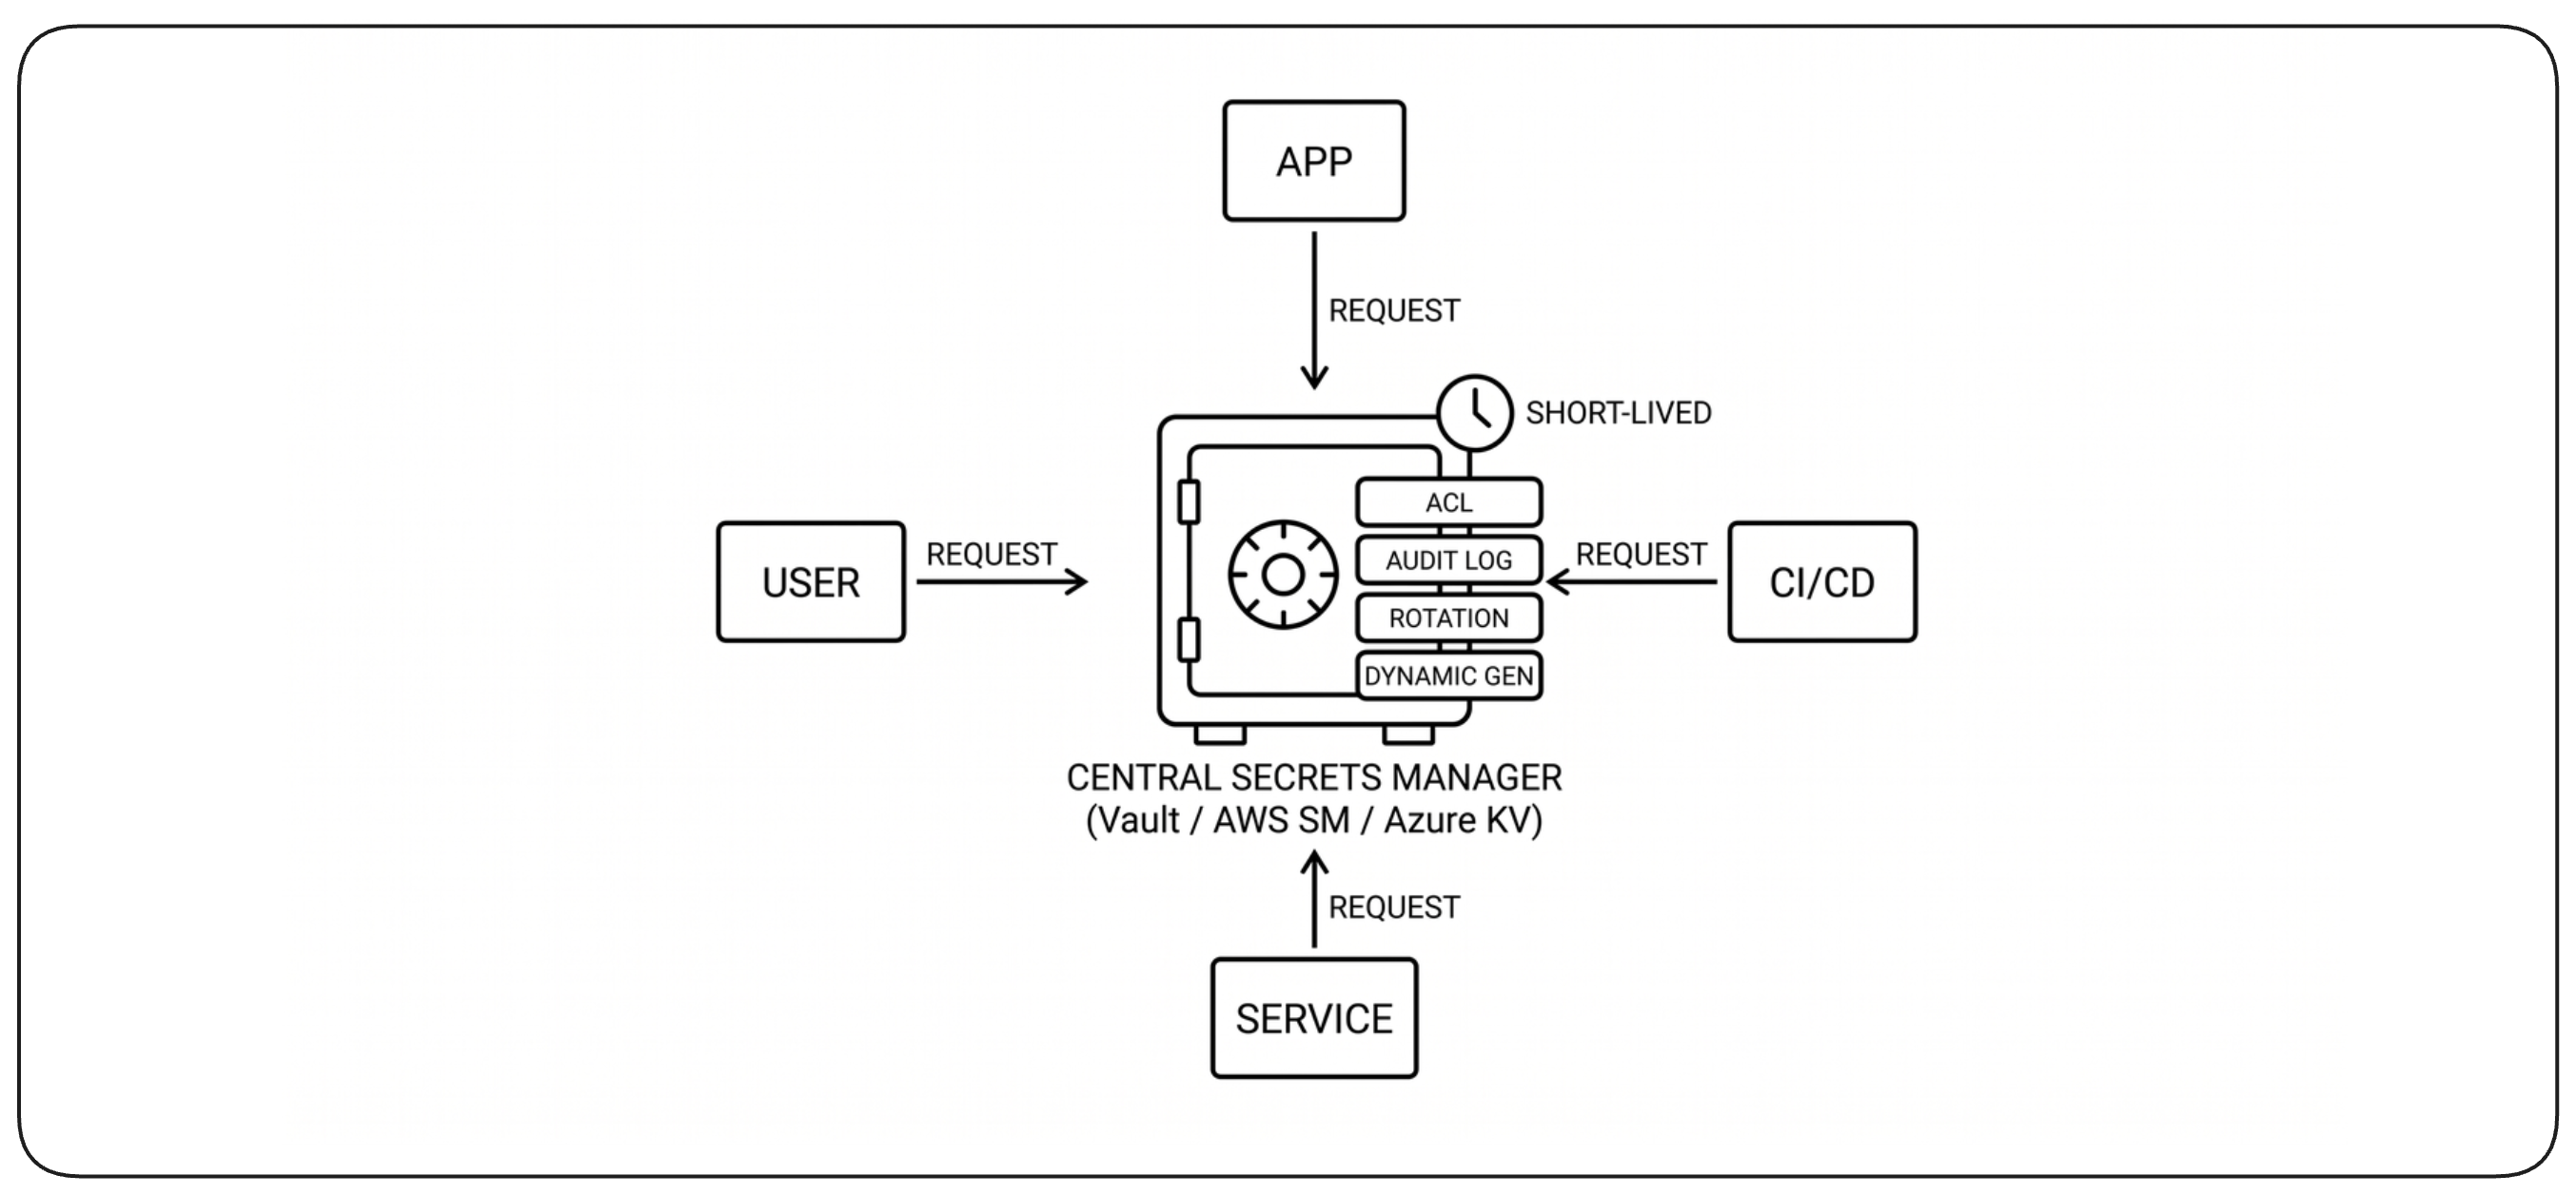
Systèmes centralisés de gestion des secrets
Les plateformes centralisées — comme HashiCorp Vault, AWS Secrets Manager, Azure Key Vault et Google Secret Manager — fournissent une source unique de vérité pour les identifiants. Chaque secret a un emplacement canonique ; les copies dans les fichiers de configuration, les variables d’environnement ou les systèmes CI sont des projections temporaires et révocables. Ces plateformes offrent un stockage chiffré, un contrôle d’accès fin, des journaux d’audit, le versionnement, la rotation et la génération dynamique de secrets. La centralisation rétablit la visibilité, applique le moindre privilège et garde cohérents les contrôles de sécurité et de conformité.
Le cycle de vie des secrets doit être automatisé
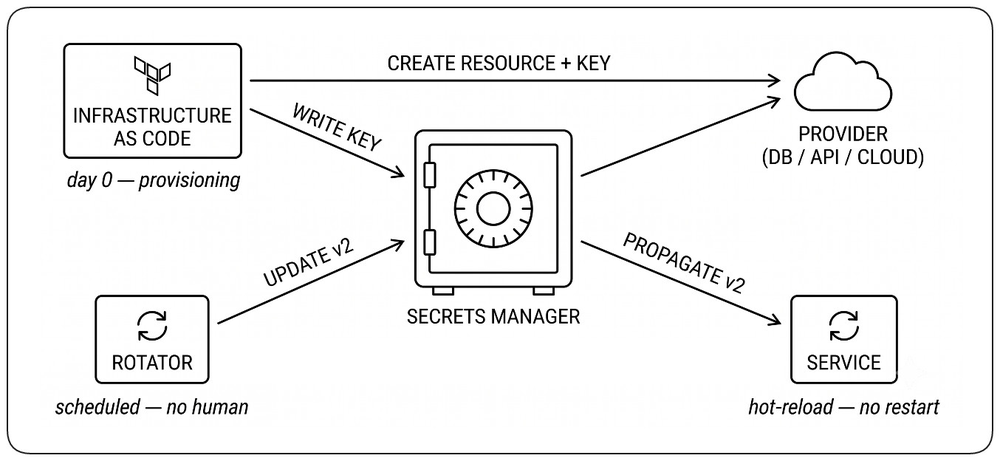
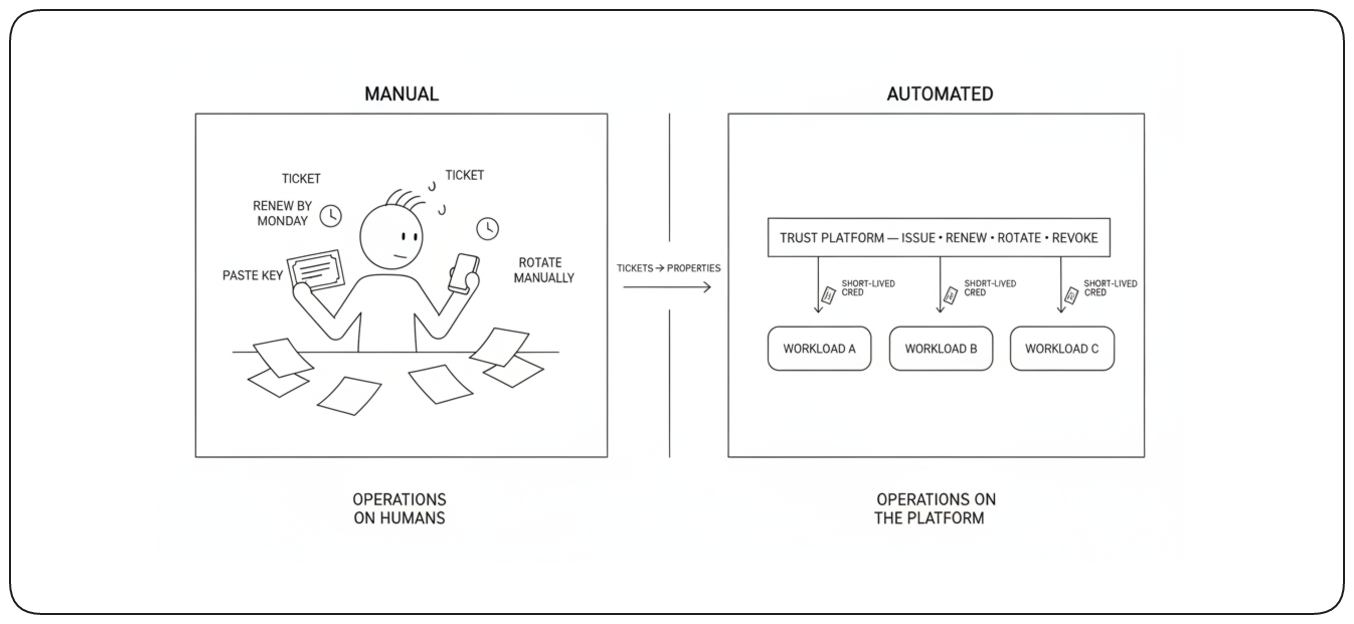
Centraliser les secrets ne suffit pas — si leur cycle de vie dépend encore d’humains, la plateforme hérite du risque même qu’elle devait supprimer. !!Génération, livraison, renouvellement, rotation et révocation sont des opérations très sensibles et doivent être automatisées partout où la plateforme le permet.!! Les workflows manuels sont lents, incohérents, et finissent par être sautés quand la rotation risque de perturber la production. L’automatisation éloigne les humains des identifiants bruts et rend les durées de vie courtes praticables.
Les secrets sont limités aux frontières d’isolation
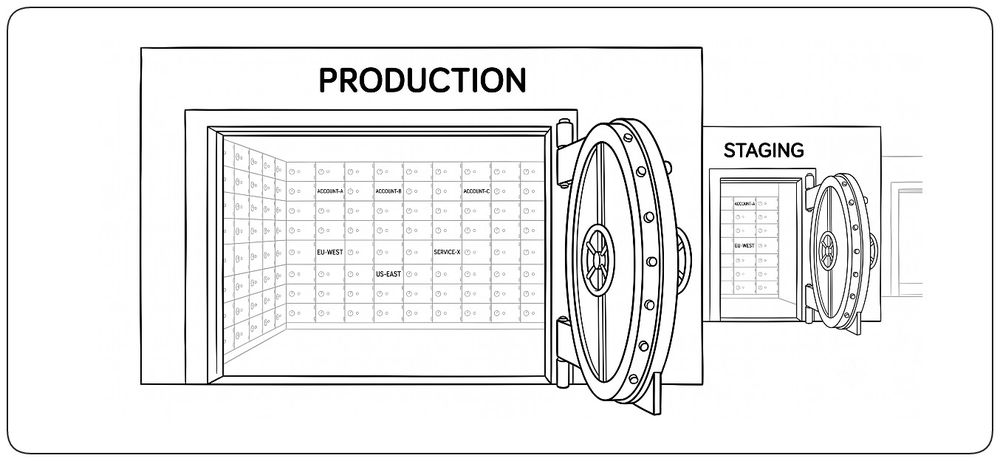
Chaque secret appartient à une frontière d’isolation — tenant, environnement, compte cloud ou région. !!Le rayon d’impact d’un secret est égal au périmètre où il vit ; une fuite dans une frontière ne peut pas compromettre les autres.!! Partager un secret entre frontières fusionne leurs rayons d’impact et doit être une décision explicite et encadrée — pas une commodité. Par défaut, chaque périmètre détient sa propre copie, générée et renouvelée indépendamment.
La récupération des secrets doit être découplée des applications
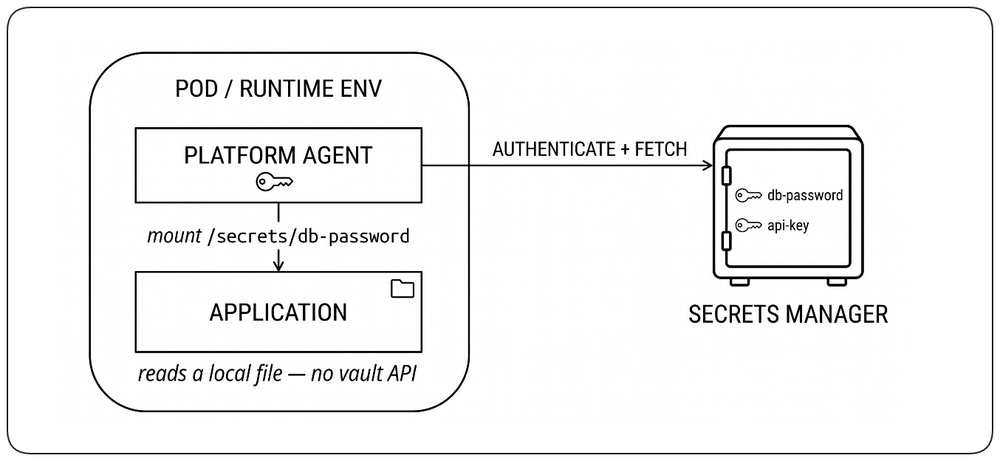
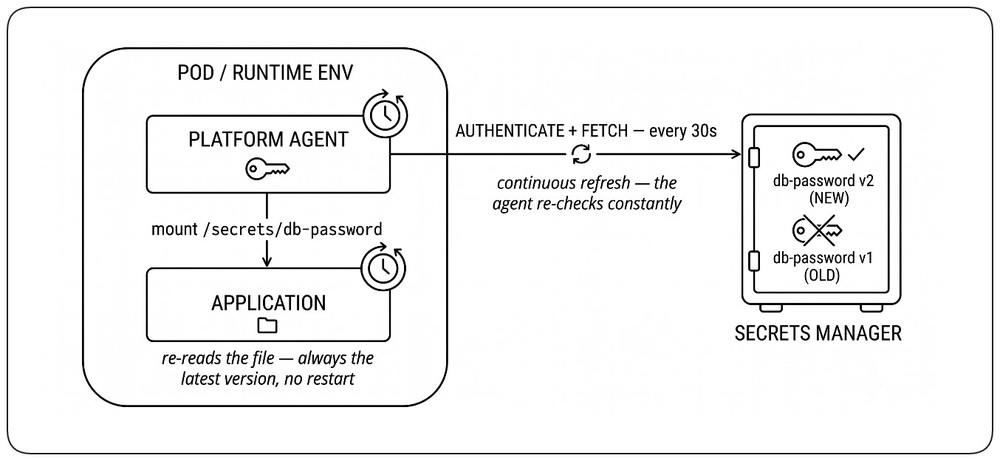
Les applications ne devraient pas s’authentifier directement auprès d’un gestionnaire de secrets ni dépendre de son API. !!La plateforme authentifie le workload, récupère les secrets auxquels il a droit et les expose via une interface locale comme un fichier monté, un volume en mémoire ou un agent local.!! Les artefacts de build et de déploiement ne contiennent que des références aux secrets requis, jamais les valeurs elles-mêmes. L’application consomme les secrets sans savoir où ils sont stockés ni comment l’accès est obtenu.
Les secrets doivent pouvoir être rafraîchis à l’exécution
Fournir un secret uniquement au démarrage le rend statique pour toute la durée de vie du processus. Mettre à jour la valeur dans le gestionnaire de secrets ne suffit pas si l’application continue d’utiliser l’ancienne. !!La plateforme doit propager automatiquement les secrets rafraîchis, et les applications doivent adopter la nouvelle valeur sans rebuild ni redémarrage.!! Cela vaut pour tout élément sensible — clés d’API, mots de passe de base de données, certificats TLS, certificats clients mTLS — un certificat renouvelé que le processus ne relit jamais cassera silencieusement l’authentification en pleine requête. La rotation exige une propagation des deux côtés : la plateforme écrit la nouvelle valeur, l’application la récupère.
Secrets dans les pipelines CI/CD
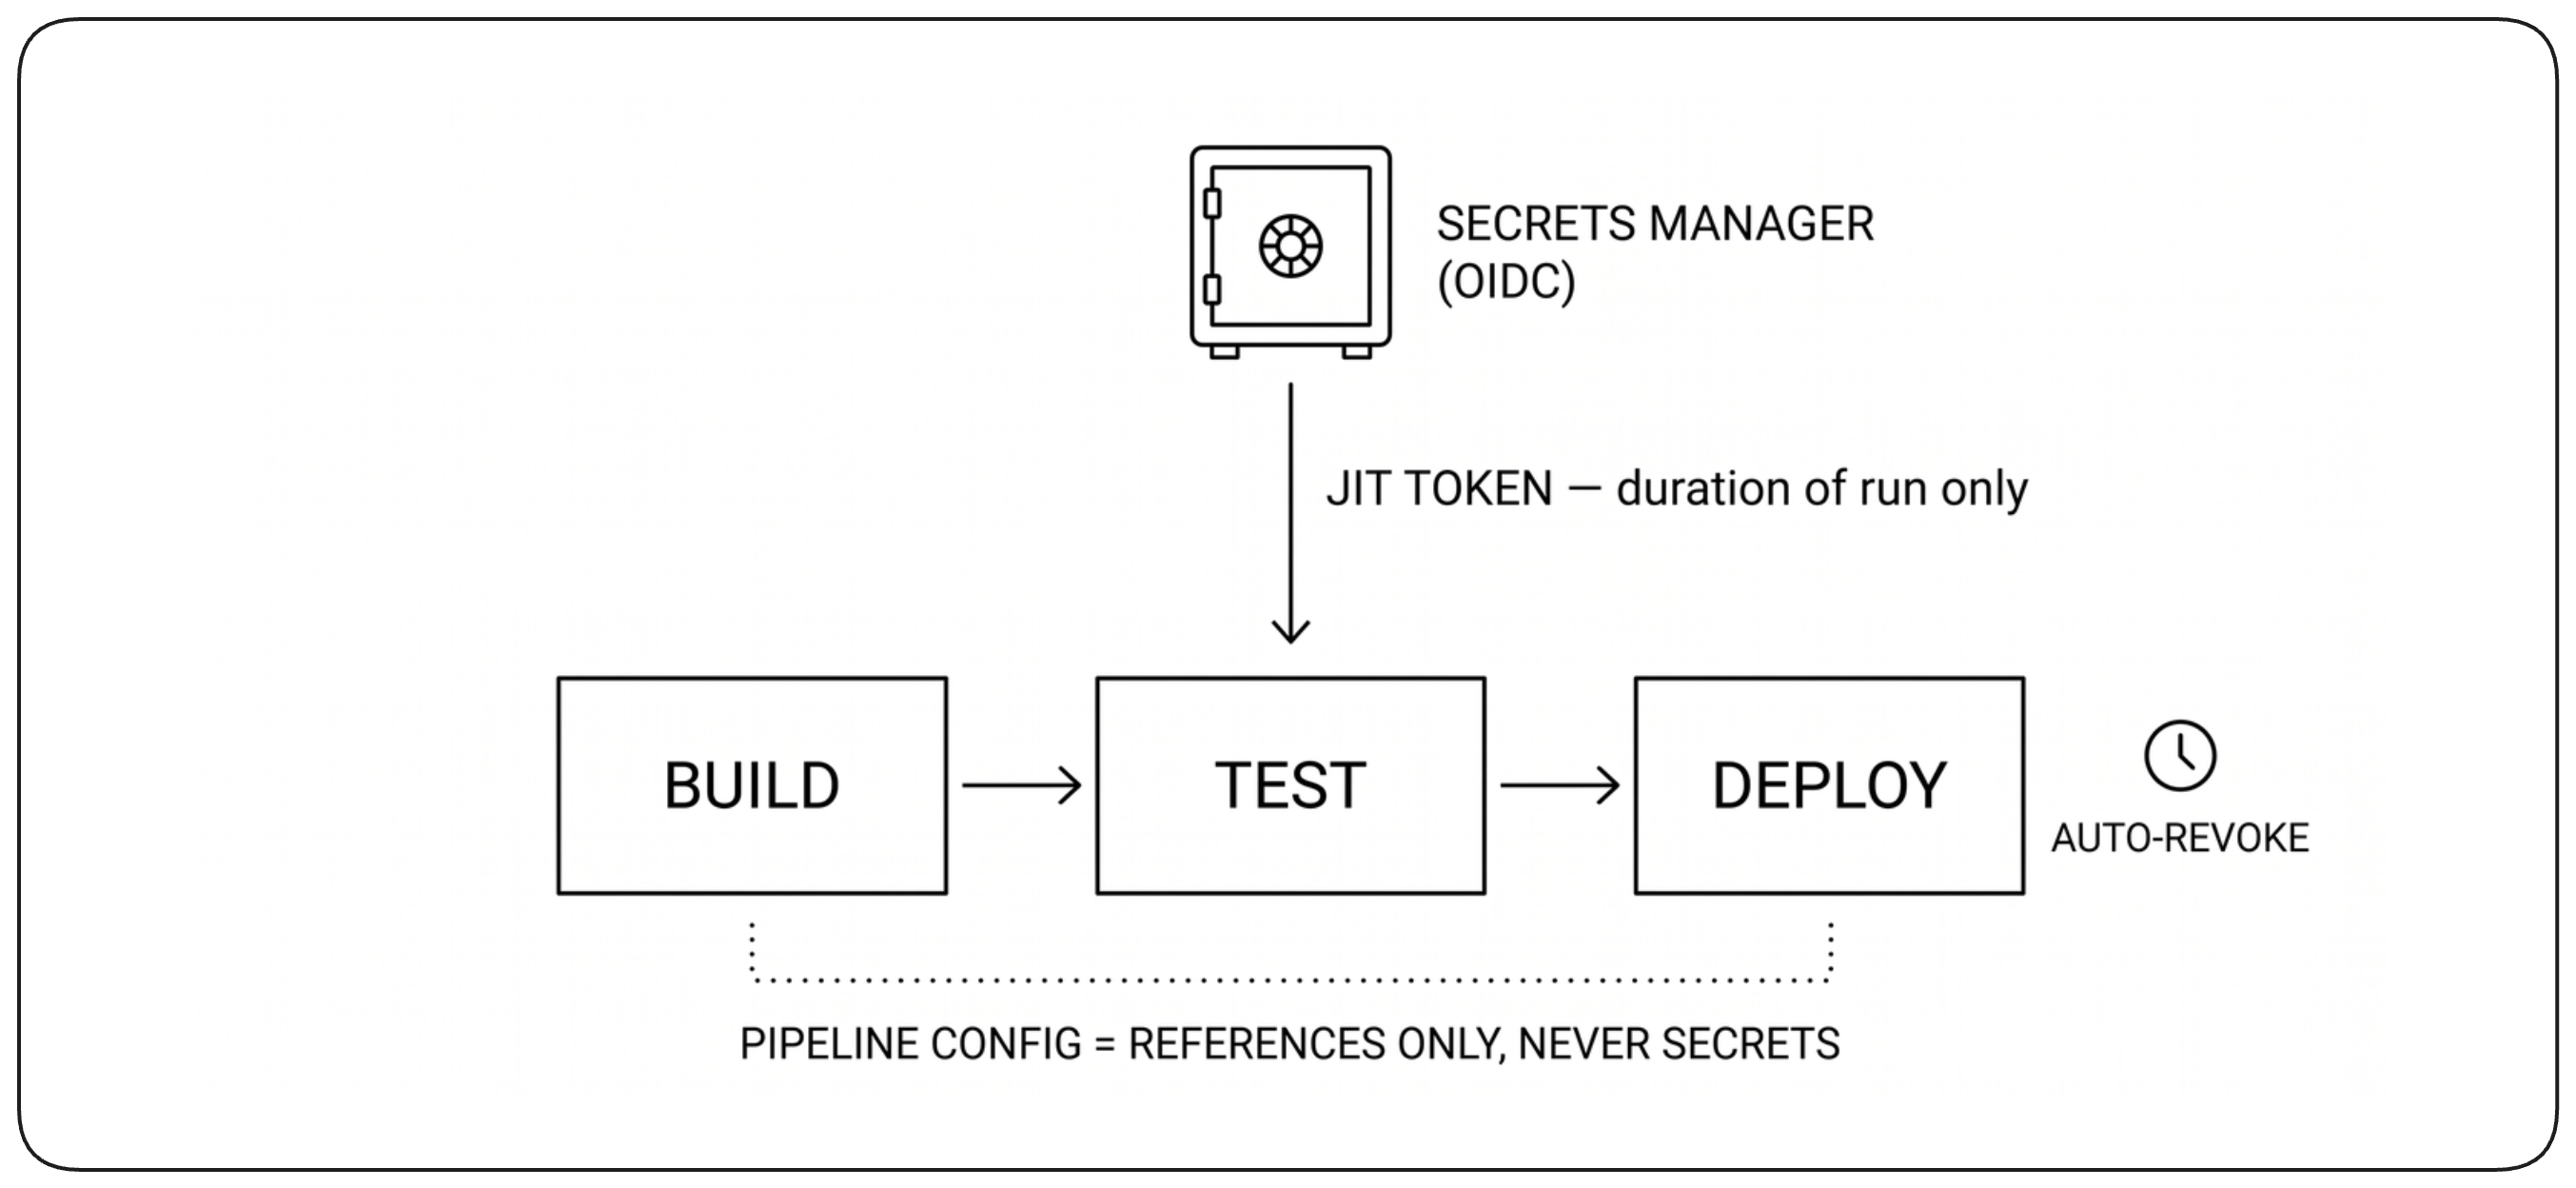
Les pipelines CI/CD ont besoin d’identifiants étendus pour déployer, tester et publier — traitez-les comme des identifiants de production, pas comme de simples commodités de build. !!Les définitions de pipeline portent des références, jamais des secrets ; le pipeline échange son identité de workload contre des identifiants de courte durée limités à l’exécution, puis ils sont révoqués.!! Pas de clés de service account de longue durée, pas de secrets committés dans le dépôt.
Opérer la confiance
Tout au long de ce chapitre, nous nous sommes concentrés sur la façon dont la confiance est établie — identités, authentification, autorisation, preuve cryptographique, protocoles, secrets, et la posture Zero Trust qui les relie. !!Le défi suivant est d’opérer cette confiance pendant toute la durée de vie du système.!! Les identités apparaissent et disparaissent, les certificats expirent, les clés sont renouvelées, les autorités sont compromises, les fédérations sont renégociées. Une architecture de confiance se juge non seulement à la justesse avec laquelle elle assemble les primitives, mais à la fidélité avec laquelle elle les opère une fois le système en marche.
Chaque identité a une source faisant autorité
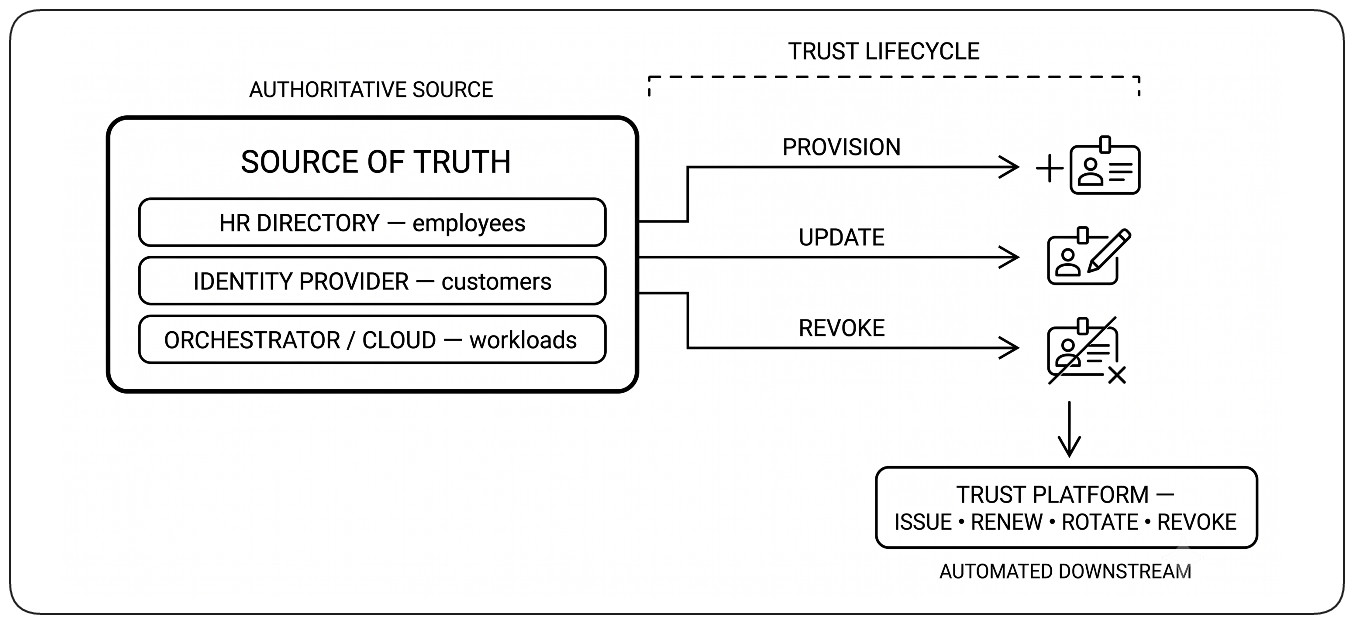
Chaque identité doit être gouvernée par une source faisant autorité — le système qui décide si l’identité existe, quels attributs elle porte, et quand elle doit changer ou disparaître. Pour les employés, c’est un annuaire RH ; pour les clients, un fournisseur d’identité ; pour les workloads, un orchestrateur, une plateforme cloud ou un système d’identité de workload. !!La source faisant autorité est le début du cycle de vie de la confiance : elle déclenche le provisionnement quand un acteur apparaît, met à jour l’accès quand son état change et lance la révocation quand l’acteur part.!! Sans source d’autorité clairement définie, les identités deviennent obsolètes, dupliquées et impossibles à retirer de façon fiable — toute la plateforme en aval hérite d’une ambiguïté qu’aucune rotation ni automatisation ne peut corriger.
Chaque artefact de confiance suit sa propre horloge
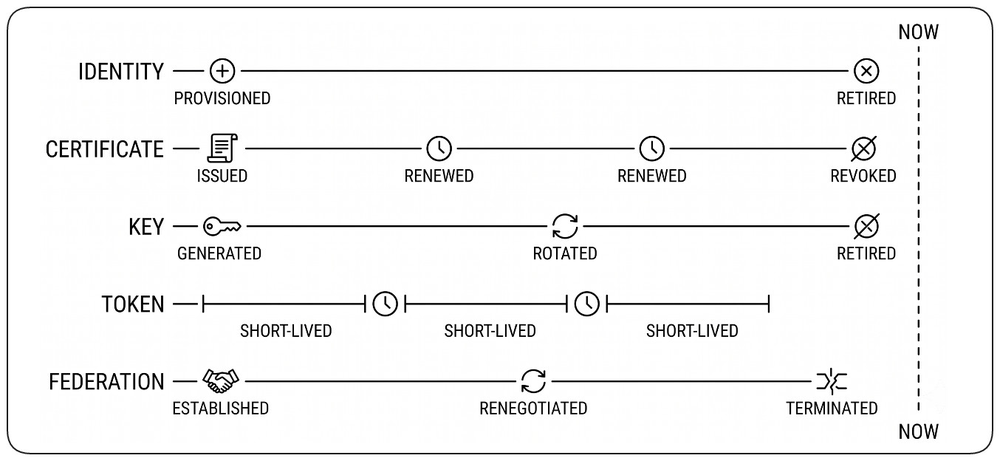
Identités, certificats, clés, tokens et fédérations suivent chacun leur propre cycle de vie indépendant. !!Une identité est provisionnée puis retirée ; un certificat est émis, renouvelé et révoqué ; une clé est générée, renouvelée et remplacée ; un token vit quelques minutes et est réémis en continu ; une fédération est établie, renégociée et finalement terminée.!! À tout instant, chaque artefact du système se trouve quelque part sur sa propre ligne de temps — aucun n’est stable, tous évoluent. Opérer la confiance, c’est concevoir pour ce mouvement continu, et non pour l’état figé du jour où le système a été déployé.
Chaque modèle de confiance déplace la complexité ailleurs
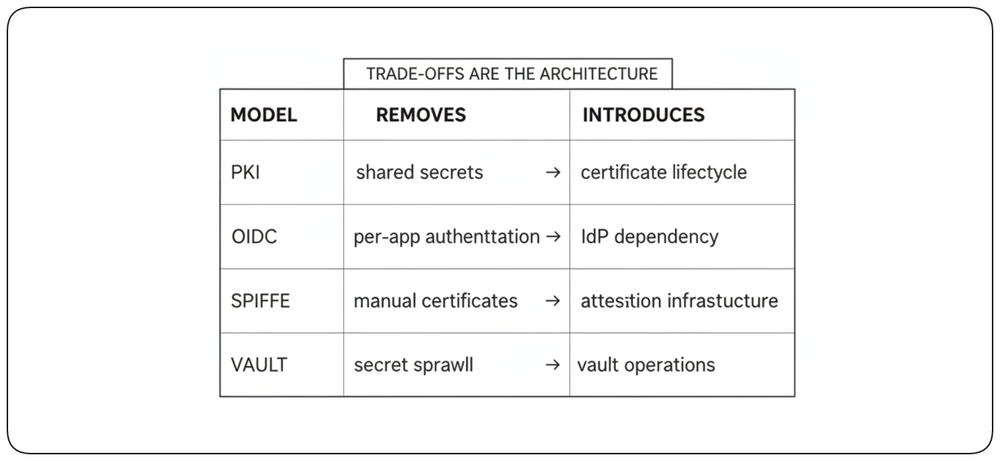
Une bonne architecture supprime la complexité inutile et place délibérément ce qui reste. Chaque mécanisme de confiance élimine une charge opérationnelle tout en en introduisant une autre : la PKI supprime la distribution de secrets partagés mais exige une gestion du cycle de vie des certificats ; OIDC retire la logique d’authentification des applications mais crée une dépendance envers l’IdP ; SPIFFE élimine le provisionnement manuel des certificats mais requiert une infrastructure d’attestation ; Vault réduit la dispersion des secrets mais devient lui-même un système critique. Choisir un modèle de confiance, c’est décider quelle complexité peut être supprimée et où la complexité restante doit vivre. Les architectes qui n’évaluent les mécanismes que sur leur élégance cryptographique ne voient que la moitié du tableau — l’autre moitié est la surface opérationnelle qu’ils créent.
Les plateformes opèrent la confiance
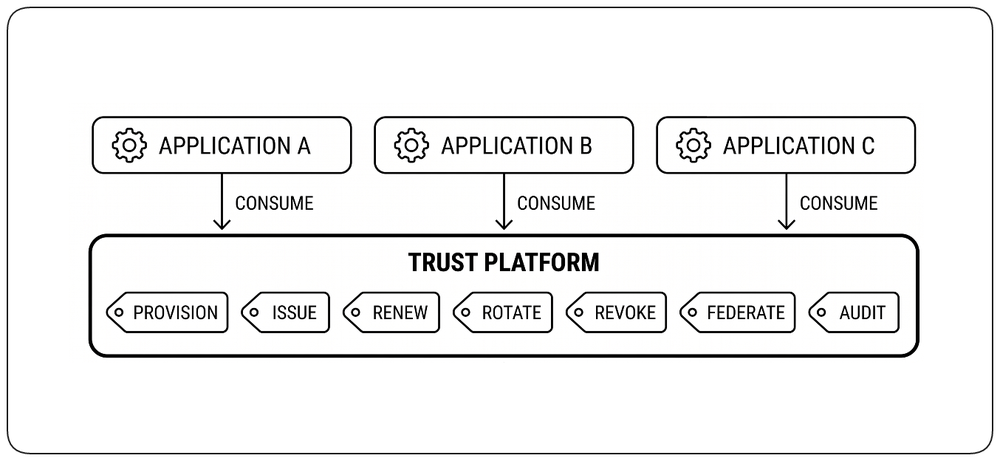
!!Les applications doivent consommer la confiance — les plateformes doivent l’opérer.!! Une application ne devrait pas savoir comment un certificat a été émis, quand il sera renouvelé, ni comment une identité de workload est attestée ; elle devrait seulement présenter l’identifiant que la plateforme lui a donné et faire confiance à la plateforme pour le maintenir en vie. Tout ce que le cycle de vie de la confiance exige — provisionnement, émission, renouvellement, rotation, révocation, fédération, audit — est une propriété de la plateforme, pas une checklist à l’intérieur de chaque service. L’automatisation n’est pas ici une optimisation, c’est l’architecture : dès qu’une opération de confiance exige qu’un humain soit en ligne, le système cesse de passer à l’échelle avec le nombre de workloads et commence à passer à l’échelle avec le nombre d’ingénieurs.
Conçu pour survivre à ses propres défaillances
!!Une architecture de confiance se juge à la façon dont elle se comporte quand l’un de ses propres fondements se brise.!! Tout mécanisme finit par échouer : des certificats expirent sans qu’on s’en aperçoive, des CA sont compromises, des clés doivent être révoquées en plein vol, des fournisseurs d’identité tombent, des fédérations se rompent, des rotations échouent en cours de route, des identifiants sont volés. Chacun de ces événements est réel et se produira, et chacun a une réponse architecturale — fenêtres de validité qui se chevauchent pour que les renouvellements ne soient jamais un précipice, CA de secours préparées pour une rotation sans interruption, chemins de révocation qui se propagent plus vite que les identifiants qu’ils invalident, redondance de l’IdP et tokens en cache de courte durée pour qu’une panne de fournisseur ne se propage pas en cascade, rayon d’impact limité pour qu’une identité compromise ne puisse pas dépasser son périmètre. Le chemin nominal n’est pas la conception. Le chemin de défaillance l’est.
La confiance est le substrat des systèmes distribués
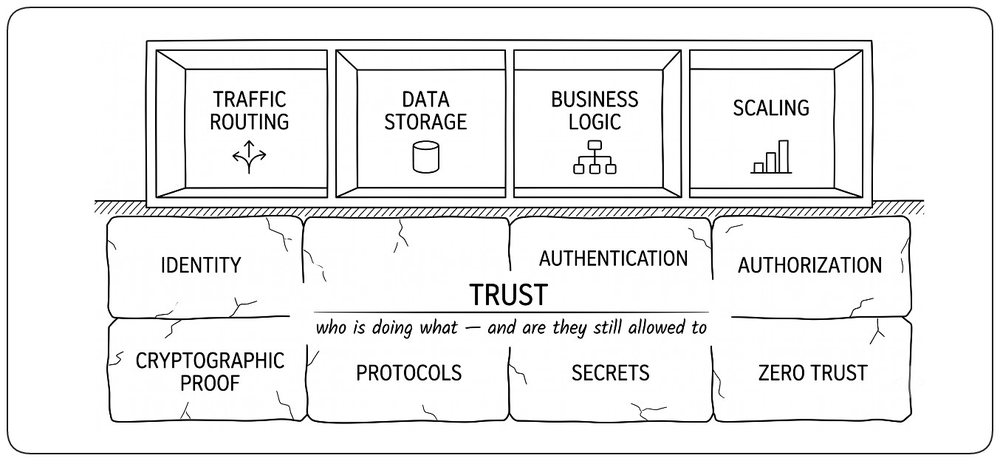
Les mécanismes de ce chapitre — identité, authentification, autorisation, preuve cryptographique, protocoles, secrets, Zero Trust — ne sont pas une checklist à configurer une fois pour toutes. Ensemble, ils forment le substrat qui permet à un système distribué de continuer à répondre à la seule question qui compte : !!qui fait quoi, en ce moment, et en a-t-il toujours le droit.!! Tout le reste dans une architecture distribuée — routage du trafic, stockage des données, logique métier, scalabilité — suppose que cette question a une réponse correcte, continue et applicable. La confiance n’est pas une préoccupation de sécurité superposée au système ; c’est le fondement sur lequel il repose.