Concevoir pour la testabilité
Chapter Info
Calculating... Writing Progress: 70%
La testabilité est une propriété architecturale, pas une activité de QA ajoutée après l’implémentation. Le système est conçu pour que son comportement puisse être vérifié en continu et avec un effort minimal, grâce à des contrats clairs, des entrées maîtrisées et des résultats observables.
L’objectif de la testabilité n’est pas de produire plus de tests. C’est de réduire l’incertitude sur le fait qu’un changement soit sans danger.
Quand la testabilité fait défaut, les équipes compensent par des environnements end-to-end lents, des fixtures fragiles et de la validation manuelle. Le coût se manifeste par des tests instables, de longues boucles de feedback et des déploiements qui semblent risqués. Concevoir pour la testabilité fait de la vérification une capacité courante plutôt qu’un projet récurrent.
Ce chapitre explique comment rendre un logiciel vérifiable par construction : des choix de conception qui permettent l’isolation, l’exécution déterministe et un feedback pertinent à chaque niveau, de la logique unitaire jusqu’à la validation en production.
Pourquoi la testabilité compte
La testabilité est un multiplicateur de qualité et de vélocité. Quand l’architecture permet des vérifications rapides et fiables, les équipes peuvent refactorer sans risque, livrer plus souvent et détecter les régressions avant les utilisateurs.
La testabilité est une propriété architecturale
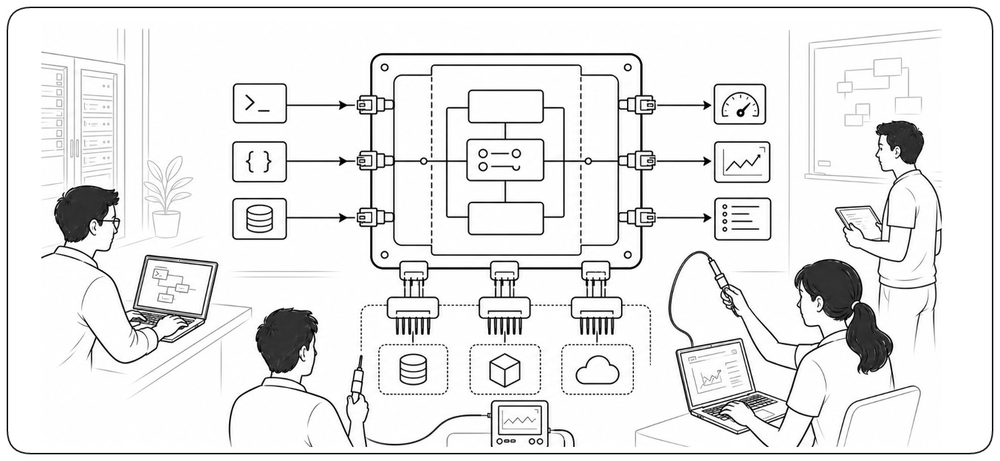
Un système est testable quand on peut l’exercer avec des entrées maîtrisées et observer son comportement sans deviner. Cela suppose des frontières explicites, des contrats stables et des points d’insertion (seams) pour les dépendances. !!Les tests ne créent pas la testabilité ; ils ne font que l’exploiter.!! Quand un composant est impossible à valider sans être modifié, c’est le symptôme d’un couplage fort, pas un obstacle de test.
Concevoir pour la testabilité dès le premier jour
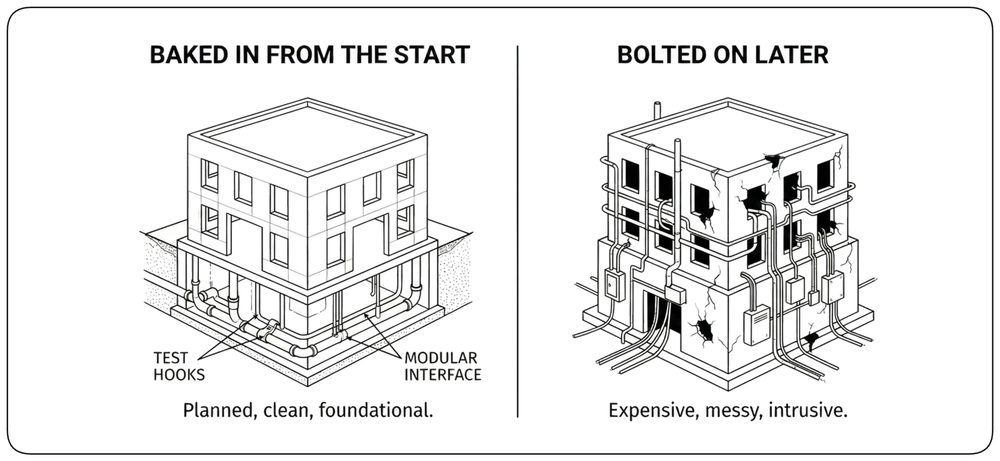
Les décisions structurelles qui rendent un système testable — frontières claires, dépendances remplaçables, état contrôlable, comportement observable — ne se rattrapent pas à bas coût. Concevez pour la testabilité dès le premier jour, comme une contrainte de premier rang au même titre que la sécurité, la scalabilité et la résilience.
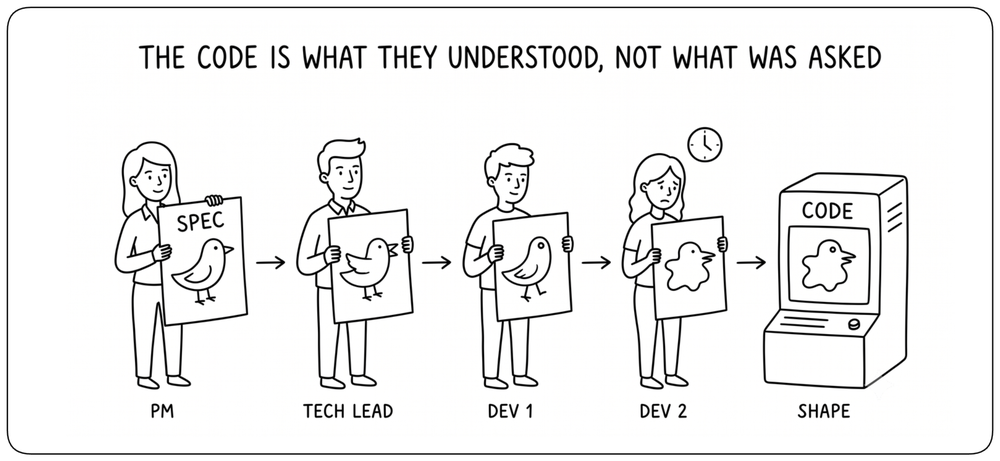
Le code n’est pas la spécification
Lire le code dit ce qu’un système fait, pas ce qu’il devait faire. Entre la spécification produit et le code en production se trouve une chaîne d’interprétation : ce que le PM a écrit, ce que le tech lead a entendu, ce que chaque développeur a compris, ce qu’il a eu le temps de construire. !!Le code n’est pas la spécification — c’est ce que l’équipe croyait être la spécification!!. La rétro-ingénierie d’une base de code restitue la compréhension des développeurs, jamais la vérité produit, c’est pourquoi le comportement attendu doit avoir une source de vérité indépendante : exigences, contrats, SLO ou autres spécifications explicites.
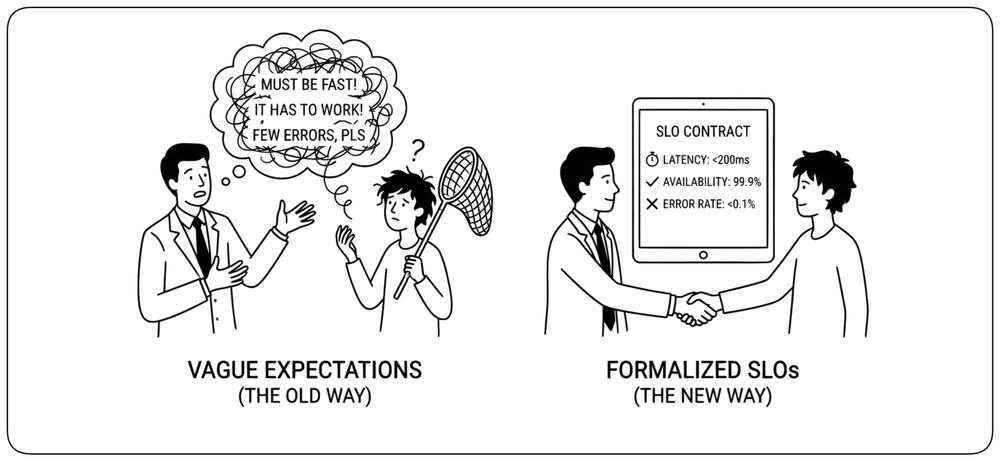
Formaliser explicitement les SLO
On ne peut pas tester ce qu’on n’a pas défini. Les Service Level Objectives (SLO) transforment des attentes vagues en cibles mesurables comme la disponibilité, la latence ou les taux d’erreur. Chaque SLO doit être vérifiable et rattaché à un contrat explicite : s’il exige une capacité ou une latence précise, ces exigences doivent être encodées et vérifiées automatiquement, afin que les seuils d’alerte découlent de la définition et créent un lien direct entre exigences métier et validation automatisée.
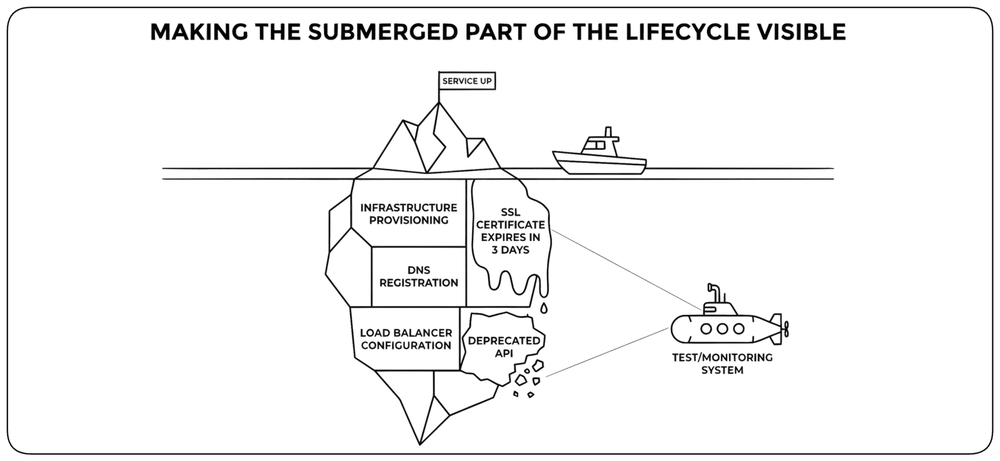
Rendre visible le cycle de vie du système
Un système n’est testable que si son cycle de vie est observable. Quand un SLO exige plusieurs étapes pour devenir opérationnel — provisionnement, enregistrement des endpoints, routage du trafic — ces étapes doivent être explicites et vérifiables. Un cycle de vie caché crée des dépendances de test cachées : un test peut échouer non pas parce que le comportement est faux, mais parce que le système n’a pas encore atteint l’état que le test suppose. Traitez la dérive du cycle de vie comme un mode de défaillance de premier rang et écrivez des tests qui détectent quand les hypothèses dont dépend votre système (dépréciations de modèles, expirations de certificats) ne sont plus vraies, avant qu’elles n’échouent en production.
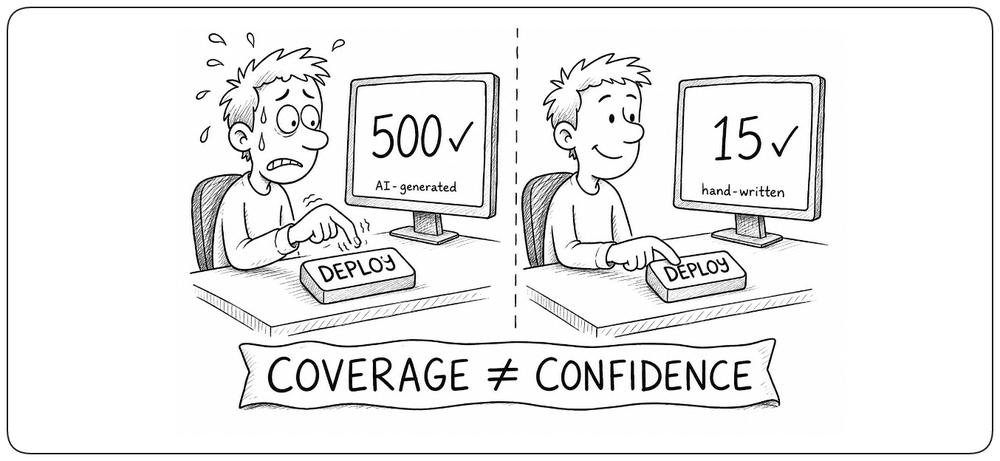
La confiance prime sur la couverture
La couverture indique quelle part du code est couverte par des tests, mais une couverture élevée ne signifie pas que le comportement important est correctement testé. On peut avoir 90 % de couverture et avoir quand même peur de modifier le code, parce que les tests peuvent ne pas détecter ce qu’on casse. Le vrai objectif est la confiance : quand vous changez quelque chose d’important, les tests vous diront-ils rapidement si le système fonctionne toujours comme prévu ? !!La couverture est une mesure. La confiance est l’objectif.!!
La valeur du feedback rapide
Des tests rapides changent les comportements. Quand la validation s’exécute en quelques secondes, les développeurs la lancent en permanence et corrigent les problèmes à la source ; quand elle prend une heure, ils la repoussent, et les problèmes s’accumulent jusqu’à devenir plus difficiles à isoler. Les choix d’architecture déterminent si le feedback est rapide : le service peut-il tourner en local, les dépendances peuvent-elles être substituées, l’état peut-il être réinitialisé à peu de frais. La testabilité est la discipline qui consiste à réduire le coût de la vérification.
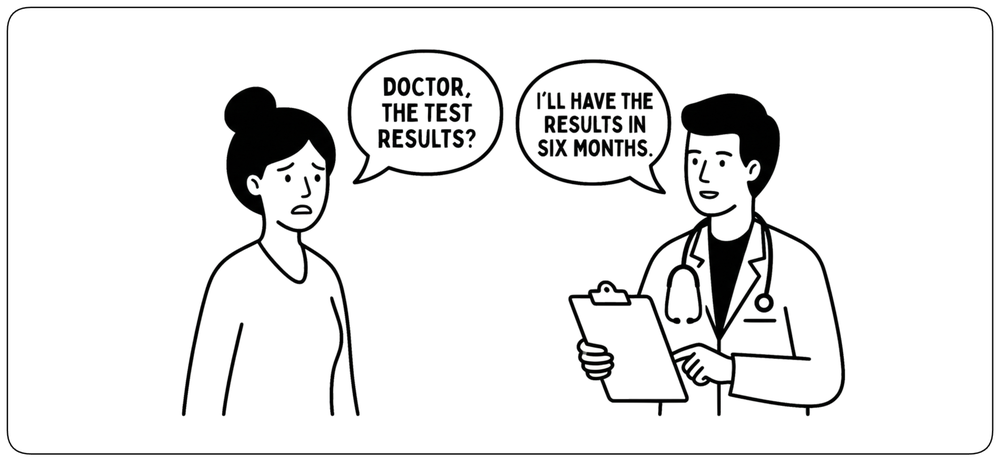
Le SLO du développeur, c’est le temps-jusqu’à-la-confiance
La confiance n’est utile que si elle arrive assez vite pour influencer le changement qui l’a produite. Le vrai SLO du développeur est le temps-jusqu’à-la-confiance : le délai entre un changement et une preuve fiable qu’il peut être livré sans danger. Quand cet intervalle est court, le déploiement devient routinier — une étape, pas un événement. Quand il s’allonge, les ingénieurs repoussent les changements, les regroupent et perdent l’attribution fine qui rend les défaillances peu coûteuses à diagnostiquer. !!Une suite de tests ne crée de la valeur que si la confiance arrive assez vite pour influencer la décision de livrer.!!
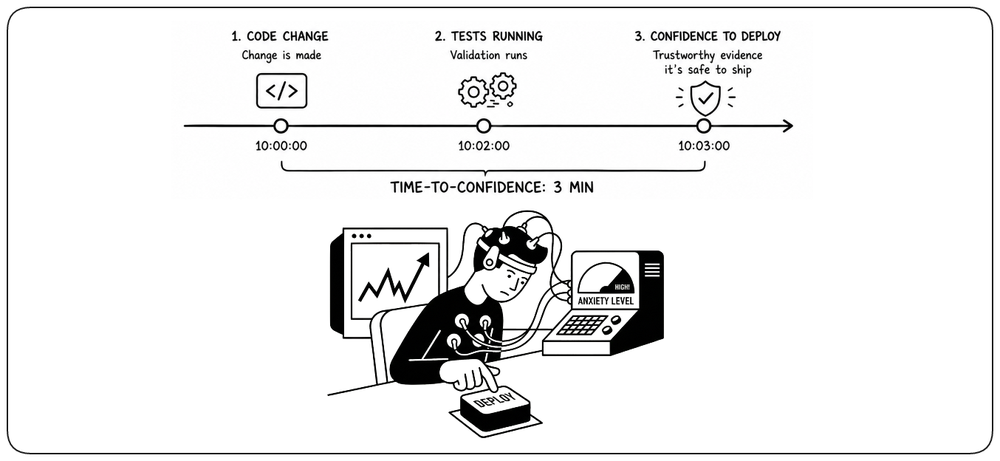
La testabilité rend l’incertitude peu coûteuse à lever
Une architecture testable rend l’incertitude peu coûteuse à lever. Ses dépendances peuvent être contrôlées, son comportement observé, ses défaillances reproduites, et ses composants vérifiés sans reconstruire tout le système. Les tests sont le mécanisme ; la confiance est le résultat. !!L’objectif de la testabilité n’est pas d’avoir plus de tests. C’est d’avoir moins d’incertitude.!!
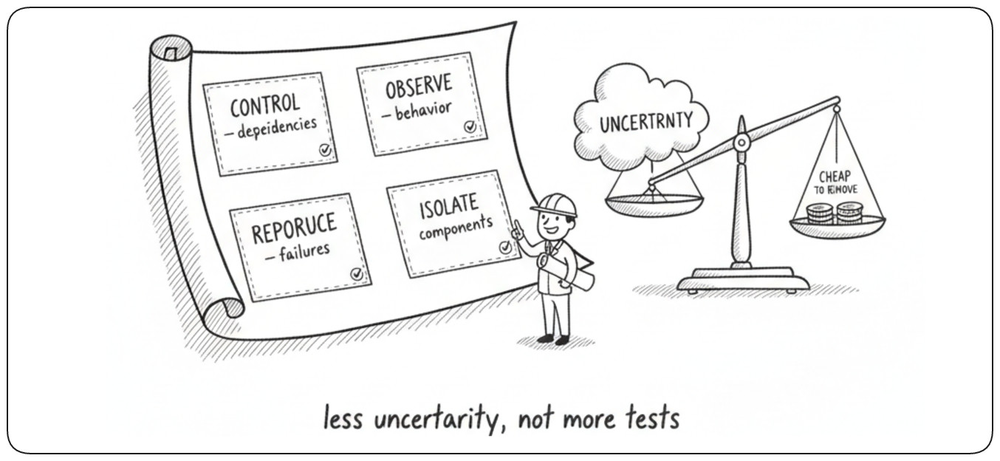
Fondations architecturales de la testabilité
Concevez pour la testabilité en rendant les dépendances explicites, les résultats observables et l’exécution reproductible. L’objectif est de vérifier le comportement sans reconstruire le monde.
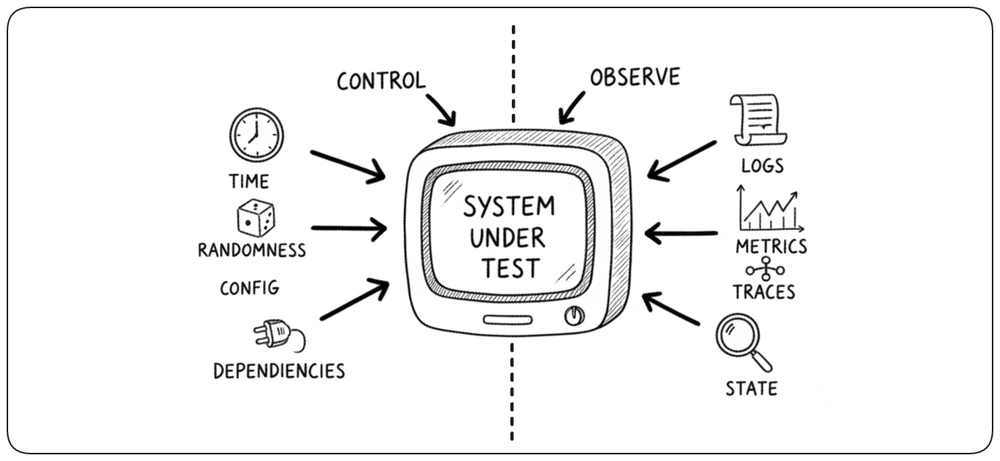
Les deux faces : contrôlabilité et observabilité
Un système est testable quand on peut à la fois contrôler ses conditions et observer son comportement. !!La contrôlabilité nous permet d’établir l’état, le temps, la configuration, les dépendances et les défaillances. L’observabilité nous permet de déterminer ce qui s’est passé et pourquoi.!! Sans contrôle, les scénarios ne peuvent pas être reproduits. Sans observation, les résultats ne peuvent pas être vérifiés. Chaque technique qui suit — injection de dépendances, isolation des effets de bord, tracing, hooks de test — est en définitive une façon d’affûter l’un de ces deux axes.
Contrats clairs et frontières stables
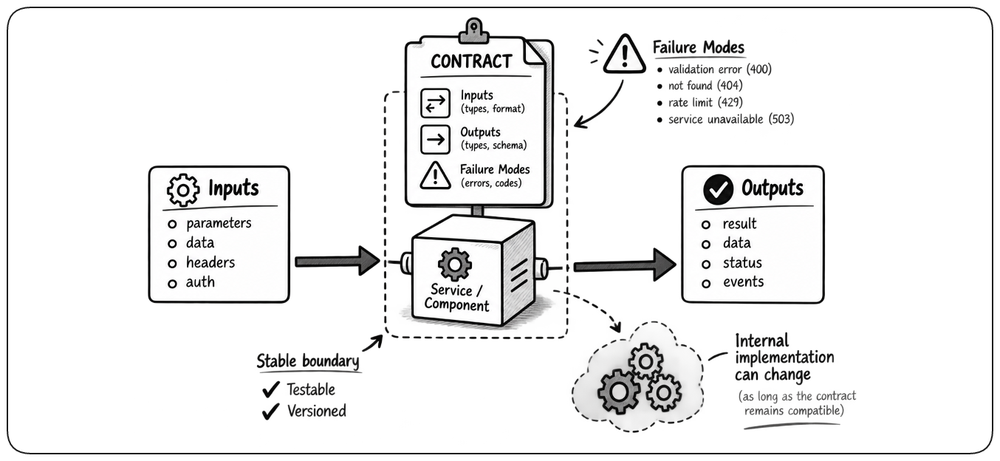
Une frontière est testable quand elle a un contrat clair : entrées, sorties et modes de défaillance sont explicites. !!Les contrats font de l’intégration quelque chose qui se valide et se versionne, plutôt que de se découvrir par accident à l’exécution.!! De bons contrats rendent les tests plus résilients, car ils se concentrent sur le comportement plutôt que sur les détails d’implémentation interne, et ils permettent un travail parallèle entre équipes : les changements sont sûrs tant que le contrat reste compatible.
Isoler les effets de bord derrière une frontière
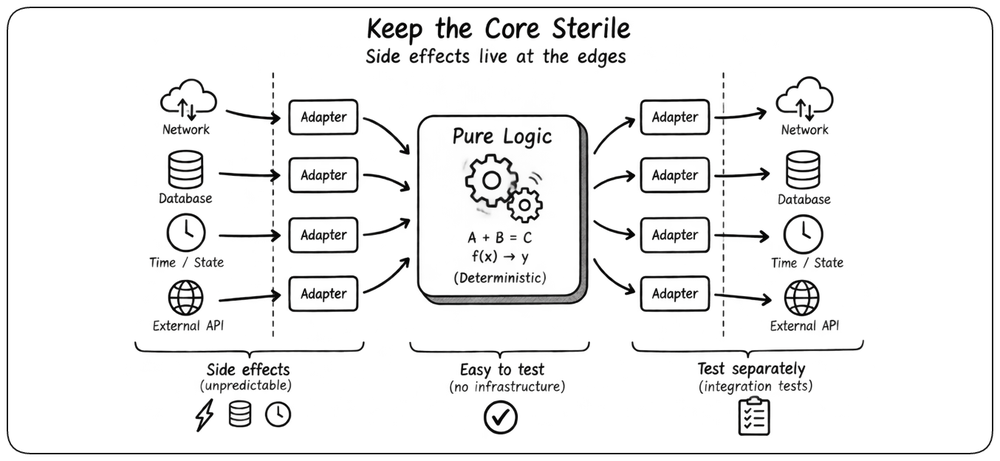
Les effets de bord compliquent les tests. Appels réseau, écritures en base, état global et temps peuvent tous introduire un comportement imprévisible. Gardez la logique métier simple et déterministe, et déplacez ces effets de bord derrière des adapters. Ainsi, l’essentiel du système peut être testé rapidement sans infrastructure, tandis que les adapters sont testés séparément.
L’injection de dépendances pour faciliter les tests
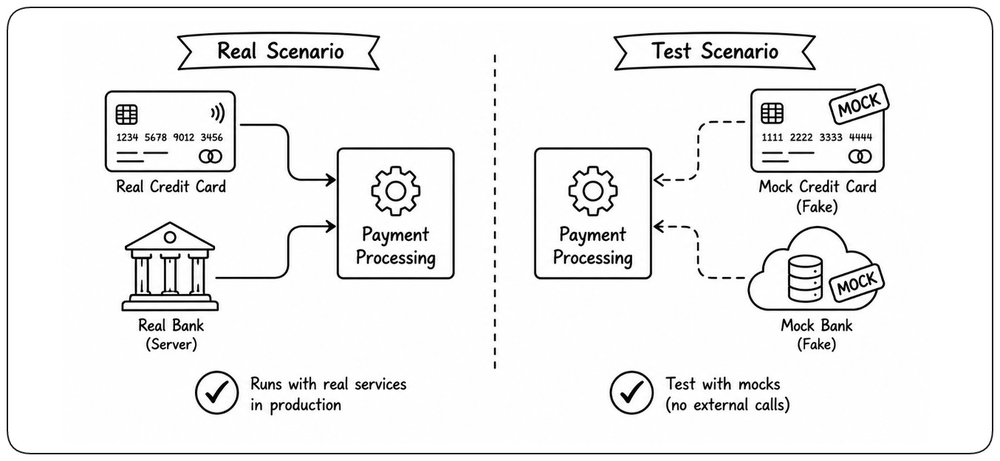
L’injection de dépendances rend les dépendances explicites et remplaçables. Au lieu de créer en interne un client HTTP, une connexion à une base de données ou une horloge, un composant les reçoit. !!Dans les tests, ces dépendances peuvent être remplacées par des doublures déterministes.!! On conserve ainsi vitesse et prévisibilité tout en validant la logique métier, et l’architecture s’améliore, car on est forcé de séparer le comportement central de la mécanique d’infrastructure.
Les limites du mocking
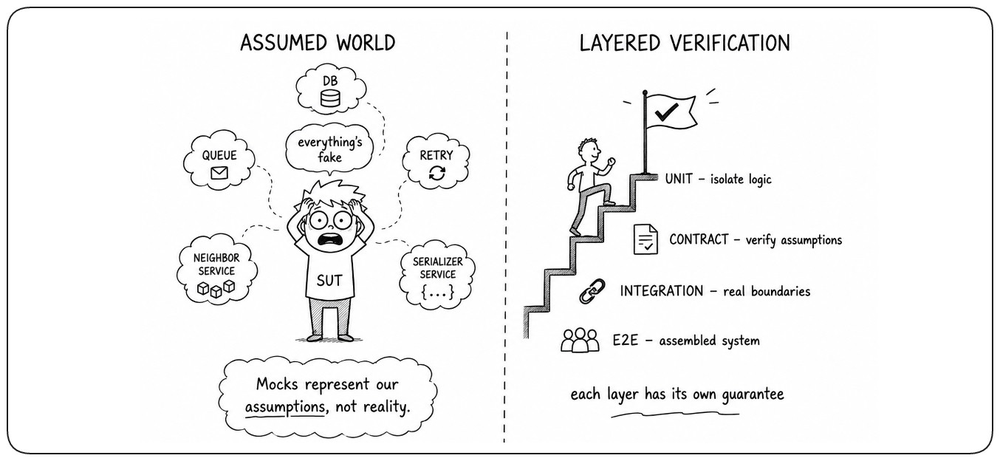
Les mocks sont utiles pour isoler la logique et garder des tests rapides, mais ils ont une limite importante : un mock représente notre hypothèse sur le comportement d’une dépendance, pas la dépendance elle-même. Un test peut passer alors que cette hypothèse ne correspond plus à la réalité. Plus on mocke de dépendances, plus le test peut s’éloigner du système réel. C’est pourquoi les mocks doivent être complétés par des tests de contrat, d’intégration et end-to-end qui vérifient ces hypothèses face à de vrais composants et de vraies frontières. !!Les mocks vérifient des hypothèses. Les autres niveaux de test confrontent ces hypothèses à la réalité.!!
Rendre les tests reproductibles
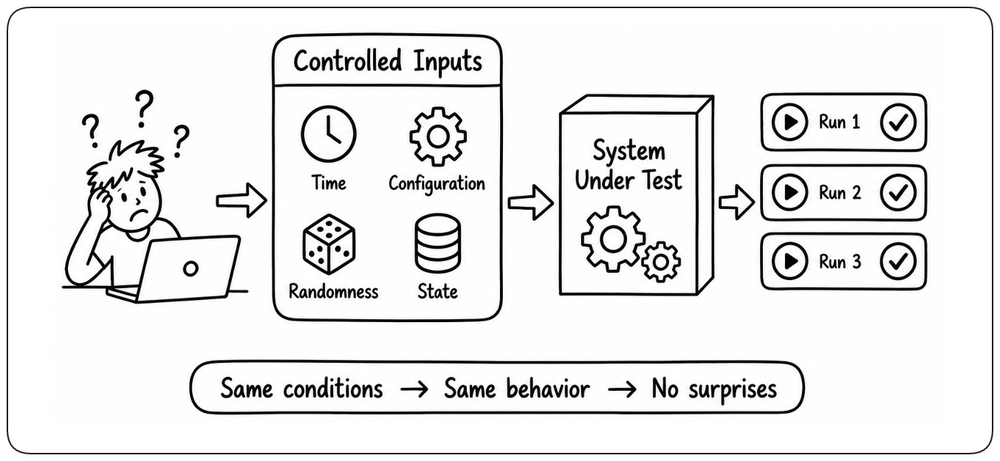
Un test n’est fiable que si les mêmes conditions produisent le même comportement. !!Contrôlez tout ce qui peut varier d’une exécution à l’autre — temps, configuration, aléatoire, état et dépendances externes!! — pour que le scénario lui-même soit stable et reproductible.
Capturer les échecs pour pouvoir les rejouer
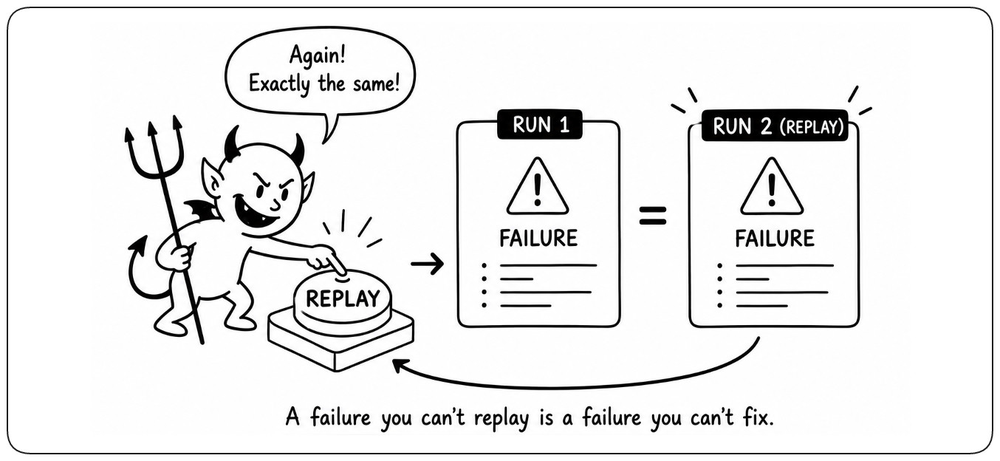
Quand un test échoue, la reproductibilité devient un autre problème : conserver assez de preuves pour recréer ce qui s’est passé. Capturez les entrées, la seed aléatoire, les versions des dépendances, l’état de l’environnement, les correlation IDs et la séquence d’événements pertinente. L’objectif n’est plus d’empêcher la variation, mais de rendre l’exécution en échec rejouable a posteriori. !!Avant le test : contrôler les conditions. Après un échec : préserver les preuves.!!
Rendre l’exécution des tests idempotente
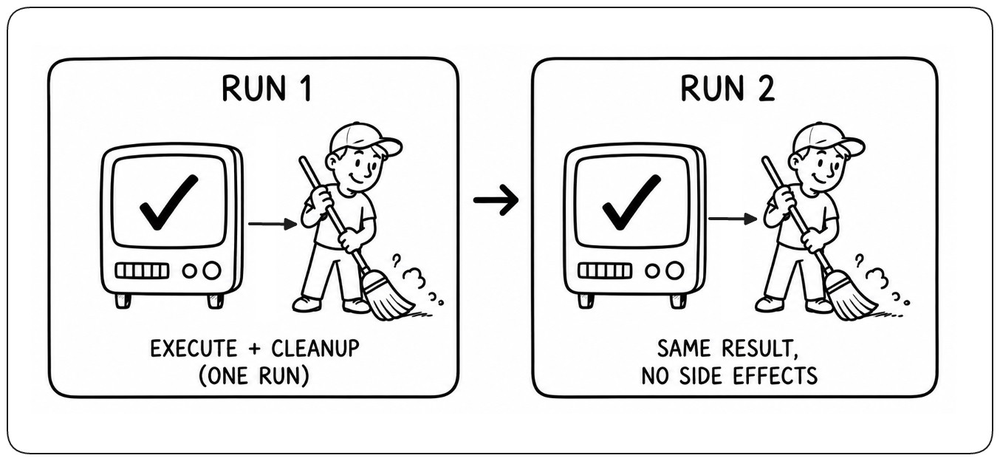
Les tests doivent laisser le système exactement comme ils l’ont trouvé. Ils doivent pouvoir être exécutés sans risque de façon répétée, séquentielle ou parallèle, sans qu’une exécution n’affecte une autre. La préparation, l’exécution et le nettoyage doivent donc être isolés et répétables, de sorte que lancer deux fois le même test n’ait pas plus d’impact que le lancer une fois. !!Exécuter un test deux fois doit avoir le même effet que l’exécuter une fois.!!
Garder les tests isolés
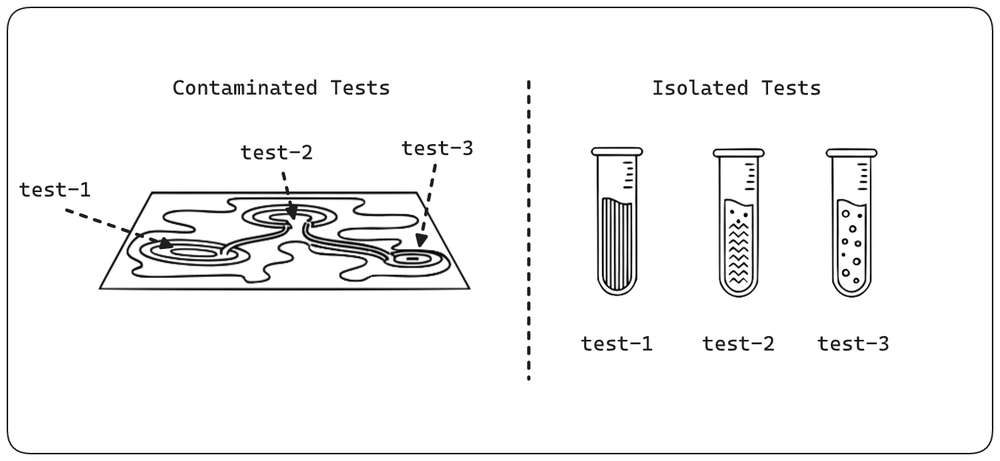
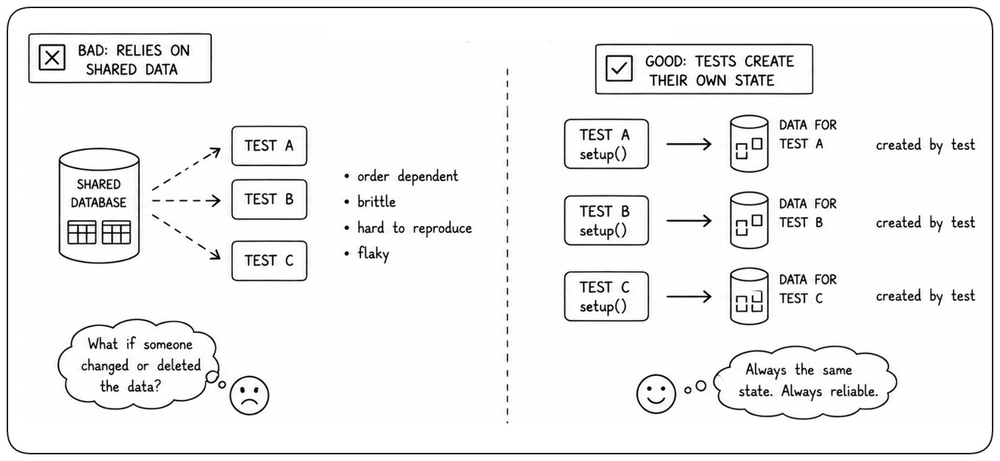
Les tests s’exécutent souvent en parallèle sur le même système. S’ils partagent utilisateurs, enregistrements, files, fichiers ou noms de ressources, un test peut modifier l’état sur lequel un autre s’appuie — même si les deux nettoient correctement ensuite. !!Chaque test doit donc posséder ses données et ses ressources, en utilisant des jeux de données isolés, des identifiants uniques ou des namespaces dédiés.!!
Créer les données dont vos tests ont besoin
Les tests qui dépendent de données doivent créer ou initialiser eux-mêmes l’état dont ils ont besoin, plutôt que de s’appuyer sur des données partagées préexistantes. Les utilisateurs, enregistrements, configurations ou fixtures nécessaires doivent faire partie de la préparation du test, pour que le scénario démarre d’un état connu et puisse s’exécuter à répétition dans n’importe quel environnement. Les données de test font partie du test, pas d’une dépendance cachée de l’environnement.
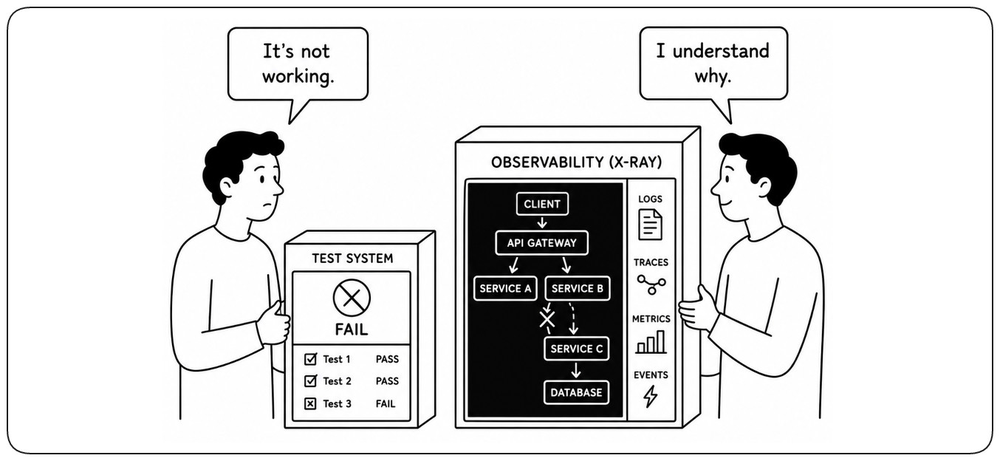
Tests et observabilité fonctionnent ensemble
Les tests et l’observabilité offrent deux vues complémentaires du comportement du système. !!Les tests vérifient si le système s’est comporté comme prévu ; l’observabilité aide à expliquer ce qui s’est réellement passé et pourquoi.!! Logs, métriques, traces et état observable facilitent le diagnostic des défaillances et peuvent aussi vérifier un comportement architectural important, comme les services appelés ou le chemin suivi par une requête. Ensemble, ils transforment un simple succès ou échec en preuve que les développeurs peuvent comprendre et exploiter.
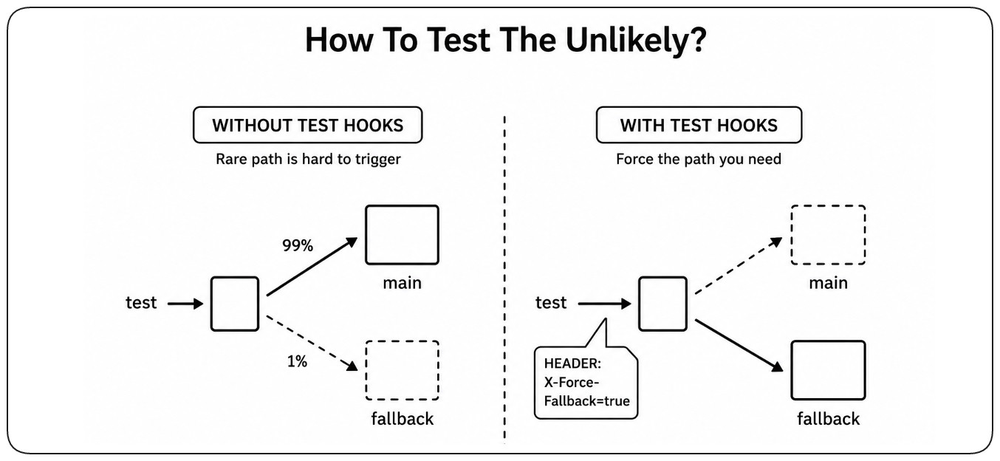
Concevoir le système pour qu’il soit testable
Certains comportements sont difficiles ou peu fiables à tester de l’extérieur. Dans ces cas, la testabilité peut exiger des changements délibérés de conception : injection de pannes contrôlée, modes déterministes, endpoints de debug ou autres hooks de test. L’architecture doit offrir des moyens sûrs de contrôler des conditions qui seraient sinon rares, imprévisibles ou inaccessibles. Ces mécanismes doivent être soigneusement protégés, mais le principe est plus large : !!rendre un logiciel testable, c’est parfois le concevoir pour être testé.!!
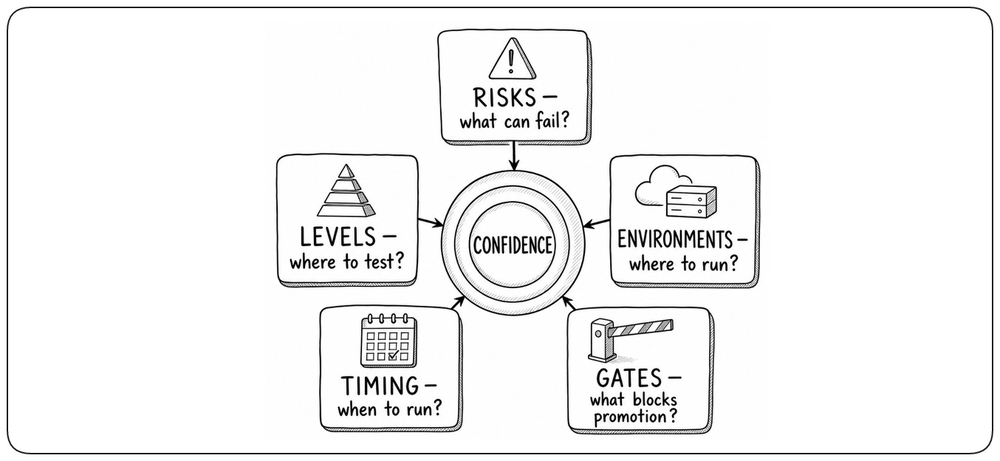
Une stratégie de test pour bâtir la confiance
Il est impossible de tout tester. Une stratégie de test décide donc quels risques comptent, quel niveau de test peut révéler chaque risque, quel environnement est nécessaire, quand chaque test doit s’exécuter et quels échecs doivent bloquer la promotion. L’objectif n’est pas l’exhaustivité, mais une confiance suffisante avec un temps et des ressources limités.
Une stratégie relie plusieurs décisions
Une liste de tests n’est pas une stratégie. Une stratégie relie chaque risque important à un niveau de test, un environnement, un moment et une décision de release. !!Partez du risque, puis choisissez la preuve crédible la moins chère.!!
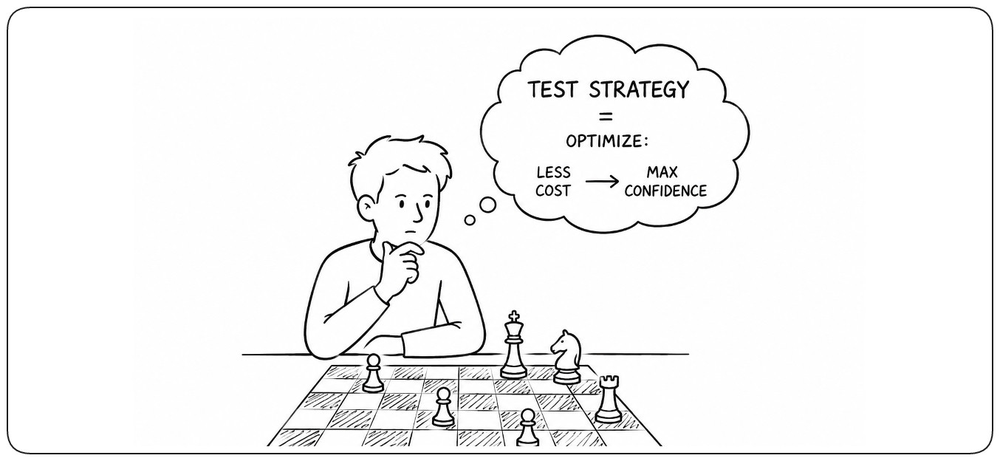
La stratégie de test est un problème d’optimisation
Une stratégie de test ne consiste pas à maximiser le nombre de tests. !!Elle consiste à affecter chaque risque au test le moins cher capable de le détecter de façon fiable.!! La stratégie réussit quand les risques importants sont couverts sans payer plus de vérification que nécessaire.
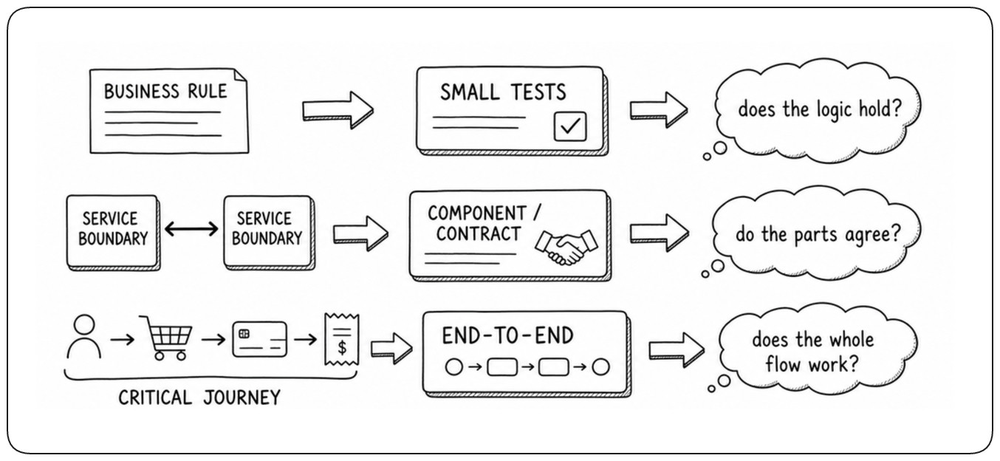
Des risques différents exigent des niveaux de test différents
Utilisez des petits tests pour les règles métier, des tests de composant ou de contrat pour les frontières, et des tests end-to-end pour les parcours critiques. Ne répétez pas la même assertion à chaque niveau. !!Utilisez le niveau le plus bas capable de détecter le risque, et des tests plus larges uniquement pour les risques qui apparaissent quand les parties fonctionnent ensemble.!!
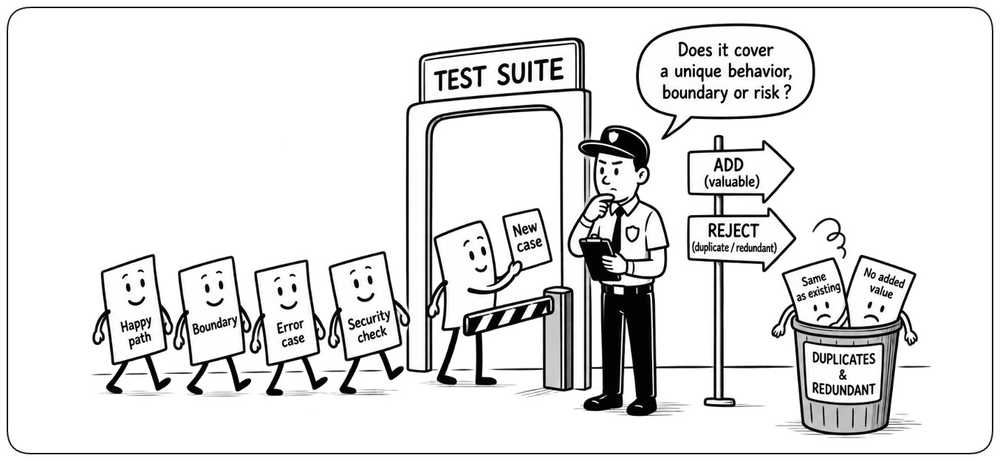
Chaque cas de test doit mériter sa place
Une bonne sélection de tests ne consiste pas à ajouter plus d’exemples ; elle consiste à choisir des cas qui révèlent des comportements différents. Regroupez les entrées censées se comporter de la même façon, puis choisissez un représentant par groupe. Portez une attention particulière aux limites, là où le comportement change et où les défauts se concentrent. !!Chaque cas de test doit couvrir un comportement, une limite ou un risque qu’aucun autre cas ne couvre déjà.!! Une suite plus petite et intentionnelle donne généralement plus de confiance qu’une grande collection d’exemples redondants.
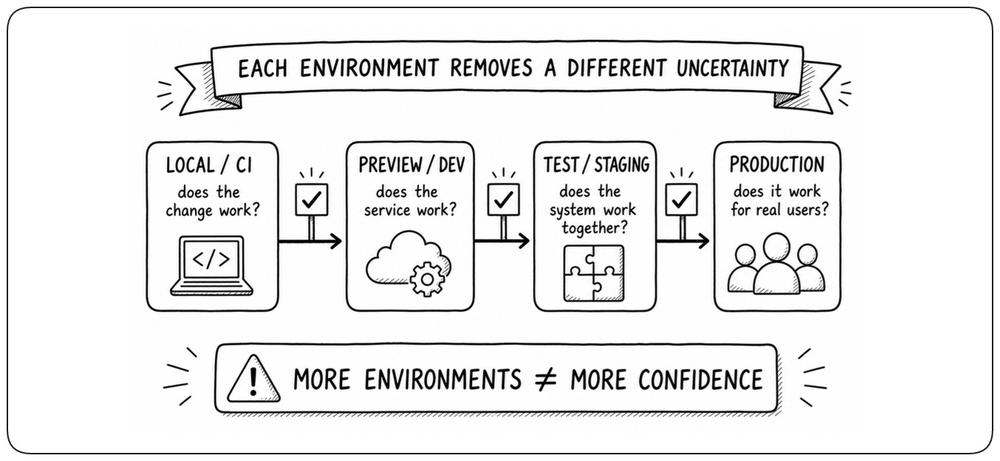
Chaque environnement doit lever une incertitude différente
Un niveau de test dit quelle partie du système est vérifiée ; un environnement dit où le test s’exécute. Le local et la CI exposent les problèmes du changement, la préview ou le développement vérifient le service, le staging vérifie le système assemblé, et la production vérifie le vrai routage, les vraies permissions et les vraies intégrations. !!Davantage d’environnements n’apportent de la confiance que si chacun répond à une question différente.!!
Les tests suivent le cycle de livraison
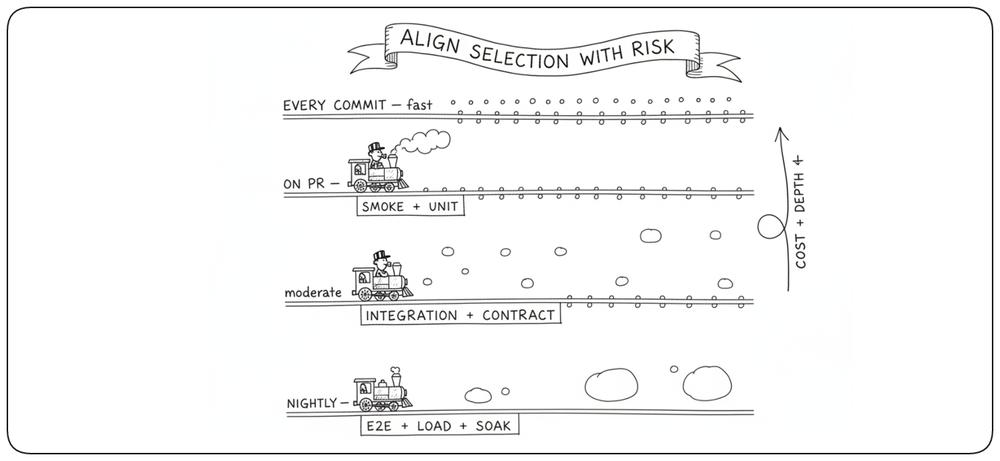
Les tests s’exécutent en CI à chaque changement, avant la promotion comme garde-fous de release, après le déploiement pour valider le nouvel environnement, et en continu ou de façon planifiée entre les déploiements. Ces moments sont complémentaires, car chacun révèle des défaillances différentes. !!Choisissez le test qui peut lever l’incertitude à ce moment précis.!!
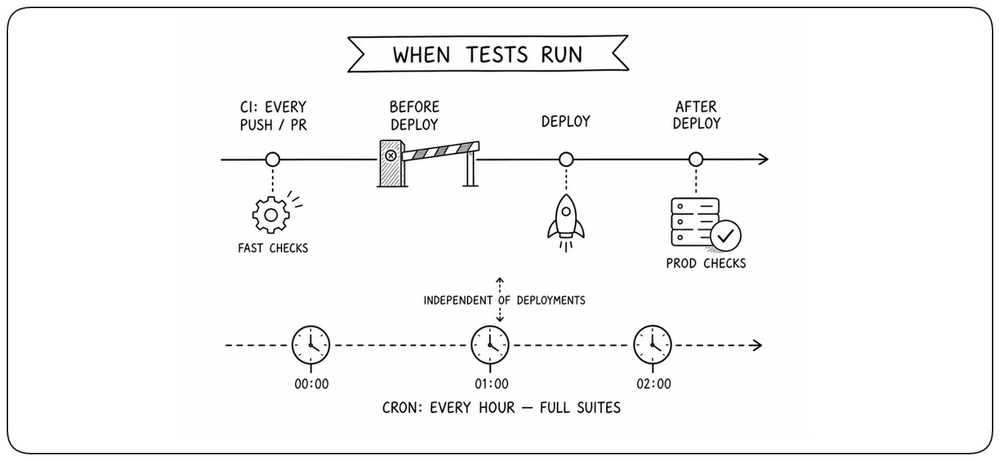
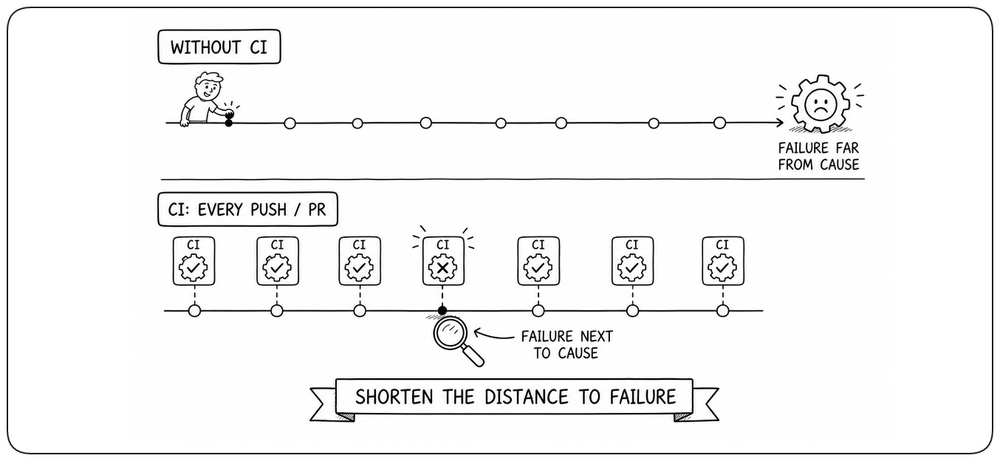
Trouver les problèmes au plus près du changement
En CI, exécutez des tests rapides et fiables à chaque push ou pull request. Un échec détecté immédiatement est plus facile à relier au changement qui l’a causé et moins coûteux à corriger. Des tests plus larges peuvent suivre, mais le premier signal utile doit arriver en quelques minutes. !!Raccourcissez la distance entre le changement et l’échec.!!
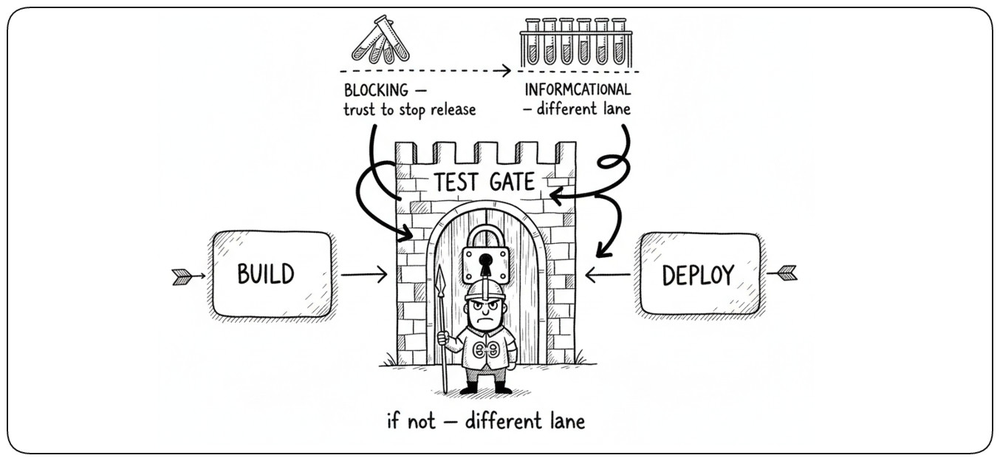
Avant le déploiement, des garde-fous de confiance
Seuls les tests critiques et de confiance doivent bloquer un déploiement. Demandez-vous : !!arrêterions-nous une release pour cet échec ?!! Sinon, exécutez la vérification dans une autre voie. Les tests de charge, les suites exploratoires et les scans informatifs comptent toujours ; ils ne doivent simplement pas faire attendre chaque déploiement. Placez le garde-fou de release autour de risques comme la sécurité, la facturation et l’intégrité des données.
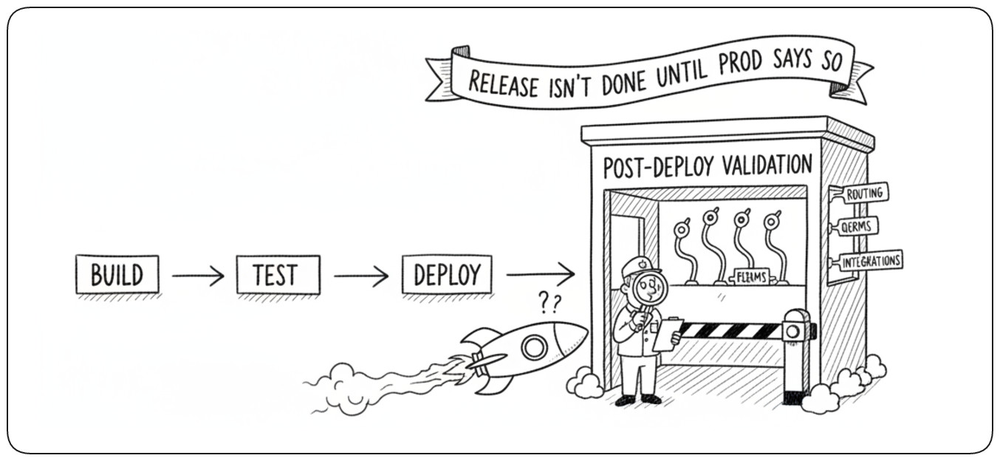
Après le déploiement, tester ce que seul l’environnement peut révéler
Certains problèmes n’apparaissent qu’après le déploiement : routage, permissions, quotas et vraies intégrations tierces. !!Le déploiement n’est pas la fin des tests ; il rend possible un nouveau type de test.!! Intégrez ces vérifications au processus de release, plutôt que de les découvrir plus tard via le monitoring ou les utilisateurs.
Continuer à tester entre les déploiements
Certaines défaillances apparaissent avec le temps ou sans nouveau déploiement. Exécutez les suites coûteuses de façon planifiée, gardez de petites vérifications de production tournant en continu, et déclenchez des tests plus larges quand une dépendance ou une configuration pertinente change. !!Un pipeline de livraison silencieux ne signifie pas que le système a cessé de changer.!!
Types de tests et techniques
La stratégie décide de quelles preuves on a besoin. Les types de tests sont les outils pour produire ces preuves. Chacun répond à une question différente, et plusieurs peuvent être combinés quand un risque traverse plus d’une frontière.
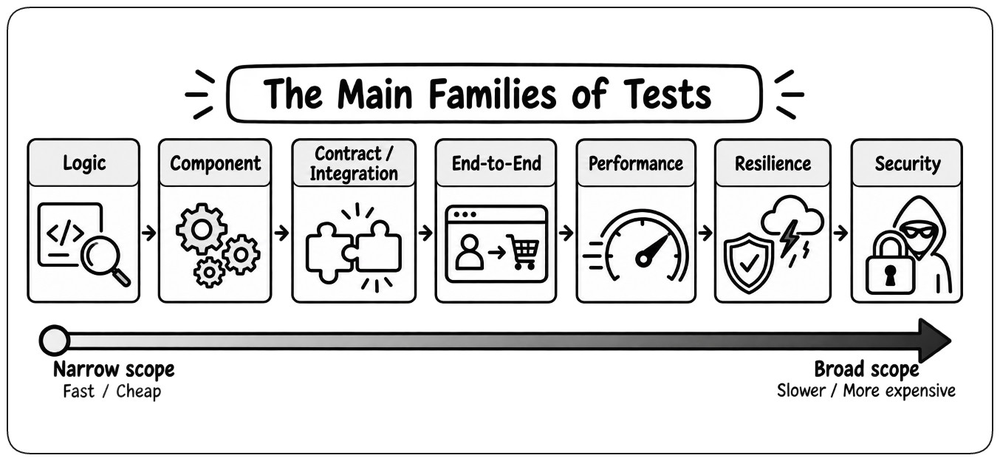
Les grandes familles de tests
Les tests opèrent à différents niveaux et ciblent différents types de risques. Certains vérifient une logique isolée, d’autres valident des composants et leurs frontières, des parcours utilisateur complets, la performance sous charge, la résilience aux pannes ou la sécurité face à un comportement hostile. !!Comprendre ces familles donne une carte du paysage des tests avant de décider quel type de test précis utiliser.!!
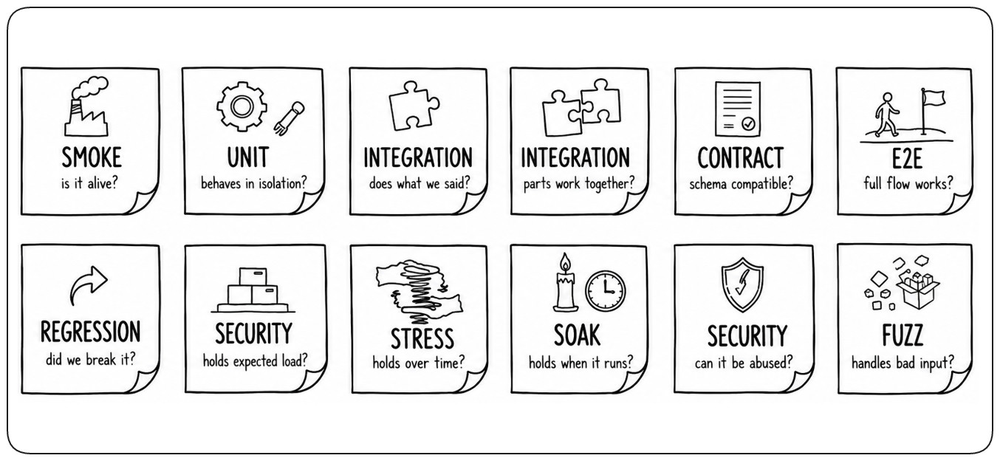
Chaque type de test répond à une question différente
Chaque type de test répond à une question différente et cible un risque différent. Le smoke vérifie que le service répond, l’unitaire vérifie un comportement isolé, le contrat vérifie la compatibilité des interfaces, la charge et le stress vérifient les limites de capacité, le fuzz et la sécurité vérifient les entrées hostiles. !!Un type de test a de la valeur grâce à la question à laquelle il répond, pas parce qu’il figure dans la suite.!!
Rendre les signaux de test explicites
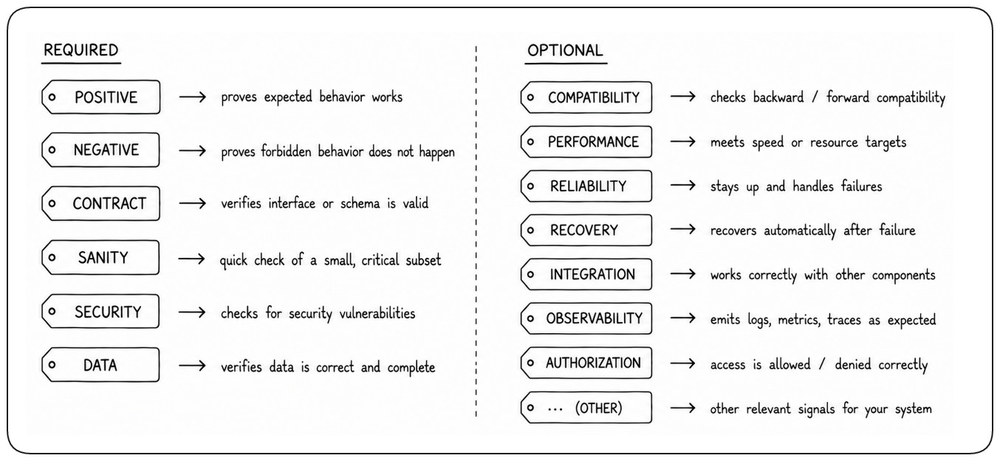
Un test doit rendre clair quel comportement, contrat ou risque il protège. Des tags ou des métadonnées peuvent décrire le signal qu’il fournit — par exemple, qu’un comportement attendu est présent, qu’un comportement interdit est absent, ou qu’un contrat de service reste valide. Des signaux explicites rendent les tests plus faciles à comprendre, sélectionner, router et exploiter. À l’échelle de l’organisation, ils permettent aussi l’application de règles : les équipes peuvent définir quels signaux chaque service doit fournir et vérifier automatiquement que les propriétaires de service maintiennent les tests requis. Quand un signal représente une garantie partagée, sa responsabilité doit être explicite pour que quelqu’un reste chargé de le garder pertinent et fiable.
Asserter des règles, pas seulement des cas
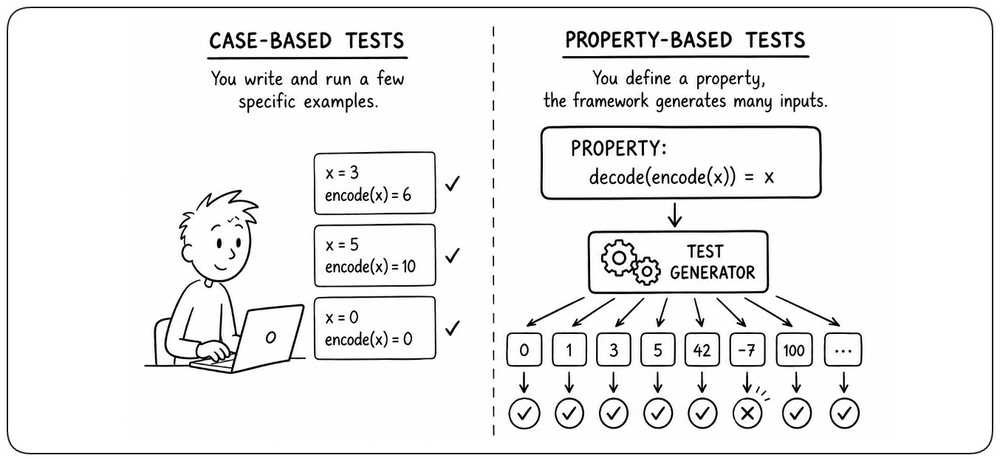
Les tests traditionnels vérifient généralement un ensemble d’exemples choisis par le développeur. Le property-based testing va plus loin : au lieu de coder en dur chaque cas, on définit ce qui doit rester vrai et on laisse le framework générer automatiquement de nombreuses entrées différentes. Par exemple, encoder puis décoder doit redonner la valeur d’origine, et trier doit préserver le nombre d’éléments. !!Au lieu de tester seulement les cas auxquels vous avez pensé, le property-based testing explore de nombreux cas que vous n’avez pas choisis manuellement.!!
Mutation testing : casser le code pour éprouver la suite
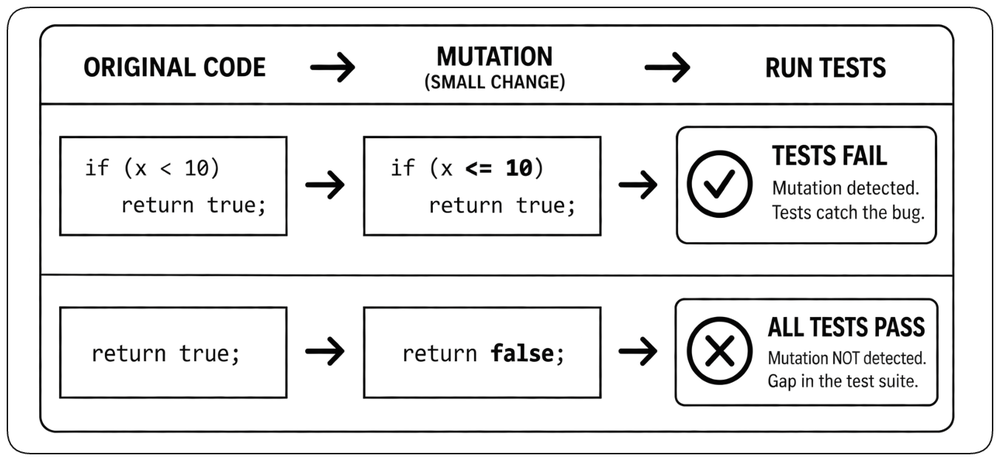
Le mutation testing vérifie si vos tests peuvent réellement détecter des bugs. Il introduit délibérément de petites modifications dans le code et relance la suite de tests. Si un test échoue, la mutation a été détectée. Si les tests restent verts, la suite manque peut-être d’une vérification importante. !!Le mutation testing pose une question simple : si le code était faux, les tests s’en apercevraient-ils ?!! Comme il est coûteux, utilisez-le surtout là où des bugs non détectés auraient le plus d’importance.
Tester des composants sans le système complet
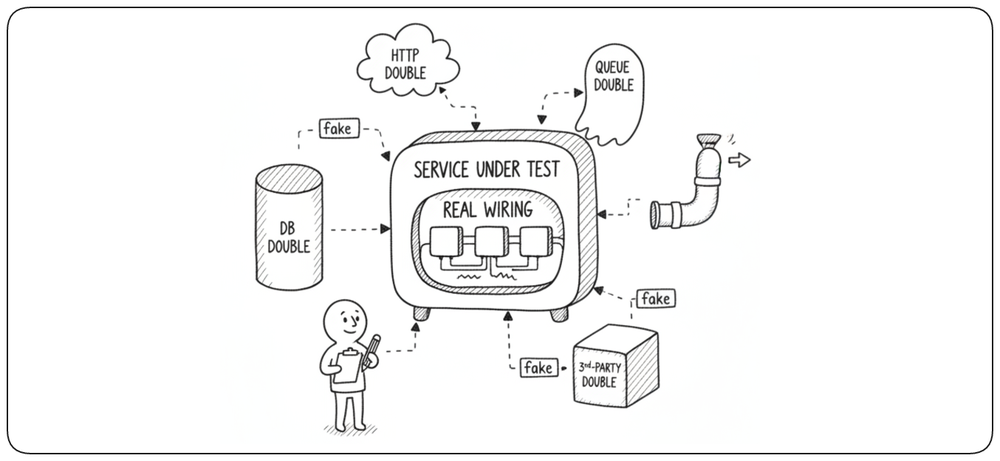
Un test de composant exécute un service dans son ensemble, sans démarrer le reste du système. Son câblage interne réel est utilisé, tandis que les dépendances externes — bases de données, files, autres services — sont remplacées par des doublures contrôlées. !!Si tester un service exige d’en déployer dix autres, sa frontière n’est pas assez isolée.!! On obtient ainsi une forte confiance dans le service sans le coût ni la complexité d’un environnement end-to-end complet.
Les tests de contrat protègent les interfaces
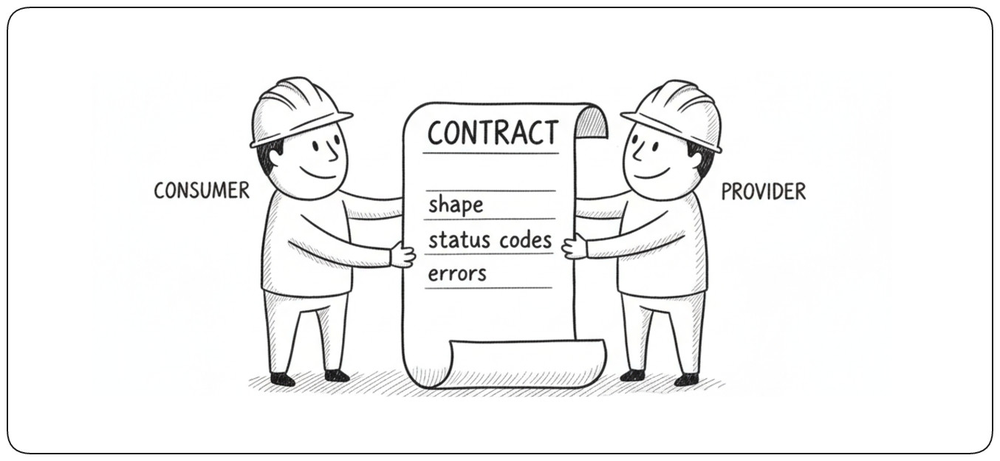
Un test de contrat vérifie que deux services se comprennent toujours. Il vérifie ce qu’un service attend d’un autre : la requête, la réponse et les erreurs possibles. Cela détecte tôt les changements cassants — sans déployer les deux services ensemble. Les équipes peuvent faire évoluer leurs services indépendamment, en sachant que l’interface fonctionne toujours.
Faire cohabiter ancien et nouveau
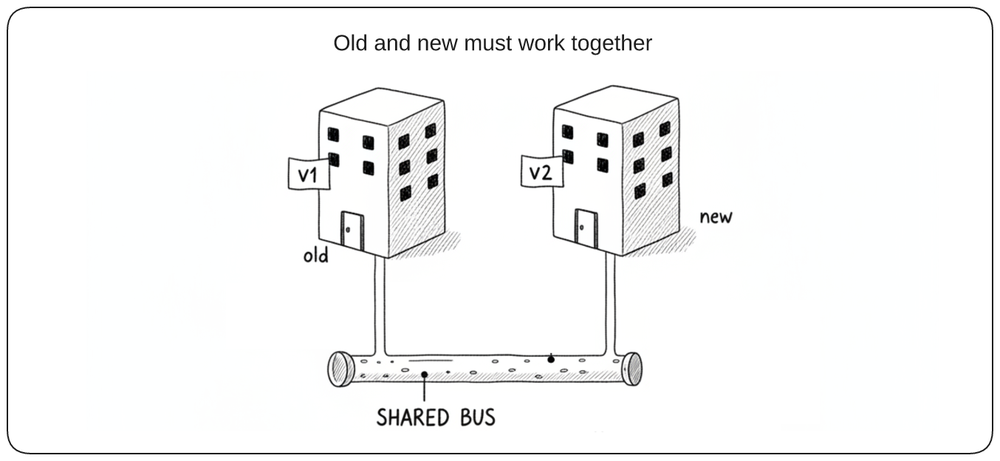
Les systèmes distribués sont rarement mis à jour d’un seul coup. Pendant un rollout, anciennes et nouvelles versions tournent côte à côte. Testez la compatibilité entre APIs, événements, schémas et données stockées pendant cette transition. Un changement n’est pas sûr simplement parce que la nouvelle version fonctionne seule ; elle doit aussi fonctionner avec l’ancienne.
Tester là où les composants se rencontrent
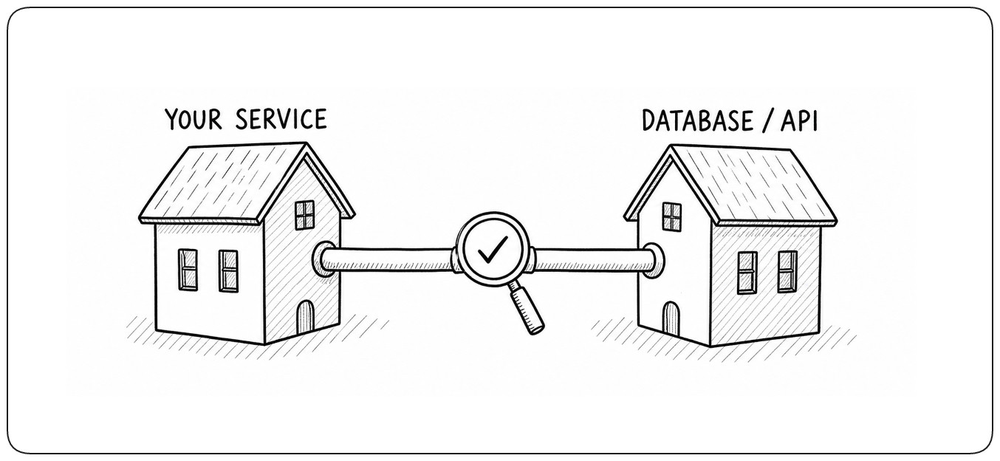
Les tests d’intégration vérifient l’endroit où votre code rencontre un autre composant — comme une base de données, une file ou une API externe. Gardez chaque test centré sur une seule frontière. Quand il échoue, vous devez savoir exactement où chercher.
Les tests end-to-end valident de vrais parcours utilisateur
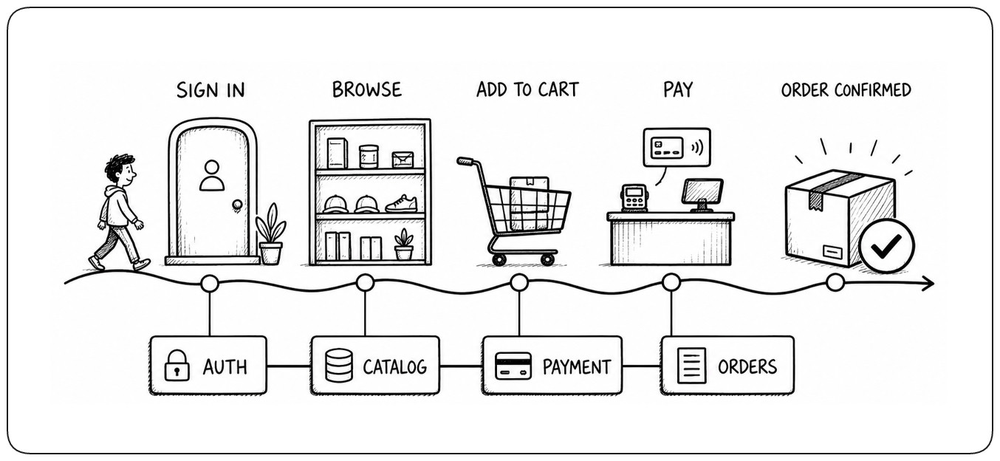
Les tests end-to-end vérifient que le système entier fonctionne, de la première action de l’utilisateur au résultat final. Utilisez-les pour les parcours qui comptent le plus — comme l’inscription, le paiement ou la passation de commande. !!Ils révèlent des problèmes qui n’apparaissent que lorsque plusieurs parties du système fonctionnent ensemble.!! Quand l’un d’eux échoue, des tests plus petits aident à identifier la cause.
Rendre les gros tests peu coûteux à écrire
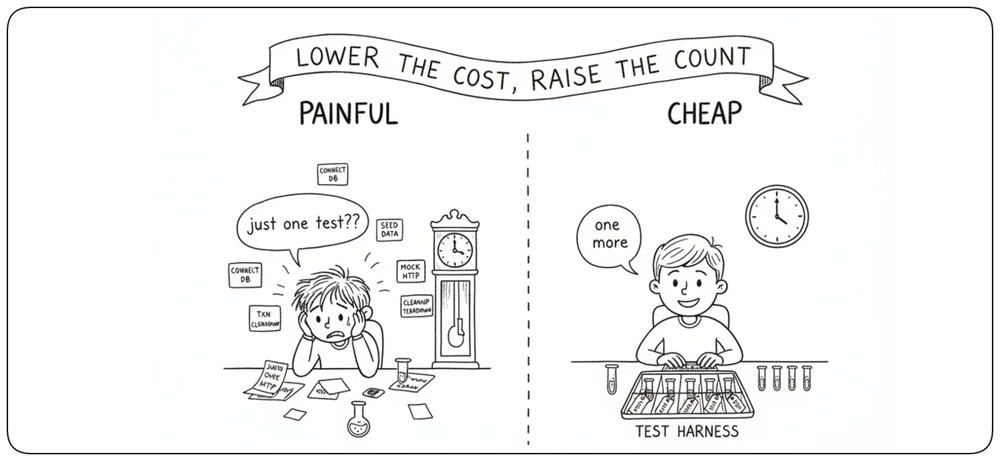
Quand les tests d’intégration et end-to-end sont difficiles à écrire, les équipes sautent des scénarios importants. Ne forcez pas les développeurs à reconstruire la préparation, les données de test, le nettoyage et le teardown pour chaque test. Des outils de test partagés facilitent l’ajout de scénarios utiles. !!Un coût plus bas permet des tests plus larges, mais chaque nouveau test doit couvrir un risque différent.!!
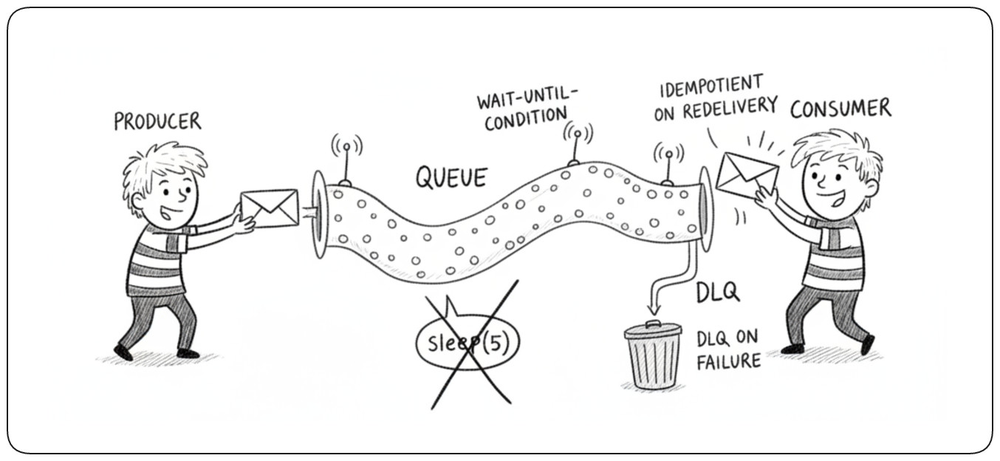
Tester les systèmes asynchrones
Les systèmes asynchrones se transmettent le travail via des messages et des files. Le résultat n’est pas toujours disponible immédiatement. !!N’attendez pas un nombre fixe de secondes en espérant que ce soit terminé.!! Attendez plutôt un résultat clair, comme une commande créée ou un message arrivé dans la file d’erreurs. Testez aussi ce qui se passe quand des messages arrivent en double, dans le mauvais ordre, ou échouent en boucle.
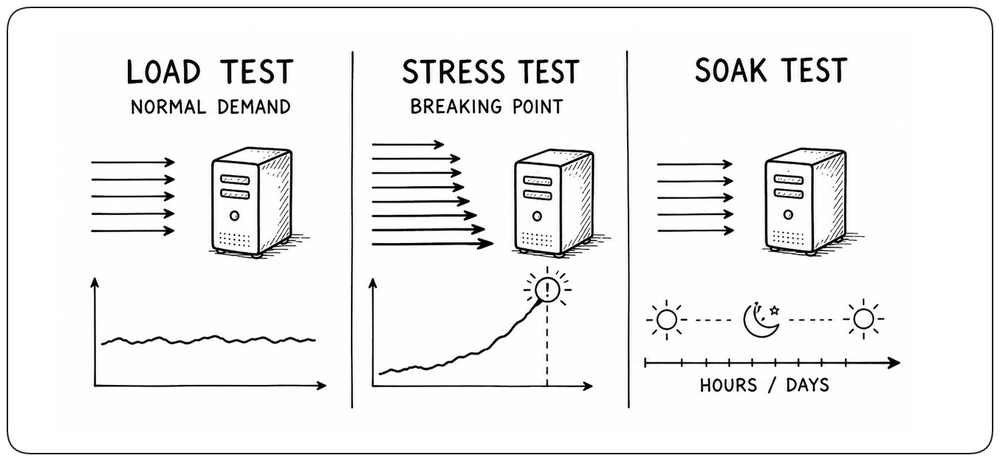
Tester la performance dans la durée
Les tests de performance répondent à trois questions : le système supporte-t-il la demande normale, que se passe-t-il sous une demande extrême, et reste-t-il sain dans la durée ? !!Les tests de charge vérifient l’usage normal. Les tests de stress trouvent le point de rupture. Les tests d’endurance (soak) révèlent les problèmes qui n’apparaissent qu’après des heures ou des jours d’utilisation soutenue.!!
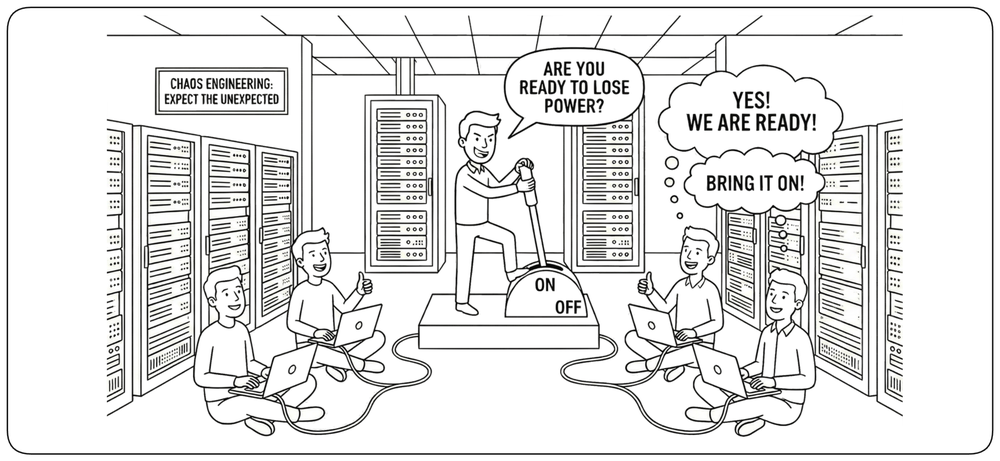
Tester la façon dont le système gère la défaillance
Le chaos engineering teste le comportement d’un système quand quelque chose tourne mal. Partez d’un résultat attendu, introduisez une défaillance contrôlée — comme une dépendance lente ou un service arrêté — et vérifiez si le système se comporte toujours comme prévu.
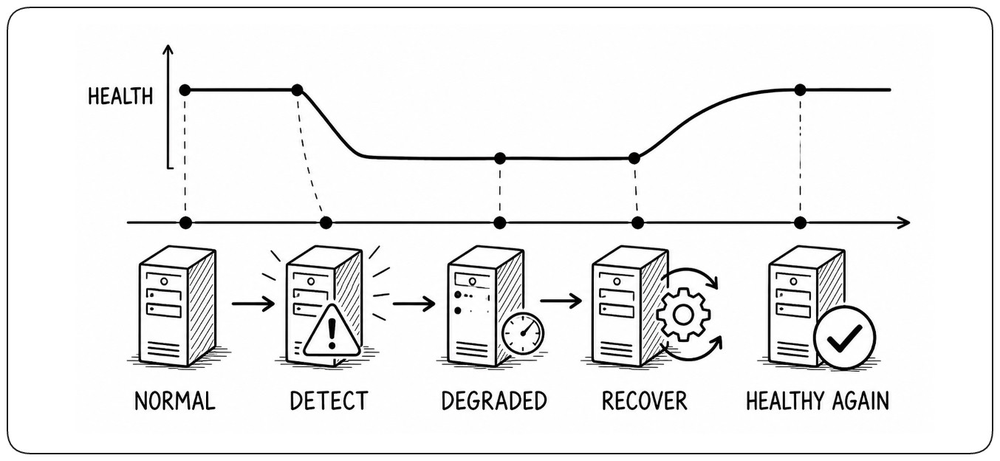
Tester la récupération, pas seulement la panne
Injecter une défaillance montre qu’un système peut tomber en panne. Cela ne montre pas qu’il peut récupérer. Un test de résilience doit suivre tout le chemin : détecter le problème, continuer à servir les utilisateurs du mieux possible, récupérer via des retries ou un failover, et revenir à la normale. !!Le test n’est terminé que lorsque le système est de nouveau sain.!!
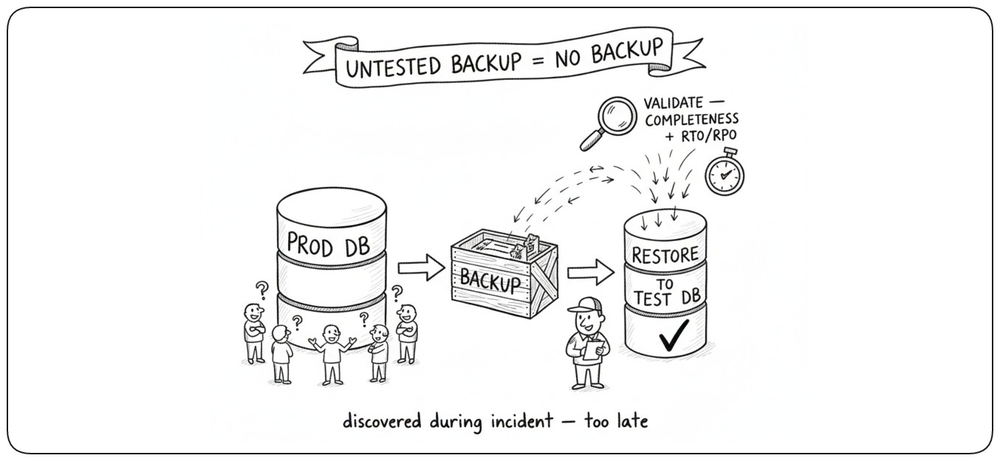
Tester la sauvegarde et la restauration
Les sauvegardes ne sont utiles que si elles peuvent être restaurées. Restaurez-en régulièrement une dans un environnement de test et vérifiez que les données sont complètes et que la récupération respecte les RPO et RTO requis. Sinon, une équipe risque de découvrir un problème de sauvegarde lors d’un vrai incident.
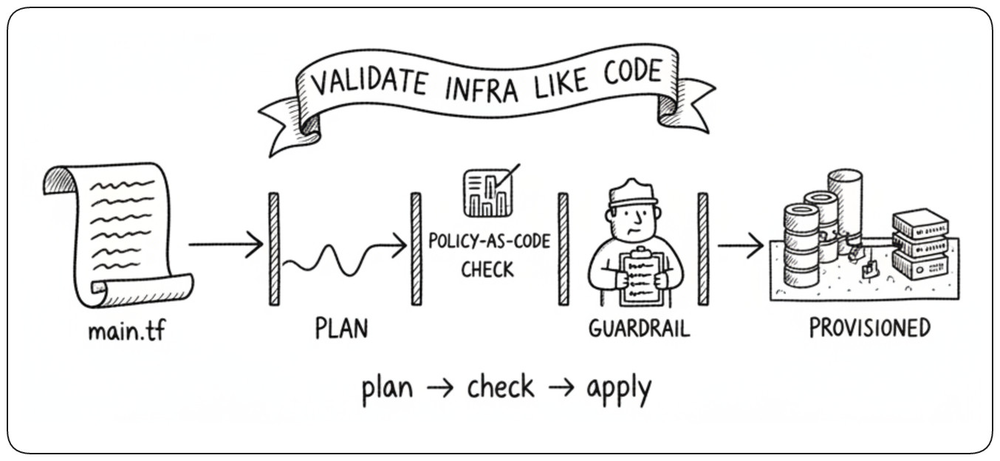
Tester l’Infrastructure as Code
Le code d’infrastructure a aussi besoin de tests. Vérifiez le changement planifié, contrôlez que les ressources et politiques requises sont présentes, puis appliquez-le. Cela détecte les erreurs de configuration avant qu’elles n’atteignent la production.
Tester à l’ère de l’IA
L’IA peut désormais générer du code et des tests plus vite que les équipes ne peuvent les relire. Quel travail est passé à l’IA ? Qu’est-ce qui revient encore aux humains ? Dans cette section, nous examinons comment les responsabilités de test changent quand les machines écrivent, exécutent et analysent une plus grande part des tests.
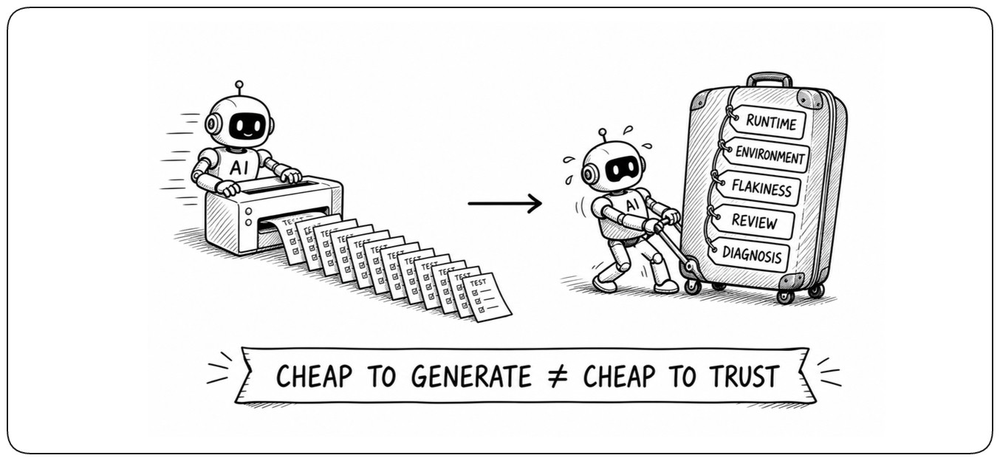
L’IA rend les tests peu coûteux à écrire, pas à croire
L’IA permet d’écrire des tests plus vite, mais ils demandent toujours du temps pour être exécutés, relus, maintenus et débogués. Ils peuvent aussi nécessiter des données et des environnements de test. Un test n’est utile que si l’on peut faire confiance à ce qu’il vérifie. !!Peu coûteux à générer ne veut pas dire peu coûteux à croire.!!
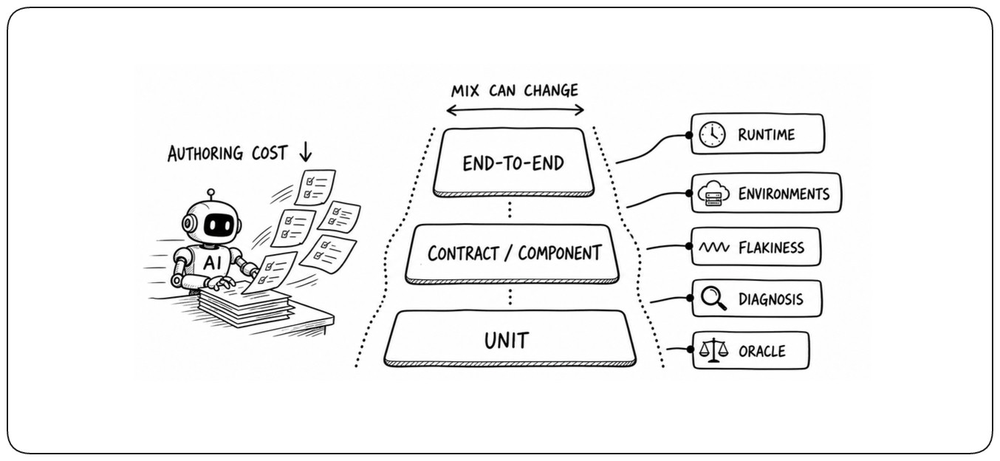
Le dosage des tests peut évoluer
La pyramide est un guide, pas un ratio fixe. Si l’IA rend les tests end-to-end fiables moins chers, utilisez-en davantage pour les parcours utilisateur importants. Gardez les tests unitaires pour les règles et les tests de contrat ou de composant pour les frontières. !!Choisissez le plus petit test capable de détecter le risque.!!
Plus de tests exigent une meilleure sélection
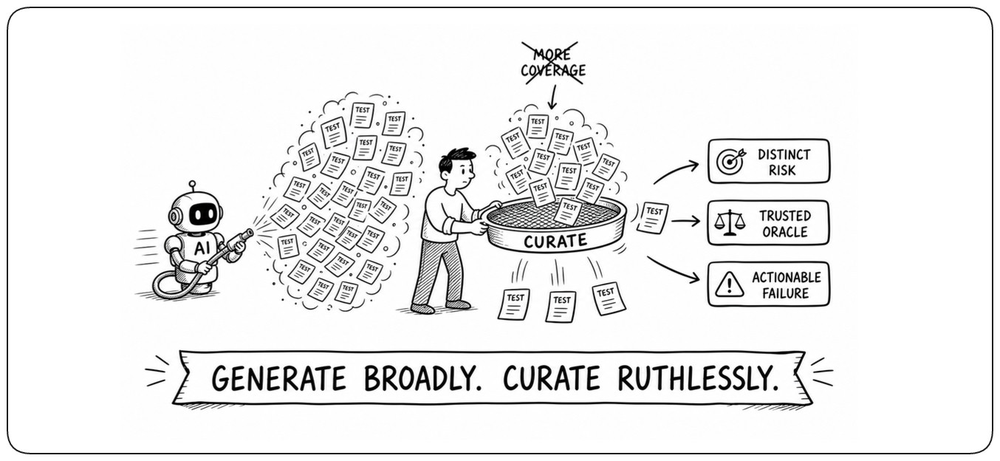
L’IA peut générer des centaines de tests, mais plus de tests ne créent pas toujours plus de confiance. Ne gardez un test généré que s’il vérifie un nouveau risque, a un résultat attendu clair et aide à expliquer le problème quand il échoue. Le mutation testing, les défauts connus et la détection de doublons peuvent révéler des tests faibles ou répétés. !!Générez largement. Ne gardez que les tests utiles.!!
L’IA peut sélectionner des tests, mais elle peut se tromper
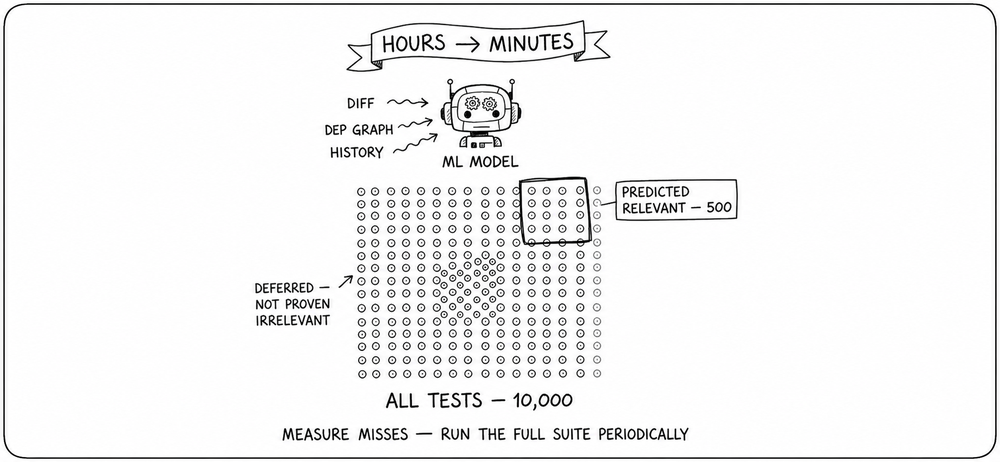
L’IA peut prédire quels tests ont le plus de chances d’être pertinents pour un changement, ce qui accélère le feedback. Mais une prédiction peut être fausse. Exécutez toujours les tests critiques, comparez ses choix aux résultats de la suite complète, et lancez régulièrement la suite complète. !!Un feedback plus rapide n’est utile que si l’on mesure ce que la sélection laisse passer.!!
Les humains décident de ce que « correct » signifie
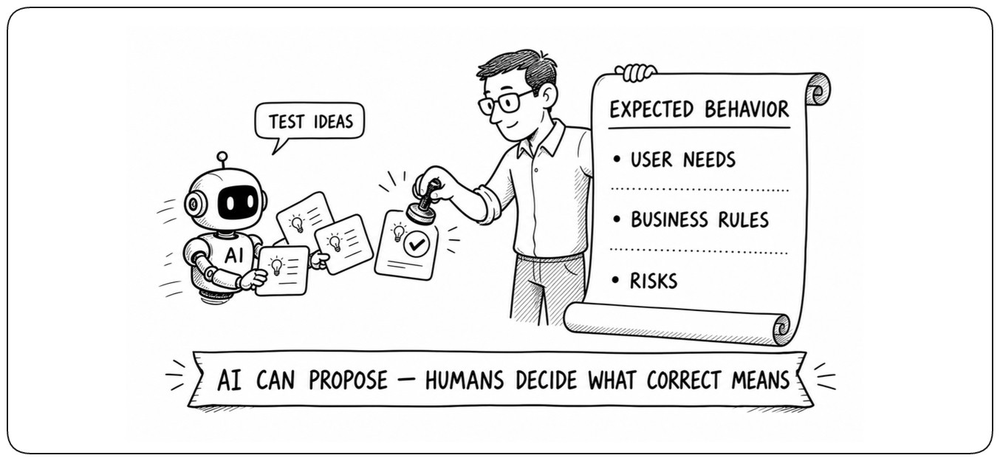
Les personnes qui comprennent le produit définissent le comportement que le système doit garantir. L’IA peut lire le code et suggérer des tests, mais elle ne doit pas décider du résultat attendu, car le code peut déjà contenir un bug. !!L’IA peut proposer. Les humains décident de ce que « correct » signifie.!!
L’IA transforme l’intention en tests
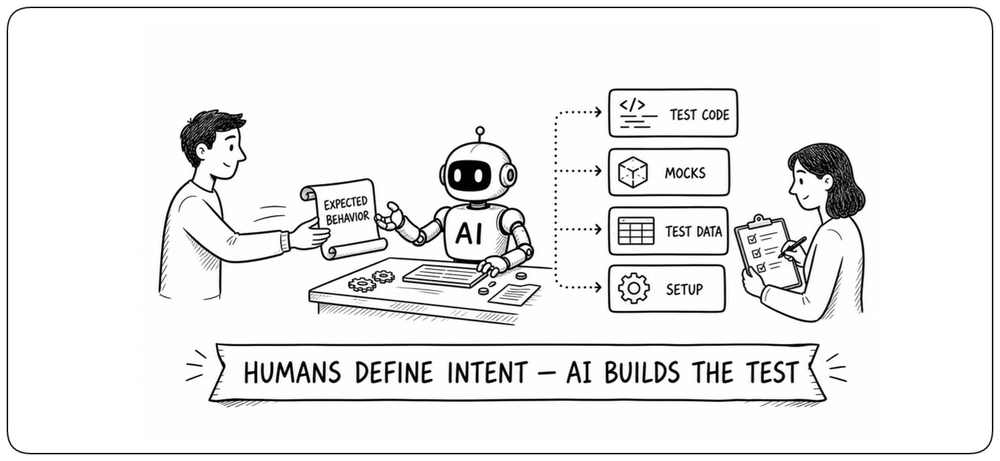
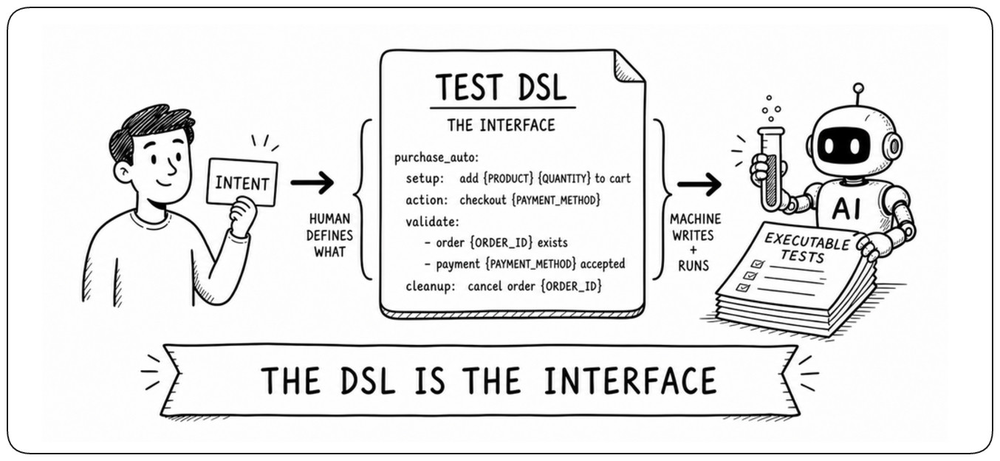
Une fois le comportement attendu clair, l’IA peut générer le code de test, les mocks, les données de test et la préparation. Les humains relisent le résultat pendant que l’IA s’occupe du travail répétitif. !!Les humains définissent l’intention. L’IA construit le test.!!
Un DSL de test est l’interface avec la machine
La façon la plus propre de séparer ce que les humains définissent de ce que fait la machine — écrire et exécuter les tests — est de créer un DSL de test comme interface entre les deux. Il utilise le langage du produit pour énoncer un scénario, une règle et un résultat attendu — pas des sélecteurs, des mocks ou de la préparation. Les humains possèdent et relisent cette interface. L’IA et l’outillage peuvent changer la manière dont elle devient des tests exécutables sans changer ce qu’elle déclare. !!Le DSL est le contrat : les humains disent quoi ; les machines décident comment l’exécuter.!!
Utiliser l’IA pour comprendre pourquoi un test a échoué
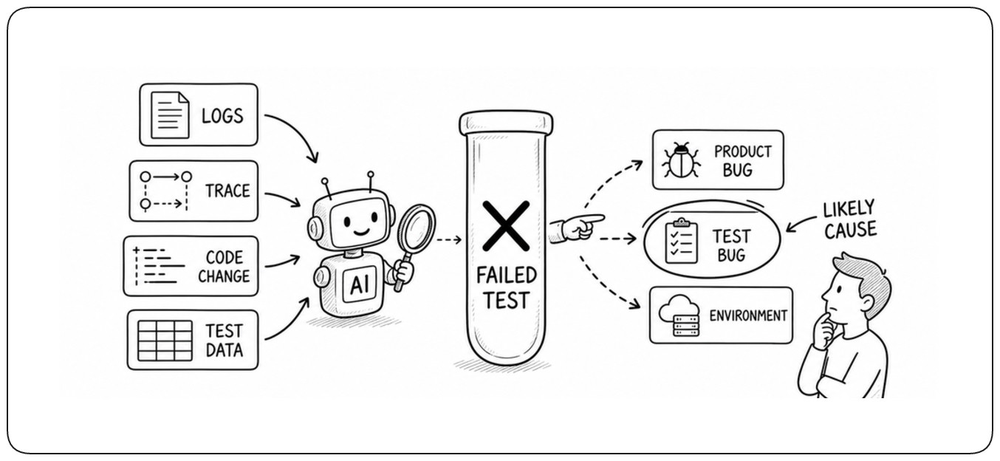
Quand un test échoue, l’IA peut comparer logs, traces, changements de code et données de test pour suggérer la cause la plus probable. Elle peut aider à montrer si le problème vient du produit, du test ou de l’environnement. Un développeur doit relire les preuves avant d’agir. !!Utilisez l’IA pour comprendre un test rouge, pas pour le masquer.!!
L’IA peut explorer plus de chemins
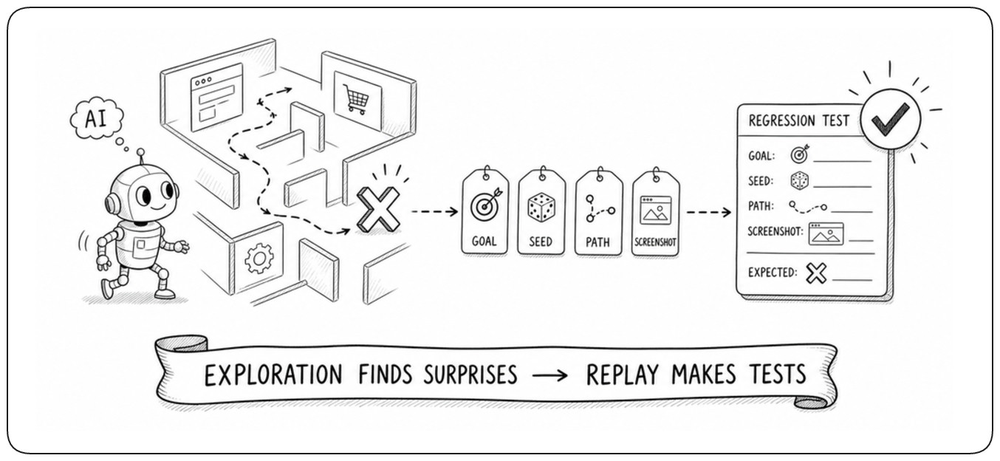
L’IA peut essayer des entrées inhabituelles, explorer des parcours utilisateur et repérer des problèmes visuels que les tests scriptés peuvent manquer. Quand elle trouve un problème, sauvegardez l’objectif, les données, le chemin et les captures d’écran pour que l’échec puisse être reproduit. Transformez ensuite la découverte en test de non-régression classique. !!L’exploration trouve les surprises ; le replay les rend testables.!!
Donner aux agents de test des limites claires
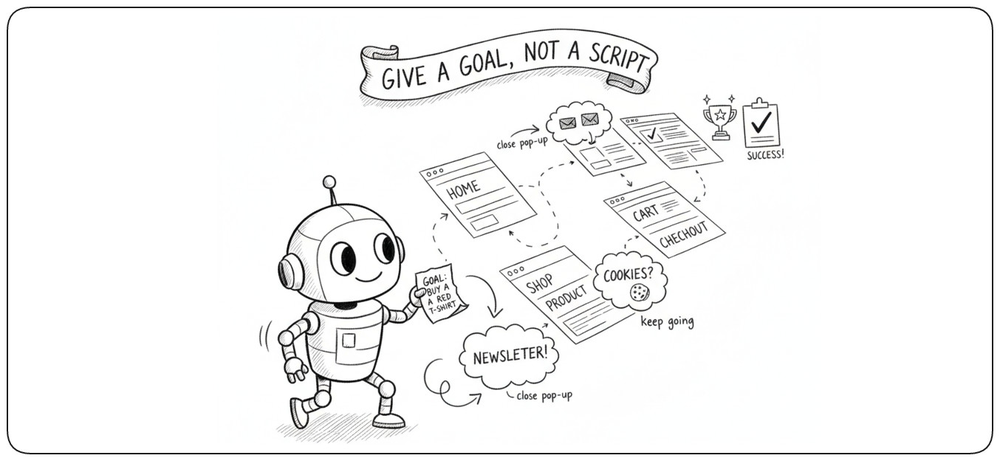
Les agents de test peuvent découvrir des chemins que les tests scriptés ne couvrent pas, mais ils peuvent aussi entreprendre des actions inattendues. Exécutez-les dans des environnements isolés avec des comptes de test, des permissions limitées, des plafonds de temps et de dépense, et une trace complète de leurs actions. Utilisez-les pour trouver des problèmes, pas comme unique vérification de release d’un flux critique. !!Donnez aux agents de la marge pour explorer, mais des limites sur ce qu’ils peuvent faire.!!
Exécution à grande échelle
La stratégie décide de quelles preuves on a besoin et quand. L’exécution rend ce plan fiable : les échecs doivent pointer vers un changement, les tests doivent s’exécuter de façon indépendante et cohérente entre environnements, et les releases validées doivent atteindre les utilisateurs avec un risque maîtrisé.
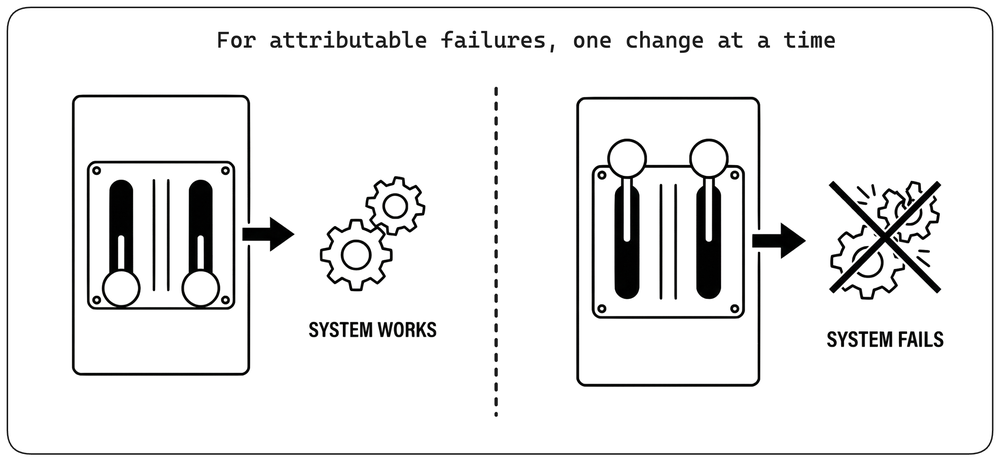
Un changement à la fois rend les échecs attribuables
Le feedback rapide n’aide que si l’on peut relier un échec à un changement. Si plusieurs changements arrivent ensemble, un build rouge devient un jeu de devinettes. Gardez les changements petits pour qu’un échec pointe vers une cause probable et que le rollback ou la correction soit évident.
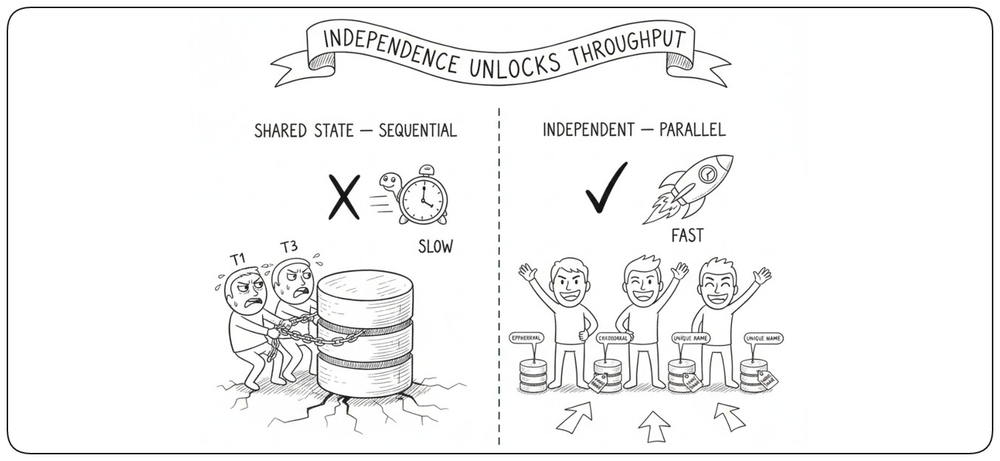
Le parallélisme exige l’indépendance
Les tests parallèles ne font gagner du temps que s’ils ne s’affectent pas les uns les autres. Ne vous appuyez ni sur l’ordre des tests, ni sur des données partagées, ni sur un état global. Utilisez des données isolées, des noms de ressources uniques et des environnements éphémères pour que chaque test puisse s’exécuter seul.
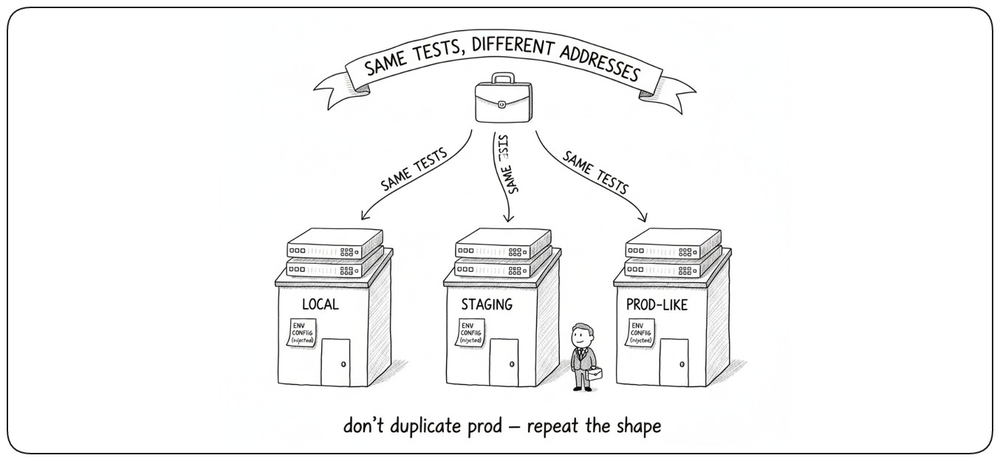
Parité et portabilité des environnements
Les mêmes tests doivent pouvoir s’exécuter en local, en staging et dans un environnement proche de la production sans être réécrits. Des endpoints, identifiants et topologies codés en dur rendent les tests fragiles. Utilisez la configuration et des outils de test portables. La parité ne signifie pas copier exactement la production ; elle consiste à créer un environnement reproductible avec des données maîtrisées et peu de collisions entre équipes.
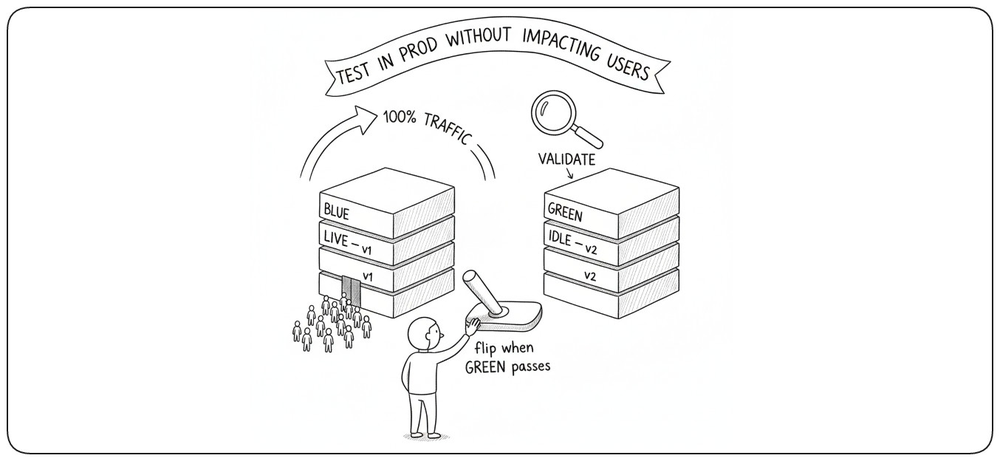
Tests en blue-green
Le déploiement blue-green utilise deux environnements équivalents. L’un sert les utilisateurs pendant que la nouvelle version est déployée et vérifiée sur l’autre. Quand elle passe, on bascule le trafic. Gardez l’ancienne version prête pour qu’un rollback soit rapide.
La livraison progressive limite le rayon d’impact
Le blue-green bascule tout le trafic d’un coup. La livraison progressive commence par un petit groupe d’utilisateurs et n’élargit que si les signaux restent sains. !!Erreurs, latence et métriques business deviennent des garde-fous en direct : promouvoir ou annuler.!! Les mêmes SLO définis avant la release guident la décision en production.
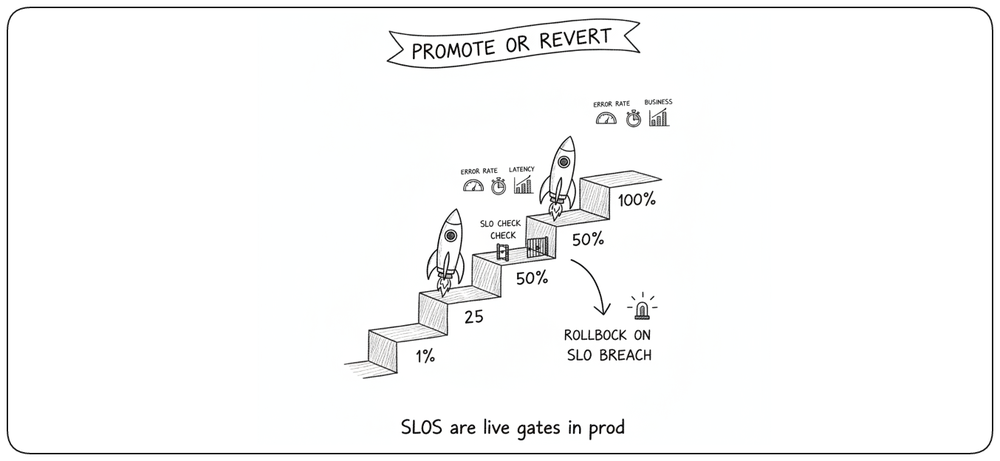
La vérification de sécurité mérite une stratégie dédiée
La sécurité mérite sa propre stratégie de vérification, car la correction sous usage attendu ne prouve pas la correction sous usage hostile. L’objectif est d’avoir confiance que les contrôles critiques tiennent, pas d’accumuler des rapports.
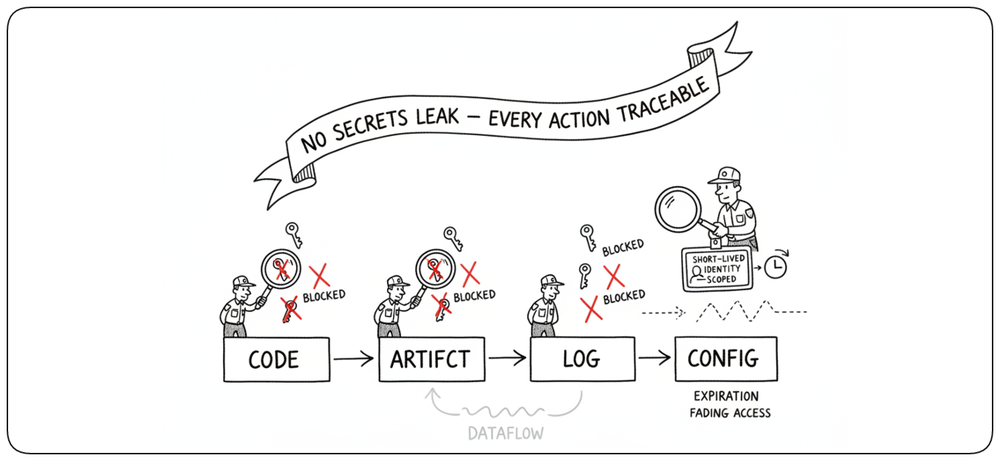
Protéger les secrets et utiliser des identités à portée limitée
Empêchez les éléments sensibles d’entrer dans le code, les artefacts, les logs ou la config : identifiants, tokens, clés et endpoints internes. Privilégiez des accès de courte durée et à portée limitée, ainsi que la traçabilité, pour que chaque action ait une identité responsable.
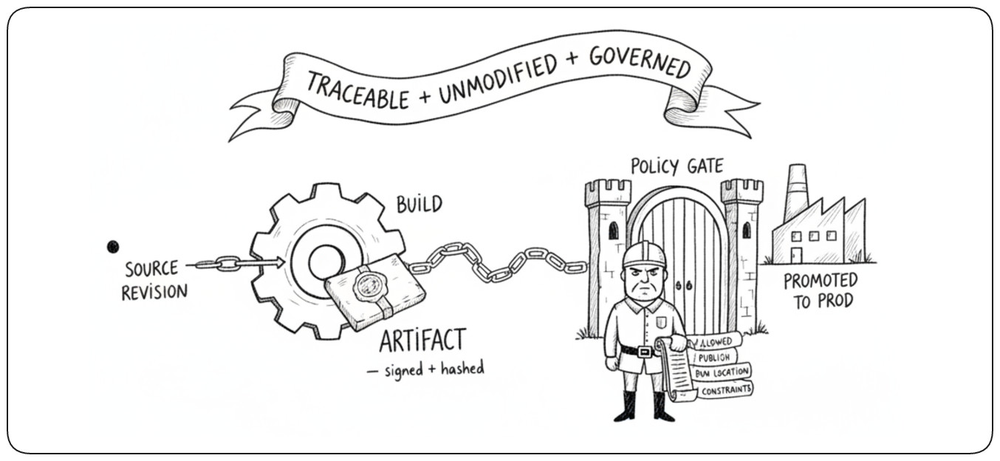
Prouver artefacts et politiques avant la promotion
Traitez les artefacts comme des objets gouvernés : traçables jusqu’à une révision de source et un build, et vérifiables comme non modifiés. Les politiques doivent être applicables au moment de la promotion : ce qui peut être publié, où cela peut s’exécuter et sous quelles contraintes.
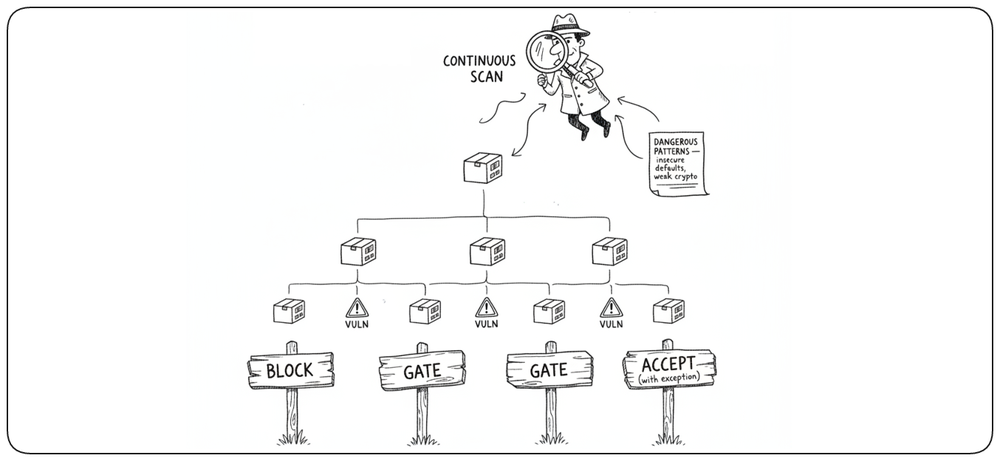
Réduire l’exposition de la supply chain et les patterns dangereux
Mesurez en continu l’exposition des dépendances et des images, et transformez les constats en décisions : bloquer, filtrer ou accepter avec des exceptions explicites. Validez le code et la configuration face aux patterns dangereux (security hotspots, valeurs par défaut non sûres, contraintes d’export/crypto) sans lier le chapitre à des outils spécifiques.
Valider les frontières d’exécution et les chemins d’abus
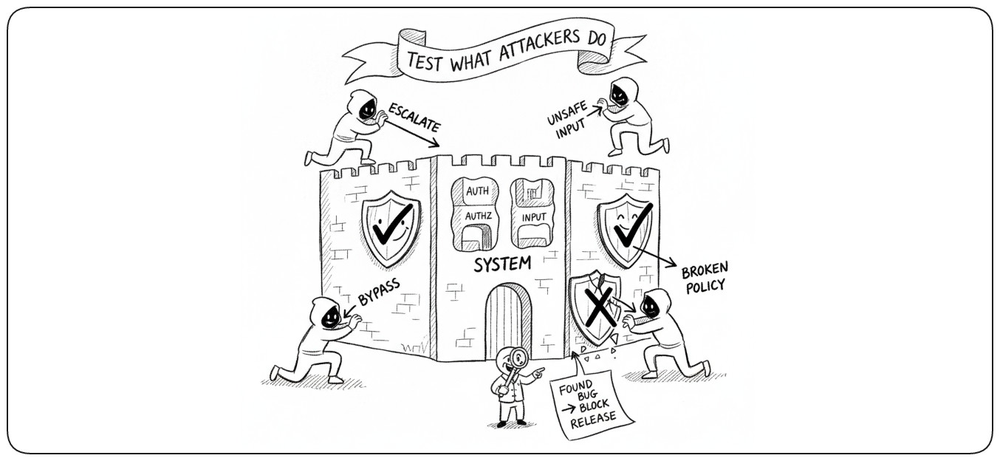
Les défaillances les plus risquées surviennent aux frontières : authentification, autorisation, traitement des entrées et application des politiques. Testez les comportements que les attaquants exploitent : contournements, élévation de privilèges et entrées dangereuses qui déclenchent des chemins risqués — les vérifications qui comptent sont celles en lesquelles vous avez assez confiance pour bloquer une release.
Maintenir la confiance
Les suites de tests se dégradent si on ne les entretient pas. À mesure que le système évolue, les tests doivent évoluer aussi, sinon ils deviennent du bruit qui ralentit les équipes.
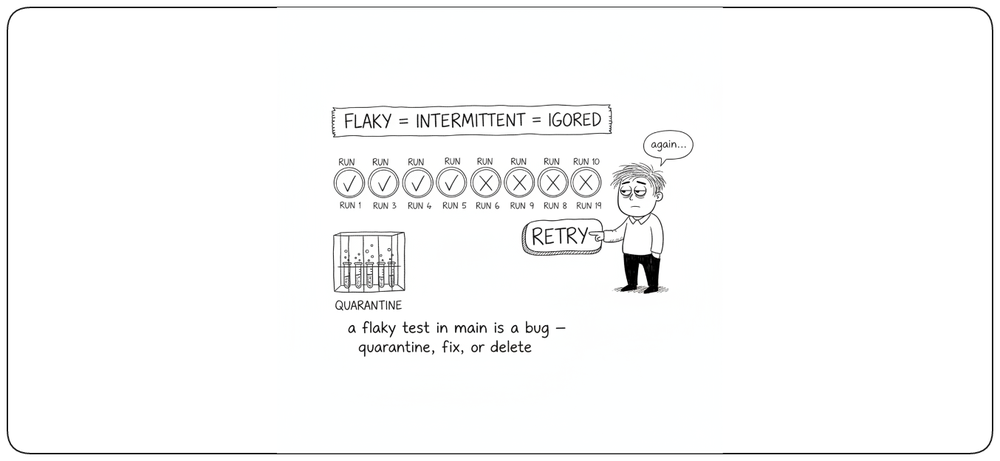
Les tests flaky érodent la confiance
Un test flaky peut être plus nuisible qu’un test manquant, car il apprend aux équipes à ne pas se fier aux échecs. Quand une suite échoue par intermittence, les ingénieurs apprennent à relancer, ré-exécuter et finalement ignorer les builds rouges — exactement l’habitude que la suite est censée empêcher. !!Un test flaky est un défaut, pas une nuisance.!! Suivez le taux de flakiness comme une métrique de premier rang, mettez immédiatement en quarantaine les tests instables, et traitez la flakiness persistante des tests critiques comme un défaut d’ingénierie exigeant un propriétaire immédiat. La suite n’est aussi fiable que sa vérification la moins fiable.
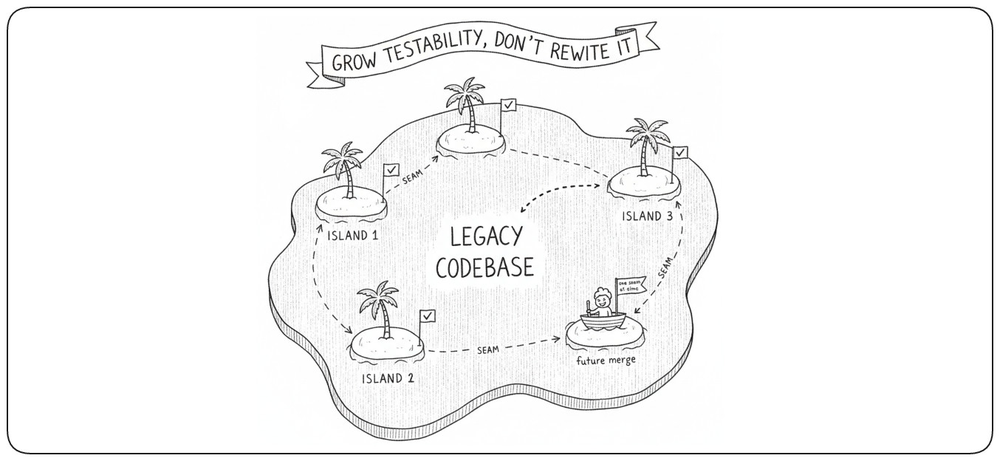
Faire croître la testabilité autour du code legacy
Toute base de code ne peut pas devenir testable d’un seul coup. Dans les systèmes antérieurs aux pratiques actuelles, la stratégie pragmatique consiste à faire croître progressivement des îlots de testabilité. Quand un changement touche du code legacy, extrayez le nouveau comportement dans une unité bien délimitée avec des entrées et sorties explicites, et faites appeler cette unité par le code legacy. Avec le temps, ces îlots se rejoignent : chaque modification ajoute une partie du système qui peut être vérifiée isolément. !!La testabilité n’a pas à être introduite par une réécriture ; elle peut être cultivée, une seam à la fois.!!
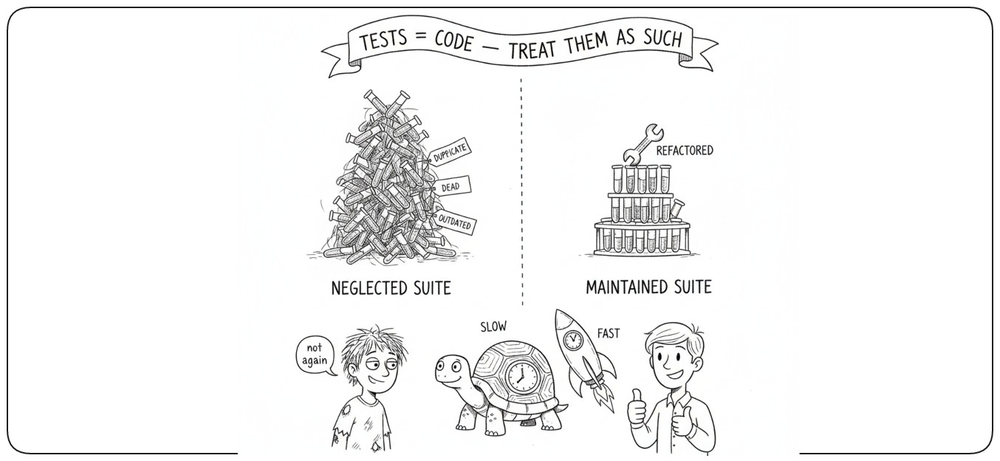
Refactorer les tests comme le code de production
Les tests sont du code. Ils doivent être relus, simplifiés et refactorés régulièrement — supprimez les vérifications obsolètes, fusionnez les doublons et gardez les assertions alignées sur le comportement actuel. Une suite bien entretenue reste rapide et à fort signal ; une suite négligée devient lente et apprend aux équipes à se méfier des résultats.
Des métriques qui font progresser
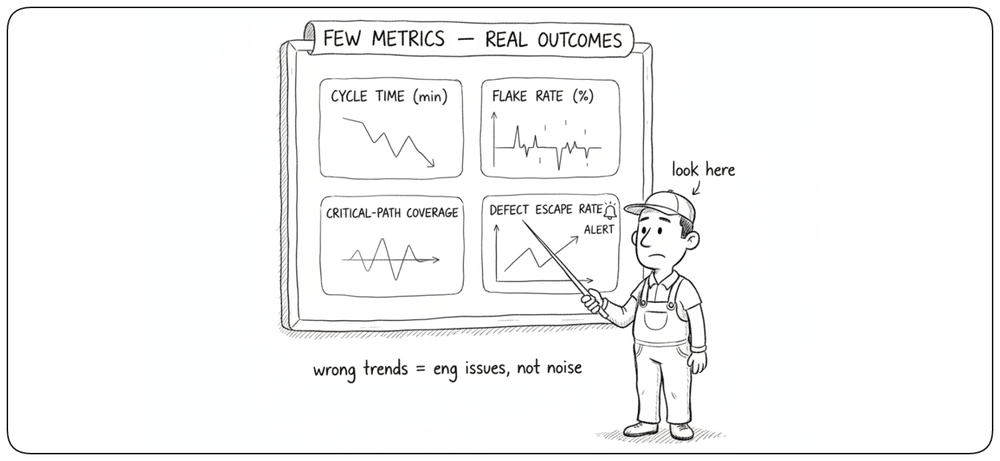
Suivez un petit ensemble d’indicateurs reflétant la santé : cycle time, taux de flakiness, couverture du chemin critique et taux d’échappement des défauts. Ces métriques révèlent où la fiabilité se dégrade et où investir — le but n’est pas d’avoir des chiffres de vanité mais des résultats prévisibles. Quand les données évoluent dans le mauvais sens, traitez-le comme un problème d’ingénierie, pas comme du bruit de fond.
Traiter les échecs de test comme des signaux exploitables
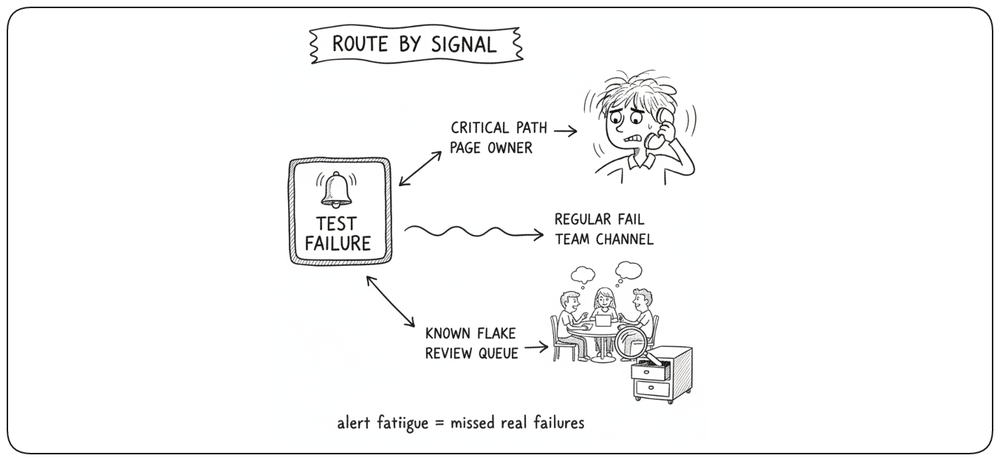
Les échecs doivent atteindre les personnes capables d’agir, avec assez de contexte pour faire le tri rapidement. Des alertes qui se déclenchent pour des flakes connus ou des échecs à faible signal apprennent aux équipes à les ignorer — concevez l’alerting pour que les échecs du chemin critique soient bruyants et que tout le reste soit routé pour revue. Traitez la gestion des échecs de test comme la réponse aux incidents : responsabilité claire, triage rapide et suivi rigoureux.
Culture et processus
L’architecture crée les conditions de la testabilité ; la culture détermine si ces conditions sont utilisées. Un système peut avoir des seams propres, des pipelines rapides et une riche observabilité, et pourtant accumuler des changements non vérifiés si la validation est vue comme le travail de quelqu’un d’autre ou comme une phase qui suit le développement. La confiance ne reste à jour que si ceux qui font un changement possèdent aussi la preuve qu’il est sûr.
Cette responsabilité doit apparaître dans le travail quotidien : dans ce qu’une équipe appelle « terminé », dans les questions que posent les reviewers, dans la façon dont les échecs sont routés et dans la manière dont les leçons de la production façonnent le changement suivant. L’objectif n’est pas un rituel de test séparé. C’est une pratique de développement dans laquelle l’incertitude est mise en évidence tôt, réduite délibérément et jamais transmise en silence.
La définition de « terminé » inclut la vérification
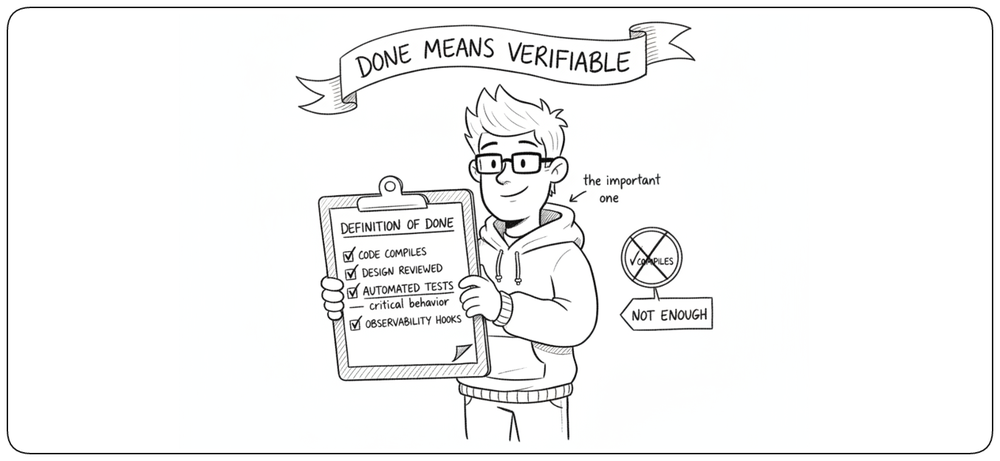
Une fonctionnalité n’est pas terminée quand elle compile ; elle l’est quand son comportement est vérifiable. !!Rendez la validation explicite dans la planification et la conception, et exigez que le comportement critique ait des vérifications automatisées avant le merge.!! Quand les équipes possèdent la vérification, la testabilité s’améliore naturellement, car les ingénieurs ressentent immédiatement le coût d’une conception non testable.
Le TDD comme pression de conception
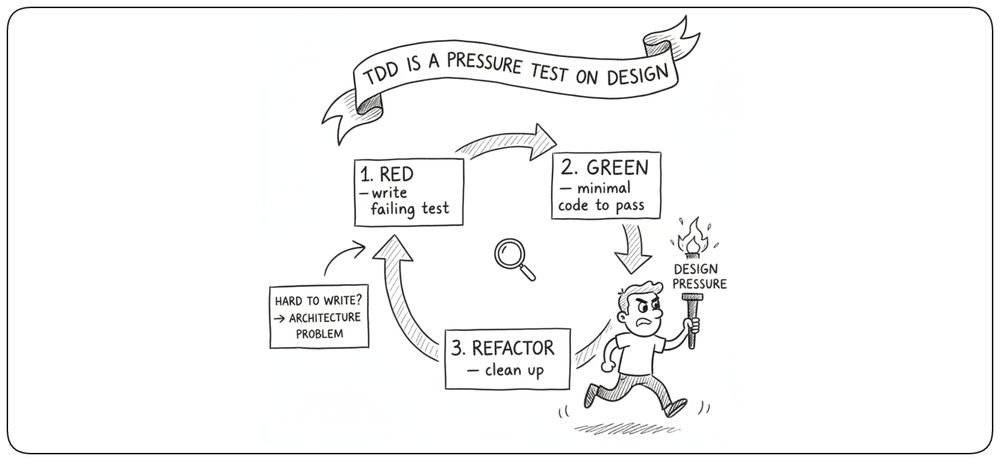
Le Test-Driven Development n’est pas obligatoire, mais c’est un bon test de pression pour la conception. Quand il est difficile d’écrire un test d’abord, c’est souvent le signe que les frontières sont floues ou que les dépendances sont trop implicites. Le TDD fonctionne mieux combiné à une architecture qui isole les effets de bord et expose des seams — dans ce contexte, il devient une méthode pratique pour construire par défaut un comportement vérifiable.
La code review comme garde-fou qualité
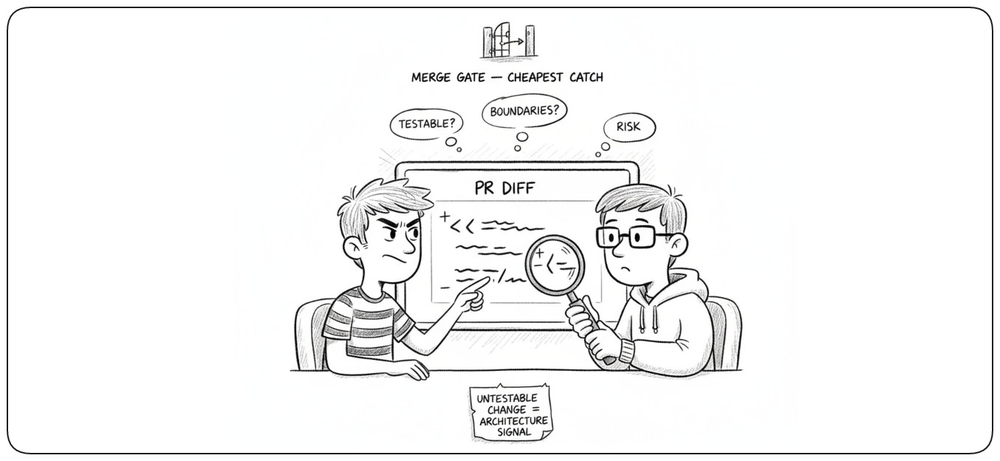
!!Le merge est le dernier endroit peu coûteux pour détecter de nombreuses classes de défauts.!! Les systèmes modernes peuvent être revertés, protégés par feature flags ou annulés progressivement, mais la review reste le moment le moins cher pour repérer les problèmes de logique, d’hypothèses de sécurité et de défauts de conception avant qu’ils ne deviennent des problèmes de production. Utilisez la review pour valider la stratégie de test autant que l’implémentation — si un changement ne peut pas être testé, c’est un signal architectural, pas un désagrément mineur.
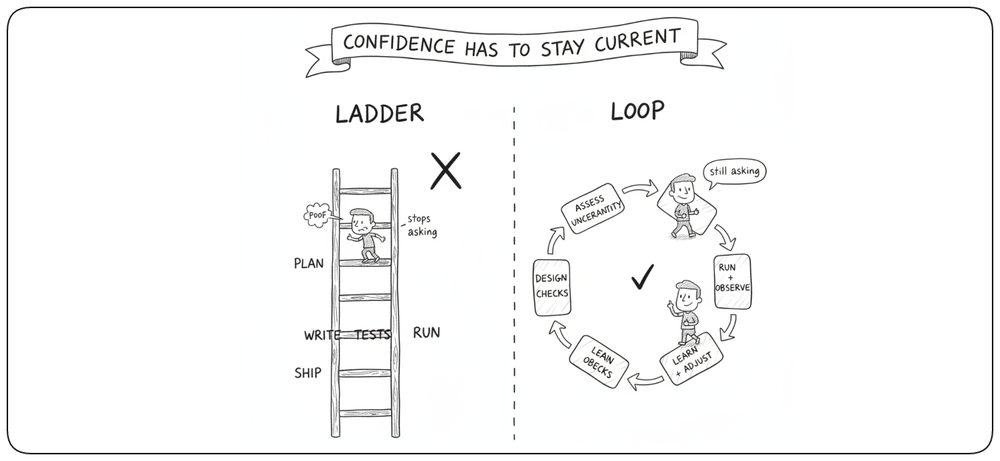
Tester est une boucle, pas une échelle
Tester n’est pas une étape qu’on gravit une fois pour la laisser derrière soi. À mesure que le système évolue, son profil de risque évolue aussi : de nouvelles fonctionnalités déplacent l’incertitude, et les anciennes hypothèses vieillissent en silence. Le schéma sain est une boucle — évaluer où se situe l’incertitude aujourd’hui, concevoir des vérifications qui la réduisent, les exécuter, apprendre de ce qu’elles révèlent, puis réévaluer. !!Une équipe qui voit le test comme une échelle livre une fois et cesse de se poser des questions ; une équipe qui le voit comme une boucle maintient sa confiance à jour à mesure que le système change.!!