Concevoir pour la sécurité
Chapter Info
Calculating... Writing Progress: 80%
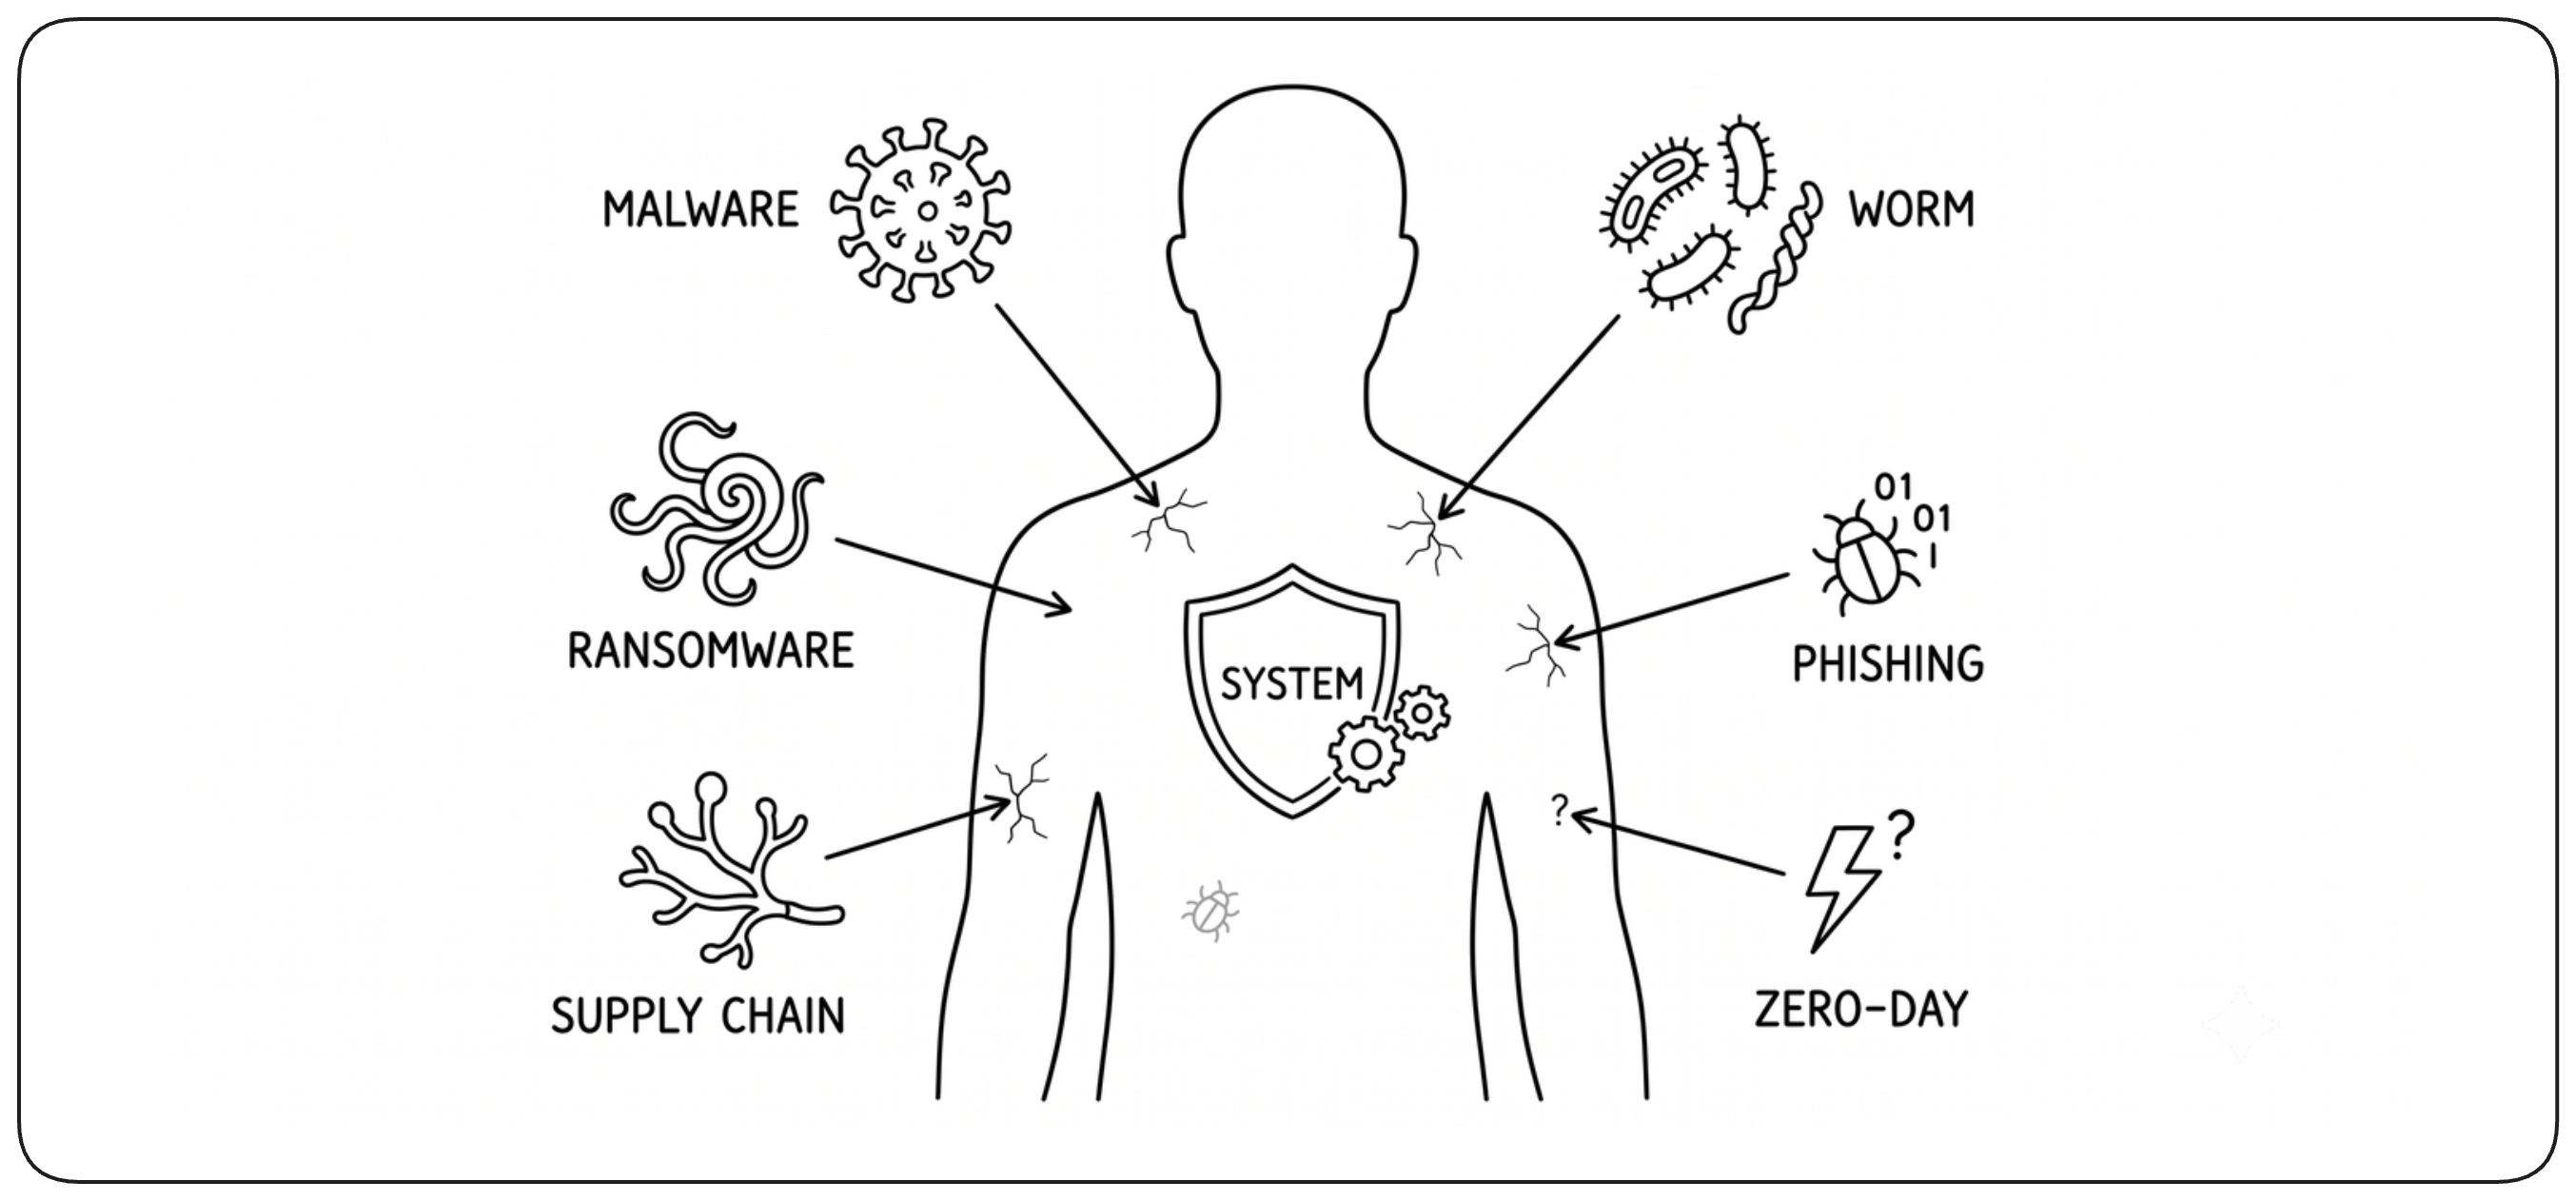
!!La sécurité n’est pas une fonctionnalité que l’on peut ajouter à la fin du développement. Elle émerge de la façon dont un système est conçu, construit, déployé et exploité. Chaque décision d’architecture influence ce qui peut être attaqué, jusqu’où une compromission peut se propager et à quelle vitesse le système peut se rétablir.!! Ce chapitre présente les principes durables pour réduire ces risques à travers la software supply chain, l’infrastructure, les données, les pratiques de développement et la réponse aux incidents. L’identité et le Zero Trust sont traités séparément dans le chapitre Concevoir pour la confiance.
Introduction
Ce qui était normal hier est une vulnérabilité aujourd’hui
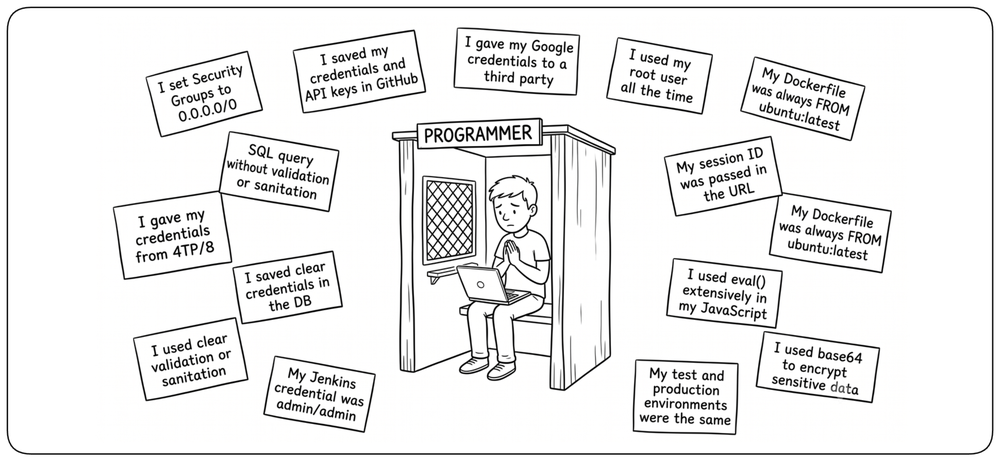
!!Ce qui était considéré comme sûr hier ne l’est plus aujourd’hui.!! Des algorithmes autrefois fiables se cassent désormais trivialement, des protocoles sont discrètement dépréciés, et des configurations qui semblaient parfaitement raisonnables sont devenues des erreurs de manuel. Tout ingénieur expérimenté porte en lui la confession de pratiques passées qui feraient sonner l’alarme dans n’importe quelle revue moderne. Il ne s’agit pas d’un échec individuel — c’est la nature du domaine. La sécurité évolue, et ce qui était la norme devient indéfendable.
Les pratiques changent, les fondations durent
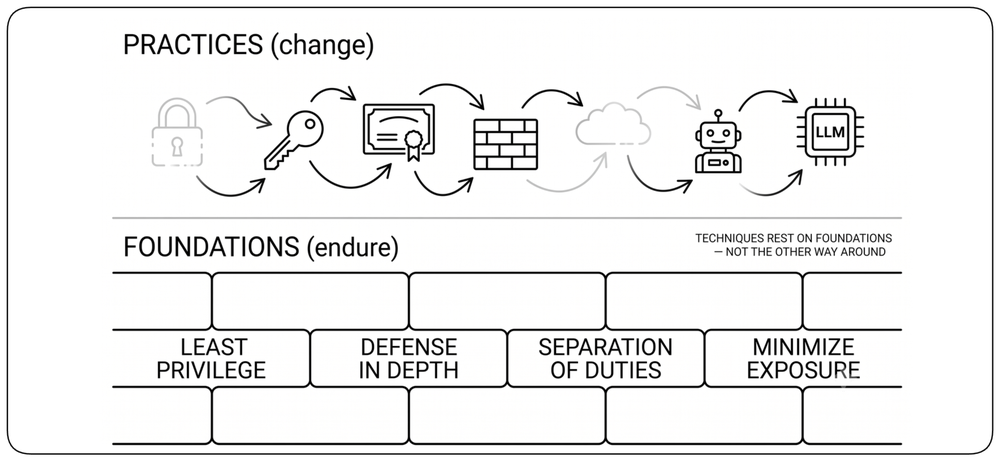
!!Les pratiques de sécurité changent constamment, mais les principes sous-jacents sont peu nombreux et conceptuellement simples!! — moindre privilège, défense en profondeur, séparation des tâches, minimisation de l’exposition. Ces fondations étaient vraies il y a des décennies, elles le sont aujourd’hui, et elles tiendront encore quand les outils actuels seront obsolètes. Ce chapitre se concentre sur ces fondations, car un ingénieur sécurité ancré dans les principes peut s’adapter à n’importe quelle nouvelle menace, alors que celui qui ne connaît que les pratiques du jour devient obsolète avec elles.
Aucune défense n’est infaillible
!!Même avec les protections les plus solides, aucune défense n’est efficace à 100 % — un risque résiduel subsiste toujours!!. L’humilité s’impose : accepter que des vulnérabilités existeront, que les attaquants évolueront, et que notre travail est d’apprendre en permanence, de nous adapter et de rester prêts face aux incidents que la prévention laissera inévitablement passer.
La vie continue sous attaque
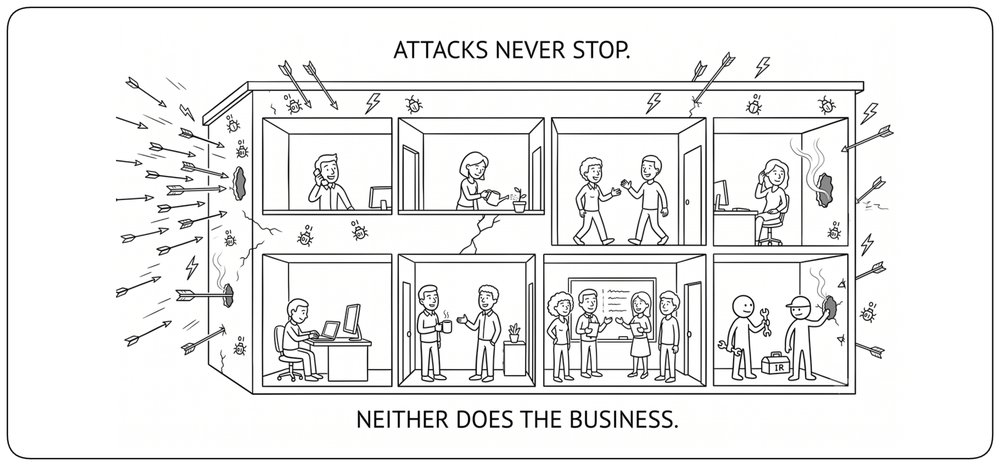
La sécurité moderne accepte une dure vérité : !!les attaques ne s’arrêtent jamais, et l’activité ne peut pas s’arrêter non plus!!. L’ancien paradigme demandait « comment empêcher toute intrusion ? » — le nouveau demande « comment continuer à opérer malgré elles ? ». Les défenses comptent toujours, mais on n’attend plus d’elles qu’elles soient parfaites. Les systèmes sont plutôt conçus pour que les intrusions puissent être détectées, contenues et réparées pendant que le reste de l’organisation continue de fonctionner. La résilience ne consiste pas à survivre à une attaque puis à retrouver la paix ; elle consiste à construire une vie normale sous une pression permanente et continue.
Principes fondamentaux de sécurité
Sécurité holistique : voir la sécurité comme un système
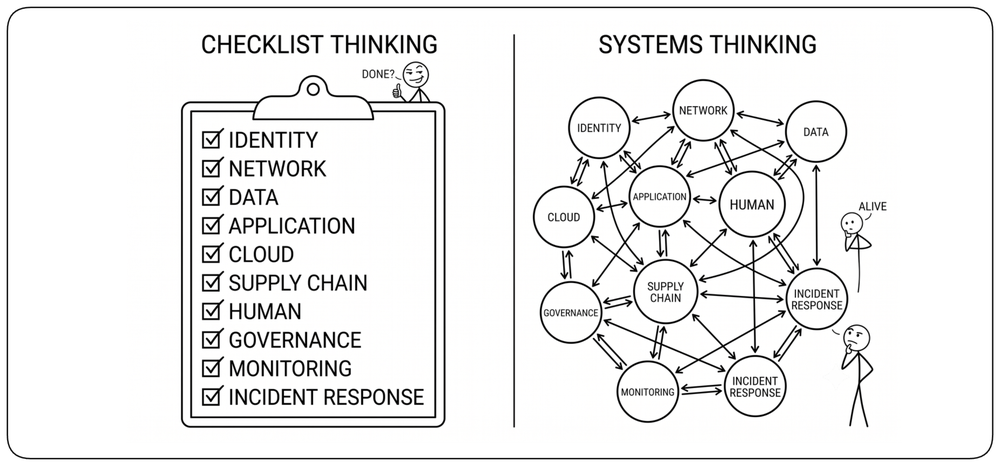
Face au nombre considérable de domaines de sécurité, le réflexe naturel est d’en faire une checklist et de la dérouler point par point. C’est rassurant — cochez toutes les cases et le travail semble terminé. Mais une checklist n’est qu’une liste de pièces ; la vraie sécurité est un système. !!Chaque contrôle tire sa force de sa relation avec les autres, pas du fait d’être coché sur une liste!!. Les principes qui suivent dans ce chapitre — défense en profondeur, moindre privilège, segmentation, monitoring, réponse aux incidents, et le reste — semblent chacun puissants isolément, mais chacun est faible seul et fort uniquement lorsqu’ils se renforcent mutuellement. La pensée holistique est ce changement de perspective : cesser de compter les contrôles, commencer à voir comment ils tiennent ensemble.
La sécurité vaut ce que vaut son maillon le plus faible
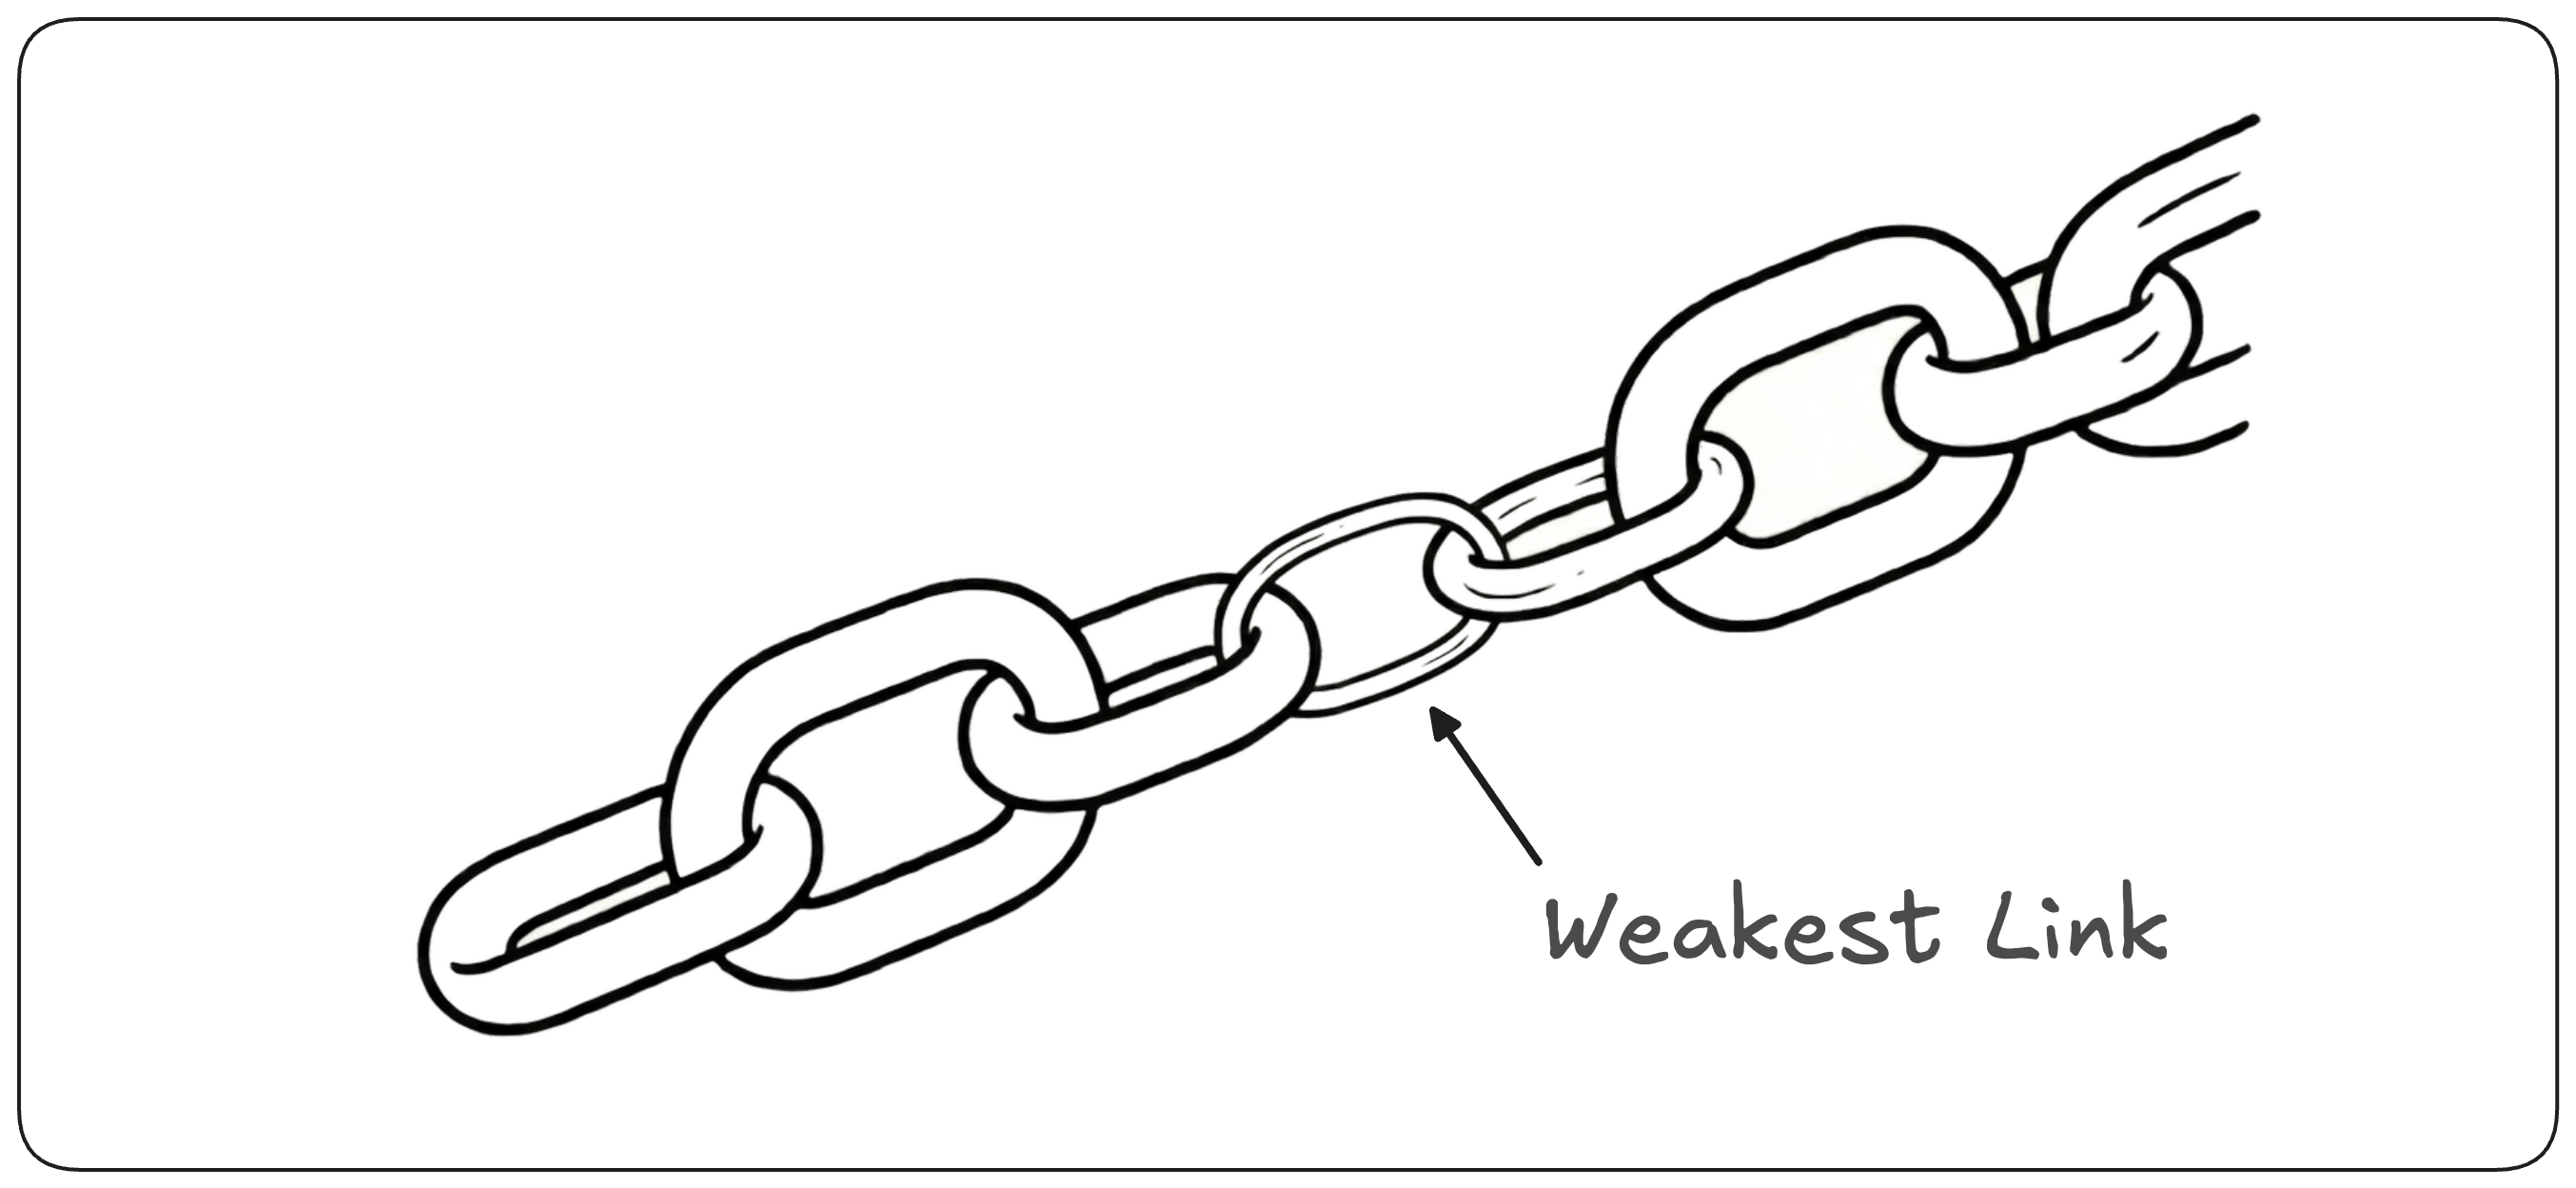
!!Les attaquants n’attaquent pas les systèmes là où ils sont les plus forts — ils attaquent là où ils sont les plus faibles!!. Peu importe le nombre de couches de défense autour des joyaux de la couronne si un serveur oublié, un endpoint legacy, un rôle trop permissif ou une dépendance non patchée offre un chemin moins coûteux. Le défenseur doit couvrir chaque point ; l’attaquant n’a qu’à en trouver un. Cette asymétrie rend la sécurité si difficile : renforcer les parties fortes ne rapporte rien, seule la fermeture du maillon le plus faible relève réellement le plancher.
S’appuyer sur des standards éprouvés, pas sur l’obscurité
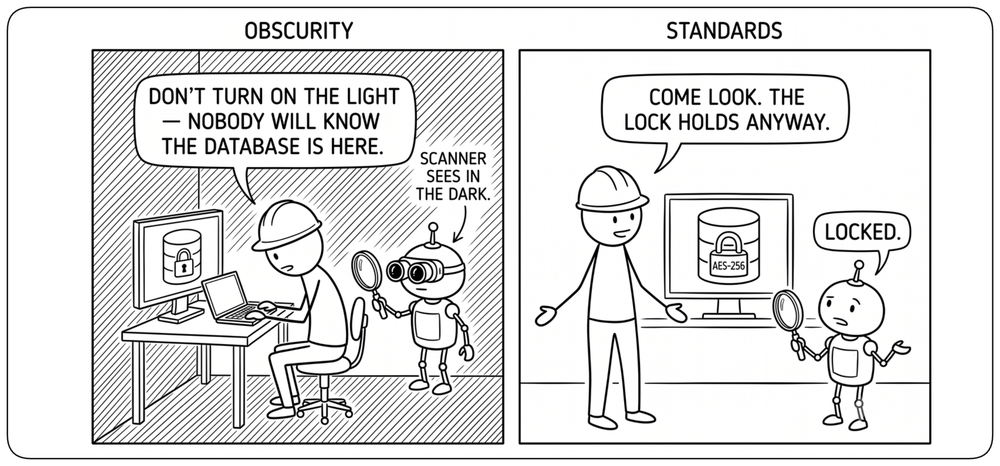
!!La vraie sécurité vient de standards éprouvés, pas d’inventions ingénieuses!!. Les algorithmes, protocoles et frameworks éprouvés — authentification forte, chiffrement moderne, modèles d’autorisation établis, défense en profondeur — ont survécu pendant des années à l’examen public des chercheurs comme des attaquants, et leurs faiblesses sont connues et corrigées. Une alternative maison, aussi brillante soit-elle, n’a aucun de ces antécédents : elle fonctionne peut-être, ou elle contient la faille fatale que personne n’a encore repérée. Les standards sont plus solides non pas parce qu’ils cachent quoi que ce soit, mais parce qu’ils ont été forgés au grand jour et ont tenu bon.
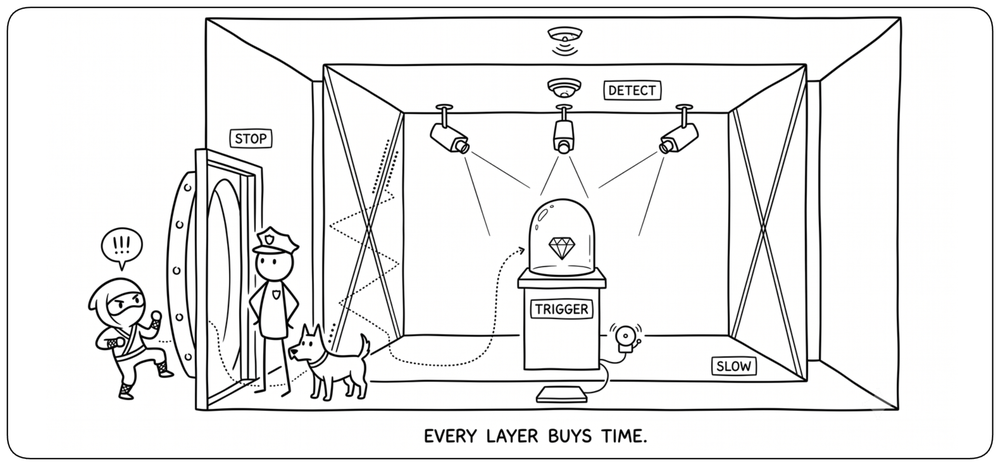
L’approche de sécurité multicouche
!!Aucun contrôle ne peut être cru infaillible — les systèmes sont donc enveloppés de multiples couches indépendantes, chacune remplissant un rôle différent!!. Certaines couches arrêtent l’attaquant net, d’autres ne font que le ralentir, d’autres encore se contentent de détecter et de déclencher l’alarme. L’intérêt de la défense en profondeur n’est pas la redondance pour elle-même mais la diversité : quand la première barrière tombe, la seconde est un obstacle d’une autre nature, qui oblige l’attaquant à résoudre un nouveau problème au lieu de répéter le même tour. Chaque couche supplémentaire fait gagner du temps, et le temps est ce qui transforme une brèche en intrusion détectée.
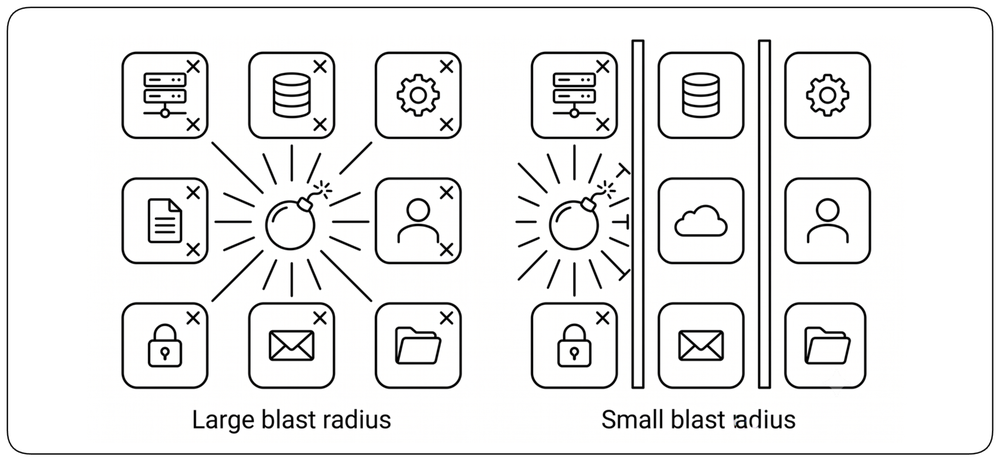
Limiter les dégâts, réduire le blast radius
Même avec de solides défenses, des brèches finiront par se produire. !!Réduire le blast radius, c’est concevoir les systèmes de sorte que, lorsqu’une défaillance survient, son impact reste contenu au lieu de se propager à tout l’environnement!!. Ce n’est pas une technique en soi mais un résultat : les mécanismes qui le produisent — segmentation, réduction de l’exposition, moindre privilège — sont détaillés dans les sections suivantes.
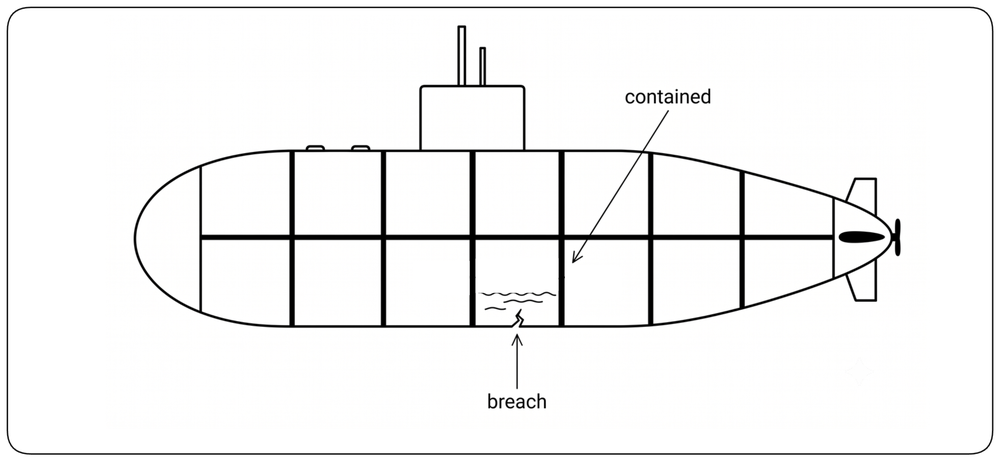
Segmentation : le mécanisme derrière un petit blast radius
La segmentation est le principal moyen de garder le blast radius petit. !!Des frontières internes transforment un grand système en de nombreux petits, de sorte qu’une compromission dans une section ne peut pas se propager au reste!!. Les sous-marins reposent sur la même idée — des compartiments étanches font qu’une brèche dans la coque inonde une section, pas tout le navire.
Minimiser l’exposition pour réduire les opportunités d’attaque
Les attaquants prospèrent grâce au temps, à la visibilité et à la persistance : !!plus une ressource reste exposée longtemps et plus elle est largement accessible, plus la probabilité que ses faiblesses soient découvertes et exploitées augmente!!. L’exposition combine la durée d’existence d’une ressource, l’étendue de son accessibilité et sa visibilité depuis l’extérieur — à travers les accès, les credentials, les services, les relations de confiance et l’infrastructure. Comme un sous-marin qui ne fait surface que brièvement pour éviter la détection, un système doit minimiser la durée et l’étendue de l’exposition de ses composants.
Tout garder temporaire
L’un des moyens les plus efficaces de minimiser l’exposition est de rendre les ressources de courte durée. !!Credentials éphémères, compute temporaire, tokens expirants et accès limités dans le temps!! réduisent tous les opportunités de l’attaquant et imposent un renouvellement continu. Quand tout expire naturellement, les systèmes se rafraîchissent d’eux-mêmes et réduisent le risque à long terme.
Protection des données
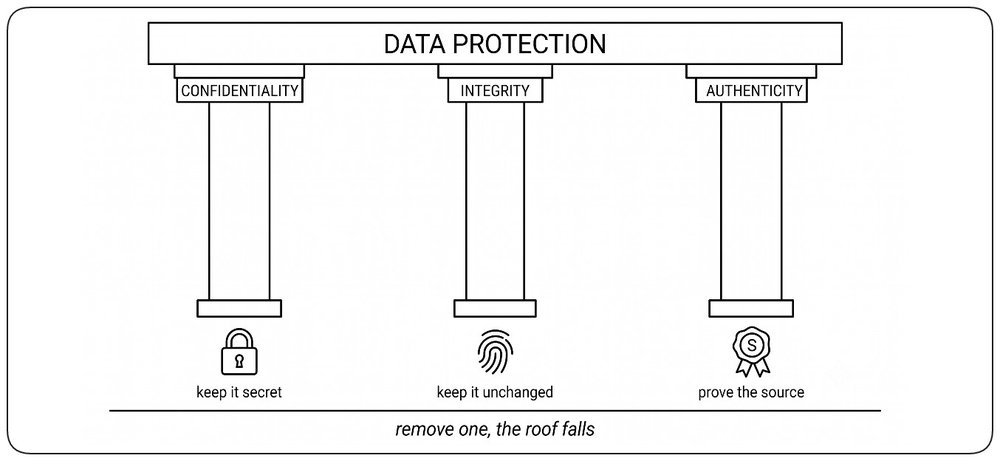
Pour la plupart des organisations, les données sont l’actif que les attaquants visent en définitive. L’infrastructure, les applications, les identités et les réseaux ont de la valeur avant tout parce qu’ils donnent un chemin vers ces données. Protéger les données commence donc bien avant le chiffrement — avec des décisions sur ce qu’il faut collecter, comment le classifier, qui peut y accéder, combien de temps le conserver et comment prouver qu’il n’a pas été altéré. Confidentialité, intégrité et authenticité sont des garanties différentes, chacune exigeant ses propres contrôles architecturaux.
Classification des données
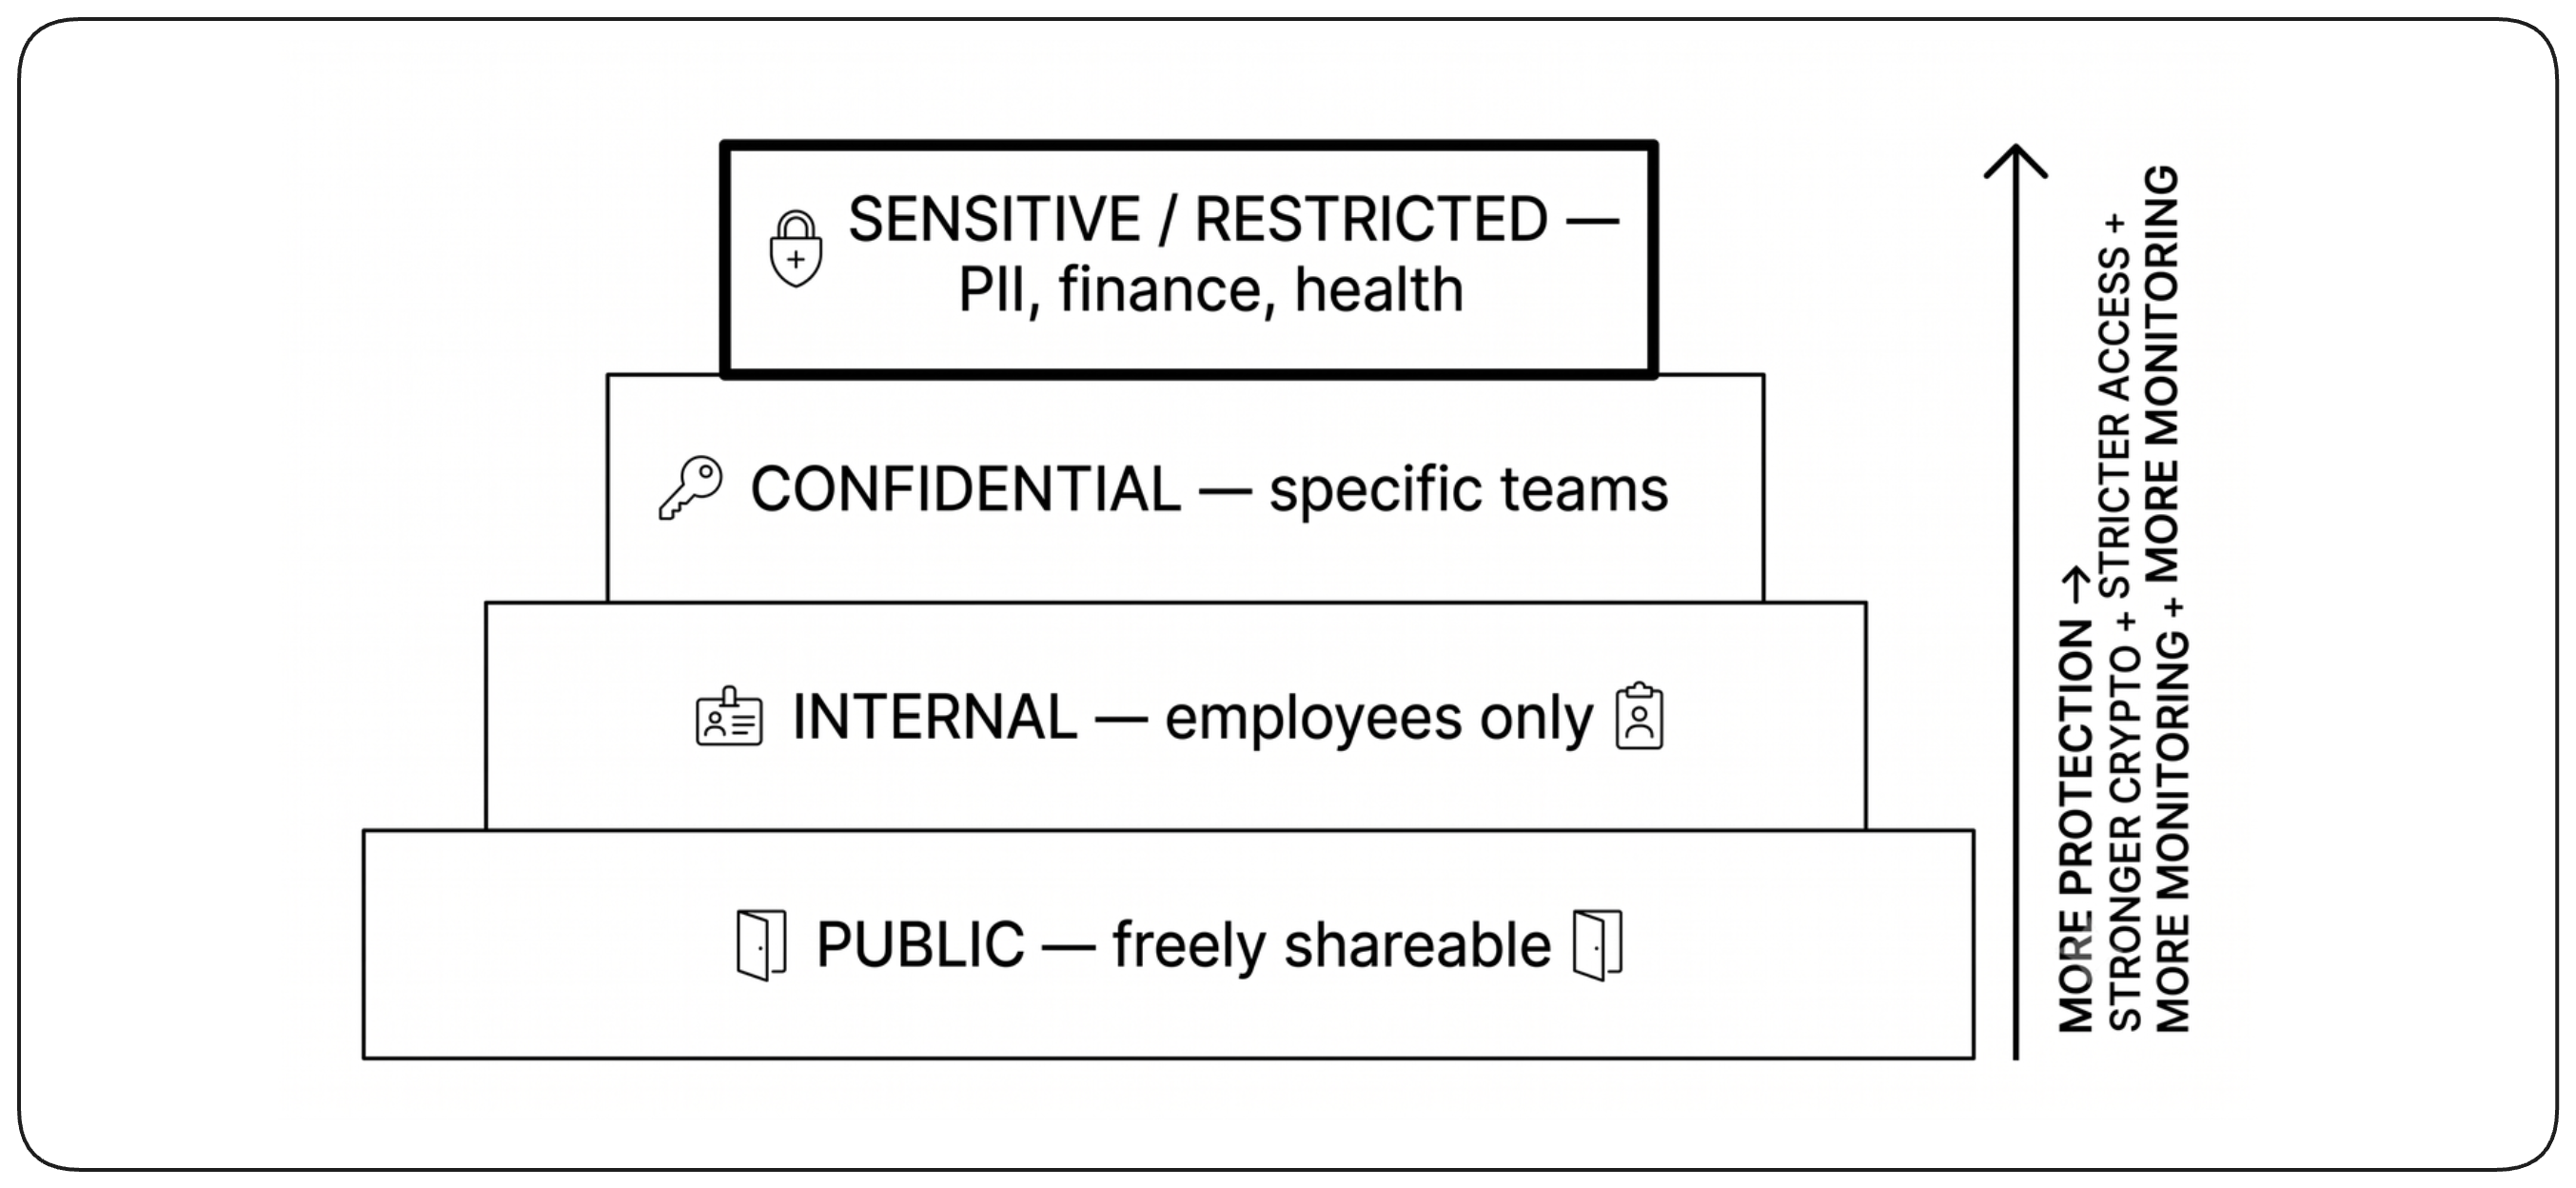
!!Toutes les données ne méritent pas la même protection, et la classification est ce qui transforme ce principe en contrôles concrets : chaque niveau détermine sa propre force de chiffrement, ses règles d’accès, sa durée de rétention et sa profondeur de monitoring!!. Sans elle, soit tout est sur-protégé — lent, coûteux, inutilisable — soit tout est sous-protégé, et les joyaux de la couronne côtoient le menu de la cafétéria. La classification est la fondation sur laquelle repose chaque contrôle de sécurité des données en aval.
Classifier avant de construire
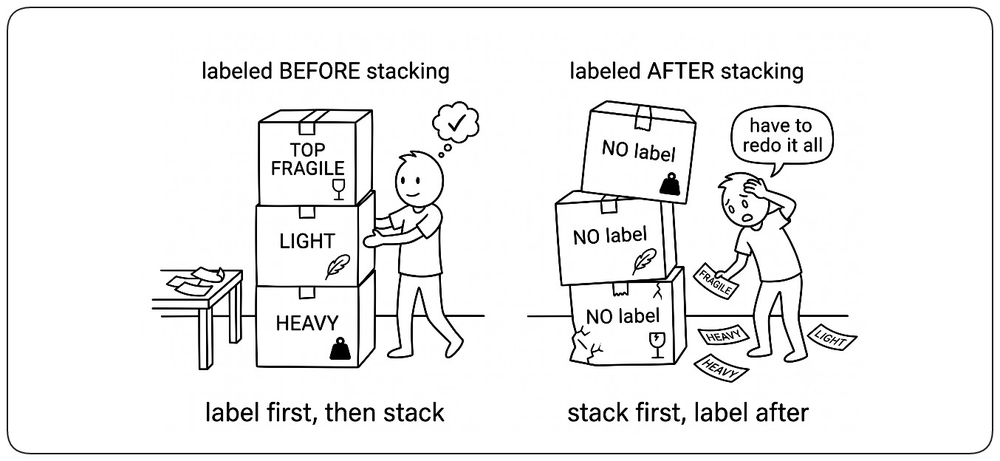
!!La classification n’est pas une étiquette collée sur un système une fois qu’il existe — c’est une entrée de la conception elle-même!!. Où vivent les champs sensibles, quelles tables peuvent être jointes, quels services peuvent lire quoi et ce qu’expose une API sont tous des décisions d’architecture déguisées en décisions de données. Un schéma dessiné sans classification laisse fuir la sensibilité à travers les frontières par défaut, et le rattrapage implique des migrations coûteuses, des découpages pénibles et des contrôles greffés après coup. Classifiez d’abord, puis concevez en conséquence.
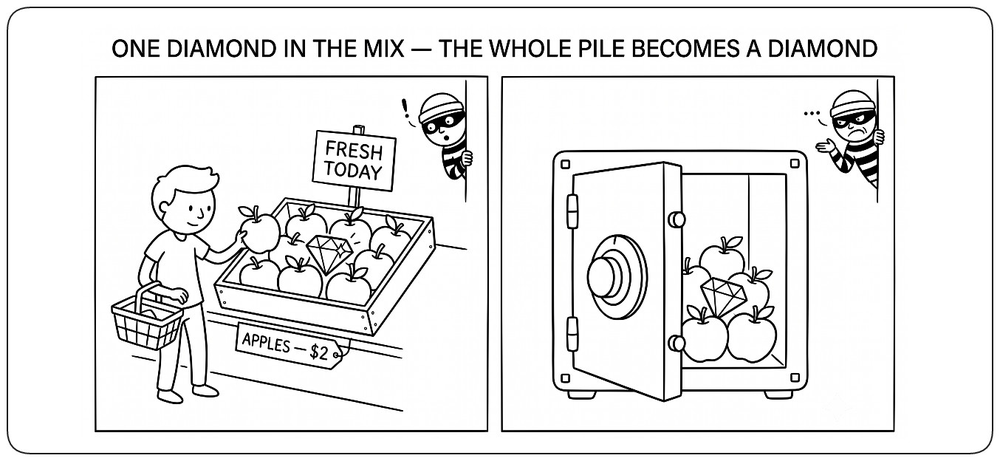
Les données mixtes héritent de la classification la plus élevée
!!Quand des données de classifications différentes sont combinées, le résultat hérite de la classification la plus élevée présente, car un seul champ sensible impose la même protection à l’ensemble du jeu de données!!. Ce principe du high-water mark est particulièrement important dans les pipelines d’analytique, les data lakes et l’entraînement de modèles ML, où l’agrégation masque souvent la sensibilité des entrées individuelles. La classification suit toujours la donnée la plus sensible — pas la moyenne.
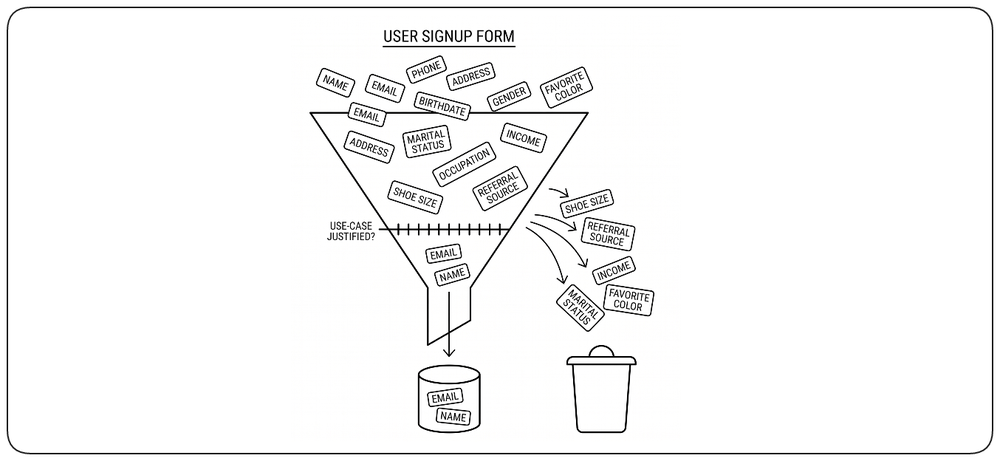
Ne collecter que le nécessaire
!!La donnée la mieux protégée est celle que vous n’avez jamais collectée!!. Chaque champ stocké est un champ à sécuriser, chiffrer, sauvegarder, auditer et finalement supprimer — et, en cas de brèche, à divulguer. La minimisation des données inverse le réflexe de tout capturer « au cas où » : chaque attribut doit justifier son existence par un cas d’usage réel, pas hypothétique. Ce qui n’est pas collecté ne peut pas fuiter, ne peut pas être réquisitionné, ne peut pas être vendu, et ne vieillit pas en passif.
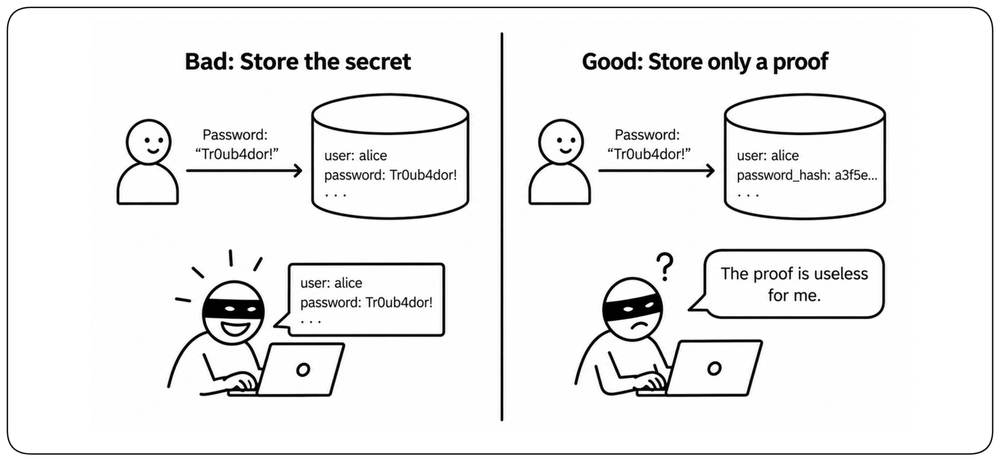
Stocker la preuve, pas les secrets
!!Un système doit stocker la représentation minimale de l’information sensible nécessaire à sa fonction — pas nécessairement la valeur d’origine.!! Si le système doit seulement vérifier quelque chose, il stocke ce qui est nécessaire pour le vérifier, pas le secret lui-même. Les mots de passe en sont l’exemple classique : l’authentification exige de prouver qu’un mot de passe correspond, pas de le retrouver, donc le mot de passe d’origine n’a jamais besoin d’être stocké. Ce principe s’applique bien au-delà des mots de passe : chaque fois que la valeur sensible d’origine peut être remplacée par une représentation dérivée, le faire supprime une information qu’un attaquant pourrait autrement voler.
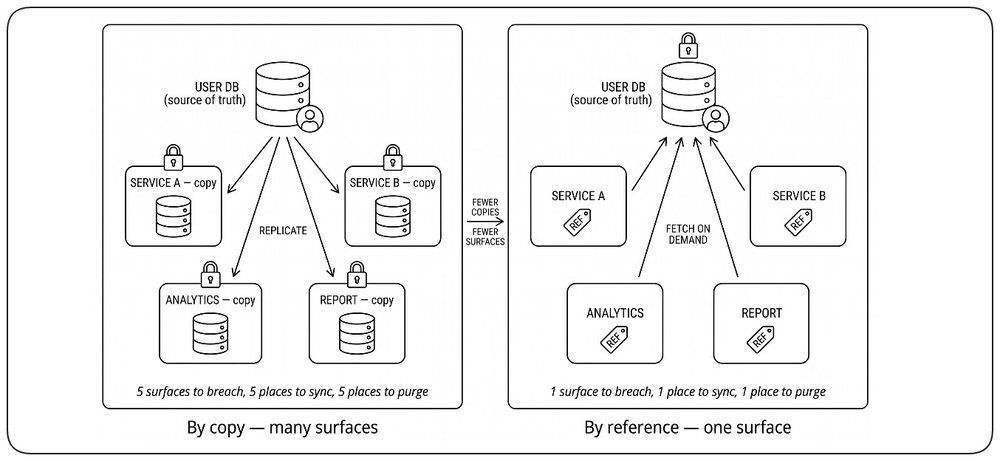
Les données par référence, pas par copie
!!Chaque copie de données sensibles est un actif de plus à protéger!!. Dès qu’un enregistrement est dupliqué dans un cache, un service en aval, un entrepôt analytique ou un rapport, il multiplie la surface d’attaque, le périmètre d’audit et le nombre d’endroits à garder synchronisés quand un client demande sa suppression. Privilégiez un accès contrôlé à la source faisant autorité plutôt qu’une réplication inutile. Quand des copies sont nécessaires — pour la disponibilité, la performance ou l’analytique — rendez-les explicites, minimisées, gouvernées et protégées indépendamment.
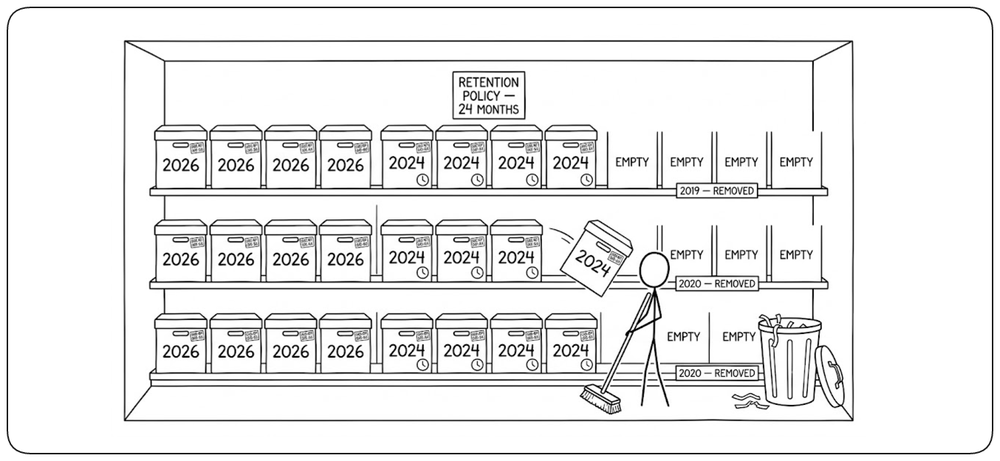
Supprimer les données dès que possible
Les données ont un cycle de vie, et chaque jour qu’elles survivent est un jour de plus où elles peuvent être volées. !!La rétention est une décision de risque, pas une décision d’archivage!!. Un enregistrement conservé « au cas où » devient un passif dès qu’il est compromis, réquisitionné ou reclassé comme sensible. Des politiques de rétention automatisées, des TTL sur les caches, des sauvegardes qui expirent et des purges planifiées font de la suppression une propriété du système plutôt qu’une réflexion après coup manuelle. La donnée la plus sûre est celle qui n’existe plus.
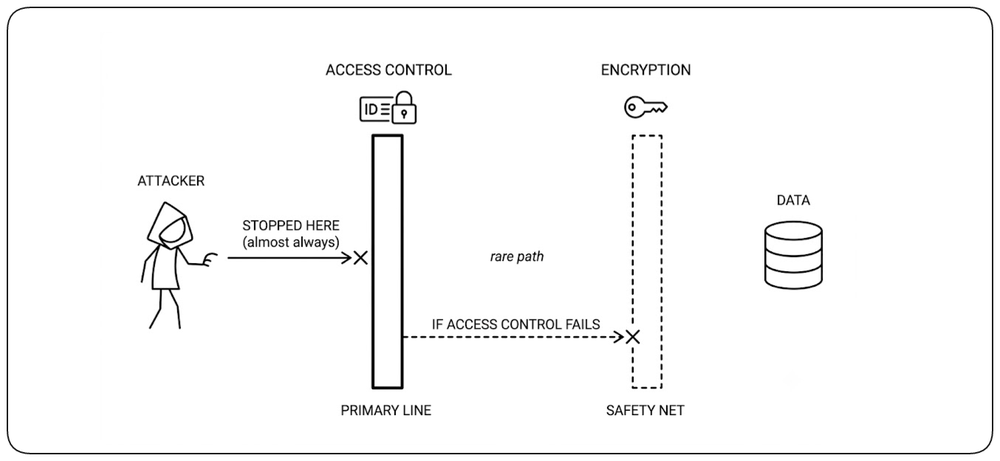
Le contrôle d’accès passe avant la cryptographie
La plupart des brèches de données ne cassent pas le chiffrement — elles entrent par la grande porte avec un credential légitime. !!Le contrôle d’accès décide qui peut lire les données ; le chiffrement les protège quand la couche de stockage ou de transport est exposée!!. AES-256 ne protège rien si un rôle trop permissif, un token périmé ou une clé d’API oubliée remet les données en clair à l’attaquant. Les architectes cherchent réflexivement une cryptographie plus forte alors que le vrai levier est une autorisation plus stricte : qui peut interroger, avec quelle portée, sous quelles conditions et avec quel audit. Posez d’abord le bon modèle d’accès — le chiffrement le complète, mais ne le remplace pas.
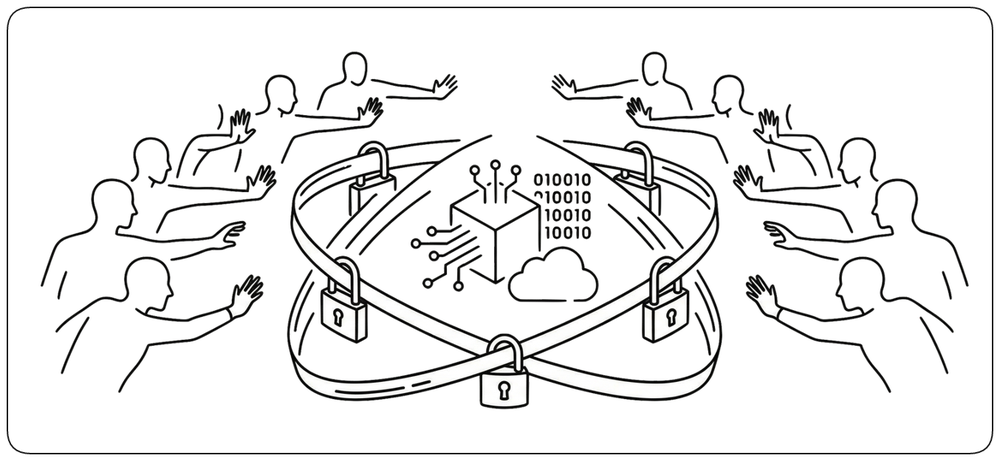
Minimiser l’accès humain aux données
!!Ce sont les systèmes qui doivent accéder aux données, pas les personnes, car chaque point de contact humain est une occasion d’erreur, d’exfiltration ou de coercition, et chaque credential d’opérateur est un credential qu’un attaquant peut voler!!. Les pipelines automatisés, les comptes de service et les API sécurisées déplacent les données entre systèmes sans jamais les exposer à des yeux humains. Quand l’accès humain est inévitable, il doit rester l’exception : de courte durée, borné, approuvé et journalisé. L’humain est le cas d’audit, pas le chemin par défaut.
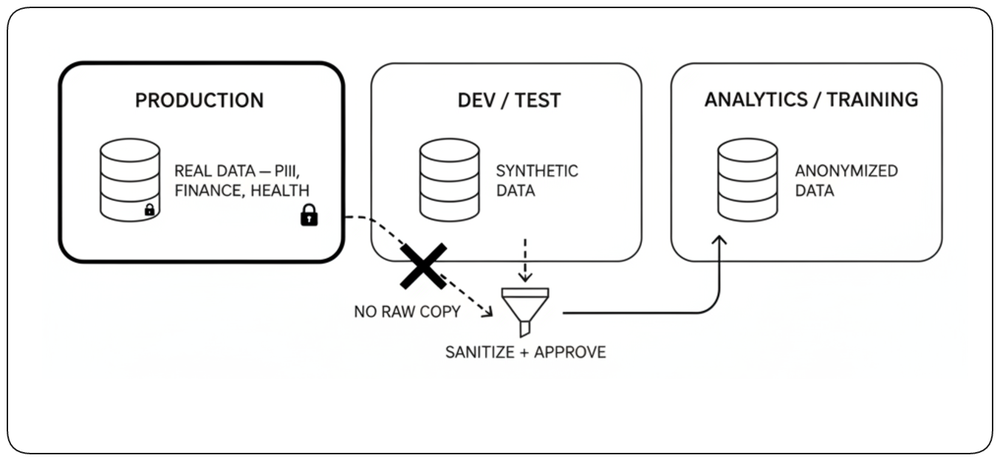
Ne jamais utiliser de données de production hors production
Les données de production portent un risque de production. Les copier dans des environnements de développement, de test, d’analytique ou d’entraînement étend le périmètre de confidentialité à des zones aux contrôles plus faibles, aux accès plus larges et aux règles de rétention plus laxistes — une source fréquente de brèches et de violations réglementaires (GDPR, HIPAA, PCI DSS). !!Les environnements inférieurs doivent utiliser par défaut des jeux de données synthétiques ou entièrement anonymisés.!! Quand des données réelles sont réellement nécessaires pour un cas d’usage précis, elles doivent être assainies, formellement approuvées, limitées dans le temps et traitées avec les mêmes contrôles que la production elle-même.
Le chiffrement protège le support, pas l’accès
Le chiffrement est la dernière ligne de défense : quand le disque est volé, la bande de sauvegarde perdue ou le réseau mis sur écoute, seul du texte chiffré fuite. !!Le chiffrement protège contre la perte du support, pas contre un utilisateur légitime!!. Une application autorisée, un processus compromis ou une requête avec des credentials valides voient quand même le texte en clair — parce qu’ils détiennent la clé. Chiffrez tout par défaut, mais reconnaissez la limite : le chiffrement complète le contrôle d’accès, il ne le remplace pas. La question suivante est toujours : qui a le droit de déchiffrer quoi.
Séparer les clés de chiffrement des données
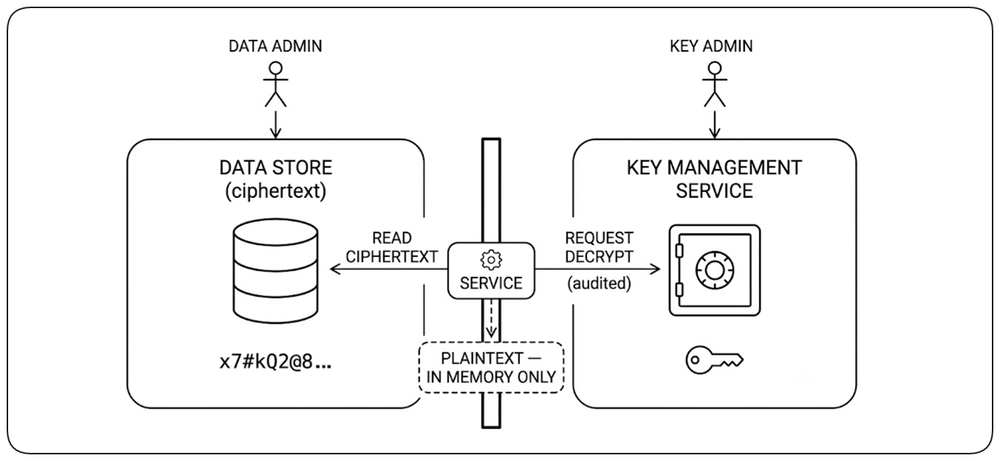
Le chiffrement se résume à la gestion des clés : !!perdez le contrôle des clés et le texte chiffré devient du texte en clair!!. Les clés ne doivent jamais vivre à côté des données qu’elles protègent — même base de données, même disque, même administrateur — car une seule compromission débloque alors les deux. Un Key Management Service dédié détient les clés sous une garde, un accès et un audit séparés ; le propriétaire des données peut lire le texte chiffré, le propriétaire des clés peut autoriser le déchiffrement, et aucun rôle ne fait les deux. La rotation, la révocation et les clés par tenant ne deviennent possibles qu’une fois cette séparation en place.
L’intégrité n’est pas la confidentialité
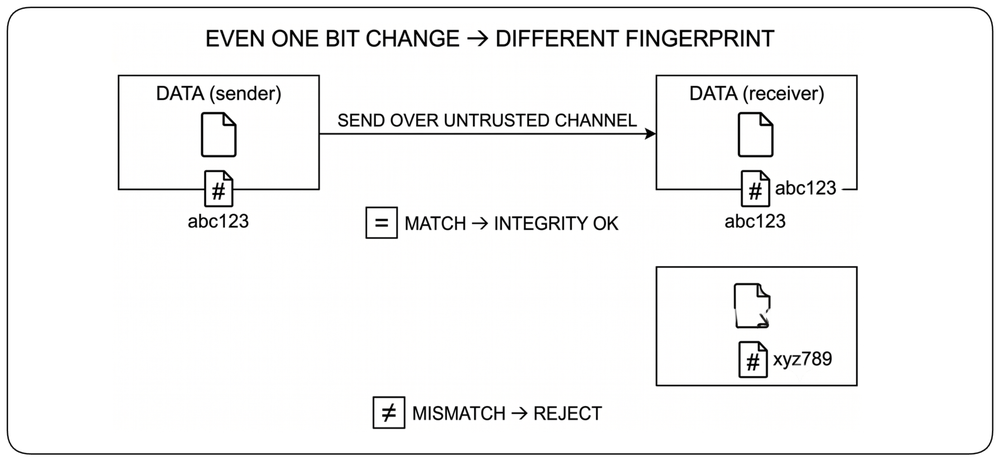
!!Le chiffrement garde les données secrètes, mais l’intégrité les garde honnêtes : un message peut être chiffré de bout en bout et pourtant être silencieusement tronqué, rejoué ou remplacé!!. Les hashes cryptographiques, les HMAC et les signatures numériques produisent une empreinte qu’un seul bit modifié suffirait à briser : l’émetteur la calcule, le récepteur la recalcule et compare. Confidentialité et intégrité sont deux garanties indépendantes — un système sérieux a besoin des deux, toujours associées.
Authenticité des messages
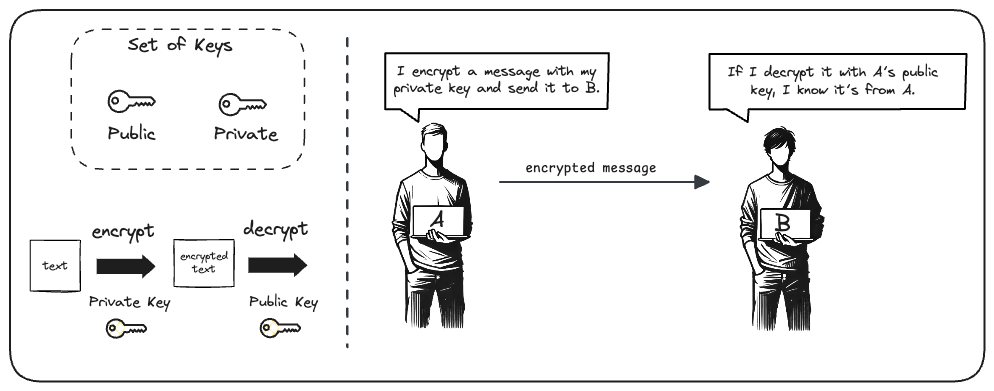
L’authenticité des messages et la non-répudiation visent à vérifier l’identité de l’émetteur et à garantir qu’il ne puisse pas nier avoir envoyé le message. Grâce à des mécanismes cryptographiques comme les clés privée et publique, un émetteur peut signer un message avec sa clé privée, créant une signature unique que lui seul pouvait générer. Le destinataire peut alors utiliser la clé publique de l’émetteur pour valider la signature, confirmant que le message provient bien de l’émetteur déclaré. Ce processus authentifie non seulement l’identité de l’émetteur, mais garantit aussi qu’il ne pourra pas prétendre plus tard ne pas avoir envoyé le message, fournissant une preuve d’origine irréfutable.
Trois piliers, pas un seul
La protection des données est souvent réduite à « tout chiffrer », mais !!confidentialité, intégrité et authenticité sont trois garanties indépendantes — il faut les trois!!. Un texte chiffré peut être rejoué. Un message signé peut être lisible par tous. Un contrôle d’intégrité ne dit rien sur l’auteur des données. Les systèmes réels les traitent comme une triade, pas comme un menu : chiffrer pour garder le secret, hasher ou utiliser un HMAC pour prouver l’absence de modification, signer pour prouver l’origine. En manquer une seule laisse grande ouverte toute une classe d’attaques.
Inventaire et contrôle
Pourquoi l’inventaire et le contrôle comptent
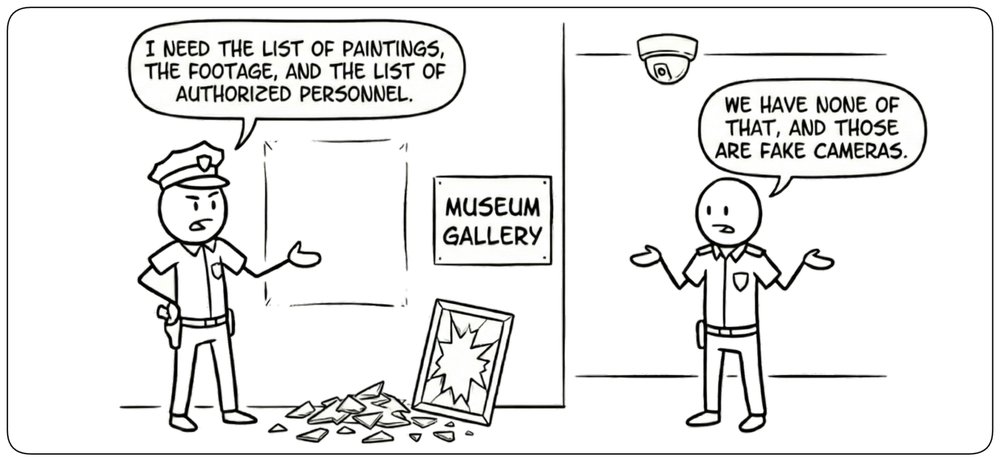
La sécurité commence par la visibilité. !!On ne peut pas protéger ce dont on ignore l’existence, ni se défendre contre des menaces que l’on n’a pas identifiées!!. L’inventaire fonctionne dans les deux sens : savoir ce que l’on protège (actifs, systèmes, données) et savoir qui a accès (utilisateurs, acteurs, menaces potentielles). Les actifs inconnus deviennent des angles morts, mais les schémas d’accès non suivis et le personnel non autorisé aussi. Les deux dimensions — vos ressources et votre paysage de menaces — forment la fondation de chaque contrôle de sécurité.
Inventaire unifié des actifs et des logiciels
Chaque appareil, VM, conteneur et bibliothèque qui tourne dans une organisation fait partie de sa surface d’attaque. Tout actif inconnu, non géré ou obsolète devient un angle mort qu’un attaquant peut exploiter. !!L’inventaire unifié réunit deux catalogues!! — la couche matérielle (serveurs, endpoints, ressources cloud, IoT) et la couche logicielle (applications, services, bibliothèques, dépendances). Ensemble, ils forment l’image complète sans laquelle rien d’autre ne peut être protégé, patché ou surveillé.
Software Bill of Materials (SBOM)
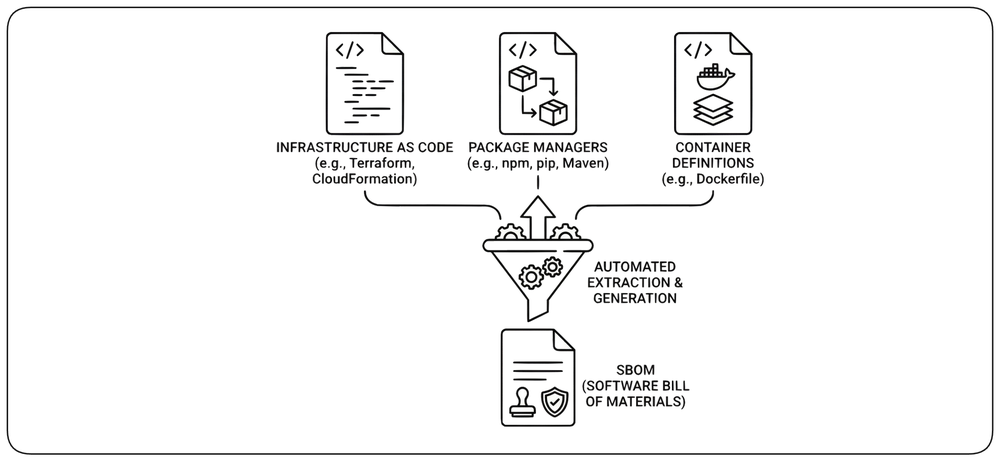
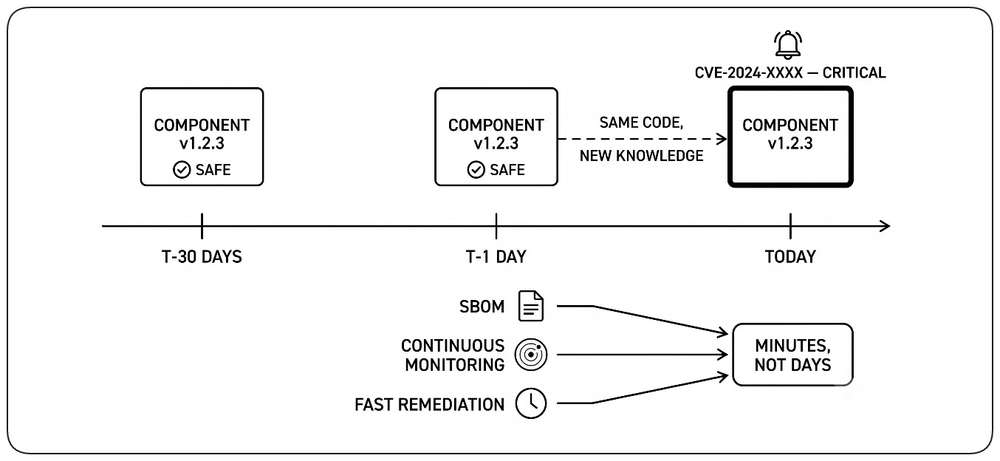
Un !!Software Bill of Materials!! est un inventaire lisible par machine de chaque composant, bibliothèque et dépendance d’une application — extrait automatiquement du code d’infrastructure, des gestionnaires de paquets et des définitions de conteneurs. De plus en plus imposé par des réglementations comme l’Executive Order américain sur la cybersécurité, il transforme un logiciel opaque en une supply chain visible, de sorte que lorsqu’une nouvelle CVE tombe, les composants concernés sont identifiés en minutes plutôt qu’en jours.
Le déficit de visibilité du déploiement
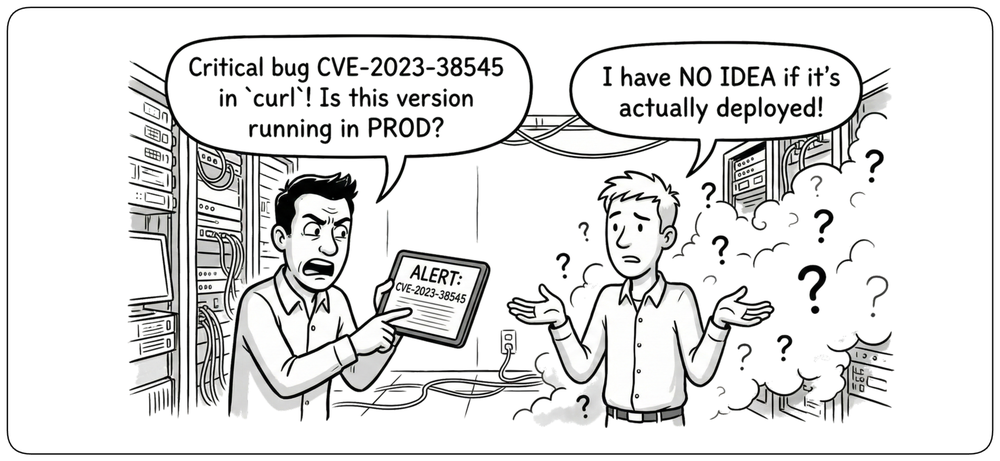
Savoir quels composants existent dans votre logiciel (SBOM) ne représente que la moitié de l’équation — il faut aussi savoir où ces artefacts sont réellement déployés et en cours d’exécution. Quand une vulnérabilité critique est annoncée, une évaluation rapide de l’impact exige de répondre à : « Où cela tourne-t-il ? » Sans mapping déploiement-artefact, les organisations font face à un angle mort critique : elles peuvent identifier qu’une bibliothèque vulnérable existe dans le dépôt d’artefacts, mais ne peuvent pas déterminer quels environnements, services ou instances sont touchés. Ce déficit transforme chaque avis de sécurité en longue enquête plutôt qu’en réponse immédiate et ciblée. Les équipes de sécurité perdent des heures à auditer les déploiements manuellement, pour répondre à des questions élémentaires sur l’exposition et l’impact.
Artifact Manager : la source unique de vérité
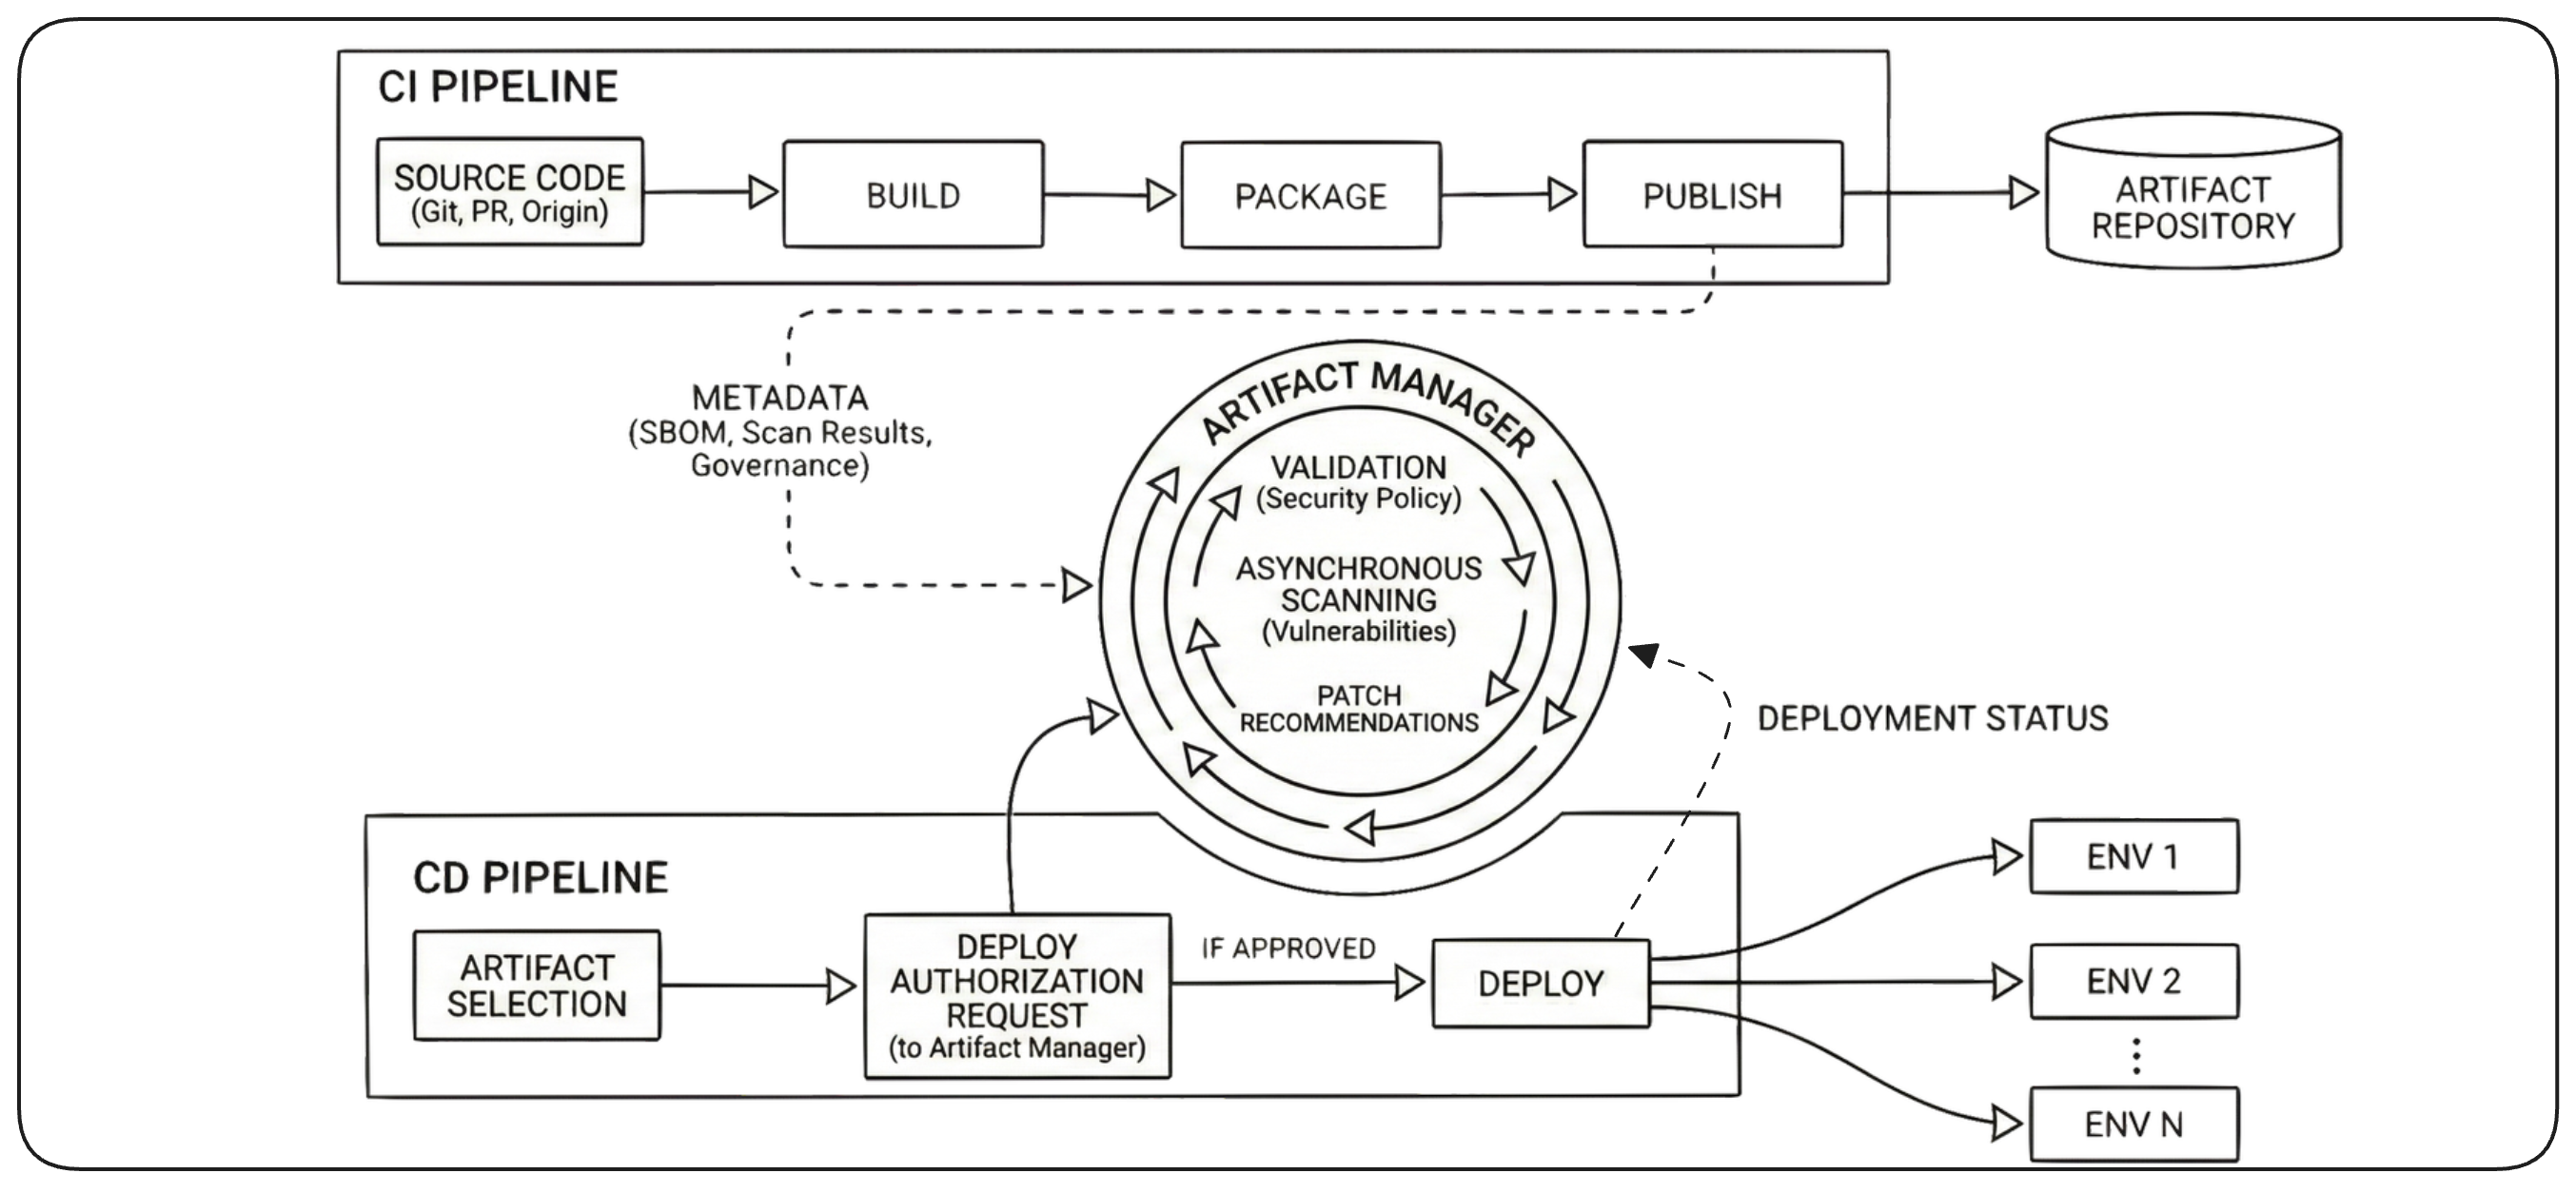
Un Artifact Manager joue le rôle de source unique de vérité pour chaque artefact. Le CI publie chacun avec son SBOM, ses résultats de scan et sa provenance de build ; le CD doit interroger le manager avant de déployer, puis signale où l’artefact tourne. Ce flux bidirectionnel révèle ce qu’un artefact contient, quels contrôles il a passés et où il se trouve précisément — transformant une nouvelle CVE d’un audit de plusieurs jours en une réponse ciblée de quelques minutes.
Contrôler la sécurité de la supply chain
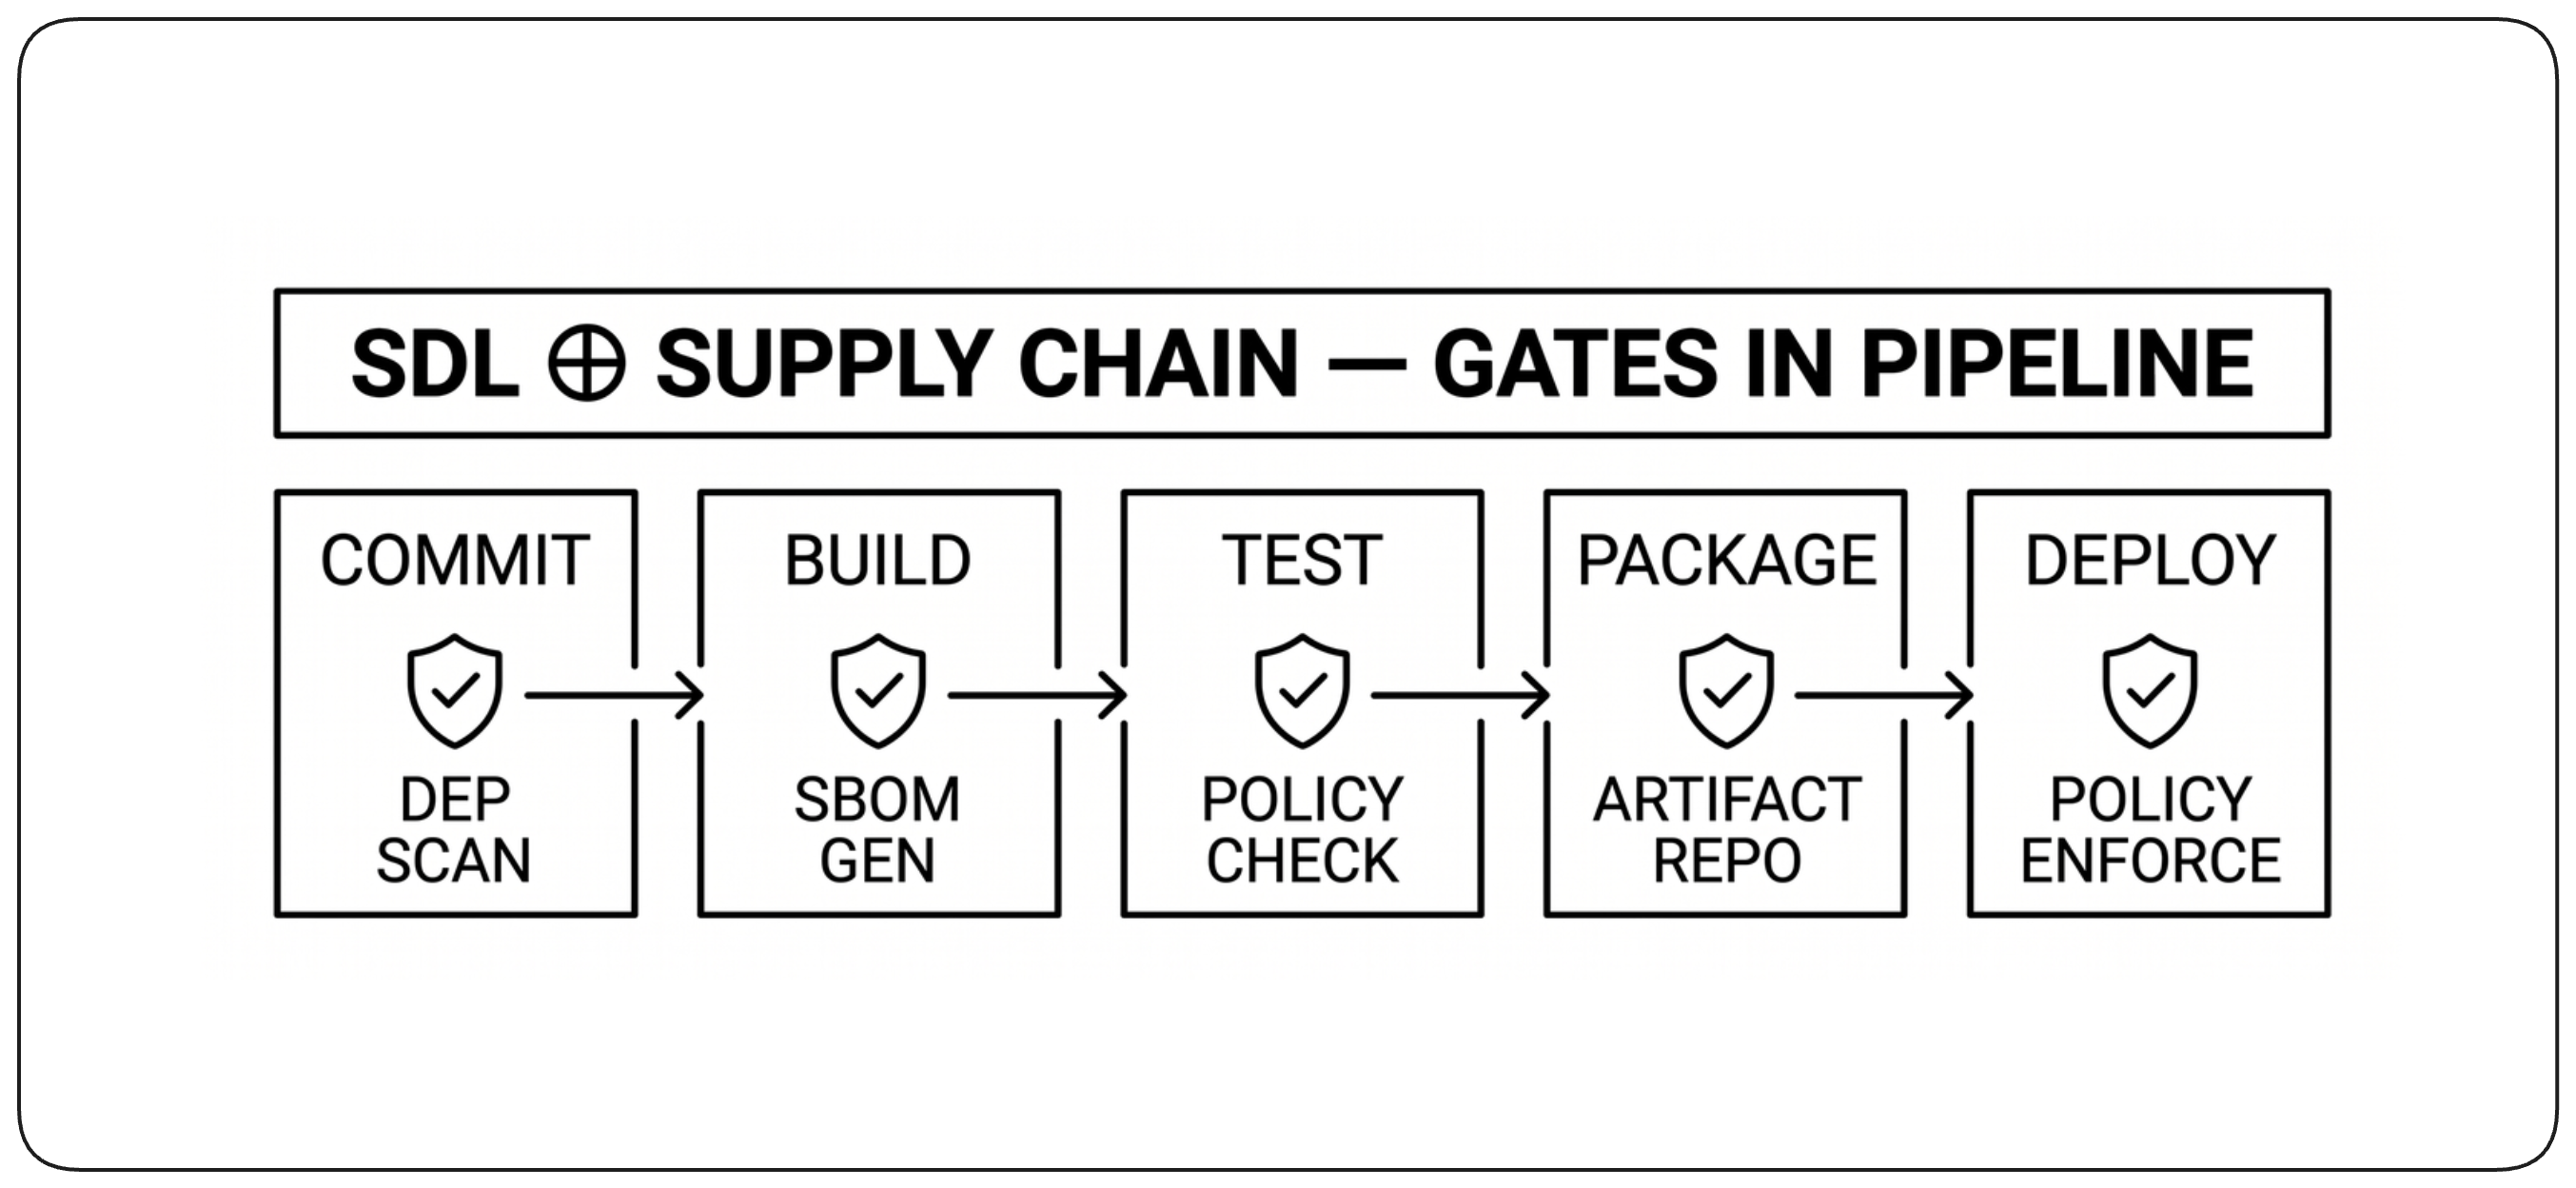
Le logiciel moderne repose sur des milliers de dépendances externes — bibliothèques, frameworks, images de conteneurs, outils de build — chacune étant un vecteur d’attaque potentiel. !!La visibilité seule ne suffit pas!! : le SBOM dit ce qui est là, mais seul un contrôle actif décide de ce qui a le droit d’entrer. La sécurité de la supply chain est ce qui transforme cet inventaire en application de règles, en bloquant les composants compromis ou non approuvés avant qu’ils n’atteignent la production.
Pipeline CI : la principale porte de contrôle
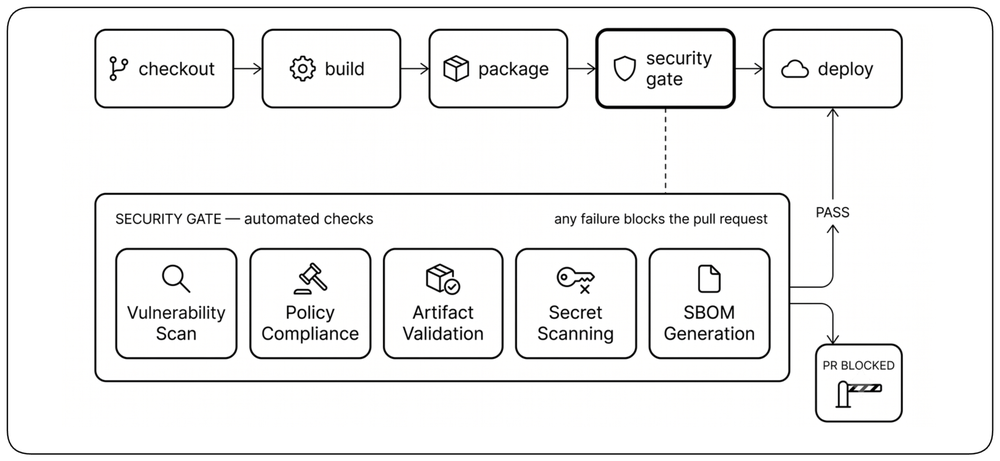
La sécurité de la supply chain commence dans le pipeline CI. !!Chaque changement qui entre en production passe par des portes de validation automatisées!! — génération du SBOM, scan de vulnérabilités, conformité aux politiques, validation des artefacts — et tout échec bloque la pull request avant qu’elle n’atteigne la production. Traiter la sécurité comme une porte de qualité au build, au même titre que les tests, est ce qui la rend peu coûteuse : les problèmes sont détectés quand ils ne sont encore qu’une ligne de code, pas un incident.
Faire confiance au build, pas au développeur
!!Les développeurs produisent du code source ; le pipeline produit du logiciel!!. Ce qui tourne en production n’est jamais ce qu’un développeur a construit sur son laptop — c’est ce que le pipeline a reconstruit à partir de ce code source, puis signé, scanné et validé. Ce changement est ce qui donne du sens à la provenance, aux attestations et aux builds reproductibles : l’artefact porte la preuve de son origine et de sa fabrication, indépendamment de la machine d’un individu. À mesure que le code généré par IA et les contributions tierces deviennent la norme, la frontière de confiance se déplace de l’humain qui écrit le code vers le système automatisé qui le transforme.
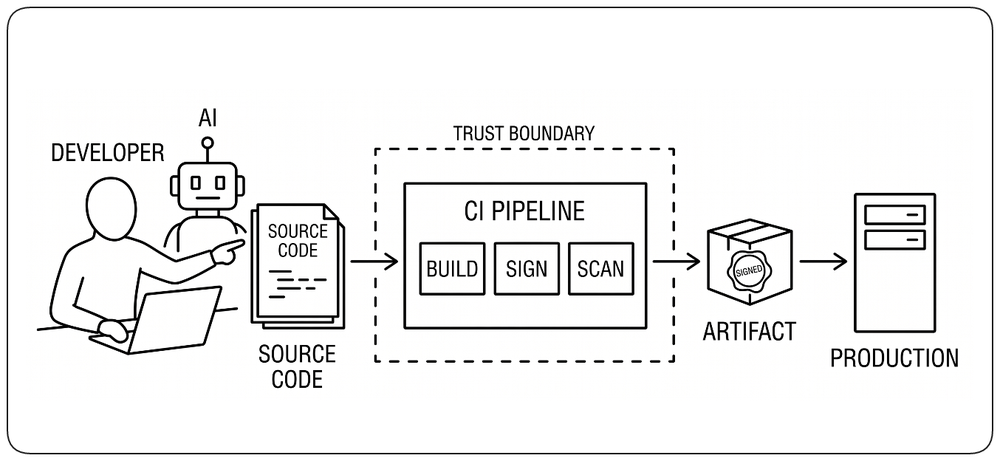
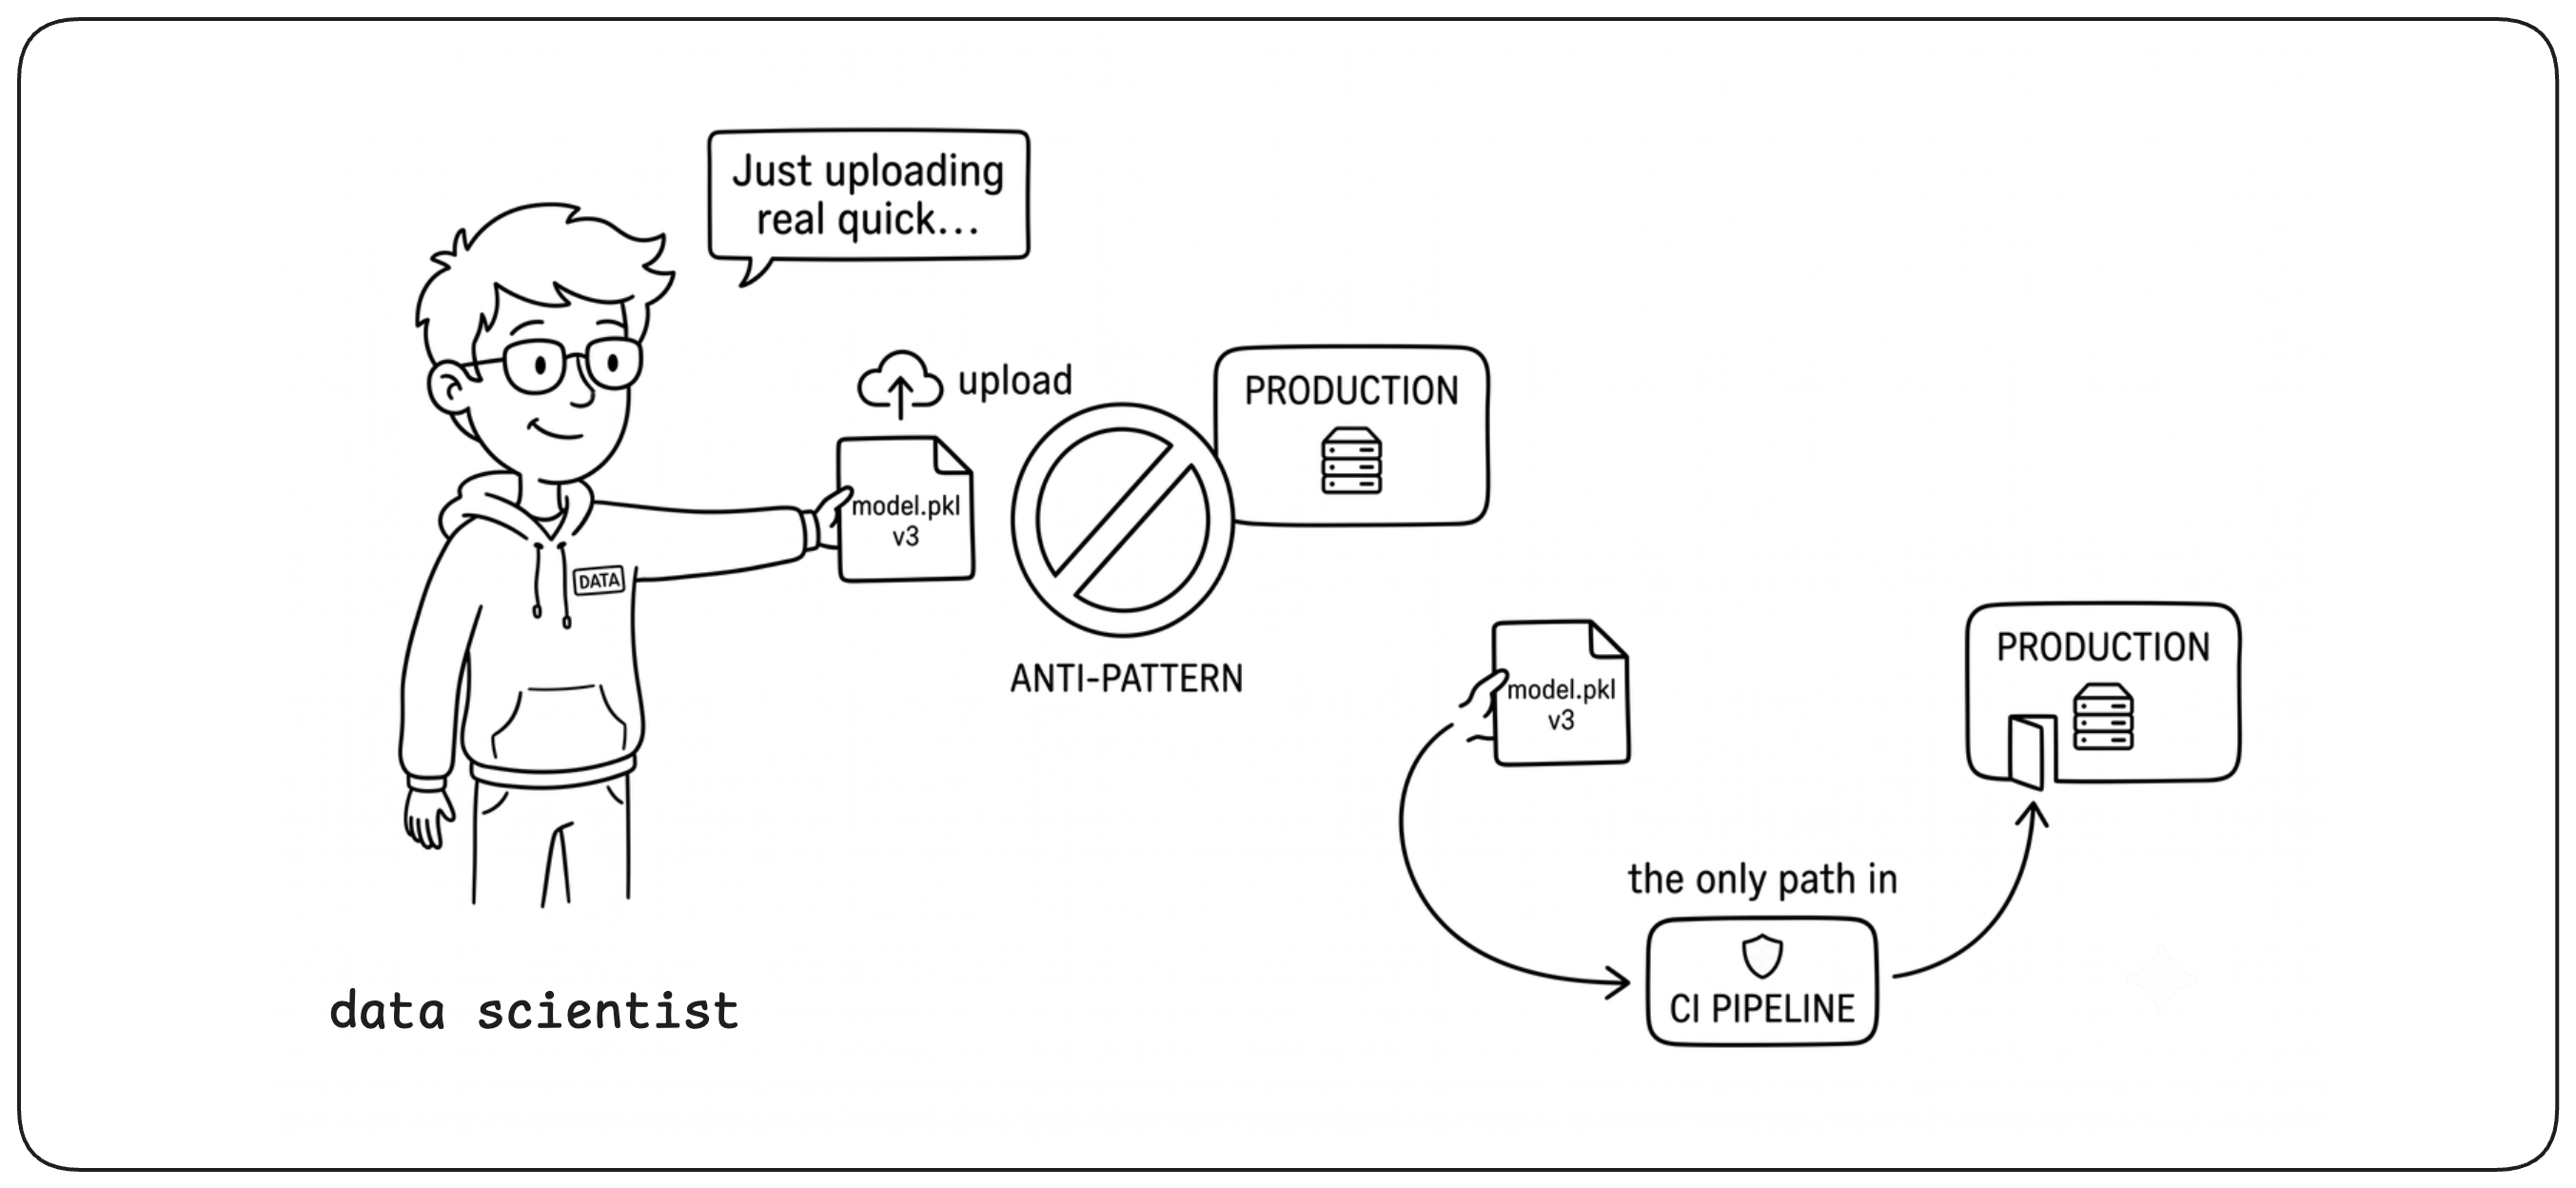
Pas de portes dérobées : le pipeline est le seul chemin vers la production
Une porte de contrôle n’est aussi solide que sa capacité à être la seule porte. !!Chaque artefact qui atteint la production doit être épinglé à une version exacte et passer par le pipeline CI!! — code, configuration, images de conteneurs, modèles de machine learning, jeux de données, feature flags, tout. Rien de flottant, rien de « latest », rien de transporté à la main. Un seul contournement invalide toutes les portes : un upload manuel dans un bucket, un manifeste édité à la main, un « correctif rapide » poussé directement dans un registry, et toute la chaîne de scans, de SBOM, de politiques et de détection de secrets devient optionnelle. La production ne fait confiance qu’à l’identité du pipeline.
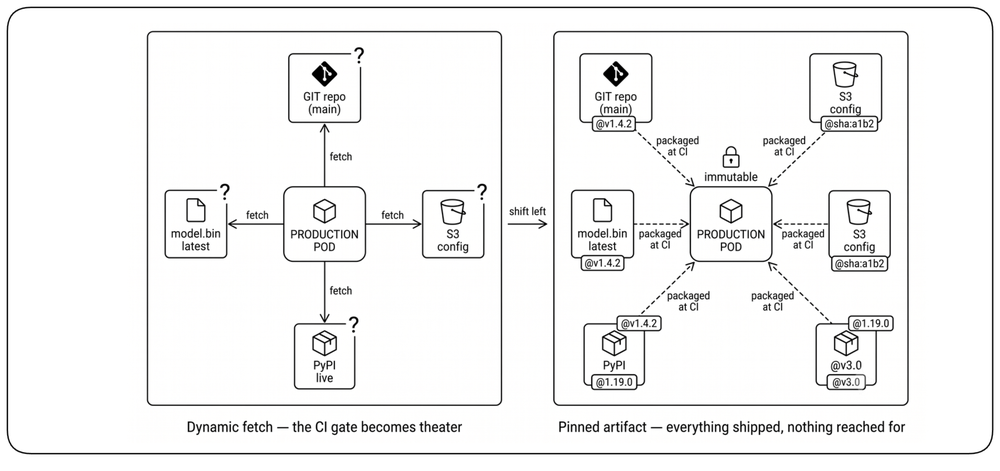
Pas de téléchargement dynamique à l’exécution
Les applications elles-mêmes ne doivent pas non plus contourner la porte. !!La production ne doit rien récupérer dynamiquement à l’exécution, car tout code chargé après le scan CI est du code que personne n’a validé!! — pas de pip install au démarrage du conteneur, pas de téléchargement de modèle depuis un registry externe. Si c’est permis, ce sont autant de portes dérobées : du contenu non scanné qui coule vers la production, déguisé en détail d’exécution. Tout ce dont le workload a besoin est intégré à l’artefact déployé au moment du CI, de sorte que l’artefact scanné à la porte est exactement celui qui tourne — sinon la porte CI devient du théâtre, et la production se réécrit discrètement à partir d’une source que personne n’a scannée.
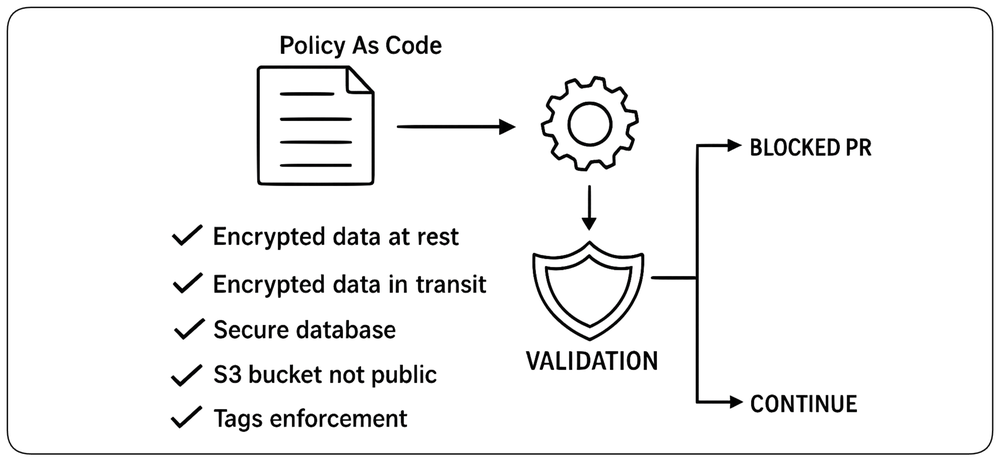
Policy-as-Code : application automatisée de la gouvernance
Si le pipeline est la seule porte, la question devient : que vérifie-t-il ? !!Le policy-as-code transforme la gouvernance de documentation en règles exécutables!!. Chiffrement obligatoire, stockage jamais public, ressources taguées pour la propriété, résidence des données respectée — chaque règle vit dans le pipeline CI sous forme de code, et toute violation bloque automatiquement le déploiement. La conformité devient native plutôt que greffée après coup.
Contrôler vos dépendances externes
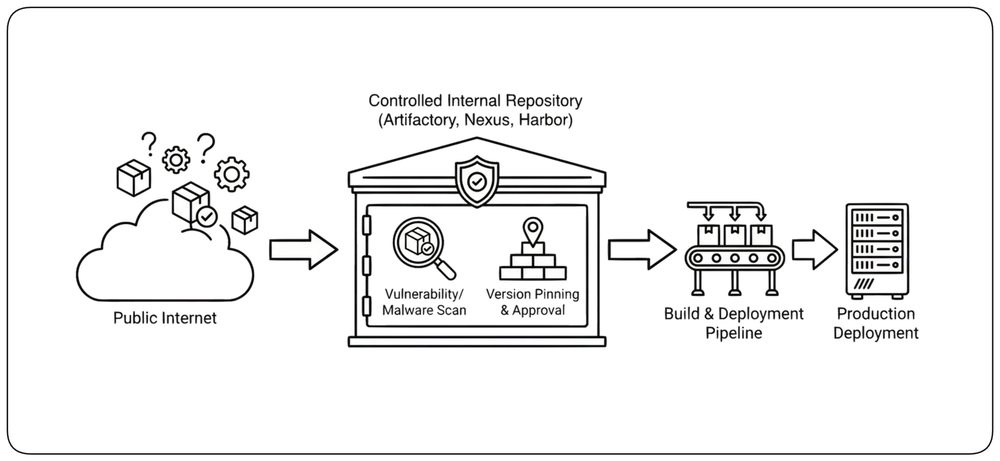
Les paquets, bibliothèques et images de conteneurs externes ne doivent jamais entrer dans le pipeline de build directement depuis l’Internet public. !!Les dépôts publics sont des sources de logiciels, pas des sources de confiance!!. Ils transitent par un dépôt interne contrôlé (Artifactory, Nexus, Harbor) qui scanne chaque artefact à la recherche de vulnérabilités et de malwares, épingle les versions sur des releases approuvées et offre un point de contrôle unique pour bloquer ou patcher une CVE sur tous les projets dès sa divulgation.
Approbation des composants tiers
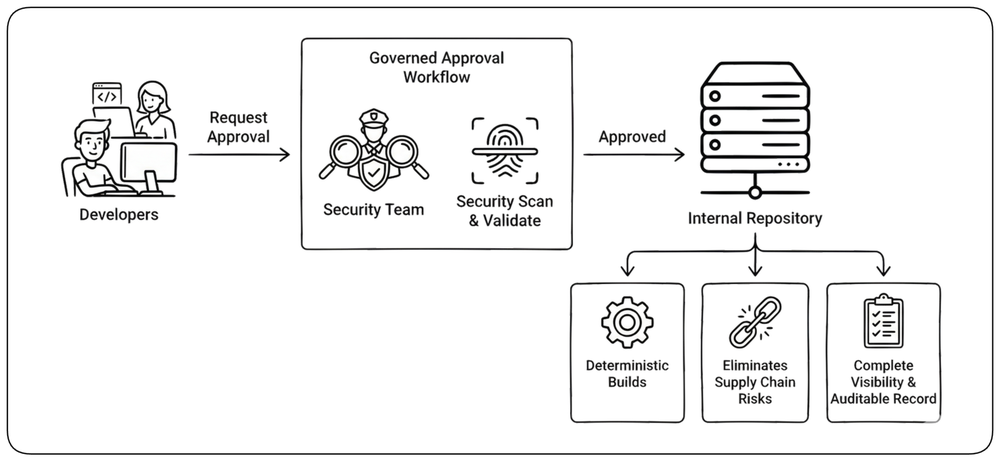
!!Les composants approuvés entrent dans un dépôt interne de confiance!! — c’est de là seulement qu’ils peuvent atteindre le build. Toute demande de nouvelle bibliothèque externe déclenche une revue coordonnée juridique, sécurité et conformité ; une fois approuvé, le composant est mis en miroir et devient disponible pour toutes les équipes. Tout le reste reste dehors.
Surveillance et patching automatisés des dépendances
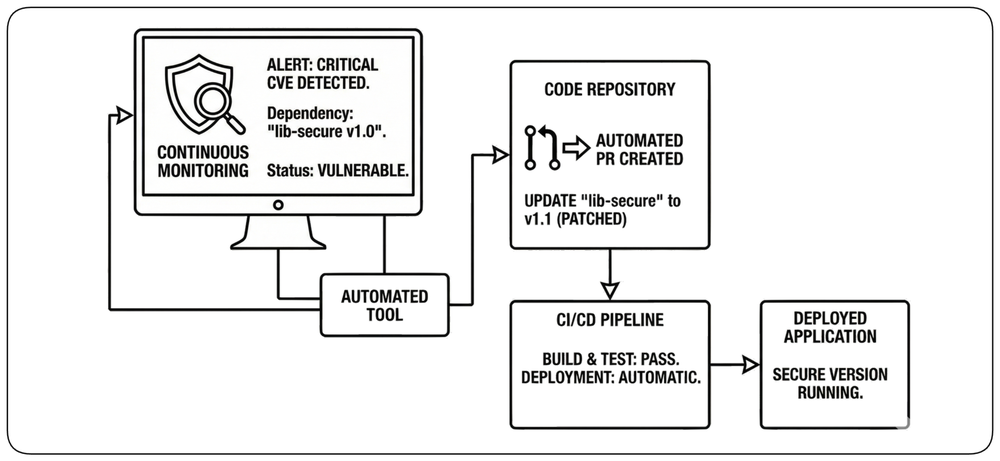
Une bibliothèque sûre aujourd’hui peut avoir une CVE critique demain. !!Approuvé ne veut pas dire approuvé pour toujours!! — des outils automatisés surveillent en continu les dépendances déployées, les recoupent avec le dépôt de SBOM et ouvrent des pull requests avec les versions corrigées dès qu’elles sont disponibles. Ce qui exigeait un audit manuel du code devient une requête, faisant de la gestion des dépendances une hygiène automatisée plutôt que de la lutte réactive contre les incendies.
Gestion des vulnérabilités
Les vulnérabilités sont inévitables ; les laisser sans réponse est optionnel. Là où l’inventaire voit ce qui existe et où la supply chain filtre ce qui entre, la gestion des vulnérabilités réduit la fenêtre entre la découverte d’une faiblesse et son élimination.
On ne corrige pas ce qu’on ne voit pas
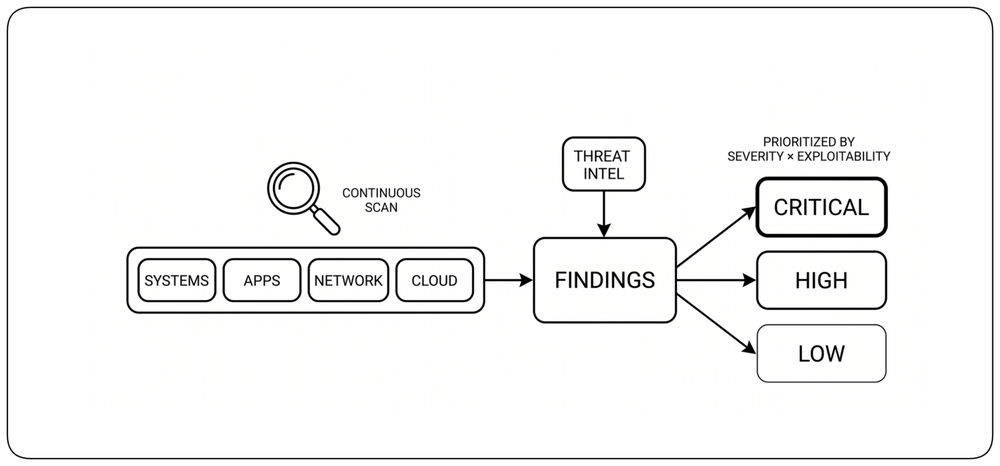
La gestion des vulnérabilités commence par une visibilité continue sur chaque actif — systèmes, applications, dépendances, configurations. !!Les scanners sont une implémentation ; le principe est que la recherche de faiblesses ne s’arrête jamais!!. Les actifs changent, les dépendances publient de nouvelles versions, et le renseignement sur les menaces révèle des exploits dans des composants qui étaient sûrs la semaine dernière. Un angle mort dans l’inventaire est une vulnérabilité à lui seul : la faille que vous n’avez pas vue est celle qui sera exploitée.
Prioriser le risque, pas le CVSS
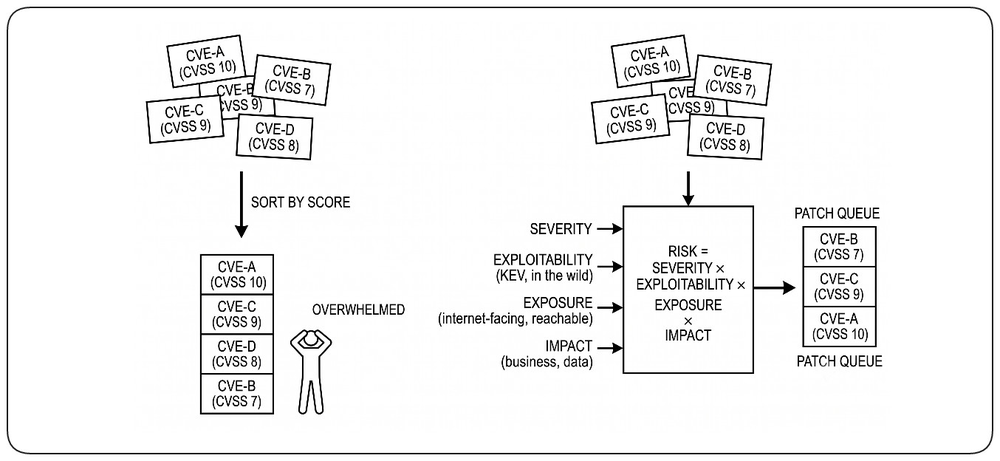
!!La sévérité est un signal ; le risque est une décision!!. Un CVSS 10 dans un composant que votre service n’appelle jamais est souvent moins urgent qu’un CVSS 7 déjà exploité contre un endpoint exposé sur Internet. Le risque réel multiplie la sévérité par l’exploitabilité, l’exposition et l’impact métier — patcher selon le seul score noie les équipes dans le bruit tout en laissant ouvertes les failles réellement exploitables. Ordonnez la file par probabilité d’exploitation × blast radius, pas par CVSS.
La rapidité compte plus que la perfection
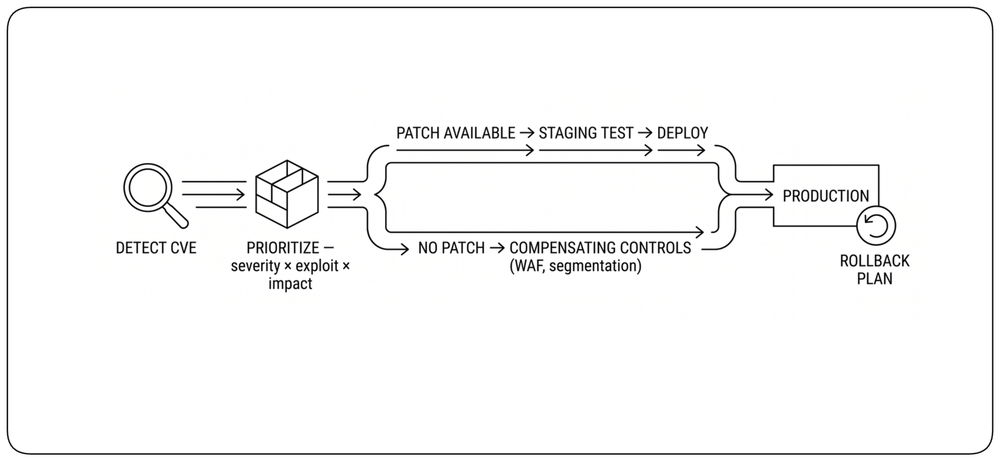
Le danger n’est pas d’avoir une vulnérabilité ; c’est de la laisser exploitable pendant des semaines. !!Le Mean Time To Remediation est la métrique qui compte!!. Une mitigation partielle déployée en quelques heures — une règle WAF, une restriction d’accès, un segment réseau — vaut mieux qu’un patch parfait livré dans un mois. Les pipelines de patch automatisés, les plans de rollback et les contrôles compensatoires existent pour comprimer la fenêtre entre la divulgation et la neutralisation. Corrigez vite, puis corrigez bien.
Supposer que de nouvelles vulnérabilités seront découvertes demain
!!Chaque dépendance à laquelle vous faites confiance aujourd’hui peut devenir critique demain : le composant sûr d’hier est le zero-day de demain, donc la vraie question n’est pas si, mais à quelle vitesse vous pouvez le trouver et l’éliminer!!. Log4Shell, XZ Utils, Heartbleed — aucun n’était « risqué » la veille de la publication de sa CVE. C’est pourquoi le SBOM, le monitoring continu et la remédiation rapide ne sont pas une infrastructure optionnelle : quand une nouvelle CVE tombe à 2 h du matin, la question n’est pas « sommes-nous concernés ? » mais « à quelle vitesse pouvons-nous prouver où cela tourne et l’éliminer ? ».
Ne jamais se fier à ses hypothèses — valider ses défenses
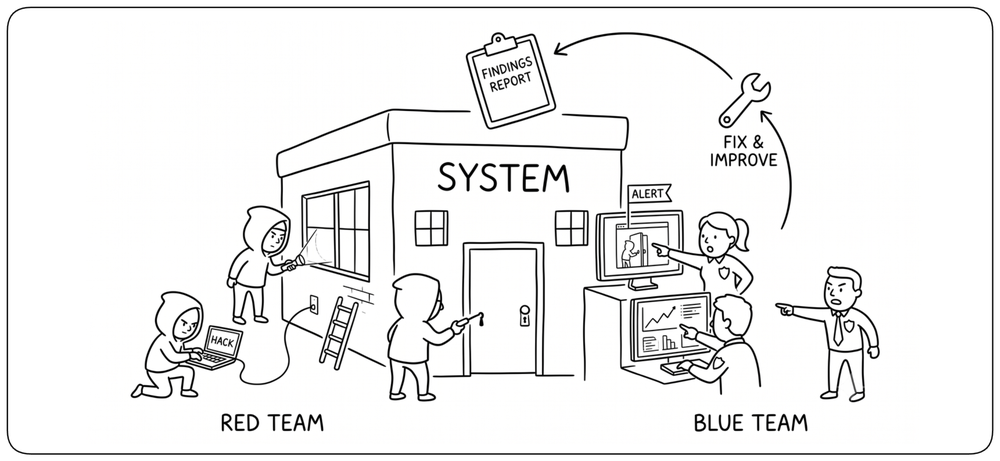
Les pentests ne servent pas à trouver « un bug de plus ». !!Ils vérifient que les contrôles que vous avez conçus fonctionnent réellement — ensemble, sous attaque, dans le système réel!!. Une règle de firewall, une politique IAM, une signature WAF et une alerte de monitoring peuvent chacune être correctes isolément et laisser pourtant un chemin une fois combinées. Les exercices de red team valident le système, pas les composants — le test de réalité de chaque hypothèse intégrée à l’architecture.
Sécurité réseau et périmètre
Tout attaquant qui atterrit dans le réseau veut se déplacer latéralement. Cette section traite de deux défenses complémentaires : !!segmenter l’intérieur pour qu’une brèche ne puisse pas se propager!!, et !!contrôler la frontière pour que seul le trafic autorisé entre ou sorte!!.
Segmentation réseau
La segmentation réseau est l’un des moyens les plus efficaces de limiter la propagation d’une attaque une fois un point d’entrée compromis. !!Diviser un réseau en zones isolées interdit aux attaquants de circuler librement dans l’environnement!! — VPC, sous-réseaux et security groups appliquent chacun leurs propres règles d’accès. Une brèche dans la zone applicative s’arrête là ; la zone de base de données, dans son propre segment, reste intacte. Combinée à de solides contrôles d’ingress et d’egress, la segmentation réduit considérablement le blast radius de toute compromission isolée.
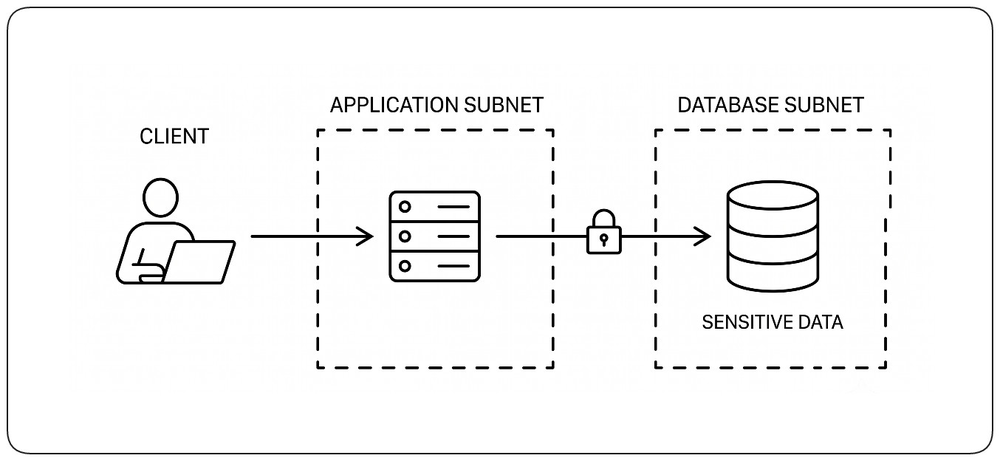
Isolation physique vs isolation logique
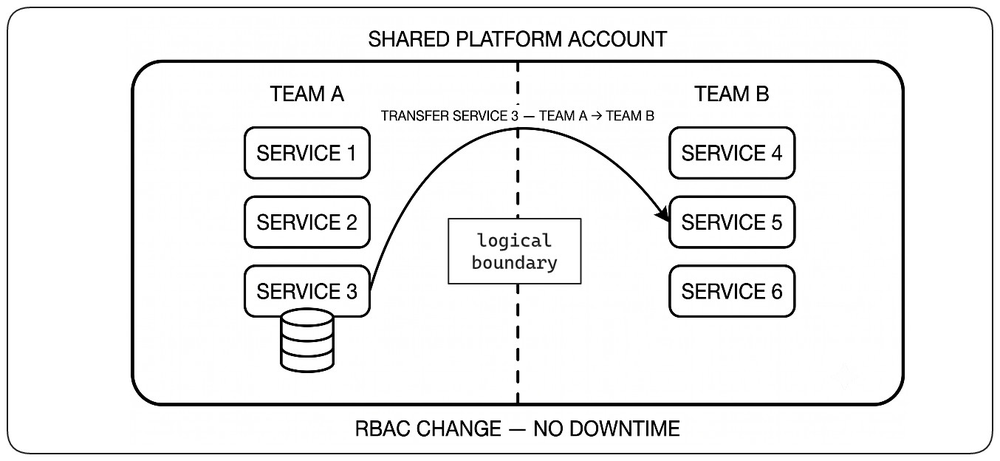
Toute architecture finit par affronter la même décision de conception : cette frontière doit-elle être imposée par l’infrastructure ou par la configuration ? !!L’isolation forte place la frontière dans l’infrastructure elle-même!! — comptes, tenants, réseaux ou clusters séparés — de sorte qu’elle reste efficace même si une configuration est erronée. !!L’isolation logique place la frontière dans le logiciel!! — RBAC, politiques IAM, tags, namespaces — ce qui la rend plus flexible, mais aussi solide que les règles qui l’appliquent. L’isolation forte favorise le confinement. L’isolation logique favorise la flexibilité. Une bonne architecture, c’est savoir où chacune a sa place.
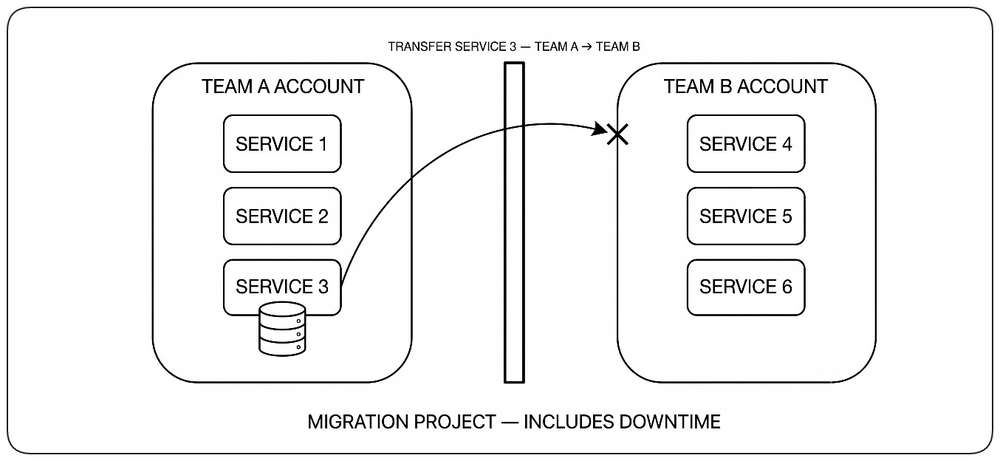
Isolation logique par défaut
!!L’isolation logique doit être le choix par défaut!! car elle préserve la flexibilité, réduit le coût opérationnel et facilite l’évolution des systèmes. Sa faiblesse est qu’elle dépend de la configuration : elle doit donc être renforcée par des tests automatisés, des vérifications de politiques et une validation continue. L’isolation forte ne doit être introduite que lorsque le risque d’une erreur de configuration justifie la complexité et le coût supplémentaires — séparation des tenants, données réglementées, workloads critiques pour le blast radius. Commencez souple, durcissez là où le risque le justifie.
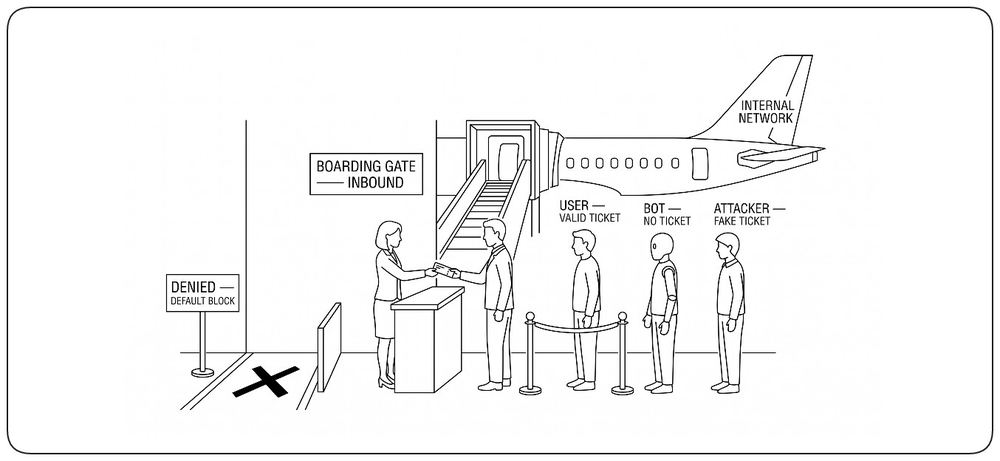
Contrôler le trafic entrant
!!Le trafic entrant doit être refusé par défaut et autorisé uniquement par des points d’entrée explicites et contrôlés!!. Chaque service exposé ne doit accepter que les protocoles, sources et identités dont il a besoin. Firewalls, load balancers, API gateways, WAF, authentification, rate limits et protection DDoS travaillent ensemble pour réduire la surface d’attaque et bloquer le trafic malveillant avant qu’il n’atteigne l’application. Chaque chemin autorisé doit être intentionnel, observable et revu en continu.
Contrôler le trafic sortant
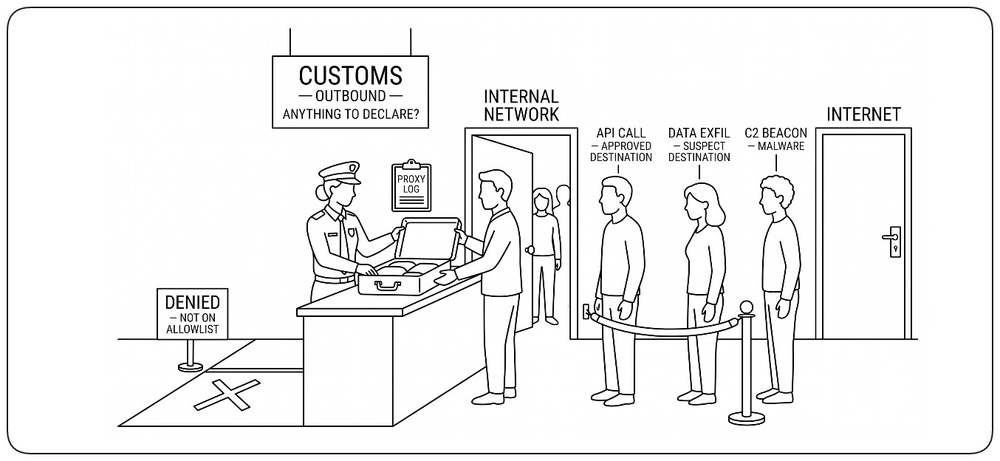
Rien ne doit sortir du système par défaut. Les connexions sortantes doivent être explicitement autorisées uniquement vers des destinations approuvées, via des chemins contrôlés. Firewalls d’egress, proxies, allowlists et monitoring empêchent les workloads compromis d’exfiltrer des données, de contacter des serveurs de command-and-control ou de télécharger du contenu malveillant. Chaque connexion permise doit être nécessaire, observable et facile à révoquer.
Sécuriser l’accès distant avec un VPN
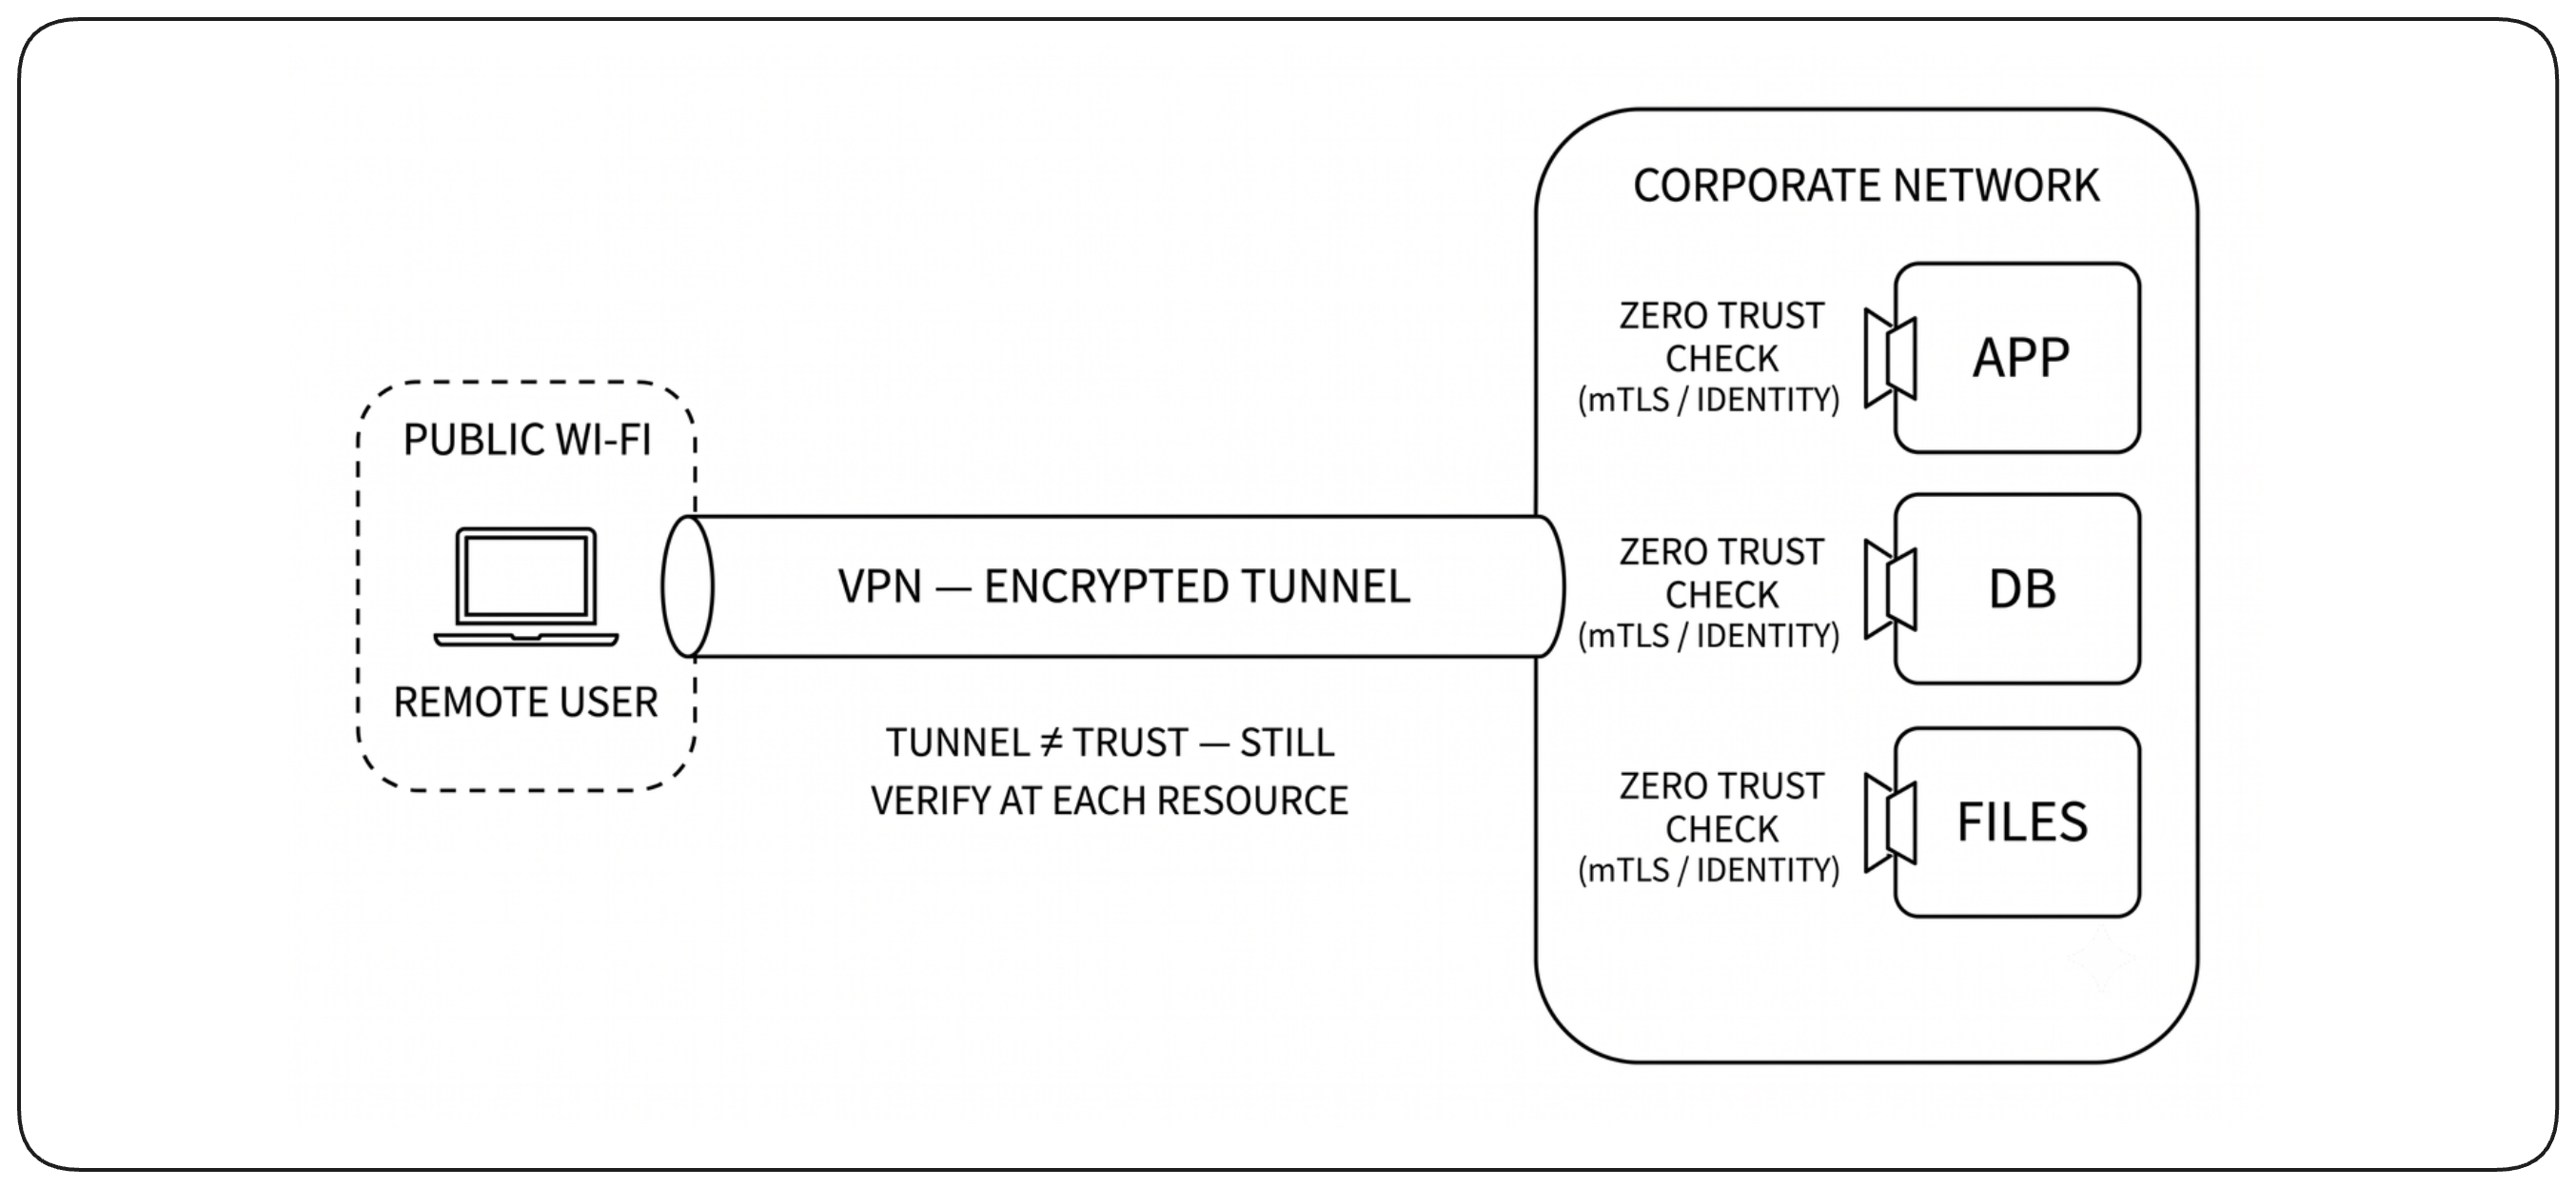
Un Virtual Private Network (VPN) crée un tunnel chiffré entre un utilisateur ou un site distant et un réseau interne. Il étend en pratique le périmètre de sécurité au-delà du réseau physique, permettant d’atteindre les ressources internes sans les exposer directement à l’Internet public. !!Mais étendre le périmètre n’établit pas la confiance!! : l’accès doit rester restreint par l’identité, le moindre privilège et l’autorisation au niveau de chaque ressource.
Isolation des environnements
Pourquoi le développement ne doit jamais atteindre la production
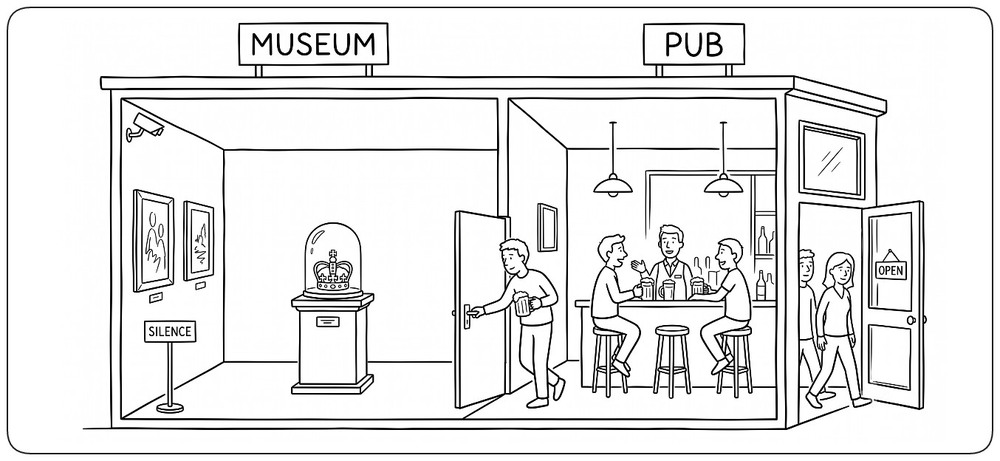
Le développement et la production appartiennent à des zones de confiance différentes. La production fonctionne sous des règles plus strictes de contrôle, de monitoring, de patching et de gestion du changement, alors que le développement contient du code expérimental, des permissions plus larges, des outils de debug et des accès humains fréquents. Un chemin direct Dev-vers-Prod crée à la fois une voie pour les attaquants et une voie pour les changements accidentels. !!Les environnements de moindre confiance ne doivent jamais pouvoir influencer directement la production.!!
Accès à la production limité dans le temps
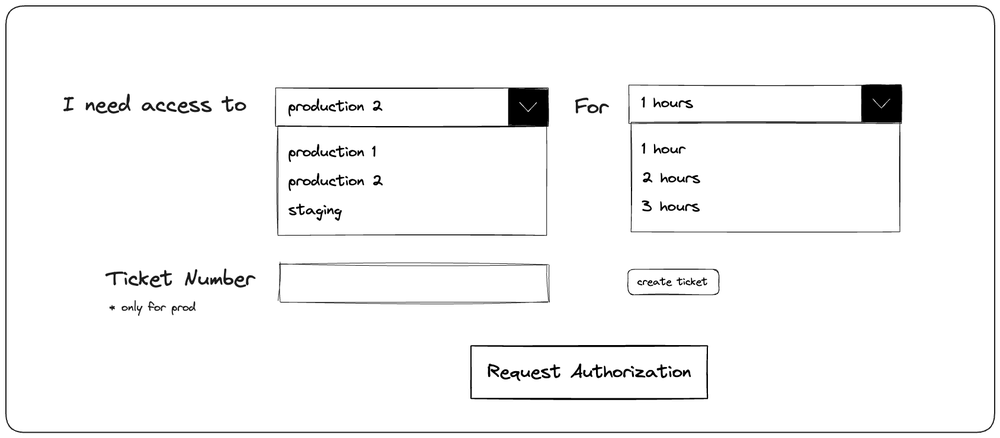
L’accès humain à la production ne doit jamais être permanent. !!Les ingénieurs demandent un accès pour une tâche précise, pour une durée précise, et l’accès disparaît à la fermeture de la fenêtre — pas de révocation manuelle, pas de permissions oubliées.!! Un système d’accès just-in-time accorde des droits élevés temporaires contre un ticket ou une approbation, limités à l’environnement et bornés dans le temps (minutes ou heures, pas jours). Cela garde le travail quotidien hors de la production, rend chaque entrée auditable et réduit le blast radius de tout compte compromis à la durée d’une fenêtre active.
Les déploiements en pull sont plus sûrs
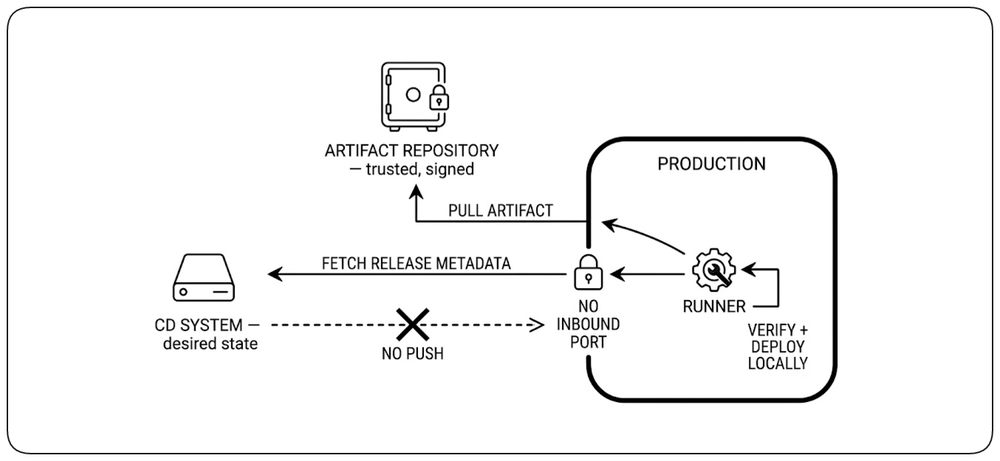
Le déploiement en push exige que la production expose un chemin de contrôle entrant vers un système de déploiement externe. Ce chemin fait partie de la surface d’attaque : il doit être authentifié, autorisé, surveillé et protégé. Le déploiement en pull évite cette exposition en gardant la production fermée au contrôle entrant. Un runner à l’intérieur de l’environnement récupère les métadonnées de la release souhaitée auprès du système CD, tire l’artefact approuvé depuis le dépôt de confiance, le vérifie et le déploie localement. Le système CD définit l’état désiré, mais c’est l’environnement qui initie chaque connexion et applique le changement. Le déploiement en pull devrait être le choix par défaut quand c’est possible.
Le pattern Secure Gateway
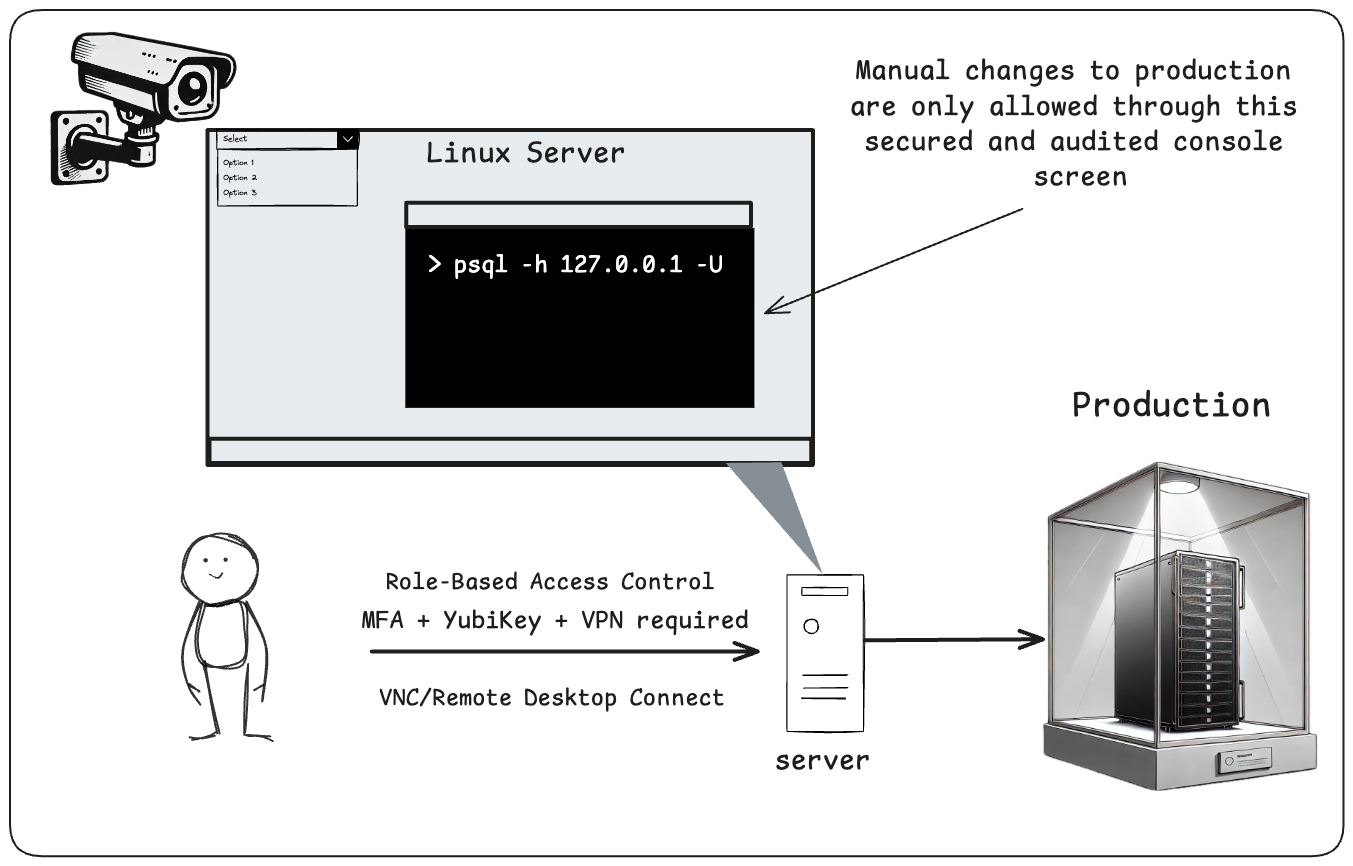
Dans un Secure Gateway, les utilisateurs se connectent à distance à un serveur via une interface VNC ou de bureau à distance pour accéder à une console sécurisée où tous les changements de production sont exécutés. Cette configuration garantit un accès contrôlé, permettant d’effectuer efficacement les tâches critiques tout en minimisant les risques.
Le système applique des bonnes pratiques comme le contrôle d’accès basé sur les rôles (RBAC) et le principe du moindre privilège, garantissant que les utilisateurs n’ont que les permissions nécessaires à leurs tâches. L’authentification est renforcée par la MFA, les YubiKey et l’accès VPN, pour que seul le personnel autorisé accède au système.
Les permissions temporaires sont accordées à la demande, et toutes les actions effectuées dans la console sont intégralement journalisées pour assurer traçabilité et responsabilité. Les opérations sensibles, comme les copier-coller, sont activement surveillées pour réduire le risque de fuite de données ou d’erreur accidentelle. Cette approche garantit la sécurité opérationnelle, en équilibrant flexibilité et garde-fous robustes pour protéger les environnements de production contre les abus et les erreurs humaines.
Le pattern Safe Proxies
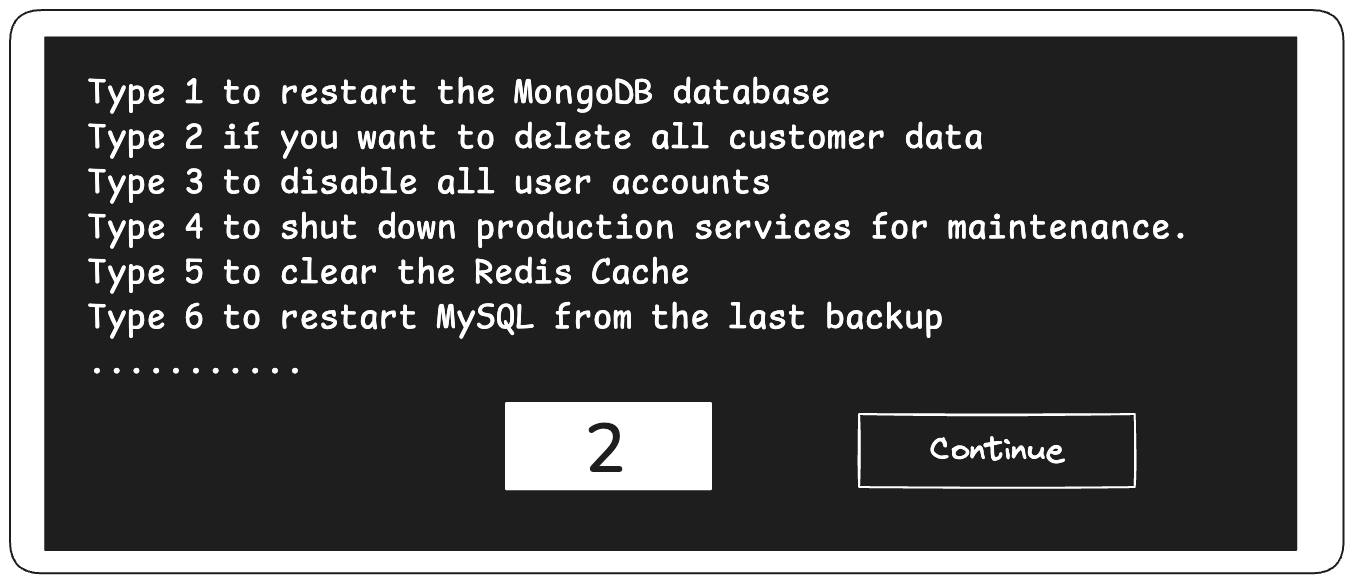
Une autre alternative consiste à utiliser des safe proxies comme couche de contrôle entre les utilisateurs et les systèmes de production pour limiter l’accès direct. Au lieu d’accorder des permissions illimitées, les proxies n’autorisent que des opérations spécifiques et pré-approuvées, garantissant que chaque action — routinière ou d’urgence — est journalisée et surveillée. Cette approche minimise le risque d’erreurs, d’activités malveillantes ou d’accès non autorisés.
En appliquant des politiques et des permissions strictes via des safe proxies, les organisations peuvent sécuriser plus efficacement leurs environnements de production. Cette configuration apporte une couche supplémentaire de contrôle et de fiabilité sans exiger de changements importants aux systèmes existants, assurant à la fois efficacité opérationnelle et sécurité.
External Material
Mécanisme de Breakglass
L’accès normal à la production est fortement contraint — moindre privilège, workflows d’approbation, safe proxies, pas de console directe. Mais lors d’une panne critique ou d’un incident urgent, un ingénieur peut avoir besoin de privilèges élevés que le chemin standard ne peut pas accorder à temps. Un mécanisme de breakglass fournit ce chemin — une voie exceptionnelle vers la production réservée aux urgences. !!L’accès d’urgence doit rester possible, mais il doit être exceptionnel, temporaire, visible et entièrement traçable.!!
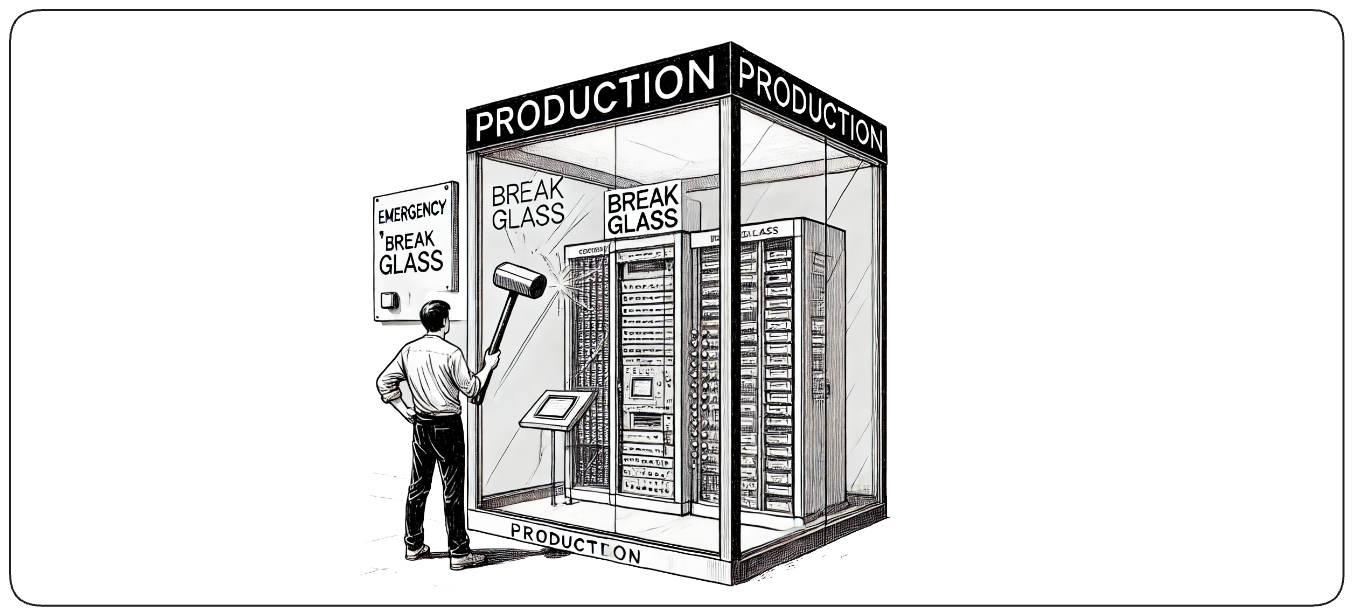
L’accès breakglass accorde des privilèges temporairement élevés, exige une justification ou une approbation explicite au moment de l’usage, expire automatiquement après une courte fenêtre et produit une journalisation exhaustive ainsi que des alertes en temps réel, de sorte que chaque action d’urgence soit revue a posteriori. La revue post-incident de chaque usage du breakglass est obligatoire, et le mécanisme lui-même doit être testé régulièrement pour s’assurer qu’il fonctionne quand on en a réellement besoin. Surtout, les comptes breakglass ne doivent jamais devenir un chemin d’administration normal — dès que les ingénieurs y recourent de façon routinière, le mécanisme a échoué en tant que contrôle.
Pratiques de développement sécurisé
La plupart des vulnérabilités sont introduites pendant le développement, bien avant qu’un attaquant ne sonde le système. Une vérification d’entrée manquante, une exception avalée, un credential codé en dur « pour l’instant » — chacun est une décision prise en quelques secondes qui survivra au développeur qui l’a écrite. Les principes qui suivent ne sont ni des outils ni des checklists, mais les habitudes d’architecture qui font du code sécurisé le choix par défaut : concevoir en pensant à l’attaquant, se méfier de toute entrée, échouer vers le refus, garder les secrets hors du code, standardiser ce que le jugement individuel rate, et faire relire par quelqu’un d’autre.
Secure by Design
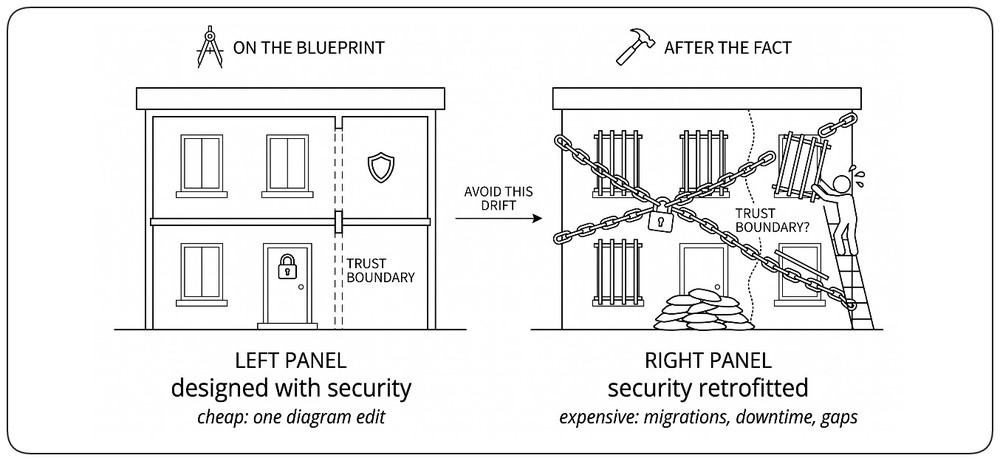
!!La sécurité est une décision de conception, pas un détail d’implémentation!!. Greffer la sécurité sur un système dessiné sans elle est coûteux et rarement complet — les frontières de confiance dérivent, les privilèges s’accumulent et la surface d’attaque dépasse le modèle mental de chacun. Threat modeling, moindre privilège, surface d’attaque minimisée et frontières de confiance explicites ont leur place sur le tableau blanc, pas dans la revue de PR. Une faille d’architecture repérée en conception coûte une modification de diagramme ; repérée en production, elle coûte une migration.
Ne jamais faire confiance aux entrées
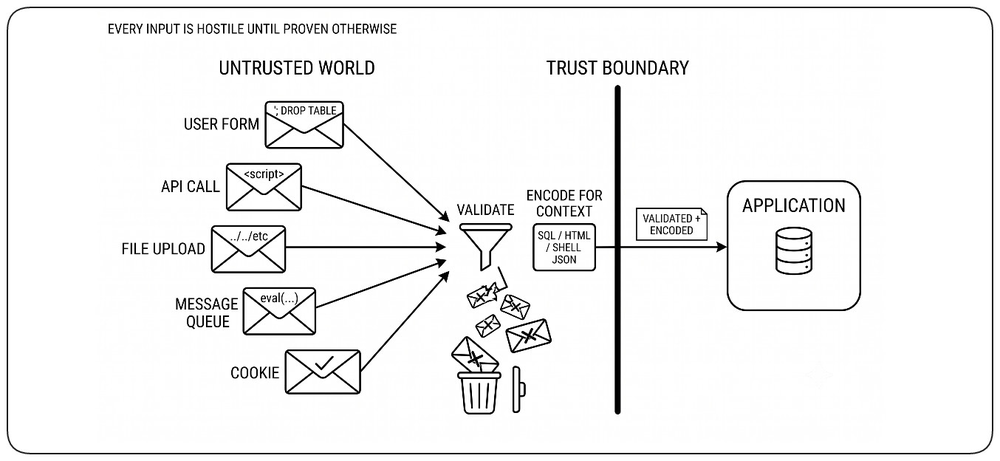
!!Chaque octet qui franchit une frontière de confiance est hostile jusqu’à preuve du contraire!!. Le principe ne concerne pas les formulaires utilisateur — il concerne les frontières : une réponse d’API d’une autre équipe, un message tiré de Kafka, une ligne lue dans une base de données externe, un fichier déposé par un partenaire, un appel interne d’un système voisin. Toute donnée dont vous ne contrôlez pas entièrement la provenance peut véhiculer de l’injection SQL, du XSS, des exploits de désérialisation, du path traversal ou de l’injection de commandes. La défense est structurelle, pas basée sur la vigilance : valider à la frontière selon un schéma strict, encoder pour le contexte exact d’utilisation de la donnée (SQL, HTML, shell, JSON), et utiliser des API paramétrées qui rendent l’injection syntaxiquement impossible. La frontière est l’endroit où la vérification a lieu, pas l’origine de la requête.
Échouer de manière sûre
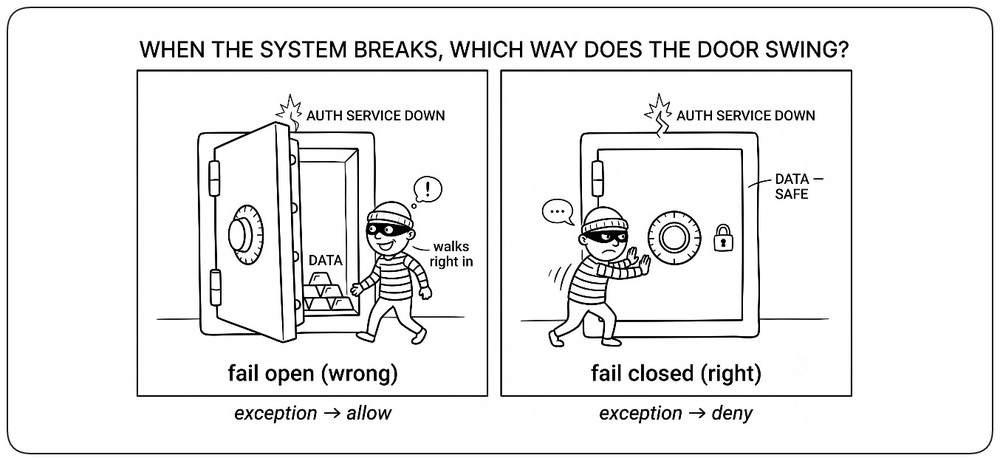
Quand le code atteint un état inattendu, !!la valeur par défaut doit être de refuser, pas d’autoriser!!. Une exception non interceptée dans un contrôle d’autorisation doit refuser l’opération, pas la sauter. Un timeout sur un moteur de politiques doit bloquer la requête, pas l’admettre. Un feature flag manquant doit garder la porte fermée, pas ouverte. Les attaquants sondent activement ces limites — entrées malformées, race conditions, partitions réseau — précisément parce que tant de systèmes échouent en mode ouvert par accident. La règle est structurelle : chaque chemin de code qui peut lever une exception, expirer ou retourner null doit être examiné pour son mode d’échec, et la réponse doit toujours être « refuser ».
Les secrets ne sont pas de la configuration
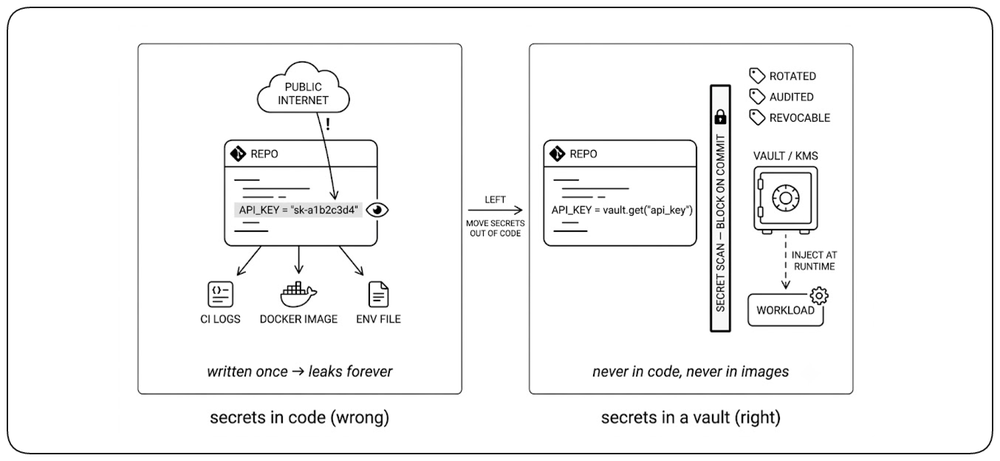
!!Un mot de passe, une clé d’API, un credential de base de données ou une clé de signature n’est pas une valeur de config — c’est une capacité, et une fois écrite en clair sur disque, elle doit être considérée comme compromise!!. La commiter dans un repo, l’intégrer dans une image ou la déposer dans un fichier d’env revient à la publier : une fois écrite en clair sur disque, elle doit être considérée comme compromise. Les secrets appartiennent à un vault dédié (KMS, Secrets Manager, HashiCorp Vault), injectés dans le workload à l’exécution, renouvelés selon un calendrier et révoqués instantanément en cas de compromission. Et le pipeline doit rattraper ce que le développeur a oublié — le scan de secrets sur chaque commit transforme toute une classe d’erreurs catastrophiques en simple pull request bloquée.
Concevoir des chemins sûrs, pas des développeurs sûrs
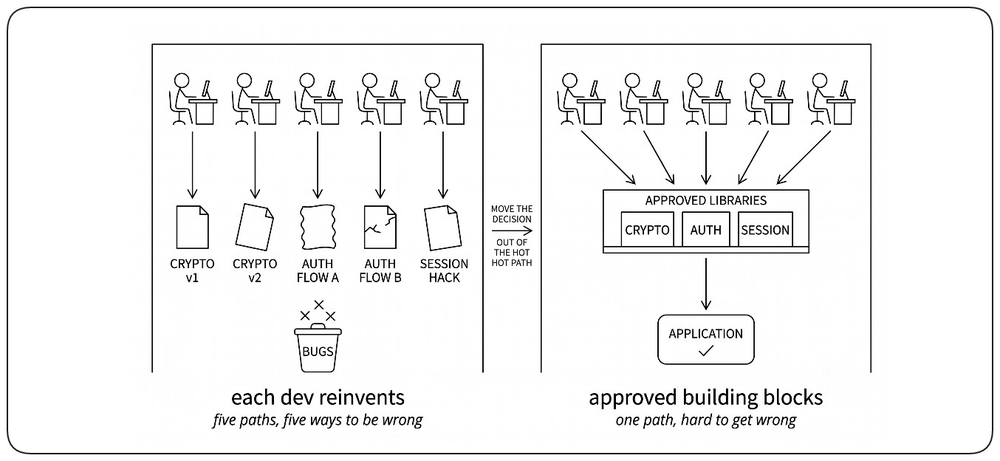
Chaque développeur laissé à réinventer la sécurité finira par se tromper sur une décision — et une suffit. La réponse n’est pas plus de formation, plus de checklists ou plus de discipline. !!Faites du chemin sûr le chemin facile, et du chemin dangereux un chemin plus difficile à écrire que le bon!!. Les bibliothèques cryptographiques approuvées remplacent la crypto faite maison, les frameworks d’authentification validés remplacent la logique de session sur mesure, les query builders sûrs rendent le SQL brut malcommode, les valeurs par défaut des frameworks gèrent automatiquement l’échappement et le CSRF. C’est le système qui se souvient ; le développeur n’a qu’à saisir l’outil le plus proche pour atterrir en sécurité.
Revue indépendante
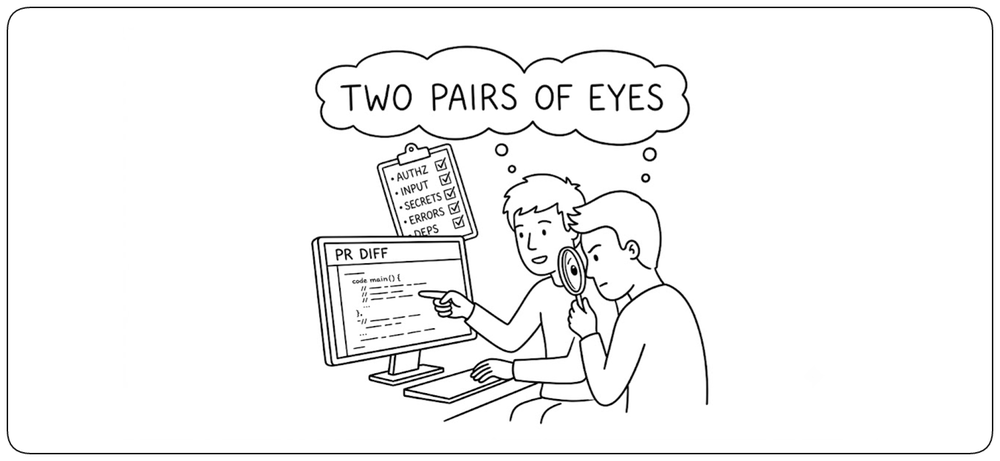
!!Un logiciel sûr est produit par des systèmes d’ingénierie sûrs, pas en attendant des développeurs qu’ils ne se trompent jamais!!. Même avec des standards, des bibliothèques sûres et une conception rigoureuse, l’auteur d’un changement est temporairement trop proche de celui-ci pour voir ce qui manque — un contrôle d’autorisation oublié, une exception mal gérée, une politique IAM trop large, une dépendance ajoutée sans vérification. La revue par les pairs, les branches protégées et les approbations obligatoires transforment cet espoir en propriété du système : le merge ne peut tout simplement pas avoir lieu sans une seconde signature. C’est l’expression finale de la philosophie de tout le chapitre — la sécurité est une propriété du système, pas de l’individu.
Réponse aux incidents de sécurité
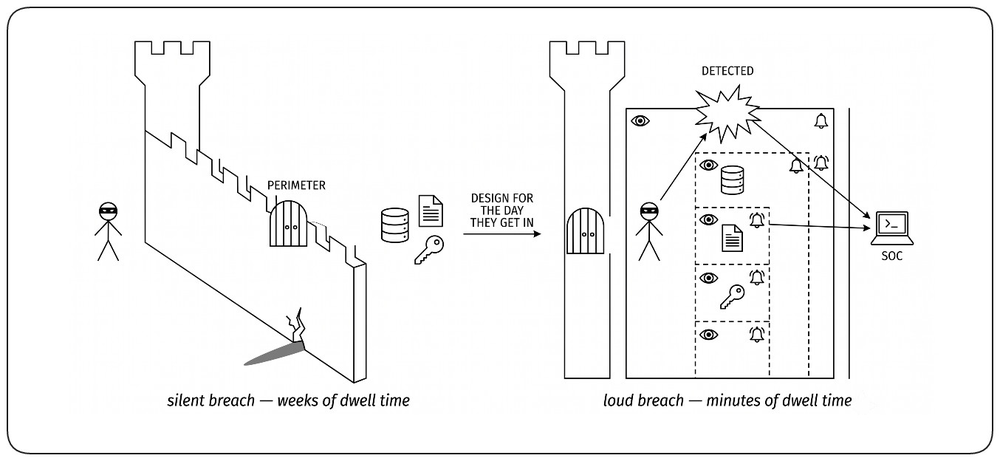
C’est ici que chaque principe antérieur du chapitre porte ses fruits. La défense en profondeur a ralenti l’attaquant, le blast radius a gardé les dégâts locaux, la segmentation a stoppé la propagation — et maintenant la détection révèle l’intrusion, la réponse la contient, et chaque incident devient une amélioration d’architecture. La réponse aux incidents opérationnels demande le service fonctionne-t-il, et comment le rétablir ? La réponse aux incidents de sécurité pose un tout autre ensemble de questions : sommes-nous compromis, jusqu’où l’attaquant est-il allé, quelles preuves faut-il préserver ? Les outils se recoupent — logs, alertes, dashboards — mais pas les objectifs. Les principes qui suivent supposent que la prévention a déjà échoué et se concentrent sur ce que le système doit être conçu pour faire le jour où un attaquant est à l’intérieur.
Supposer la compromission
!!La question n’est pas de savoir si un attaquant entrera, mais quand — et combien de temps vous mettrez à le remarquer!!. Une couche de défense finira par échouer : un credential volé, un token qui fuite, un zero-day, un fournisseur compromis. Une fois cette hypothèse acceptée, la conception passe de « les empêcher d’entrer » à « les détecter vite, limiter leur portée, les évincer proprement ». Les systèmes bâtis sur la seule prévention échouent en silence. Les systèmes bâtis sur la compromission supposée échouent bruyamment et se rétablissent.
Détecter l’attaquant, pas seulement le service
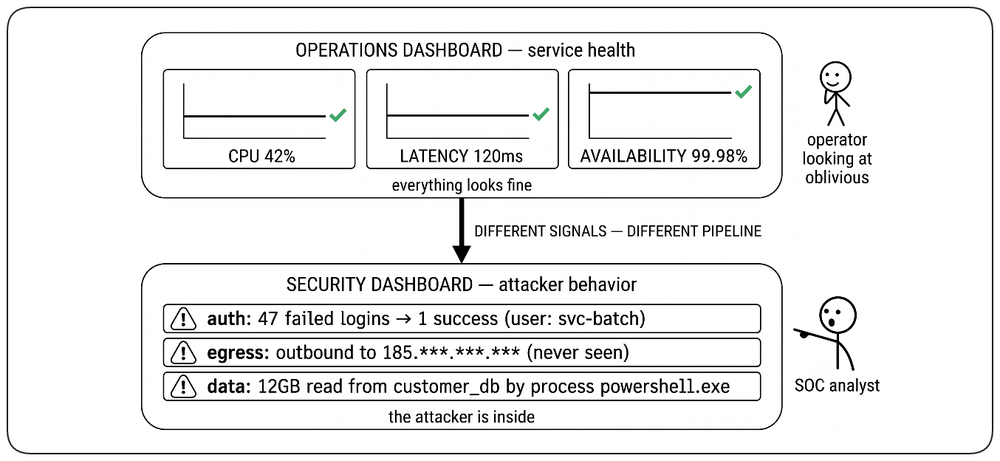
Le monitoring opérationnel surveille si le système fonctionne. La détection de sécurité surveille si le système est utilisé contre vous. !!Un graphe de CPU sain peut coexister avec un attaquant en train d’exfiltrer votre base de données clients!! La télémétrie de sécurité cherche un autre motif : des échecs de connexion suivis d’un succès, un compte de service qui s’authentifie depuis une région inhabituelle, un workload qui appelle une adresse qu’il n’a jamais contactée, un processus qui lit des fichiers qu’il n’a aucune raison de lire. Ces signaux apparaissent rarement sur les dashboards de disponibilité — le système doit être instrumenté séparément, avec des règles qui modélisent le comportement de l’attaquant, pas l’expérience utilisateur.
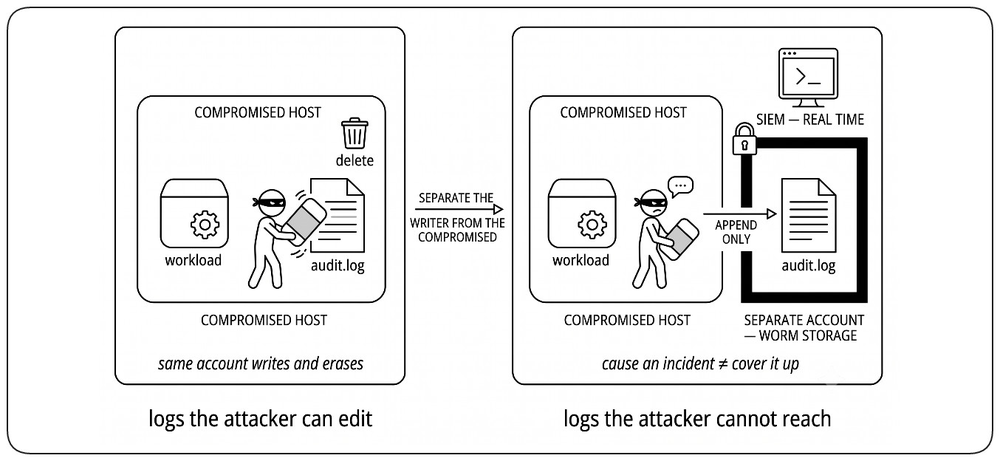
La piste d’audit doit survivre à l’attaquant
La première chose que fait un attaquant compétent après avoir obtenu l’accès est d’effacer ses traces. !!Des logs d’audit qu’un attaquant peut modifier sont des preuves que l’attaquant contrôle!!. Les pistes d’audit doivent être écrites sur un stockage que le système compromis ne peut pas réécrire : un bucket append-only dans un autre compte, une archive WORM, un SIEM qui ingère en quasi temps réel. La règle est simple — le compte capable de provoquer un incident ne doit pas pouvoir le dissimuler. Sans cette séparation, chaque enquête finit par conclure « logs indisponibles ».
Contenir avant de rétablir
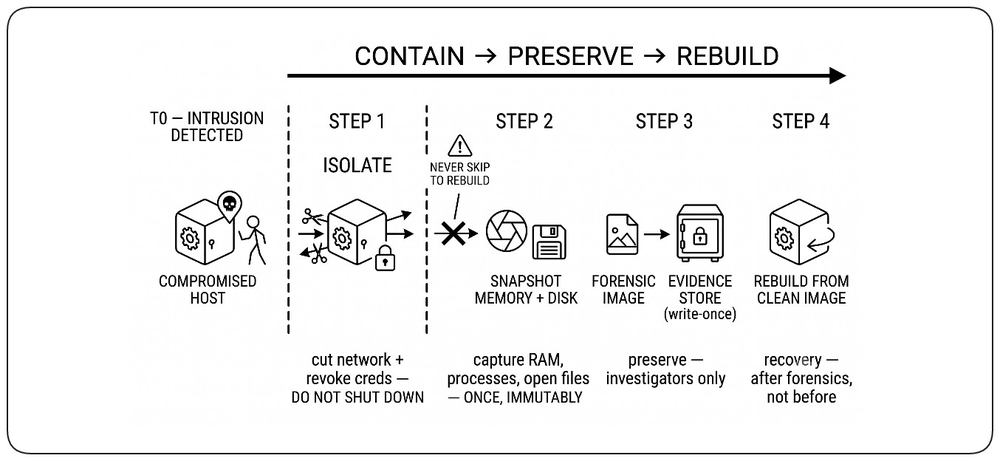
L’instinct de l’opérateur est de restaurer : tuer le processus, effacer la machine, remettre le service en bonne santé. Mais rétablir sur une intrusion qui se propage encore n’est pas un rétablissement — c’est l’attaquant qui s’enfonce plus profondément pendant que les défenseurs soignent les symptômes. !!Le premier objectif n’est pas de réparer le système, c’est d’empêcher l’attaque de continuer!!. Isolez d’abord : coupez le réseau, révoquez les credentials, bloquez l’egress. Puis faites un snapshot de la mémoire et du disque avant la reconstruction — détruire ces preuves peut empêcher définitivement de comprendre la compromission initiale. Contenir, préserver, rétablir — dans cet ordre, à chaque fois.
Chaque incident renforce le système
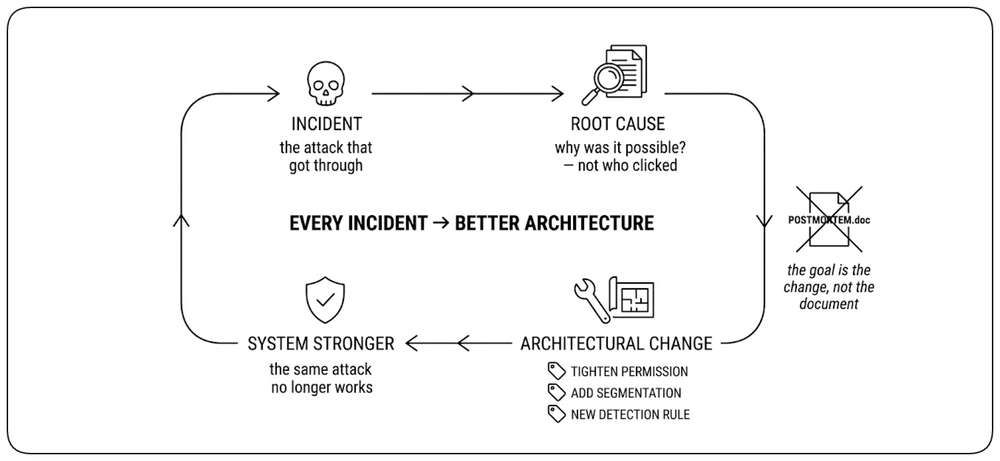
Un incident de sécurité coûte cher. La seule façon de rentabiliser ce coût est de retransformer l’incident en architecture. !!Une cause racine technique est rarement la cause racine architecturale!! « L’attaquant a utilisé un email de phishing » ou « un credential a fuité » s’arrête un niveau trop tôt — la réponse utile est pourquoi ce credential était-il assez puissant pour compter, pourquoi le blast radius était-il si grand, pourquoi la détection a-t-elle pris si longtemps. Chaque incident sérieux devrait resserrer une permission, ajouter une frontière de segmentation ou retirer une capacité. Une organisation qui mène deux fois la même enquête n’a pas encore mené la première.