Concevoir pour la résilience et la tolérance aux pannes
Chapter Info
Calculating... Writing Progress: 75%
Dans les systèmes distribués, la défaillance est inévitable. Les réseaux se partitionnent, les serveurs plantent, les dépendances ralentissent et les ressources s’épuisent — et pourtant les utilisateurs attendent que le système reste disponible.
Ce chapitre explore comment concevoir des systèmes qui traitent la défaillance comme une condition normale de fonctionnement. Il présente les principes et les patterns qui contiennent les perturbations, préservent le service essentiel et aident les systèmes à défaillir en douceur et à se rétablir de façon autonome.
Ce chapitre se concentre sur la résilience à l’exécution. La résilience pendant les déploiements et les autres transitions d’état est traitée dans le chapitre Concevoir pour être déployé.
Introduction
Concevoir pour la défaillance
Concevoir pour la défaillance, c’est accepter que des composants vont tomber, que des dépendances vont disparaître et que des hypothèses finiront par être violées. Ces décisions sont architecturales : la résilience est plus facile à intégrer dès le départ et coûteuse à ajouter après coup. L’objectif n’est pas d’empêcher toutes les défaillances, mais de les garder contenues, récupérables et aussi invisibles que possible pour les utilisateurs. L’isolation, la redondance, les deadlines, la dégradation gracieuse et la reprise découlent tous de ce principe.
Résilience vs tolérance aux pannes
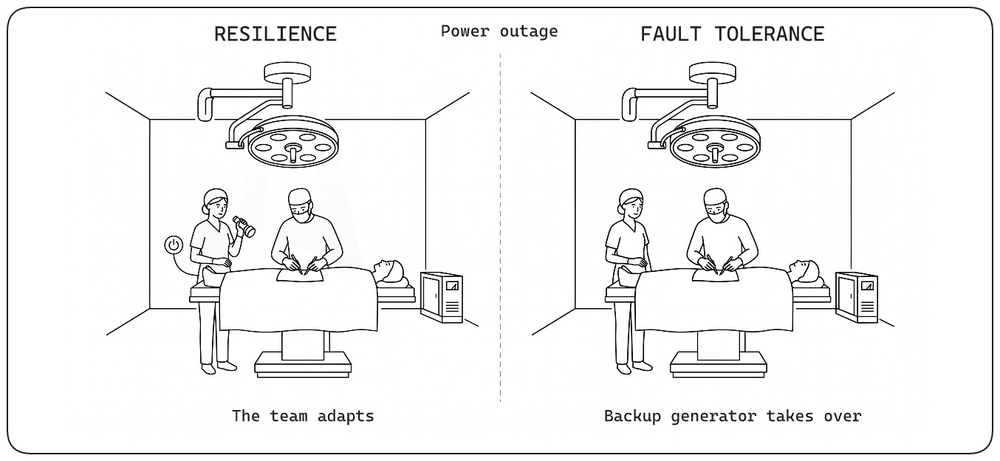
Deux propriétés voisines mais distinctes décrivent la façon dont les systèmes gèrent la défaillance. La résilience est la capacité à continuer de fournir un niveau de service acceptable malgré les défaillances, en les détectant, en les contenant et en s’en rétablissant. La tolérance aux pannes est plus stricte : la capacité à continuer de fonctionner correctement même lorsque des composants tombent, sans aucune perturbation visible. Les systèmes tolérants aux pannes utilisent la redondance et la réplication pour que les utilisateurs ne remarquent jamais la défaillance. En pratique, la plupart des systèmes modernes visent la résilience partout et réservent la tolérance aux pannes aux quelques chemins critiques où toute perturbation est inacceptable.
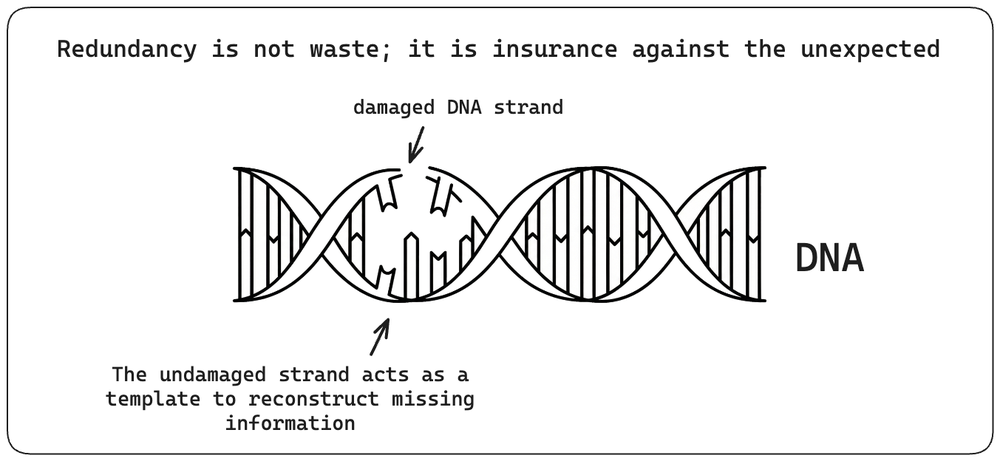
La résilience est dans notre ADN
La biologie a déjà résolu ce problème. Chaque cellule du corps porte une copie complète du génome ; quand une cellule est endommagée, ses voisines détiennent encore l’information nécessaire pour reconstruire ce qui a été perdu. La détection locale déclenche une réparation locale, et l’organisme continue de fonctionner pendant que la correction se fait en arrière-plan. Les mécanismes sont concrets : copies redondantes de l’état, détection au plus près des dégâts, auto-réparation à partir d’une référence intacte et rétablissement sans coordinateur central. Un logiciel résilient emprunte les mêmes primitives — état répliqué, signaux de santé locaux, rétablissement autonome et reconstruction à partir d’un réplica sain.
Comprendre les défaillances
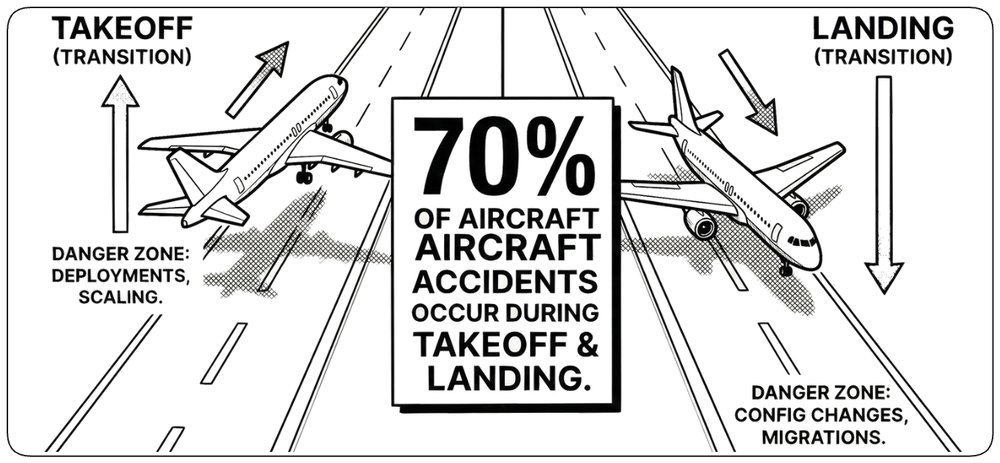
Quand surviennent les défaillances ?
Les défaillances peuvent survenir à tout moment, mais les transitions d’état révèlent souvent des faiblesses qui restent cachées en fonctionnement stable. Les déploiements, changements de configuration, migrations, failovers et grands déplacements de trafic modifient les conditions du système et peuvent exposer des hypothèses fragiles concernant le scaling, l’état du cache, la profondeur des files et le comportement des dépendances. Les transitions méritent donc une attention particulière, mais elles ne sont pas la seule source de défaillance. Ce chapitre se concentre sur la façon dont les systèmes survivent aux défaillances à l’exécution ; la discipline pour modifier les systèmes en toute sécurité est traitée dans le chapitre sur la gestion des releases.
En savoir plus
Chapitre : Concevoir pour être déployé.
Qu’est-ce qui peut mal tourner ?
On ne peut pas se défendre contre des modes de défaillance auxquels on n’a jamais pensé. La résilience commence par identifier ce qui peut casser, comment la défaillance peut se propager et ce que le système doit faire lorsqu’elle survient. Les défaillances se regroupent en trois grandes familles : quelque chose disparaît, quelque chose sature, ou quelque chose se comporte de manière incorrecte.
Quelque chose disparaît
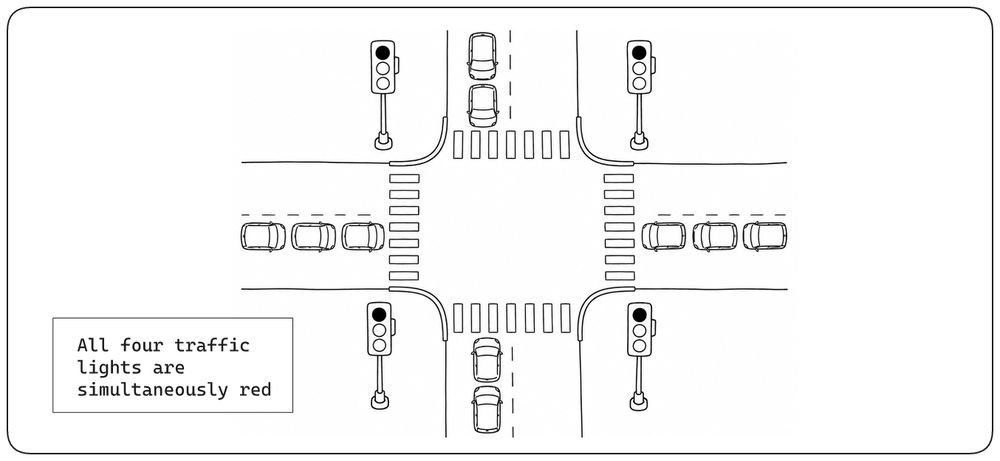
Un composant dont dépend le système peut soudainement devenir indisponible. Un serveur peut planter, une partition réseau peut isoler une partie du système, ou un service externe peut cesser de répondre. La réponse résiliente consiste à détecter rapidement la perte, à en contenir l’impact et à continuer de fonctionner grâce à la redondance, au failover, au fallback ou à la dégradation gracieuse.
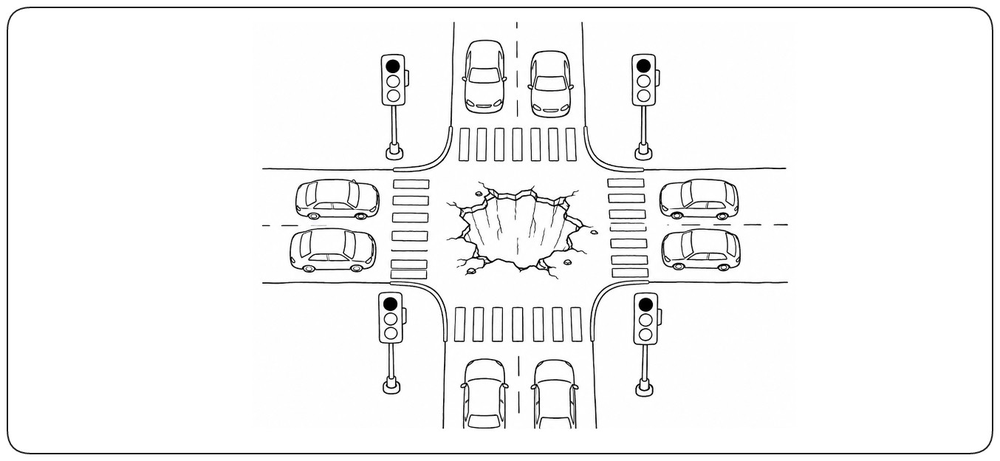
Quelque chose sature
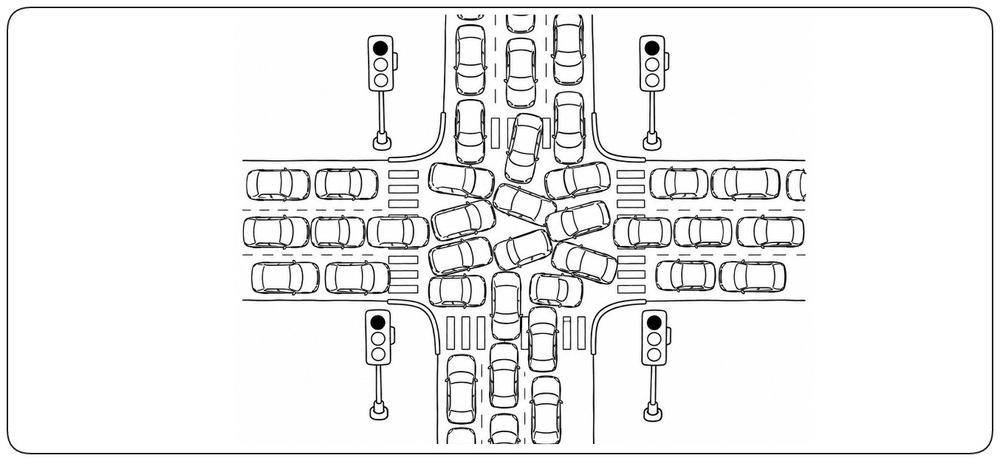
Chaque ressource a une limite. CPU, mémoire, threads, connexions, files et stockage peuvent tous s’épuiser lorsque la demande dépasse la capacité ou que le travail s’accumule plus vite qu’il ne peut être traité. Les systèmes résilients utilisent des limites, l’isolation, le backpressure et le load shedding pour empêcher une pression locale de devenir une panne en cascade.
Quelque chose se comporte de manière incorrecte
Un composant peut rester disponible tout en produisant un mauvais résultat. Bugs logiciels, configuration obsolète, race conditions, état corrompu et erreurs d’opérateur peuvent tous créer des défaillances difficiles à détecter, car le système semble toujours fonctionner. La résilience exige de la validation, de l’observabilité, des valeurs par défaut sûres et des chemins de reprise qui limitent les dégâts lorsque le comportement est faux plutôt qu’absent.
La défaillance est multidimensionnelle
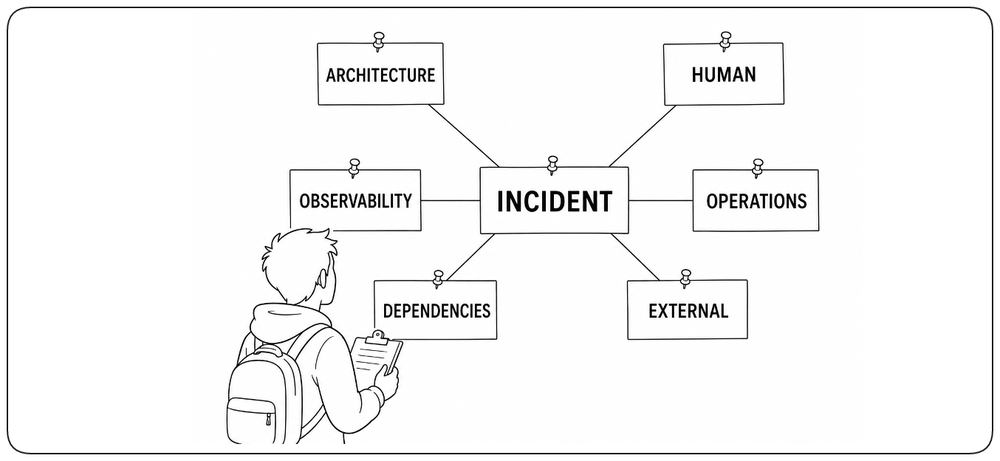
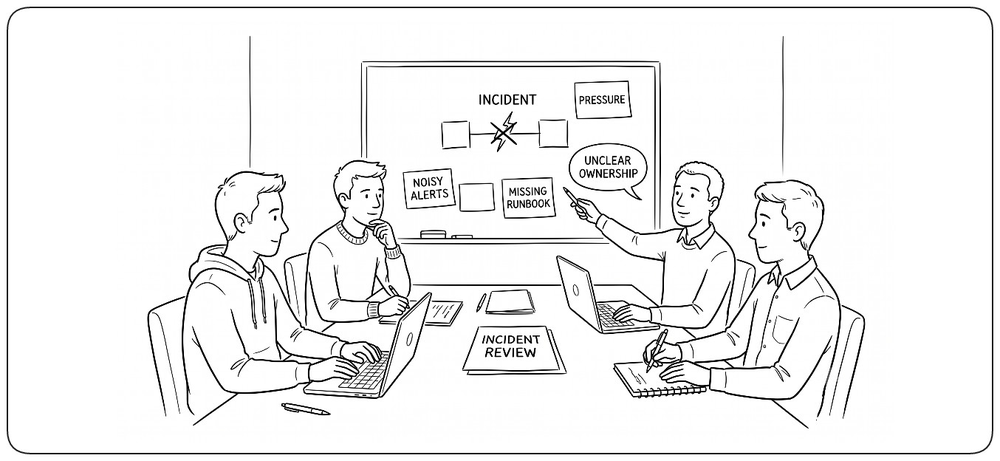
Les incidents majeurs ont rarement une cause unique. Ils émergent de faiblesses réparties sur plusieurs dimensions du système : un défaut technique, une limite architecturale, une observabilité insuffisante, des lacunes opérationnelles, des décisions humaines ou des dépendances externes. Chaque problème peut sembler gérable isolément, mais ensemble ils créent les conditions de la défaillance. L’analyse d’incident doit donc regarder au-delà de l’événement déclencheur et identifier quelles faiblesses architecturales, opérationnelles, organisationnelles et techniques se sont combinées pour permettre l’incident.
Le coût de la résilience
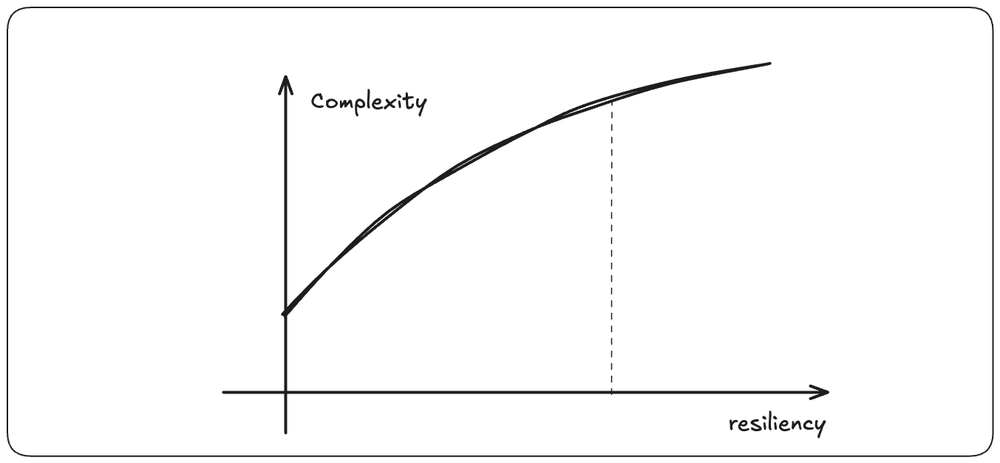
Construire un système résilient ajoute à la fois de la complexité et du coût. Cela demande une conception soignée pour isoler les défaillances, ainsi qu’une infrastructure supplémentaire : réplicas, sauvegardes et mécanismes de failover. Ces systèmes demandent aussi plus d’efforts d’exploitation et de maintenance ; les investissements en résilience doivent donc se concentrer sur les zones où une défaillance aurait le plus fort impact business.
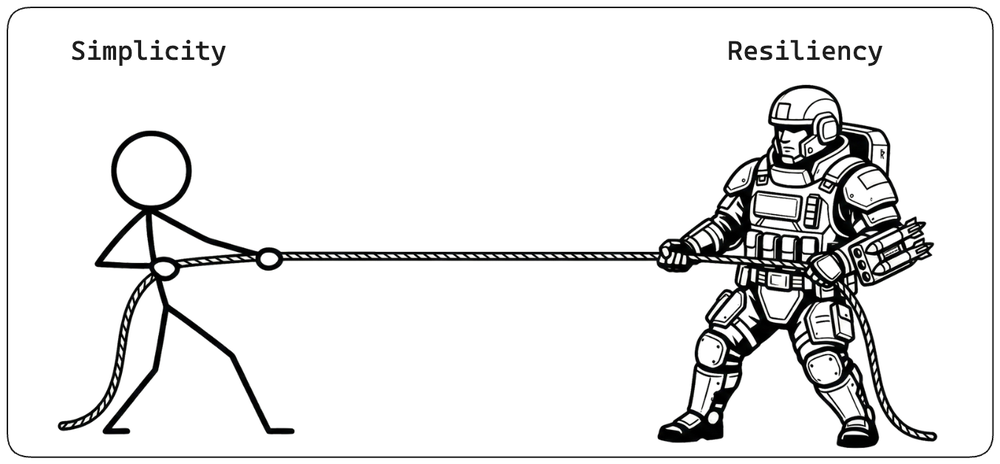
Équilibrer simplicité et résilience
Il existe une tension fondamentale entre simplicité et résilience. La simplicité doit rester le choix par défaut, car elle réduit la complexité et améliore l’adaptabilité. Une résilience supplémentaire ne doit être introduite que là où l’impact business d’une défaillance justifie le coût. Le bon équilibre est en fin de compte une décision business, qui met en balance la complexité d’implémentation et les conséquences d’une indisponibilité.
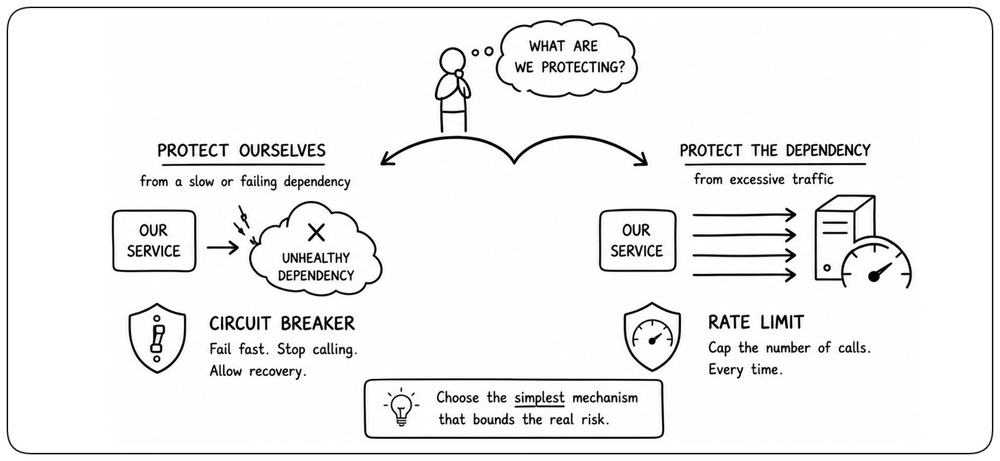
Utiliser le pattern le plus simple qui contient le risque
La résilience ne vient pas de l’empilement de tous les patterns disponibles. Chaque mécanisme protège contre un mode de défaillance précis et introduit sa propre complexité, son propre état et ses propres cas limites. Partez du risque à contenir, puis choisissez le mécanisme le plus simple qui le borne. Par exemple, un circuit breaker protège les appelants d’une dépendance en mauvaise santé, tandis qu’un rate limit protège une dépendance d’un trafic excessif. Utilisez le mécanisme qui correspond à la défaillance pour laquelle vous concevez.
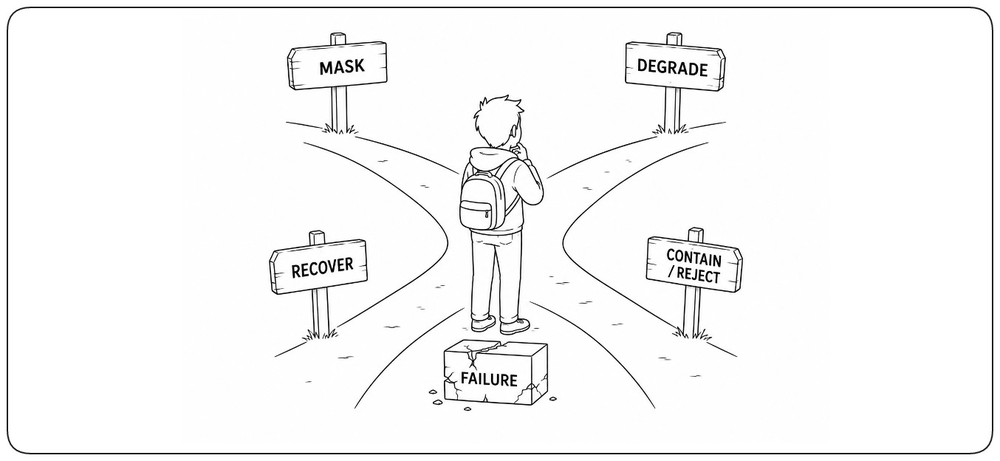
Quand la défaillance survient, vous avez des choix
La défaillance n’est pas binaire. Quand quelque chose casse, un système a quatre réponses possibles : !!masquer la défaillance!! grâce à la redondance, !!dégrader!! en réduisant les fonctionnalités tout en préservant le service essentiel, !!contenir ou rejeter!! des requêtes pour éviter des dégâts plus larges, ou !!se rétablir!! en restaurant un fonctionnement sain. Chaque pattern de résilience de ce chapitre existe pour atteindre l’une de ces issues. Le défi de conception est de choisir la bonne réponse pour chaque type de défaillance.
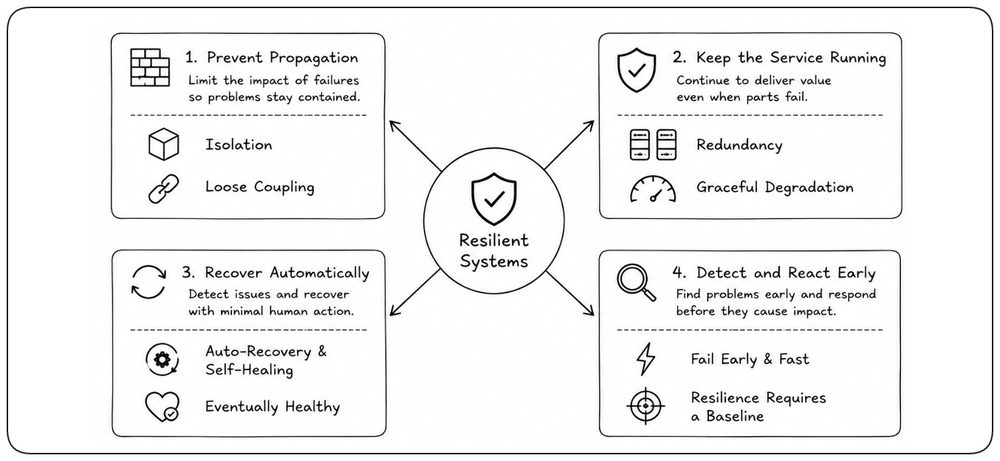
Principes fondamentaux de résilience
La résilience se construit à partir d’un petit ensemble de principes complémentaires. Certains façonnent l’architecture avant que les défaillances ne surviennent, d’autres définissent le comportement du système une fois qu’elles se produisent. Ensemble, ils limitent la propagation des défaillances, préservent le service essentiel et permettent une reprise prévisible.
Échouer tôt et vite
Un système résilient expose la défaillance tôt au lieu de la cacher ou de la repousser. À l’exécution, les services doivent échouer clairement et rapidement plutôt que de se bloquer, de réessayer à l’aveugle ou de continuer à consommer des ressources pour un travail qui ne peut pas aboutir. Une défaillance précoce limite le blast radius, simplifie le diagnostic et laisse aux mécanismes de reprise le temps d’agir.
La résilience exige une référence
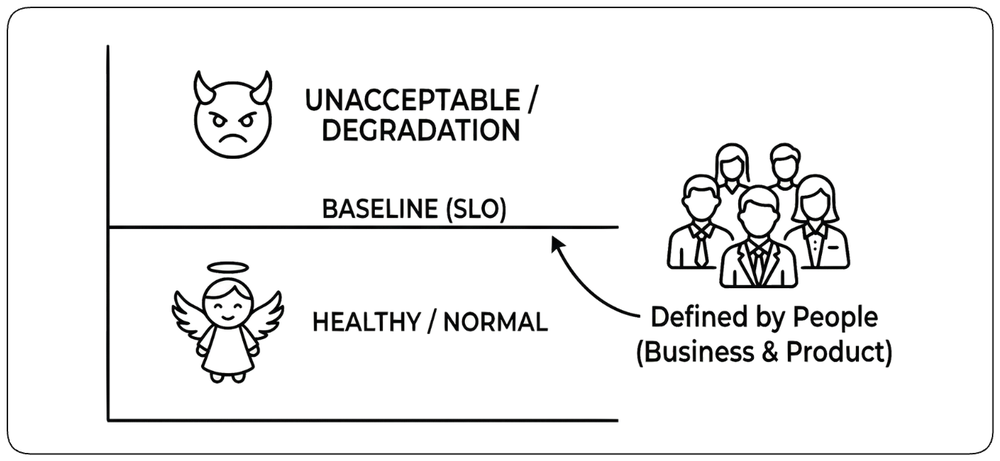
On ne peut pas concevoir pour la résilience sans définir ce que « acceptable » signifie. Cette référence est le Service Level Objective (SLO) : la frontière entre une disponibilité, une latence et un taux d’erreurs acceptables ou non. Le SLO est une décision produit, pas seulement technique — le business définit le service dont les utilisateurs ont besoin, et l’ingénierie détermine comment l’atteindre. Sans SLO, les équipes ne peuvent pas juger quelle redondance est justifiée, quand une dégradation exige une action, ni quels investissements de résilience comptent le plus.
Cacher la reprise interne aux clients
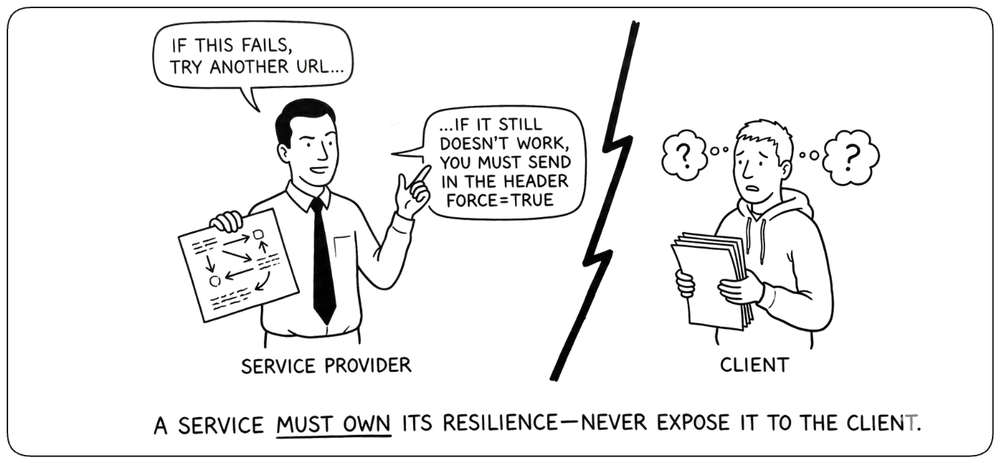
Un service doit posséder les mécanismes de reprise situés à l’intérieur de sa frontière : sélection de réplicas, retries vers ses propres dépendances, warmup du cache, circuit breakers internes et failover entre ses propres instances. Les clients ne doivent voir que le contrat public de défaillance — codes de statut, sémantique des erreurs, deadlines et indications de backoff — et non la topologie interne du service ni ses chemins de reprise. Quand la logique de reprise fuit à travers la frontière, chaque client la réimplémente différemment et le comportement du système devient incohérent.
Isolation
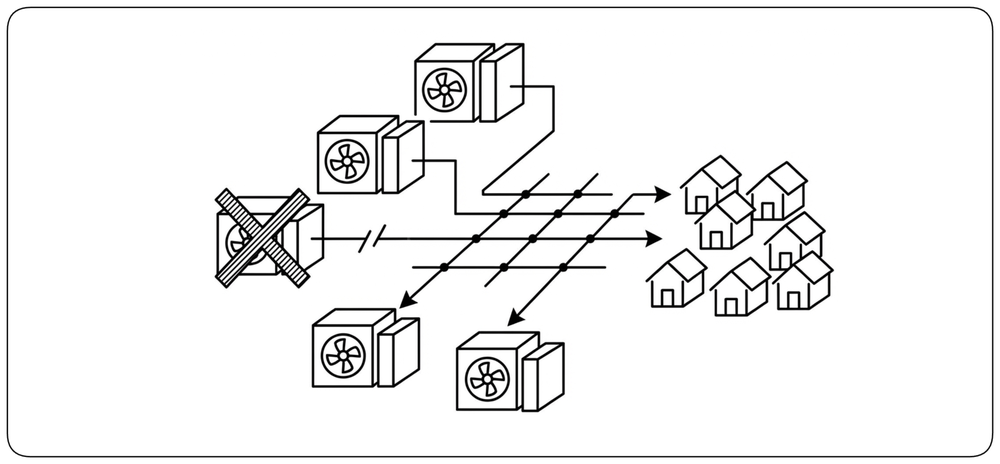
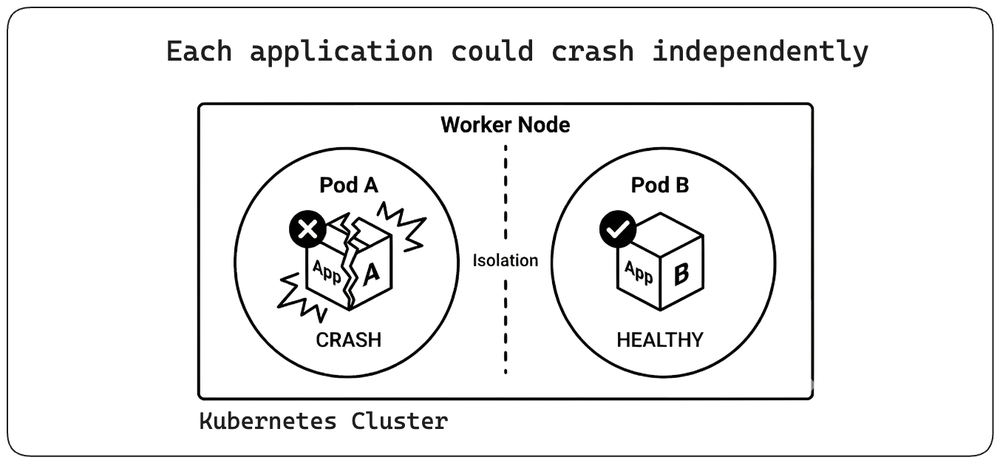
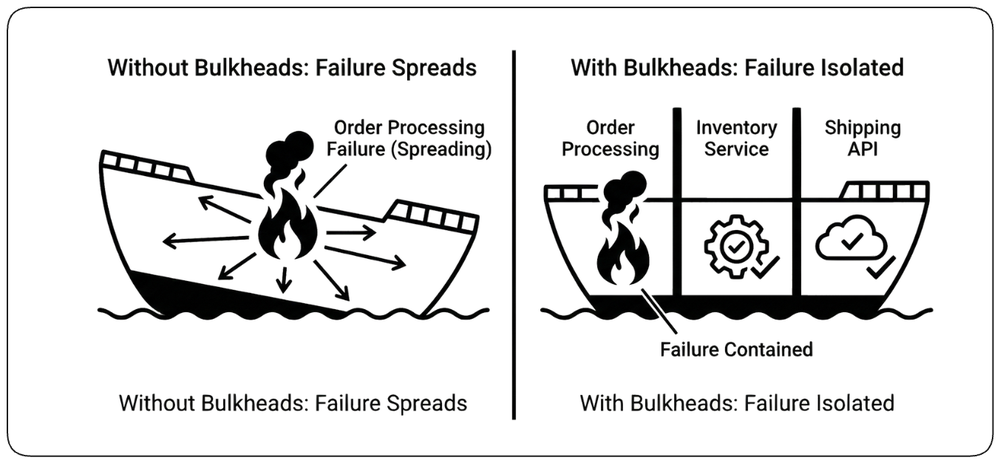
L’isolation empêche les défaillances de se propager au-delà des frontières du système. Quand les composants sont correctement isolés, une défaillance reste confinée au lieu de se répandre en cascade vers des services, workloads, tenants ou utilisateurs sans rapport. L’objectif est de créer des domaines de défaillance explicites — comme les cloisons étanches d’un navire — pour que les dégâts d’un compartiment ne puissent pas inonder le reste du système.
Isolation des services
Chaque service doit fonctionner comme un domaine de défaillance indépendant, avec son propre cycle de vie, son propre chemin de déploiement et son propre comportement de reprise. Un défaut ou une défaillance de dépendance dans un service ne doit pas déstabiliser directement le reste du système. Cette indépendance permet aussi aux équipes de déployer, scaler et rétablir des composants sans coordonner chaque changement à l’échelle globale.
Isolation des ressources
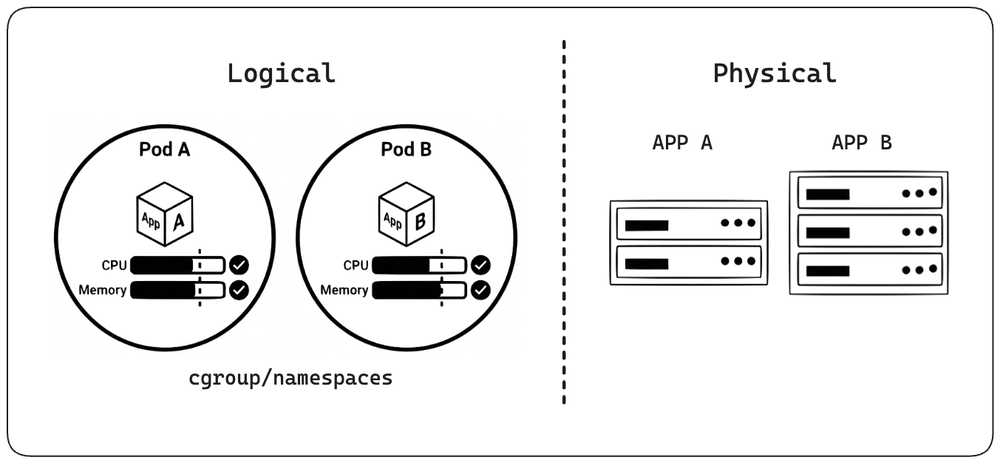
L’isolation des ressources empêche un workload de consommer le CPU, la mémoire, le stockage, les threads ou les connexions dont les autres ont besoin. Pools dédiés, quotas, limites de conteneurs et instances séparées préservent la capacité pour le travail critique lorsqu’un autre workload devient bruyant ou lent.
Isolation des tenants et des données
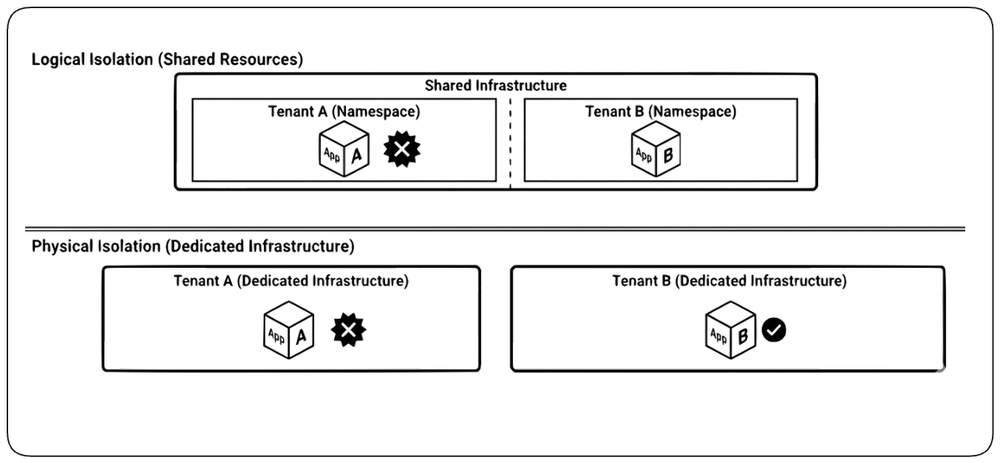
Dans les systèmes multi-tenants, l’isolation empêche la charge, un défaut, un incident de sécurité ou la corruption de données d’un tenant d’affecter les autres. La conception peut aller d’une séparation logique sur une infrastructure partagée à des bases de données dédiées ou à des environnements totalement isolés. Plus l’exigence business, réglementaire ou de blast radius est stricte, plus la frontière doit être forte.
Isolation des workloads
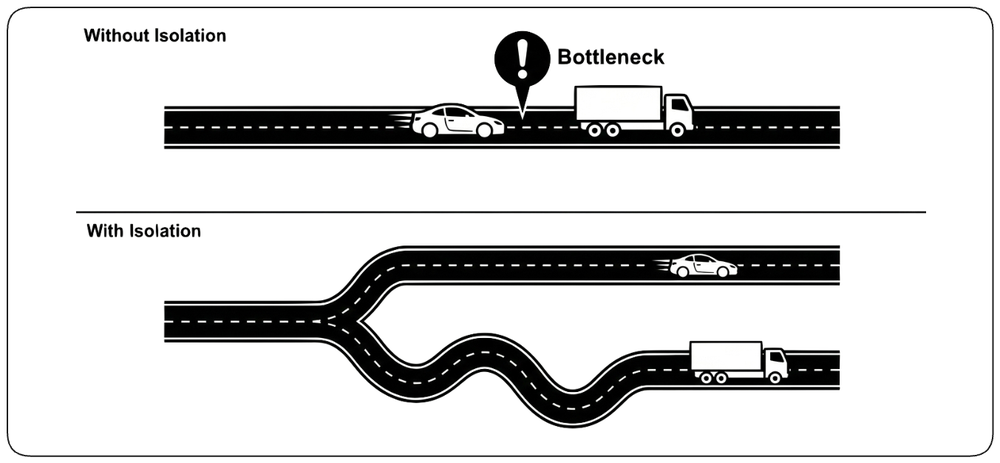
L’isolation des workloads sépare le trafic ayant des profils d’exécution différents. Les jobs batch de longue durée, les requêtes analytiques et le traitement en arrière-plan ne doivent pas entrer en concurrence directe avec les requêtes utilisateur sensibles à la latence. Des files, pools ou instances de service séparés empêchent le travail lent de dégrader les chemins critiques.
Redondance
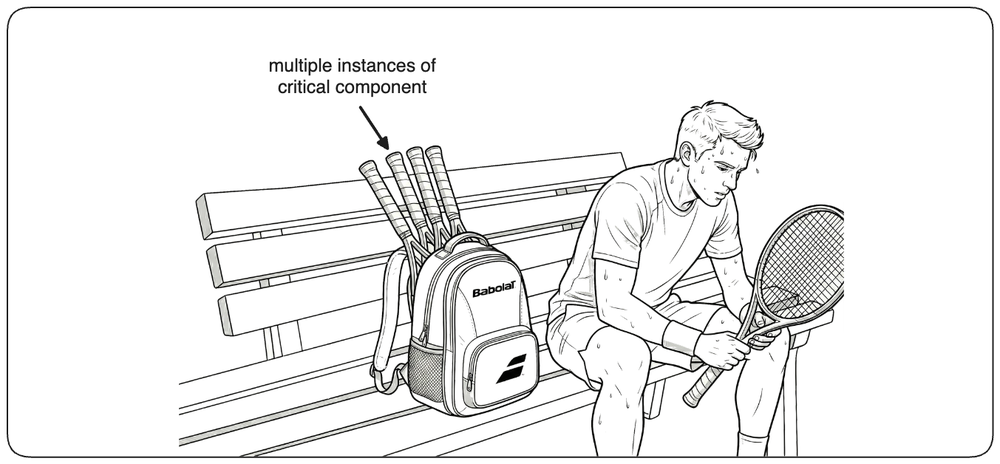
La redondance supprime les points de défaillance uniques en maintenant plusieurs instances ou copies des composants critiques. Quand l’un tombe, un autre peut continuer à servir le trafic ou préserver l’accès à l’état. Réplicas, instances load-balancées, bases de données synchronisées et systèmes de secours offrent tous cette protection. La redondance n’est pas gratuite : chaque copie supplémentaire ajoute du coût, de la complexité opérationnelle et des compromis de cohérence. Son niveau doit donc refléter l’impact business d’une indisponibilité.
La résilience exige de la marge de capacité
La résilience suppose une !!capacité en réserve!!. Un système qui tourne en permanence à 95 % de CPU n’a aucune marge pour absorber un pic de trafic, une dépendance lente, une retry storm ou un événement de failover. !!La redondance, les retries, le hedging et le failover consomment tous de la capacité lorsqu’ils s’activent!! — sans marge, le premier incident sature ce qui reste et la défaillance se propage. Dimensionnez pour la charge de pointe plus un tampon, pas pour la moyenne.

Couplage faible
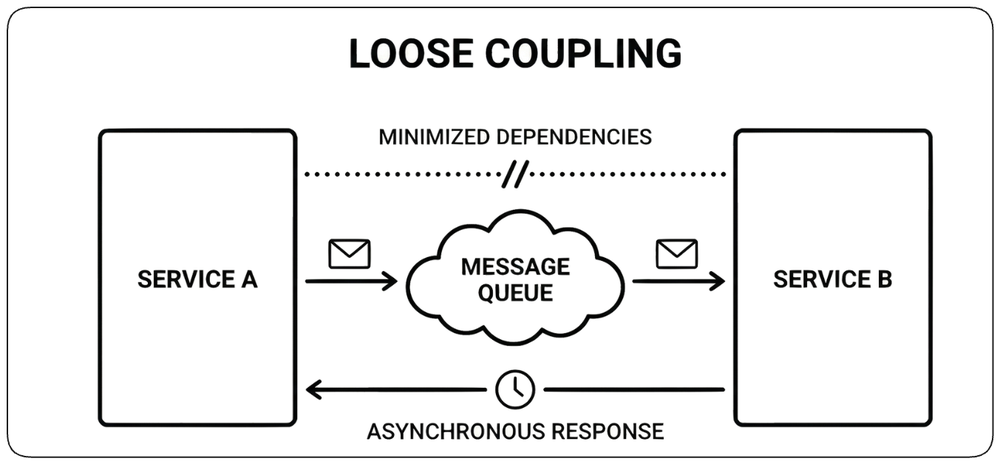
Un couplage faible limite la distance à laquelle les défaillances se propagent. Les composants doivent interagir via des contrats explicites et éviter les hypothèses inutiles sur le timing, l’implémentation et la disponibilité. La communication asynchrone peut en outre séparer producteurs et consommateurs dans le temps, permettant à chacun de défaillir et de se rétablir indépendamment.
Auto-rétablissement et self-healing
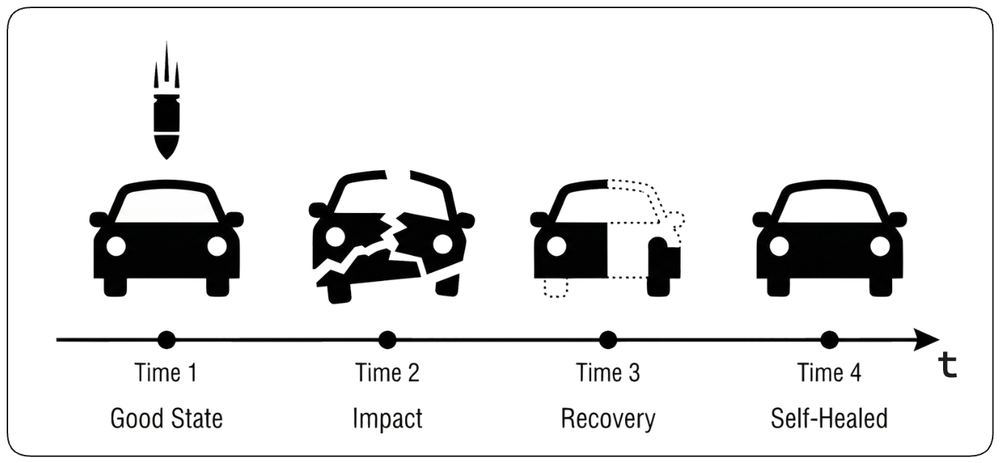
Les systèmes résilients détectent et corrigent automatiquement les défaillances courantes. Les health checks, l’orchestration et le routage basé sur la santé peuvent redémarrer des processus défaillants, remplacer des instances en mauvaise santé et rediriger le trafic avant que les utilisateurs ne soient touchés. L’automatisation réduit le temps de reprise et la charge opérationnelle, mais seulement lorsque l’action de reprise est sûre, bornée et observable.
Savoir quand redémarrer
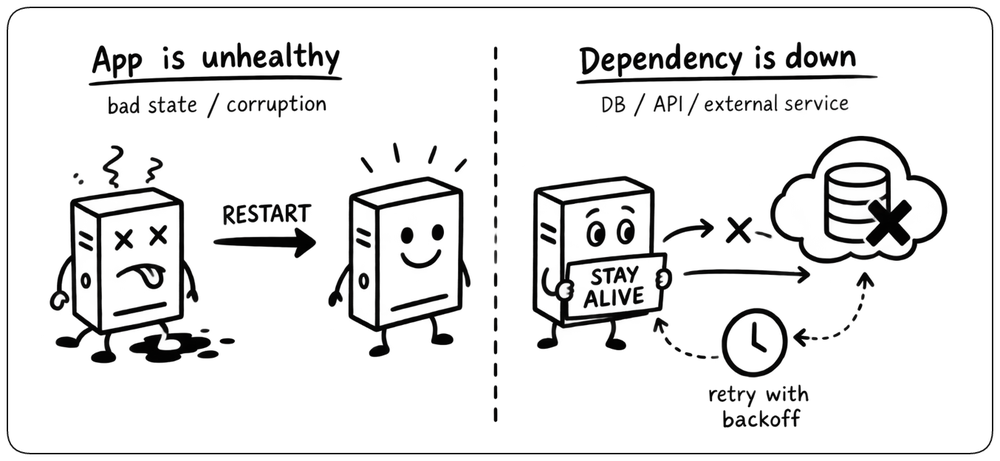
Redémarrer un processus efface son état interne et donne une nouvelle chance à l’initialisation. À utiliser quand le processus lui-même est en mauvaise santé, corrompu ou incapable de garantir ses invariants — pas pour réparer une base de données indisponible, une API externe cassée ou une autre défaillance persistante de dépendance. Des redémarrages répétés peuvent créer des boucles, ajouter de la charge et aggraver une panne. Si le processus est sain, gardez-le en vie, cessez d’accepter du travail si nécessaire, et rétablissez-vous avec des retries bornés, du backoff, des circuit breakers ou des probes périodiques. Redémarrez quand le redémarrage peut changer le résultat ; sinon, rétablissez-vous sur place.
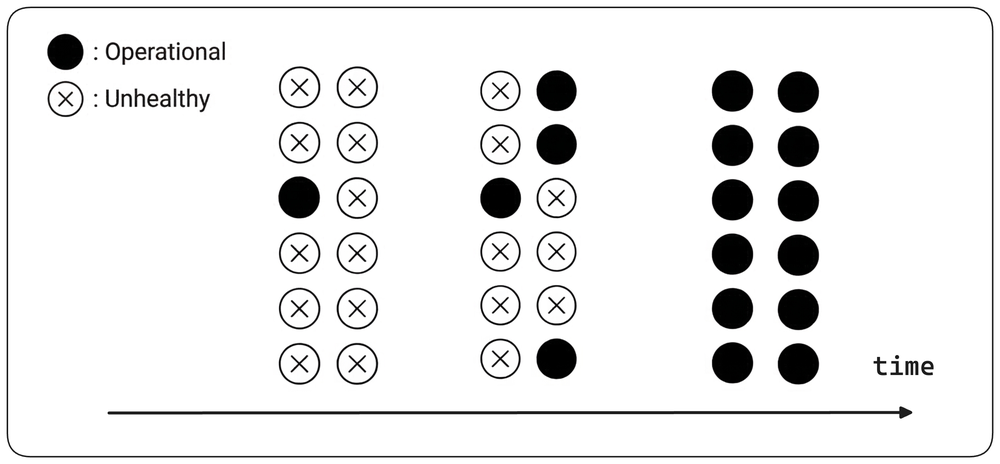
Finalement sain
Les systèmes complexes doivent converger vers un état sain sans dépendre d’un ordre de démarrage fragile ni d’une intervention manuelle. Les composants peuvent devenir disponibles à des moments différents, mais le système doit se stabiliser automatiquement à mesure que les dépendances se rétablissent.
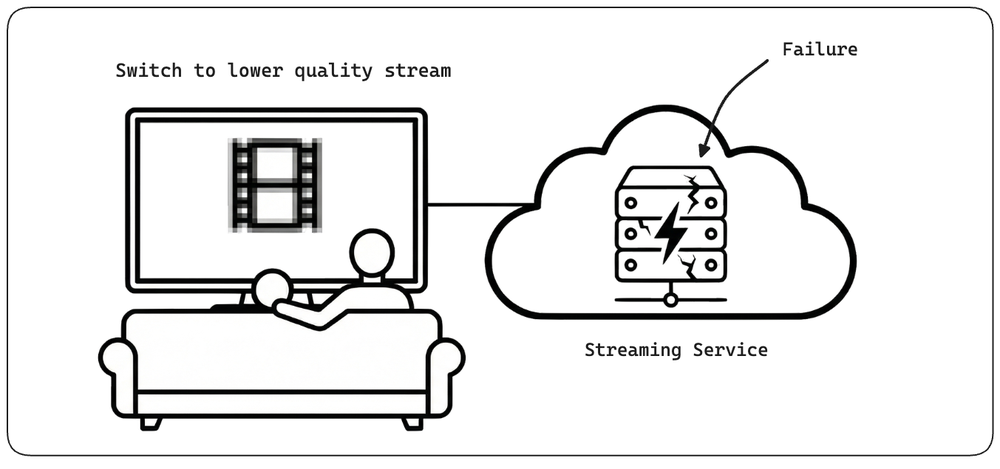
Dégradation gracieuse
La dégradation gracieuse consiste à continuer de fournir le meilleur service possible lorsque la fonctionnalité complète n’est plus disponible. Plutôt que d’échouer complètement, le système réduit délibérément la qualité, la performance ou les fonctionnalités non essentielles afin que les capacités centrales restent disponibles.
Résilience des requêtes
Un appel en aval peut échouer en devenant lent, indisponible ou peu fiable. Les patterns au niveau de la requête bornent la durée d’attente de l’appelant, déterminent quand une nouvelle tentative est justifiée, arrêtent les appels vers des dépendances clairement en mauvaise santé et fournissent une alternative acceptable lorsque le chemin principal ne peut pas aboutir. Ensemble, ils empêchent une interaction défaillante de consommer tout le budget de latence et de ressources de l’appelant.
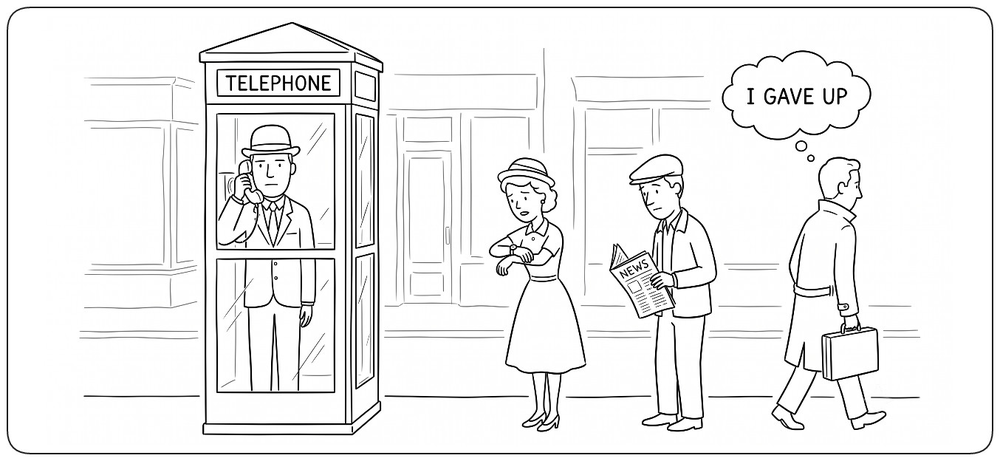
Pattern Timeout
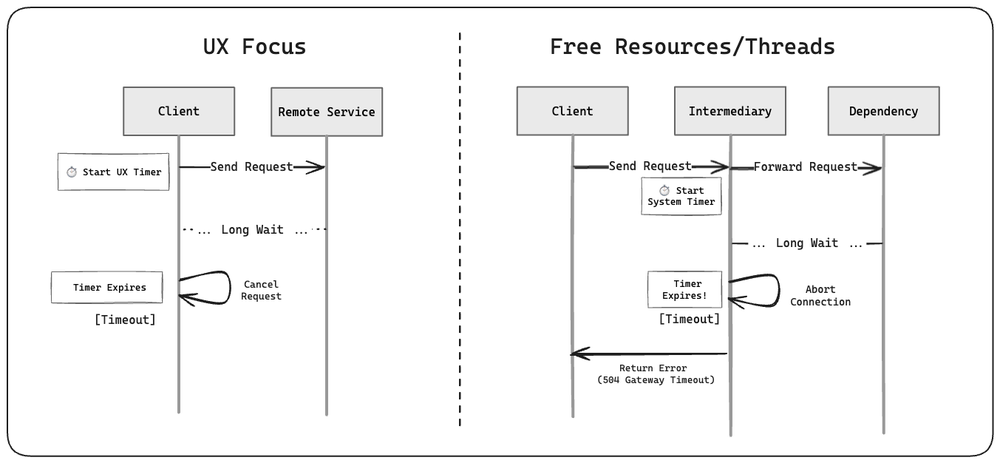
Un timeout définit le temps maximal qu’un appelant attendra avant d’abandonner une opération et de la considérer comme échouée. Il sert deux objectifs. À la frontière du client, il protège la réactivité en évitant que les utilisateurs n’attendent indéfiniment. À l’intérieur du système, il protège la capacité. Sans timeouts, les dépendances lentes retiennent threads, sockets, mémoire et entrées de pool de connexions jusqu’à ce que le système lui-même sature.
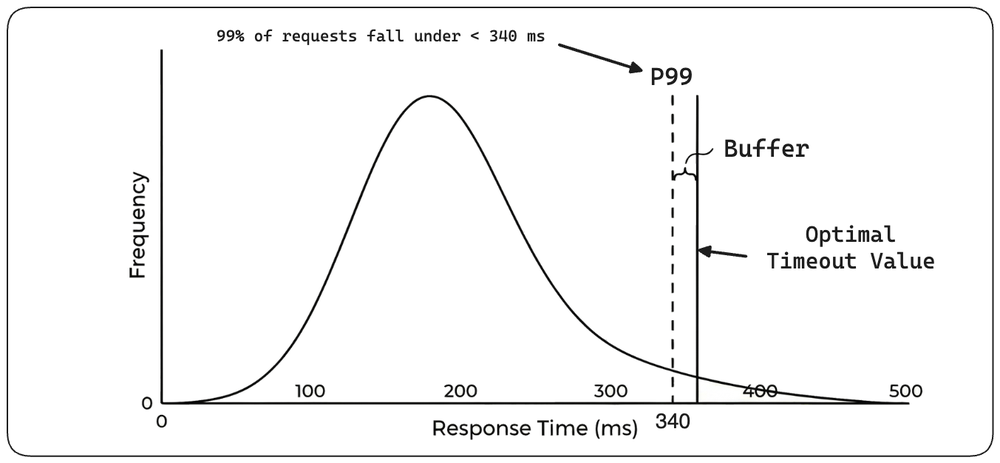
Fixer les timeouts à partir de la latence observée et du budget de bout en bout
Les valeurs de timeout doivent provenir de deux entrées. Premièrement, le comportement observé du service : utilisez la latence p99 comme signal de borne inférieure de la durée normale d’un appel sain. Deuxièmement, le budget de bout en bout : combien de temps l’appelant peut attendre, moins le temps déjà écoulé et la marge pour les retries. Un timeout basé uniquement sur le p99 peut dépasser la deadline de l’appelant, tandis qu’un timeout basé uniquement sur la deadline peut ignorer si l’appel a une chance réaliste d’aboutir. Les deux sont nécessaires.
Propager la deadline, pas le timeout
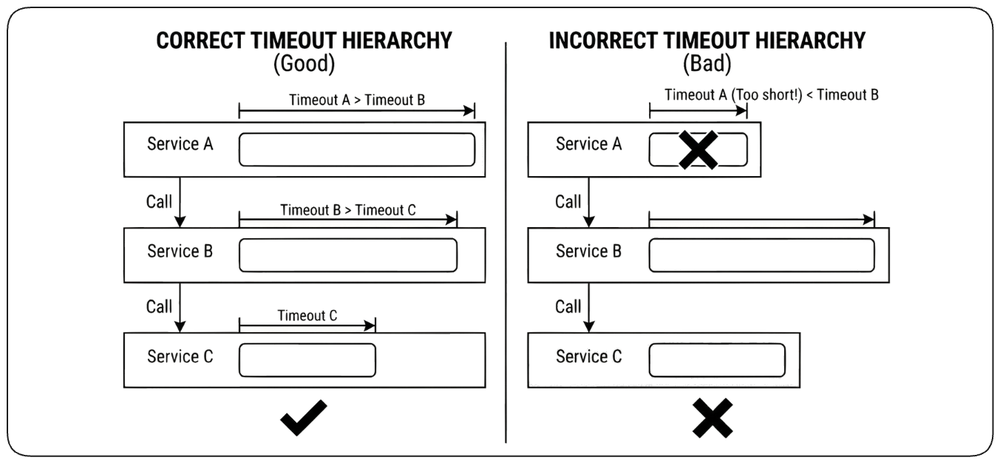
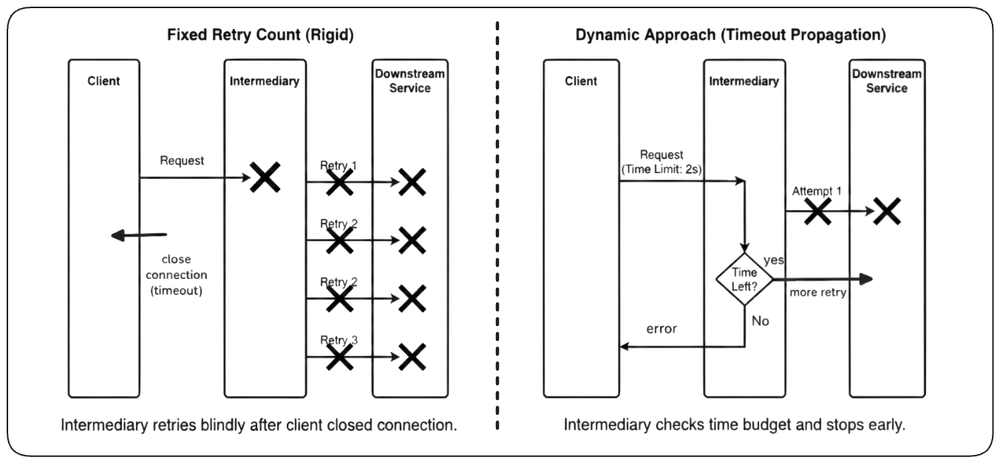
Les chaînes de timeouts statiques sont fragiles, car chaque service définit sa propre limite sans savoir combien de temps l’appelant a déjà consommé. La meilleure approche est la propagation de deadline : l’appelant de plus haut niveau fixe une deadline de bout en bout, et chaque service transmet le budget restant en aval. Une requête qui arrive avec seulement 200 ms restantes ne doit pas lancer un retry de 5 secondes ni appeler une dépendance qui ne peut pas terminer à temps. Propager la deadline garde chaque décision alignée sur le budget réel de l’appelant et évite le travail dont le résultat arrivera trop tard.
Comportement conscient de la deadline en cas de dégradation
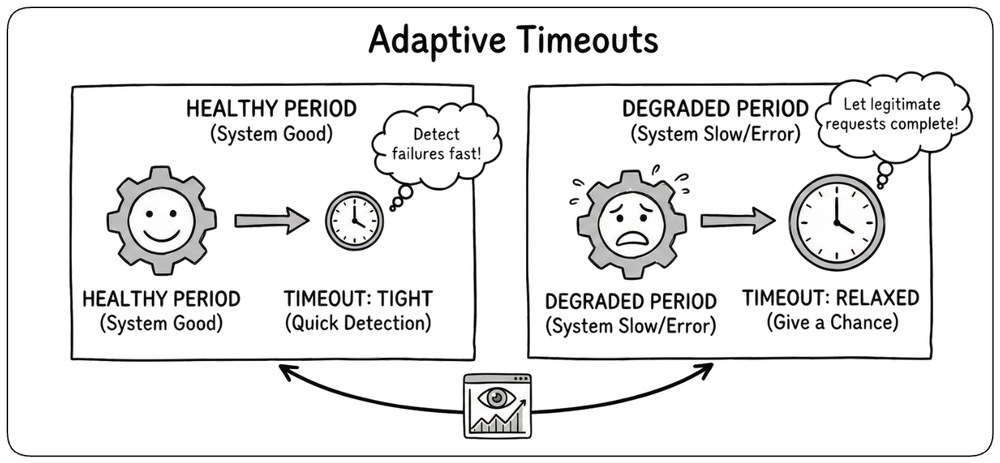
En cas de dégradation, des timeouts plus longs aggravent généralement la situation au lieu de l’améliorer. Ils gardent threads, sockets et mémoire occupés, augmentant la saturation. À la place, restez conscient de la deadline : suivez le budget restant de l’appelant et utilisez des signes comme la hausse de la latence ou du taux d’erreurs pour décider quand sauter du travail via le load shedding, les circuit breakers ou les fallbacks. Adaptez ce que vous abandonnez, pas la durée de votre attente.
Pattern Retry
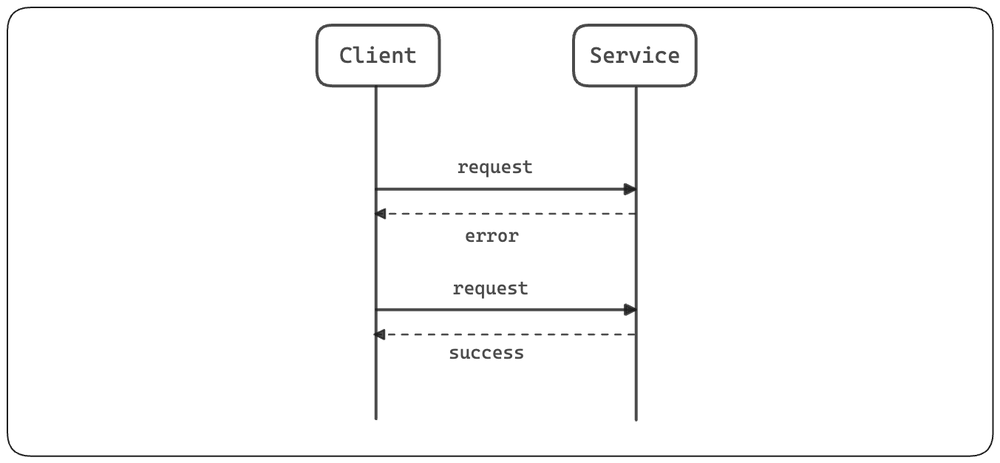
Un retry répète une opération échouée lorsque la défaillance est probablement transitoire : une brève interruption réseau, une surcharge temporaire ou une indisponibilité de courte durée d’une dépendance. Réessayer n’est utile que lorsqu’une nouvelle tentative a une chance réaliste de produire un résultat différent.
Les limites du retry
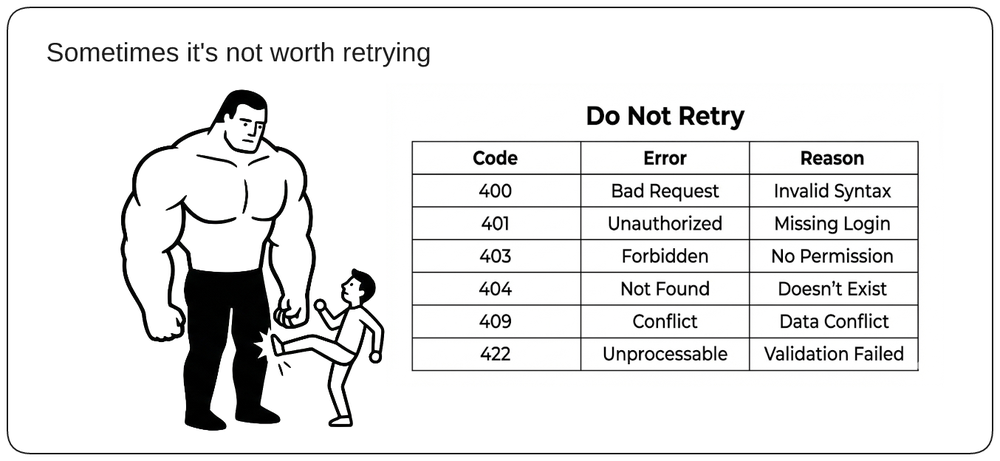
Le retry est fondamentalement une question de contexte. Avant de réessayer, demandez-vous : « Une nouvelle tentative peut-elle réalistement produire un résultat différent ? » Sinon, réessayer ne fait que gaspiller des ressources, retarder l’échec et possiblement amplifier la charge sur un système déjà en difficulté. Les retries ont du sens pour des défaillances transitoires comme de brèves interruptions réseau ou une surcharge temporaire. Ils n’aident pas pour des défaillances déterministes comme des identifiants invalides, une entrée malformée ou une ressource supprimée, qui doivent échouer immédiatement.
Idempotence
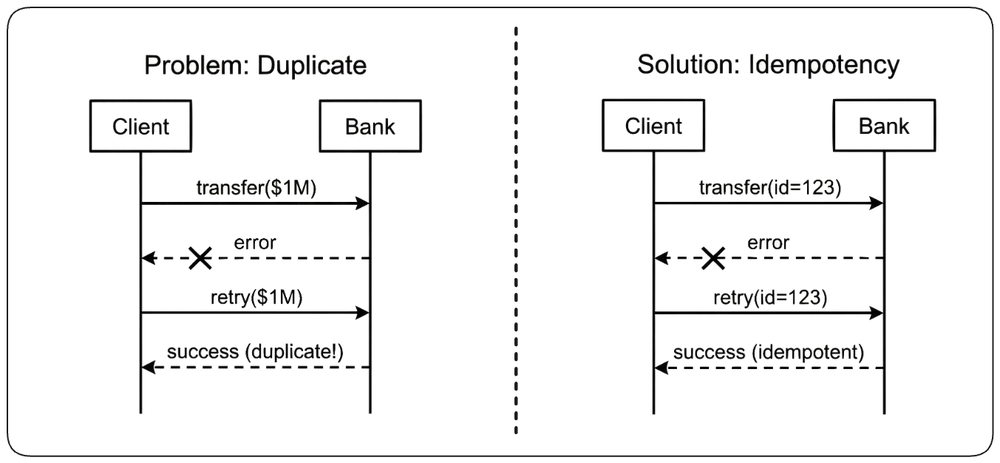
Des retries sûrs exigent l’idempotence : répéter la même opération logique ne doit pas produire d’effets de bord supplémentaires. C’est important quand l’appelant ne peut pas savoir si la première tentative a réussi avant que la connexion n’échoue. Une clé d’idempotence unique permet au récepteur de reconnaître les tentatives en double et de renvoyer le résultat d’origine au lieu de facturer deux fois, de créer deux commandes ou de répéter une autre action irréversible.
Ne pas réessayer après la deadline de l’appelant
Une erreur courante de retry est de continuer alors que l’appelant a déjà abandonné. Les nombres de retries fixes ignorent le temps, si bien qu’un intermédiaire peut continuer d’essayer même après l’expiration de la deadline de bout en bout. Ce travail est perdu et consomme de la capacité qui pourrait servir des requêtes encore dans leur budget. Avant chaque retry, vérifiez la deadline restante. S’il n’y a pas assez de temps pour que la tentative aboutisse, arrêtez. Les retries doivent tenir dans le budget de temps d’origine, pas l’étendre.
Backoff et jitter
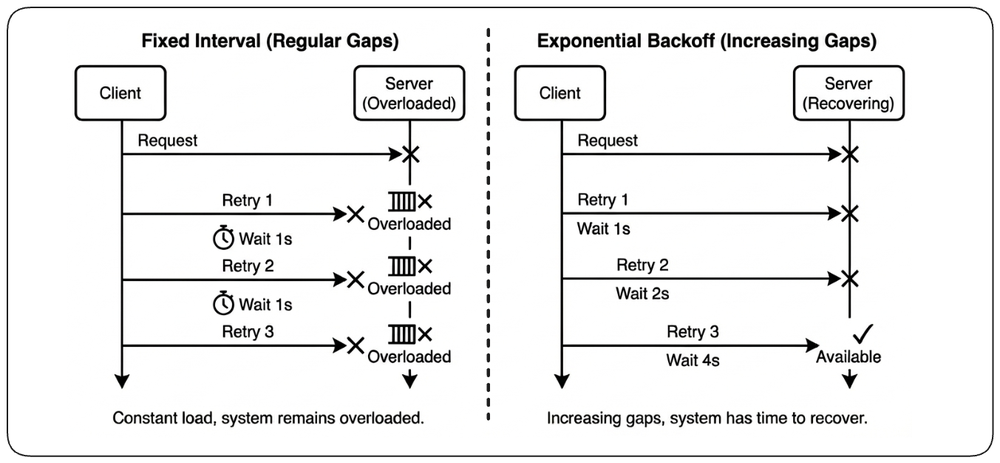
Les scénarios de retry résultent généralement d’une surcharge, d’un quota épuisé ou d’une indisponibilité temporaire ; quand réessayer compte donc autant que s’il faut réessayer. Le backoff exponentiel espace les tentatives pour laisser au système le temps de se rétablir au lieu de le marteler en continu. Le jitter rend ces délais aléatoires pour que les clients ne réessaient pas en rythme et ne créent pas de thundering herd. Quand le serveur fournit un header Retry-After, respectez-le — il reflète une information de rétablissement que le client ne peut pas déduire seul.
Pattern Circuit Breaker
Un circuit breaker arrête les appels vers une dépendance qui échoue de façon répétée. Une fois le seuil d’échecs atteint, le breaker s’ouvre et rejette immédiatement les nouveaux appels. Après un délai, il laisse passer un nombre limité de requêtes de sondage ; si elles réussissent, le trafic normal reprend. Cela évite que des appels répétés ne consomment des ressources et n’amplifient une panne.
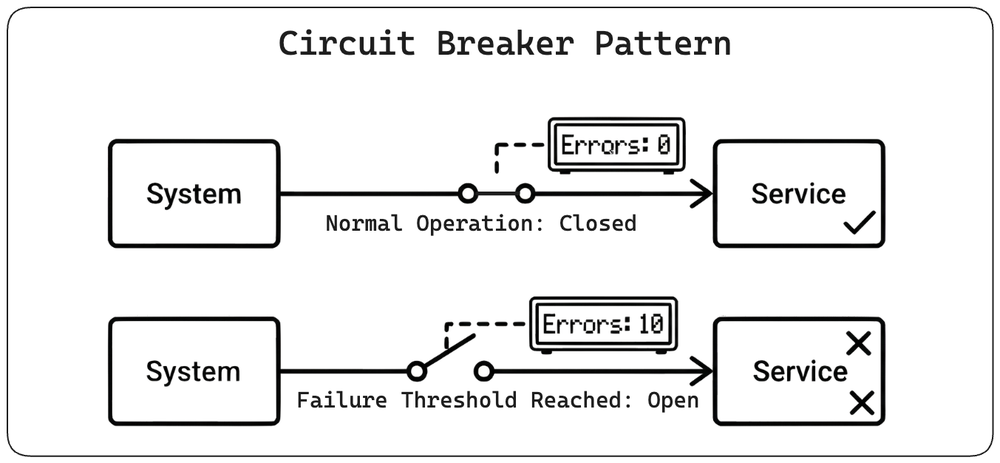
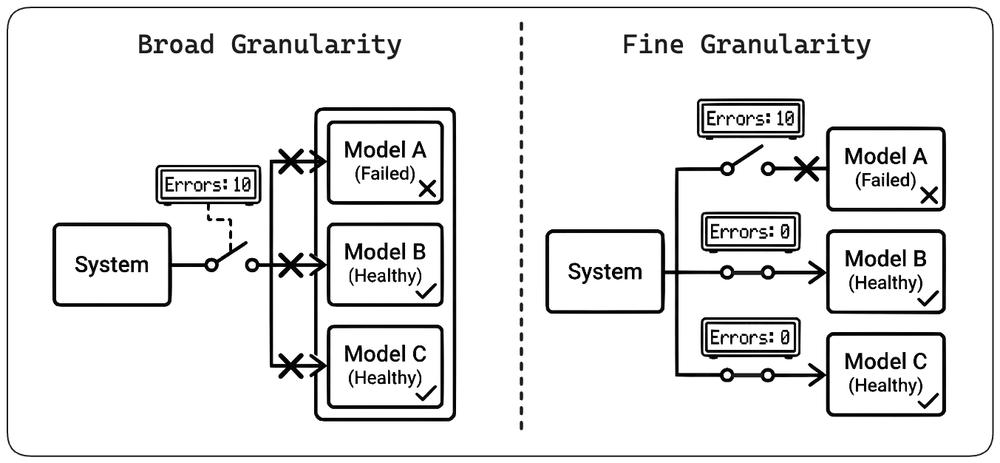
Granularité du circuit breaker
Un circuit breaker n’est efficace que par sa granularité. S’il protège plusieurs dépendances indépendantes, la défaillance de l’une peut bloquer l’accès à toutes, y compris celles en bonne santé. Par exemple, placer plusieurs modèles LLM derrière un seul circuit breaker signifie qu’un modèle déprécié ou défaillant peut empêcher les requêtes vers tous les autres modèles. Le circuit breaker, censé contenir la défaillance, l’amplifie à la place. Limitez le périmètre des circuit breakers à des endpoints, modèles ou instances de service individuels afin que les défaillances restent isolées et que les alternatives saines restent disponibles.
Pattern Hedging
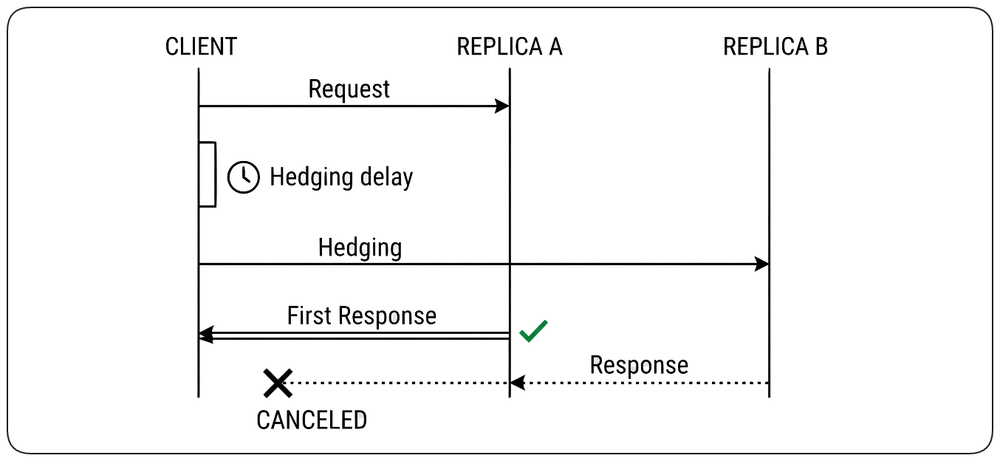
Le hedging réduit l’impact des réponses exceptionnellement lentes en envoyant une requête de secours avant que la requête d’origine n’ait échoué. L’appelant envoie la requête à un réplica, attend brièvement et — si aucune réponse n’est arrivée — envoie la même requête à un autre réplica. La première réponse réussie l’emporte, et l’autre requête est annulée. Le hedging doit être limité aux opérations idempotentes et aux réplicas indépendants, car les requêtes en double augmentent la charge.
Pattern Fallback
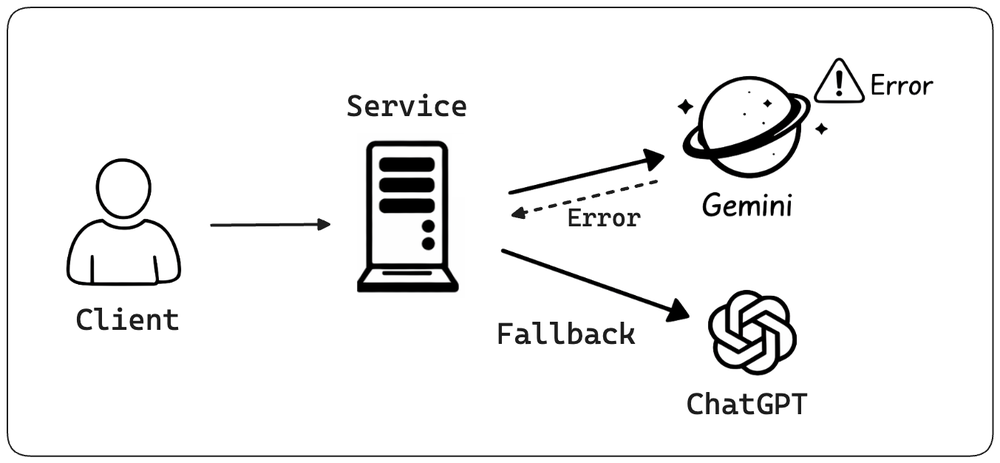
Le pattern fallback fournit une réponse alternative lorsque l’opération principale ne peut pas aboutir. Plutôt que de propager une erreur, le système renvoie un résultat acceptable — quoique dégradé — afin que les fonctionnalités essentielles restent disponibles. Les fallbacks peuvent renvoyer des données en cache ou périmées, des valeurs par défaut sûres, du contenu statique ou des réponses d’un service alternatif. La bonne stratégie dépend du compromis acceptable entre fraîcheur, exactitude et disponibilité.
Protection de la capacité
Même quand chaque composant se comporte correctement, un système peut échouer simplement parce que la demande dépasse sa capacité. Les patterns de protection de la capacité contrôlent la quantité de travail qui entre dans le système, isolent les workloads concurrents, propagent la saturation vers l’amont et écartent le travail qui ne peut pas être traité en toute sécurité. Leur but est de maintenir le système dans des limites soutenables au lieu de le laisser s’effondrer sous la surcharge.
Pattern Bulkhead
Le pattern bulkhead divise la capacité partagée en compartiments indépendants afin que l’épuisement d’un workload ne puisse pas tout consommer. Des thread pools, pools de connexions, files ou groupes d’instances séparés préservent la capacité pour le trafic non affecté lorsqu’une dépendance ou un workload devient lent.
Pattern Rate Limiting
Le rate limiting contrôle le nombre de requêtes qu’un client ou un service peut effectuer dans une fenêtre de temps donnée. En plafonnant le débit, il empêche tout acteur isolé de submerger le système, que ce soit par des attaques malveillantes, des clients défaillants ou des pics de trafic soudains. Lorsque les limites sont dépassées, le système renvoie une réponse 429 Too Many Requests, souvent accompagnée d’un header Retry-After indiquant quand réessayer.
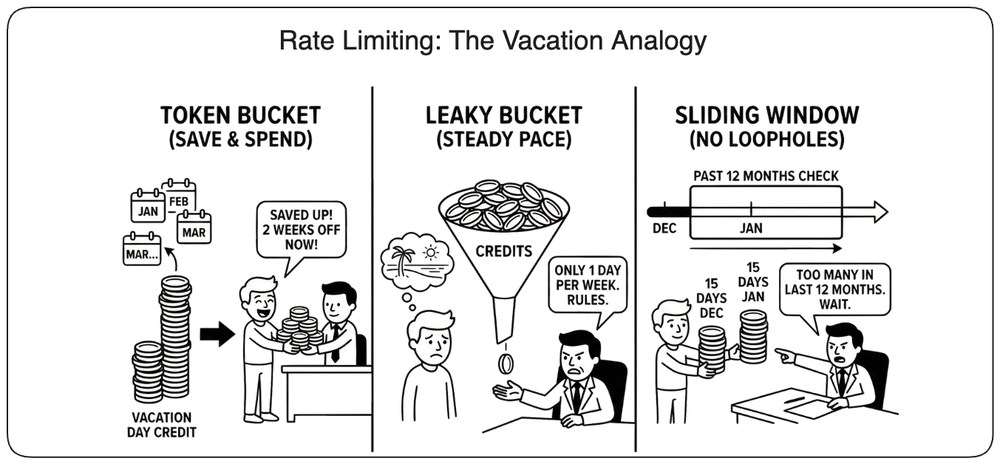
Algorithmes de rate limiting
Plusieurs algorithmes implémentent le rate limiting, chacun avec des compromis différents. Le Token Bucket autorise de courtes rafales tout en imposant un débit moyen stable. Le Leaky Bucket lisse le trafic en traitant les requêtes à un rythme constant. La Sliding Window suit les requêtes sur une période glissante, évitant les remises à zéro brutales des fenêtres fixes. En pratique, l’algorithme compte moins que de décider ce qu’il faut limiter (requêtes, octets, tokens, CPU) et où appliquer la limite (par utilisateur, tenant, endpoint ou globalement).
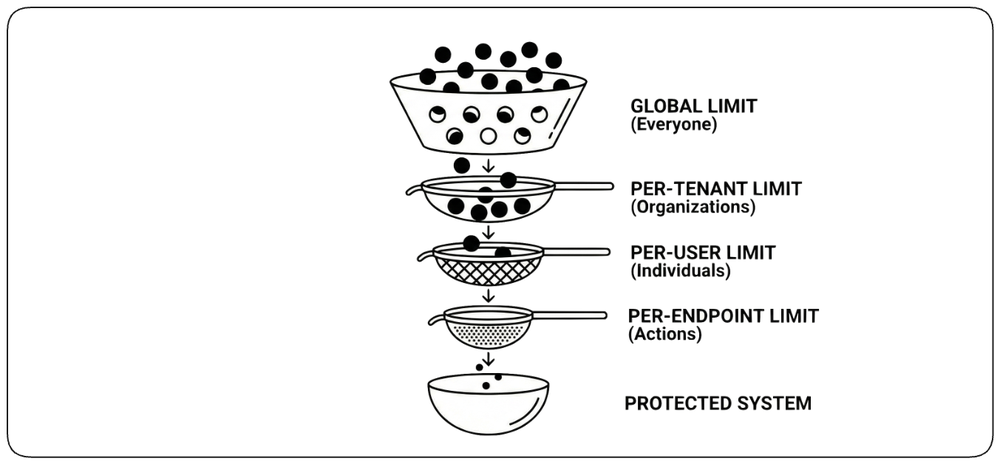
Granularité du rate limiting
L’efficacité du rate limiting dépend du choix du bon périmètre. Les limites par utilisateur empêchent des comptes individuels de monopoliser les ressources. Les limites par tenant contrôlent la consommation à l’échelle d’une organisation. Les limites par endpoint permettent une protection plus stricte des opérations coûteuses, tandis que les limites globales offrent une dernière ligne de défense pour l’ensemble du système. En pratique, combiner plusieurs niveaux offre la meilleure protection et la meilleure équité.
Limiter le travail, pas seulement les requêtes
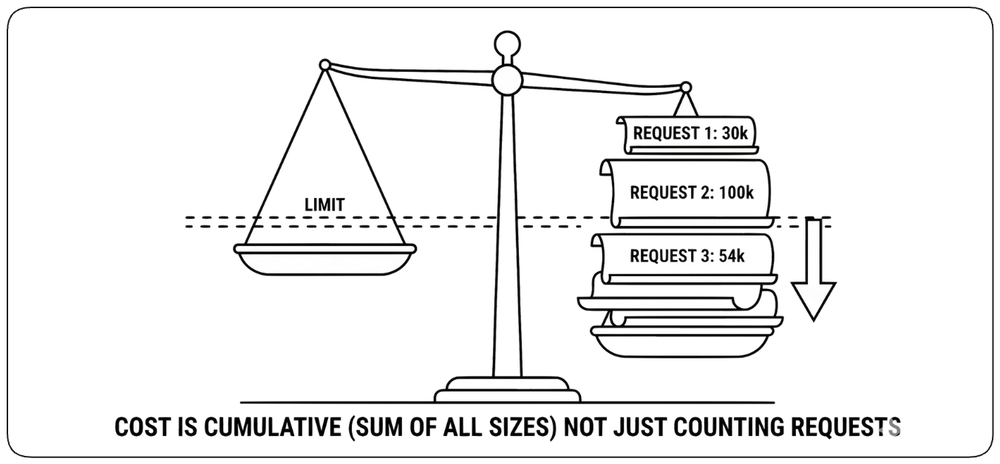
Compter uniquement les requêtes suppose que chaque requête coûte autant, ce qui est souvent faux. Une petite lecture et une requête de base de données complexe — ou un court prompt LLM et un très long — peuvent consommer des ressources très différentes. Quand le coût des requêtes varie fortement, limitez plutôt l’unité de travail réelle : octets transférés, coût de la requête, temps CPU ou tokens générés. Les services LLM ont popularisé cette approche en limitant les tokens par minute plutôt que les requêtes par minute, mais le principe s’applique dès que le nombre de requêtes est un mauvais indicateur de la consommation de ressources.
Pattern Backpressure
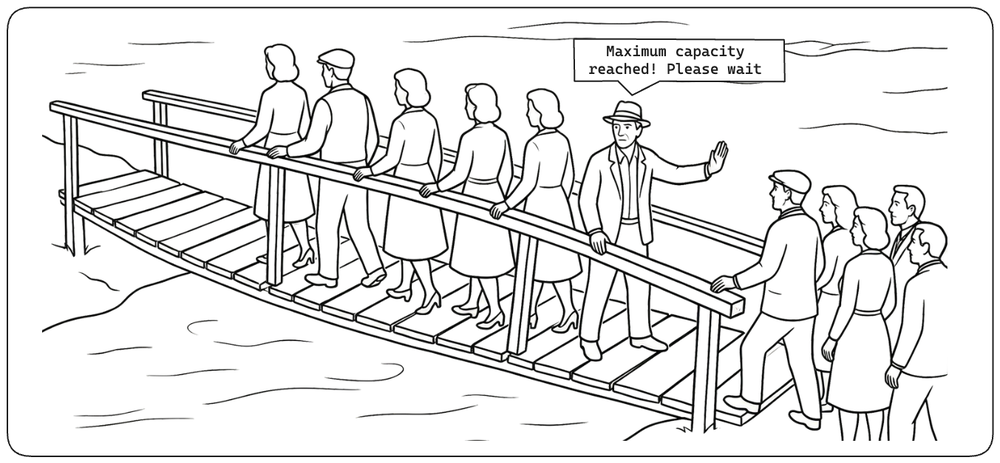
Le backpressure est un mécanisme de contrôle de flux par lequel les services en aval signalent leurs limites aux producteurs en amont. Au lieu d’accepter un travail qu’il ne peut pas traiter, un service surchargé ralentit ou rejette le trafic entrant afin que la pression se propage en sens inverse à travers le système. Contrairement au rate limiting, qui impose un plafond prédéfini, le backpressure s’adapte à la capacité en temps réel. Cela évite les files non bornées, l’épuisement de la mémoire et les timeouts en cascade tout en maintenant le débit dans des limites soutenables.
Implémenter le backpressure
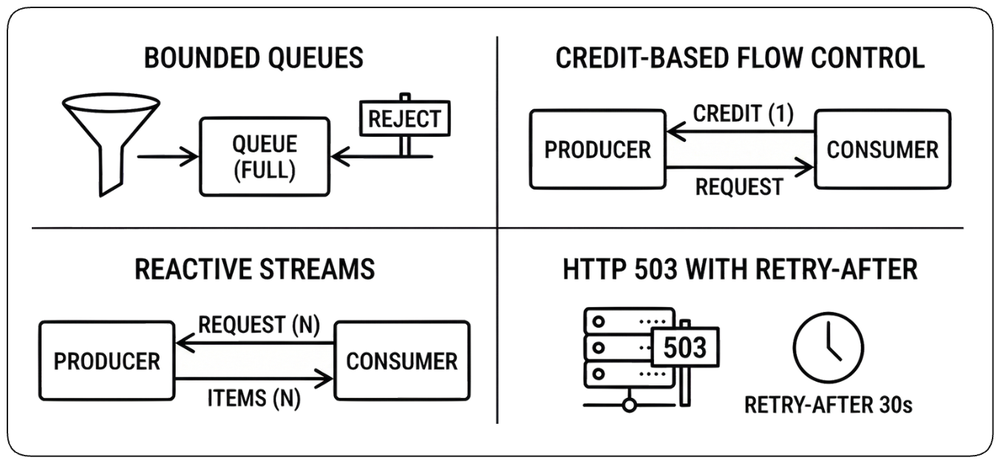
Le backpressure peut être implémenté via des files bornées qui rejettent les requêtes à pleine capacité, un contrôle de flux à base de crédits où les consommateurs accordent des tokens aux producteurs, des frameworks de reactive streams qui laissent les consommateurs ne tirer que ce qu’ils peuvent traiter, ou des réponses HTTP 503 avec des headers Retry-After. La distinction clé avec le rate limiting : le backpressure est adaptatif et bidirectionnel, et reflète l’état du système en temps réel plutôt que des seuils statiques.
Pattern Load Shedding
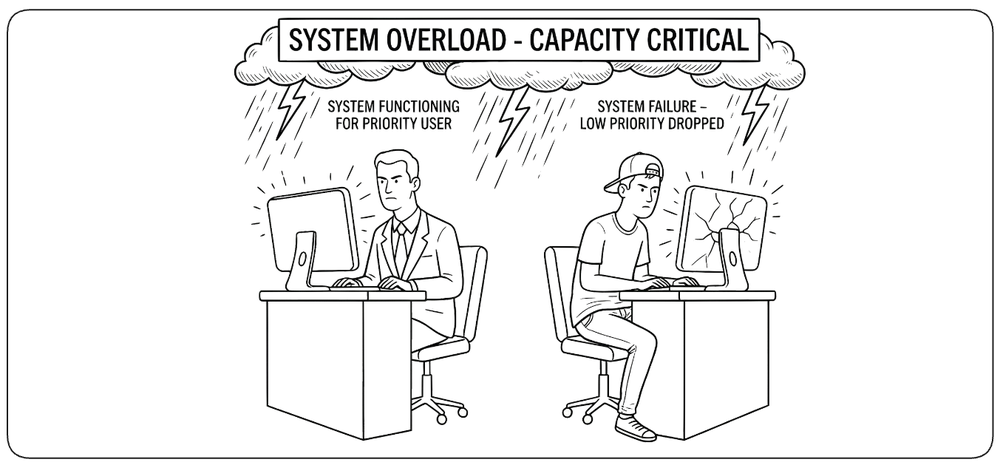
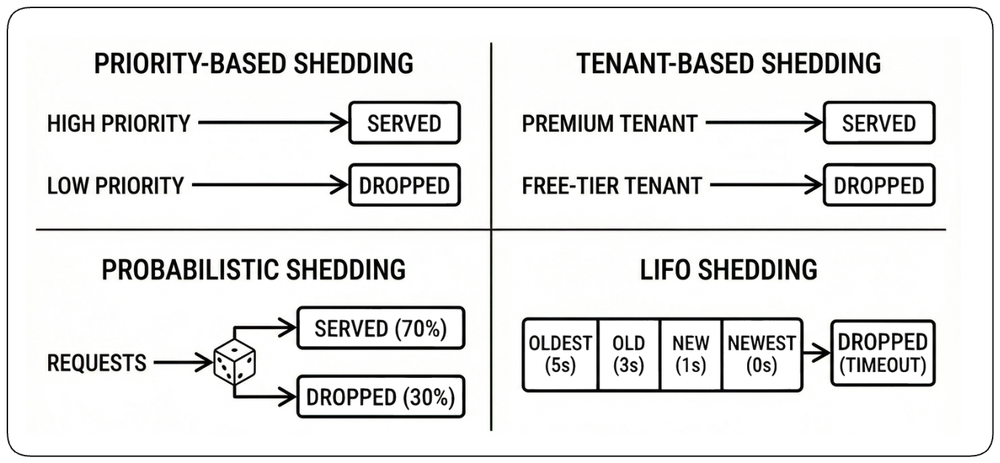
Le load shedding écarte délibérément les requêtes de faible priorité en cas de surcharge afin de préserver la capacité pour les opérations critiques. Quand un système ne peut pas absorber tout le trafic entrant, il vaut mieux servir avec succès les requêtes importantes que de faire échouer tout le monde de la même façon.
Stratégies de shedding
Un load shedding efficace commence par décider quoi écarter en premier. Les requêtes peuvent être priorisées par importance, par tenant ou par probabilité, afin de préserver les opérations critiques en sacrifiant le travail de moindre valeur. Une autre stratégie utile est le shedding basé sur l’âge : si une requête a déjà dépassé la deadline utile de l’appelant, la traiter ne fait que gaspiller de la capacité. Le load shedding doit toujours renvoyer un signal clair — typiquement un HTTP 503 avec un header Retry-After — pour que les clients patientent au lieu de créer des retry storms.
Disponibilité et résilience des données
Certaines défaillances touchent plus qu’une seule requête : une instance plante, une région devient indisponible ou un état durable est menacé. Ces patterns protègent la disponibilité à long terme et l’intégrité des données grâce à la réplication, au failover, à la réparation et à la reprise coordonnée. Leur but est de garder le service joignable et le système cohérent malgré des défaillances d’infrastructure ou de stockage.
Définir ce que l’on peut perdre : RTO et RPO
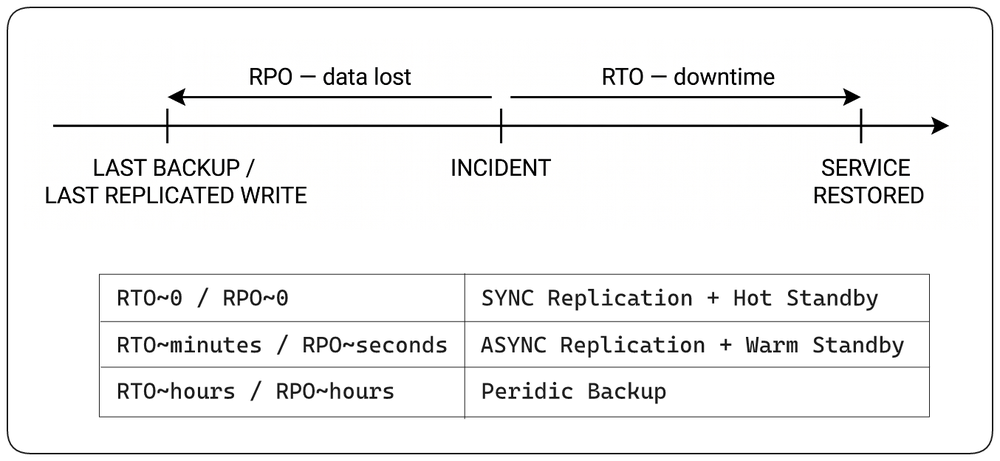
Avant de choisir une stratégie de failover ou une politique de sauvegarde, définissez ce que le business peut se permettre de perdre. Le RTO (Recovery Time Objective) est l’indisponibilité maximale acceptable, tandis que le RPO (Recovery Point Objective) est la perte de données maximale acceptable. Ces deux objectifs guident chaque décision de résilience — de la stratégie de réplication et de la configuration des standbys à la fréquence des sauvegardes. Sans cibles claires de RTO et de RPO, les équipes sur-ingénient la résilience ou sous-protègent les systèmes critiques.
Failover et réplication
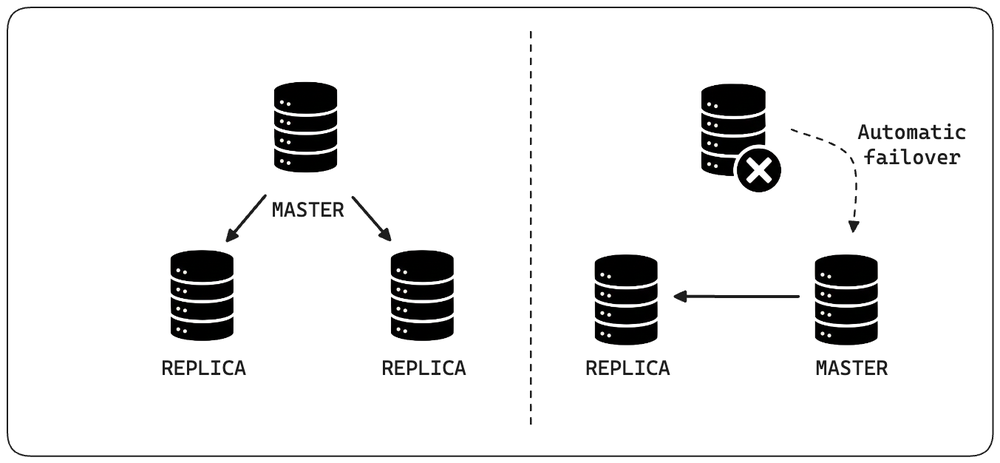
Le failover redirige le trafic vers une instance saine lorsqu’une instance tombe ; la réplication garantit qu’il existe une autre copie de l’état vers laquelle basculer. Si une base de données primaire tombe, un réplica est promu et le trafic est redirigé. Le failover réduit l’indisponibilité, mais il est rarement transparent : de brèves erreurs peuvent survenir, certaines données en transit peuvent être perdues selon le mode de réplication, et les conceptions médiocres peuvent encore souffrir de split-brain. L’objectif n’est pas zéro perturbation, mais une perturbation qui reste dans les objectifs de RTO et de RPO du système.
Domaines de défaillance géographiques
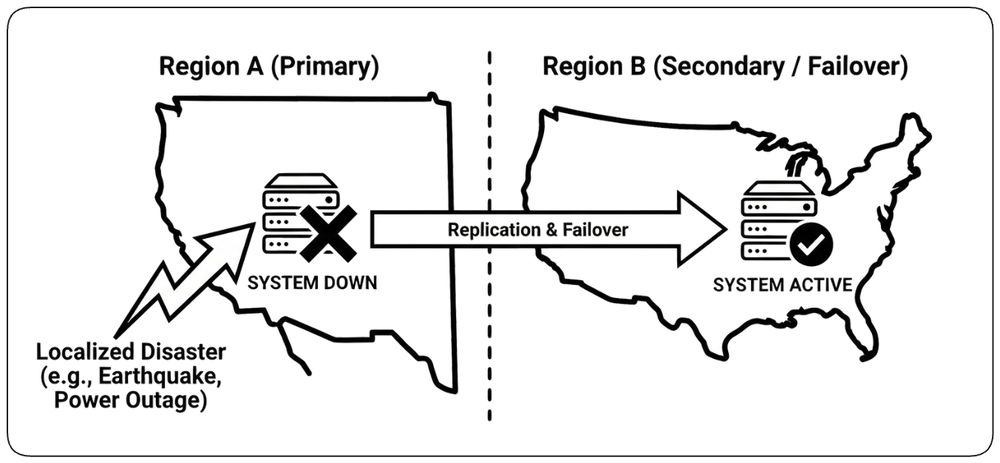
Les domaines de défaillance géographiques répartissent les services et les données critiques sur des régions ou des data centers indépendants, afin que la défaillance d’un site n’entraîne pas tout le système. La réplication inter-régions permet le failover lorsqu’un site entier devient indisponible à cause de pannes d’infrastructure, de réseau ou régionales. La redondance géographique se justifie lorsque les objectifs de disponibilité business, les objectifs de reprise après sinistre ou les exigences réglementaires ne peuvent pas être atteints depuis un seul site.
Réparation des réplicas
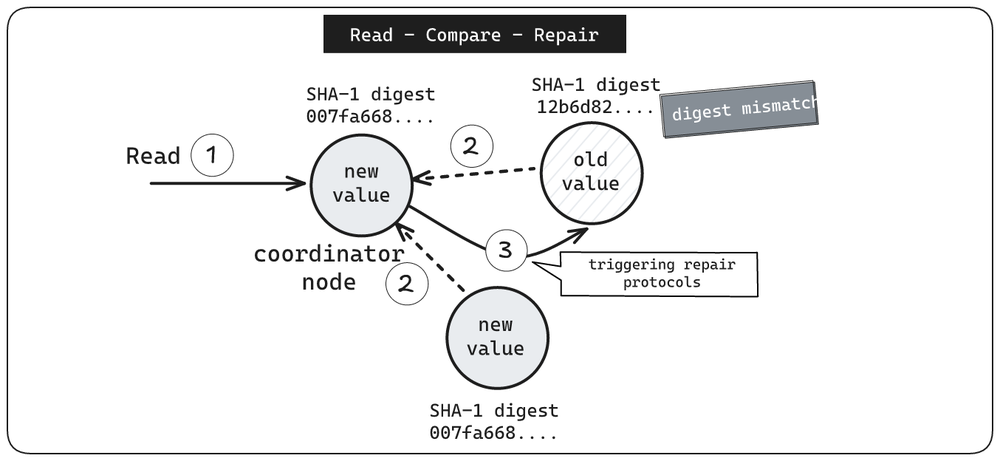
Quand les données sont répliquées, les réplicas finissent inévitablement par se désynchroniser à cause d’écritures perdues, de partitions réseau ou de défaillances de nœuds. À chaque lecture, le coordinateur interroge les autres réplicas, compare leurs valeurs et répare au passage ceux qui sont en retard. La réparation est un effet de bord de la lecture : pas de scan périodique, pas d’intervention manuelle — les réplicas convergent vers le même état au fil du trafic qui les traverse.
Exploiter des systèmes résilients
Concevoir pour la résilience n’est qu’un début. Un système résilient doit rester observable, testable, récupérable et maintenable à mesure qu’il évolue en production. Les pratiques de cette section vérifient que les mécanismes de reprise fonctionnent toujours, détectent tôt la dégradation et transforment la reprise, d’une réponse improvisée, en une capacité éprouvée.
La maintenabilité permet la résilience
Maintenabilité et résilience se renforcent mutuellement. Les systèmes difficiles à comprendre, à modifier ou à déboguer deviennent fragiles, car les incidents prennent plus de temps à diagnostiquer et les mécanismes de reprise deviennent plus difficiles à faire évoluer en toute sécurité. Un code clair, des frontières explicites et des chemins de reprise simples facilitent l’investigation et la correction des défaillances. La dette technique est aussi une dette de résilience : chaque raccourci qui rend un système plus difficile à changer le rend aussi plus difficile à rétablir et à améliorer.
Les health checks sont des signaux de contrôle
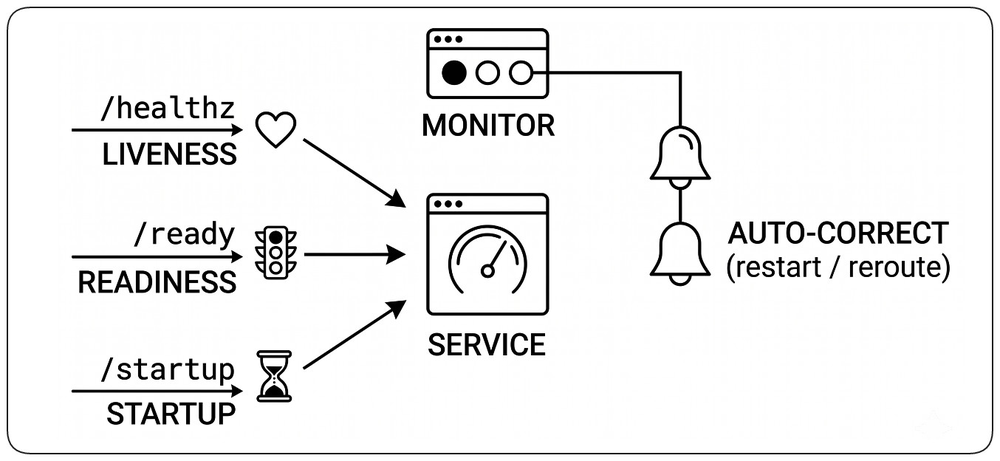
Les health checks ne sont pas de simples signaux d’observabilité ; ce sont des entrées de boucles de contrôle automatisées. Les plateformes s’en servent pour décider si une instance doit démarrer, recevoir du trafic, rester en service ou être redémarrée. Parce que ces signaux influencent directement le comportement du système, ils doivent être conçus avec soin. La section suivante explique les rôles distincts des checks de startup, de readiness et de liveness, et pourquoi les confondre peut créer des défaillances au lieu de les corriger.
Types de health checks
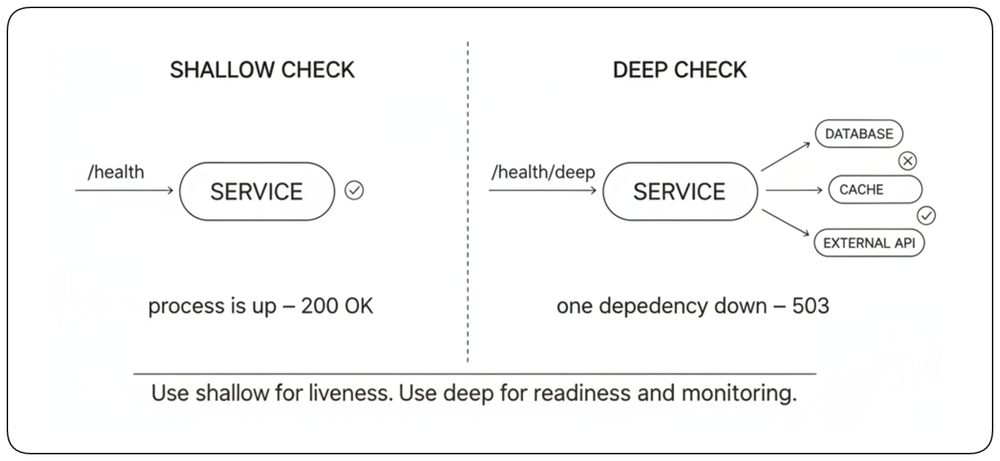
Chaque health check répond à une question opérationnelle différente : Liveness : le processus fonctionne-t-il encore ? Un check en échec peut déclencher un redémarrage. Gardez-le local et simple ; les défaillances de dépendances ne doivent pas faire paraître le processus mort. Readiness : cette instance peut-elle traiter du trafic en toute sécurité maintenant ? Un check en échec la retire de la rotation sans la redémarrer. Startup : l’initialisation est-elle terminée ? Cela empêche les checks de liveness de tuer des applications à démarrage lent avant qu’elles ne soient prêtes.
Health checks superficiels vs profonds
Les checks superficiels (shallow) ne vérifient que le processus local. Ils sont rapides, fiables et conviennent le mieux aux checks de liveness. Les checks profonds (deep) vérifient aussi les dépendances comme les bases de données ou les services externes. Ils offrent de meilleurs diagnostics mais ne doivent généralement pas déclencher de redémarrages, car la défaillance d’une dépendance ne signifie pas nécessairement que le processus lui-même est en mauvaise santé. Utilisez les checks profonds pour la readiness et le monitoring.
Les SLOs guident l’investissement en résilience
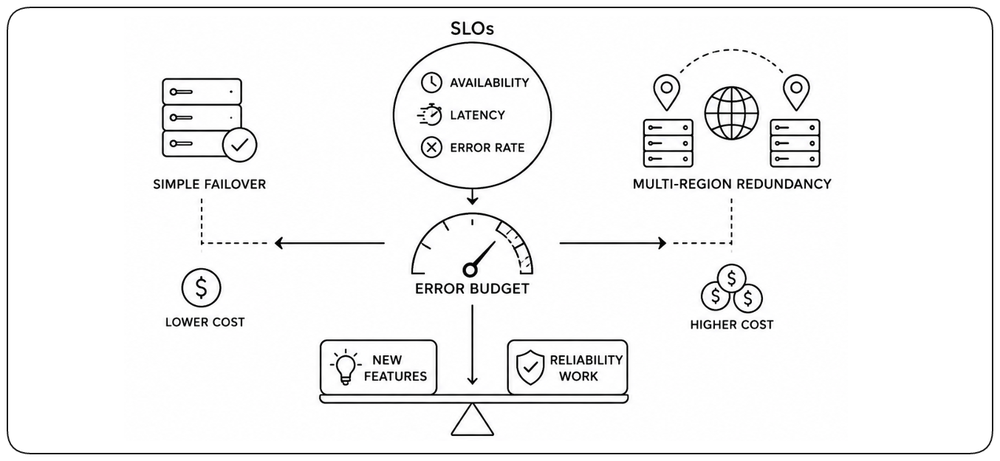
Les Service Level Objectives (SLOs) définissent la fiabilité dont les utilisateurs ont besoin en termes de disponibilité, de latence et de taux d’erreurs. Avec l’error budget, ils déterminent quelle résilience est justifiée — du simple failover à la redondance multi-régions — et quand le travail de fiabilité doit passer avant les nouvelles fonctionnalités. Sans SLO, les investissements en résilience relèvent de la conjecture.
En savoir plus
Chapitre : Design for Visibility — SLIs, alertes sur le taux de consommation et toute la mécanique d’erreur-budget/SLO.
Chaos engineering
Le chaos engineering est une méthode contrôlée pour tester les hypothèses de résilience. Chaque expérience commence par une hypothèse d’état stable mesurable, injecte une défaillance précise et plausible dans un blast radius limité, et définit une condition d’abandon avant le début du test. L’objectif n’est pas de casser le système, mais de découvrir si la détection, le confinement, la dégradation et la reprise se comportent comme prévu. Les constats doivent alimenter directement l’architecture, l’automatisation, les tests et les runbooks. Le chaos engineering transforme « espérer le meilleur » en « savoir comment le système réagira ».
Tester la dégradation, pas seulement la panne
La plupart des incidents réels !!commencent par une dégradation progressive!!, pas par une panne franche. La latence DNS augmente peu à peu, une zone de disponibilité perd une partie de sa capacité, le jitter réseau monte, le taux d’erreurs d’une dépendance passe de 0,1 % à 5 %. Ces !!défaillances grises!! sont plus difficiles à détecter qu’un crash et mettent souvent en échec des systèmes qui n’ont été testés que face à une perte totale. Les expériences de chaos doivent injecter des défaillances lentes, partielles et asymétriques — latence ajoutée, perte de paquets, réplicas dégradés, dépendances throttlées — et pas seulement des interrupteurs d’arrêt.

Reprise après sinistre exécutable
La reprise après sinistre doit être conçue avant d’être nécessaire, et exécutable le moment venu. À partir des cibles de RTO et de RPO, le plan doit définir les responsabilités, les canaux de communication, l’ordre de restauration, les points de décision et les étapes de validation. Les procédures de failover, de restauration et de redémarrage doivent être codifiées, versionnées et exercées régulièrement. L’automatisation réduit la variabilité et les erreurs humaines, tandis que les opérateurs restent responsables de lancer, d’observer et de valider la reprise.
Tester et répéter la reprise
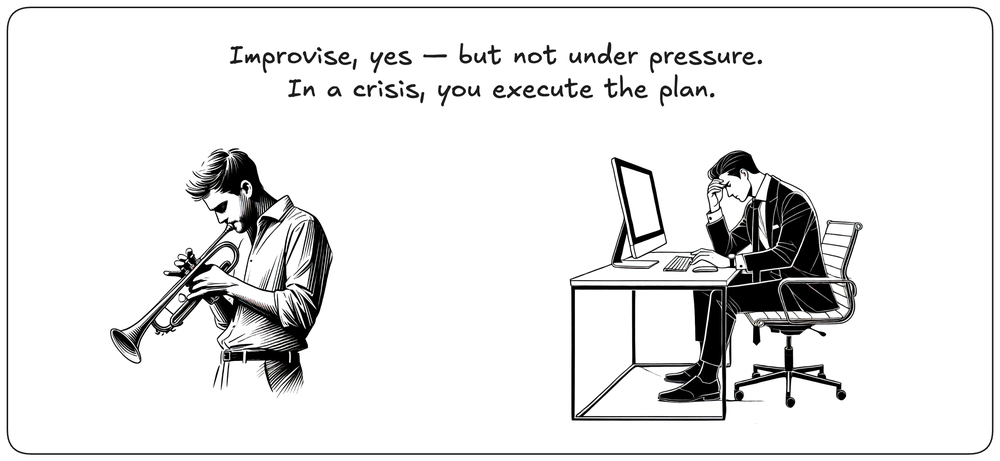
Un plan de reprise qui n’a jamais été exécuté reste une hypothèse. Les game days, failovers planifiés et exercices de restauration révèlent identifiants périmés, dépendances manquantes, runbooks obsolètes et dérive de l’automatisation avant un vrai incident. La répétition donne aussi aux opérateurs une familiarité pratique avec le chemin de reprise.
La reprise appartient à des opérateurs entraînés
La reprise doit être menée par des personnes qui comprennent déjà le système ou qui ont répété la procédure. Un runbook est nécessaire, mais il ne peut pas remplacer la familiarité opérationnelle. Le groupe responsable peut inclure l’équipe propriétaire, des ingénieurs d’astreinte formés et des spécialistes qui ont pratiqué le chemin de reprise. L’incident ne doit pas être leur premier contact avec le système.
Apprendre des défaillances
Les défaillances sont inévitables dans les systèmes complexes, mais elles ne doivent jamais être gaspillées. Examinés avec soin, les incidents révèlent des hypothèses cachées, des choix de conception fragiles, des pratiques opérationnelles faibles et des angles morts organisationnels. Apprendre de la défaillance est ce qui transforme une panne, d’une perturbation passagère, en une amélioration durable de la façon dont le système est conçu, exploité et compris.
Revue d’incident
Une revue d’incident — souvent appelée post-mortem — est le processus structuré qui transforme un incident en améliorations concrètes. Son but n’est pas de trouver un coupable, mais de décider ce qui doit changer pour que la même défaillance soit moins probable, ait moins d’impact, ou puisse être détectée et rétablie plus vite. Bien menées, les revues d’incident produisent des actions priorisées, renforcent l’appropriation partagée et convertissent des événements douloureux en travail concret de résilience.
La revue d’incident comme opportunité
Les incidents rendent visibles des risques cachés. Pendant la livraison normale, signaux faibles, risques reportés, responsabilités floues, dépendances fragiles et frictions entre équipes restent souvent implicites, car les équipes sont occupées à faire avancer le système. La revue d’incident crée un espace protégé pour mettre ces préoccupations sur la table, sur la base de preuves plutôt que d’opinions. Cela ne fonctionne que si la discussion est assez sûre pour que chacun explique ce qu’il a vu, ce qu’il a supposé et pourquoi ses décisions avaient du sens à l’époque.
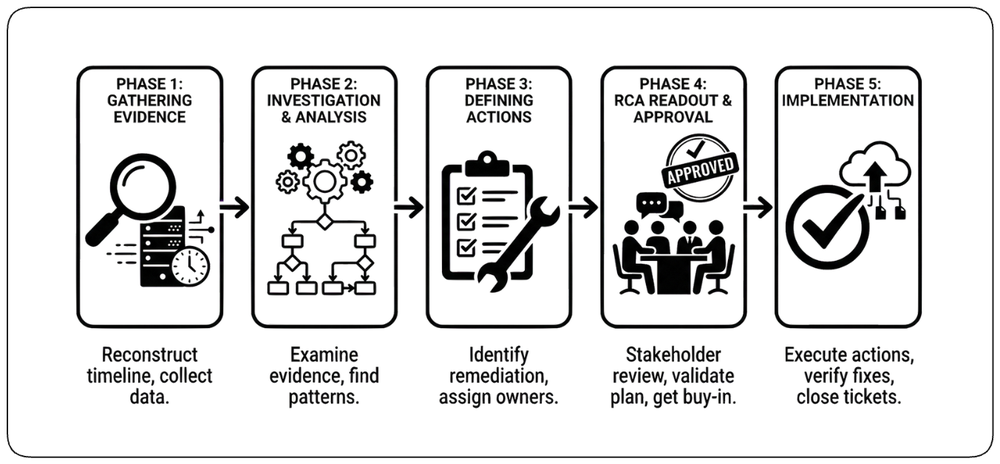
Les cinq phases de la revue d’incident
Une revue d’incident structurée suit cinq phases : collecter les preuves, réaliser l’analyse des causes racines, définir des actions avec responsables et priorités, relire et aligner les parties prenantes, et assurer le suivi jusqu’à la clôture des actions.
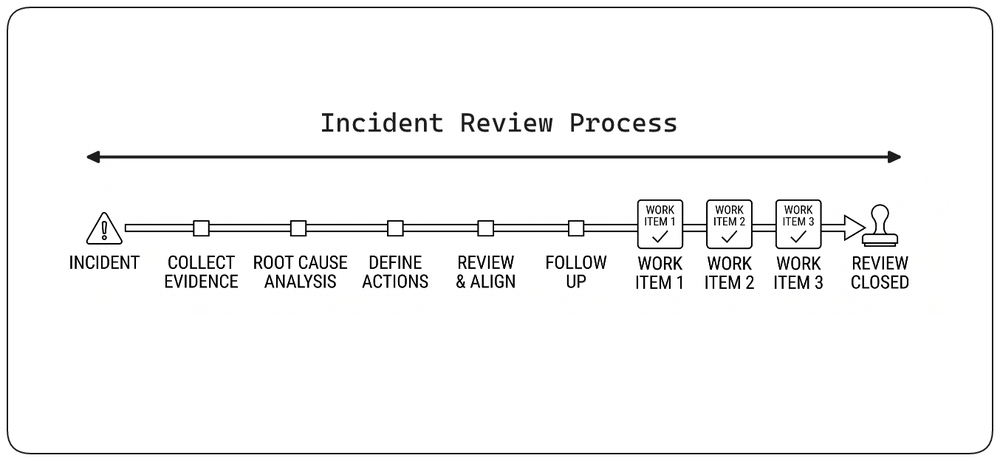
Une revue d’incident est un processus, pas une réunion
Une revue d’incident est un processus, pas seulement une réunion. Elle commence avec l’incident et se termine lorsque les work items correspondant aux lacunes identifiées sont clos. L’organisation doit définir une durée maximale recommandée pour ce processus. Les changements structurels plus importants, comme la refonte d’un service ou le sharding d’une base de données, doivent passer dans le backlog d’ingénierie normal avec un responsable et une priorité clairs.
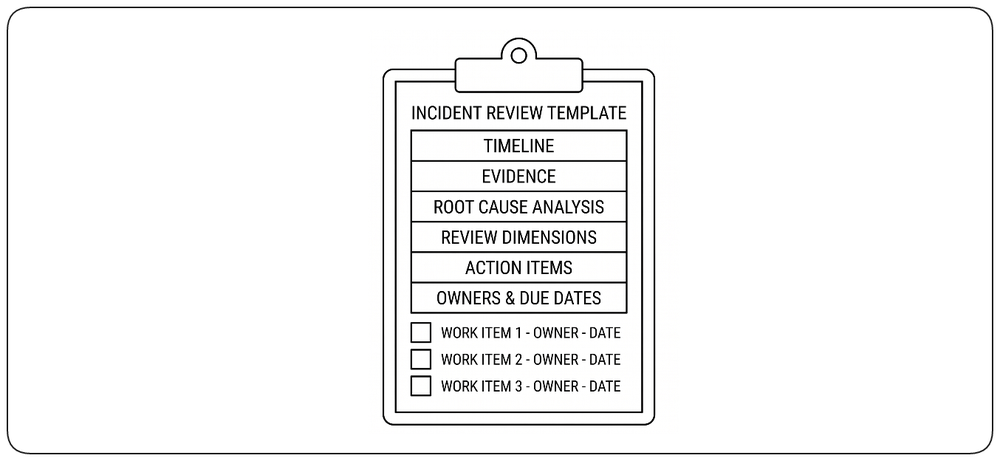
Le template de revue d’incident
Une revue d’incident doit être guidée par un document template partagé qui garde la discussion ciblée, factuelle et complète. Sans structure, les équipes peuvent sauter sur la première explication, éviter les sujets inconfortables ou se concentrer trop sur le bug déclencheur. Un bon template guide tout le processus : chronologie, preuves, analyse des causes racines, actions, responsables et dates. Le template est un outil opérationnel, pas seulement une mise en page. Il garde la discussion factuelle et sûre, rend les revues plus faciles à comparer, réduit les angles morts et transforme les lacunes identifiées en travail suivi.
Commencer par une chronologie factuelle
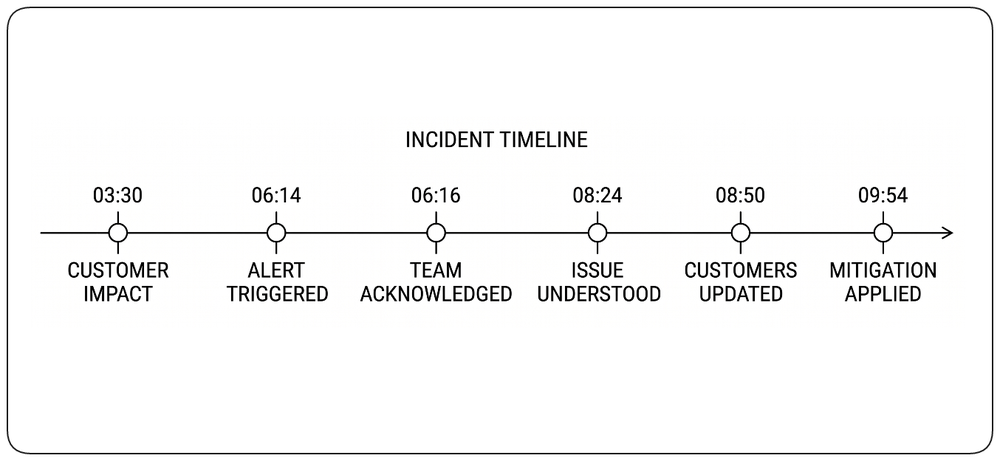
La revue d’incident commence par la reconstitution la plus objective possible de la séquence d’événements. La chronologie doit indiquer quand le problème a commencé, quand les clients ont été touchés, quand les alertes se sont déclenchées, quand les personnes s’en sont aperçues, quelles actions ont été menées et quand le service s’est rétabli. Elle doit être construite à partir de preuves : données de monitoring, logs, déploiements, chat d’incident, communications clients, tickets de support, emails et mises à jour de la status page.
Comparer les métriques de l’incident aux cibles
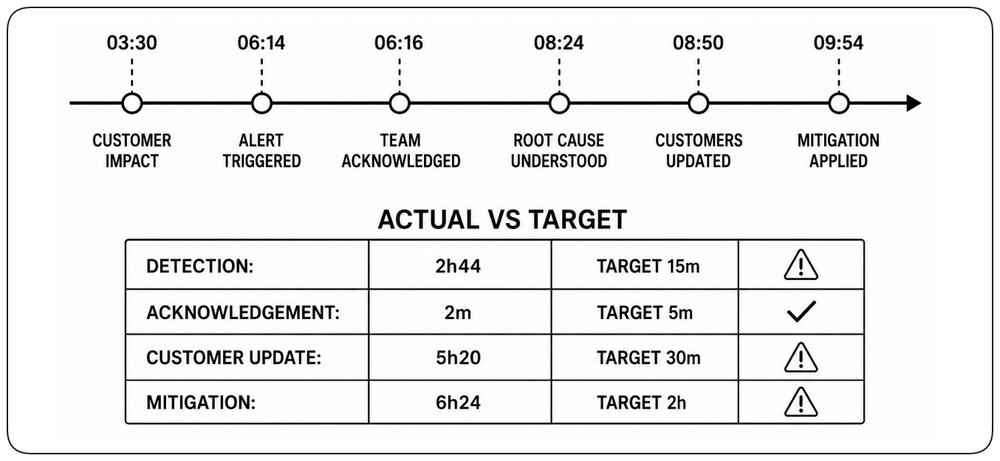
Une fois la chronologie claire, l’équipe peut comparer l’incident aux cibles attendues par l’organisation. Ces cibles définissent ce qui est acceptable pour l’impact client, le délai de détection, l’escalade, la communication, la mitigation, le temps de reprise, le taux d’erreurs, la perte de données ou toute autre mesure pertinente. Cette analyse se déroule en parallèle de l’analyse des causes racines : elle demande où la réponse a été insuffisante et pourquoi. Pourquoi l’équipe a-t-elle remarqué l’incident tard ? Pourquoi la mitigation a-t-elle pris autant de temps une fois le problème compris ? Pourquoi les clients ont-ils été informés trop tard ? Les réponses créent des work items pour les alertes, dashboards, runbooks, outils, formation, communication et processus d’exploitation.
Trouver les causes racines à travers les dimensions
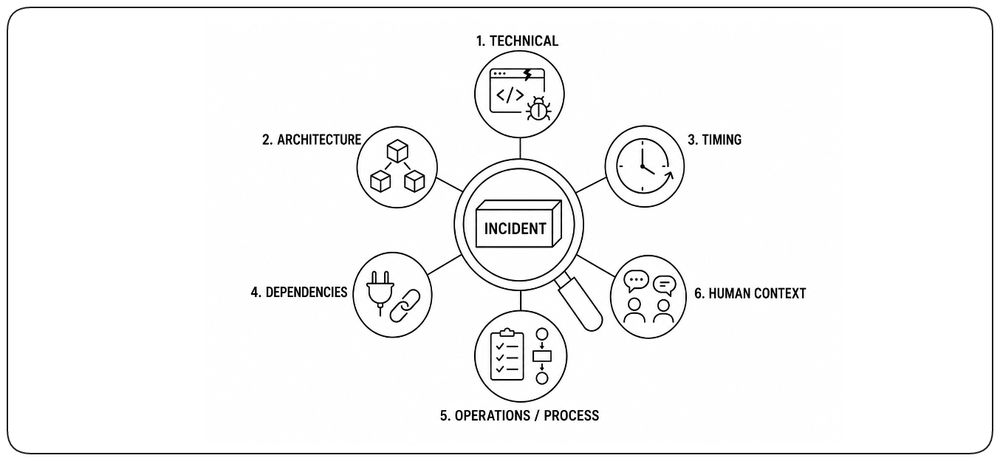
L’analyse des causes racines explique pourquoi l’incident s’est produit, pourquoi il a eu un impact et quels facteurs lui ont permis de se dérouler. La revue doit être guidée par des questions concrètes pour chaque dimension pertinente — causes techniques, résilience architecturale, timing, dépendances, opérations et processus, contexte humain — afin d’aider les participants à réfléchir eux-mêmes à l’incident et à explorer des pistes auxquelles ils n’auraient pas pensé.
Toutes les dimensions ne se valent pas : la résilience architecturale
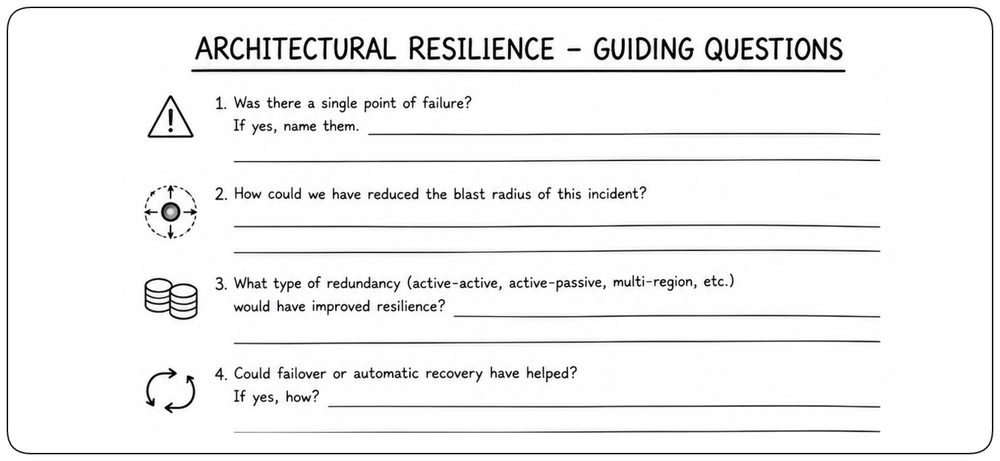
Certaines dimensions améliorent la façon dont les équipes répondent aux incidents. La résilience architecturale améliore la façon dont le système se comporte pendant les incidents. Cette différence explique pourquoi toutes les dimensions n’ont pas le même effet de levier : les améliorations de la réponse réduisent le temps de détection, de coordination et de reprise, tandis que les améliorations architecturales peuvent réduire la probabilité ou l’impact de toute une classe d’incidents. Bugs, alertes tardives et lacunes de processus peuvent déclencher un incident, mais des faiblesses comme le couplage fort, l’isolation manquante ou les points de défaillance uniques déterminent souvent son impact final.
Contexte humain et processus
Les facteurs humains et d’équipe sont souvent évités parce qu’ils peuvent créer des tensions. Il est plus facile, et généralement plus sûr, de se concentrer sur le bug, l’architecture ou la dépendance. Mais les incidents exposent aussi des lacunes de communication, des responsabilités floues, de la pression, de la charge cognitive et des processus qui rendaient le chemin sûr plus difficile que le chemin risqué. La revue doit aborder ces facteurs avec des questions neutres et fondées sur les faits, afin que l’équipe puisse améliorer sa façon de travailler sans transformer la discussion en recherche de coupable.
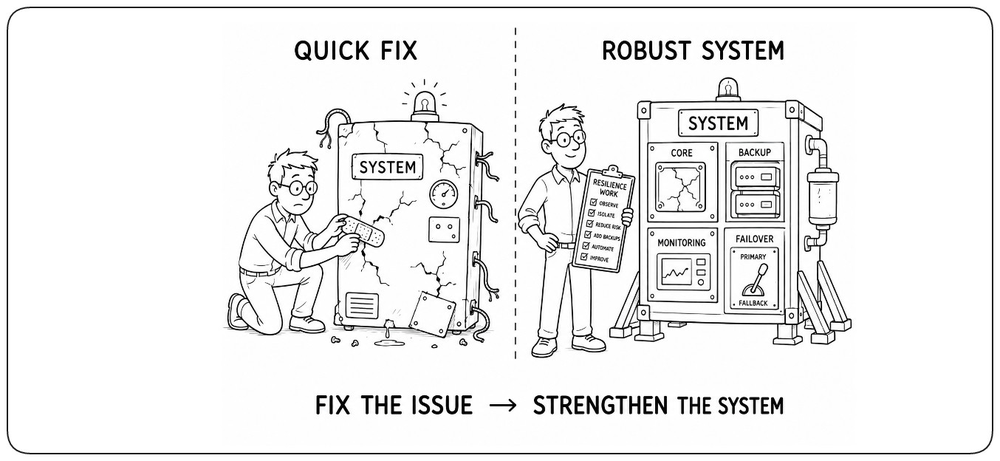
De la correction de problèmes à la construction de systèmes robustes
Une revue d’incident doit faire plus que produire des actions. Les meilleures revues ne se contentent pas de résoudre l’incident ; elles laissent le système fondamentalement plus solide qu’avant. Cela signifie regarder au-delà du défaut déclencheur et améliorer l’isolation, l’observabilité, la scalabilité, les mécanismes de reprise et la préparation opérationnelle. Un système robuste n’est pas un système qui ne tombe jamais, mais un système qui défaille en douceur et se rétablit de façon prévisible.
Analyse des patterns d’incidents
Les revues d’incident individuelles expliquent ce qui s’est passé une fois ; l’analyse de patterns révèle ce qui se répète. En classant les incidents de façon cohérente et en les comparant dans le temps, les équipes peuvent découvrir des faiblesses récurrentes qu’aucune revue isolée ne ferait apparaître. Il peut s’agir de patterns temporels, comme des défaillances regroupées autour des déploiements, des migrations ou des pics de trafic, ou de patterns structurels, comme des incidents répétés dans le même composant, la même dépendance, le même tenant, la même région ou le même workflow opérationnel. Le but est de transformer une collection d’incidents isolés en preuves en faveur d’améliorations architecturales et opérationnelles plus larges.