Concevoir pour la performance
Chapter Info
Calculating... Writing Progress: 90%
La performance désigne l’efficacité avec laquelle un système transforme du temps et des ressources en travail utile. Cela peut signifier répondre à une requête en quelques millisecondes, traiter des millions d’événements par seconde, terminer un calcul dans un délai imparti ou soutenir une charge sans saturation. Ce que « assez rapide » veut dire dépend du système, mais cela doit toujours se définir par rapport à une charge de travail et à un objectif mesurable.
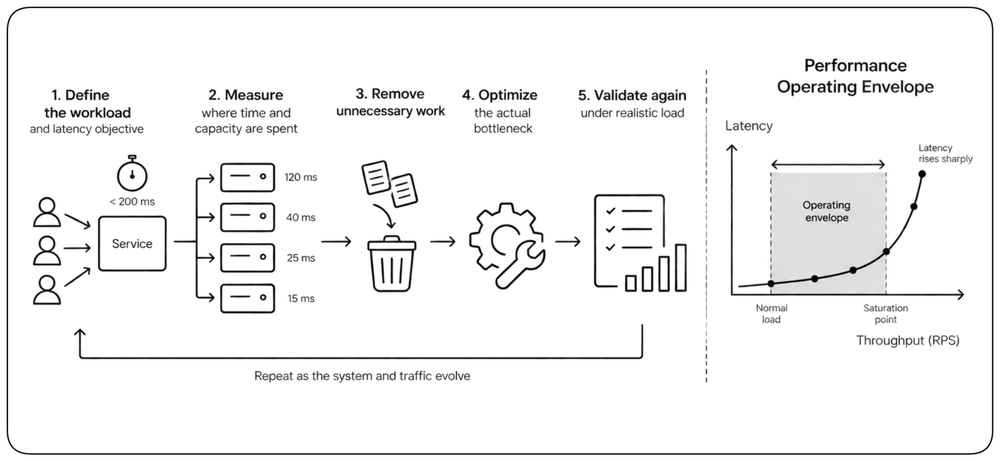
Concevoir pour la performance, c’est comprendre où le temps et les ressources sont dépensés, identifier ce qui limite le système et améliorer les parties qui comptent vraiment. Ce chapitre développe cette discipline : définir la cible de performance, mesurer le système dans des conditions réalistes, éliminer le travail inutile, optimiser le goulot d’étranglement et valider le résultat à mesure que la charge augmente.
Les fondations de la performance
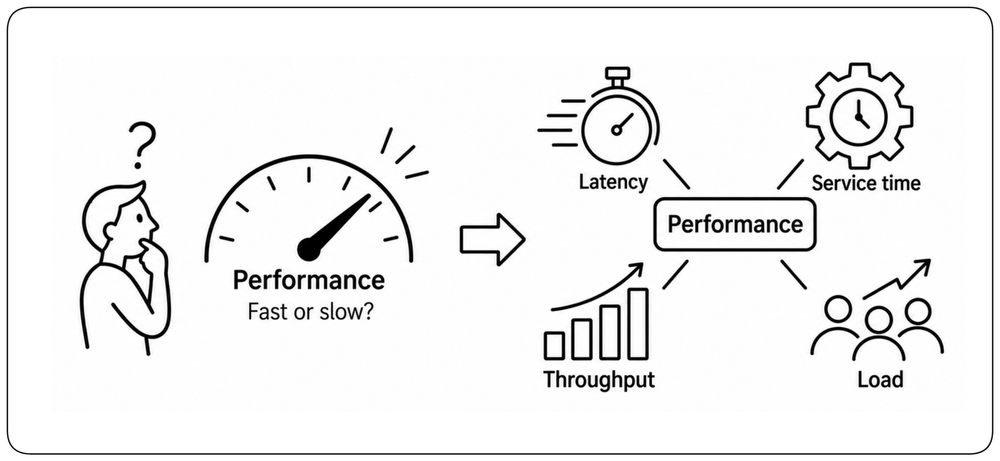
La performance ressemble à une métrique unique — rapide ou lent — mais la réalité est une constellation d’attributs. La latence, le temps de service, le débit et la charge interagissent, et la bonne cible dépend entièrement de ce que le système doit accomplir.
Ce que promet la performance
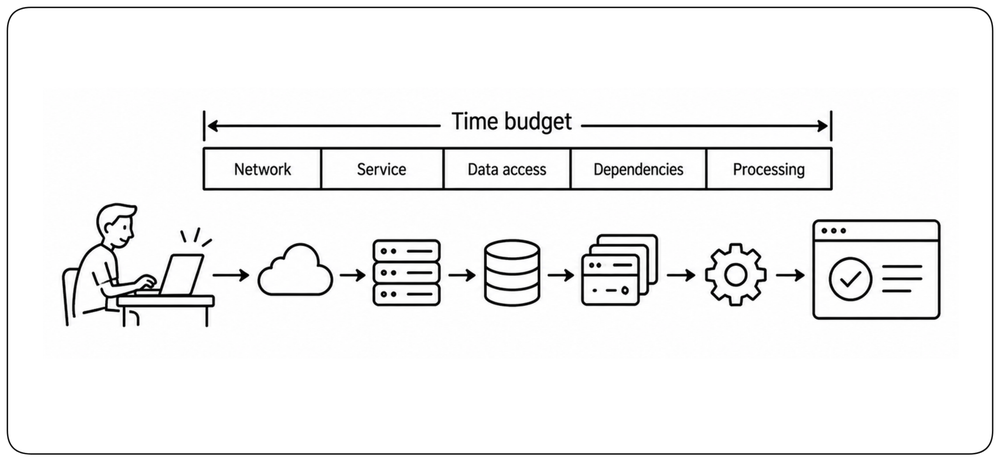
Le système répond assez vite pour les personnes et les processus qui en dépendent. !!La performance n’est pas un chiffre unique — c’est un budget de temps, réparti sur chaque couche que traverse la requête.!! Un système performant se fait oublier : l’utilisateur clique, les résultats apparaissent, et rien entre les deux ne se manifeste. Chaque décision d’architecture dépense ce budget de temps ou le protège.
Latence, temps de traitement et débit
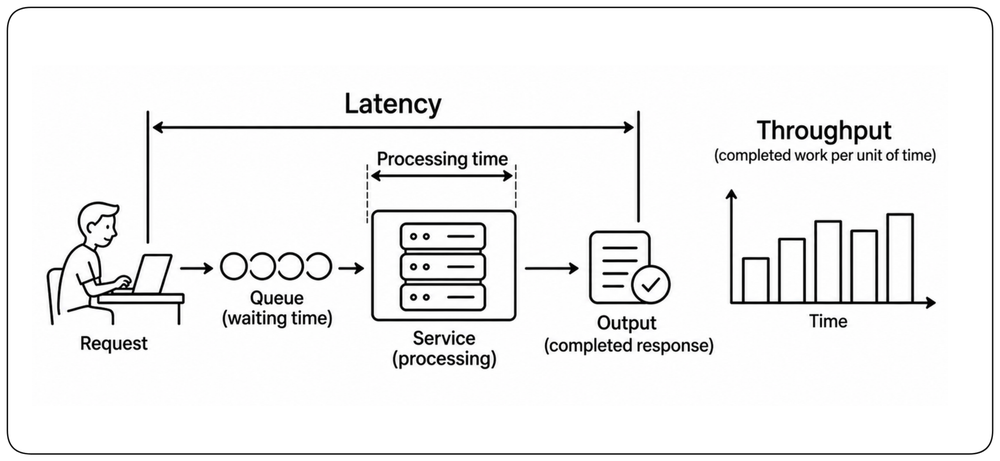
La latence est le temps que prend une unité de travail, du début à la fin. Le temps de traitement est la part de ce temps réellement consacrée à faire le travail. Le débit est le nombre d’unités de travail que le système termine par unité de temps. Sous charge, le temps d’attente peut augmenter même si le temps de traitement reste presque constant. Une bonne performance, c’est respecter la latence requise tout en soutenant le débit requis.
Des percentiles, pas des moyennes
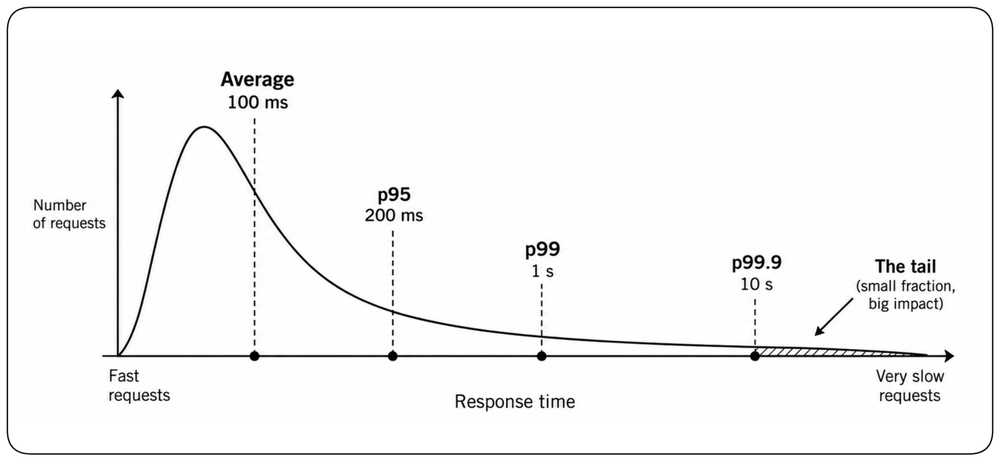
Les moyennes masquent la queue de distribution. Un service avec une moyenne de 100 ms peut avoir une petite fraction de requêtes qui prennent plusieurs secondes. Les percentiles tels que p95, p99 et p999 exposent ces expériences lentes et révèlent les chemins lents, les retries et la contention que la moyenne peut cacher. Concevez pour la queue de distribution quand elle compte pour l’expérience utilisateur.
Définir des SLO de performance
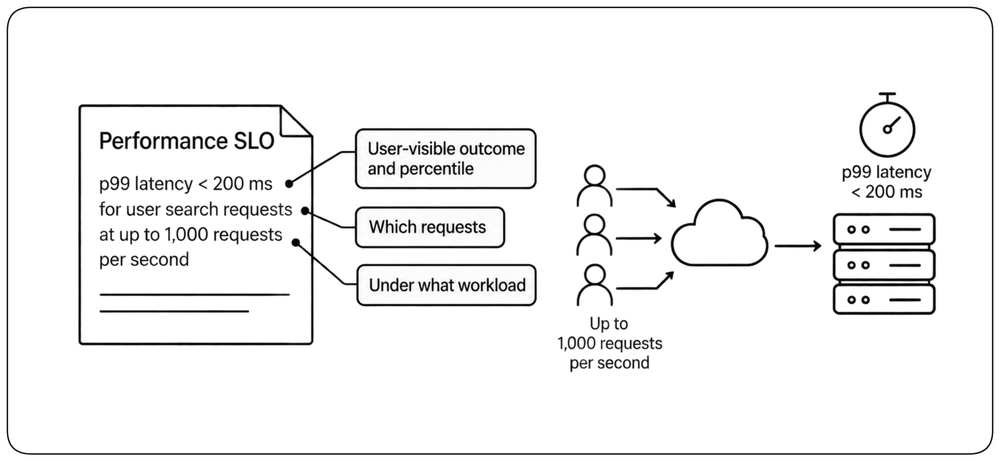
Une exigence de performance doit préciser ce qui est mesuré, pour quelles requêtes et sous quelle charge. « Une latence p99 inférieure à 200 ms » n’a de sens que si la population de requêtes et le trafic attendu sont définis. Un bon SLO de performance combine un résultat visible par l’utilisateur, un percentile et une condition d’exploitation. Il définit la performance que l’architecture doit préserver, et pas seulement la vitesse observée dans un benchmark isolé.
La performance dépend de la charge
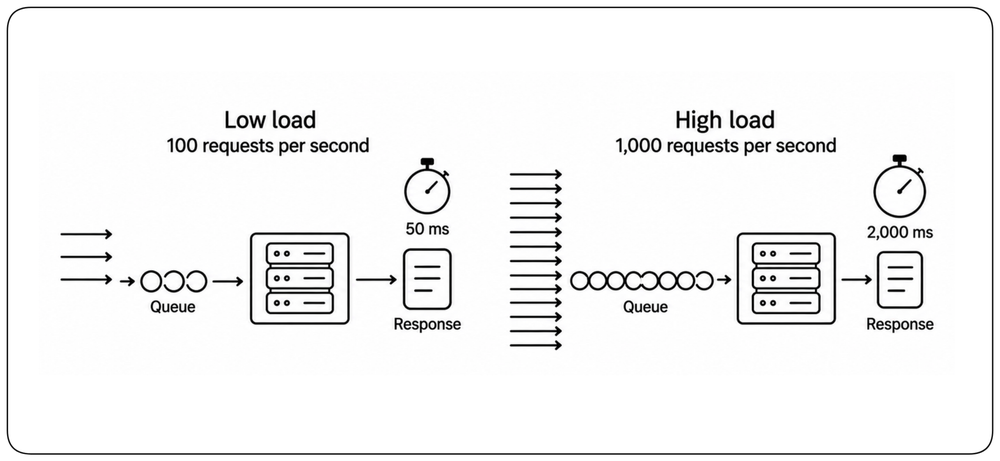
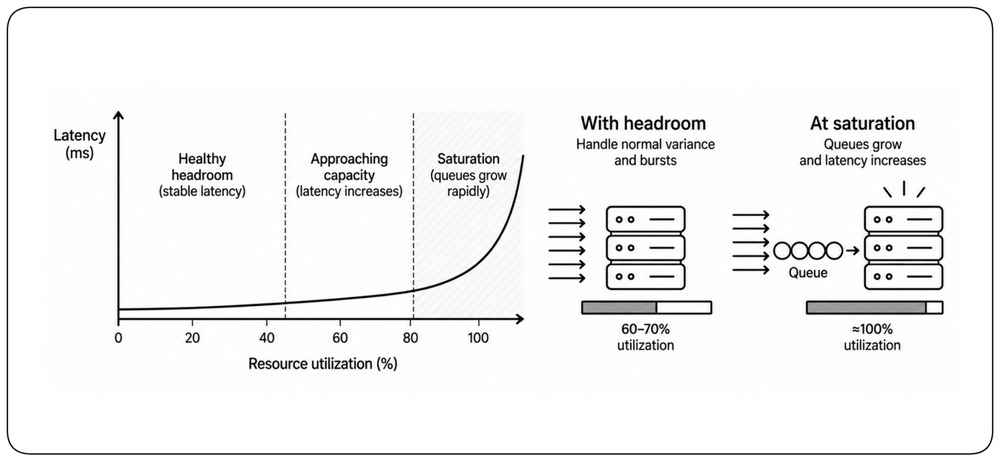
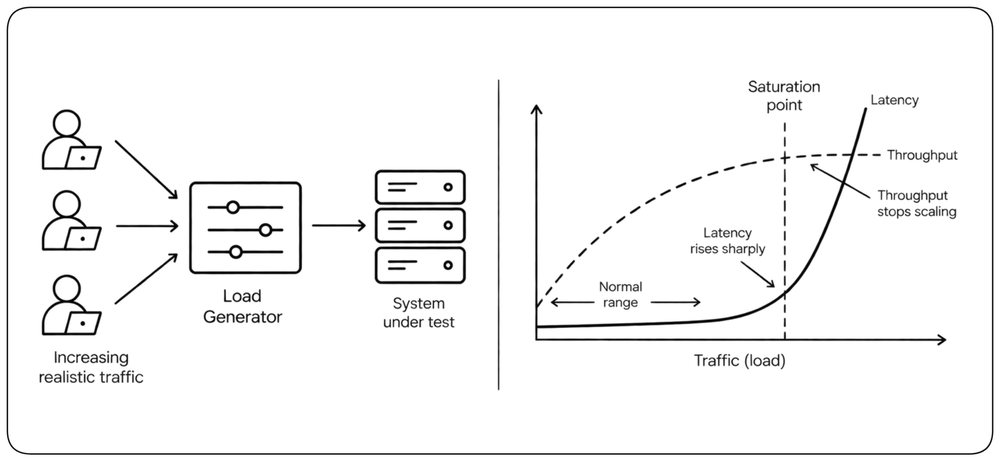
La performance n’a de sens qu’à une charge donnée. Un système peut répondre en 50 ms à 100 requêtes par seconde et en 2 secondes à 1 000. Quand l’utilisation approche la capacité d’une ressource limitée, les files d’attente grossissent et la latence de queue peut exploser. Une cible de latence sans cible de débit ou de concurrence est incomplète. Définissez la charge que le système doit soutenir, et pas seulement la vitesse d’une requête isolée.
Prévoir de la marge
Un système ne devrait pas être conçu pour fonctionner en permanence à son point de saturation. Le trafic varie, les requêtes n’ont pas le même coût, les dépendances ralentissent et les pannes réduisent la capacité disponible. Gardez assez de marge pour absorber la variance normale et les pics sans entrer dans la zone où les files d’attente et la latence croissent rapidement. Le capacity planning ne consiste pas seulement à gérer la charge attendue, mais à préserver une performance acceptable quand les conditions sont moins favorables.
La performance est un enjeu business
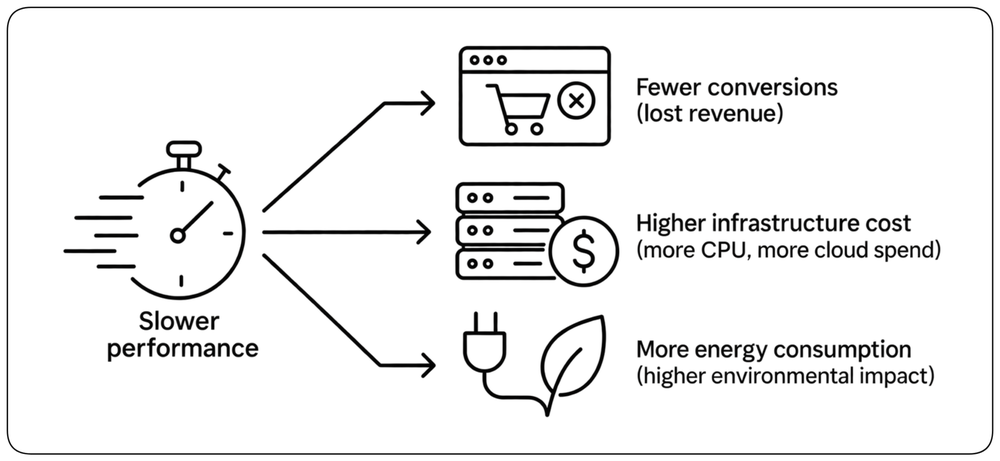
Les systèmes lents n’affectent pas que l’expérience utilisateur. Ils peuvent réduire la conversion, augmenter le coût d’infrastructure, consommer plus d’énergie et limiter la quantité de travail utile que le système peut soutenir. La performance a donc des conséquences directes sur le produit et le business, pas seulement techniques.
Performance vs efficience
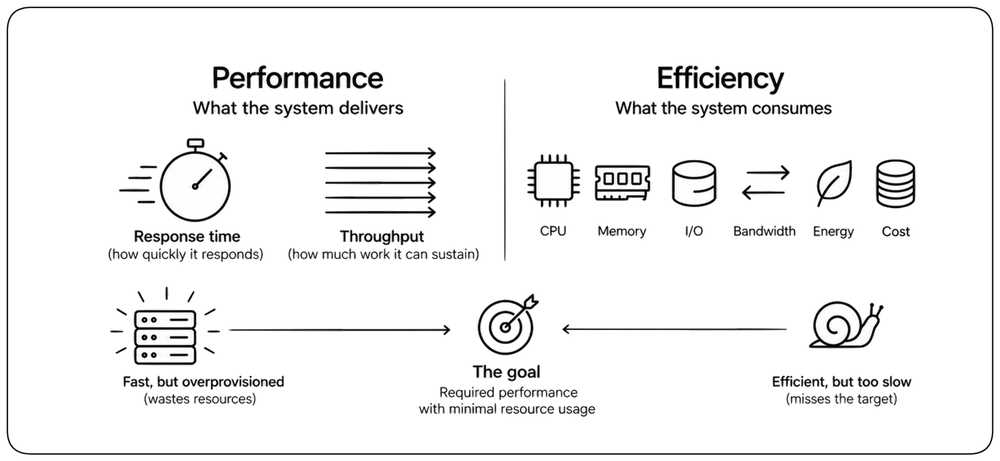
La performance mesure ce qu’un système délivre : la rapidité de ses réponses et la quantité de travail qu’il peut soutenir. L’efficience mesure ce que le système consomme pour le délivrer : CPU, mémoire, I/O, bande passante, énergie et coût. Un système peut être rapide parce qu’il est massivement surdimensionné, ou efficient mais encore trop lent. Une bonne conception vise à atteindre la performance requise sans consommer plus de ressources que nécessaire.
Les principes fondamentaux de la performance
La performance décrit ce qu’un système délivre ; l’efficience décrit les ressources qu’il consomme pour le délivrer. Les techniques de cette section sont des moyens généraux d’améliorer l’une ou l’autre, voire les deux, sans lier le chapitre à un runtime ou à une charge de travail particuliers.
Réduire le travail avant de l’accélérer
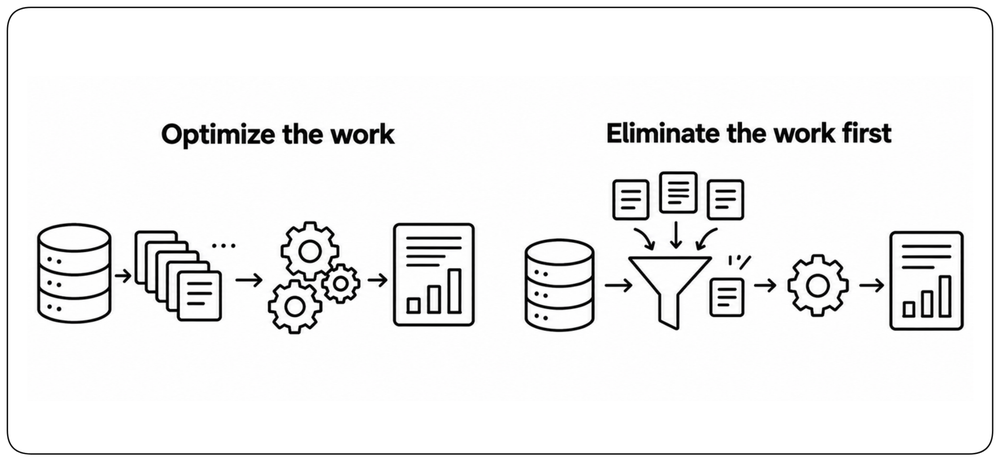
L’opération la moins chère est celle que le système n’exécute pas. Avant d’accélérer le code, demandez-vous si le travail est vraiment nécessaire. Éliminez les requêtes redondantes, les calculs répétés, la sérialisation inutile, les transferts de données excessifs et le travail dont le résultat n’est jamais consommé. Réduire la quantité de travail produit souvent des gains plus importants et plus simples que l’optimisation du même travail.
Amortir les coûts fixes
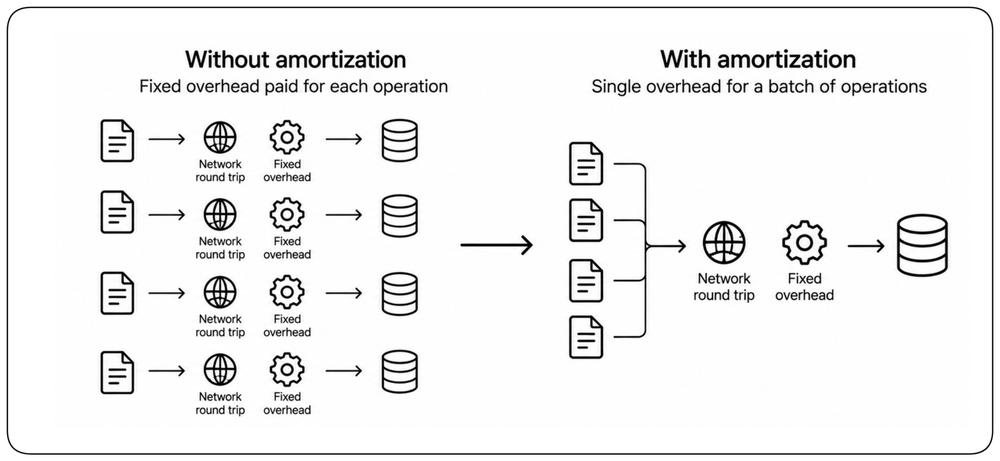
De nombreuses opérations portent un surcoût fixe quelle que soit la quantité de travail utile qu’elles effectuent : un aller-retour réseau, une transaction, l’acquisition d’un verrou, un appel système ou un échange de protocole. Le batching, le pooling, la réutilisation des connexions et les opérations vectorisées répartissent ce surcoût sur davantage de travail utile. Le but n’est pas un batching maximal, mais assez d’amortissement pour améliorer l’efficience sans violer les exigences de latence.
Réutiliser le travail
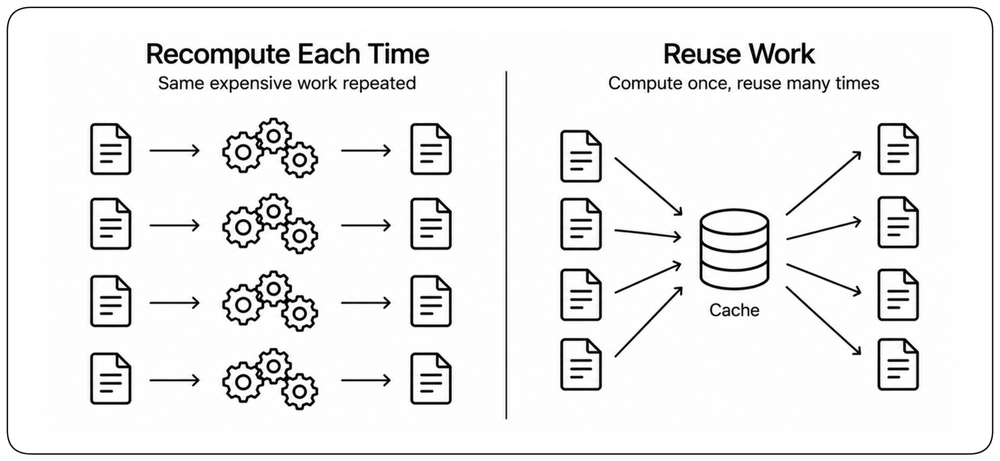
Ne recalculez pas ce que le système sait déjà. Le caching, la mémoïsation, les résultats intermédiaires partagés, les données précalculées, les artefacts compilés et les connexions réutilisables évitent de répéter un travail coûteux. La réutilisation peut améliorer en même temps la latence, le débit et l’efficience des ressources. Le prix à payer est l’état : la fraîcheur, l’invalidation, la consommation mémoire et la gestion du cycle de vie doivent rester explicites.
Utiliser la représentation la moins chère qui fonctionne
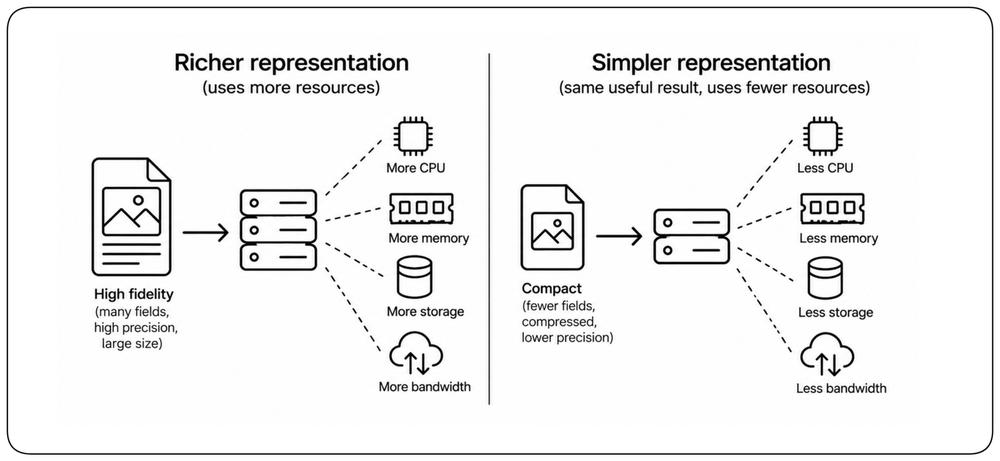
Plus de précision et des représentations plus riches exigent généralement plus de calcul, de mémoire, de stockage ou de bande passante. Quand l’exigence le permet, utilisez la représentation la plus petite et la plus simple qui préserve le résultat voulu : moins de champs, une sérialisation compacte, des données compressées, des index plus petits ou une précision numérique réduite. Ne payez pas pour une précision, une fidélité ou une information dont la charge de travail n’a pas besoin.
Faire se chevaucher le travail plutôt qu’attendre
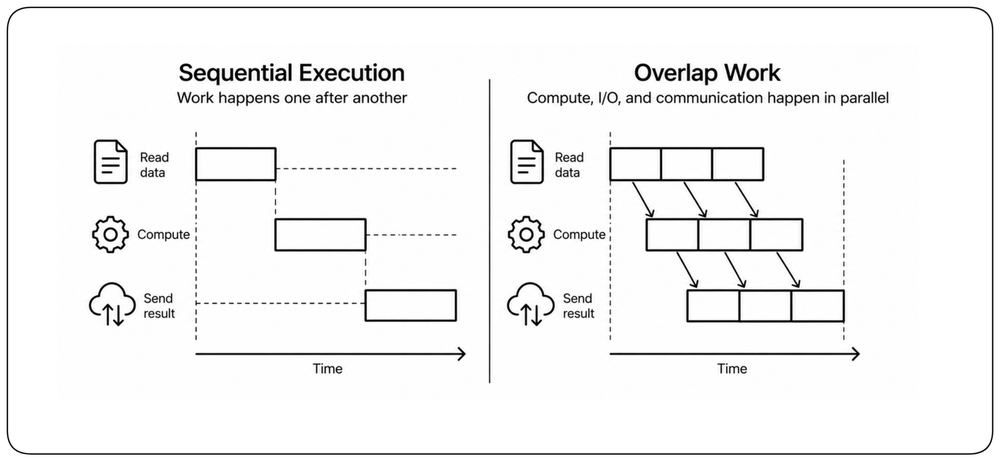
Un travail indépendant n’a pas toujours besoin d’être séquentiel. Le pipelining, le streaming, les I/O asynchrones et l’exécution concurrente peuvent faire se chevaucher calcul, communication et attente. La quantité totale de travail peut rester la même, mais moins de temps est passé avec des ressources inactives et moins de travail reste sur le chemin critique. Le parallélisme n’aide que si le travail est réellement indépendant et si la concurrence supplémentaire ne crée pas un nouveau goulot d’étranglement.
Streamer les résultats dès qu’ils sont disponibles
Un résultat n’a pas toujours besoin d’être complet pour qu’un travail utile puisse commencer. Le streaming permet à un système de livrer les données de façon incrémentale au fur et à mesure qu’elles sont produites, ce qui réduit le temps jusqu’au premier résultat et évite d’attendre la réponse entière. C’est particulièrement utile pour les grosses réponses, les calculs longs et le contenu généré. Le streaming ne réduit pas forcément le temps de traitement total, mais il peut réduire nettement la latence réellement perçue par les utilisateurs.
Corriger la performance avant de scaler
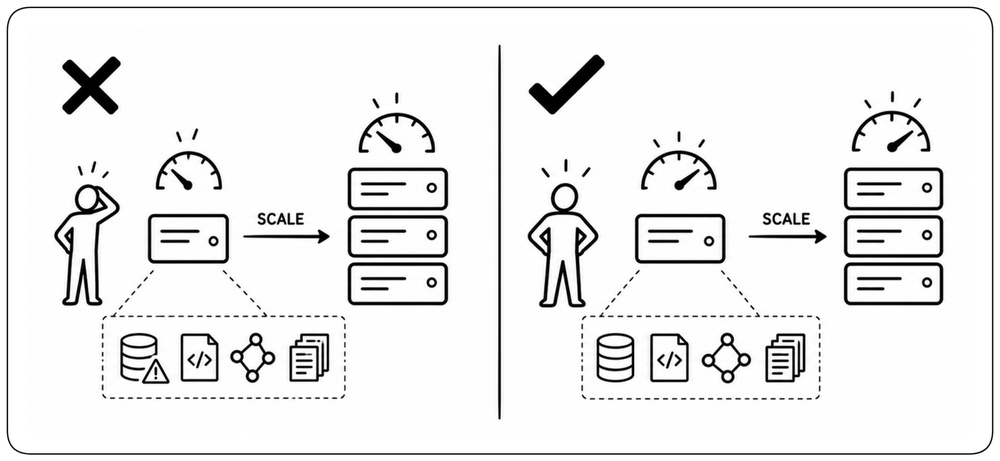
Quand un système peine sous la charge, le premier réflexe est souvent d’ajouter des ressources. Mais le scaling peut masquer, sans les corriger, des requêtes inefficaces, du travail inutile, trop d’appels réseau, de la contention ou un mauvais accès aux données. Mesurez et améliorez d’abord la performance, puis scalez quand la charge dépasse réellement la capacité d’un système efficient. Le scaling doit multiplier une bonne performance, pas compenser une mauvaise.
Trouver le goulot d’étranglement
Les problèmes de performance sont rarement uniformes — un composant contraint dicte la vitesse de l’ensemble. Trouver ce goulot d’étranglement, et le regarder se déplacer à mesure que vous corrigez chacun d’eux, est le travail quotidien de l’ingénierie de la performance.
Suivre le chemin critique
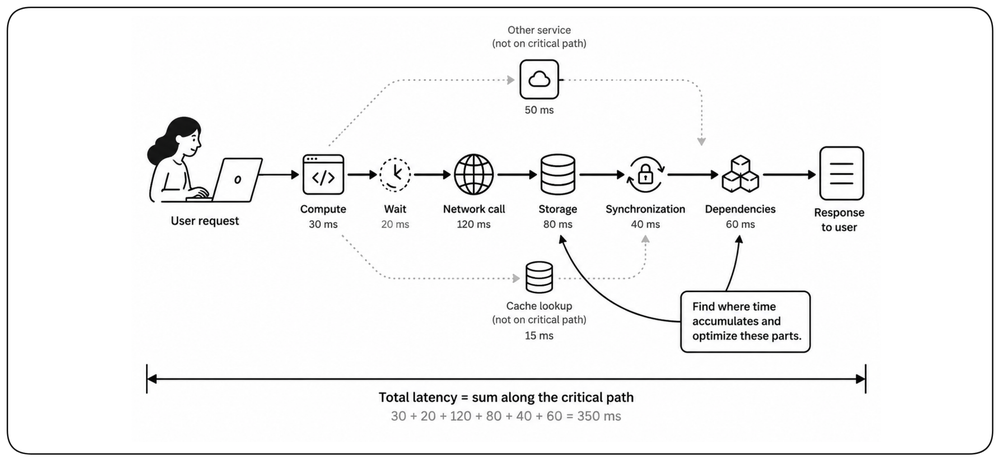
Une requête dépense son budget de latence entre calcul, attente, appels réseau, stockage, synchronisation et dépendances. La performance de bout en bout émerge du chemin entier, pas d’un composant isolé. Tracez le chemin sur lequel l’utilisateur attend réellement, identifiez où le temps s’accumule et optimisez les parties qui dominent le budget.
Corriger le goulot d’étranglement, pas la couche
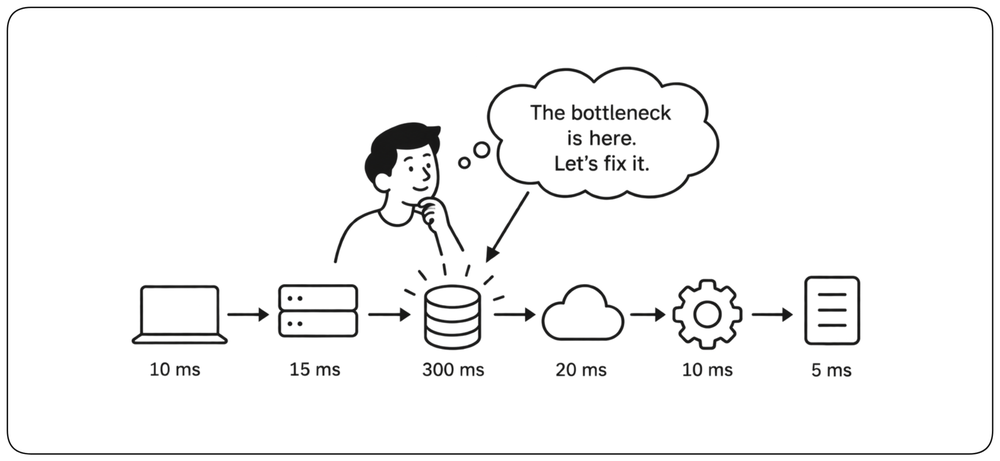
Ne présumez pas de l’endroit où se situe le problème de performance. Ce peut être le code applicatif, une requête de base de données, un saut réseau, un verrou, un quota, une dépendance ou l’architecture elle-même. Mesurez le chemin de la requête, identifiez la ressource ou l’opération qui limite la performance, et optimisez à cet endroit. Améliorer un composant qui ne limite pas le système change la complexité, pas la performance.
L’anatomie d’un goulot d’étranglement
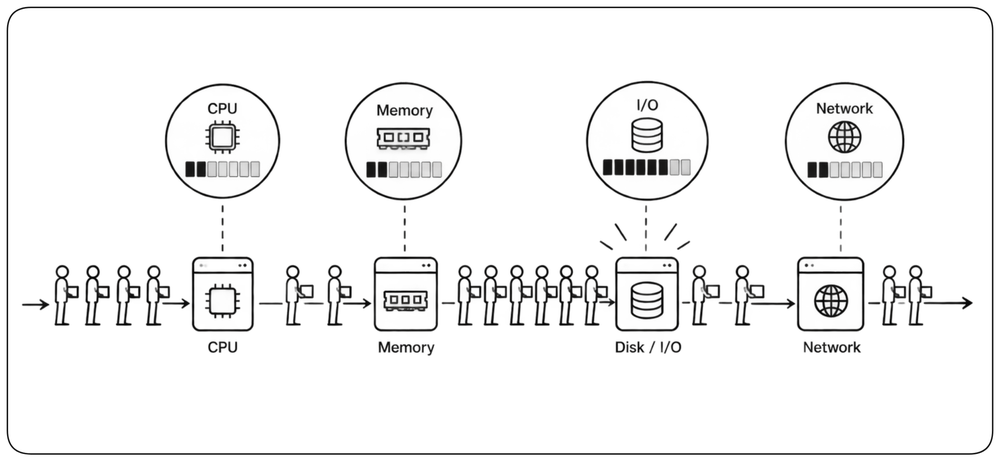
Un goulot d’étranglement est tout point où le flux est contraint, obligeant chaque opération en amont à faire la queue derrière lui. !!Les quatre familles classiques sont le CPU, la mémoire, les I/O et le réseau — mais le vrai coupable peut aussi être une API bavarde, un appel synchrone qui retient un thread ou un verrou en contention.!! Les goulots d’étranglement doivent être identifiés par des mesures plutôt que par l’intuition, car en corriger un déplace souvent la contrainte ailleurs.
Mesurer avant d’optimiser
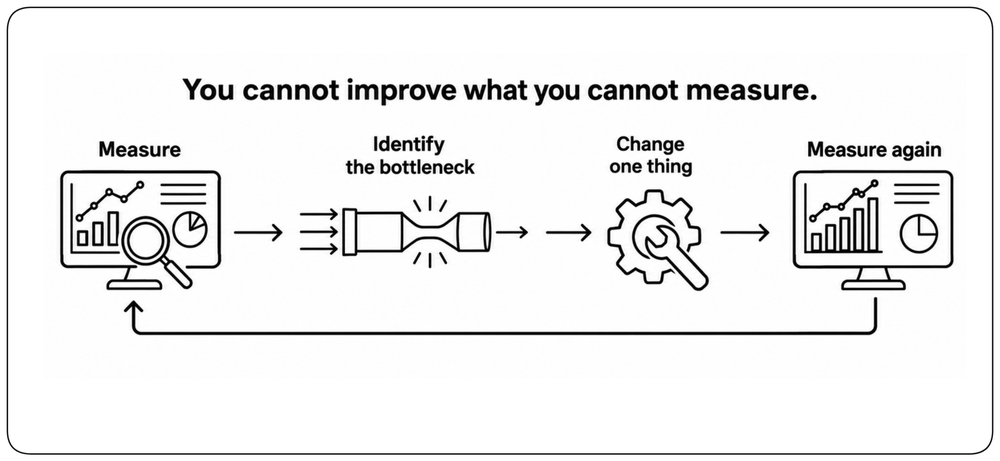
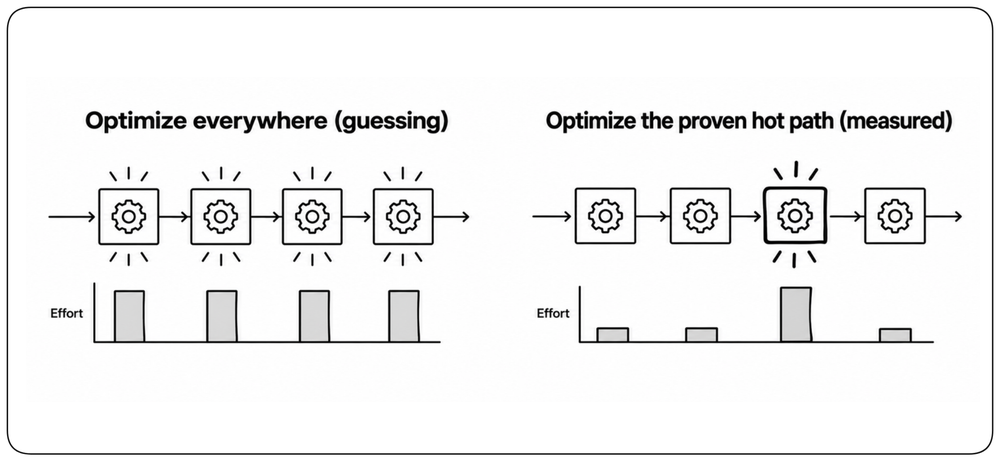
Le travail de performance suit une boucle disciplinée : mesurer, identifier l’opération ou la ressource limitante, changer une seule chose, puis mesurer à nouveau. Les profilers, les traces et les outils d’APM révèlent où le temps est réellement dépensé et si le changement a amélioré la métrique pertinente de latence, de débit ou de capacité. Sans cette boucle, l’optimisation devient de la devinette.
L’effet de cascade
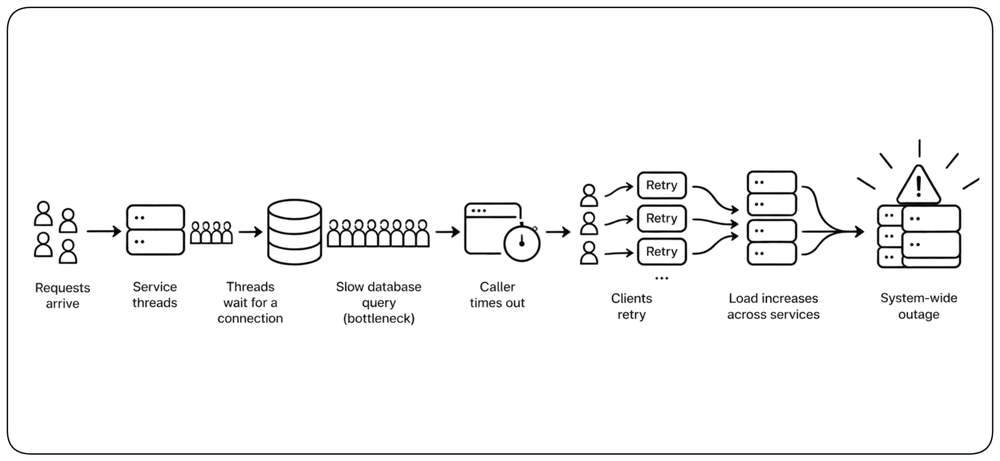
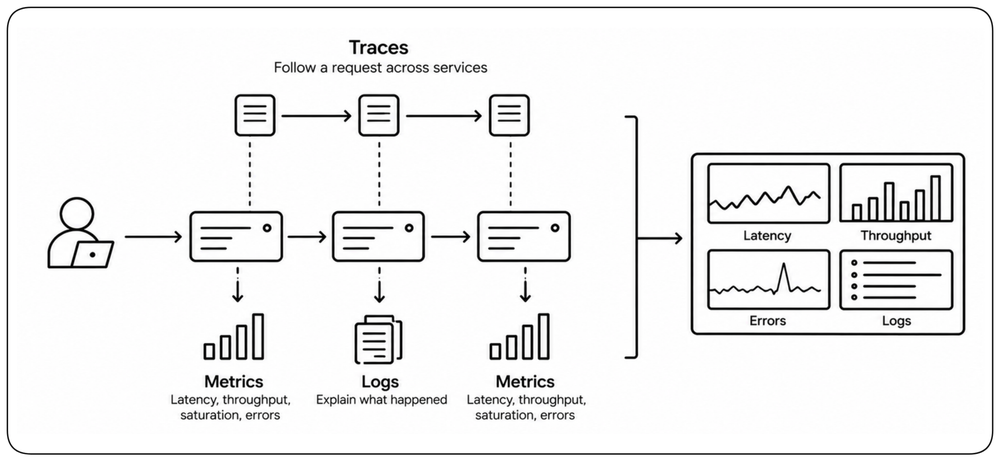
Les goulots d’étranglement restent rarement locaux. Une requête de base de données lente retient une connexion, qui bloque un thread, qui fait expirer un appelant, qui réessaie — et un petit accroc peut se propager en une défaillance de tout le système. Tracer le parcours d’une requête à travers les services révèle quels retards se cumulent et lesquels le système absorbe sans s’en apercevoir.
Mesurer avec soin
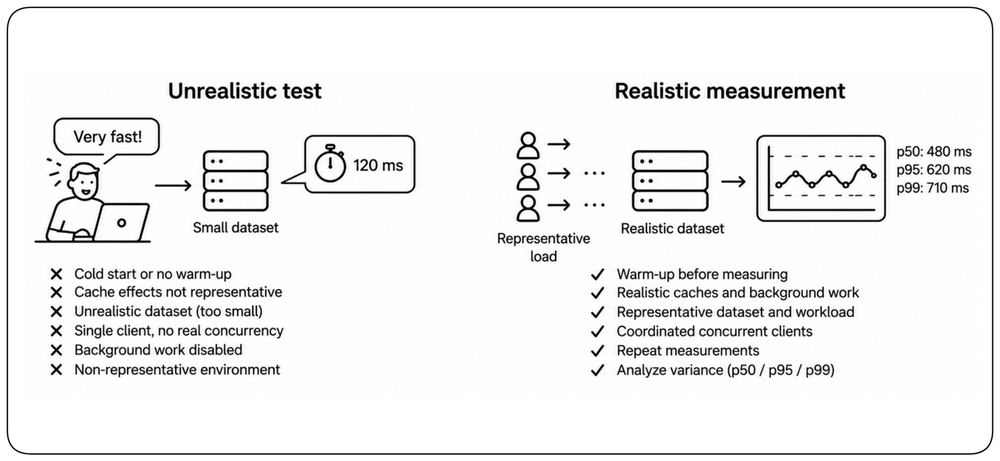
Les mesures de performance ne sont utiles que si l’expérience reflète la réalité. Les effets de warm-up, les caches, le garbage collection, la pression d’allocation, le travail en arrière-plan, les jeux de données irréalistes, les clients coordonnés et les environnements bruités peuvent fausser les résultats. Comparez des charges équivalentes, répétez les mesures et séparez le signal de la variance. Un benchmark précis d’une charge irréaliste produit une réponse précise mais inutile.
Optimisation au niveau du code
Les plus grands gains de performance ne viennent presque jamais d’astuces ingénieuses. Ils viennent de faire moins de travail, de choisir le bon algorithme et de n’optimiser que le code dont la mesure montre qu’il compte.
Penser en algorithmes
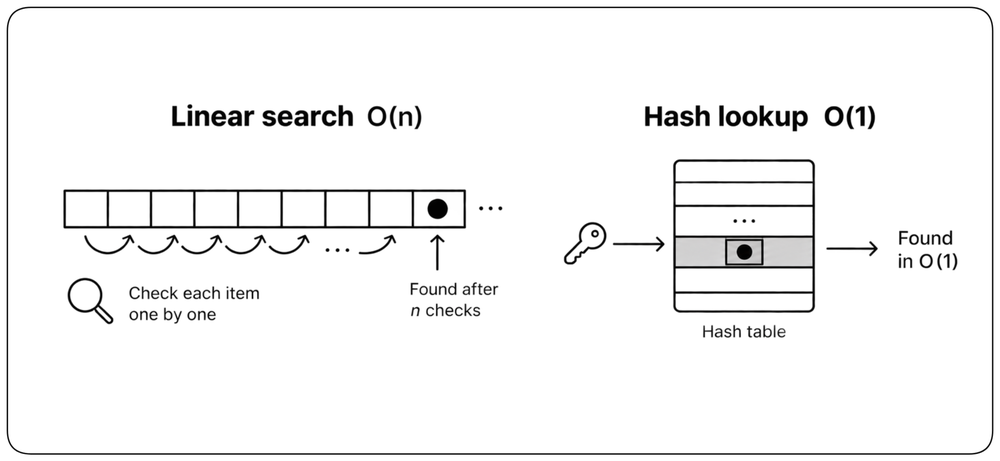
L’optimisation la plus impactante est de choisir le bon algorithme. !!La différence entre O(n) et O(n²) n’est pas un pourcentage — c’est la différence entre un système qui passe à l’échelle et un système qui s’effondre.!! Un parcours linéaire de dix éléments est invisible ; le même parcours sur un million d’éléments devient la panne. Choisissez la structure de données qui correspond au schéma d’accès : les recherches par hachage sont en O(1) en moyenne, tandis que celles dans un arbre équilibré sont en O(log n).
Le coût caché des abstractions
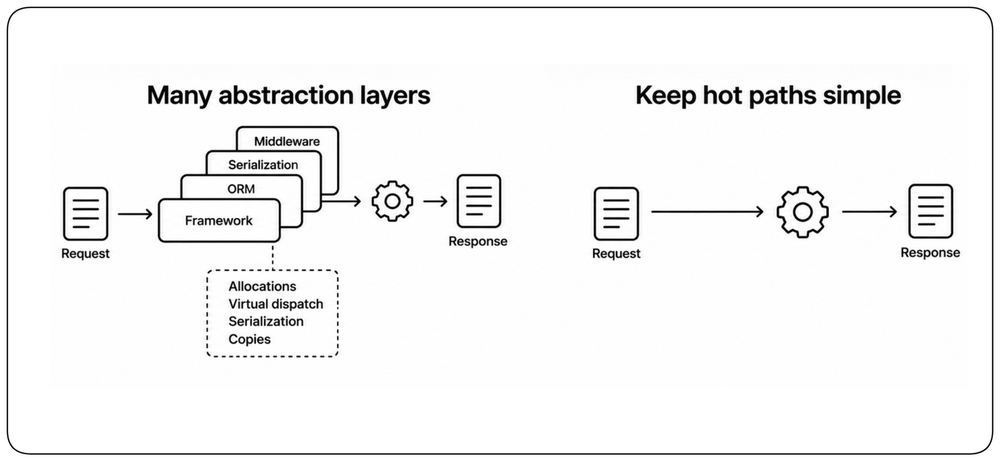
Les frameworks et les abstractions accélèrent le développement et peuvent ajouter des allocations, du virtual dispatch, de la sérialisation et des copies sur les chemins chauds. La leçon n’est pas d’abandonner les abstractions ; c’est de savoir lesquelles s’exécutent fréquemment et de garder ces chemins simples, directs et mesurés.
Évaluation paresseuse
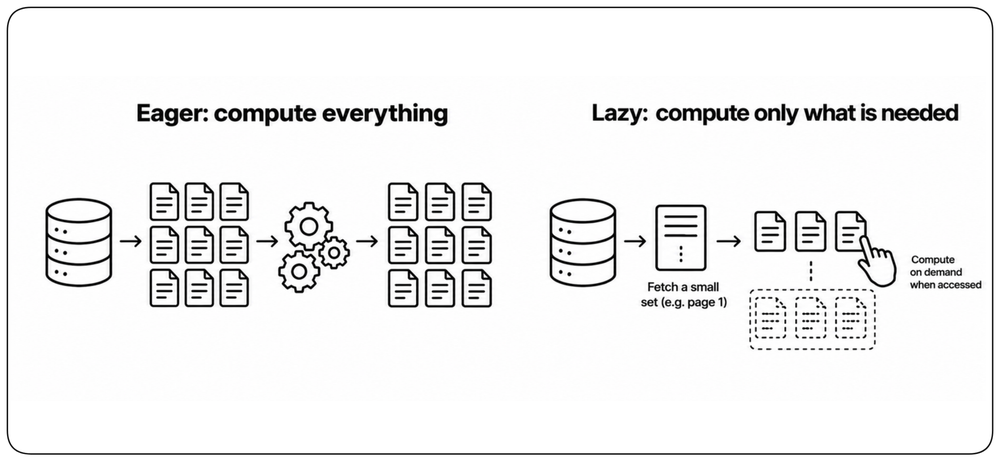
Les patterns lazy repoussent le calcul jusqu’au moment où le résultat est réellement nécessaire : pagination, lazy loading, champs à la demande et valeurs dérivées calculées seulement à la lecture. Ils sont une expression pratique de la réduction du travail inutile, surtout quand beaucoup de résultats possibles ne seront jamais consommés.
Optimiser les chemins chauds avérés
L’optimisation doit suivre les preuves, pas l’anticipation. La plupart du code doit d’abord être correct, clair et facile à modifier avant d’avoir besoin d’être exceptionnellement rapide. Mesurez d’abord, optimisez le chemin chaud avéré, puis mesurez à nouveau. Quand une optimisation ajoute de la complexité, isolez-la derrière une interface propre et documentez le goulot d’étranglement ou le benchmark qui l’a justifiée.
Performance des données et du stockage
L’accès aux données domine souvent le budget d’une requête. La bonne question n’est pas quelle technique de stockage est à la mode, mais comment la charge lit et écrit les données.
Concevoir l’accès aux données autour de la charge de travail
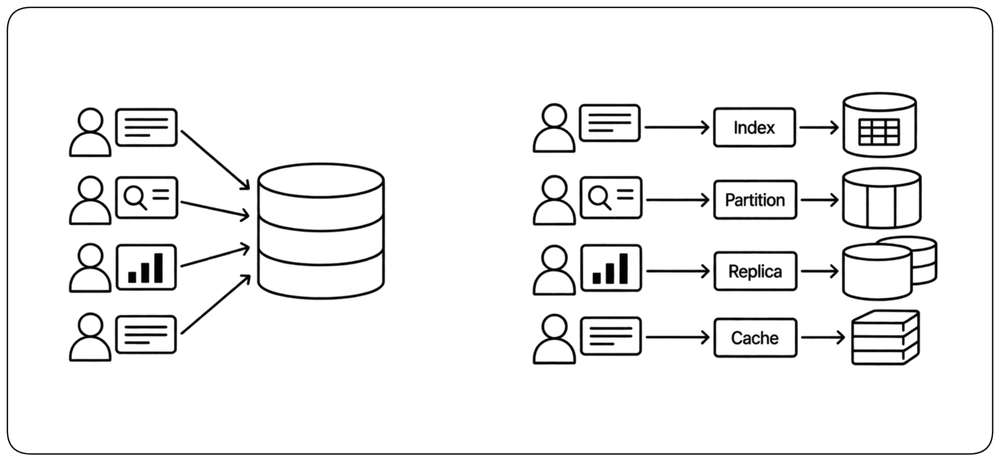
Les structures de données, index, partitions, réplicas et caches doivent suivre les schémas d’accès que le système sert réellement. Les charges à dominante lecture et à dominante écriture exigent des conceptions différentes, et un schéma optimisé pour une forme de requête peut être mauvais pour une autre. La performance commence par comprendre comment les données sont lues et écrites, et non par appliquer des techniques de stockage de façon générique.
La base de données : amie et ennemie
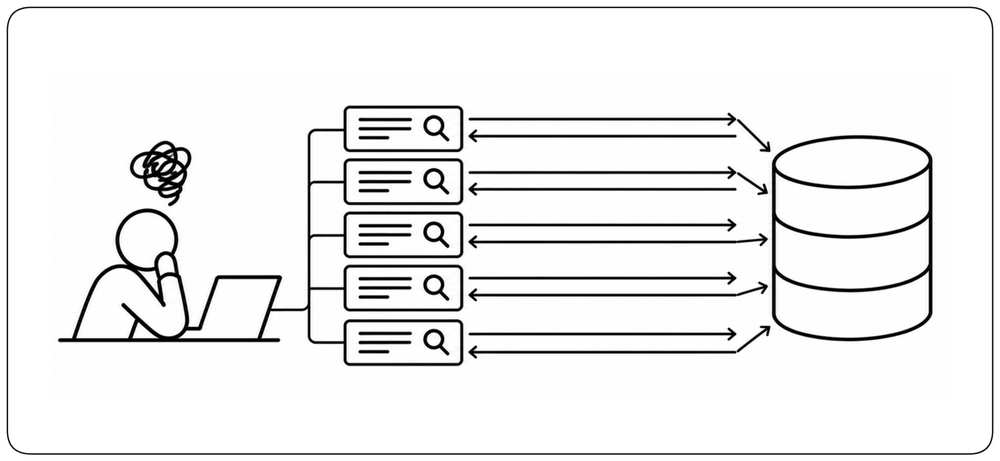
Les bases de données offrent durabilité et requêtes puissantes, et elles sont un goulot d’étranglement fréquent dans les systèmes réels. !!L’accès à la base de données peut impliquer des allers-retours réseau, de la synchronisation, des I/O de stockage, de la sérialisation et de la contention. À grande échelle, des requêtes répétées ou mal formées peuvent dominer le budget de la requête.!! Indexez les schémas d’accès que vous avez réellement, éliminez les requêtes N+1 et lisez les plans d’exécution comme du code.
Protéger la base de données avec le connection pooling
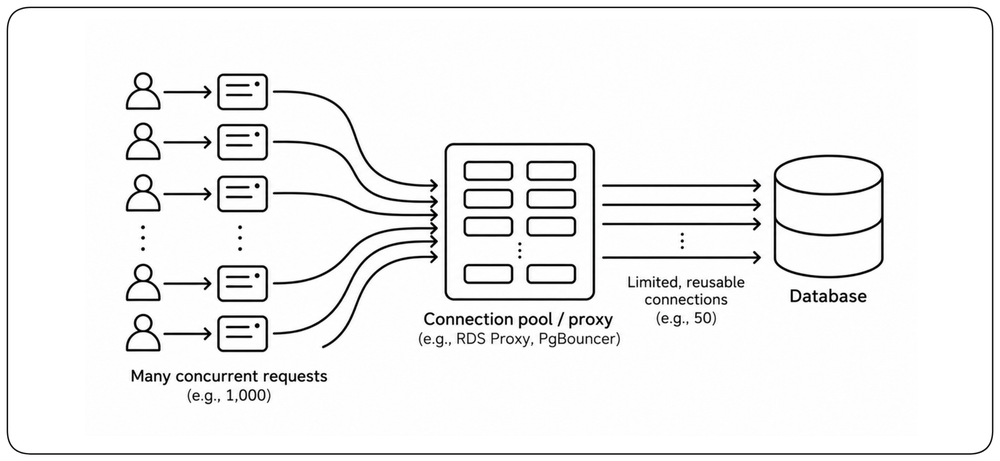
Les applications peuvent gérer des milliers de requêtes concurrentes, mais une base de données ne peut soutenir efficacement qu’un nombre limité de connexions. Les pools de connexions et les proxies de base de données découplent la concurrence applicative des connexions à la base : les requêtes empruntent un ensemble borné de connexions réutilisables au lieu de créer une connexion par requête. Cela réduit le surcoût des connexions, protège la base contre les tempêtes de connexions et offre un point naturel pour contrôler la pression exercée sur la base.
Le caching : échanger de l’espace contre du temps
Le caching est le compromis fondamental de la performance — dépenser de la mémoire pour éviter du calcul ou des I/O. !!Le caching peut éviter des calculs répétés ou des I/O plus lentes et retirer du travail coûteux du chemin critique.!! La difficulté n’est jamais la lecture ; ce sont l’invalidation, l’obsolescence et les stampedes quand une clé populaire expire. Mettez en cache la bonne chose à la bonne couche, et maîtrisez les règles qui décident quand elle disparaît.
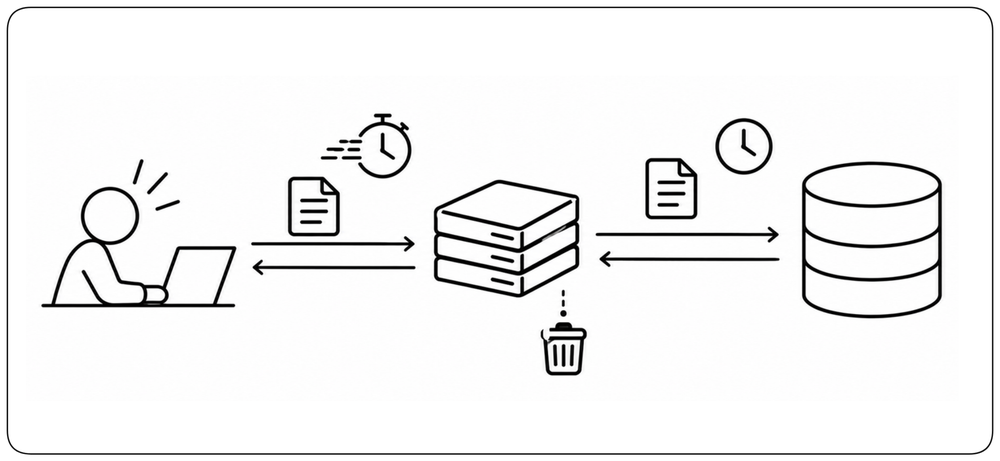
Le caching peut aussi sacrifier la fraîcheur à la vitesse : quand l’état en cache peut être en retard sur sa source, l’obsolescence acceptable doit être explicite.
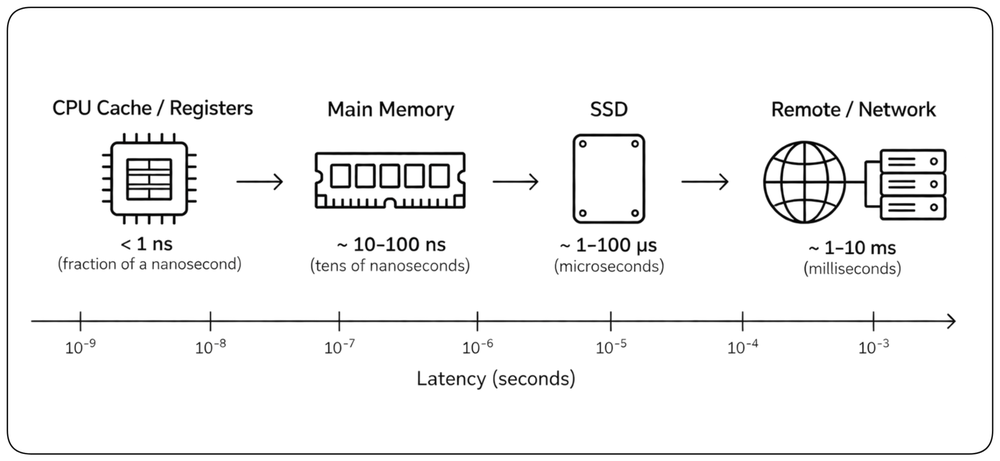
La hiérarchie mémoire
Les données locales au CPU sont infiniment plus rapides à accéder que la mémoire principale ; la mémoire principale est infiniment plus rapide que le stockage ; le stockage distant et les réseaux sont encore plus lents. Ces écarts couvrent plusieurs ordres de grandeur. Un code qui respecte la localité, regroupe les accès et évite les allocations inutiles peut être réactif sur du matériel modeste ; un code qui ignore ces coûts peut ramer même sur des machines haut de gamme.
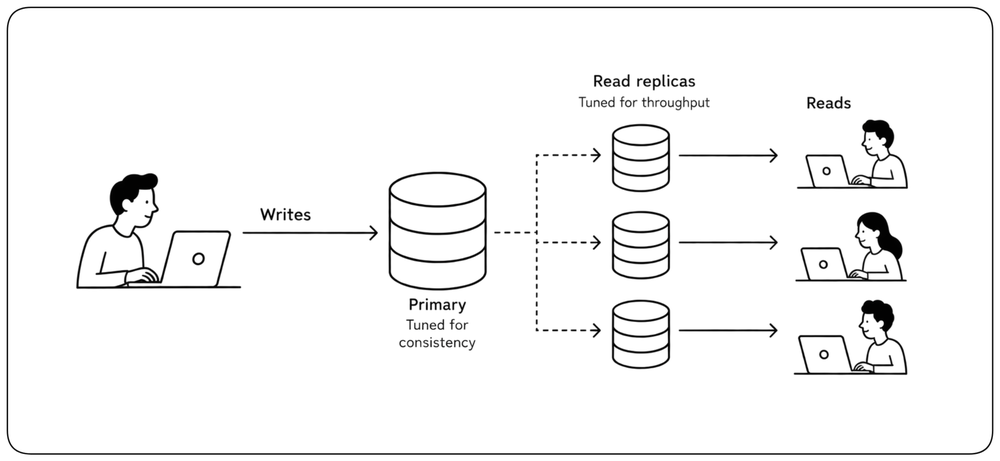
Réplicas en lecture
La plupart des applications lisent bien plus qu’elles n’écrivent. Séparez les chemins : les écritures vont vers un primaire réglé pour la cohérence, tandis que les lectures peuvent se répartir sur des réplicas réglés pour le débit. Les réplicas asynchrones peuvent améliorer la capacité de lecture et la localité, mais les applications doivent tolérer qu’un réplica renvoie temporairement des données plus anciennes.
Performance des I/O
De nombreux systèmes passent plus de temps à attendre des données qu’à les calculer. La performance des I/O dépend de la fréquence d’accès aux données, de la quantité de données déplacées et du schéma d’accès utilisé. Une bonne conception des I/O réduit les opérations inutiles avant d’essayer d’accélérer chaque opération.
Garder le chemin chaud hors du disque
Le disque et le stockage distant sont bien plus lents que la mémoire. Quand la latence compte et que les mêmes données sont lues à répétition, gardez le working set chaud en mémoire, dans un cache ou dans un buffer adapté plutôt que de retourner au stockage à chaque requête. Le stockage persistant reste essentiel pour la durabilité et les gros jeux de données, mais il ne doit pas se trouver inutilement sur un chemin sensible à la latence.
Réduire les I/O avant de les accélérer
Chaque lecture ou écriture peut impliquer de la latence de stockage, des appels système, de la sérialisation, des copies et des transferts de données. Avant d’optimiser la couche de stockage, réduisez la quantité d’I/O dont la charge a besoin. Ne lisez que les données nécessaires, évitez les écritures inutiles, réutilisez les données déjà disponibles et éliminez les accès répétés. L’opération d’I/O la plus rapide est celle que vous n’exécutez pas.
Préférer les I/O séquentielles et localisées
La performance du stockage dépend fortement des schémas d’accès. Un accès séquentiel et localisé permet au stockage, aux systèmes d’exploitation et au matériel de déplacer efficacement les données, tandis qu’un accès aléatoire dispersé peut transformer la même quantité de données en de nombreuses opérations coûteuses. Organisez les données autour du chemin d’accès courant, préservez la localité quand c’est possible et utilisez le buffering ou le prefetching quand l’accès futur est prévisible.
Concurrence et files d’attente
Le matériel moderne a de nombreux cœurs et les systèmes modernes servent de nombreux utilisateurs à la fois. Transformer ce potentiel en capacité réelle exige une exécution concurrente, des ressources bornées et une gestion explicite de la surcharge.
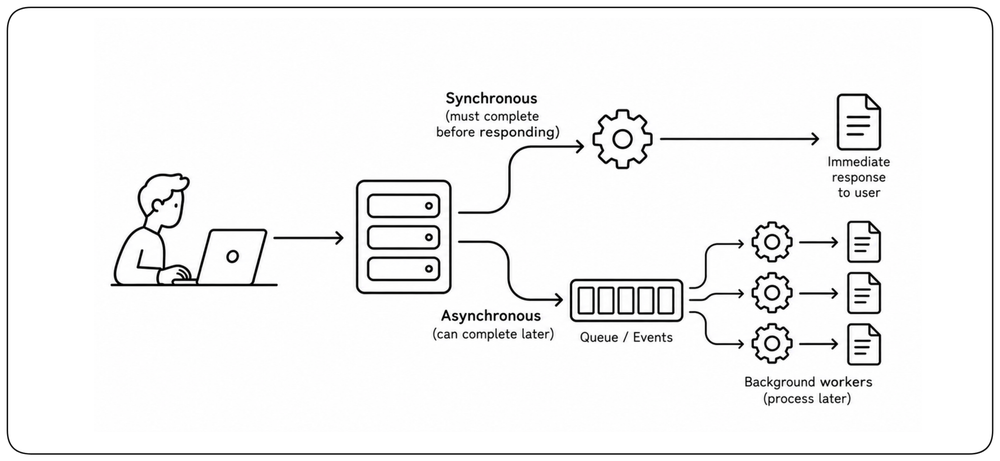
Décider ce qui doit être synchrone
Toutes les opérations n’ont pas leur place sur le chemin critique de l’utilisateur. Le travail dont le résultat est requis immédiatement doit se terminer de façon synchrone ; le travail qui peut finir plus tard peut être acquitté puis traité de façon asynchrone. Déplacer le travail non critique vers des files, des événements ou des workers en arrière-plan peut réduire considérablement la latence visible par l’utilisateur et isoler les opérations lentes. La décision d’architecture n’est pas « sync ou async », mais quel travail l’utilisateur doit réellement attendre.
Concurrence vs parallélisme
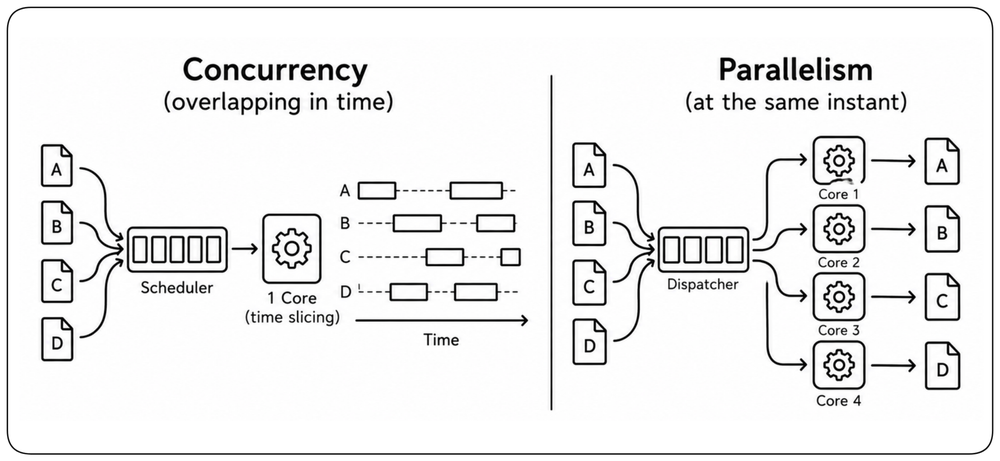
La concurrence est une structure — un système capable de gérer plusieurs tâches qui se chevauchent dans le temps. Le parallélisme est une exécution — faire réellement tourner plusieurs tâches au même instant sur plusieurs cœurs. Un système concurrent bien conçu débloque le parallélisme quand le matériel le permet et continue de se comporter correctement lorsqu’il est contraint de tourner sur un seul cœur.
Patterns asynchrones
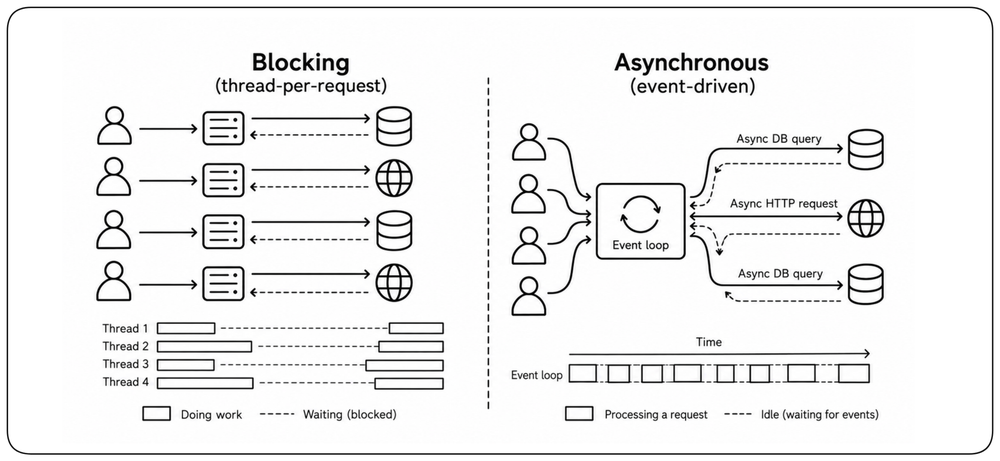
Le blocage est l’ennemi du débit. !!Un thread qui attend une requête de base de données ou une réponse réseau ne fait rien tout en consommant des ressources — le code asynchrone permet à ce thread de servir d’autres requêtes à la place.!! Le passage d’un modèle thread-par-requête à des pipelines orientés événements peut permettre à un petit nombre de cœurs de servir de nombreuses connexions concurrentes, à condition que les dépendances en aval puissent soutenir le travail.
Thread pools et pools de ressources
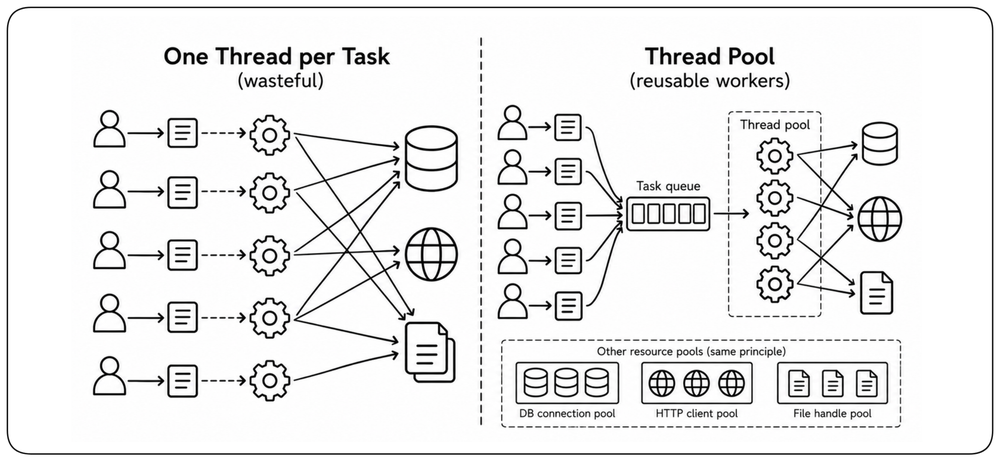
Créer un thread pour chaque tâche est du gaspillage ; n’en créer aucun et tout sérialiser est lent. Les thread pools maintiennent un ensemble réutilisable de workers, et le même principe s’applique aux connexions de base de données, aux clients HTTP et aux descripteurs de fichiers. La taille des pools doit refléter la capacité des ressources, le temps de service, la concurrence et les limites en aval, et être validée sous charge.
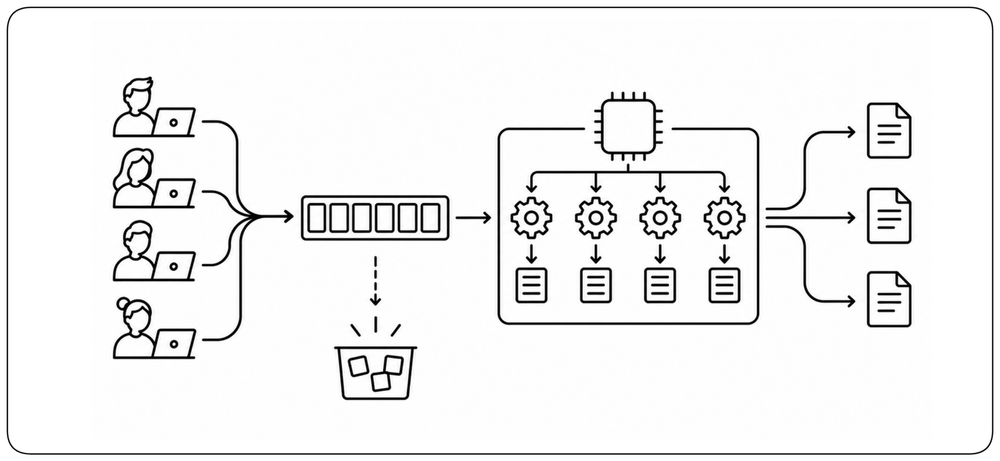
Files d’attente et backpressure
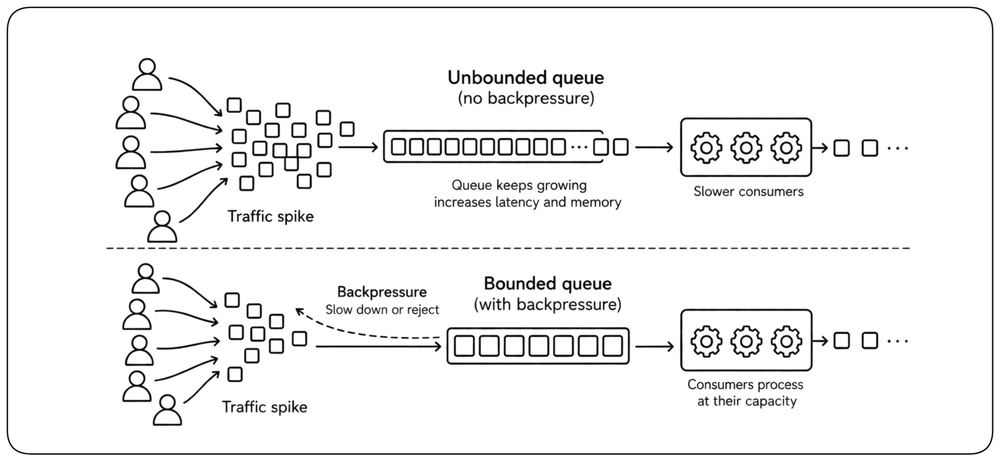
Les files d’attente absorbent les pics pour que le système ne s’effondre pas immédiatement lors d’un pic de trafic, mais elles ajoutent aussi de la latence. Une file ne crée pas de capacité ; elle déplace le temps d’attente d’un appelant ou d’un worker vers la file. Les files bornées avec backpressure disent aux producteurs de ralentir quand les consommateurs prennent du retard, afin que le système se dégrade délibérément au lieu de cacher la surcharge jusqu’à ce que la mémoire se remplisse et que tout tombe d’un coup.
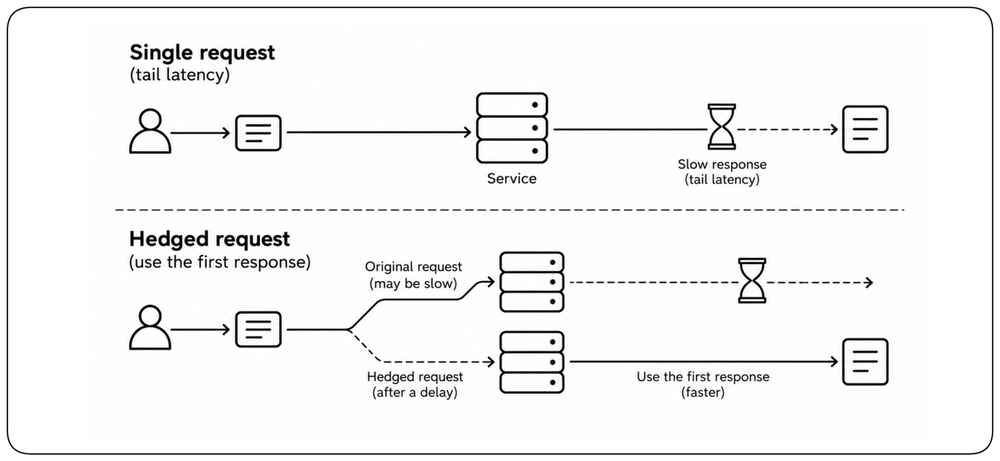
Hedged requests : combattre la latence de queue
Pour les lectures idempotentes sensibles à la latence, une hedged request envoie une seconde copie quand la première dépasse un délai soigneusement choisi, et utilise la première réponse qui arrive. Elle traite la latence de queue causée par la variabilité du temps de requête, pas la mise en file sous forte charge. Le hedging peut réduire la latence p99 quand une petite fraction des requêtes se bloque, mais il consomme de la capacité supplémentaire et peut amplifier la charge s’il est utilisé de façon agressive. Hedgez la queue, pas chaque requête.
Performance réseau
Dans les systèmes distribués, le réseau est souvent le maillon le plus lent. Chaque saut ajoute de la latence, chaque octet coûte du temps et chaque choix de protocole façonne l’enveloppe de performance de tout ce qui est construit par-dessus.
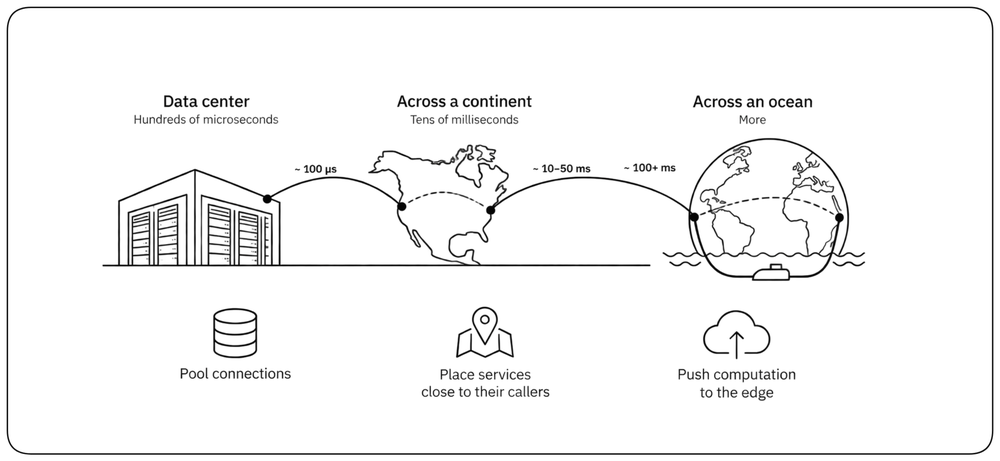
La latence : le tueur silencieux
Un paquet qui traverse un data center met des centaines de microsecondes ; à travers un continent, des dizaines de millisecondes ; à travers un océan, davantage. !!Dans les systèmes distribués, des dépendances réseau séquentielles peuvent consommer rapidement un budget de latence, même quand chaque dépendance semble rapide individuellement.!! Poolez les connexions, placez les services près de leurs appelants et poussez le calcul vers l’edge quand cela sert la charge.
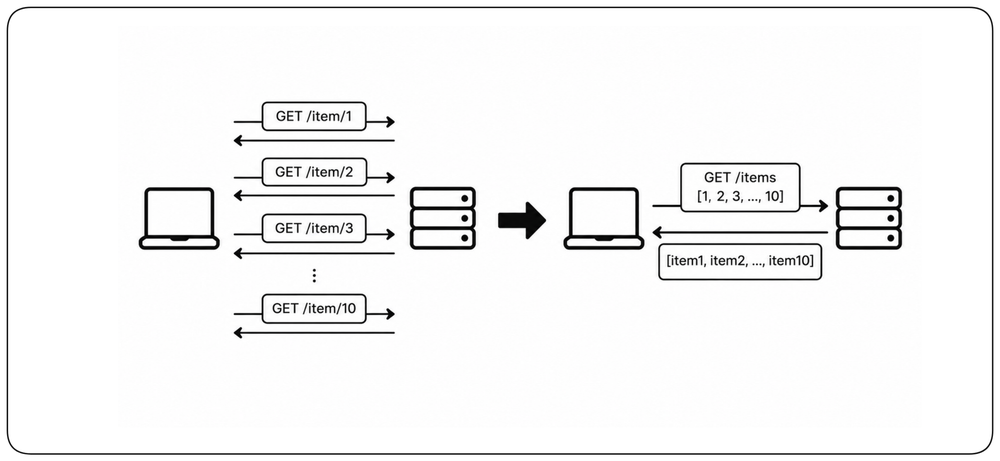
Réduire les allers-retours avec le batching
L’optimisation réseau ne consiste pas seulement à accélérer chaque requête — elle consiste aussi à faire moins de requêtes. !!Dix petits appels séquentiels peuvent coûter bien plus qu’un seul appel plus gros, car chaque aller-retour repaie la latence réseau.!! Regroupez les opérations liées quand elles peuvent être traitées ensemble, surtout sur des liens à forte latence.
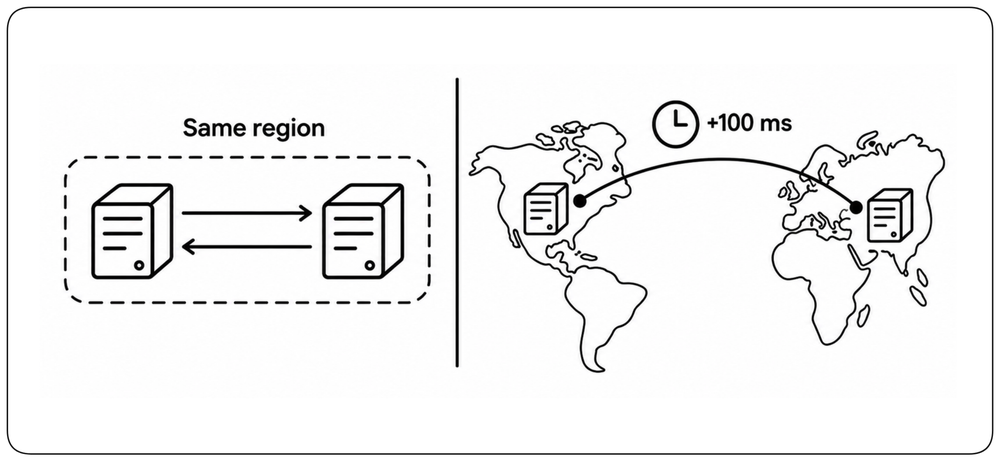
Garder les dépendances proches
La distance entre services fait partie de chaque requête. Une dépendance dans une autre région peut ajouter des dizaines ou des centaines de millisecondes avant même de faire du travail utile. !!Les services qui communiquent fréquemment devraient vivre près les uns des autres — idéalement dans la même région — car l’architecture ne peut pas optimiser la vitesse de la lumière.!! Les appels inter-régions doivent être délibérés, asynchrones quand c’est possible, et tenus hors des chemins sensibles à la latence.
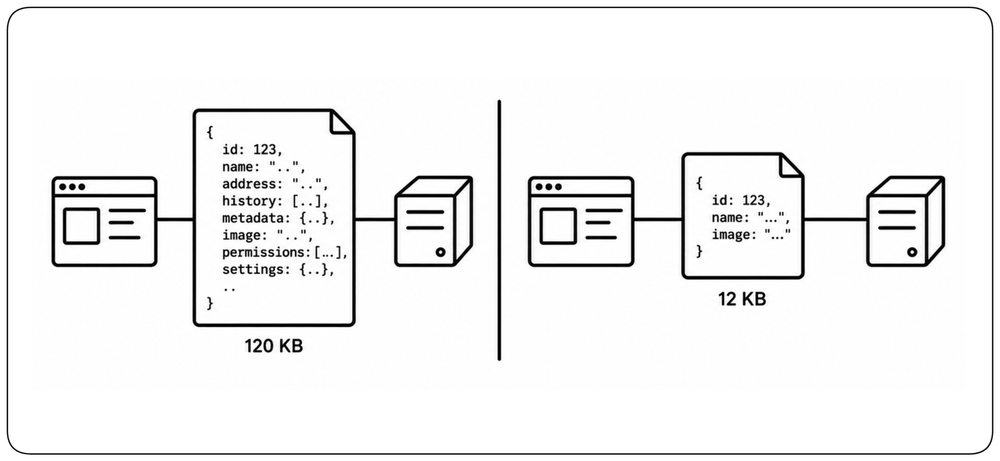
Optimisation des payloads
Chaque octet sur le réseau coûte du temps, de la bande passante et de la batterie côté client. Compressez, choisissez des formats de sérialisation efficaces et ne renvoyez que les champs dont l’appelant a réellement besoin. Le bon compromis dépend de la taille du payload, des besoins de l’appelant et de la nature du consommateur principal, humain ou machine.
Concevoir les API pour minimiser le travail réseau
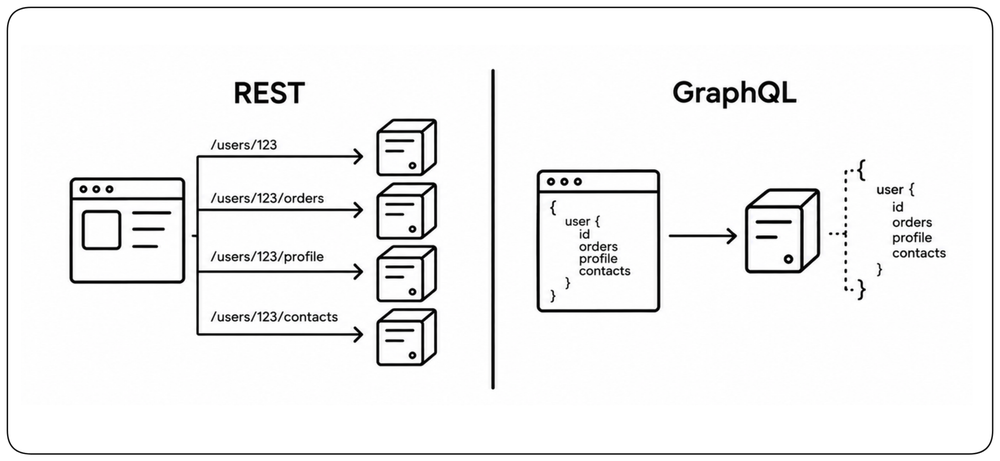
La conception d’API affecte directement le coût réseau. Une API REST aux endpoints trop larges ou mal alignés peut forcer les clients à faire plusieurs appels ou à télécharger des données dont ils n’ont pas besoin, tandis que GraphQL permet aux clients de demander plusieurs champs liés en une seule opération. Mais GraphQL n’est pas intrinsèquement plus rapide : des requêtes complexes peuvent créer un travail backend coûteux, de grosses réponses ou des schémas d’accès N+1. Choisissez la forme d’API qui minimise le travail total côté client, réseau et backend.
Choix du protocole
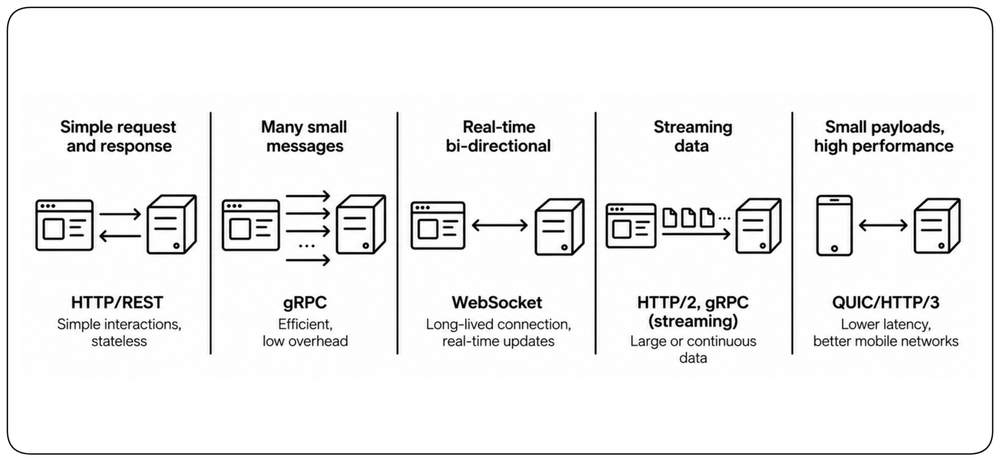
Choisissez les protocoles selon le schéma d’interaction, la taille des payloads, les besoins de streaming, la durée de vie des connexions et la sensibilité à la latence. Le choix du protocole compte, mais réduire les appels et les dépendances inutiles compte généralement davantage.
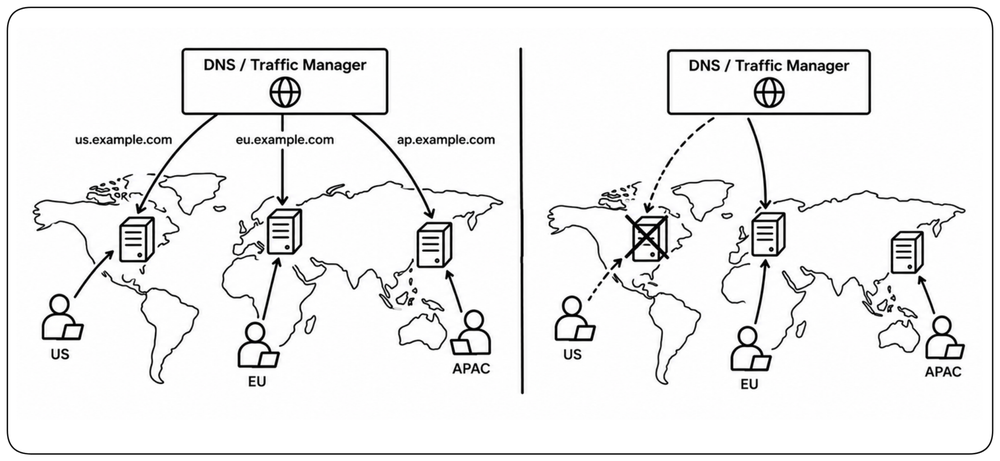
Servir près des utilisateurs
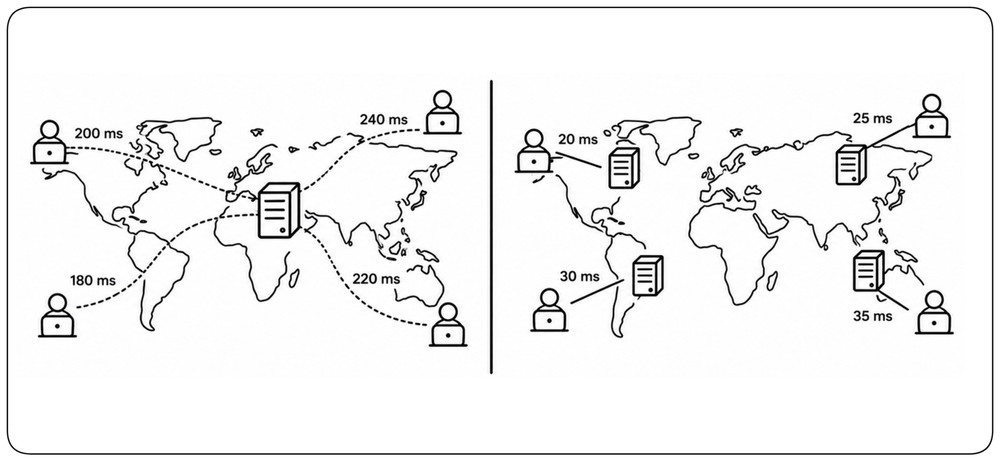
La distance physique fait partie de la latence. Quand les utilisateurs sont géographiquement distribués, servez le trafic sensible à la latence depuis une infrastructure proche d’eux chaque fois que la charge le permet. Les CDN rapprochent le contenu en cache des utilisateurs, tandis que l’edge computing peut y déplacer aussi le calcul. Aucune optimisation du backend ne peut éliminer la latence réseau créée par une distance inutile.
Router les utilisateurs vers le bon emplacement
Déployer près des utilisateurs n’aide que si le trafic atteint le bon emplacement. Un DNS géo-aware peut renvoyer des endpoints différents selon l’origine d’une requête DNS, tandis que les gestionnaires de trafic globaux et les réseaux anycast peuvent orienter le trafic vers une infrastructure proche. Le routage doit tenir compte de la disponibilité autant que de la proximité : quand l’emplacement le plus proche est indisponible, le trafic doit être dirigé ailleurs. Placement et routage fonctionnent ensemble — placez la capacité près des utilisateurs, puis routez les utilisateurs vers elle.
Chemins critiques et architecture
À partir d’une certaine échelle, aucun réglage au niveau du code ne peut sauver une architecture mal conçue. La façon dont les services sont découpés, l’endroit où le travail s’exécute et ce qui tourne au premier plan plutôt qu’en arrière-plan déterminent le plafond de performance du système.
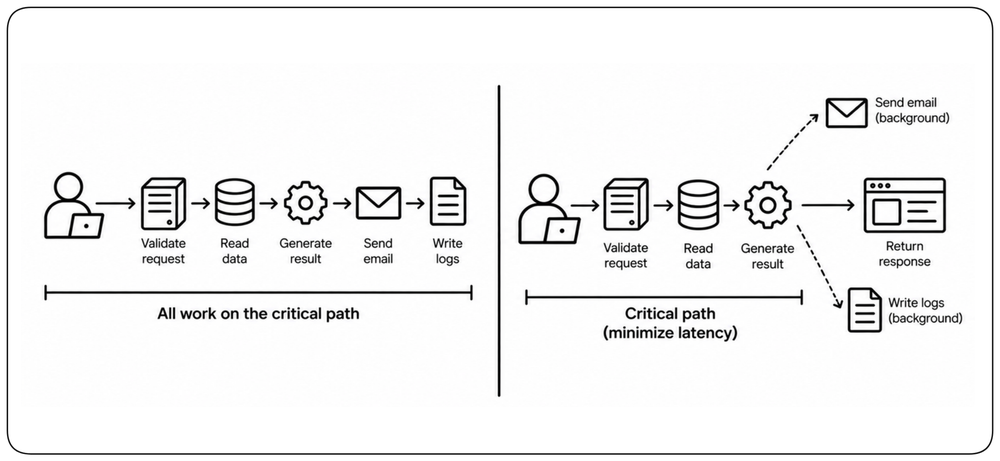
Garder le travail hors du chemin critique
Tout le code ne se vaut pas. !!Le chemin critique est la séquence d’opérations entre l’action de l’utilisateur et le résultat visible — chaque milliseconde sur ce chemin se ressent.!! Le travail en dehors du chemin critique peut ne pas affecter directement la latence visible, mais il consomme quand même des ressources et peut affecter le débit et la capacité. Cartographiez le chemin critique, parallélisez ce qui peut l’être et poussez le travail non essentiel vers le traitement en arrière-plan.
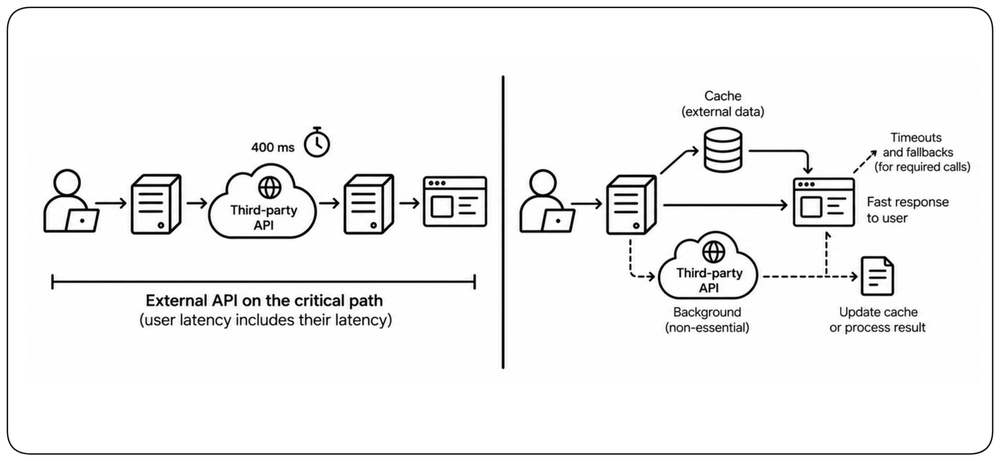
Garder les dépendances externes hors du chemin critique
Chaque dépendance externe synchrone transfère une partie de votre budget de latence à un système que vous ne contrôlez pas. !!Si l’utilisateur ne peut recevoir de réponse avant qu’une API tierce ne réponde, la latence et le comportement de queue de ce fournisseur deviennent une partie de votre propre SLO.!! Mettez en cache les données externes quand c’est possible, déplacez les appels non essentiels vers le traitement en arrière-plan, et définissez des timeouts stricts et des fallbacks pour les dépendances qui doivent rester synchrones.
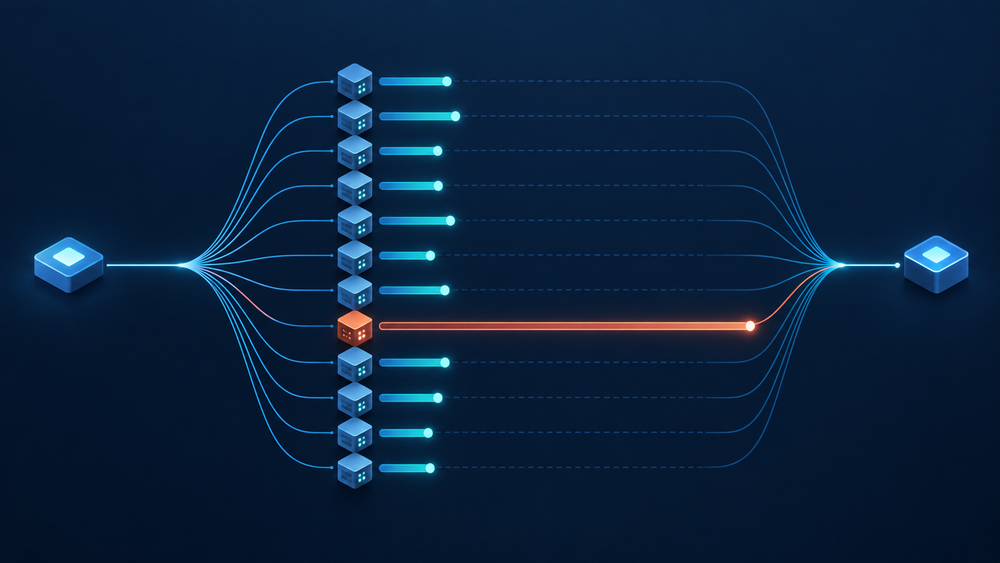
Le fan-out amplifie la latence de queue
Une requête qui dépend de nombreux appels en aval hérite du plus lent. Même quand chaque dépendance est généralement rapide, le fan-out rend de plus en plus probable de tomber sur une réponse lente. Si 100 appels indépendants ont chacun 1 % de chances d’être lents, la probabilité qu’au moins un le soit est d’environ 63 %. La latence de queue se compose le long des chemins de requêtes distribués. Réduisez le fan-out inutile, bornez la concurrence et concevez les chemins sensibles à la latence autour de la queue plutôt que de la moyenne.
Monolithe vs microservices
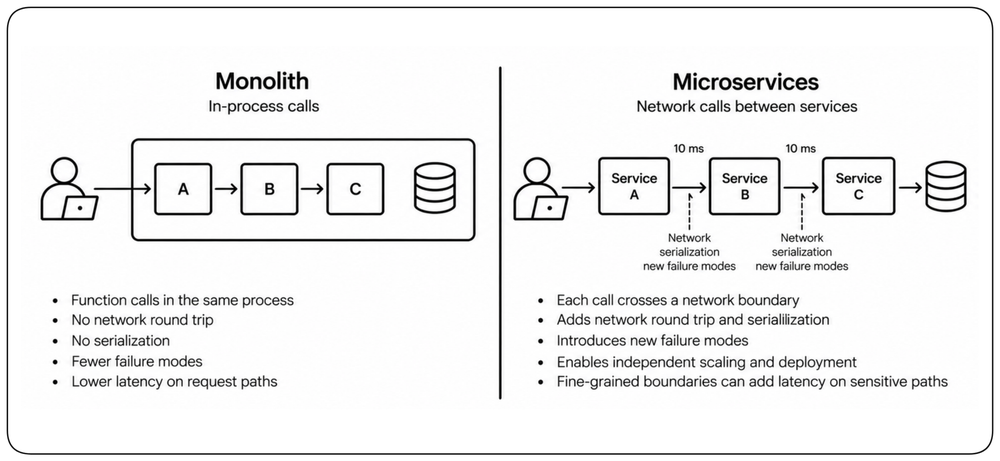
Un monolithe appelle des fonctions in-process ; une frontière de service ajoute un aller-retour réseau, de la sérialisation et de nouveaux modes de défaillance. Les microservices peuvent offrir un scaling et un déploiement indépendants, mais des frontières trop fines ajoutent de la latence aux chemins de requêtes sensibles. Choisissez des frontières qui correspondent à la propriété et aux besoins de scaling, et évitez les appels distants inutiles sur les chemins aux budgets de latence serrés.
Scaling horizontal vs vertical
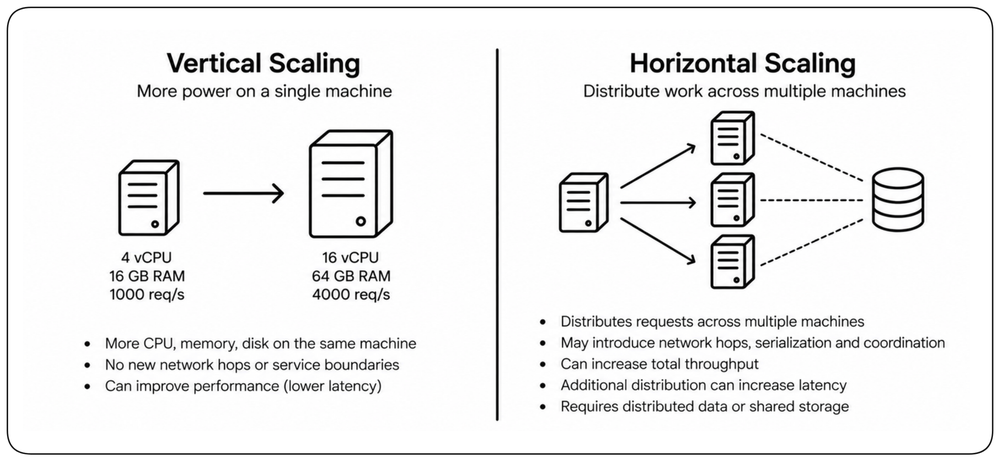
Le scaling change les caractéristiques de performance d’un système, pas seulement sa capacité. Le scaling vertical peut améliorer la performance sans ajouter de frontières de communication, tandis que le scaling horizontal distribue le travail mais peut introduire des sauts réseau, de la sérialisation, de la coordination et des coûts liés aux données distribuées. Le scale-out est précieux quand la charge l’exige, mais une distribution supplémentaire peut augmenter la latence tout en augmentant le débit total.
En savoir plus
Chapitre : Concevoir pour la scalabilité.
Performance des LLM
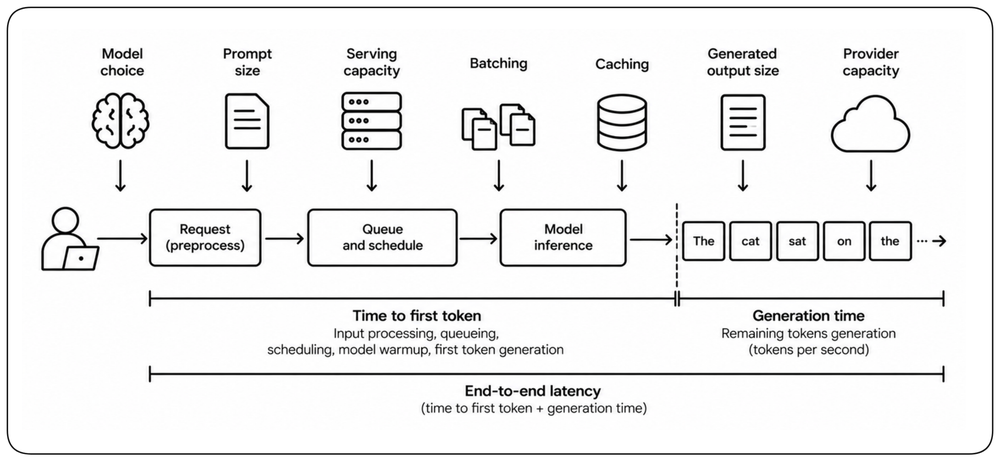
La performance des LLM dépend de plus que de la vitesse du modèle. Le choix du modèle, la taille du prompt, la sortie générée, la capacité de serving, le batching, le caching et la capacité du fournisseur affectent tous la latence ressentie par les utilisateurs. Contrairement au traitement de requêtes classique, l’inférence a souvent une phase distincte de time to first token et une phase de génération, qu’il faut donc concevoir et mesurer explicitement.
Mesurer le time to first token et la vitesse de génération
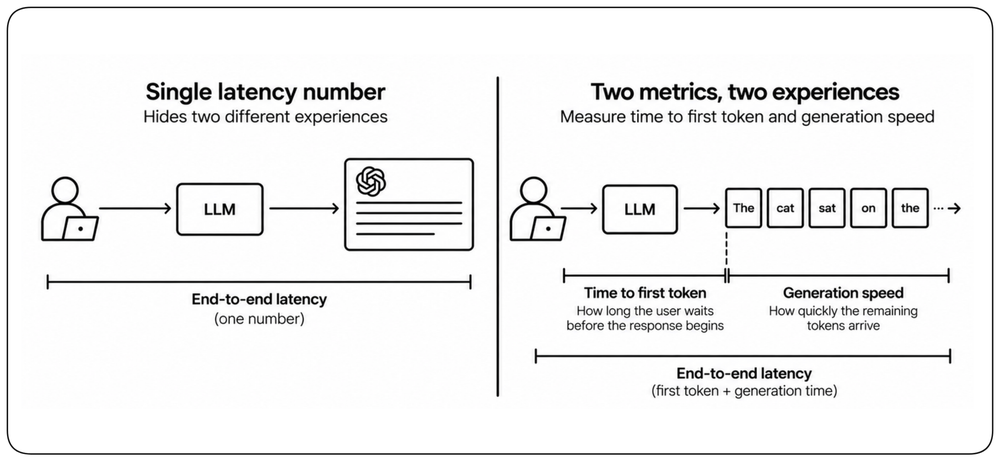
Un seul chiffre de latence de bout en bout masque deux expériences différentes. Le time to first token mesure combien de temps l’utilisateur attend avant que la réponse ne commence ; la vitesse de génération mesure la rapidité d’arrivée des tokens restants. Les applications interactives peuvent se soucier davantage d’un premier token rapide et d’un streaming régulier que du temps nécessaire pour générer la réponse complète. Streamez les tokens au fur et à mesure de leur génération pour que l’utilisateur puisse commencer à consommer la réponse immédiatement au lieu d’attendre la génération complète. Mesurez les deux séparément, ainsi que la latence de bout en bout.
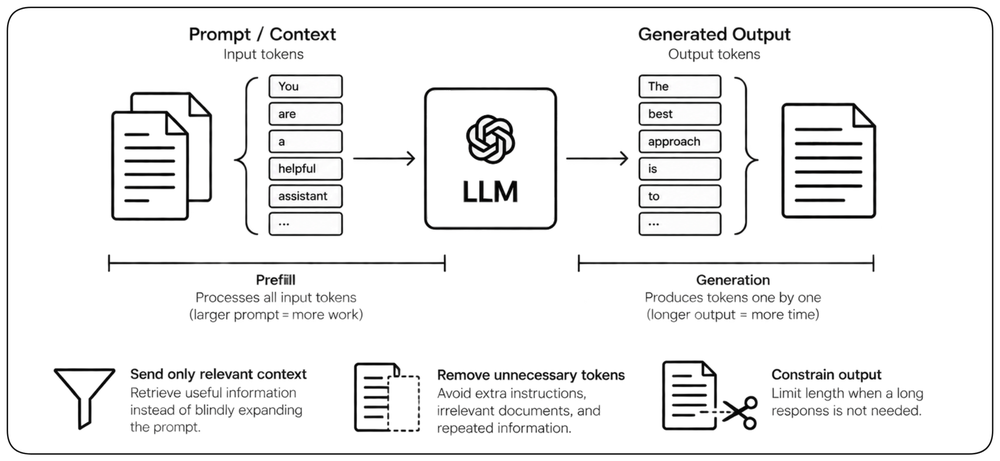
Les tokens sont l’unité de travail des LLM
Le coût et la latence de l’inférence LLM croissent avec la quantité de contexte traité et de sortie générée. Les gros prompts augmentent le travail de prefill, tandis que les longues réponses allongent le temps de génération token après token. N’envoyez que le contexte qui contribue au résultat, récupérez les informations pertinentes au lieu d’étendre aveuglément les prompts, et contraignez la sortie quand l’application n’a pas besoin d’une longue réponse. Réduire les tokens inutiles améliore en même temps la latence, le débit et le coût.
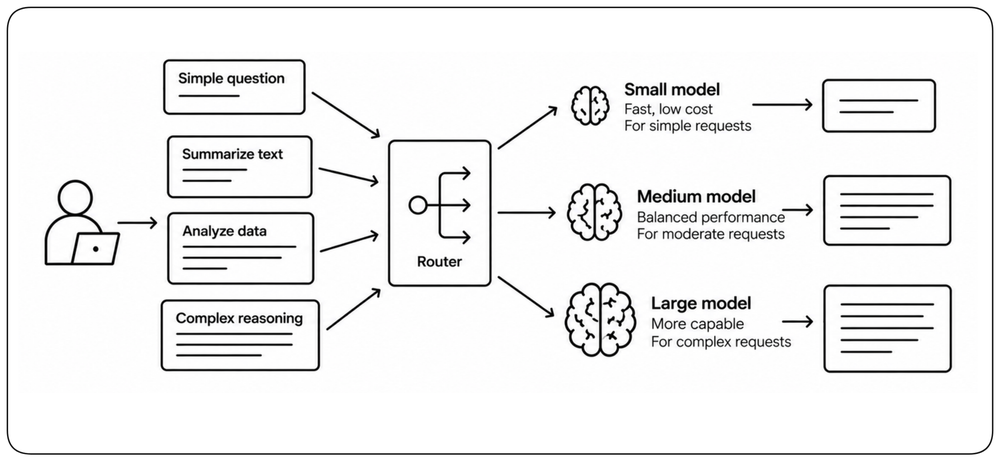
Choisir le plus petit modèle qui répond à l’exigence
Les modèles plus grands demandent généralement plus de calcul et peuvent offrir des capacités dont la charge n’a pas toujours besoin. Routez le travail selon sa difficulté réelle : les requêtes simples peuvent utiliser des modèles plus petits et plus rapides tandis que les plus difficiles utilisent des modèles plus capables. Le choix du modèle est donc une décision de performance autant que de qualité. Faites vos benchmarks sur les vrais prompts de l’application et la qualité de sortie requise, plutôt que de supposer qu’un seul modèle doit servir toutes les requêtes.
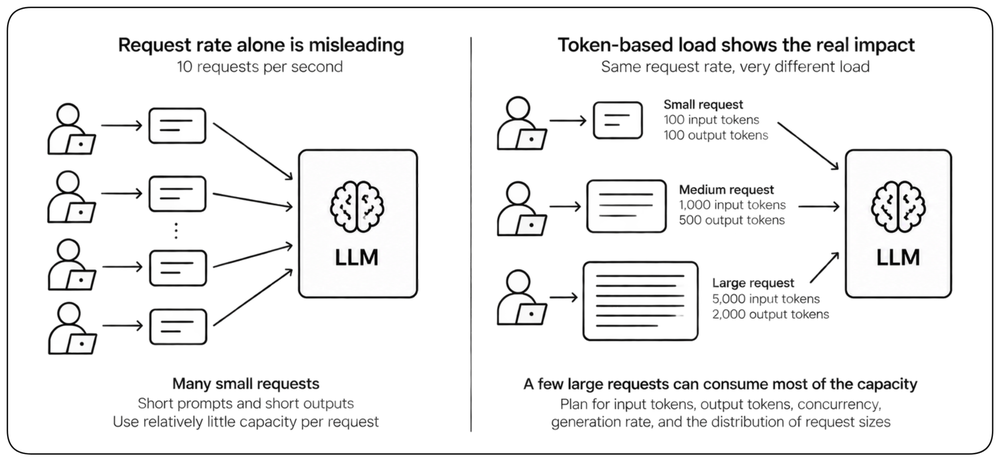
Concevoir pour le débit LLM, pas seulement le taux de requêtes
Deux requêtes peuvent consommer des quantités radicalement différentes de capacité d’inférence parce que leurs prompts et leurs sorties générées diffèrent en longueur. Les requêtes par seconde seules décrivent donc mal la charge d’un LLM. Le capacity planning doit inclure les tokens d’entrée, les tokens de sortie, la concurrence, le rythme de génération et la distribution des tailles de requêtes. Quelques grosses générations peuvent consommer une capacité qui servirait autrement de nombreuses petites requêtes.
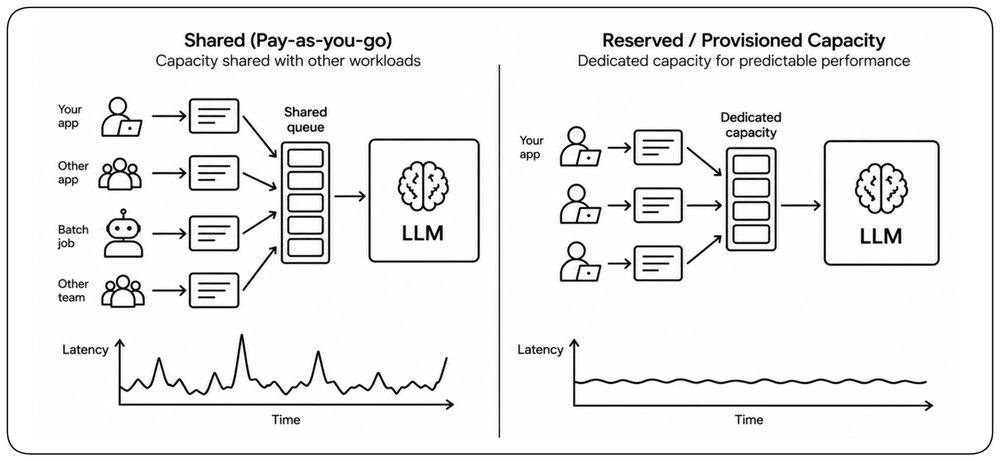
Une latence prévisible exige une capacité réservée
L’inférence partagée en pay-as-you-go est pratique pour une demande variable, mais la latence dépend d’une capacité partagée avec d’autres charges et peut ne pas s’accompagner d’un engagement de performance. Si une application exige une latence prévisible sous charge soutenue, une capacité de serving dédiée ou provisionnée peut réduire la variabilité introduite par la capacité partagée. La capacité provisionnée ou réservée échange de la flexibilité et un engagement plus élevé contre un débit et une latence plus prévisibles. Traitez le niveau de serving comme une partie de l’architecture de performance : utilisez la capacité partagée là où la variabilité est acceptable et réservez de la capacité là où le SLO de latence l’exige.
Compromis de performance
Chaque choix de performance se paie ailleurs — en sécurité, en fiabilité, en coût ou en maintenabilité. La discipline consiste à assumer chaque compromis explicitement.
Performance vs sécurité
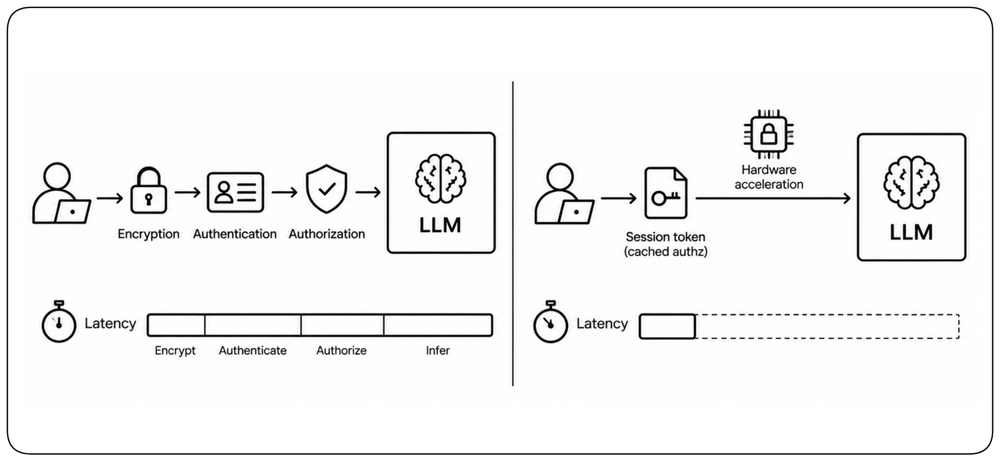
Le chiffrement, l’authentification et l’autorisation ajoutent tous un coût à chaque requête. L’accélération matérielle moderne a considérablement réduit ce coût, et des patterns comme les tokens de session ou l’autorisation en cache peuvent le réduire encore. Sécurité et performance sont des exigences conjointes à concevoir, pas des forces opposées à sacrifier à la légère.
Performance vs fiabilité
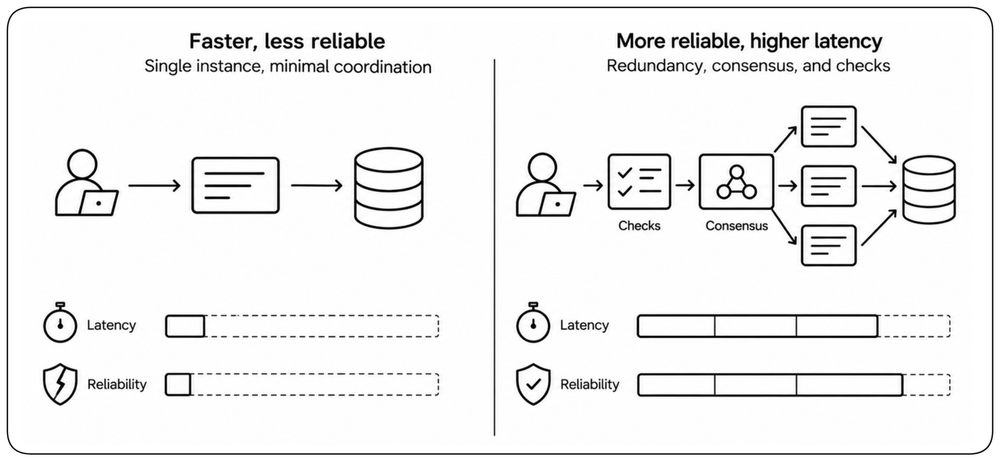
La redondance améliore la fiabilité et peut dégrader la latence brute — écrire sur plusieurs réplicas prend plus de temps que sur un seul, les protocoles de consensus ajoutent de la coordination et les circuit breakers ajoutent une vérification à chaque appel. Le compromis est asymétrique : un système rapide qui perd des données ou plante sous charge n’apporte aucune valeur. La performance vit dans l’enveloppe que la fiabilité définit.
Pour aller plus loin
Chapitre : Concevoir pour la résilience.
Performance vs coût
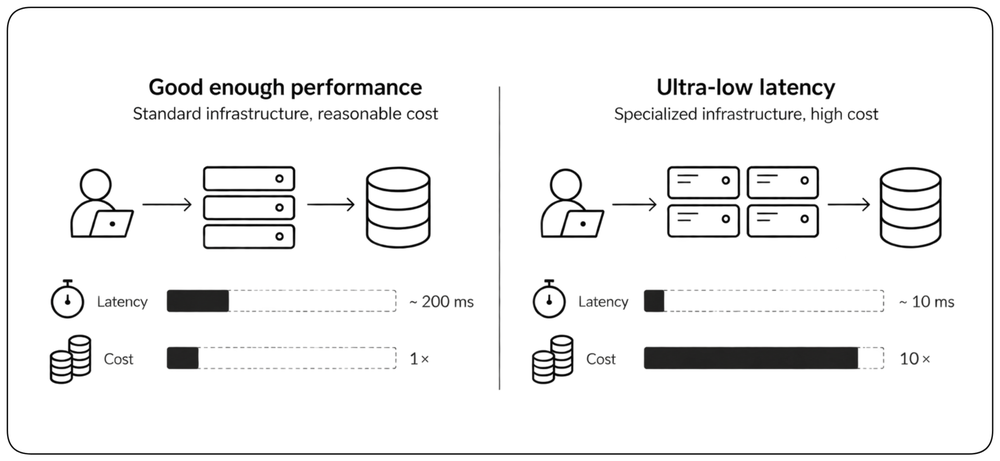
La dernière milliseconde — et le dernier percentile — peuvent être disproportionnellement coûteux. Faire baisser la latence p99 peut exiger de la capacité supplémentaire, des instances dédiées, des chemins réseau premium, une infrastructure in-memory et un effort d’ingénierie important. Fixez le SLO de latence là où la performance crée une vraie valeur, puis arrêtez de dépenser quand une amélioration supplémentaire ne justifie plus son coût.
Prouver la performance
Un système que vous ne voyez pas est un système que vous ne pouvez pas améliorer. Définissez d’abord le contrat de performance, observez son comportement en production et testez délibérément les limites de son enveloppe d’exploitation.
Décaler la performance vers la gauche
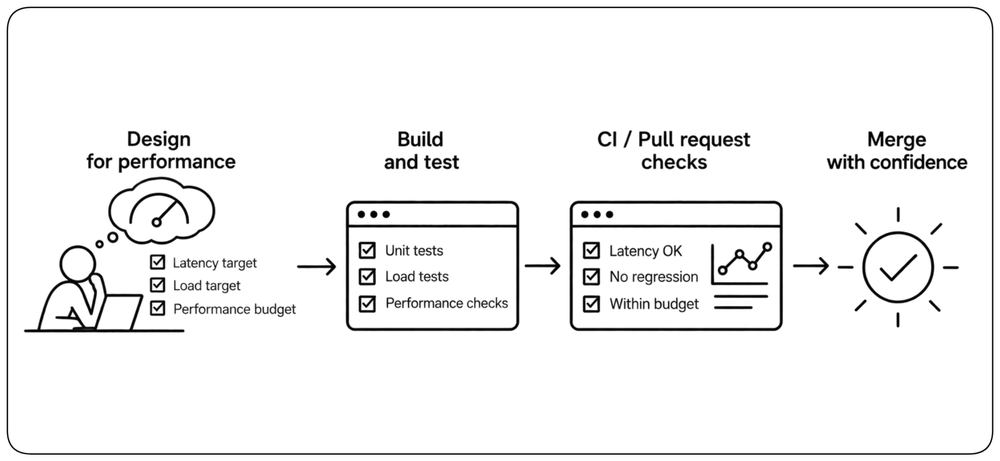
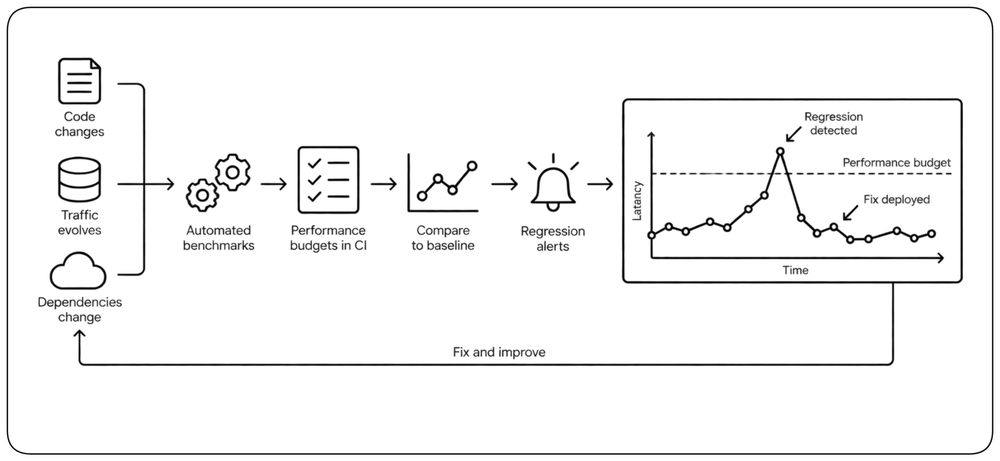
Les problèmes de performance sont moins chers et plus faciles à traiter avant d’être ancrés dans l’architecture de production. Intégrez cibles de latence, tests de charge et vérifications de budget dès la phase de conception et dans la CI — pas dans le post-mortem. Une régression détectée sur une pull request prend quelques minutes ; la même en production demande une war room.
Observabilité de la performance
L’observabilité est la capacité de comprendre l’état interne d’un système à partir de ses sorties externes. !!Les métriques portent des chiffres comme la latence, le débit, la saturation et les erreurs ; les traces suivent des requêtes individuelles à travers les services ; les logs expliquent ce qui s’est passé quand les chiffres se dégradent.!! En production, ces signaux révèlent comment le trafic réel utilise le système et où le temps et la capacité sont dépensés.
Tests de charge
Les tests de charge relient les cibles de performance à la capacité. Augmentez un trafic réaliste jusqu’à ce que des files se forment, que la latence grimpe fortement, que le débit cesse de croître ou que des erreurs apparaissent. L’objectif est de découvrir le point de saturation du système et son enveloppe d’exploitation utilisable, pas seulement de prouver que le trafic attendu passe.
Amélioration continue de la performance
La performance régresse à mesure que les systèmes, le trafic et les dépendances évoluent. Les benchmarks automatisés, les budgets de performance en CI et les alertes de régression rendent ces changements visibles tôt et font de l’amélioration une discipline de routine.
Conclusion
La performance est une enveloppe d’exploitation mesurable
Définissez la charge de travail et l’objectif de latence. Mesurez où le temps et la capacité sont dépensés. Supprimez le travail inutile, optimisez le vrai goulot d’étranglement et validez à nouveau sous charge réaliste. La performance n’est pas la vitesse maximale ; c’est un comportement prévisible dans une enveloppe d’exploitation définie.