Concevoir pour être livré (anciennement : CD)
Chapter Info
Calculating... Writing Progress: 70%
Le changement est la façon dont le logiciel crée de la valeur, mais chaque changement introduit un risque. La gestion moderne des releases est la discipline qui consiste à faire passer les systèmes d’un état à un autre de manière contrôlée, observable et réversible.
Ce chapitre explore comment les releases sont définies, promues, exécutées et gouvernées — de l’état déclaratif et de l’exposition progressive aux gates de promotion, au rollback et à l’architecture des plateformes de release.
Introduction
Le logiciel adaptatif, battement de cœur de l’entreprise
Le logiciel n’est pas un actif statique ; sa valeur vient de sa capacité à évoluer. Chaque nouvelle capacité, amélioration d’architecture ou adaptation métier exige du changement. La capacité à transformer des idées en logiciel fonctionnel, de façon sûre et continue, est donc devenue une compétence centrale de l’entreprise moderne.
L’essence de la release : provisioning vs déploiement
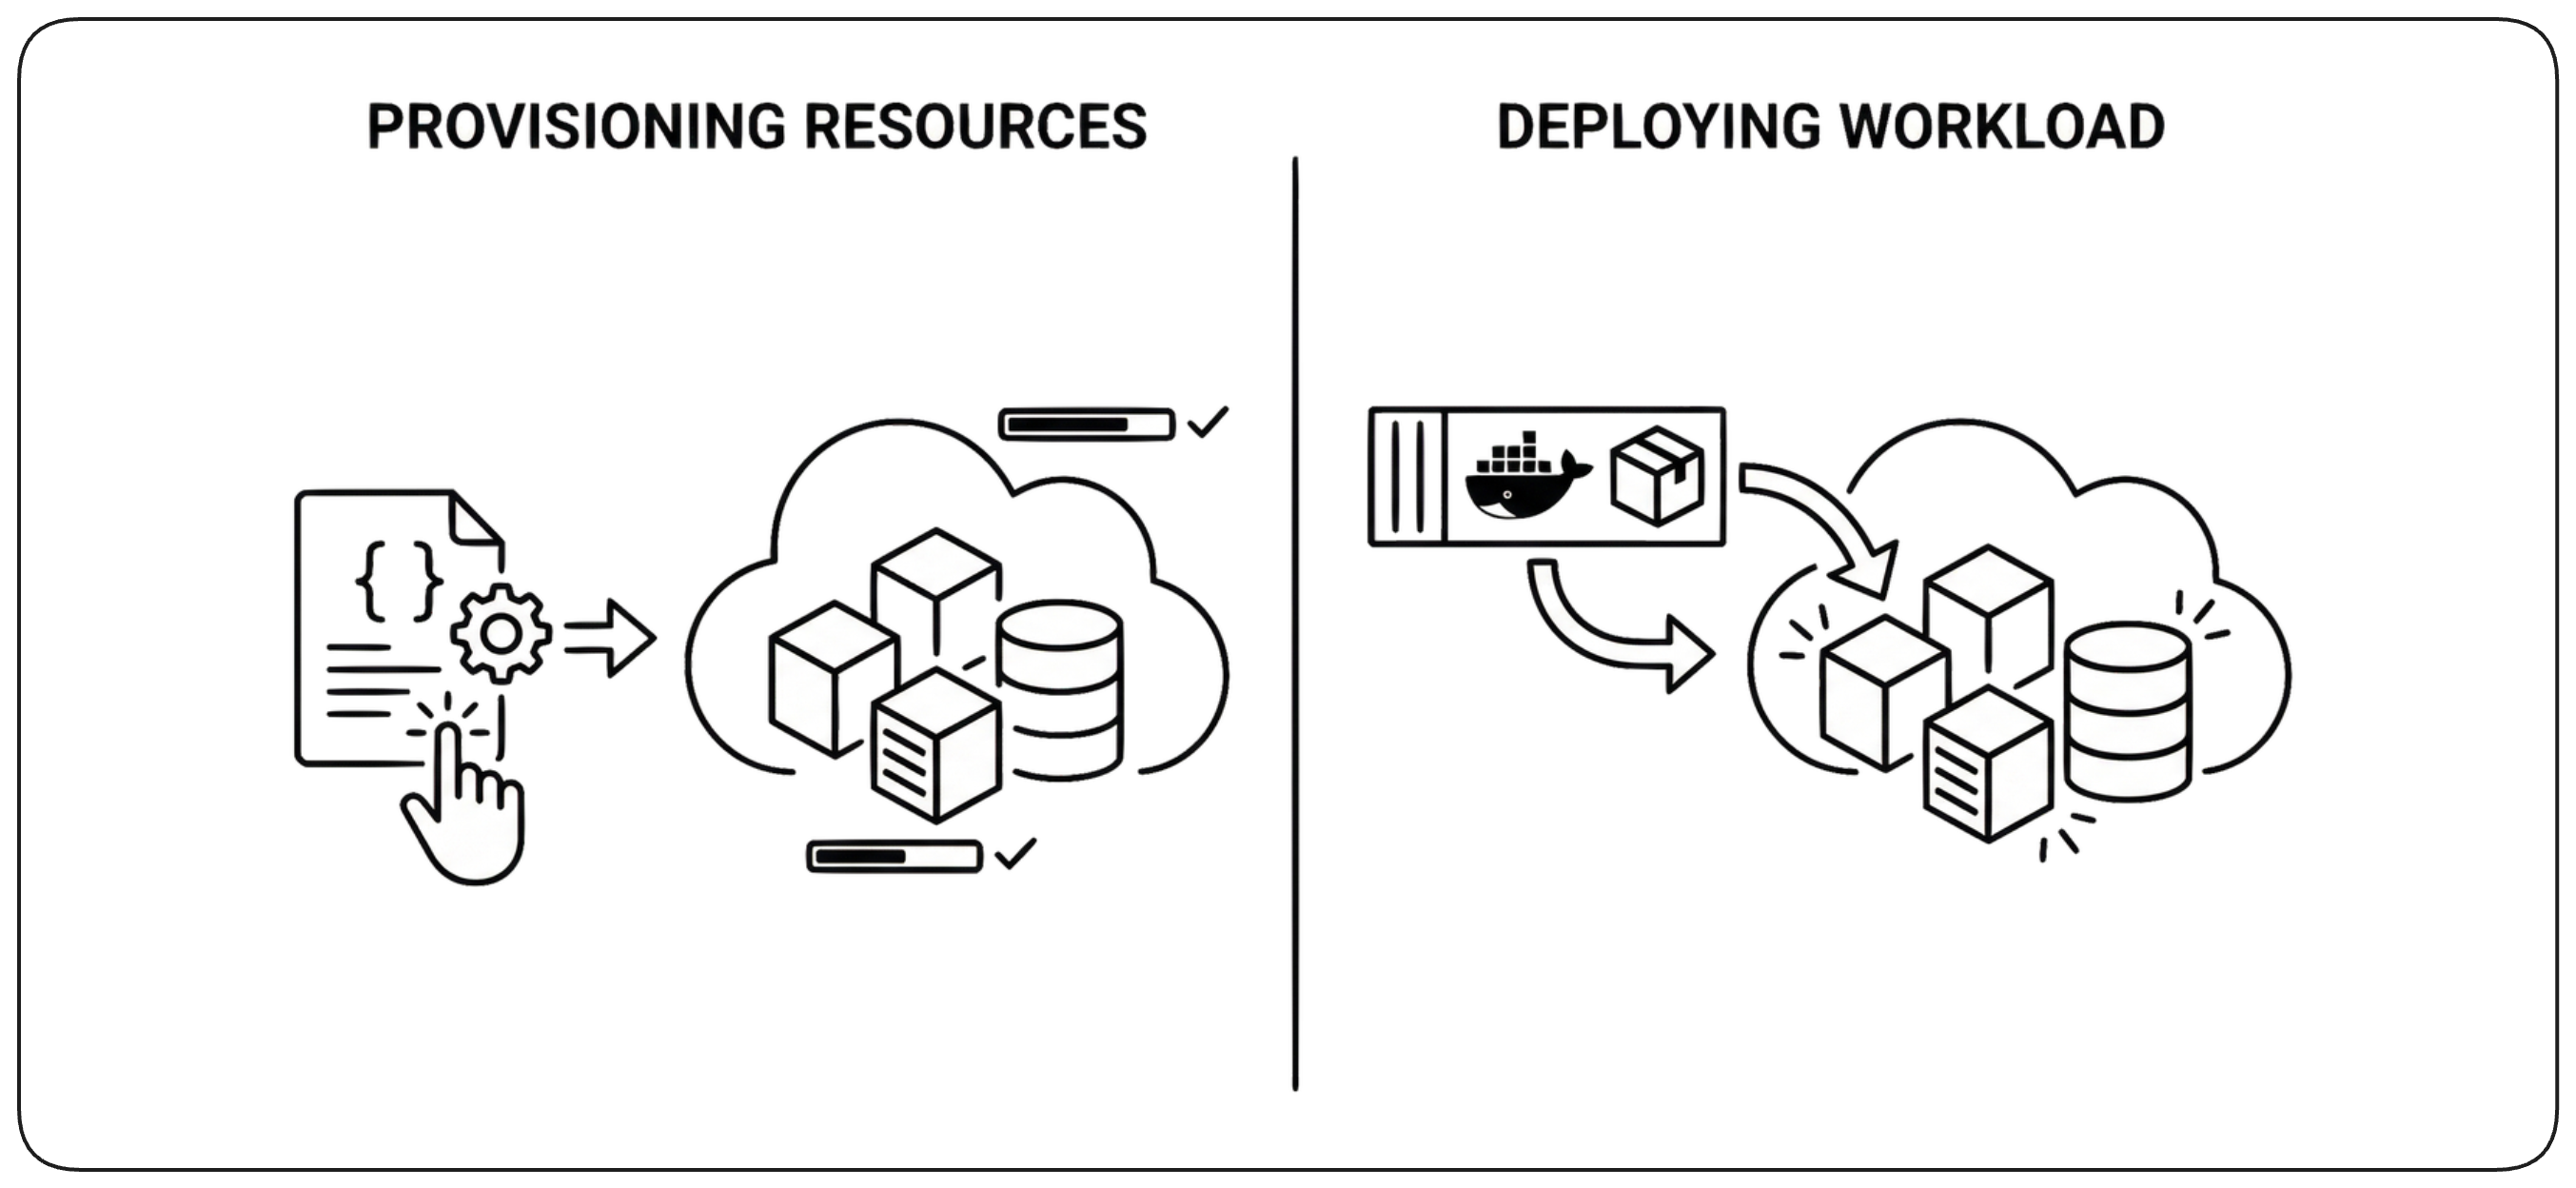
Un changement de système agit sur deux dimensions complémentaires. Le provisioning des ressources utilise l’Infrastructure-as-Code pour créer ou modifier l’infrastructure requise par le service. Le déploiement des workloads place des artefacts de build immuables — images de conteneur, binaires ou JARs — sur cette infrastructure. Ensemble, ils font évoluer l’infrastructure et le logiciel qui s’y exécute.
Le virage : du déploiement à la gestion des releases
Les premières pratiques de déploiement se concentraient sur l’exécution : pousser un artefact vers un environnement rapidement et de façon répétable. Mais un déploiement nous dit seulement que quelque chose s’est produit ; il ne définit pas l’état résultant du système et ne facilite pas le raisonnement sur le risque, le rollback et la responsabilité. La gestion moderne des releases traite donc la release comme un objet de premier ordre : un état défini et versionné, qui peut être nommé, comparé, promu, audité et restauré.
Une release ne signifie pas la même chose pour tout le monde
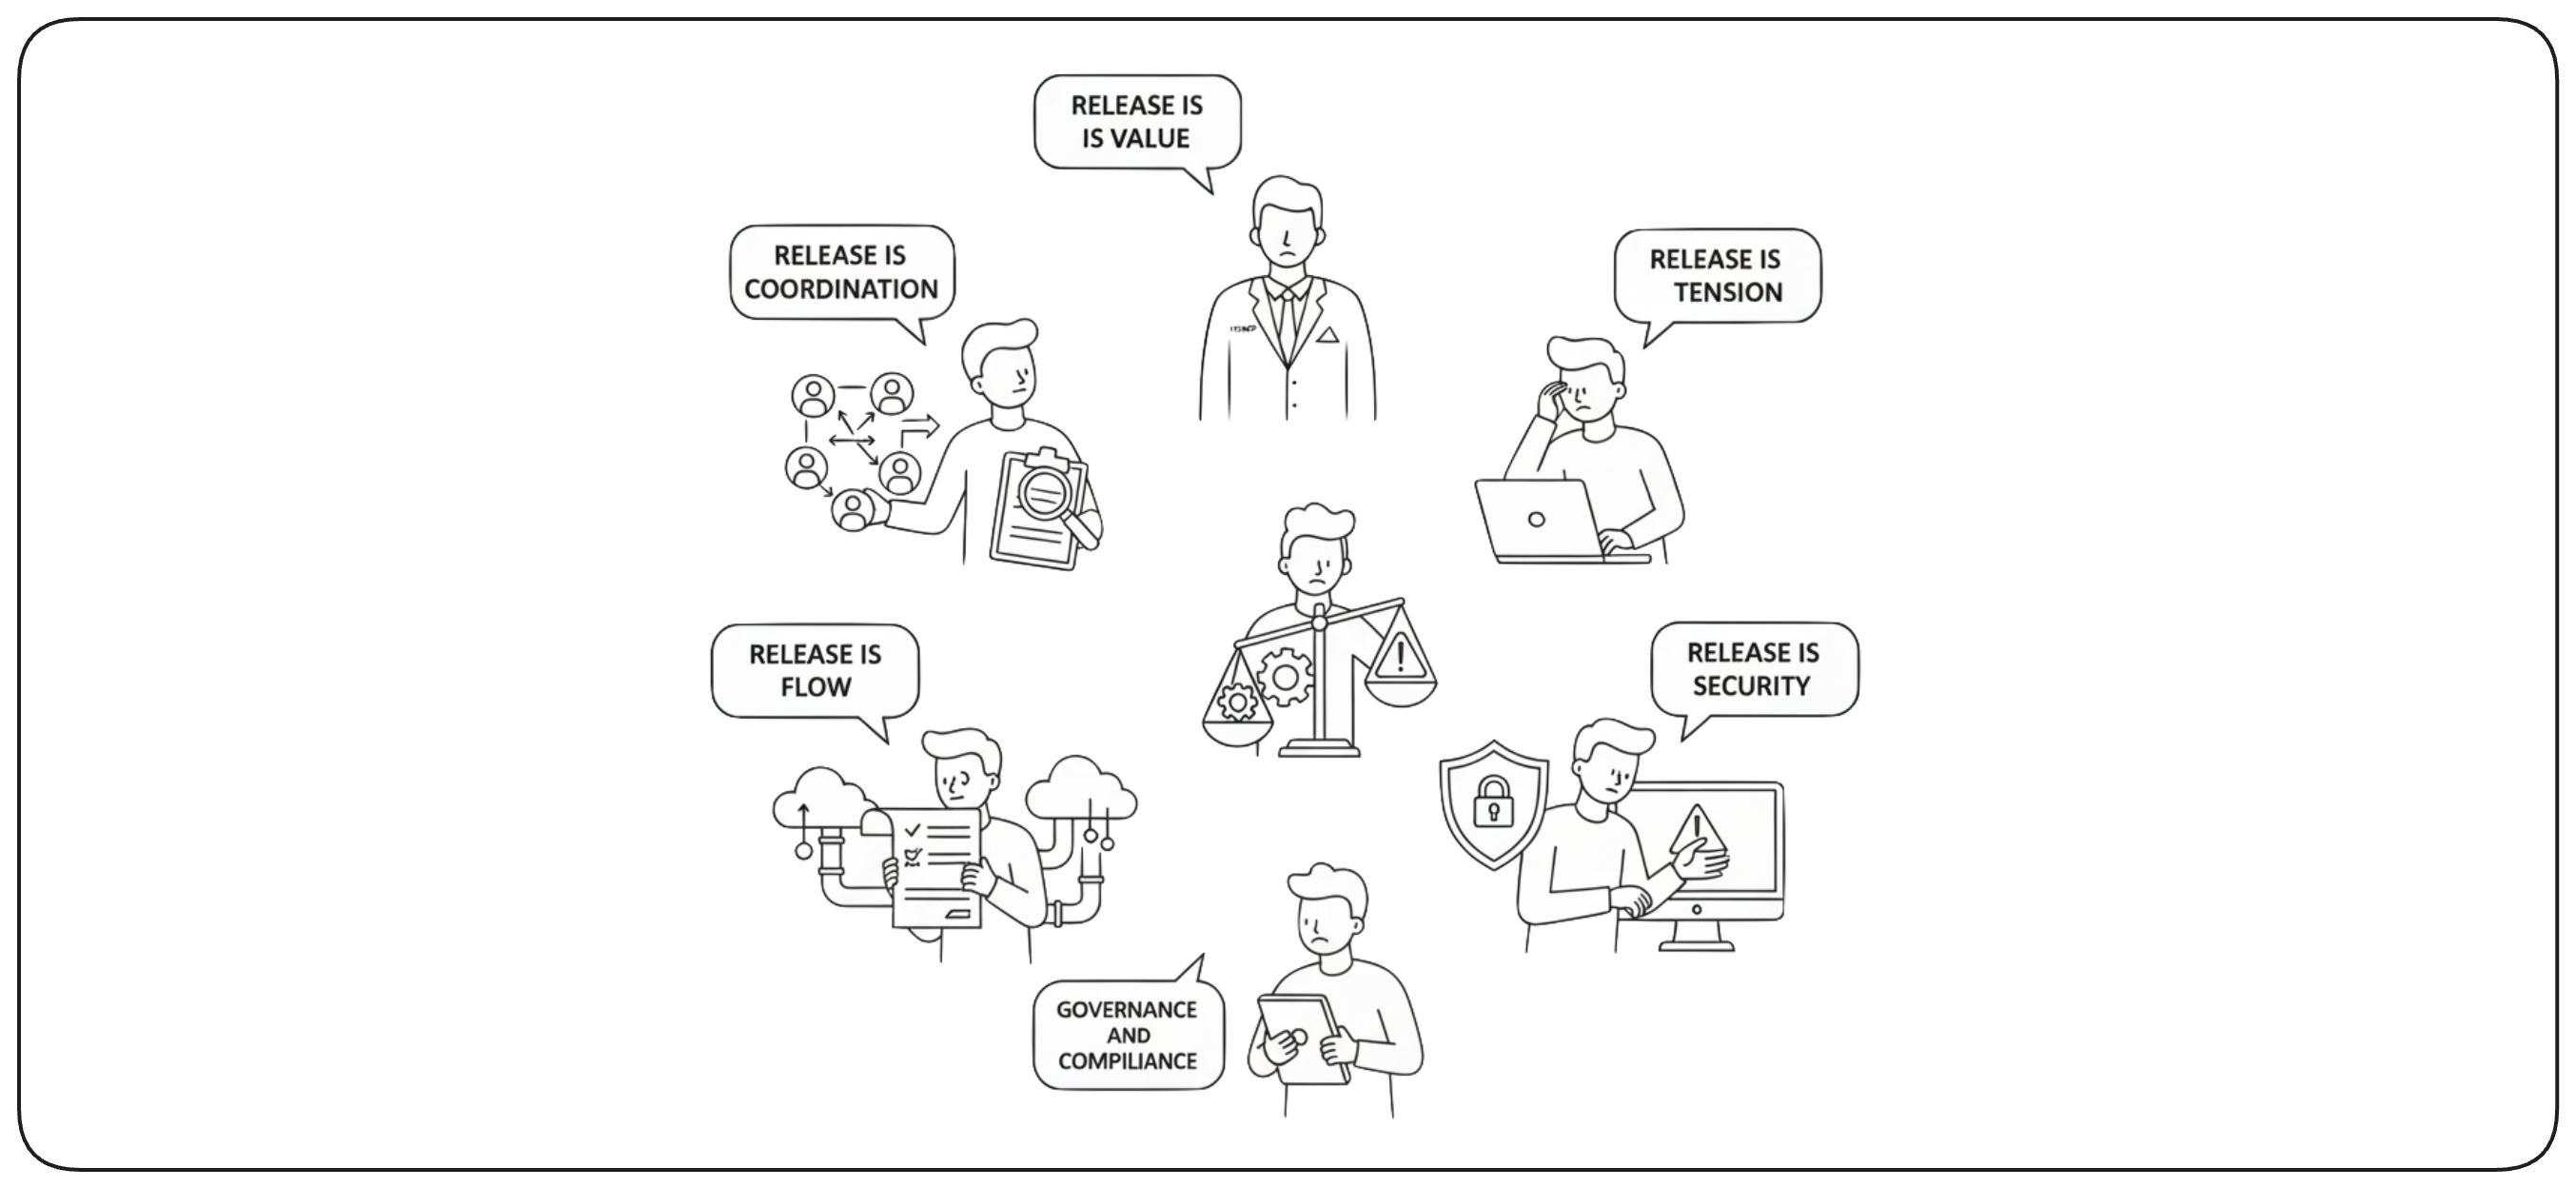
Une release signifie des choses différentes selon les rôles de l’organisation. Les développeurs y voient un changement qui atteint la production, la sécurité une nouvelle exposition, les managers du risque et de la coordination, les équipes plateforme un flux contrôlé, et le business de la valeur livrée. Chaque point de vue apporte ses attentes et ses contraintes. La gestion moderne des releases existe pour les réunir dans un cycle de vie unique où la valeur avance sans perdre en contrôle, en sécurité ni en responsabilité.
La release
Qu’est-ce qu’une release ?
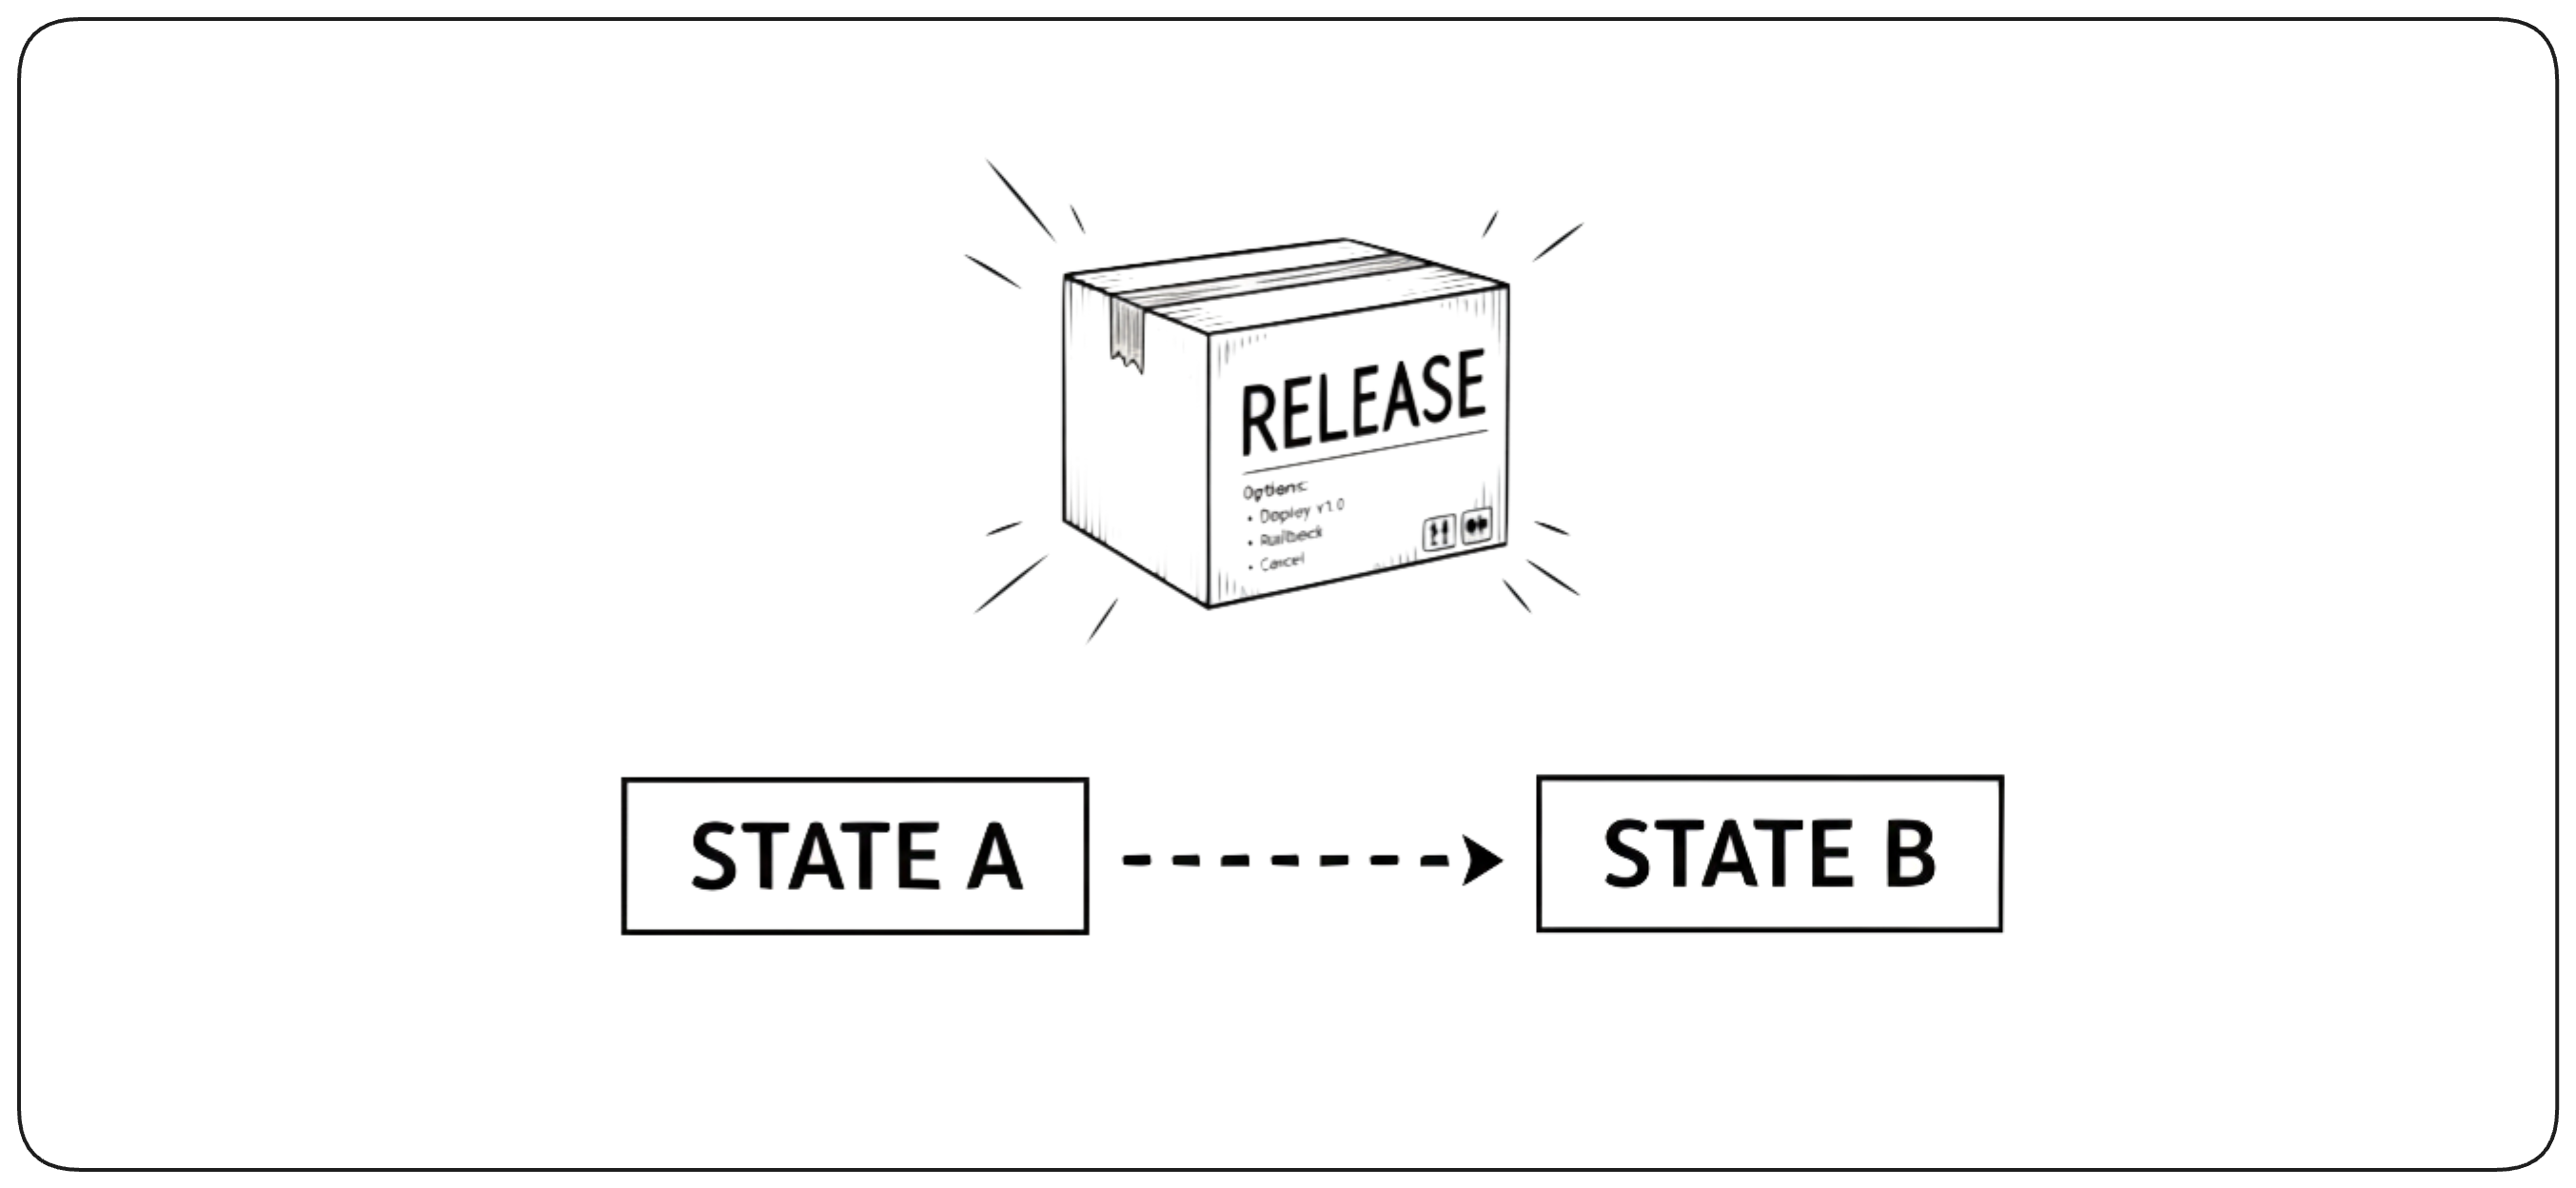
Une release résolue identifie un état de système précis et versionné : ce qui tourne, comment c’est configuré et les règles qui gouvernent sa promotion. Elle existe indépendamment de toute action de déploiement et fournit une unité stable qui peut être suivie, évaluée, promue et annulée.
Ne planifiez pas les releases, définissez-les
Une définition de release doit décrire l’état voulu, et non prescrire une séquence ponctuelle d’étapes de déploiement. Le système de livraison décide quand et où une release résolue peut progresser, en fonction des preuves, des politiques et de la disponibilité de la cible. La gestion des releases passe ainsi de l’orchestration d’étapes à la définition d’états valides et des règles qui gouvernent leur promotion.
La release est une responsabilité du développeur
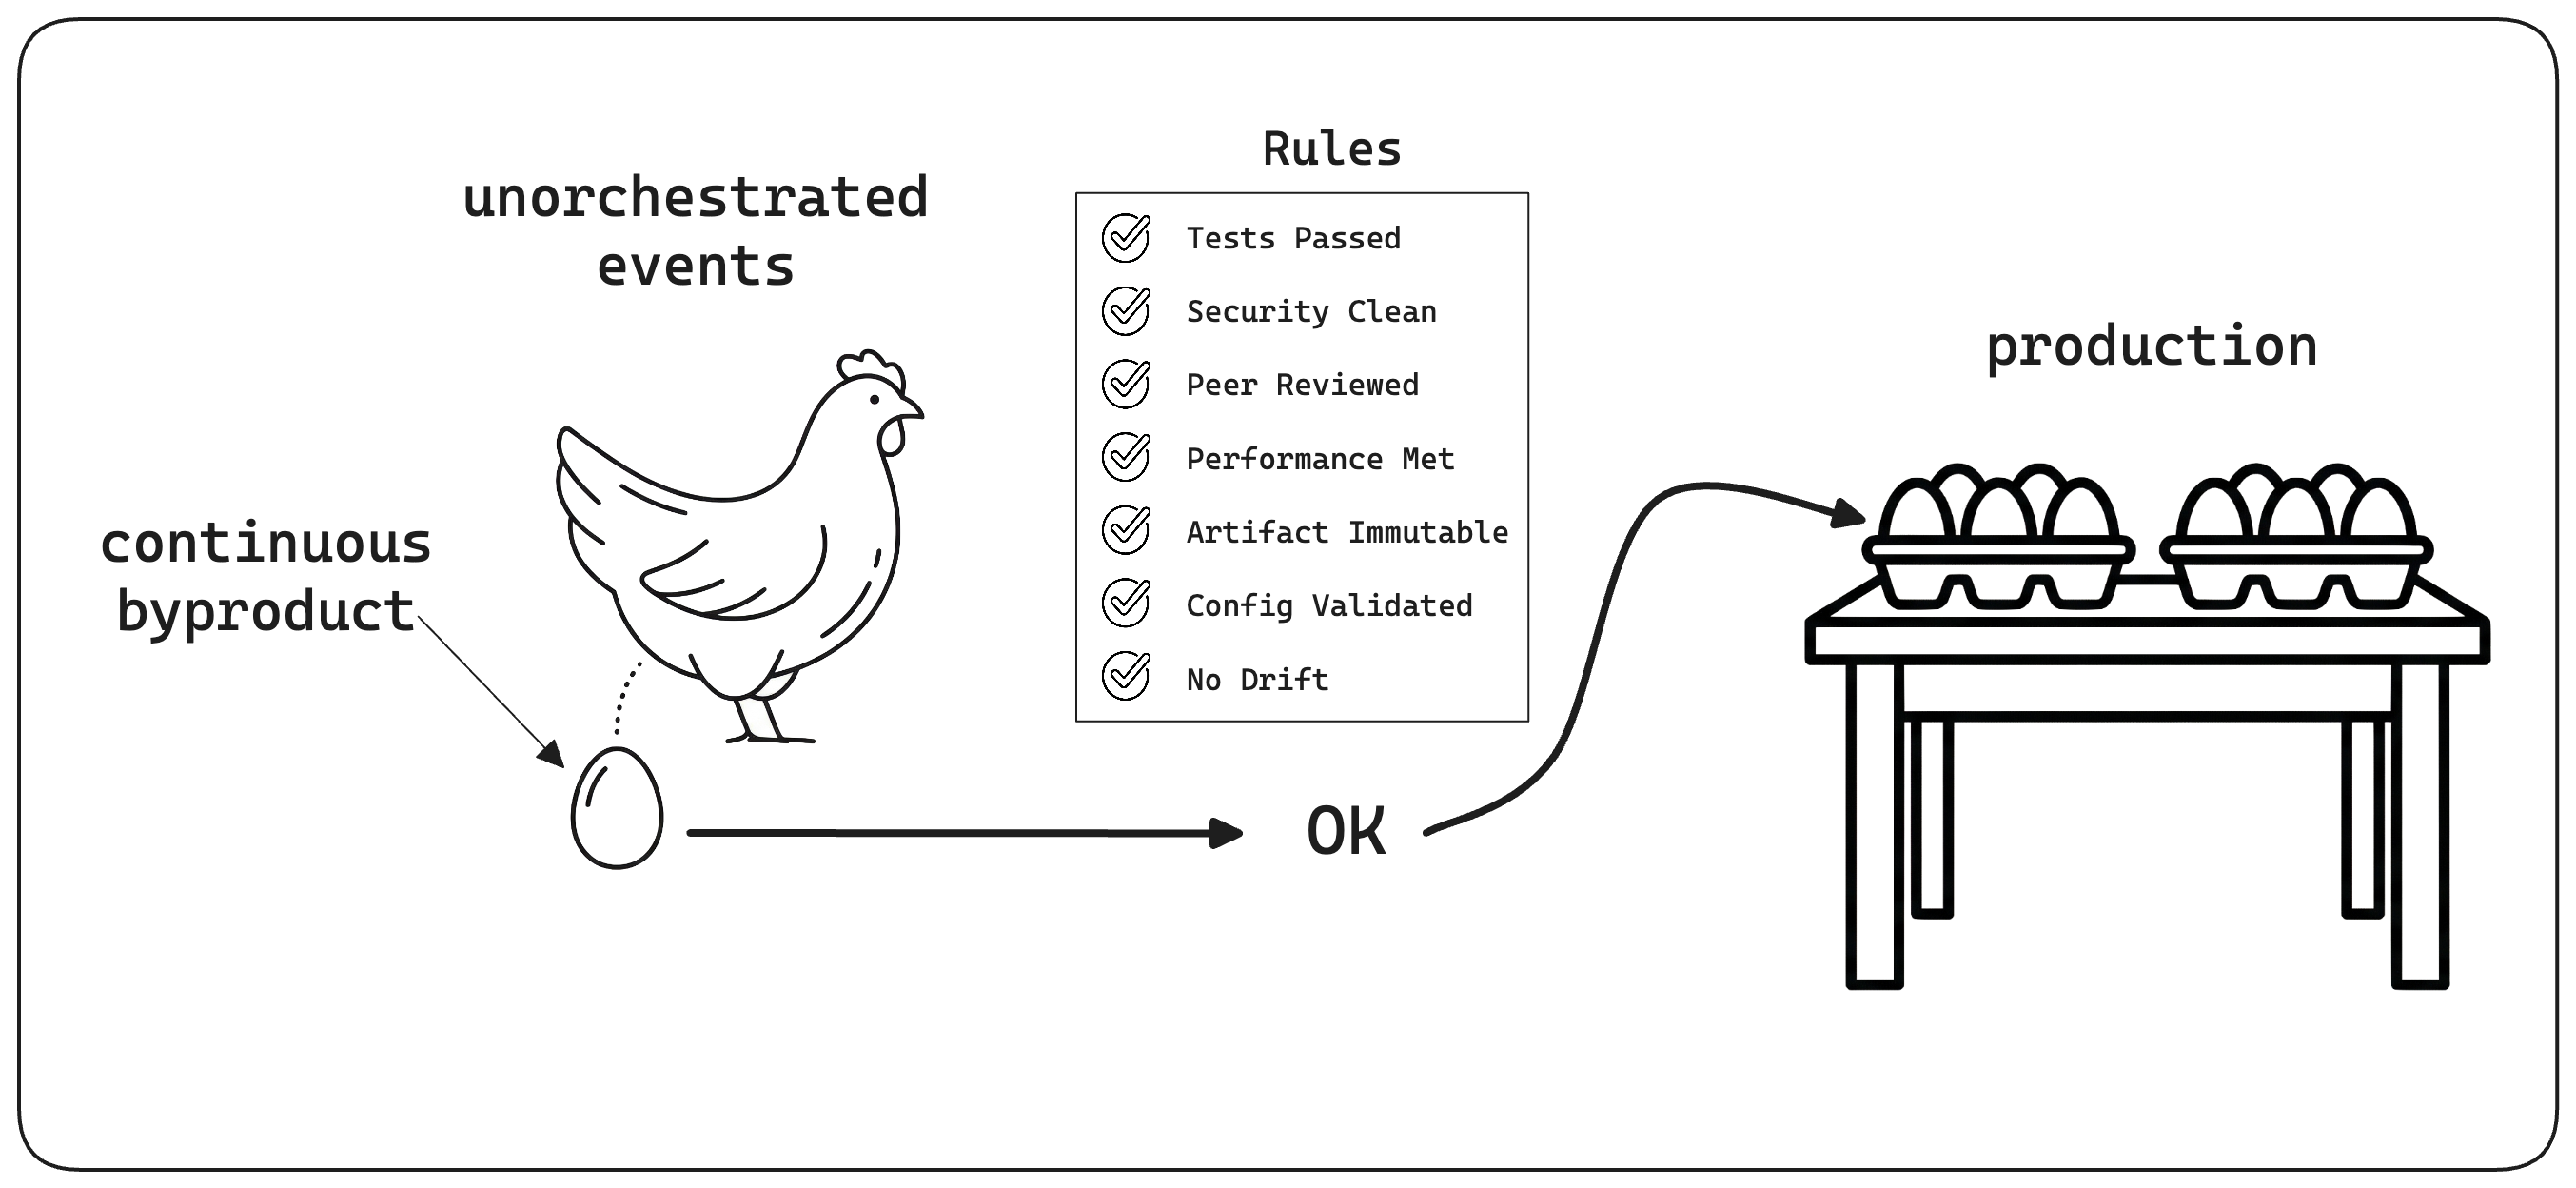
Les développeurs introduisent le changement et en comprennent l’intention ; leur responsabilité ne doit donc pas s’arrêter au merge. Ils restent responsables jusqu’à ce que le changement atteigne la production et fonctionne comme prévu. Cela crée un lien direct entre les décisions de développement et leur impact en production.
La gouvernance des releases est une responsabilité du système
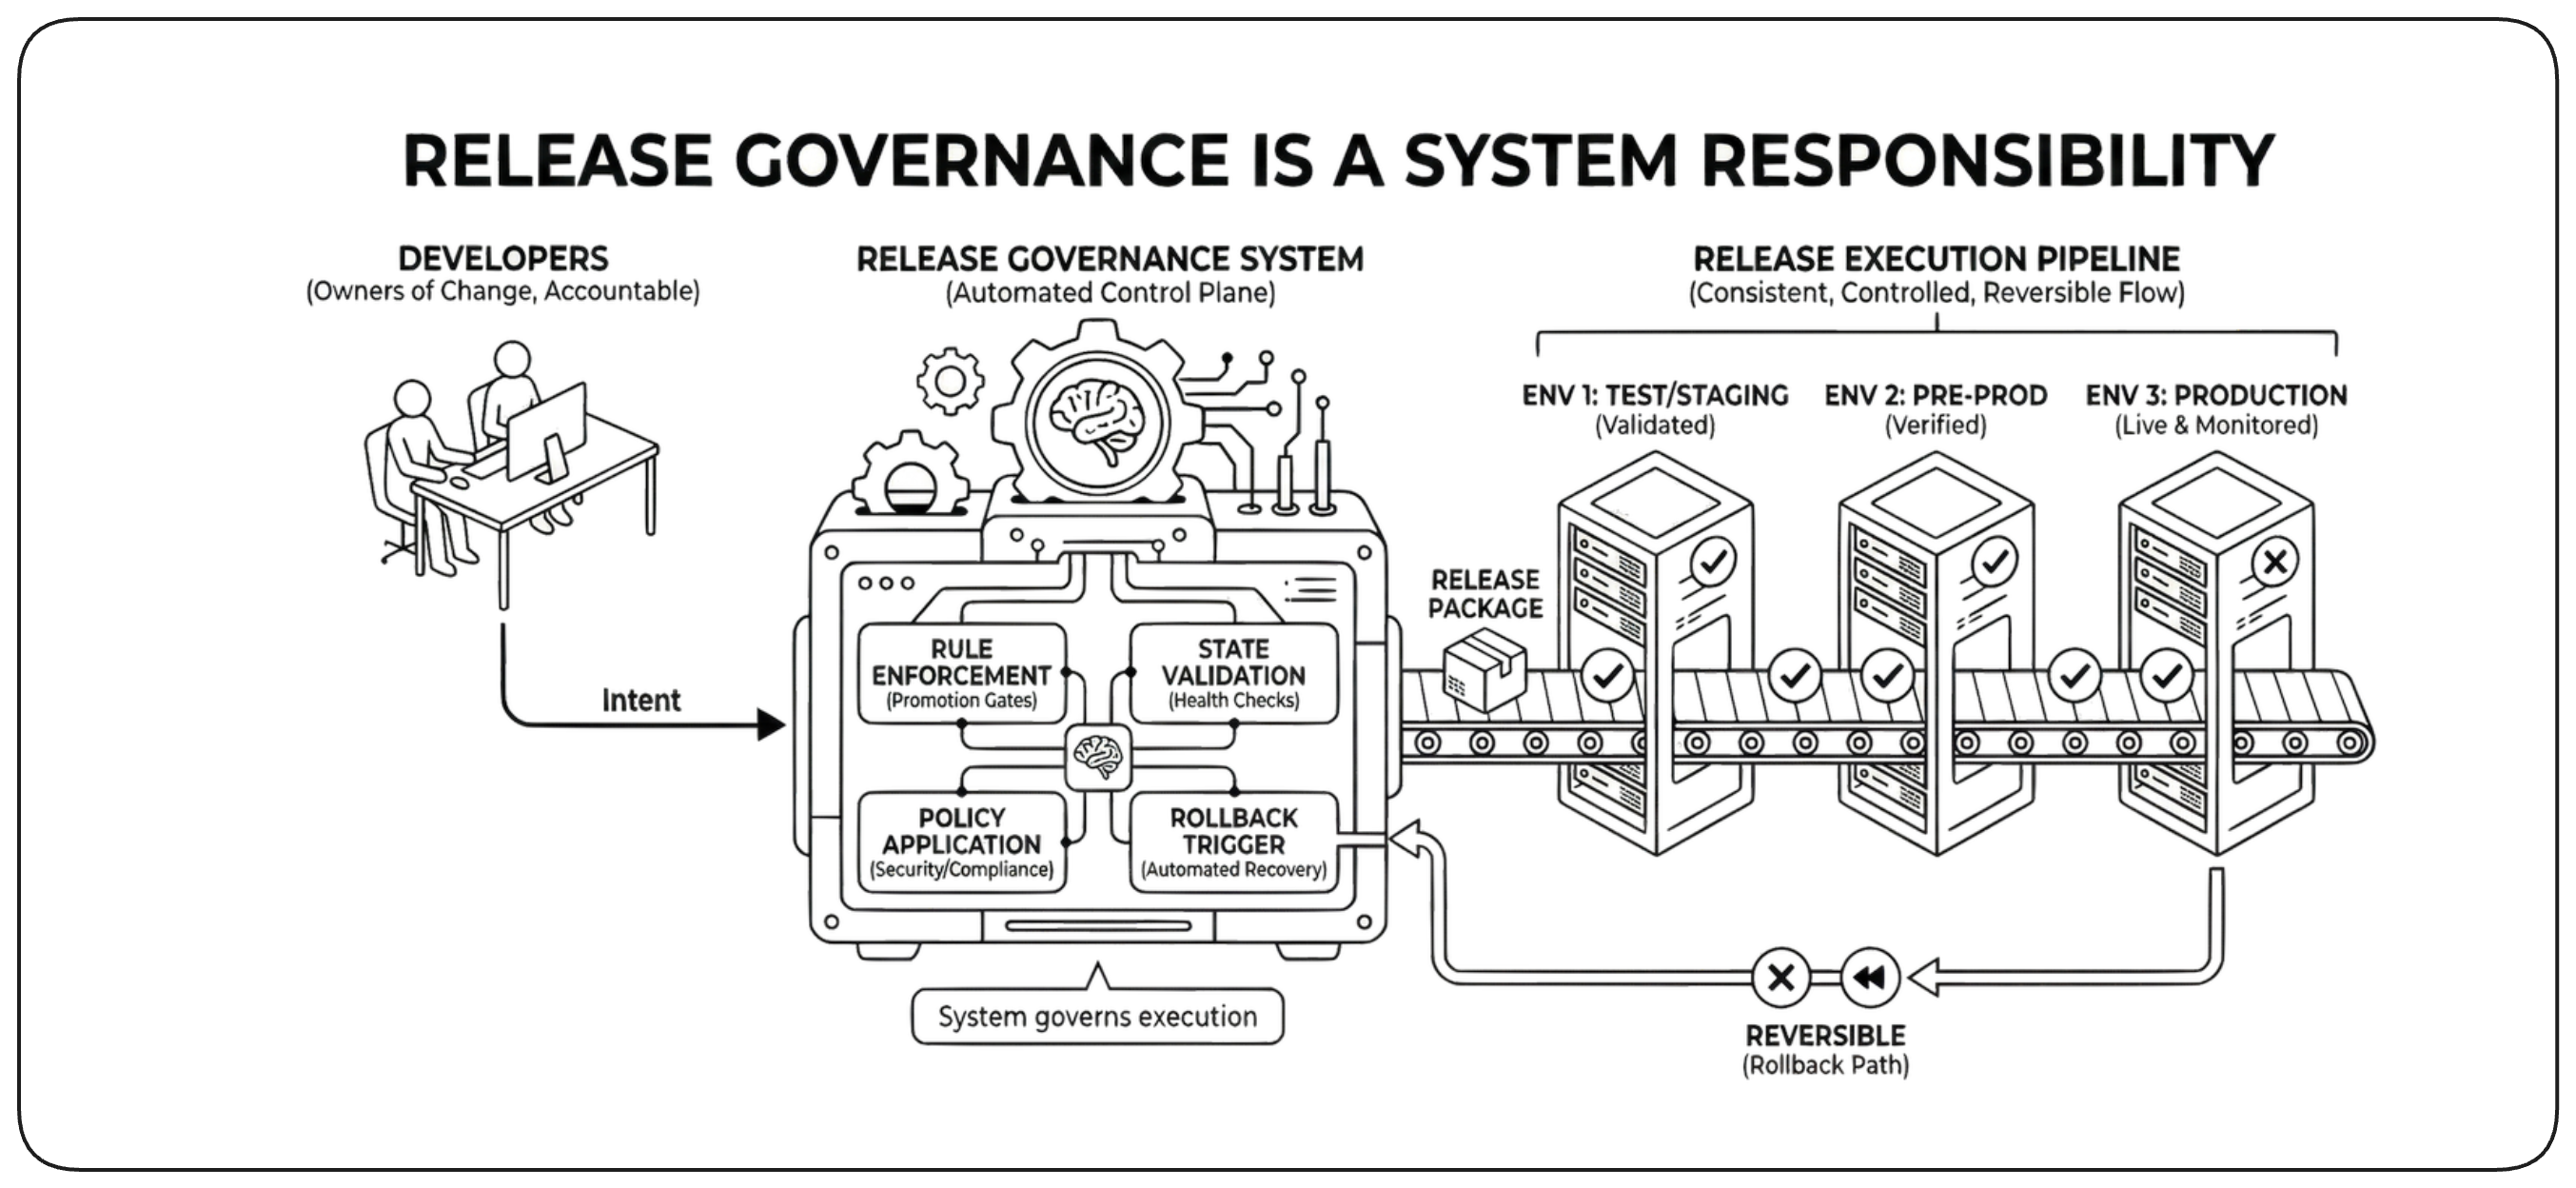
Les développeurs possèdent le changement, mais la sécurité de la release ne doit pas dépendre de la coordination humaine. Le système de release applique les règles de promotion, valide les transitions d’état, met en œuvre les politiques de l’organisation et contrôle le rollback. Les développeurs restent responsables du résultat ; le système rend l’exécution cohérente et gouvernée.
Les releases portent sur des artefacts, pas sur du code
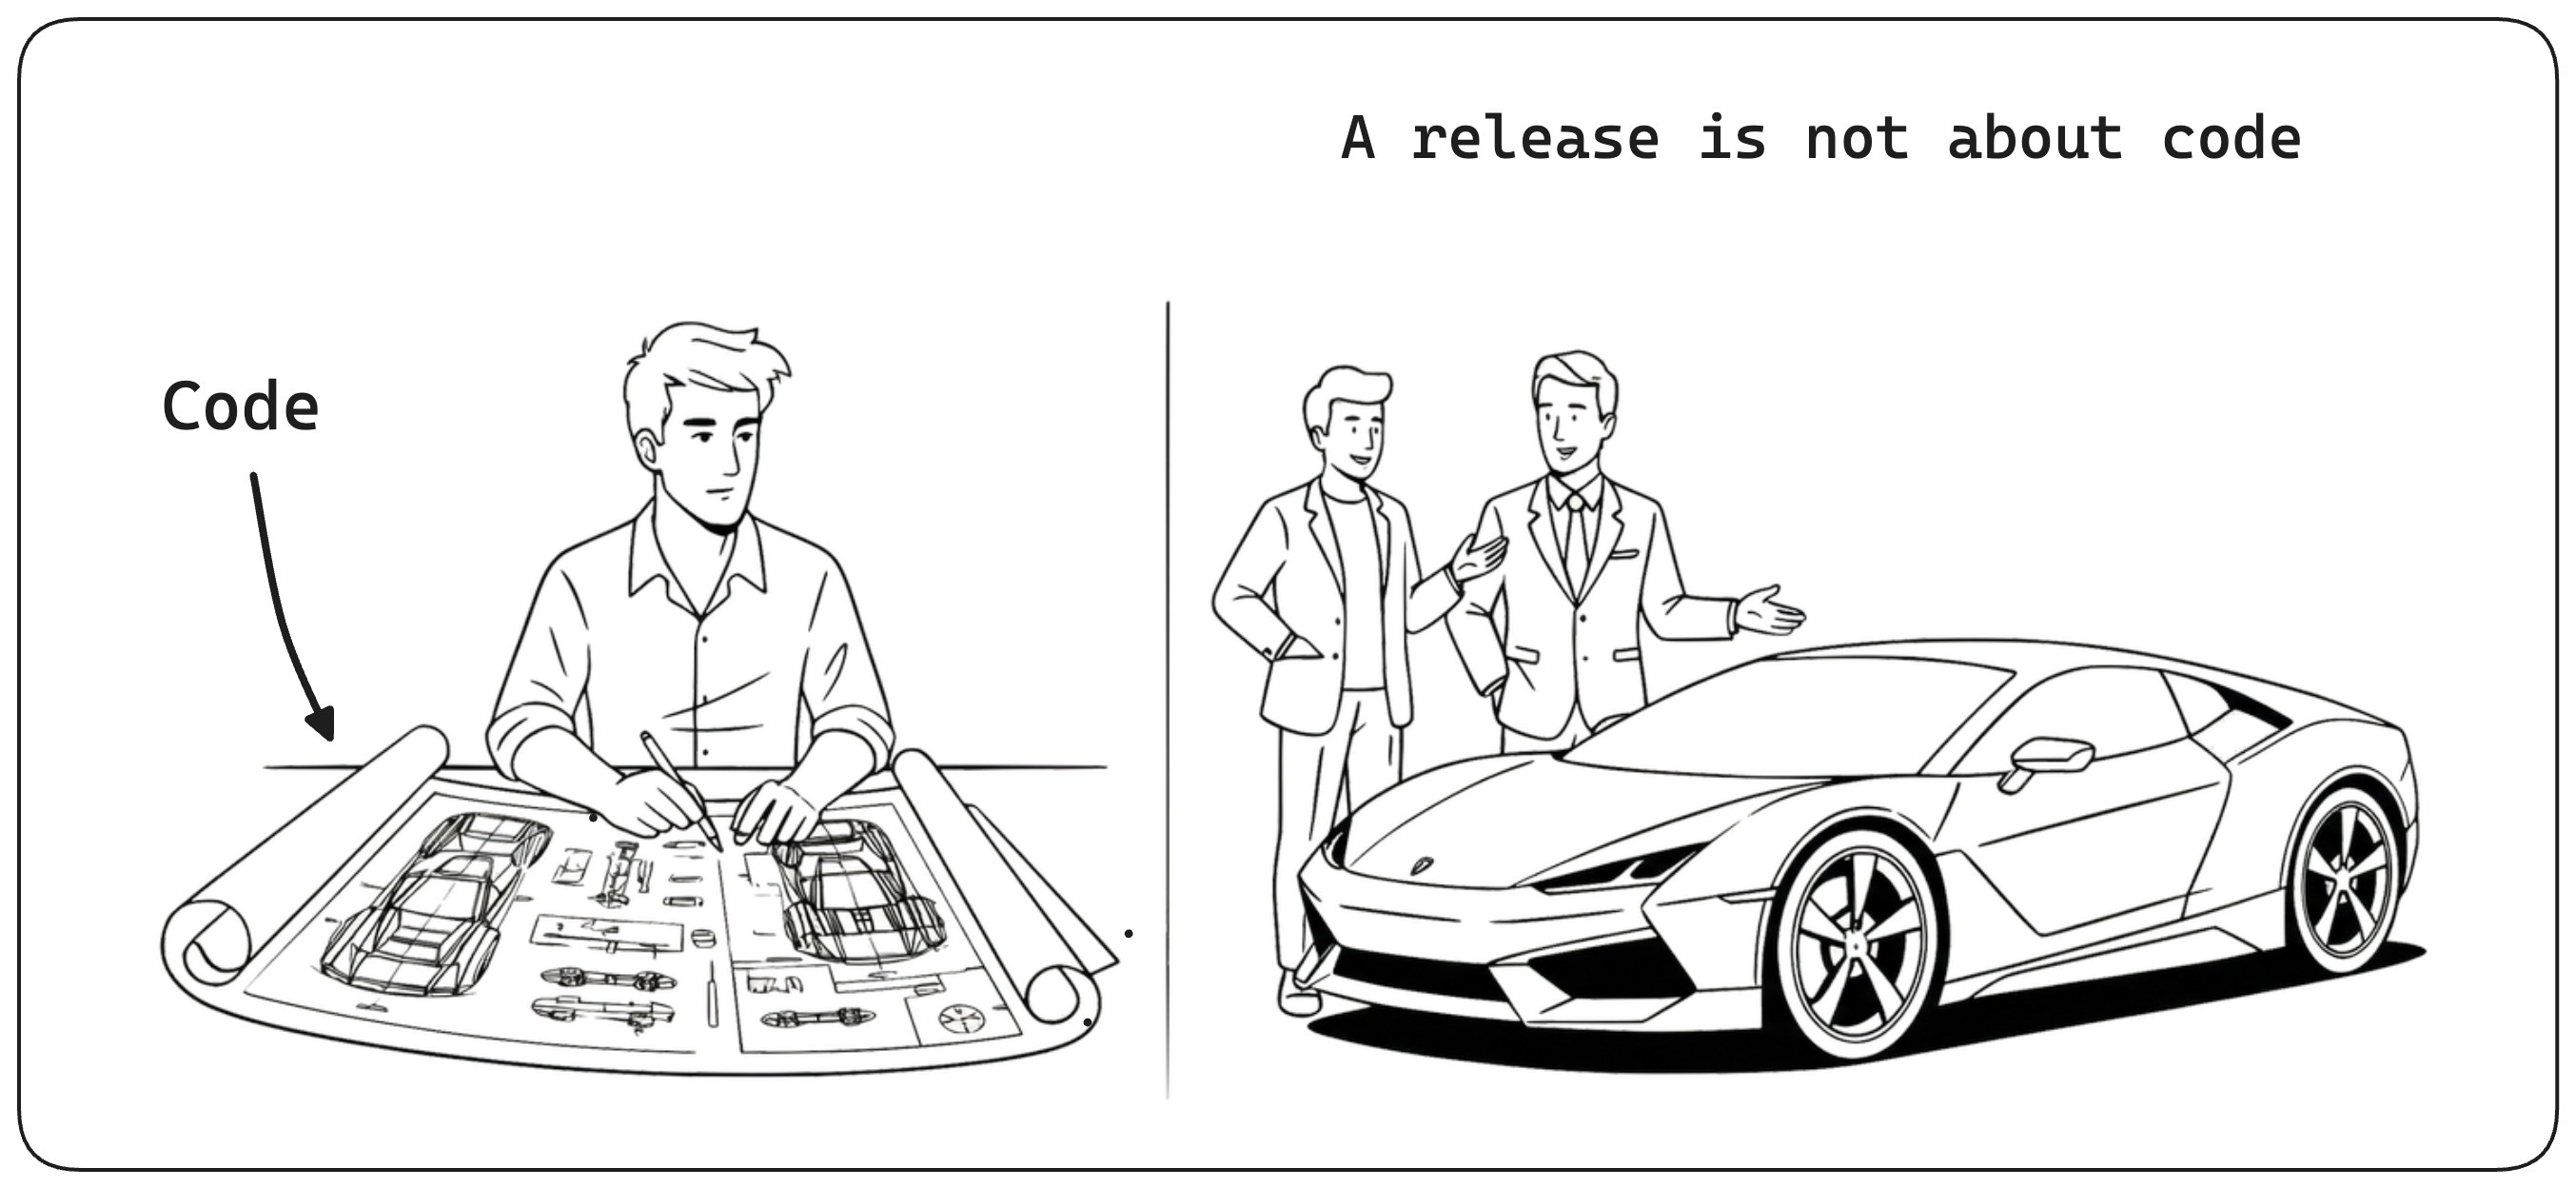
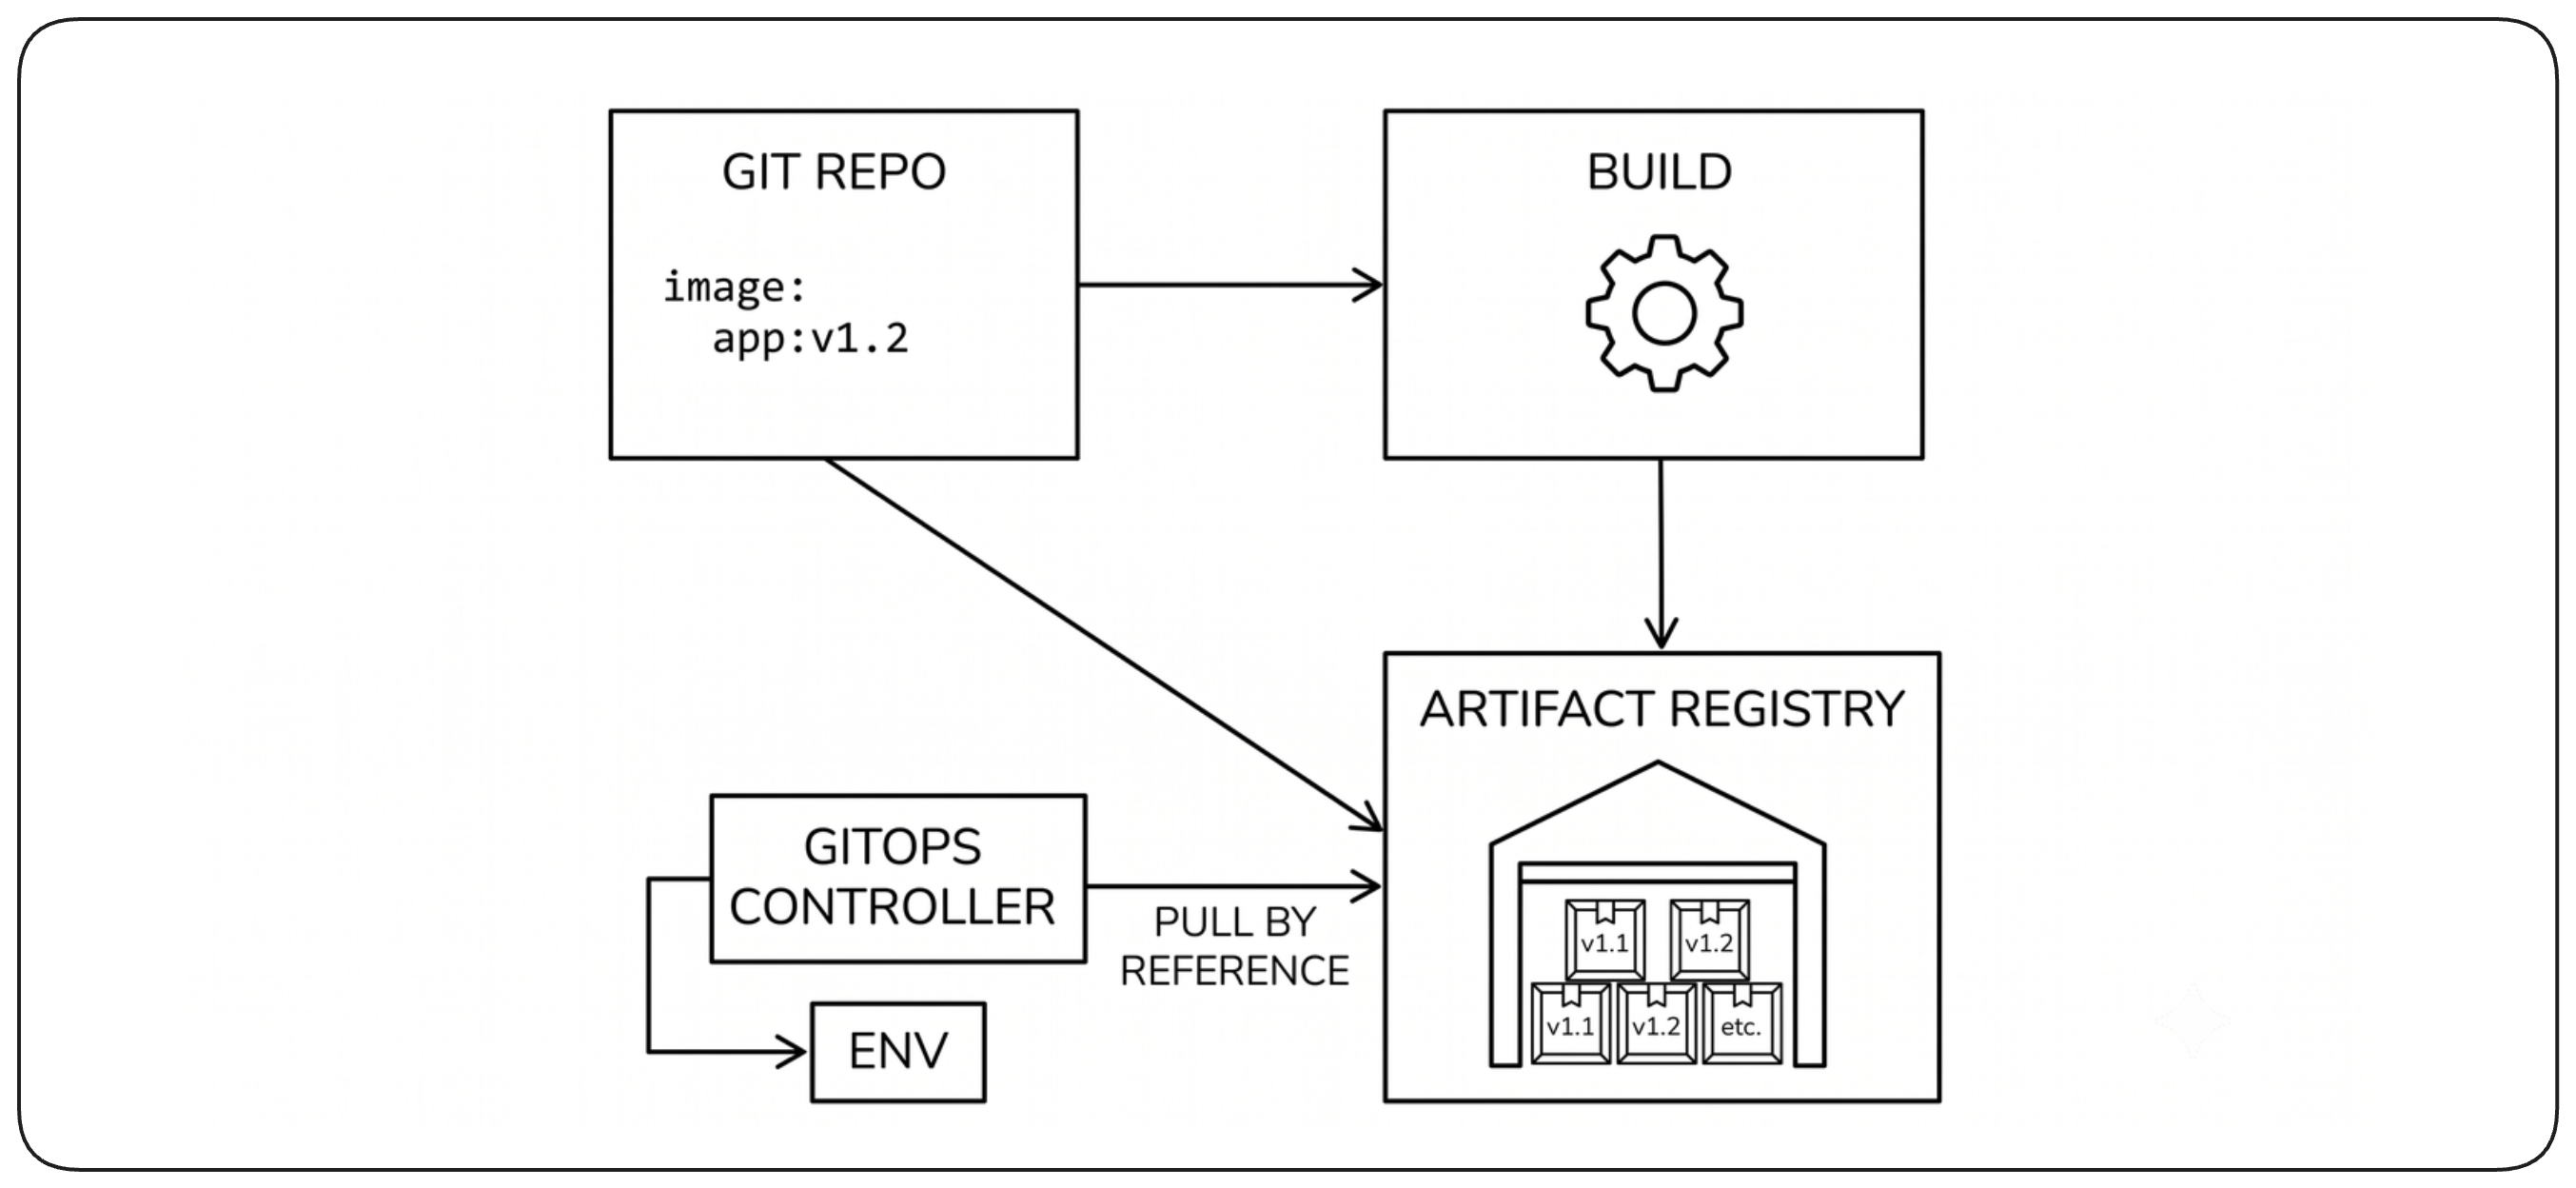
Une release opère sur des artefacts immuables et de la configuration, pas sur le code source. Le code source sert en amont à produire des artefacts versionnés : images de conteneur, binaires, charts ou packages. Une fois construits et stockés, ces artefacts — et non le dépôt de code — deviennent les unités référencées par la release.
Interagir avec le cloud via le control plane
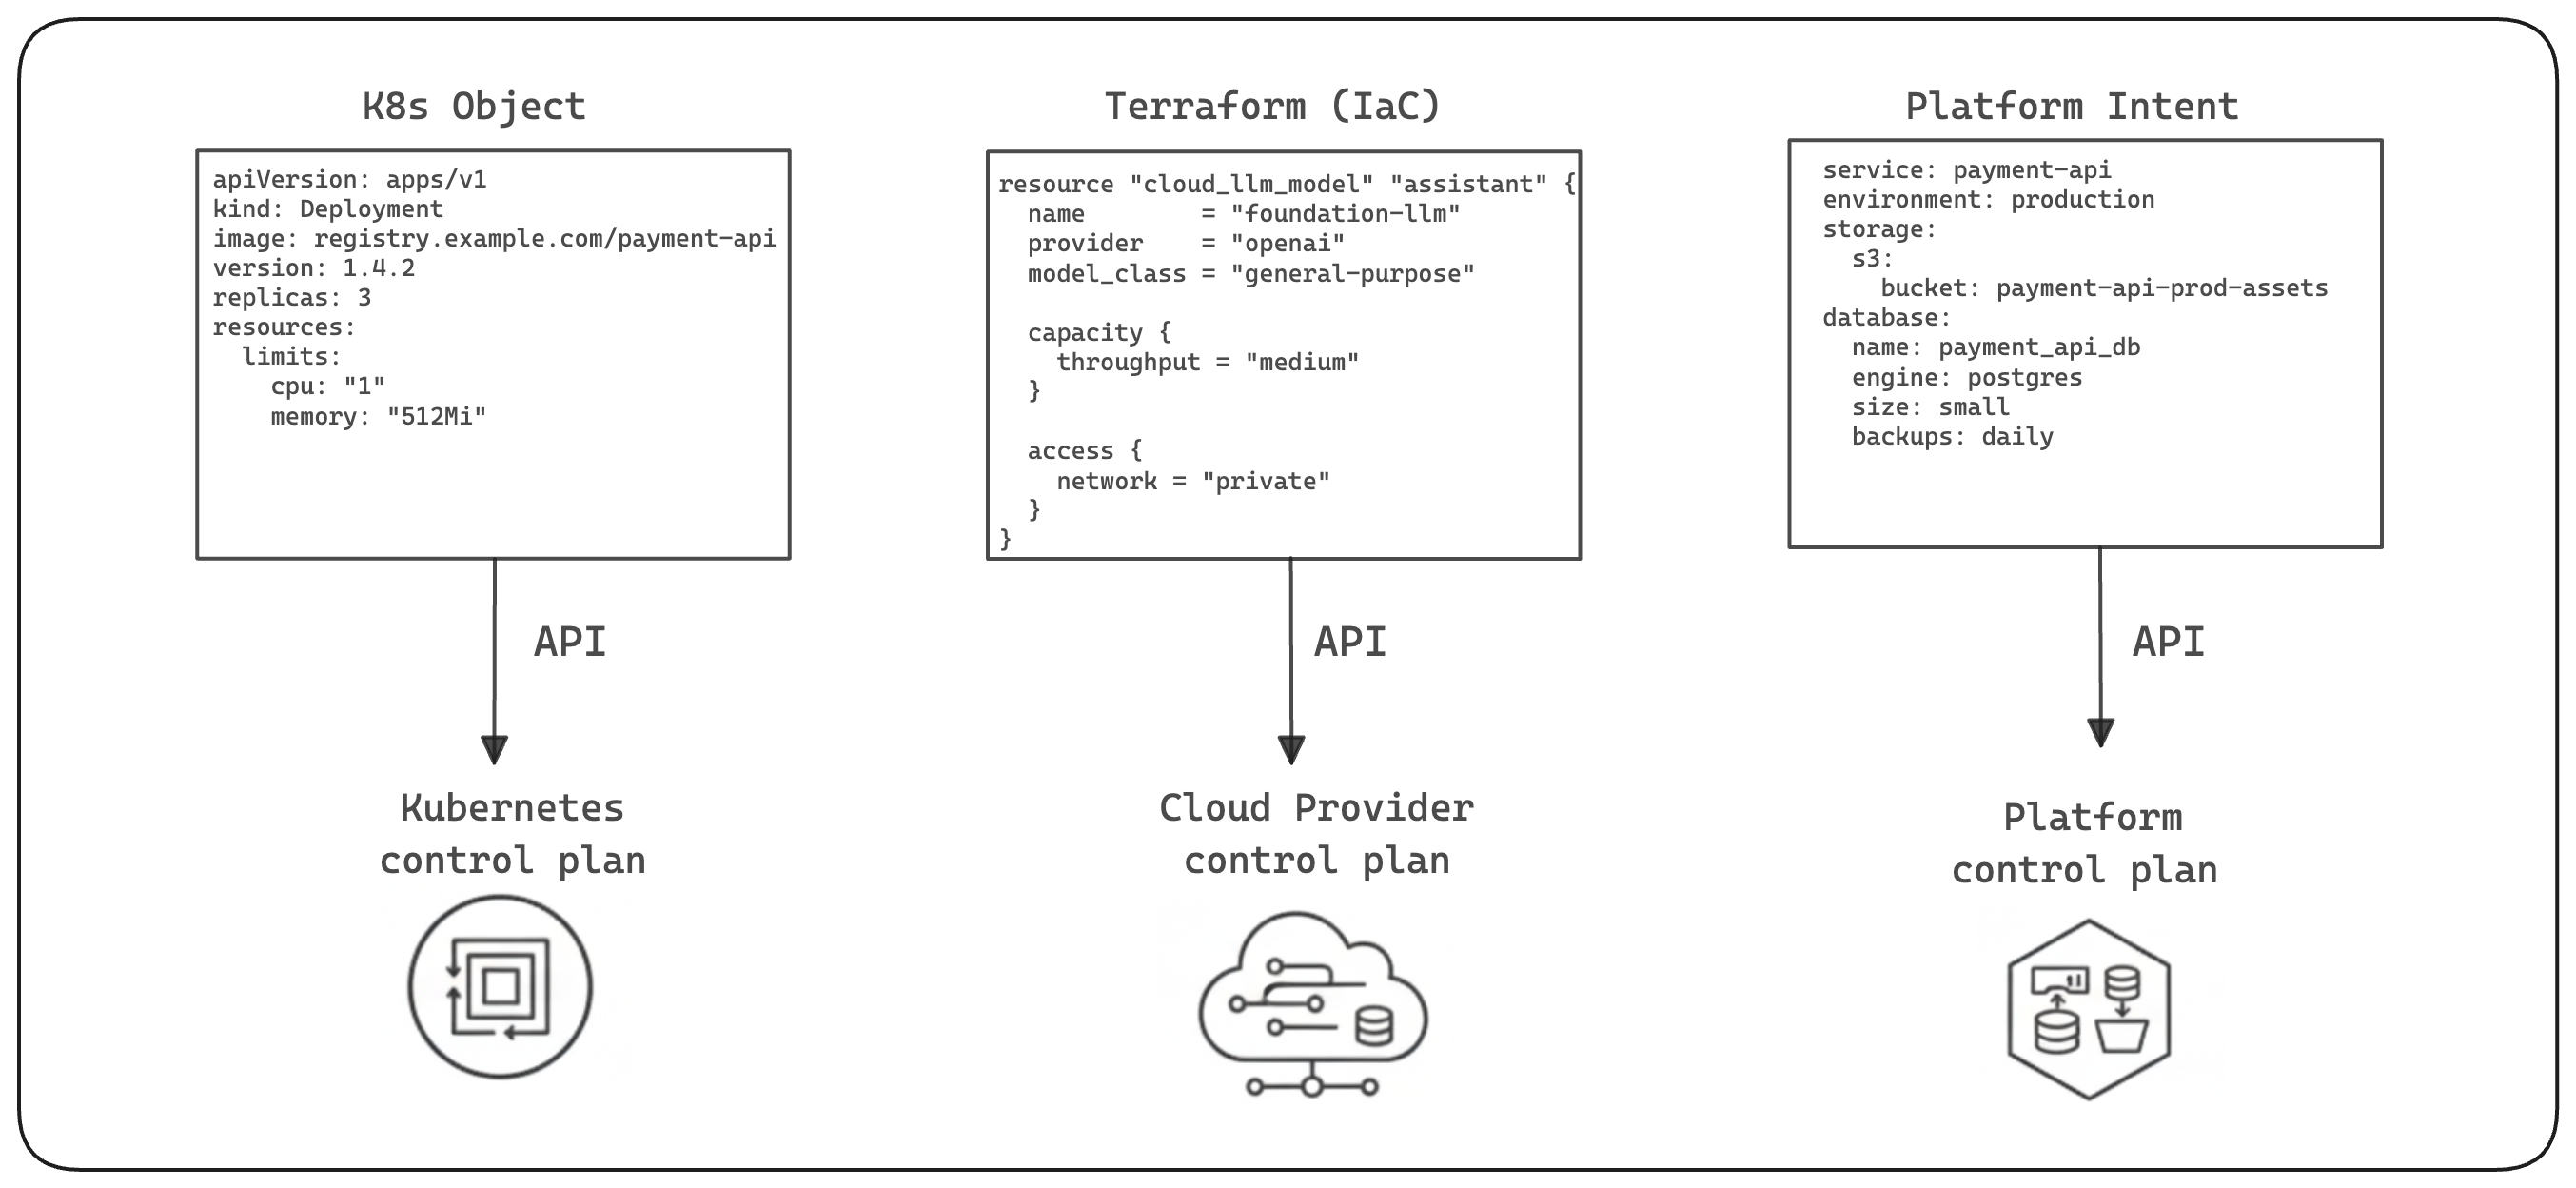
Les systèmes modernes sont opérés par des control planes plutôt que par des actions impératives directes. Les releases expriment une intention auprès des API cloud, des orchestrateurs d’infrastructure et des couches de plateforme, qui réconcilient l’état désiré avec la réalité. La release décrit ce que l’environnement doit devenir ; les control planes déterminent comment établir et maintenir cet état.
Référencez les artefacts, ne les déplacez pas
Dès que les environnements sont médiés par des control planes, l’exécution passe à la plateforme. Le control plane reçoit l’intention déclarative, récupère les artefacts référencés, applique les changements requis, fait respecter les politiques et réconcilie en continu la réalité avec l’état désiré. Une release ne déplace plus de charges utiles ni n’exécute d’étapes elle-même ; elle met à jour l’intention et pointe vers des artefacts immuables. Rien n’est transféré par la release — tout est référencé.
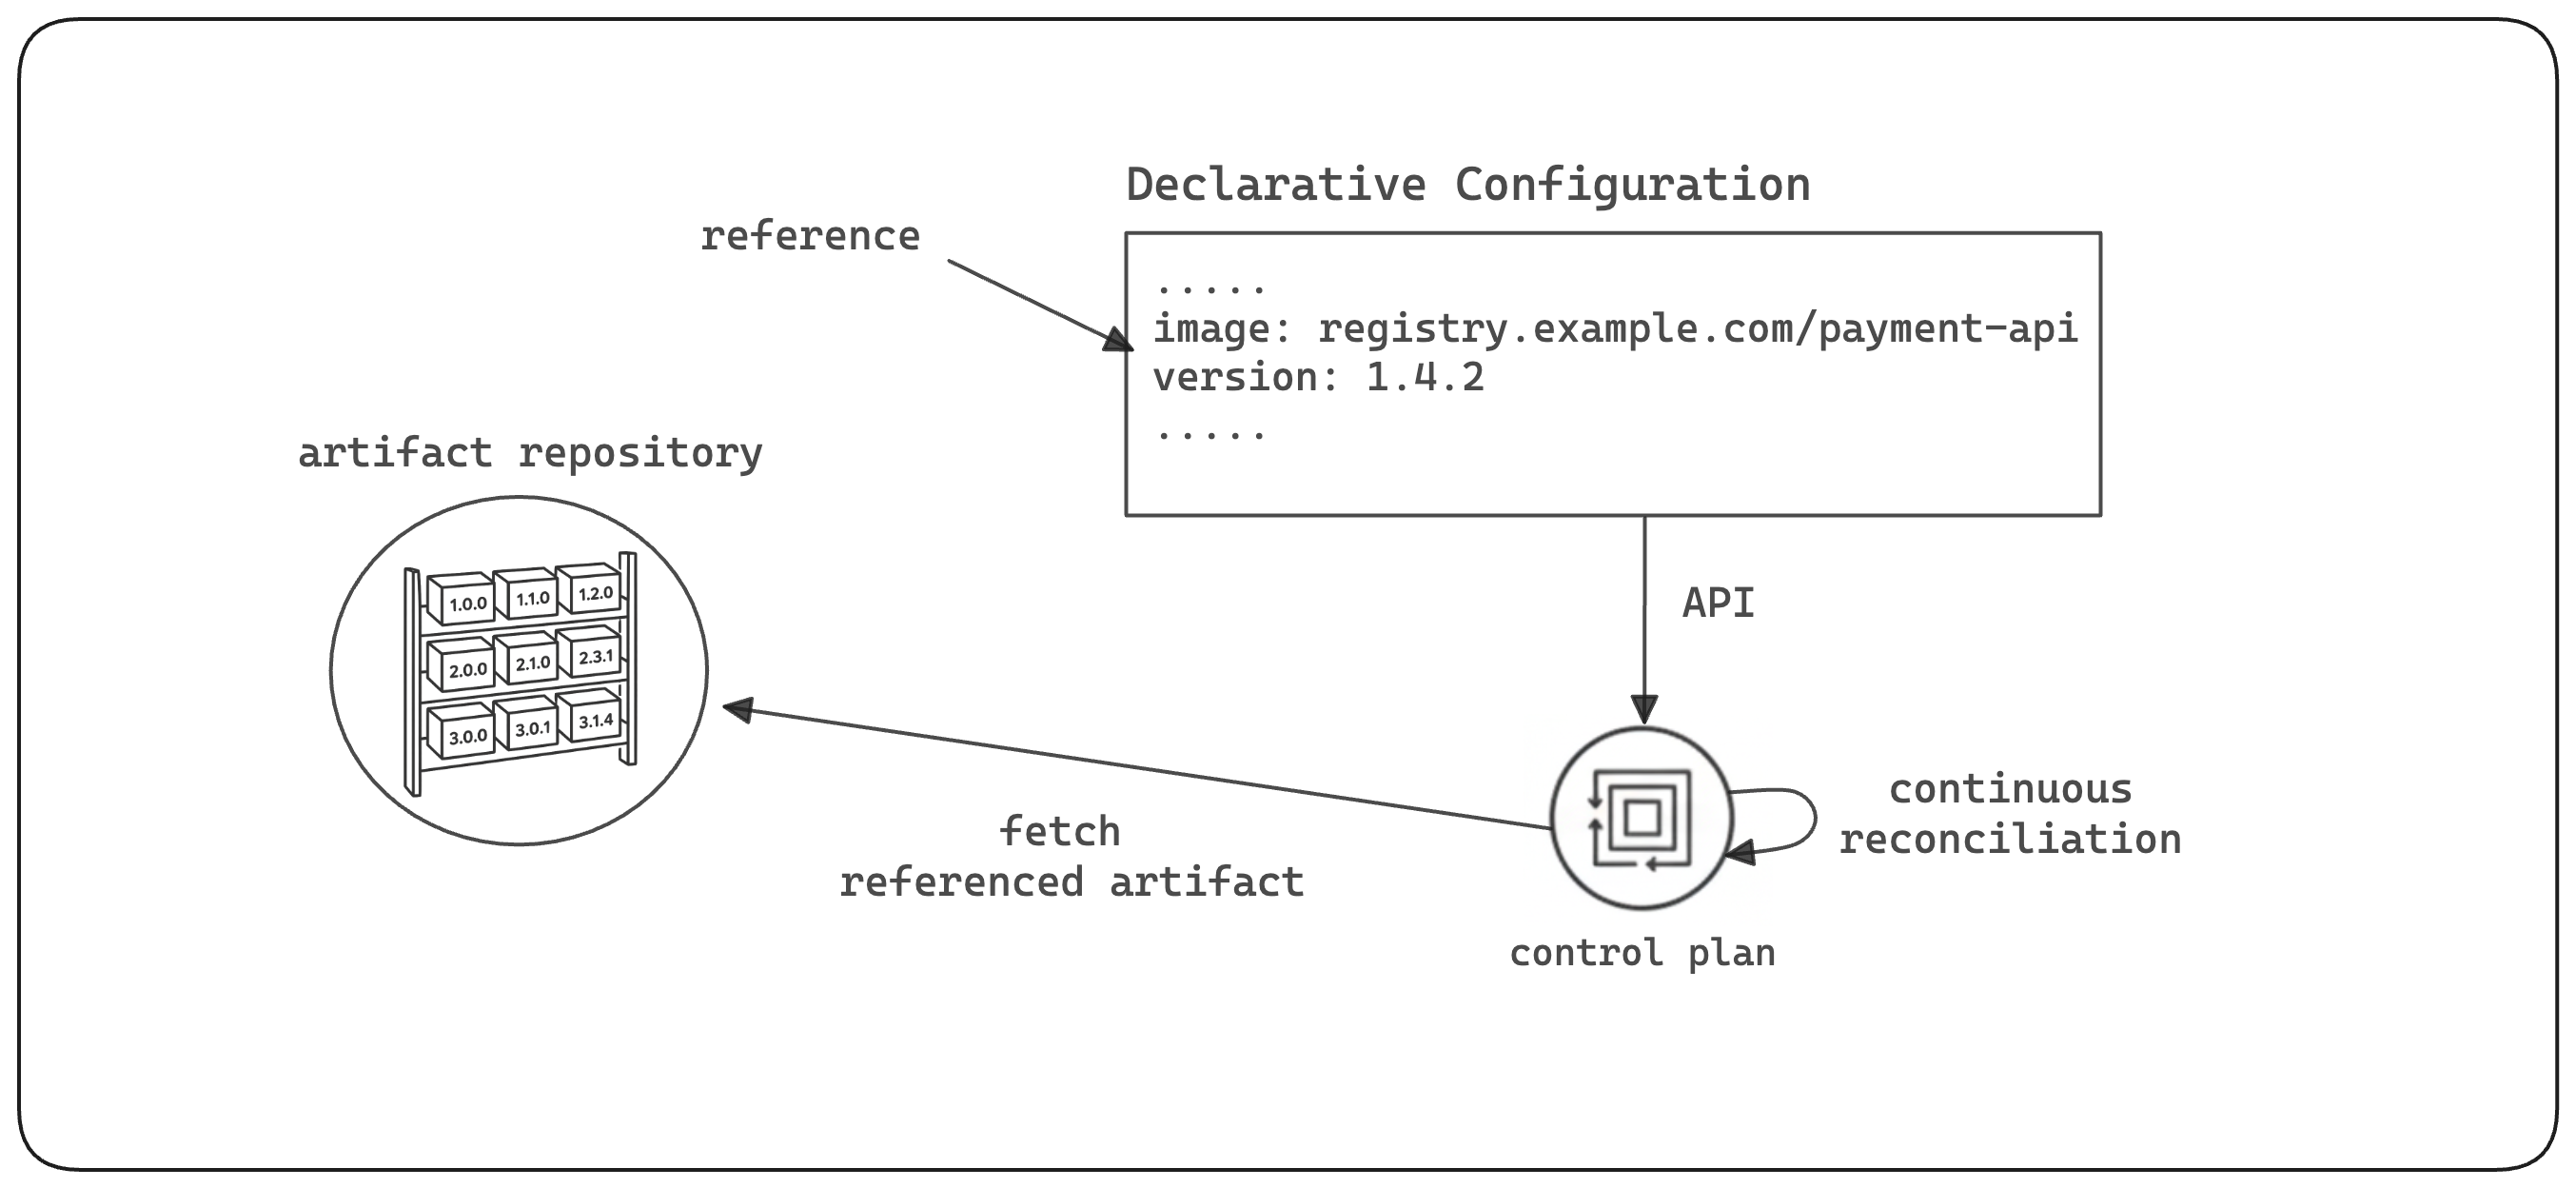
La configuration déclarative définit l’état du système
Dans une architecture pilotée par control plane, l’état du système est défini par l’intention déclarative plutôt que par l’historique d’exécution. Manifestes d’application, définitions d’infrastructure, politiques et paramètres décrivent ensemble l’état désiré, tandis que leurs control planes respectifs réconcilient en continu la réalité vers celui-ci. Changez l’intention et le système converge vers l’avant ; restaurez-la et il converge en arrière.
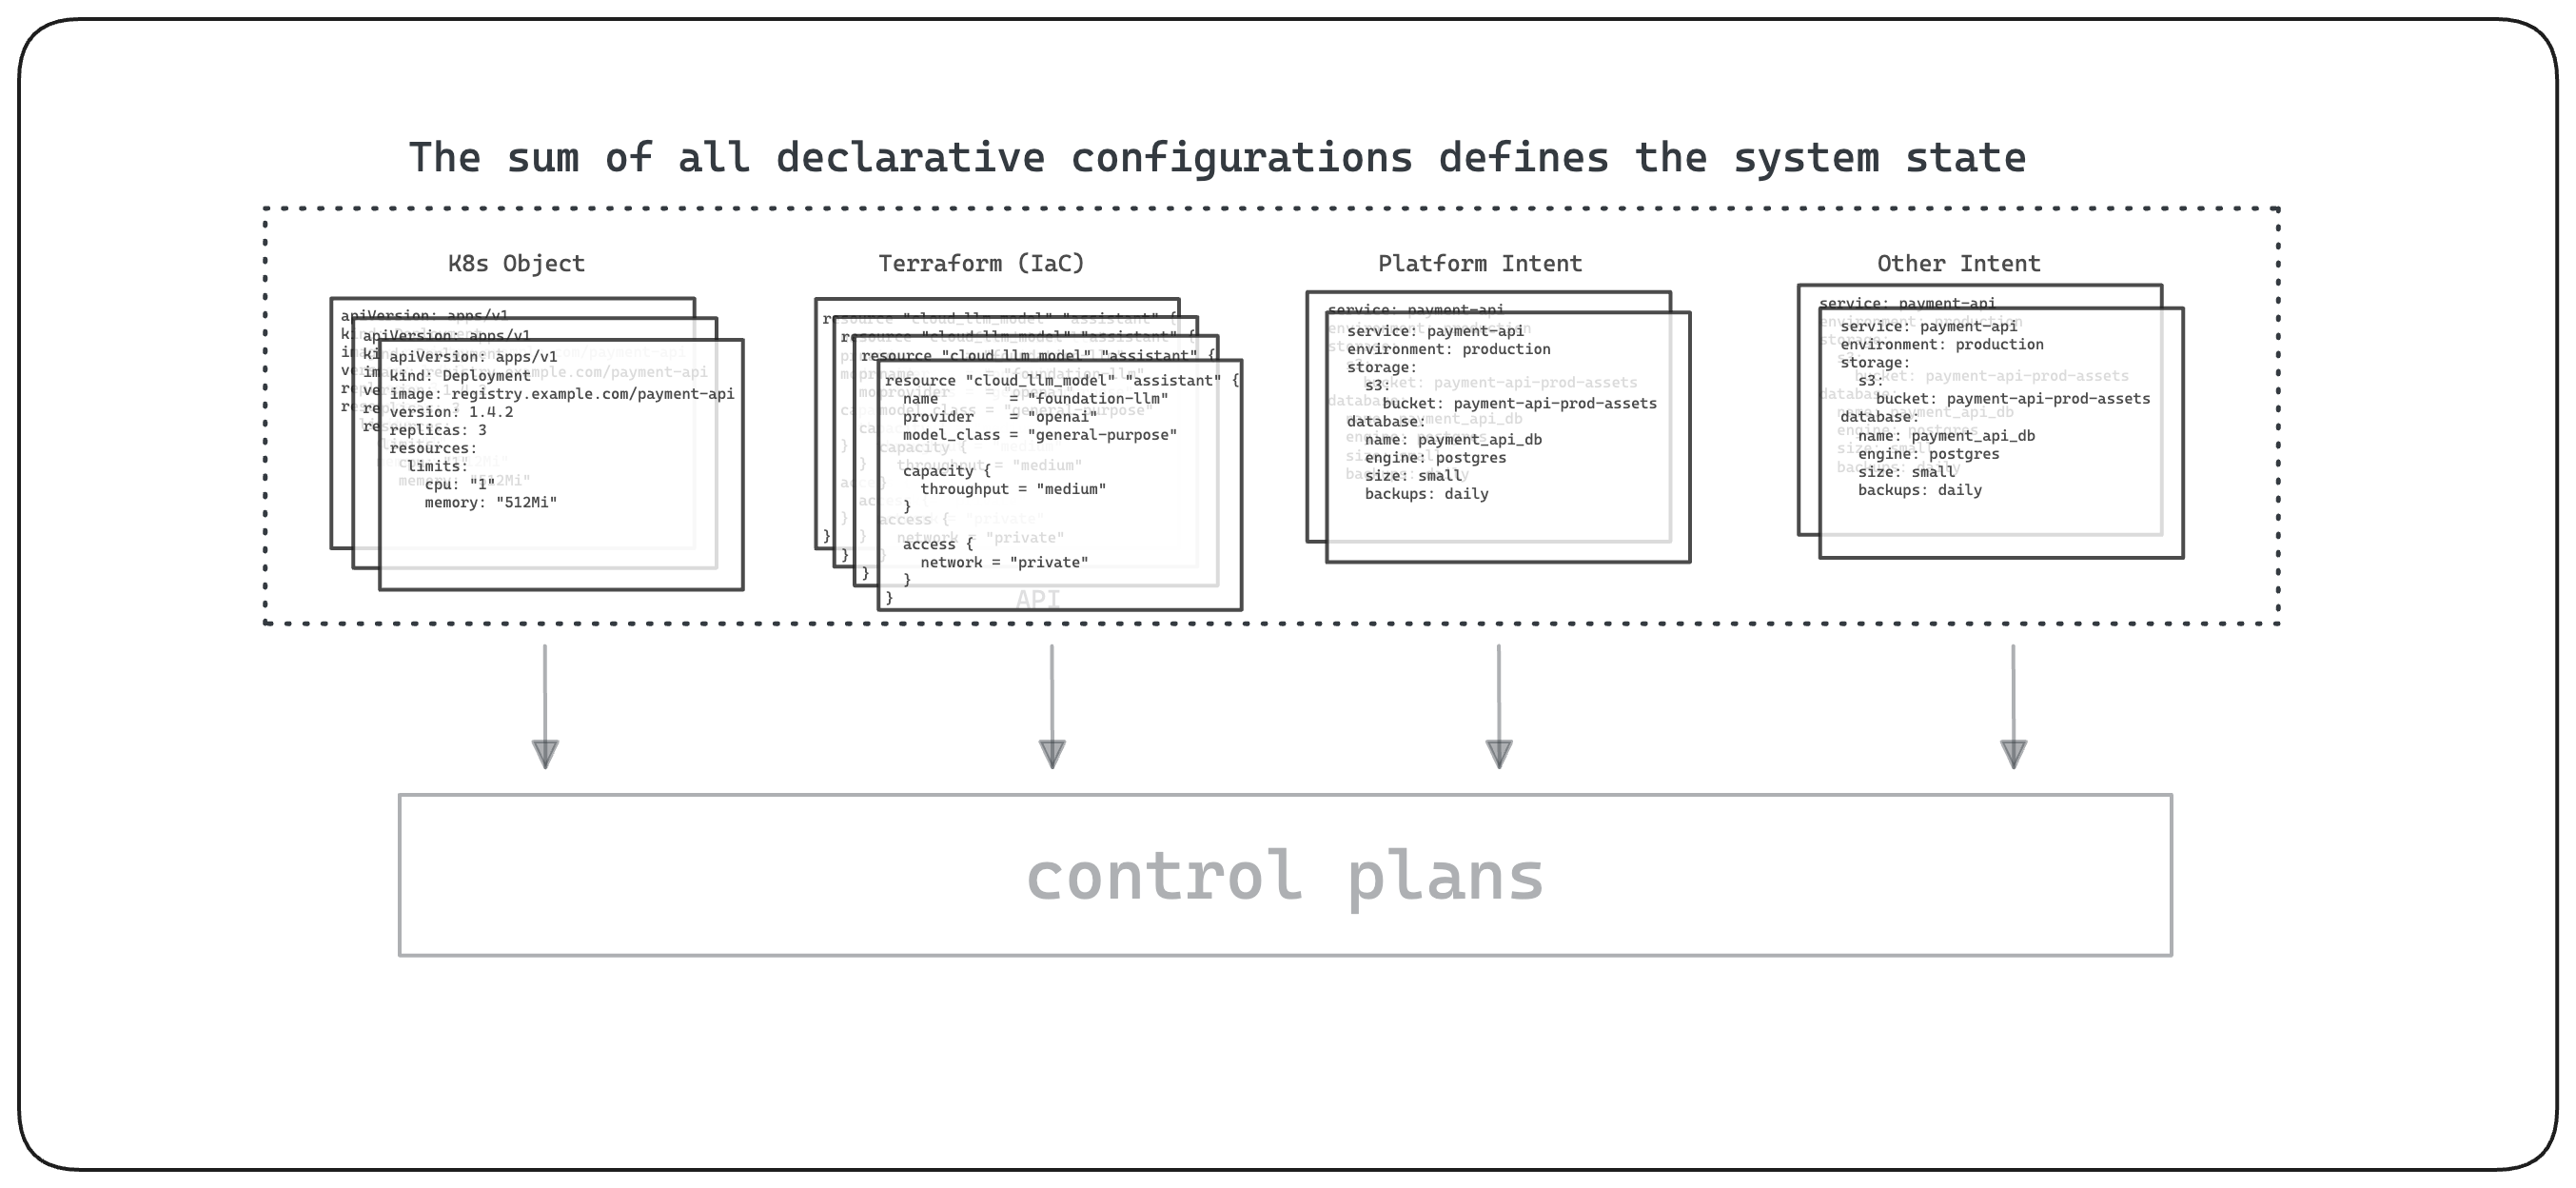
Définition de release et release résolue
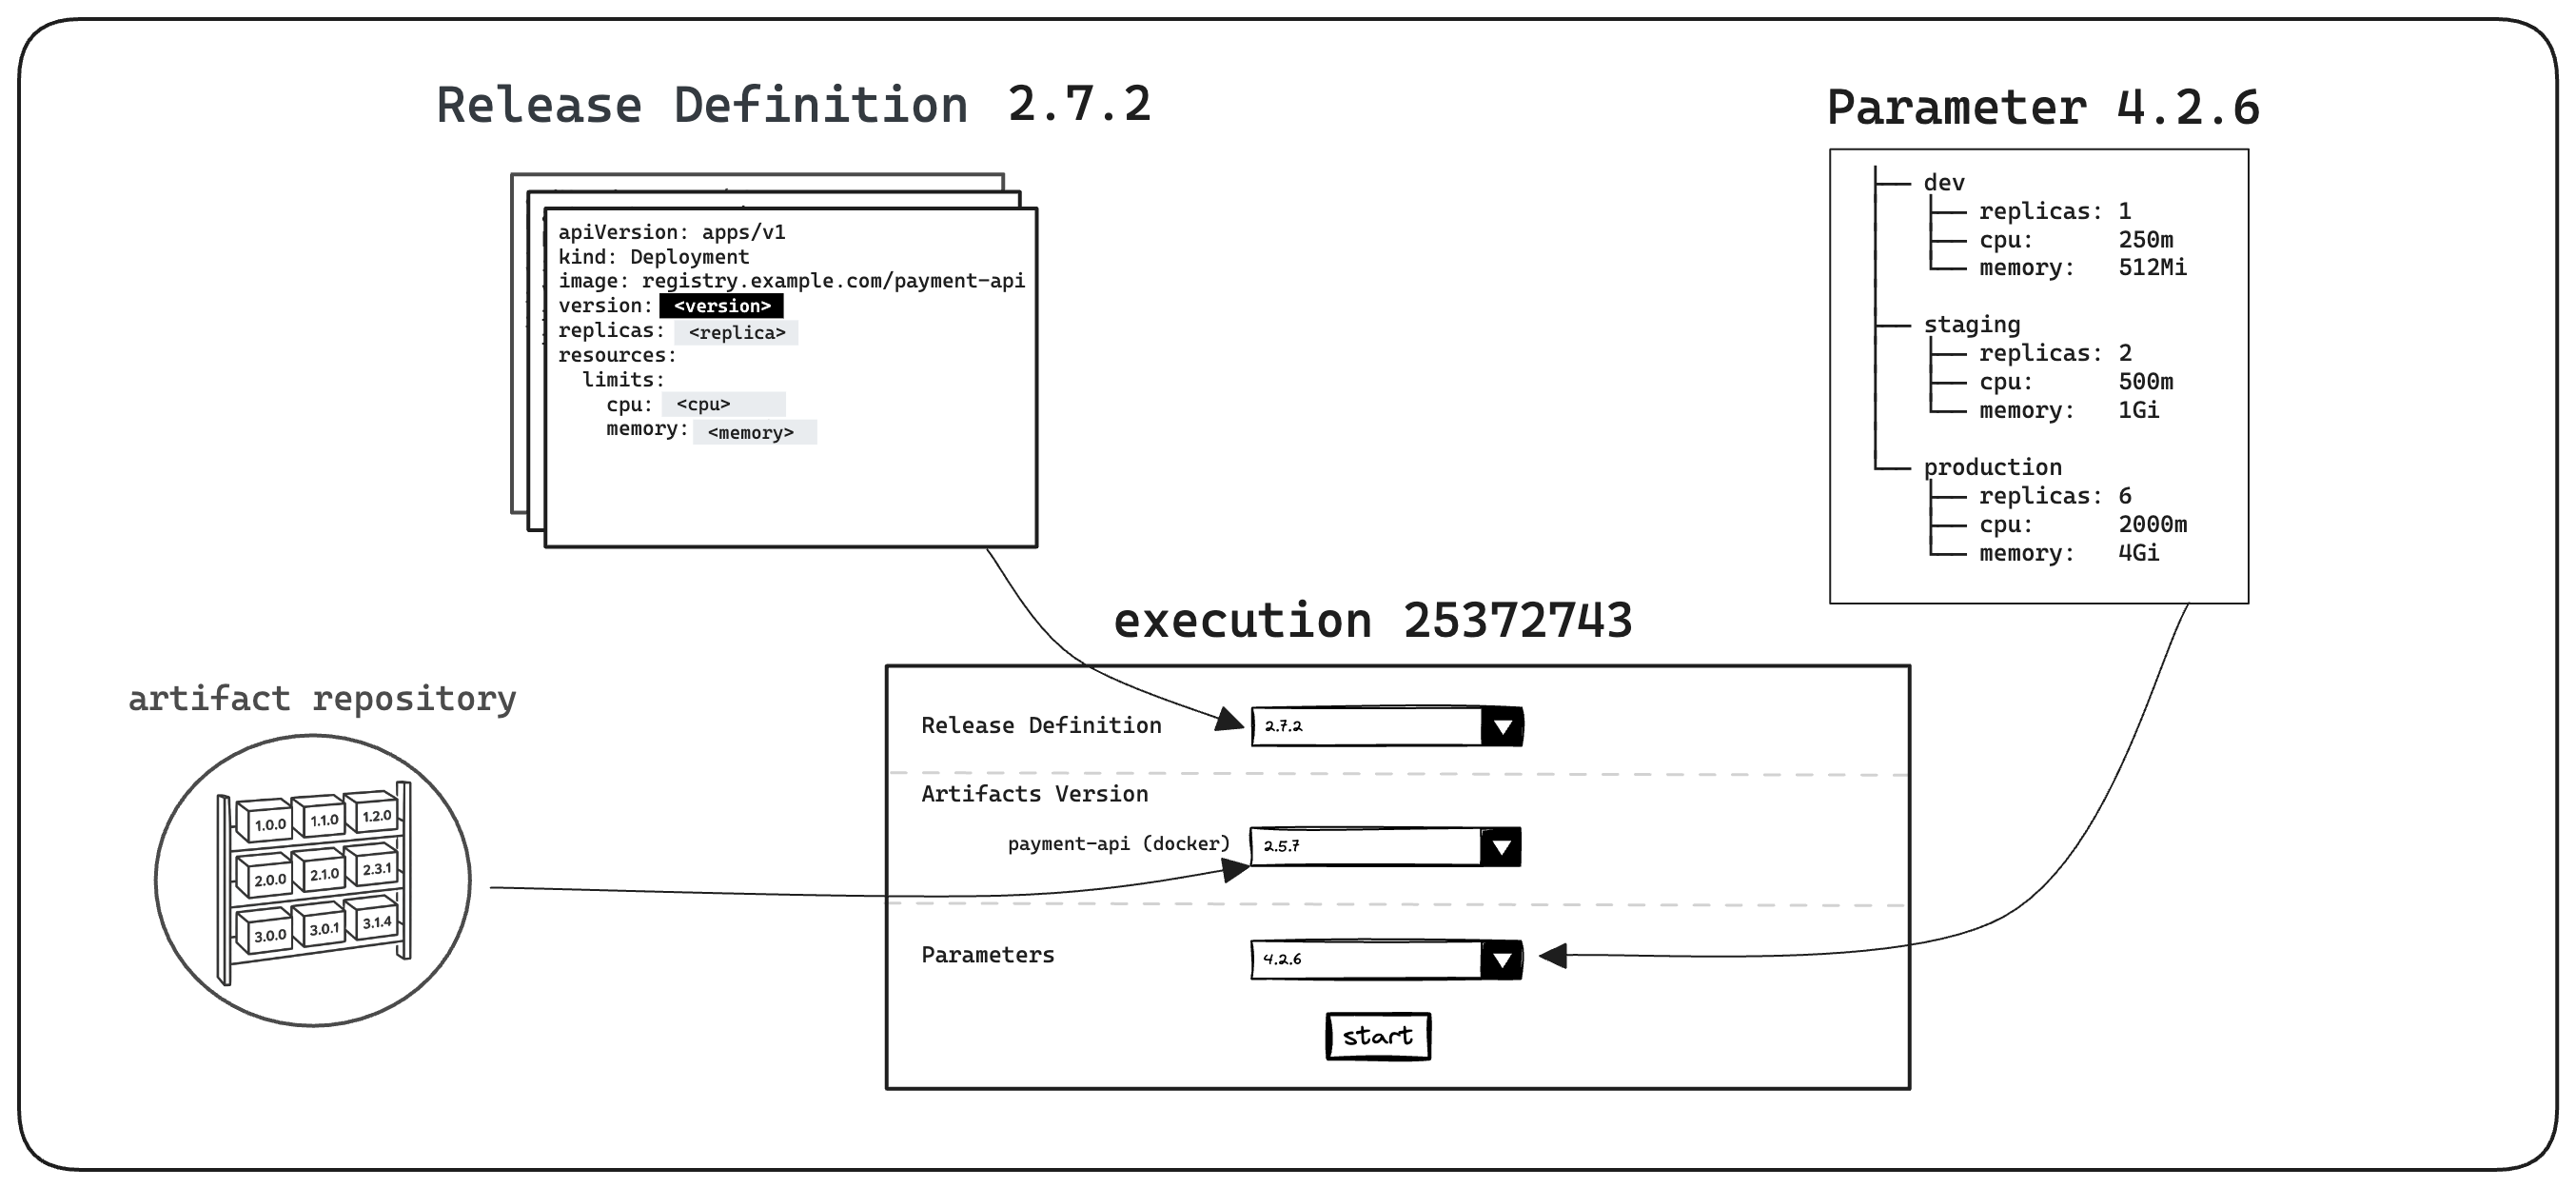
Une définition de release est un bundle nommé et versionné qui exprime une intention stable couvrant l’infrastructure, le workload, la plateforme, les politiques et la gouvernance. Une release résolue lie cette définition à des versions d’artefacts et des paramètres d’exécution précis, produisant l’instantané d’état système immuable qui peut être comparé, promu, audité, déployé et annulé.
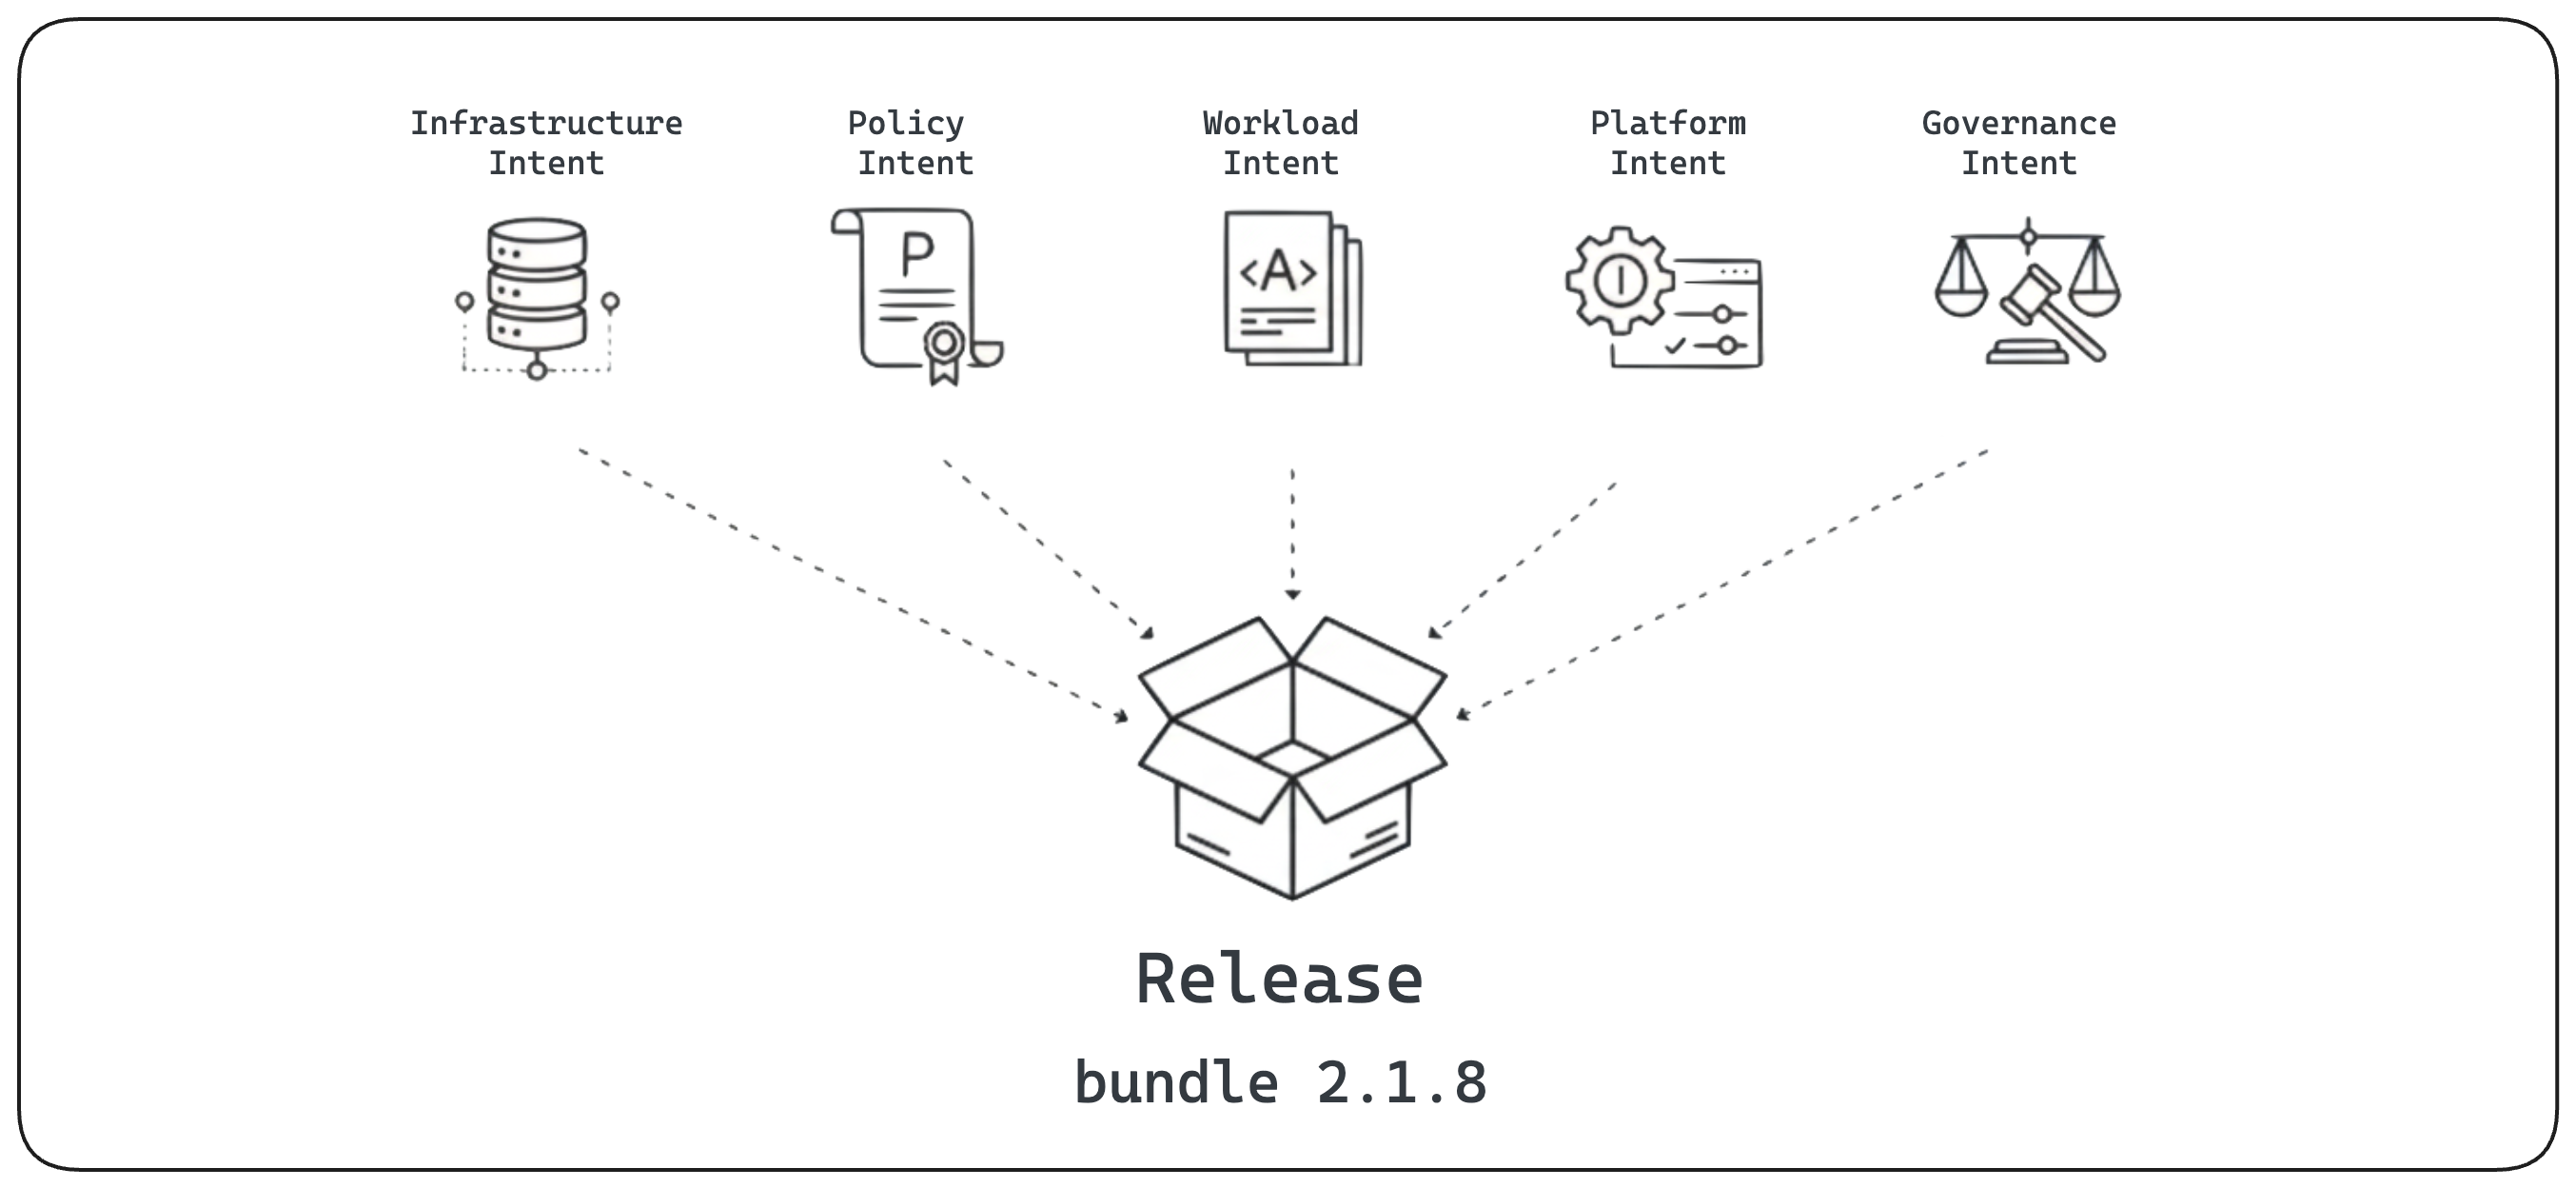
Une release résolue rend l’état identifiable
Une release résolue donne à l’état du système une identité stable et immuable. Le monitoring et les incidents peuvent être corrélés à ce qui tournait exactement, les états précédents peuvent être choisis pour un rollback, et chaque liaison reste traçable et auditable. Sécurité, observabilité, gouvernance et responsabilité deviennent des propriétés du modèle de release plutôt que des processus reconstitués après coup.
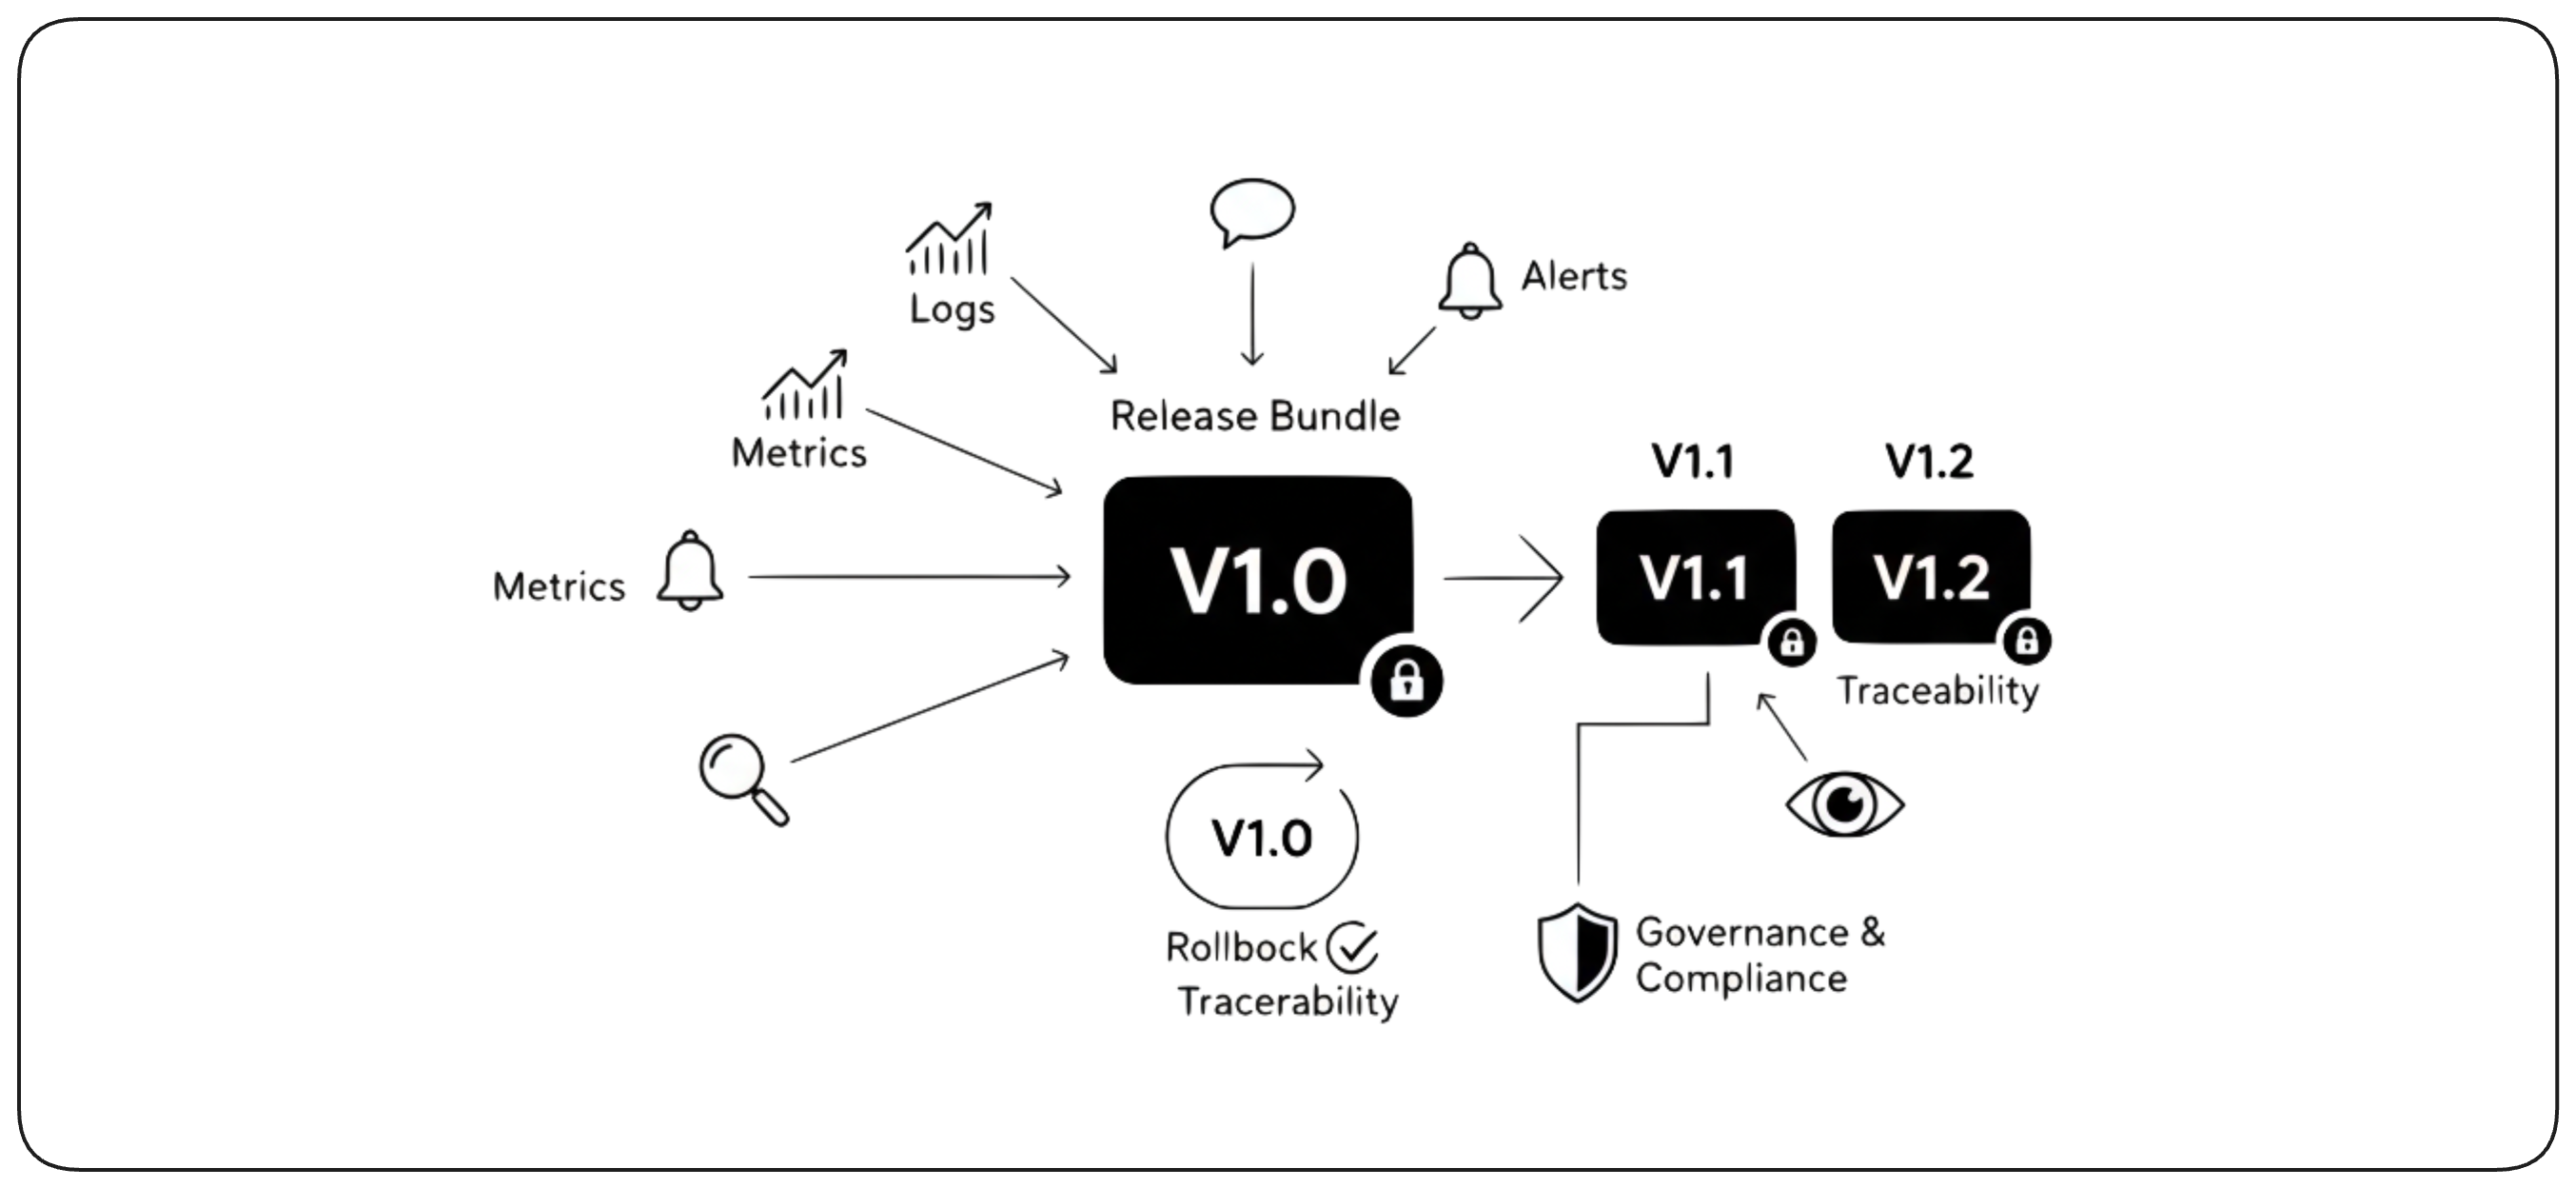
Périmètre de release et rayon d’impact
Le périmètre d’une release est un choix de gestion du risque. Des releases petites et indépendantes réduisent généralement le rayon d’impact, simplifient la reprise et permettent aux équipes d’avancer indépendamment. Mais des changements fortement couplés peuvent être plus sûrs s’ils sont livrés ensemble. L’objectif n’est donc pas toujours la plus petite release, mais le plus petit périmètre qui préserve la cohérence du système.
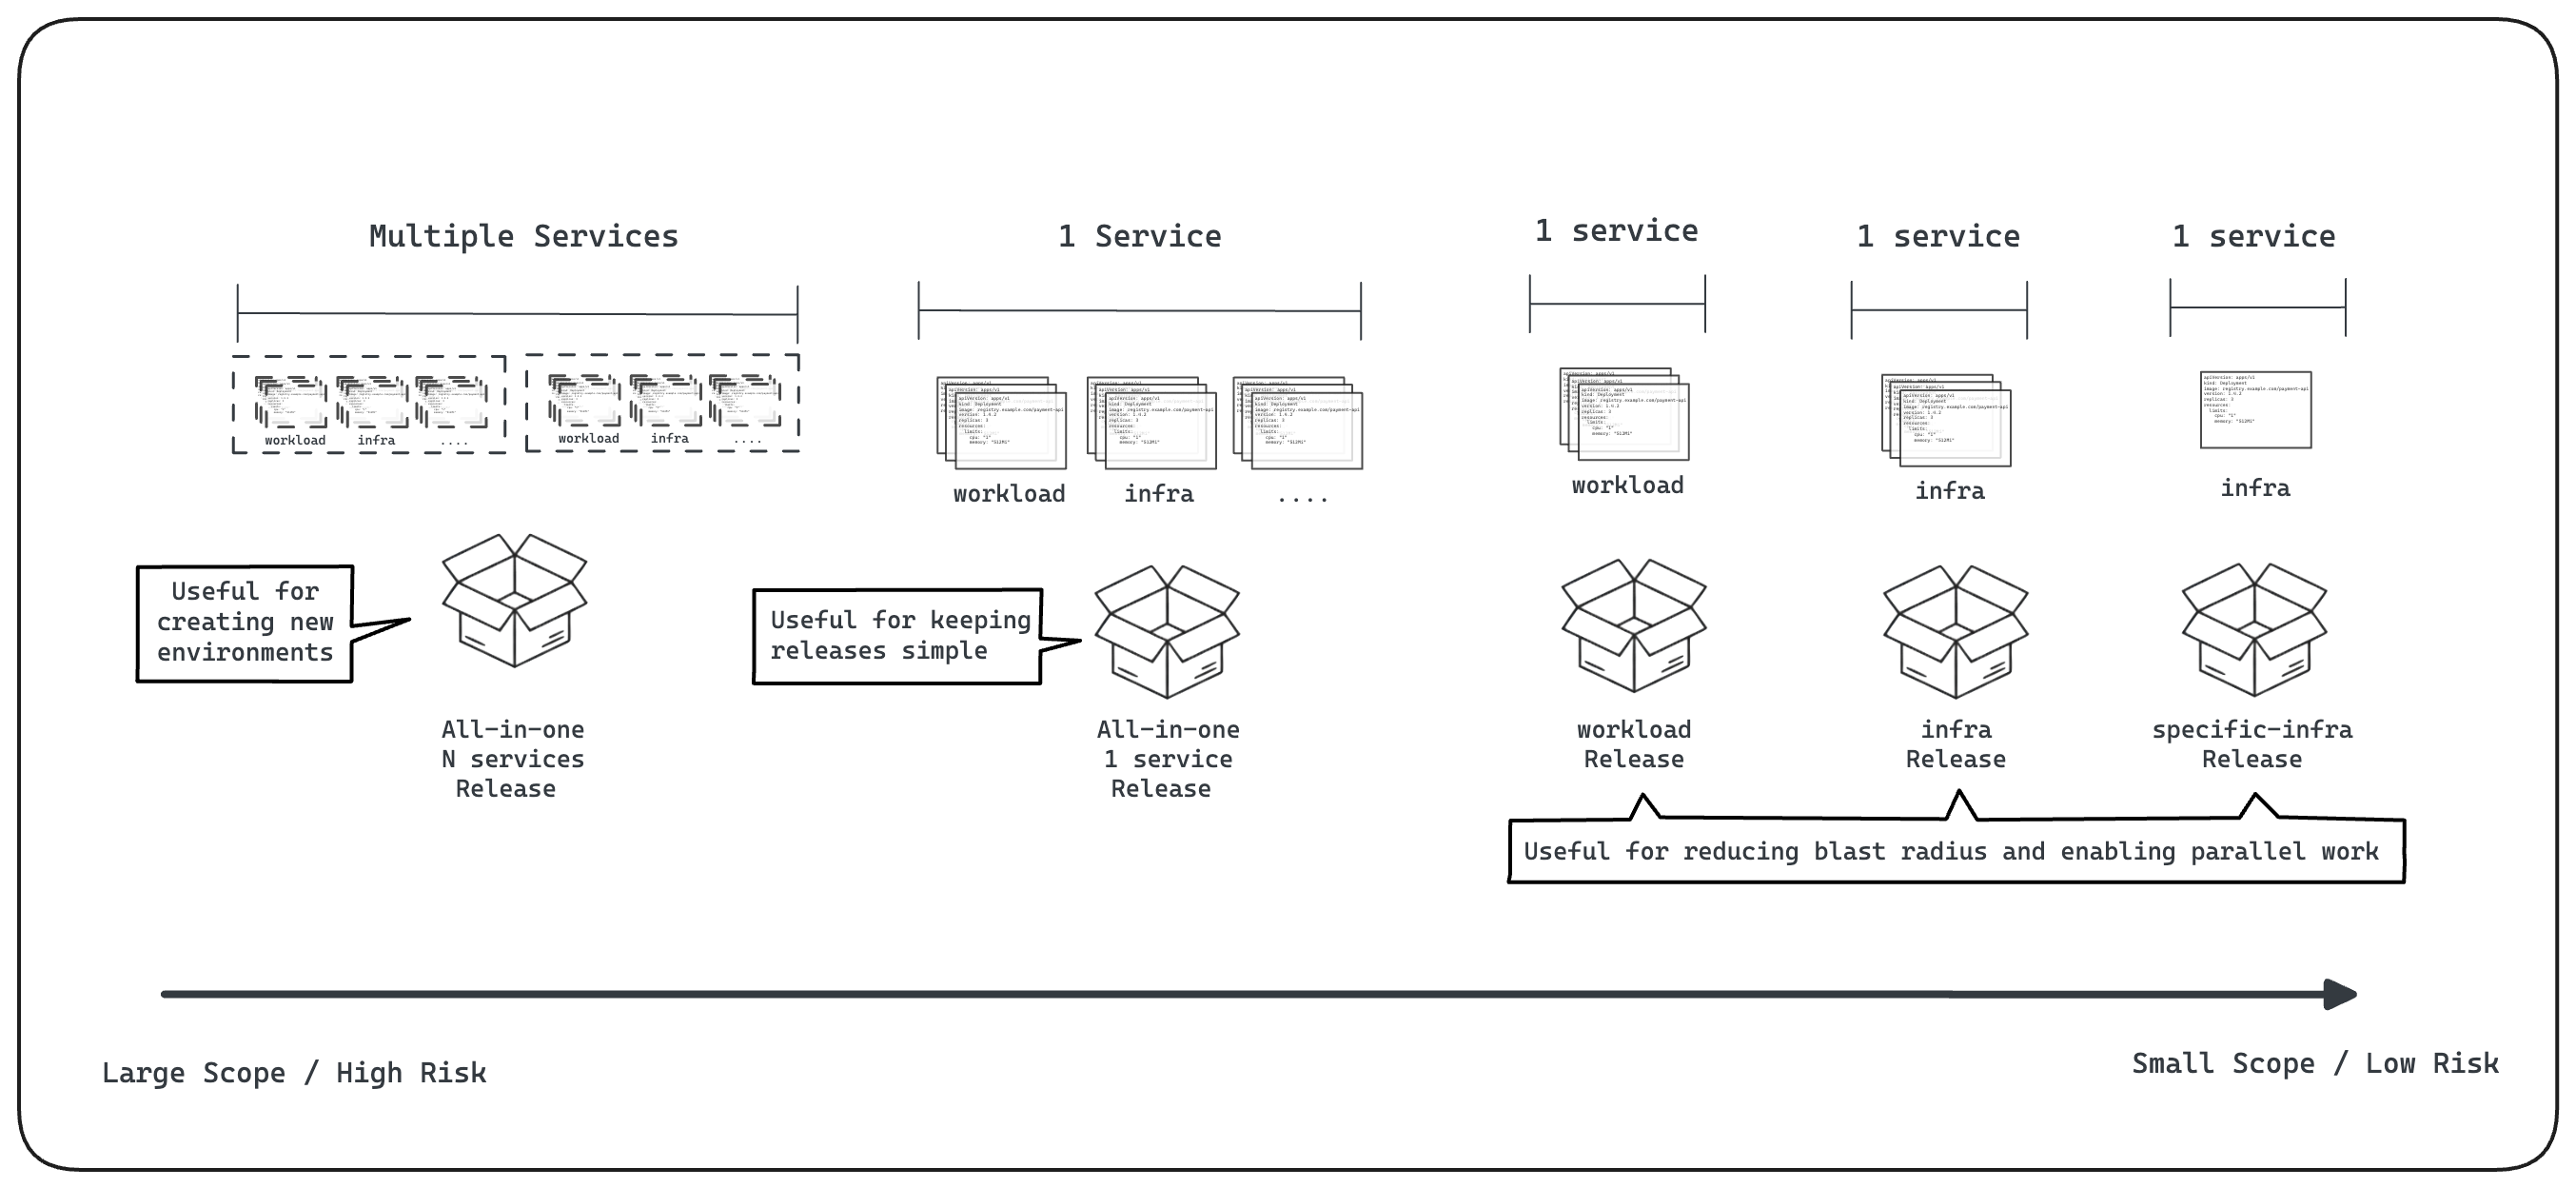
Versions d’artefact et versions de release ont des rôles différents
Les versions d’artefact peuvent communiquer la compatibilité, car les artefacts exposent des contrats consommés par d’autres composants. Une version de release sert un autre but : identifier un instantané d’état système résolu. Les versions d’artefact décrivent la compatibilité ; les versions de release fournissent une identité pour le suivi, la promotion, l’audit et le rollback.
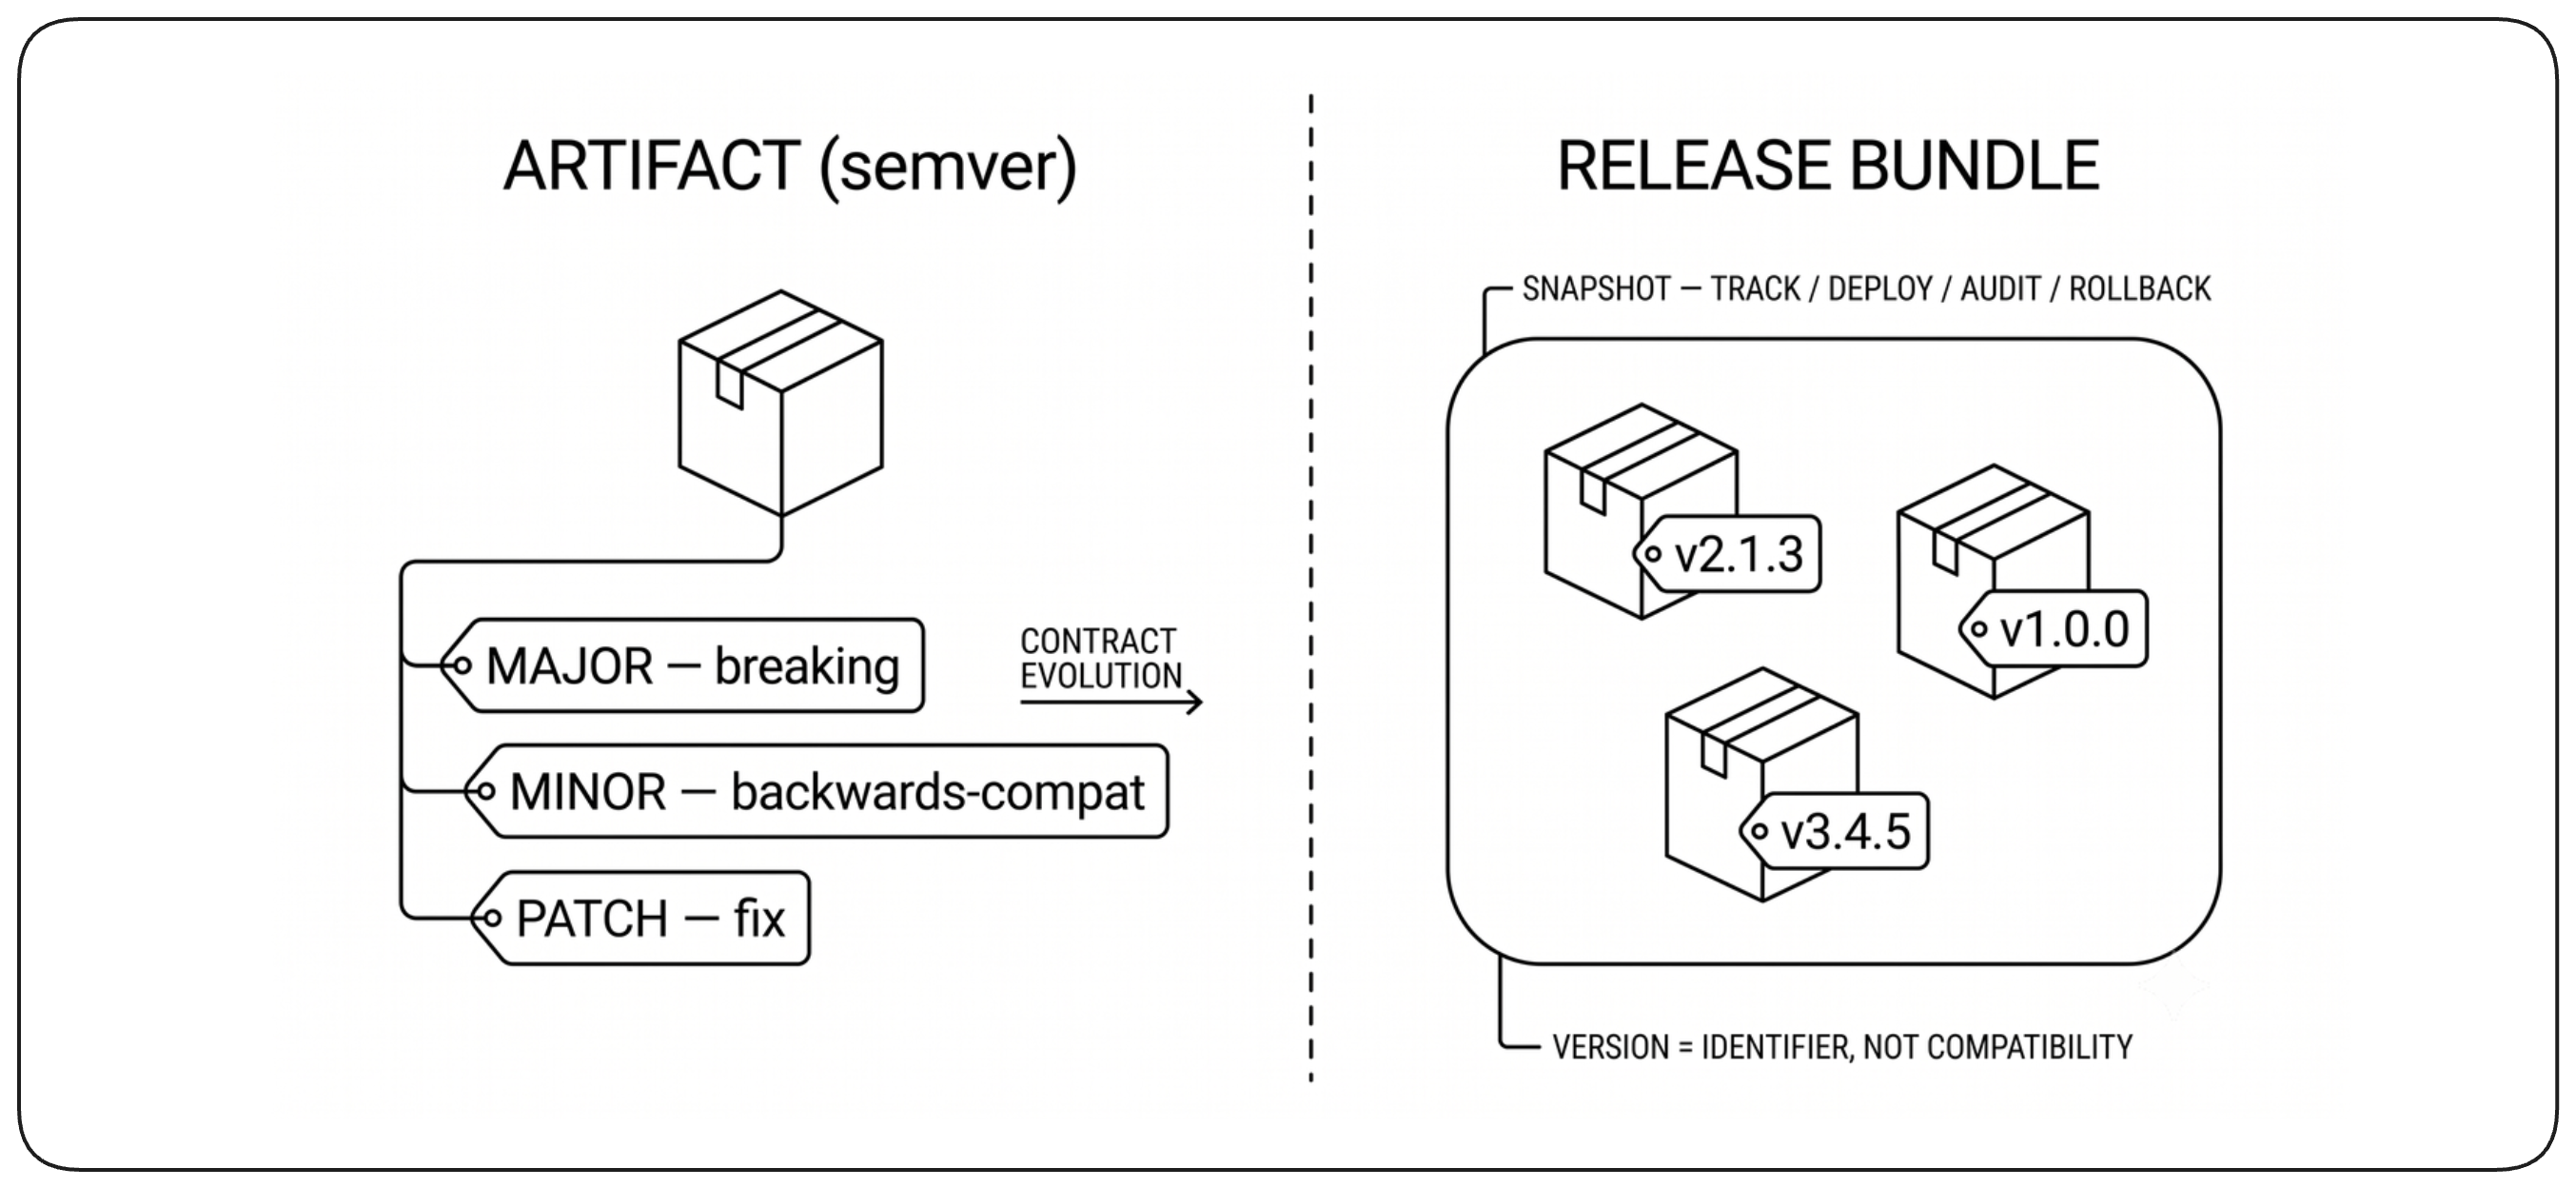
Rendre les releases déclaratives stables, réutilisables et portables
Séparez la définition de la résolution
Une définition de release capture une intention réutilisable. La résolution fournit les valeurs concrètes requises pour une release précise — comme les versions d’artefacts et les paramètres d’environnement — et produit une release résolue immuable.
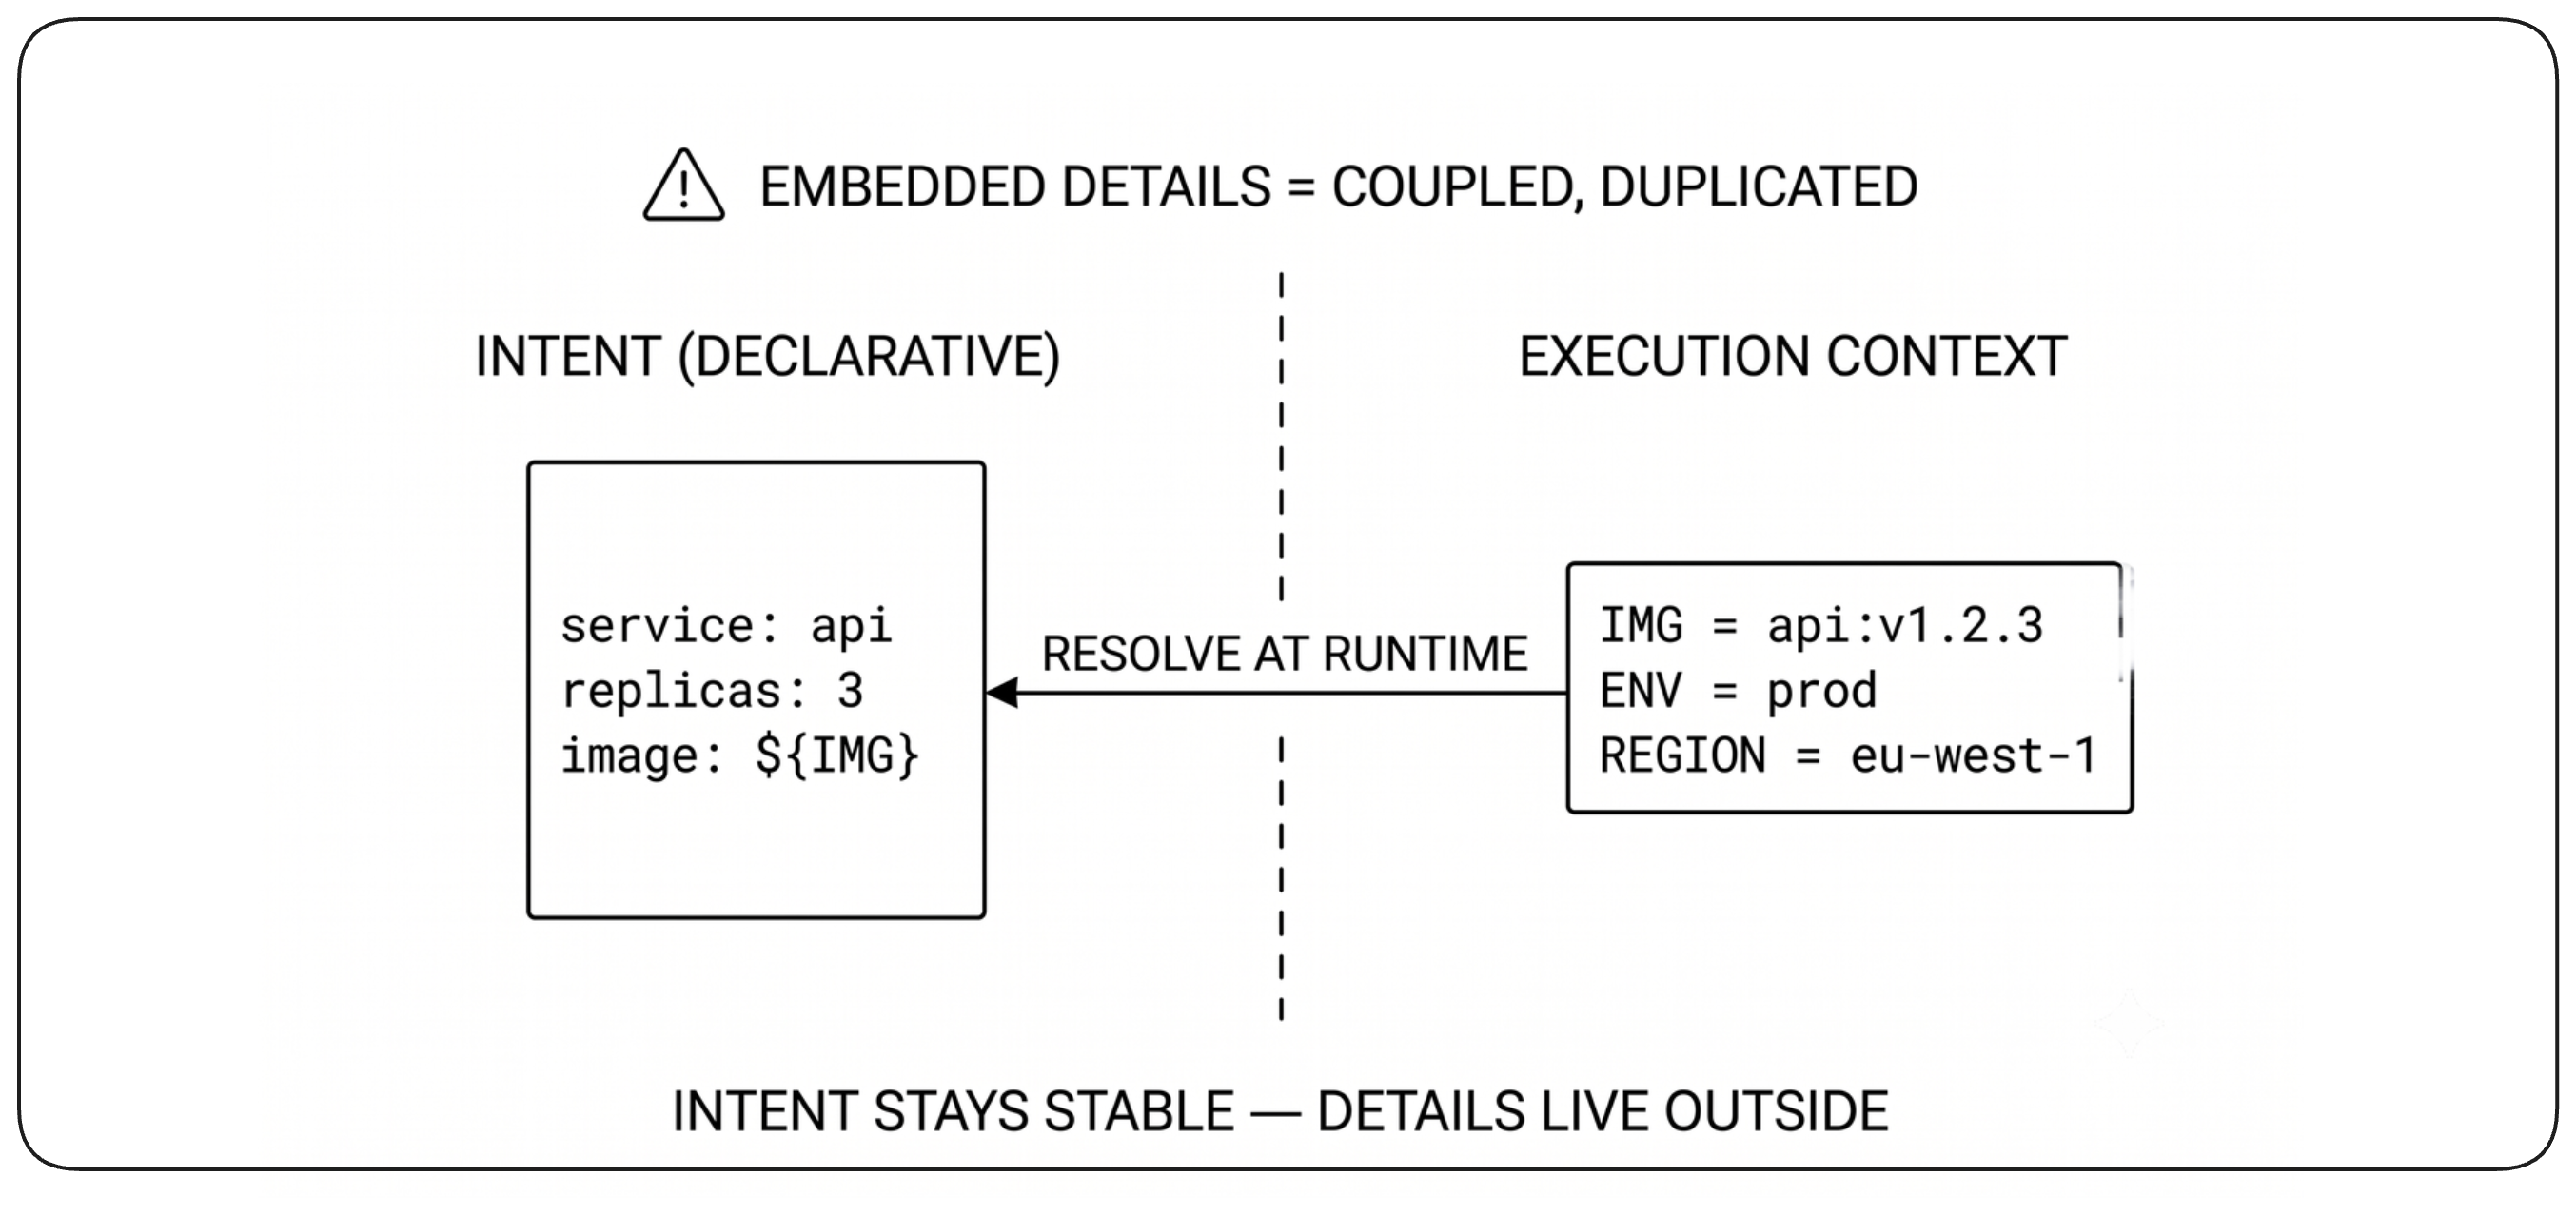
Gardez le contexte d’exécution hors de l’intention déclarative
Les configurations déclaratives doivent rester stables quand le contexte d’exécution change. Y intégrer des valeurs liées à un build, un environnement ou un moment particulier couple l’intention à l’exécution, crée de la duplication et réduit la réutilisation.
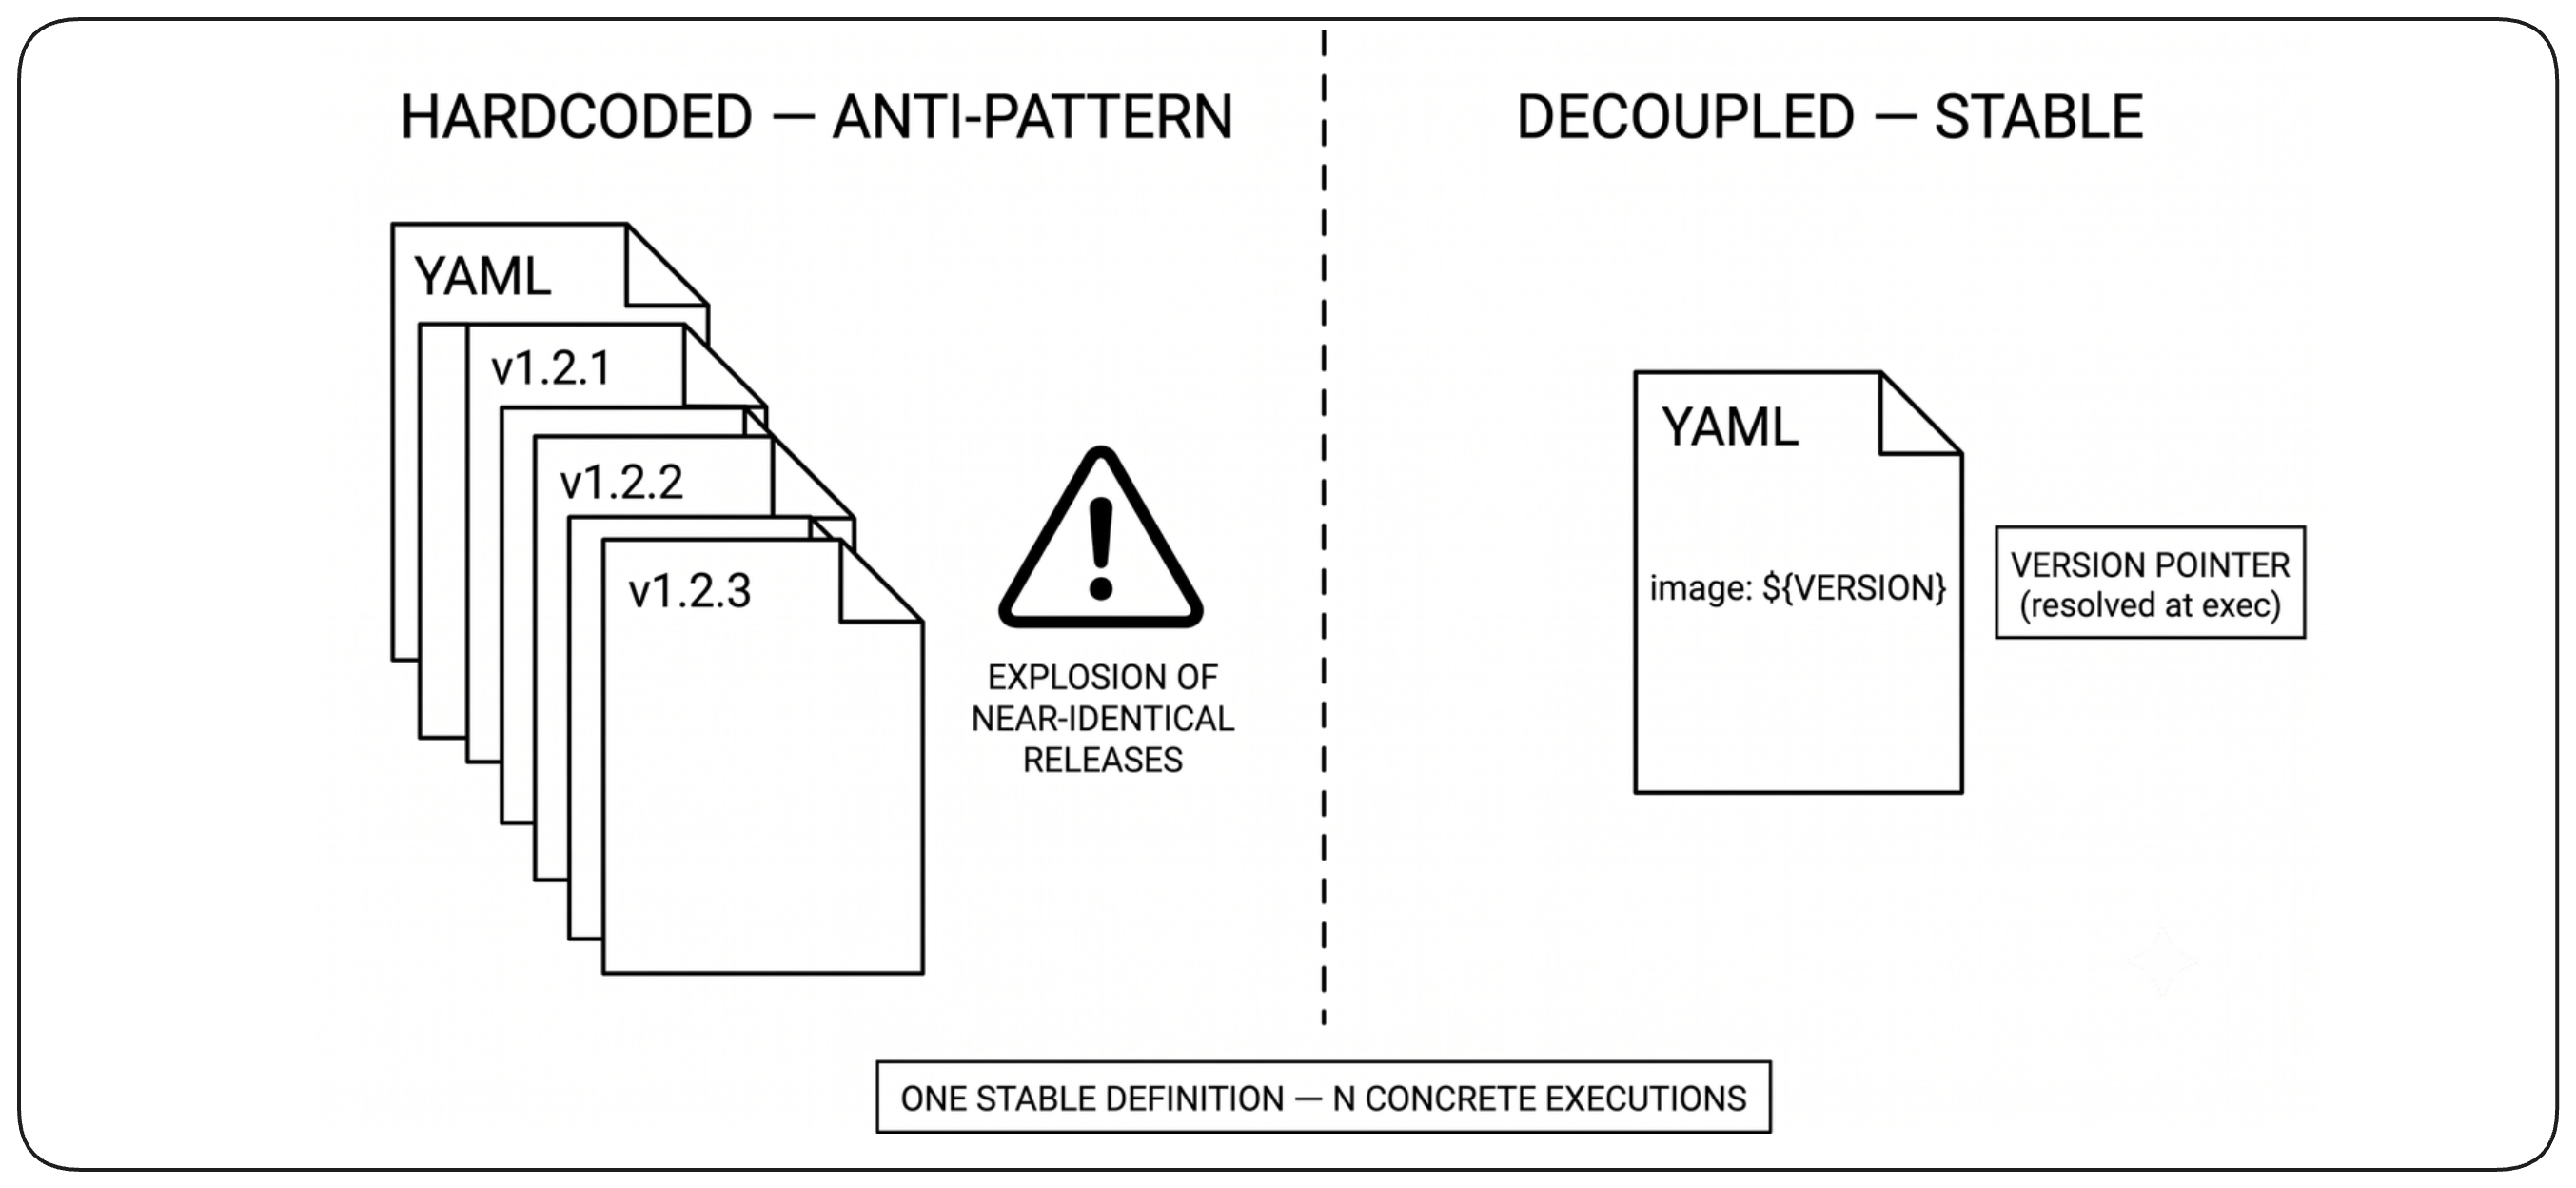
Pourquoi les versions d’artefact ne doivent pas être codées en dur
Les versions d’artefact changent indépendamment de la structure de la release. Les coder en dur impose une nouvelle définition de release pour chaque build, et produit de nombreuses définitions quasi identiques. Les garder externes préserve une définition stable et réutilisable, tandis que la release résolue enregistre exactement quels artefacts ont été choisis.
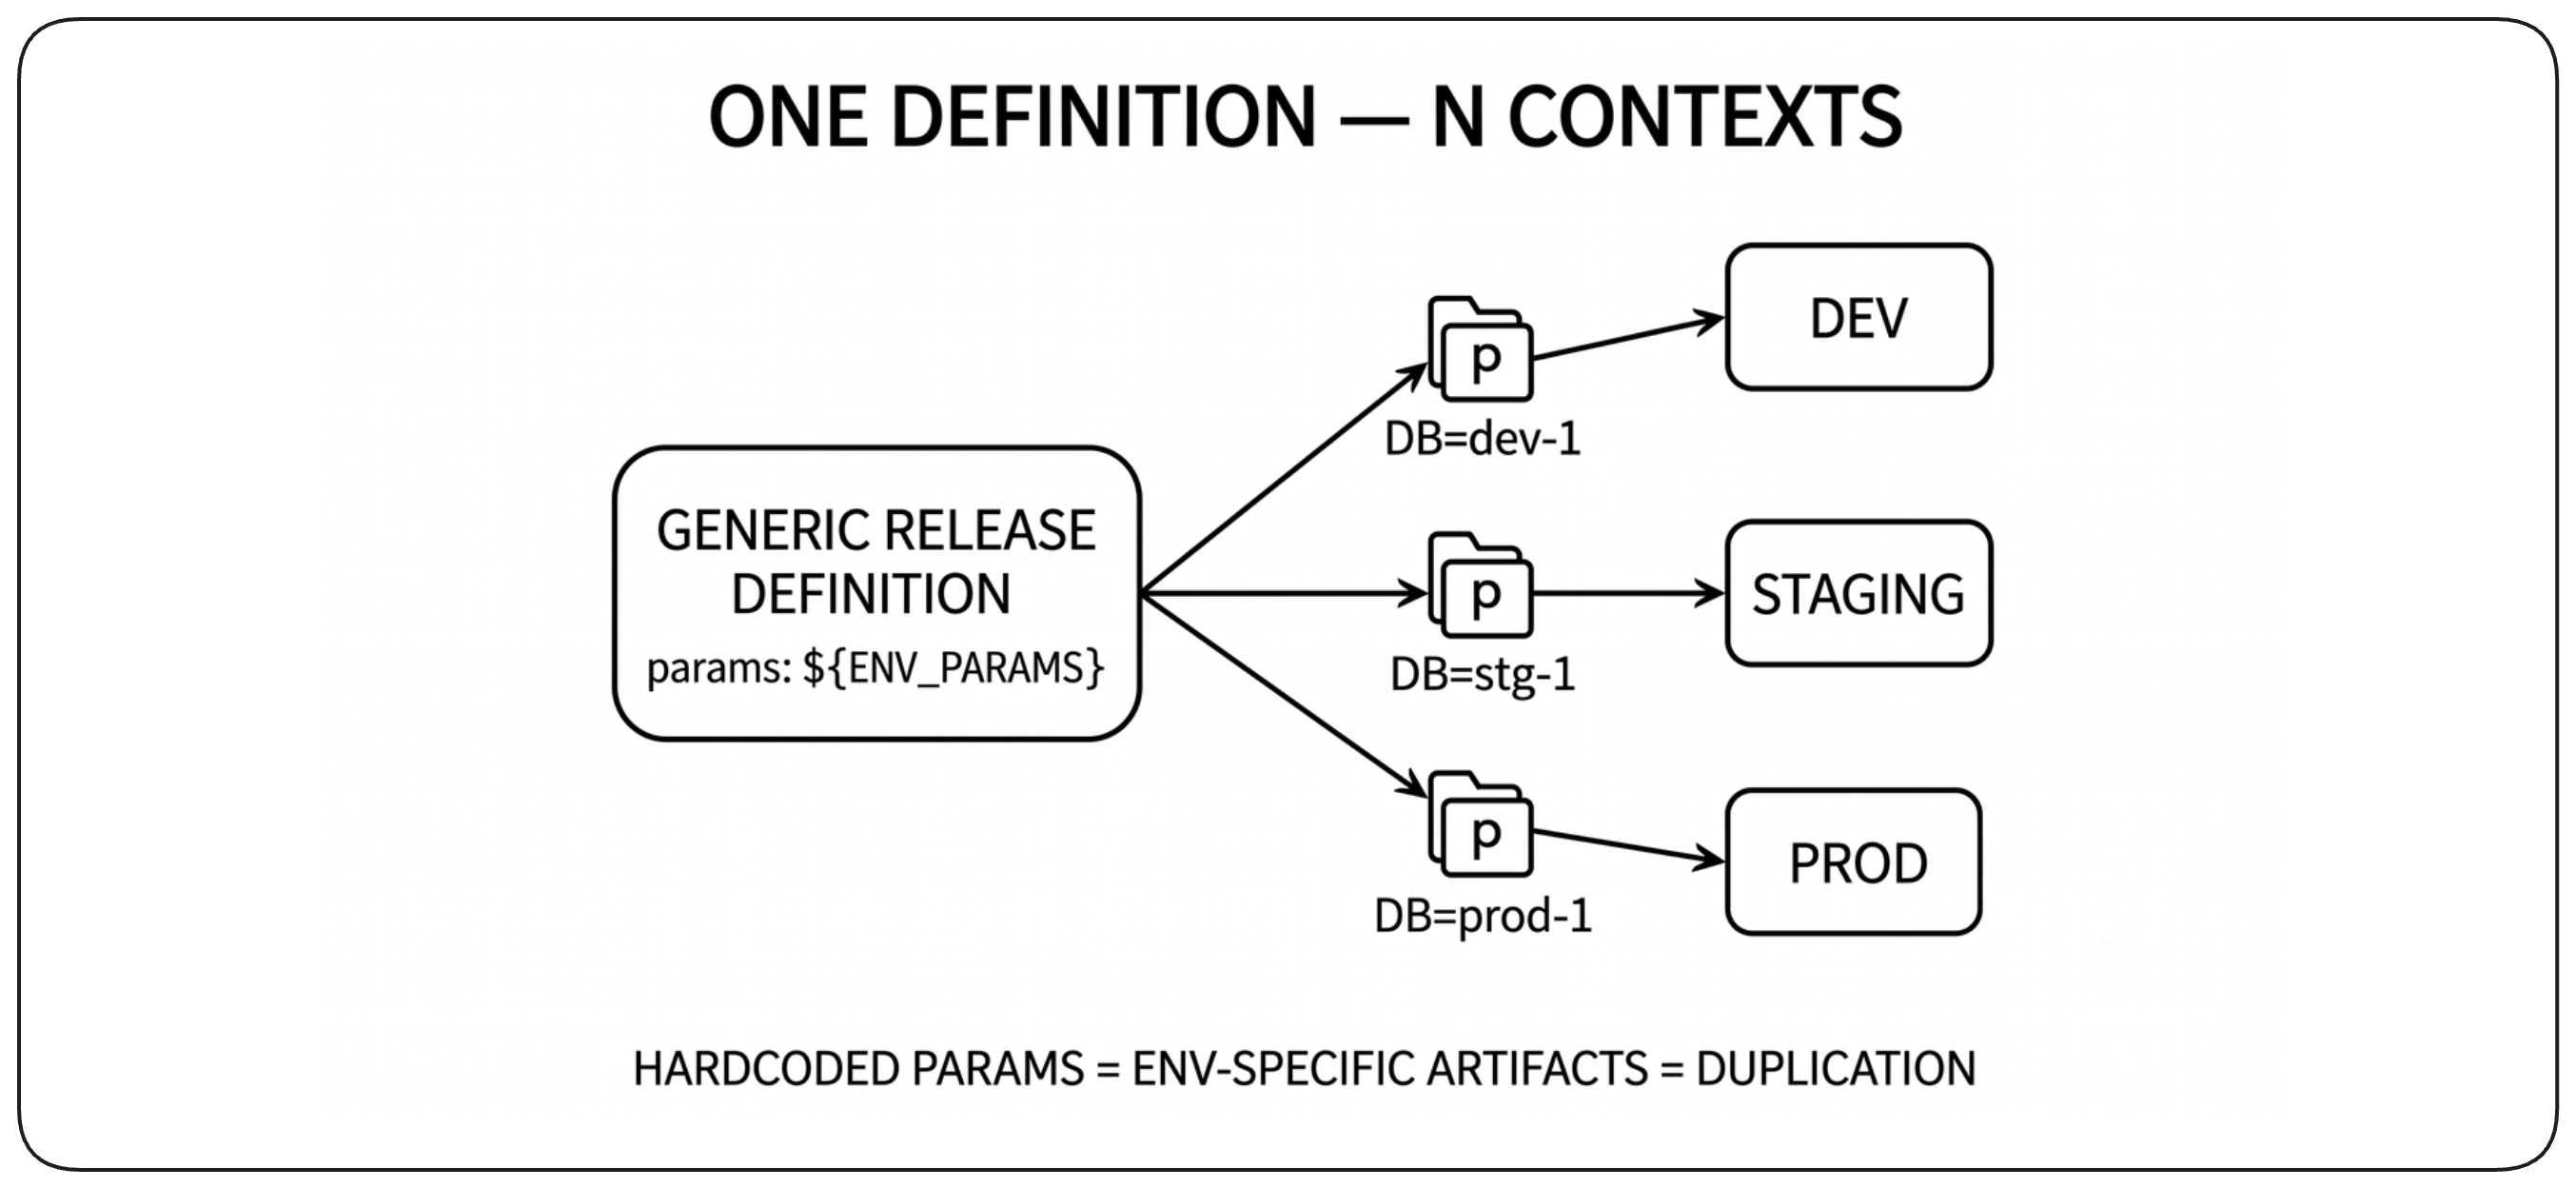
Pourquoi les paramètres ne doivent pas être codés en dur
Les paramètres représentent un contexte d’exécution plutôt qu’une intention stable. Les coder en dur lie une définition de release à un environnement précis, crée de la duplication et réduit la réutilisation. Les garder externes préserve la portabilité, tandis que la release résolue enregistre les valeurs concrètes utilisées pour chaque cible.
La triade de la configuration : statique, dynamique et secrets
La configuration participe aux releases à travers des valeurs d’origines et de cycles de vie différents : les paramètres statiques expriment l’intention humaine, les paramètres dynamiques enregistrent l’état découvert, et les secrets portent une autorité sensible. Garder ces préoccupations distinctes évite que le pipeline de release devienne propriétaire de toutes les valeurs.
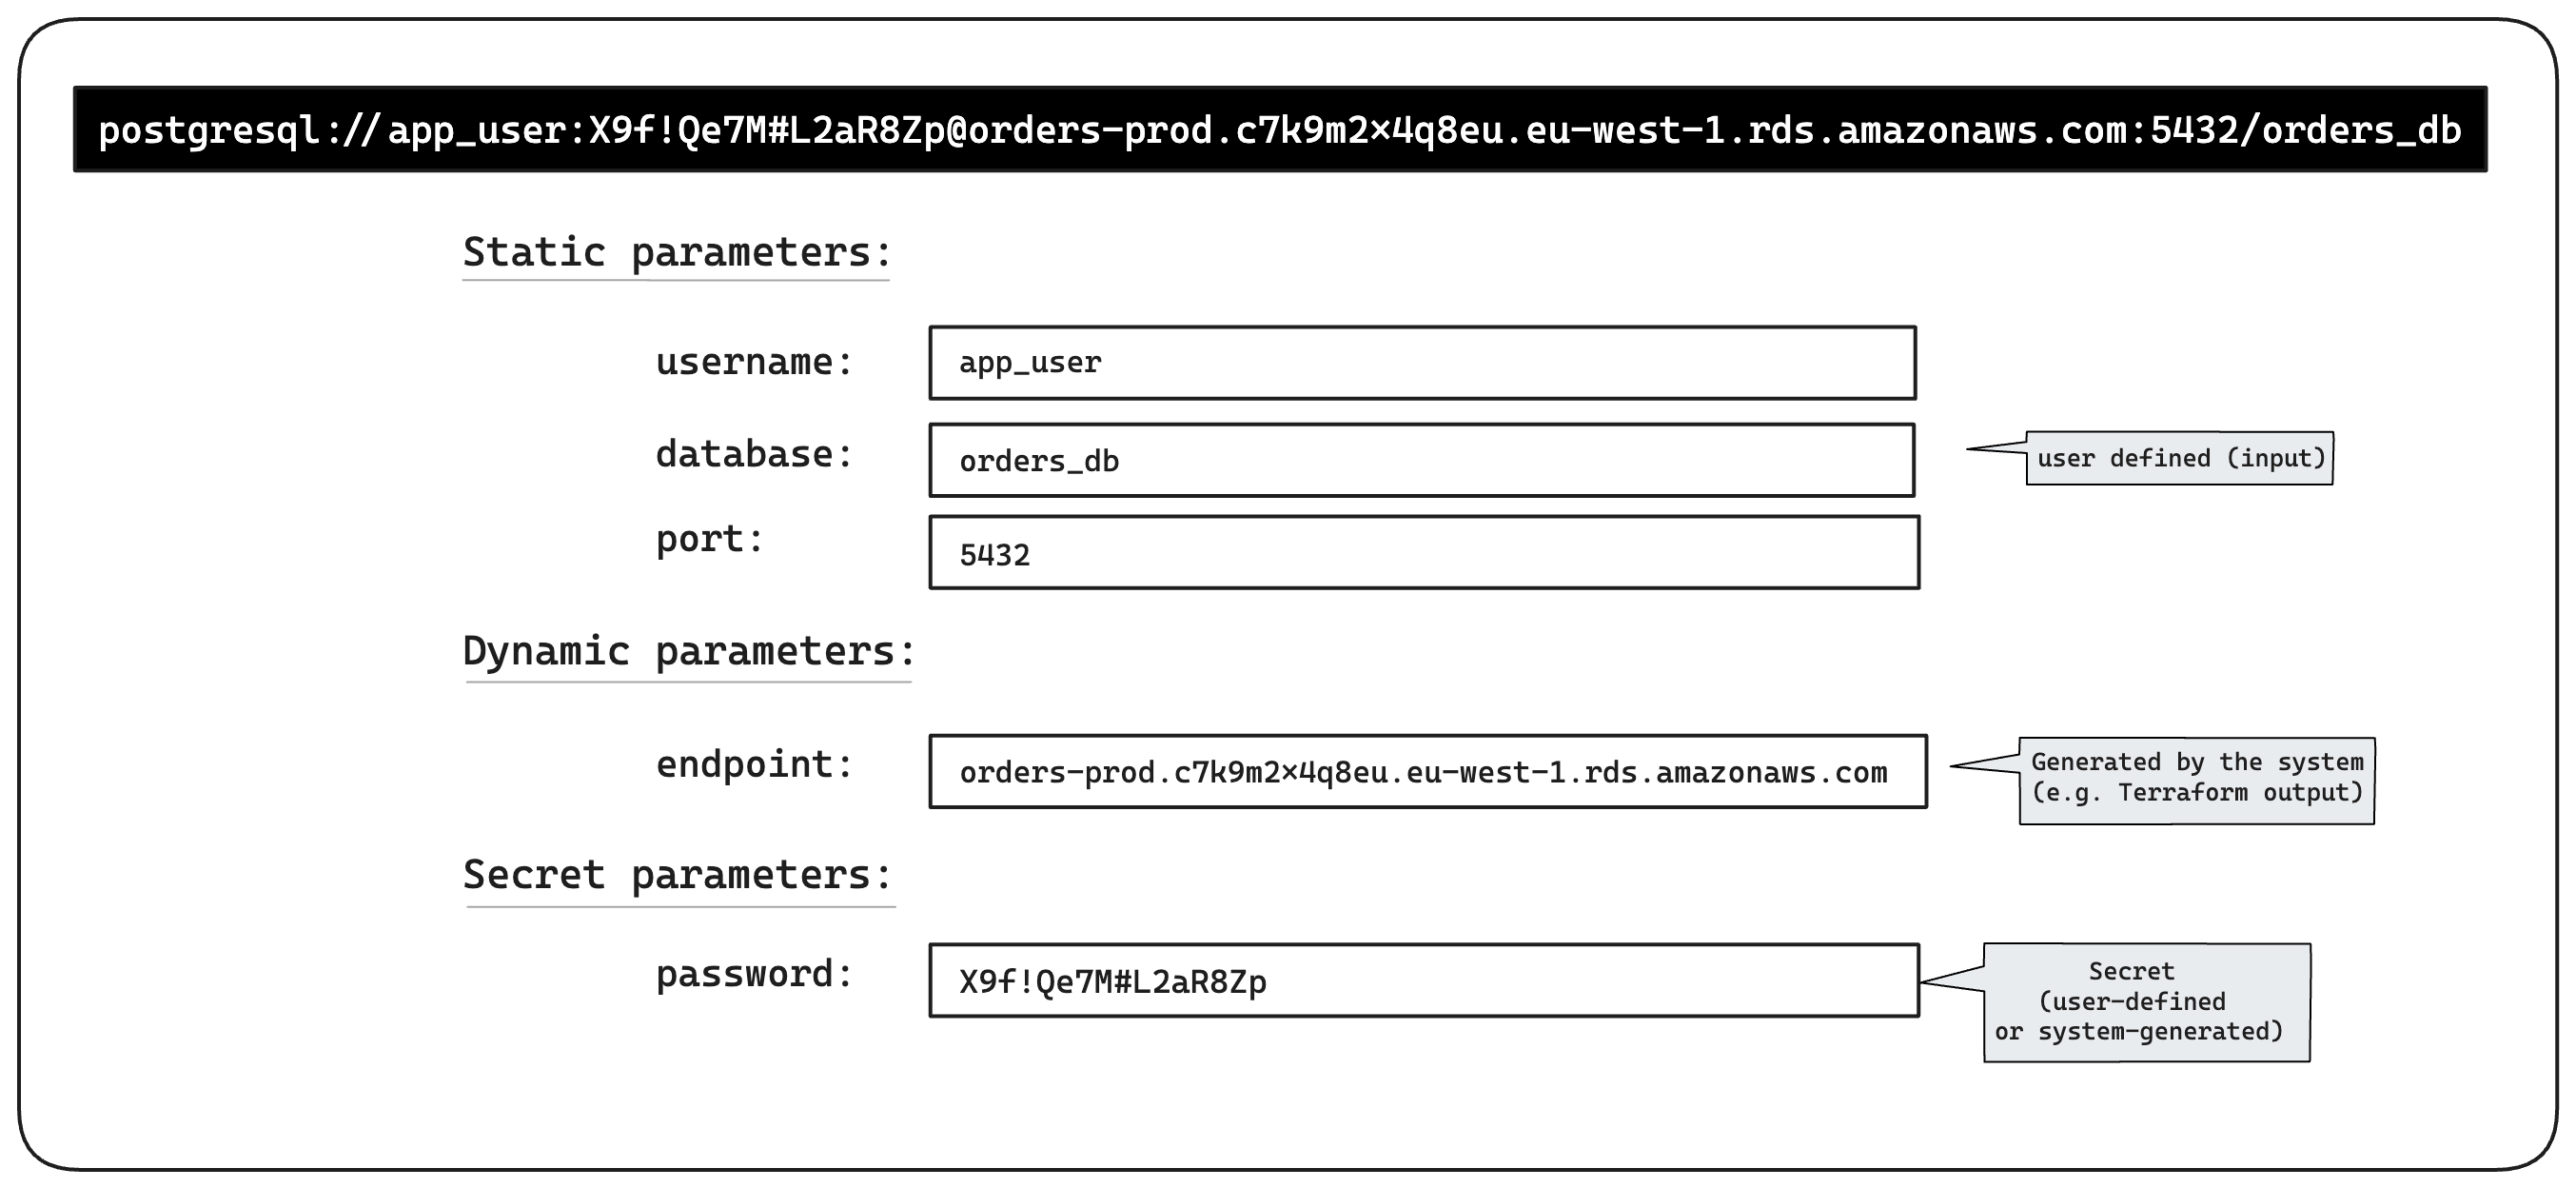
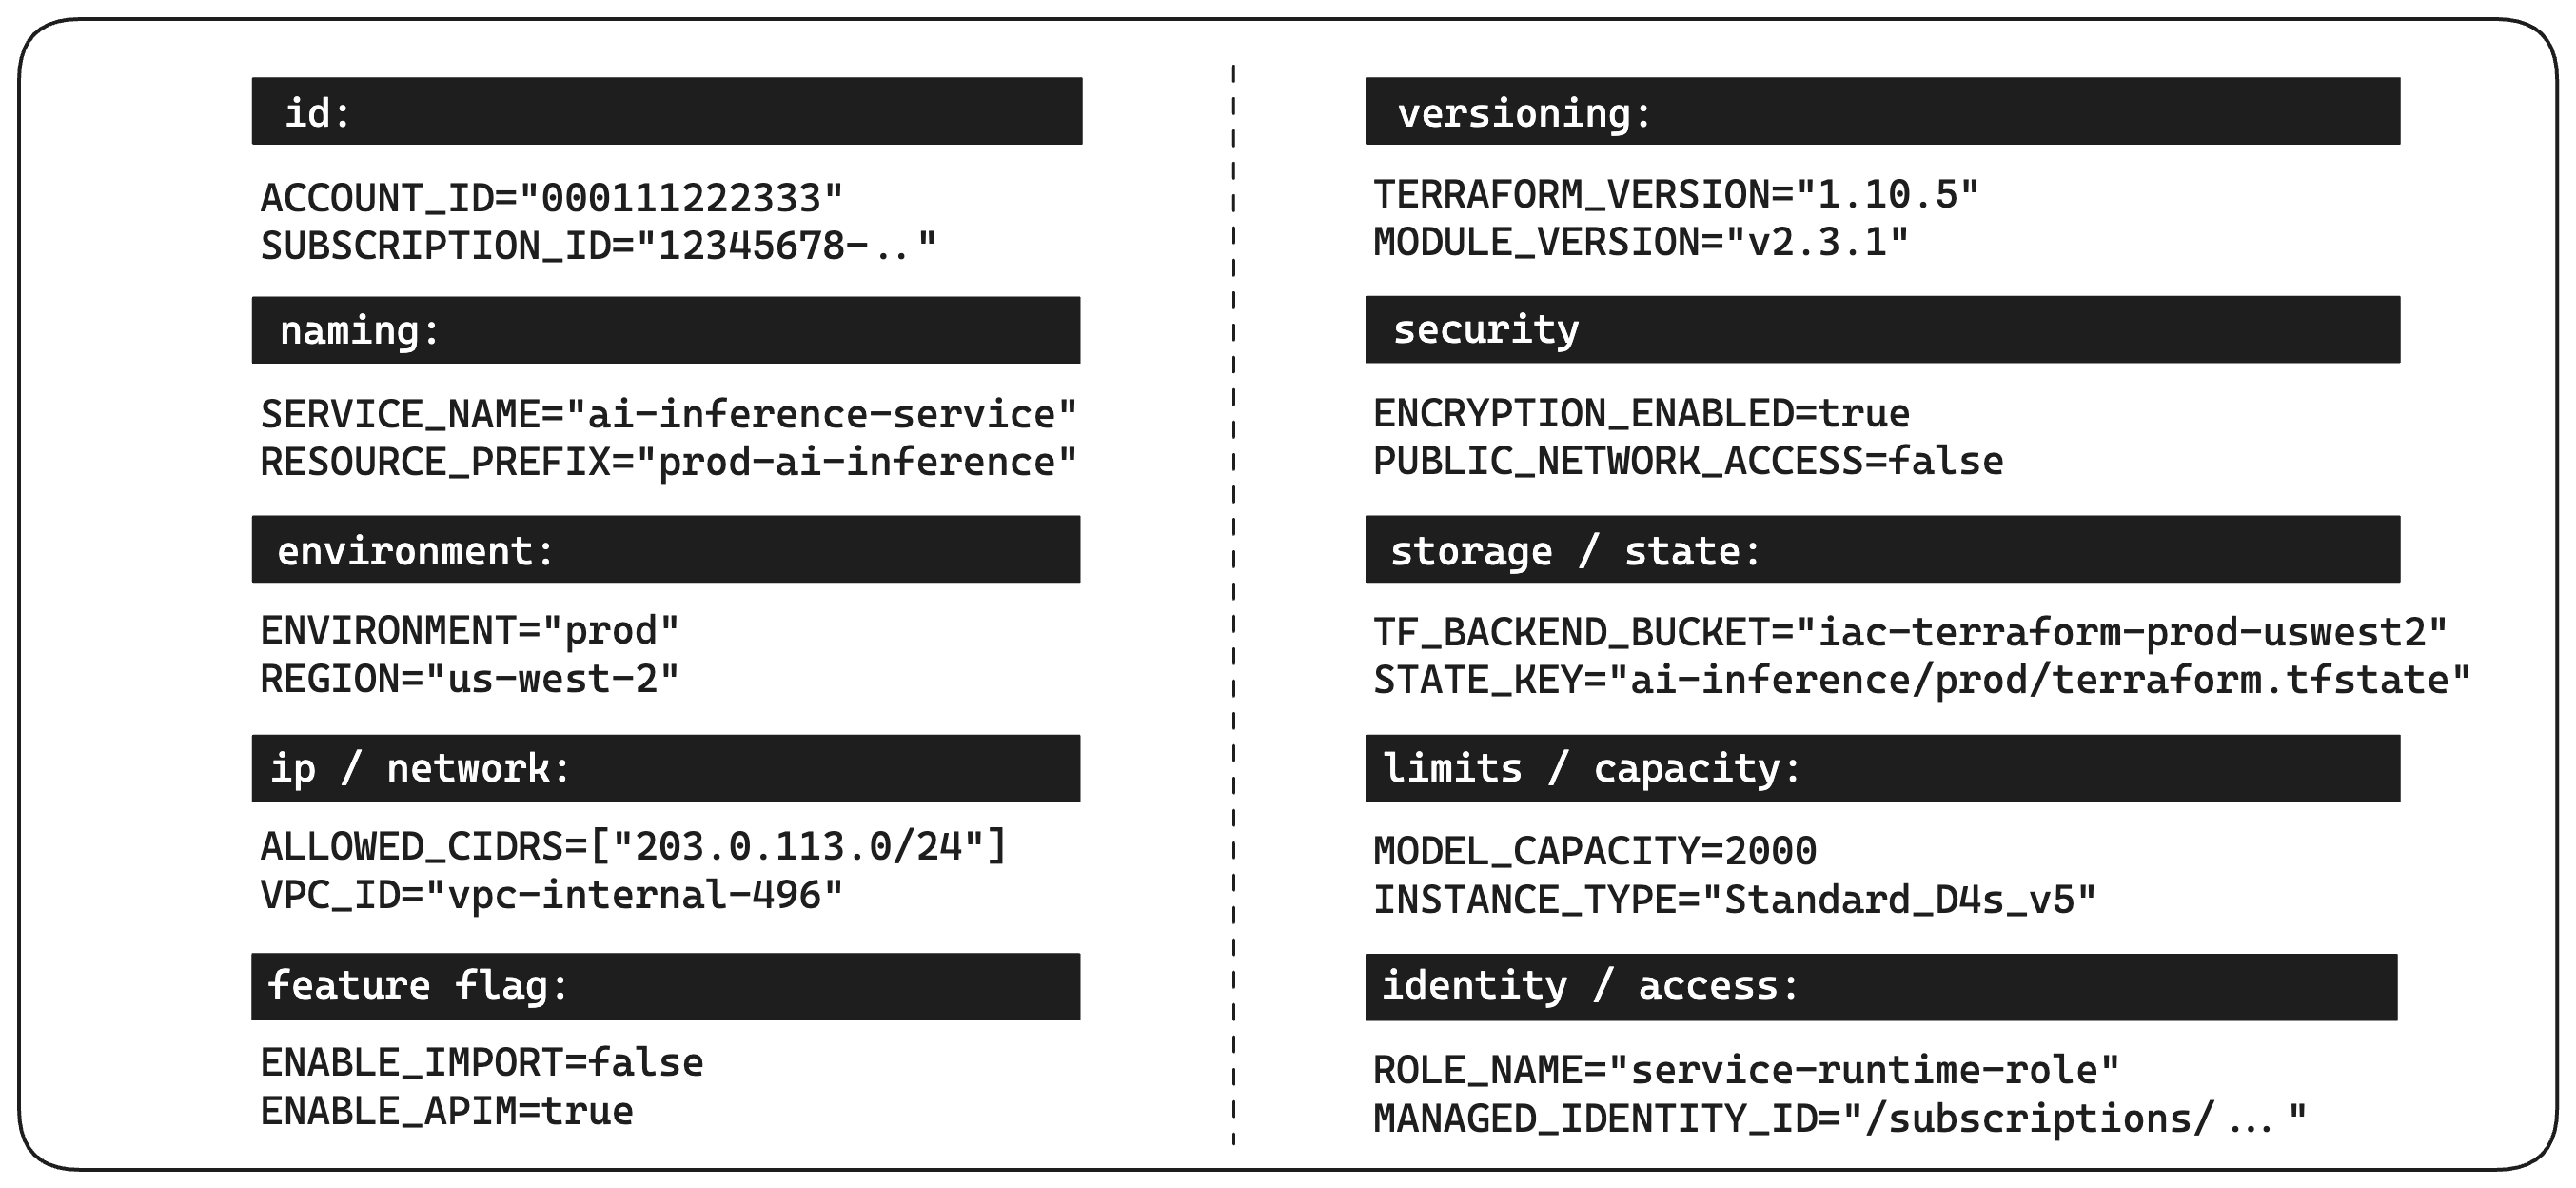
Paramètres statiques
Les paramètres statiques sont des choix humains délibérés et relisibles, qui décrivent comment un environnement doit être configuré. Ils appartiennent à l’intention déclarative et doivent rester séparés de la mécanique d’exécution qui applique une release.
Paramètres dynamiques
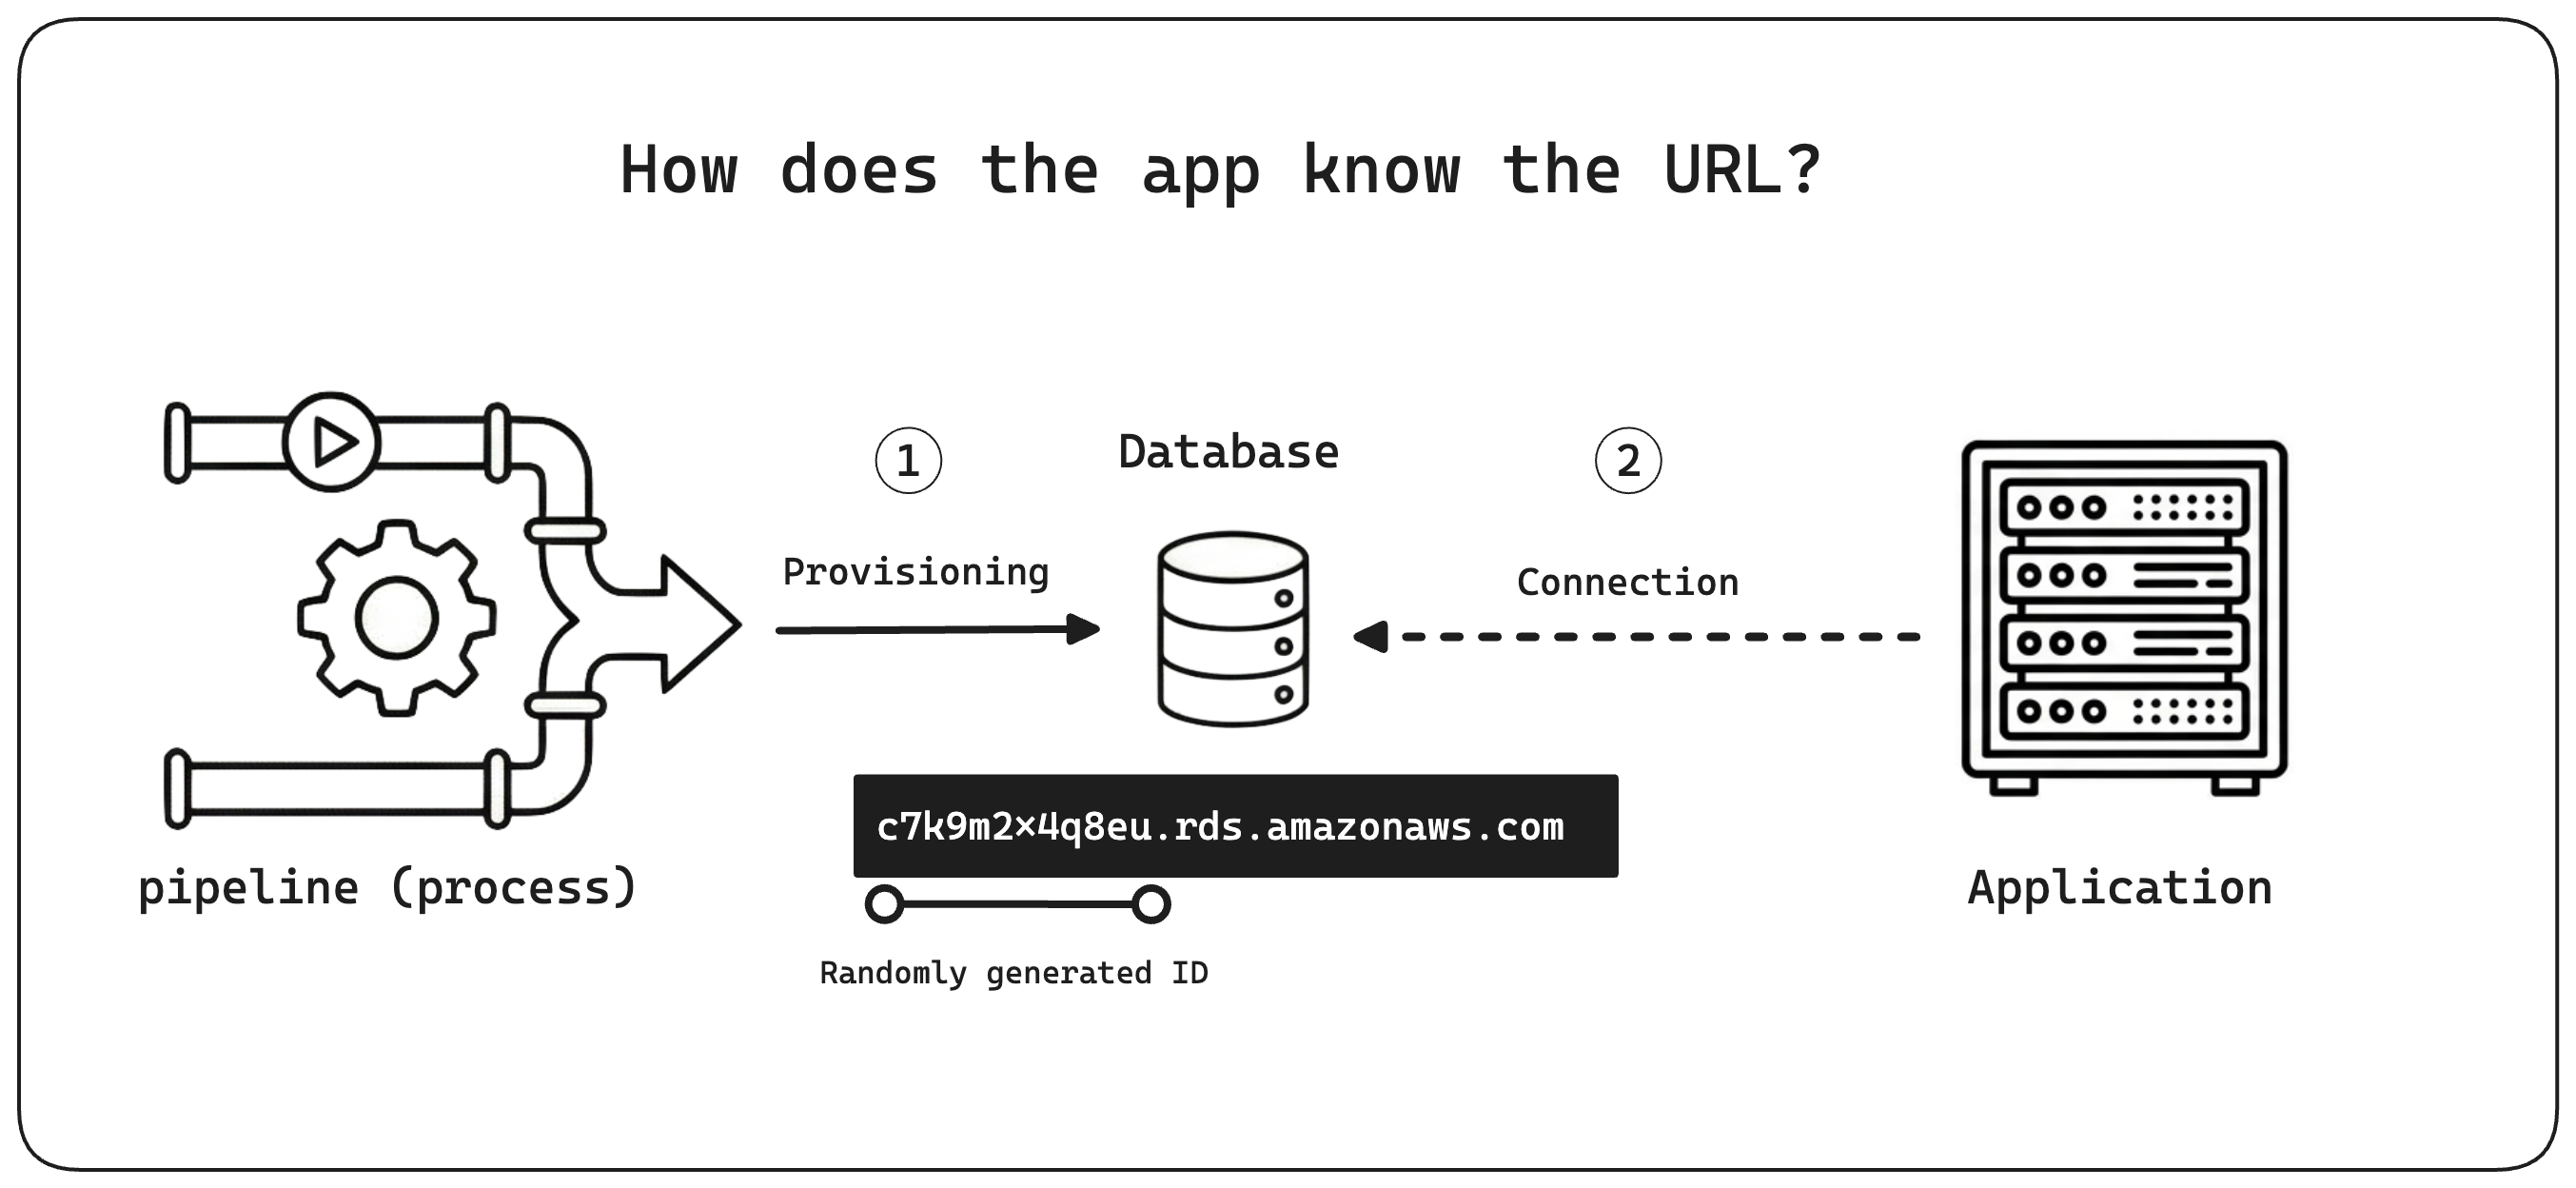
Les paramètres dynamiques sont des valeurs découvertes ou générées lors de l’exécution des systèmes, comme des identifiants de ressources ou des endpoints. Ils décrivent la réalité observée plutôt que l’intention future ; les consommateurs doivent donc les récupérer via une interface durable plutôt que de coupler leur cycle de vie à une exécution de déploiement unique.
Secrets
Les secrets représentent une autorité sensible plutôt qu’une configuration ordinaire. Leur stockage, leur accès, leur rotation et leur durée de vie exigent donc un cycle de vie de sécurité distinct de celui des paramètres statiques et dynamiques.
Gardez les secrets hors du chemin de release
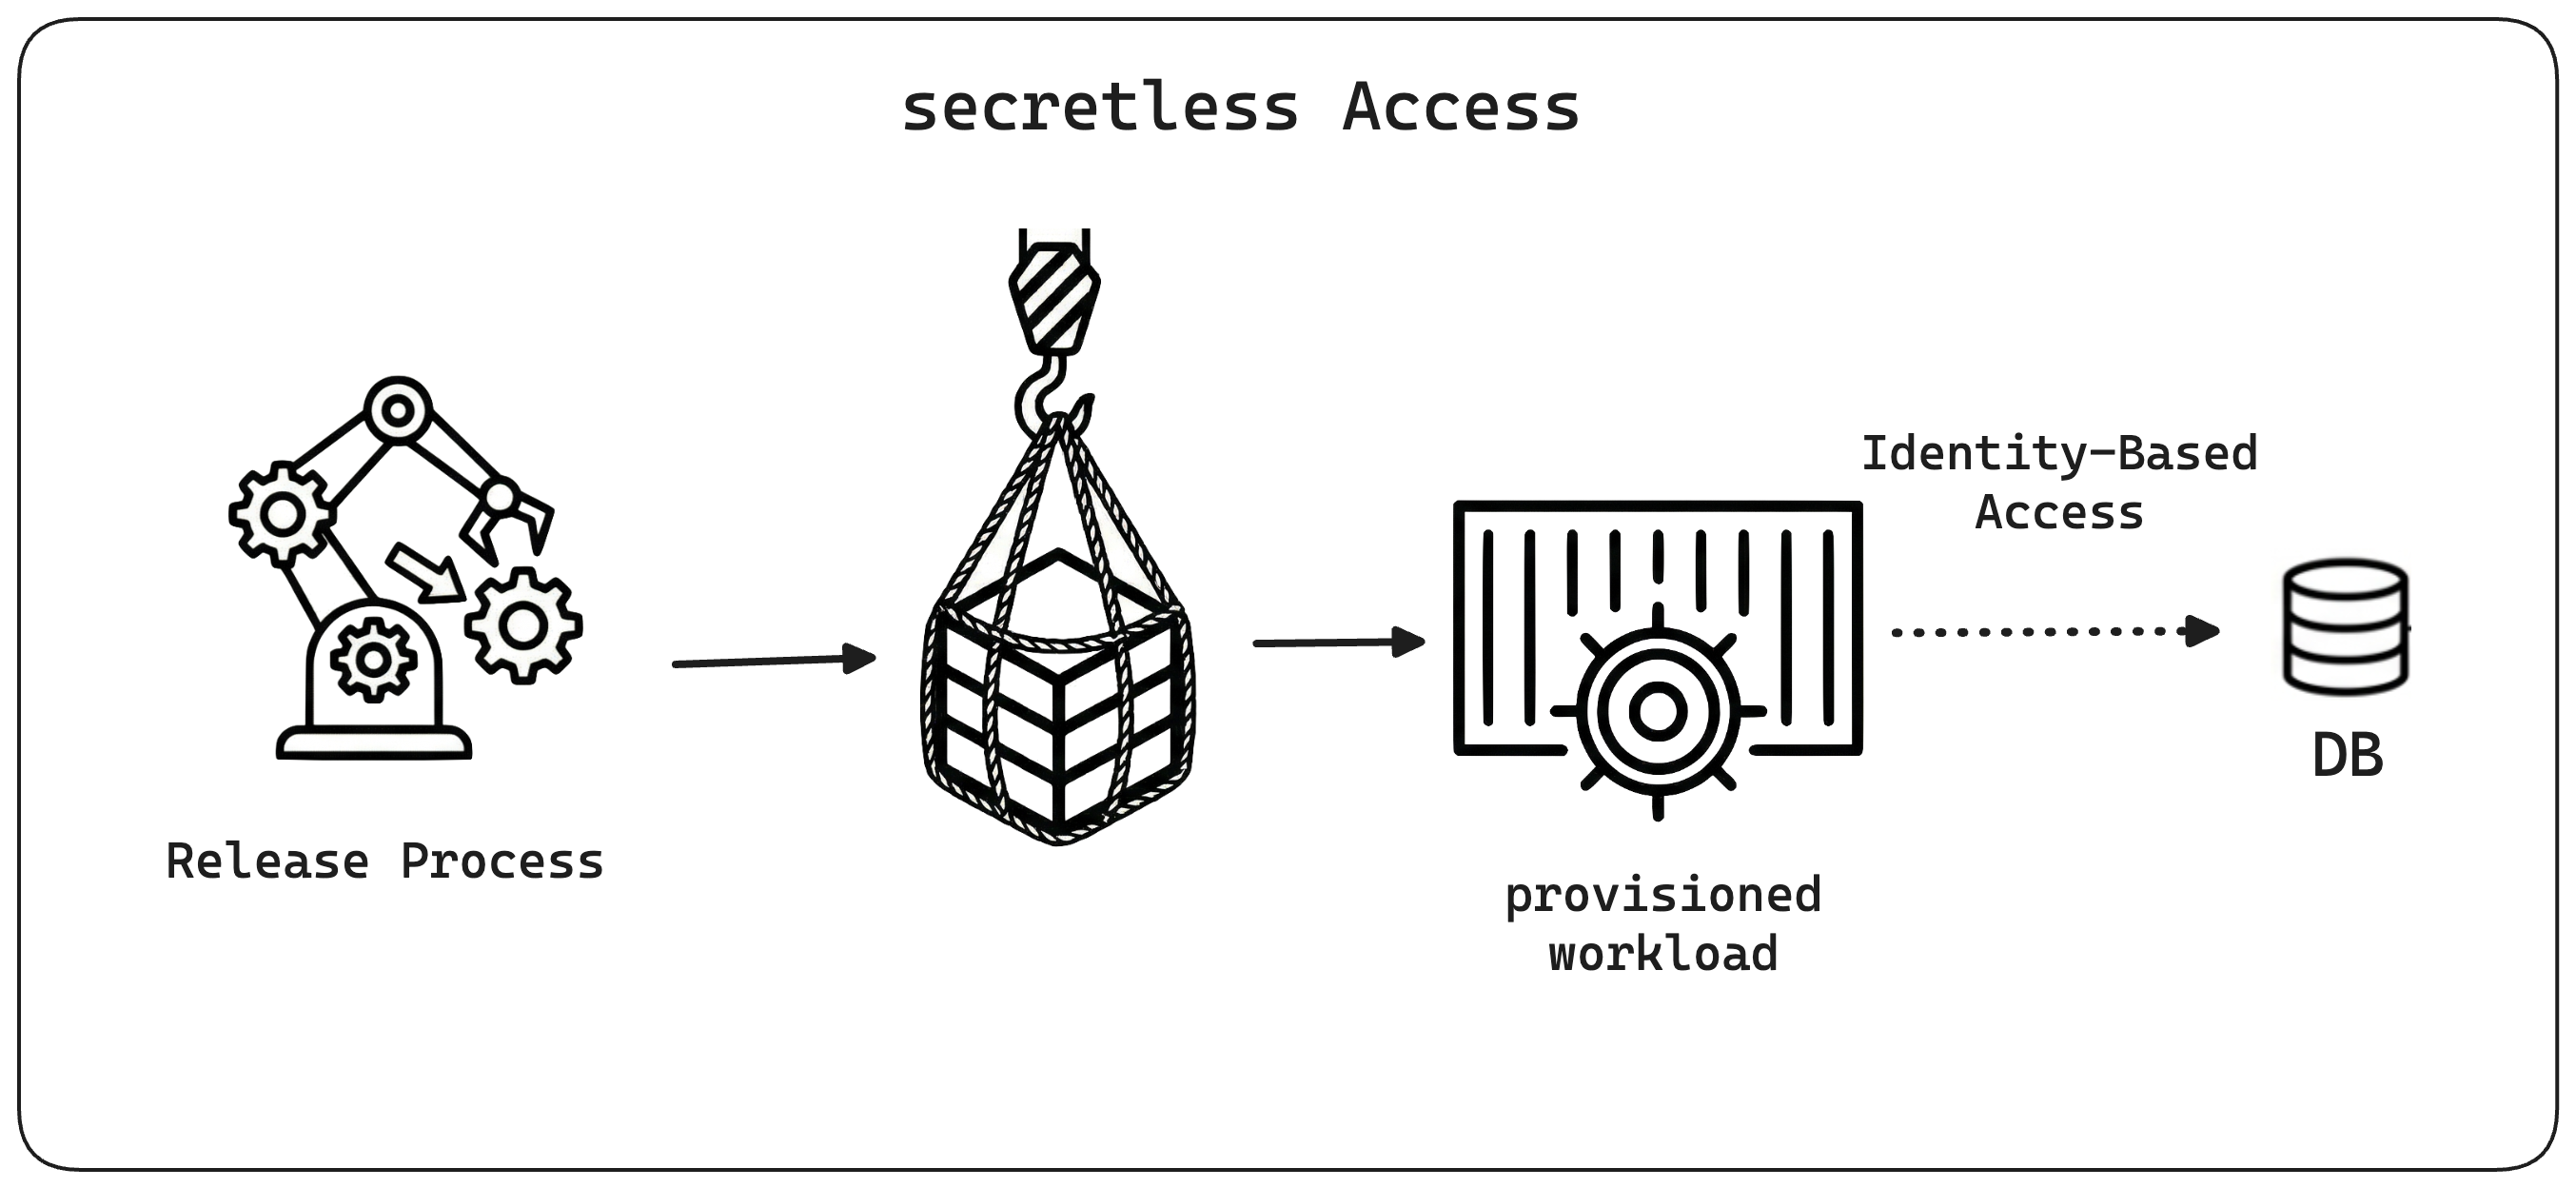
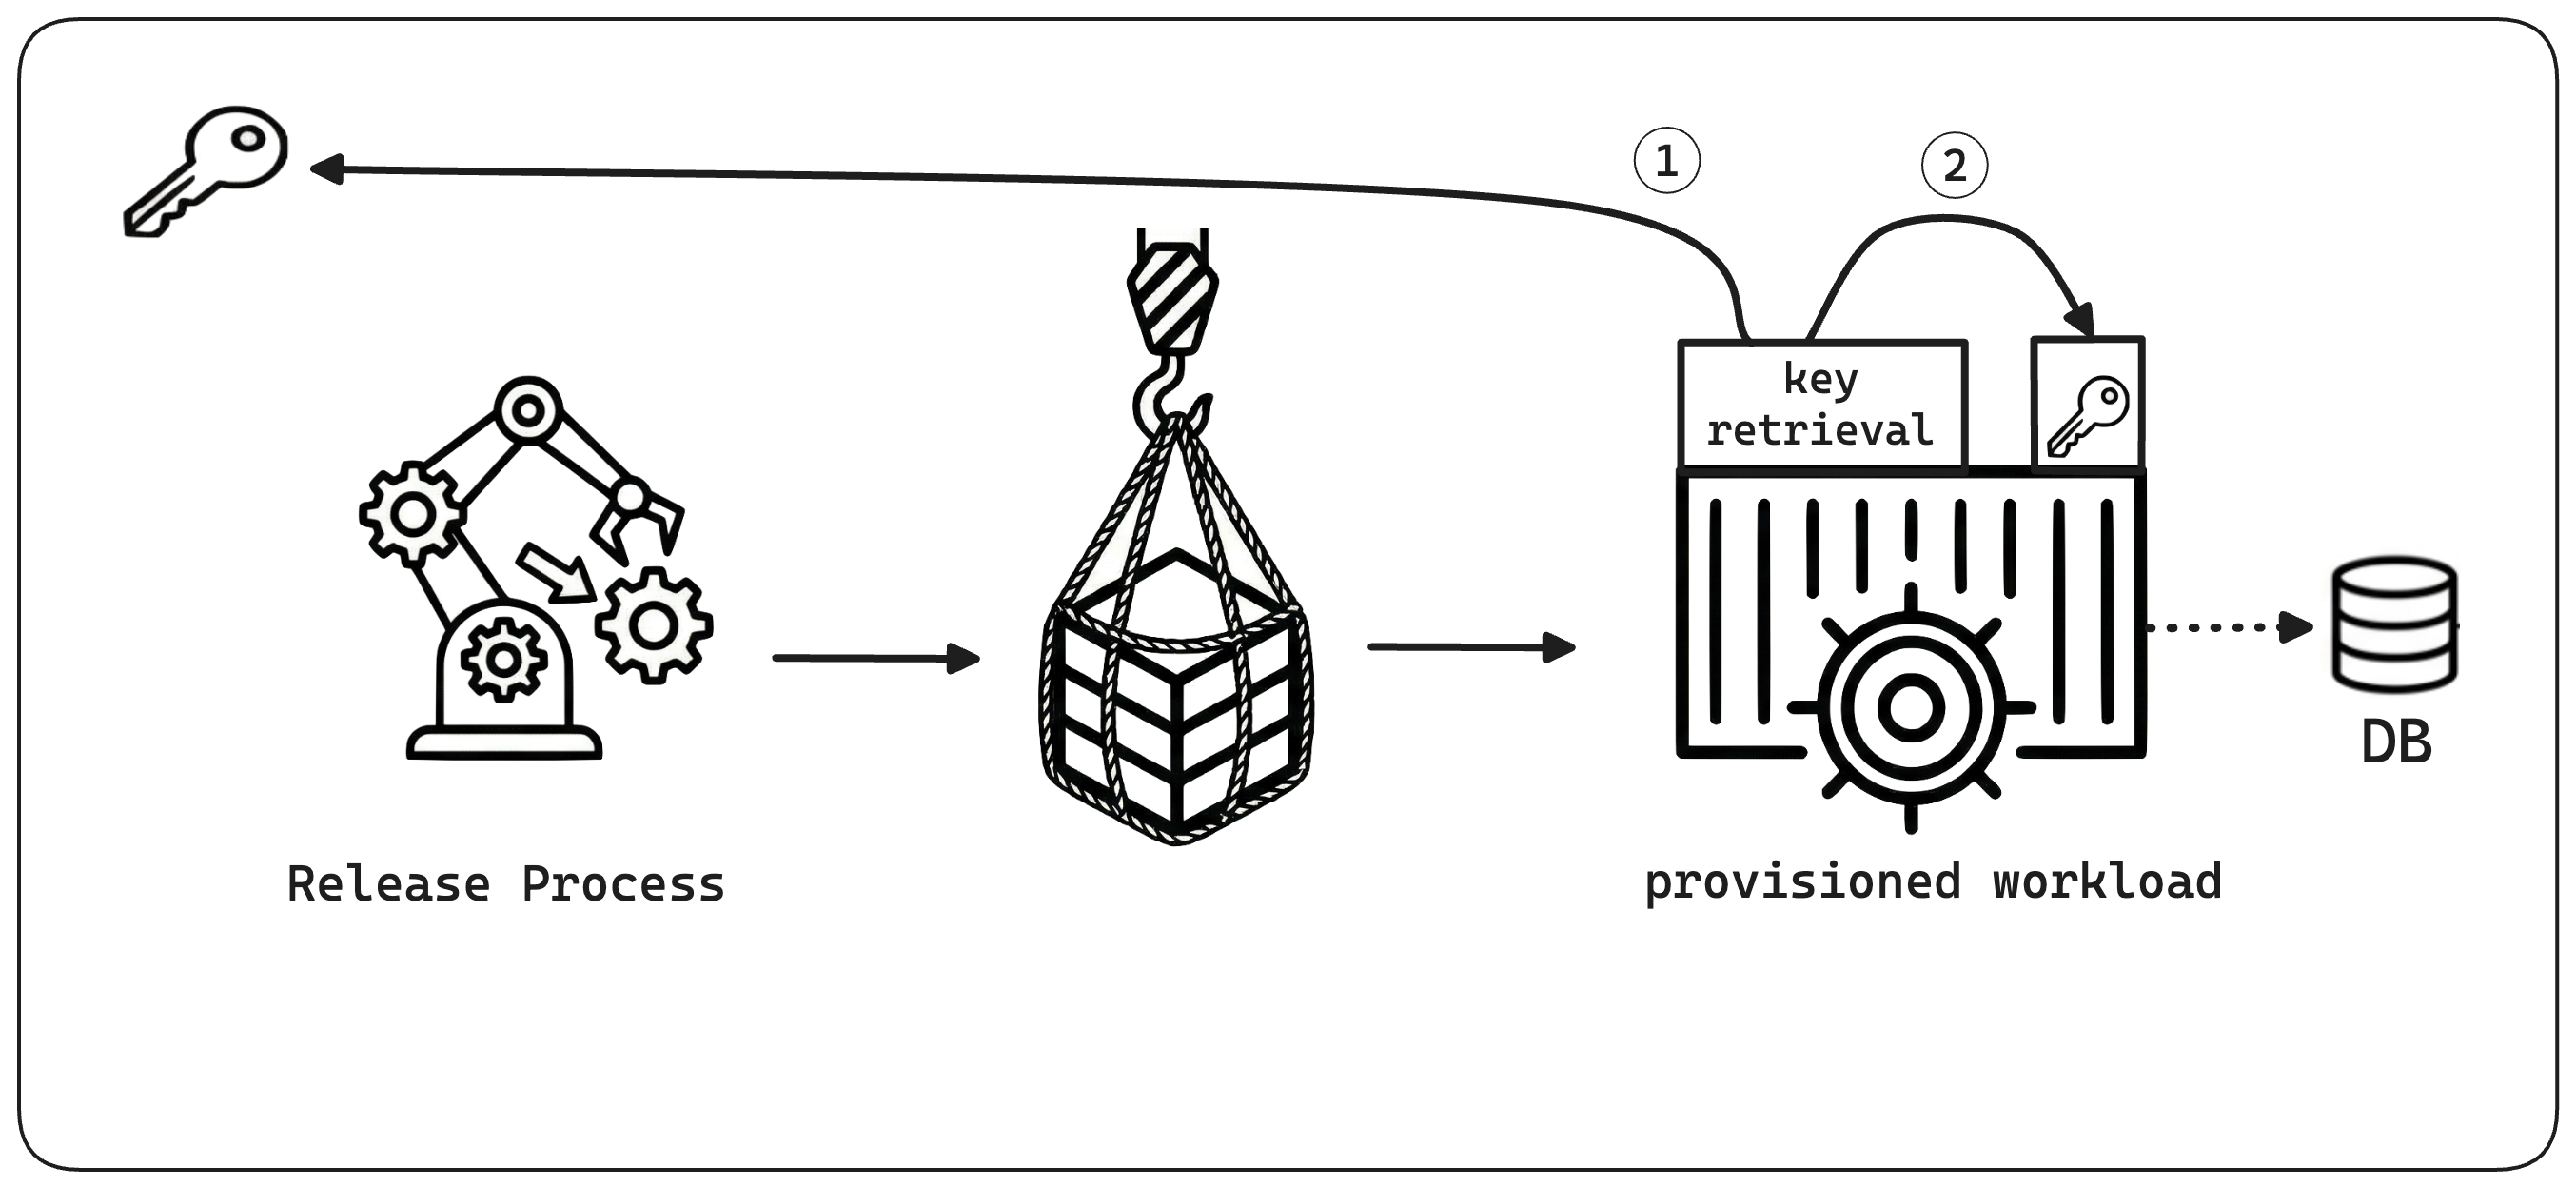
Un pipeline de release ne doit pas jouer le rôle de convoyeur d’identifiants applicatifs. Cela expose une autorité sensible au système de livraison et couple la rotation des secrets au déploiement. Les workloads doivent obtenir eux-mêmes leur accès à l’exécution, directement, en utilisant si possible une workload identity.
Unifiez l’accès, pas le stockage
La configuration statique, l’état dynamique et les secrets peuvent exiger des modèles de stockage et de sécurité différents. Les consommateurs ne devraient pas avoir à s’intégrer séparément à chaque backend qui les fournit. Une plateforme peut offrir des modèles d’accès cohérents tout en préservant la sémantique de stockage, de sécurité et de cycle de vie propre à chaque type.
GitOps
GitOps stocke l’état désiré déclaratif dans Git et utilise des contrôleurs pour réconcilier en continu cette intention avec l’environnement d’exécution.
Git stocke des artefacts d’état désiré
GitOps traite la configuration déclarative comme un artefact versionné : manifestes, valeurs Helm, définitions d’infrastructure ou autres fichiers décrivant l’état désiré d’un environnement. Ces artefacts peuvent référencer des artefacts de build immuables stockés ailleurs, comme une image de conteneur par digest. L’intention de déploiement reste ainsi versionnée et auditable, sans faire de Git l’emplacement de stockage des sorties de build exécutables.
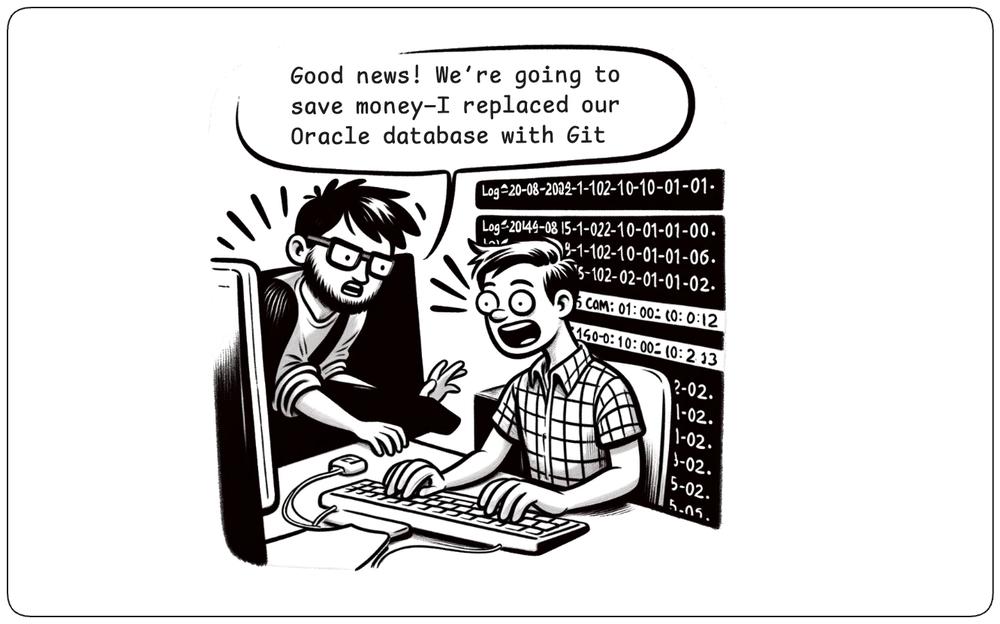
Limites de GitOps
Git convient bien à l’état déclaratif qui évolue par commits relisibles, mais ce n’est pas une base de données opérationnelle généraliste. Les données d’exécution qui changent souvent, la télémétrie de déploiement, les inventaires ou l’historique opérationnel riche en requêtes appartiennent à des systèmes conçus pour ces modes d’accès. Quand l’automatisation réécrit sans cesse un état transitoire dans Git ou crée de grandes quantités de pull requests mécaniques, on peut se demander si GitOps n’est pas poussé au-delà de son rôle prévu.
Changement sûr
Le changement sûr est la discipline qui consiste à introduire du changement tout en maîtrisant son incertitude. L’objectif n’est pas d’éliminer le risque, mais de limiter l’exposition, de détecter rapidement les problèmes et de préserver un chemin de retour sûr.
Aucun changement n’est sans risque
Chaque changement introduit de l’incertitude. Aussi petit, familier ou bien testé qu’il paraisse, son impact réel ne peut pas être entièrement prédit avant qu’il atteigne l’environnement où il s’exécutera. Une mise à jour de configuration, un changement de dépendance, une modification DNS ou une nouvelle version peut interagir de façon inattendue avec le système existant.
Identifier ce qui peut mal tourner
Une gestion efficace du risque commence par identifier précisément ce qui peut mal tourner. En livraison logicielle, chaque changement introduit par nature de l’incertitude. Avant de parler d’outils ou de pratiques, il faut définir clairement les risques que l’on cherche à atténuer. Fondamentalement, ils se répartissent en deux catégories : les échecs de déploiement, qui laissent le système dans un état dégradé, et les échecs applicatifs, où le code se déploie correctement mais où la fonctionnalité est défectueuse. Les pratiques de changement sûr existent pour traiter les deux — préserver la stabilité du système quand les déploiements échouent, et limiter le « rayon d’impact » quand l’application rate sa cible.
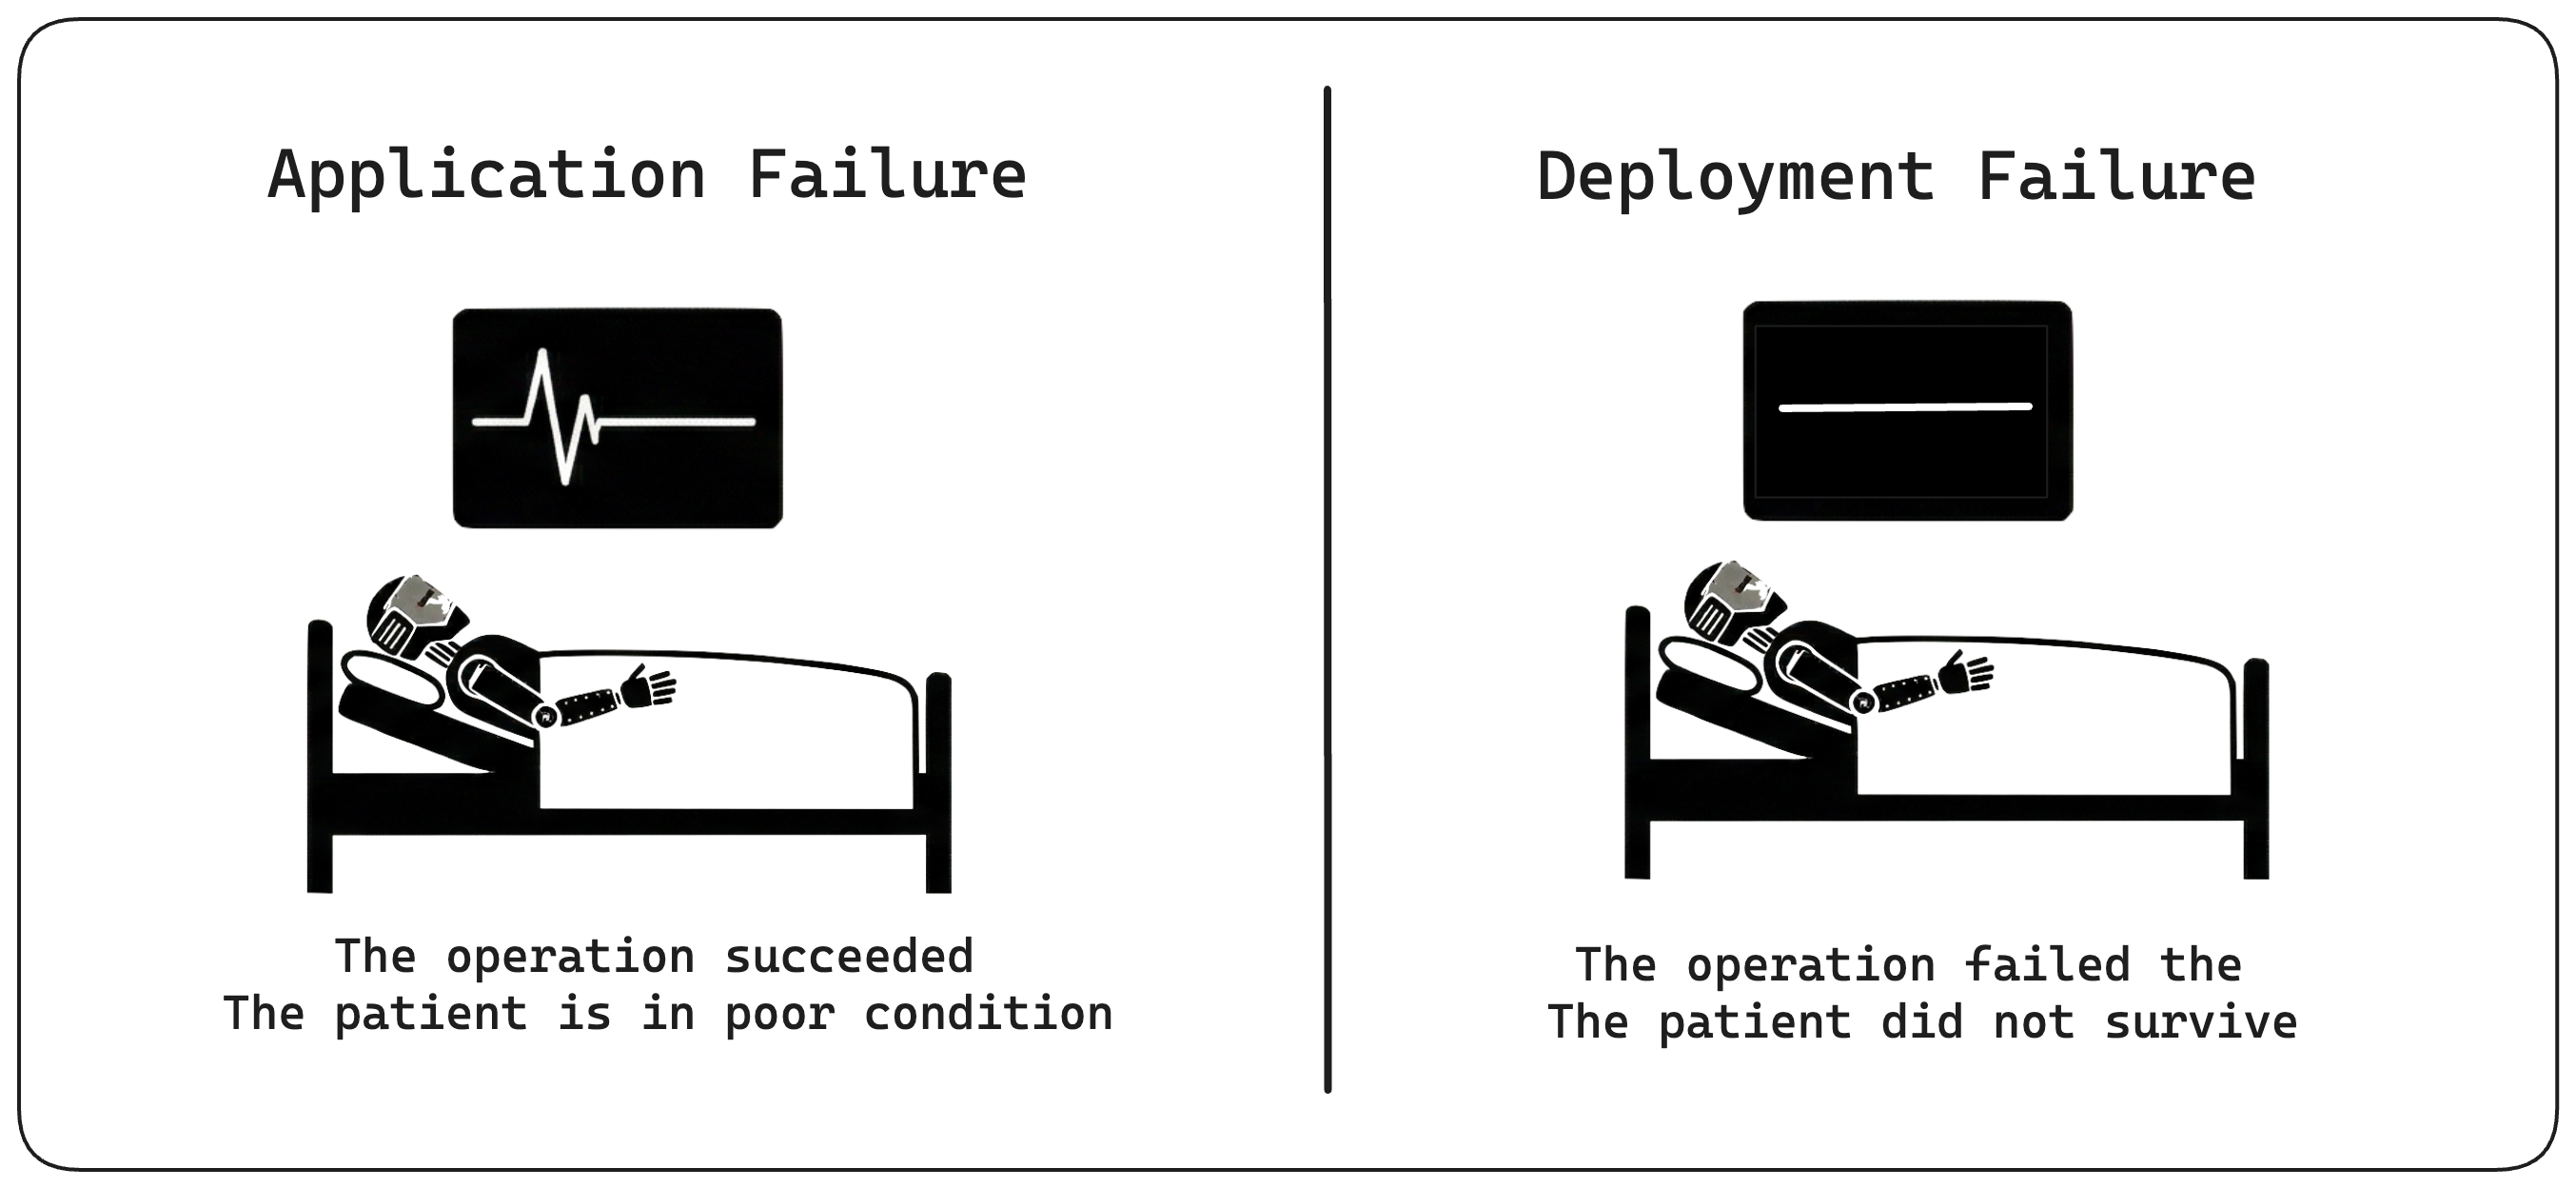
Note : Cette section traite principalement des problèmes d’échec applicatif. Les problèmes liés à l’échec de déploiement sont abordés dans la section « Échecs de déploiement et reprise ».
Gérer le risque par des principes universels
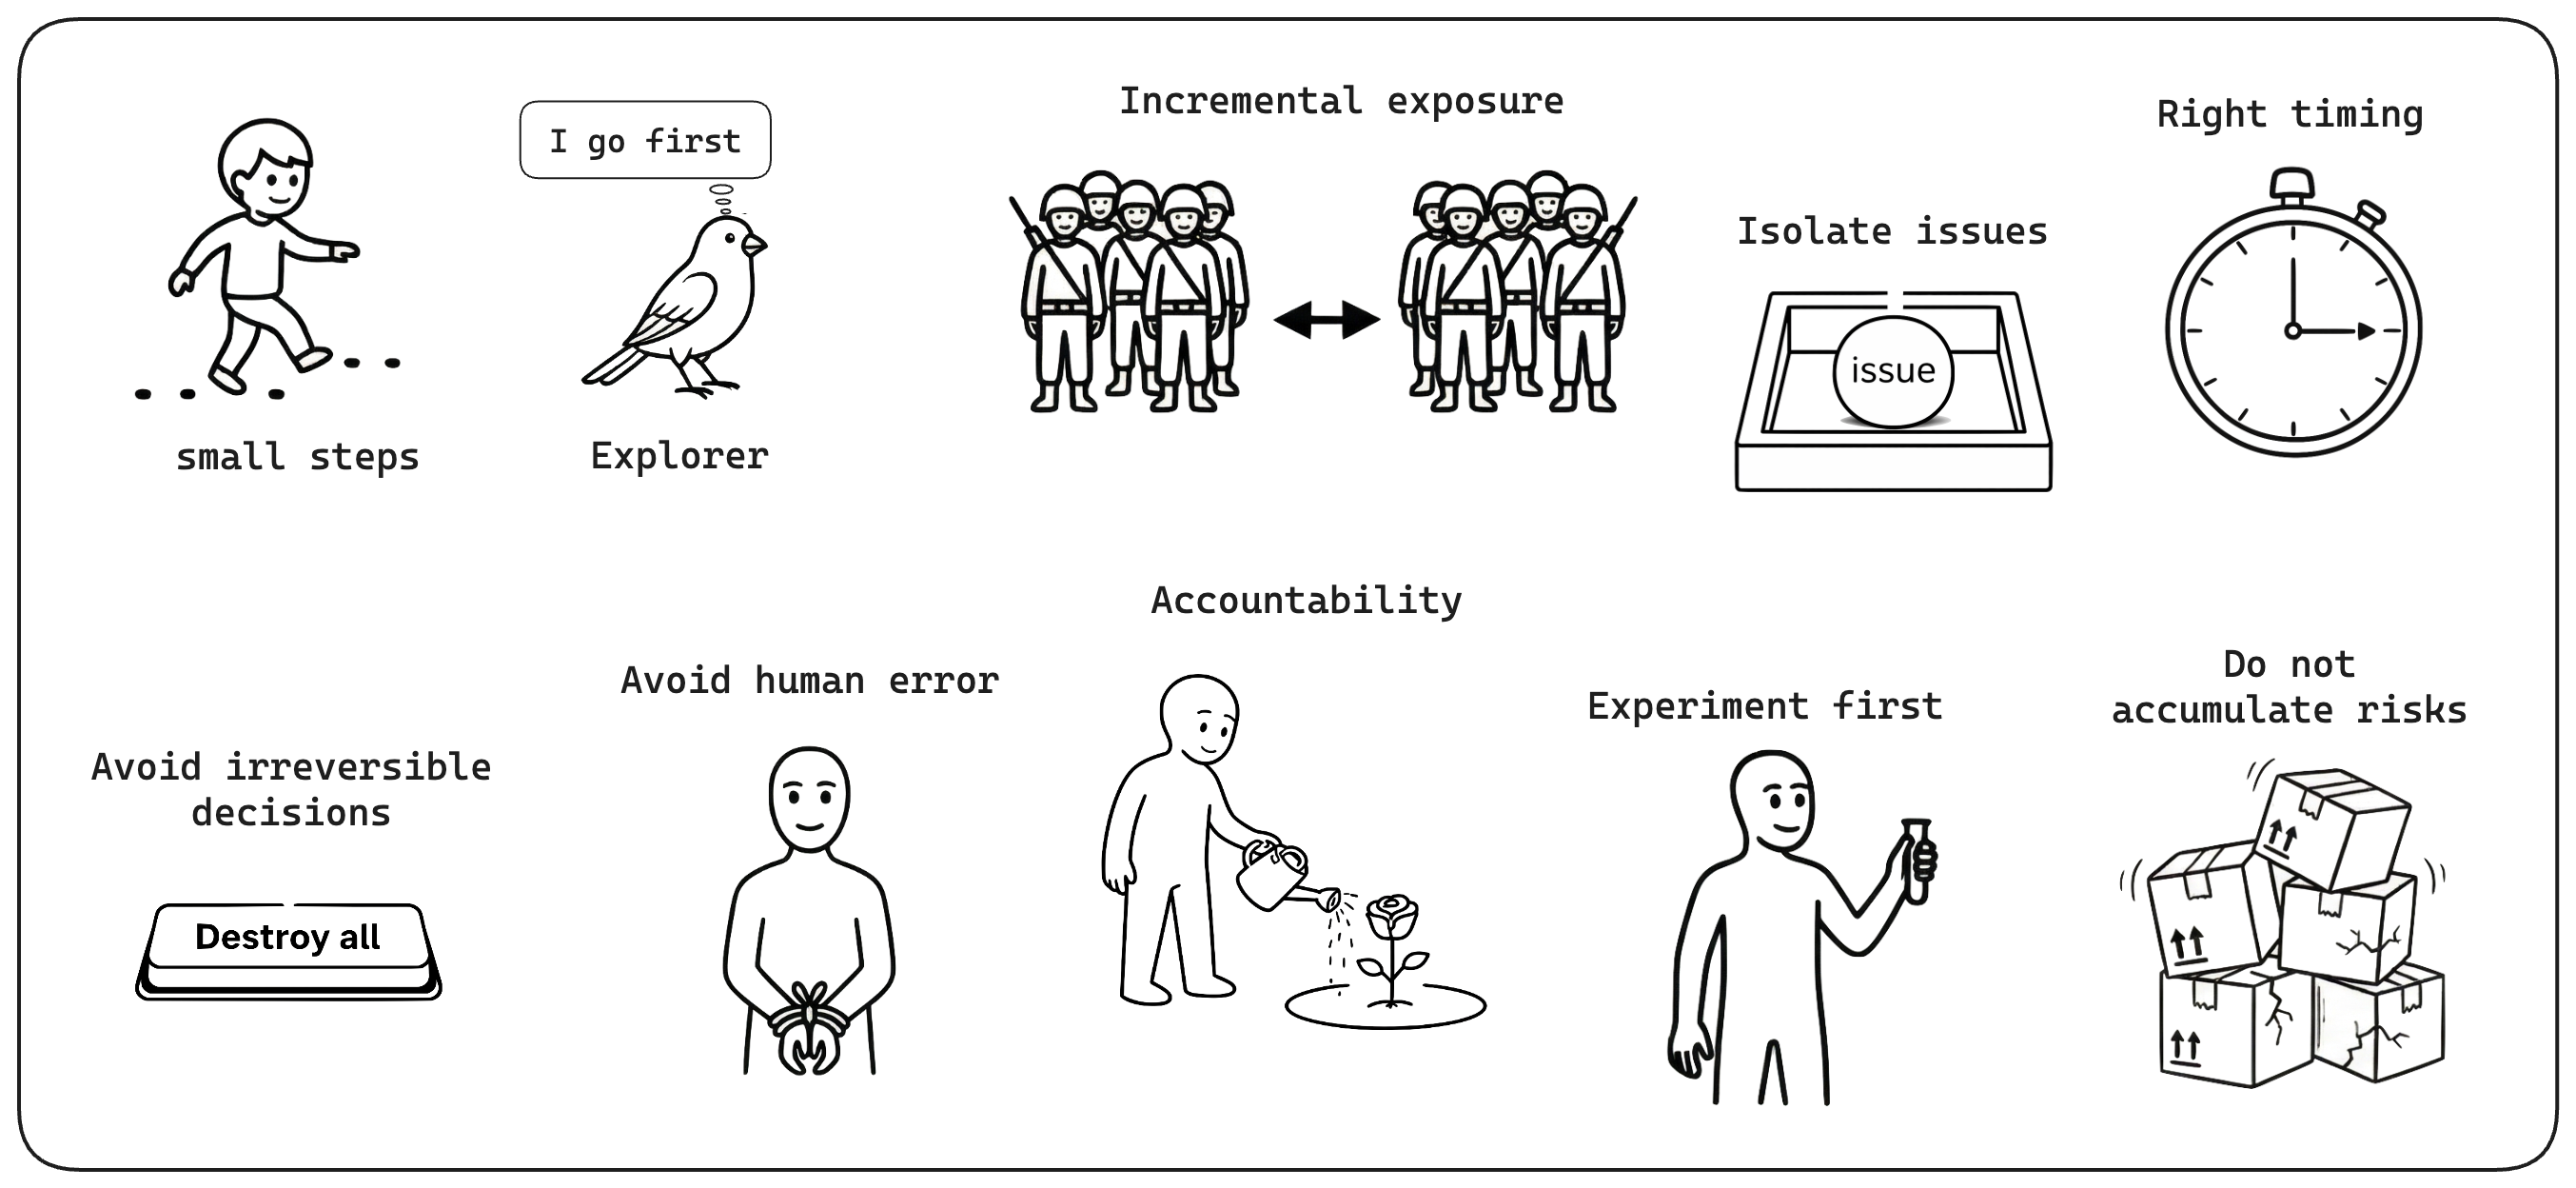
Le changement sûr maîtrise l’incertitude grâce à un petit ensemble de principes récurrents : faire de petits changements, expérimenter en sécurité, limiter l’exposition, automatiser l’exécution, maintenir une propriété claire, observer le résultat et préserver la réversibilité. Ces principes couvrent à la fois le comportement défectueux de l’application et les défaillances du mécanisme utilisé pour établir le nouvel état.
Des releases sûres exigent des endroits sûrs pour expérimenter
L’expérimentation est essentielle, mais elle ne doit pas se faire sur le chemin vers la production. Les développeurs ont besoin d’espaces isolés où explorer librement des idées incertaines, des intégrations et des changements risqués sans contaminer le flux de release. Un système de release sûr garde l’expérimentation rapide et flexible tout en garantissant que seuls des changements contrôlés et validés entrent dans le chemin de production.
La sécurité est dans la préparation, pas dans le changement
Un changement n’est pas sûr simplement parce que son code semble correct ou que ses tests passent. La sécurité vient de la préparation à l’échec : détecter rapidement les problèmes, savoir qui doit réagir, limiter leur impact et maintenir un chemin de reprise testé. L’objectif n’est pas de prouver que rien n’échouera, mais d’être prêt quand quelque chose échoue.
Une propriété claire : le prérequis des changements sûrs
Chaque changement a besoin d’un propriétaire identifiable qui comprend son intention et son impact potentiel. Ce propriétaire suit la release, surveille son résultat et a l’autorité de l’arrêter ou de l’annuler si nécessaire. La propriété doit être établie avant le début du changement — pas découverte pendant un incident.
Automatisez le chemin vers la production
Les opérations de release répétées doivent être déterministes et automatisées. L’exécution manuelle introduit de la variabilité, des hypothèses implicites et des résultats incohérents d’un environnement à l’autre. L’automatisation rend le chemin vers la production répétable, auditable et applicable.
De petites releases incrémentales
Les petits changements réduisent l’incertitude et le rayon d’impact. Ils sont plus faciles à comprendre, valider, observer et annuler, et quand quelque chose tourne mal, il y a moins de causes possibles à investiguer.
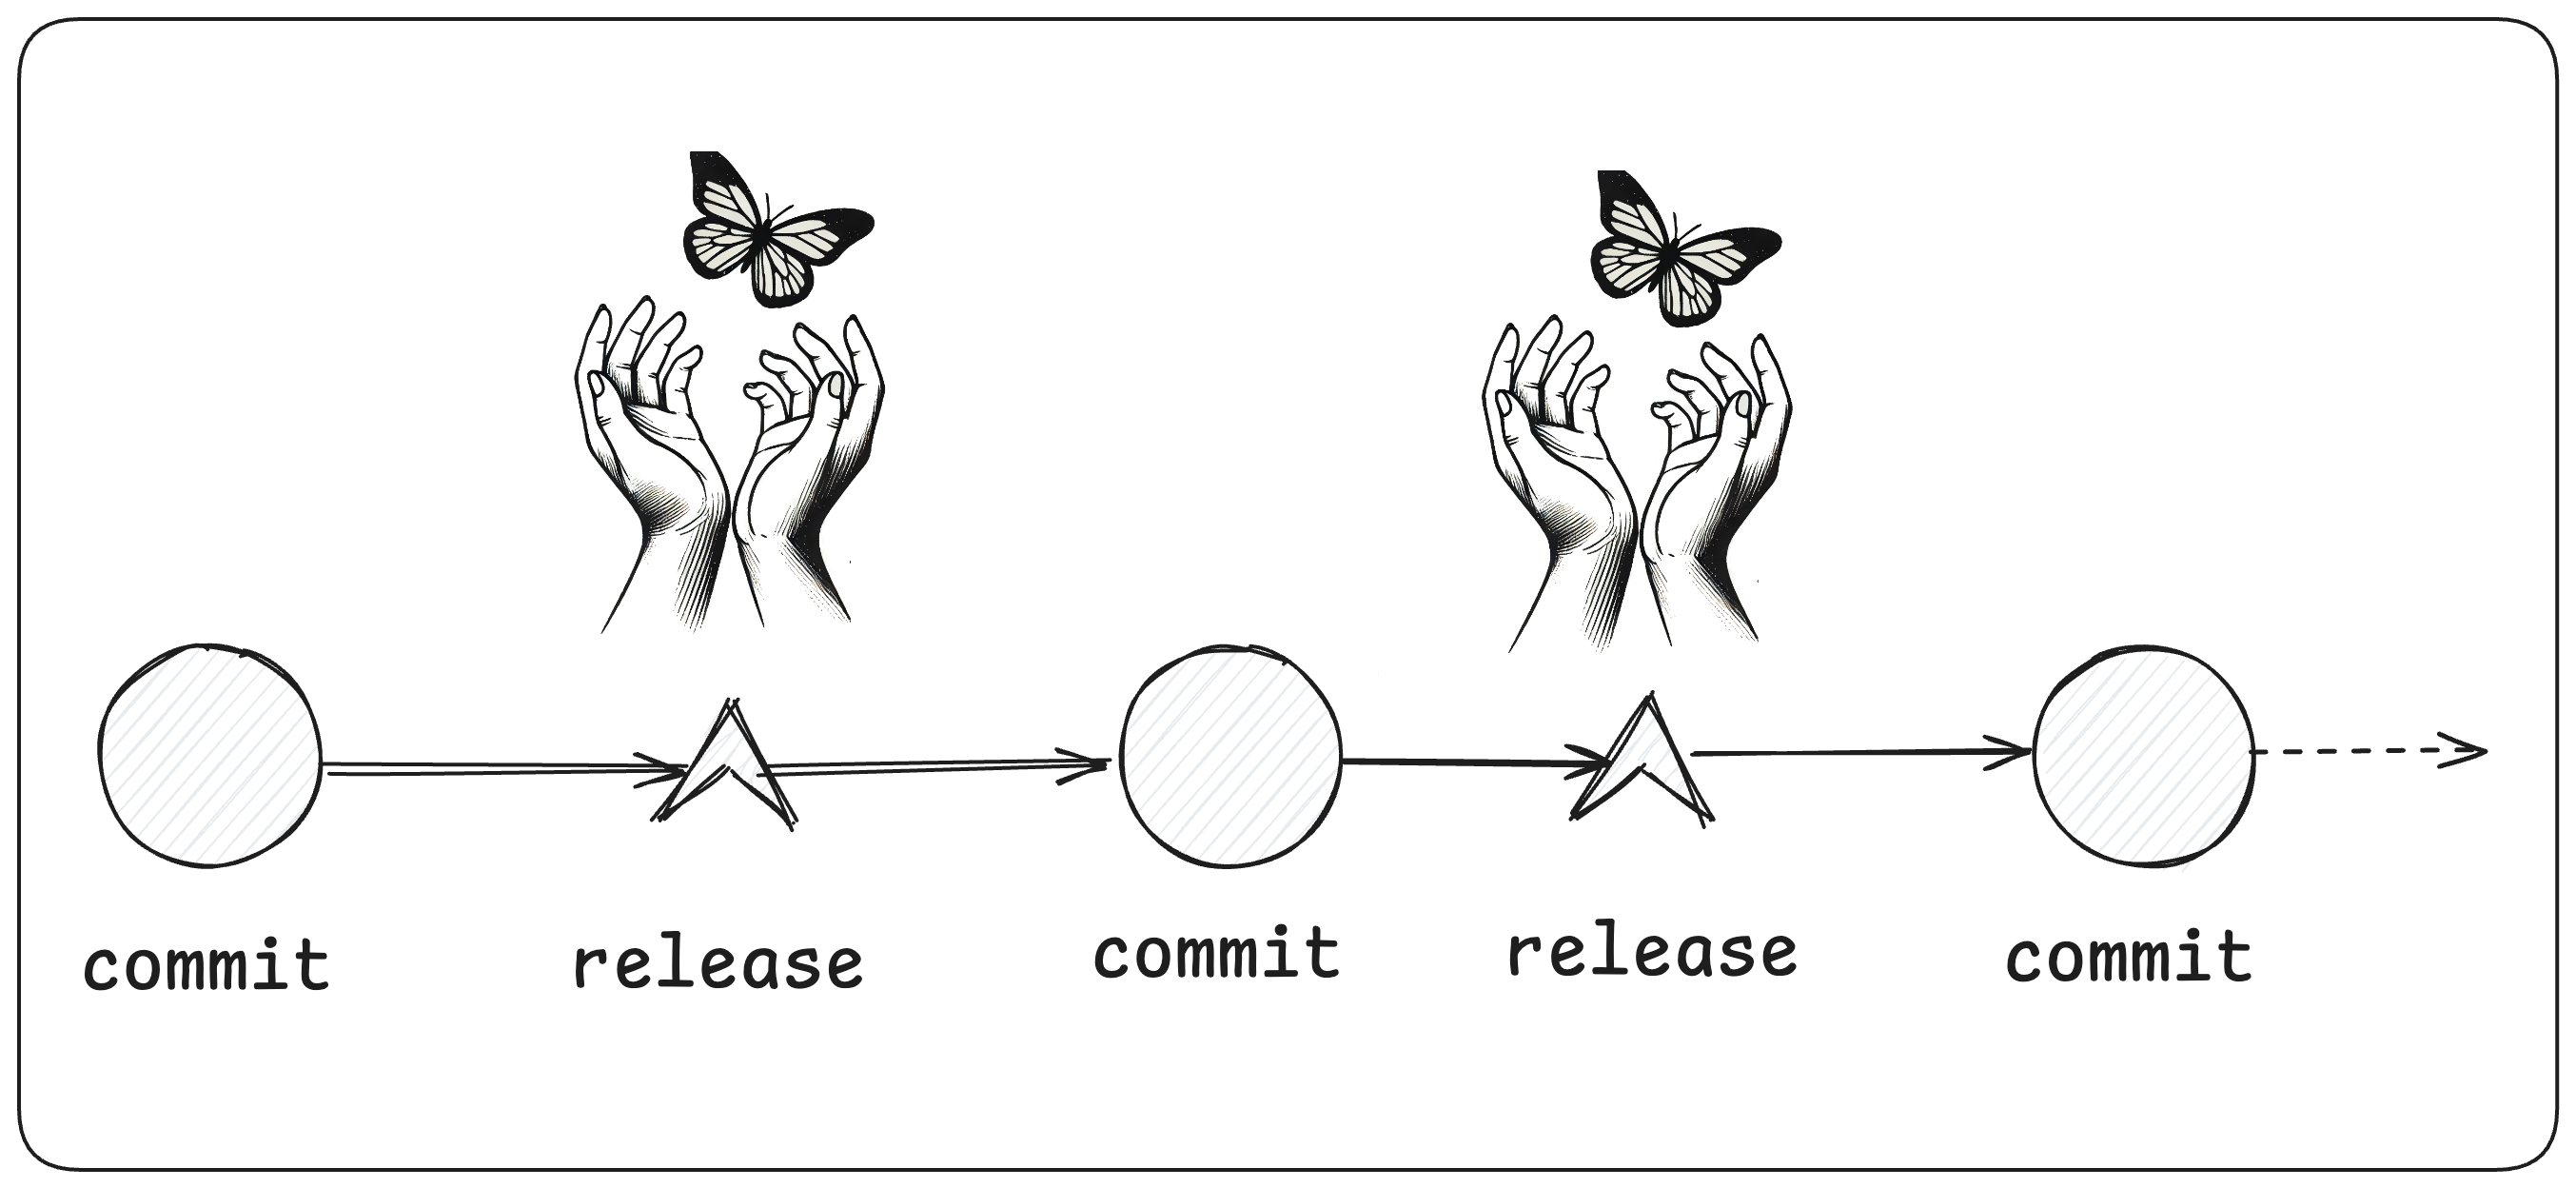
Livrez souvent pour apprendre plus vite
Des releases fréquentes raccourcissent la distance entre un changement et un vrai retour. Les petits incréments atteignent les utilisateurs plus tôt, les problèmes sont plus faciles à isoler, et les équipes peuvent ajuster avant que de gros lots d’hypothèses ne s’accumulent. Le but n’est pas la fréquence de release pour elle-même, mais un cycle plus court de changement, de preuve et d’apprentissage.
Portez le changement jusqu’en production
Un changement n’est pas terminé quand il est mergé, mais quand il a atteint tous les environnements de production visés et fonctionne comme prévu. Quand une validation manuelle reste nécessaire, le développeur qui a introduit le changement doit le suivre jusqu’au bout. Sinon, les changements inachevés s’accumulent et les releases suivantes héritent d’un risque qui ne les concerne pas.
Exposition progressive
Maintenir la parité avec la production
Gardez les environnements hors production assez proches de la production pour que la validation en amont reste significative. Configuration, dépendances, forme des données, mécanismes de déploiement et comportement opérationnel ne devraient différer que là où c’est nécessaire. Plus l’écart est grand, plus le risque est reporté jusqu’à la production.
Les limites de la parité avec la production
Une parité parfaite avec la production n’est ni pratique ni économique. L’échelle, l’infrastructure, la confidentialité des données, le trafic réel et le comportement réel des utilisateurs diffèrent inévitablement des environnements hors production. Certaines défaillances restent donc invisibles jusqu’à ce qu’un changement rencontre des conditions qui n’existent qu’en production.
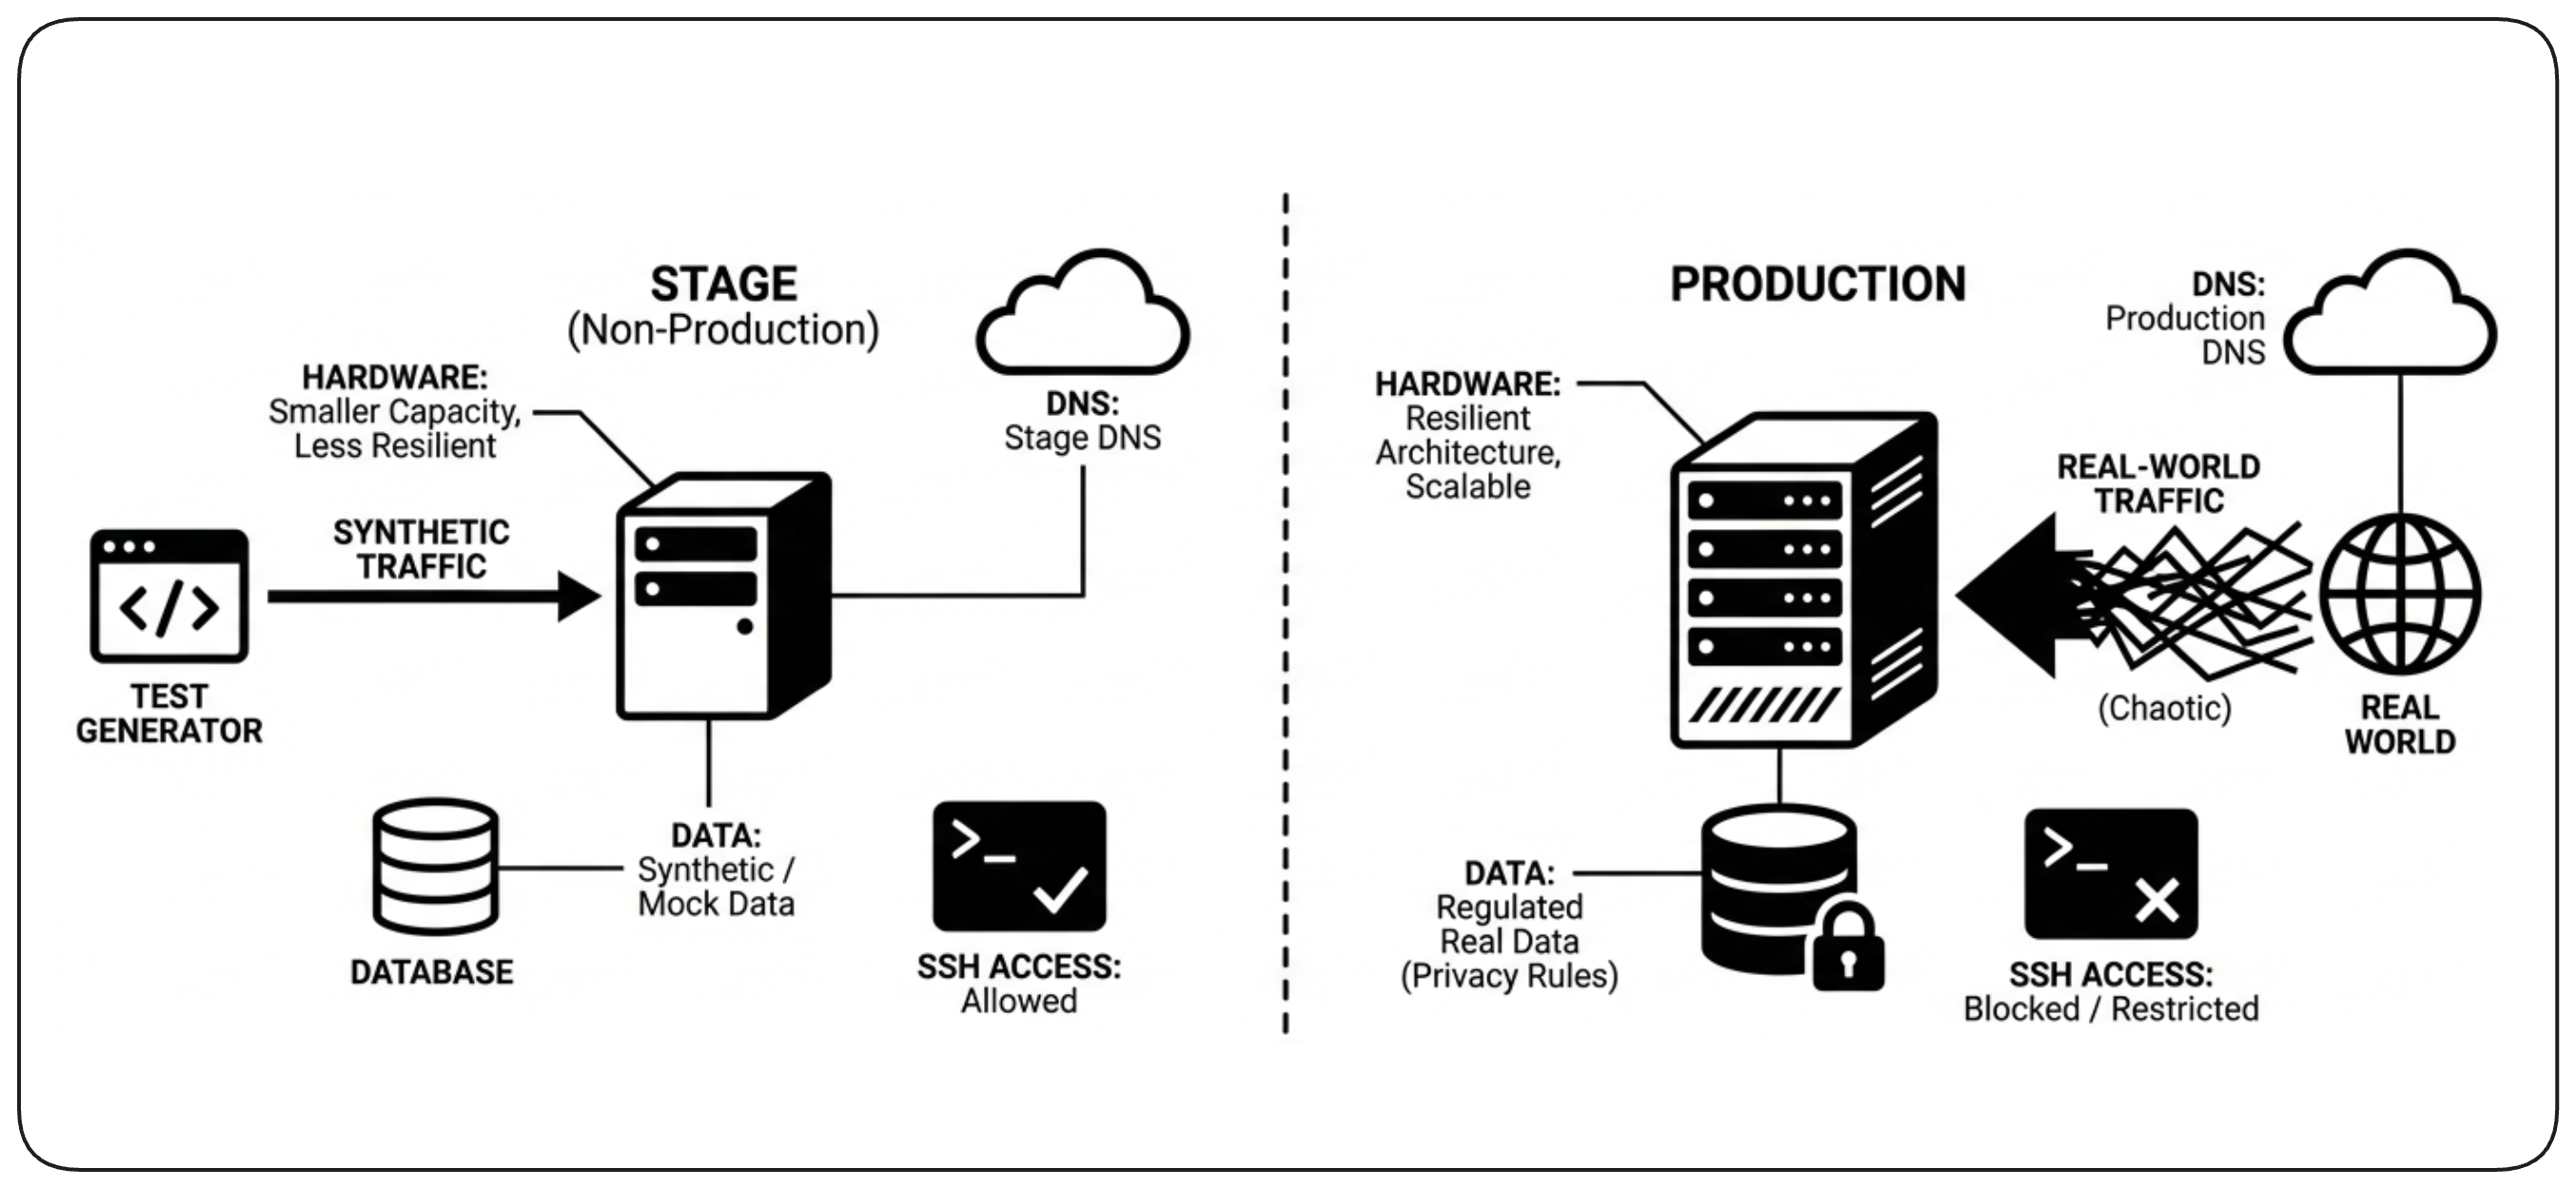
Certaines preuves ne peuvent venir que de la production
Certaines propriétés ne peuvent pas être entièrement validées hors production, car elles dépendent du trafic réel, de l’échelle, du timing et des interactions de données. Quand la production est le seul environnement crédible, l’exposition doit être volontairement restreinte et étroitement observée, pour que l’incertitude devienne une preuve maîtrisée plutôt qu’un risque incontrôlé.
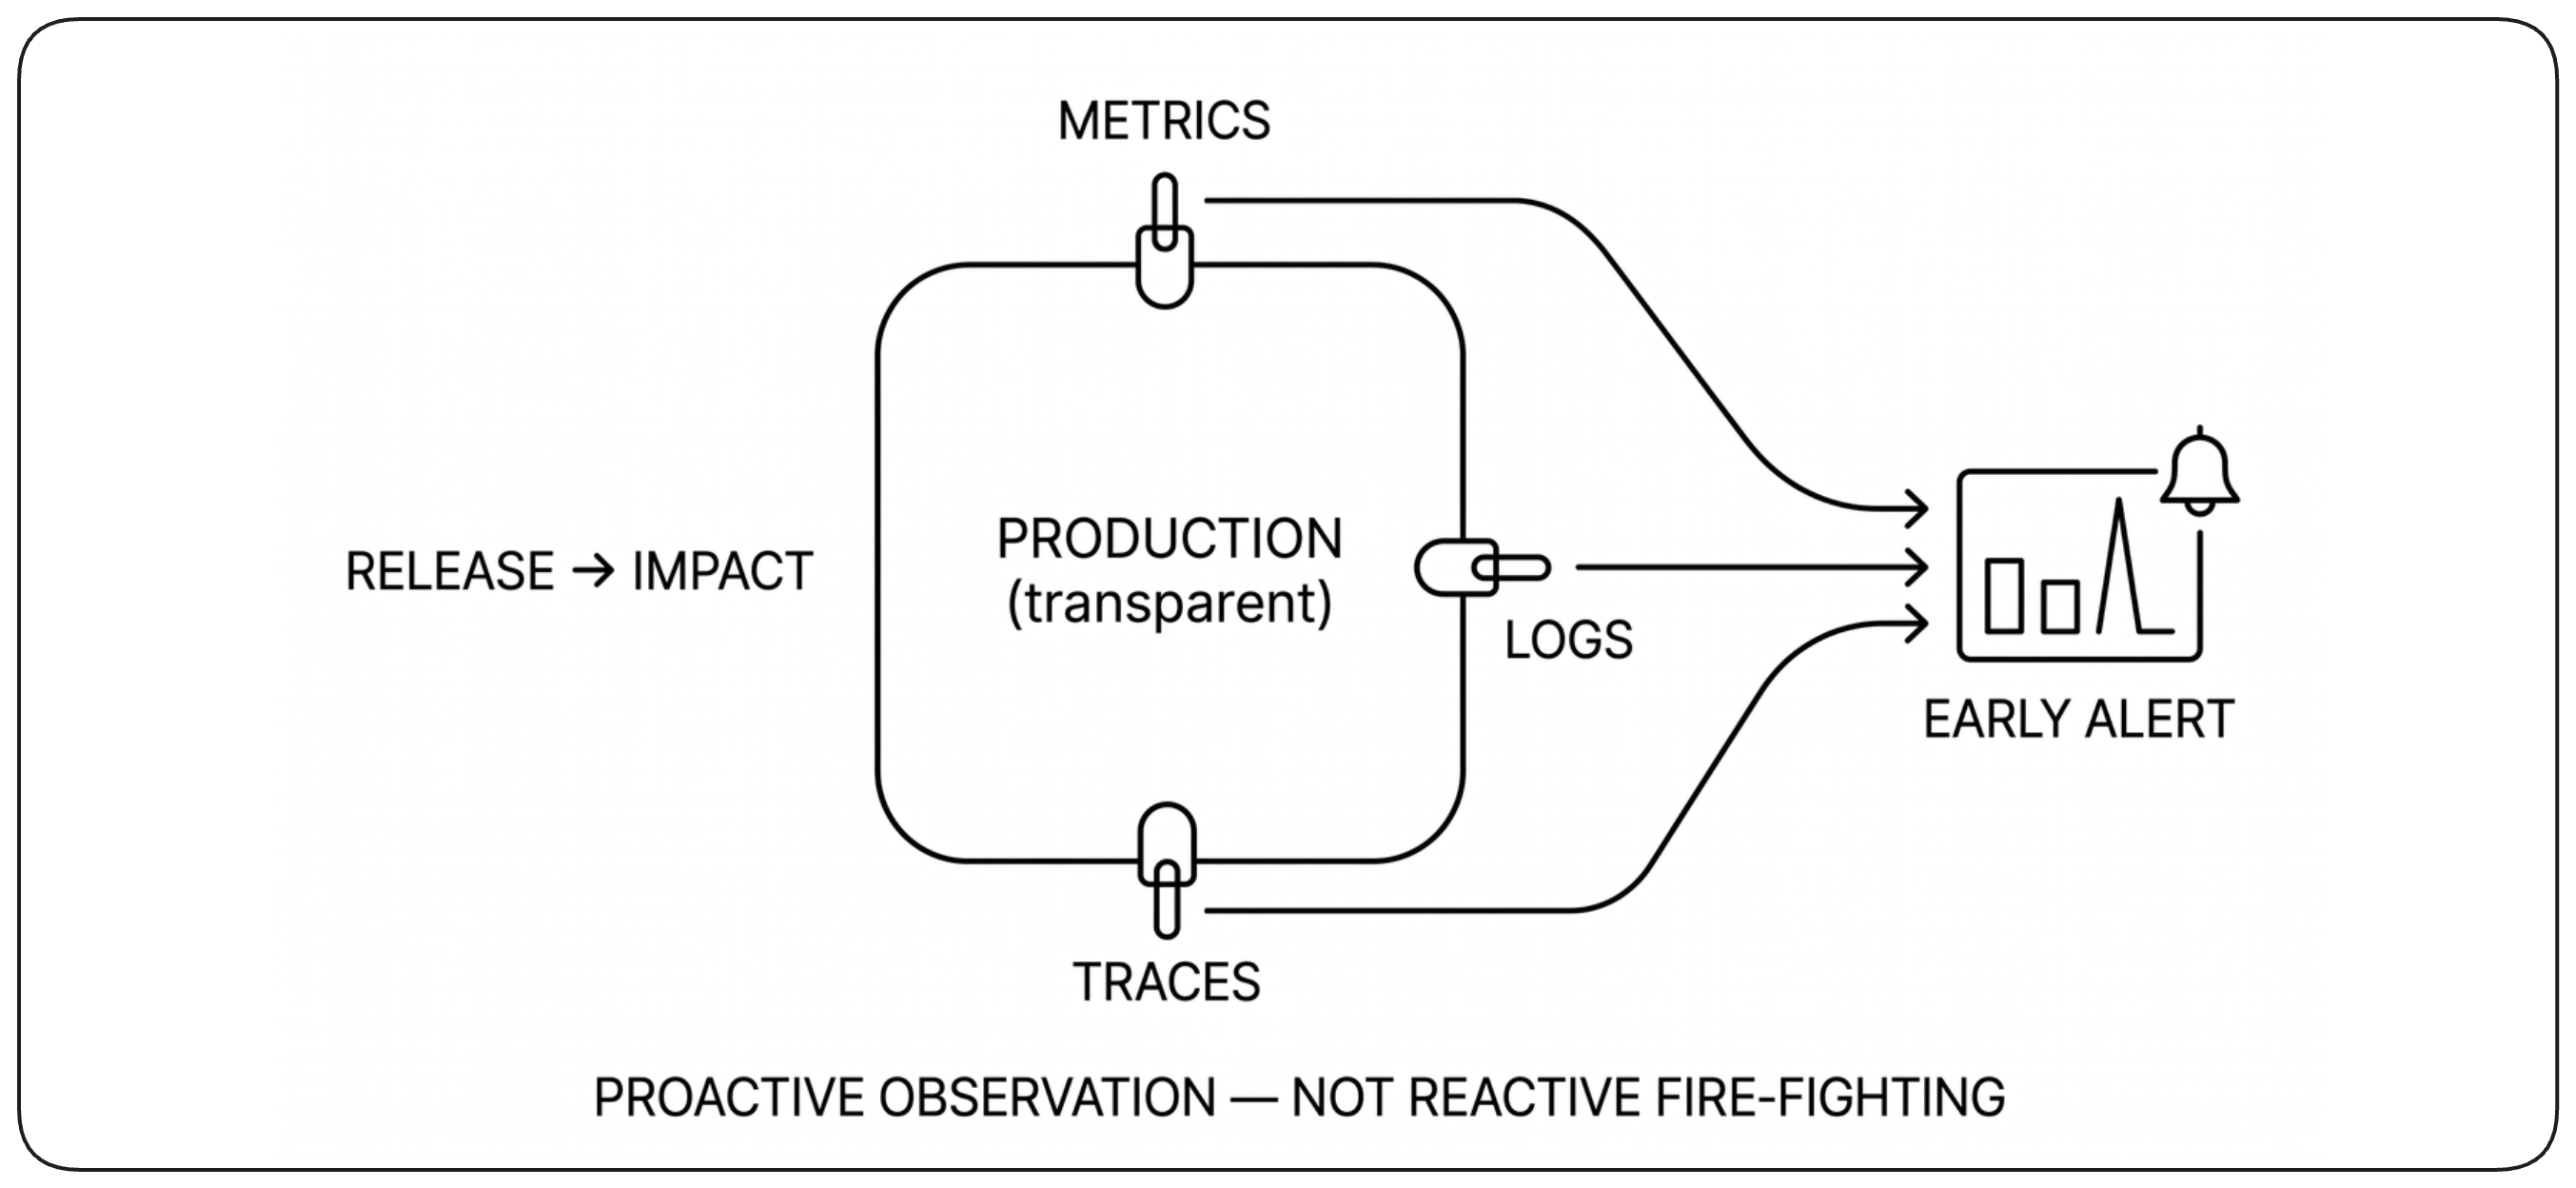
Monitoring continu
Une fois qu’un changement atteint la production, l’observation fait partie de la décision de release. Métriques, logs, traces et alertes révèlent si le nouvel état se comporte comme prévu et fournissent les preuves nécessaires pour poursuivre l’exposition ou annuler. Sans visibilité, la livraison progressive n’est qu’un risque progressif.
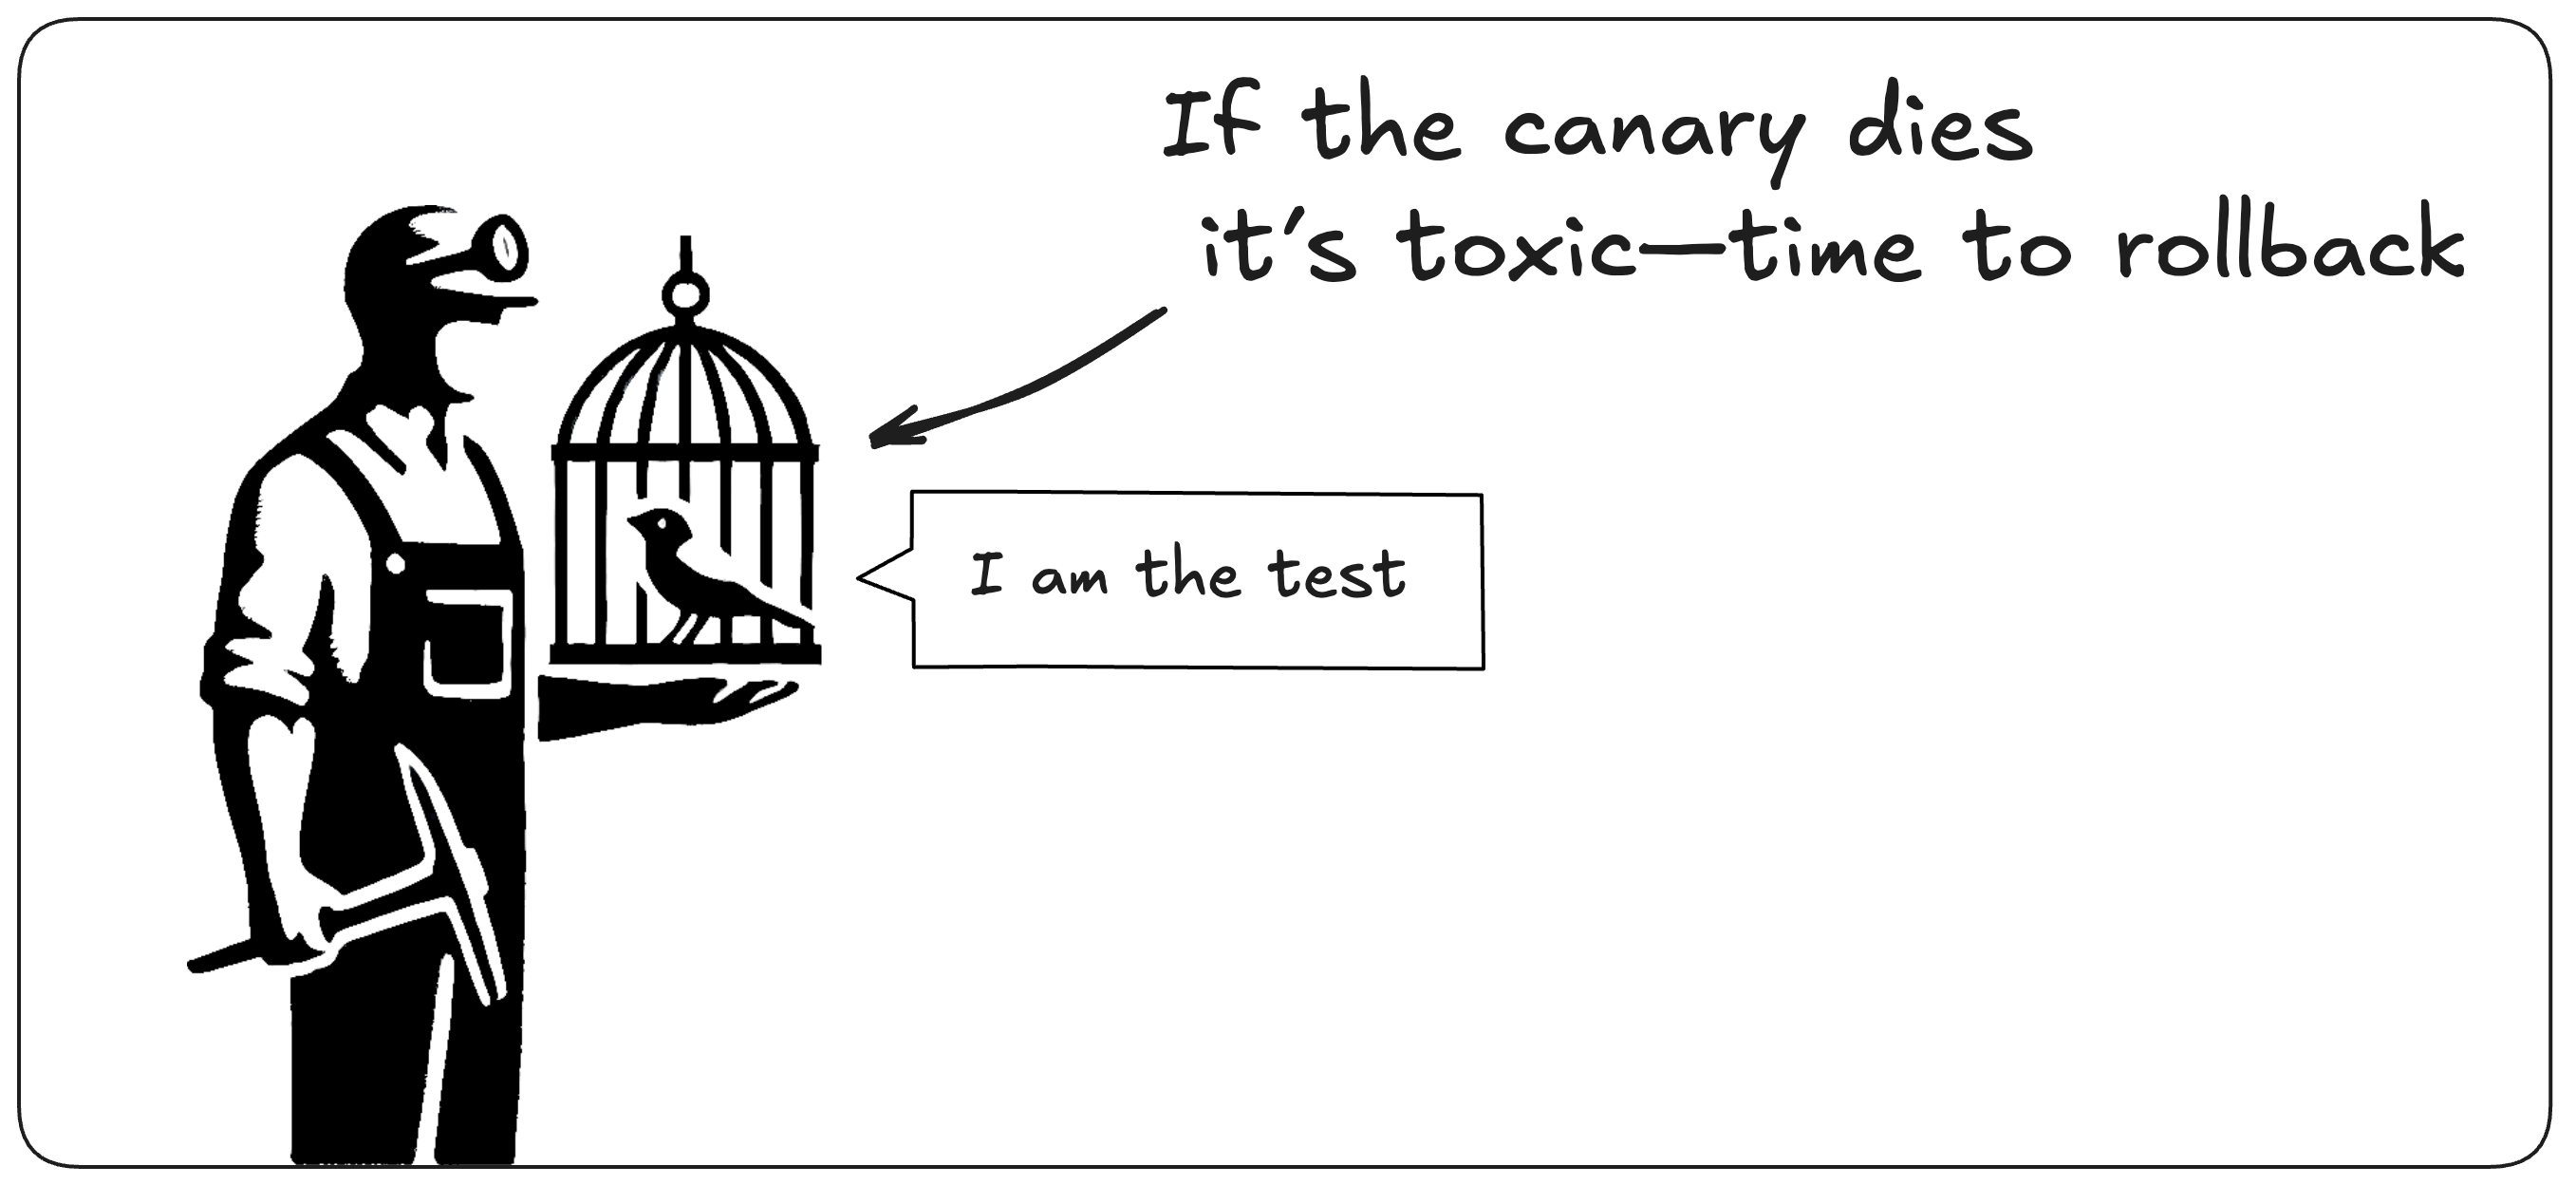
Limiter l’exposition initiale avec un canary
Le déploiement canary limite le rayon d’impact en n’exposant une nouvelle version qu’à une petite fraction du trafic réel. Son comportement est observé avant que l’exposition ne s’étende. Si la santé se dégrade, le déploiement s’arrête ou est annulé tandis que la plupart des utilisateurs restent sur la version connue comme saine.
Étendre l’exposition graduellement
Après le succès du canary initial, l’exposition doit augmenter progressivement plutôt que sauter directement à 100 %. Chaque palier n’élargit le rayon d’impact qu’une fois que le précédent a produit assez de preuves. La segmentation peut suivre le trafic, la géographie, des groupes de clients, l’infrastructure ou toute frontière qui contient réellement le risque.
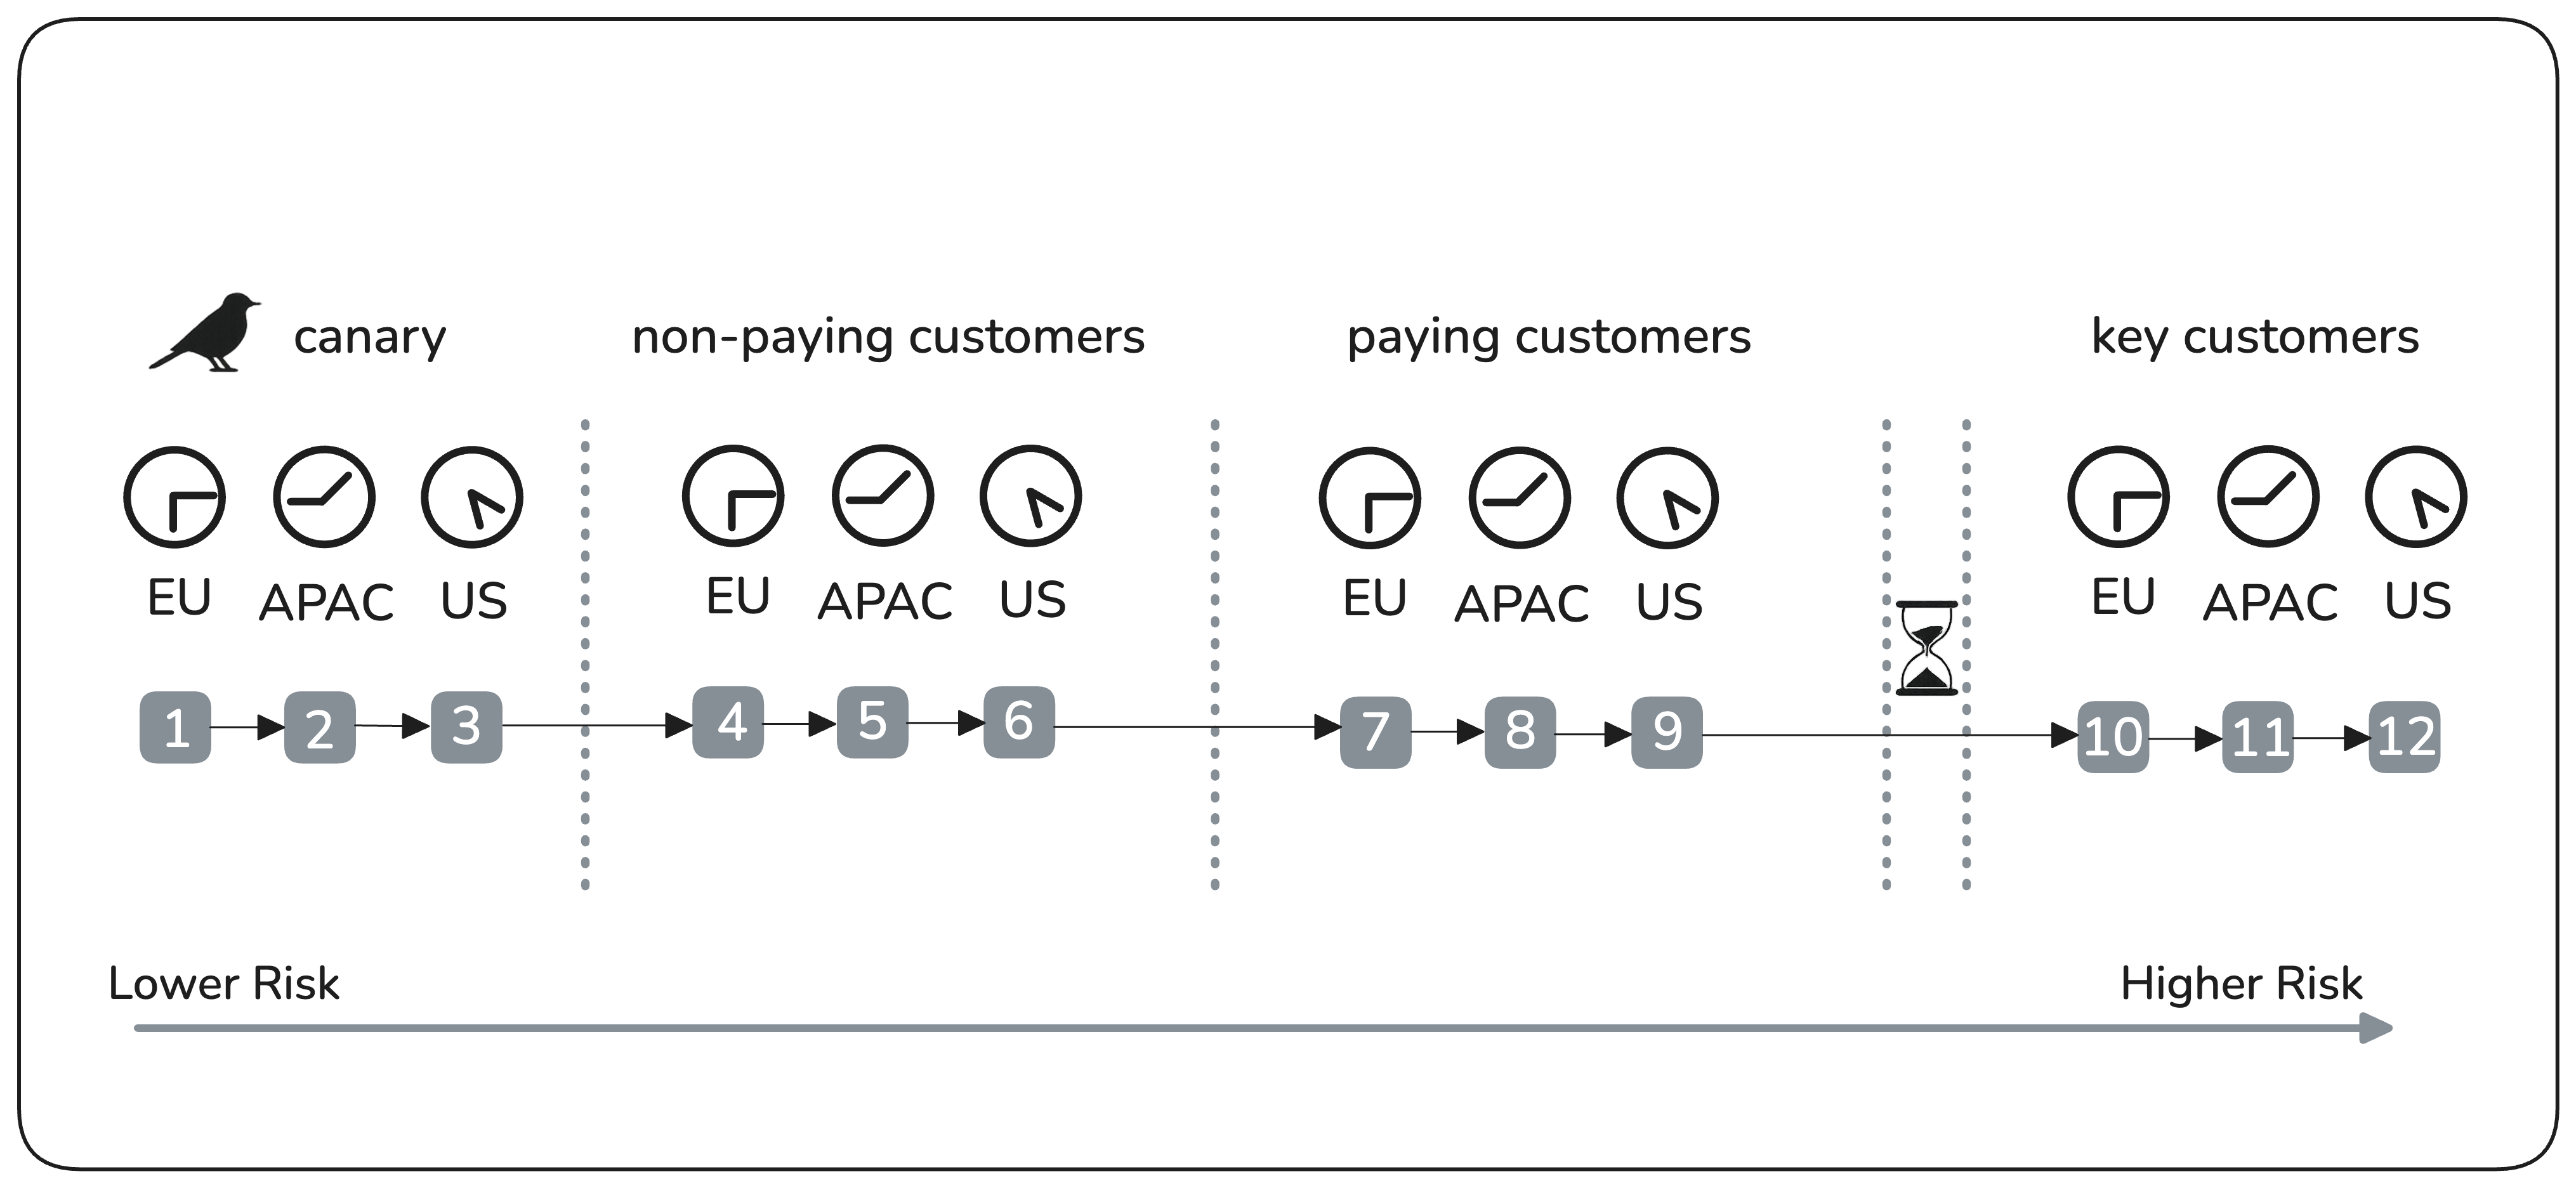
Le conflit entre déploiements graduels et releases à haute fréquence
Le rollout progressif réduit le risque en ralentissant l’exposition, alors que la livraison à haute fréquence dépend de la fluidité des changements. Un rollout long peut donc bloquer les changements suivants et les faire s’accumuler en lots plus gros. Un mécanisme de sécurité peut paradoxalement augmenter le risque si l’exposition et le déploiement ne peuvent pas progresser indépendamment.
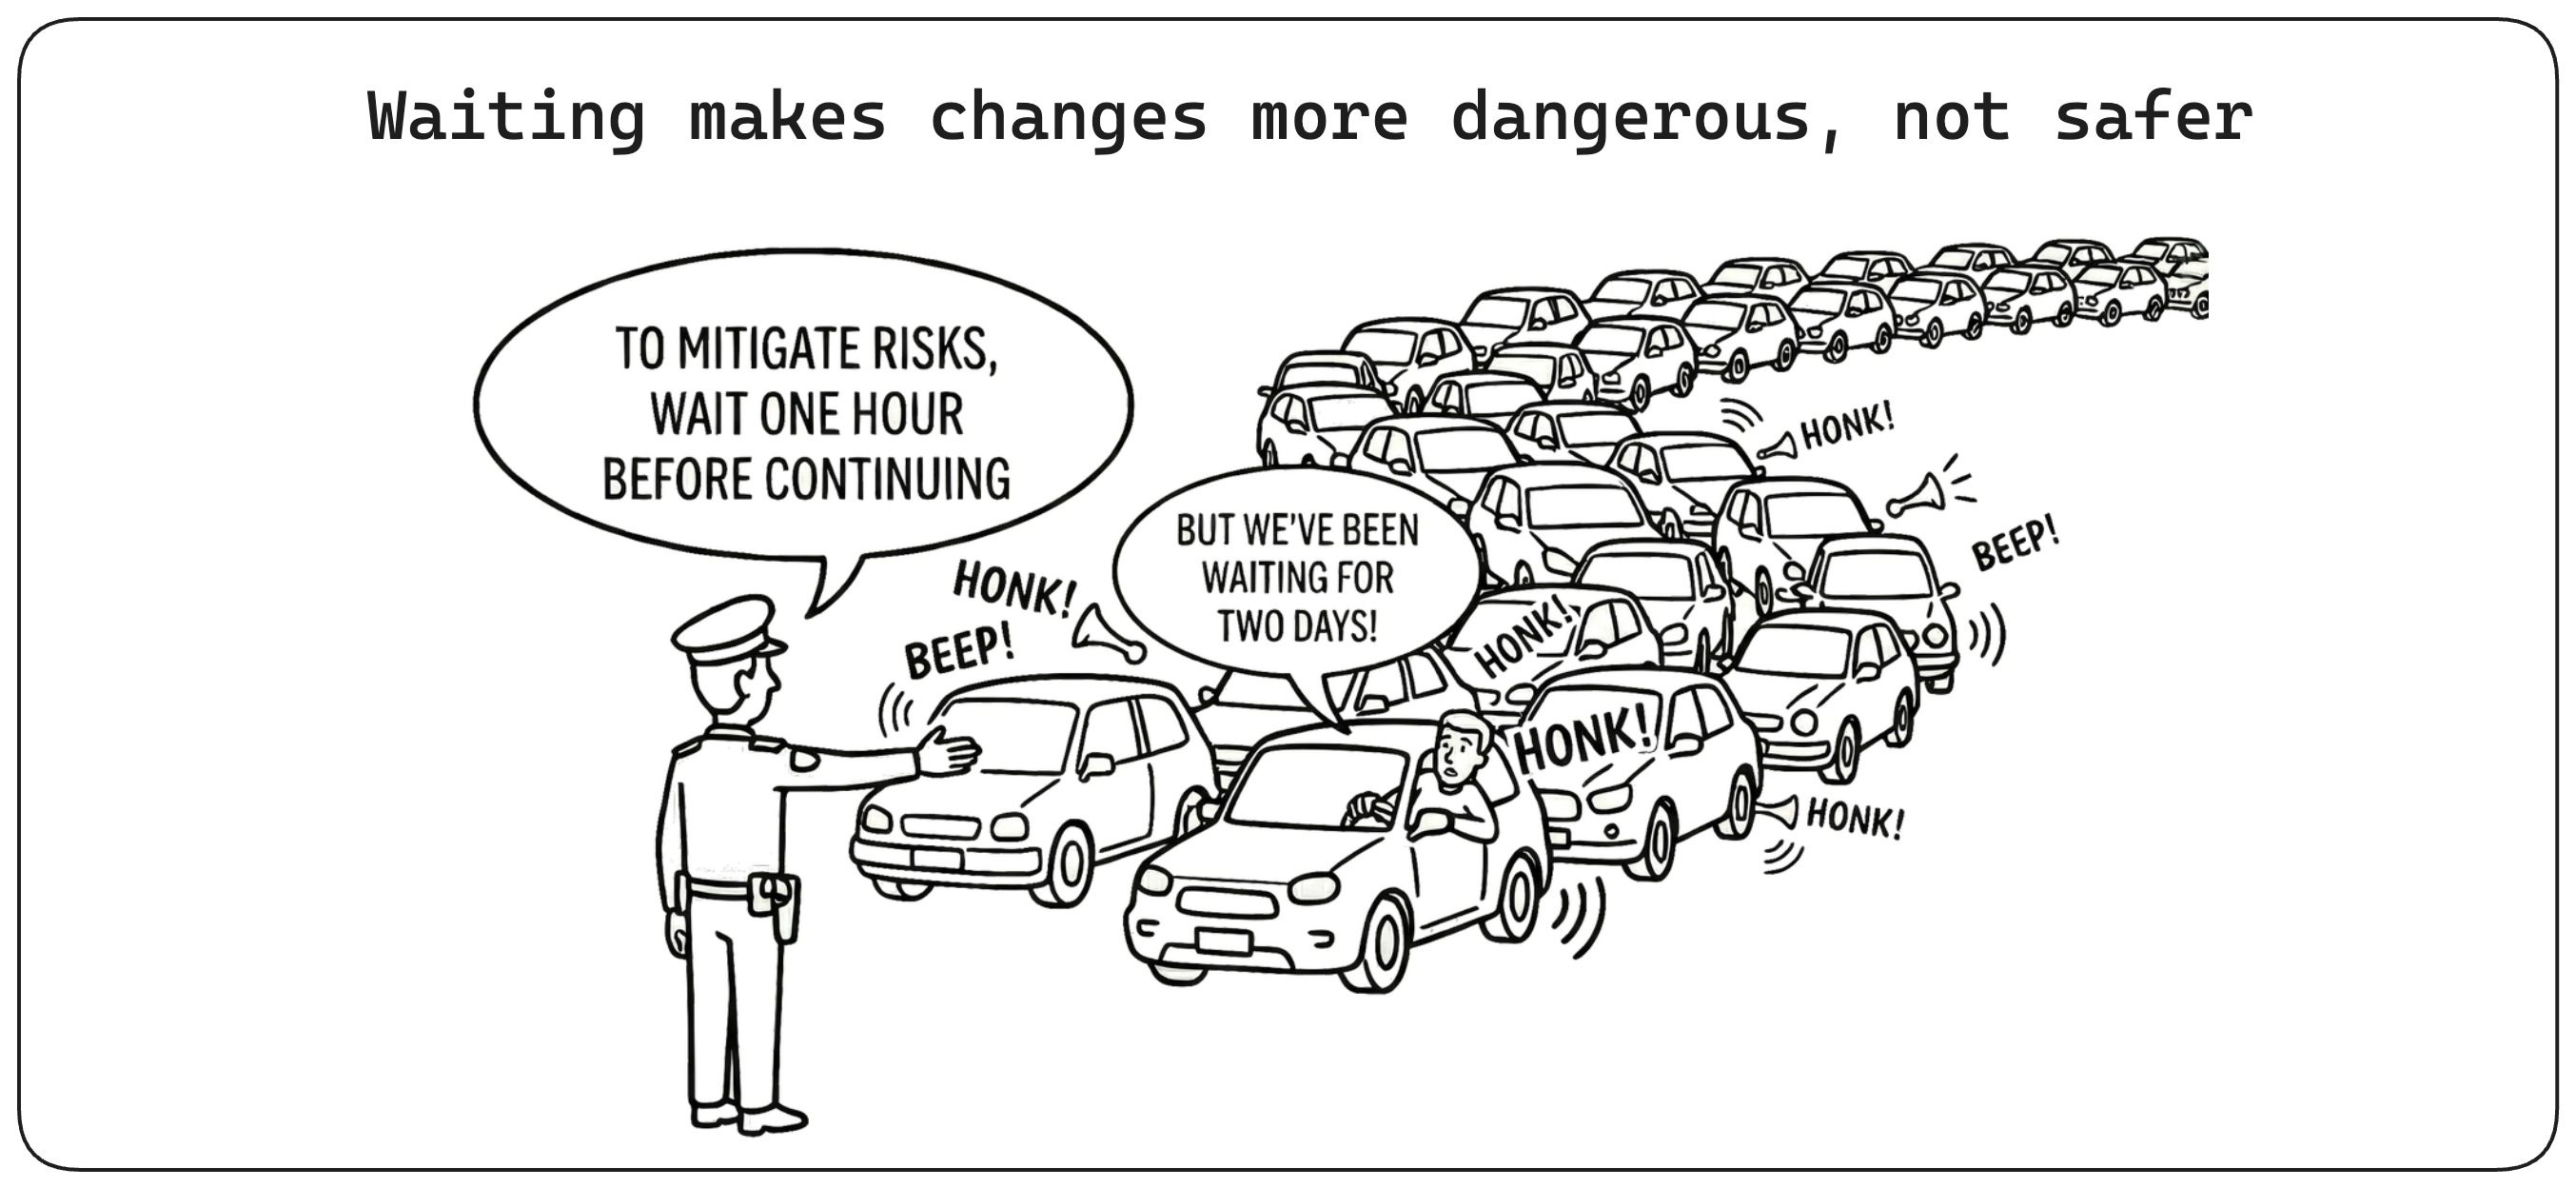
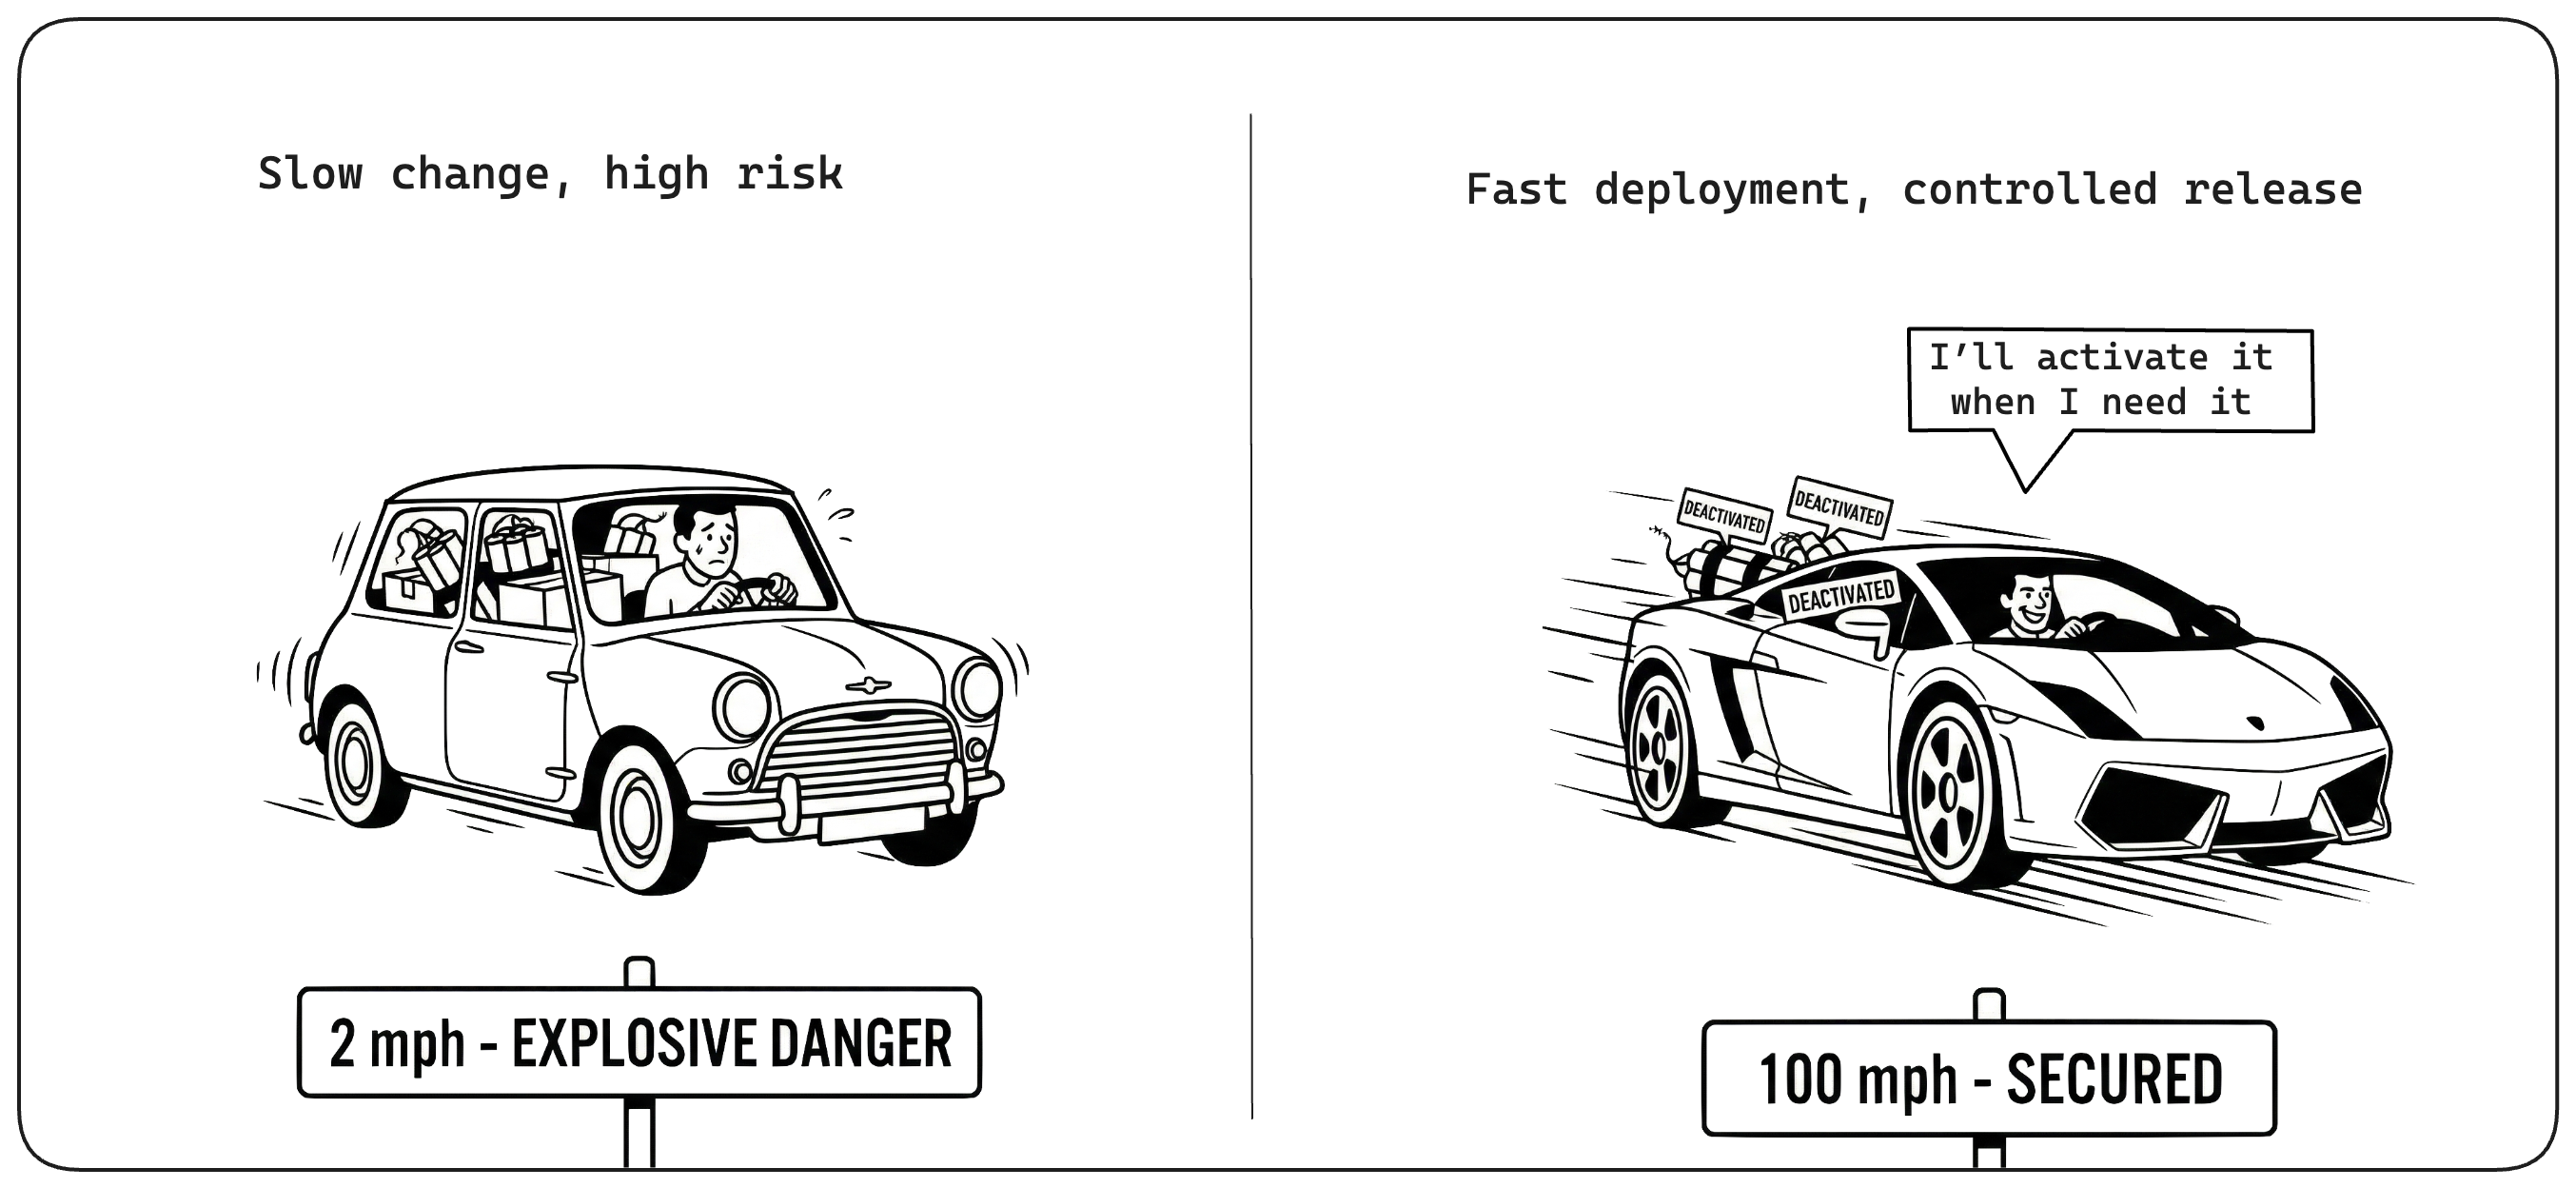
Découpler déploiement et release : les feature flags
Les feature flags séparent le déploiement de l’exposition aux utilisateurs lorsque le comportement peut être activé indépendamment. Le code peut être déployé largement alors que la nouvelle fonctionnalité reste dormante, puis exposé progressivement sans bloquer les déploiements suivants. L’infrastructure, les schémas, les protocoles et les migrations peuvent exiger d’autres techniques de compatibilité, car cette séparation n’est pas toujours possible.
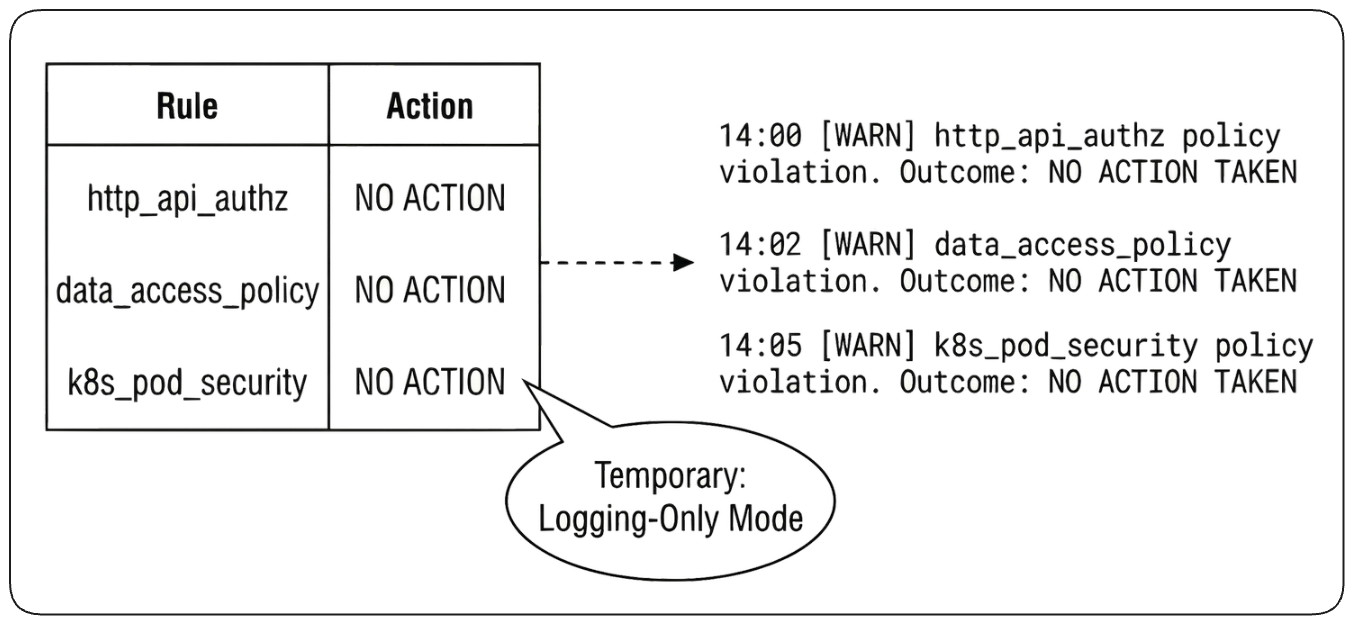
Observer avant d’activer : le mode logging seul
Une nouvelle logique peut parfois s’exécuter sur de vraies entrées de production sans affecter le résultat réel. Le système garde le comportement existant comme référence tout en enregistrant ce que le nouveau chemin aurait fait. Comparer les deux résultats révèle des cas limites et des différences de comportement avant l’activation, transformant le trafic réel en preuve sans exposer les utilisateurs au nouveau comportement.
Changement réversible
Concevoir les changements pour la réversibilité
Certains changements créent des états irréversibles : schémas incompatibles, migrations destructives ou changements de protocole qui cassent la rétrocompatibilité. Une fois franchies, ces frontières rendent le rollback risqué ou impossible. Si un changement ne peut pas être annulé en sécurité, repensez la transition pour qu’elle puisse être introduite par étapes réversibles.
Décomposer le changement en étapes sûres
Certains changements sont trop gros pour rester réversibles en toute sécurité en une seule transition. Décomposez-les en états intermédiaires où l’ancien et le nouveau comportement peuvent coexister et où chaque étape peut être validée ou annulée indépendamment. L’objectif n’est pas seulement d’atteindre l’état cible, mais de rendre sûr le chemin qui y mène.
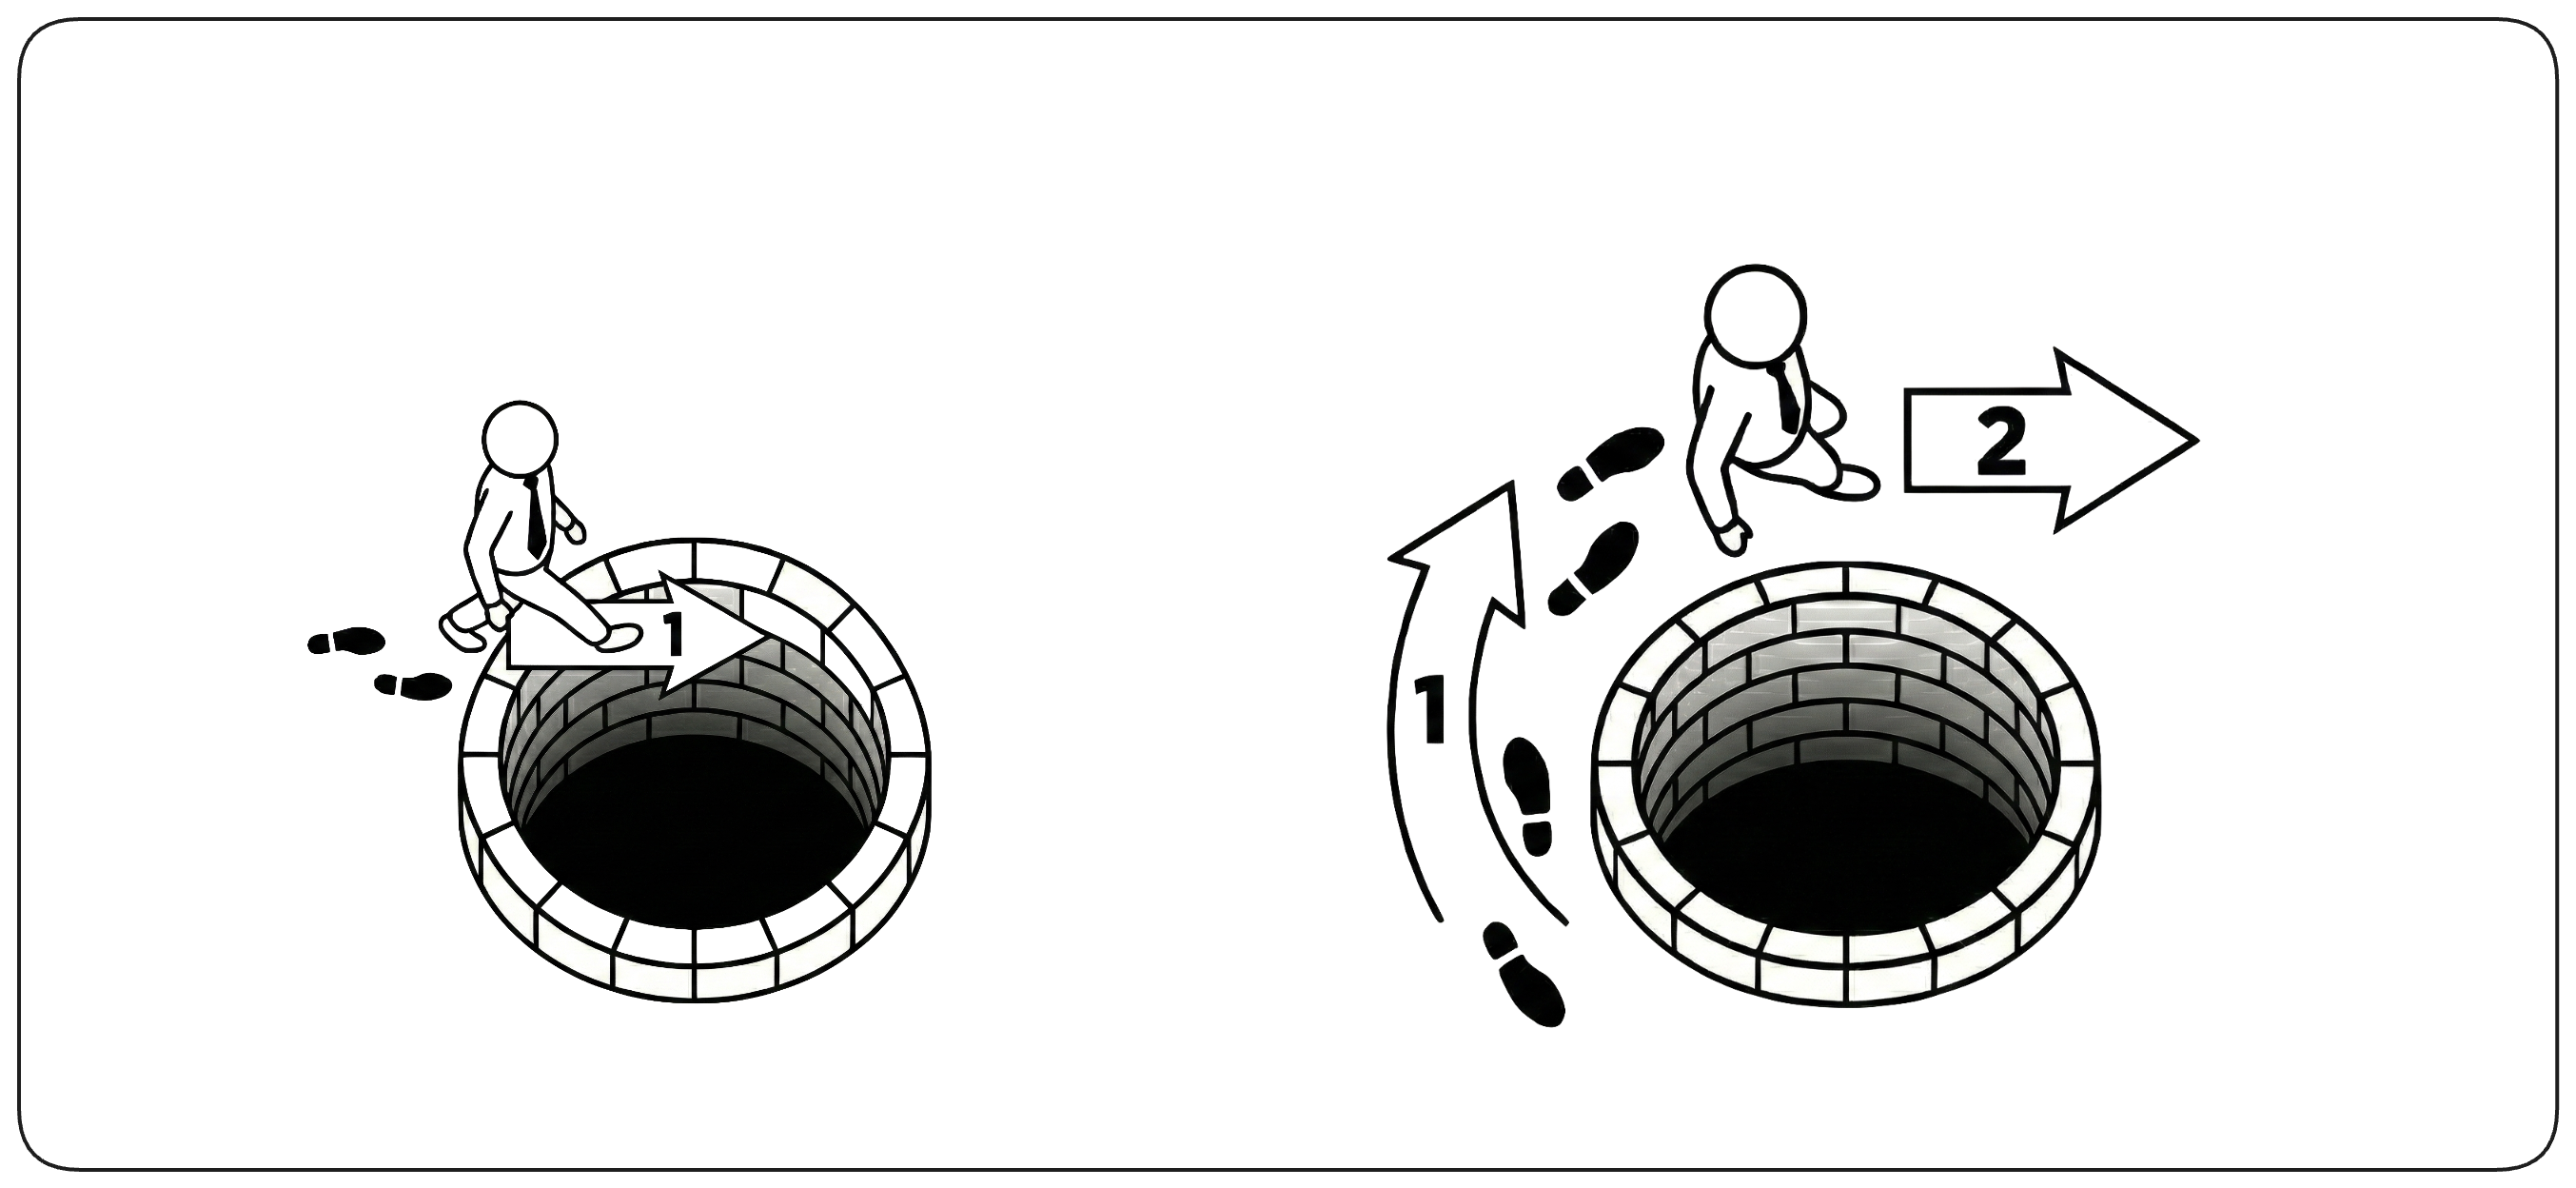
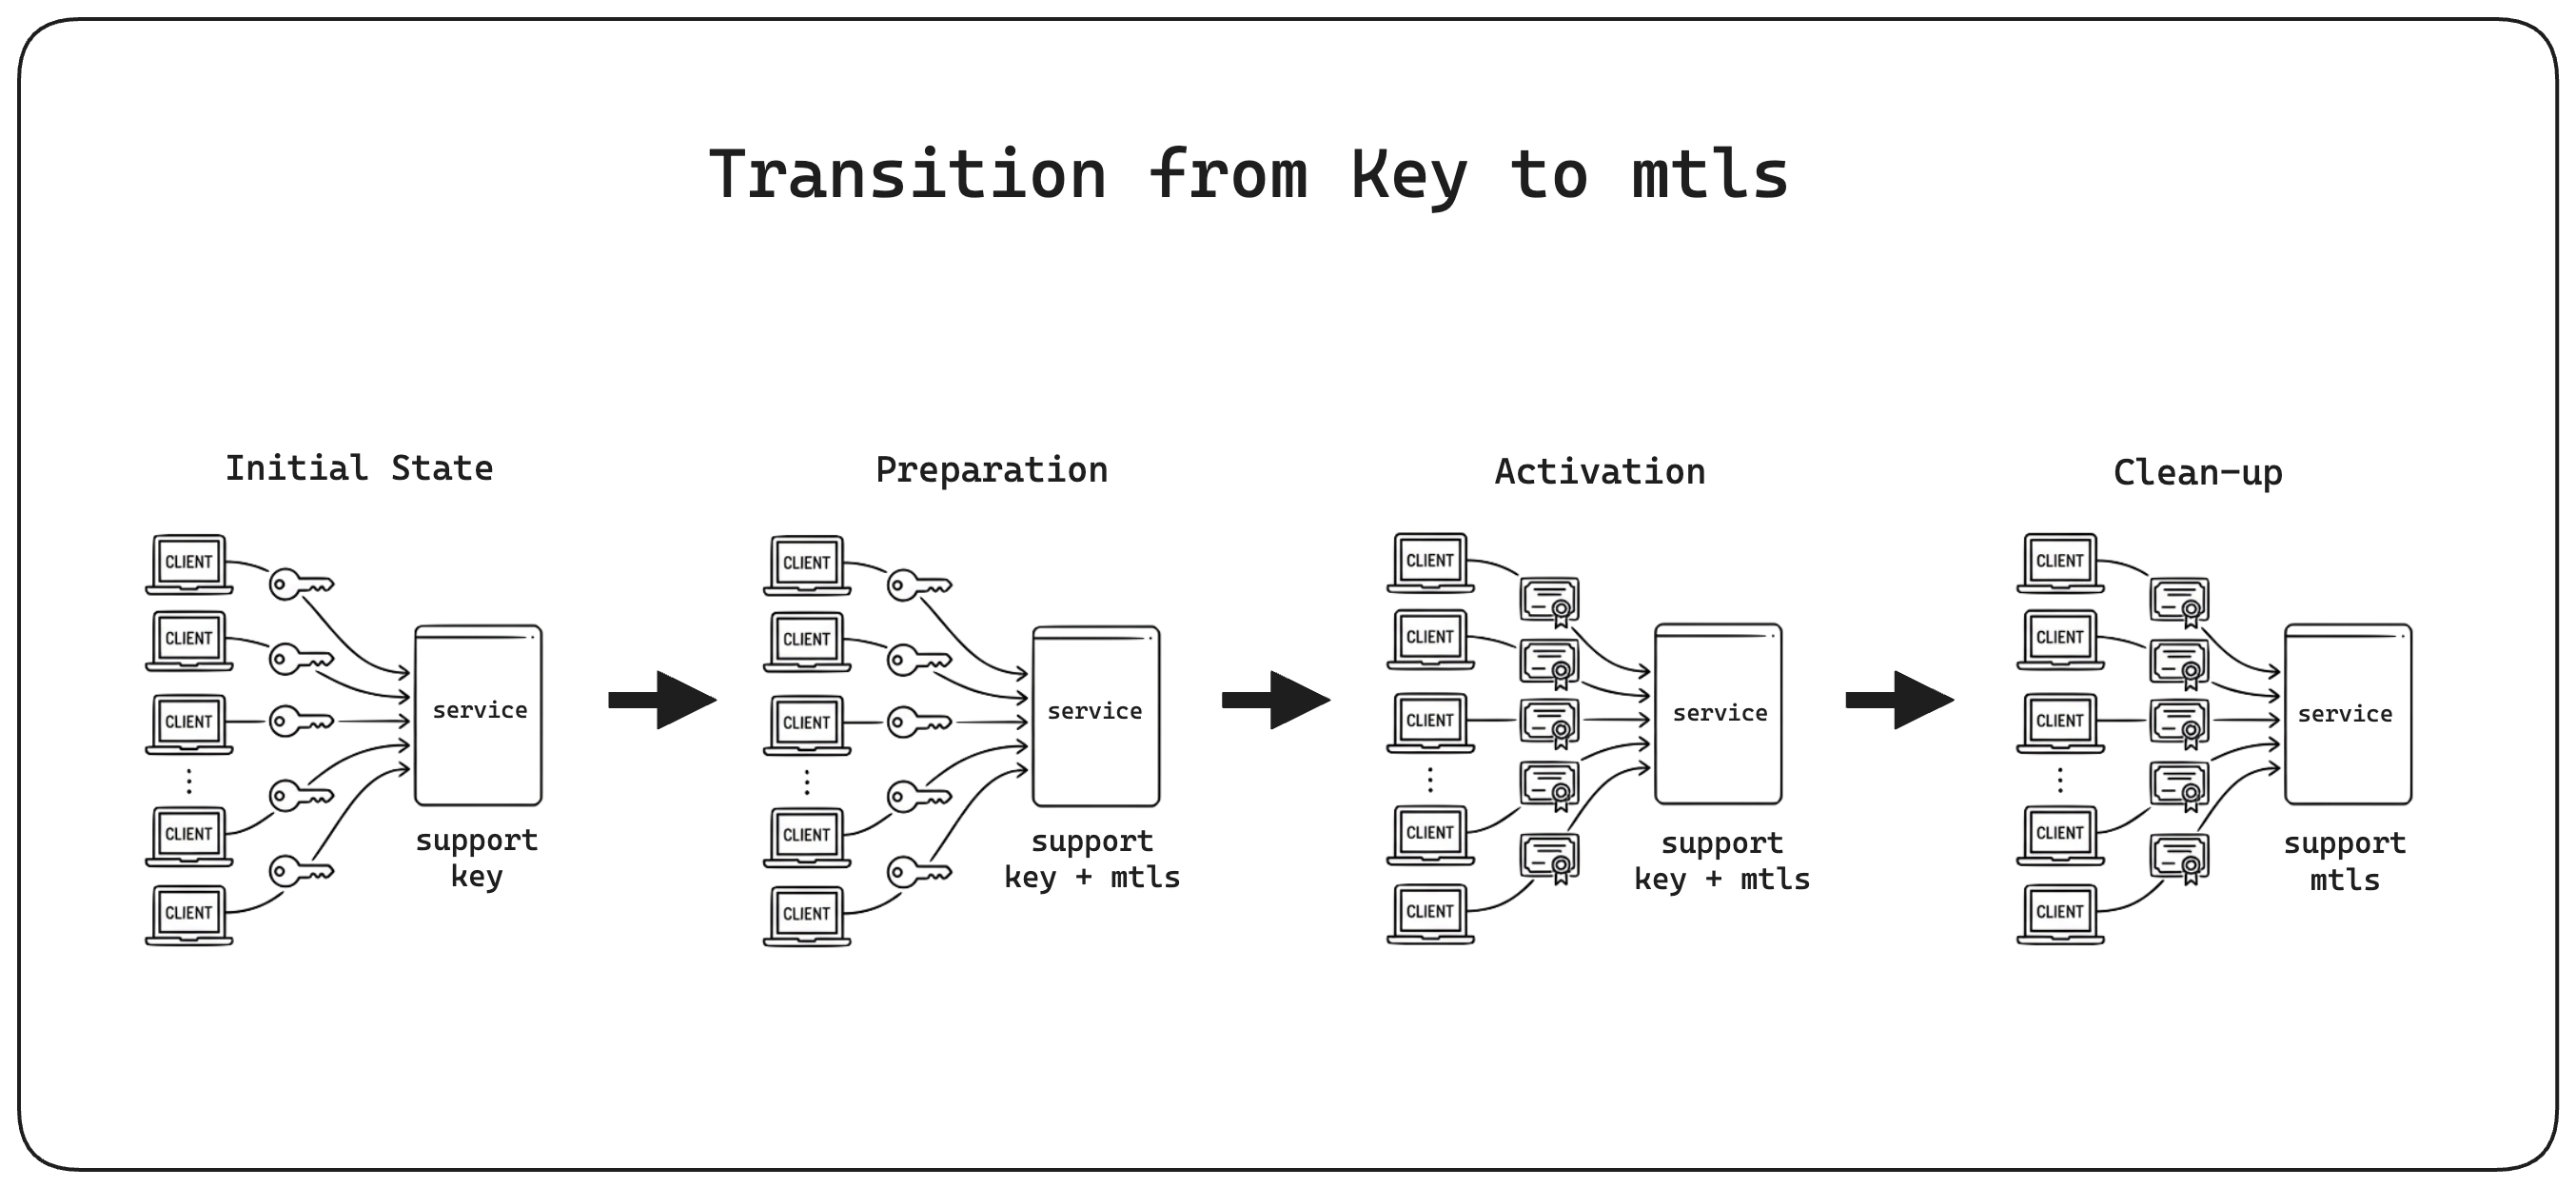
Déploiement en deux phases : séparer la préparation de l’activation
Le déploiement en deux phases sépare la préparation de l’activation. On rend d’abord le système capable de supporter à la fois l’état actuel et l’état futur ; ce n’est qu’ensuite qu’on active le nouveau comportement. Garder les deux états valides pendant la transition préserve un chemin sûr vers l’avant comme vers l’arrière.
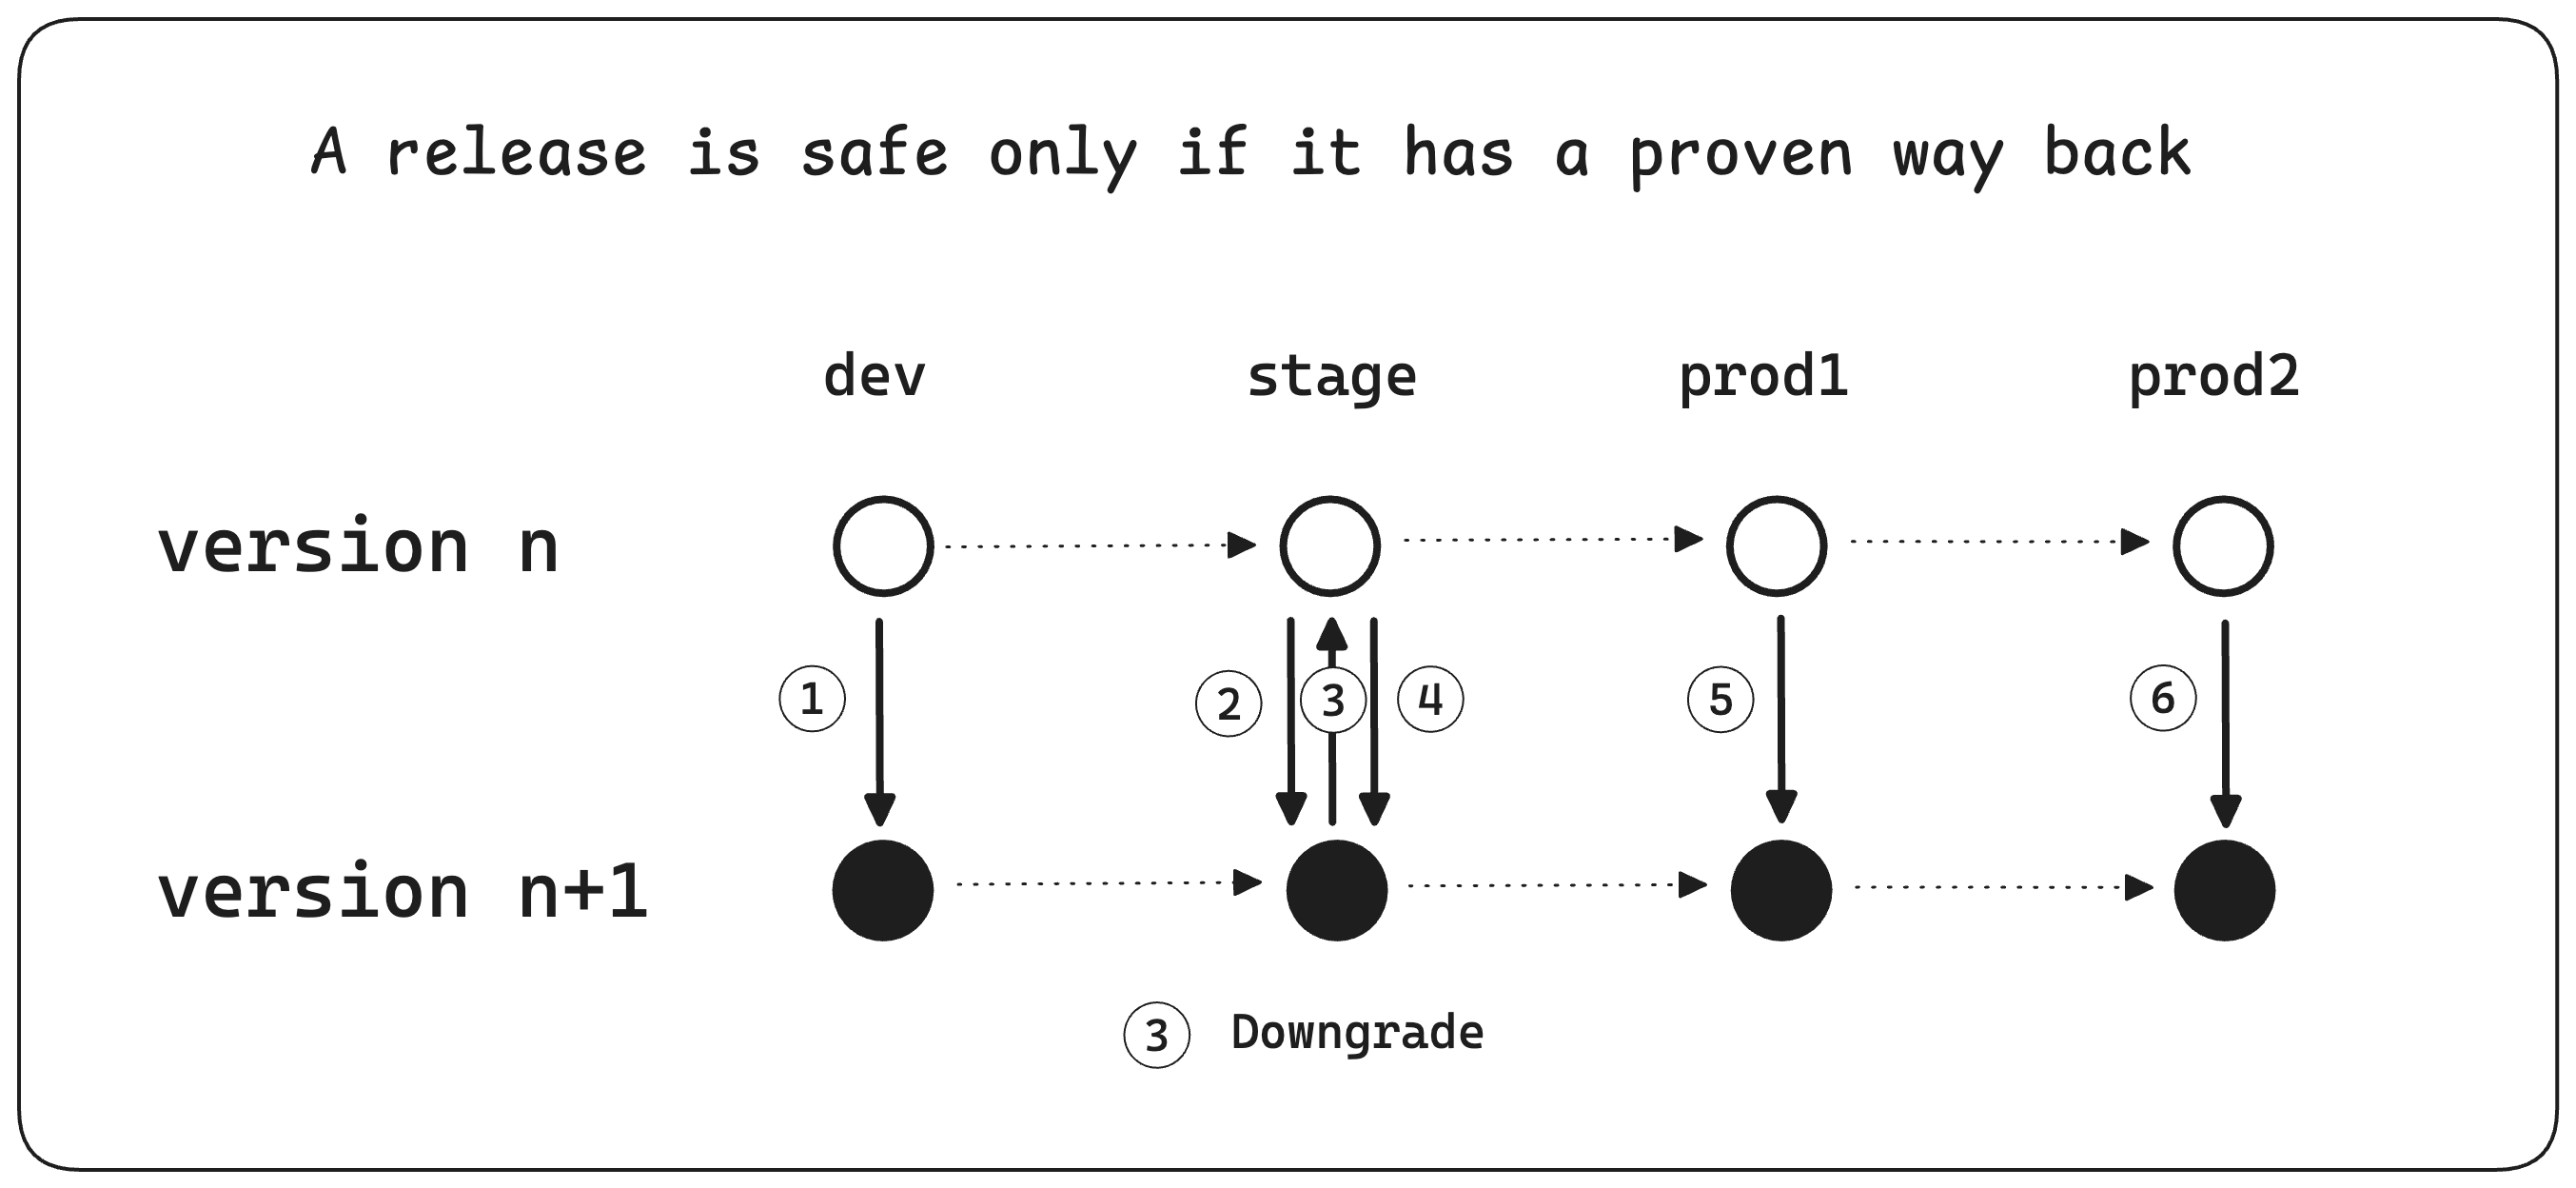
Rendre le rollback possible grâce aux tests de montée et descente de version
La réversibilité doit être testée, pas supposée. Le test de montée et descente de version fait passer le système à la nouvelle version puis le ramène à la précédente, validant que les deux transitions préservent la compatibilité, la disponibilité et l’intégrité des données. Un chemin de rollback jamais exercé n’est qu’une hypothèse.
Rendre les instances remplaçables
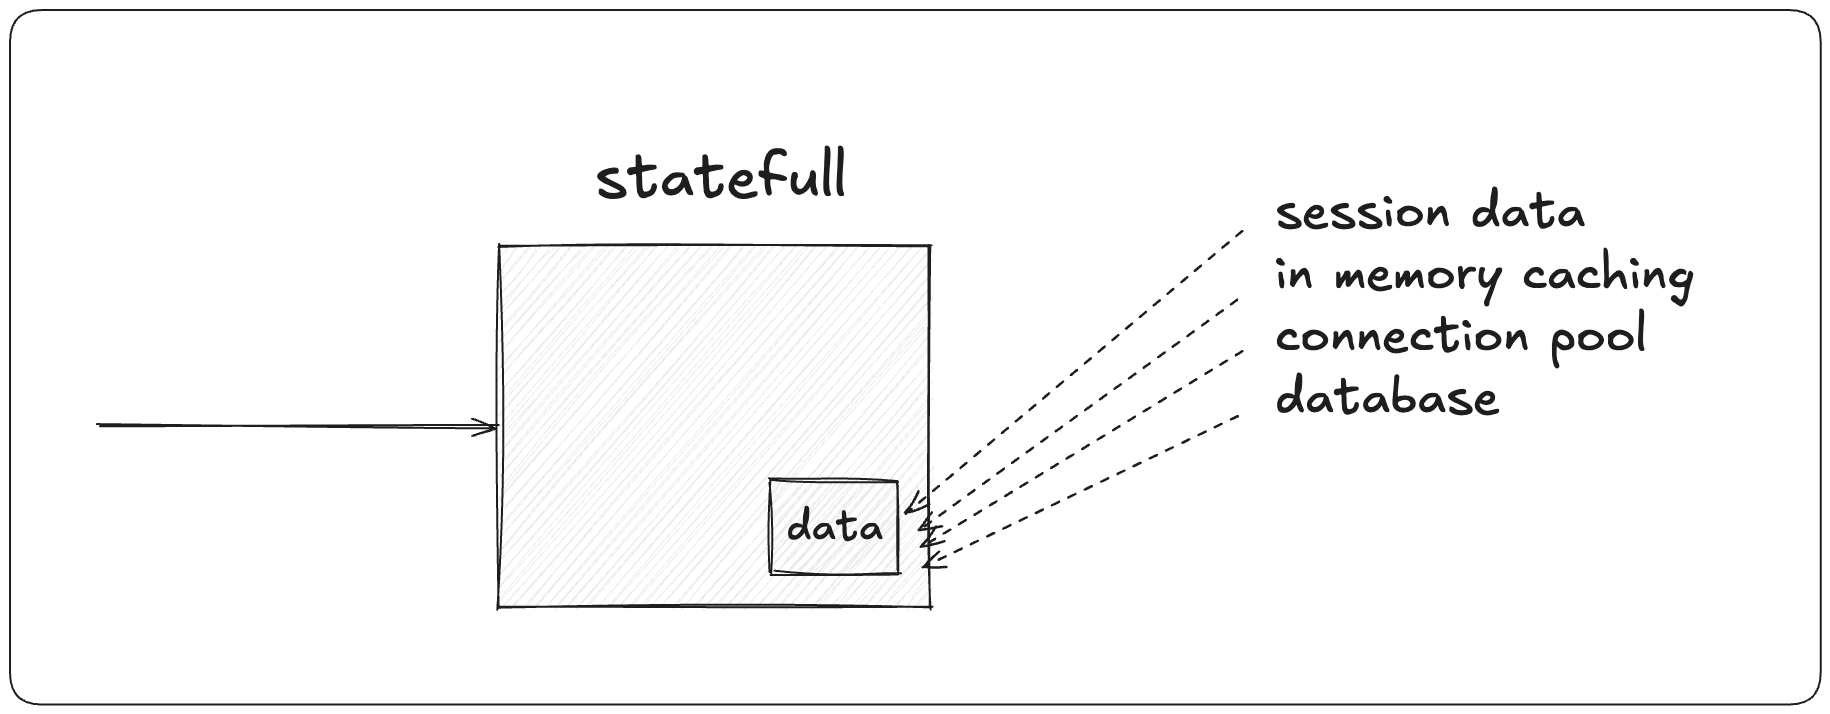
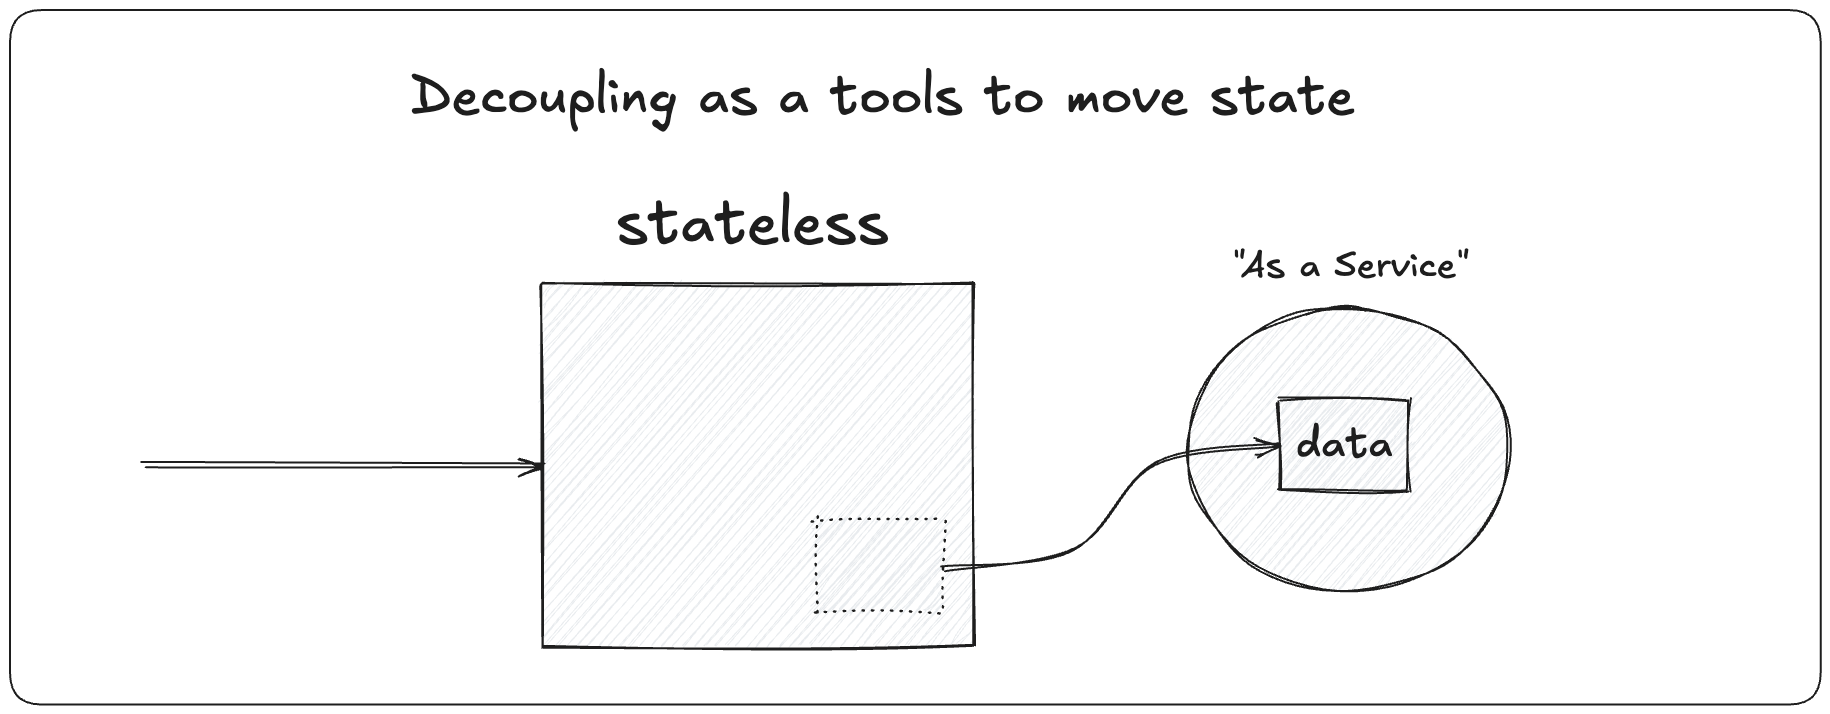
Le déploiement sans interruption exige que les instances soient remplaçables pendant que le trafic continue de circuler. L’état local rend le remplacement difficile, car les sessions, les données en mémoire ou le travail en cours peuvent disparaître avec l’instance. Gardez autant que possible l’état durable en dehors du compute jetable, et concevez les instances pour qu’elles puissent entrer en service et en sortir en toute sécurité.
Préserver les traitements longs
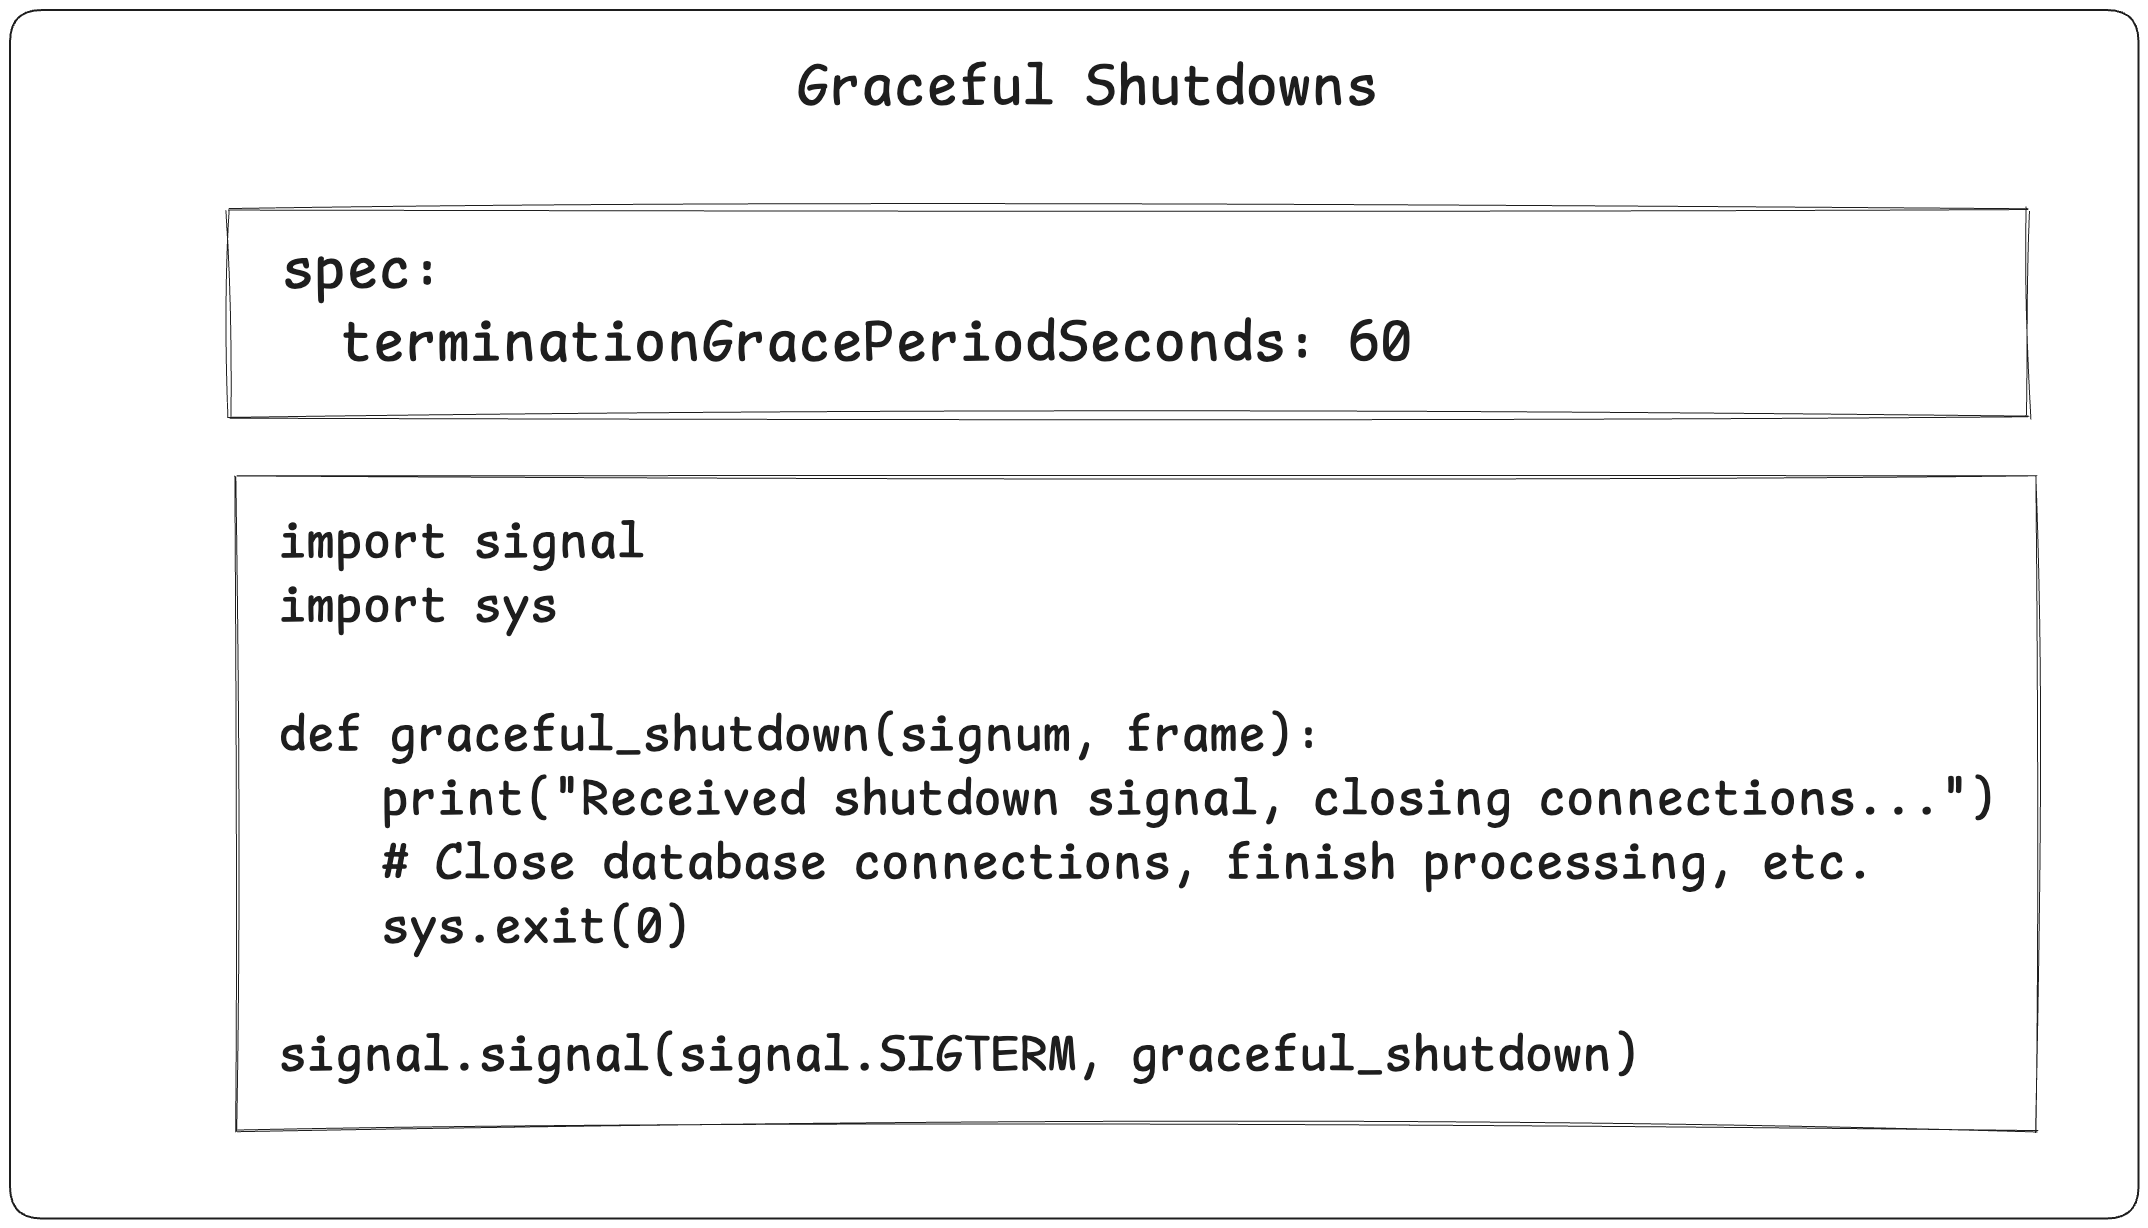
Les traitements longs doivent se terminer ou reprendre en sécurité pendant le remplacement des instances. L’arrêt gracieux laisse le travail en cours se terminer avant l’extinction, tandis que le checkpointing ou les files durables permettent au travail de continuer ailleurs quand il ne peut pas se terminer immédiatement.
Remplacer la capacité sans interrompre le service
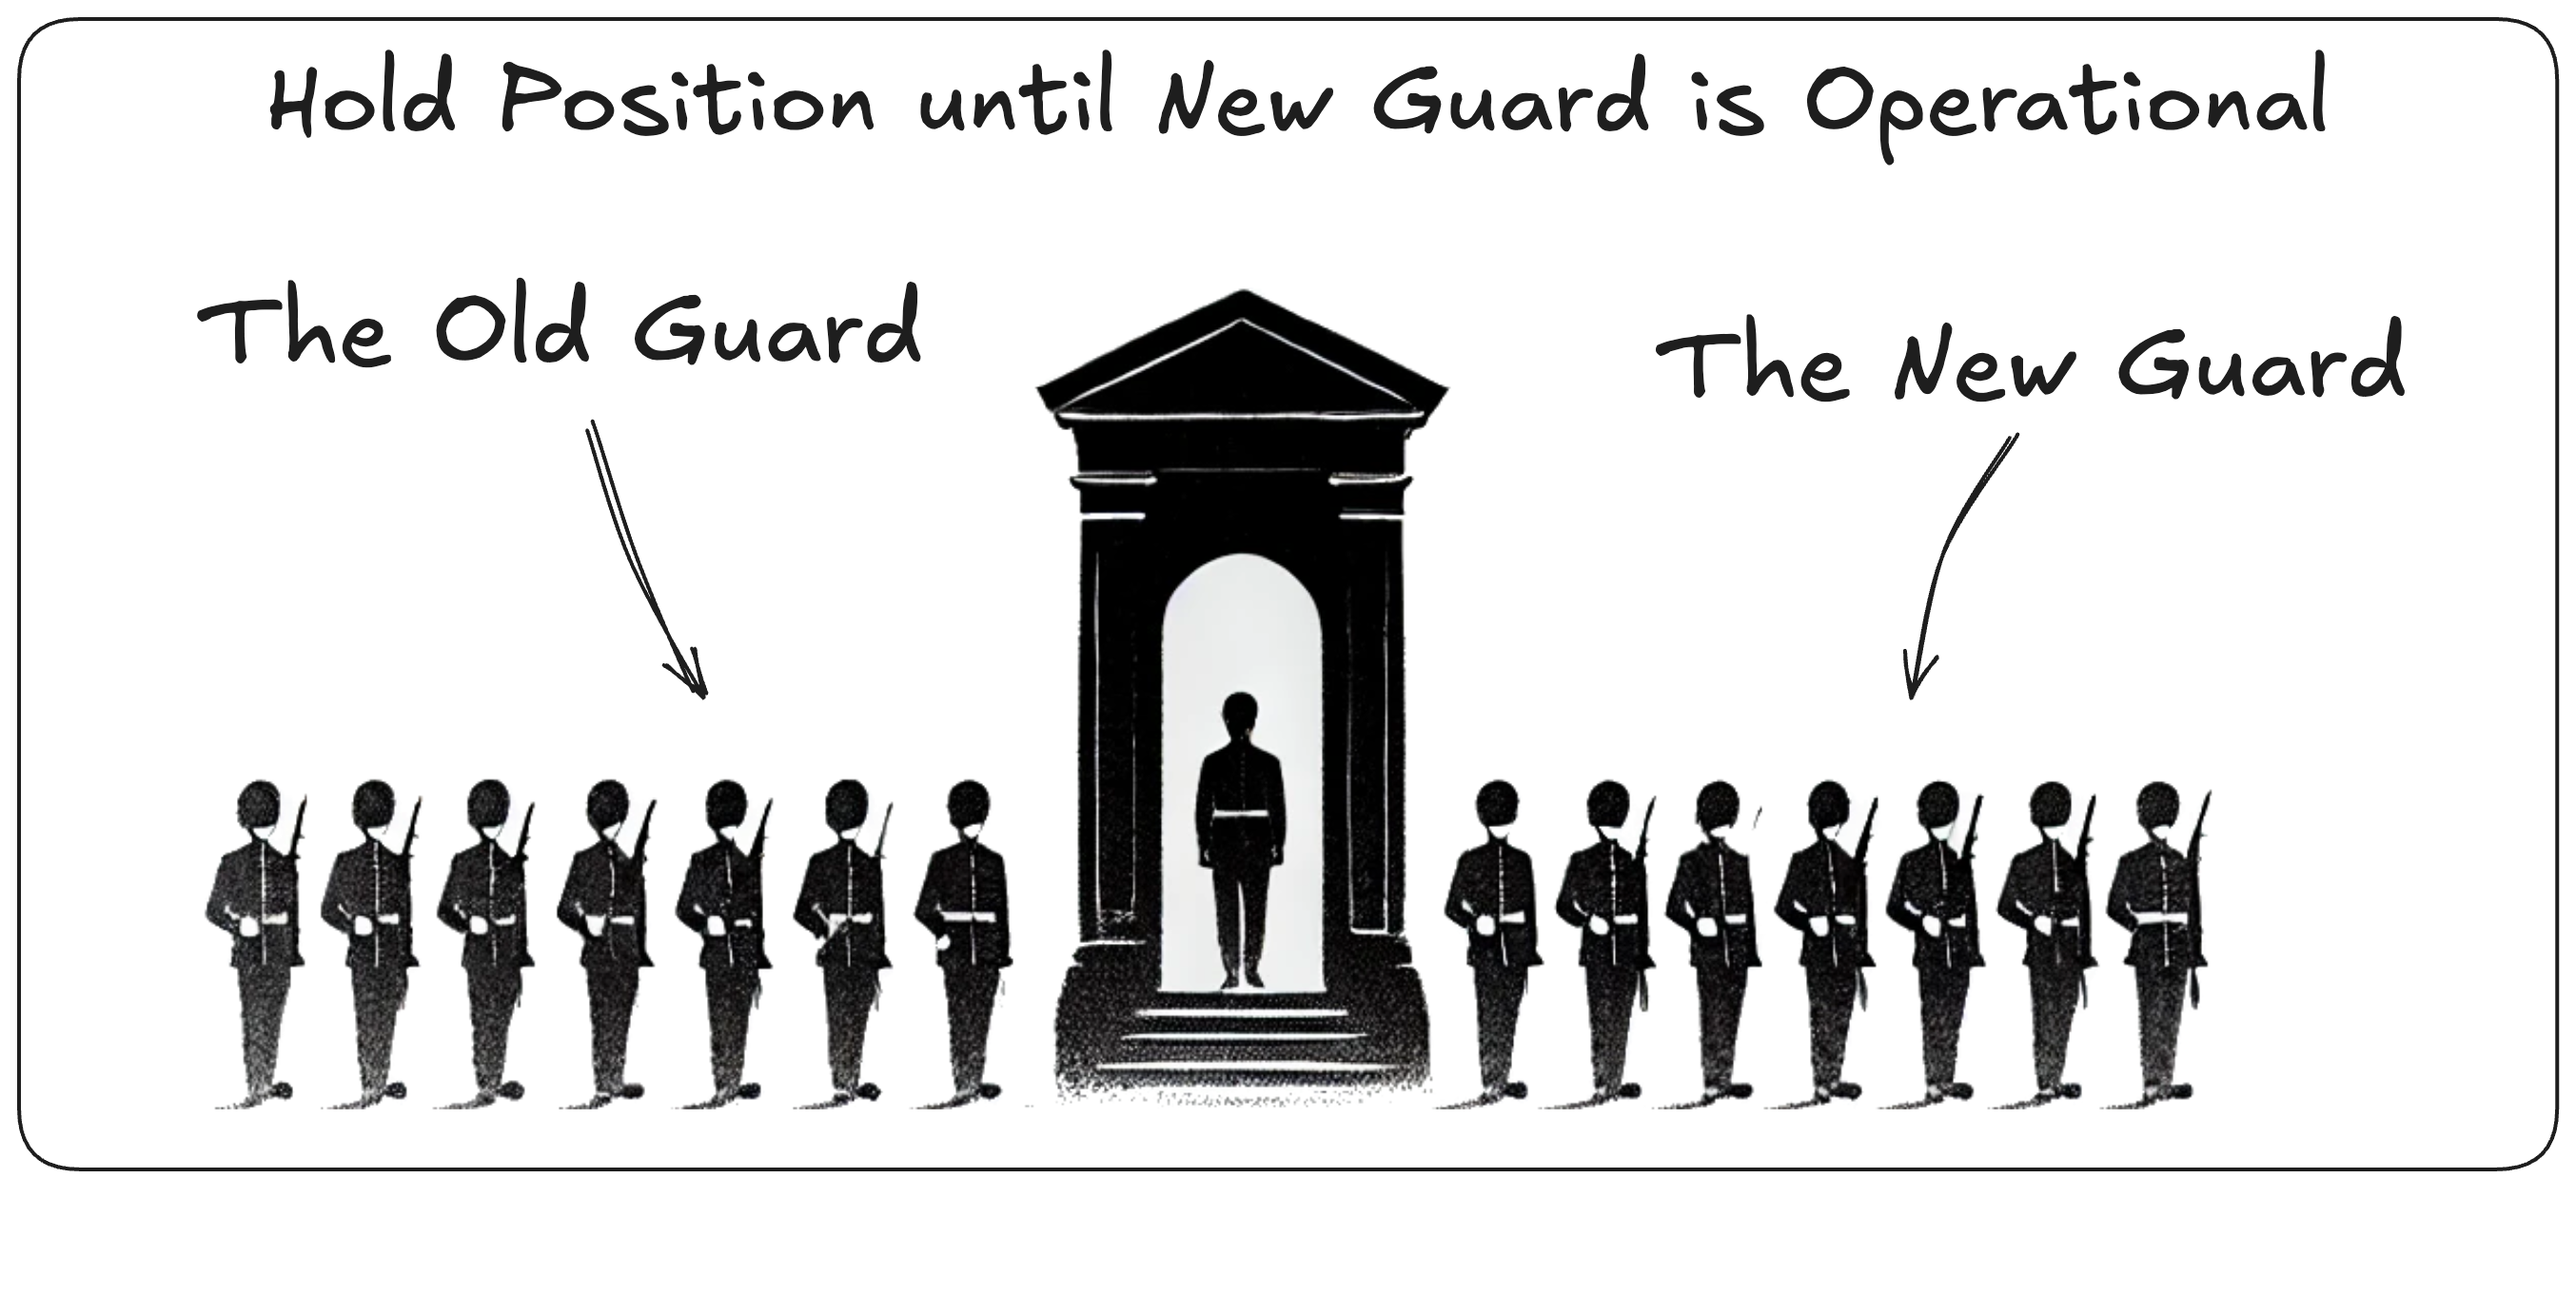
Les stratégies sans interruption remplacent la capacité sans retirer trop tôt la version saine. Les déploiements blue-green préparent un environnement entièrement nouveau avant de basculer le trafic, tandis que les déploiements rolling remplacent les instances progressivement. Les deux exigent que l’ancienne et la nouvelle version coexistent en sécurité pendant la transition, ce qui rend essentielles les interfaces rétrocompatibles et le remplacement gracieux des instances.
Moment de la release
Moment de la release : quand le temps change le risque
Un même changement peut porter un risque très différent selon le moment où il est livré. Un pic de trafic, des événements métier critiques ou une couverture opérationnelle limitée peuvent rendre dangereux un déploiement par ailleurs banal. Les politiques de release devraient donc intégrer le temps et le contexte métier, avec des garde-fous automatisés lorsque c’est approprié.
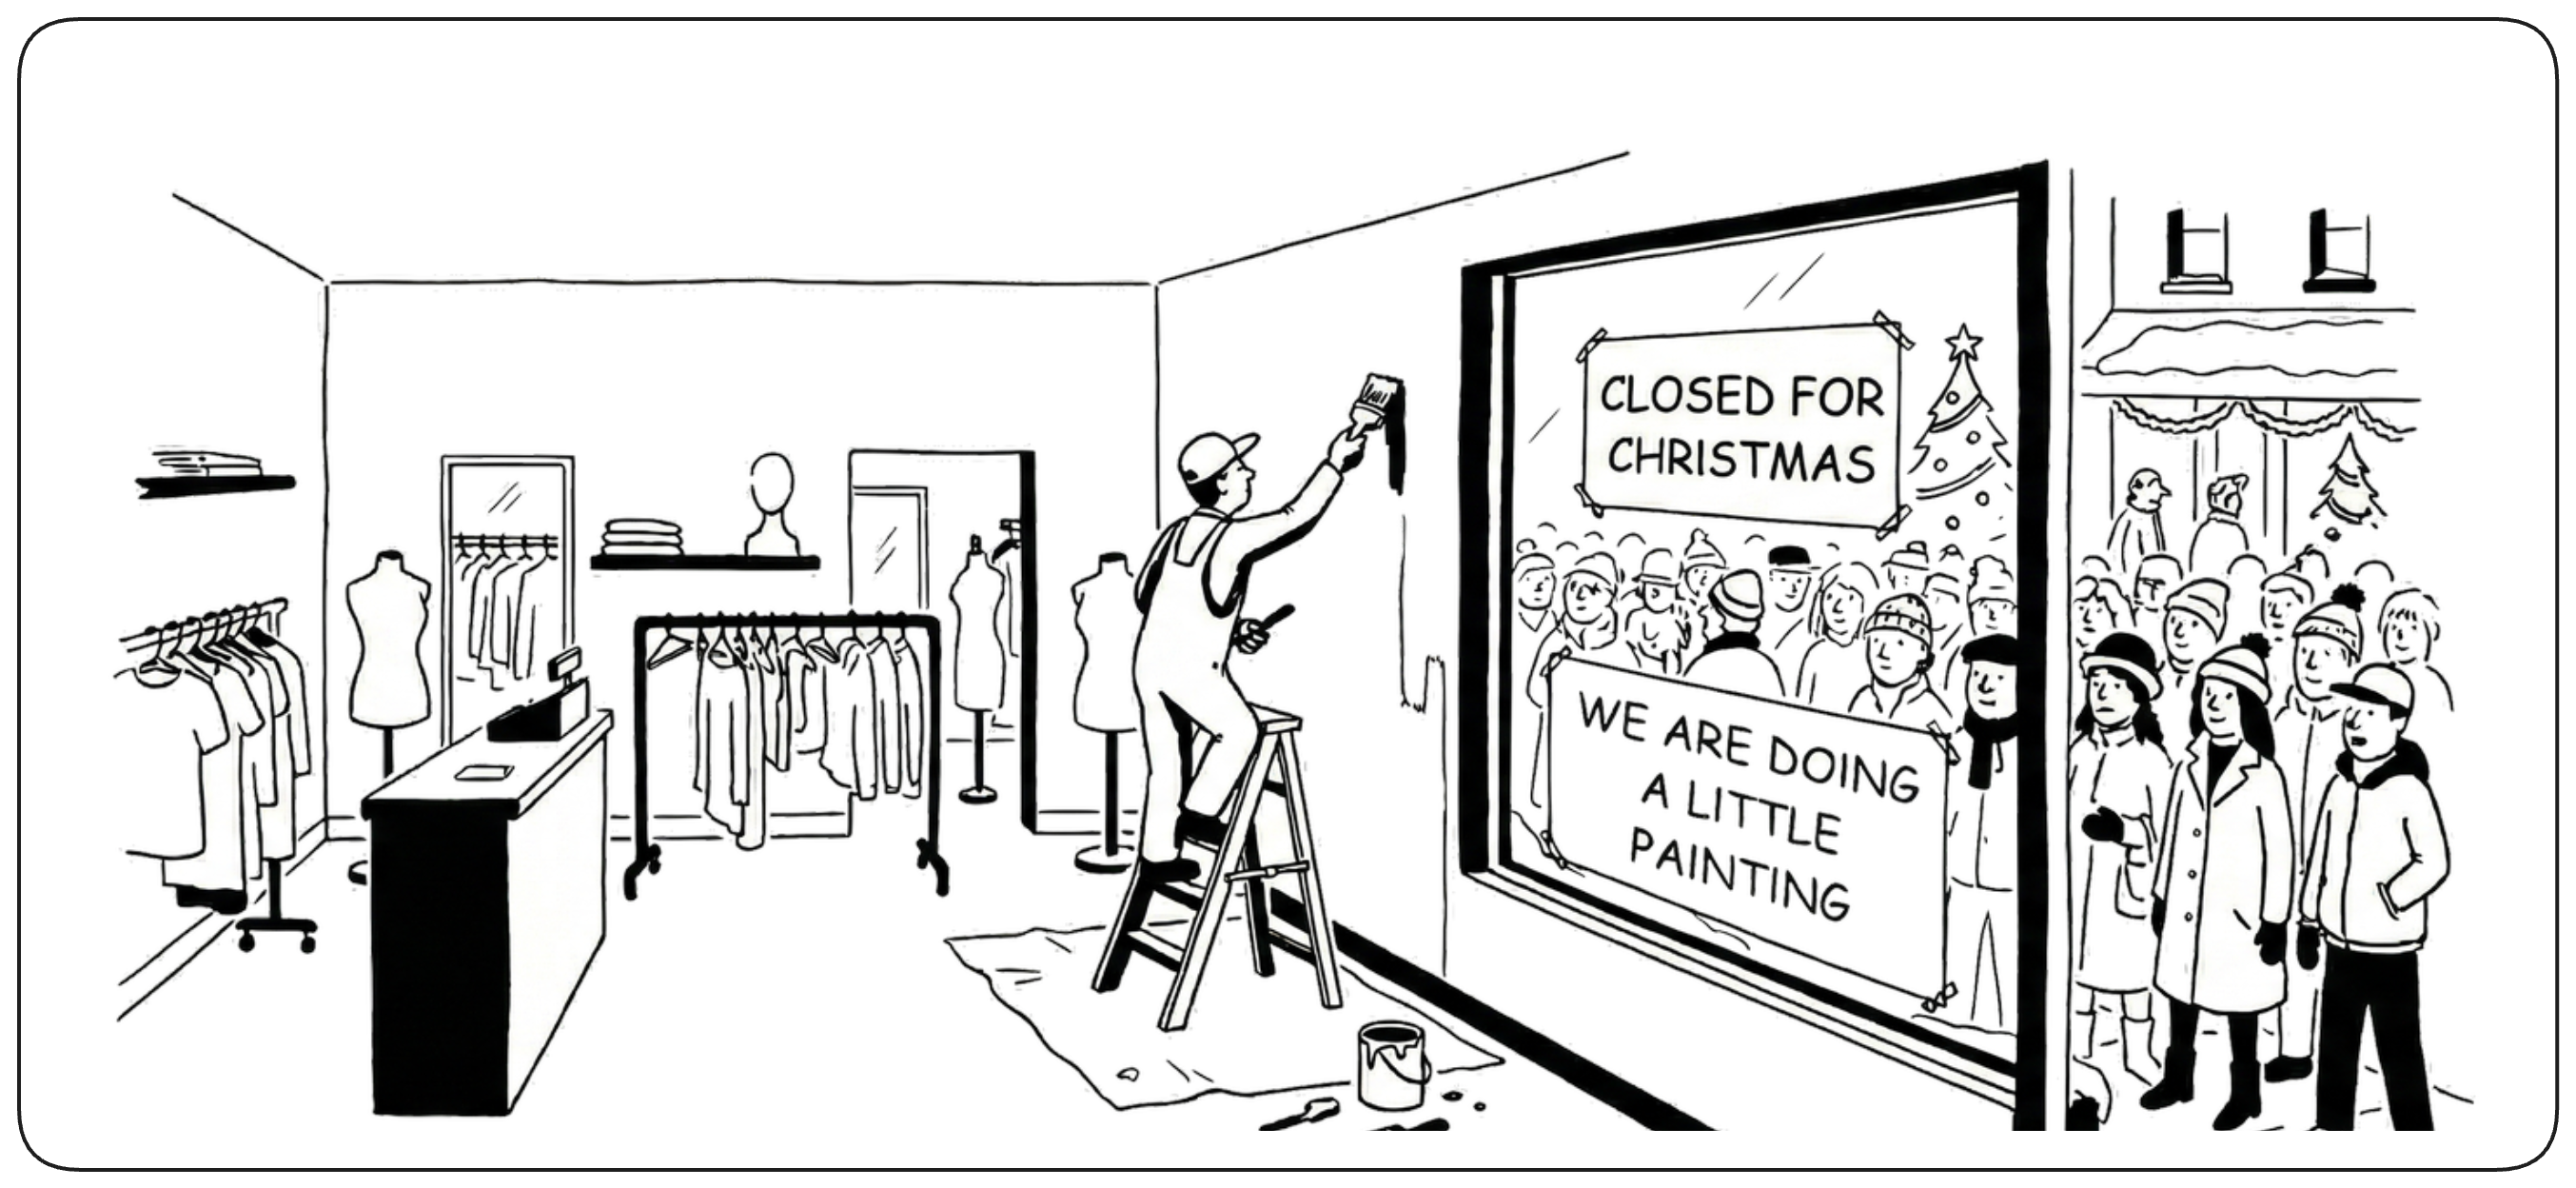
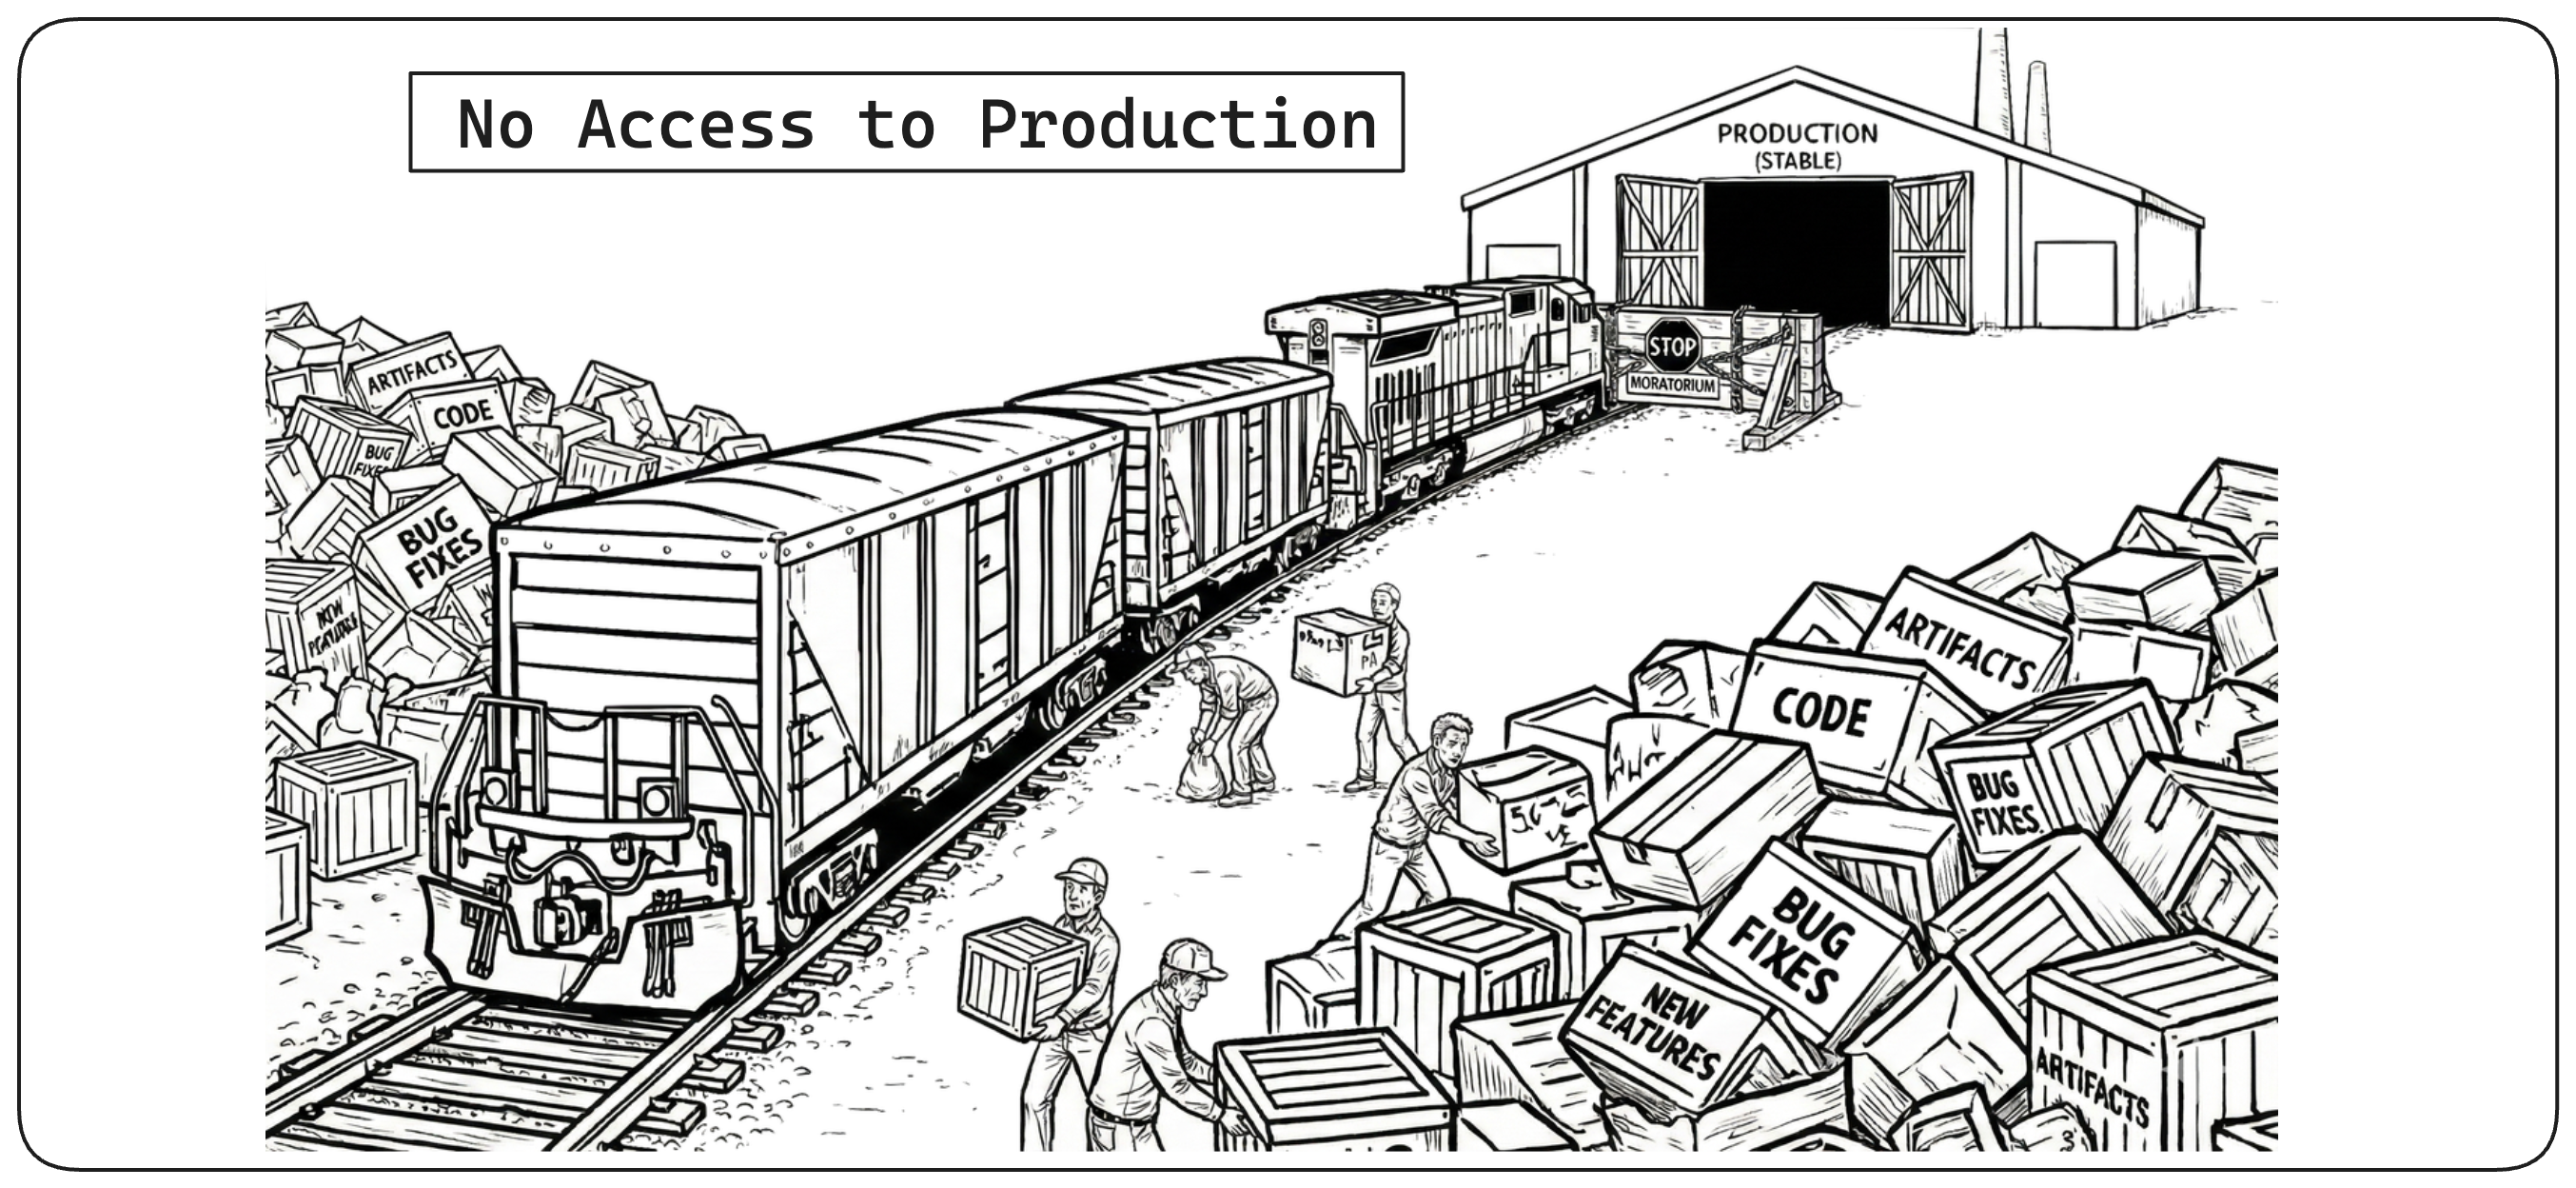
Le paradoxe du moratoire : protection vs accumulation
Un moratoire sur les releases réduit le risque à court terme en gelant les changements de production non essentiels pendant les périodes critiques. Mais le développement continue : les changements non livrés s’accumulent et l’écart avec la production se creuse. Plus le gel est long, plus la release finale devient grosse et risquée. Les moratoires échangent donc une stabilité immédiate contre un risque de changement différé.
Promotion gates
Une promotion gate est une décision
La promotion est la décision d’augmenter l’exposition d’une release. Une gate rend cette décision explicite en évaluant trois choses : les preuves concernant le changement, la disponibilité de la cible et la politique de l’organisation. La promotion n’avance que lorsque les conditions requises pour le niveau d’exposition suivant sont réunies.
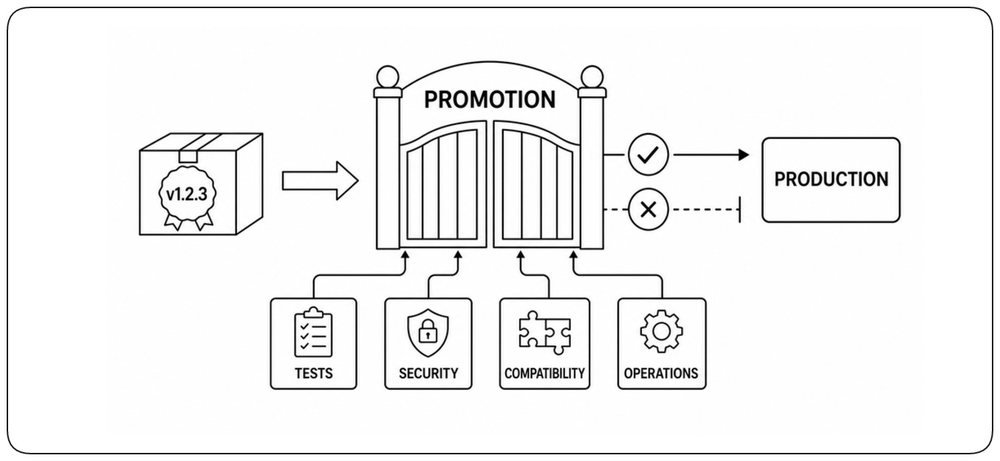
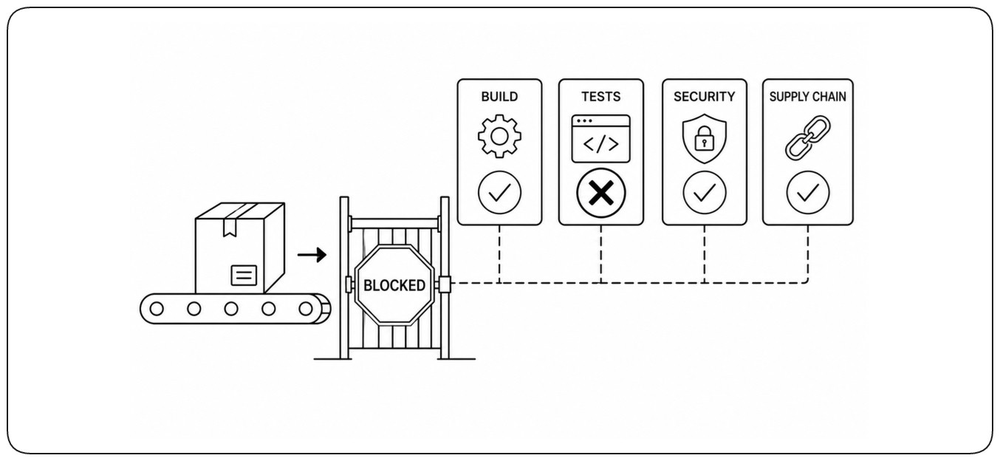
Une gate bloque en l’absence de preuves
Une release ne progresse que si des preuves suffisantes justifient une exposition plus large. Des builds ou tests en échec, des constats de sécurité non résolus et des validations manquantes bloquent donc la promotion. Les gates devraient évaluer ces preuves automatiquement et identifier la condition exacte à résoudre.
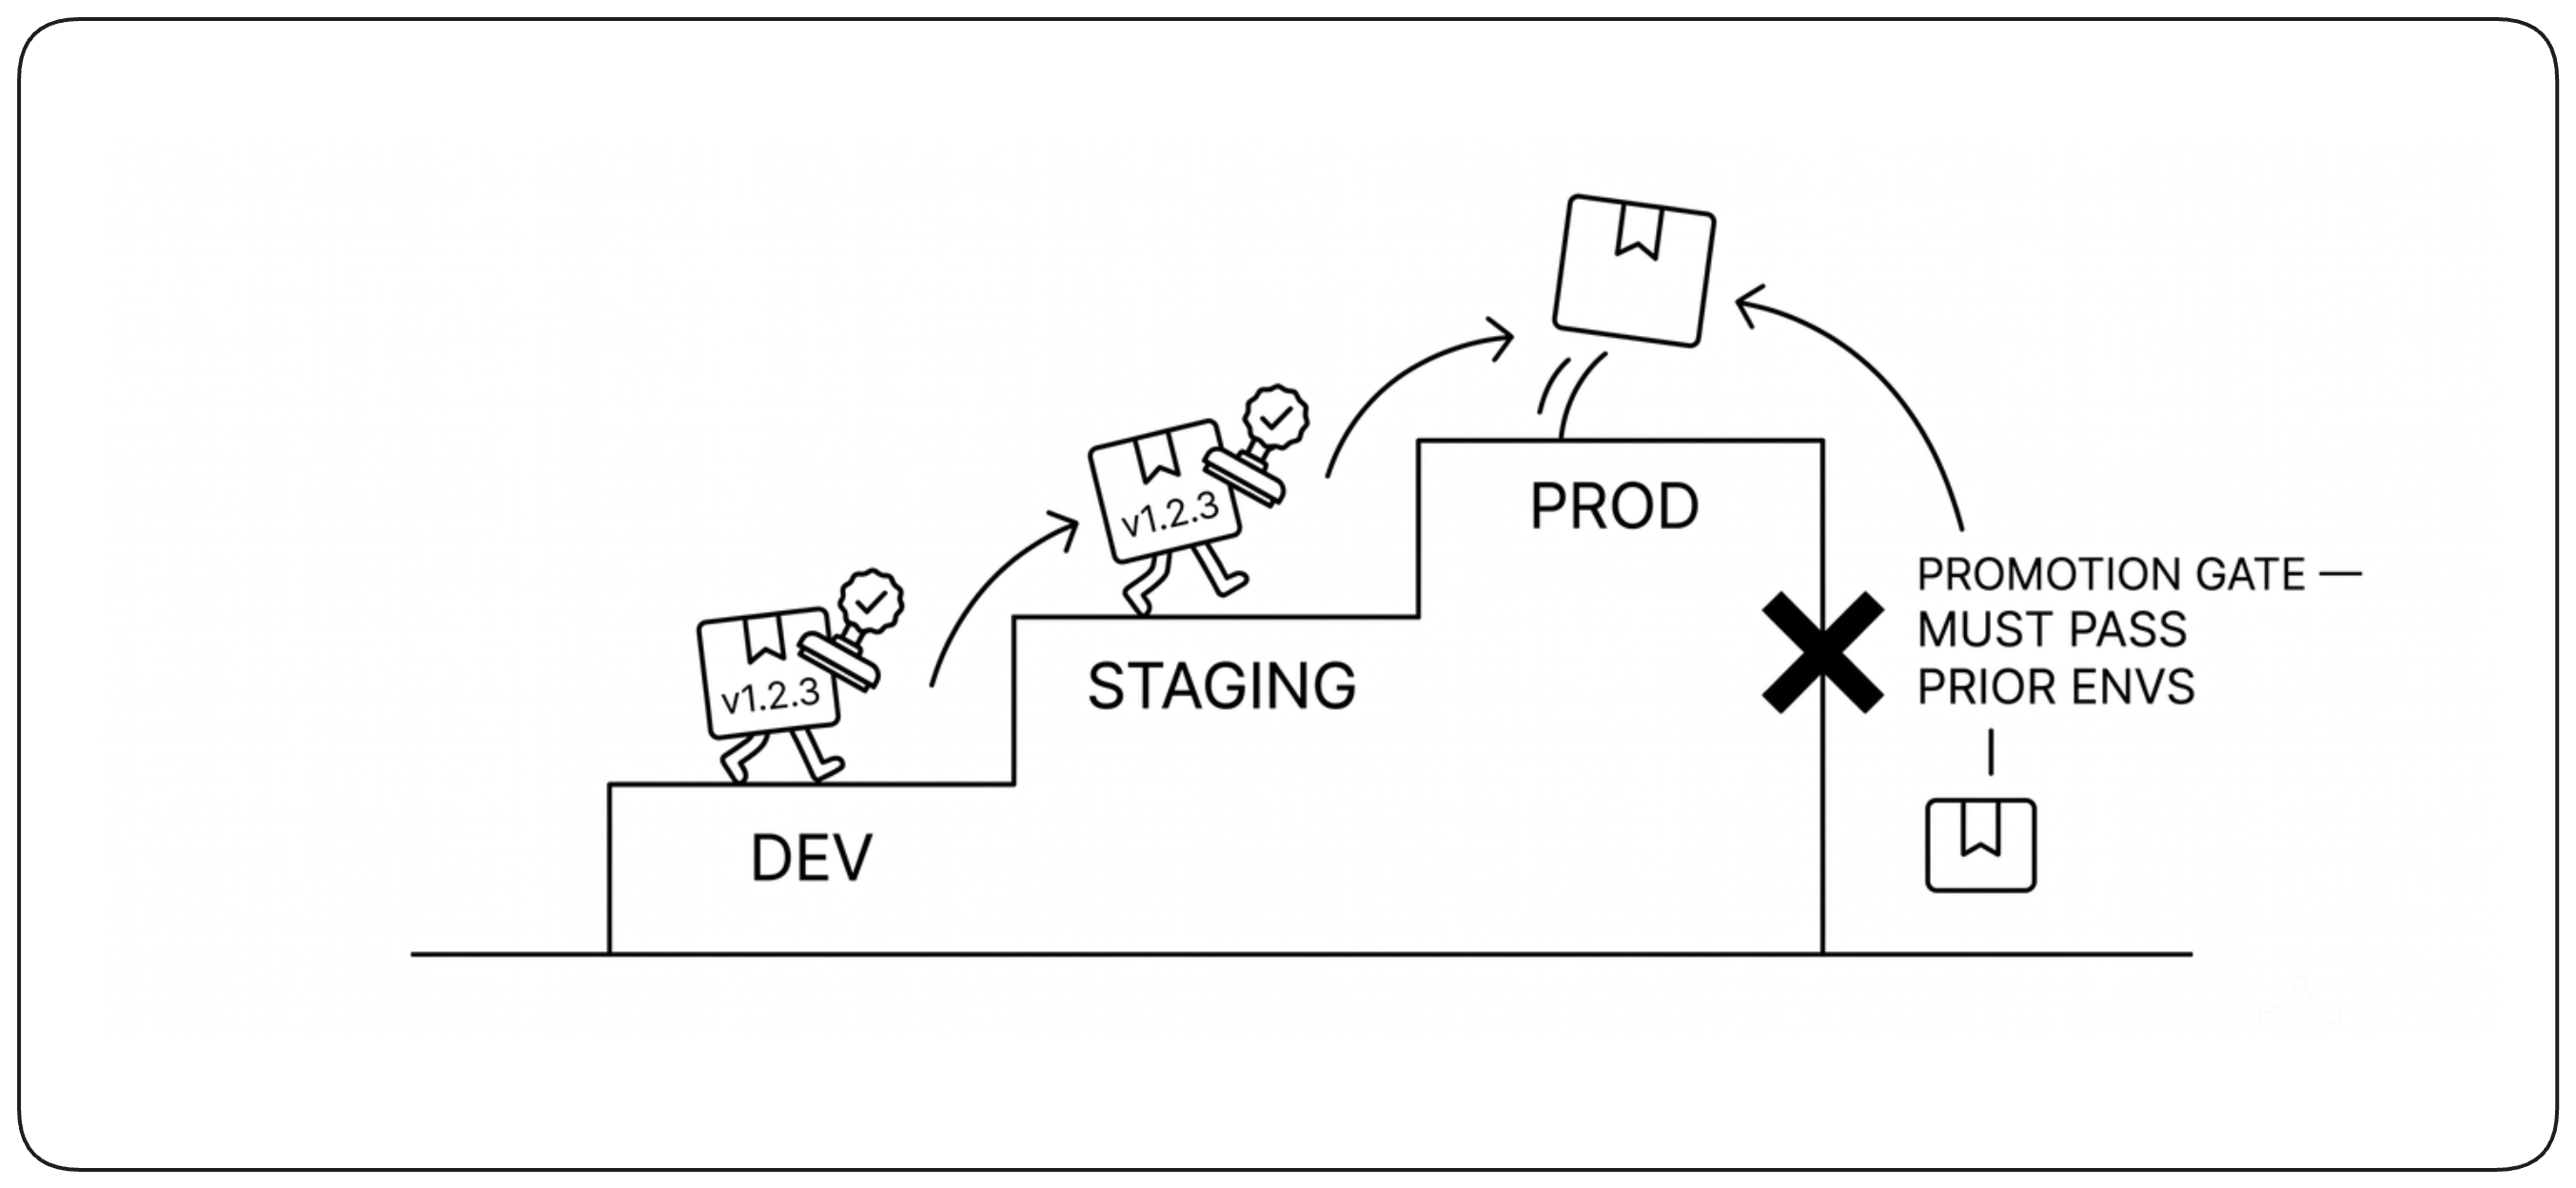
La promotion exige des preuves préalables
La promotion exige des preuves adaptées au risque de la cible. Dans de nombreux systèmes, un déploiement et une validation réussis dans un environnement à risque plus faible fournissent une partie de ces preuves. Le principe important n’est pas une séquence DEV → STAGING → PROD obligatoire, mais que l’exposition n’augmente qu’une fois les preuves requises établies.
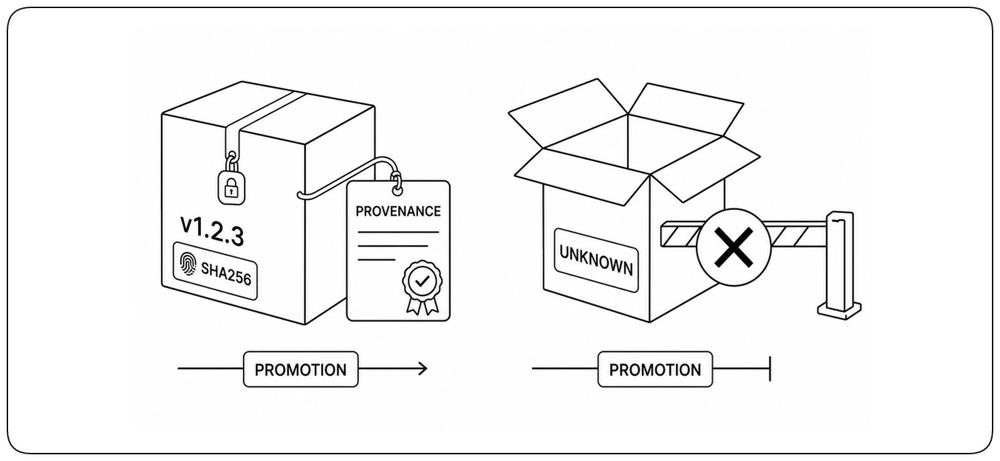
Un artefact doit être identifiable et fiable
La promotion exige l’artefact immuable qui a été construit et validé, lié à son digest, sa provenance et ses résultats de scan. Reconstruire pour la production, utiliser un tag flottant ou perdre le lien avec ses preuves rompt la chaîne de confiance.
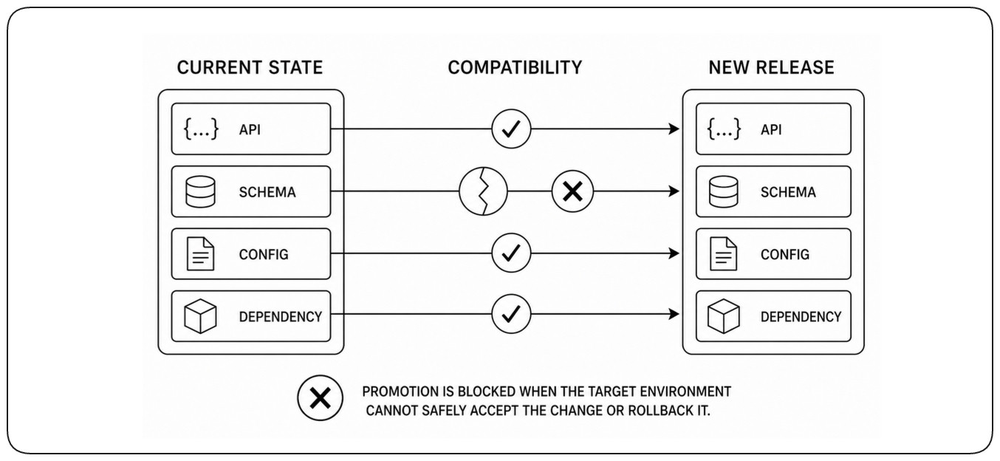
La cible doit être prête pour le changement
Un artefact par ailleurs sain peut rester dangereux pour sa cible. La promotion doit valider la transition autant que l’artefact : la configuration et les dépendances requises existent, le changement est compatible avec ce qui tourne déjà, et un chemin de reprise viable subsiste.
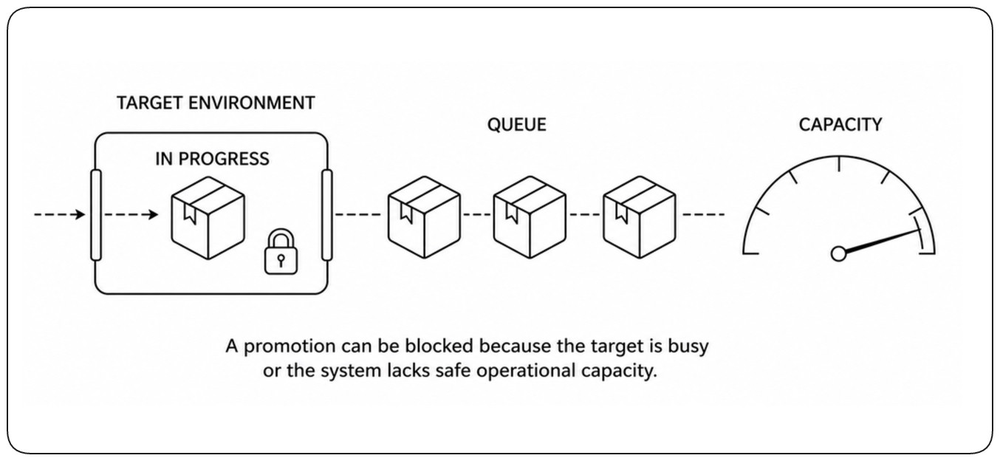
Une cible occupée ne doit pas être forcée
Une cible peut déjà avoir un déploiement en cours, un changement conflictuel peut détenir son verrou, ou la plateforme peut manquer de capacité pour un rollout sûr. Sérialiser les opérations incompatibles évite que des changements qui se chevauchent n’obscurcissent la relation de cause à effet ou n’aggravent un incident.
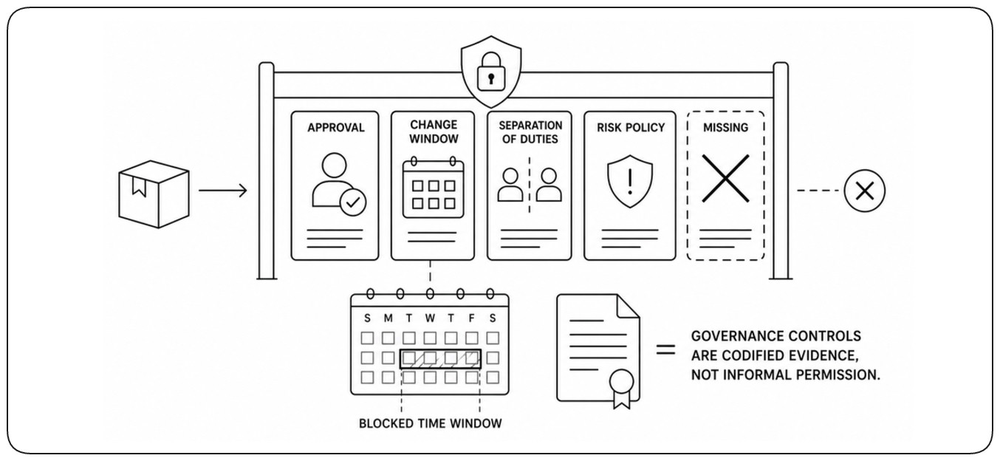
Une politique peut bloquer un changement techniquement valide
La validité technique est nécessaire, mais elle ne fait pas toute la décision. Des approbations manquantes, des fenêtres de changement fermées, des règles de séparation des tâches ou une politique de risque propre à la cible peuvent toutes bloquer la promotion. Ces contrôles devraient être des règles explicites et auditables, automatisées lorsque c’est possible.
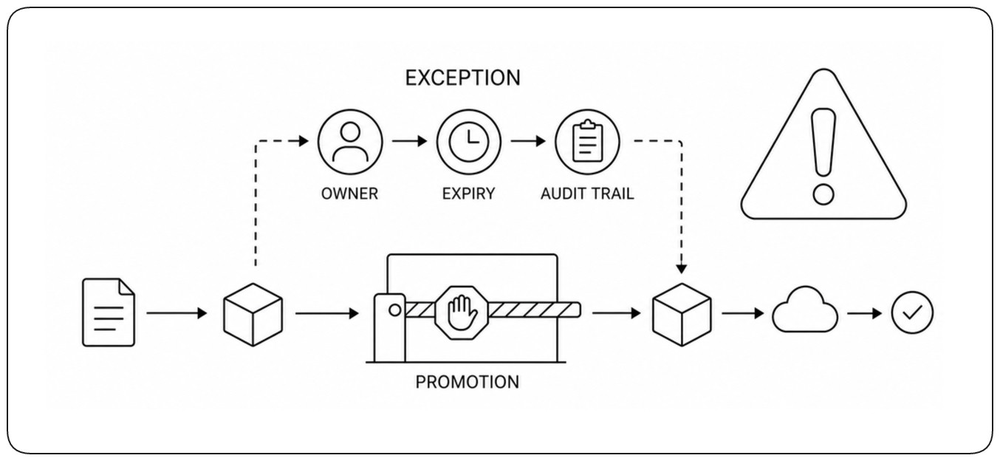
Les exceptions doivent être plus sûres que les contournements
Les changements d’urgence peuvent exiger une exception, mais une exception est un chemin contrôlé — pas un contournement caché. Elle doit avoir un propriétaire responsable, un périmètre explicite, une expiration automatique et une piste d’audit durable. Des exceptions fréquentes montrent que la gate ou la conception de la livraison doit être améliorée.
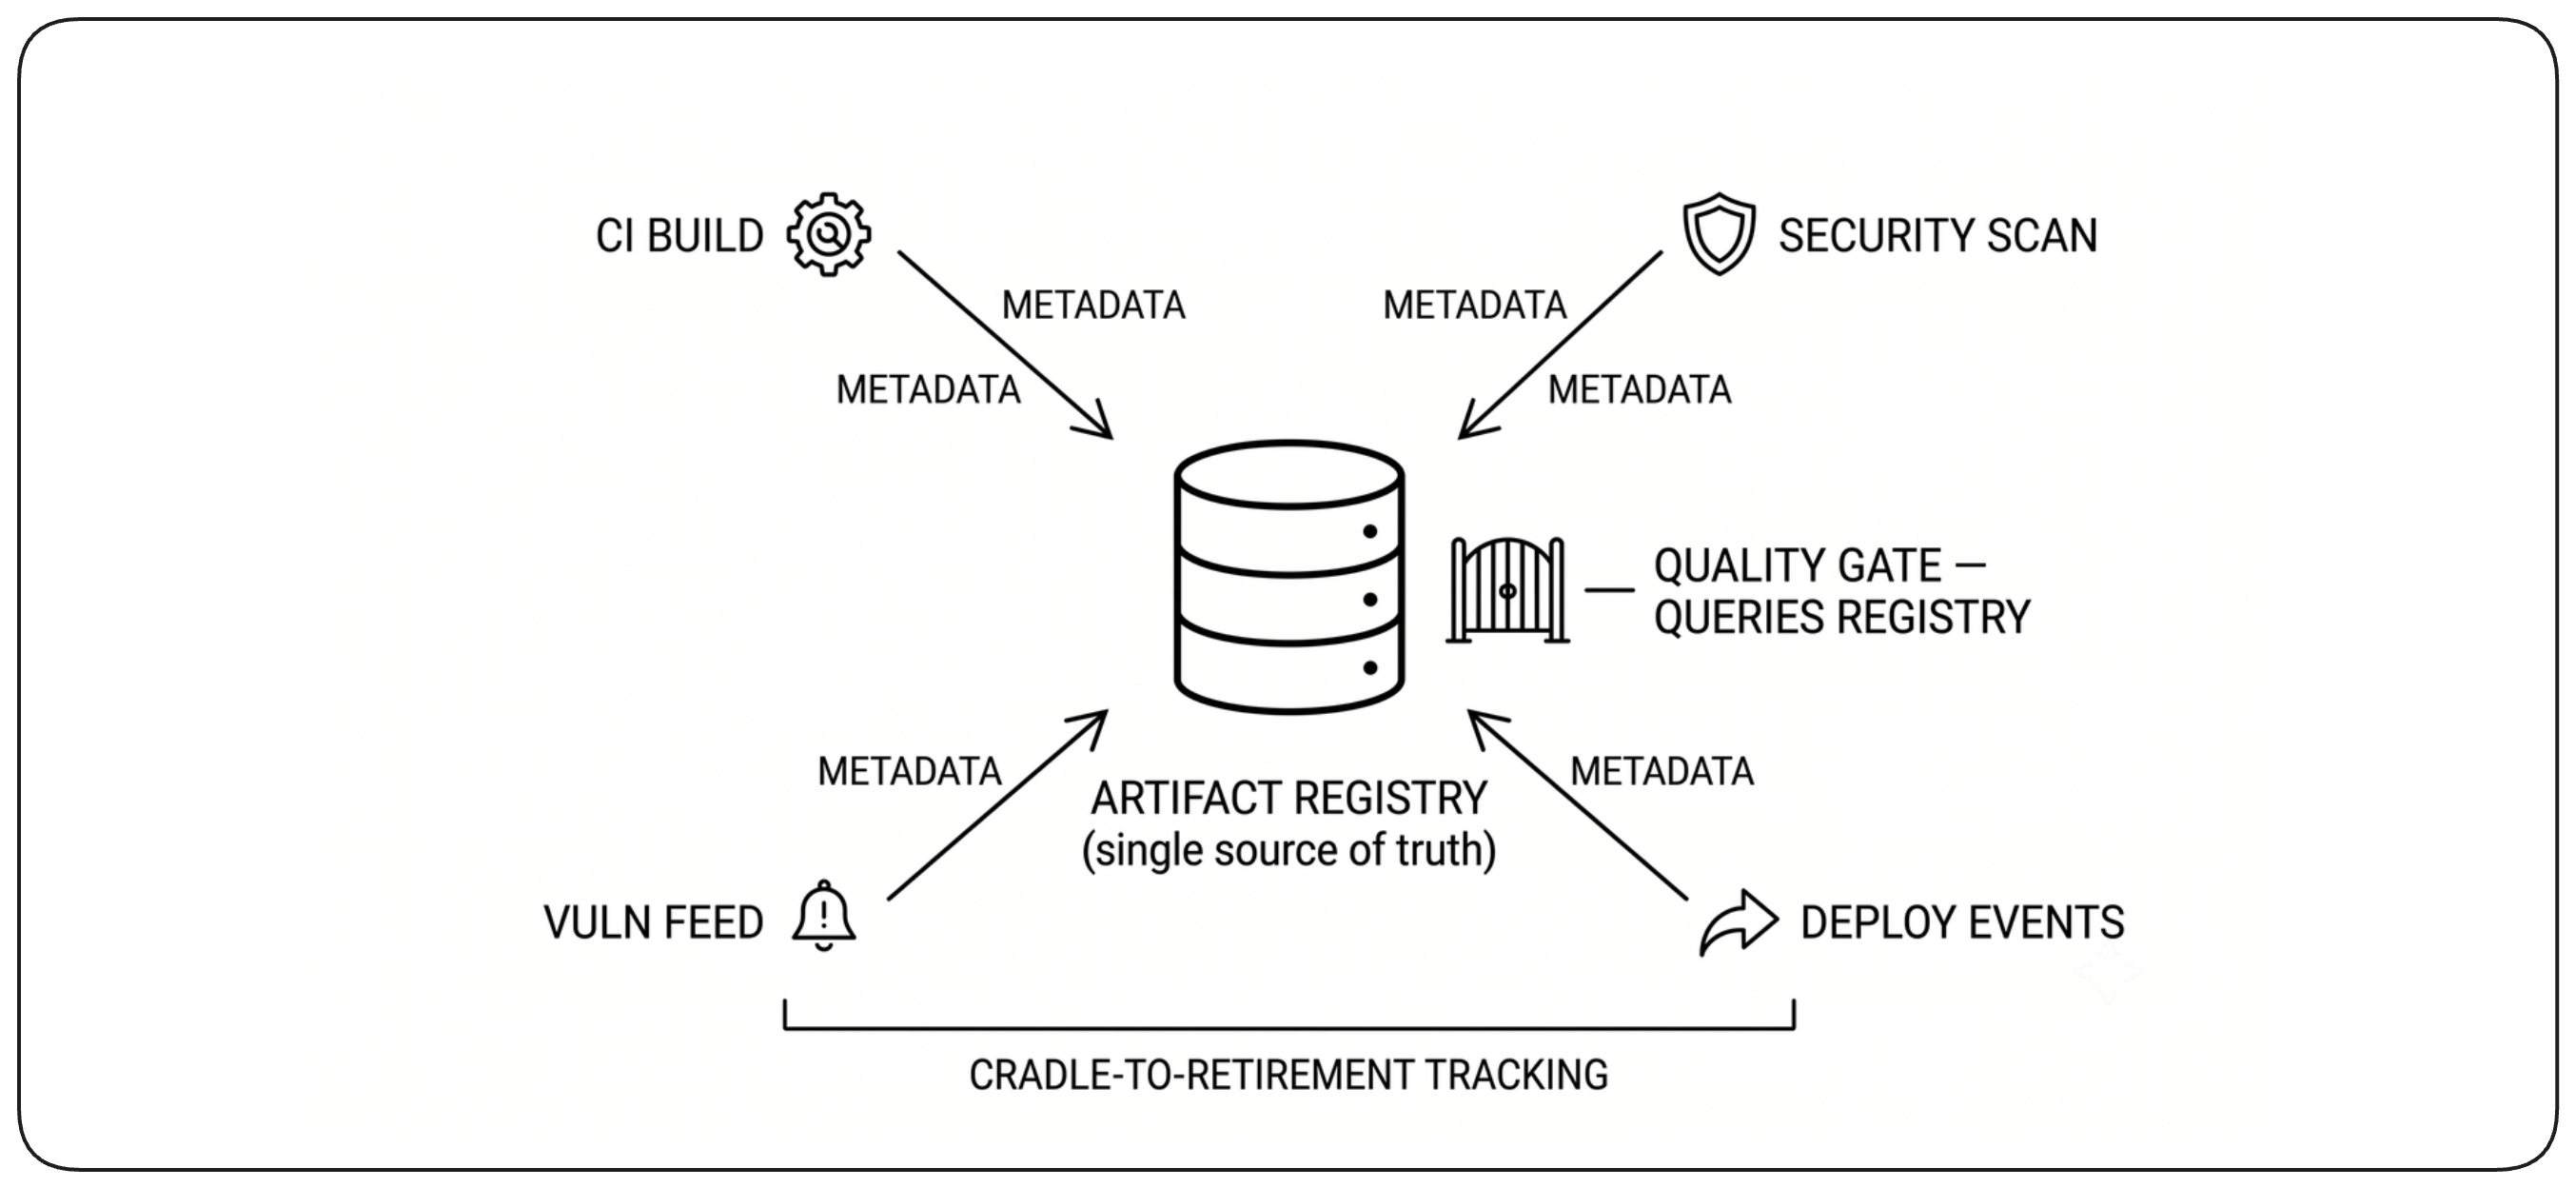
Conserver les preuves au-delà du pipeline
Les preuves évoluent tout au long du cycle de vie d’un artefact : provenance, constats de sécurité, résultats de validation, historique de déploiement et statut des vulnérabilités peuvent changer indépendamment. Ces preuves doivent rester associées durablement à l’artefact immuable, pour que les futures décisions de promotion ne dépendent pas de l’état transitoire du pipeline.
Rendre les changements traçables
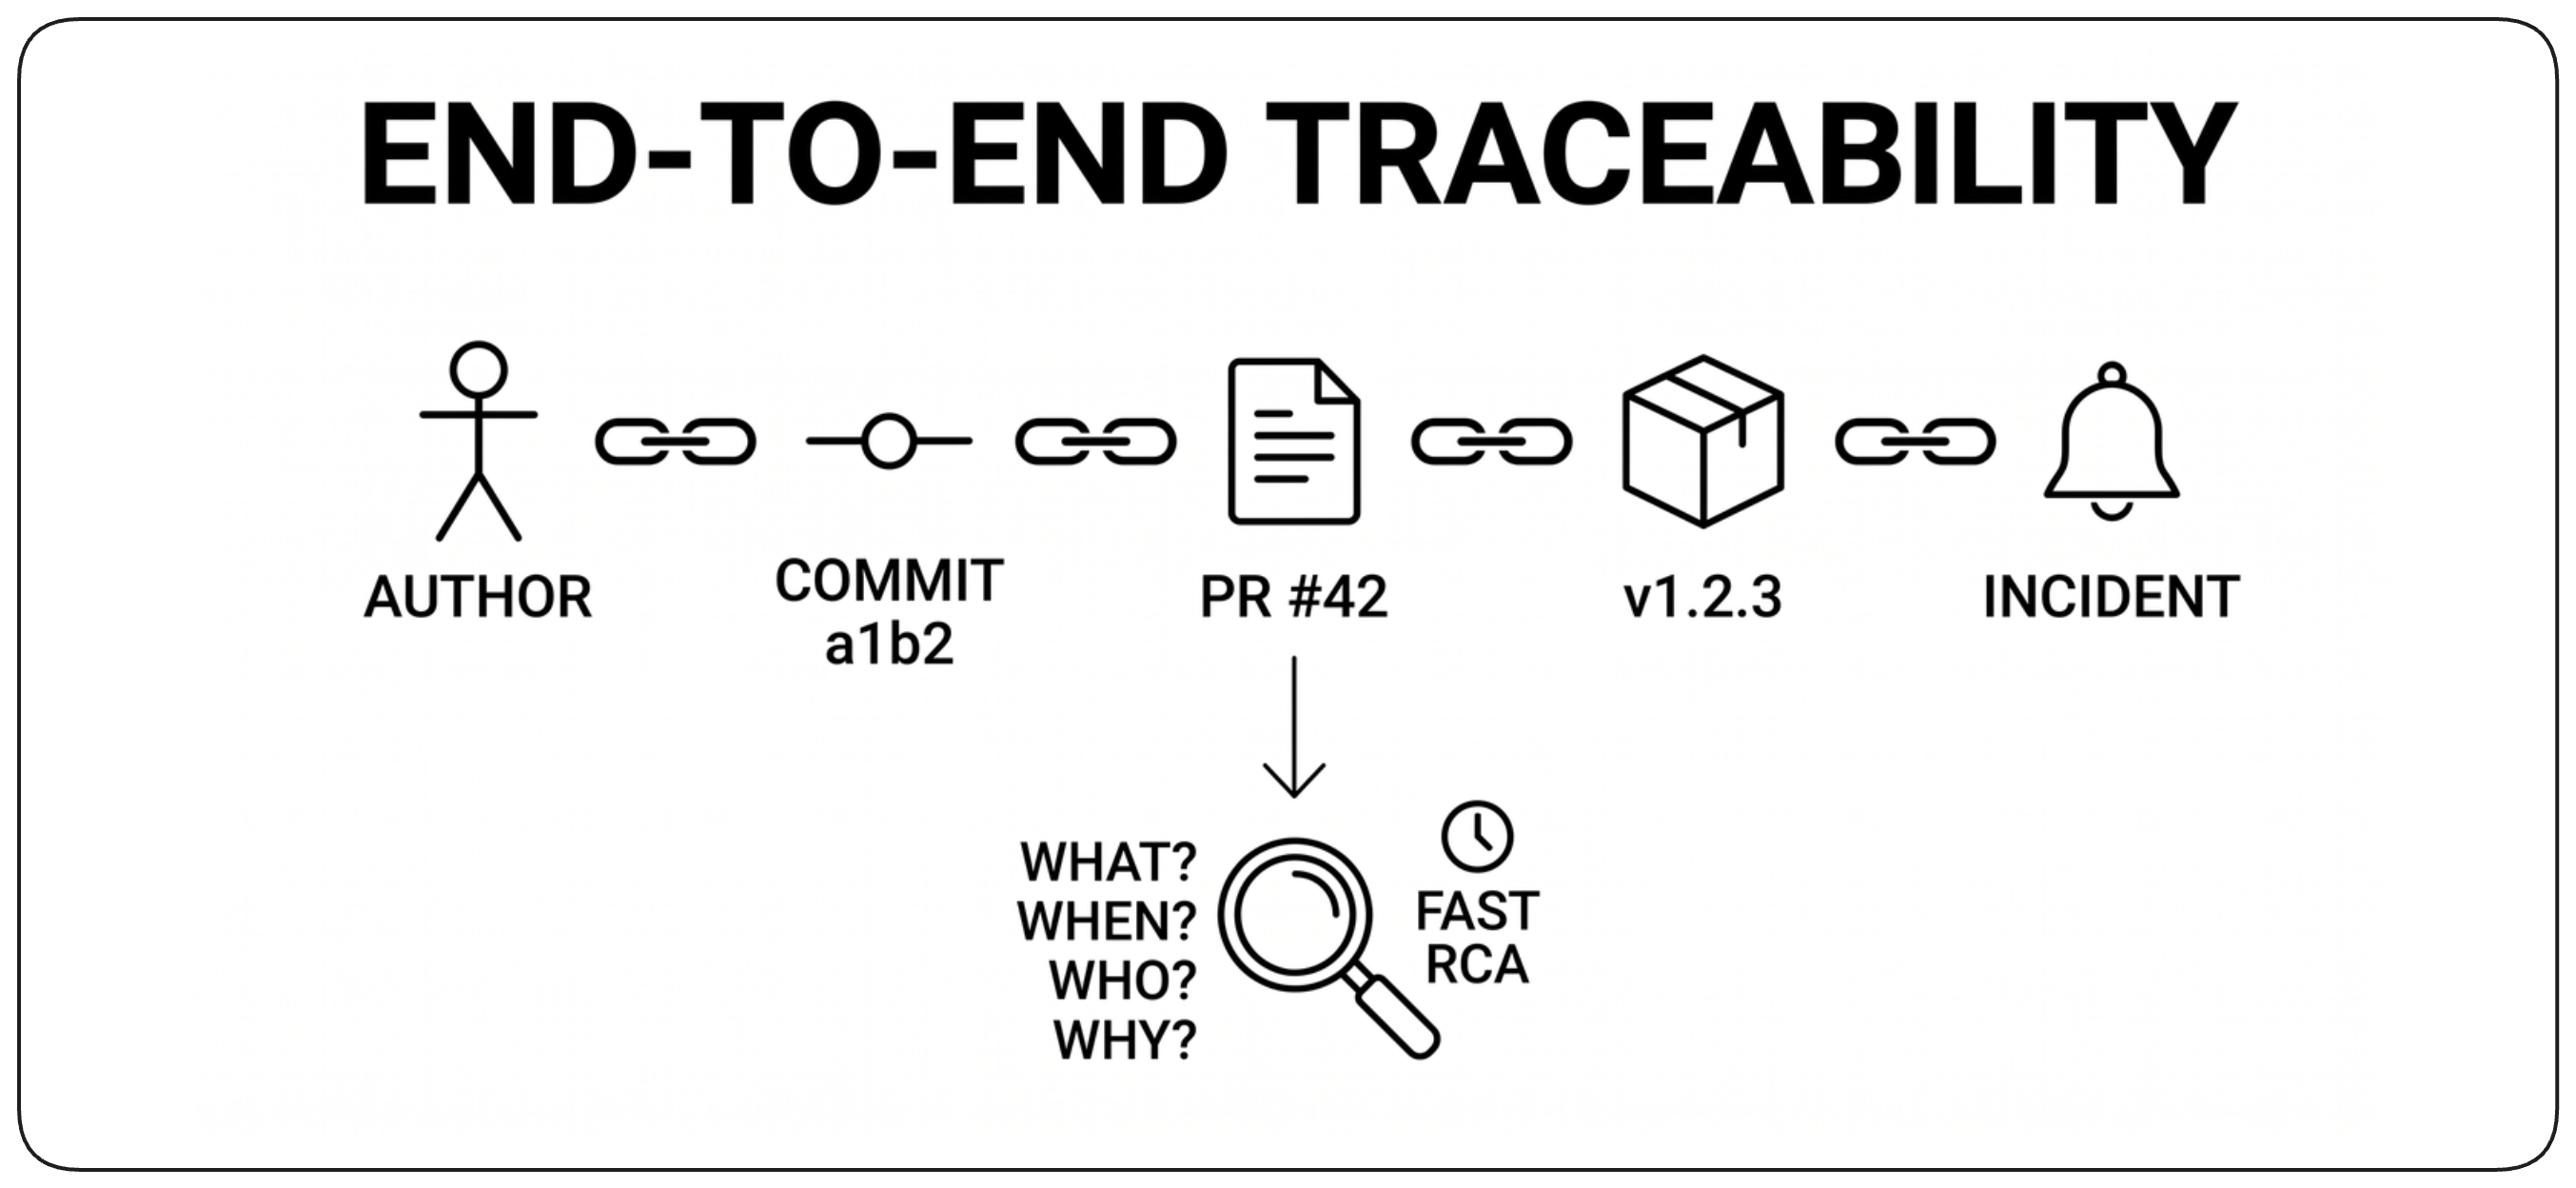
Chaque changement en production devrait être traçable jusqu’à son origine : ce qui a changé, quand, pourquoi, par qui et via quelle release. Relier l’état en cours d’exécution à son commit, sa revue, son artefact, ses approbations et son historique de déploiement transforme l’investigation d’incident d’un exercice de reconstitution en une simple consultation.
L’IA dans la gestion des releases
L’IA a besoin d’un système de release sur lequel raisonner
L’IA ne peut pas gérer le changement en sécurité à partir de scripts éparpillés, d’un état implicite et de procédures non documentées. Elle a besoin d’une intention de release explicite, d’identités immuables, de preuves durables, de résultats observables et de limites de politique déterministes. Les mêmes fondations qui rendent les releases compréhensibles pour les humains sont celles qui les rendent opérables par des agents.
L’IA déplace le goulot d’étranglement des releases
L’IA peut augmenter considérablement le rythme de production de changements prêts pour la production. L’exécution du déploiement est rarement le facteur limitant ; décider si chaque changement peut être exposé en sécurité devient le problème le plus difficile. Les systèmes de release doivent donc faire passer à l’échelle la prise de décision, pas seulement le débit de déploiement.
Des gates statiques aux décisions fondées sur les preuves
Les gates de release traditionnelles évaluent des conditions prédéfinies. L’IA peut raisonner sur un ensemble de preuves plus large — résultats de tests, constats de sécurité, historique de déploiement, signaux opérationnels, contexte du changement et incidents passés — pour aider à évaluer le risque d’une release. Les politiques déterministes continuent de définir les limites strictes ; l’IA apporte du jugement là où les preuves sont contextuelles.
Laisser le risque déterminer la stratégie de release
Tous les changements n’ont pas besoin du même chemin vers la production. Un système de release assisté par IA peut évaluer la nature et le risque d’un changement et recommander une stratégie adaptée : canary plus large ou plus étroit, exposition plus lente ou plus rapide, validation supplémentaire ou exigences d’approbation renforcées. Le chemin de release s’adapte au risque au lieu d’être identique pour chaque changement.
L’IA peut observer le rollout en continu
La livraison progressive produit des preuves continues à mesure que l’exposition grandit. L’IA peut corréler métriques, logs, traces, événements de déploiement et comportement historique pour repérer des schémas anormaux que des seuils individuels peuvent manquer. Chaque palier du rollout devient l’occasion de réévaluer si l’exposition doit continuer, être suspendue ou être inversée.
L’IA raccourcit le chemin de la défaillance à la reprise
Quand une release dégrade la production, le premier défi est souvent de comprendre ce qui a changé et quel chemin de reprise est sûr. L’IA peut corréler la release résolue, les changements récents, les signaux opérationnels et les schémas de défaillance connus pour proposer rapidement les causes probables et des actions de reprise éprouvées. La reprise reste contrôlée par des mécanismes prédéfinis ; l’IA réduit le temps nécessaire pour choisir parmi eux.
Les plateformes de release deviennent des control planes agentiques
À mesure que les systèmes de release accumulent intention structurée, preuves, politiques, état opérationnel et connaissances de reprise, ils deviennent des plateformes naturelles pour des agents de release. Les agents peuvent évaluer le risque, recommander une promotion, observer l’exposition, investiguer les défaillances et coordonner la reprise — tandis que des control planes déterministes gardent l’autorité sur les actions autorisées. La plateforme de release passe d’un moteur d’exécution à un control plane intelligent du changement.
Architecture d’une plateforme de release
Le moteur de release monolithique
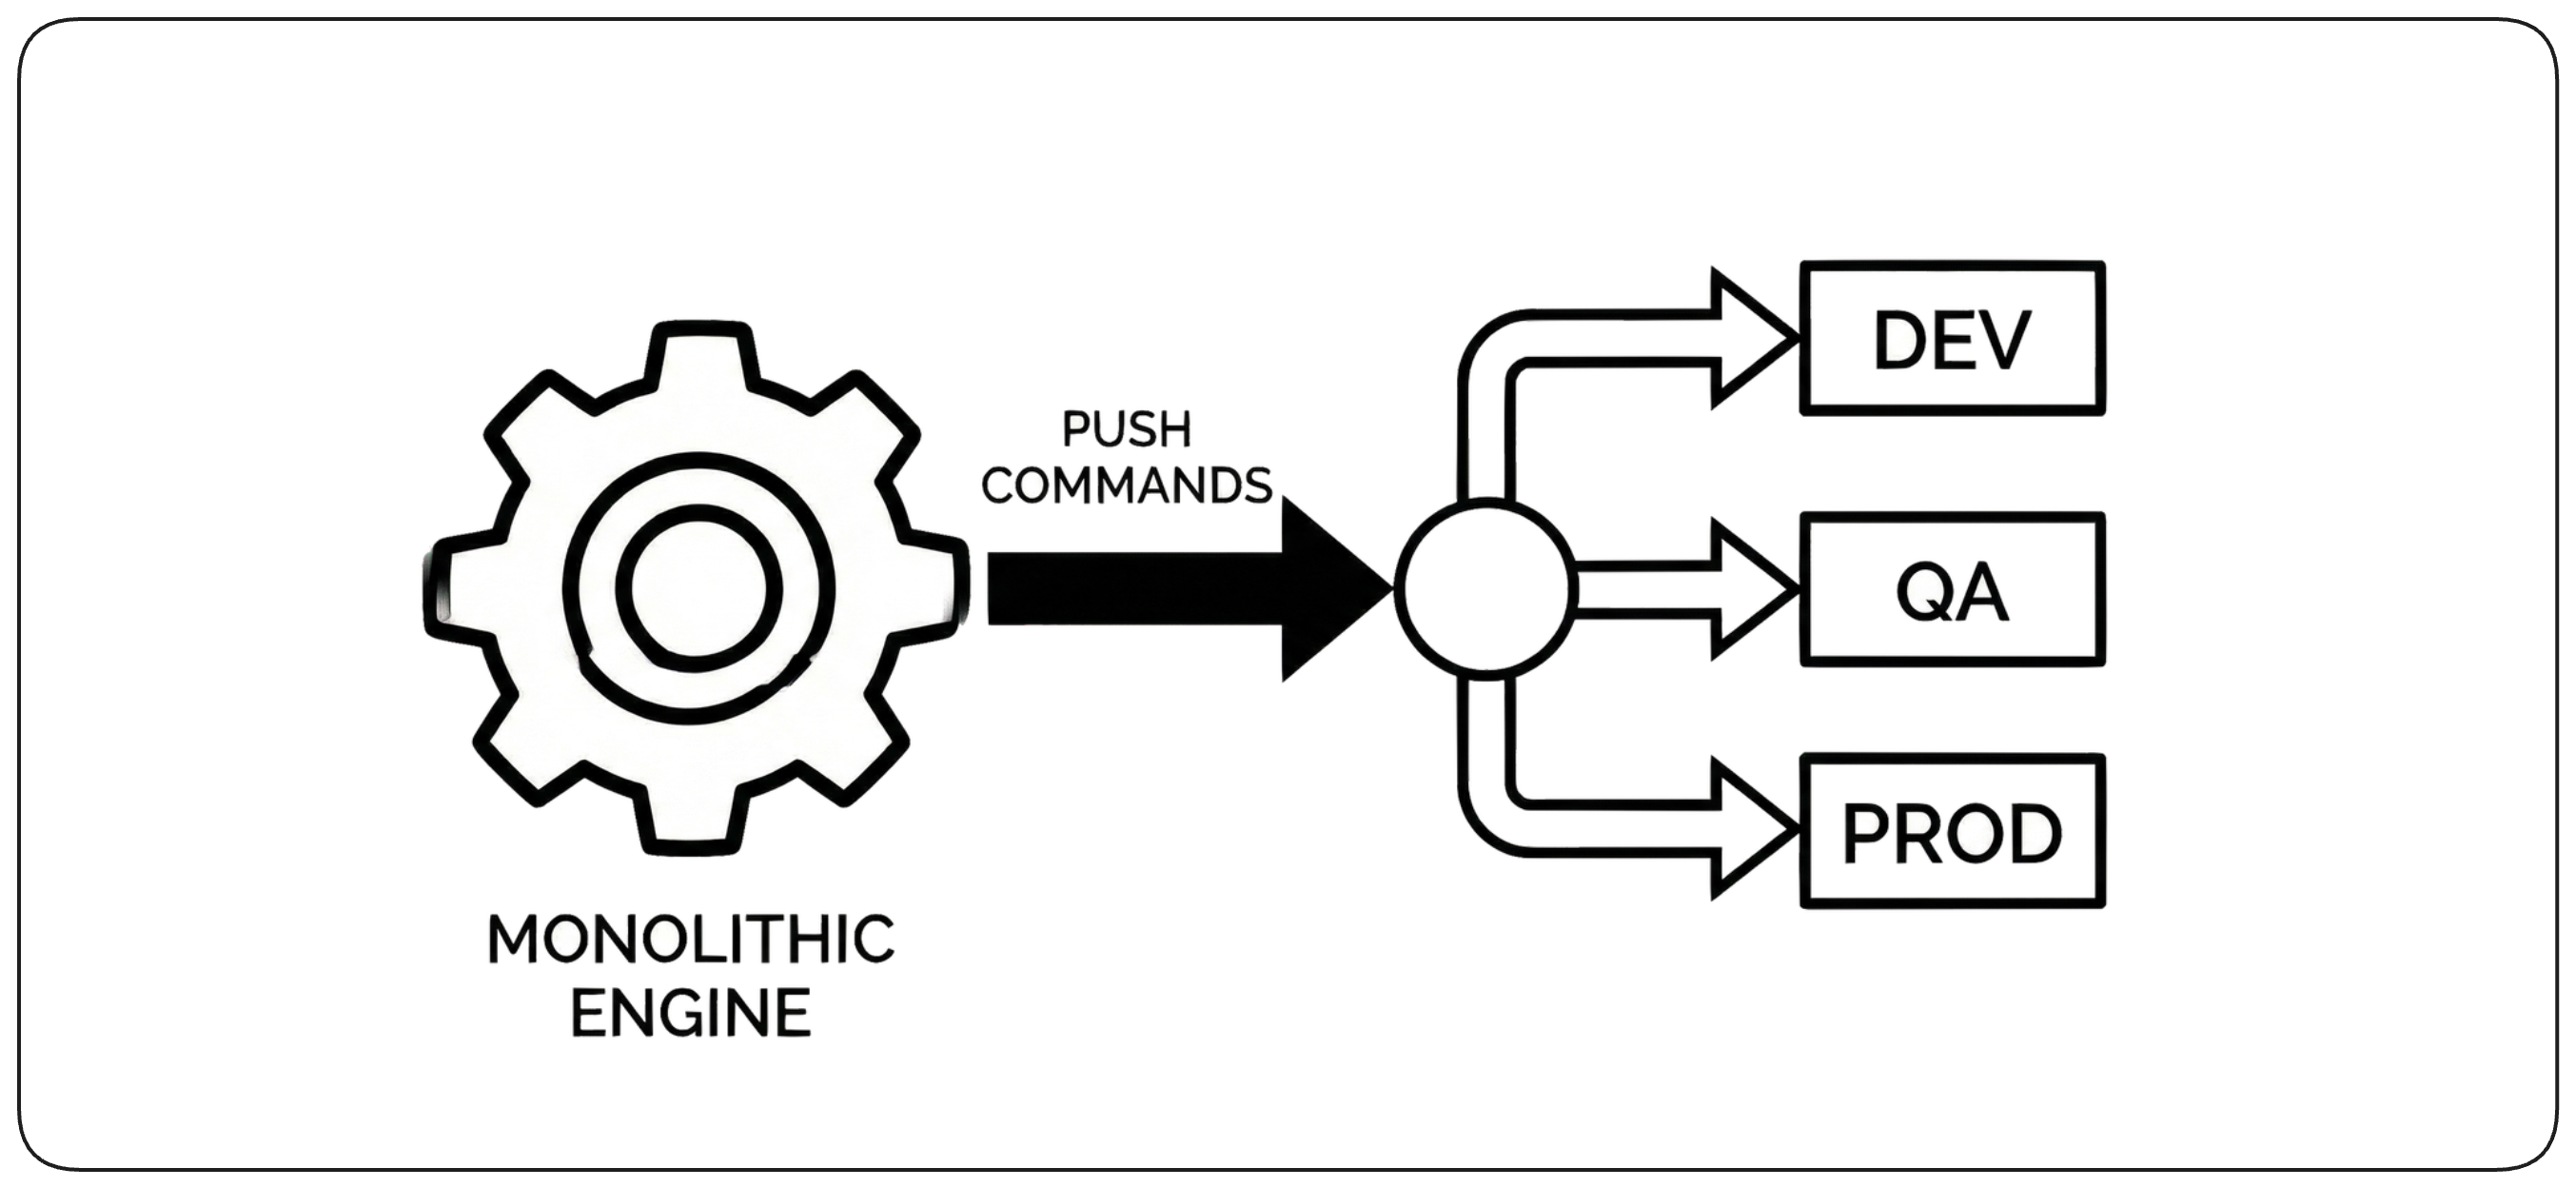
Un moteur de release monolithique pousse les changements de façon centralisée vers chaque cible. Cela concentre au même endroit les identifiants, l’exécution et la gestion des échecs, créant un goulot d’étranglement de scalabilité et un grand rayon d’impact. Les problèmes d’une cible peuvent bloquer des releases sans rapport, et les changements du moteur lui-même affectent tout le système de livraison.
Le control plane distribué
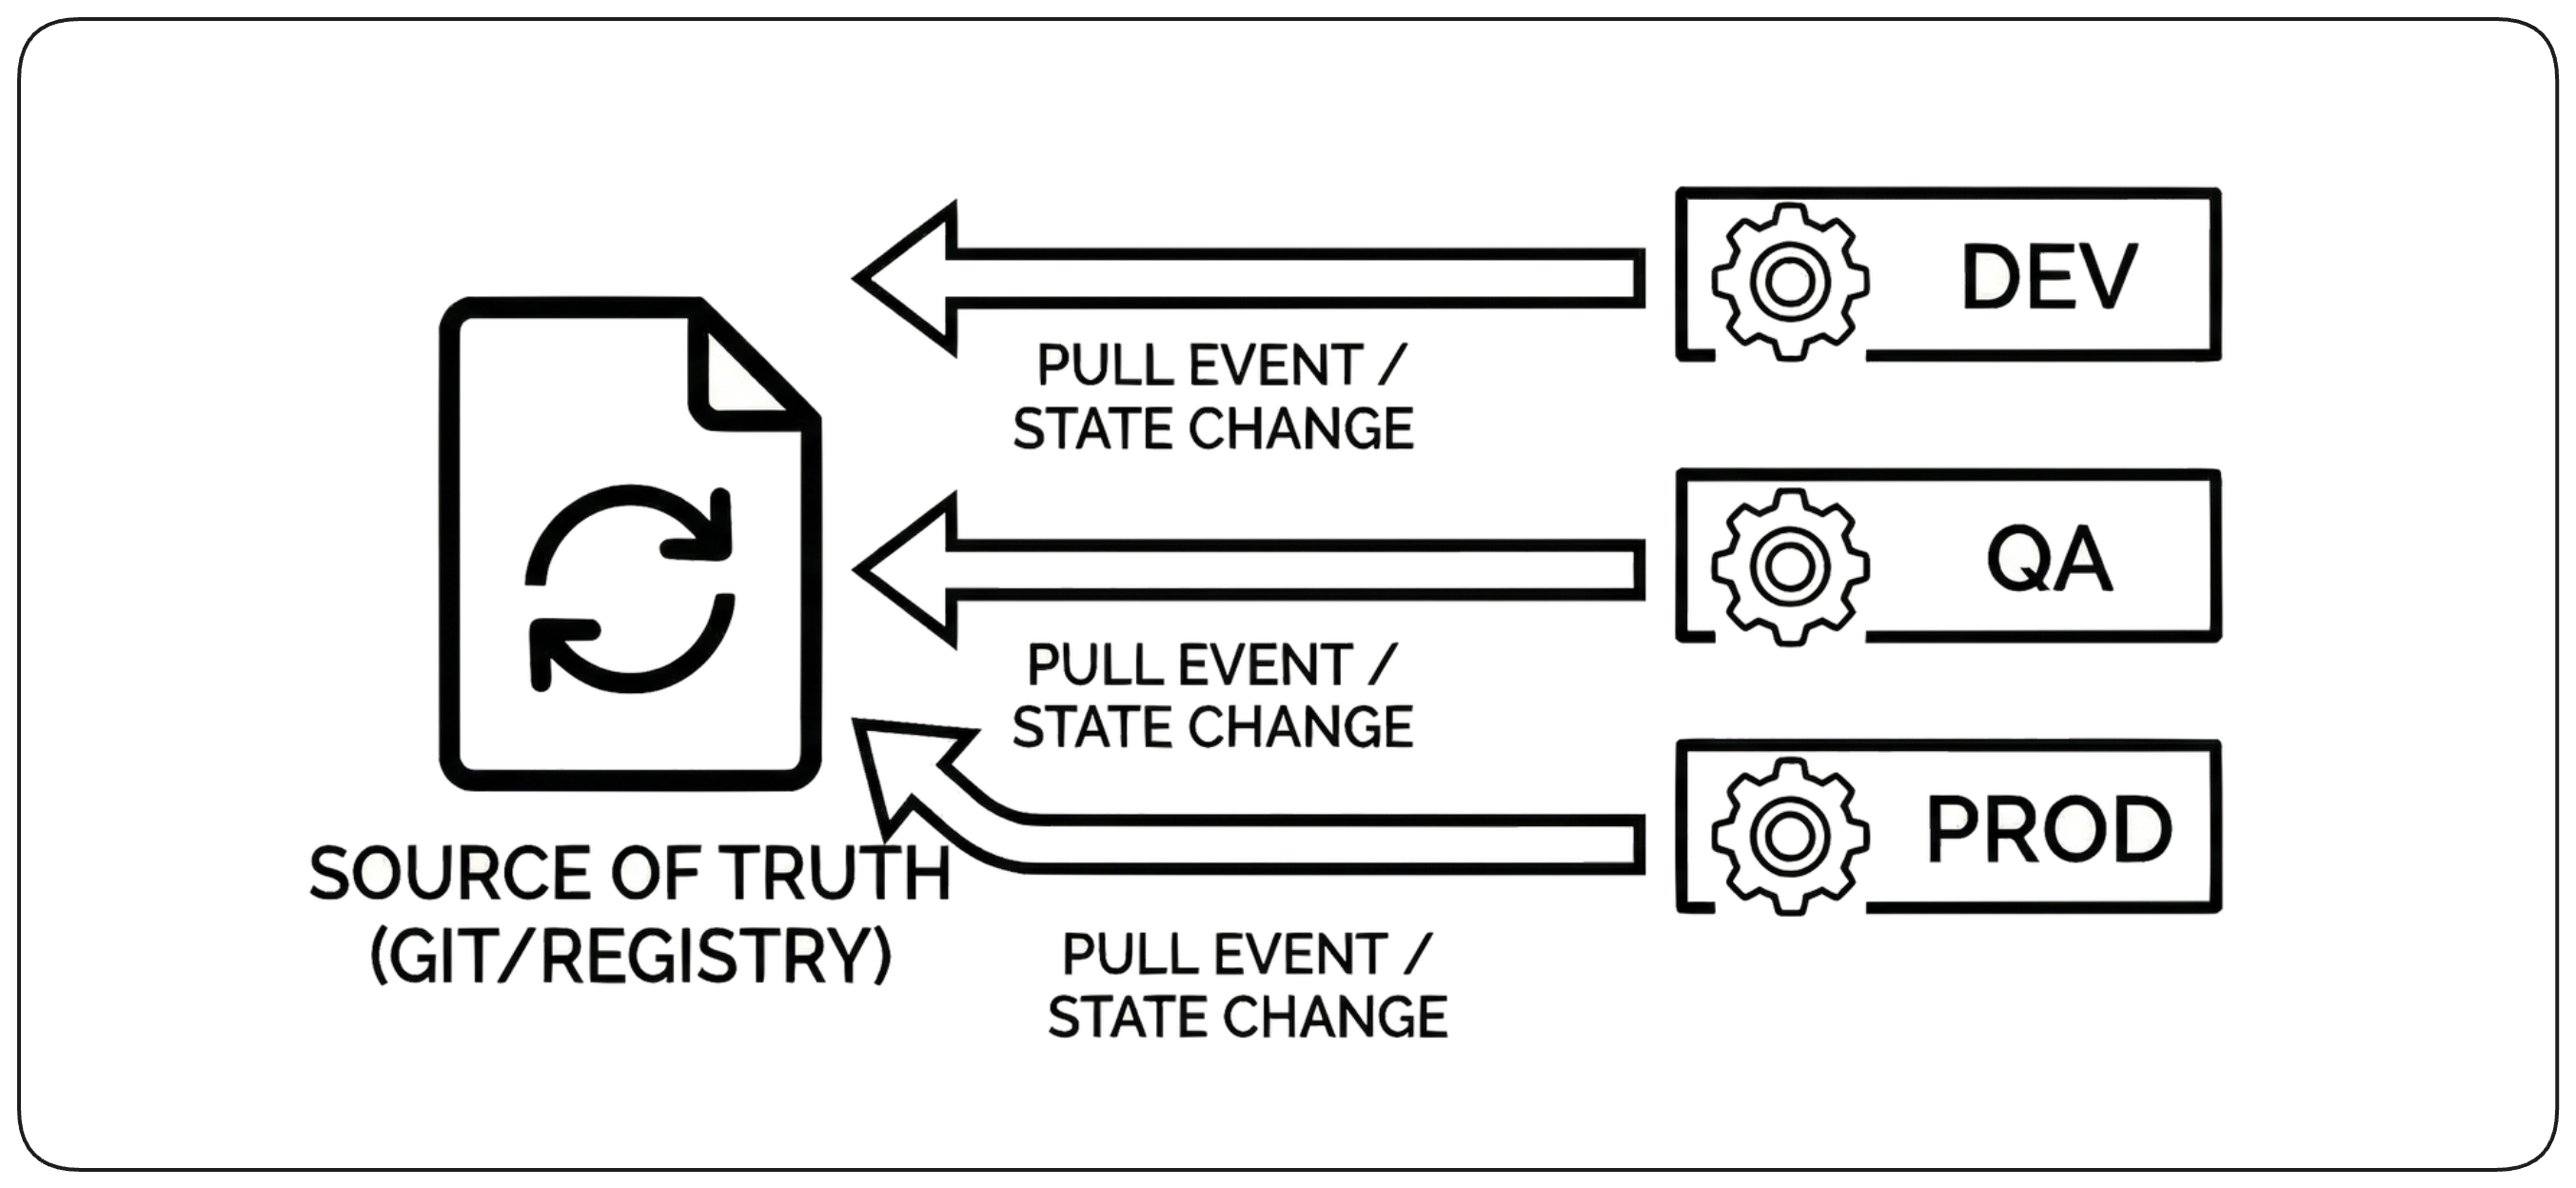
L’exécution distribuée rapproche l’activité de release de chaque cible. Des agents autonomes tirent l’état désiré et le réconcilient localement, ce qui permet d’isoler par environnement la capacité d’exécution et les défaillances. Le système central n’a plus besoin d’effectuer lui-même chaque déploiement.
Gouvernance centralisée
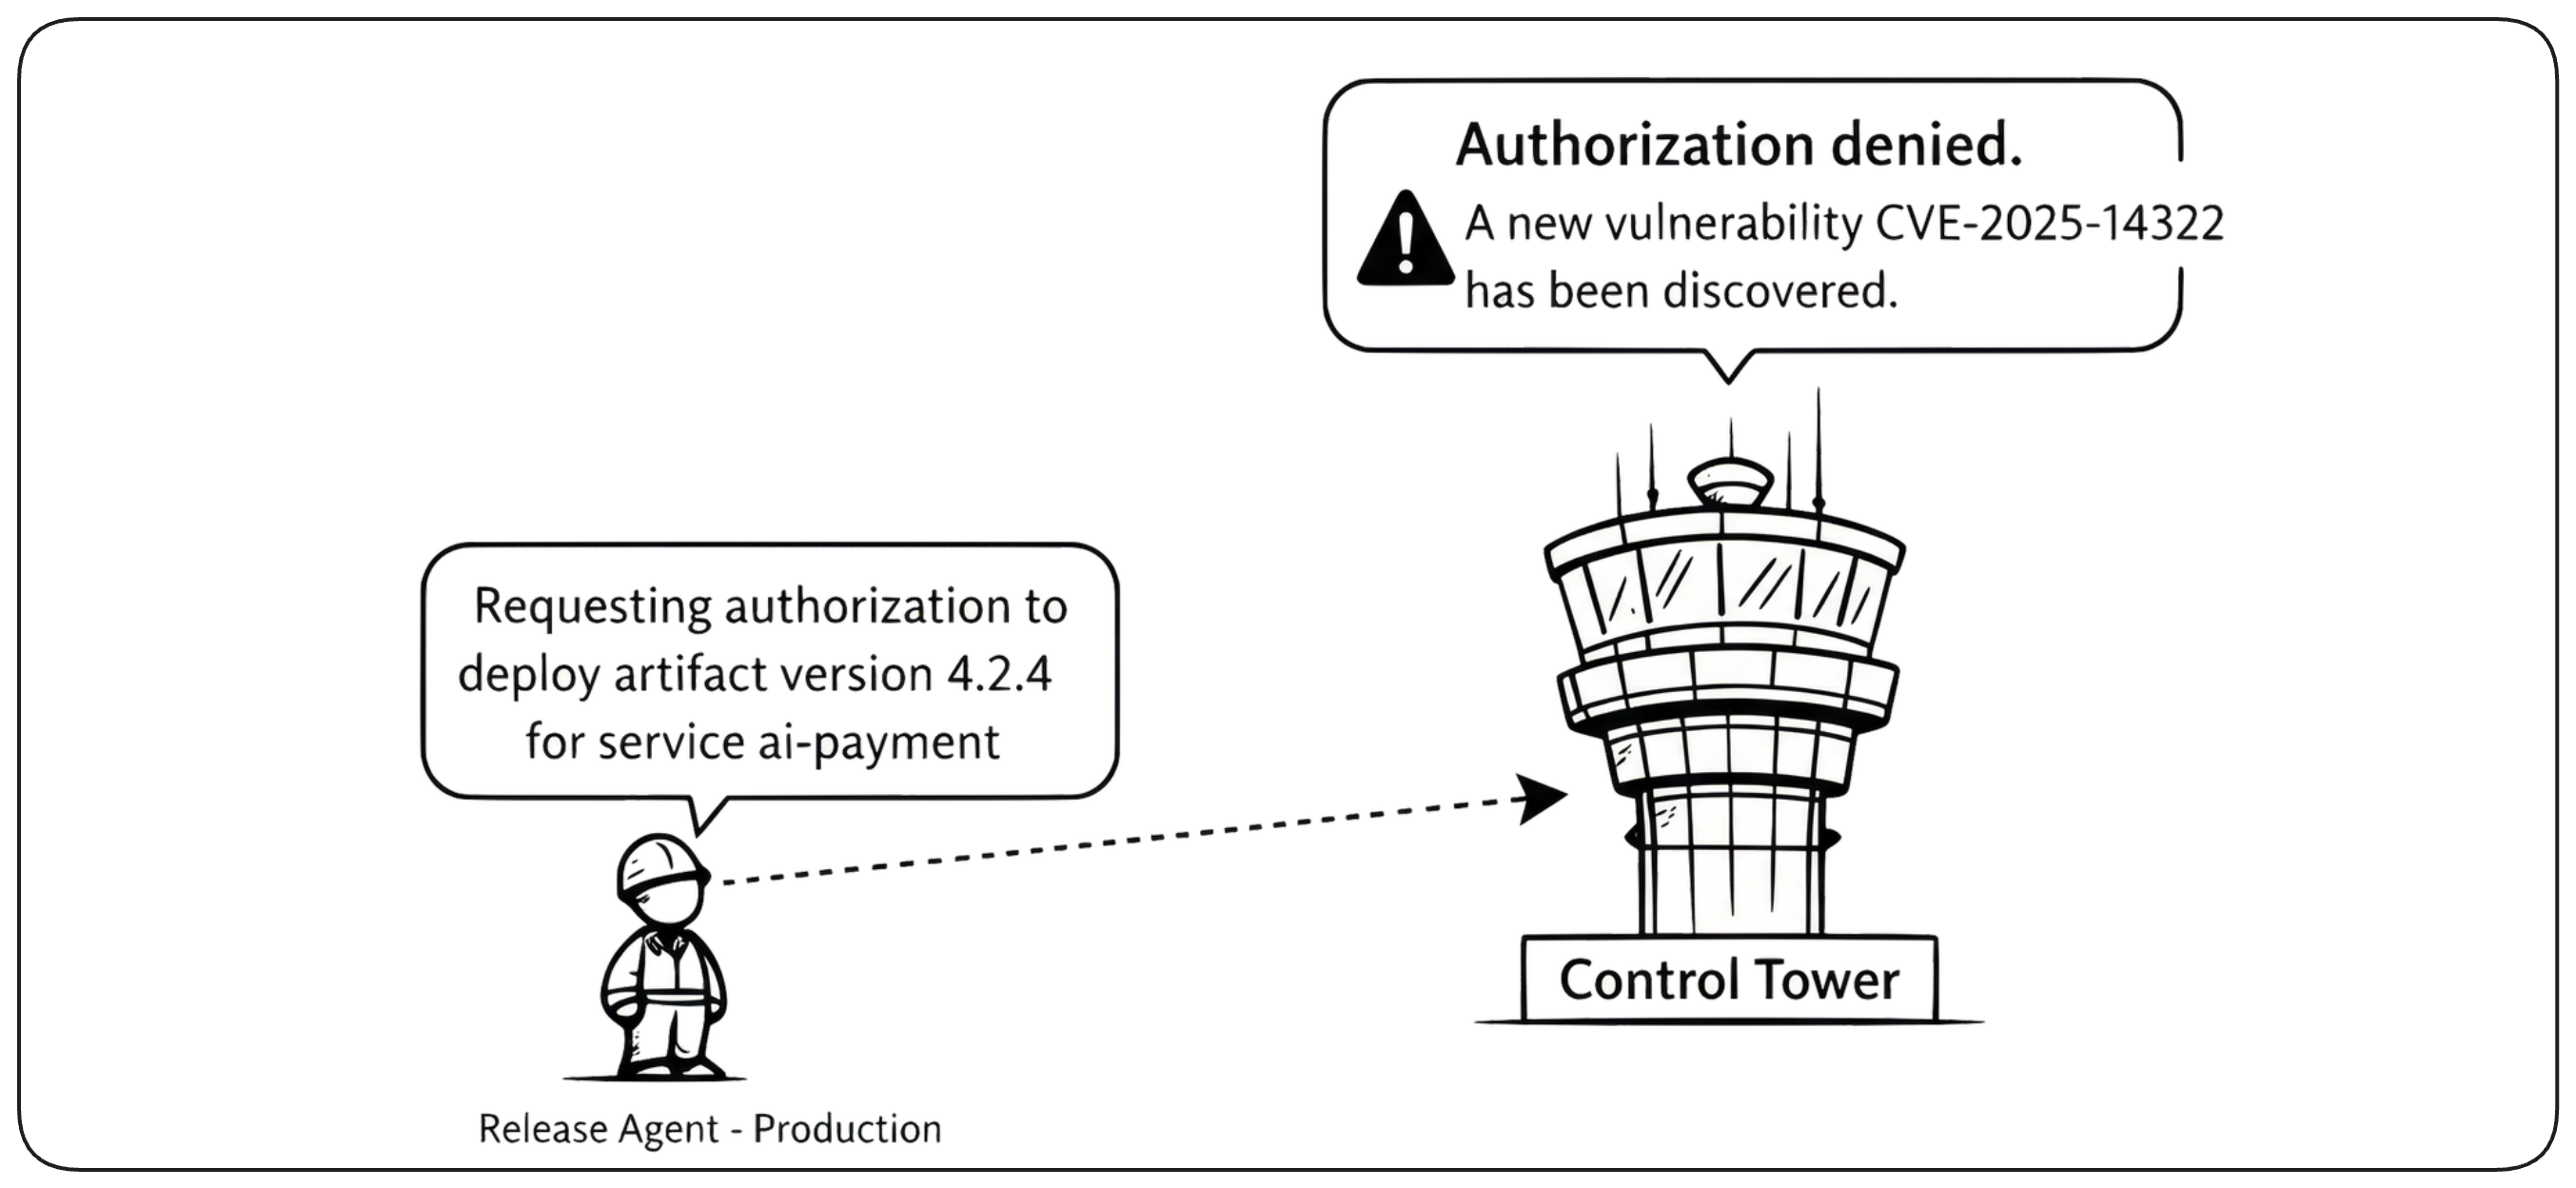
L’exécution peut être distribuée tandis que l’autorité reste centralisée. Une couche de gouvernance évalue les contraintes globales — sécurité, conformité, fenêtres de release et politique métier — avant d’autoriser un changement. Les agents locaux exécutent ensuite de façon autonome et remontent leur état et leurs résultats, ce qui préserve le contrôle centralisé sans centraliser l’exécution.
Un rollout graduel pour tous les systèmes de livraison
L’infrastructure de release est de l’infrastructure de production. Les systèmes CI/CD, les CLI, les politiques et les composants de plateforme doivent donc évoluer avec les mêmes pratiques de rollout contrôlé que les services exposés aux clients. Un changement défectueux dans la plateforme de livraison peut affecter la capacité de l’organisation à livrer ou à récupérer ; son rayon d’impact doit donc lui aussi être limité.
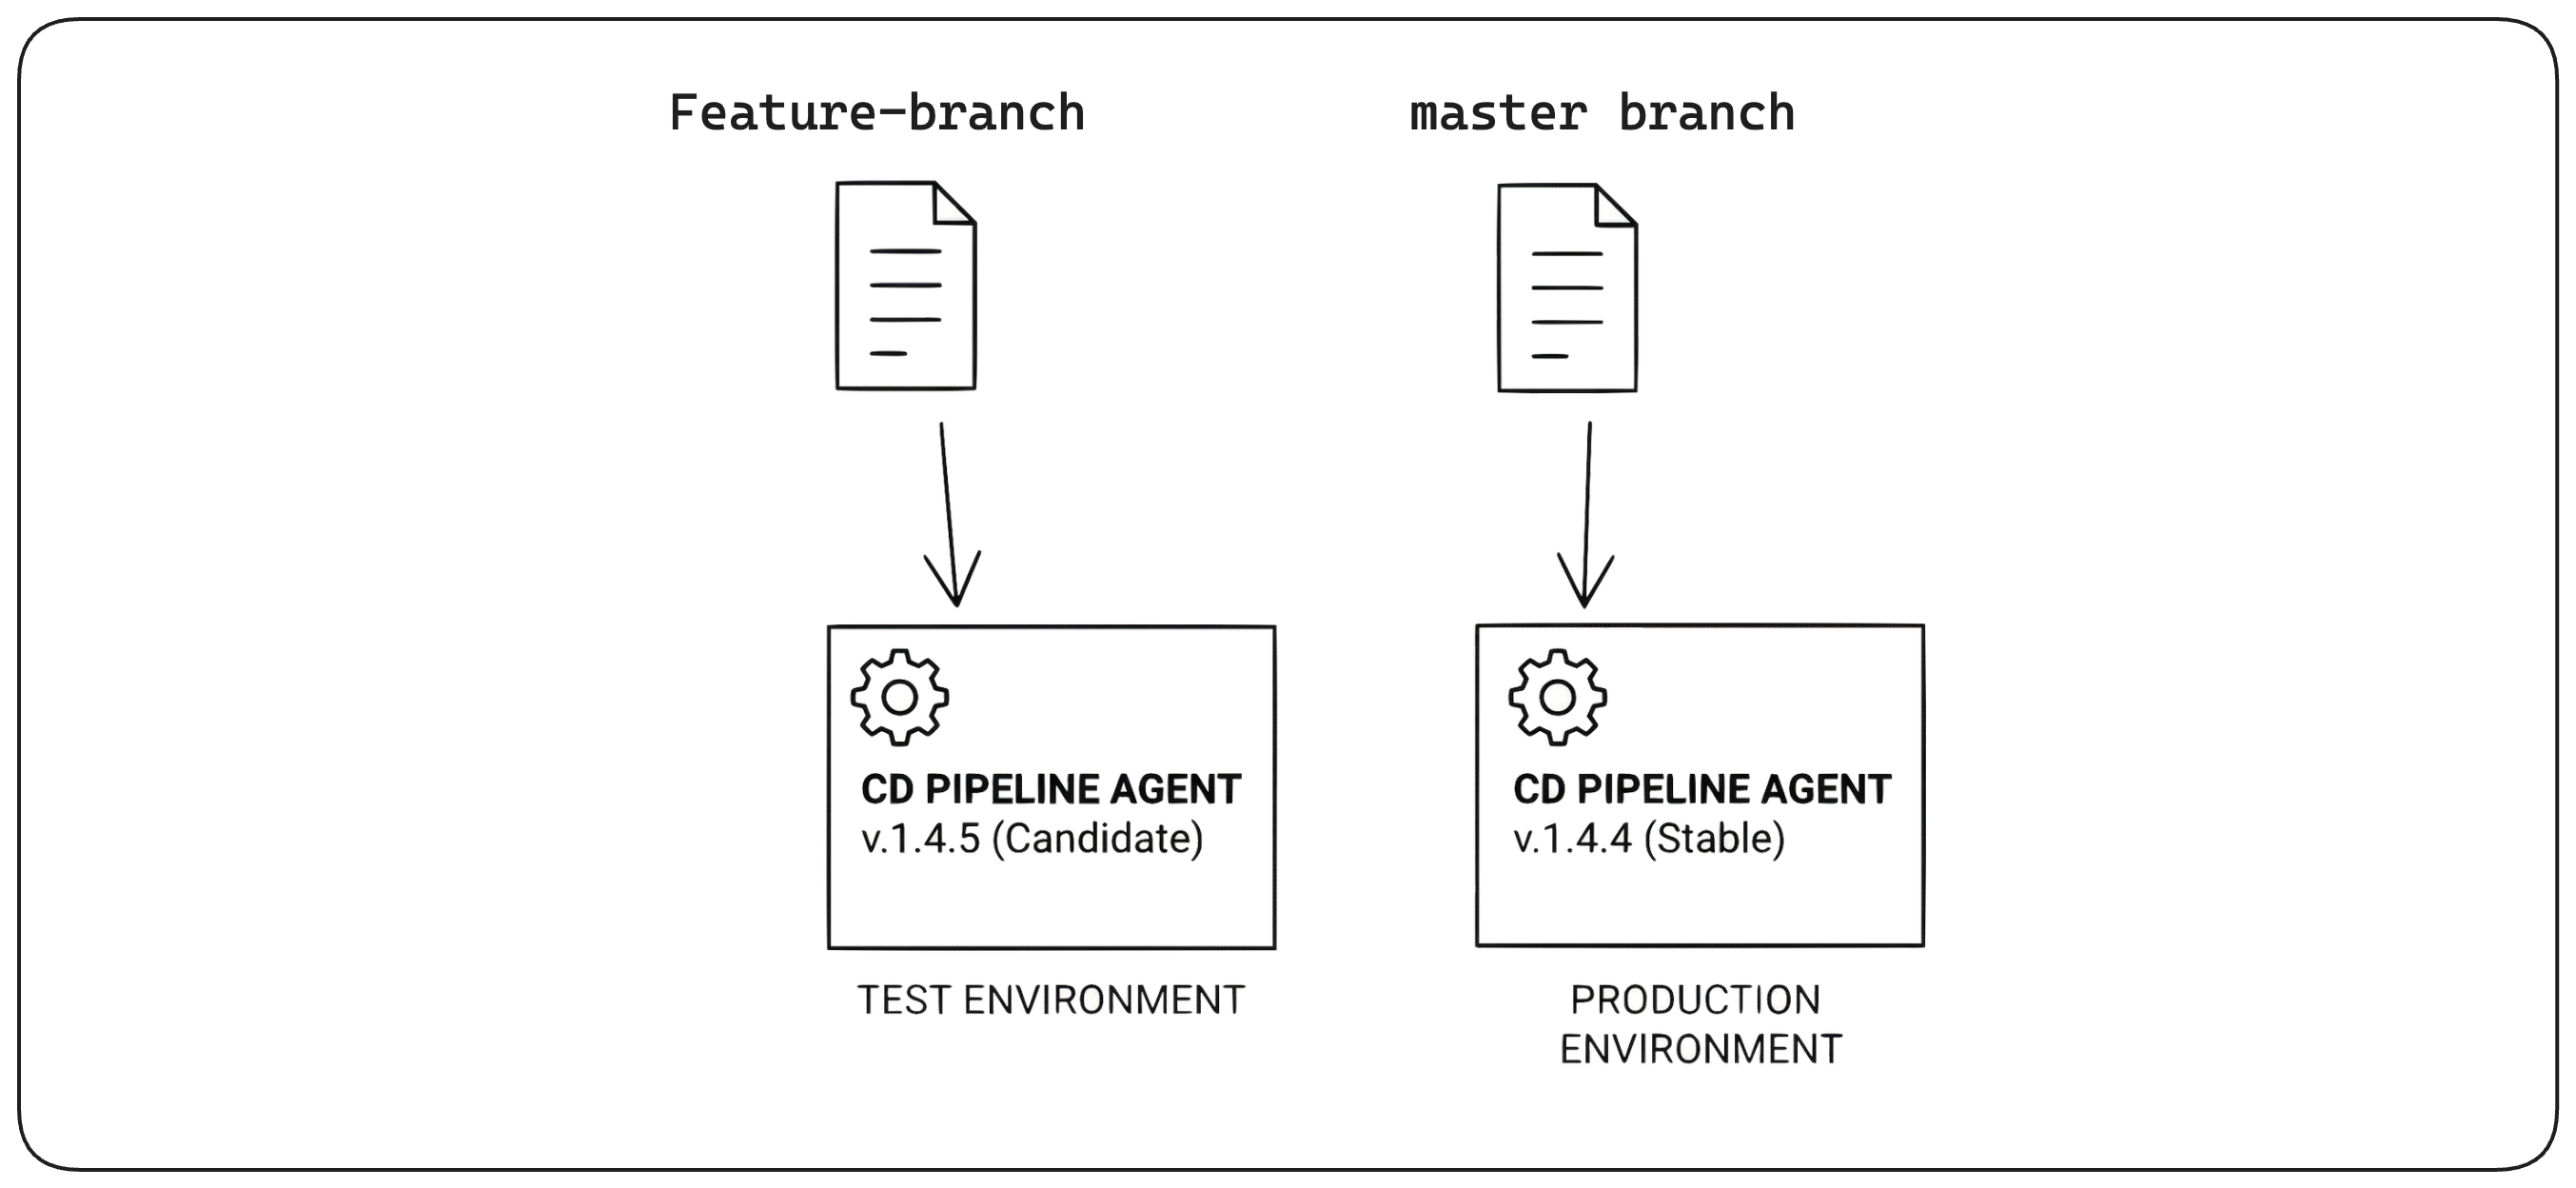
CD évolutif : le pipeline comme produit
La plateforme de release doit évoluer selon le même cycle de vie que celui qu’elle fournit aux applications. Les agents de release et les composants de pipeline sont des artefacts versionnés qui peuvent être validés dans des environnements à risque plus faible puis promus progressivement. Le mécanisme de livraison devient ainsi un produit qui peut évoluer sans changer partout en même temps.
Échecs de déploiement et reprise
Les échecs de déploiement sont attendus
Les échecs de déploiement sont inévitables ; la reprise doit donc être conçue avant qu’ils ne surviennent. L’objectif n’est pas seulement de réduire la probabilité d’échec, mais de détecter rapidement les transitions dégradées, de stabiliser le service et de restaurer un état sain connu avec un minimum d’incertitude.
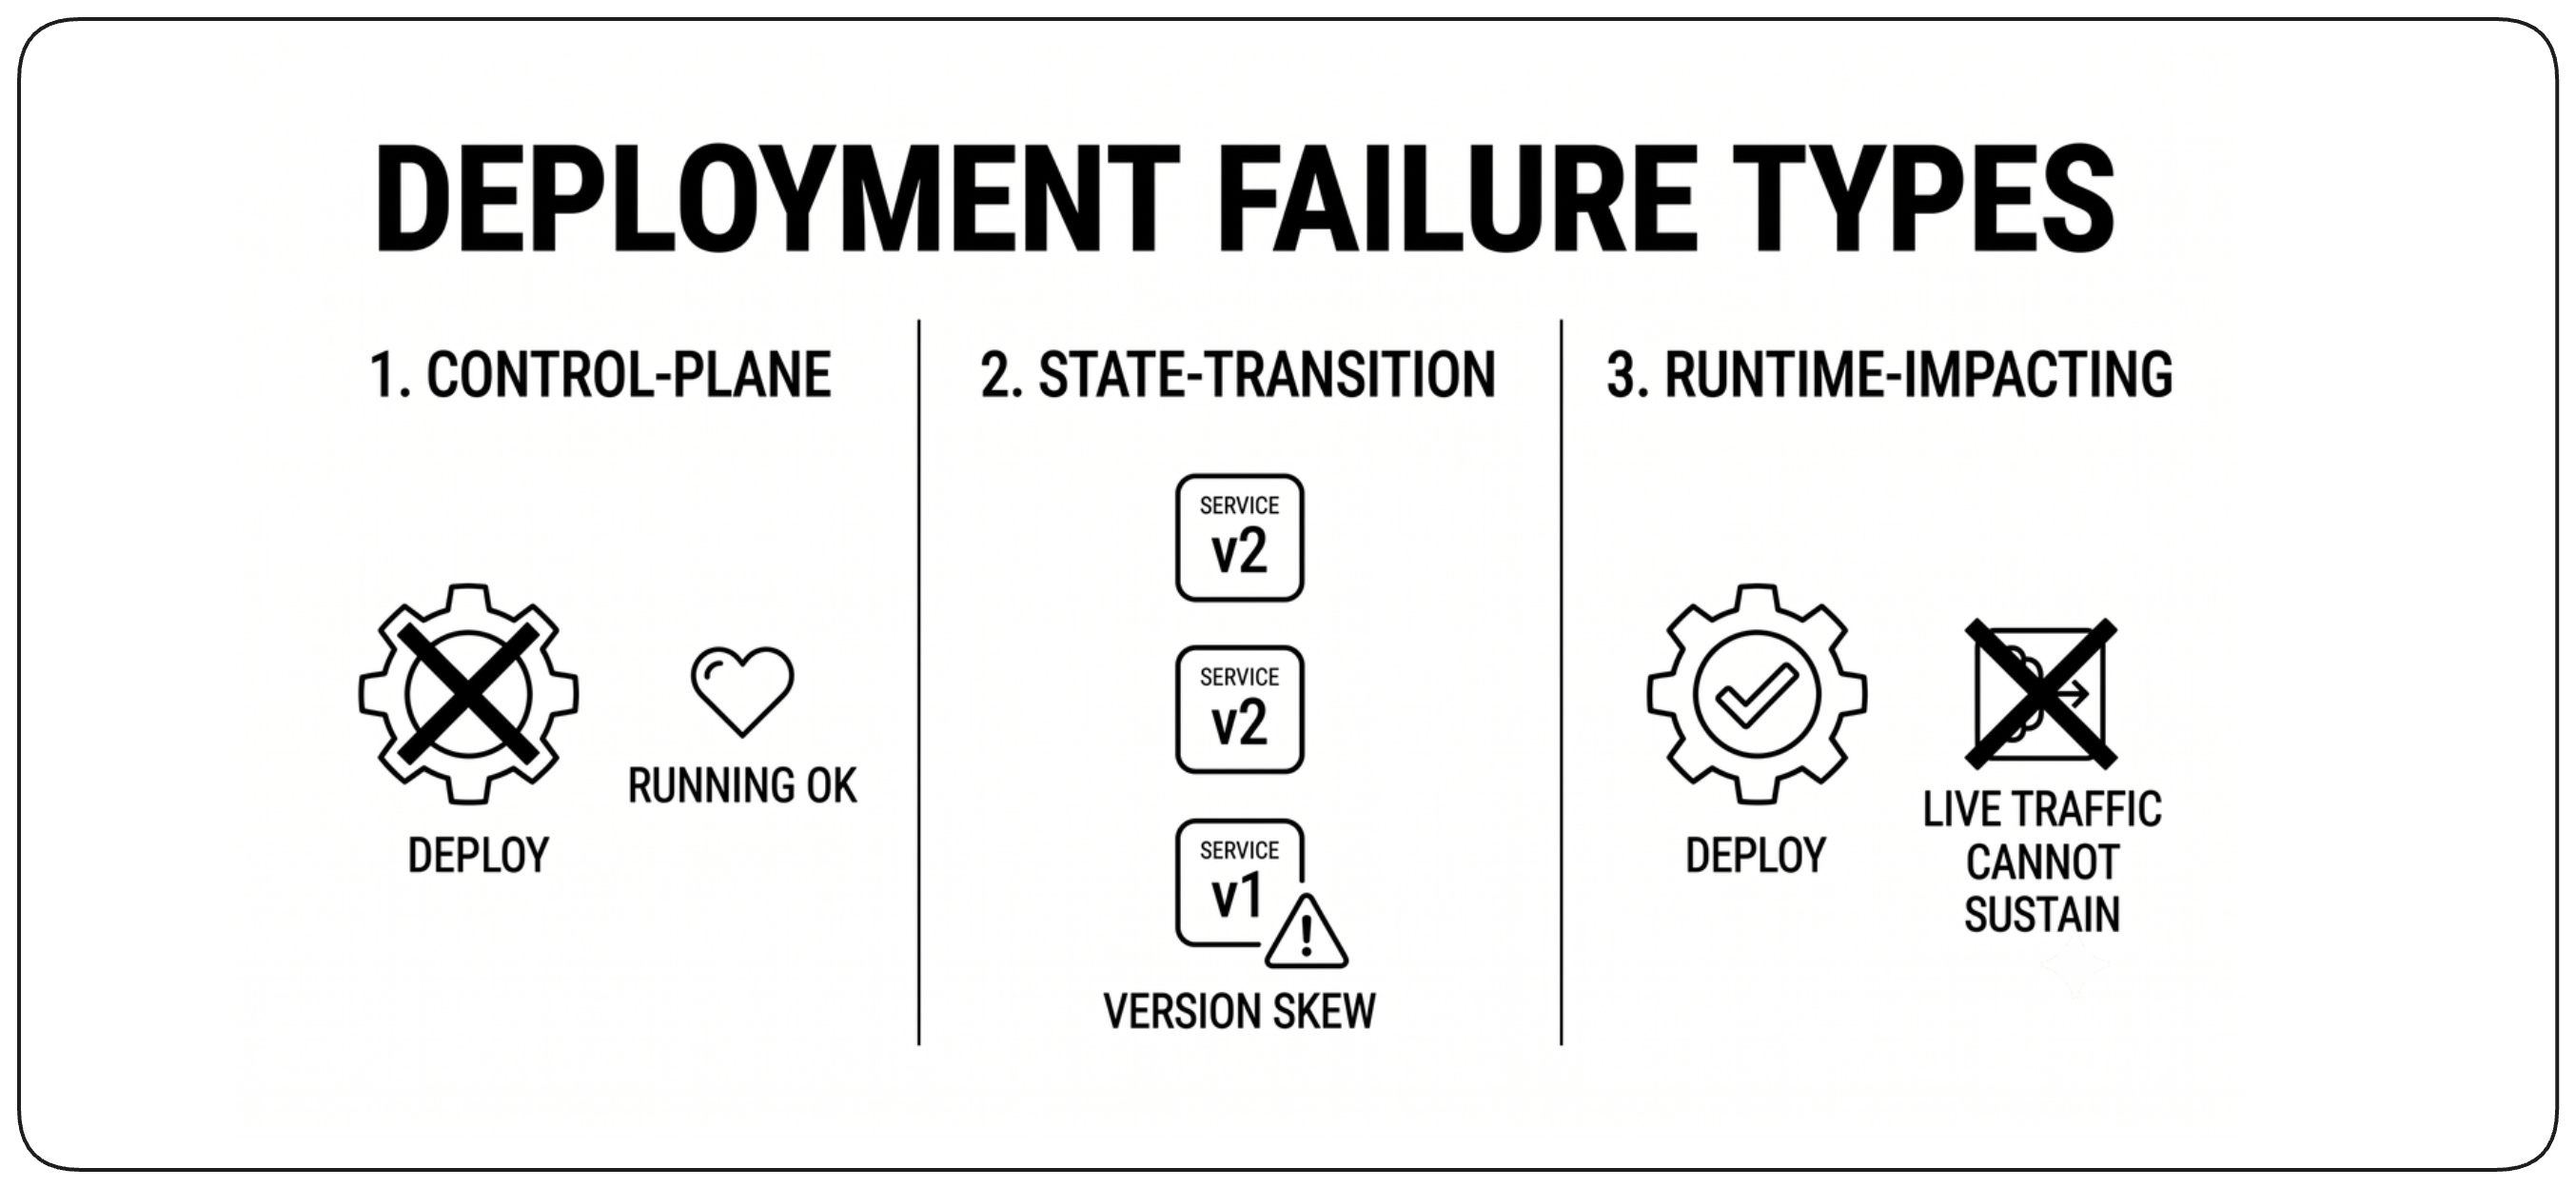
Trois types d’échec de déploiement
Les échecs de déploiement se répartissent en trois grandes catégories. Les échecs de control plane empêchent le mécanisme de déploiement d’établir l’état demandé alors que le service en cours d’exécution peut rester sain. Les échecs de transition d’état laissent le système partiellement mis à jour ou incohérent. Les échecs à impact runtime établissent bien le nouvel état, mais celui-ci ne peut pas soutenir le comportement attendu en production.
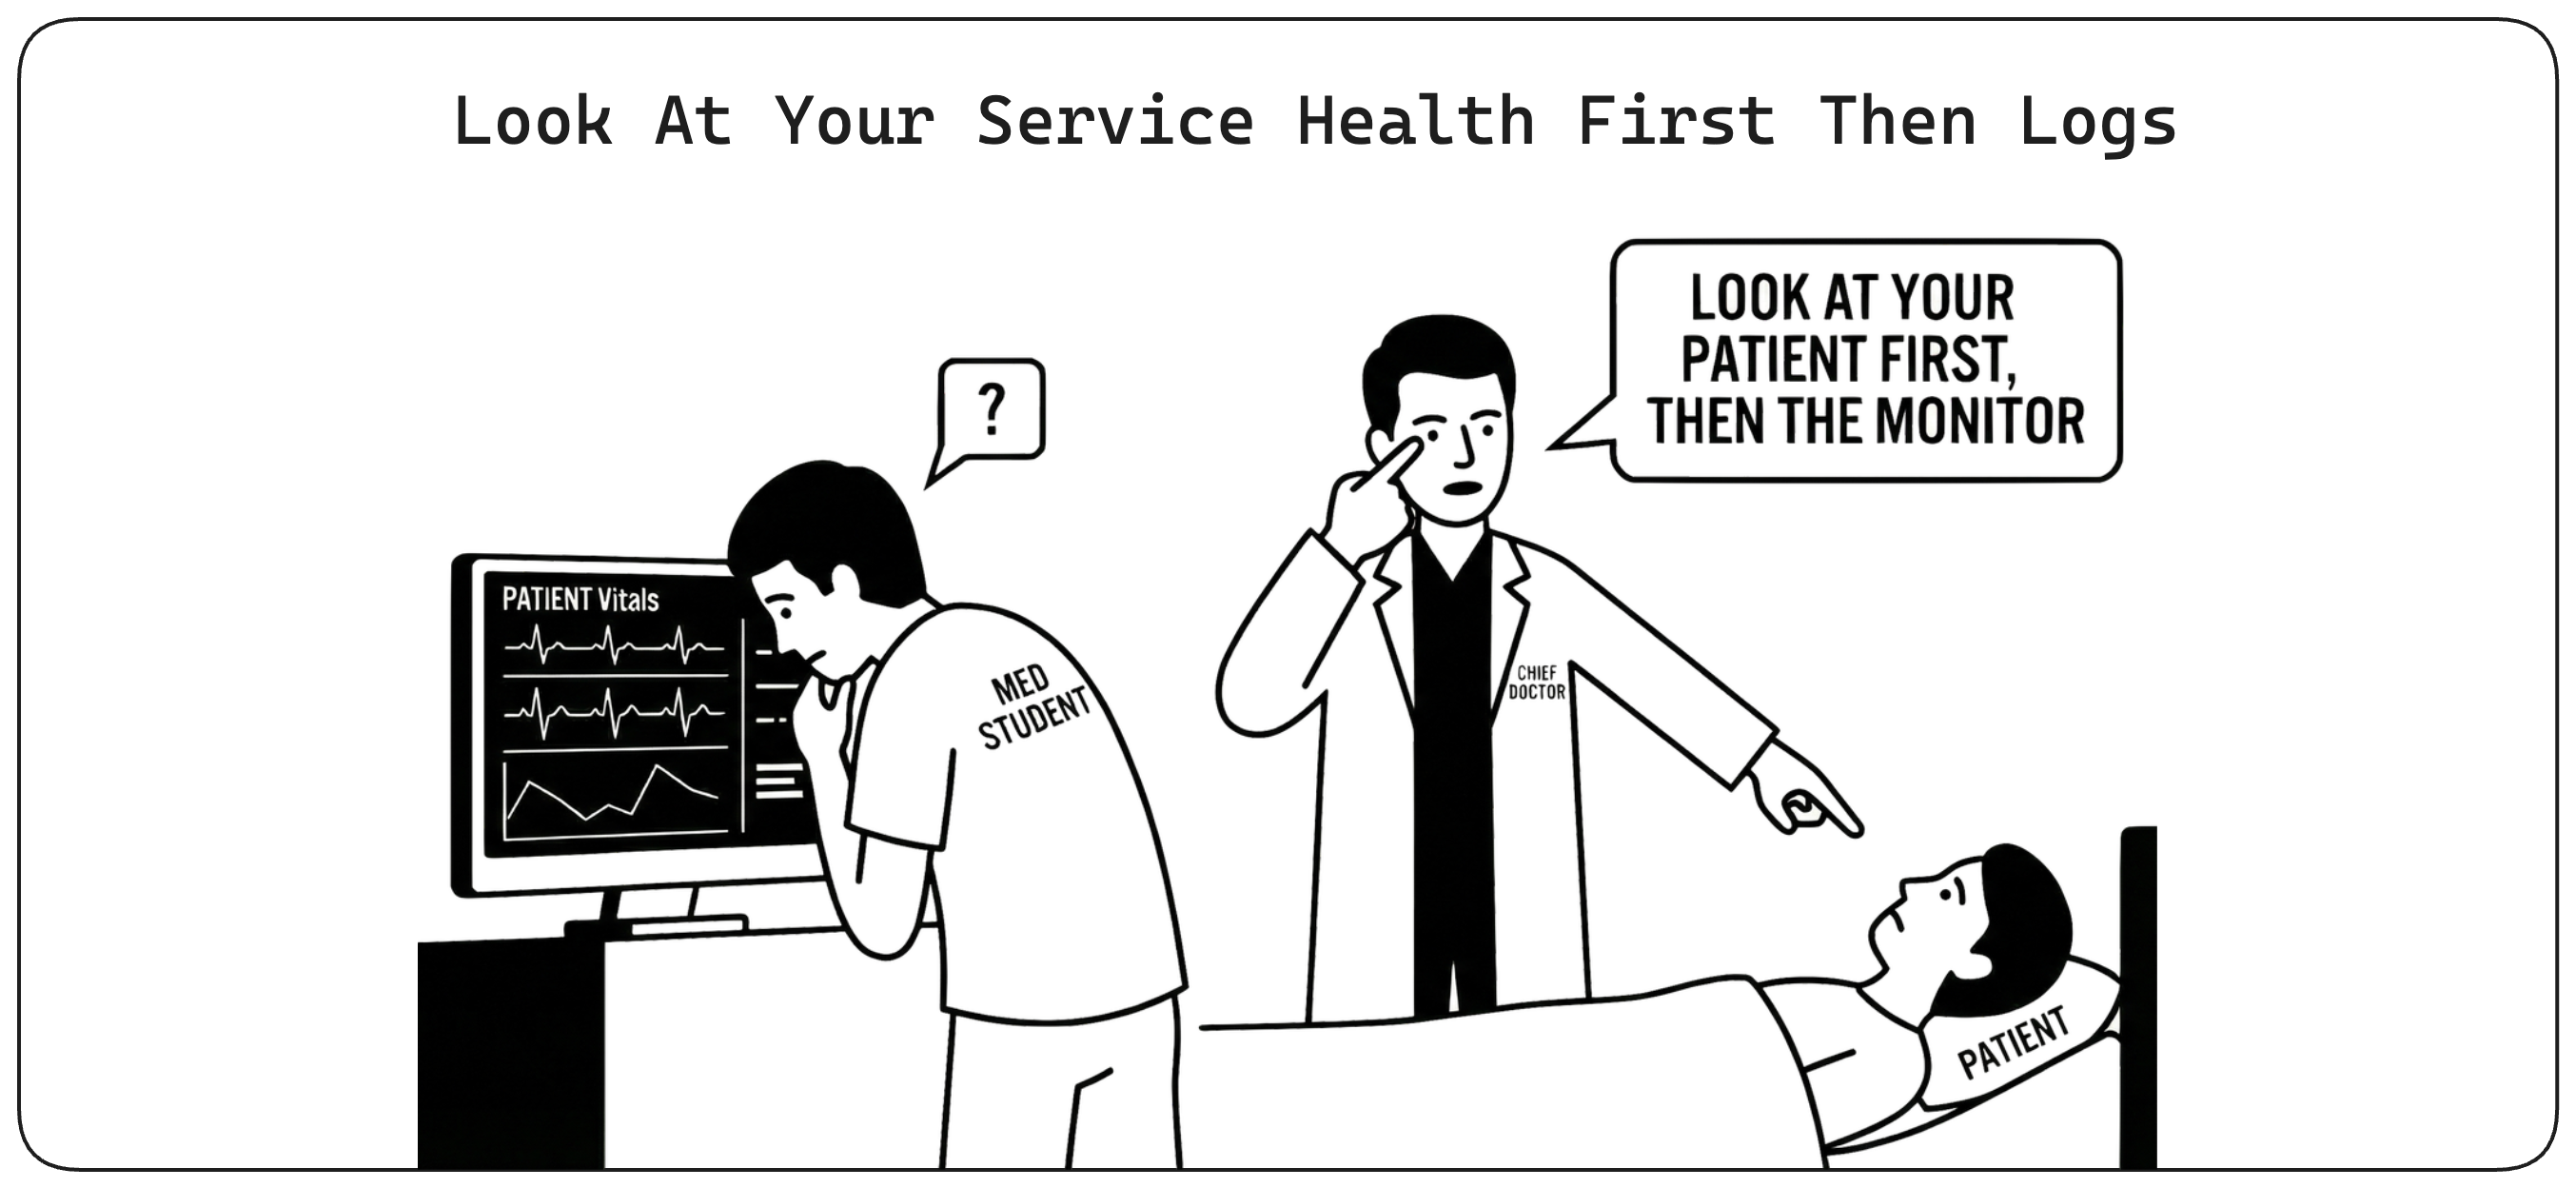
Vérifier d’abord la santé du service
Le statut du déploiement et la santé du service ne sont pas la même chose. Une étape de déploiement en échec peut laisser le service sain, tandis qu’un déploiement réussi peut introduire une dégradation. Avant de décider de la suite, évaluez la disponibilité réelle, la latence, les erreurs et la saturation — pas seulement le résultat du déploiement.
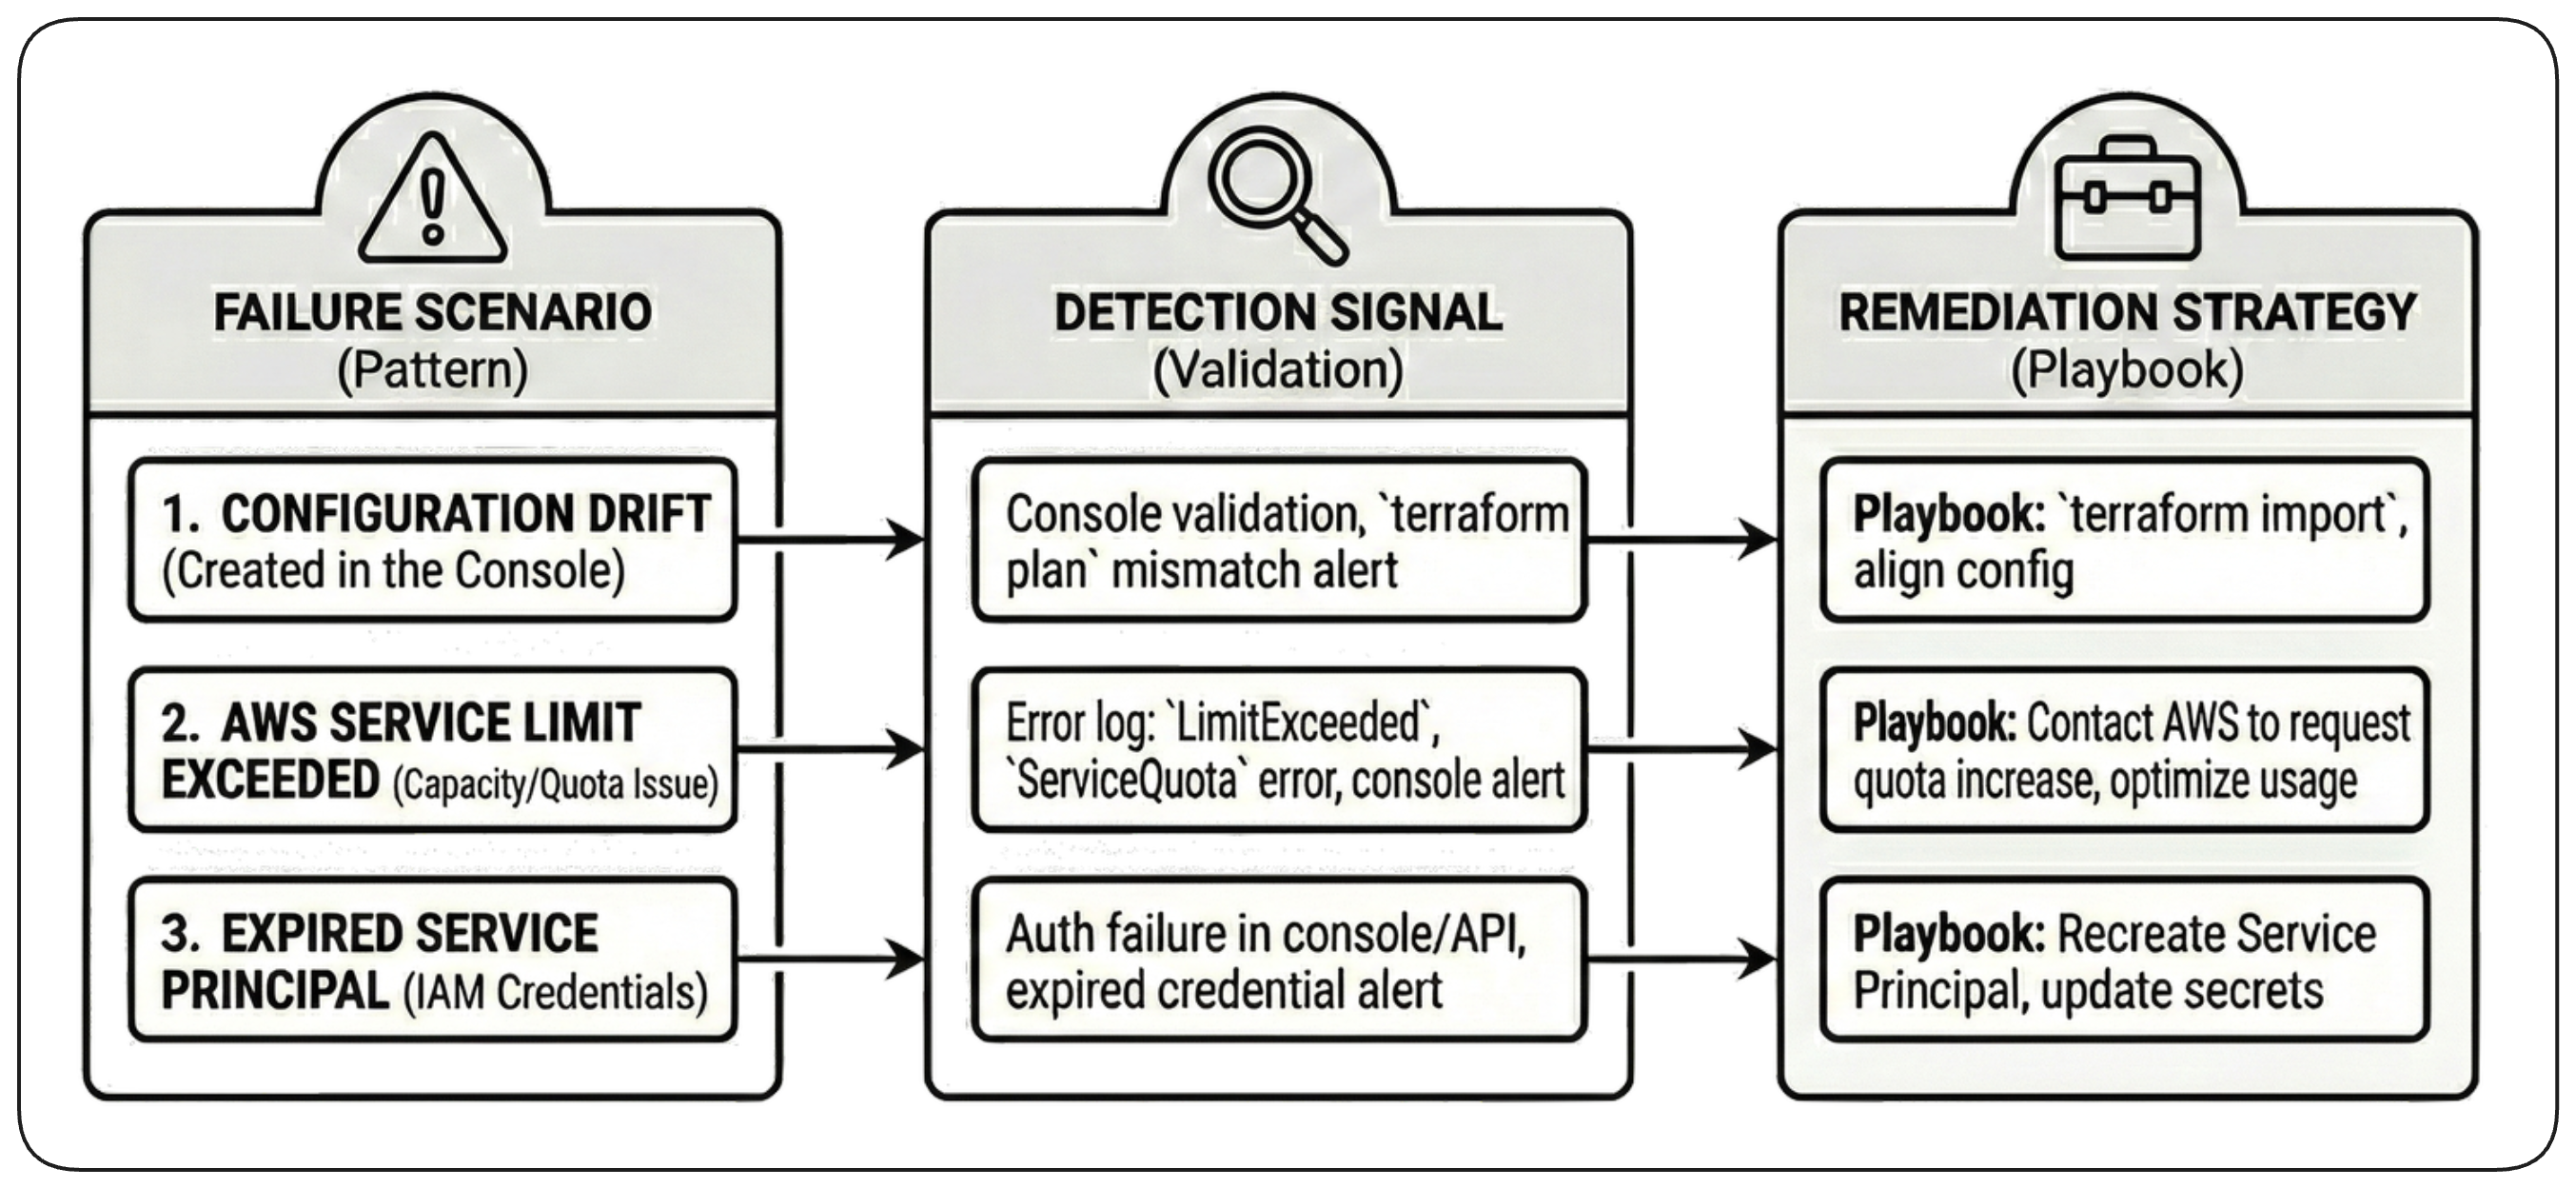
Se préparer aux scénarios d’échec connus
Les schémas d’échec récurrents doivent devenir un savoir opérationnel explicite. Consignez leurs signaux de détection, leurs causes probables et leurs actions de reprise éprouvées dans des playbooks maintenus. Chaque incident résolu devrait enrichir ce catalogue, pour que les échecs connus soient traités plus vite et de façon plus déterministe.
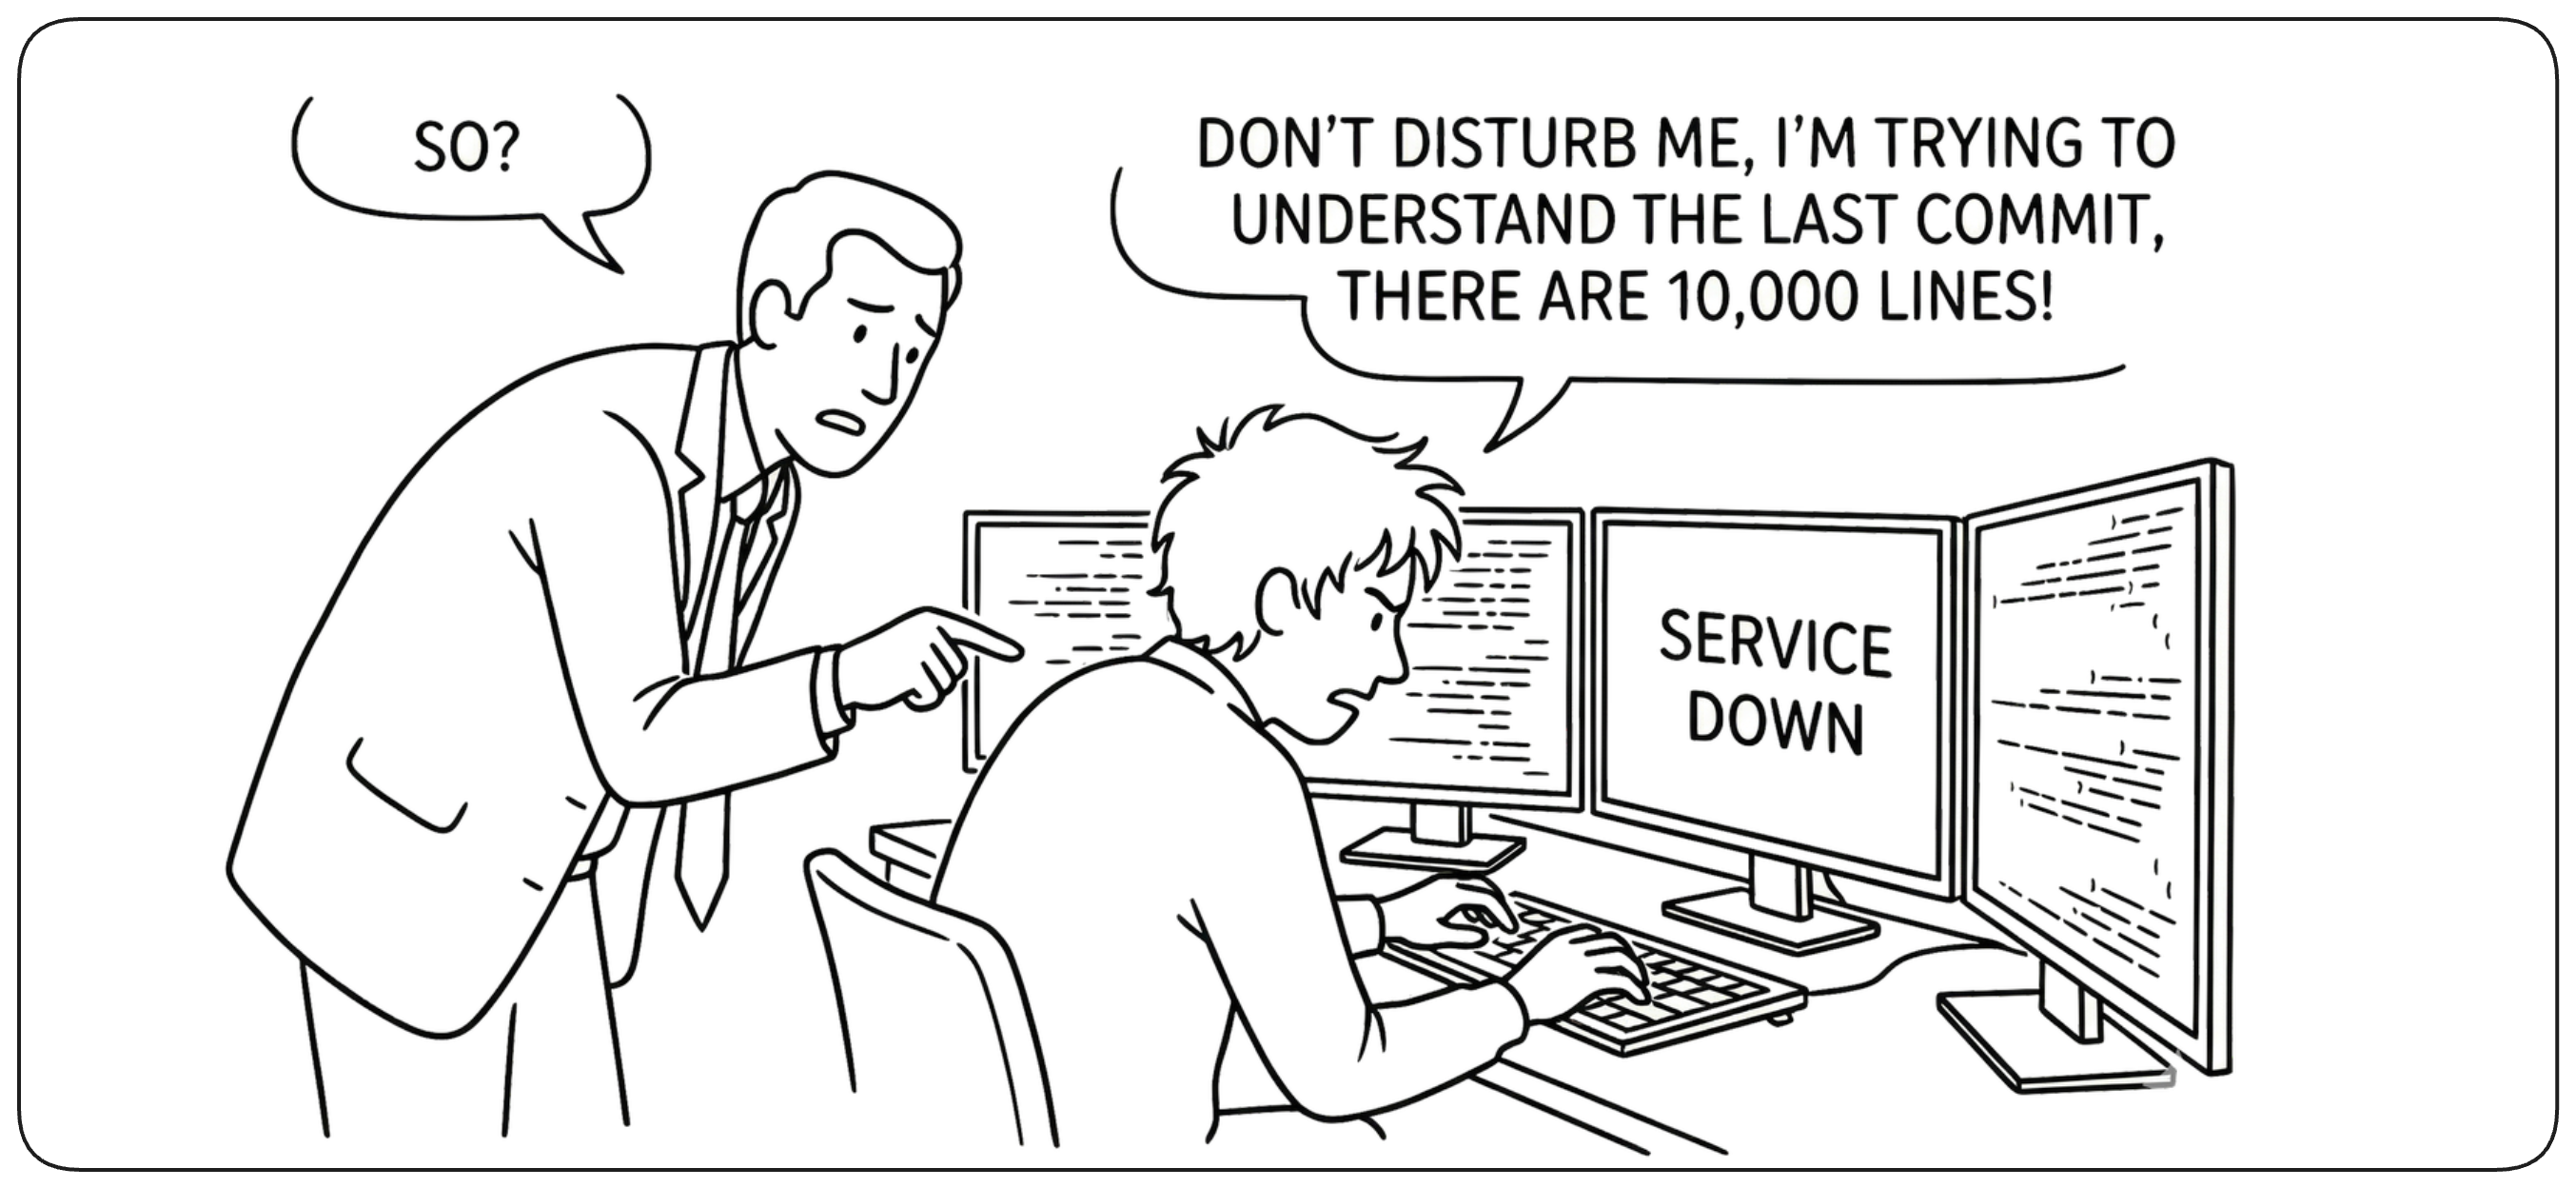
Stabiliser avant d’investiguer
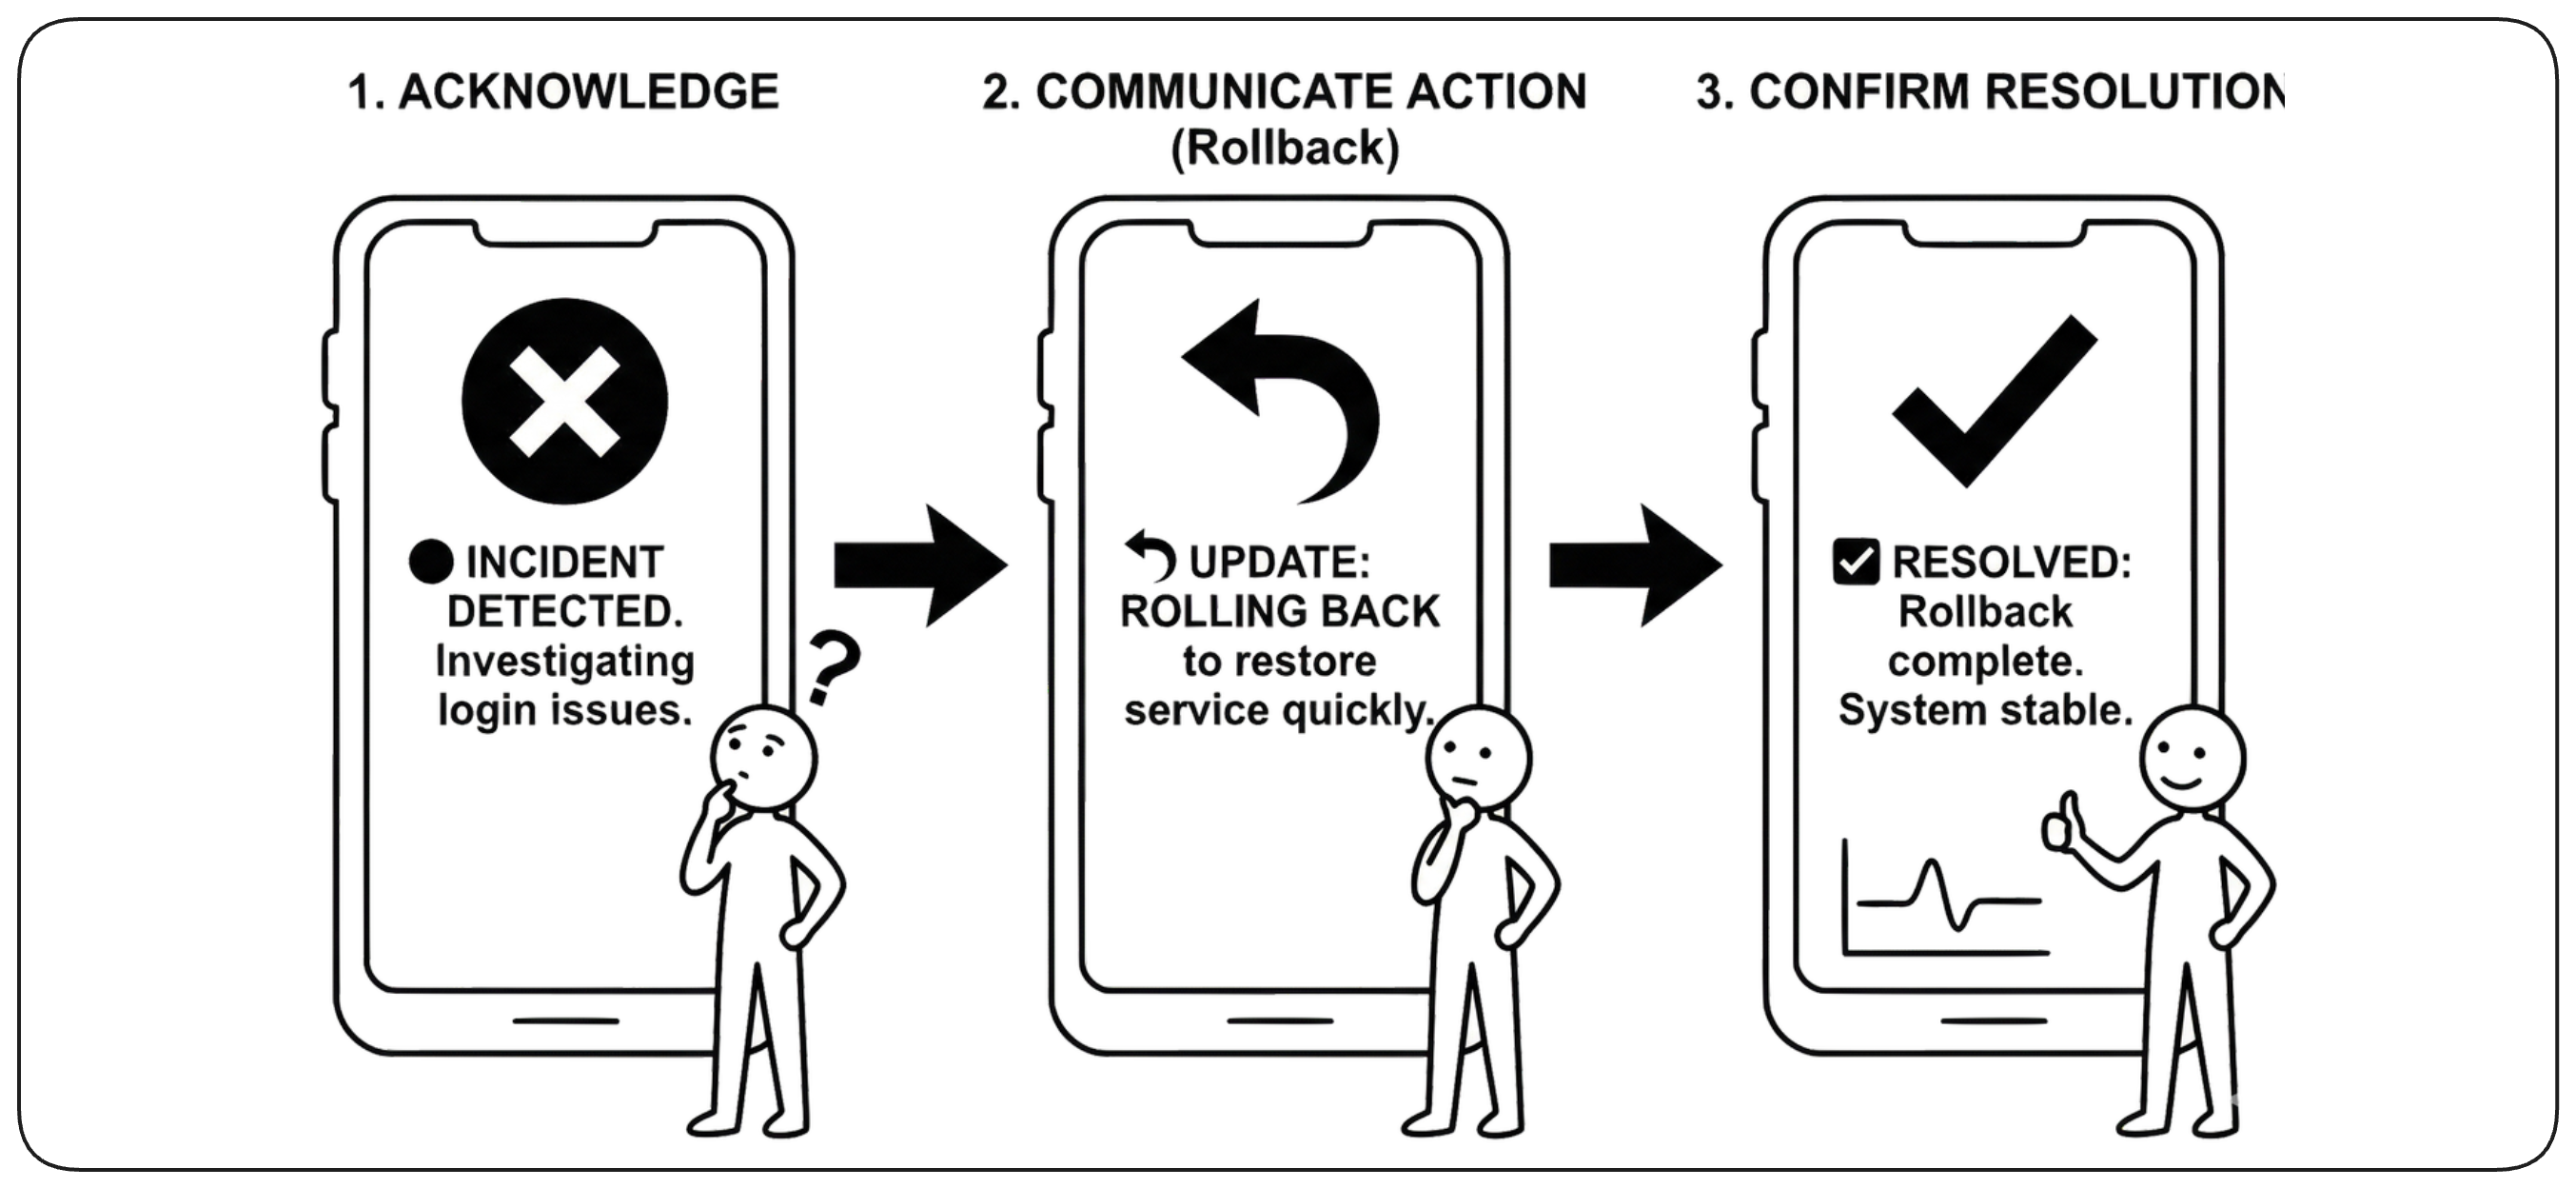
Pendant un incident, restaurez un état sain connu avant d’investiguer la cause racine. La stabilisation protège les utilisateurs et empêche le diagnostic de retarder la reprise. Une fois le service rétabli, l’investigation peut se poursuivre sans prolonger l’impact en production.
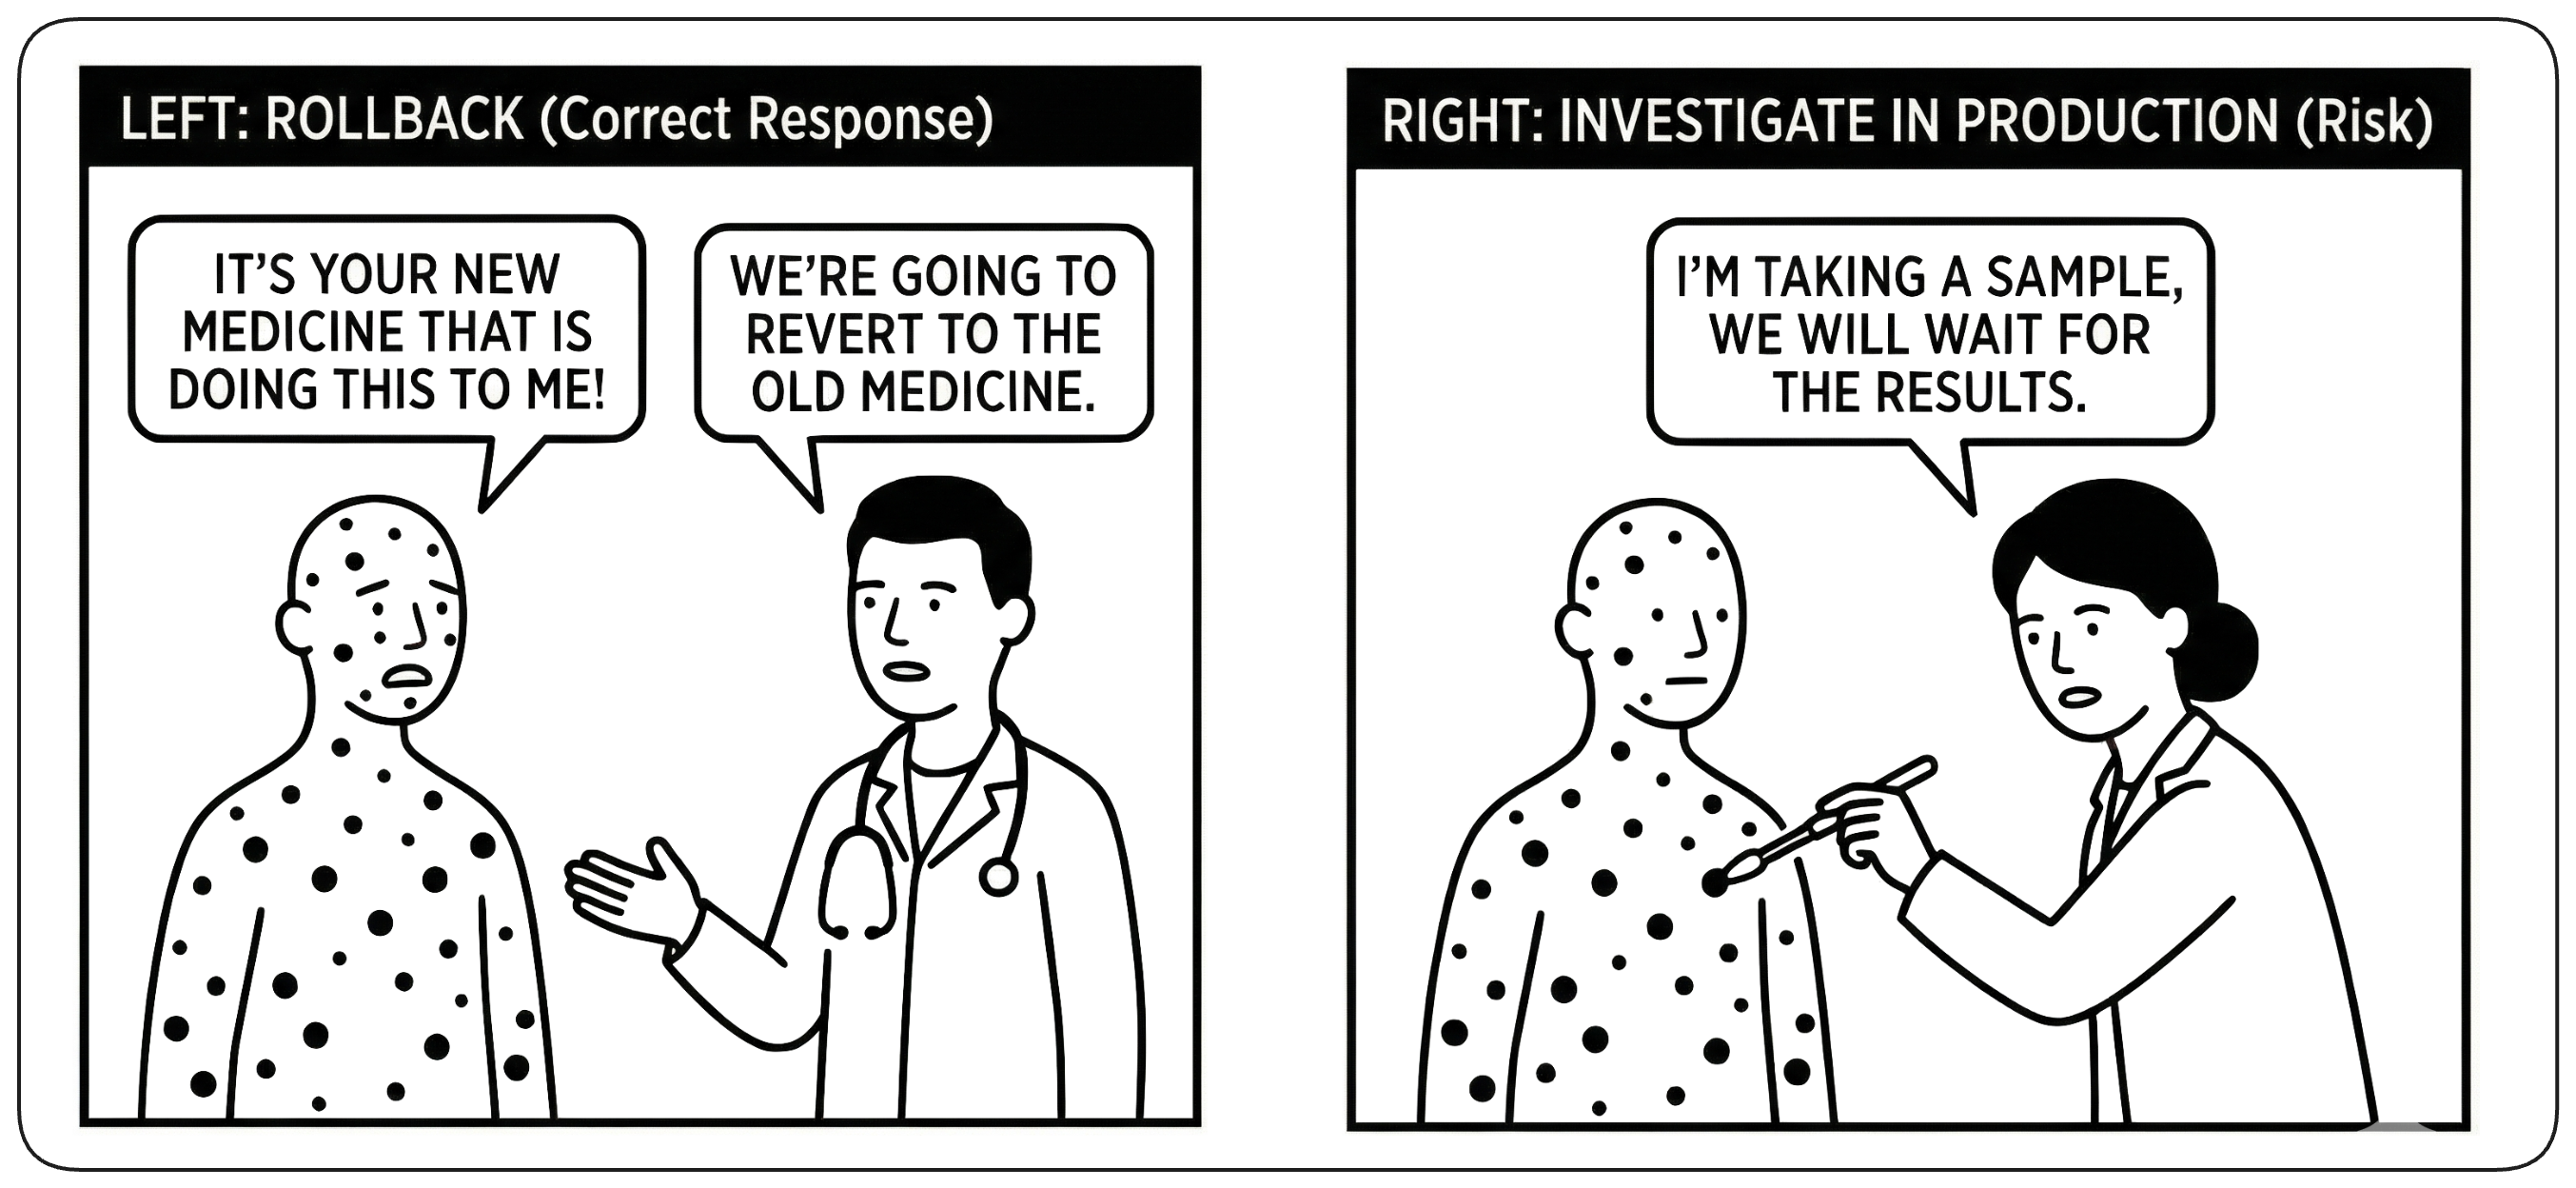
Préférer une reprise éprouvée au débogage en avant
Quand un déploiement provoque une dégradation, le retour à un état sain connu devrait être le chemin de reprise privilégié dès lors que le rollback est sûr. Évitez de déboguer ou de patcher en avant en production quand un retour arrière éprouvé peut rétablir le service plus vite. Quand le rollback n’est pas viable, utilisez un chemin de reprise prédéfini plutôt que d’improviser sous pression.
Communiquer l’état en toute transparence
Quand une release affecte les utilisateurs, communiquez tôt et maintenez le flux d’informations pendant toute la reprise. Partagez ce que l’on sait, l’impact actuel, l’action en cours et le moment où le service sera rétabli. N’attendez pas l’analyse de cause racine pour communiquer.
Apprendre de l’échec : les post-mortems sans blâme
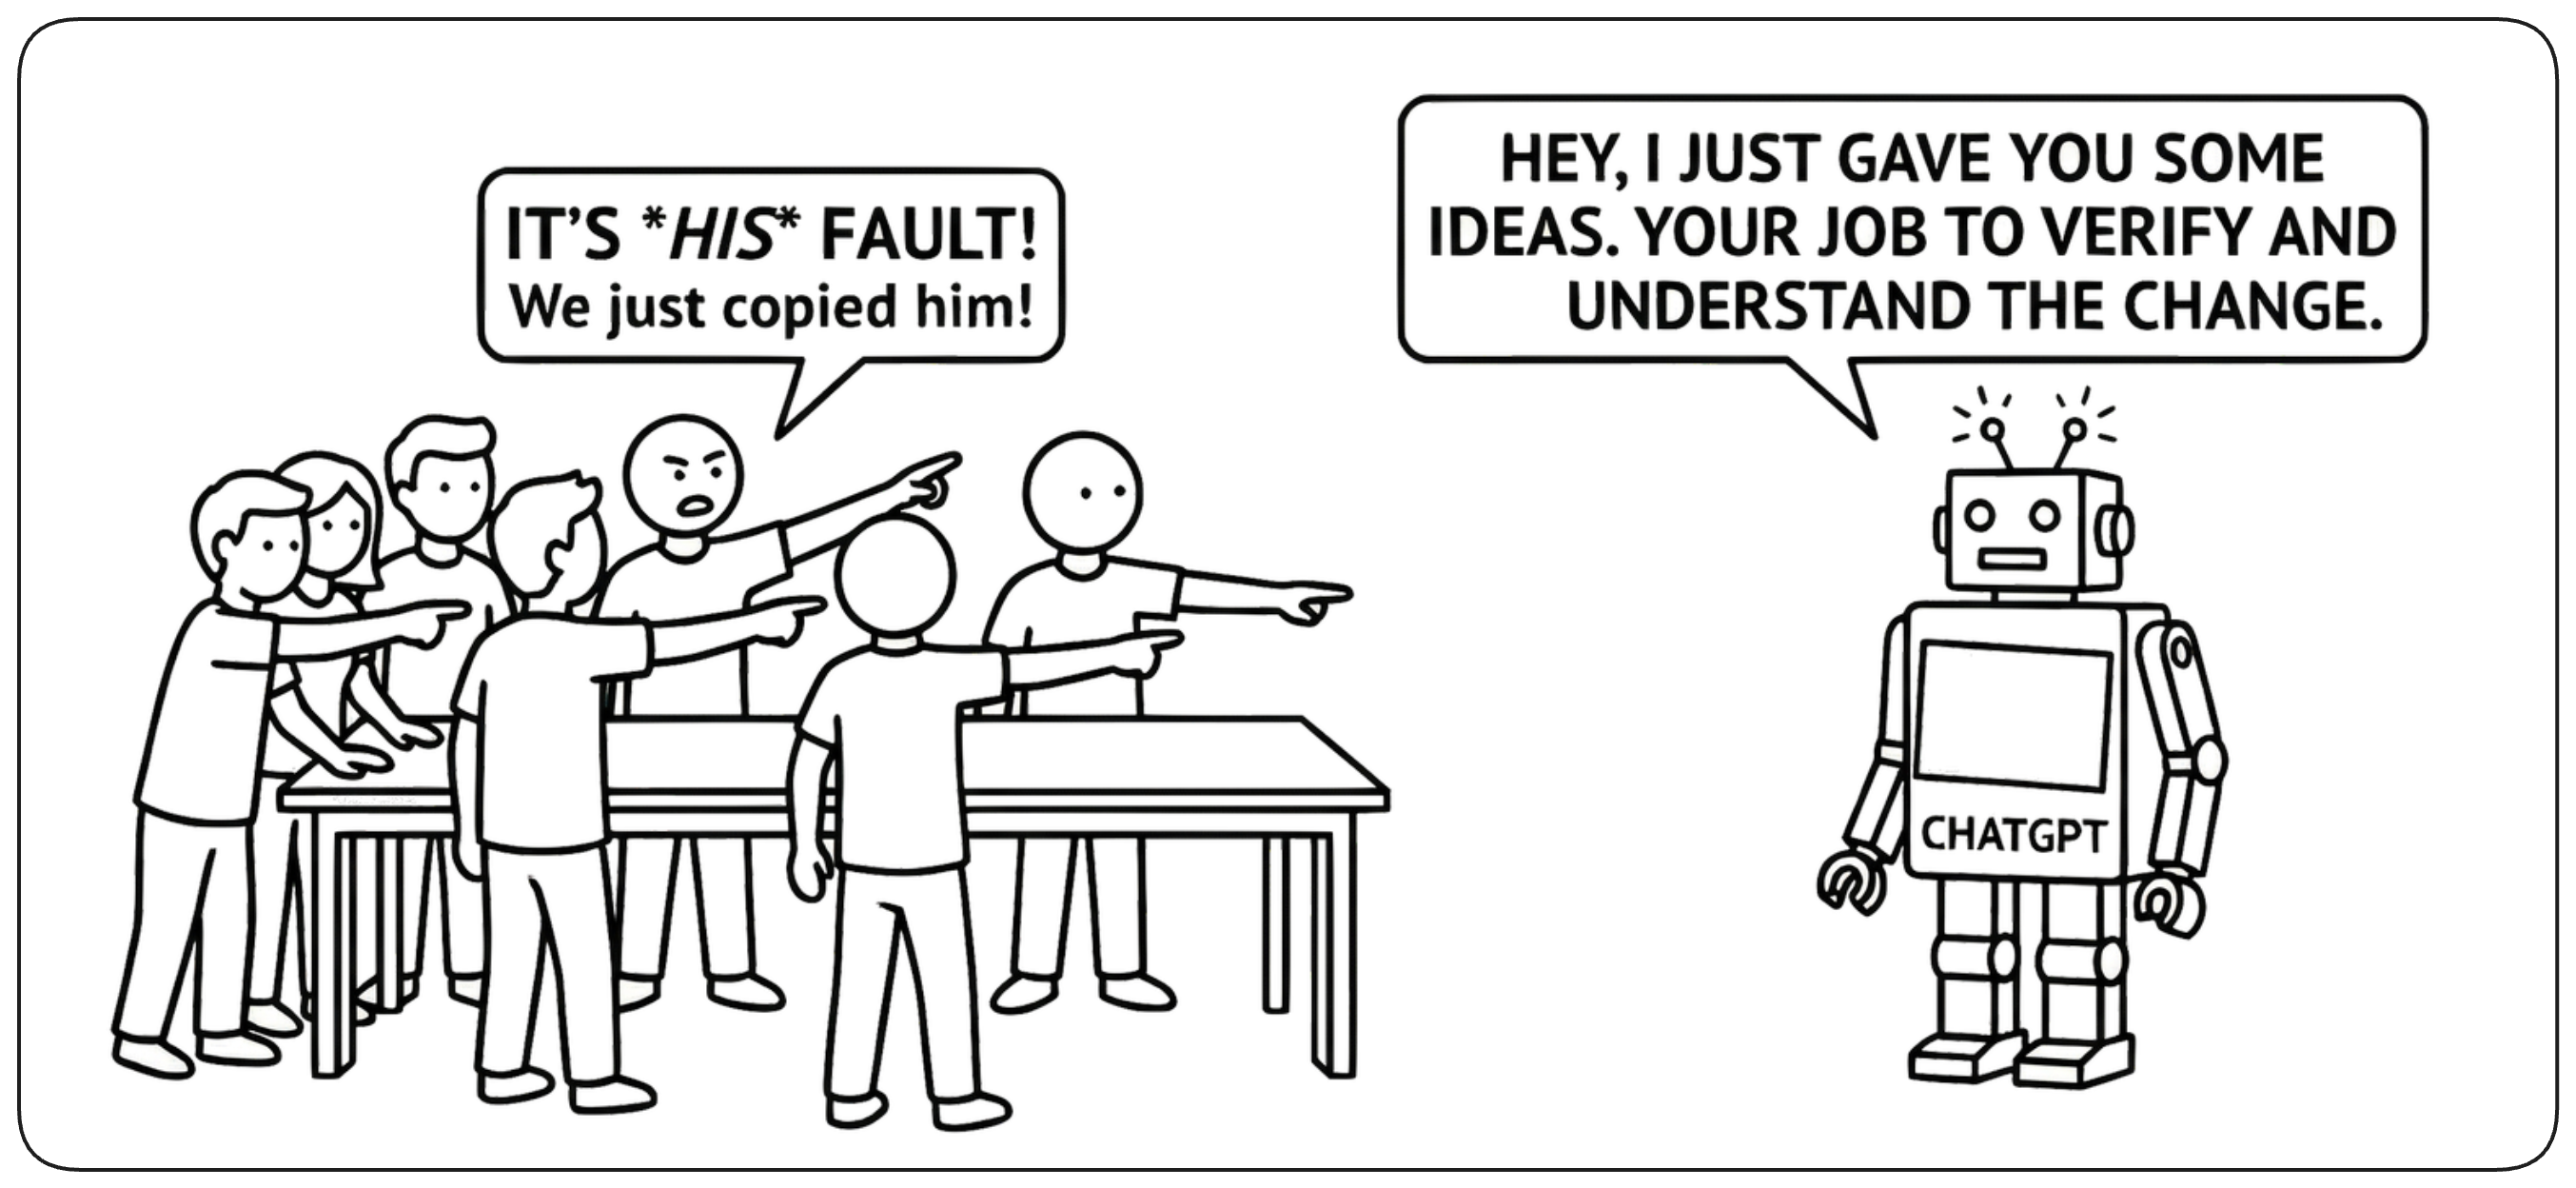
Les échecs de déploiement doivent améliorer le système de release. L’analyse post-incident se concentre sur les conditions qui ont permis l’échec et transforme ses conclusions en garde-fous concrets — meilleure validation, monitoring, automatisation, procédures de reprise ou contraintes d’architecture. L’objectif n’est pas de désigner un coupable, mais de faciliter la prévention ou la reprise du même échec la prochaine fois.
Unifier la consommation, séparer le stockage
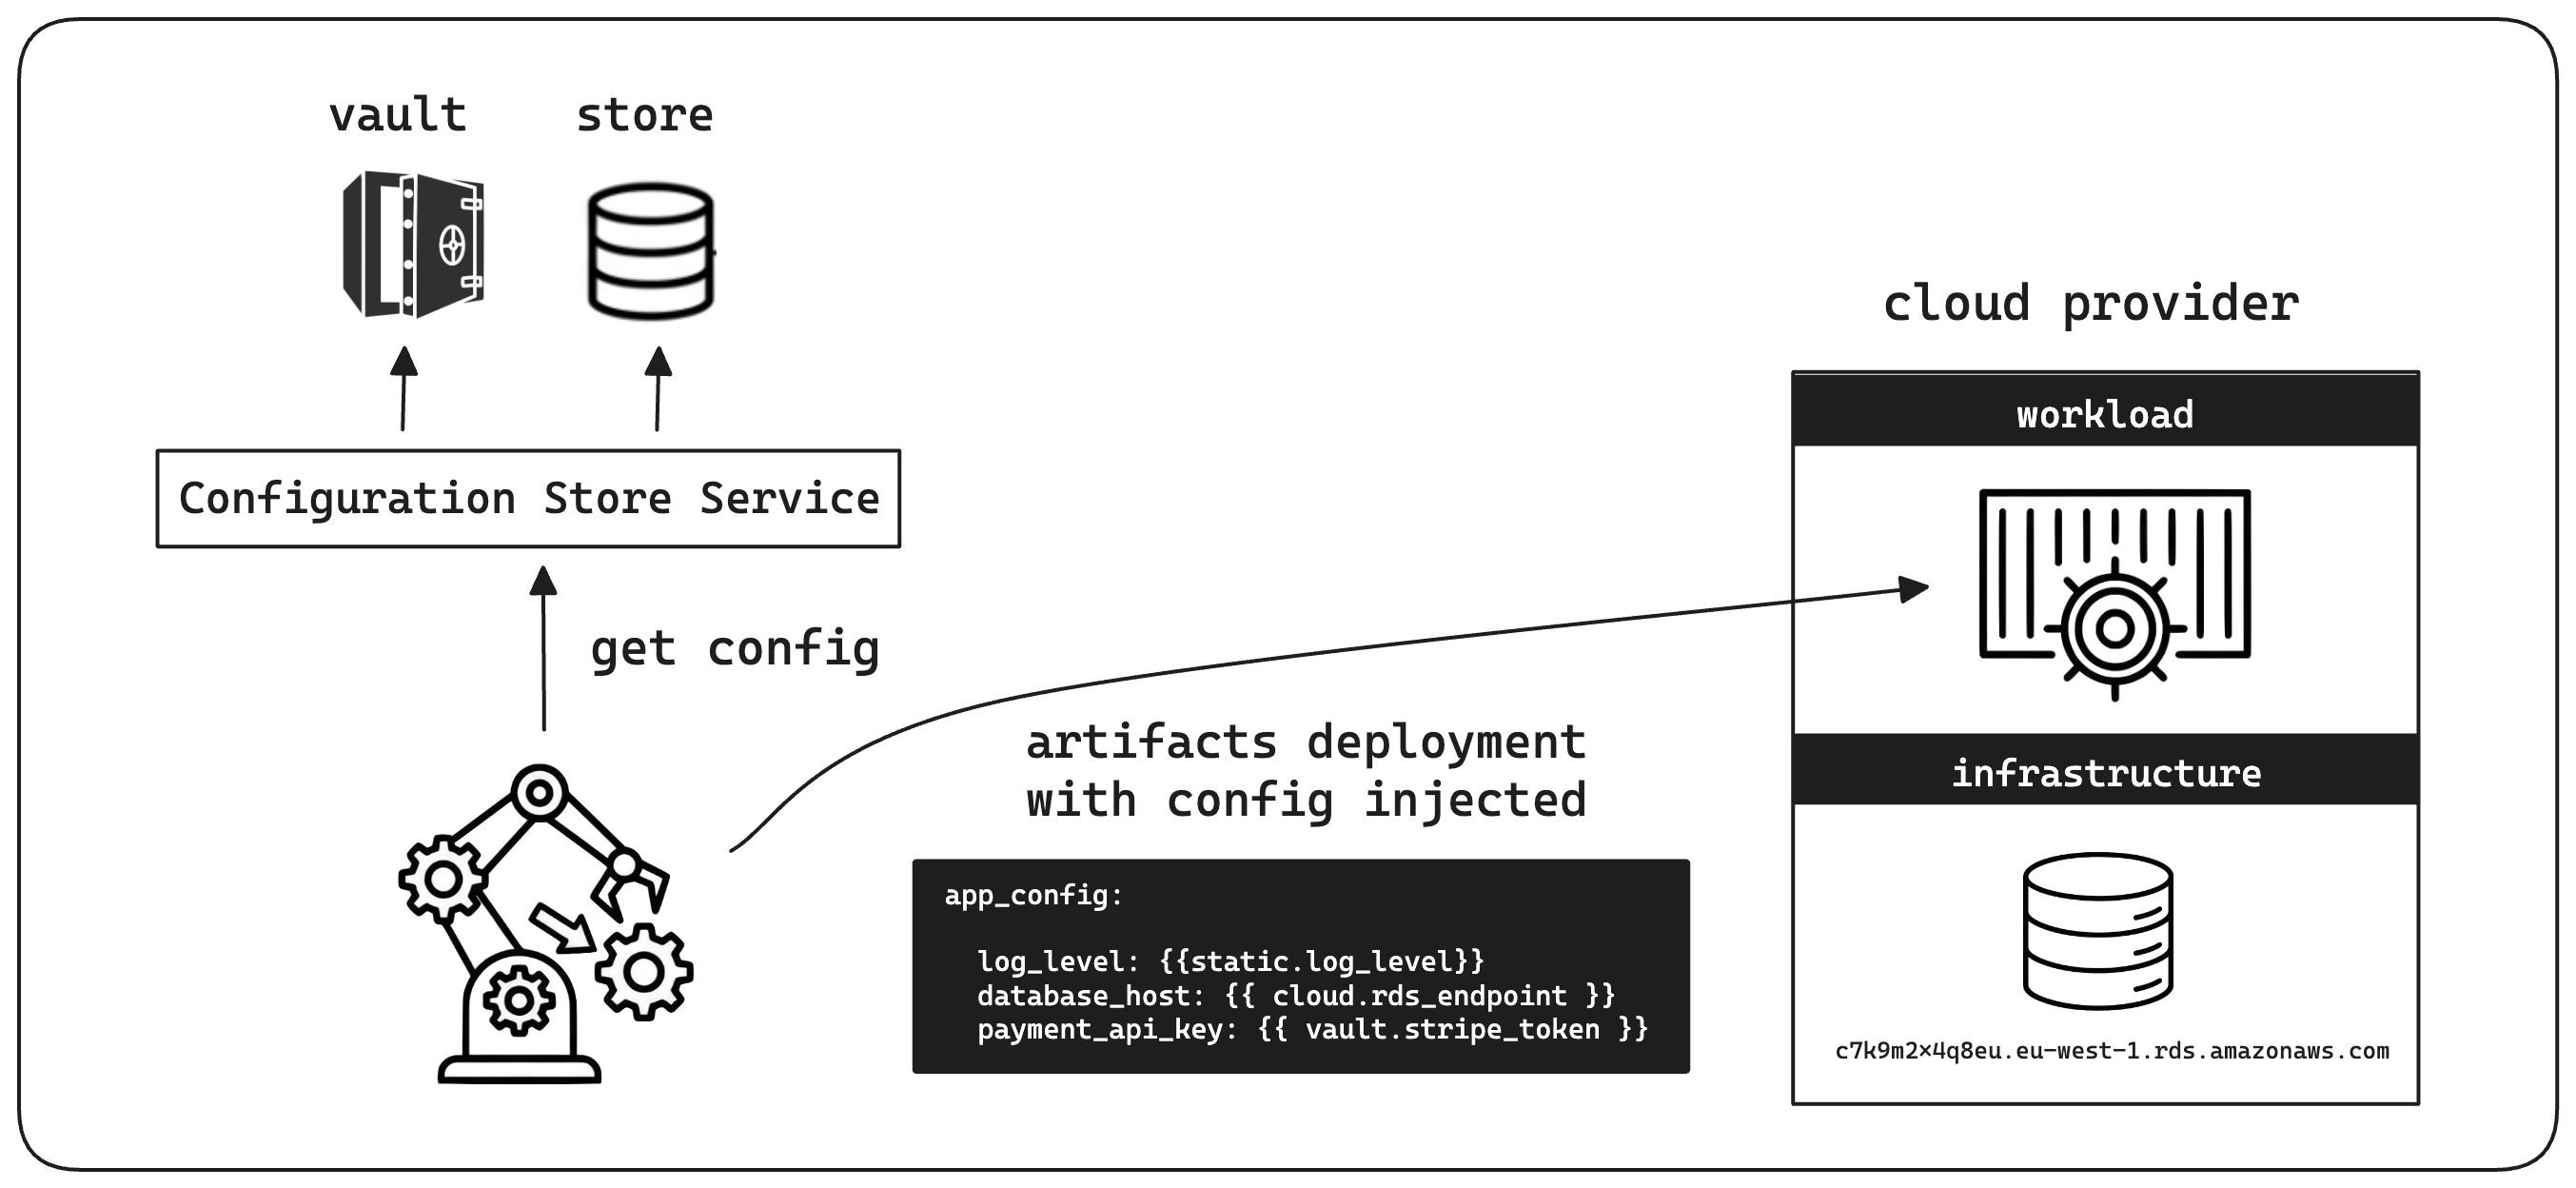
Du point de vue de la Developer Experience (DX), la complexité de gérer des backends de stockage distincts (Git pour la configuration, Vault pour les secrets) est une charge cognitive inutile. La logique applicative a simplement besoin d’entrées. La plateforme idéale résout cette friction en abstrayant la séparation du stockage. Grâce à des opérateurs intermédiaires (comme l’External Secrets Operator dans Kubernetes), les données sont récupérées depuis des coffres sécurisés et projetées dans le workload aux côtés des configmaps standard. On obtient ainsi une couche de consommation unifiée : que la valeur soit une URL banale ou un mot de passe critique, le développeur y accède par la même interface native (par ex. les variables d’environnement), ce qui garantit une sécurité stricte côté backend sans compliquer le code côté frontend.
Illustration à faire : os.getenv('DB_URL') ou os.getenv('DB_PASSWORD') -->
Garantir la qualité des releases
La qualité d’une release ne peut pas être une réflexion après coup — elle doit être intégrée dès le premier jour du développement. Mais la qualité ne se mesure que par les tests. Sans tests, il n’existe aucun moyen objectif d’évaluer si le code répond aux exigences, fonctionne correctement ou reste fiable. Les tests fournissent les métriques et les preuves nécessaires pour valider la qualité tout au long du cycle de développement, ce qui en fait le fondement de toute stratégie d’assurance qualité.
Des critères bien définis
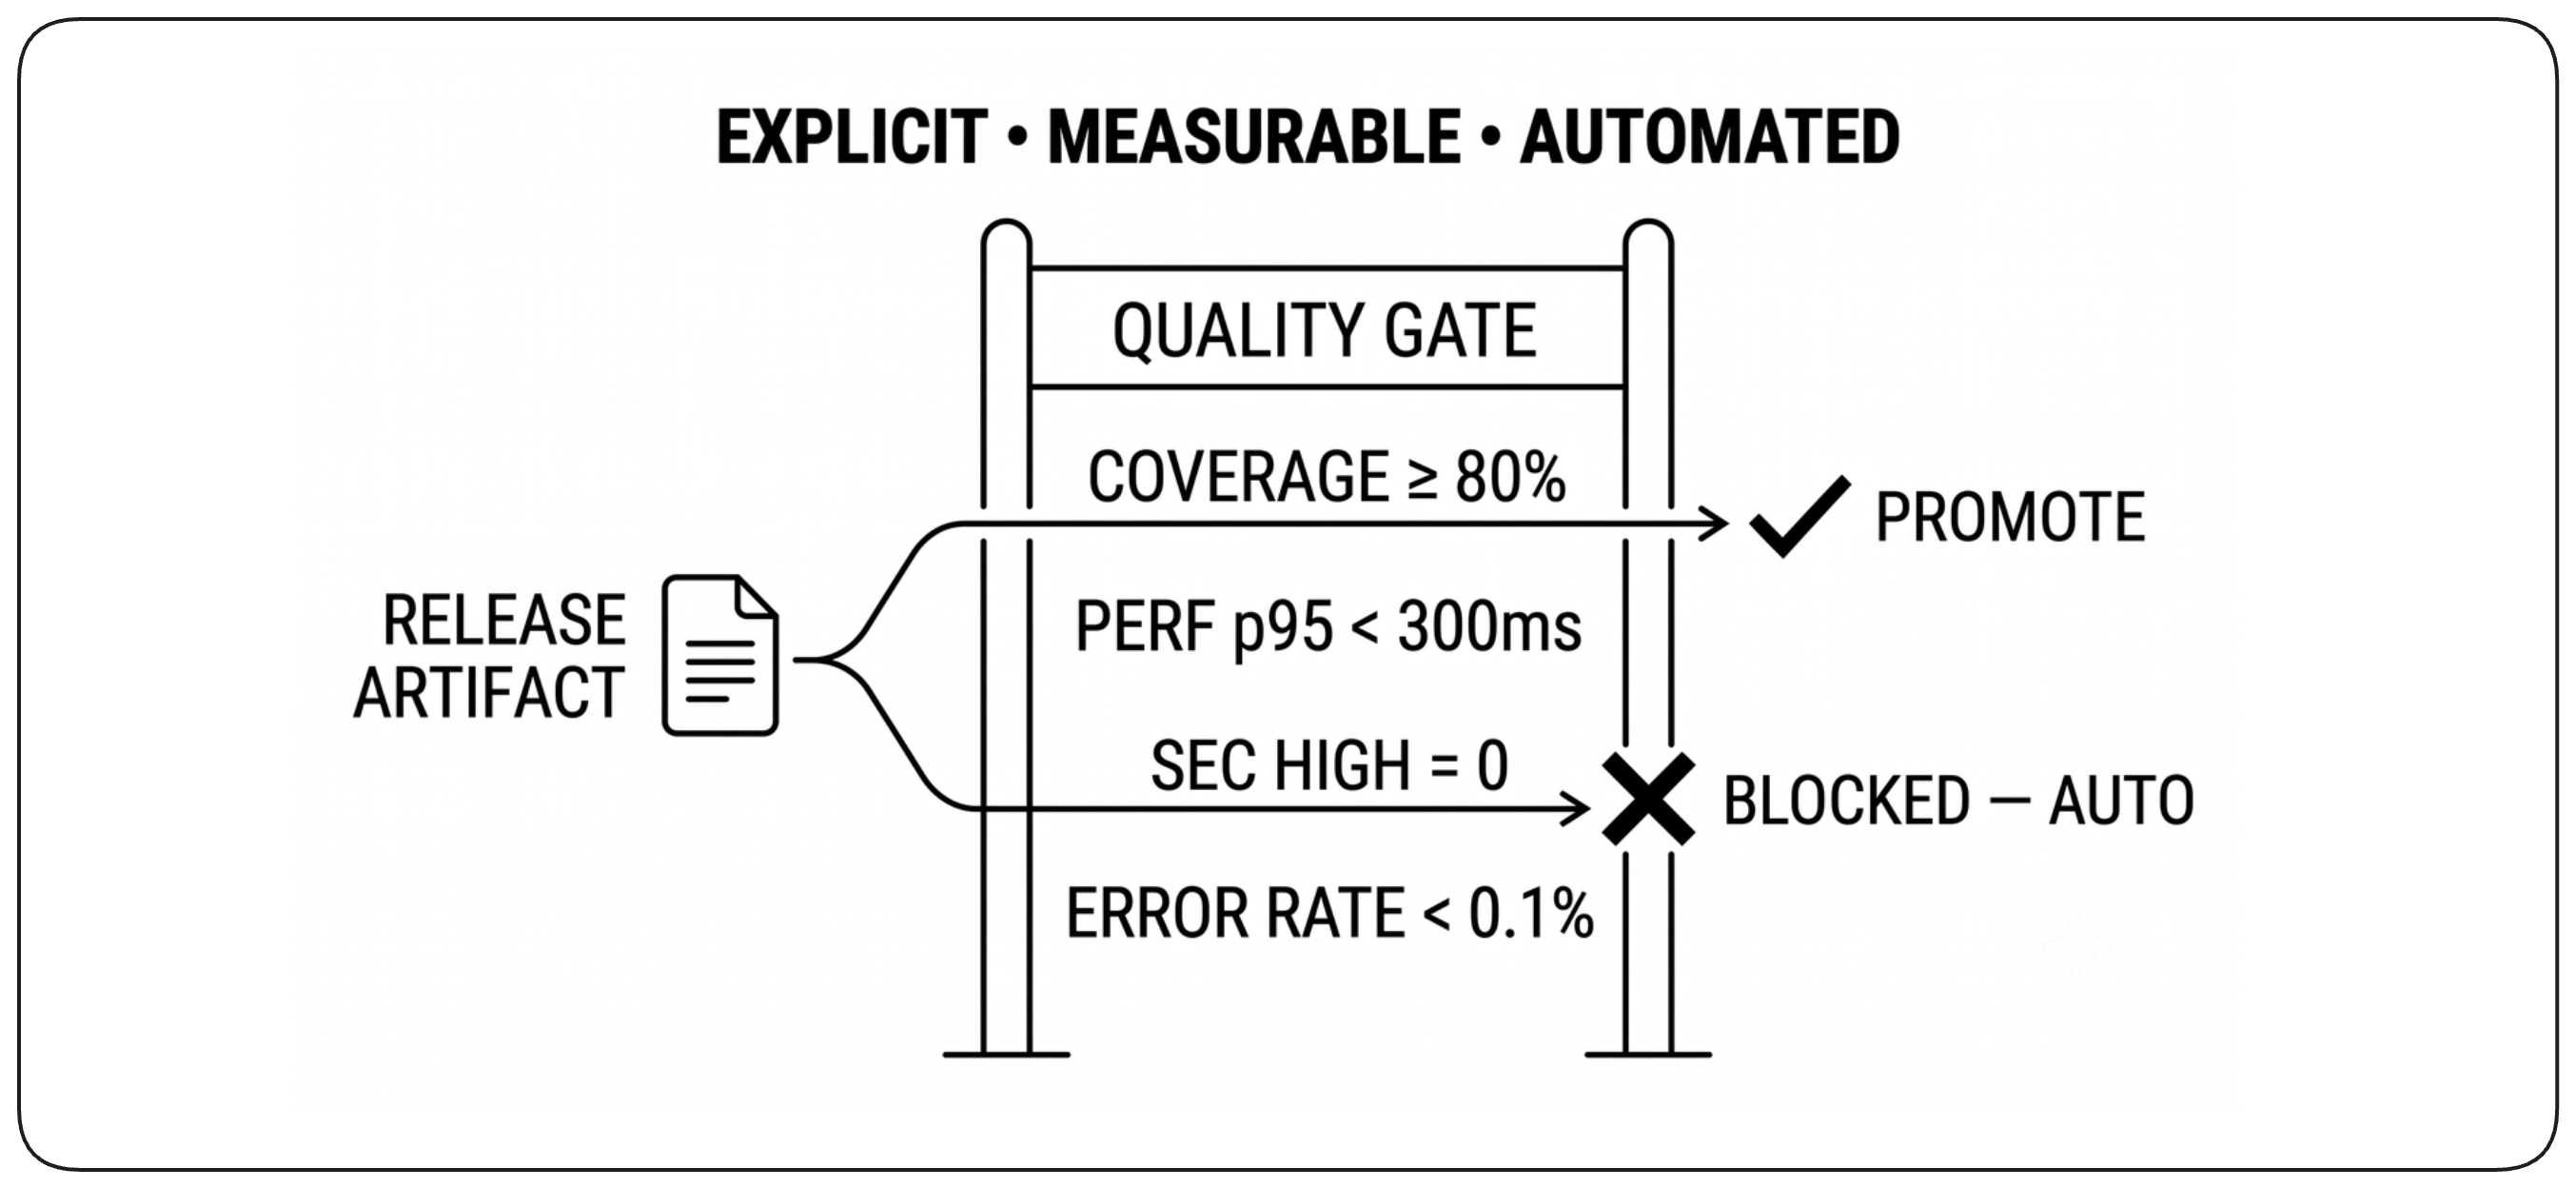
Les quality gates doivent être explicites, mesurables et appliquées automatiquement au niveau de la plateforme. Les contrôles manuels et les bonnes intentions ne suffisent pas — si les critères ne sont pas remplis, les équipes doivent être empêchées de déployer en production. Des gates automatisées devraient bloquer les déploiements qui ne respectent pas des seuils prédéfinis de couverture de tests, de benchmarks de performance, de scans de sécurité ou d’autres métriques de qualité. En rendant les critères obligatoires et non négociables, les organisations s’assurent que les standards de qualité sont appliqués de façon cohérente à toutes les releases, éliminant le risque d’exceptions qui compromettent la fiabilité du système.
Garantir la qualité uniquement par des tests robustes
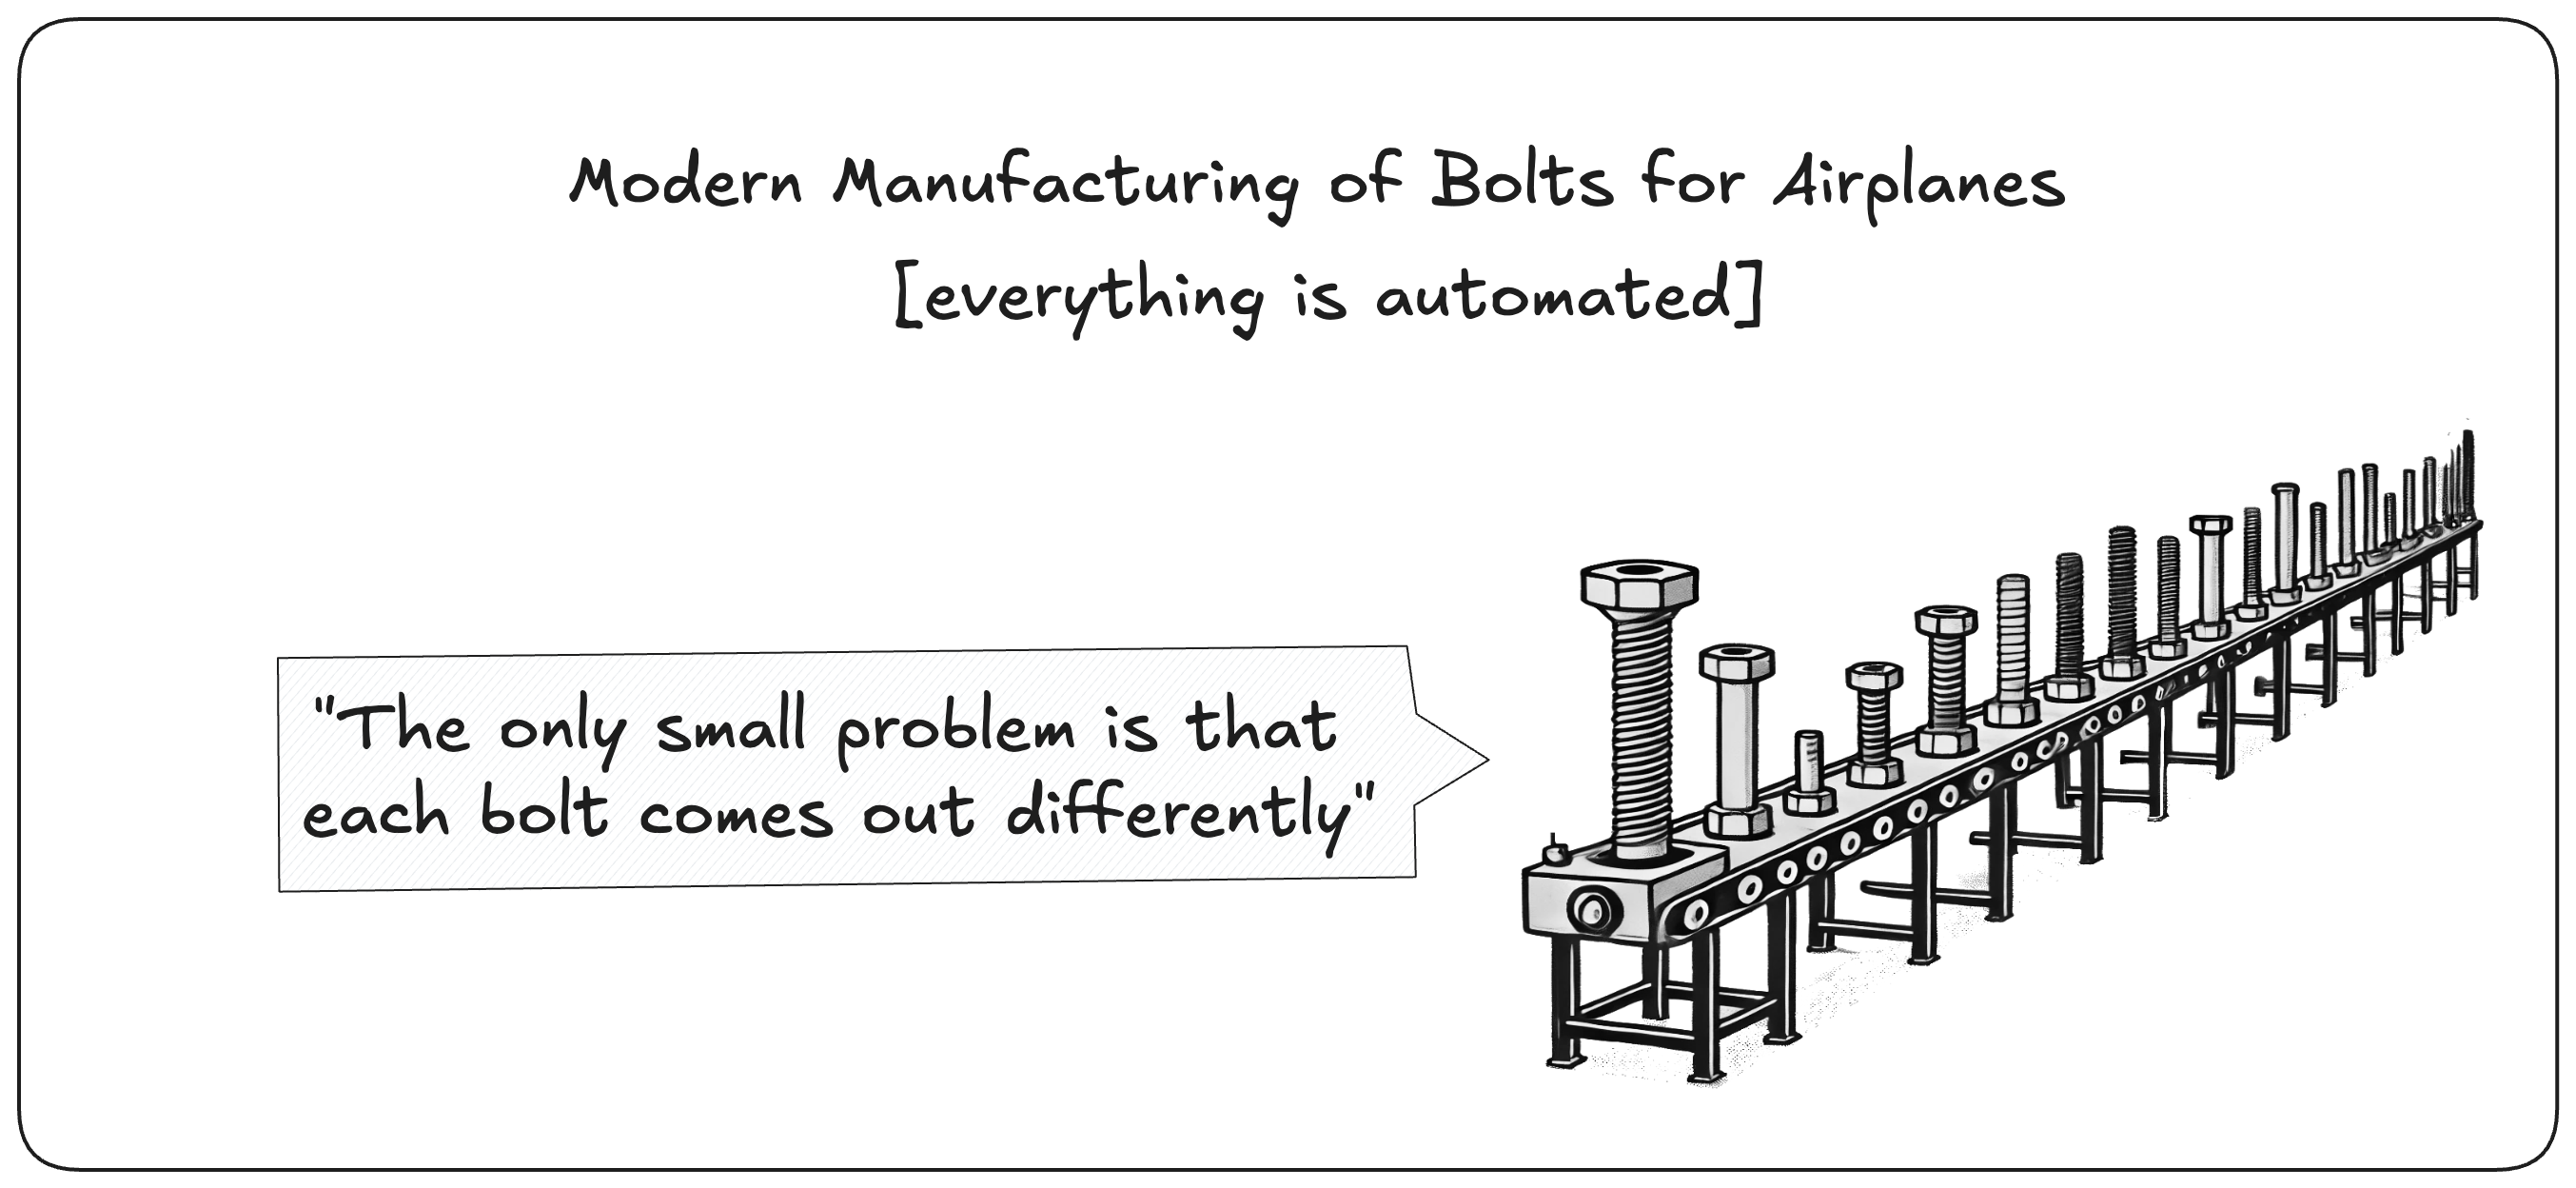
Investir dans les tests doit précéder tout investissement dans le DevOps. Beaucoup de projets attendent à tort du DevOps qu’il compense des tests insuffisants, mais c’est une erreur fondamentale. Si les tests sont faibles, aucune architecture de release, aussi sophistiquée soit-elle, ne sauvera le projet. La qualité d’une release commence par des tests solides et fiables — des processus de test robustes doivent être priorisés avant de se lancer dans des implémentations DevOps complexes. L’intégrité d’un pipeline de déploiement n’est jamais plus solide que les tests qui le valident.
Couverture de code
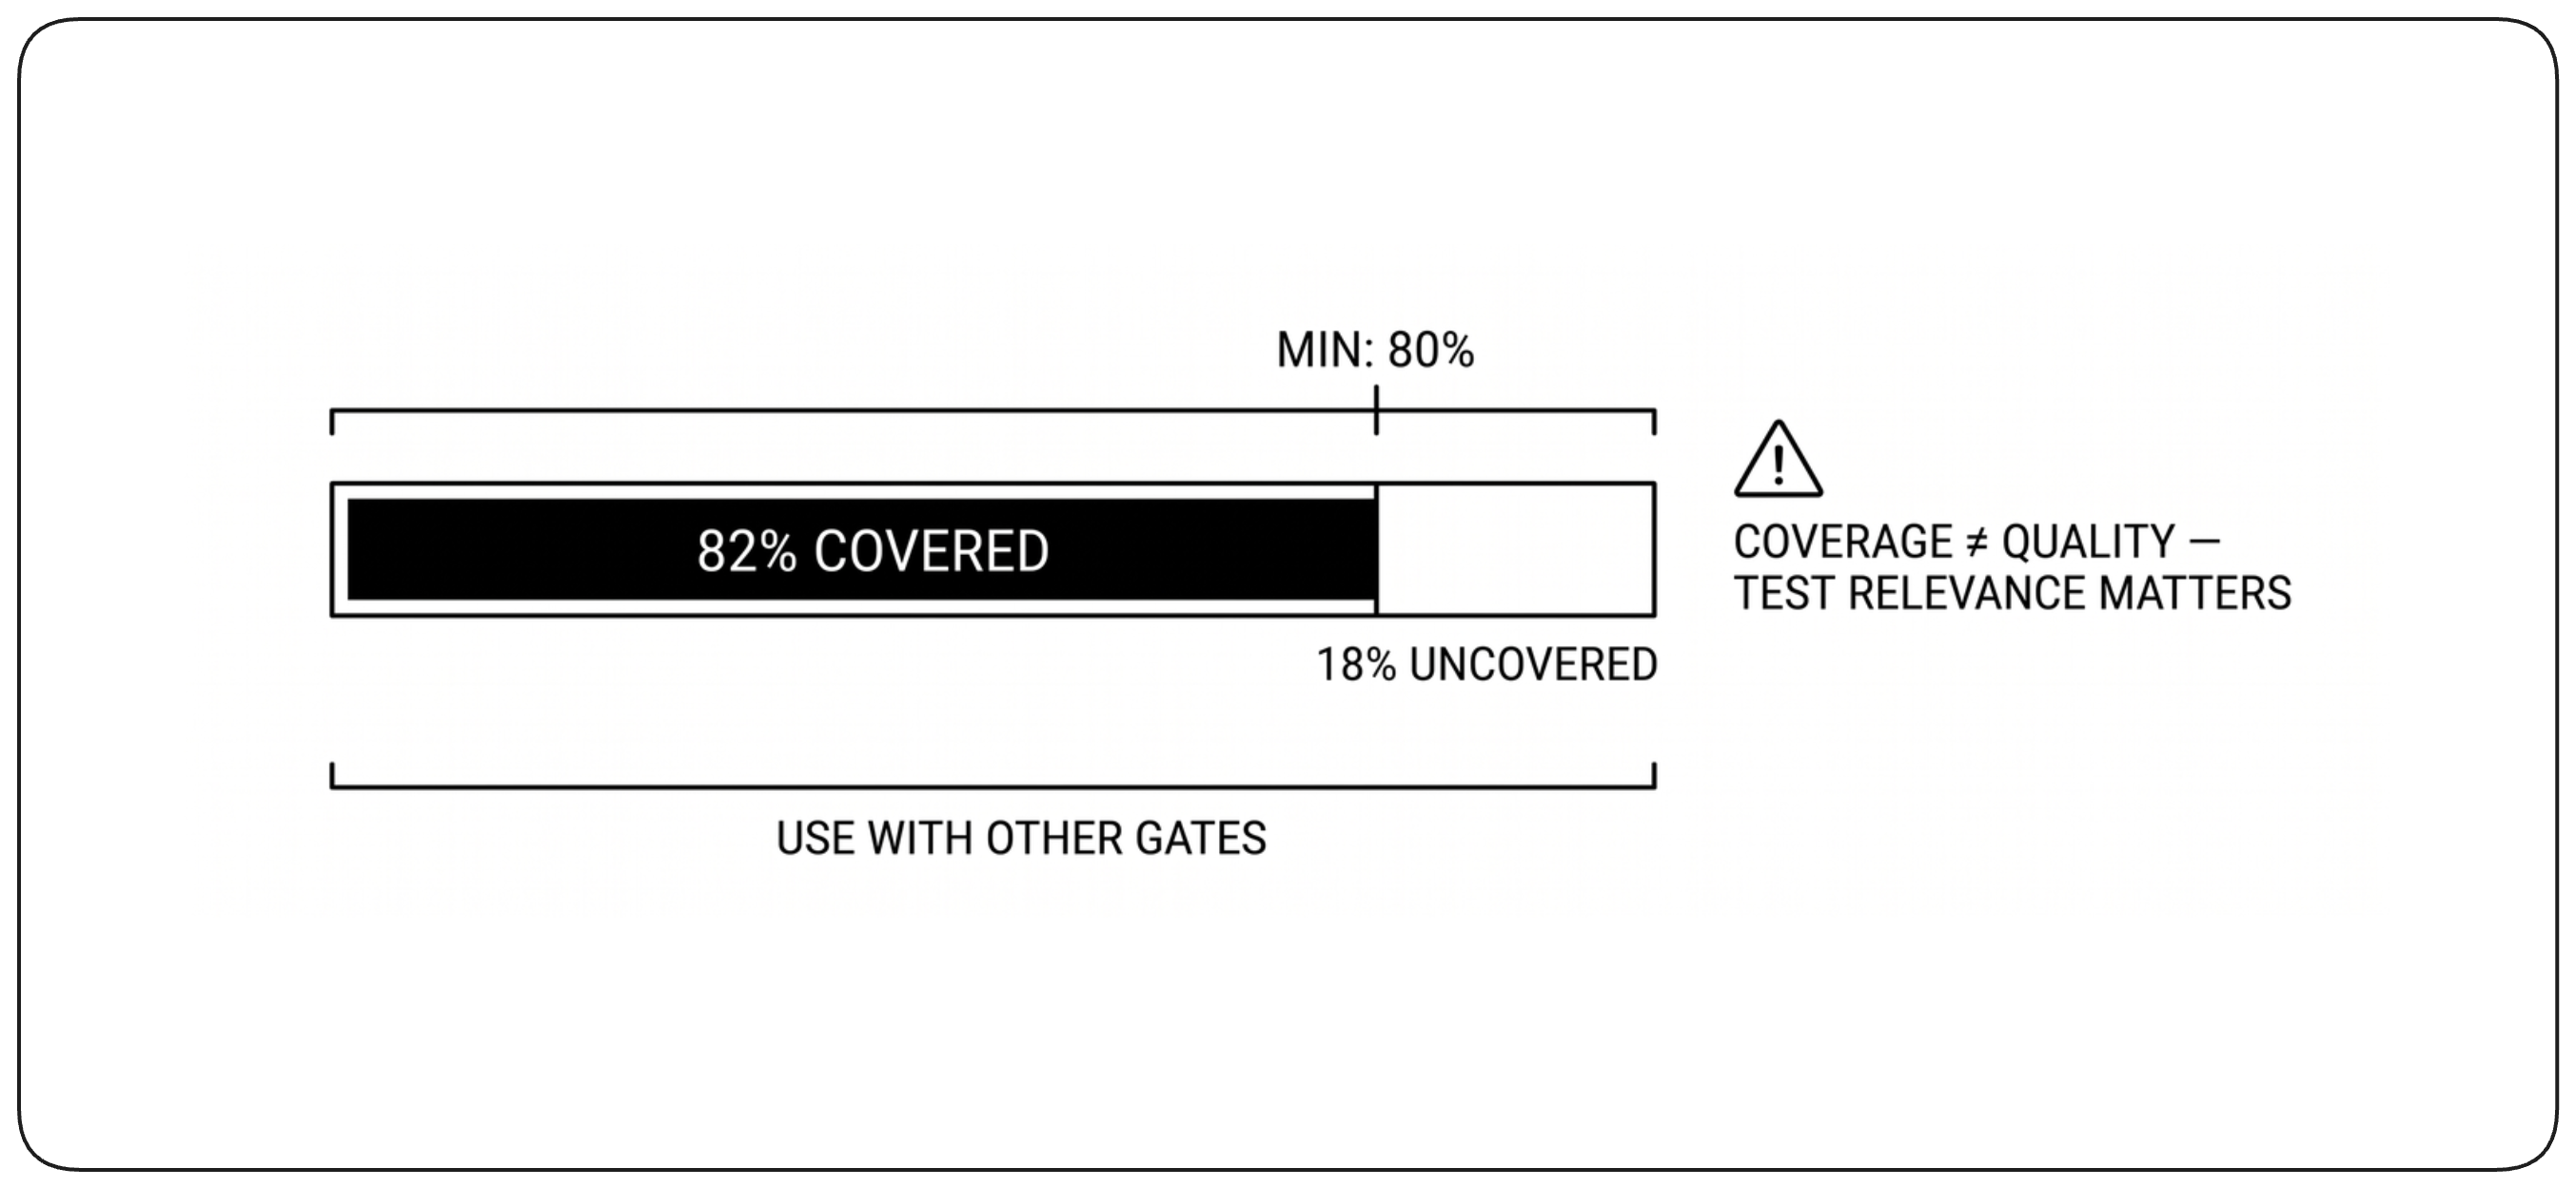
Les métriques de couverture de code révèlent quelle part du code est exercée par les tests. Une couverture élevée ne garantit pas la qualité, mais une couverture faible signale un risque important. Fixer des seuils minimaux de couverture comme quality gate garantit que les chemins de code critiques sont testés. Toutefois, la couverture seule ne suffit pas — ce qui compte, c’est la qualité et la pertinence des tests, pas seulement le pourcentage. Les métriques de couverture doivent servir d’indicateur de base, combinées à d’autres mesures de qualité pour assurer des tests complets.
Tests d’intégration
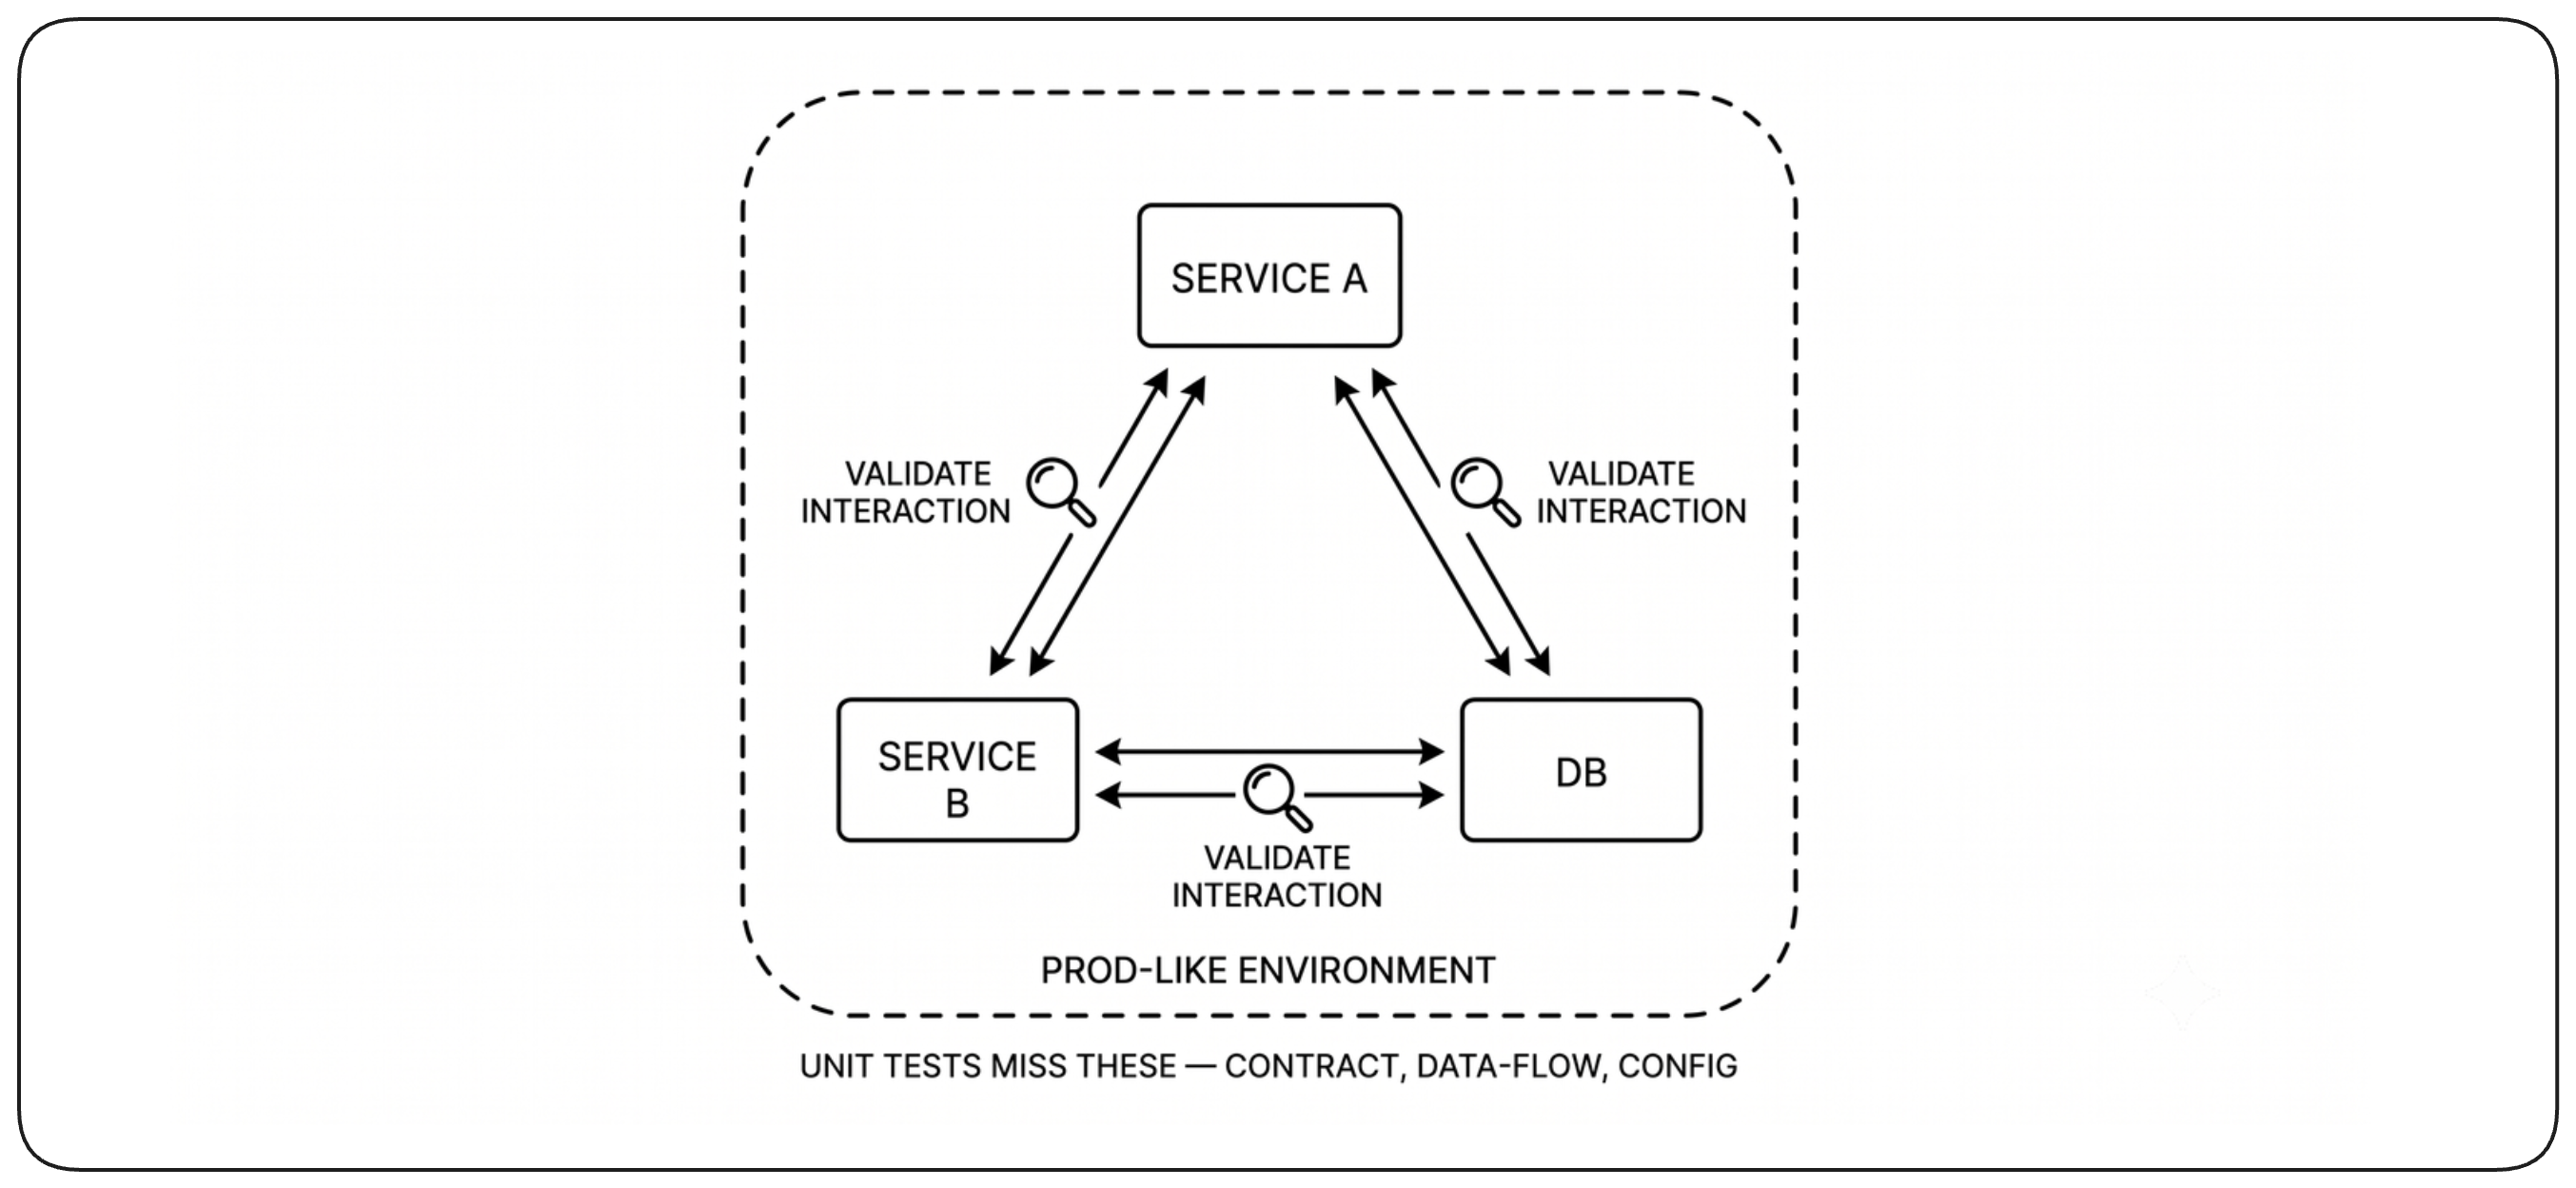
Les tests d’intégration valident que plusieurs composants fonctionnent correctement ensemble. Contrairement aux tests unitaires qui isolent chaque composant, les tests d’intégration vérifient les interactions entre services, bases de données, API et dépendances externes. Ces tests sont essentiels pour détecter les problèmes qui n’émergent que lorsque les composants sont combinés — contrats d’API incompatibles, problèmes de flux de données, erreurs de configuration. Les tests d’intégration doivent s’exécuter dans des environnements qui reproduisent fidèlement la production, pour que les mêmes interactions validées en test fonctionnent en production.
Prouver la rollbackabilité
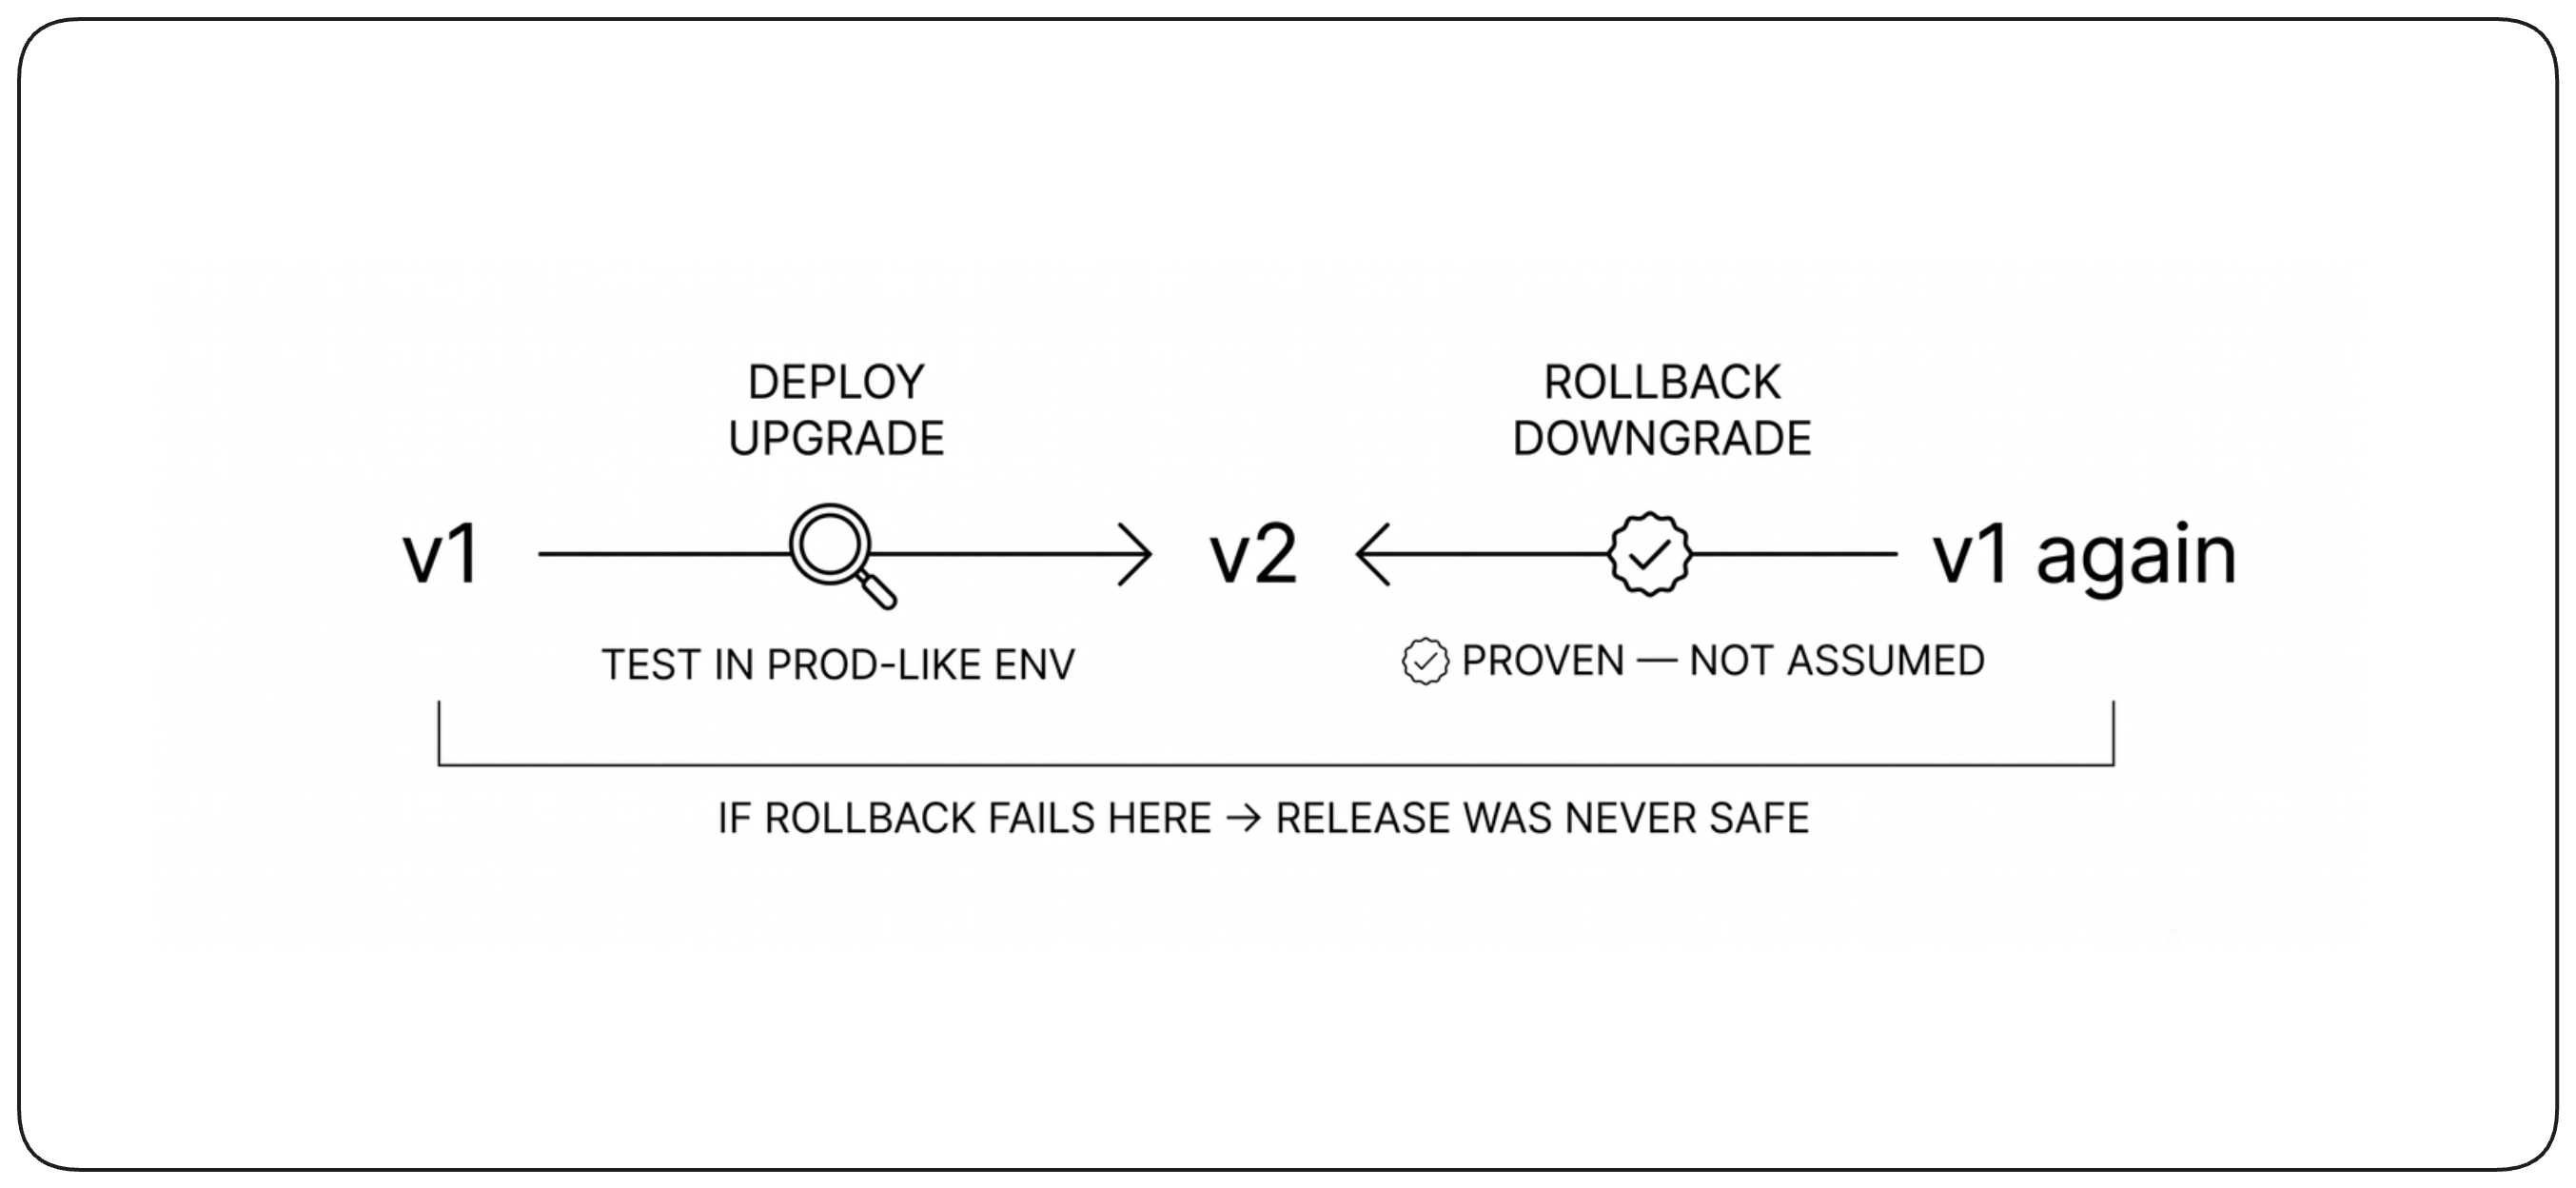
La rollbackabilité doit être démontrée, pas supposée. La seule façon fiable de la vérifier est de déployer un changement vers l’avant puis de l’annuler explicitement dans un environnement qui reproduit la production. Le test de montée et descente de version révèle des hypothèses cachées et des transitions dangereuses qui resteraient sinon indétectées. Si le rollback échoue pendant les tests, la release n’a jamais été sûre.
La triade de la configuration en profondeur
Cette section approfondit la triade de la configuration introduite plus haut, en examinant en détail les paramètres statiques, les paramètres dynamiques et les secrets.
Paramètres statiques
La réalité : l’éparpillement de la configuration
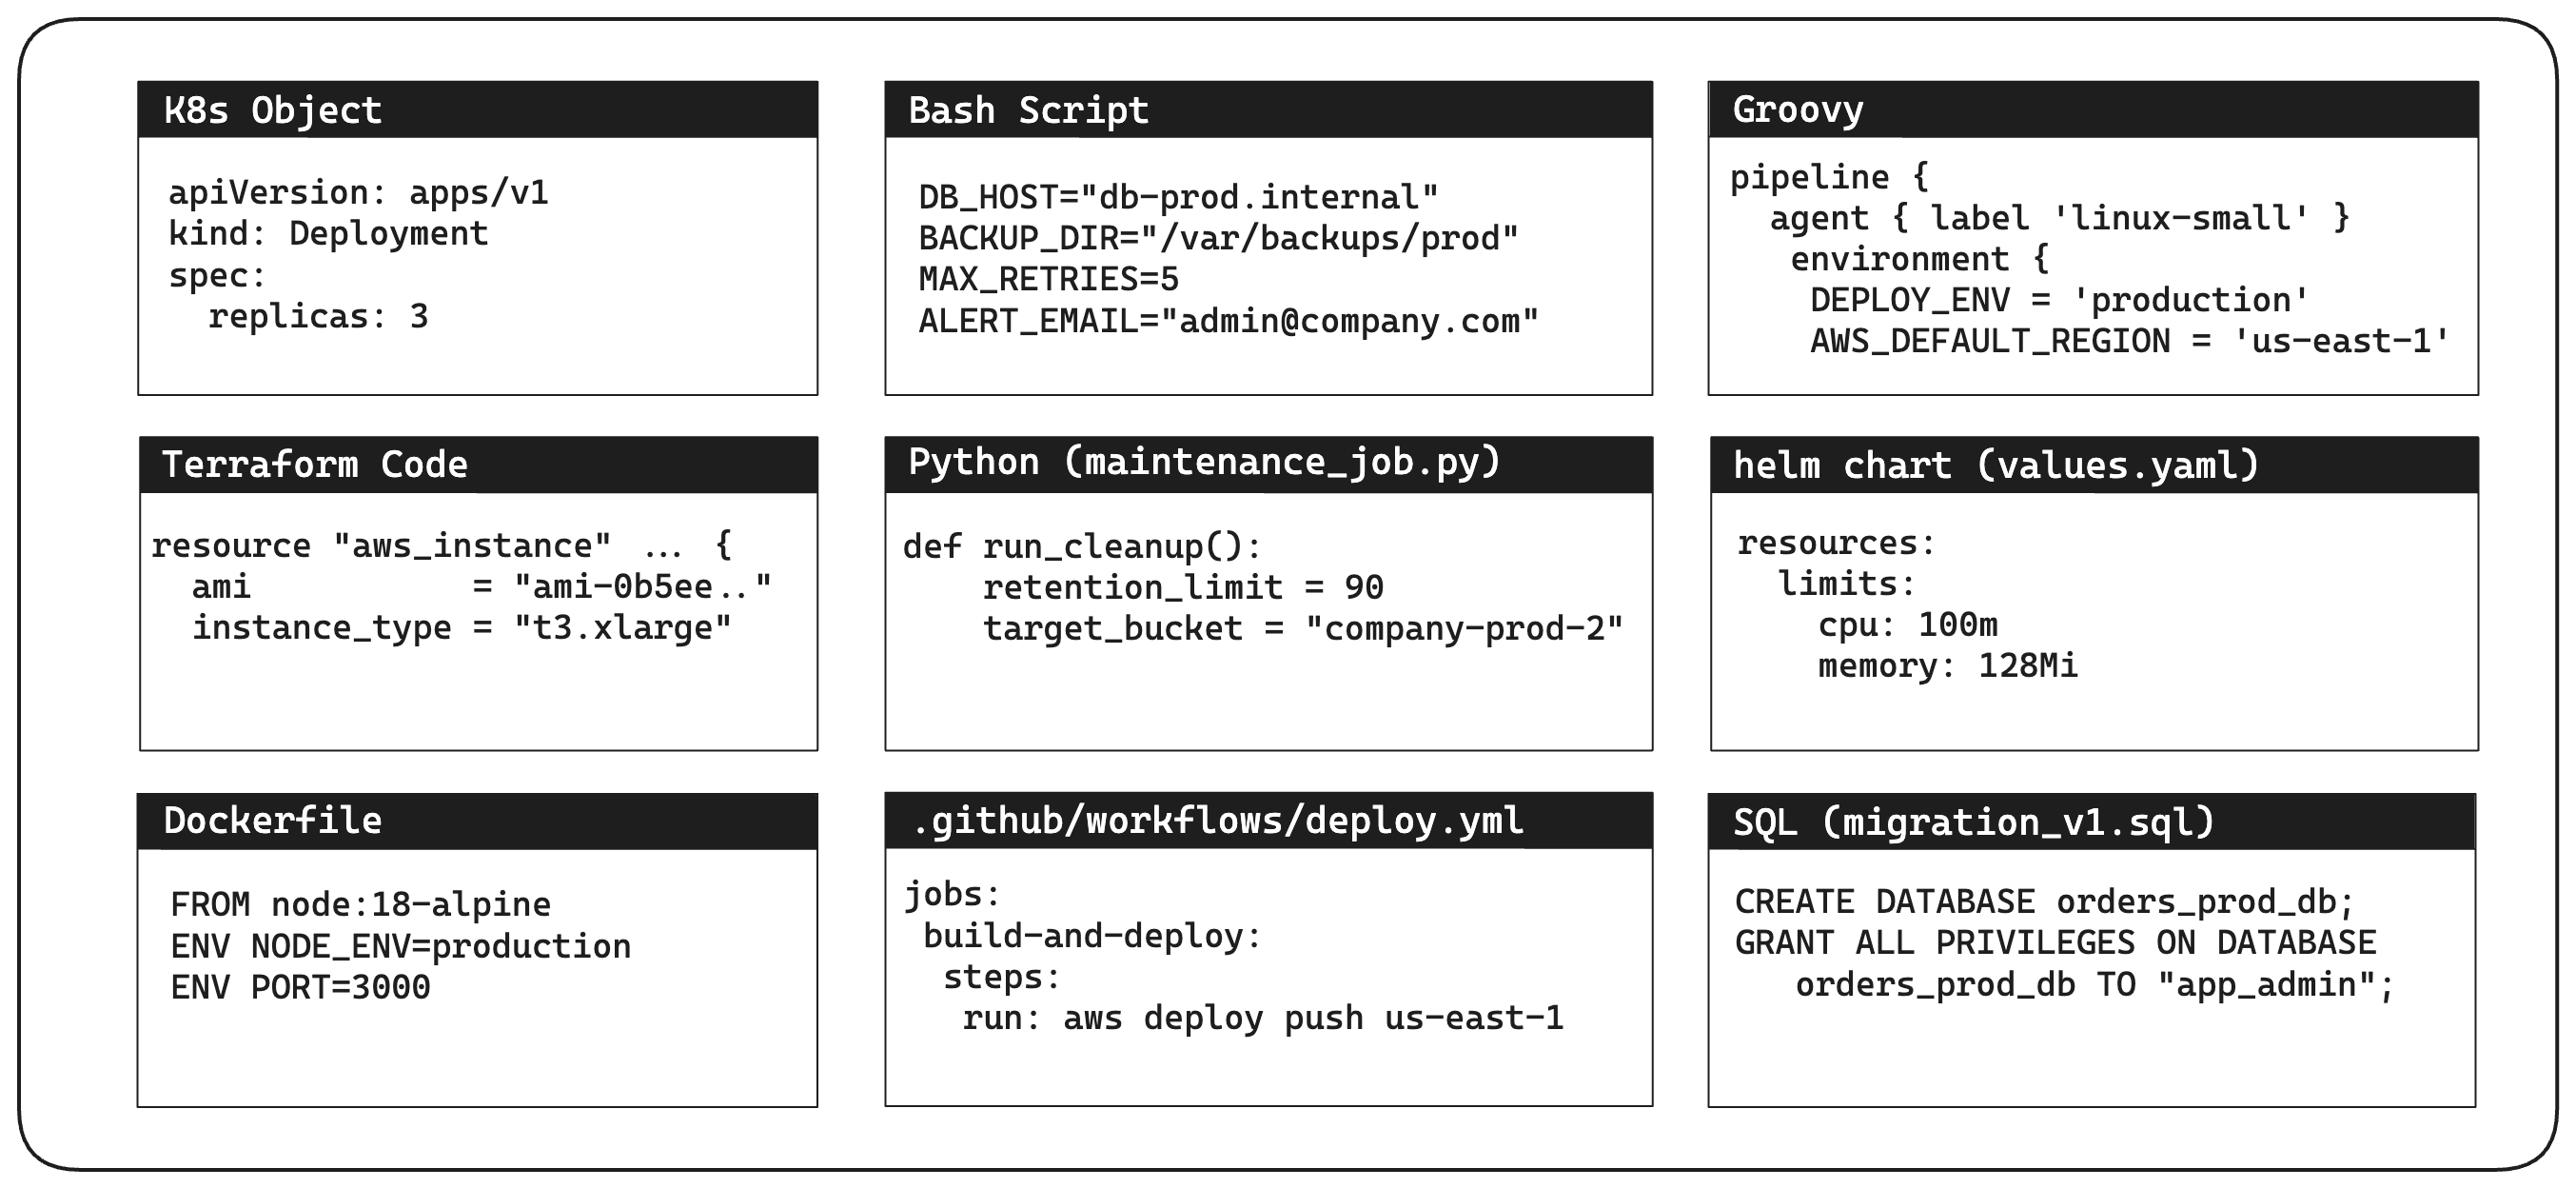
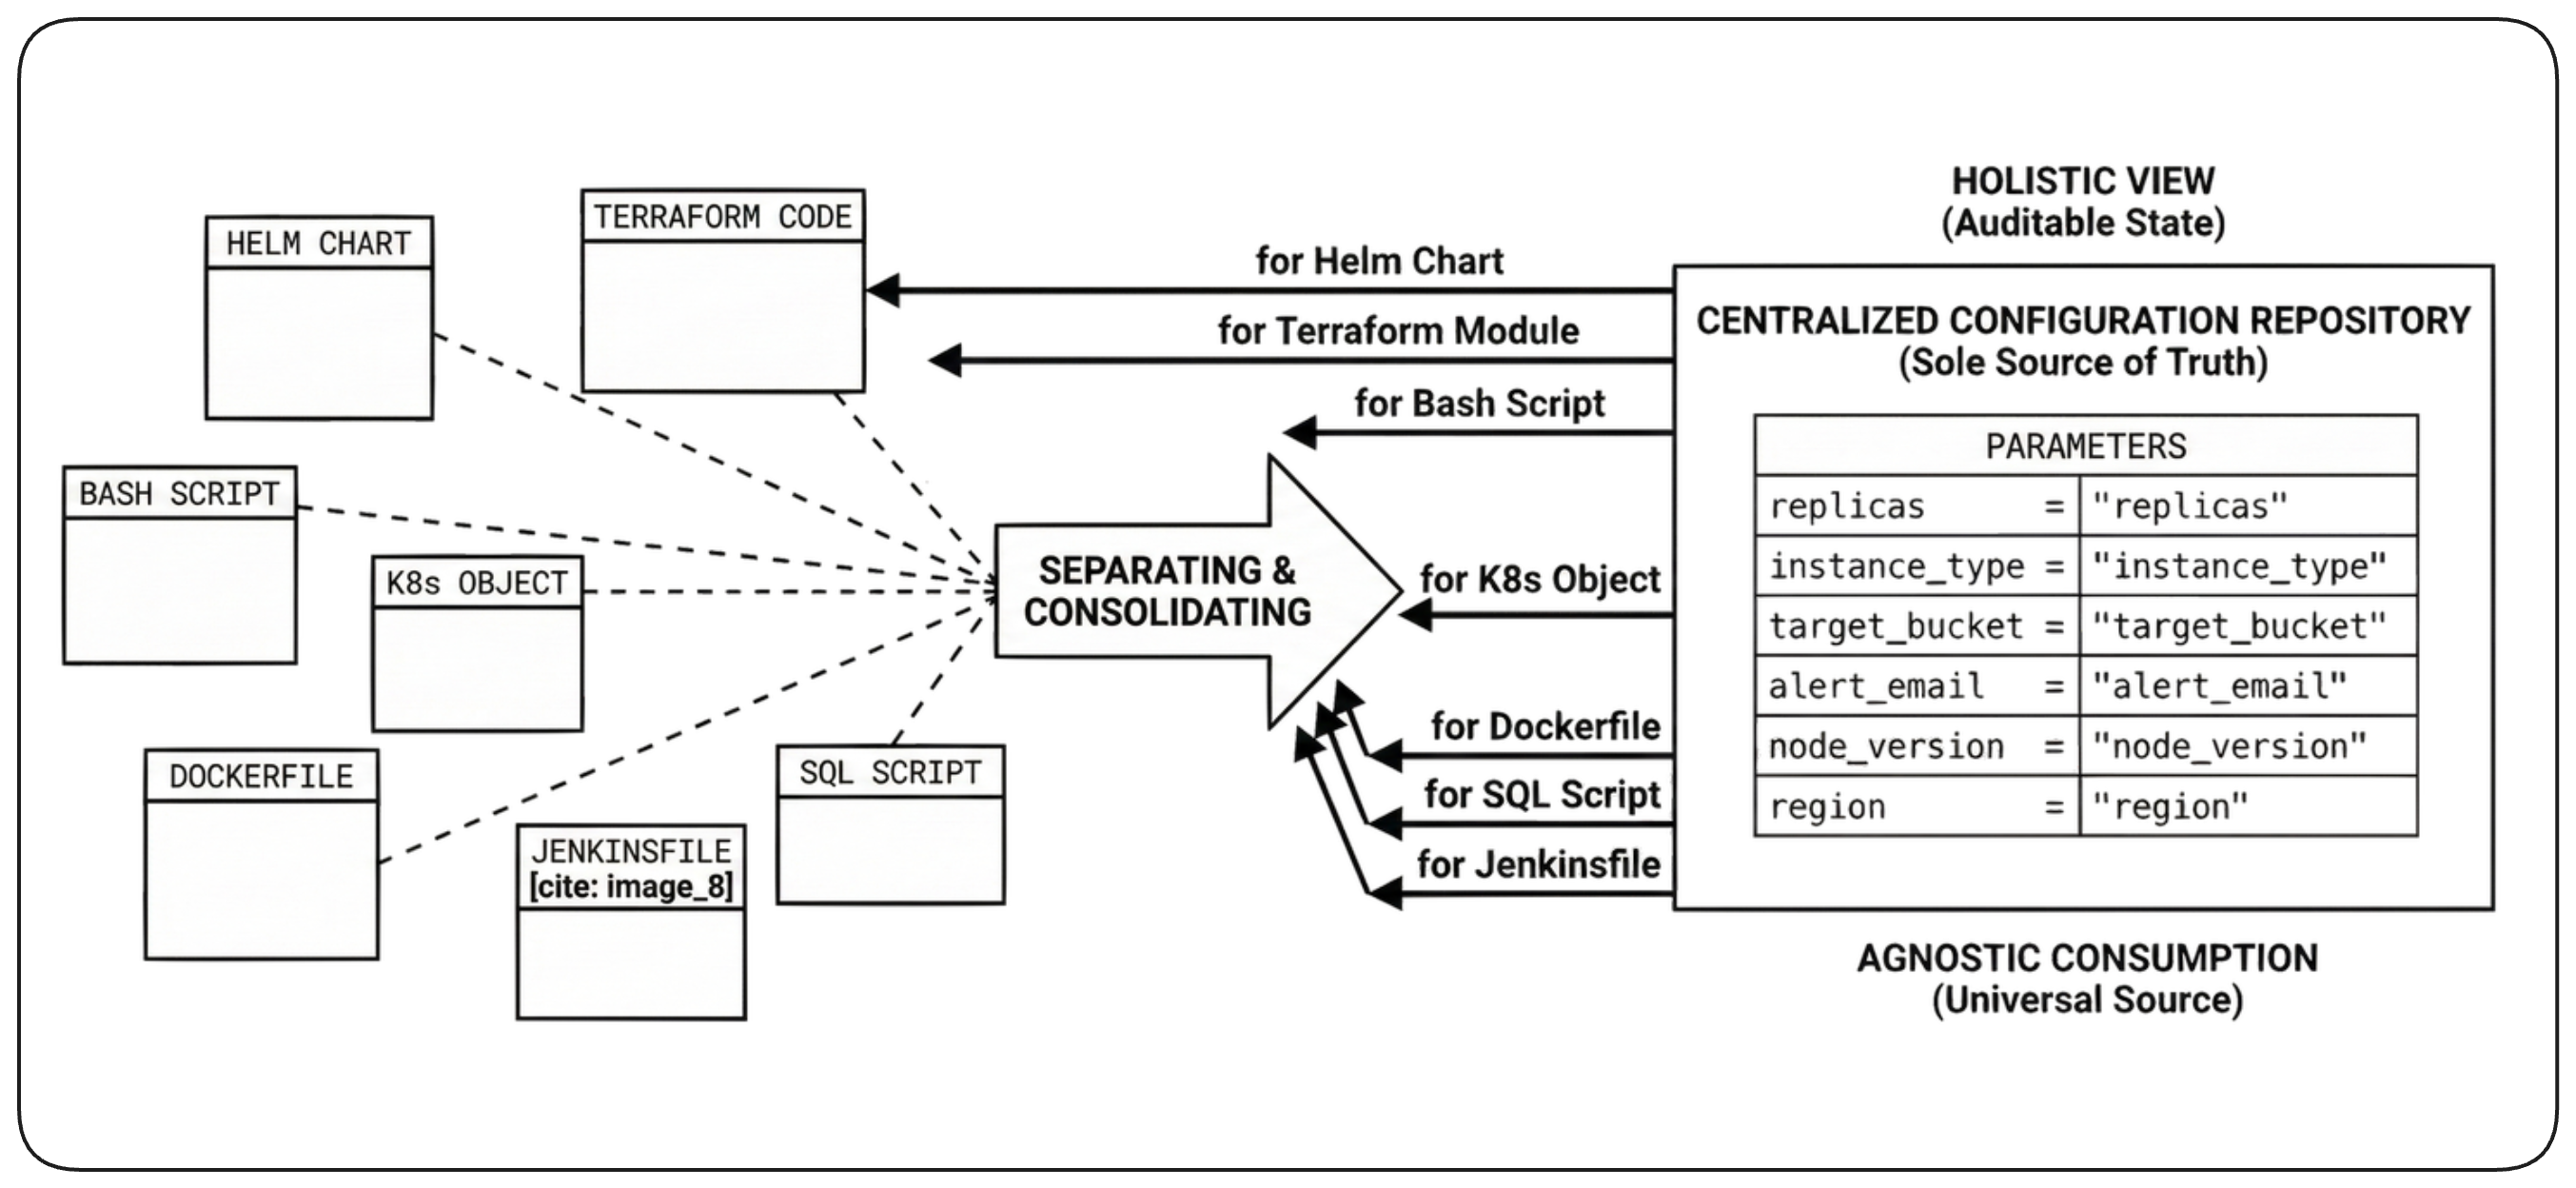
Trop souvent, les paramètres statiques sont profondément enfouis dans la logique d’implémentation. On les trouve codés en dur dans des templates Helm, noyés dans des blocs de ressources Terraform et dispersés dans des scripts Bash ou Python. Cette dispersion rend impossible toute vue consolidée de l’environnement. Se demander simplement « Quel était l’état exact de nos variables lors du déploiement de la semaine dernière ? » devient un projet d’enquête exigeant un audit manuel de toute la base de code.
Source unique de vérité
La solution exige un changement fondamental : séparer tous les paramètres statiques du code de déploiement et les consolider dans une entité unique qui sert de seule source de vérité. Ce dépôt centralisé est conçu pour une consommation agnostique ; peu importe que la donnée soit requise par un chart Helm, un module Terraform ou un script. En centralisant ces entrées, on obtient une vue d’ensemble de l’état voulu du système, et l’historique de configuration devient un actif accessible et auditable.
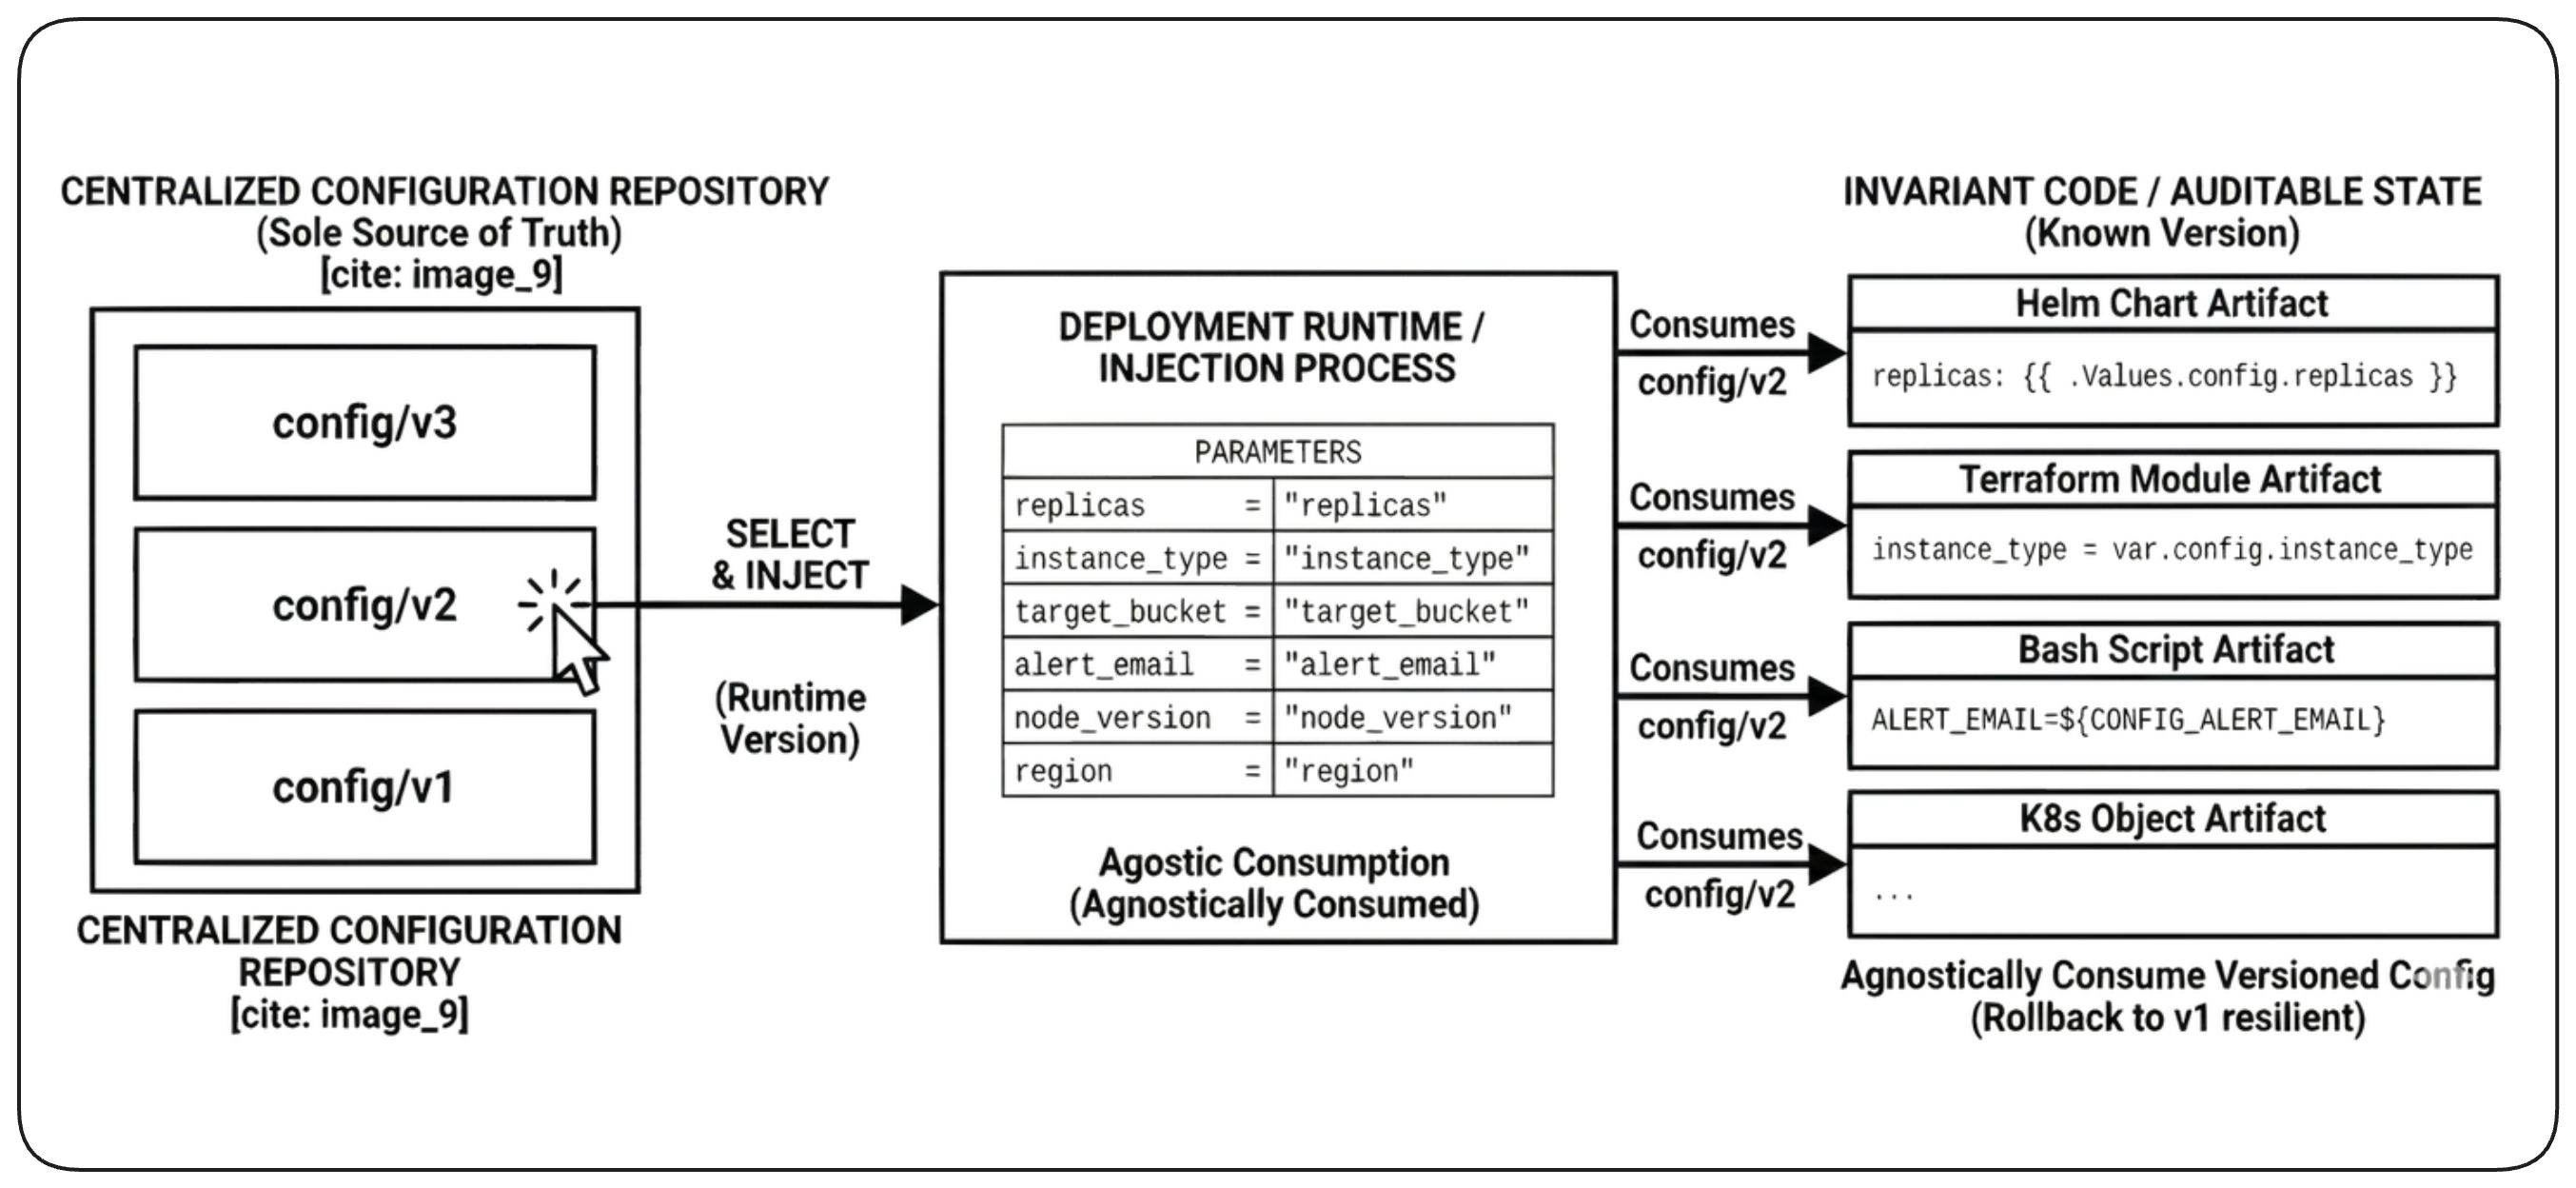
Injection à l’exécution d’une configuration versionnée
Le dépôt central traite la configuration comme du code versionné et immuable. À l’exécution, une version précise est injectée dans le runtime. Les artefacts de déploiement restent ainsi invariants d’un environnement à l’autre, tout en garantissant un état du système entièrement auditable. Les rollbacks deviennent simples : il suffit d’associer la version précédente de l’artefact à la version précédente de la configuration.
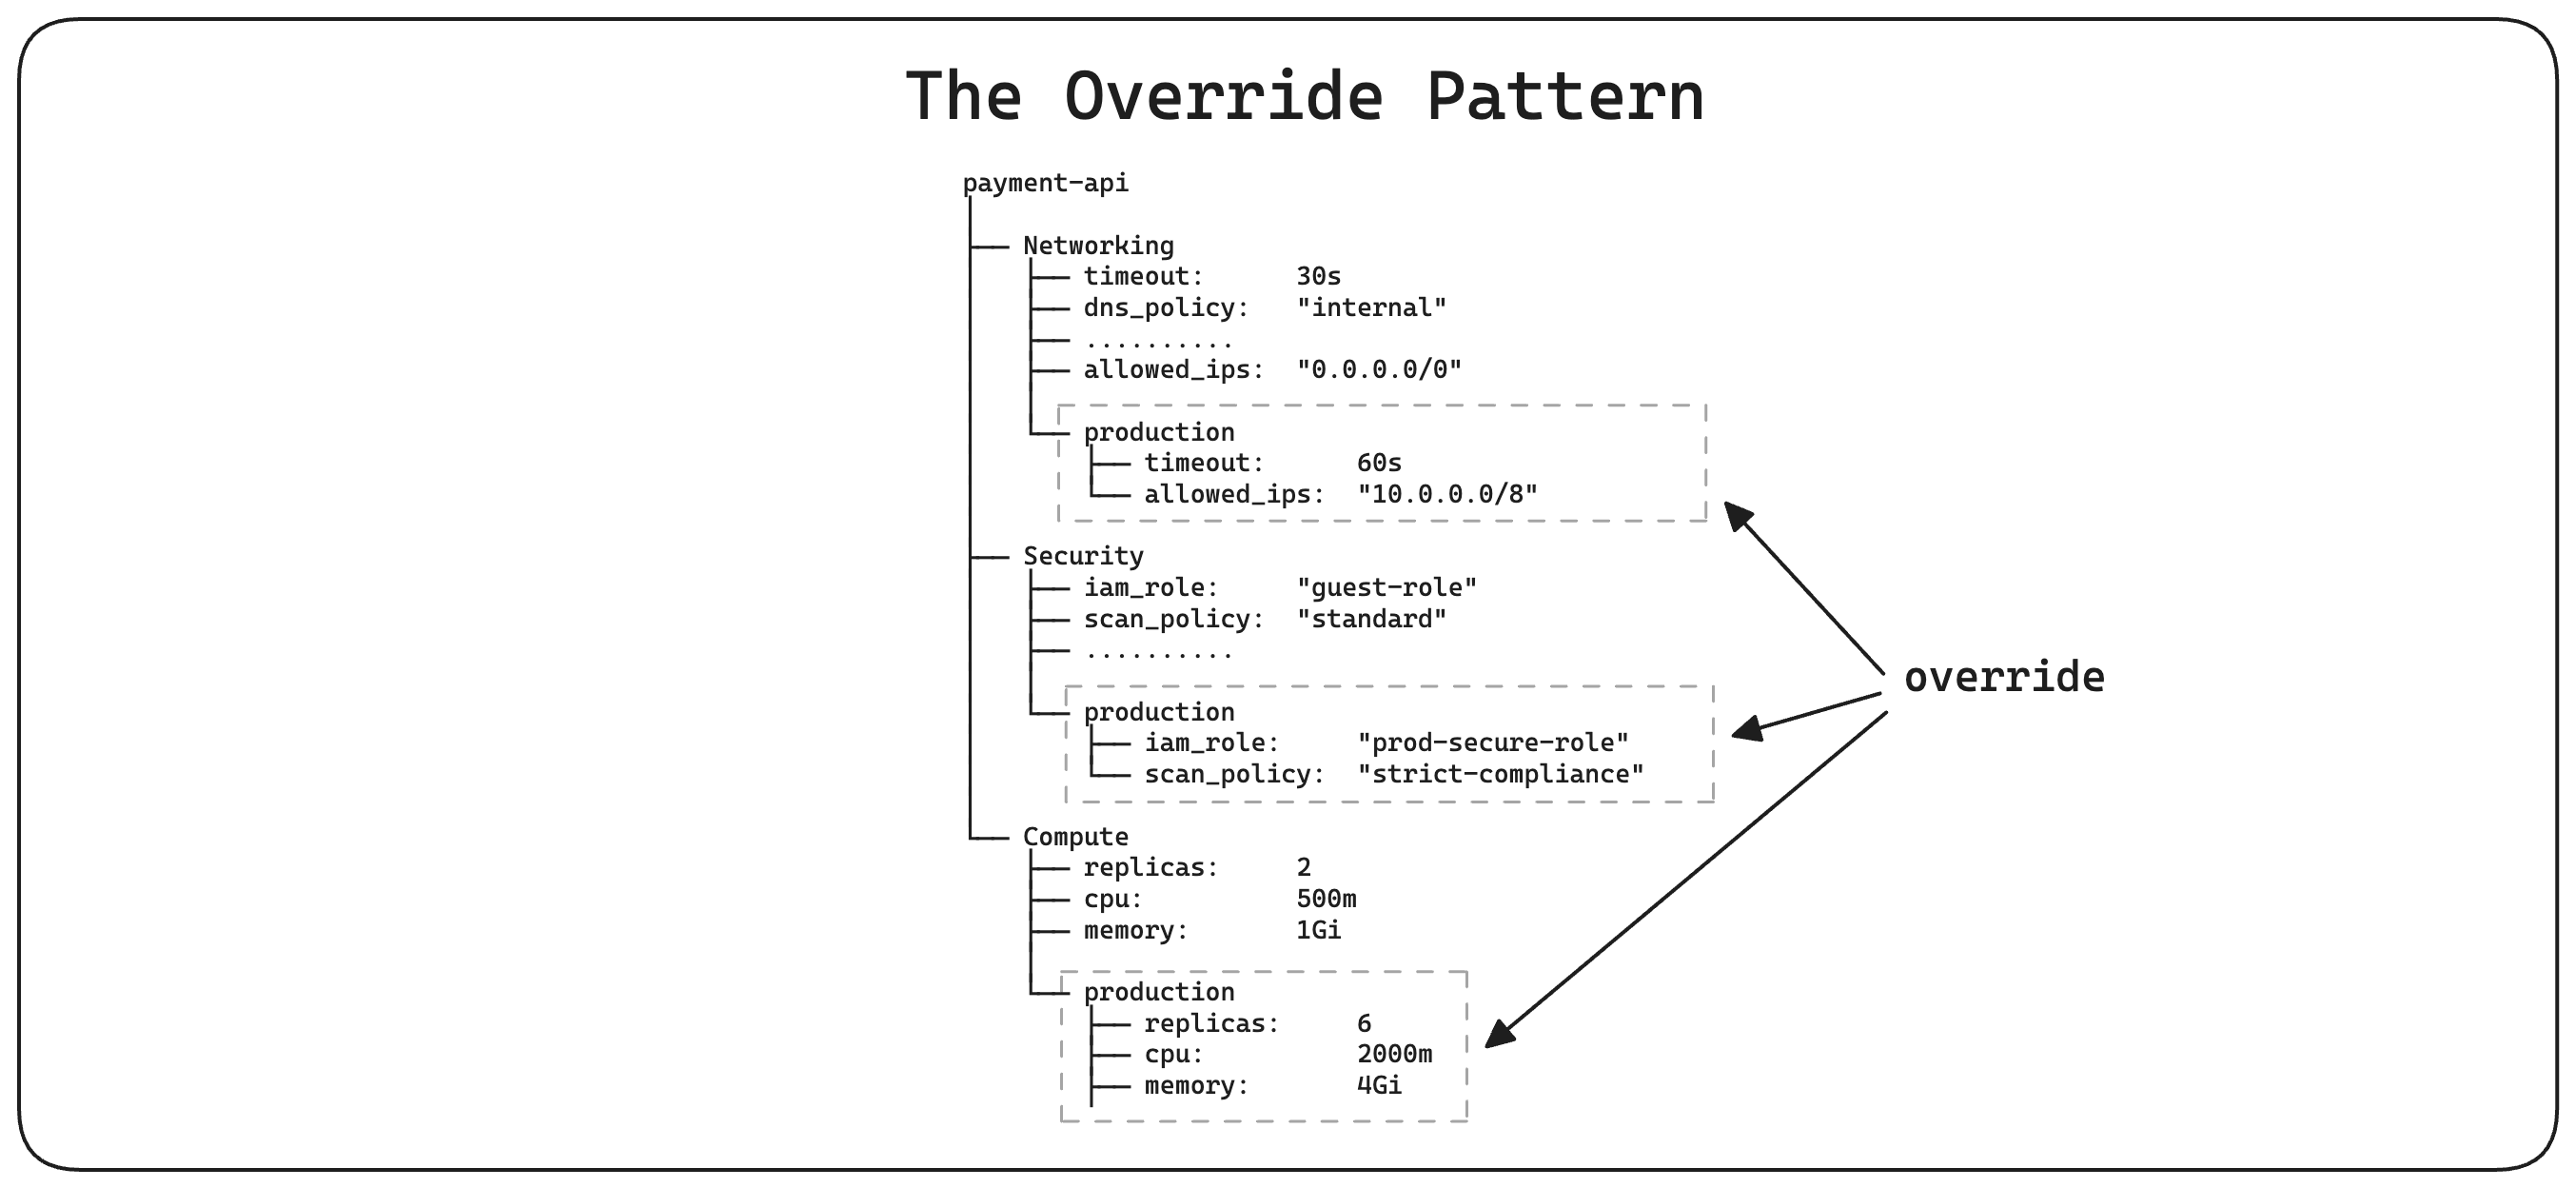
Le pattern d’override
Une gestion efficace repose sur une conception orientée valeurs par défaut. En définissant un fichier de configuration générique rempli de valeurs standard, on établit une base pour la majorité des environnements. Les cibles spécifiques, comme la production, sont gérées par des « deltas » — des fichiers ne contenant que les overrides nécessaires. Cette méthode isole les différences critiques entre environnements, élimine les erreurs de duplication et accélère le provisioning de nouvelle infrastructure.
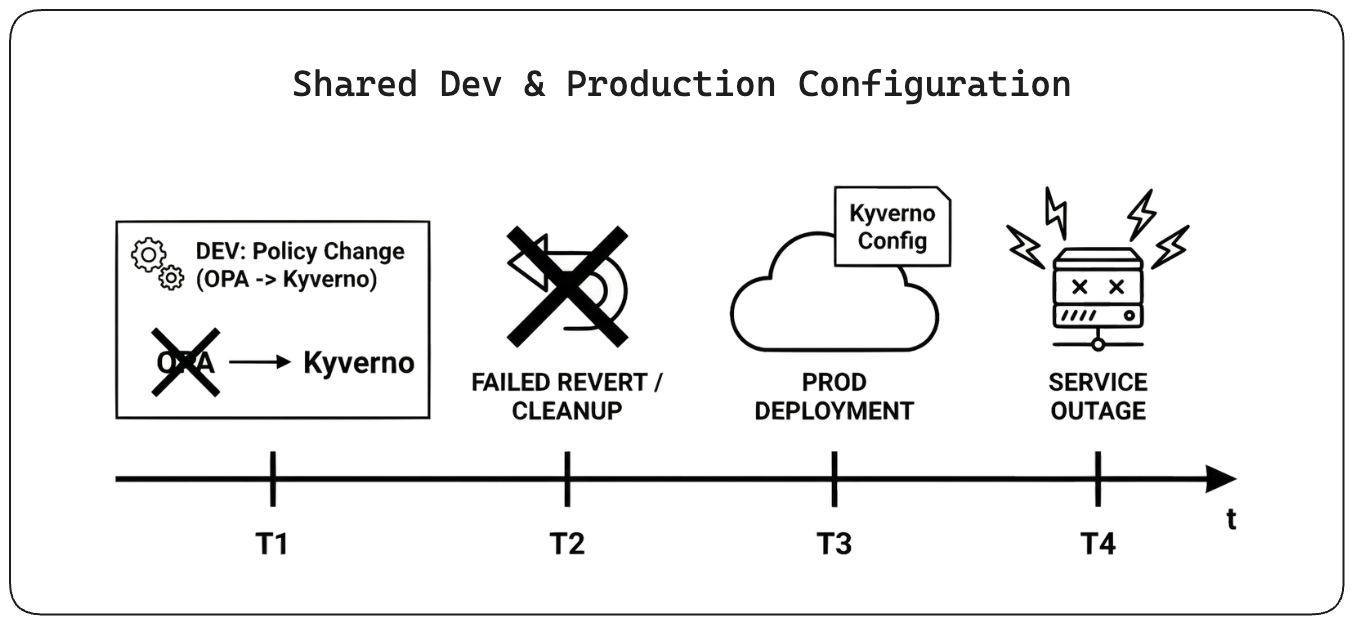
Le principe d’isolation de la configuration
Les configurations de production et de hors-production doivent rester strictement indépendantes pour éviter la « fuite de configuration ». Il est vital de s’assurer que les réglages utilisés pour tester de nouvelles mesures de sécurité ou des migrations techniques ne puissent jamais migrer par inadvertance vers l’environnement live. Sans cette séparation totale, un simple oubli de nettoyage après un test peut appliquer des restrictions bloquantes à tous les utilisateurs légitimes, transformant une erreur de manipulation mineure en panne majeure. Nous explorerons dans une section ultérieure des patterns de configuration hiérarchique qui imposent cette séparation par conception.
Paramètres dynamiques
Capturer la réalité vs définir l’intention
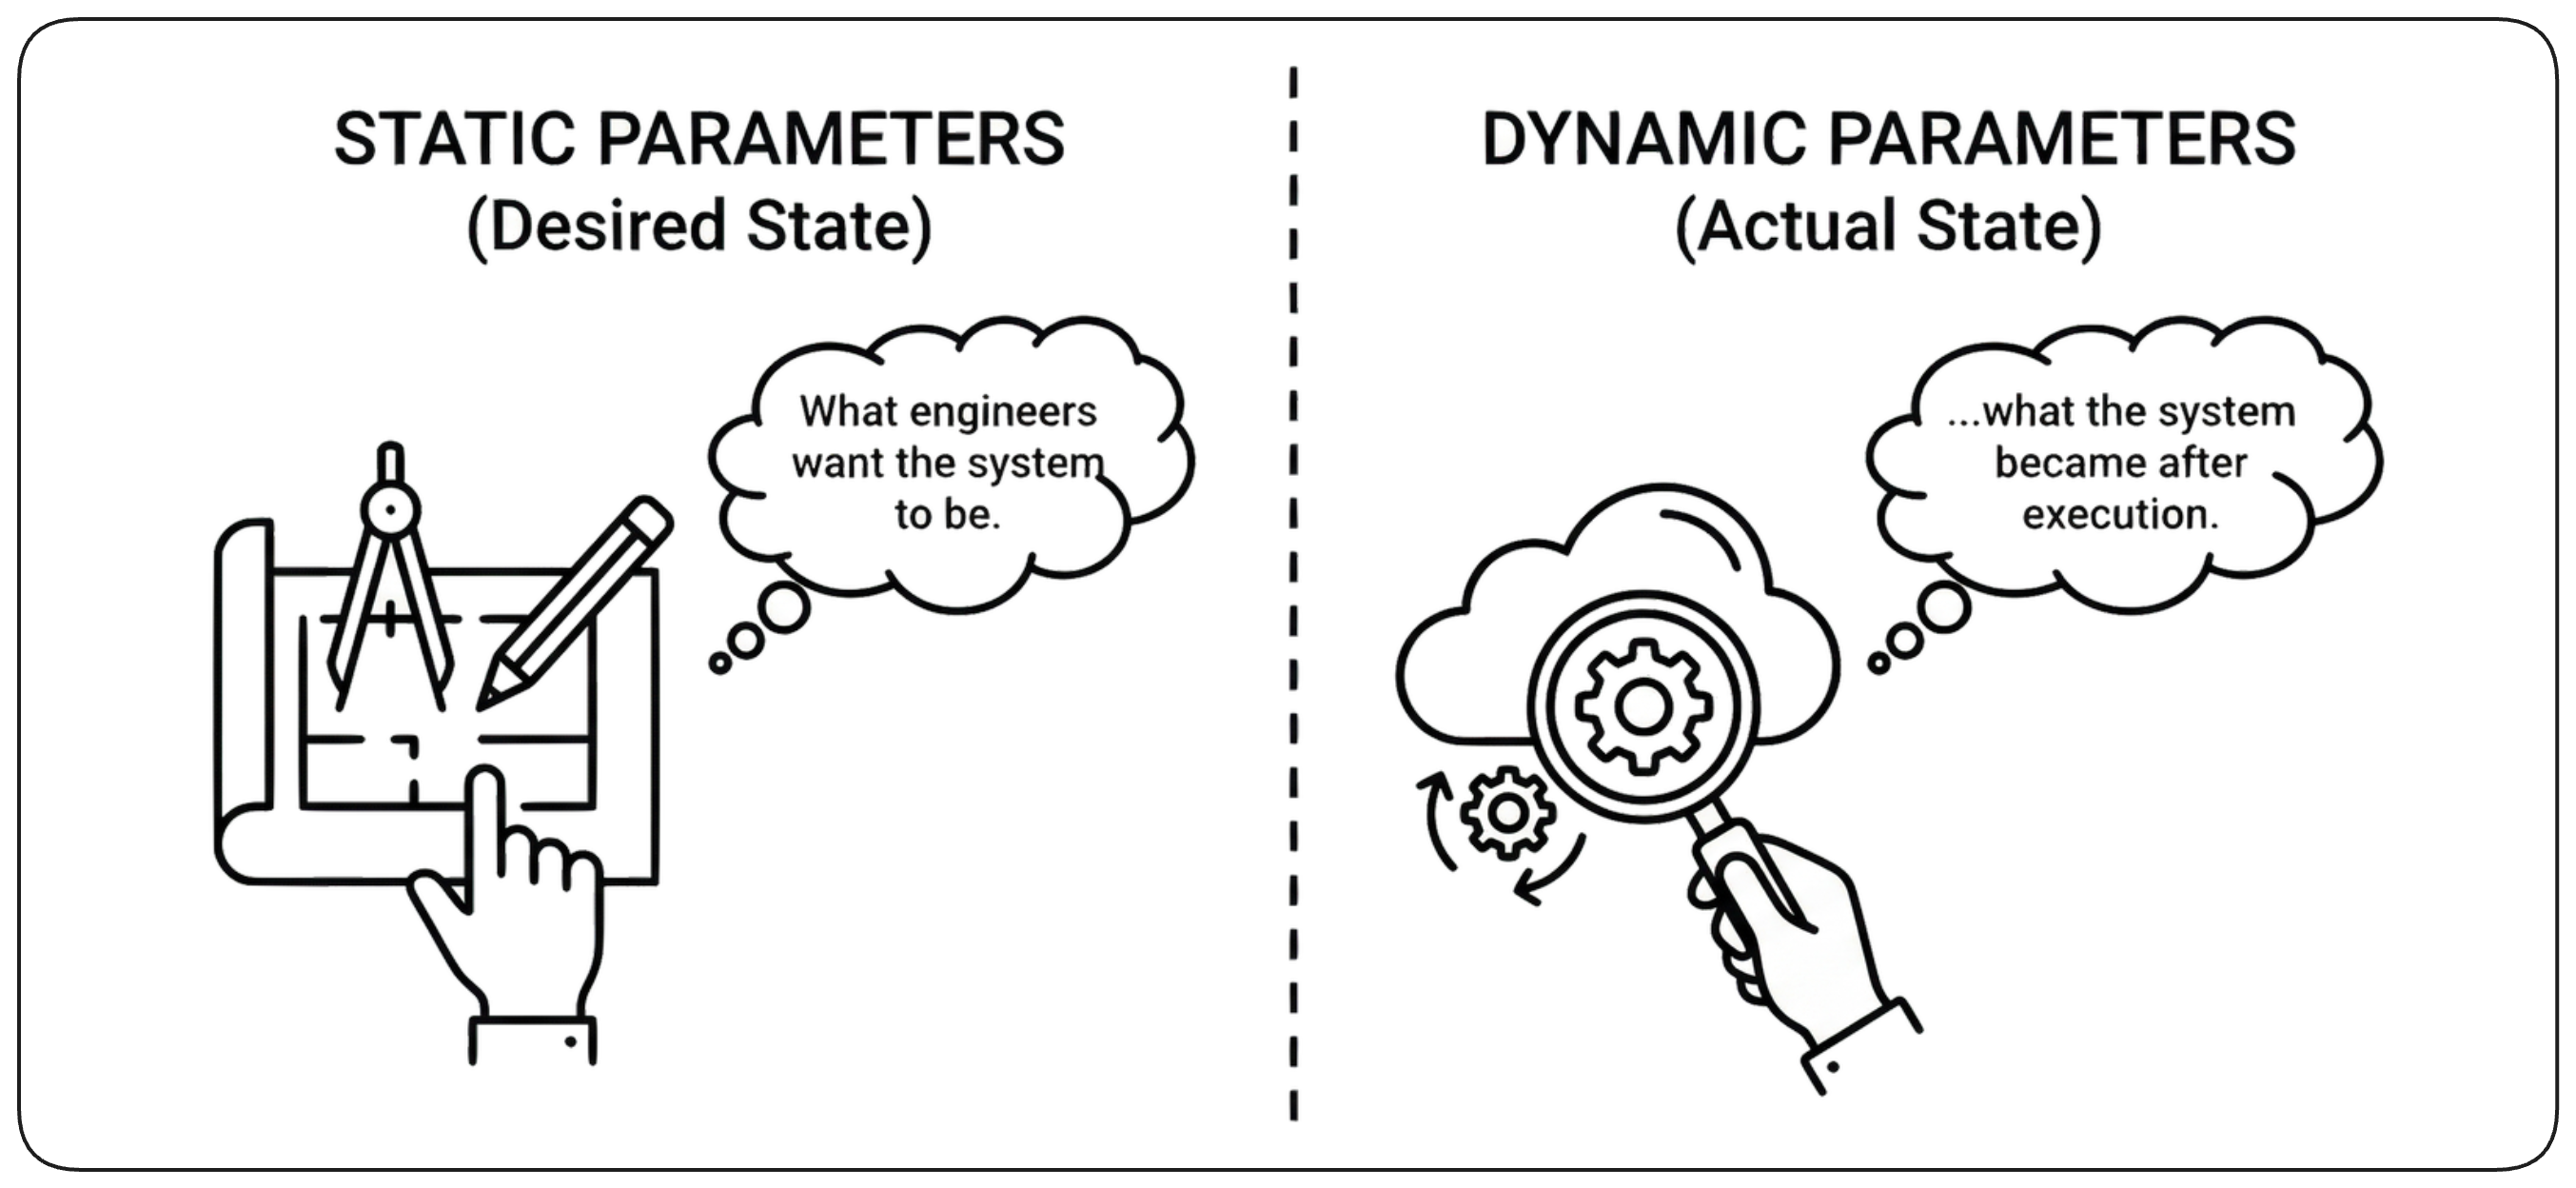
Alors que les paramètres statiques représentent l’état désiré (ce que les ingénieurs veulent que le système soit), les paramètres dynamiques capturent l’état réel (ce que le système est devenu après l’exécution). On ne peut pas versionner le futur ; on ne peut que le découvrir. Un nom DNS de load balancer unique ou un ID de VPC généré par un fournisseur cloud n’existe pas avant le provisioning de l’infrastructure. Ces valeurs représentent donc la réalité immuable de l’environnement live.
Stratégies pour récupérer le contexte dynamique
Comme les paramètres dynamiques sont générés à l’exécution, ils ne peuvent pas être stockés dans Git comme la configuration statique. La mécanique de déploiement a donc besoin d’une stratégie fiable pour récupérer ces valeurs et les transmettre au workload dépendant. Nous explorons ci-dessous trois stratégies distinctes pour relever ce défi.
Stratégie 1 : passage direct dans le pipeline (couplé)
La méthode la plus simple se déroule entièrement au sein d’une seule exécution de pipeline. À l’étape A, un processus (comme Terraform) crée l’infrastructure et produit des valeurs (par ex. un endpoint de base de données). Ces valeurs sont transmises immédiatement « à la volée » à l’étape B (déploiement de l’application) via la mémoire ou des fichiers temporaires.
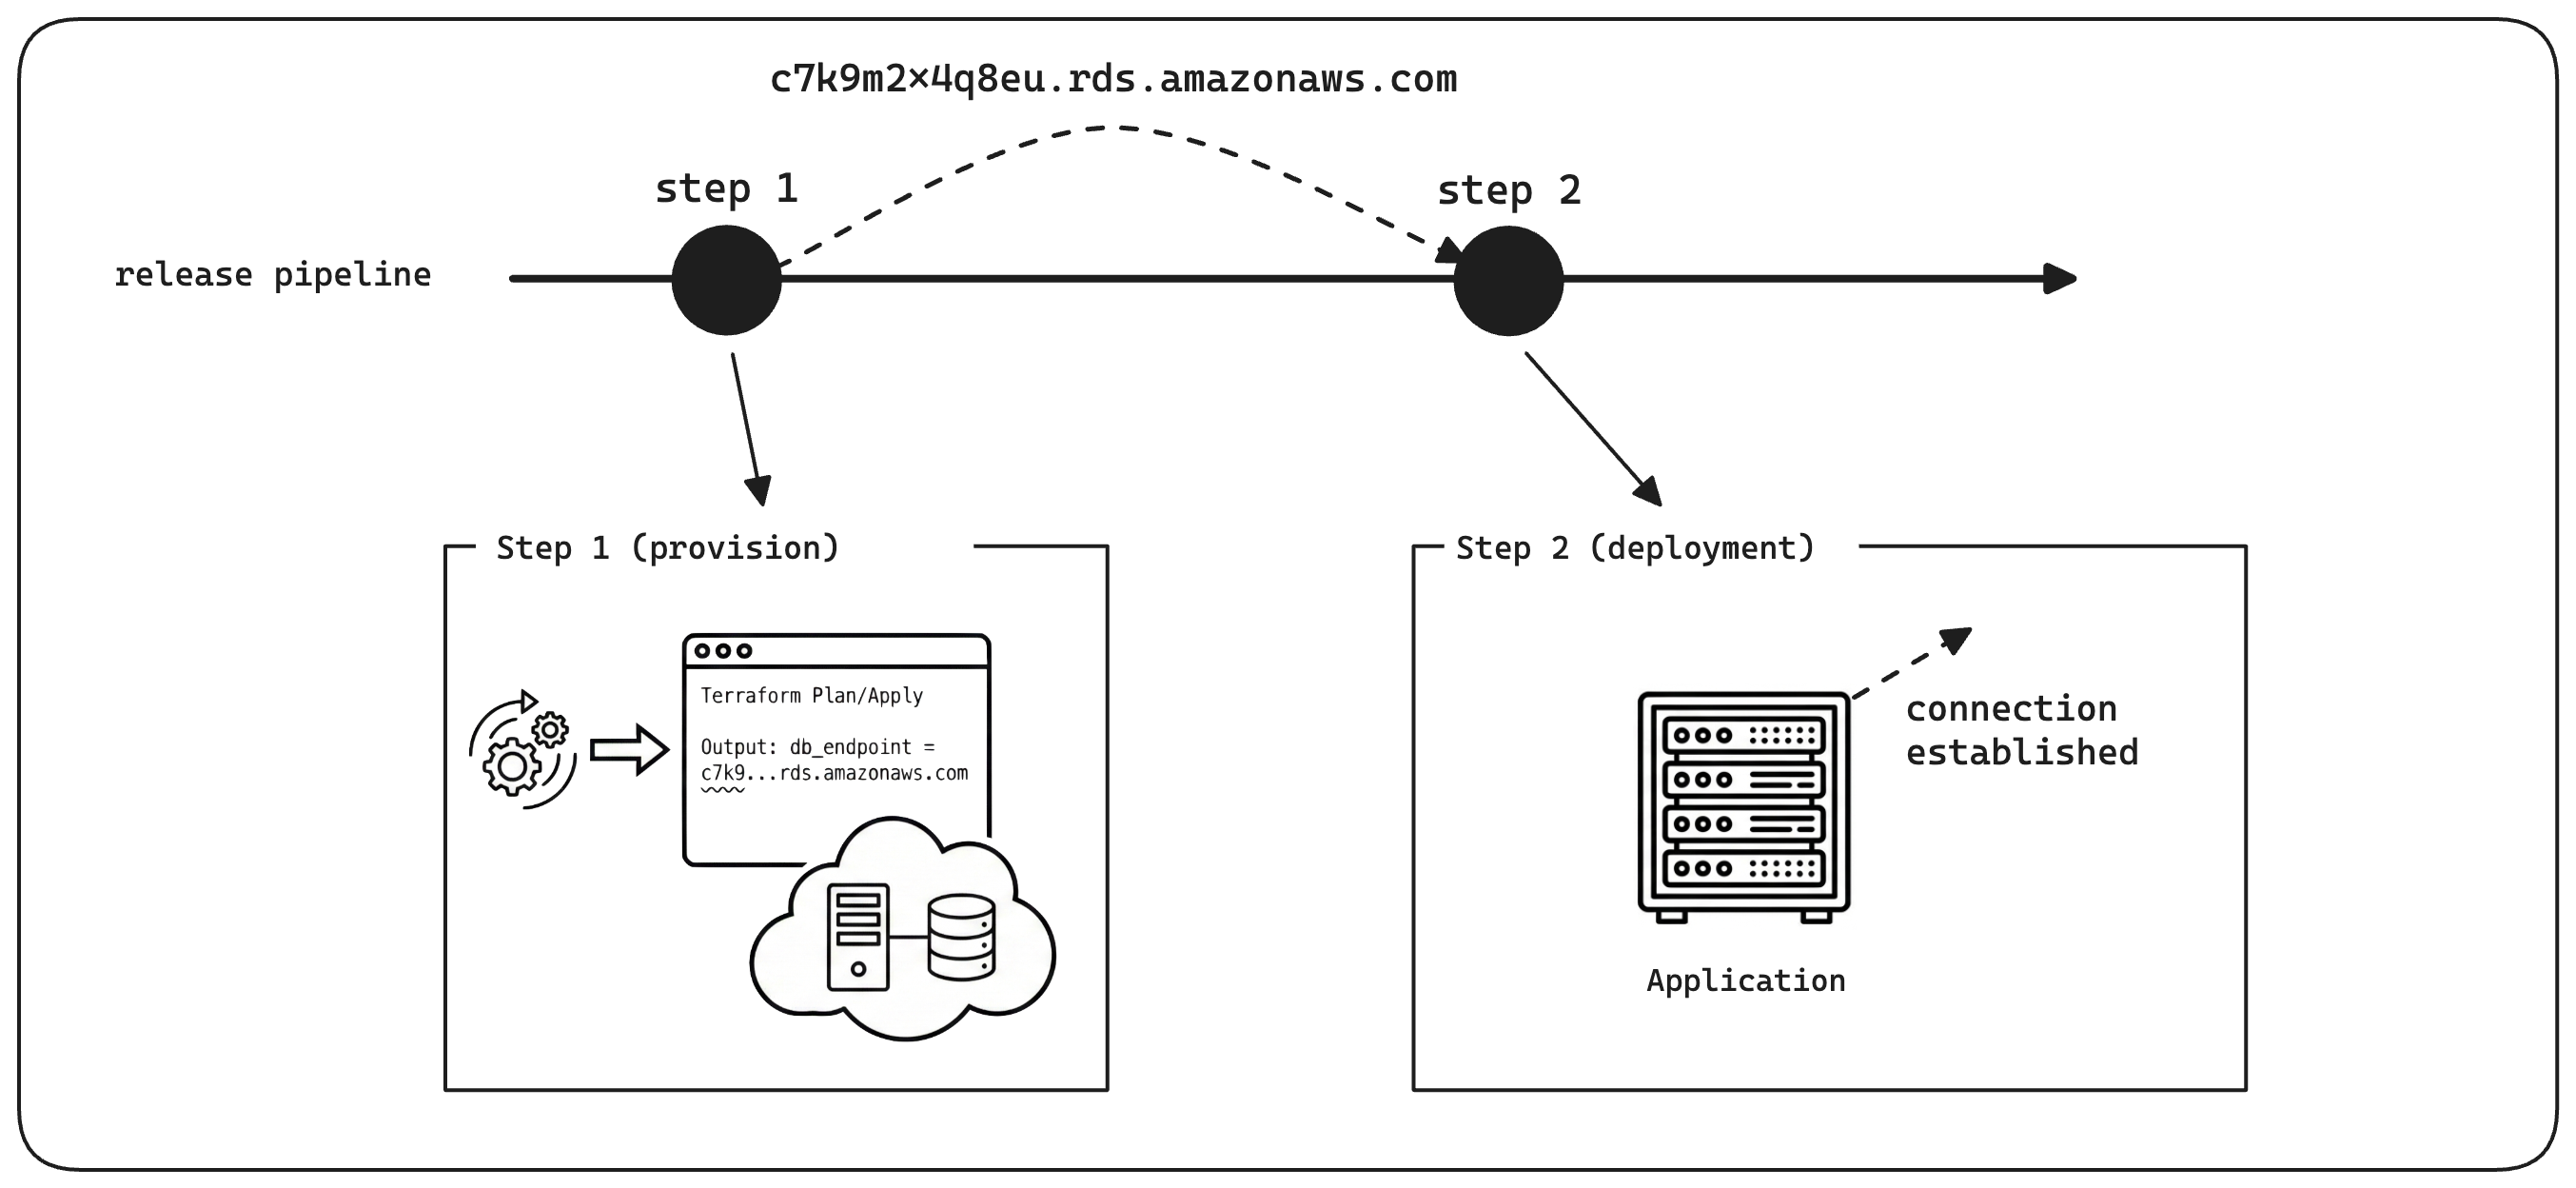
L’inconvénient : cela crée un couplage fort. On ne peut pas déployer l’application sans exécuter le code d’infrastructure. La modularité est limitée et les retries deviennent difficiles, car la donnée est éphémère — si le pipeline plante, l’état est perdu.
Stratégie 2 : interrogation directe du cloud (découverte)
Cette approche découple fondamentalement le cycle de vie du provisioning de celui du déploiement applicatif. Contrairement à la stratégie du « pipeline unique », ces deux processus fonctionnent indépendamment, sans partager de mémoire, de fichiers temporaires ni de contexte d’exécution. Pour combler cet écart, le pipeline de déploiement doit « découvrir » son environnement. Au lieu de recevoir passivement les valeurs, il interroge activement la réalité en utilisant les API cloud pour requêter l’infrastructure live, généralement en filtrant les ressources par des tags spécifiques attribués à la création.
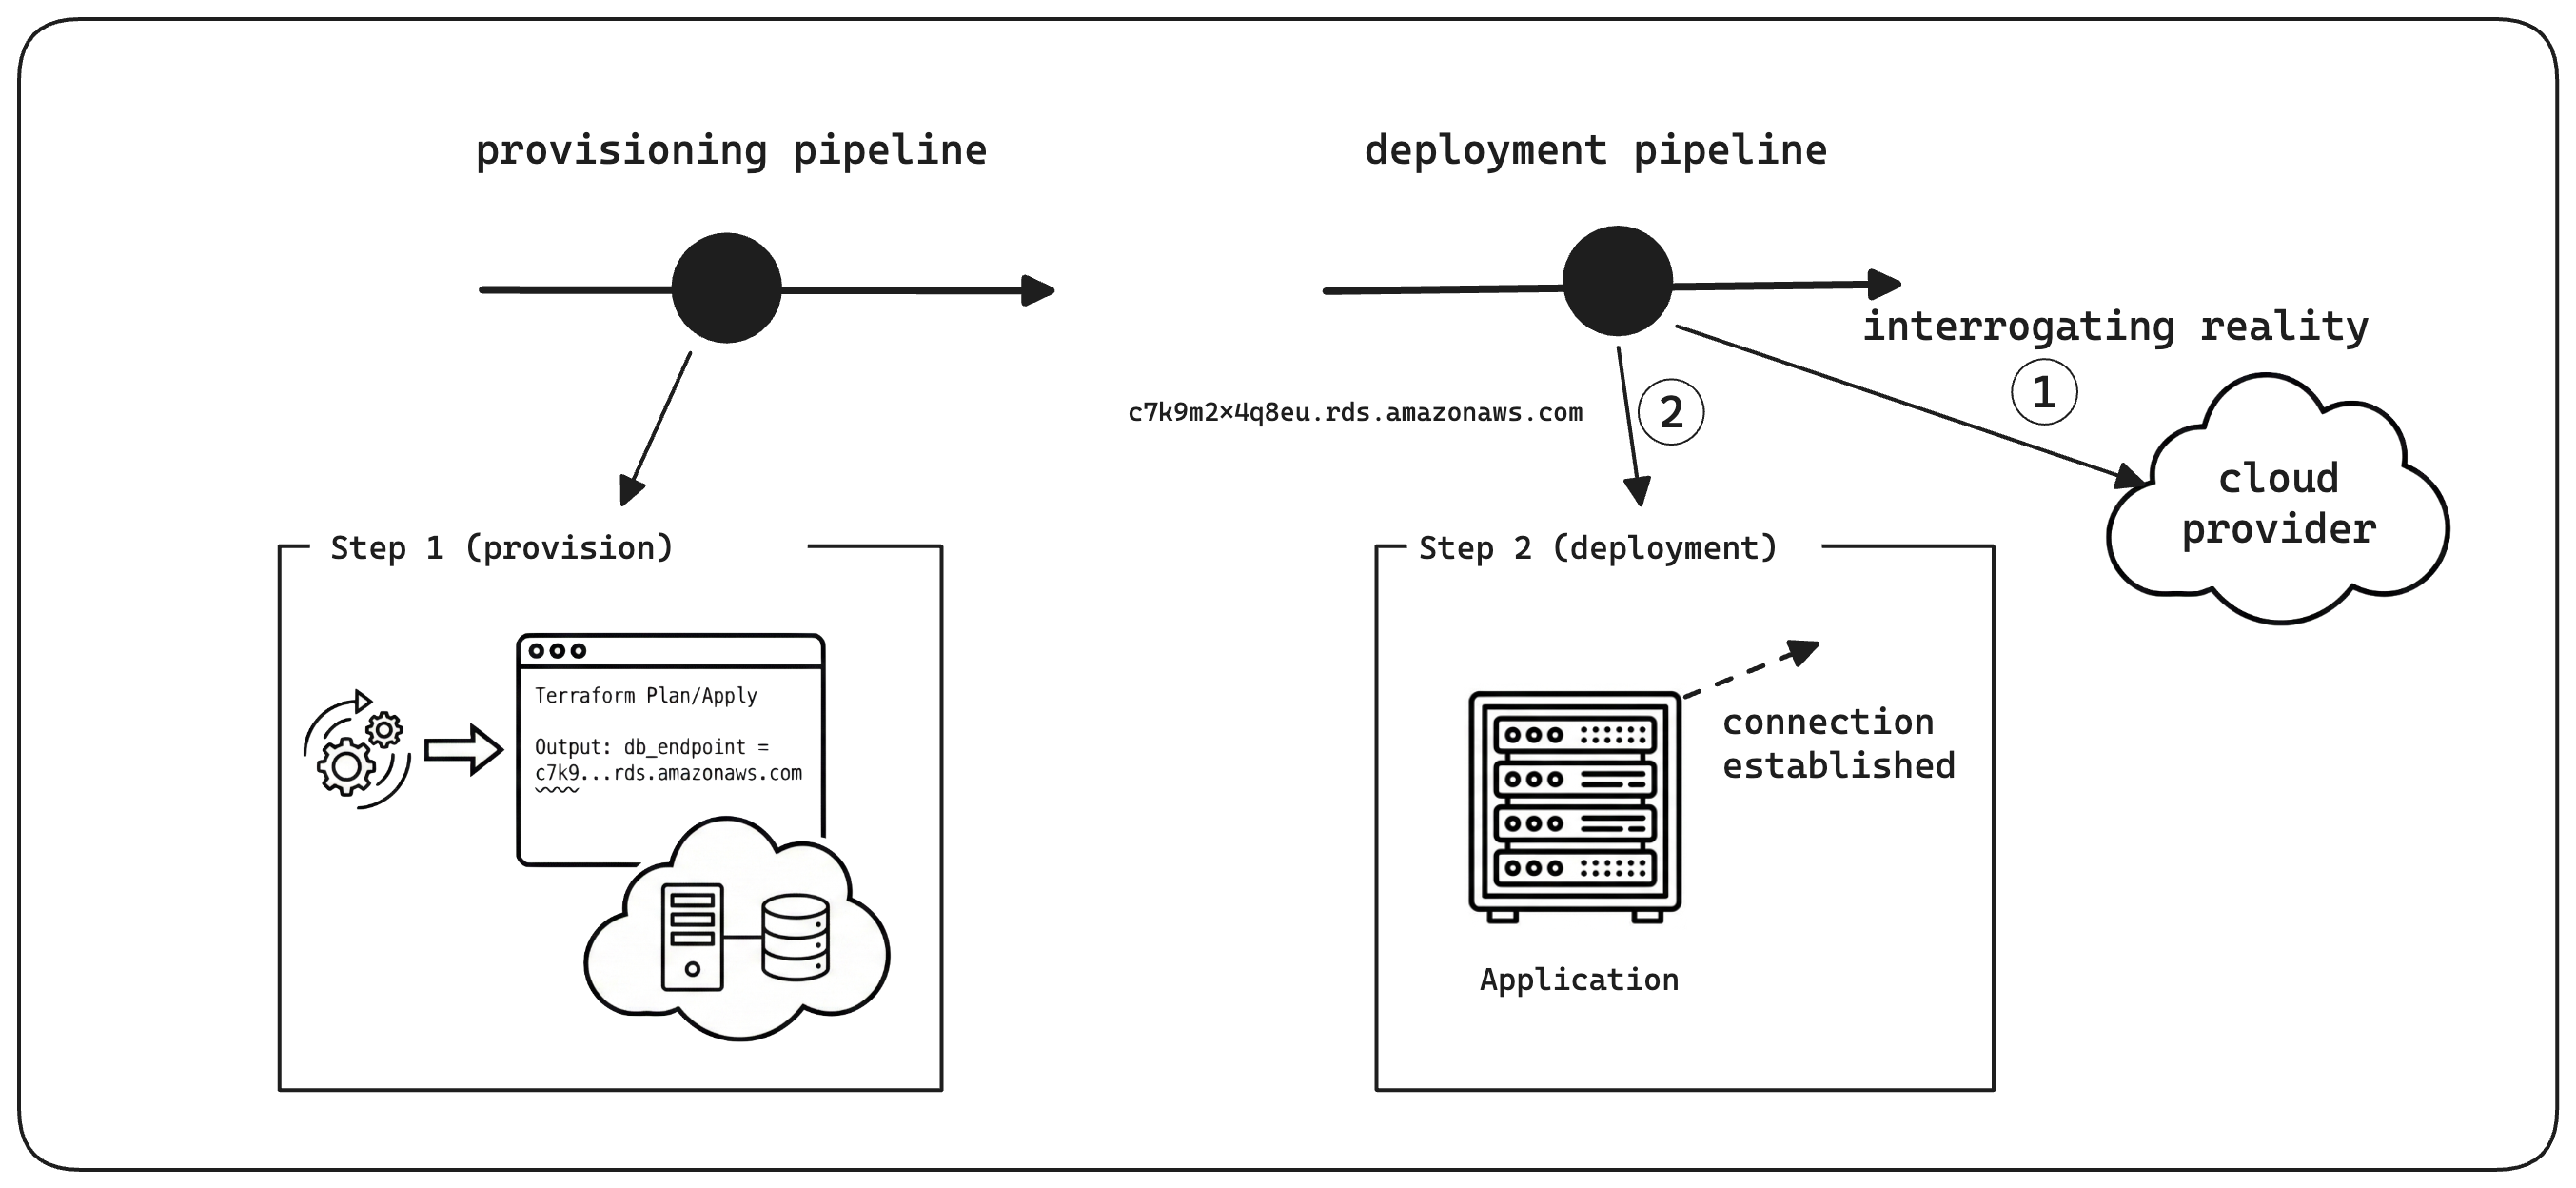
L’inconvénient : cela introduit une forte dépendance à des API externes. On souffre de problèmes de scalabilité et de performance (latence, rate-limiting/throttling par le fournisseur cloud) et de fragilité — si un tag est modifié à la main, le déploiement casse.
Stratégie 3 : persistance d’état dédiée (le pattern recommandé)
La méthode la plus robuste utilise un service de stockage intermédiaire dédié. Le processus qui crée les ressources (par ex. Terraform) « publie » explicitement uniquement les sorties pertinentes dans un magasin de données persistant (comme un store clé-valeur ou une base de données). La consommation devient alors sans effort : tout système aval ou tout utilisateur n’a qu’à interroger le store pour récupérer la valeur, ce qui découple l’accès de la création.
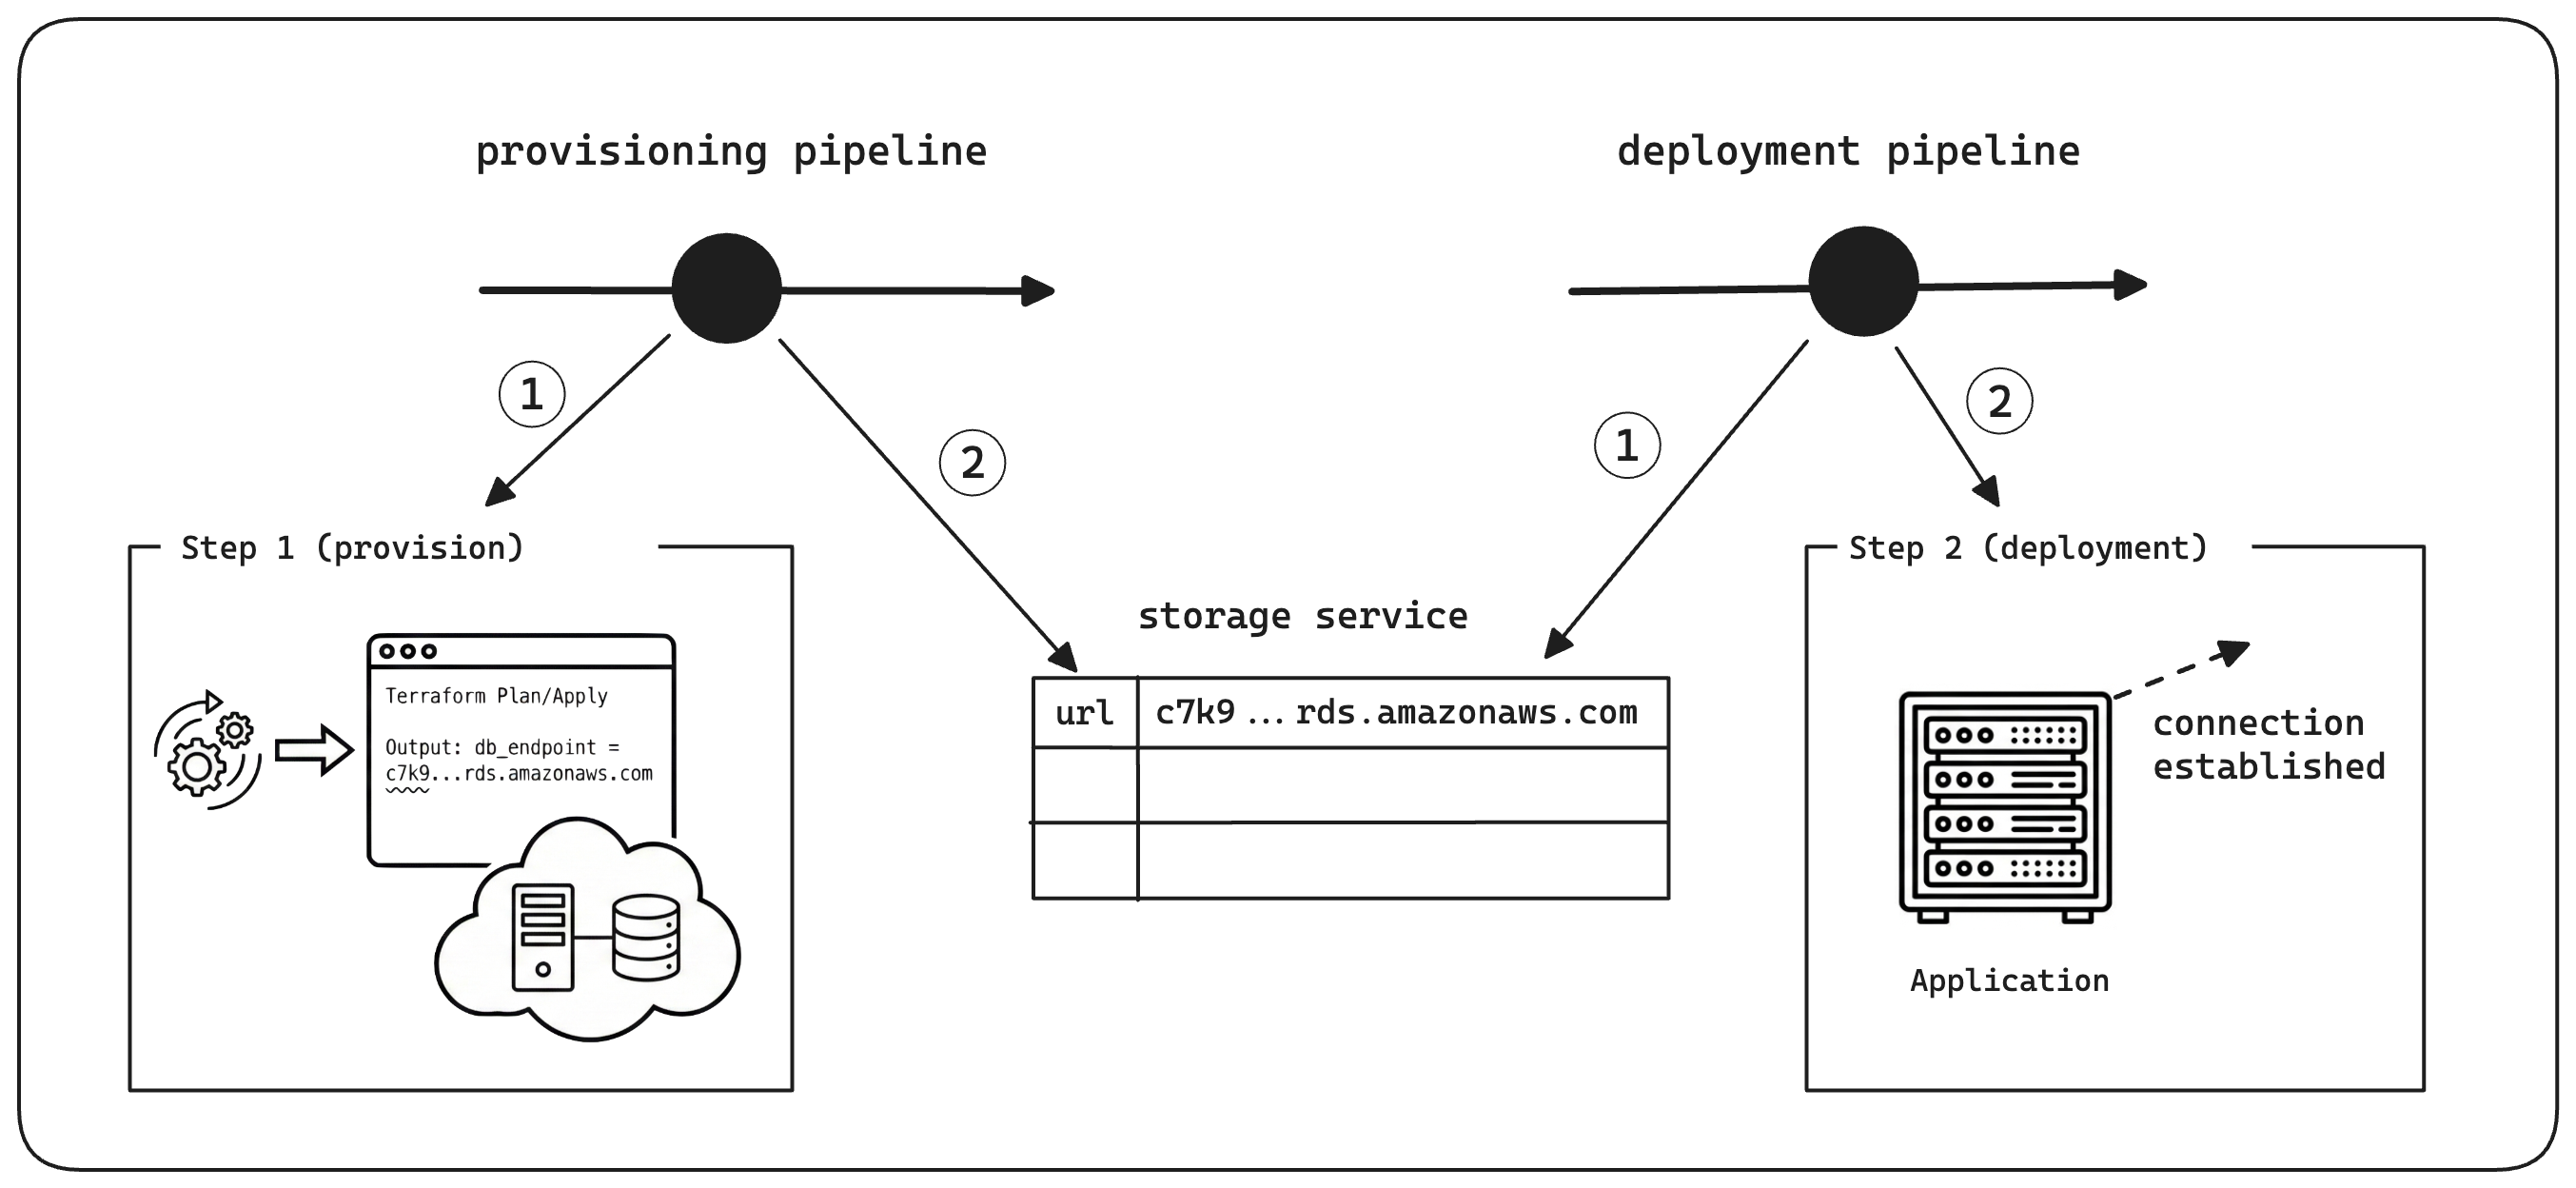
L’avantage : cela offre sélectivité et découplage. On choisit exactement quelles données sont exposées au reste du système. De plus, comme nous le verrons plus loin, cette méthode est la clé de l’architecture « Unified Store » : elle permet de consolider ces valeurs dynamiques avec les paramètres statiques derrière une API unique et cohérente, en masquant la complexité de leur origine.
Secret
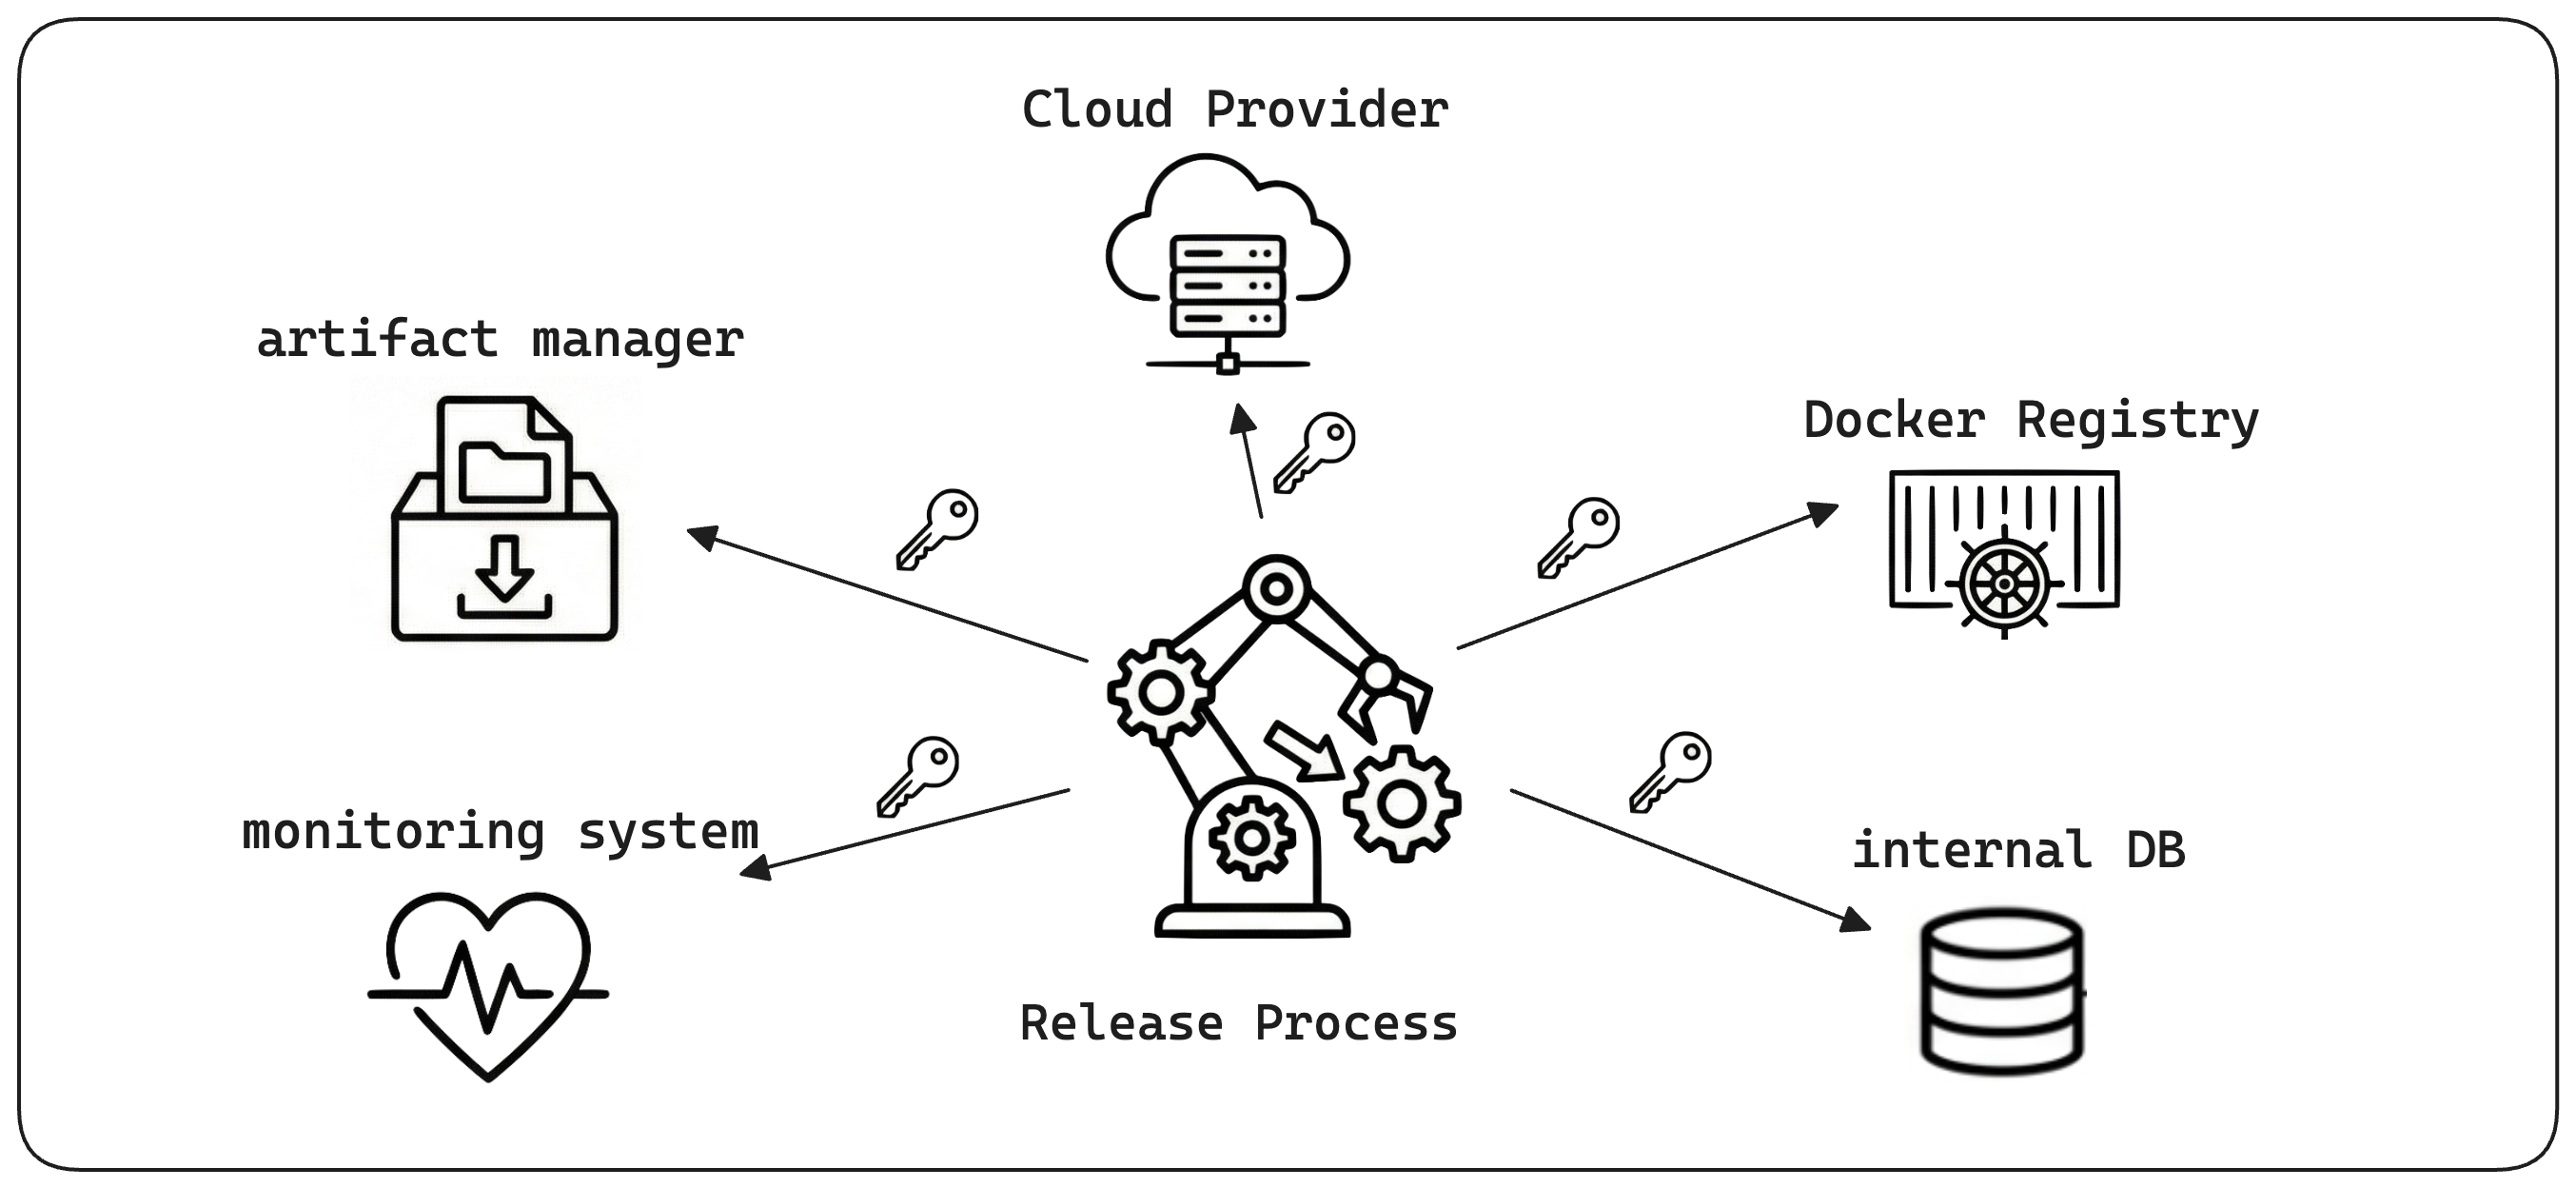
Les secrets englobent toutes les données sensibles qui représentent une identité ou une autorisation. En raison de leur caractère critique, ils exigent une gestion de cycle de vie spécialisée qui les classe strictement par consommateur. Une architecture de release robuste doit distinguer les identifiants opérationnels nécessaires pour orchestrer le déploiement des secrets d’exécution consommés par l’application.
Secrets opérationnels pour le processus de release
La mécanique de release a besoin de ses propres identifiants pour fonctionner. Les « secrets de processus » sont des clés utilisées par l’infrastructure CI/CD elle-même — comme les clés de service account Terraform ou les tokens de registry Docker. Ils opèrent strictement au niveau de la couche infrastructure et donnent au « robot de déploiement » l’autorité d’orchestrer la release.
Livrer les secrets à l’application
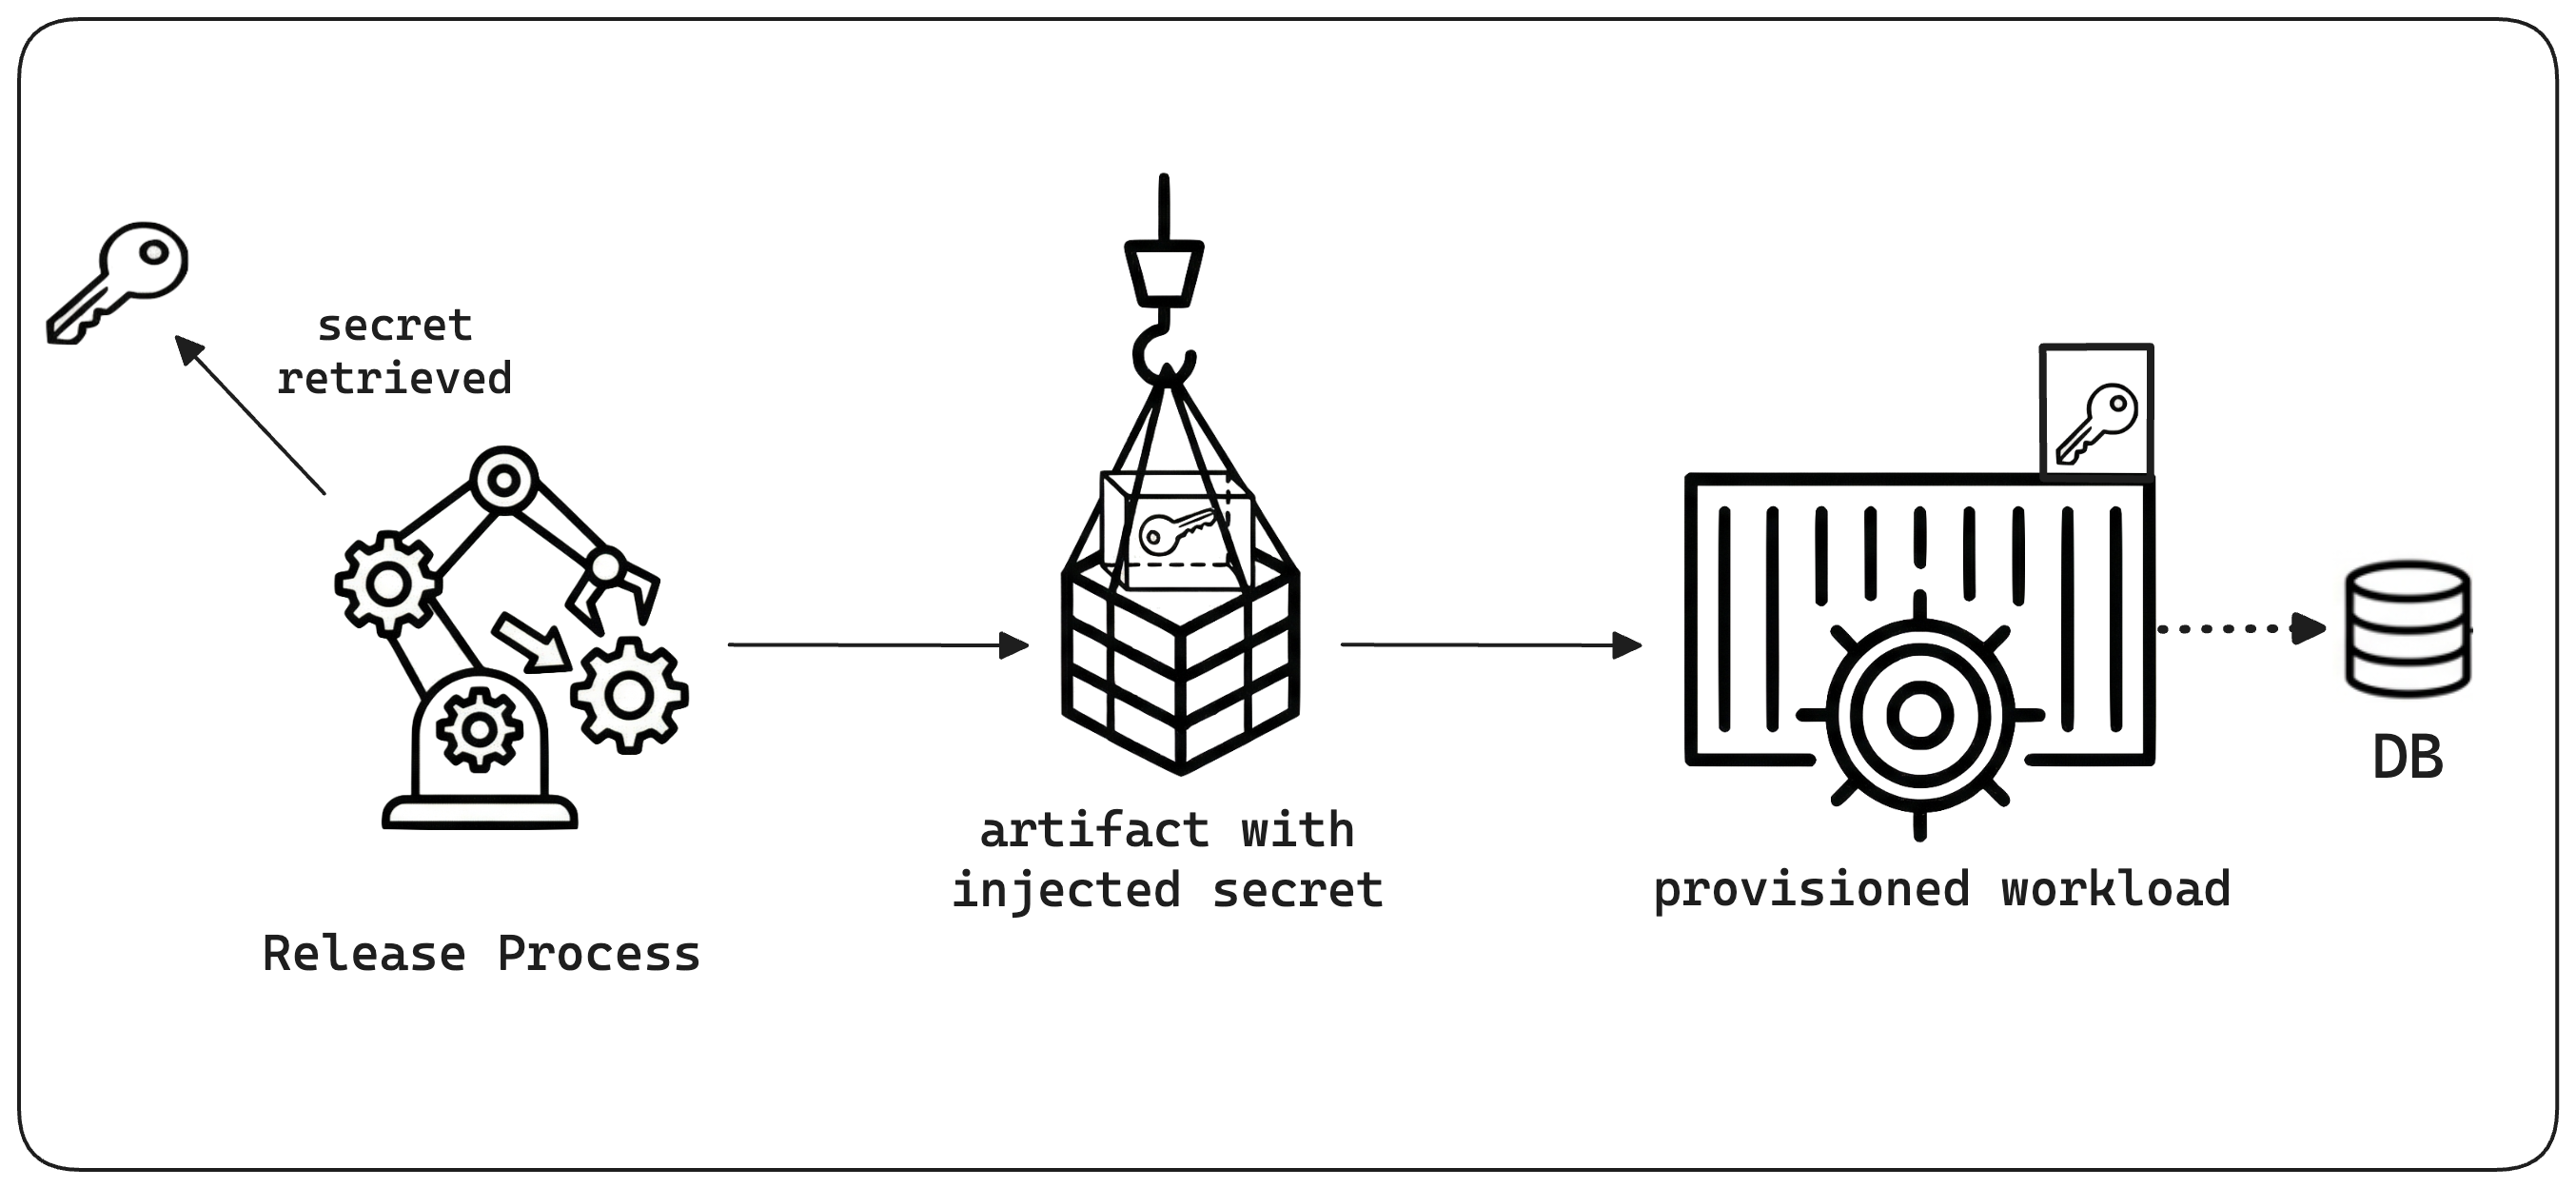
Le pipeline de release est fréquemment utilisé pour livrer des secrets à l’application. Dans ce modèle, le processus joue le rôle de convoyeur : il récupère les données sensibles (comme les mots de passe de base de données) et les injecte dans le workload au moment du déploiement. L’application démarre ainsi avec un accès immédiat à ses dépendances. Cependant, cela implique que le pipeline de déploiement lui-même manipule des secrets en clair. Plus grave encore, cela crée un couplage fort : on ne peut pas déployer l’application sans exécuter la logique de provisioning qui récupère les clés. De plus, cela lie le cycle de vie du secret à la release : par exemple, pour faire tourner ses clés, on est obligé de redéployer tout le workload.
Repli sur des identifiants éphémères
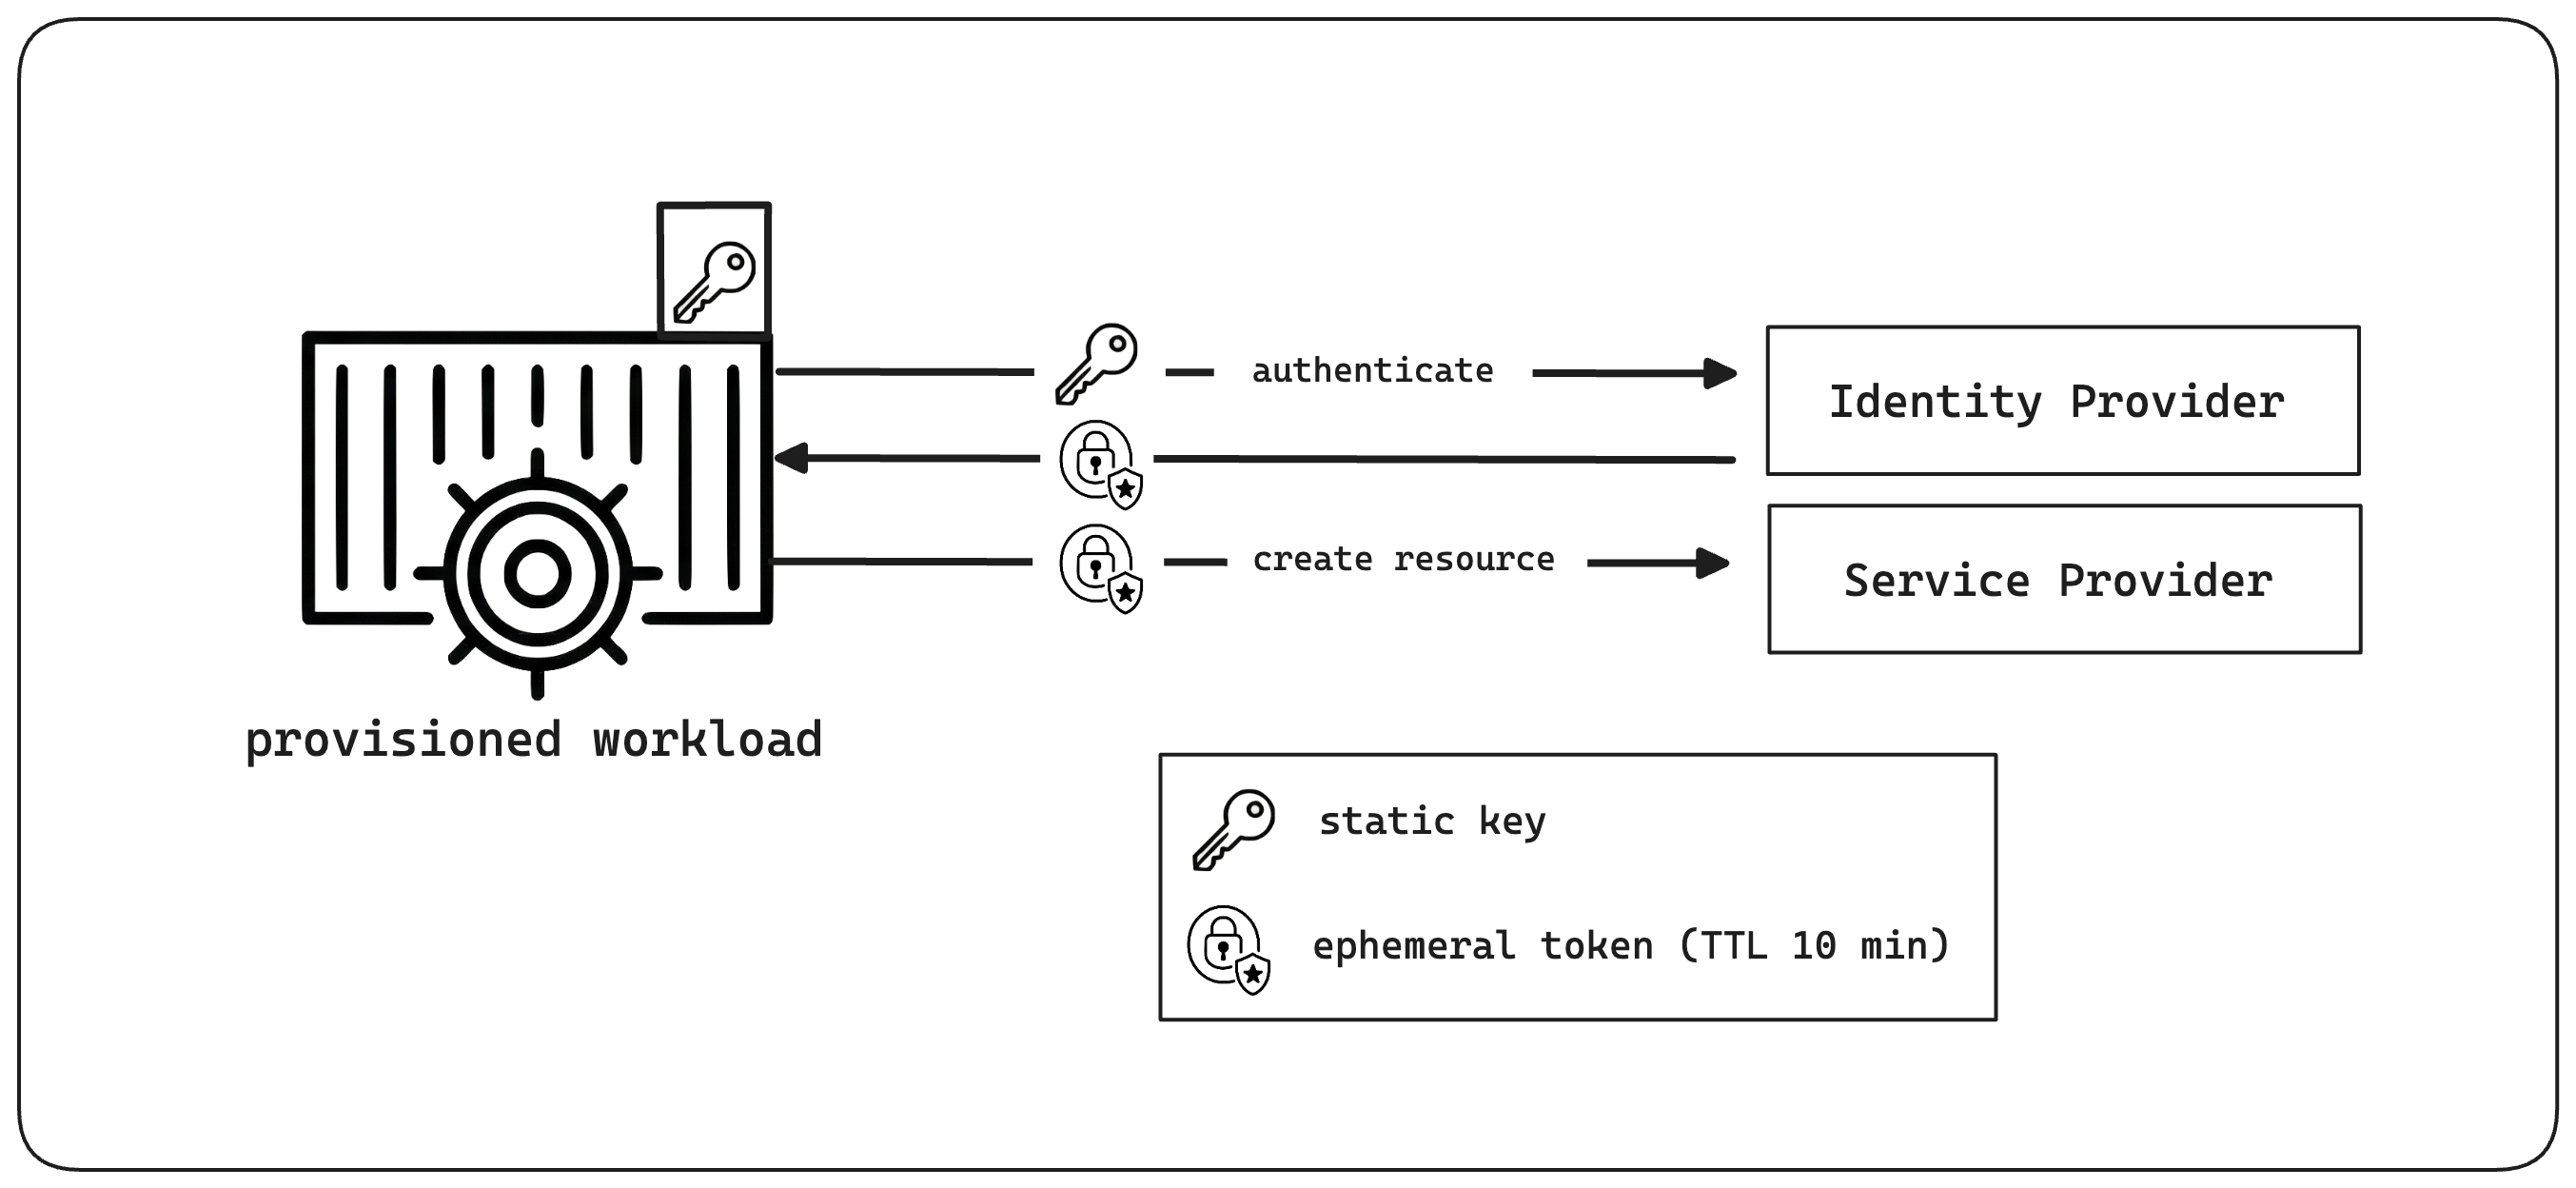
Quand l’authentification directe par identité est techniquement impossible — souvent à cause de bases de données héritées ou d’API tierces qui imposent strictement un échange d’identifiants — la stratégie doit basculer vers les identifiants éphémères. Au lieu de revenir à des clés statiques risquées, le système s’appuie sur l’identité du workload pour émettre des tokens de courte durée ou des « secrets dynamiques » qui n’existent que le temps d’une session ou d’une transaction précise. Cette approche réduit drastiquement le rayon d’impact en matière de sécurité ; même si un identifiant fuite, sa durée de vie très limitée le rend inutilisable pour un attaquant presque immédiatement, neutralisant efficacement la menace d’une exposition de long terme sans rotation manuelle.
Le défi de la fragmentation : une vérité éparpillée
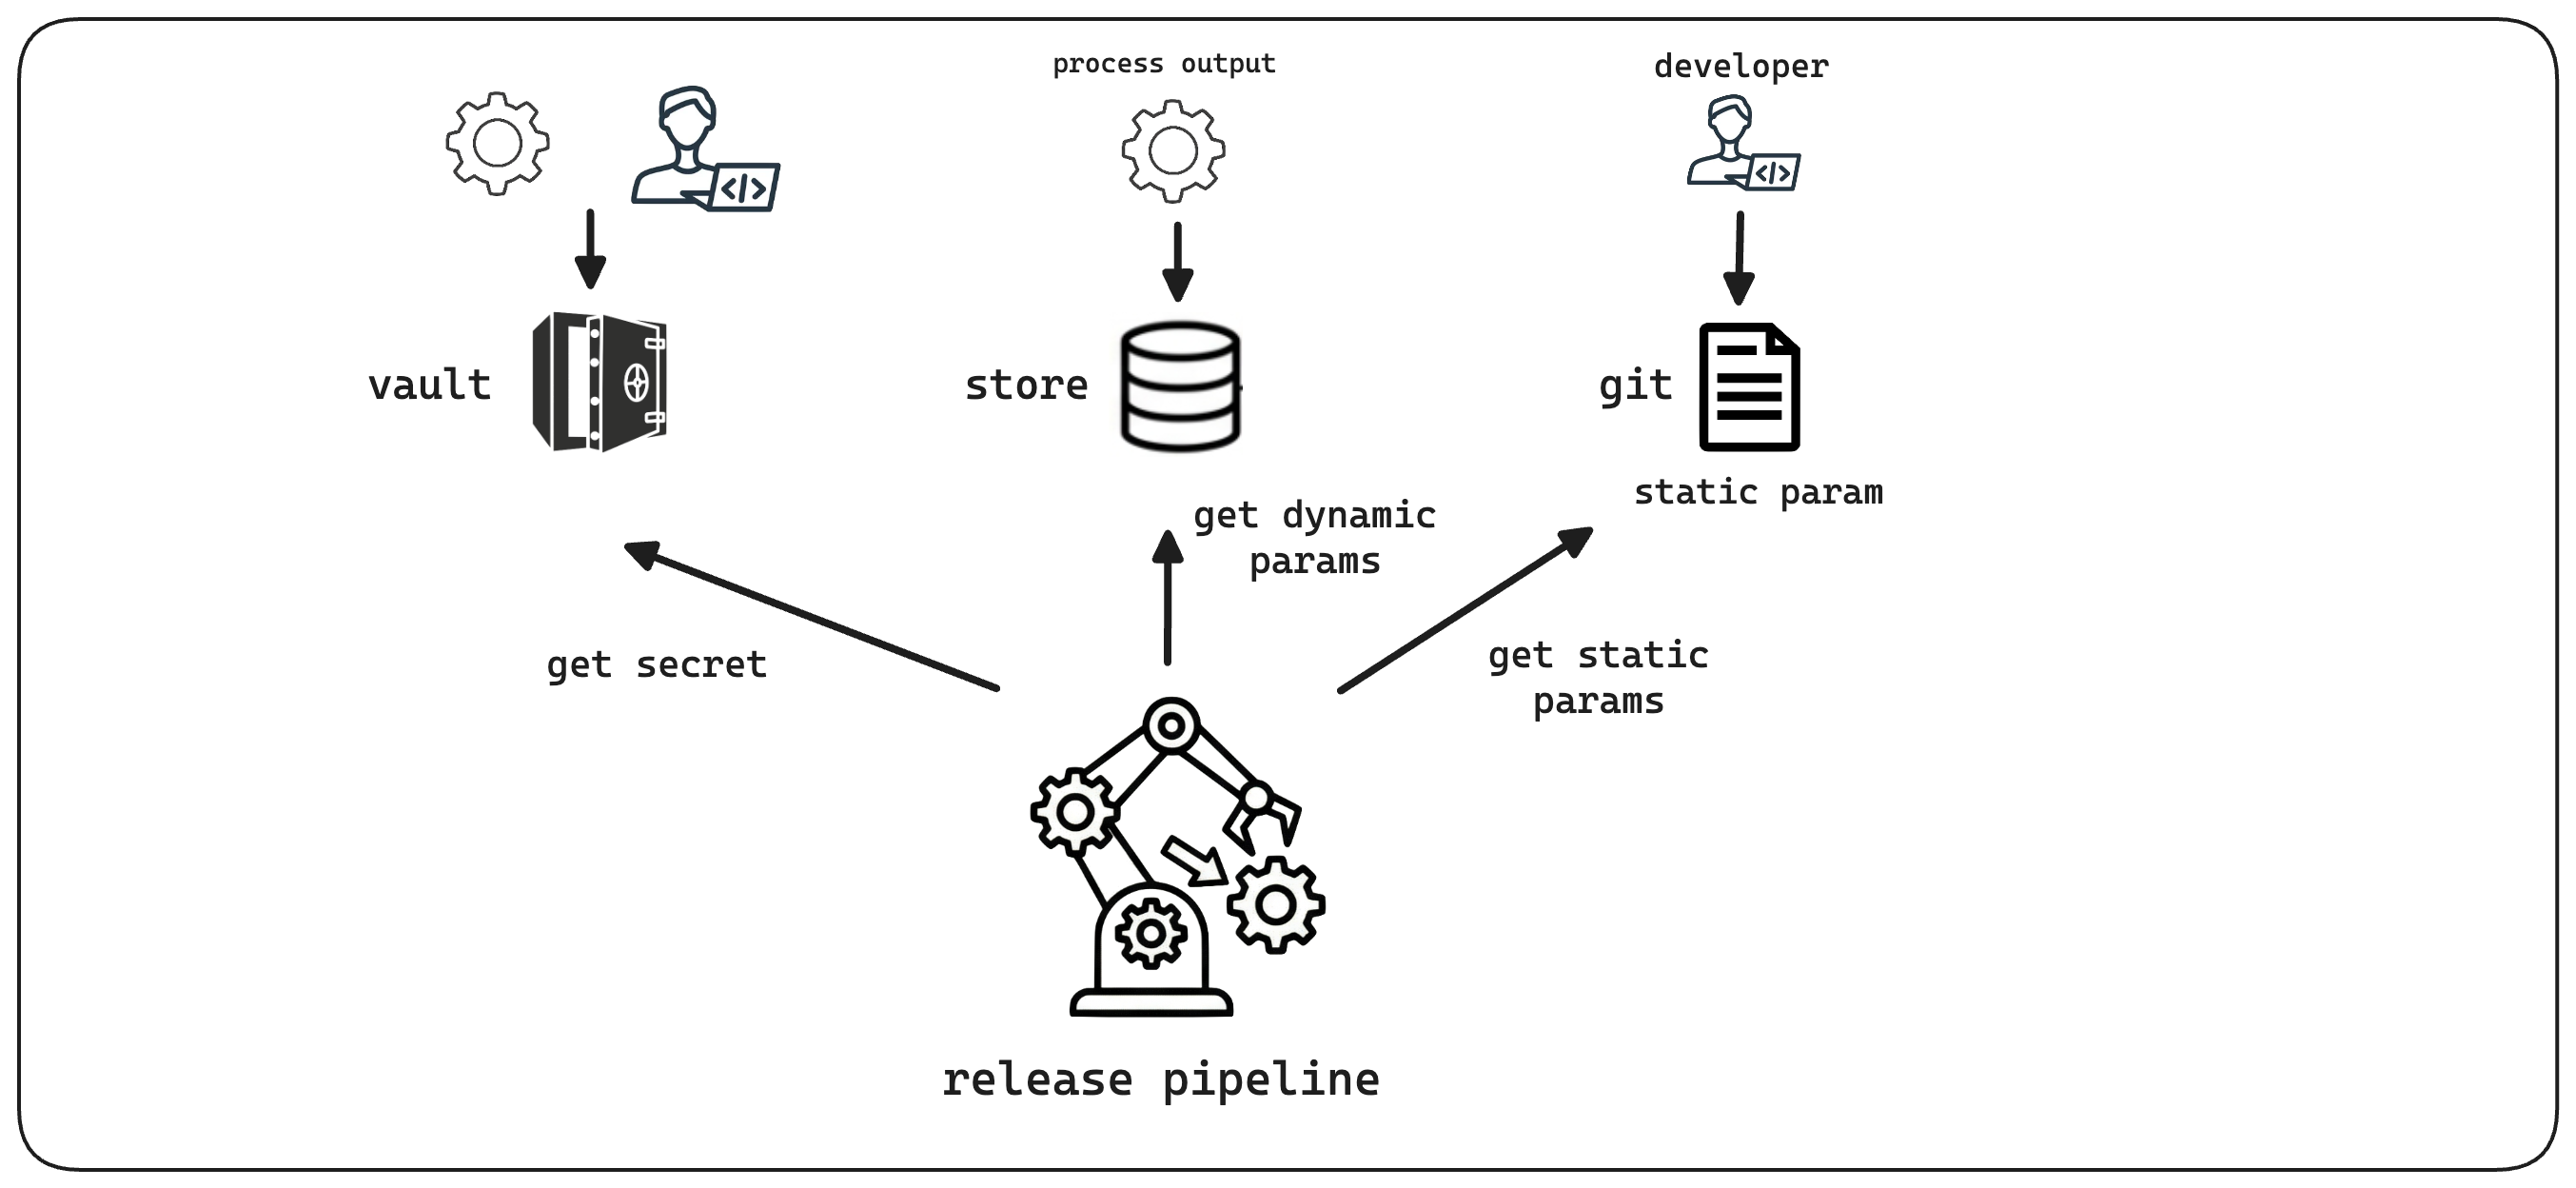
Le fardeau de l’assemblage. Dans une architecture fragmentée, le pipeline de release est forcé de jouer le rôle d’un broker d’intégration complexe. Comme les données de configuration sont hébergées dans trois systèmes incompatibles — Git pour les fichiers statiques, les API cloud pour les ressources dynamiques et les coffres pour les secrets —, la logique de déploiement doit implémenter des connecteurs spécifiques pour chacun. Cela crée une « couche de colle » fragile où le pipeline supporte le gros du travail de récupération, d’analyse et de fusion de ces flux disparates à l’exécution, uniquement pour construire un état applicatif utilisable.
Le store de configuration unifié
L’évolution ultime de la gestion de configuration est de découpler complètement l’origine d’un paramètre de sa consommation. En mettant en place un Unified State Store, nous consolidons les trois catégories de configuration — statique, dynamique et secrets — dans une couche unique et interrogeable. Dans ce modèle, Git reste l’interface de rédaction pour les humains, en préservant l’historique des versions et les revues par les pairs pour les paramètres statiques ; en revanche, un processus de synchronisation réplique immédiatement ces valeurs dans le Store au merge. En parallèle, les pipelines d’infrastructure injectent les valeurs dynamiques et les workflows de sécurité alimentent le Vault.
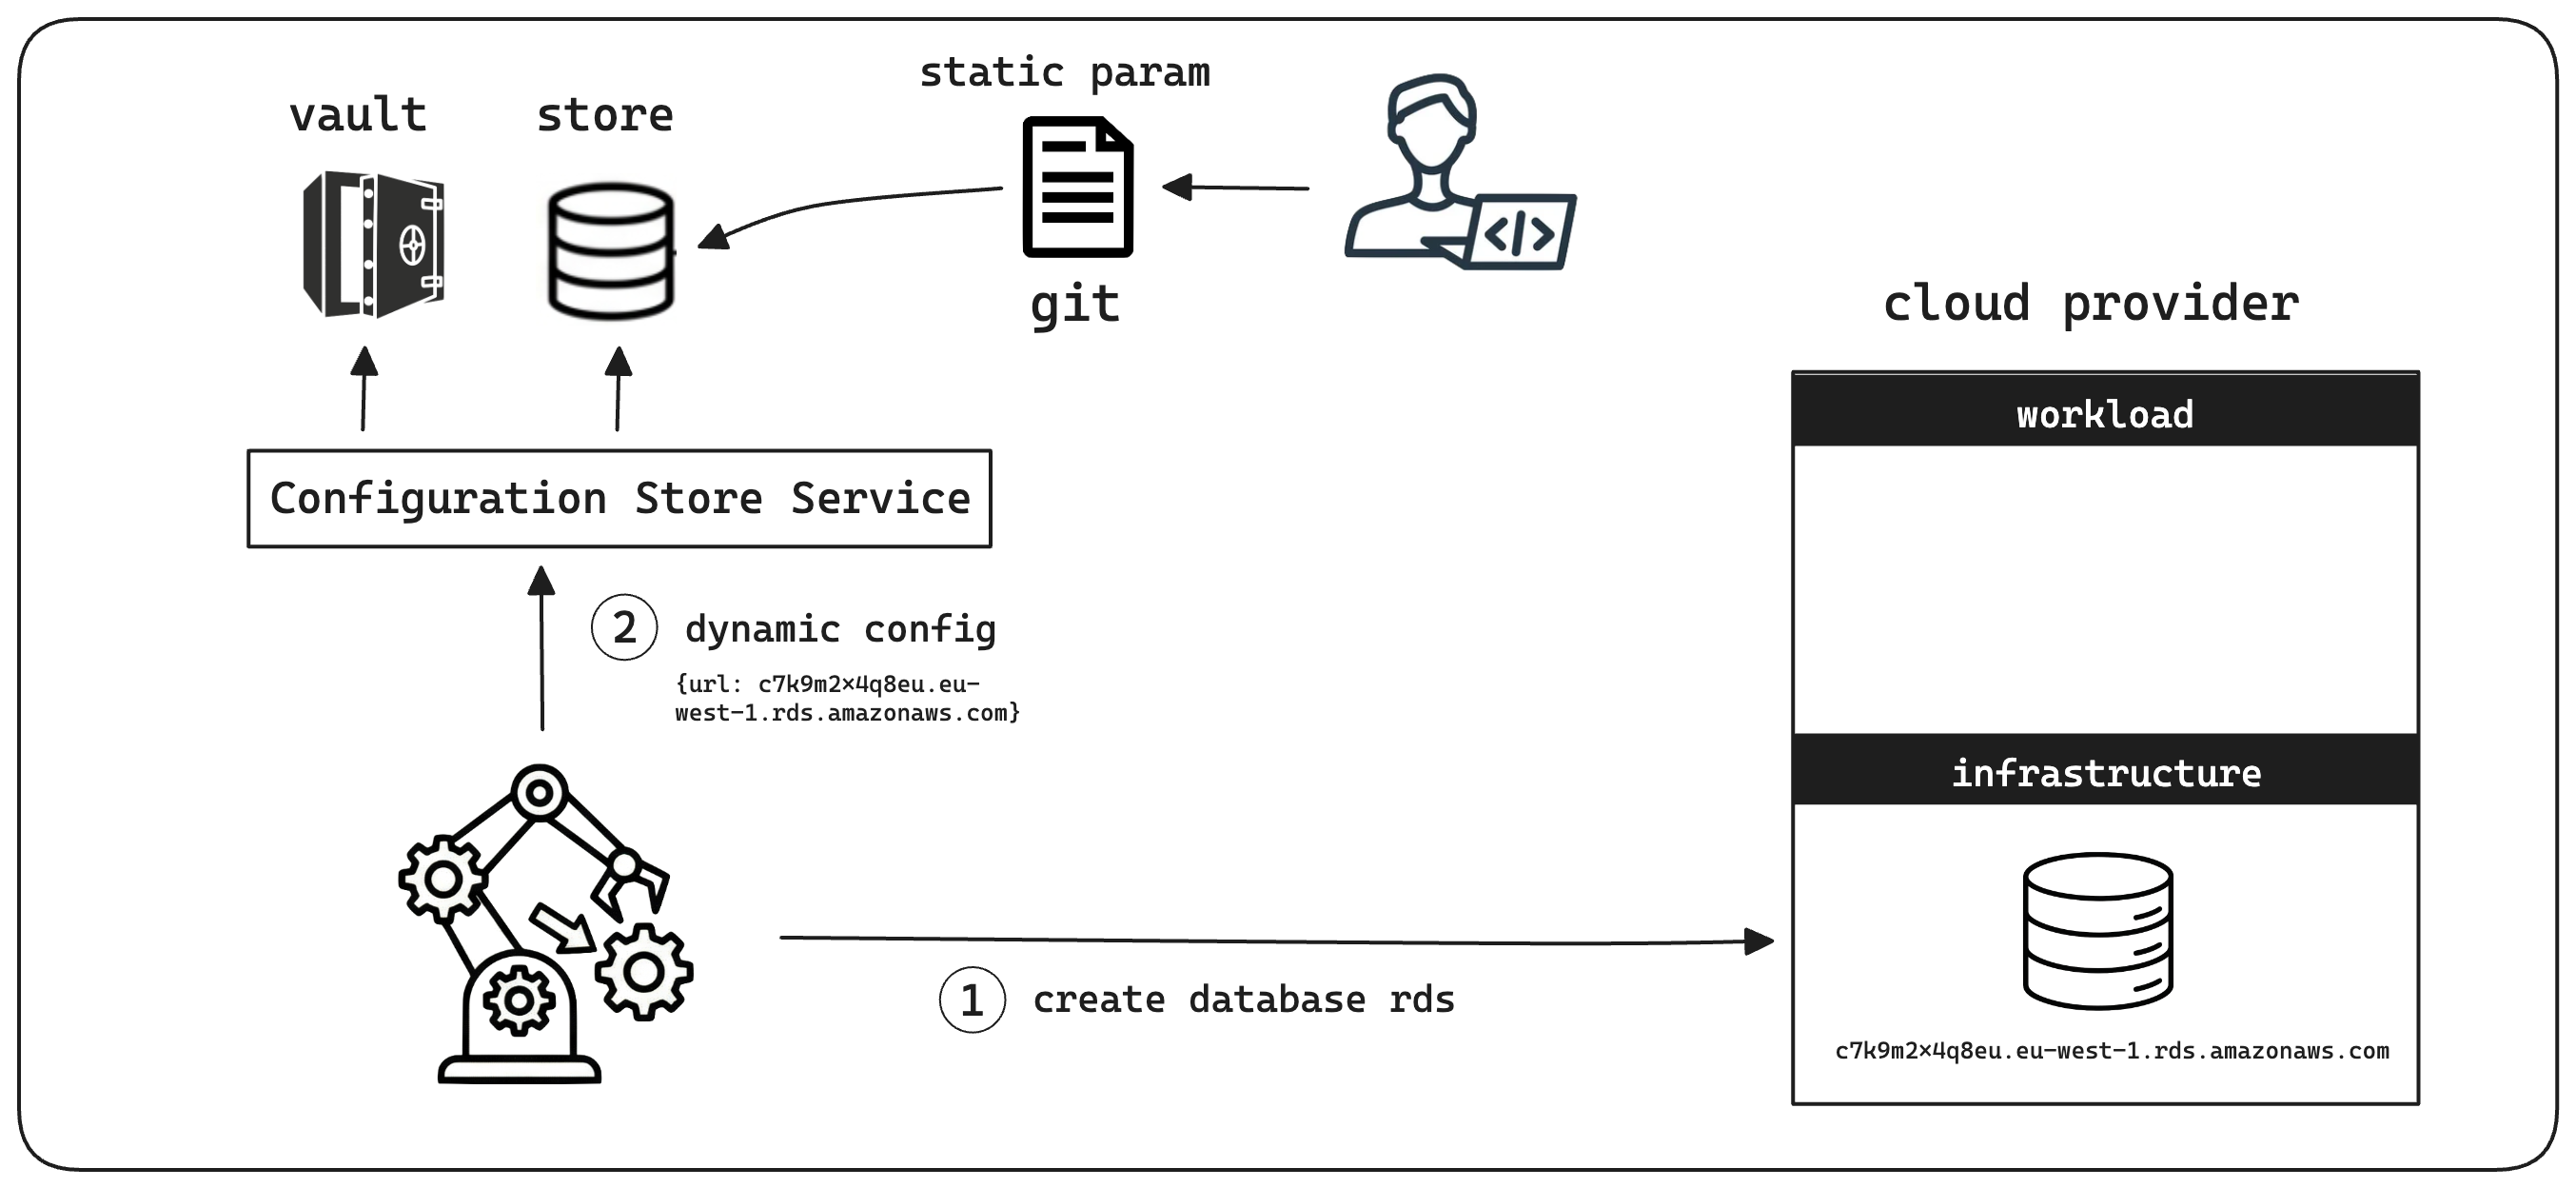
Pour le pipeline de release, cette complexité est invisible. Il interagit avec une seule API ou couche d’abstraction pour récupérer l’intégralité de son état de configuration, peu importe qu’une valeur ait été saisie par un développeur dans un fichier YAML, générée par un fournisseur cloud ou chiffrée par un responsable sécurité.